Dies ist die mehrseitige Druckansicht dieses Abschnitts. .
Grundlagen
- 1: Datenmodell
- 2: Design des etcd-Clients
- 3: Design der Learner in etcd
- 4: Authentifizierungsdesign von etcd v3
- 5: etcd-API
- 6: Dateien der persistenten Speicherung in etcd
- 7: Garantien der etcd-API
- 8: etcd im Vergleich mit anderen Schlüssel-Wert-Speichern
- 9: Glossar
1 - Datenmodell
etcd ist darauf ausgelegt, selten aktualisierte Daten zuverlässig zu speichern und zuverlässige Watch-Abfragen bereitzustellen. etcd macht frühere Versionen von Schlüssel-Wert-Paaren zugänglich, um kostengünstige Snapshots und die Beobachtung historischer Ereignisse zu ermöglichen („Zeitreiseabfragen“). Ein persistentes Datenmodell mit Mehrversions-Nebenläufigkeitskontrolle eignet sich gut für diese Anwendungsfälle.
etcd speichert Daten in einem persistenten Schlüssel-Wert-Speicher mit mehreren Versionen. Dieser bewahrt die vorherige Version eines Schlüssel-Wert-Paars auf, wenn dessen Wert durch neue Daten ersetzt wird. Der Schlüssel-Wert-Speicher ist praktisch unveränderlich: Seine Operationen aktualisieren die Struktur nicht an Ort und Stelle, sondern erzeugen stets eine neue, aktualisierte Struktur. Alle früheren Versionen von Schlüsseln bleiben nach einer Änderung zugänglich und können beobachtet werden. Damit der Datenspeicher nicht unbegrenzt wächst und alte Versionen dauerhaft vorhält, kann er kompaktiert werden, um die ältesten Versionen ersetzter Daten zu entfernen.
Logische Sicht
Die logische Sicht auf den Speicher ist ein flacher binärer Schlüsselraum. Ein lexikalisch sortierter Index über Schlüssel aus Bytefolgen ermöglicht kostengünstige Bereichsabfragen.
Der Schlüsselraum verwaltet mehrere Revisionen. Beim Anlegen des Speichers ist die erste Revision 1. Jede atomare ändernde Operation erzeugt eine neue Revision des Schlüsselraums; eine Transaktionsoperation kann beispielsweise mehrere Operationen enthalten. Alle Daten früherer Revisionen bleiben unverändert. Alte Schlüsselversionen sind über frühere Revisionen weiterhin zugänglich. Auch die Revisionen sind indiziert, sodass Watcher effizient Revisionsbereiche durchlaufen können. Wird der Speicher zur Platzersparnis kompaktiert, werden die Revisionen vor der Kompaktierungsrevision entfernt. Revisionen steigen während der gesamten Lebensdauer eines Clusters monoton an.
Das Leben eines Schlüssels umfasst eine Generation von der Erstellung bis zur Löschung. Jeder Schlüssel kann eine oder mehrere Generationen haben. Das Anlegen eines Schlüssels erhöht seine Version, beginnend bei 1, falls der Schlüssel in der aktuellen Revision nicht existiert. Das Löschen erzeugt einen Tombstone für den Schlüssel und beendet dessen aktuelle Generation, indem seine Version auf 0 zurückgesetzt wird. Jede Änderung eines Schlüssels erhöht seine Version. Versionen steigen daher innerhalb einer Schlüsselgeneration monoton an. Bei einer Kompaktierung werden alle Generationen entfernt, die vor der Kompaktierungsrevision endeten. Auch alle vor dieser Revision gesetzten Werte außer dem jeweils neuesten werden entfernt.
Physische Sicht
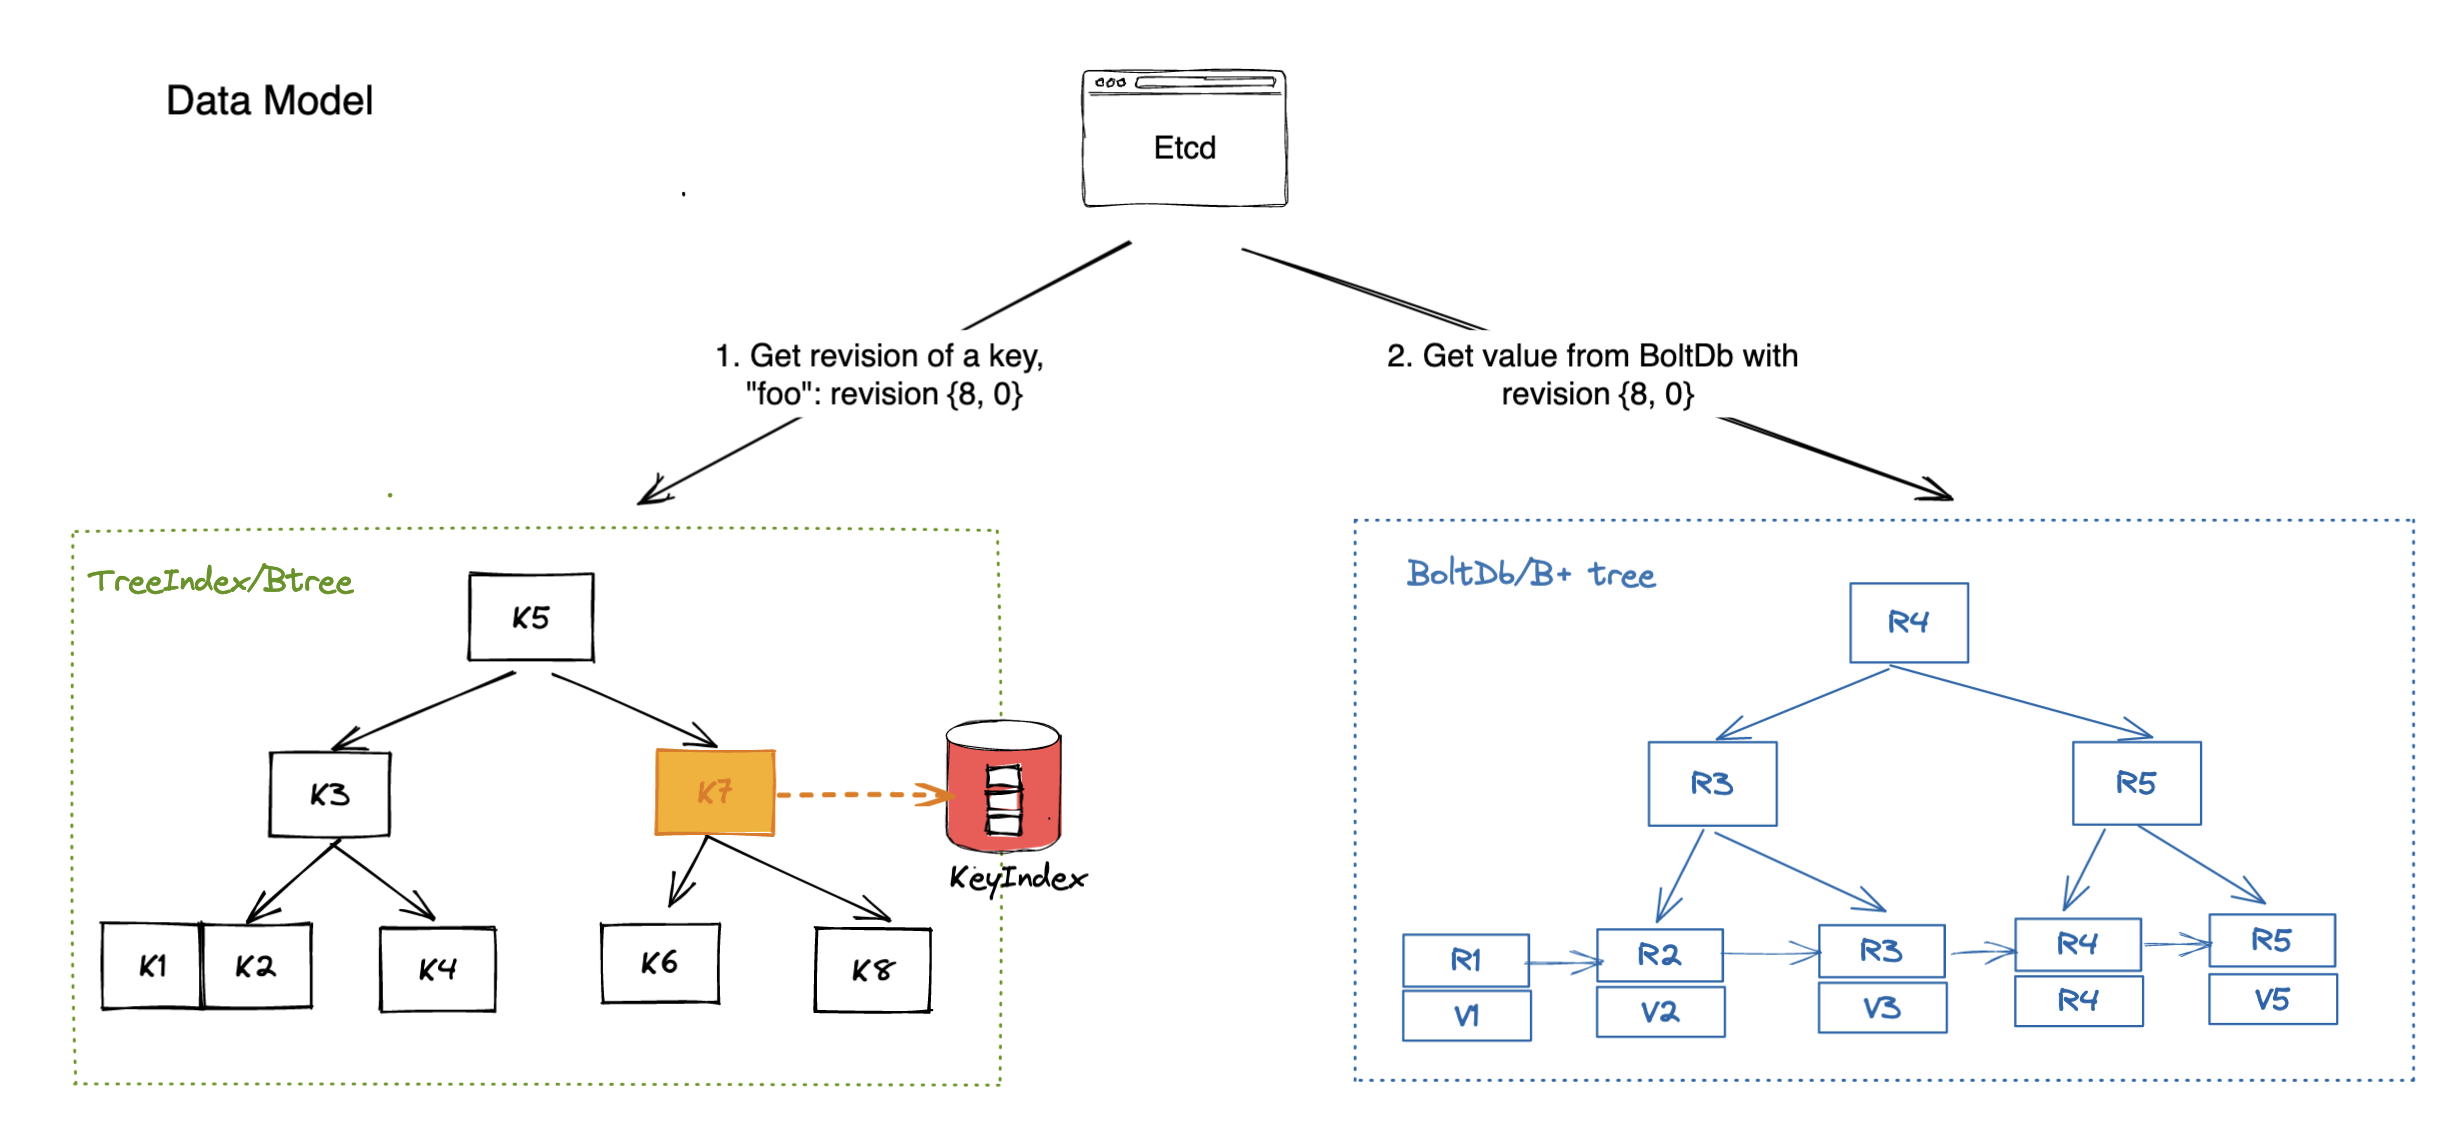
etcd speichert die physischen Daten als Schlüssel-Wert-Paare in einem persistenten B+-Baum . Aus Effizienzgründen enthält jede Revision des Speicherzustands nur die Differenz zur vorherigen Revision. Einer einzelnen Revision können mehrere Schlüssel im Baum entsprechen.
Der Schlüssel eines Schlüssel-Wert-Paars ist ein 3-Tupel (major, sub, type). Major ist die Speicherrevision, die den Schlüssel enthält. Sub unterscheidet Schlüssel innerhalb derselben Revision. Type ist ein optionales Suffix für besondere Werte, etwa t, wenn der Wert einen Tombstone enthält. Der Wert des Schlüssel-Wert-Paars enthält die Änderung gegenüber der vorherigen Revision, also eine Differenz zu ihr. Der B+-Baum ist lexikalisch nach den Bytes der Schlüssel sortiert. Bereichssuchen über Revisionsdifferenzen sind schnell; so lassen sich Änderungen zwischen zwei bestimmten Revisionen rasch ermitteln. Die Kompaktierung entfernt veraltete Schlüssel-Wert-Paare.
etcd hält außerdem einen sekundären B-Baum -Index im Arbeitsspeicher, um Bereichsabfragen über Schlüssel zu beschleunigen. Die Schlüssel in diesem Index sind die für Benutzer sichtbaren Schlüssel des Speichers. Der Wert ist ein Zeiger auf die Änderung im persistenten B+-Baum. Die Kompaktierung entfernt ungültig gewordene Zeiger.
etcd ermittelt also die Revisionsinformationen aus dem B-Baum und verwendet anschließend die Revision als Schlüssel, um den Wert aus dem B+-Baum abzurufen (siehe unten).
2 - Design des etcd-Clients
Design des etcd-Clients
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Einleitung
Der etcd-Server hat seine Robustheit in jahrelangen Tests mit gezielt ausgelösten Fehlern bewiesen. Die meiste komplexe Anwendungslogik übernimmt bereits der etcd-Server mit seinen Datenspeichern. Beispielsweise bleibt die Clustermitgliedschaft für Clients transparent, da die Raft-Schicht Vorschläge an den Leader weiterleitet. Auch wenn die Serverkomponenten korrekt arbeiten, erfordert ihr Zusammenspiel mit dem Client weitere komplexe Protokolle, um Korrektheit und Hochverfügbarkeit auch bei Fehlern zu gewährleisten. Idealerweise bietet der etcd-Server eine einzige logische Clustersicht auf viele physische Rechner, während der Client automatisches Failover zwischen Replikaten implementiert. Dieses Dokument beschreibt die Architekturentscheidungen des Clients und die Details ihrer Implementierung.
Glossar
clientv3: Offizieller Go-Client von etcd für die etcd-v3-API.
clientv3-grpc1.0: Offizielle Client-Implementierung mit grpc-go v1.0.x
, die in der neuesten Version von etcd v3.1 verwendet wird.
clientv3-grpc1.7: Offizielle Client-Implementierung mit grpc-go v1.7.x
, die in den neuesten Versionen von etcd v3.2 und v3.3 verwendet wird.
clientv3-grpc1.23: Offizielle Client-Implementierung mit grpc-go v1.23.x
, die in der neuesten Version von etcd v3.4 verwendet wird.
Load-Balancer: Lastverteiler des etcd-Clients, der Wiederholungs- und Failover-Mechanismen implementiert. Der etcd-Client sollte die Last automatisch auf mehrere Endpunkte verteilen.
Endpunkte: Eine Liste von etcd-Serverendpunkten, mit denen sich Clients verbinden können. Üblicherweise sind dies 3 oder 5 Client-URLs eines etcd-Clusters.
Fest zugeordneter Endpunkt: Bei mehreren konfigurierten Endpunkten wählt der Client-Load-Balancer in Versionen <= v3.3 nur einen Endpunkt für eine TCP-Verbindung aus, um die Gesamtzahl offener Verbindungen zum etcd-Cluster gering zu halten. In v3.4 wechselt der Load-Balancer für jede Anfrage im Round-Robin-Verfahren zwischen den fest zugeordneten Endpunkten und verteilt die Last dadurch gleichmäßiger.
Client-Verbindung: Eine über gRPC Dial aufgebaute TCP-Verbindung zu einem etcd-Server.
Unterverbindung: Die gRPC-Schnittstelle SubConn. Jede Unterverbindung enthält eine Adressliste. Der Load-Balancer erstellt aus einer Liste aufgelöster Adressen eine SubConn. Eine gRPC ClientConn kann mehreren SubConn entsprechen, etwa wenn example.com auf 10.10.10.1 und 10.10.10.2 zweier Unterverbindungen aufgelöst wird. Der Load-Balancer von etcd v3.4 verwendet einen internen Resolver, um für jeden Endpunkt eine Unterverbindung aufzubauen.
Vorübergehender Verbindungsabbruch: Wenn der gRPC-Server einen Statusfehler vom Typ code Unavailable
zurückgibt.
Anforderungen an den Client
Korrektheit. Bei Serverfehlern können Anfragen fehlschlagen. Konsistenzgarantien werden jedoch nie verletzt: Eigenschaften der globalen Reihenfolge, kein Schreiben beschädigter Daten, At-most-once-Semantik für ändernde Operationen, keine Beobachtung unvollständiger Ereignisse durch Watches usw.
Fortschrittsgarantie. Server können ausfallen oder kurzzeitig die Verbindung verlieren. Clients sollten in beiden Fällen Fortschritte machen. Sie sollten beim Warten auf die Rückkehr eines offline gegangenen Servers niemals dauerhaft blockieren , sofern dies nicht ausdrücklich konfiguriert ist. Idealerweise erkennen Clients nicht verfügbare Server mit HTTP/2-Pings und wechseln mit verständlichen Fehlermeldungen zu anderen Knoten.
Effizienz. Clients sollten mit minimalem Ressourcenverbrauch wirksam arbeiten: Nach einem Endpunktwechsel sollten vorherige TCP-Verbindungen geordnet geschlossen werden. Der Failover-Mechanismus sollte das nächste geeignete Replikat für eine Verbindung bestimmen, ohne Ressourcen durch wiederholte Versuche an ausgefallenen Knoten zu verschwenden.
Portierbarkeit. Der offizielle Client sollte klar dokumentiert sein, und seine Implementierung sollte sich auf Anbindungen anderer Sprachen übertragen lassen. Die Fehlerbehandlung sollte über die Sprachanbindungen hinweg konsistent sein. Da etcd vollständig auf gRPC setzt, sollte sich die Implementierung eng an den langfristigen Entwurfszielen von gRPC orientieren. Beispielsweise sollte eine austauschbare Wiederholungsrichtlinie mit gRPC-Wiederholungen kompatibel sein. Upgrades zwischen zwei Client-Versionen sollten den Betrieb nicht unterbrechen.
Client-Überblick
Der etcd-Client implementiert die folgenden Komponenten:
- einen Load-Balancer, der gRPC-Verbindungen zu einem etcd-Cluster aufbaut,
- einen API-Client, der RPCs an einen etcd-Server sendet, und
- eine Fehlerbehandlung, die entscheidet, ob eine fehlgeschlagene Anfrage wiederholt oder der Endpunkt gewechselt wird.
Sprachen können sich darin unterscheiden, wie die erste Verbindung aufgebaut wird, etwa durch TLS-Konfiguration, wie Protocol-Buffer-Nachrichten kodiert und an den Server gesendet werden, wie Streaming-RPCs verarbeitet werden usw. Die vom etcd-Server zurückgegebenen Fehler sind jedoch dieselben. Entsprechend sollten auch Fehlerbehandlung und Wiederholungsrichtlinie gleich sein.
Beispielsweise kann der etcd-Server "rpc error: code = Unavailable desc = etcdserver: request timed out" zurückgeben, einen vorübergehenden Fehler, bei dem Wiederholungen erwartet werden. Oder er gibt rpc error: code = InvalidArgument desc = etcdserver: key is not provided zurück. Dies bedeutet, dass die Anfrage ungültig war und nicht wiederholt werden sollte. Der Go-Client kann Fehler mit google.golang.org/grpc/status.FromError auswerten, der Java-Client mit io.grpc.Status.fromThrowable.
clientv3-grpc1.0: Überblick über den Load-Balancer
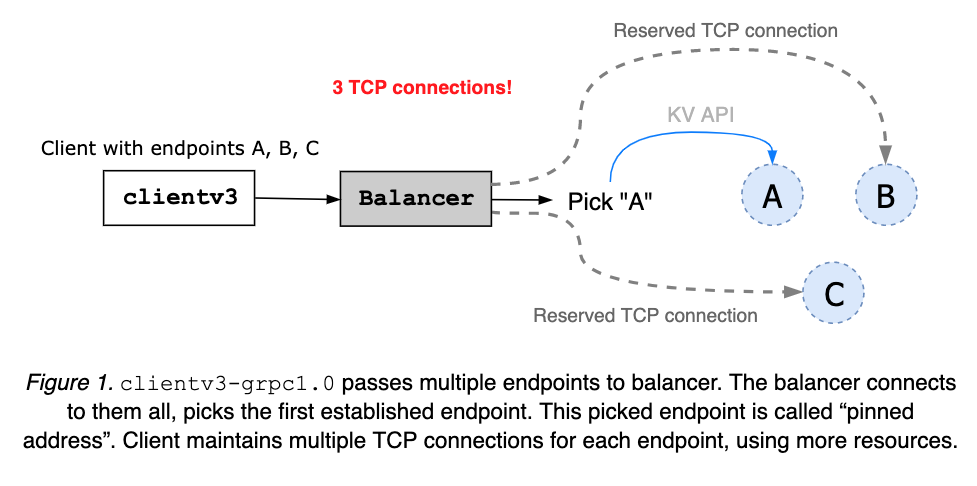
Bei mehreren konfigurierten etcd-Endpunkten hält clientv3-grpc1.0 mehrere TCP-Verbindungen offen. Anschließend wählt er eine Adresse und sendet darüber alle Client-Anfragen. Die fest zugeordnete Adresse bleibt erhalten, bis das Client-Objekt geschlossen wird (siehe Abbildung 1). Wenn der Client einen Fehler erhält, wählt er zufällig eine andere Adresse und versucht es erneut.
clientv3-grpc1.0: Einschränkungen des Load-Balancers
Die mehreren TCP-Verbindungen von clientv3-grpc1.0 können ein schnelleres Failover des Load-Balancers ermöglichen, benötigen aber mehr Ressourcen. Der Load-Balancer kennt weder den Zustand der Knoten noch ihre Clustermitgliedschaft. Daher kann er an einem ausgefallenen oder durch eine Netzwerkpartition abgetrennten Knoten hängen bleiben.
clientv3-grpc1.7: Überblick über den Load-Balancer
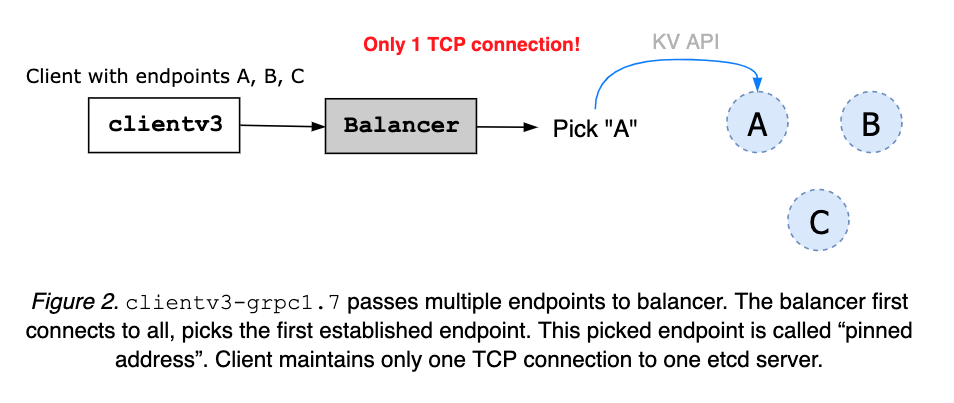
clientv3-grpc1.7 hält nur eine TCP-Verbindung zu einem ausgewählten etcd-Server offen. Bei mehreren angegebenen Clusterendpunkten versucht ein Client zunächst, sich mit allen zu verbinden. Sobald eine Verbindung steht, ordnet der Load-Balancer die Adresse fest zu und schließt die anderen Verbindungen (siehe Abbildung 2). Die Adresse soll zugeordnet bleiben, bis das Client-Objekt geschlossen wird. Ein Fehler des Servers oder des Client-Netzwerks wird an die Fehlerbehandlung des Clients weitergeleitet (siehe Abbildung 3).
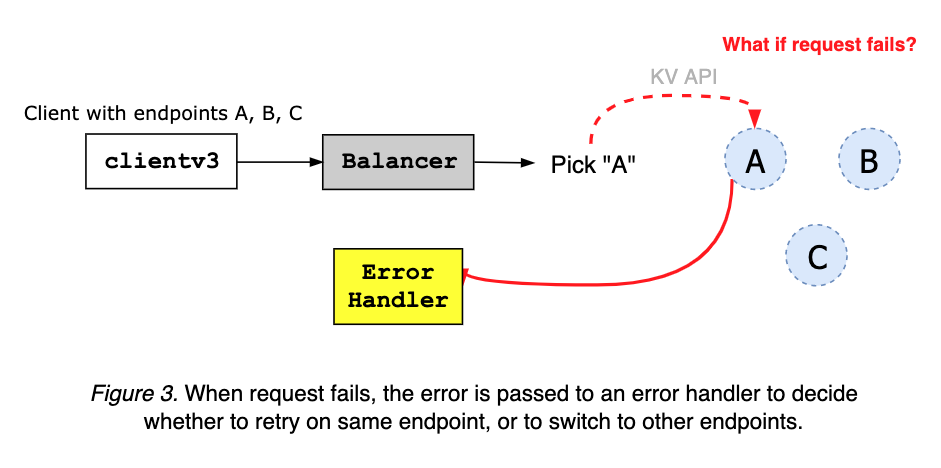
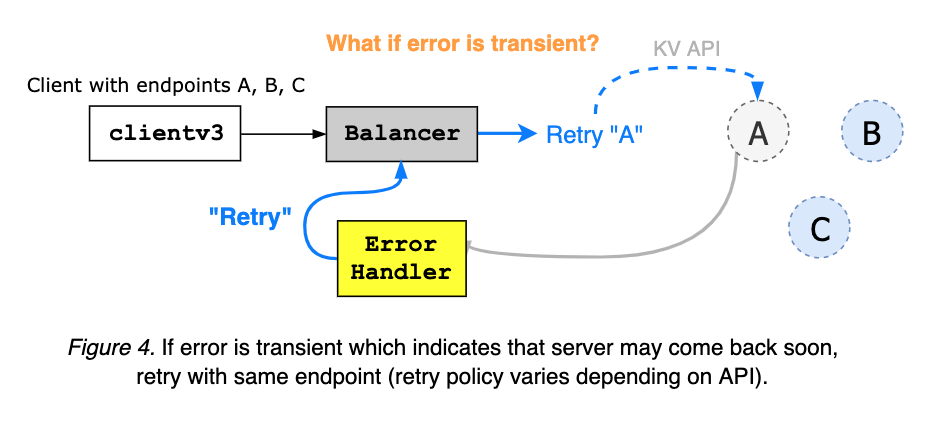
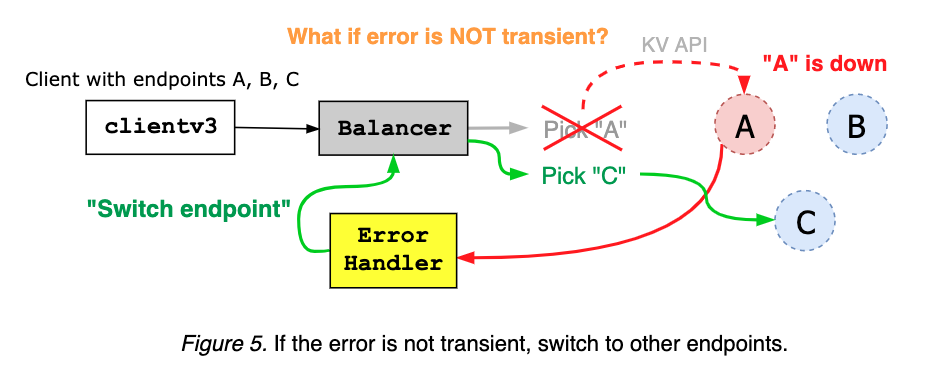
Die Fehlerbehandlung des Clients erhält einen Fehler vom gRPC-Server und entscheidet anhand von Fehlercode und Meldung, ob dieselbe Anfrage am selben Endpunkt wiederholt oder zu einer anderen Adresse gewechselt wird (siehe Abbildung 4 und Abbildung 5).
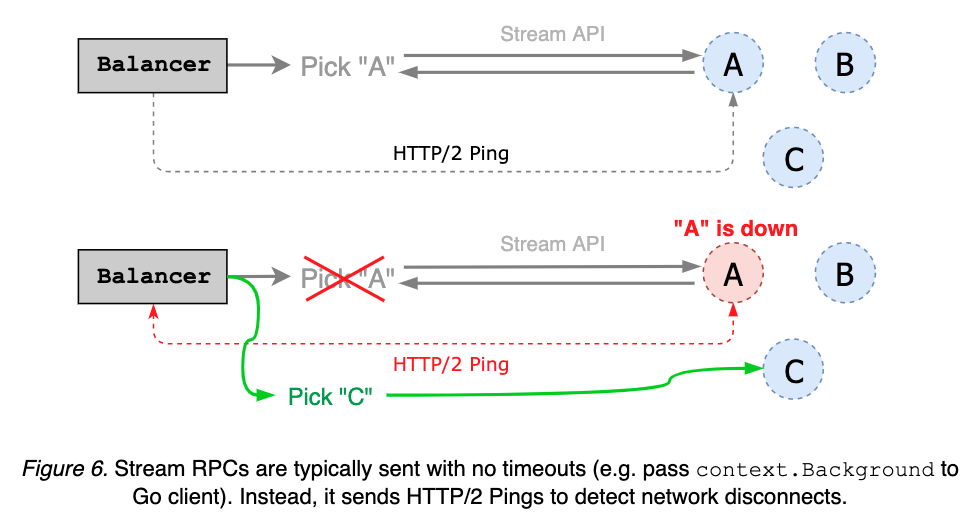
Streaming-RPCs wie Watch und KeepAlive werden häufig ohne Zeitlimit angefordert. Stattdessen kann der Client regelmäßig HTTP/2-Pings senden, um den Zustand eines fest zugeordneten Endpunkts zu prüfen. Antwortet der Server nicht auf den Ping, wechselt der Load-Balancer zu anderen Endpunkten (siehe Abbildung 6).
clientv3-grpc1.7: Einschränkungen des Load-Balancers
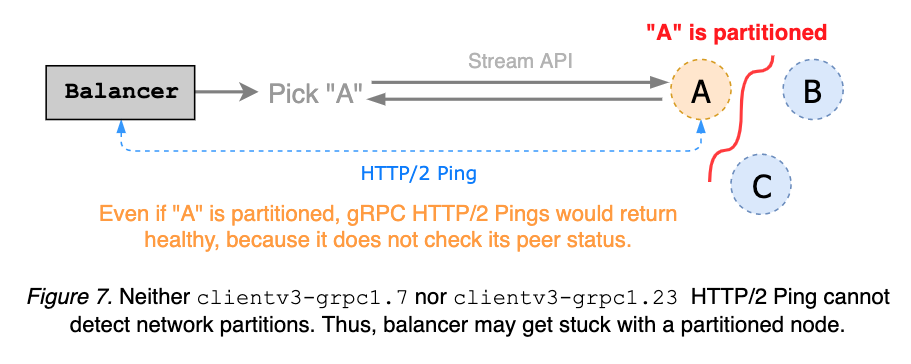
Der Load-Balancer von clientv3-grpc1.7 sendet HTTP/2-Keepalives, um Verbindungsabbrüche bei Streaming-Anfragen zu erkennen. Dieser einfache Ping-Mechanismus für gRPC-Server berücksichtigt keine Clustermitgliedschaft und kann daher Netzwerkpartitionen nicht erkennen. Da ein abgetrennter gRPC-Server weiterhin auf Client-Pings antworten kann, kann der Load-Balancer an diesem Knoten hängen bleiben. Idealerweise erkennt der Keepalive-Ping die Partition und löst vor Ablauf des Anfragezeitlimits einen Endpunktwechsel aus (siehe etcd#8673
und Abbildung 7).
Der Load-Balancer von clientv3-grpc1.7 führt eine Liste nicht funktionsfähiger Endpunkte. Adressen mit abgebrochener Verbindung werden dieser Liste hinzugefügt und gelten bis zum Ende einer Wartezeit als nicht verfügbar. Diese Wartezeit ist fest an das Verbindungsaufbau-Zeitlimit mit einem Standardwert von 5 Sekunden gekoppelt. Der Load-Balancer kann Endpunkte fälschlich als nicht funktionsfähig einstufen. Beispielsweise kann Endpunkt A unmittelbar nach Aufnahme in die Sperrliste zurückkehren, bleibt aber dennoch für die nächsten 5 Sekunden unbenutzbar (siehe Abbildung 8).
clientv3-grpc1.0 hatte dieselben oben beschriebenen Probleme.
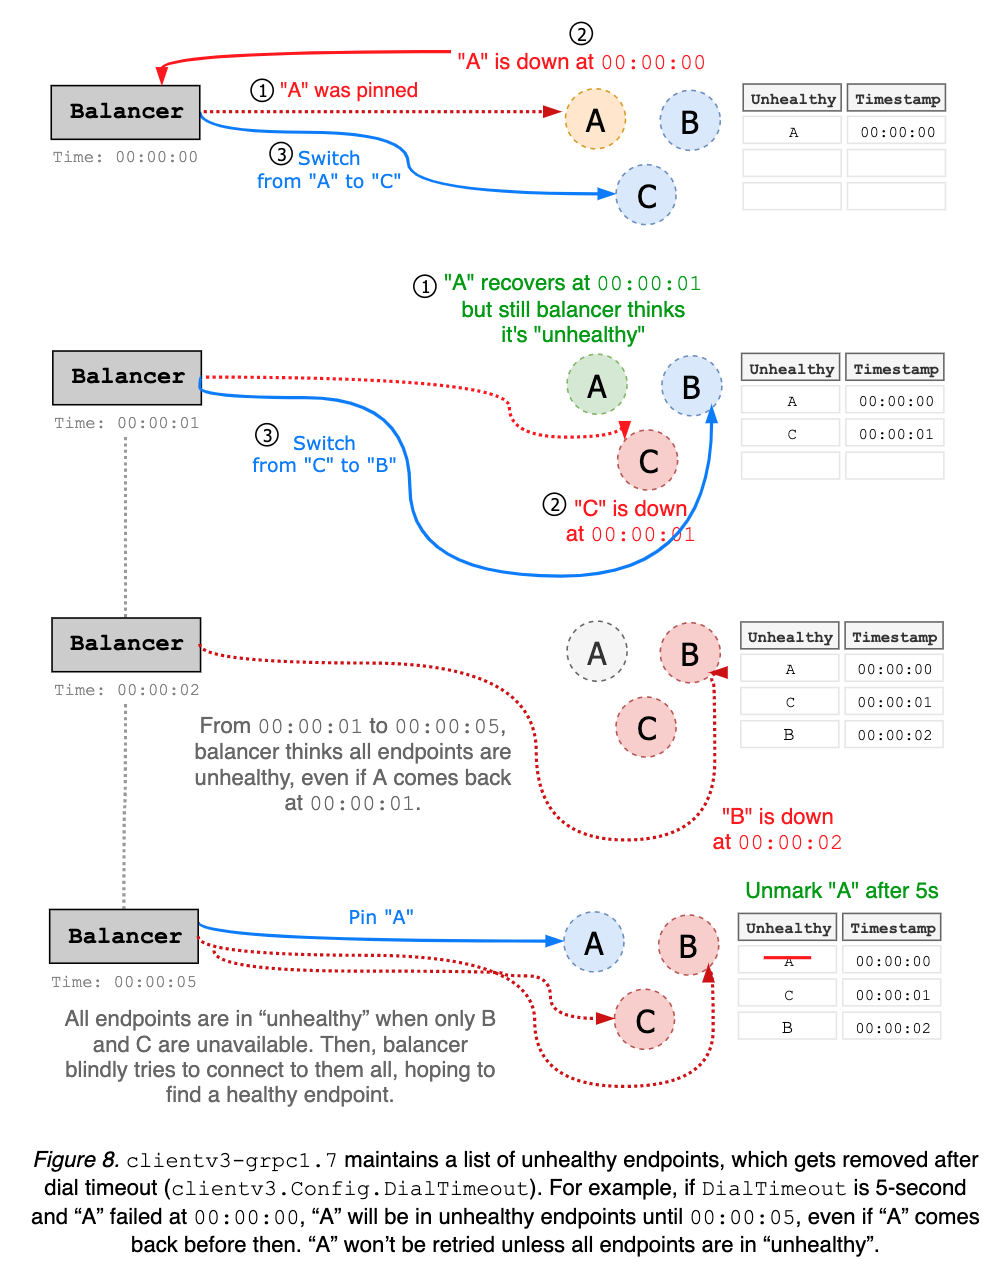
Das Upstream-Projekt gRPC Go war bereits auf die neue Load-Balancer-Schnittstelle umgestiegen. So verwendet die zugrunde liegende Implementierung von clientv3-grpc1.7 den neuen gRPC-Load-Balancer und versucht dabei, das Verhalten des alten beizubehalten. Obwohl die Kompatibilität recht gut erhalten blieb, war der etcd-Client dennoch von subtilen inkompatiblen Änderungen betroffen
. Zudem empfiehlt der gRPC-Maintainer, sich nicht auf die alte Load-Balancer-Schnittstelle zu stützen
. Für bessere Unterstützung durch Upstream ist es generell am besten, mit den neuesten gRPC-Versionen Schritt zu halten. Neue Funktionen wie Wiederholungsrichtlinien werden möglicherweise nicht auf den gRPC-1.7-Zweig zurückportiert. Daher müssen sowohl etcd-Server als auch -Client auf die neuesten gRPC-Versionen umsteigen.
clientv3-grpc1.23: Überblick über den Load-Balancer
clientv3-grpc1.7 ist so eng an die alte gRPC-Schnittstelle gekoppelt, dass jedes Upgrade der gRPC-Abhängigkeit das Client-Verhalten beeinträchtigte. Der Großteil der Entwicklungs- und Fehlersucharbeit floss in die Behebung dieser Verhaltensänderungen. Dadurch wurde die Implementierung übermäßig komplex und beruhte auf falschen Annahmen über Serververbindungen.
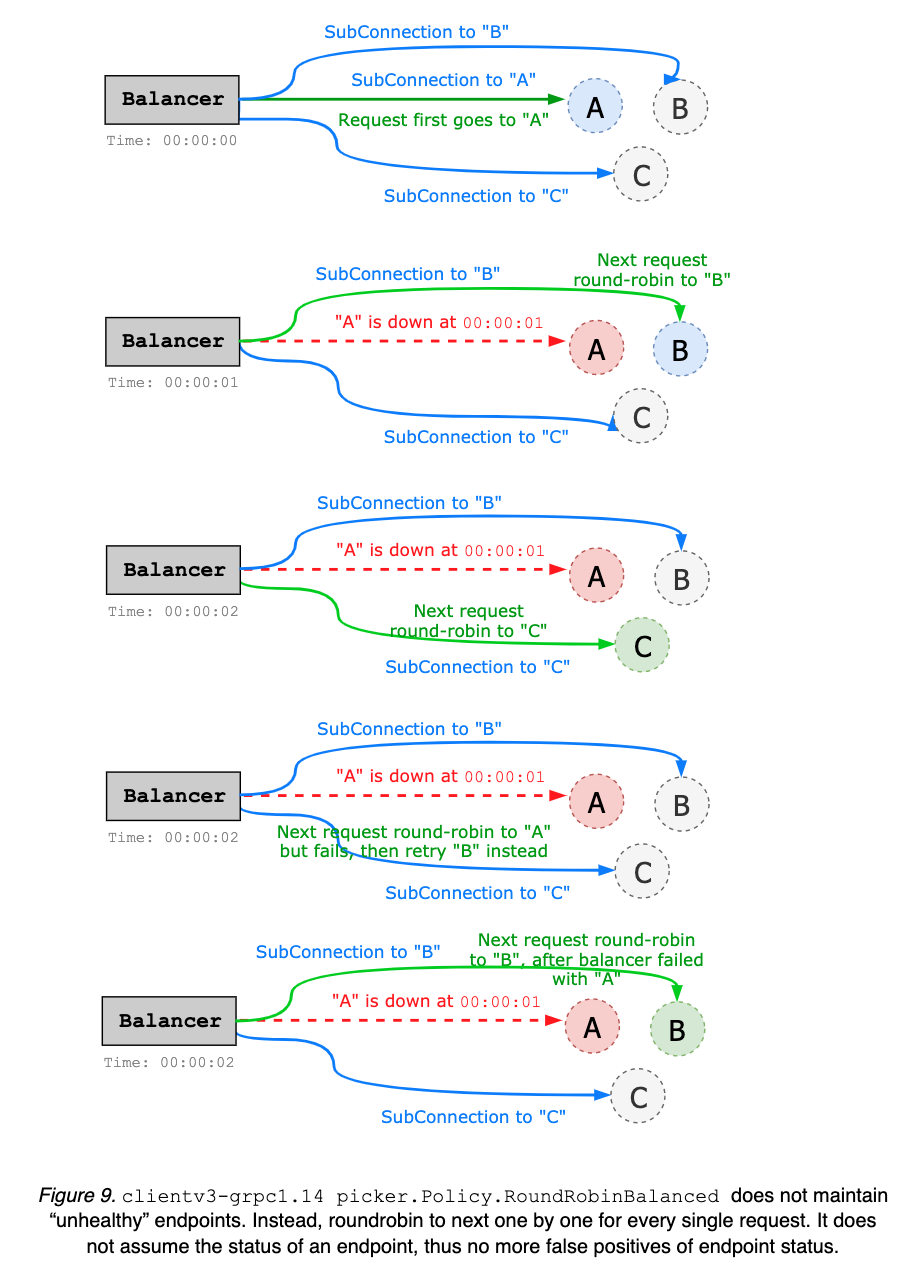
Das Hauptziel von clientv3-grpc1.23 ist eine einfachere Failover-Logik des Load-Balancers. Statt eine möglicherweise veraltete Liste nicht funktionsfähiger Endpunkte zu führen, wechselt er bei jedem Verbindungsabbruch zum aktuellen Endpunkt im Round-Robin-Verfahren zum nächsten. Er trifft keine Annahmen über den Endpunktzustand. Eine komplexe Zustandsverfolgung ist daher nicht mehr nötig (siehe Abbildung 8 und die vorangehenden Erläuterungen). Ein Upgrade auf clientv3-grpc1.23 sollte problemlos sein: Alle Änderungen waren intern und bewahrten die vollständige Abwärtskompatibilität.
Bei mehreren Endpunkten erstellt clientv3-grpc1.23 intern mehrere Unterverbindungen, eine pro Endpunkt. clientv3-grpc1.7 erstellt dagegen nur eine Verbindung zu einem fest zugeordneten Endpunkt (siehe Abbildung 9). In einem Cluster mit 5 Knoten benötigt der Load-Balancer von clientv3-grpc1.23 beispielsweise 5 TCP-Verbindungen, während clientv3-grpc1.7 nur eine benötigt. Durch den erhaltenen TCP-Verbindungspool kann clientv3-grpc1.23 mehr Ressourcen verbrauchen, bietet aber eine flexiblere Lastverteilung mit besserer Failover-Leistung. Standardmäßig wird Round Robin verwendet; andere Verfahren wie „Power of Two“ oder die Auswahl des Leaders lassen sich leicht ergänzen. clientv3-grpc1.23 verwendet eine gRPC-Resolver-Gruppe und implementiert eine Auswahlrichtlinie für den Load-Balancer, um die komplexe Lastverteilung an Upstream-gRPC zu delegieren. clientv3-grpc1.7 verwaltet dagegen jede gRPC-Verbindung und das Failover selbst, was die Implementierung verkompliziert. clientv3-grpc1.23 implementiert Wiederholungen in der gRPC-Interceptor-Kette, die interne gRPC-Fehler automatisch behandelt und fortgeschrittene Wiederholungsrichtlinien wie Backoff ermöglicht. clientv3-grpc1.7 wertet gRPC-Fehler für Wiederholungen dagegen selbst aus.
clientv3-grpc1.23: Einschränkungen des Load-Balancers
Verbesserungen sind durch Zwischenspeichern des Zustands jedes Endpunkts möglich. Beispielsweise kann der Load-Balancer vorab jeden Server anpingen, um eine Liste funktionsfähiger Kandidaten zu führen und diese Informationen beim Round-Robin-Verfahren zu nutzen. Oder er kann nach einem Verbindungsabbruch funktionsfähige Endpunkte bevorzugen. Dies kann die Implementierung verkomplizieren und deshalb in späteren Versionen behandelt werden.
Der clientseitige Keepalive-Ping berücksichtigt weiterhin keine Netzwerkpartitionen. Streaming-Anfragen können an einem abgetrennten Knoten hängen bleiben. Um die Clustermitgliedschaft zu berücksichtigen, muss ein erweiterter Health-Check-Dienst implementiert werden (Einzelheiten unter etcd#8673 ).
Derzeit wird die Wiederholungslogik manuell als Interceptor umgesetzt. Dies kann durch offizielle gRPC-Wiederholungen vereinfacht werden.
3 - Design der Learner in etcd
Learner in etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Hintergrund
Die Neukonfiguration der Clustermitgliedschaft zählt zu den größten Herausforderungen im Betrieb. Im Folgenden werden häufige Schwierigkeiten betrachtet.
1. Ein neues Clustermitglied überlastet den Leader
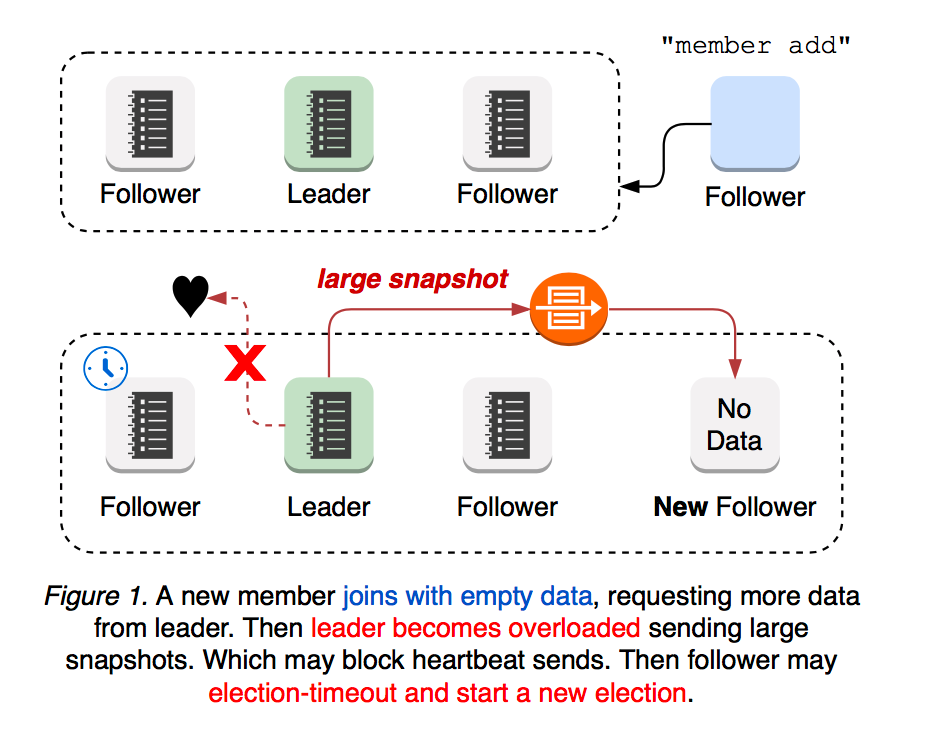
Ein neu beigetretenes etcd-Mitglied startet ohne Daten und fordert daher zusätzliche Aktualisierungen vom Leader an, bis es dessen Logstand erreicht hat. Dadurch kann das Netzwerk des Leaders leichter überlastet werden, sodass seine Heartbeats an Follower blockiert oder verworfen werden. In diesem Fall kann bei einem Follower das Wahlzeitlimit ablaufen und eine neue Leader-Wahl auslösen. Ein Cluster mit einem neuen Mitglied ist somit anfälliger für Leader-Wahlen. Sowohl die Wahl als auch die anschließende Übertragung der Aktualisierungen an das neue Mitglied können Zeiträume verursachen, in denen der Cluster nicht verfügbar ist (siehe Abbildung 1).
2. Szenarien mit Netzwerkpartitionen
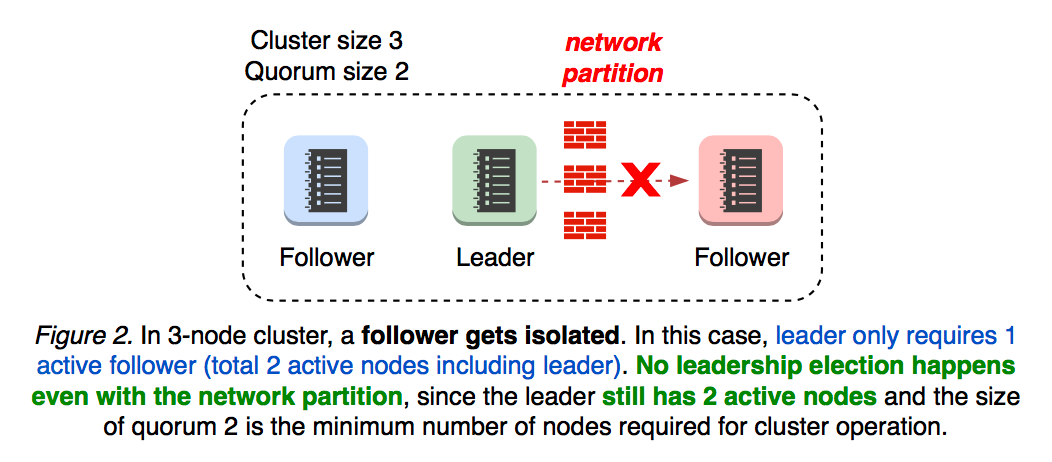
Was passiert bei einer Netzwerkpartition? Das hängt von der Partition des Leaders ab. Verfügt der Leader weiterhin über ein aktives Quorum, arbeitet der Cluster weiter (siehe Abbildung 2).
2.1 Isolation des Leaders
Was passiert, wenn der Leader vom Rest des Clusters isoliert wird? Der Leader überwacht den Fortschritt jedes Followers. Verliert er die Verbindung zum Quorum, kehrt er in die Follower-Rolle zurück. Dies beeinträchtigt die Clusterverfügbarkeit (siehe Abbildung 3).
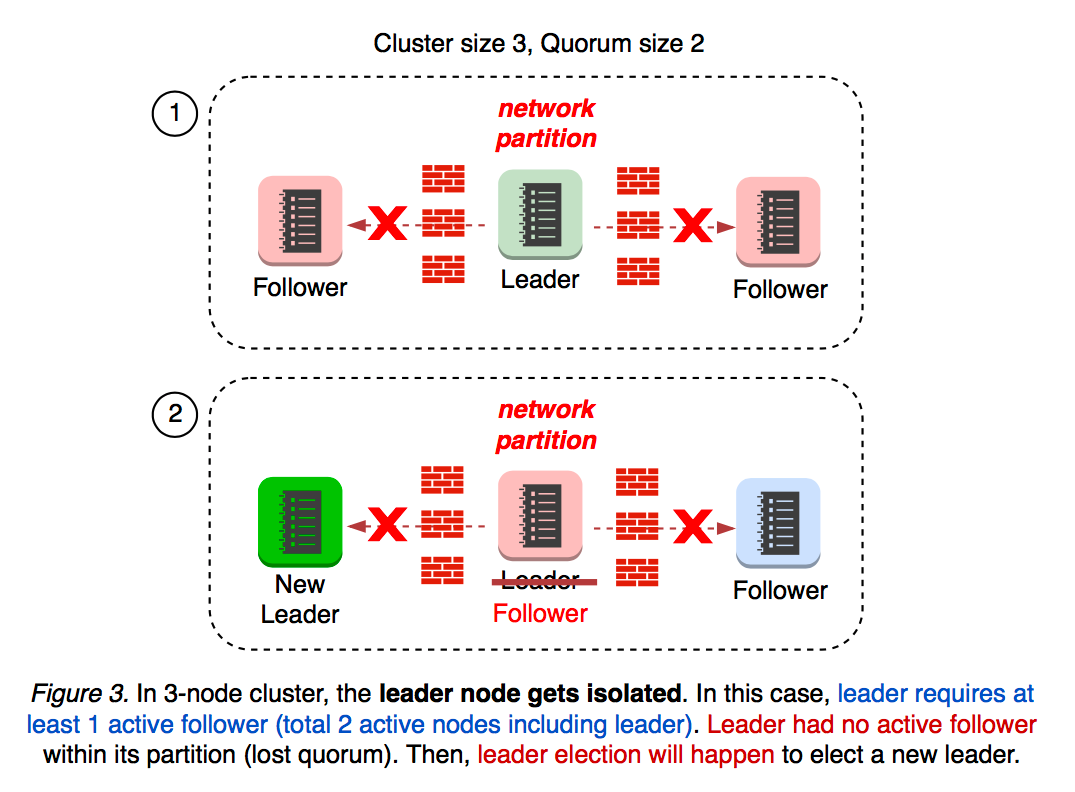
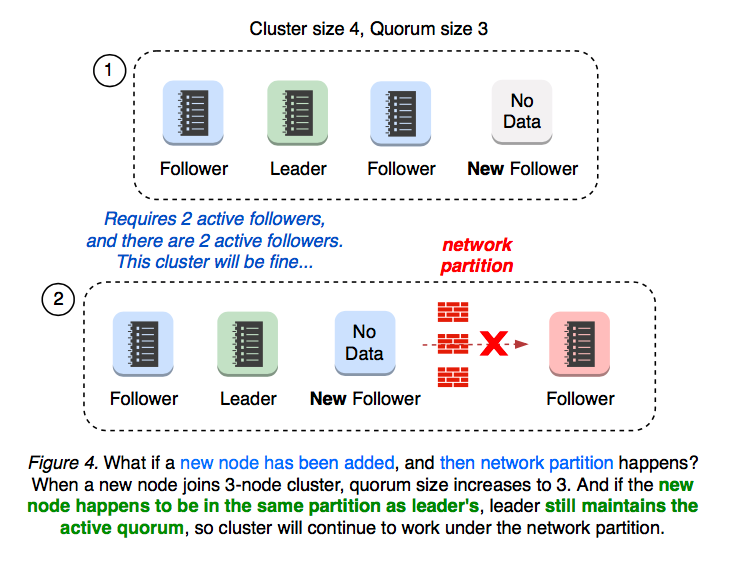
Wird einem Cluster mit 3 Knoten ein neuer Knoten hinzugefügt, steigt die Clustergröße auf 4 und die Quorumgröße auf 3. Was passiert, wenn nach dem Beitritt eines neuen Knotens eine Netzwerkpartition auftritt? Das hängt davon ab, in welcher Partition sich das neue Mitglied anschließend befindet.
2.2 Clusteraufteilung 3+1
Befindet sich der neue Knoten in derselben Partition wie der Leader, verfügt dieser weiterhin über ein aktives Quorum von 3. Es findet keine Leader-Wahl statt, und die Clusterverfügbarkeit bleibt unbeeinträchtigt (siehe Abbildung 4).
2.3 Clusteraufteilung 2+2
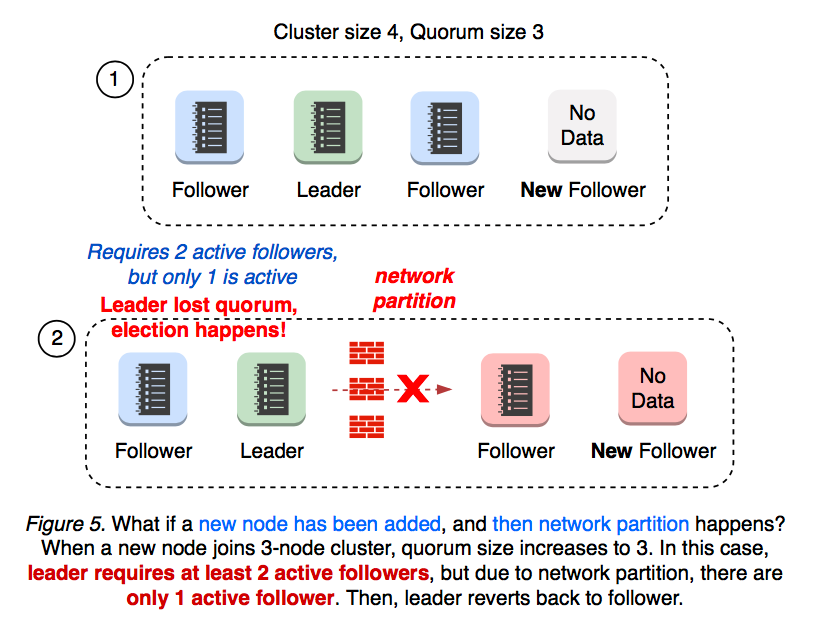
Wird der Cluster in 2 und 2 Knoten aufgeteilt, erreicht keine Partition das Quorum von 3. In diesem Fall findet eine Leader-Wahl statt (siehe Abbildung 5).
2.4 Quorum verloren
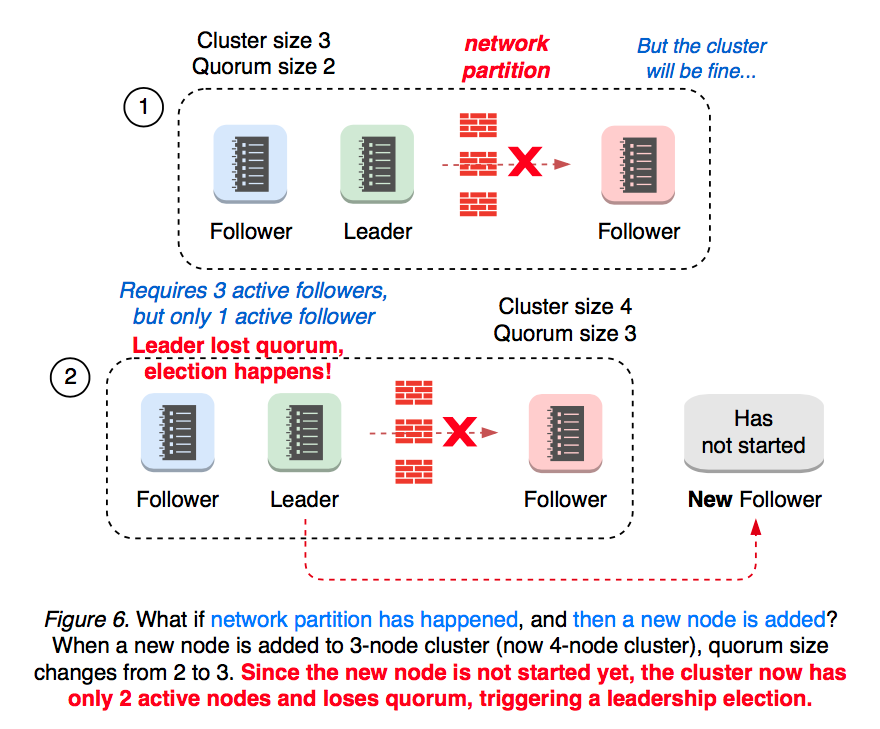
Was passiert, wenn zuerst eine Netzwerkpartition auftritt und danach ein neues Mitglied hinzugefügt wird? In einem partitionierten Cluster mit 3 Knoten ist bereits ein Follower abgetrennt. Wird ein neues Mitglied hinzugefügt, steigt das Quorum von 2 auf 3. Der Cluster hat nun nur 2 aktive von 4 Knoten, verliert dadurch sein Quorum und beginnt eine neue Leader-Wahl (siehe Abbildung 6).
Da das Hinzufügen eines Mitglieds die Quorumgröße ändern kann, wird beim Ersetzen eines nicht funktionsfähigen Knotens stets empfohlen, zuerst „member remove“ auszuführen.
Das Hinzufügen eines neuen Mitglieds zu einem Cluster mit 1 Knoten erhöht die Quorumgröße auf 2. Sobald der bisherige Leader feststellt, dass das Quorum nicht aktiv ist, löst dies unmittelbar eine Leader-Wahl aus. Der Grund: „member add“ ist ein Vorgang mit 2 Schritten, bei dem der Benutzer zuerst den Befehl „member add“ ausführen und anschließend den Prozess des neuen Knotens starten muss (siehe Abbildung 7).
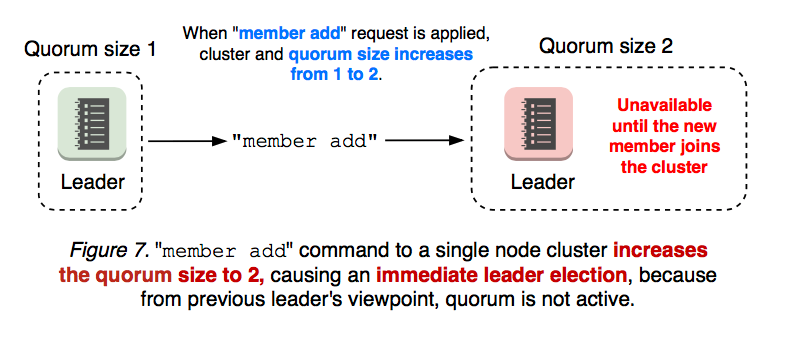
3. Fehlkonfigurationen des Clusters
Noch problematischer ist ein falsch konfiguriertes hinzugefügtes Mitglied. Die Neukonfiguration der Mitgliedschaft besteht aus zwei Schritten: „etcdctl member add“ und dem Start eines etcd-Serverprozesses mit der angegebenen Peer-URL. Der Befehl „member add“ wird also unabhängig von der URL angewendet, selbst wenn diese ungültig ist. Werden im ersten Schritt ungültige URLs verwendet, kann der zweite Schritt den neuen etcd-Prozess nicht einmal starten. Sobald der Cluster sein Quorum verliert, lässt sich die Mitgliedschaftsänderung nicht mehr rückgängig machen (siehe Abbildung 8).
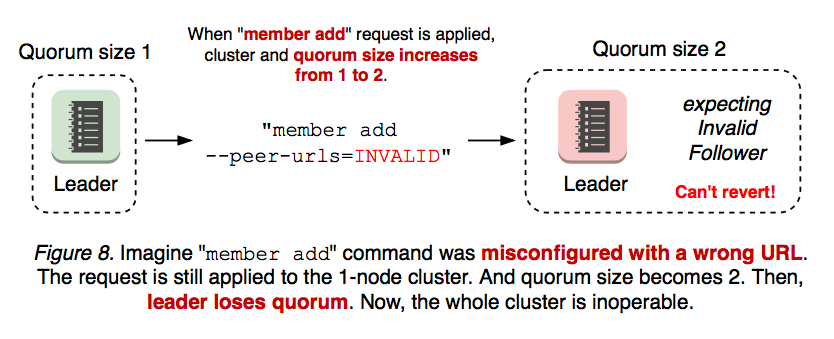
Dasselbe gilt für einen Cluster mit mehreren Knoten. Beispielsweise hat der Cluster zwei nicht verfügbare Mitglieder, eines ausgefallen und eines falsch konfiguriert, sowie zwei aktive Mitglieder. Er benötigt nun aber mindestens 3 Stimmen, um die Clustermitgliedschaft zu ändern (siehe Abbildung 9).
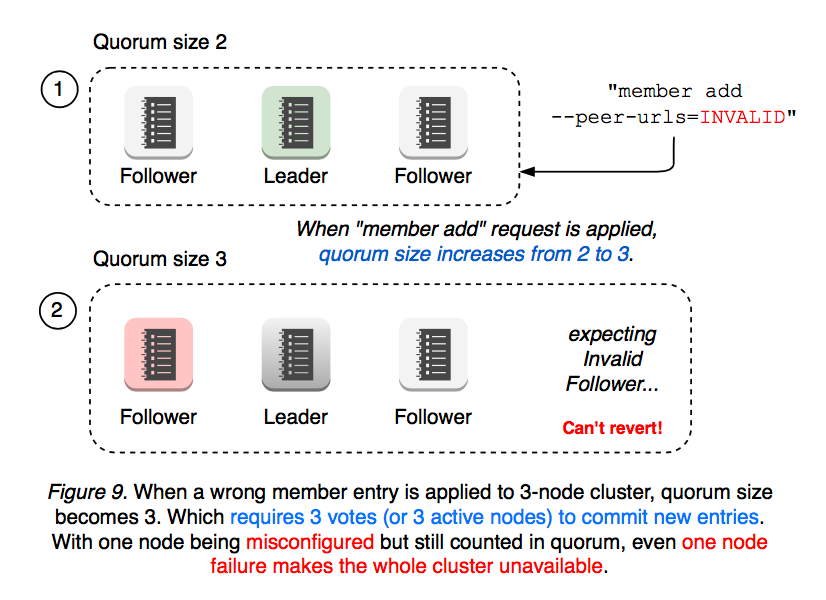
Wie gezeigt, kann eine einfache Fehlkonfiguration den gesamten Cluster funktionsunfähig machen. In diesem Fall muss ein Betreiber den Cluster manuell mit der Option etcd --force-new-cluster neu erstellen. Da etcd für Kubernetes zu einem betriebskritischen Dienst geworden ist, können selbst kürzeste Ausfälle erhebliche Auswirkungen auf Benutzer haben. Wie lassen sich solche etcd-Operationen vereinfachen? Besonders entscheidend für die Clusterverfügbarkeit ist die Leader-Wahl: Lässt sich die Neukonfiguration der Mitgliedschaft weniger störend gestalten, indem die Quorumgröße unverändert bleibt? Kann ein neuer Knoten zunächst inaktiv bleiben und nur die nötigsten Aktualisierungen vom Leader anfordern, bis er aufgeholt hat? Lassen sich Fehlkonfigurationen der Mitgliedschaft immer rückgängig machen und sicherer behandeln, sodass ein falscher Befehl zum Hinzufügen eines Mitglieds niemals den Cluster ausfallen lässt? Sollte ein Benutzer beim Hinzufügen eines Mitglieds die Netzwerktopologie berücksichtigen müssen? Kann die API zum Hinzufügen von Mitgliedern unabhängig von der Lage der Knoten und bestehenden Netzwerkpartitionen funktionieren?
Raft-Learner
Um die im vorigen Abschnitt beschriebenen Verfügbarkeitslücken zu verringern, führt Raft §4.2.1 den neuen Knotenzustand „Learner“ ein. Ein solcher Knoten tritt dem Cluster als nicht stimmberechtigtes Mitglied bei, bis er den Logstand des Leaders erreicht hat.
Funktionen in v3.4
Ein Betreiber sollte möglichst wenig Aufwand haben, um einen neuen Learner-Knoten hinzuzufügen. Der Befehl member add --learner fügt einen Learner hinzu, der als nicht stimmberechtigtes Mitglied beitritt, aber dennoch alle Daten vom Leader empfängt (siehe Abbildung 10).
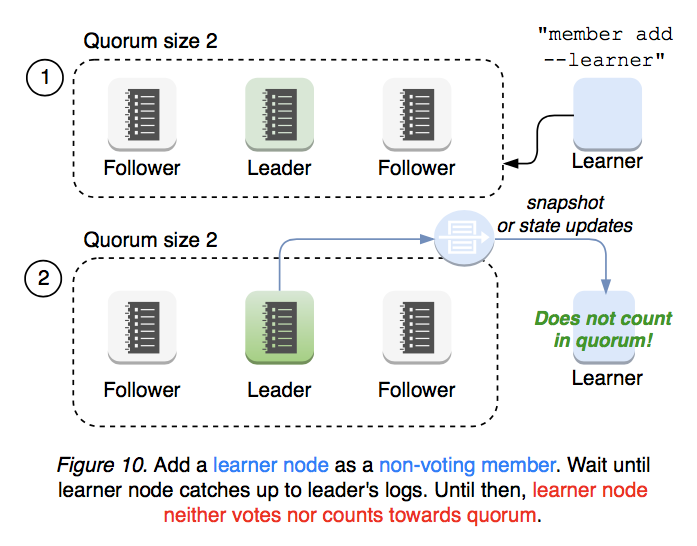
Hat ein Learner den Fortschritt des Leaders eingeholt, kann er über die API member promote zu einem stimmberechtigten Mitglied hochgestuft werden und zählt dann zum Quorum (siehe Abbildung 11).
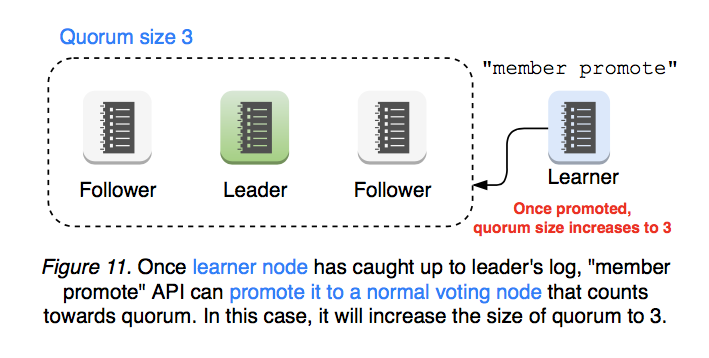
Der etcd-Server validiert die Hochstufungsanfrage, um einen sicheren Betrieb zu gewährleisten. Erst wenn sein Log den Stand des Leaders erreicht hat, kann ein Learner zu einem stimmberechtigten Mitglied hochgestuft werden (siehe Abbildung 12).
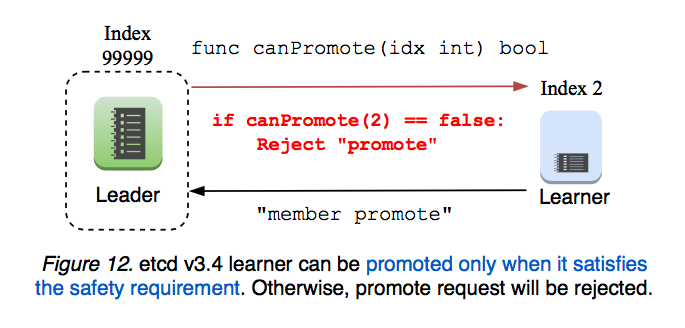
Bis zur Hochstufung dient ein Learner nur als Standby-Knoten: Die Führungsrolle kann ihm nicht übertragen werden. Ein Learner lehnt Lese- und Schreibanfragen von Clients ab; der Client-Load-Balancer sollte keine Anfragen an ihn weiterleiten. Daher muss ein Learner keine Read-Index-Anfragen an den Leader senden. Diese Einschränkung vereinfacht die erste Learner-Implementierung in v3.4 (siehe Abbildung 13).
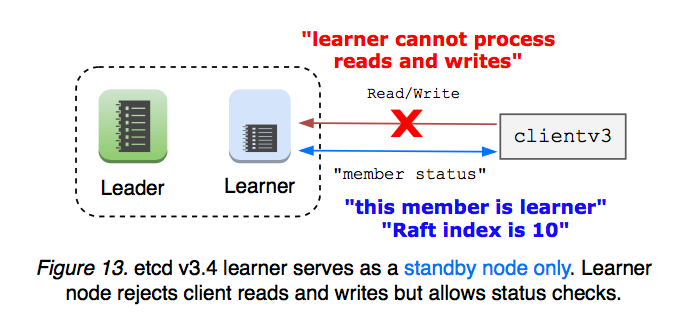
Außerdem begrenzt etcd die Gesamtzahl der Learner in einem Cluster, um eine Überlastung des Leaders durch Logreplikation zu vermeiden. Ein Learner stuft sich niemals selbst hoch. etcd liefert Statusinformationen über Learner und Sicherheitsprüfungen; die endgültige Entscheidung über eine Hochstufung muss jedoch der Clusterbetreiber treffen.
Vorgeschlagene Funktionen für künftige Versionen
Learner als einzigen Anfangszustand und Standard festlegen: Wird der Anfangszustand neuer Mitglieder auf Learner gesetzt, erhöht dies die Sicherheit der Mitgliedschaftsneukonfiguration erheblich, da Learner die Quorumgröße nicht verändern. Fehlkonfigurationen lassen sich dann immer rückgängig machen, ohne das Quorum zu verlieren.
Die Hochstufung zum stimmberechtigten Mitglied vollständig automatisieren: Sobald ein Learner den Logstand des Leaders erreicht hat, kann der Cluster ihn automatisch hochstufen. Der Benutzer legt bestimmte von etcd benötigte Schwellenwerte fest. Sind die Anforderungen erfüllt, stuft sich der Learner selbst zu einem stimmberechtigten Mitglied hoch. Aus Benutzersicht würde „member add“ wie bisher funktionieren, aber dank der Learner-Funktion mehr Sicherheit bieten.
Learner als Standby-Knoten für Failover verwenden: Ein Learner tritt als Standby-Knoten bei und wird automatisch hochgestuft, wenn die Clusterverfügbarkeit beeinträchtigt ist.
Learner nur für Lesezugriffe verwenden: Ein Learner kann als ausschließlich lesender Knoten dienen, der nie hochgestuft wird. In einem Modus mit schwacher Konsistenz empfängt er nur Daten vom Leader und verarbeitet keine Schreibvorgänge. Lokale Lesezugriffe ohne Konsensaufwand würden die Last des Leaders erheblich verringern, können aber veraltete Daten liefern. In einem Modus mit starker Konsistenz fordert der Learner einen Leseindex vom Leader an, um die neuesten Daten bereitzustellen, lehnt Schreibvorgänge aber weiterhin ab.
Learner und Mirror Maker im Vergleich
etcd implementiert „mirror maker“ mit der Watch-API, um Schlüsselerstellungen und -aktualisierungen fortlaufend an einen separaten Cluster weiterzuleiten. Nach Abschluss der anfänglichen Synchronisierung verursacht die Spiegelung gewöhnlich nur geringe zusätzliche Latenz. Learner und Spiegelung überschneiden sich darin, dass beide vorhandene Daten für reine Lesezugriffe replizieren können. Die Spiegelung garantiert jedoch keine Linearisierbarkeit. Bei Netzwerkunterbrechungen können frühere Schlüssel-Wert-Paare bereits verworfen worden sein, und von Clients wird erwartet, die Watch-Antworten auf korrekte Reihenfolge zu prüfen. Eine Spiegelung bietet daher keine Reihenfolgegarantie. Spiegelung eignet sich für minimale Latenz, etwa zwischen Rechenzentren, auf Kosten der Konsistenz. Learner eignen sich, um alle historischen Daten und deren Reihenfolge zu erhalten.
Anhang: Learner-Implementierung in v3.4
Den Knotentyp “Learner” in der API “MemberAdd” verfügbar machen.
Der etcd-Client ergänzt die API „MemberAdd“ um eine Option für Learner-Knoten. Der Server-Handler von etcd wendet einen Mitgliedschaftsänderungseintrag vom Typ pb.ConfChangeAddLearnerNode an. Nach Anwendung des Befehls tritt ein Server mit der Option etcd --initial-cluster-state=existing dem Cluster bei. Dieser Learner-Knoten ist weder stimmberechtigt noch zählt er zum Quorum.
Der etcd-Server darf die Führungsrolle keinem Learner übertragen, da dieser noch zurückliegen kann und nicht zum Quorum zählt. Der etcd-Server begrenzt die Anzahl der Learner pro Cluster auf einen: Je mehr Learner vorhanden sind, desto mehr Daten muss der Leader verteilen. Clients können mit einem Learner-Knoten kommunizieren, dieser lehnt jedoch alle Anfragen außer serialisierbaren Lesezugriffen und der API für den Mitgliedsstatus ab. Das vereinfacht die erste Implementierung. Künftig kann ein Learner zu einem ausschließlich lesenden Server erweitert werden, der Clusterdaten fortlaufend spiegelt. Der Client-Load-Balancer muss eine Hilfsfunktion bereitstellen, um den Endpunkt eines Learner-Knotens auszuschließen. Andernfalls können Anfragen an den Learner fehlschlagen. Der Client-Aufruf zur Mitgliedersynchronisierung sollte den Knotentyp Learner berücksichtigen, ebenso der Aufruf zur Aktualisierung der Client-Endpunkte.
Die Antworten von MemberList und MemberStatus sollten angeben, welcher Knoten ein Learner ist.
Die API “MemberPromote” hinzufügen.
Raft-intern stuft ein zweiter MemberAdd-Aufruf für den Learner-Knoten diesen zu einem stimmberechtigten Mitglied hoch. Der Leader verwaltet den Fortschritt jedes Followers und Learners. Hat der Learner die Verarbeitung seiner Snapshot-Nachricht noch nicht abgeschlossen, wird die Hochstufungsanfrage abgelehnt. Sie wird genau dann angenommen, wenn der Learner-Knoten funktionsfähig ist und mit dem Leader synchron ist oder die Differenz innerhalb des Schwellenwerts liegt. Beispielsweise muss die Zahl der an den Learner zu replizierenden Einträge unter 1/10 der Snapshot-Anzahl liegen; damit ist es weniger wahrscheinlich, dass der Leader selbst nach der Hochstufung einen Snapshot an den Learner senden müsste. Diese gesamte Logik ist im Paket etcdserver fest codiert und nicht konfigurierbar.
Referenzen
- Ursprüngliches GitHub-Issue: etcd#9161
- Anwendungsfall: etcd#3715
- Anwendungsfall: etcd#8888
- Anwendungsfall: etcd#10114
4 - Authentifizierungsdesign von etcd v3
Warum das Authentifizierungssystem von v2 nicht wiederverwenden?
Das v3-Protokoll verwendet gRPC als Transport anstelle einer RESTful-Schnittstelle wie in v2. Das neue Protokoll bietet die Gelegenheit, den Entwurf von v2 weiterzuentwickeln und zu verbessern. Beispielsweise authentifiziert v3 pro Verbindung, während die langsamere Authentifizierung in v2 pro Anfrage erfolgt. Zudem erschwert die Semantik der v2-Authentifizierung in der Praxis Überlegungen zur Konsistenz, wie die nächsten Abschnitte erläutern. Für v3 gibt es eine klar definierte Beschreibung und Implementierung des Authentifizierungsmechanismus, die die Schwächen des v2-Systems behebt.
Funktionale Anforderungen
- Authentifizierung pro Verbindung statt pro Anfrage
- Auf Benutzer-ID und Passwort basierende Authentifizierung für die gRPC-API
- Die Authentifizierung muss nach Änderungen der Authentifizierungsrichtlinie erneuert werden
- Die Funktionalität sollte so einfach und nützlich sein wie in v2
- v3 bietet einen flachen Schlüsselraum statt der Verzeichnisstruktur von v2. Berechtigungen werden durch Intervallabgleich geprüft.
- Sie sollte stärkere Konsistenzgarantien als die v2-Authentifizierung bieten
Wesentliche erforderliche Änderungen
- Ein Client muss vor dem Senden authentifizierter Anfragen eine eigene Verbindung ausschließlich zur Authentifizierung aufbauen
- Berechtigungsinformationen (Benutzer-ID und autorisierte Revision) zu den Raft-Befehlen (
etcdserverpb.InternalRaftRequest) hinzufügen - Die Berechtigungen jeder Anfrage werden in der Zustandsmaschinenschicht statt in der API-Schicht geprüft
Konsistenz der Berechtigungsmetadaten
Die Authentifizierungsmetadaten sollten wie andere Daten in etcd im Speicher abgelegt und verwaltet werden, den das Raft-Protokoll von etcd kontrolliert. Das ist erforderlich, um Verfügbarkeit und Konsistenz des gesamten etcd-Clusters zu erhalten. Wenn das Lesen oder Schreiben der Metadaten, etwa von Berechtigungsinformationen, die Zustimmung jedes Knotens und damit mehr als ein Quorum benötigt, kann der Ausfall eines einzelnen Knotens den gesamten Cluster anhalten. Müssen alle Knoten gleichzeitig zustimmen, lässt sich die Prüfung gewöhnlicher Lese- und Schreibanfragen nicht abschließen, sobald ein Clustermitglied ausfällt, selbst wenn noch ein Quorum verfügbar ist. Dieses Einstimmigkeitsverfahren verschlechtert letztlich die Clusterverfügbarkeit. Der auf einem Quorum basierende Raft-Konsens sollte ausreichen, da die Übereinstimmung aus einer konsistenten Reihenfolge folgt.
Der Authentifizierungsmechanismus des etcd-v2-Protokolls hat eine problematische Eigenschaft: Die Metadatenkonsistenz sollte wie oben beschrieben funktionieren, tut es aber nicht. Jede Berechtigungsprüfung wird von dem etcd-Mitglied durchgeführt, das die Client-Anfrage empfängt (server/etcdserver/api/v2http/client.go), einschließlich Follower-Mitgliedern. Die Prüfung kann daher auf veralteten Metadaten beruhen.
Aufgrund dieser möglichen Veraltung wird die Authentifizierungskonfiguration nicht zwingend wirksam, sobald Betreiber etcdctl ausführen. Es lässt sich daher nicht feststellen, wie lange veraltete Metadaten noch gelten. In der Praxis wird die Konfigurationsänderung unmittelbar nach der Befehlsausführung wirksam. Unter hoher Last kann der inkonsistente Zustand jedoch länger anhalten und für Benutzer und Entwickler unerwartete Situationen verursachen. Dafür ist eine Umgehungslösung wie diese erforderlich.
Inkonsistente Berechtigungen gefährden linearisierte Anfragen
Ein inkonsistenter Authentifizierungszustand ist bei Schreibvorgängen am schwerwiegendsten. Selbst wenn ein Betreiber einem Benutzer das Schreiben verbietet, kann ein Schreibvorgang erfolgreich abgeschlossen werden, sofern seine Reihenfolge nur gegenüber dem Schlüssel-Wert-Speicher, nicht aber gegenüber dem Authentifizierungssystem festgelegt ist. Ohne eine Reihenfolge über Authentifizierungsspeicher und Schlüssel-Wert-Speicher hinweg ist das System für Angriffe mit veralteten Berechtigungen anfällig.
Deshalb sollte die Berechtigungsprüfung in die Zustandsmaschine von etcd aufgenommen werden. Jede Zustandsmaschine sollte Anfragen in der Apply-Phase anhand ihrer Berechtigungsinformationen prüfen. Die Authentifizierungsinformationen dürfen dabei nicht veraltet sein.
Entwurf und Implementierung
Authentifizierung
Zunächst muss ein Client eine gRPC-Verbindung ausschließlich zur Authentifizierung seiner Benutzer-ID und seines Passworts aufbauen. Ein etcd-Server antwortet bei Erfolg mit einem Authentifizierungstoken, bei Fehlschlag mit einem Fehler. Der Client kann das Token verwenden, um sich bei API-Anfragen gegenüber etcd auszuweisen.
Die Client-Verbindung, über die das Authentifizierungstoken angefordert wurde, wird üblicherweise verworfen; sie kann die Anmeldedaten des neuen Tokens nicht übertragen. gRPC bietet nämlich keine Möglichkeit, nach dem Verbindungsaufbau durch grpc.Dial() Anmeldedaten pro RPC hinzuzufügen. Ein Client kann einer Verbindung daher kein Token zuweisen, das er über diese Verbindung erhalten hat. Zur Verwendung des Tokens benötigt er eine neue Verbindung.
Hinweise zur Implementierung des RPC Authenticate()
Der RPC Authenticate() erzeugt anhand eines angegebenen Benutzernamens und Passworts ein Authentifizierungstoken. etcd verwendet das Go-Paket bcrypt, um ein konfiguriertes Passwort zu speichern und ein angegebenes Passwort dagegen zu prüfen. Die Passwortprüfung von bcrypt ist absichtlich rechenaufwendig und dauert auf einem gewöhnlichen x64-Server fast 100ms. Diese Prüfung in der Apply-Phase der Zustandsmaschine würde daher Leistungsprobleme verursachen: Der gesamte etcd-Cluster könnte nur knapp 10 Authenticate()-Anfragen pro Sekunde verarbeiten.
Aus Leistungsgründen prüft der v3-Authentifizierungsmechanismus Passwörter in der API-Schicht von etcd, wo dies außerhalb von Raft parallelisiert werden kann. Dadurch können jedoch Berechtigungslücken zwischen Prüf- und Verwendungszeitpunkt entstehen (Time-of-check/Time-of-use, TOCTOU):
- Client A sendet eine Anfrage
Authenticate() - Die API-Schicht führt die Passwortprüfung von
Authenticate()aus - Ein anderer Client B sendet eine Anfrage
ChangePassword(), die der Server abschließt - Die Zustandsmaschinenschicht ermittelt die Revisionsnummer für
Authenticate()von A - Der Server meldet A Erfolg
- A ist nun mit einem veralteten Passwort authentifiziert
Um diese Situation zu vermeiden, führt die API-Schicht eine Validierung der Versionsnummer anhand der Revisionsnummer des Authentifizierungsspeichers durch. Während der Passwortprüfung speichert sie dessen Revisionsnummer. Nach erfolgreicher Prüfung vergleicht sie die gespeicherte mit der neuesten Revisionsnummer. Unterscheiden sich die Nummern, wurden die Authentifizierungsmetadaten zwischenzeitlich aktualisiert, und die Prüfung wird wiederholt. Dieser Mechanismus verhindert eine erfolgreiche Prüfung anhand eines veralteten Passworts.
Ein Token in der API-Schicht auflösen
Nach der Authentifizierung mit Authenticate() kann ein Client wie ohne Authentifizierung eine gRPC-Verbindung aufbauen. Zusätzlich zum bestehenden Initialisierungsablauf muss er das Token der neu erstellten Verbindung zuordnen. grpc.WithPerRPCCredentials() bietet die dafür erforderliche Funktion.
Jede authentifizierte Client-Anfrage enthält ein Token. Serverseitig lässt es sich mit grpc.metadata.FromIncomingContext() abrufen. Der Server kann daraus ermitteln, wer die Anfrage stellt und wann der Benutzer autorisiert wurde. Die API-Schicht trägt diese Informationen in den Header (etcdserverpb.RequestHeader.Username und etcdserverpb.RequestHeader.AuthRevision) eines Raft-Logeintrags (etcdserverpb.InternalRaftRequest) ein.
Berechtigungen in der Zustandsmaschine prüfen
Die Authentifizierungsinformationen in etcdserverpb.RequestHeader werden in der Apply-Phase der Zustandsmaschine geprüft. Dabei wird anhand der neuesten Revision des Authentifizierungsspeichers geprüft, ob der Benutzer Zugriff auf die angeforderten Schlüssel hat.
Zwei Token-Typen: simple und JWT
Es gibt zwei Token-Typen: simple und JWT. Das simple-Token ist nicht für den Produktivbetrieb vorgesehen. Diese Token sind nicht kryptografisch signiert, und die Server müssen die Zuordnung zwischen Token und Benutzern als Zustand verwalten. Sie sind für Entwicklungstests gedacht. Für produktive Bereitstellungen sollten JWT-Token verwendet werden, da sie kryptografisch signiert und geprüft werden. Aus Implementierungssicht ist JWT zustandslos. Ein JWT-Token kann Metadaten wie Benutzernamen und Revision enthalten, sodass Server die Zuordnung zwischen Token und Metadaten nicht speichern müssen.
Für simple-Token ist das Problem #18437 bekannt. Auf etcd-Servern werden Token in der API-Schicht aufgelöst, und simple-Token sind zustandsbehaftet. Der Vorgang ist nicht durch eine linearisierbare Prüfung geschützt. Daher kann ein etcd-Mitglied die vorherige Authentifizierungsanfrage noch nicht vollständig verarbeitet haben, wenn die nächste eintrifft. In diesem Fall kann es dem Client den Fehler “invalid auth token” zurückgeben. Auf einem Knoten mit guten Netzwerkbedingungen tritt dieses Problem gewöhnlich selten auf; bei hoher Latenz ist es jedoch möglich. Als Umgehungslösung können Anwendungen bei diesem Fehler einen Wiederholungsmechanismus einsetzen.
JWT-Token direkt setzen
Zusätzlich zum Standardablauf über den RPC Authenticate() unterstützt etcd das direkte Setzen von JWT-Token auf Client-Ebene. Dadurch können Anwendungen den gesamten Lebenszyklus von JWT-Token außerhalb von etcd verwalten, einschließlich Erzeugung, Validierung und Rotation.
Anwendungsfall und Ablauf
Dieser Ansatz ist sinnvoll, wenn:
- Ein separates Token-Verwaltungssystem außerhalb von etcd die Erzeugung und den Lebenszyklus der JWT-Token übernimmt
- Anwendungen bereits signierte JWT-Token über einen externen Mechanismus erhalten, etwa Umgebungsvariablen oder einen Konfigurationsdienst
- Der Token-Lebenszyklus vollständig von der Client-Anwendung statt durch die automatische Token-Erzeugung von etcd verwaltet werden muss
Der typische Ablauf ist:
- Eine externe Instanz außerhalb von etcd erzeugt ein signiertes JWT-Token, das den Benutzernamen und weitere Claims enthält
- Die Anwendung erhält das signierte Token und konfiguriert damit den etcd-Client
- Der Client sendet das JWT-Token direkt mit den Anfragen, ohne
Authenticate()aufzurufen - Der etcd-Server prüft die Token-Signatur mit seinem konfigurierten öffentlichen Schlüssel und gewährt Zugriff anhand des Benutzernamens im Token
- Vor Ablauf des Tokens ruft die Anwendung ein neues Token von der externen Instanz ab
- Die Anwendung erstellt einen neuen Client mit dem aktualisierten Token; Token-Aktualisierungen erfordern eine Neuerstellung des Clients
Unterschiede zur Standardauthentifizierung
Beim Standardablauf mit Authenticate():
- Der Client ruft
Authenticate()mit Benutzername und Passwort auf - etcd erzeugt ein Token und gibt es zurück
- Der Client verwendet dieses Token automatisch für nachfolgende Anfragen
- Zum Erneuern des Tokens muss
Authenticate()erneut aufgerufen werden
Beim direkten Setzen von JWT-Token:
- Der Client wird mit einem bereits signierten JWT-Token initialisiert
- Der Client ruft
Authenticate()nicht auf - Das Token wird direkt in allen Anfragen verwendet
- Die Client-Anwendung ist dafür verantwortlich, vor Ablauf neue Token zu beschaffen und den Lebenszyklus des Clients zu verwalten
AuthStatus ohne gültiges Token
Um Anwendungen mit eigener JWT-Token-Verwaltung zu unterstützen, ermöglicht der RPC AuthStatus Clients festzustellen, ob die Authentifizierung aktiviert ist, und die aktuelle authRevision abzurufen. Das ist für Wiederherstellungsszenarien wichtig, in denen ein Token abgelaufen ist und der Client die neueste Revision benötigt, um von seinem externen Token-Anbieter ein neues gültiges Token zu erhalten.
Ohne diese Möglichkeit könnte ein abgelaufenes Token verhindern, dass ein Client die aktuelle authRevision ermittelt. Dies könnte zu einer Blockade führen, in der kein neues Token erzeugt werden kann.
Unterschiede zwischen KVS-Modellen und Dateisystemmodellen
etcd v3 ist ein KVS und kein Dateisystem. Daher können Benutzern Berechtigungen für einen exakten Schlüsselnamen oder einen Schlüsselbereich wie ["start key", "end key") erteilt werden. Berechtigungen für nicht vorhandene Schlüssel sind somit möglich. Benutzer sollten auf unbeabsichtigt erteilte Berechtigungen achten. In dateisystemähnlichen Systemen wie Chubby oder ZooKeeper kann eine inode-ähnliche Datenstruktur die Berechtigungsinformationen enthalten. Dort können keine Berechtigungen für nicht vorhandene Schlüssel erteilt werden, abgesehen vom Fall der Sticky Bits.
Anders als dateisystemähnliche Systeme erfordert das Modell von etcd v3 mehrere Metadatenabfragen. Im ungünstigsten Fall entspricht der Suchaufwand der Summe aller Schlüssel und Intervalle, für die der Benutzer Berechtigungen hat. Dieser Aufwand lässt sich nicht vermeiden, weil sich der flache Schlüsselraum von v3 grundlegend vom Unix-Dateisystemmodell unterscheidet, bei dem jeder inode Berechtigungsmetadaten enthält. In der Praxis ist der Aufwand kein ernstes Problem, da die Metadaten klein genug sind, um vom Caching zu profitieren.
5 - etcd-API
Dieses Dokument gibt einen Überblick über den grundlegenden Entwurf der etcd-v3-APIs. Diese sind nicht mit der etcd-v2-API zu verwechseln, die seit etcd v3.5 veraltet ist. Der Überblick ist keineswegs vollständig. Er konzentriert sich auf die Grundideen, die zum Verständnis von etcd nötig sind, ohne durch seltenere API-Aufrufe abzulenken. Alle etcd-APIs sind in gRPC-Diensten definiert, die die vom etcd-Server verstandenen Remote Procedure Calls (RPCs) nach Funktionen gliedern. Eine vollständige Liste aller etcd-RPCs ist in Markdown in der gRPC-API-Übersicht dokumentiert.
gRPC-Dienste
Jede API-Anfrage an einen etcd-Server ist ein gRPC-Remote-Procedure-Call. Die RPCs von etcd werden nach ihrer Funktion in Dienste eingeteilt.
Für die Arbeit mit dem Schlüsselraum von etcd sind folgende Dienste wichtig:
- KV - Erstellt, aktualisiert, liest und löscht Schlüssel-Wert-Paare.
- Watch - Überwacht Änderungen an Schlüsseln.
- Lease - Grundoperationen zum Verarbeiten von Keepalive-Nachrichten der Clients.
Den Cluster selbst verwalten folgende Dienste:
- Auth - Rollenbasierter Authentifizierungsmechanismus zur Authentifizierung von Benutzern.
- Cluster - Liefert Mitgliedschaftsinformationen und Konfigurationsfunktionen.
- Maintenance - Erstellt Snapshots für die Wiederherstellung, defragmentiert den Speicher und liefert Statusinformationen pro Mitglied.
Anfragen und Antworten
Alle RPCs in etcd folgen demselben Format. Jeder RPC hat eine Funktion Name, die NameRequest als Argument entgegennimmt und NameResponse als Antwort zurückgibt. Beispielsweise lautet die Beschreibung des RPC Range:
Antwortheader
Alle Antworten der etcd-API enthalten einen Antwortheader mit Clustermetadaten zur Antwort:
- Cluster_ID - Die ID des Clusters, der die Antwort erzeugt.
- Member_ID - Die ID des Mitglieds, das die Antwort erzeugt.
- Revision - Die Revision des Schlüssel-Wert-Speichers beim Erzeugen der Antwort.
- Raft_Term - Der Raft-Term des Mitglieds beim Erzeugen der Antwort.
Eine Anwendung kann das Feld Cluster_ID oder Member_ID lesen, um sicherzustellen, dass sie mit dem beabsichtigten Cluster beziehungsweise Mitglied kommuniziert.
Anwendungen können über das Feld Revision die neueste Revision des Schlüssel-Wert-Speichers ermitteln. Das ist besonders nützlich, wenn sie eine historische Revision für eine Zeitreiseabfrage angeben und die zum Anfragezeitpunkt neueste Revision kennen möchten.
Mit Raft_Term können Anwendungen erkennen, wann der Cluster eine neue Leader-Wahl abgeschlossen hat.
Schlüssel-Wert-API
Die Schlüssel-Wert-API bearbeitet die in etcd gespeicherten Schlüssel-Wert-Paare. Der Großteil der Anfragen an etcd sind üblicherweise Schlüssel-Wert-Anfragen.
Grundoperationen des Systems
Schlüssel-Wert-Paar
Ein Schlüssel-Wert-Paar ist die kleinste Einheit, die die Schlüssel-Wert-API bearbeiten kann. Jedes Paar hat mehrere Felder, die im Protobuf-Format definiert sind:
- Key - Schlüssel als Bytes. Ein leerer Schlüssel ist nicht zulässig.
- Value - Wert als Bytes.
- Version - Version ist die Version des Schlüssels. Eine Löschung setzt sie auf null zurück, und jede Änderung des Schlüssels erhöht sie.
- Create_Revision - Revision der letzten Erstellung des Schlüssels.
- Mod_Revision - Revision der letzten Änderung des Schlüssels.
- Lease - Die ID der dem Schlüssel zugeordneten Lease. Ist lease 0, ist dem Schlüssel keine Lease zugeordnet.
Zusätzlich zu Schlüssel und Wert fügt etcd der Schlüsselnachricht Revisionsmetadaten hinzu. Diese Informationen ordnen Schlüssel nach Erstellungs- und Änderungszeitpunkt, was für die Nebenläufigkeitskontrolle bei verteilter Synchronisierung nützlich ist. Die verteilten gemeinsamen Sperren des etcd-Clients verwenden die Erstellungsrevision, um auf den Besitz einer Sperre zu warten. Entsprechend dient die Änderungsrevision dazu, Konflikte in der Lesemenge von Software Transactional Memory zu erkennen und auf Aktualisierungen bei der Leader-Wahl zu warten.
Revisionen
etcd verwaltet einen clusterweiten 64-Bit-Zähler, die Speicherrevision, der bei jeder Änderung des Schlüsselraums erhöht wird. Die Revision dient als globale logische Uhr und ordnet alle Speicheraktualisierungen sequenziell. Die durch eine neue Revision repräsentierte Änderung ist inkrementell: Einer Revision sind die Daten zugeordnet, die den Speicher geändert haben. Intern bedeutet eine neue Revision, die Änderungen mit der erhöhten Revision als Schlüssel in den B+-Baum des Backends zu schreiben.
Besonders nützlich sind Revisionen im Backend mit Mehrversions-Nebenläufigkeitskontrolle von etcd. Das MVCC-Modell erlaubt eine Sicht auf den Schlüssel-Wert-Speicher aus früheren Revisionen, da historische Schlüsselrevisionen erhalten bleiben. Clusteradministratoren können die Aufbewahrungsrichtlinie für diesen Verlauf zur gezielten Speicherverwaltung konfigurieren. Üblicherweise verwirft etcd alte Schlüsselrevisionen zeitgesteuert. Ein typischer etcd-Cluster bewahrt ersetzte Schlüsseldaten mehrere Stunden auf. Das ermöglicht auch die zuverlässige Behandlung langer Client-Verbindungsunterbrechungen statt nur kurzer Netzwerkausfälle: Watcher setzen einfach ab der letzten beobachteten historischen Revision fort. Ebenso können Leseanfragen mit einer Revision versehen werden, um Schlüssel aus der Sicht des Schlüsselraums zu dem Zeitpunkt zurückzugeben, an dem diese Revision bestätigt wurde.
Schlüsselbereiche
Das Datenmodell von etcd indiziert alle Schlüssel in einem flachen binären Schlüsselraum. Es unterscheidet sich damit von anderen Schlüssel-Wert-Speichern, die Schlüssel hierarchisch in Verzeichnissen organisieren. Schlüssel werden über Schlüsselintervalle [a, b) statt nach Verzeichnissen aufgelistet.
Diese Intervalle werden in etcd häufig als Bereiche bezeichnet. Bereichsoperationen sind leistungsfähiger als Verzeichnisoperationen. Wie ein hierarchischer Speicher unterstützen Intervalle einzelne Schlüsselabfragen über [a, a+1), etwa [‘a’, ‘a\x00’) zum Abrufen von ‘a’, und Verzeichnisabfragen durch Kodierung der Schlüssel nach Verzeichnistiefe. Darüber hinaus können Intervalle auch Präfixe abbilden: Das Intervall ['a', 'b') ruft beispielsweise alle Schlüssel mit dem Präfix ‘a’ ab.
Vereinbarungsgemäß werden Bereiche einer Anfrage durch die Felder key und range_end angegeben. Das Feld key ist der erste Schlüssel des Bereichs und sollte nicht leer sein. range_end ist der Schlüssel nach dem letzten Schlüssel des Bereichs. Ist range_end nicht angegeben oder leer, enthält der Bereich nur das Argument key. Ist range_end gleich key plus eins, etwa “aa”+1 == “ab” oder “a\xff”+1 == “b”, umfasst der Bereich alle Schlüssel mit dem Präfix key. Sind key und range_end beide ‘\0’, umfasst der Bereich alle Schlüssel. Ist range_end ‘\0’, umfasst der Bereich alle Schlüssel größer oder gleich dem Argument key.
Range
Schlüssel werden mit dem API-Aufruf Range aus dem Schlüssel-Wert-Speicher abgerufen. Er nimmt eine RangeRequest entgegen:
- Key, Range_End - Der abzurufende Schlüsselbereich.
- Limit - Die maximale Anzahl der für die Anfrage zurückgegebenen Schlüssel. Der Wert 0 bedeutet keine Begrenzung.
- Revision - Der für den Bereich zu verwendende Zeitpunkt im Schlüssel-Wert-Speicher. Ist revision kleiner oder gleich null, bezieht sich der Bereich auf den neuesten Stand. Wurde die Revision kompaktiert, wird ErrCompacted zurückgegeben.
- Sort_Order - Die Reihenfolge für sortierte Anfragen.
- Sort_Target - Das Schlüssel-Wert-Feld, nach dem sortiert wird.
- Serializable - Legt fest, dass die Bereichsanfrage serialisierbare, auf das Mitglied beschränkte Lesezugriffe verwendet. Standardmäßig ist Range linearisierbar und spiegelt den aktuellen Konsens des Clusters wider. Für bessere Leistung und Verfügbarkeit auf Kosten möglicherweise veralteter Leseergebnisse wird eine serialisierbare Bereichsanfrage lokal bearbeitet, ohne einen Konsens mit anderen Clusterknoten herstellen zu müssen.
- Keys_Only - Gibt nur die Schlüssel, nicht die Werte zurück.
- Count_Only - Gibt nur die Anzahl der Schlüssel im Bereich zurück.
- Min_Mod_Revision - Die Untergrenze für Änderungsrevisionen von Schlüsseln; kleinere Änderungsrevisionen werden herausgefiltert.
- Max_Mod_Revision - Die Obergrenze für Änderungsrevisionen von Schlüsseln; größere Änderungsrevisionen werden herausgefiltert.
- Min_Create_Revision - Die Untergrenze für Erstellungsrevisionen von Schlüsseln; kleinere Erstellungsrevisionen werden herausgefiltert.
- Max_Create_Revision - Die Obergrenze für Erstellungsrevisionen von Schlüsseln; größere Erstellungsrevisionen werden herausgefiltert.
Der Client erhält vom Aufruf Range eine Nachricht RangeResponse:
- Kvs - Die Liste der Schlüssel-Wert-Paare, die der Bereichsanfrage entsprechen. Wenn
Count_Onlygesetzt ist, istKvsleer. - More - Gibt bei gesetztem
limitan, ob im angeforderten Bereich weitere Schlüssel zurückzugeben sind. - Count - Die Gesamtzahl der Schlüssel, die die Bereichsanfrage erfüllen.
Für große Schlüsselbereiche, deren vollständige Antwort nicht zwischengespeichert werden soll, siehe RangeStream .
RangeStream
RangeStream liefert dieselbe Ergebnismenge wie Range, der Server teilt die Antwort jedoch in eine Folge von Blöcken auf und überträgt sie als Stream an den Client. So muss keine Seite große Bereiche vollständig im Arbeitsspeicher zwischenspeichern. RangeStream akzeptiert dieselbe RangeRequest wie Range.
Der Client erhält vom Aufruf RangeStream einen Stream von RangeStreamResponse-Nachrichten:
Belegung der Felder über die Blöcke hinweg:
- Kvs - Jeder Block enthält einen disjunkten Teil des Ergebnisses. Werden die
kvsaller Blöcke in ihrer Empfangsreihenfolge aneinandergehängt, ergibt sich dieselbe Schlüsselmenge wie bei einem einzelnenRange-Aufruf. - Header, More, Count - Werden nur im letzten Block gesetzt, und nur wenn der Stream ohne Fehler endet. In früheren Blöcken behalten diese Felder ihre Nullwerte. Wird
proto.Mergeauf dierange_responsejedes Blocks angewendet, entsteht eineRangeResponse, die der Antwort vonRangeentspricht.
Endet der Stream mit einem Fehler, enthält kein Block einen gültigen Wert für header, more oder count.
Alle Blöcke des Streams werden anhand derselben Revision bereitgestellt. Ist Revision in der Anfrage nicht gesetzt, erfasst der Server beim Start des Streams die neueste bestätigte Revision und verwendet sie für den restlichen Stream weiter.
RangeStream unterstützt weder benutzerdefinierte Sortierreihenfolgen noch Revisionsfilter (min_mod_revision, max_mod_revision, min_create_revision, max_create_revision). Anfragen, die eines davon verwenden, liefern Unimplemented. Auch der gRPC-Proxy von etcd unterstützt RangeStream nicht.
Es gibt zwei übliche Arten, einen RangeStream zu verarbeiten:
- Jeden Block unabhängig verarbeiten. Geeignet für Szenarien mit hohen Leistungsanforderungen, in denen der Client Schlüssel beim Eintreffen dekodieren und verarbeiten möchte, statt zuerst das gesamte Ergebnis zu sammeln. Der Client durchläuft die Blöcke und verarbeitet die jeweiligen
kvs. Nachdem der Stream fehlerfrei beendet wurde, liest erheader,moreodercountaus dem letzten Block. - Eine einzelne Antwort zusammensetzen. Geeignet, wenn der Client ein Ergebnis wie bei einem unären
Range-Aufruf benötigt. Er führt dierange_responsejedes Blocks zu einerRangeResponsezusammen, etwa mitproto.Merge. Das Ergebnis enthält die vollständigenkvssowieheader,moreundcountaus dem letzten Block. Der Go-Client bietet dafür die Hilfsfunktionclientv3.GetStreamToGetResponse.
Put
Schlüssel werden mit dem Aufruf Put im Schlüssel-Wert-Speicher gespeichert. Er nimmt eine PutRequest entgegen:
- Key - Der Name des Schlüssels, der in den Schlüssel-Wert-Speicher geschrieben werden soll.
- Value - Der Wert als Bytes, der dem Schlüssel im Schlüssel-Wert-Speicher zugeordnet werden soll.
- Lease - Die Lease-ID, die dem Schlüssel im Schlüssel-Wert-Speicher zugeordnet werden soll. Der Lease-Wert 0 bedeutet keine Lease.
- Prev_Kv - Wenn gesetzt, enthält die Antwort die Daten des Schlüssel-Wert-Paars vor der Aktualisierung durch diese
Put-Anfrage. - Ignore_Value - Wenn gesetzt, wird der Schlüssel aktualisiert, ohne seinen aktuellen Wert zu ändern. Existiert der Schlüssel nicht, wird ein Fehler zurückgegeben.
- Ignore_Lease - Wenn gesetzt, wird der Schlüssel aktualisiert, ohne seine aktuelle Lease zu ändern. Existiert der Schlüssel nicht, wird ein Fehler zurückgegeben.
Der Client erhält vom Aufruf Put eine Nachricht PutResponse:
- Prev_Kv - Das durch
Putüberschriebene Schlüssel-Wert-Paar, wennPrev_Kvin derPutRequestgesetzt war.
Schlüsselbereich löschen
Schlüsselbereiche werden mit dem Aufruf DeleteRange gelöscht. Er nimmt eine DeleteRangeRequest entgegen:
- Key, Range_End - Der zu löschende Schlüsselbereich.
- Prev_Kv - Wenn gesetzt, wird der Inhalt der gelöschten Schlüssel-Wert-Paare zurückgegeben.
Der Client erhält vom Aufruf DeleteRange eine Nachricht DeleteRangeResponse:
- Deleted - Anzahl der gelöschten Schlüssel.
- Prev_Kv - Eine Liste aller durch die Operation
DeleteRangegelöschten Schlüssel-Wert-Paare.
Transaktion
Eine Transaktion ist ein atomares If/Then/Else-Konstrukt über dem Schlüssel-Wert-Speicher. Sie bietet eine Grundoperation, die Anfragen zu atomaren Blöcken, also then/else, zusammenfasst und deren Ausführung anhand des Speicherinhalts bedingt, also if. Transaktionen können Schlüssel vor unbeabsichtigten gleichzeitigen Aktualisierungen schützen, Compare-and-swap-Operationen bilden und als Grundlage einer übergeordneten Nebenläufigkeitskontrolle dienen.
Eine Transaktion kann mehrere Anfragen atomar in einer einzigen Anfrage verarbeiten. Bei Änderungen des Schlüssel-Wert-Speichers bedeutet dies, dass die Speicherrevision für die Transaktion nur einmal erhöht wird und alle erzeugten Ereignisse dieselbe Revision haben. Derselbe Schlüssel darf innerhalb einer einzelnen Transaktion jedoch nicht mehrfach geändert werden.
Alle Transaktionen werden durch eine Konjunktion von Vergleichen abgesichert, ähnlich einer If-Anweisung. Jeder Vergleich prüft einen einzelnen Schlüssel im Speicher. Er kann prüfen, ob ein Wert fehlt oder vorhanden ist, ihn mit einem angegebenen Wert vergleichen oder die Revision beziehungsweise Version eines Schlüssels prüfen. Zwei verschiedene Vergleiche können denselben oder unterschiedliche Schlüssel betreffen. Alle Vergleiche werden atomar angewendet. Sind alle wahr, gilt die Transaktion als erfolgreich, und etcd wendet ihren then- beziehungsweise success-Anfrageblock an. Andernfalls gilt sie als fehlgeschlagen, und der else- beziehungsweise failure-Anfrageblock wird angewendet.
Jeder Vergleich wird als Nachricht Compare kodiert:
- Result - Die Art der logischen Vergleichsoperation, etwa gleich oder kleiner als.
- Target - Das zu vergleichende Schlüssel-Wert-Feld: Version, Erstellungsrevision, Änderungsrevision oder Wert des Schlüssels.
- Key - Der Schlüssel für den Vergleich.
- Target_Union - Die vom Benutzer angegebenen Daten für den Vergleich.
Nach dem Verarbeiten des Vergleichsblocks wendet die Transaktion einen Anfrageblock an. Ein Block ist eine Liste von RequestOp-Nachrichten:
- Request_Range - Eine
RangeRequest. - Request_Put - Eine
PutRequest. Die Schlüssel müssen eindeutig sein. Sie darf keine Schlüssel mit anderen Put- oder Delete-Anfragen gemeinsam haben. - Request_Delete_Range - Eine
DeleteRangeRequest. Sie darf keine Schlüssel mit Put- oder Delete-Anfragen gemeinsam haben.
Zusammengesetzt wird eine Transaktion mit dem API-Aufruf Txn ausgeführt, der eine TxnRequest entgegennimmt:
- Compare - Eine Liste von Prädikaten, die eine Konjunktion von Bedingungen zur Absicherung der Transaktion repräsentiert.
- Success - Eine Liste von Anfragen, die verarbeitet werden, wenn alle Vergleiche true ergeben.
- Failure - Eine Liste von Anfragen, die verarbeitet werden, wenn ein Vergleich false ergibt.
Der Client erhält vom Aufruf Txn eine Nachricht TxnResponse:
- Succeeded - Gibt an, ob
Comparetrue oder false ergab. - Responses - Eine Liste von Antworten auf die Ergebnisse der Anwendung des Blocks
Success, wenn succeeded true ist, beziehungsweiseFailure, wenn succeeded false ist.
Die Liste Responses entspricht den Ergebnissen der angewendeten Liste RequestOp. Jede Antwort ist als ResponseOp kodiert:
Der in jeder inneren Antwort enthaltene ResponseHeader sollte in keiner Weise ausgewertet werden.
Wenn Clients die neueste Revision benötigen, sollten sie immer den obersten ResponseHeader in TxnResponse prüfen.
Watch-API
Die API Watch bietet eine ereignisbasierte Schnittstelle zur asynchronen Überwachung von Schlüsseländerungen. Ein etcd-Watch wartet auf Änderungen, indem er ab einer angegebenen aktuellen oder historischen Revision fortlaufend beobachtet und Schlüsselaktualisierungen an den Client zurückstreamt.
Ereignisse
Jede Änderung an jedem Schlüssel wird durch Event-Nachrichten dargestellt. Eine Event-Nachricht enthält sowohl die Daten als auch die Art der Aktualisierung:
- Type - Die Art des Ereignisses. PUT zeigt an, dass neue Daten unter dem Schlüssel gespeichert wurden. DELETE zeigt an, dass der Schlüssel gelöscht wurde.
- KV - Der dem Ereignis zugeordnete KeyValue. Ein PUT-Ereignis enthält das aktuelle kv-Paar. Ein PUT-Ereignis mit kv.Version=1 zeigt die Erstellung eines Schlüssels an. Ein DELETE-Ereignis enthält den gelöschten Schlüssel, dessen Änderungsrevision auf die Revision der Löschung gesetzt ist.
- Prev_KV - Das Schlüssel-Wert-Paar aus der Revision unmittelbar vor dem Ereignis. Um Bandbreite zu sparen, wird es nur gesetzt, wenn der Watch dies ausdrücklich aktiviert hat.
Watch-Streams
Watches sind lang laufende Anfragen und übertragen Ereignisdaten über gRPC-Streams. Ein Watch-Stream ist bidirektional: Der Client schreibt in den Stream, um Watches einzurichten, und liest daraus, um Watch-Ereignisse zu empfangen. Ein einzelner Stream kann viele verschiedene Watches multiplexen, indem er Ereignisse mit einer Kennung pro Watch versieht. Dieses Multiplexing verringert den Speicherbedarf und den Verbindungsaufwand im eigentlichen etcd-Cluster.
Garantien für Watch-Ereignisse sind unter Garantien der etcd-API beschrieben.
Ein Client erstellt einen Watch, indem er eine WatchCreateRequest über einen von Watch zurückgegebenen Stream sendet:
- Key, Range_End - Der zu beobachtende Schlüsselbereich.
- Start_Revision - Eine optionale Revision, ab der einschließlich beobachtet wird. Ist sie nicht angegeben, werden Ereignisse nach der Revision im Antwortheader der Watch-Erstellung gestreamt. Der gesamte verfügbare Ereignisverlauf kann ab der letzten Kompaktierungsrevision beobachtet werden.
- Progress_Notify - Wenn gesetzt und keine aktuellen Ereignisse vorliegen, erhält der Watch regelmäßig eine WatchResponse ohne Ereignisse. Das ist nützlich, wenn Clients einen unterbrochenen Watcher ab einer kürzlich bekannt gewordenen Revision wiederherstellen möchten. Der etcd-Server entscheidet anhand der aktuellen Serverlast, wie häufig er Benachrichtigungen sendet.
- Filters - Eine Liste von Ereignistypen, die serverseitig herausgefiltert werden sollen.
- Prev_Kv - Wenn gesetzt, erhält der Watch die Schlüssel-Wert-Daten vor dem Ereignis. So lässt sich erkennen, welche Daten überschrieben wurden.
Als Antwort auf eine WatchCreateRequest oder bei einem neuen Ereignis für einen eingerichteten Watch erhält der Client eine WatchResponse:
- Watch_ID - Die ID des Watches, zu dem die Antwort gehört.
- Created - Wird auf true gesetzt, wenn die Antwort zu einer Anfrage zum Erstellen eines Watches gehört. Der Client sollte die ID speichern und die Ereignisse für den Watch im Stream erwarten. Alle an den erstellten Watcher gesendeten Ereignisse haben dieselbe watch_id.
- Canceled - Wird auf true gesetzt, wenn die Antwort zu einer Anfrage zum Abbrechen eines Watches gehört. An den abgebrochenen Watcher werden keine weiteren Ereignisse gesendet.
- Compact_Revision - Wird auf die kleinste in etcd verfügbare historische Revision gesetzt, wenn ein Watcher versucht, eine kompaktierte Revision zu beobachten. Dies geschieht beim Erstellen eines Watchers an einer kompaktierten Revision oder wenn er den Fortschritt des Schlüssel-Wert-Speichers nicht einholen kann. Der Watcher wird abgebrochen; das Erstellen neuer Watches mit derselben start_revision schlägt fehl.
- Events - Eine geordnete Liste neuer Ereignisse für die angegebene Watch-ID.
Wenn der Client keine weiteren Ereignisse für einen Watch empfangen möchte, sendet er eine WatchCancelRequest:
- Watch_ID - Die ID des abzubrechenden Watches, damit keine weiteren Ereignisse übertragen werden.
Lease-API
Leases sind ein Mechanismus zur Erkennung, ob Clients noch aktiv sind. Der Cluster gewährt Leases mit einer Lebensdauer. Eine Lease läuft ab, wenn der etcd-Cluster innerhalb eines angegebenen TTL-Zeitraums kein keepAlive empfängt.
Um Leases mit dem Schlüssel-Wert-Speicher zu verknüpfen, kann jeder Schlüssel höchstens einer Lease zugeordnet werden. Läuft eine Lease ab oder wird sie widerrufen, werden alle ihr zugeordneten Schlüssel gelöscht. Jeder abgelaufene Schlüssel erzeugt ein Löschereignis im Ereignisverlauf.
Leases erhalten
Leases werden mit dem API-Aufruf LeaseGrant angefordert. Er nimmt eine LeaseGrantRequest entgegen:
- TTL - Die als Richtwert angegebene Lebensdauer in Sekunden.
- ID - Die angeforderte ID der Lease. Ist ID auf 0 gesetzt, wählt etcd eine ID aus.
Der Client erhält vom Aufruf LeaseGrant eine LeaseGrantResponse:
- ID - Die Lease-ID der gewährten Lease.
- TTL - Die vom Server gewählte Lebensdauer der Lease in Sekunden.
- ID - Die Lease-ID der zu widerrufenden Lease. Beim Widerruf werden alle zugeordneten Schlüssel gelöscht.
Keepalives
Leases werden über einen bidirektionalen Stream erneuert, der mit dem API-Aufruf LeaseKeepAlive erstellt wird. Möchte der Client eine Lease erneuern, sendet er eine LeaseKeepAliveRequest über den Stream:
- ID - Die Lease-ID der am Leben zu haltenden Lease.
Der Keepalive-Stream antwortet mit einer LeaseKeepAliveResponse:
- ID - Die Lease, die mit einer neuen TTL erneuert wurde.
- TTL - Die neue verbleibende Lebensdauer der Lease in Sekunden.
6 - Dateien der persistenten Speicherung in etcd
Dieses Dokument erläutert das Format der persistenten Speicherung in etcd: Benennung, Inhalt und Werkzeuge, mit denen Entwickler die Dateien untersuchen können. Künftig sollte es um Änderungen am Speichermodell erweitert werden. Es richtet sich an etcd-Entwickler und soll sie bei der Datenwiederherstellung unterstützen.
Voraussetzungen
Die folgenden Artikel liefern hilfreiche Hintergrundinformationen zu diesem Dokument:
- Überblick über das Datenmodell von etcd
- Überblick über Raft , insbesondere Abschnitt „5.3 Logreplikation“.
Überblick
Langlebige Dateien
| Dateiname | Zweck |
|---|---|
./member/snap/db |
bbolt B+-Baum, der alle angewendeten Daten, Informationen zur Mitgliedschaft und Autorisierung sowie Metadaten speichert. Er kennt den zuletzt angewendeten WAL-Index ("consistent_index"). |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap |
Regelmäßige Snapshots des alten v2-Speichers, mit:
Seit etcd v3 ist dieser Inhalt gegenüber den /snap/db-Dateien redundant. Regelmäßig (30s) werden diese Dateien bereinigt, wobei die letzten |
/member/snap/000000000007a178.snap.db |
Ein vollständiger heruntergeladener bbolt-Snapshot vom etcd-Leader, falls das Replikat zu weit zurücklag. Enthält dieselbe Art von Daten wie die Datei ( Die Datei wird in 2 Fällen verwendet:
Die Datei wird nach Abschluss der Wiederherstellung nicht gelöscht (der gesamte Inhalt wurde dann in ./member/snap/db übernommen). Regelmäßig (30s) werden die Dateien bereinigt.
Auch hier bleiben |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal |
Write-Ahead-Logs von Raft, mit aktuellen von Raft akzeptierten Transaktionen, regelmäßigen Snapshots oder CRC-Einträgen. Die neuesten Bei zu seltenen Snapshots können mehr als |
./member/wal/0.tmp (or .../1.tmp) |
Vorab zugewiesener Speicherplatz für die nächste Write-Ahead-Log-Datei. Verhindert, dass Raft wegen fehlender WAL-Kapazität blockiert, ohne einen Alarm auslösen zu können. |
Temporäre Dateien
Während der internen Verarbeitung von etcd können mehrere kurzlebige Dateien auftreten:
| Datei | Zweck |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken |
Snapshot-Dateien werden in „broken“ umbenannt, wenn sie nicht geladen werden können.
Der Versuch, die neueste Datei zu laden, erfolgt, wenn etcd gestartet wird. Oder während der backup/migrate-Befehle von etcdctl. |
./member/snap/tmp071677638 (random suffix) |
Temporäre bbolt-Datei, die auf Replikaten als Antwort auf die msgSnap-Anfrage des Leaders erstellt wird, also auf dessen Aufforderung, den Speicher aus dem angegebenen Snapshot wiederherzustellen.
Nach erfolgreichem vollständigem Abruf des Inhalts wird die Datei umbenannt in: Siehe etcd/issues/12837. In etcd 3.5 behoben. |
/member/snap/db.tmp.071677638 (random suffix) |
Eine temporäre Datei, die während der Defragmentierung eine Kopie des Backend-Inhalts (/member/snap/db) enthält. Nach erfolgreichem Abschluss wird sie in /member/snap/db umbenannt und ersetzt das ursprüngliche Backend. Beim Start des etcd-Servers werden diese Dateien bereinigt. |
bbolt-B+-Baum: member/snap/db
Diese Datei enthält die Hauptdaten von etcd, angewendet bis zu einer bestimmten Position im Raft-Log (siehe consistent_index ).
Physischer Aufbau
Der Speicher von „better bolt“ ist physisch als B+-Baum
organisiert. Die physischen Seiten des B-Baums werden niemals an Ort und Stelle geändert1. Stattdessen wird ihr Inhalt auf eine neue Seite kopiert, die aus der Liste freier Seiten stammt. Die alte Seite wird dieser Liste hinzugefügt, sobald keine offene Transaktion mehr auf sie zugreifen könnte. Dadurch sieht eine offene RO-Transaktion einen konsistenten historischen Speicherzustand. Die RW-Transaktion ist exklusiv und blockiert alle anderen RW-Transaktionen.
Große Werte werden auf mehreren zusammenhängenden Seiten gespeichert. Die Wiederverwendung von Seiten zusammen mit der nötigen Zuweisung zusammenhängender Seitenbereiche unterschiedlicher Größe kann zu einer zunehmenden Fragmentierung des bbolt-Speichers führen.
Die bbolt-Datei schrumpft niemals von selbst. Nur bei der Defragmentierung kann sie in eine neue Datei mit einem Puffer freier Seiten am Ende und verkleinerter Dateigröße umgeschrieben werden.
Logischer Aufbau
Der bbolt-Speicher ist in Buckets unterteilt. In jedem Bucket werden Schlüssel (Paare vom Typ byte[]->value byte[]) in lexikografischer Reihenfolge gespeichert. Die folgende Liste zeigt die von etcd verwendeten Buckets mit Stand Version 3.5 und ihre Schlüssel.
| Bucket | Schlüssel | Beispielwert | Beschreibung |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT}
|
nil |
Zeigt an, dass bei einem Mitglied Probleme erkannt wurden. |
| auth | "authRevision" | "" (leer) oder BigEndian.PutUint64 |
Jede Änderung an Rollen oder Benutzern erhöht dieses Feld beim Bestätigen der Transaktion. Der Wert dient ausschließlich zur optimistischen Sperrung während des Autorisierungsvorgangs. |
| authRoles | [roleName] als Zeichenfolge | authpb.Role serialisiert |
|
| authUsers | [userName] als Zeichenfolge | authpb.User serialisiert |
|
| cluster | "clusterVersion" | "3.5.0" (string) |
Minor-Version der durch Konsens vereinbarten gemeinsamen Speicherversion. |
| "downgrade" | JSON: {
"target-version": "3.4.0"
"enabled": true/false
}
|
Speichert die Absicht dauerhaft, die durch die neueste Anfrage Seit v3.5 |
|
| key |
[revisionId], kodiert mit bytesToRev{main,sub} Löschungen von Schlüssel-Wert-Paaren werden mit einem abschließenden 't' als „Tombstone“ serialisiert |
mvccpb.KeyValue als serialisiertes Proto (key, create_rev, mod_rev, version, value, lease id) |
|
| lease | leasepb.Lease als serialisiertes Proto (ID, TTL, RemainingTTL) |
Hinweis: LeaseCheckpoint verlängert nur RemainingTTL. TTL stammt weiterhin vom ursprünglichen Grant. Hinweis2: TTLs werden in Sekunden ab einem nicht definierten „jetzt“ gespeichert. Ein ständig abstürzender und neu startender Server gibt keine Leases frei!!! |
|
| members | [memberId] hexadezimal als Zeichenfolge: "8e9e05c52164694d" |
Als JSON-Zeichenfolge serialisierte Member-Struktur:
{
  "id":10276657743932975437,
  "peerURLs":[
  "http://localhost:2380"],
  "name":"default",
  "clientURLs": ["http://localhost:2379"]
}
|
Durch Konsens vereinbarte Informationen zur Clustermitgliedschaft. |
| members_removed | [memberId] hexadezimal als Zeichenfolge: "8e9e05c52164694d" |
[]byte("removed") |
IDs aller entfernten Mitglieder. Damit wird geprüft, dass ein entferntes Mitglied niemals unter derselben ID erneut hinzugefügt wird. Das Feld wird derzeit (3.4) aus dem V2-Speicher und niemals aus V3 gelesen. Siehe https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | uint64-Bytes (BigEndian) | Repräsentiert den Offset des letzten auf den bolt-DB-Speicher angewendeten WAL-Eintrags. |
| "scheduledCompactRev" | bytesToRev{main,sub} kodiert. (16 Bytes) | Dient zur erneuten Initialisierung der Kompaktierung, wenn nach einer Kompaktierungsanfrage ein Absturz aufgetreten ist. | |
| "finishedCompactRev" | bytesToRev{main,sub} kodiert. (16 Bytes) | Revision, bis zu der der Speicher zuletzt erfolgreich kompaktiert wurde (https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | Seit etcd 3.5 | ||
| "term" | Seit etcd 3.5 | ||
| "storage-version" |
Werkzeuge
bbolt
bbolt bietet ein Befehlszeilenwerkzeug zum Untersuchen des Dateiinhalts.
Anwendungsbeispiele:
Alle Buckets einer bbolt-Datei auflisten:
Ein bestimmtes Schlüssel-Wert-Paar lesen:
etcd-dump-db
etcd-dump-db kann den Inhalt des etcd-v3-Backends (bbolt) auflisten.
Weitere Beispiele: https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL: Write-Ahead-Log
Das Write-Ahead-Log ist ein persistenter Raft-Speicher für Vorschläge. Zuerst speichert der Leader den Vorschlag in seinem Log und repliziert ihn anschließend gleichzeitig über das Raft-Protokoll an die Follower. Jeder Follower speichert den Vorschlag dauerhaft in seinem WAL, bevor er dem Leader die Replikation bestätigt.
Das in etcd verwendete WAL unterscheidet sich in 2 Punkten vom kanonischen Raft-Modell:
- Es speichert nicht nur indizierte Einträge dauerhaft, sondern auch kleine Raft-Snapshots und HardState. So lässt sich der gesamte Raft-Zustand eines Mitglieds allein aus dem WAL wiederherstellen.
- Es wird nur angehängt. Einträge werden nicht an Ort und Stelle überschrieben; ein später in der Datei angehängter Eintrag mit demselben Index ersetzt den vorherigen logisch.
Dateinamen
Die WAL-Dateien werden nach folgendem Muster benannt:
Beispiel: ./member/wal/0000000000000010-00000000000bf1e6.wal
Die Dateinamen enthalten also hexadezimal kodiert:
- Die fortlaufende Nummer der WAL-Datei
- Den Index des ersten Eintrags oder Snapshots in der Datei. Insbesondere enthält die erste Datei „0000000000000000-0000000000000000.wal“ den anfänglichen Snapshot-Eintrag mit index=0.
Physischer Inhalt
Die WAL-Datei enthält eine Folge von „Frames “. Jeder Frame enthält:
- Eine in LittleEndian 2 kodierte uint64-Zahl mit der Länge des serialisierten walpb.Record (3).
- Auffüllung: Eine Anzahl von 0-Bytes, sodass die Größe des gesamten Frames ausgerichtet ist (mod 8)
- Serialisierte walpb.Record
-Daten:
- type - Als int kodierte Aufzählung, die die Interpretation des folgenden data-Felds bestimmt
- data - Je nach type gewöhnlich ein serialisiertes Proto
- crc - CRC-32-Prüfsumme aller zusammengefassten „data“-Felder ohne type in allen Logeinträgen dieses Replikats seit Erstellung des WAL. CRC berücksichtigt ALLE Einträge, auch wenn sie nicht durch Raft bestätigt wurden.
Eine neue Datei beginnt, sobald die aktuelle Datei 64*10^6 Bytes überschreitet.
Logischer Inhalt
Auf logischer Ebene enthalten Write-Ahead-Log-Dateien:
Raftpb.Entry:Aktuelle vom Raft-Leader replizierte Vorschläge. Einige gelten als bestätigt, andere können noch logisch überschrieben werden.Raftpb.HardState(term,commit,vote):Regelmäßige, sehr häufige Informationen über den Index eines bestätigten Logeintrags, der also auf die Mehrheit der Server repliziert wurde. Er wird garantiert nicht mehr geändert oder überschrieben und kann auf die Backends v2 und v3 angewendet werden. Enthalten sind außerdem ein „term“ als Hinweis auf wahlbezogene Änderungen sowie eine Stimme: das Mitglied, für das das aktuelle Replikat im aktuellen Term gestimmt hat.walpb.Snapshot(term, index):Regelmäßige Snapshots des Raft-Zustands ohne DB-Inhalt, nur mit Snapshot-Logindex und Raft-Term- Der Inhalt des V2-Speichers liegt in separaten *.store-Dateien.
- Der Inhalt des V3-Speichers wird in der bbolt-Datei verwaltet und bildet einen impliziten Snapshot, sobald die Einträge dort angewendet sind.
- Ein crc32-Prüfsummeneintrag am Anfang jeder Datei, um die CRC-Prüfung für den Rest der Datei fortzusetzen.
etcdserverpb.Metadata(node_id, cluster_id)- Identifiziert den Cluster und das Replikat, für die das Log steht.
Jede WAL-Datei besteht in dieser Reihenfolge aus:
-
CRC-32-Frame mit der fortlaufenden crc aller vorherigen Dateien, 0 für die erste Datei.
-
Metadaten-Frame mit Cluster- und Replikat-IDs
-
Nur für die erste WAL-Datei:
- Leerer Snapshot-Frame (Index:0, Term: 0). Er stellt die Invariante sicher, dass allen Einträgen ein Snapshot vorausgeht.
Für spätere WAL-Dateien (ab der 2.):
- HardState-Frame.
-
Mischung aus Entry-, HardState- und Snapshot-Einträgen
Das WAL kann mehrere Einträge mit demselben Index enthalten. Dies kann in den in Abbildung 7. der Raft-Veröffentlichung beschriebenen Fällen auftreten. Da an das etcd-WAL nur angehängt wird, werden Einträge durch Anhängen eines neuen Eintrags mit demselben Index überschrieben.
Insbesondere ersetzt die Leselogik alte Einträge durch neuere Einträge . Daher kann nur die jeweils letzte Version von Einträgen mit entry.index <= HardState.commit als endgültig gelten. Einträge mit index > HardState.commit können sich noch ändern.
Es wird erwartet, dass die Terms im WAL monoton sind.
Für die Indizes im WAL wird Folgendes erwartet:
- Sie beginnen bei einem Snapshot.
- Nach diesem Snapshot steigen sie fortlaufend, solange sie im selben Term bleiben.
- Bei einem Term-Wechsel kann der Index sinken, jedoch nur auf einen neuen Wert oberhalb des neuesten HardState.commit.
- Ein neuer Snapshot kann mit jedem Index >= HardState.commit auftreten und beginnt eine neue Indexfolge.
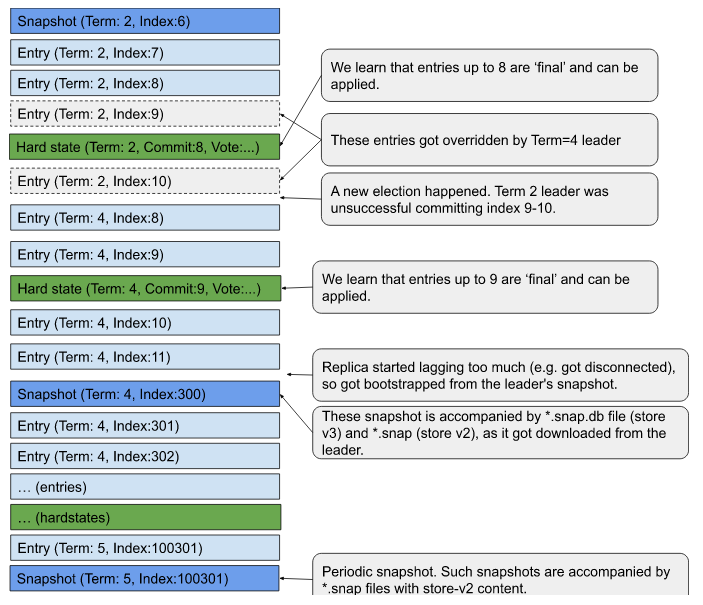
Werkzeuge
etcd-dump-logs
WAL-Dateien von etcd können mit dem Werkzeug etcd-dump-logs gelesen werden:
Zu beachten:
- Das Werkzeug zeigt nur Entries und nicht alle WAL-Einträge wie Snapshots und HardStates in den WAL-Dateien.
- Es berücksichtigt automatisch das Überschreiben von Einträgen. Wurde ein Eintrag durch einen neueren mit demselben Index überschrieben, wird nur der endgültige Wert ausgegeben.
- Es gibt auch unbestätigte Einträge vom Ende des LOG aus, ohne Informationen zu HardState.commitIndex. Daher ist nicht erkennbar, ob diese Einträge endgültig sind.
Snapshots des V2-Speichers: member/snap/{term}-{index}.snap
Dateinamen:
member/snap/{term}-{index}.snap
Die Dateinamen werden hier
mit ("%016x-%016x.snap") erzeugt und verwenden 2 hexadezimal kodierte Bestandteile:
- term -> Raft-Term, also der Zeitraum zwischen Wahlen, zum Zeitpunkt der Snapshot-Erstellung
- index -> Index des zuletzt angewendeten Vorschlags zum Zeitpunkt der Snapshot-Erstellung
Erstellung
Die *.snap-Dateien werden von der Methode Snapshotter.SaveSnap erstellt.
Es gibt 2 Auslöser für die Erstellung dieser Dateien:
- Ungefähr alle –snapshot-count=(standardmäßig 10,000 in v3.7.0) angewendeten Vorschläge wird eine neue Datei erstellt. Dies ist nur ein Näherungswert, da Vorschläge gebündelt eintreffen können, ein Snapshot erst am Ende eines solchen Pakets geprüft und der Snapshot-Vorgang schließlich asynchron eingeplant wird. Der Optionsname –snapshot-count ist recht irreführend, da er die Differenz der Indexwerte zwischen dem letzten Snapshot und dem zuletzt angewendeten Vorschlag steuert.
- Raft fordert das Replikat auf, sich aus einem Snapshot wiederherzustellen. Während das Replikat den Snapshot über eine msgSnap-Nachricht empfängt, hält es ihn auch als kleinen Checkpoint im WAL fest. Damit ist garantiert, dass am Ende des WAL stets ein gültiger Snapshot gefolgt von Einträgen steht. Mögliche Lücken im WAL werden so vermieden.
Derzeit entsprechen die Dateien ungefähr3 im Verhältnis 1-1 den Snapshot-Einträgen im WAL. Mit der Stilllegung des v2-Speichers wird erwartet, dass diese Dateien überhaupt nicht mehr geschrieben werden, optional ab 3.5.x und verpflichtend ab 3.6.x.
Inhalt
Die Datei enthält das serialisierte snapdb.snapshot-Proto
(uint32 crc, bytes data),
das im Feld ‘data’ einen Raftpb.Snapshot enthält:
(bytes data, SnapshotMetadata{index, term, conf } metadata),
Die verschachtelten Daten enthalten schließlich den JSON-serialisierten Inhalt des v2-Speichers .
Insbesondere enthalten sind:
- Term
- Index
- Mitgliedschaftsdaten:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- Speicherversion: /0/version-> 3.5.0
Werkzeuge
protoc
Der folgende Befehl zeigt den Dateiinhalt an, wenn er im Stammverzeichnis von etcd ausgeführt wird:
Ebenso lässt sich das Feld ‘data’ extrahieren und als Raftpb.Snapshot dekodieren.
Beispiel für JSON-serialisierten v2-Speicherinhalt in *.snap-Dateien von etcd 3.4:
Änderungen
Dieser Abschnitt ist für die Beschreibung von Dateiformatänderungen zwischen etcd-Versionen vorgesehen.
-
Die Metadatenseiten am Anfang der bbolt-Datei werden an Ort und Stelle geändert. ↩︎
-
Inkonsistent, da die meisten uint-Werte in Big Endian geschrieben werden ↩︎
-
Der anfängliche Snapshot mit index:0 am Anfang des WAL ist keiner *.snap-Datei zugeordnet. Zudem können alte *.snap-Dateien oder WAL-Dateien bereinigt werden. ↩︎
7 - Garantien der etcd-API
etcd ist ein konsistenter und dauerhafter Schlüssel-Wert-Speicher. Der Zugriff erfolgt über gRPC-Dienste . etcd bietet die stärksten Konsistenz- und Dauerhaftigkeitsgarantien für ein verteiltes System. Diese Spezifikation führt die API-Garantien von etcd auf.
Betrachtete APIs
- KV-APIs
- Watch-APIs
- Lease-APIs
Die KV-API ermöglicht das direkte Lesen und Bearbeiten des Schlüssel-Wert-Speichers. Mit der Watch-API lassen sich Änderungen am Schlüssel-Wert-Speicher abonnieren. Mit der Lease-API lässt sich einem Schlüssel eine Lebensdauer zuweisen.
Die KV- und Watch-APIs erlauben den Zugriff nicht nur auf die neuesten Schlüsselversionen, sondern auch auf frühere Versionen innerhalb eines zusammenhängenden Verlaufsfensters, das durch eine Kompaktierungsoperation begrenzt wird.
Ein Aufruf der KV-API wirkt unmittelbar, während die Watch-API mit einer nicht begrenzten Verzögerung zurückkehrt. In einem korrekt arbeitenden etcd-Cluster sollten Watch-Ereignisse etwa 10ms nach ihrem Auftreten sichtbar werden. Es gibt jedoch keine Obergrenze; in gestörten Clustern kommen Ereignisse möglicherweise nie an.
KV-APIs
etcd gewährleistet Dauerhaftigkeit und strikte Serialisierbarkeit für alle KV-API-Aufrufe. Dies sind die stärksten Isolationsgarantien verteilter transaktionaler Datenbanksysteme.
Dauerhaftigkeit
Alle abgeschlossenen Operationen sind dauerhaft. Auch alle zugänglichen Daten sind dauerhaft gespeichert. Ein Lesezugriff gibt niemals Daten zurück, die noch nicht dauerhaft gespeichert wurden.
Strikte Serialisierbarkeit
Operationen des KV-Dienstes sind atomar und erfolgen in einer totalen Ordnung, die ihrer Echtzeitreihenfolge entspricht. Diese totale Ordnung ergibt sich aus der Revision . Weitere Informationen zur strikten Serialisierbarkeit .
Bei Transaktionen ohne verschachtelte TXNs entspricht die Ausführungsreihenfolge garantiert jener in der Operationsliste. Dadurch sind die GET-Antworten innerhalb der Transaktion stabil. Bei Transaktionen mit verschachtelten TXNs ist die Ausführungsreihenfolge nicht festgelegt.
Strikte Serialisierbarkeit impliziert weitere, schwächere Garantien, die möglicherweise leichter verständlich sind:
Atomarität
Alle API-Anfragen sind atomar: Eine Operation wird entweder vollständig oder gar nicht abgeschlossen. Bei Watch-Anfragen befinden sich alle von einer Operation erzeugten Ereignisse in einer Watch-Antwort. Ein Watch beobachtet niemals nur einen Teil der Ereignisse einer einzelnen Operation.
Linearisierbarkeit
Aus Sicht des Clients bietet Linearisierbarkeit nützliche Eigenschaften, die das Nachvollziehen des Verhaltens erleichtern.
Die folgende klare Beschreibung stammt aus der
Originalveröffentlichung
: Linearisierbarkeit erweckt den Eindruck, dass jede von nebenläufigen Prozessen ausgeführte Operation zu einem Zeitpunkt zwischen ihrem Aufruf und ihrer Antwort augenblicklich wirksam wird.
Angenommen, ein Client schließt einen Schreibvorgang zum Zeitpunkt 1 (t1) ab. Ein Client, der zu t2 mit t2 > t1 einen Lesevorgang startet, sollte einen Wert erhalten, der mindestens so aktuell ist wie der zuvor zu t1 abgeschlossene Schreibvorgang. Der Lesevorgang wird möglicherweise aber erst zu t3 abgeschlossen. Linearisierbarkeit garantiert, dass er den neuesten Wert zu einem Zeitpunkt zwischen seinem Beginn zu t2 und seinem Abschluss zu t3 zurückgibt. Er berücksichtigt alle vor seinem Beginn abgeschlossenen Schreibvorgänge. Ein gleichzeitiger Schreibvorgang zwischen t2 und t3 kann berücksichtigt werden oder auch nicht; der zurückgegebene Wert muss beim Abschluss des Lesevorgangs nicht der neueste sein.
etcd gewährleistet standardmäßig Linearisierbarkeit für alle anderen Operationen.
Sie hat jedoch ihren Preis, da linearisierte Anfragen den Raft-Konsensprozess durchlaufen müssen.
Für geringere Latenzen und höheren Durchsatz bei Leseanfragen können Clients deren Konsistenzmodus
auf serializable setzen. Dabei können gegenüber dem Quorum veraltete Daten gelesen werden,
doch der Leistungsnachteil linearisierter Zugriffe durch ihre Abhängigkeit vom laufenden Konsens entfällt.
Watch-APIs
Watches bieten folgende Garantien für Ereignisse:
- Geordnet - Ereignisse sind nach Revision geordnet. Ein Ereignis erscheint niemals in einem Watch, wenn es zeitlich vor einem bereits ausgegebenen Ereignis liegt. Bei Transaktionen ohne verschachtelte TXNs entspricht die Reihenfolge der erzeugten Ereignisse garantiert der Reihenfolge in der Operationsliste. Bei Transaktionen mit verschachtelten TXNs ist sie nicht festgelegt.
- Eindeutig - Ein Ereignis erscheint niemals zweimal in einem Watch.
- Zuverlässig - Innerhalb des verfügbaren Verlaufsfensters geht niemals eine Teilfolge einer Ereignisfolge verloren. Sind Ereignisse zeitlich als a < b < c geordnet und empfängt der Watch a und c, empfängt er garantiert auch b, sofern b im verfügbaren Verlaufsfenster liegt.
- Atomar - Eine Ereignisliste umfasst garantiert vollständige Revisionen. Aktualisierungen mehrerer Schlüssel in derselben Revision werden nicht auf mehrere Ereignislisten aufgeteilt.
- Fortsetzbar - Ein unterbrochener Watch kann durch einen neuen Watch fortgesetzt werden, der nach der letzten vor der Unterbrechung in einem Watch-Ereignis empfangenen Revision beginnt, sofern diese Revision noch im Verlaufsfenster liegt.
- Mit Fortschrittsmarken - Fortschrittsbenachrichtigungen garantieren, dass alle Ereignisse bis zu einer Revision bereits ausgeliefert wurden.
etcd gewährleistet keine Linearisierbarkeit für Watch-Operationen. Von Benutzern wird erwartet, die Revision von Watch-Ereignissen zu prüfen, um ihre korrekte Reihenfolge gegenüber anderen Operationen sicherzustellen.
Lease-APIs
etcd bietet einen Lease-Mechanismus . Der wichtigste Anwendungsfall einer Lease ist die Implementierung verteilter Koordinationsmechanismen wie verteilter Sperren. Der Mechanismus selbst ist einfach: Eine Lease kann mit der Grant-API erstellt, mit der Put-API einem Schlüssel zugeordnet und mit der Revoke-API widerrufen werden. Sie läuft nach ihrer anhand der realen Uhrzeit gemessenen Lebensdauer (TTL) ab. Um korrekte verteilte Koordinationsmechanismen zu implementieren, müssen Benutzer jedoch die wesentlichen Eigenschaften der APIs und ihrer Verwendung kennen.
etcd-spezifische Definitionen
Abgeschlossene Operation
Eine etcd-Operation gilt als abgeschlossen, wenn sie durch Konsens bestätigt und damit von der
Speicherengine von etcd „ausgeführt“, also dauerhaft gespeichert wurde. Der Client weiß, dass eine
Operation abgeschlossen ist, sobald er eine Antwort vom etcd-Server erhält. Bei einer Zeitüberschreitung
oder einer Netzwerkunterbrechung zwischen Client und etcd-Mitglied kann ihr Status für den Client jedoch
ungewiss sein. etcd kann Operationen auch während einer Leader-Wahl abbrechen. In diesem Fall sendet
etcd keine abort-Antworten auf ausstehende Client-Anfragen.
Revision
Einer etcd-Operation, die den Schlüssel-Wert-Speicher ändert, wird genau eine steigende Revision zugewiesen. Eine Transaktionsoperation kann den Speicher mehrfach ändern, erhält aber nur eine Revision. Das Revisionsattribut eines durch die Operation geänderten Schlüssel-Wert-Paars hat denselben Wert wie die Revision der Operation. Die Revision kann als logische Uhr des Schlüssel-Wert-Speichers dienen. Ein Paar mit einer größeren Revision wurde nach einem Paar mit einer kleineren Revision geändert. Zwei Schlüssel-Wert-Paare mit derselben Revision wurden durch eine Operation „gleichzeitig“ geändert.
8 - etcd im Vergleich mit anderen Schlüssel-Wert-Speichern
Der Name „etcd“ entstand aus zwei Ideen: dem Unix-Verzeichnis “/etc” und verteilten Systemen, auf Englisch „distributed systems“. Im Verzeichnis “/etc” liegen Konfigurationsdaten eines einzelnen Systems, während etcd Konfigurationsinformationen für große verteilte Systeme speichert. Aus „/etc“ und dem Anfangsbuchstaben von „distributed“ wird somit „etcd“.
etcd ist als allgemeine Grundlage für große verteilte Systeme ausgelegt. Diese Systeme tolerieren keinen Split-Brain-Betrieb und nehmen dafür Einschränkungen der Verfügbarkeit in Kauf. etcd speichert Metadaten konsistent und fehlertolerant. Ein etcd-Cluster soll einen Schlüssel-Wert-Speicher mit erstklassiger Stabilität, Zuverlässigkeit, Skalierbarkeit und Leistung bieten.
Verteilte Systeme verwenden etcd als konsistenten Schlüssel-Wert-Speicher für Konfigurationsverwaltung, Diensterkennung und die Koordination verteilter Arbeit. Viele Organisationen nutzen etcd für Produktivsysteme wie Container-Scheduler, Dienste zur Diensterkennung und verteilte Datenspeicherung. Häufige verteilte Entwurfsmuster mit etcd sind Leader-Wahlen , verteilte Sperren und die Überwachung der Erreichbarkeit von Rechnern.
Anwendungsfälle
- Container Linux von CoreOS: Anwendungen auf Container Linux erhalten automatische Linux-Kernel-Updates ohne Ausfallzeit. Container Linux koordiniert Updates mit locksmith . Locksmith implementiert über etcd ein verteiltes Semaphor, das sicherstellt, dass zu jedem Zeitpunkt nur ein Teil des Clusters neu startet.
- Kubernetes speichert Konfigurationsdaten für Diensterkennung und Clusterverwaltung in etcd. Die Konsistenz von etcd ist für die korrekte Einplanung und den Betrieb von Diensten entscheidend. Der Kubernetes-API-Server speichert den Clusterzustand dauerhaft in etcd. Er verwendet die Watch-API von etcd, um den Cluster zu überwachen und kritische Konfigurationsänderungen auszurollen.
Vergleichstabelle
Vielleicht erscheint etcd bereits passend. Wie bei jeder Technologieentscheidung ist jedoch Vorsicht geboten. Diese Dokumentation wurde vom etcd-Team verfasst. Obwohl ein unvoreingenommener Vergleich von Technik und Funktionen das Ziel ist, begünstigen Fachkenntnisse und Vorlieben der Autoren offensichtlich etcd. Nur nach Anweisung verwenden.
Die folgende Tabelle bietet einen schnellen Überblick über die Unterschiede zwischen etcd und seinen beliebtesten Alternativen. Weitere Erläuterungen und Einzelheiten zu jeder Spalte folgen in den Abschnitten nach der Tabelle.
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| Grundoperationen für Nebenläufigkeit | Lock-RPCs , Election-RPCs , Sperren per Befehlszeile , Wahlen per Befehlszeile , Rezepte in Go | Externe Curator-Rezepte in Java | Native Sperr-API | Selten , wenn überhaupt |
| Linearisierbare Lesezugriffe | Ja | Nein | Ja | Manchmal |
| Mehrversions-Nebenläufigkeitskontrolle | Ja | Nein | Nein | Manchmal |
| Transaktionen | Feldvergleiche, Lesen, Schreiben | Versionsprüfungen, Schreiben | Feldvergleich, Sperren, Lesen, Schreiben | Im SQL-Stil |
| Änderungsbenachrichtigungen | Historische und aktuelle Schlüsselintervalle | Aktuelle Schlüssel und Verzeichnisse | Aktuelle Schlüssel und Präfixe | Trigger (manchmal) |
| Benutzerberechtigungen | Rollenbasiert | ACLs | ACLs | Unterschiedlich (GRANT pro Tabelle, Rollen pro Datenbank) |
| API für HTTP/JSON | Ja | Nein | Ja | Selten |
| Neukonfiguration der Mitgliedschaft | Ja | >3.5.0 | Ja | Ja |
| Maximal zuverlässig nutzbare Datenbankgröße | Mehrere Gigabyte | Hunderte Megabyte (manchmal mehrere Gigabyte) | Hunderte MB | Terabyte und mehr |
| Minimale Latenz zur Linearisierung von Lesezugriffen | Netzwerk-RTT | Keine Linearisierung von Lesezugriffen | RTT + fsync | Uhrzeitbarrieren (Atomuhr, NTP) |
ZooKeeper
ZooKeeper löst dasselbe Problem wie etcd: die Koordination verteilter Systeme und die Speicherung von Metadaten. etcd kann jedoch auf Entwicklungs- und Betriebserfahrungen mit dem Entwurf und der Implementierung von ZooKeeper zurückgreifen. Diese Erfahrungen haben den Entwurf von etcd geprägt und dabei geholfen, große Systeme wie Kubernetes zu unterstützen. Zu den Verbesserungen von etcd gegenüber ZooKeeper gehören:
- Dynamische Neukonfiguration der Clustermitgliedschaft
- Stabile Lese- und Schreibzugriffe unter hoher Last
- Ein Datenmodell mit Mehrversions-Nebenläufigkeitskontrolle
- Zuverlässige Schlüsselüberwachung, die niemals unbemerkt Ereignisse verwirft
- Lease-Grundoperationen, die Verbindungen von Sitzungen entkoppeln
- APIs für sichere verteilte gemeinsame Sperren
Darüber hinaus unterstützt etcd unmittelbar zahlreiche Sprachen und Frameworks. ZooKeeper verwendet sein eigenes, ausschließlich dort eingesetztes Jute-RPC-Protokoll, das die unterstützten Sprachanbindungen
begrenzt. Das Client-Protokoll von etcd basiert dagegen auf gRPC
, einem verbreiteten RPC-Framework mit Anbindungen für Go, C++, Java und weitere Sprachen. gRPC lässt sich außerdem als JSON über HTTP serialisieren, sodass auch allgemeine Befehlszeilenwerkzeuge wie curl damit kommunizieren können. Dank dieser Auswahl lassen sich Systeme mit ihren nativen Werkzeugen auf etcd aufbauen, statt sie mit einem einzigen festen Technologiesatz um etcd herum zu entwickeln.
Unter Berücksichtigung von Funktionen, Unterstützung und Stabilität sind neue Anwendungen, die ZooKeeper als konsistenten Schlüssel-Wert-Speicher einsetzen wollen, gut beraten, stattdessen etcd zu wählen.
Consul
Consul ist ein umfassendes Framework zur Diensterkennung. Es bietet integrierte Health Checks, Ausfallerkennung und DNS-Dienste. Außerdem stellt Consul einen Schlüssel-Wert-Speicher mit RESTful-HTTP-APIs bereit. Beim Stand von Consul 1.0 skaliert dieser Speicher bei Schlüssel-Wert-Operationen weniger gut als Systeme wie etcd oder ZooKeeper. Systeme mit Millionen Schlüsseln leiden unter hohen Latenzen und Speicherdruck. Der Schlüssel-Wert-API fehlen insbesondere Mehrversionsschlüssel, bedingte Transaktionen und zuverlässige Streaming-Watches.
etcd und Consul lösen unterschiedliche Probleme. Für einen verteilten konsistenten Schlüssel-Wert-Speicher ist etcd die bessere Wahl. Für eine umfassende Diensterkennung im Cluster reichen die Funktionen von etcd nicht aus; dafür eignen sich Kubernetes, Consul oder SmartStack.
NewSQL (Cloud Spanner, CockroachDB, TiDB)
Sowohl etcd als auch NewSQL-Datenbanken wie Cockroach , TiDB und Google Spanner bieten starke Datenkonsistenzgarantien und Hochverfügbarkeit. Die deutlich unterschiedlichen Systementwurfsparameter führen jedoch zu deutlich unterschiedlichen Client-APIs und Leistungseigenschaften.
NewSQL-Datenbanken sind für horizontale Skalierung über Rechenzentren hinweg ausgelegt. Sie verteilen Daten üblicherweise auf mehrere konsistente Replikationsgruppen, sogenannte Shards, die weit auseinanderliegen können, und speichern Datenmengen im Terabyte-Bereich und darüber. Für verteilte Koordination eignet sich diese Skalierung schlecht: Das Warten auf Uhren verursacht hohe Latenzen, und Aktualisierungen werden mit weitgehend lokalen Abhängigkeitsgraphen erwartet. Die Daten sind in Tabellen organisiert und lassen sich mit SQL-artigen Abfragen mit umfangreicherer Semantik als bei etcd abfragen. Dafür steigt jedoch die Komplexität der Verarbeitung sowie der Planung und Optimierung von Abfragen.
Für Metadatenspeicherung oder die Koordination verteilter Anwendungen eignet sich etcd. Sollen mehr als einige GB Daten gespeichert werden oder sind vollständige SQL-Abfragen erforderlich, eignet sich eine NewSQL-Datenbank.
etcd für Metadaten verwenden
etcd repliziert alle Daten innerhalb einer einzigen konsistenten Replikationsgruppe. Für bis zu einige GB Daten mit konsistenter Reihenfolge ist dies der effizienteste Ansatz. Jede Änderung des Clusterzustands, die mehrere Schlüssel betreffen kann, erhält aus einem monoton steigenden Zähler eine global eindeutige ID, in etcd Revision genannt. Anhand dieser ID lässt sich die Reihenfolge bestimmen. Da es nur eine Replikationsgruppe gibt, muss die Änderungsanfrage zur Bestätigung nur das Raft-Protokoll durchlaufen. Durch die Begrenzung des Konsenses auf eine Replikationsgruppe erreicht etcd verteilte Konsistenz mit einem einfachen Protokoll bei geringer Latenz und hohem Durchsatz.
Die Replikation von etcd lässt sich mangels Daten-Sharding nicht horizontal skalieren. NewSQL-Datenbanken verteilen Daten dagegen üblicherweise auf mehrere konsistente Replikationsgruppen und speichern Datenmengen im Terabyte-Bereich und darüber. Um jeder Änderung eine global eindeutige, steigende ID zuzuweisen, muss jede Anfrage jedoch ein zusätzliches Koordinationsprotokoll zwischen den Replikationsgruppen durchlaufen. Dieser zusätzliche Schritt kann Konflikte um die globale ID verursachen und geordnete Anfragen zur Wiederholung zwingen. Das Ergebnis ist ein komplexerer Ansatz mit üblicherweise schlechterer Leistung als etcd bei strikter Reihenfolge.
Wenn eine Anwendung vor allem Metadaten oder deren Reihenfolge verarbeitet, etwa zur Prozesskoordination, eignet sich etcd. Benötigt sie einen großen Datenspeicher über mehrere Rechenzentren hinweg und ist nicht stark auf eine strikte globale Reihenfolge angewiesen, eignet sich eine NewSQL-Datenbank.
etcd für verteilte Koordination verwenden
etcd bietet direkt Grundoperationen für verteilte Koordination, darunter Ereignis-Watches, Leases, Wahlen und verteilte gemeinsame Sperren. Bei letzteren müssen Benutzer allerdings nicht offensichtliche Eigenschaften beachten, die unten erläutert werden. Diese Grundoperationen werden von den etcd-Entwicklern gepflegt und unterstützt. Sie externen Bibliotheken zu überlassen, würde die Verantwortung für die Entwicklung grundlegender verteilter Software abgeben und das System im Wesentlichen unvollständig lassen. NewSQL-Datenbanken erwarten üblicherweise, dass Drittanbieter solche Grundoperationen entwickeln. Ebenso verfügt ZooKeeper bekanntlich über eine separate, unabhängige Bibliothek mit Koordinationsrezepten. Consul bietet eine native Sperr-API, weist aber sogar entschuldigend darauf hin, dass sie „keine absolut sichere Methode “ sei.
Theoretisch lassen sich diese Grundoperationen auf jedem Speichersystem mit starker Konsistenz aufbauen. Die Algorithmen sind jedoch oft subtil: Schnell entsteht ein scheinbar funktionierender Sperralgorithmus, der plötzlich an gleichzeitig aufwachenden Wartenden, dem Thundering-Herd-Problem, oder Zeitabweichungen scheitert. Außerdem hängen weitere von etcd unterstützte Grundoperationen wie transaktionaler Speicher vom MVCC-Datenmodell ab; starke Konsistenz allein reicht nicht aus.
Für verteilte Koordination kann die Wahl von etcd Betriebsprobleme vermeiden helfen und Entwicklungsaufwand sparen.
Hinweise zur Verwendung von Sperren und Leases
etcd bietet Sperr-APIs , die auf dem Lease-Mechanismus und dessen Implementierung in etcd basieren. Die Grundidee: Ein Server gewährt einem anfragenden Client ein Token namens Lease und ordnet ihm eine TTL zu. Stellt der Server fest, dass mehr Zeit als die TTL vergangen ist, widerruft er die Lease. Solange der Client eine nicht widerrufene Lease hält, kann er beanspruchen, den Zugriff auf eine zugeordnete Ressource zu besitzen. Bei etcd ist diese Ressource ein Schlüssel im Schlüsselraum. Auf diesem Prinzip beruhen die Sperr-APIs von etcd. Für sich allein gewährleisten sie jedoch keinen gegenseitigen Ausschluss. Die Bezeichnung „lock“ hat historische Gründe . Wie unten beschrieben, können die Sperr-APIs den gegenseitigen Ausschluss jedoch optimieren.
Der wichtigste Aspekt des Lease-Mechanismus ist, dass die TTL als physisches Zeitintervall definiert ist. Server und Client messen den Zeitablauf jeweils mit ihrer eigenen Uhr. Daher kann der Server die Lease bereits widerrufen haben, während der Client weiterhin behauptet, sie zu besitzen.
Wie gewährleistet der Lease-Mechanismus dann den gegenseitigen Ausschluss der Sperren? Tatsächlich gewährleistet er selbst keinen gegenseitigen Ausschluss. Der Besitz einer Lease garantiert nicht, dass ihr Besitzer eine Sperre auf der Ressource hält.
Wenn etcd-Sperren den gegenseitigen Zugriff auf Schlüssel von etcd selbst steuern, wird der gegenseitige Ausschluss durch die Validierung von Versionsnummern implementiert. In anderen Systemen wie Consul wird dies manchmal Compare and Swap genannt. In etcd-RPCs wie Put oder Txn lassen sich erforderliche Bedingungen für Revisionsnummer und Lease-ID der Operationen angeben. Sind diese nicht erfüllt, kann die Operation fehlschlagen. Mit diesem Mechanismus stellt etcd verteilte Sperren für Clients bereit. Ein Client weiß also, dass er die Sperre eines Schlüssels erwirbt, wenn der etcd-Cluster seine Anfragen erfolgreich abschließt.
Die Literatur zu verteilten Sperren beschreibt ähnliche Entwürfe:
- Die Veröffentlichung zu Chubby führt den Begriff Sequencer ein. Nach unserem Verständnis entspricht er nahezu der Kombination aus Revisionsnummer und Lease-ID in etcd.
- In Verteilte Sperren implementieren stellt Martin Kleppmann das Konzept des Fencing-Tokens vor. Nach Auffassung der Autoren entspricht dieses Token bei etcd der Revisionsnummer.
- Praktische Anwendungen synchronisierter Uhren in verteilten Systemen beschreibt, wie Thor verteilte Sperren auf Grundlage von Versionsnummernvalidierung und Leases implementiert.
Warum bieten etcd und andere Systeme Leases, wenn sie gegenseitigen Ausschluss durch Versionsnummernvalidierung gewährleisten? Leases dienen als Optimierung, um die Anzahl abgebrochener Anfragen zu verringern.
Schlüssel in etcd lassen sich dank Leases und Versionsnummernvalidierung effizient sperren. Müssen Benutzer Ressourcen außerhalb von etcd schützen, müssen diese wie etcd-Schlüssel eine Versionsnummernvalidierung und konsistente Replikate bereitstellen. Die Sperrfunktion von etcd allein kann externe Ressourcen nicht schützen.
9 - Glossar
Dieses Dokument definiert die verschiedenen Begriffe, die in der etcd-Dokumentation, der Befehlszeile und dem Quellcode verwendet werden.
Alarm
Der etcd-Server löst einen Alarm aus, wenn ein Eingriff des Betreibers erforderlich ist, damit der Cluster zuverlässig bleibt.
Authentifizierung
Die Authentifizierung verwaltet die Zugriffsberechtigungen von Benutzern auf etcd-Ressourcen.
Client
Ein Client verbindet sich mit dem etcd-Cluster, um Dienstanfragen zu stellen, etwa zum Abrufen von Schlüssel-Wert-Paaren, zum Schreiben von Daten oder zum Beobachten von Änderungen.
Cluster
Ein Cluster besteht aus mehreren Mitgliedern.
Der Knoten in jedem Mitglied folgt dem Raft-Konsensprotokoll, um Logs zu replizieren. Der Cluster empfängt Vorschläge von Mitgliedern, bestätigt sie und wendet sie auf den lokalen Speicher an.
Kompaktierung
Die Kompaktierung verwirft den gesamten etcd-Ereignisverlauf und die ersetzten Schlüssel vor einer bestimmten Revision. Sie dient dazu, Speicherplatz in der Backend-Datenbank von etcd zurückzugewinnen.
Wahl
Der etcd-Cluster hält im Rahmen des Raft-Konsensprotokolls Wahlen unter seinen Mitgliedern ab, um einen Leader zu bestimmen.
Endpunkt
Eine URL, die auf einen etcd-Dienst oder eine etcd-Ressource verweist.
Schlüssel
Ein benutzerdefinierter Bezeichner zum Speichern und Abrufen benutzerdefinierter Werte in etcd.
Schlüsselbereich
Eine Schlüsselmenge, die entweder einen einzelnen Schlüssel, ein lexikalisches Intervall für alle x mit a <= x < b oder alle Schlüssel größer als ein bestimmter Schlüssel enthält.
Schlüsselraum
Die Menge aller Schlüssel in einem etcd-Cluster.
Lease
Eine kurzlebige, verlängerbare Vereinbarung, die bei ihrem Ablauf die ihr zugeordneten Schlüssel löscht.
Mitglied
Ein logischer etcd-Server, der am Betrieb eines etcd-Clusters beteiligt ist.
Änderungsrevision
Die erste Revision, die den letzten Schreibvorgang für einen bestimmten Schlüssel enthält.
Peer
Ein Peer ist ein anderes Mitglied desselben Clusters.
Vorschlag
Ein Vorschlag ist eine Anfrage, etwa eine Schreibanfrage oder eine Anfrage zur Konfigurationsänderung, die das Raft-Protokoll durchlaufen muss.
Quorum
Die Anzahl aktiver Mitglieder, die für einen Konsens zur Änderung des Clusterzustands benötigt wird. etcd benötigt eine Mehrheit der Mitglieder, um ein Quorum zu erreichen.
Revision
Ein clusterweiter 64-Bit-Zähler, der bei 1 beginnt und bei jeder Änderung des Schlüsselraums erhöht wird.
Rolle
Eine Einheit von Berechtigungen für eine Menge von Schlüsselbereichen, die zur Zugriffskontrolle einer Menge von Benutzern zugewiesen werden kann.
Snapshot
Ein Backup des etcd-Clusterzustands zu einem bestimmten Zeitpunkt.
Speicher
Der physische Speicher, in dem der Schlüsselraum des Clusters abgelegt ist.
Term
Ein Term ist eine monoton steigende Ganzzahl, die im Raft-Algorithmus jeder Leader-Wahl zugeordnet wird. Pro Term kann es nur einen gewählten Leader geben. Bei einem Leader-Wechsel wird der Term erhöht.
Transaktion
Eine atomar ausgeführte Menge von Operationen. Alle in einer Transaktion geänderten Schlüssel haben dieselbe Änderungsrevision.
Schlüsselversion
Die Anzahl der Schreibvorgänge für einen Schlüssel seit seiner Erstellung, beginnend bei 1. Die Version eines nicht vorhandenen oder gelöschten Schlüssels ist 0.
Watcher
Ein Client öffnet einen Watcher, um Änderungen in einem bestimmten Schlüsselbereich zu beobachten.