Dies ist die mehrseitige Druckansicht dieses Abschnitts. .
Betriebshandbuch
- 1: Anleitungen zur Authentifizierung
- 2: Konfigurationsoptionen
- 3: Sicherheitsmodell für den Datentransport
- 4: Anleitung zur Clusterbildung
- 5: etcd-Cluster als Kubernetes-StatefulSet ausführen
- 6: etcd-Cluster in Containern ausführen
- 7: Ausfallarten
- 8: Recovery nach einem Totalausfall
- 9: etcd-Gateway
- 10: gRPC-Proxy
- 11: Hardwareempfehlungen
- 12: Wartung
- 13: etcd überwachen
- 14: Leistung
- 15: Entwurf der Laufzeitrekonfiguration
- 16: Laufzeitrekonfiguration
- 17: Unterstützte Plattformen
- 18: Versionierung
- 19: Datenbeschädigung
1 - Anleitungen zur Authentifizierung
1.1 - Authentifizierung
auth,user,role für die Authentifizierung:
Hinweis:
Dies ist lediglich ein Entwurf, der um weitere Informationen zur Authentifizierung ergänzt und aktualisiert werden muss. Der obige Text ist nur ein Codebeispiel.
1.2 - Rollenbasierte Zugriffskontrolle
Überblick
Die Authentifizierung wurde in etcd 2.1 eingeführt. Die etcd-v3-API hat die API und die Benutzeroberfläche der Authentifizierungsfunktion geringfügig angepasst, um dem neuen Datenmodell besser gerecht zu werden. Diese Anleitung hilft dabei, eine grundlegende Authentifizierung und rollenbasierte Zugriffskontrolle in etcd v3 einzurichten.
Besondere Benutzer und Rollen
Es gibt einen besonderen Benutzer, root, und eine besondere Rolle, root.
Benutzer root
Der Benutzer root, der uneingeschränkten Zugriff auf etcd hat, muss vor der Aktivierung der Authentifizierung angelegt werden. Der Benutzer root ist für Verwaltungsaufgaben vorgesehen: die Verwaltung von Rollen und gewöhnlichen Benutzern. Der Benutzer root muss die Rolle root haben und darf alles in etcd ändern.
Rolle root
Die Rolle root kann neben dem root-Benutzer jedem Benutzer zugewiesen werden. Ein Benutzer mit der Rolle root hat sowohl globalen Lese- und Schreibzugriff als auch die Berechtigung, die Authentifizierungskonfiguration des Clusters zu ändern. Darüber hinaus gewährt die Rolle root Rechte für die allgemeine Clusterwartung, einschließlich der Änderung der Clustermitgliedschaft, der Defragmentierung des Speichers und der Erstellung von Snapshots.
Benutzer verwalten
Der Unterbefehl user von etcdctl übernimmt alle Aufgaben rund um Benutzerkonten.
Benutzer lassen sich wie folgt auflisten:
Ein Benutzer lässt sich einfach so anlegen:
Beim Anlegen eines neuen Benutzers wird ein neues Passwort abgefragt. Mit der Option --interactive=false kann das Passwort über die Standardeingabe übergeben werden. Auch --new-user-password kann zur Übergabe des Passworts verwendet werden.
Ein Benutzer, der sich nicht mit einem Passwort authentifizieren kann, lässt sich ebenfalls anlegen:
Ein solcher Benutzer kann sich nur über den TLS Common Name authentifizieren .
etcd unterstützt keine Authentifizierung mit einem leeren Passwort über --user username:. Beispielsweise kann sich ein mit leerem Passwort angelegter Benutzer wie etcdctl user add anonymous:'' nicht über Anfragen mit Benutzername und Passwort authentifizieren; Anfragen wie etcdctl --user anonymous: get foo schlagen mit user name is empty fehl.
Einem Benutzer lassen sich Rollen wie folgt zuweisen und entziehen:
Die Einstellungen des Benutzers lassen sich wie folgt anzeigen:
Das Passwort eines Benutzers lässt sich wie folgt ändern:
Bei der Passwortänderung wird erneut ein neues Passwort abgefragt. Mit der Option --interactive=false kann das Passwort über die Standardeingabe übergeben werden.
Ein Konto löschen:
Rollen verwalten
Der Unterbefehl role von etcdctl übernimmt alle Aufgaben rund um die Zugriffskontrolle für einzelne Rollen, die Benutzern zugewiesen wurden.
Rollen auflisten:
Eine neue Rolle anlegen:
Eine Rolle hat kein Passwort; sie definiert lediglich eine neue Menge von Zugriffsrechten.
Rollen erhalten Zugriff auf einen einzelnen Schlüssel oder einen Schlüsselbereich.
Der Bereich kann als Intervall [start-key, end-key) angegeben werden, wobei start-key in alphabetischer, lexikografischer Reihenfolge kleiner als end-key sein sollte.
Der Zugriff kann zum Lesen, zum Schreiben oder für beides gewährt werden, wie in den folgenden Beispielen:
Die gewährten Rechte lassen sich jederzeit anhand der Rolle anzeigen:
Der Entzug von Berechtigungen folgt demselben Prinzip:
Ebenso das vollständige Löschen einer Rolle:
Authentifizierung aktivieren
Für die Aktivierung der Authentifizierung sind mindestens die folgenden Schritte erforderlich. Der Administrator kann Benutzer und Rollen nach Belieben vor oder nach der Aktivierung der Authentifizierung einrichten.
Sicherstellen, dass der root-Benutzer angelegt ist:
Authentifizierung aktivieren:
Danach läuft etcd mit aktivierter Authentifizierung. Um sie aus beliebigem Grund zu deaktivieren, dient der entsprechende Gegenbefehl:
Schutzumfang der Authentifizierung
Wenn die Authentifizierung mit etcdctl auth enable aktiviert wird, schützt sie die Operationen der V3-gRPC-API (get, put, delete, watch usw.).
Die HTTP-Endpunkte /metrics und /health verwenden einen separaten Handler und werden nicht durch die V3-RBAC-Authentifizierung geschützt. Dadurch können Prometheus und Load-Balancer Metriken ohne gRPC-Authentifizierung abrufen, während die Schlüssel-Wert-Daten weiterhin geschützt sind.
Diese Endpunkte zur Überwachung lassen sich wie folgt absichern:
- mTLS mit
--cert-file,--key-fileund--client-cert-authaktivieren - Oder die Metriken mit
--listen-metrics-urlsan eine private Schnittstelle binden - Oder den Zugriff durch Netzwerkrichtlinien/Firewallregeln beschränken
Mit etcdctl authentifizieren
etcdctl unterstützt zur Authentifizierung eine ähnliche Option wie curl.
Das Passwort kann interaktiv abgefragt werden:
Das Passwort kann auch mit der Befehlszeilenoption --password übergeben werden:
Ansonsten bleiben alle etcdctl-Befehle unverändert. Benutzer und Rollen können weiterhin angelegt und geändert werden; dafür ist jedoch die Authentifizierung durch einen Benutzer mit der root-Rolle erforderlich.
TLS Common Name verwenden
Ab Version v3.2 wird beim Start eines etcd-Servers mit der Option --client-cert-auth=true das Feld Common Name (CN) im TLS-Zertifikat des Clients als etcd-Benutzer verwendet. In diesem Fall authentifiziert der Common Name den Benutzer, und der Client benötigt kein Passwort. Wenn sowohl 1. --client-cert-auth=true übergeben wird und der Client einen CN bereitstellt als auch 2. der Client Benutzername und Passwort übergibt, hat die Authentifizierung mit Benutzername und Passwort Vorrang. Diese Funktion kann nicht mit gRPC-proxy und gRPC-gateway verwendet werden. gRPC-proxy terminiert TLS vom Client, sodass alle Clients ein Zertifikat des Proxys gemeinsam nutzen. gRPC-gateway verwendet intern eine TLS-Verbindung, um HTTP-Anfragen in gRPC-Anfragen umzuwandeln, und unterliegt daher derselben Einschränkung. Die Clients können ihren CN deshalb nicht korrekt an den Server übermitteln. gRPC-proxy meldet einen Fehler und beendet sich, wenn ein angegebenes Zertifikat einen nicht leeren CN enthält. gRPC-proxy gibt einen Fehler zurück, der auf den nicht leeren CN im Zertifikat des Clients hinweist.
Hinweise zur Passwortstärke
etcdctl und die etcd-API erzwingen beim Anlegen von Benutzern oder beim Ändern ihrer Passwörter keine bestimmte Passwortlänge. Die Durchsetzung solcher Anforderungen liegt in der Verantwortung des Administrators. Um Sicherheitsrisiken durch schwache Passwörter zu vermeiden, können die Authentifizierung über den TLS Common Name
und Benutzer verwendet werden, die mit der Option --no-password angelegt wurden.
2 - Konfigurationsoptionen
etcd lässt sich auf folgende Arten konfigurieren:
- Befehlszeilenoptionen
- Umgebungsvariablen: Zu jeder Option gehört eine gleichnamige Umgebungsvariable,
deren Name jedoch mit
ETCD_beginnt und in Großbuchstaben mit Unterstrichen als Worttrennern geschrieben wird. Beispielsweise entspricht--some-flagder VariablenETCD_SOME_FLAG. - Konfigurationsdatei
Achtung: Werden verschiedene Konfigurationsarten kombiniert, gelten die folgenden Regeln.
- Befehlszeilenoptionen haben Vorrang vor Umgebungsvariablen.
- Wird eine Konfigurationsdatei angegeben, werden alle Befehlszeilenoptionen und Umgebungsvariablen ignoriert.
Befehlszeilenoptionen
Die Optionen werden im Folgenden im Format --flag-name DEFAULT_VALUE dargestellt.
Diese importierte Referenz enthält einige ältere v2-Optionen als Kontext für die Migration. In etcd 3.7 sind --enable-v2 und der v2-Proxy-Modus nicht verfügbar. Die veraltete Option --v2-deprecation ignoriert Benutzereingaben und erzwingt ihren Standardwert. Vor der Verwendung älterer Optionen die Ausgabe von etcd --help für die installierte Version prüfen.
Die folgende Optionsliste ist aufgrund laufender Entwicklungsänderungen möglicherweise nicht aktuell. Die neuesten verfügbaren Optionen lassen sich mit etcd --help oder in der etcd-Hilfe
nachschlagen.
Hinweis: Einzelheiten zu neuen, aktualisierten und als veraltet markierten Optionen in v3.7 stehen in CHANGELOG-3.7.md .
Mitglied
Clusterbildung
Sicherheit
Authentifizierung
Profiling und Überwachung
Protokollierung
Hinweis: Mehrere --experimental-*-Optionen wurden in v3.7 in stabile Optionen überführt oder umbenannt.
Veraltete Optionen unbedingt durch die unten aufgeführten stabilen Entsprechungen ersetzen.
Verteiltes Tracing
v2-Proxy
Der v2-Proxy wurde vor v3.7 entfernt. Die folgenden Optionen bleiben nur als historische Migrationsreferenz erhalten und dürfen nicht an einen etcd-v3.7-Server übergeben werden.
Funktionen
Funktionsschalter
Unsichere Funktionen
Warnung: Die Verwendung unsicherer Funktionen kann die Garantien des Konsensprotokolls außer Kraft setzen!
Konfigurationsdatei
Eine etcd-Konfigurationsdatei besteht aus einer YAML-Map. Ihre Schlüssel sind die Namen der Befehlszeilenoptionen und ihre Werte die jeweiligen Optionswerte.
Um diese Datei zu verwenden, ihren Pfad als Wert der Option --config-file oder der Umgebungsvariablen ETCD_CONFIG_FILE angeben.
Ein Beispiel bietet die etcd.conf.yml-Beispieldatei .
Zeitdauerfelder wie --grpc-keepalive-min-time, --grpc-keepalive-interval,
--grpc-keepalive-timeout, --backend-batch-interval, --corrupt-check-time,
--compact-hash-check-time, --compaction-sleep-interval,
--watch-progress-notify-interval, --warning-apply-duration,
--warning-unary-request-duration und --downgrade-check-time akzeptieren
als Befehlszeilenoptionen menschenlesbare Zeichenfolgen (z. B. 10m, 5s),
in einer Konfigurationsdatei jedoch nur ganzzahlige Werte in
Nanosekunden. Dies ist eine bekannte Einschränkung der Go-Standardbibliothek
,
bei der time.Duration als einfache Ganzzahl deserialisiert wird.
Beispiel für ein Intervall von 10 Minuten für Watch-Fortschrittsmeldungen in einer Konfigurationsdatei:
3 - Sicherheitsmodell für den Datentransport
etcd unterstützt automatisches TLS sowie die Authentifizierung über Clientzertifikate sowohl für die Kommunikation zwischen Clients und Servern als auch zwischen Peers (Servern bzw. innerhalb des Clusters). etcd aktiviert weder die RBAC-basierte Authentifizierung noch die Authentifizierung auf der Transportschicht standardmäßig, um den Einstieg in die Datenbank zu erleichtern. Eine Änderung dieses Standards würde außerdem die Kompatibilität des seit 2013 bestehenden Projekts brechen. Ein etcd-Cluster ohne aktivierte Sicherheitsfunktionen kann seine Daten beliebigen Clients zugänglich machen.
Für den Einstieg werden zunächst ein CA-Zertifikat und ein signiertes Schlüsselpaar für ein Mitglied benötigt. Es wird empfohlen, für jedes Clustermitglied ein neues Schlüsselpaar zu erstellen und zu signieren.
Das Werkzeug cfssl bietet eine einfache Schnittstelle zur Zertifikatserzeugung; ein Beispiel für seine Verwendung steht hier . Alternativ hilft diese Anleitung zum Erzeugen selbstsignierter Schlüsselpaare .
Die folgende Optionsliste ist aufgrund laufender Entwicklungsänderungen möglicherweise nicht aktuell. Die neuesten verfügbaren Optionen lassen sich mit etcd --help oder in der etcd-Hilfe
nachschlagen.
Grundlegende Einrichtung
etcd akzeptiert mehrere zertifikatsbezogene Konfigurationsoptionen, entweder als Befehlszeilenoptionen oder als Umgebungsvariablen:
Kommunikation zwischen Client und Server:
--cert-file=<path>: Zertifikat für SSL/TLS-Verbindungen zu etcd. Ist diese Option gesetzt, kann advertise-client-urls das HTTPS-Schema verwenden.
--key-file=<path>: Schlüssel für das Zertifikat. Muss unverschlüsselt sein.
--client-cert-auth: Ist diese Option gesetzt, prüft etcd alle eingehenden HTTPS-Anfragen auf ein von der vertrauenswürdigen CA signiertes Clientzertifikat. Anfragen ohne gültiges Clientzertifikat schlagen fehl. Ist die Authentifizierung
aktiviert, liefert das Zertifikat die Anmeldedaten für den im Feld Common Name angegebenen Benutzernamen.
--trusted-ca-file=<path>: Vertrauenswürdige Zertifizierungsstelle.
--auto-tls: Automatisch erzeugte, selbstsignierte Zertifikate für TLS-Verbindungen mit Clients verwenden.
Peer-Kommunikation (zwischen Servern bzw. innerhalb des Clusters):
Die Peer-Optionen funktionieren genauso wie die Optionen für die Kommunikation zwischen Client und Server:
--peer-cert-file=<path>: Zertifikat für SSL/TLS-Verbindungen zwischen Peers. Es wird sowohl beim Lauschen auf der Peer-Adresse als auch beim Senden von Anfragen an andere Peers verwendet.
--peer-key-file=<path>: Schlüssel für das Zertifikat. Muss unverschlüsselt sein.
--peer-client-cert-auth: Ist diese Option gesetzt, prüft etcd alle eingehenden Peer-Anfragen aus dem Cluster auf gültige Clientzertifikate, die von der angegebenen CA signiert wurden.
--peer-trusted-ca-file=<path>: Vertrauenswürdige Zertifizierungsstelle.
--peer-auto-tls: Automatisch erzeugte, selbstsignierte Zertifikate für TLS-Verbindungen zwischen Peers verwenden.
Wird ein Zertifikat für Client-Server- oder Peer-Verbindungen angegeben, muss auch der Schlüssel gesetzt sein. Alle diese Konfigurationsoptionen sind ebenfalls über Umgebungsvariablen wie ETCD_TRUSTED_CA_FILE, ETCD_PEER_TRUSTED_CA_FILE usw. verfügbar.
Gemeinsame Optionen:
--cipher-suites: Kommagetrennte Liste unterstützter TLS-Cipher-Suites zwischen Server und Client sowie zwischen Peers (bei leerem Wert automatisch von Go befüllt).
--tls-min-version=<version> Legt die niedrigste von etcd unterstützte TLS-Version fest.
--tls-max-version=<version> Legt die höchste von etcd unterstützte TLS-Version fest. Ohne Angabe wird die höchste von Go unterstützte Version verwendet.
keyUsage und extendedKeyUsage in TLS-Zertifikaten
Beim Erzeugen von X.509-Zertifikaten zur Absicherung des etcd-Datentransports sollten die Zertifikate
je nach ihrer Rolle passende Felder für keyUsage und
extendedKeyUsage enthalten. etcd verwendet zur Zertifikatsprüfung die Go-Bibliotheken
crypto/tls und crypto/x509,
die diese Verwendungszwecke beim TLS-Handshake durchsetzen.
Die folgende Tabelle fasst die empfohlenen Verwendungszwecke für gängige Zertifikatsrollen zusammen:
| Zertifikatsrolle | keyUsage | extendedKeyUsage |
|---|---|---|
| Server (Client-Server-Verbindung) | digitalSignature, keyEncipherment | serverAuth |
| Client | digitalSignature, keyEncipherment | clientAuth |
| Peer (Server-Server-Verbindung) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
Hinweise:
- Ist
--peer-client-cert-authaktiviert, werden Peer-Zertifikate für gegenseitiges TLS zwischen etcd-Mitgliedern verwendet und benötigen daher sowohlserverAuthals auchclientAuth. - Clientzertifikate für
--client-cert-authsolltenclientAuthenthalten.
Beispiel 1: Transportsicherheit zwischen Client und Server mit HTTPS
Dafür ein CA-Zertifikat (ca.crt) und ein signiertes Schlüsselpaar (server.crt, server.key) bereithalten.
etcd schrittweise für einfache HTTPS-Transportsicherheit konfigurieren:
Der Start sollte problemlos gelingen. Die Konfiguration lässt sich anschließend durch HTTPS-Kommunikation mit etcd testen:
Der Befehl sollte einen erfolgreichen Handshake anzeigen. Da selbstsignierte Zertifikate mit einer eigenen Zertifizierungsstelle verwendet werden, muss die CA mit der Option --cacert an curl übergeben werden. Alternativ kann das CA-Zertifikat zum Verzeichnis der vertrauenswürdigen Systemzertifikate hinzugefügt werden, gewöhnlich /etc/pki/tls/certs oder /etc/ssl/certs.
Benutzer von OSX 10.9+: curl 7.30.0 auf OSX 10.9+ versteht keine auf der Befehlszeile übergebenen Zertifikate.
Stattdessen die Testdatei ca.crt direkt in den Schlüsselbund importieren oder curl die Option -k übergeben, um Fehler zu ignorieren.
Für einen Test ohne -k den Befehl open ./tests/fixtures/ca/ca.crt ausführen und den Anweisungen folgen.
Dieses Zertifikat nach dem Test unbedingt entfernen!
Falls eine andere Lösung bekannt ist, teilen Sie uns diese mit.
Beispiel 2: Authentifizierung zwischen Client und Server mit HTTPS-Clientzertifikaten
Bisher kann der etcd-Client die Serveridentität prüfen und Transportsicherheit herstellen. Mit Clientzertifikaten lässt sich darüber hinaus unbefugter Zugriff auf etcd verhindern.
Die Clients übermitteln ihre Zertifikate an den Server. Dieser prüft, ob das Zertifikat von der angegebenen CA signiert wurde, und entscheidet, ob er die Anfrage bedient.
Dafür werden dieselben Dateien wie im ersten Beispiel benötigt, außerdem ein von derselben Zertifizierungsstelle signiertes Schlüsselpaar für den Client (client.crt, client.key).
Nun dieselbe Anfrage wie oben an diesen Server senden:
Der Server sollte die Anfrage ablehnen:
Damit sie erfolgreich ist, muss das von der CA signierte Clientzertifikat an den Server übergeben werden:
Die Ausgabe sollte Folgendes enthalten:
Außerdem die Antwort des Servers:
Cipher-Suites angeben, um schwache TLS-Cipher-Suites zu sperren.
Der TLS-Handshake schlägt fehl, wenn das Client Hello ungültige Cipher-Suites anfordert.
Zum Beispiel:
Clientanfragen müssen dann eine der auf dem Server angegebenen Cipher-Suites verwenden:
Beispiel 3: Transportsicherheit und Clientzertifikate in einem Cluster
etcd unterstützt dasselbe Modell für die Peer-Kommunikation, also die Kommunikation zwischen etcd-Mitgliedern eines Clusters.
Angenommen, ca.crt sowie zwei Mitglieder mit eigenen, von dieser CA signierten Schlüsselpaaren (member1.crt & member1.key, member2.crt & member2.key) sind vorhanden. Dann wird etcd wie folgt gestartet:
Die etcd-Mitglieder bilden einen Cluster. Die gesamte Kommunikation zwischen dessen Mitgliedern wird verschlüsselt und anhand der Clientzertifikate authentifiziert. Die Ausgabe von etcd zeigt, dass die für Verbindungen verwendeten Adressen HTTPS nutzen.
Beispiel 4: Automatische Transportsicherheit mit selbstsignierten Zertifikaten
Werden ClientAutoTLS und PeerAutoTLS angegeben, sind die von etcd automatisch erzeugten Client- und Peer-Zertifikate nur 1 Jahr gültig. Mit der Option –self-signed-cert-validity lässt sich die Gültigkeitsdauer der Zertifikate in Jahren festlegen.
Für Fälle, in denen die Kommunikation verschlüsselt, aber nicht authentifiziert werden muss, kann etcd seine Nachrichten mit automatisch erzeugten, selbstsignierten Zertifikaten verschlüsseln. Dies vereinfacht die Bereitstellung, da Zertifikate und Schlüssel nicht außerhalb von etcd verwaltet werden müssen.
etcd mit den Optionen --auto-tls und --peer-auto-tls so konfigurieren, dass es selbstsignierte Zertifikate für Client- und Peer-Verbindungen verwendet:
Selbstsignierte Zertifikate authentifizieren keine Identität, daher gibt curl einen Fehler zurück:
Um die Prüfung der Zertifikatskette zu deaktivieren, curl mit der Option -k aufrufen:
Hinweise zu DNS SRV
Seit v3.1.0 (außer v3.2.9) authentifiziert die Initialisierung über SRV-Erkennung ServerName anhand der Stammdomäne aus der Option --discovery-srv. Dies soll Zertifikatsangriffe nach dem Man-in-the-Middle-Prinzip verhindern, indem ein passender Stammdomänenname im Feld Subject Alternative Name (SAN) des Zertifikats verlangt wird. Beispielsweise authentifiziert etcd --discovery-srv=etcd.local Peers und Clients nur dann, wenn die bereitgestellten Zertifikate die Stammdomäne etcd.local als Eintrag im Feld Subject Alternative Name (SAN) enthalten.
Hinweise zum etcd-Proxy
Dieser Abschnitt beschreibt den historischen v2-Proxy, der inzwischen entfernt wurde. Für etcd 3.7 den v3-gRPC-Proxy verwenden.
Bei einer abgesicherten Clientverbindung terminiert der etcd-Proxy TLS vom Client und verwendet für die Kommunikation mit etcd-Mitgliedern seinen eigenen Schlüssel und sein eigenes Zertifikat aus --peer-key-file und --peer-cert-file.
Der Proxy kommuniziert mit etcd-Mitgliedern sowohl über deren --advertise-client-urls als auch über deren --advertise-peer-urls. Er leitet Clientanfragen an die bekannt gegebenen Client-URLs der Mitglieder weiter und synchronisiert die anfängliche Clusterkonfiguration über deren bekannt gegebene Peer-URLs.
Ist für ein etcd-Mitglied die Clientauthentifizierung aktiviert, muss der Administrator sicherstellen, dass das in --peer-cert-file des Proxys angegebene Peer-Zertifikat für diese Authentifizierung gültig ist. Ist auch die Peerauthentifizierung aktiviert, muss das Peer-Zertifikat des Proxys dafür ebenfalls gültig sein.
Hinweise zur TLS-Authentifizierung
Seit v3.2.0 werden TLS-Zertifikate bei jeder Clientverbindung neu geladen . Dadurch lassen sich ablaufende Zertifikate ersetzen, ohne die etcd-Server zu stoppen: Die alten Zertifikate werden einfach mit neuen überschrieben. Das Aktualisieren bei jeder Verbindung sollte keinen allzu großen Zusatzaufwand verursachen, könnte aber künftig durch eine Caching-Schicht verbessert werden. Beispieltests stehen hier .
Seit v3.2.0
lehnt der Server eingehende Peer-Zertifikate mit falschem IP-SAN ab
. Enthält ein Peer-Zertifikat beispielsweise IP-Adressen im Feld Subject Alternative Name (SAN), authentifiziert der Server einen Peer nur, wenn dessen entfernte IP-Adresse einer dieser Adressen entspricht. Dies soll den Beitritt unbefugter Endpunkte zum Cluster verhindern. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die tatsächliche IP-Adresse von Peer B ist dabei 10.138.0.2, nicht 10.138.0.27. Versucht Peer B dem Cluster beizutreten, lehnt Peer A ihn mit dem Fehler x509: certificate is valid for 10.138.0.27, not 10.138.0.2 ab, weil Bs entfernte IP-Adresse nicht mit der Adresse im Feld Subject Alternative Name (SAN) übereinstimmt.
Seit v3.2.0
löst der Server TLS-DNSNames bei der Prüfung von SAN auf
. Enthält ein Peer-Zertifikat im Feld Subject Alternative Name (SAN) nur DNS-Namen und keine IP-Adressen, authentifiziert der Server den Peer nur, wenn die Vorwärtsauflösung dieser Namen (dig b.com) eine zur entfernten IP-Adresse passende Adresse ergibt. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die entfernte IP-Adresse von Peer B ist dabei 10.138.0.2. Versucht B dem Cluster beizutreten, löst Peer A den eingehenden Host b.com auf, um die Liste seiner IP-Adressen zu erhalten (z. B. mit dig b.com). Enthält die Liste die IP-Adresse 10.138.0.2 nicht, lehnt A den Peer B mit dem Fehler tls: 10.138.0.2 does not match any of DNSNames ["b.com"] ab.
Seit v3.2.2
akzeptiert der Server Verbindungen bei passender IP-Adresse ohne Prüfung der DNS-Einträge
. Enthält ein Peer-Zertifikat im Feld Subject Alternative Name (SAN) sowohl IP-Adressen als auch DNS-Namen und stimmt die entfernte IP-Adresse mit einer dieser IP-Adressen überein, akzeptiert der Server die Verbindung ohne weitere Prüfung der DNS-Namen. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die entfernte IP-Adresse von Peer B ist dabei 10.138.0.2, und invalid.domain ist ein ungültiger Host. Versucht B dem Cluster beizutreten, authentifiziert Peer A ihn erfolgreich, da das Feld Subject Alternative Name (SAN) eine gültige, passende IP-Adresse enthält. Weitere Einzelheiten stehen in Issue #8206
.
Seit v3.2.5
unterstützt der Server die Rückwärtsauflösung für DNS-SAN mit Platzhaltern
. Enthält ein Peer-Zertifikat im Feld Subject Alternative Name (SAN) nur DNS-Namen und keine IP-Adressen, führt der Server zunächst eine Rückwärtsauflösung der entfernten IP-Adresse durch, um die zugehörigen Namen zu erhalten (z. B. nslookup IPADDR). Er akzeptiert die Verbindung, wenn einer dieser Namen exakt oder über einen Platzhalter mit einem DNS-Namen des Peer-Zertifikats übereinstimmt. Andernfalls führt er für jeden DNS-Eintrag des Peer-Zertifikats eine Vorwärtsauflösung durch (z. B. example.default.svc bei einem Eintrag *.example.default.svc). Er akzeptiert die Verbindung dann nur, wenn die aufgelösten Adressen des Hosts die entfernte IP-Adresse des Peers enthalten. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die entfernte IP-Adresse von Peer B ist dabei 10.138.0.2. Versucht B dem Cluster beizutreten, löst Peer A die IP-Adresse 10.138.0.2 rückwärts auf, um die Liste der Hostnamen zu erhalten. Anschließend vergleicht er diese Hostnamen exakt oder über Platzhalter mit den DNS-Namen im Feld Subject Alternative Name (SAN) von Bs Zertifikat. Schlägt sowohl die Rückwärts- als auch die Vorwärtsauflösung fehl, gibt er den Fehler "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"] zurück. Weitere Einzelheiten stehen in Issue #8268
.
v3.3.0
ergänzt die Option etcd --peer-cert-allowed-cn
, um eine CN-basierte Authentifizierung (Common Name) für Verbindungen zwischen Peers
zu unterstützen. Bei der TLS-Initialisierung von Kubernetes werden dynamische Zertifikate für etcd-Mitglieder und andere Systemkomponenten erzeugt (z. B. API-Server, kubelet usw.). Separate CAs für jede Komponente ermöglichen eine strengere Zugriffskontrolle für den etcd-Cluster, sind aber häufig aufwendig zu pflegen. Mit –peer-cert-allowed-cn kann ein Knoten auch bei gemeinsam genutzten CAs nur mit passendem Common Name beitreten. Der Abgleich ist ein exakter Zeichenfolgenvergleich mit dem Feld Common Name (CN) des Zertifikats; Platzhalter und Präfixvergleiche werden nicht unterstützt. Für die Filterung anhand von Hostnamen mit –peer-cert-allowed-hostname oder –client-cert-allowed-hostname wird die Go-Funktion x509.Certificate.VerifyHostname() verwendet. Sie unterstützt sowohl exakte Hostnamen als auch Platzhaltereinträge (z. B. *.example.com). Beispielsweise wird jedes Mitglied eines Clusters mit 3 Knoten mit folgenden CSRs (mit cfssl) eingerichtet:
Wird --peer-cert-allowed-cn etcd.local angegeben, werden nur Peers mit passenden Common Names authentifiziert. Knoten mit anderen CNs in ihren CSRs oder einem anderen --peer-cert-allowed-cn werden abgelehnt:
Jeder Prozess sollte wie folgt gestartet werden:
v3.2.19
und v3.3.4
beheben das erneute Laden von TLS, wenn das SAN-Feld des Zertifikats nur IP-Adressen und keine Domänennamen enthält
. Ein Mitglied könnte beispielsweise mit folgenden CSRs (mit cfssl) eingerichtet sein:
In Go ruft der Server (*tls.Config).GetCertificate zum erneuten Laden von TLS genau dann auf, wenn sein Feld (*tls.Config).Certificates leer ist oder (*tls.ClientHelloInfo).ServerName nicht leer ist und eine gültige SNI vom Client enthält. Früher befüllte etcd (*tls.Config).Certificates beim ersten TLS-Handshake des Clients immer, sodass es nicht leer war. Daher musste der Client stets eine passende SNI liefern, um die TLS-Prüfung zu bestehen und (*tls.Config).GetCertificate zum erneuten Laden der TLS-Dateien auszulösen.
Bei einem Zertifikat, dessen SAN-Feld keine Domänennamen, sondern nur IP-Adressen enthält
, wird jedoch *tls.ClientHelloInfo mit leerem Feld ServerName angefordert. Dadurch wird beim ersten TLS-Handshake kein erneutes Laden ausgelöst. Das ist problematisch, wenn abgelaufene Zertifikate im laufenden Betrieb ersetzt werden müssen.
Nun wird (*tls.Config).Certificates beim ersten TLS-Handshake des Clients leer angelegt, um zunächst (*tls.Config).GetCertificate auszulösen und anschließend die übrigen Zertifikate bei jeder neuen TLS-Verbindung zu laden, selbst wenn die SNI des Clients leer ist, etwa bei Zertifikaten, die nur IP-Adressen enthalten.
Hinweise zur Host-Zulassungsliste
Die Option etcd --host-whitelist legt die zulässigen Hostnamen aus HTTP-Clientanfragen fest. Die Richtlinie für Clientursprünge schützt ungesicherte etcd-Server vor „DNS Rebinding“
. Dabei kann eine beliebige Website einfach einen autorisierten DNS-Namen erstellen und ihn auf "localhost" oder eine andere Adresse verweisen lassen. Dadurch werden alle HTTP-Endpunkte eines auf "localhost" lauschenden etcd-Servers zugänglich und somit für DNS-Rebinding-Angriffe anfällig. Weitere Einzelheiten stehen in CVE-2018-5702
.
Die Richtlinie für Clientursprünge funktioniert wie folgt:
- Ist die Clientverbindung über HTTPS abgesichert, alle Hostnamen zulassen.
- Ist die Clientverbindung nicht abgesichert und
"HostWhitelist"nicht leer, nur HTTP-Anfragen zulassen, deren Host-Feld in der Zulassungsliste steht.
Für strengere Kontrolle wird diese Richtlinie unabhängig davon durchgesetzt, ob die Authentifizierung aktiviert ist.
Standardmäßig verwenden etcd --host-whitelist und embed.Config.HostWhitelist den Wert *, sodass alle Hostnamen zugelassen sind. Eine leere Zulassungsliste erlaubt ebenfalls alle Hostnamen. Bei der Angabe von Hostnamen werden Loopback-Adressen nicht automatisch hinzugefügt. Um Loopback-Schnittstellen zuzulassen, sie manuell in die Zulassungsliste aufnehmen (z. B. "localhost", "127.0.0.1" usw.).
Häufig gestellte Fragen
Warum erscheint bei der TLS-Clientauthentifizierung ein SSLv3 alert handshake failure?
Das Paket crypto/tls von golang prüft vor der Verwendung des öffentlichen Zertifikatsschlüssels dessen Verwendungszweck.
Damit dieser Schlüssel zur Clientauthentifizierung verwendet werden kann, muss bei seiner Erstellung clientAuth zu Extended Key Usage hinzugefügt werden.
Dazu wie folgt vorgehen:
Den folgenden Abschnitt zu openssl.cnf hinzufügen:
Bei der Zertifikatserstellung unbedingt mit der Option -extensions darauf verweisen:
Bei der Peerauthentifizierung mit Zertifikaten erscheint “certificate is valid for 127.0.0.1, not $MY_IP”
Sicherstellen, dass die Zertifikate mit der öffentlichen IP-Adresse des Mitglieds als Subject Name signiert werden. Das Werkzeug etcd-ca bietet beispielsweise die Option --ip= für seinen Befehl new-cert.
Das Zertifikat muss für den FQDN des Mitglieds im Subject Name signiert werden; die IP-Adresse über Subject Alternative Names (kurz IP SANs) ergänzen. Das Werkzeug etcd-ca bietet die Option --domain= für seinen Befehl new-cert; auch openssl kann dies
.
Verschlüsselt etcd Daten auf Datenträgern?
Nein. etcd verschlüsselt keine auf Datenträgern gespeicherten Schlüssel-Wert-Daten. Für die Verschlüsselung von in etcd gespeicherten Daten gibt es unter anderem folgende Möglichkeiten:
- Clientanwendungen die Daten ver- und entschlüsseln lassen
- Eine Funktion des zugrunde liegenden Speichersystems zur Verschlüsselung gespeicherter Daten verwenden, etwa dm-crypt
Warum erscheint die Protokollwarnung “directory X exist without recommended permission -rwx——”?
Wenn etcd bestimmte neue Verzeichnisse erstellt, setzt es deren Dateiberechtigungen auf 700, um unberechtigten Zugriff möglichst zu verhindern. Hat der Benutzer ein Verzeichnis bereits mit eigenen Einstellungen angelegt, verwendet etcd dieses vorhandene Verzeichnis und protokolliert eine Warnung, falls die Berechtigungen von 700 abweichen.
4 - Anleitung zur Clusterbildung
Überblick
Der statische Start eines etcd-Clusters setzt voraus, dass jedes Mitglied ein anderes Mitglied des Clusters kennt. In manchen Fällen sind die IP-Adressen der Clustermitglieder im Voraus noch nicht bekannt. Dann lässt sich der etcd-Cluster mithilfe eines Erkennungsdiensts initialisieren.
Sobald ein etcd-Cluster läuft, werden Mitglieder über die Laufzeitrekonfiguration hinzugefügt oder entfernt. Für ein besseres Verständnis des zugrunde liegenden Entwurfs empfehlen wir das Entwurfsdokument zur Laufzeitkonfiguration .
Diese Anleitung behandelt folgende Verfahren zur Initialisierung eines etcd-Clusters:
Mit jedem Verfahren wird ein etcd-Cluster aus drei Rechnern mit folgenden Eigenschaften erstellt:
| Name | Adresse | Hostname |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Statisch
Da Mitglieder, Adressen und Größe des Clusters vor dem Start bekannt sind, lässt sich mit der Option initial-cluster eine Offline-Konfiguration zur Initialisierung verwenden. Auf jedem Rechner werden entweder die folgenden Umgebungsvariablen oder Befehlszeilenoptionen gesetzt:
Die in initial-cluster angegebenen URLs sind die bekannt gegebenen Peer-URLs. Sie sollten also dem Wert von initial-advertise-peer-urls auf den jeweiligen Knoten entsprechen.
Werden zu Testzwecken mehrere Cluster mit derselben Konfiguration gestartet oder ein einzelner Cluster wiederholt erstellt und gelöscht, wird dringend empfohlen, jedem Cluster einen eindeutigen initial-cluster-token zuzuweisen. Dadurch kann etcd eindeutige Cluster- und Mitglieds-IDs erzeugen, selbst wenn die Konfigurationen ansonsten exakt übereinstimmen. Dies kann etcd vor Wechselwirkungen zwischen Clustern schützen, die diese beschädigen könnten.
etcd lauscht auf listen-client-urls
, um Clientverkehr anzunehmen. Ein etcd-Mitglied gibt die unter advertise-client-urls
angegebenen URLs an andere Mitglieder, Proxys und Clients weiter. Sicherstellen, dass die vorgesehenen Clients die advertise-client-urls erreichen können. Ein häufiger Fehler ist, advertise-client-urls auf localhost zu setzen oder den Standardwert beizubehalten, obwohl entfernte Clients etcd erreichen sollen.
Auf jedem Rechner etcd mit diesen Optionen starten:
Die mit --initial-cluster beginnenden Befehlszeilenparameter werden bei späteren Starts von etcd ignoriert. Nach der Erstinitialisierung können die Umgebungsvariablen oder Befehlszeilenoptionen entfernt werden. Muss die Konfiguration später geändert werden, etwa um Mitglieder hinzuzufügen oder zu entfernen, hilft die Anleitung zur Laufzeitkonfiguration
.
TLS
etcd unterstützt verschlüsselte Kommunikation über das TLS-Protokoll. TLS-Kanäle können sowohl den internen Clusterverkehr zwischen Peers als auch den Clientverkehr verschlüsseln. Dieser Abschnitt zeigt Beispiele zur Einrichtung eines Clusters mit TLS für Peers und Clients. Weitere Einzelheiten zur TLS-Unterstützung von etcd enthält die Sicherheitsanleitung .
Selbstsignierte Zertifikate
Ein Cluster mit selbstsignierten Zertifikaten verschlüsselt den Verkehr und authentifiziert seine Verbindungen. Für den Start eines solchen Clusters sollte jedes Mitglied ein eigenes Schlüsselpaar (member.crt, member.key) besitzen, das von einem gemeinsamen CA-Zertifikat des Clusters (ca.crt) signiert wurde, sowohl für Peer- als auch für Clientverbindungen. Zertifikate können nach dem etcd-Beispiel zur TLS-Einrichtung
erzeugt werden.
Auf jedem Rechner würde etcd mit diesen Optionen gestartet:
Automatisch erzeugte Zertifikate
Benötigt der Cluster verschlüsselte Kommunikation, aber keine authentifizierten Verbindungen, kann etcd so konfiguriert werden, dass es seine Schlüssel automatisch erzeugt. Bei der Initialisierung erstellt jedes Mitglied eigene Schlüssel anhand seiner bekannt gegebenen IP-Adressen und Hosts.
Auf jedem Rechner würde etcd mit diesen Optionen gestartet:
Fehlerfälle
Im folgenden Beispiel fehlt der neue Host in der Liste der aufgeführten Knoten. Handelt es sich um einen neuen Cluster, muss der Knoten zur Liste der anfänglichen Clustermitglieder hinzugefügt werden.
In diesem Beispiel soll ein Knoten (infra0) einer anderen Adresse (127.0.0.1:2380) zugeordnet werden als der in der Clusterliste aufgeführten (10.0.1.10:2380). Soll dieser Knoten auf mehreren Adressen lauschen, müssen alle Adressen in der Konfigurationsanweisung “initial-cluster” enthalten sein.
Ist ein Peer mit anderen Konfigurationsargumenten eingerichtet und versucht, diesem Cluster beizutreten, meldet etcd eine abweichende Cluster-ID und beendet sich.
Erkennung
In manchen Fällen sind die IP-Adressen der Cluster-Peers im Voraus noch nicht bekannt. Dies ist bei Cloud-Anbietern oder Netzwerken mit DHCP üblich. Dann wird anstelle einer statischen Konfiguration ein bestehender etcd-Cluster verwendet, um einen neuen zu initialisieren. Dieser Vorgang heißt „Erkennung“ (Discovery).
Für die Erkennung stehen zwei Verfahren zur Verfügung:
- etcd-Erkennungsdienst
- DNS-SRV-Einträge
etcd-Erkennung
Die Beispiele für den Erkennungsdienst in diesem Abschnitt beschreiben das ältere v2-Protokoll, das in etcd 3.7 entfernt wurde. Für einen neuen v3.7-Cluster v3-Discovery oder die statische Initialisierung bzw. DNS-SRV-Verfahren in dieser Anleitung verwenden.
Für ein besseres Verständnis des Protokollentwurfs empfehlen wir die Dokumentation zum Protokoll des Erkennungsdiensts.
Lebensdauer einer Erkennungs-URL
Eine Erkennungs-URL identifiziert einen eindeutigen etcd-Cluster. Für die Initialisierung eines neuen Clusters verwenden alle etcd-Instanzen gemeinsam eine neue Erkennungs-URL, statt eine vorhandene wiederzuverwenden.
Erkennungs-URLs sollten außerdem NUR für die Erstinitialisierung eines Clusters verwendet werden. Wie die Mitgliedschaft eines bereits laufenden Clusters geändert wird, beschreibt die Anleitung zur Laufzeitrekonfiguration .
Eigener etcd-Erkennungsdienst
Die Erkennung verwendet einen vorhandenen Cluster zur Initialisierung. Bei Verwendung eines privaten etcd-Clusters eine URL wie folgt erstellen:
Durch Setzen des Schlüssels size unter der URL wird eine Erkennungs-URL mit der erwarteten Clustergröße 3 erstellt.
In diesem Fall lautet die zu verwendende URL https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83. Die etcd-Mitglieder verwenden beim Start das Verzeichnis https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 zur Registrierung.
Für jedes Mitglied muss die Namensoption einen anderen Wert angeben. Hostname oder machine-id können eine gute Wahl sein. Andernfalls scheitert die Erkennung an doppelten Namen.
Nun etcd für jedes Mitglied mit den entsprechenden Optionen starten:
Dadurch registriert sich jedes Mitglied beim eigenen etcd-Erkennungsdienst. Sobald alle Rechner registriert sind, startet der Cluster.
Öffentlicher etcd-Erkennungsdienst
Ist kein bestehender Cluster verfügbar, den öffentlichen Erkennungsdienst unter discovery.etcd.io verwenden. Mit folgendem Befehl über den Endpunkt “new” eine private Erkennungs-URL erstellen:
Dies erstellt den Cluster mit einer anfänglichen Größe von 3 Mitgliedern. Wird keine Größe angegeben, gilt der Standardwert 3.
Für jedes Mitglied muss die Namensoption einen anderen Wert angeben, andernfalls scheitert die Erkennung an doppelten Namen. Hostname oder machine-id können eine gute Wahl sein.
Nun etcd für jedes Mitglied mit den entsprechenden Optionen starten:
Dadurch registriert sich jedes Mitglied beim Erkennungsdienst. Sobald alle Mitglieder registriert sind, startet der Cluster.
Mit der Umgebungsvariablen ETCD_DISCOVERY_PROXY lässt sich etcd anweisen, einen HTTP-Proxy für die Verbindung zum Erkennungsdienst zu verwenden.
Fehler- und Warnfälle
Fehler des Erkennungsservers
Warnungen
Diese harmlose Warnung zeigt an, dass die Erkennungs-URL auf diesem Rechner ignoriert wird.
DNS-Erkennung
DNS-SRV-Einträge
können als Erkennungsverfahren verwendet werden.
Mit der Option --discovery-srv lässt sich die DNS-Domäne festlegen, unter der die SRV-Einträge für die Erkennung liegen.
Mit --discovery-srv example.com werden DNS-SRV-Einträge in der angegebenen Reihenfolge gesucht:
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
Wird _etcd-server-ssl._tcp.example.com gefunden, versucht etcd die Initialisierung über TLS.
Damit Clients den etcd-Cluster finden, werden folgende DNS-SRV-Einträge in der angegebenen Reihenfolge gesucht:
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
Wird _etcd-client-ssl._tcp.example.com gefunden, versuchen Clients, über SSL/TLS mit dem etcd-Cluster zu kommunizieren.
Verwendet etcd TLS, muss der SRV-Eintrag für die Erkennung (z. B. example.com) zusammen mit dem Hostnamen im DNS-SAN des SSL-Zertifikats enthalten sein. Andernfalls scheitert die Clusterbildung mit Protokollmeldungen wie dieser:
Verwendet etcd TLS ohne eine eigene Zertifizierungsstelle, muss die Erkennungsdomäne (z. B. example.com) zur Domäne des SRV-Eintrags (z. B. infra1.example.com) passen. Dies erschwert Angriffe mit gefälschten SRV-Einträgen, die auf eine andere Domäne verweisen. Diese Domäne könnte zwar ein gültiges PKI-Zertifikat besitzen, aber von einem unbekannten Dritten kontrolliert werden.
Die Option -discovery-srv-name legt zusätzlich ein Suffix für den während der Erkennung abgefragten SRV-Namen fest.
Mit ihr lassen sich mehrere etcd-Cluster unter derselben Domäne unterscheiden.
Sind beispielsweise discovery-srv=example.com und -discovery-srv-name=foo gesetzt, werden folgende DNS-SRV-Abfragen gestellt:
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
DNS-SRV-Einträge erstellen
Den etcd-Cluster über DNS initialisieren
etcd-Clustermitglieder können Domänennamen oder IP-Adressen bekannt geben; die Initialisierung löst DNS-A-Einträge auf.
Seit 3.2 lehnen --listen-peer-urls und --listen-client-urls Domänennamen für die Bindung an Netzwerkschnittstellen ab (3.1 gibt Warnungen aus).
Die aufgelöste Adresse in --initial-advertise-peer-urls muss mit einer der aufgelösten Adressen der SRV-Ziele übereinstimmen. Das etcd-Mitglied liest die aufgelöste Adresse, um festzustellen, ob es zu dem in den SRV-Einträgen definierten Cluster gehört.
Der Cluster kann auch mit IP-Adressen anstelle von Domänennamen initialisiert werden:
Seit v3.1.0 (außer v3.2.9) authentifiziert der Server bei TLS-Konfiguration von etcd --discovery-srv=example.com Peers und Clients nur dann, wenn die angegebenen Zertifikate die Stammdomäne example.com als Eintrag im Feld Subject Alternative Name (SAN) enthalten. Siehe Hinweise zu DNS SRV
.
Gateway
Das etcd-Gateway ist ein einfacher TCP-Proxy, der Netzwerkdaten an den etcd-Cluster weiterleitet. Weitere Informationen bietet die Gateway-Anleitung .
Proxy
Frühere etcd-Versionen unterstützten über --proxy einen Proxymodus
nur für v2. Dieser Modus wurde entfernt und kann mit etcd 3.7 nicht verwendet werden. Für die v3-API den gRPC-Proxy
verwenden.
Historische v2-Proxy-Installationen beschreibt die Clusterdokumentation der etcd-Version 2.3 .
5 - etcd-Cluster als Kubernetes-StatefulSet ausführen
Im Folgenden wird gezeigt, wie die statische Initialisierung als Kubernetes-StatefulSet erfolgt.
Beispielmanifest
Dieses Manifest enthält einen Service und ein StatefulSet zur Bereitstellung eines statischen etcd-Clusters in Kubernetes.
Wird der Inhalt des Manifests in eine Datei namens etcd.yaml kopiert, lässt es sich mit diesem Befehl auf einen Cluster anwenden.
Nach dem Anwenden warten, bis die Pods bereit sind.
Der im Beispiel verwendete Container enthält etcdctl, das direkt innerhalb der Pods aufgerufen werden kann.
Für eine Bereitstellung mit einem selbstsignierten Zertifikat die auskommentierten Konfigurationsüberschriften beginnend mit ## TLS beachten; dort stehen Werte, deren Kommentierung aufgehoben werden kann. Ein Abschnitt weiter unten enthält zusätzliche Anweisungen zum Erzeugen eines Zertifikats mit cert-manager.
Zertifikate erzeugen
In diesem Abschnitt wird Helm verwendet, um einen Operator namens cert-manager zu installieren.
Ist cert-manager im Cluster installiert, lassen sich dort selbstsignierte Zertifikate erzeugen. Die erzeugten Zertifikate werden in einem Secret-Objekt abgelegt, das als Dateien in Container eingebunden werden kann.
Dies ist der Helm-Befehl zur Installation von cert-manager.
Dies ist eine beispielhafte ClusterIssuer-Konfiguration zum Erzeugen selbstsignierter Zertifikate.
Dieses Manifest erzeugt Certificate-Objekte für die Client- und Serverzertifikate und verweist dabei auf den ClusterIssuer “selfsigned”. Die dnsNames sollten eine vollständige Liste gültiger Hostnamen für die von cert-manager erzeugten Zertifikate enthalten.
6 - etcd-Cluster in Containern ausführen
Die folgende Anleitung zeigt, wie etcd mit Docker über die statische Initialisierung ausgeführt wird.
Docker
Um die etcd-API für Clients außerhalb des Docker-Hosts bereitzustellen, die IP-Adresse des Container-Hosts verwenden. Weitere Informationen zum Ermitteln der IP-Adresse bietet docker inspect
. Alternativ dem Befehl docker run die Option --net=host übergeben, damit der Container keinen separaten Netzwerkstack erhält.
etcd mit einem einzelnen Knoten ausführen
Bei der Konfiguration von etcd die IP-Adresse des Hosts verwenden:
Ein Docker-Volume zur Speicherung der etcd-Daten konfigurieren:
Die neueste Version von etcd ausführen (zum Zeitpunkt der Erstellung dieses Dokuments v3.7.2):
Das Clustermitglied auflisten:
Einen etcd-Cluster mit 3 Knoten ausführen
etcdctl mit API-Version 3 ausführen:
Physische Hardware
Für die Bereitstellung eines etcd-Clusters mit 3 Knoten auf physischer Hardware können die Beispiele im baremetal-Repository hilfreich sein.
Ein Zertifikatsvolume einhängen
Der veröffentlichte etcd-Container enthält keine standardmäßigen Stammzertifikate. Um HTTPS mit Zertifikaten zu verwenden, denen eine Stammzertifizierungsstelle vertraut (z. B. für die Diensterkennung), ein Zertifikatsverzeichnis in den etcd-Container einhängen:
Der folgende rkt-Befehl ist ein historisches Beispiel. Seine v2-Discovery-Konfiguration ist mit etcd 3.7 nicht kompatibel; für aktuelle Bereitstellungen die Beispiele zur statischen Initialisierung oben verwenden.
Das folgende Docker-Beispiel verwendet das oben gesetzte NODE1 und zeigt das Einhängen eines Zertifikatsvolumes mit statischer Initialisierung.
7 - Ausfallarten
In großen Rechnerinstallationen treten häufig Ausfälle auf. Ein Rechner fällt aus, wenn seine Hardware oder Software nicht ordnungsgemäß funktioniert. Bei Stromausfällen oder Netzwerkproblemen können mehrere Rechner gleichzeitig ausfallen. Auch mehrere Ausfallarten können zugleich auftreten; es ist nahezu unmöglich, alle denkbaren Ausfallszenarien aufzuzählen.
Dieser Abschnitt ordnet Ausfälle nach Arten ein und erläutert, wie etcd sie toleriert. Die meisten, wenn nicht alle Benutzer können einen konkreten Ausfall einer dieser Arten zuordnen. Um auf seltene oder nicht behebbare Ausfälle vorbereitet zu sein, stets Backups des etcd-Clusters erstellen.
Ausfall einer Minderheit der Follower
Wenn Follower ausfallen, aber weniger als die Hälfte aller Clustermitglieder ausgefallen ist und der Leader weiterhin verfügbar bleibt, kann der etcd-Cluster weiterhin Anfragen annehmen und ohne größere Beeinträchtigung weiterarbeiten. Beispielsweise beeinträchtigt der Ausfall von zwei Followern den Betrieb eines etcd-Clusters mit fünf Mitgliedern nicht. Clients verlieren jedoch die Verbindung zu den ausgefallenen Mitgliedern. Clientbibliotheken sollten solche Unterbrechungen bei Leseanfragen vor Benutzern verbergen, indem sie automatisch Verbindungen zu anderen Mitgliedern herstellen. Betreiber sollten damit rechnen, dass diese neuen Verbindungen die Systemlast auf den anderen Mitgliedern erhöhen.
Ausfall des Leaders
Wenn ein Leader ausfällt, wählt der etcd-Cluster automatisch einen neuen Leader. Diese Wahl erfolgt nicht unmittelbar nach dem Ausfall. Sie dauert ungefähr so lange wie das Wahlzeitlimit, da die Ausfallerkennung auf Zeitüberschreitungen beruht.
Während der Leaderwahl kann der Cluster keine Schreiboperationen verarbeiten. Schreibanfragen, die während der Wahl eingehen, werden zur Verarbeitung in eine Warteschlange gestellt, bis ein neuer Leader gewählt ist.
Schreiboperationen, die bereits an den alten Leader gesendet, aber noch nicht festgeschrieben wurden, können verloren gehen. Der neue Leader kann alle nicht festgeschriebenen Einträge des vorherigen Leaders überschreiben. Aus Benutzersicht können einige Schreibanfragen nach der Wahl eines neuen Leaders mit einer Zeitüberschreitung enden. Bereits festgeschriebene Schreiboperationen gehen jedoch niemals verloren.
Der neue Leader verlängert automatisch die Zeitlimits aller Leases. Dieser Mechanismus stellt sicher, dass eine Lease nicht vor Ablauf ihrer gewährten TTL verfällt, selbst wenn sie vom alten Leader gewährt wurde.
Ausfall einer Mehrheit
Wenn die Mehrheit der Clustermitglieder ausfällt, fällt der etcd-Cluster aus und kann keine weiteren Schreiboperationen annehmen.
Der etcd-Cluster kann sich erst von einem Mehrheitsausfall erholen, wenn die Mehrheit der Mitglieder wieder verfügbar ist. Kann eine Mehrheit der Mitglieder nicht wieder online gehen, muss der Betreiber eine Disaster Recovery einleiten, um den Cluster wiederherzustellen.
Sobald eine Mehrheit der Mitglieder wieder funktioniert, wählt der etcd-Cluster automatisch einen neuen Leader und kehrt in einen intakten Zustand zurück. Der neue Leader verlängert automatisch die Zeitlimits aller Leases. Dieser Mechanismus stellt sicher, dass keine Lease wegen serverseitiger Nichtverfügbarkeit abläuft.
Netzwerkpartition
Eine Netzwerkpartition ähnelt dem Ausfall einer Minderheit der Follower oder dem Ausfall des Leaders. Sie teilt den etcd-Cluster in zwei Teile: einen mit einer Mehrheit und einen mit einer Minderheit der Mitglieder. Die Mehrheitsseite bildet den verfügbaren Cluster; die Minderheitsseite ist nicht verfügbar. In etcd gibt es kein „Split Brain“, da Clustermitglieder ausdrücklich hinzugefügt oder entfernt werden und jede solche Änderung von der aktuellen Mehrheit der Mitglieder genehmigt wird.
Befindet sich der Leader auf der Mehrheitsseite, entspricht der Ausfall aus Sicht der Mehrheit dem Ausfall einer Minderheit der Follower. Befindet er sich auf der Minderheitsseite, entspricht dies einem Leaderausfall. Der Leader auf der Minderheitsseite tritt zurück, und die Mehrheitsseite wählt einen neuen Leader.
Sobald die Netzwerkpartition aufgehoben ist, erkennt die Minderheitsseite automatisch den Leader der Mehrheitsseite an und stellt ihren Zustand wieder her.
Ausfall während der Initialisierung
Die Initialisierung eines Clusters ist nur erfolgreich, wenn alle erforderlichen Mitglieder erfolgreich starten. Tritt während der Initialisierung ein Fehler auf, die Datenverzeichnisse aller Mitglieder entfernen und den Cluster mit einem neuen cluster-token oder einem neuen Discovery-Token erneut initialisieren.
Natürlich lässt sich ein während der Initialisierung ausgefallener Cluster ebenso wie ein laufender Cluster wiederherstellen. Da aber keine Daten wiederherzustellen sind, kostet seine Wiederherstellung fast immer mehr Zeit und Ressourcen als die Initialisierung eines neuen Clusters.
8 - Recovery nach einem Totalausfall
etcd ist dafür ausgelegt, Rechnerausfälle zu verkraften. Ein etcd-Cluster erholt sich automatisch von vorübergehenden Ausfällen (z. B. Neustarts von Rechnern) und toleriert bei N Mitgliedern bis zu (N-1)/2 dauerhafte Ausfälle. Fällt ein Mitglied dauerhaft aus, etwa durch einen Hardwaredefekt oder eine Datenbeschädigung auf dem Datenträger, verliert es den Zugriff auf den Cluster. Verliert der Cluster dauerhaft mehr als (N-1)/2 Mitglieder, kommt es zum Totalausfall: Das Quorum geht unwiederbringlich verloren. Ohne Quorum kann der Cluster keinen Konsens mehr erreichen und daher keine weiteren Aktualisierungen annehmen.
Für die Recovery nach einem Totalausfall bietet etcd v3 Snapshot- und Wiederherstellungsfunktionen, mit denen sich der Cluster ohne Verlust von v3-Schlüsseldaten neu erstellen lässt. Zur Wiederherstellung von v2-Schlüsseln siehe das v2-Administrationshandbuch .
Einen Snapshot des Schlüsselraums erstellen
Für die Wiederherstellung eines Clusters wird zunächst ein Snapshot des Schlüsselraums eines etcd-Mitglieds benötigt. Ein Snapshot kann entweder mit etcdctl snapshot save von einem laufenden Mitglied erstellt oder durch Kopieren der Datei member/snap/db aus einem etcd-Datenverzeichnis gewonnen werden. Der folgende Befehl speichert beispielsweise einen Snapshot des von $ENDPOINT bereitgestellten Schlüsselraums in der Datei snapshot.db:
Bei einem Snapshot aus der Datei member/snap/db können Daten verloren gehen, die noch nicht in diese Datei geschrieben wurden, sich aber bereits im Ordner wal (Write-Ahead-Log) befinden.
Status eines Snapshots
Mit dem Befehl etcdutl snapshot status lässt sich ermitteln, welche Revision und welchen Hashwert ein Snapshot enthält:
Einen Cluster wiederherstellen
Revisionsunterschied
Bei der Wiederherstellung eines Clusters können bestehende Clients feststellen, dass die Revision um viele Hundert oder Tausend zurückspringt. Ein Snapshot enthält nämlich nur die Datenhistorie bis zum Zeitpunkt seiner Erstellung, während der aktuelle Zustand bereits weiter fortgeschritten sein kann.
Dies ist besonders beim Betrieb von Kubernetes mit etcd problematisch. Dort können Controller und Operatoren sogenannte informers verwenden, die als lokale Caches dienen und über Watches über Aktualisierungen benachrichtigt werden. Die Wiederherstellung auf eine ältere Revision aktualisiert diese Caches möglicherweise nicht korrekt und kann dadurch unvorhersehbares und inkonsistentes Verhalten der Controller verursachen.
Bei der Wiederherstellung aus einem Snapshot wird dringend empfohlen, die nachfolgend beschriebene „Revisionserhöhung“ zu verwenden, wenn bekannte Nutzer der Watch-API vorhanden sind, lokale Kopien von etcd-Daten zwischengespeichert werden oder generell Kubernetes eingesetzt wird.
Aus einem Snapshot wiederherstellen
Zur Wiederherstellung eines Clusters genügt eine einzelne Snapshot-Datei “db”. Eine Clusterwiederherstellung mit etcdutl snapshot restore erstellt neue etcd-Datenverzeichnisse; alle Mitglieder sollten denselben Snapshot verwenden. Bei der Wiederherstellung werden einige Snapshot-Metadaten überschrieben, insbesondere die Mitglieds-ID und die Cluster-ID. Das Mitglied verliert damit seine bisherige Identität. Dieses Überschreiben verhindert, dass das neue Mitglied versehentlich einem bestehenden Cluster beitritt. Um einen Cluster aus einem Snapshot zu starten, muss die Wiederherstellung daher einen neuen logischen Cluster erstellen.
Eine einfache Wiederherstellung lässt sich wie folgt ausführen:
Integritätsprüfungen
Die Integrität eines Snapshots kann bei der Wiederherstellung optional geprüft werden. Ein mit etcdctl snapshot save erstellter Snapshot enthält einen Integritätshash, den etcdutl snapshot restore prüft. Wird der Snapshot aus dem Datenverzeichnis kopiert, fehlt dieser Hash; die Wiederherstellung ist dann nur mit --skip-hash-check möglich.
Mit Revisionserhöhung wiederherstellen
Damit die Revisionen nach einer Wiederherstellung niemals zurückgehen, kann die Option --bump-revision angegeben werden. Sie nimmt eine 64-Bit-Ganzzahl entgegen, die angibt, wie viele Revisionen zur aktuellen Revision des Snapshots addiert werden sollen. Da jeder Schreibzugriff auf etcd die Revision um eins erhöht, kann eine Erhöhung um 1'000'000'000 einen eine Woche alten Snapshot abdecken, sofern etcd weniger als 1500 Schreibzugriffe pro Sekunde verarbeitet.
Im Zusammenhang mit Kubernetes-Controllern ist es wichtig, mit --mark-compacted auch alle Revisionen einschließlich der Erhöhung als kompaktiert zu markieren. Dies stellt sicher, dass alle Watches beendet werden und etcd keine Anfragen zu Revisionen beantwortet, die nach der Snapshot-Erstellung entstanden sind. Dadurch werden die Informer-Caches effektiv ungültig.
Ein vollständiger Aufruf kann so aussehen:
Mit aktualisierter Mitgliedschaft wiederherstellen
Die Mitglieder eines etcd-Clusters werden in etcd selbst gespeichert und über den Raft-Konsensalgorithmus verwaltet. Ist das Quorum vollständig verloren, kann neu entschieden werden, wo und wie der neue Cluster gebildet wird, beispielsweise mit vollständig neuen Mitgliedern.
Bei der Wiederherstellung aus einem Snapshot kann die neue Mitgliedschaft wie folgt direkt in den Datenspeicher übernommen werden:
Dies stellt sicher, dass sich der neu aufgebaute Cluster ausschließlich mit den anderen wiederhergestellten Mitgliedern mit dem angegebenen Token verbindet und nicht mit älteren Mitgliedern, die möglicherweise noch laufen und Verbindungen aufzubauen versuchen.
Alternativ kann beim Start von etcd --force-new-cluster angegeben werden, um die Clustermitgliedschaft zu überschreiben und vorhandene Anwendungsdaten beizubehalten. Davon wird jedoch dringend abgeraten, da dies eine Panic auslöst, wenn andere Mitglieder des vorherigen Clusters noch laufen. Unbedingt regelmäßig Snapshots speichern.
End-2-End-Beispiel
Einen Snapshot von einem laufenden Cluster erstellen:
Aufbauend auf dem vorherigen Beispiel werden im Folgenden neue etcd-Datenverzeichnisse (m1.etcd, m2.etcd, m3.etcd) für einen Cluster mit drei Mitgliedern erstellt:
Anschließend etcd mit den neuen Datenverzeichnissen starten:
Der wiederhergestellte etcd-Cluster sollte nun verfügbar sein und den Schlüsselraum aus dem Snapshot bereitstellen.
Ab etcd v3.6 kann etcdctl nur zum Erstellen eines Snapshots der Daten verwendet werden; zur Wiederherstellung aus einem Snapshot dient etcdutl. Wird --data-dir nicht angegeben, ist der Standardwert von --data-dir gleich <name>.etcd, wobei <name> dem Wert von --name entspricht. Wurde beispielsweise --data-dir nicht angegeben und heißen die Mitglieder m1, m2 und m3, lauten die --data-dir-Verzeichnisse m1.etcd, m2.etcd und m3.etcd.
9 - etcd-Gateway
Was ist das etcd-Gateway?
Das etcd-Gateway ist ein einfacher TCP-Proxy, der Netzwerkdaten an den etcd-Cluster weiterleitet. Es ist zustandslos und transparent: Es untersucht weder Clientanfragen noch greift es in Clusterantworten ein. Es terminiert keine TLS-Verbindungen, führt keine TLS-Handshakes im Namen seiner Clients durch und prüft nicht, ob eine Verbindung abgesichert ist.
Das Gateway unterstützt mehrere etcd-Serverendpunkte und verwendet ein einfaches Round-Robin-Verfahren. Es leitet nur an verfügbare Endpunkte weiter und verbirgt Ausfälle vor seinen Clients. Weitere Wiederholungsstrategien, etwa gewichtetes Round-Robin, können künftig unterstützt werden.
Wann das etcd-Gateway sinnvoll ist
Jede Anwendung, die auf etcd zugreift, muss zunächst die Adresse eines Clientendpunkts des etcd-Clusters kennen. Greifen mehrere Anwendungen auf demselben Server auf denselben etcd-Cluster zu, muss trotzdem jede Anwendung dessen bekannt gegebene Clientendpunkte kennen. Wird der etcd-Cluster so umkonfiguriert, dass er andere Endpunkte hat, muss möglicherweise auch jede Anwendung ihre Endpunktliste aktualisieren. Diese umfassende Umkonfiguration ist aufwendig und fehleranfällig.
Das etcd-Gateway löst dieses Problem, indem es einen stabilen lokalen Endpunkt bereitstellt. In einer typischen Konfiguration läuft auf jedem Rechner ein Gateway, das auf einer lokalen Adresse lauscht; jede etcd-Anwendung verbindet sich mit ihrem lokalen Gateway. Dadurch muss nur das Gateway seine Endpunkte aktualisieren, statt jede einzelne Anwendung anzupassen.
Um Änderungen der Clusterendpunkte automatisch weiterzugeben, läuft das etcd-Gateway also auf jedem Rechner, auf dem mehrere Anwendungen auf denselben etcd-Cluster zugreifen.
Wann das etcd-Gateway nicht sinnvoll ist
- Leistungssteigerung
Das Gateway ist nicht dafür ausgelegt, die Leistung eines etcd-Clusters zu verbessern. Es bietet weder Caching noch die Zusammenführung von Watches oder die Bündelung von Anfragen. Das etcd-Team entwickelt einen Caching-Proxy, der die Skalierbarkeit von Clustern verbessern soll.
- Betrieb auf einem Clusterverwaltungssystem
Fortgeschrittene Clusterverwaltungssysteme wie Kubernetes unterstützen Diensterkennung von Haus aus. Anwendungen können über einen DNS-Namen oder eine vom System verwaltete virtuelle IP-Adresse auf einen etcd-Cluster zugreifen. Beispielsweise entspricht kube-proxy dem etcd-Gateway.
Das etcd-Gateway starten
Als Beispiel dient ein etcd-Cluster mit folgenden statischen Endpunkten:
| Name | Adresse | Hostname | Port |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
Das etcd-Gateway mit folgendem Befehl für diese statischen Endpunkte starten:
Alternativ bei einer Diensterkennung über DNS die folgenden DNS-SRV-Einträge betrachten:
Das etcd-Gateway mit folgendem Befehl starten, damit es die Endpunkte aus den DNS-SRV-Einträgen abruft:
Konfigurationsoptionen
etcd-Cluster
–endpoints
- Kommagetrennte Liste von etcd-Serverzielen, an die Clientverbindungen weitergeleitet werden.
- Standard:
127.0.0.1:2379 - Der Port muss enthalten sein.
- Ungültiges Beispiel:
https://127.0.0.1:2379(das Gateway terminiert TLS nicht). Das Gateway prüft weder das HTTP-Schema noch die Anfragen; es leitet Anfragen lediglich an die angegebenen Endpunkte weiter.
–discovery-srv
- DNS-Domäne, über die Clusterendpunkte mithilfe von SRV-Einträgen initialisiert werden.
- Standard: (nicht gesetzt)
Netzwerk
–listen-addr
- Schnittstelle und Port, an die gebunden wird, um Clientanfragen anzunehmen.
- Standard:
127.0.0.1:23790
–retry-delay
- Wartezeit vor einem erneuten Verbindungsversuch zu ausgefallenen Endpunkten.
- Standard: 1m0s
- Ungültiges Beispiel: “123” (das Format erwartet eine Zeiteinheit)
Sicherheit
–insecure-discovery
- SRV-Einträge akzeptieren, die unsicher oder für Man-in-the-Middle-Angriffe anfällig sind.
- Standard:
false
–trusted-ca-file
- Pfad zur TLS-CA-Datei des Clients für den etcd-Cluster, um die bei der SRV-Erkennung zurückgegebenen Endpunkte zu überprüfen. Sie wird NUR zur Authentifizierung der gefundenen Endpunkte verwendet, nicht zum Aufbau von Verbindungen für die Datenübertragung. Das Gateway terminiert niemals TLS-Verbindungen und erstellt keine TLS-Verbindungen im Namen seiner Clients.
- Standard: (nicht gesetzt)
10 - gRPC-Proxy
Der gRPC-Proxy ist ein zustandsloser etcd-Reverse-Proxy auf der gRPC-Schicht (L7). Er soll die gesamte Verarbeitungslast auf dem zentralen etcd-Cluster verringern. Für horizontale Skalierbarkeit führt er Watch- und Lease-API-Anfragen zusammen. Um den Cluster vor missbräuchlich arbeitenden Clients zu schützen, speichert er Anfragen für Schlüsselbereiche zwischen.
Der gRPC-Proxy unterstützt mehrere etcd-Serverendpunkte. Beim Start wählt er zufällig einen davon aus. Dieser Endpunkt bedient alle Anfragen, bis der Proxy einen Endpunktausfall erkennt. Dann wechselt der gRPC-Proxy zu einem anderen Endpunkt, sofern verfügbar, um Ausfälle vor seinen Clients zu verbergen. Weitere Wiederholungsstrategien, etwa gewichtetes Round-Robin, können künftig unterstützt werden.
Skalierbare Watch-API
Der gRPC-Proxy führt mehrere Client-Watcher (c-watchers) für denselben Schlüssel oder Bereich zu einem einzelnen Watcher (s-watcher) zusammen, der mit einem etcd-Server verbunden ist. Der Proxy verteilt alle Ereignisse des s-watcher an seine c-watchers.
Wenn N Clients denselben Schlüssel beobachten, kann ein gRPC-Proxy die Watch-Last auf dem etcd-Server von N auf 1 reduzieren. Durch den Einsatz mehrerer gRPC-Proxys lässt sich die Serverlast weiter verteilen.
Im folgenden Beispiel beobachten drei Clients den Schlüssel A. Der gRPC-Proxy führt die drei Watcher zusammen und erstellt einen einzelnen Watcher am etcd-Server.
Einschränkungen
Um mehrere Client-Watcher effizient zu einem einzelnen Watcher zusammenzuführen, ordnet der gRPC-Proxy neue c-watchers nach Möglichkeit einem vorhandenen s-watcher zu. Dieser gemeinsame s-watcher kann wegen Netzwerkverzögerungen oder gepufferter, noch nicht zugestellter Ereignisse hinter dem etcd-Server zurückliegen. Ist keine Watch-Revision angegeben, garantiert der gRPC-Proxy nicht, dass der c-watcher bei der neuesten Revision des Speichers zu beobachten beginnt. Beobachtet ein Client beispielsweise direkt über einen etcd-Server mit Revision 1000, beginnt dieser Watcher bei Revision 1000. Bei einem Watch über den gRPC-Proxy kann der Client hingegen bereits bei Revision 990 beginnen.
Ähnliche Einschränkungen gelten für den Abbruch. Beim Abbrechen eines Watchers kann die Revision des etcd-Servers höher sein als die Revision in der Abbruchantwort.
Diese beiden Einschränkungen sollten in den meisten Anwendungsfällen keine Probleme verursachen. Künftig kann es zusätzliche Optionen geben, die den Watcher zwingen, den gRPC-Proxy zu umgehen, um genauere Revisionen in Antworten zu erhalten.
Skalierbare Lease-API
Um seine Leases aufrechtzuerhalten, muss ein Client mindestens einen gRPC-Stream zu einem etcd-Server aufbauen und darüber regelmäßig Heartbeats senden. Bei einer etcd-Arbeitslast mit umfangreicher Lease-Aktivität über viele Clients hinweg können diese Streams zu einer übermäßigen CPU-Auslastung beitragen. Um die Gesamtzahl der Streams auf dem zentralen Cluster zu verringern, unterstützt der Proxy die Zusammenführung von Lease-Streams.
Wenn N Clients Leases aktualisieren, reduziert ein einzelner gRPC-Proxy die Stream-Last auf dem etcd-Server von N auf 1. Zusätzliche gRPC-Proxys können die Streams weiter auf mehrere Proxys verteilen.
Im folgenden Beispiel aktualisieren drei Clients drei unabhängige Leases (L1, L2 und L3). Der gRPC-Proxy führt die drei Lease-Streams der Clients (c-streams) zu einem einzelnen Stream zur Aufrechterhaltung von Leases (s-stream) zusammen, der mit einem etcd-Server verbunden ist. Der Proxy leitet die clientseitigen Lease-Heartbeats von den c-streams an den s-stream weiter und sendet die Antworten anschließend an die jeweiligen c-streams zurück.
Schutz vor missbräuchlich arbeitenden Clients
Der gRPC-Proxy speichert Antworten auf Anfragen zwischen, sofern dies keine Konsistenzanforderungen verletzt. Dadurch kann er den etcd-Server vor missbräuchlich arbeitenden Clients schützen, die Anfragen in engen for-Schleifen senden.
Den etcd-gRPC-Proxy starten
Als Beispiel dient ein etcd-Cluster mit folgenden statischen Endpunkten:
| Name | Adresse | Hostname |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Den etcd-gRPC-Proxy mit folgendem Befehl für diese statischen Endpunkte starten:
Der etcd-gRPC-Proxy startet und lauscht auf Port 2379. Er leitet Clientanfragen an einen der drei oben angegebenen Endpunkte weiter.
Anfragen über den Proxy senden:
Synchronisierung der Clientendpunkte und Namensauflösung
Der Proxy kann seine Endpunkte zur Diensterkennung registrieren, indem er an einen benutzerdefinierten Endpunkt schreibt. Dies dient zwei Zwecken. Erstens können Clients ihre Endpunkte mit einer Menge von Proxyendpunkten synchronisieren, um Hochverfügbarkeit zu erreichen. Zweitens stellt dies Endpunkte für die gRPC-Namensauflösung von etcd bereit.
Proxys durch Angabe eines benutzerdefinierten Präfixes registrieren:
Der Proxy führt bei der Abfrage der Mitgliederliste alle seine Mitglieder auf:
Dadurch können Clients Proxyendpunkte automatisch über Sync erkennen:
Wird ein Proxy ohne Resolver-Präfix konfiguriert,
gibt die Mitgliederlisten-API des grpc-proxy dessen eigene advertise-client-url zurück:
Namensräume
Angenommen, eine Anwendung erwartet die volle Kontrolle über den gesamten Schlüsselraum, der etcd-Cluster wird aber mit anderen Anwendungen geteilt. Damit alle Anwendungen ohne gegenseitige Beeinträchtigung laufen können, kann der Proxy den etcd-Schlüsselraum so aufteilen, dass Clients scheinbar auf den vollständigen Schlüsselraum zugreifen. Wird dem Proxy die Option --namespace übergeben, werden alle eingehenden Clientanfragen so umgeschrieben, dass die Schlüssel ein benutzerdefiniertes Präfix erhalten. Zugriffe auf den etcd-Cluster erfolgen unter diesem Präfix; der Proxy entfernt es aus den Antworten. Für den Client wirkt es, als gäbe es überhaupt kein Präfix.
Um einen Namensraum für einen Proxy festzulegen, ihn mit --namespace starten:
Bei Zugriffen auf den Proxy wird nun im etcd-Cluster transparent das Präfix vorangestellt:
TLS-Terminierung
Der gRPC-Proxy kann TLS zu einem abgesicherten etcd-Cluster terminieren und dafür einen unverschlüsselten lokalen Endpunkt bereitstellen.
Zum Ausprobieren einen Ein-Mitglied-Cluster von etcd mit HTTPS für Clients starten:
Prüfen, ob der Clientport HTTPS bereitstellt:
Anschließend einen gRPC-Proxy auf localhost:12379 starten, der sich mithilfe der Clientzertifikate mit dem etcd-Endpunkt https://localhost:2379 verbindet:
Abschließend die TLS-Terminierung testen, indem über HTTP ein Schlüssel in den Proxy geschrieben wird:
Metriken und Zustandsprüfung
Der gRPC-Proxy stellt für die durch --endpoints definierten etcd-Mitglieder die Endpunkte /health und Prometheus /metrics bereit. Alternativ lässt sich mit der Option --metrics-addr eine zusätzliche URL definieren, die sowohl auf /metrics als auch auf /health antwortet.
Bekanntes Problem
Die Hauptschnittstelle des Proxys bedient sowohl HTTP2 als auch HTTP/1.1. Ist der Proxy wie im obigen Beispiel mit TLS eingerichtet, muss bei Anfragen eines Clients wie cURL an die lauschende Schnittstelle ausdrücklich HTTP/1.1 als Protokoll eingestellt werden, damit /metrics oder /health zurückgegeben werden. Die mit --metrics-addr eingerichtete zweite Schnittstelle hat diese Anforderung nicht.
11 - Hardwareempfehlungen
etcd läuft für Entwicklung und Tests in der Regel auch mit begrenzten Ressourcen gut; die Entwicklung mit etcd auf einem Laptop oder einer günstigen Cloud-Instanz ist üblich. Für den produktiven Betrieb von etcd-Clustern helfen jedoch einige Hardwarehinweise bei der sachgerechten Verwaltung. Diese Empfehlungen sind keine starren Regeln, sondern ein guter Ausgangspunkt für eine robuste Produktivinstallation. Wie immer sollten Installationen vor dem produktiven Einsatz mit simulierten Arbeitslasten getestet werden.
CPUs
Nur wenige etcd-Installationen benötigen viel CPU-Leistung. Typische Cluster kommen für einen reibungslosen Betrieb mit zwei bis vier Kernen aus. Stark ausgelastete etcd-Installationen, die Tausende von Clients oder Zehntausende von Anfragen pro Sekunde bedienen, sind meist durch die CPU begrenzt, da etcd Anfragen aus dem Arbeitsspeicher bedienen kann. Solche Installationen benötigen gewöhnlich acht bis sechzehn dedizierte Kerne.
Arbeitsspeicher
etcd hat einen vergleichsweise geringen Speicherbedarf, seine Leistung hängt aber dennoch von ausreichend Arbeitsspeicher ab. Ein etcd-Server speichert Schlüssel-Wert-Daten umfassend zwischen und verwendet den größten Teil des übrigen Speichers zur Verwaltung von Watchern. Typischerweise reichen 8GB aus. Für große Installationen mit Tausenden von Watchern und Millionen von Schlüsseln entsprechend 16GB bis 64GB Arbeitsspeicher vorsehen.
Datenträger
Schnelle Datenträger sind der wichtigste Faktor für Leistung und Stabilität einer etcd-Installation.
Ein langsamer Datenträger erhöht die Latenz von etcd-Anfragen und kann die Clusterstabilität beeinträchtigen. Da das Konsensprotokoll von etcd auf der dauerhaften Speicherung von Metadaten in einem Log beruht, muss eine Mehrheit der Clustermitglieder jede Anfrage auf den Datenträger schreiben. Zusätzlich schreibt etcd seinen Zustand schrittweise als Checkpoints auf den Datenträger, um dieses Log kürzen zu können. Dauern diese Schreiboperationen zu lange, können Heartbeats ihr Zeitlimit überschreiten und eine Wahl auslösen, was die Clusterstabilität beeinträchtigt. Ob ein Datenträger für etcd schnell genug ist, lässt sich im Allgemeinen mit einem Benchmarkwerkzeug wie fio ermitteln. Ein Beispiel steht hier .
etcd reagiert sehr empfindlich auf die Schreiblatenz von Datenträgern. Typischerweise sind 50 sequenzielle IOPS erforderlich (z. B. eine Festplatte mit 7200 RPM). Für stark ausgelastete Cluster werden 500 sequenzielle IOPS empfohlen (z. B. eine typische lokale SSD oder ein leistungsfähiges virtualisiertes Blockgerät). Die meisten Cloud-Anbieter veröffentlichen parallele statt sequenzieller IOPS; die veröffentlichten parallelen IOPS können 10x höher als die sequenziellen IOPS sein. Um die tatsächlichen sequenziellen IOPS zu messen, empfiehlt sich ein Datenträger-Benchmarkwerkzeug wie diskbench oder fio .
etcd benötigt nur eine mäßige Datenträgerbandbreite. Eine höhere Bandbreite verkürzt aber die Wiederherstellungszeit, wenn ein ausgefallenes Mitglied zum Cluster aufschließen muss. Typischerweise lassen sich mit 10MB/s 100MB Daten innerhalb von 15 Sekunden wiederherstellen. Für große Cluster werden mindestens 100MB/s empfohlen, um 1GB Daten innerhalb von 15 Sekunden wiederherzustellen.
Für die Speicherung von etcd nach Möglichkeit eine SSD verwenden. Eine SSD bietet gewöhnlich niedrigere und weniger schwankende Schreiblatenzen als eine rotierende Festplatte und verbessert damit Stabilität und Zuverlässigkeit von etcd. Bei rotierenden Festplatten die schnellstmöglichen Modelle wählen (15,000 RPM). RAID 0 ist ebenfalls ein wirksames Mittel, die Datenträgergeschwindigkeit zu erhöhen, sowohl bei Festplatten als auch bei SSDs. Bei mindestens drei Clustermitgliedern sind RAID-Varianten mit Spiegelung und/oder Parität nicht erforderlich; die konsistente Replikation von etcd sorgt bereits für Hochverfügbarkeit.
Netzwerk
etcd-Installationen mit mehreren Mitgliedern profitieren von einem schnellen und zuverlässigen Netzwerk. Da etcd sowohl Konsistenz als auch Partitionstoleranz gewährleisten muss, führt ein unzuverlässiges Netzwerk mit Unterbrechungen durch Partitionen zu schlechter Verfügbarkeit. Niedrige Latenz ermöglicht eine schnelle Kommunikation zwischen etcd-Mitgliedern. Hohe Bandbreite kann die Wiederherstellungszeit eines ausgefallenen Mitglieds verkürzen. Für gängige etcd-Installationen reicht 1GbE aus. Bei großen etcd-Clustern verkürzt ein 10GbE-Netzwerk die mittlere Wiederherstellungszeit.
etcd-Mitglieder nach Möglichkeit innerhalb eines einzigen Rechenzentrums bereitstellen, um zusätzliche Latenz zu vermeiden und die Wahrscheinlichkeit von Netzwerkpartitionen zu verringern. Wird ein separater Ausfallbereich in einem anderen Rechenzentrum benötigt, ein möglichst nahe gelegenes Rechenzentrum wählen. Weitere Informationen zu Installationen über mehrere Rechenzentren hinweg enthält die Dokumentation zur Optimierung .
Beispiele für Hardwarekonfigurationen
Im Folgenden stehen einige beispielhafte Hardwarekonfigurationen für AWS- und GCE-Umgebungen. Wie bereits erwähnt, gilt auch hier: Administratoren sollten eine etcd-Installation vor dem produktiven Einsatz mit einer simulierten Arbeitslast testen.
Diese Konfigurationen setzen voraus, dass die Rechner ausschließlich für etcd vorgesehen sind. Werden darauf neben etcd weitere Anwendungen ausgeführt, können Ressourcenkonflikte entstehen und den Cluster instabil machen.
Kleiner Cluster
Ein kleiner Cluster bedient weniger als 100 Clients und weniger als 200 Anfragen pro Sekunde und speichert höchstens 100MB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 50 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56.25 |
| GCE | n1-standard-2 + 50GB PD SSD | 2 | 7.5 | 1500 | 25 |
Mittlerer Cluster
Ein mittlerer Cluster bedient weniger als 500 Clients und weniger als 1,000 Anfragen pro Sekunde und speichert höchstens 500MB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 250 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93.75 |
| GCE | n1-standard-4 + 150GB PD SSD | 4 | 15 | 4500 | 75 |
Großer Cluster
Ein großer Cluster bedient weniger als 1,500 Clients und weniger als 10,000 Anfragen pro Sekunde und speichert höchstens 1GB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 1,000 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250GB PD SSD | 8 | 30 | 7500 | 125 |
Sehr großer Cluster
Ein sehr großer Cluster bedient mehr als 1,500 Clients und mehr als 10,000 Anfragen pro Sekunde und speichert mehr als 1GB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 3,000 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16,000 | 250 |
| GCE | n1-standard-16 + 500GB PD SSD | 16 | 60 | 15,000 | 250 |
12 - Wartung
Überblick
Ein etcd-Cluster muss regelmäßig gewartet werden, um zuverlässig zu bleiben. Je nach Anforderungen der etcd-Anwendung lässt sich diese Wartung gewöhnlich automatisieren und ohne Ausfallzeiten oder erhebliche Leistungseinbußen durchführen.
Alle Wartungsaufgaben in etcd dienen der Verwaltung der Speicherressourcen, die der etcd-Schlüsselraum belegt. Speicherplatzkontingente sichern gegen eine unzureichende Begrenzung der Schlüsselraumgröße ab: Wird der Speicherplatz eines etcd-Mitglieds knapp, löst ein Kontingent clusterweite Alarme aus, die das System in einen Wartungsmodus mit eingeschränktem Funktionsumfang versetzen. Damit weiterhin Platz für Schreibzugriffe auf den Schlüsselraum vorhanden ist, muss dessen Historie kompaktiert werden. Der Speicherplatz selbst kann durch Defragmentierung der etcd-Mitglieder zurückgewonnen werden. Regelmäßige Snapshot-Backups des Zustands eines etcd-Mitglieds ermöglichen schließlich die Wiederherstellung nach unbeabsichtigtem logischem Datenverlust oder nach Datenbeschädigungen durch Bedienfehler.
Aufbewahrung des Raft-Logs
etcd --snapshot-count legt fest, wie viele angewendete Raft-Einträge vor der Kompaktierung im Arbeitsspeicher gehalten werden. Sobald --snapshot-count erreicht ist, speichert der Server zunächst die Snapshot-Daten dauerhaft auf dem Datenträger und entfernt anschließend alte Einträge. Fordert ein langsamer Follower Logs vor einem kompaktierten Index an, sendet der Leader den Snapshot und zwingt den Follower damit, seinen Zustand zu überschreiben.
Ein höherer Wert für --snapshot-count hält bis zum Snapshot mehr Raft-Einträge im Arbeitsspeicher und verursacht damit eine wiederkehrend höhere Speichernutzung
. Da der Leader die neuesten Raft-Einträge länger aufbewahrt, hat ein langsamer Follower mehr Zeit, vor dem nächsten Snapshot des Leaders aufzuschließen. --snapshot-count stellt somit einen Kompromiss zwischen höherem Speicherbedarf und besserer Verfügbarkeit langsamer Follower dar.
In v3.2 wurde der Standardwert von --snapshot-count von 10,000 auf 100,000 geändert
. In v3.7.0 beträgt der Standardwert 10,000.
Werte von --snapshot-count über 100,000 können den Schreibdurchsatz beeinträchtigen. Eine größere Anzahl von Objekten im Arbeitsspeicher kann die Markierungsphase des Go-GC, runtime.scanobject
, verlangsamen; eine seltene Speicherfreigabe verlangsamt außerdem die Speicherzuweisung. Die Leistung hängt von Arbeitslast und Systemumgebung ab. Generell beeinträchtigt eine zu häufige Kompaktierung jedoch Clusterverfügbarkeit und Schreibdurchsatz. Eine zu seltene Kompaktierung ist ebenfalls schädlich, da sie den Garbage Collector von Go zu stark belastet. Weitere Untersuchungsergebnisse bietet Leistungsaspekte von etcd und Raft verstehen
.
Kompaktierung der Historie: Schlüssel-Wert-Datenbank der v3-API
Da etcd eine genaue Historie seines Schlüsselraums führt, sollte diese regelmäßig kompaktiert werden, um Leistungseinbußen und letztlich eine Erschöpfung des Speicherplatzes zu vermeiden. Die Kompaktierung der Schlüsselraumhistorie entfernt alle Informationen zu Schlüsseln, die vor einer bestimmten Revision des Schlüsselraums ersetzt wurden. Der von diesen Schlüsseln belegte Platz steht danach für weitere Schreibzugriffe auf den Schlüsselraum zur Verfügung.
Der Schlüsselraum lässt sich automatisch mit der zeitfensterbasierten Aufbewahrungsrichtlinie von etcd oder manuell mit etcdctl kompaktieren. etcdctl ermöglicht eine genaue Steuerung der Kompaktierung; die automatische Kompaktierung eignet sich für Anwendungen, die die Schlüsselhistorie nur für einen bestimmten Zeitraum benötigen.
Eine mit etcdctl ausgelöste Kompaktierung funktioniert wie folgt:
Revisionen vor der Kompaktierungsrevision sind danach nicht mehr zugänglich:
Automatische Kompaktierung
etcd lässt sich mit den Optionen --auto-compaction-mode und --auto-compaction-retention so konfigurieren, dass es den Schlüsselraum automatisch kompaktiert. Es gibt zwei Kompaktierungsmodi: periodic (Standard) und revision.
Periodische Kompaktierung
Die periodische Kompaktierung bewahrt ein zeitbasiertes Fenster der Schlüsselraumhistorie auf:
Der Aufbewahrungswert legt fest, wie viel Historie erhalten bleibt. Ein Datensatz wird erst ungefähr diese Zeitspanne nach seiner Erstellung kompaktiert. Dadurch können langsame Watcher innerhalb des Aufbewahrungsfensters noch aufschließen.
Ist die Aufbewahrungsdauer größer als 1 Stunde, kompaktiert etcd stündlich und behält dabei das vollständige Aufbewahrungsfenster bei. Beträgt die Aufbewahrungsdauer 1 Stunde oder weniger, erfolgt die Kompaktierung im Abstand dieser Dauer.
Bei --auto-compaction-retention=10h wartet etcd beispielsweise 10 Stunden bis zur ersten Kompaktierung und kompaktiert danach stündlich:
Die empfohlenen Werte hängen vom Anwendungsfall ab:
- Häufige Aktualisierungen derselben Schlüssel: ein kurzer Zeitraum wie
1hoder30m - Seltene Aktualisierungen: ein längerer Zeitraum wie
24h,48hoder72h - Allgemeiner Standardwert:
10h
Revisionsbasierte Kompaktierung
Die revisionsbasierte Kompaktierung bewahrt eine feste Anzahl von Revisionen auf:
etcd prüft alle 5 Minuten und kompaktiert bei "latest revision" - 1000. Ist die neueste Revision beispielsweise 30000, erfolgt die Kompaktierung bei Revision 29000.
Defragmentierung
Nach der Kompaktierung des Schlüsselraums kann die Backend-Datenbank intern fragmentiert sein. Interne Fragmentierung bezeichnet Platz, den das Backend wiederverwenden kann, der aber weiterhin Speicherplatz belegt. Beim Kompaktieren alter Revisionen entstehen Lücken in der Backend-Datenbank, wodurch etcd intern fragmentiert wird. Fragmentierter Platz steht etcd zur Verfügung, dem Dateisystem des Hosts jedoch nicht. Das Löschen von Anwendungsdaten gibt also keinen Speicherplatz auf dem Datenträger frei.
Die Defragmentierung gibt diesen Speicherplatz an das Dateisystem zurück. Sie wird für jedes Mitglied einzeln ausgelöst, um clusterweite Latenzspitzen vermeiden zu können.
Ein etcd-Mitglied mit dem Befehl etcdctl defrag defragmentieren:
Die Defragmentierung eines laufenden Mitglieds blockiert während des Neuaufbaus seines Zustands alle Lese- und Schreibzugriffe auf Daten.
Eine Defragmentierungsanfrage wird nicht im Cluster repliziert, sondern nur auf dem lokalen Knoten ausgeführt. Alle Mitglieder mit der Option --endpoints angeben oder mit --cluster alle Clustermitglieder automatisch ermitteln lassen.
Defragmentierung für alle Endpunkte des Clusters ausführen, zu dem der Standardendpunkt gehört:
Um ein etcd-Datenverzeichnis direkt zu defragmentieren, während etcd nicht läuft, folgenden Befehl verwenden:
Speicherplatzkontingent
Das Speicherplatzkontingent in etcd stellt einen zuverlässigen Clusterbetrieb sicher. Ohne ein solches Kontingent kann etcd bei einem übermäßig großen Schlüsselraum an Leistung verlieren oder schlicht den gesamten Speicherplatz aufbrauchen, was zu unvorhersehbarem Clusterverhalten führt. Überschreitet die Backend-Datenbank des Schlüsselraums eines beliebigen Mitglieds das Kontingent, löst etcd einen clusterweiten Alarm aus. Dieser versetzt den Cluster in einen Wartungsmodus, der nur das Lesen und Löschen von Schlüsseln erlaubt. Erst nachdem genügend Platz im Schlüsselraum freigegeben, die Backend-Datenbank defragmentiert und der Kontingentalarm aufgehoben wurde, kann der Cluster den normalen Betrieb wieder aufnehmen.
Standardmäßig verwendet etcd ein konservatives Speicherplatzkontingent, das für die meisten Anwendungen geeignet ist. Es lässt sich jedoch auf der Befehlszeile in Bytes konfigurieren:
Das Kontingent lässt sich mit einer Schleife ausschöpfen:
Durch das Entfernen überflüssiger Daten aus dem Schlüsselraum und die Defragmentierung der Backend-Datenbank liegt der Cluster wieder innerhalb des Kontingents:
Die Metrik etcd_mvcc_db_total_size_in_use_in_bytes zeigt die tatsächliche Datenbankbelegung nach einer Kompaktierung der Historie. etcd_debugging_mvcc_db_total_size_in_bytes zeigt dagegen die Datenbankgröße einschließlich freien Platzes, der noch auf Defragmentierung wartet. Letztere steigt nur, wenn Erstere nahe an ihr liegt. Nähern sich beide Metriken dem Kontingent, ist daher eine Kompaktierung der Historie erforderlich, um das Auslösen des Speicherplatzkontingents zu vermeiden.
Ab v3.4 heißt etcd_debugging_mvcc_db_total_size_in_bytes nun etcd_mvcc_db_total_size_in_bytes.
Eine Put/Txn/LeaseGrant-Anfrage kann den Fehler ErrGRPCNoSpace zurückgeben, obwohl der Schreibzugriff im Backend erfolgreich ist. etcd prüft das Speicherplatzkontingent sowohl auf der API-Schicht als auch auf der internen Apply-Schicht. Die Apply-Schicht löst lediglich den Alarm NOSPACE aus, ohne die weitere Ausführung der Transaktion zu blockieren.
Snapshot-Backup
Regelmäßige Snapshots des etcd-Clusters dienen als dauerhaftes Backup des etcd-Schlüsselraums. Durch regelmäßige Snapshots der Backend-Datenbank eines etcd-Mitglieds lässt sich ein etcd-Cluster auf einen Zeitpunkt mit einem nachweislich intakten Zustand zurücksetzen.
Ein Snapshot wird mit etcdctl erstellt:
13 - etcd überwachen
Jeder etcd-Server stellt über HTTP-Endpunkte auf seinem Clientport lokale Überwachungsinformationen bereit. Diese Daten helfen sowohl bei der Prüfung des Systemzustands als auch bei der Fehlersuche im Cluster.
Debug-Endpunkt
Ist --log-level=debug gesetzt, stellt der etcd-Server auf seinem Clientport unter dem Pfad /debug Informationen zur Fehlersuche bereit. --log-level=debug mit Bedacht setzen, da dies die Leistung beeinträchtigt und eine ausführliche Protokollierung verursacht.
Der Endpunkt /debug/pprof ist der standardmäßige Profiling-Endpunkt der Go-Laufzeitumgebung. Damit lassen sich CPU-, Heap-, Mutex- und Goroutine-Nutzung untersuchen. Im folgenden Beispiel ermittelt go tool pprof die 10 Funktionen, in denen etcd die meiste Zeit verbringt:
Der Endpunkt /debug/requests stellt gRPC-Traces und Leistungsstatistiken für einen Webbrowser bereit. Hier ist beispielsweise eine Range-Anfrage für den Schlüssel abc zu sehen:
Metrikendpunkt
Jeder etcd-Server stellt Metriken unter dem Pfad /metrics auf seinem Clientport sowie optional an den mit --listen-metrics-urls angegebenen Adressen bereit.
Die Metriken lassen sich mit curl abrufen:
Health Check
Seit v3.3.0 antworten alle mit --listen-metrics-urls angegebenen Adressen neben /metrics auch auf den Endpunkt /health. Dies ist hilfreich, wenn der Standardendpunkt mit gegenseitiger TLS-Authentifizierung (Clientauthentifizierung) konfiguriert ist, ein Load-Balancer oder Überwachungsdienst aber weiterhin Zugriff auf den Health Check benötigt.
Seit v3.4 gibt es die beiden neuen Endpunkte /livez und /readyz.
- Der Endpunkt
/livezzeigt an, ob der Prozess lebt oder neu gestartet werden muss. - Der Endpunkt
/readyzzeigt an, ob der Prozess bereit ist, Anfragen zu bedienen.
Die Entwurfsdetails der Endpunkte sind im KEP dokumentiert.
Jeder Endpunkt umfasst mehrere einzelne Health Checks. Mit dem Parameter verbose lassen sich Einzelheiten und Status der Prüfungen ausgeben, beispielsweise:
Die Antwort sieht dann etwa so aus:
Die HTTP-API unterstützt auch den Ausschluss einzelner Prüfungen, beispielsweise:
Prometheus
Ein Überwachungsdienst mit Prometheus ist der einfachste Weg, die Metriken von etcd zu erfassen und aufzuzeichnen.
Zunächst Prometheus installieren:
Die Endpunkte des etcd-Clusters als Abrufziele von Prometheus festlegen:
Den Prometheus-Handler einrichten:
Prometheus ruft nun alle 10 Sekunden die Metriken von etcd ab.
Alarmierung
Für etcd-v3-Cluster gibt es einen Satz von Standardalarmen für Prometheus.
Die job-Labels müssen möglicherweise an die jeweiligen Anforderungen angepasst werden. Die Regeln wurden für einen einzelnen Cluster geschrieben; daher werden Labels empfohlen, die für einen Cluster eindeutig sind.
Grafana
Grafana unterstützt Prometheus von Haus aus; dazu einfach eine Prometheus-Datenquelle hinzufügen:
Anschließend die standardmäßige etcd-Dashboardvorlage
importieren und anpassen. Heißt die Prometheus-Datenquelle beispielsweise my-etcd, müssen auch die Werte der datasource-Felder im JSON my-etcd lauten.
Beispieldashboard:
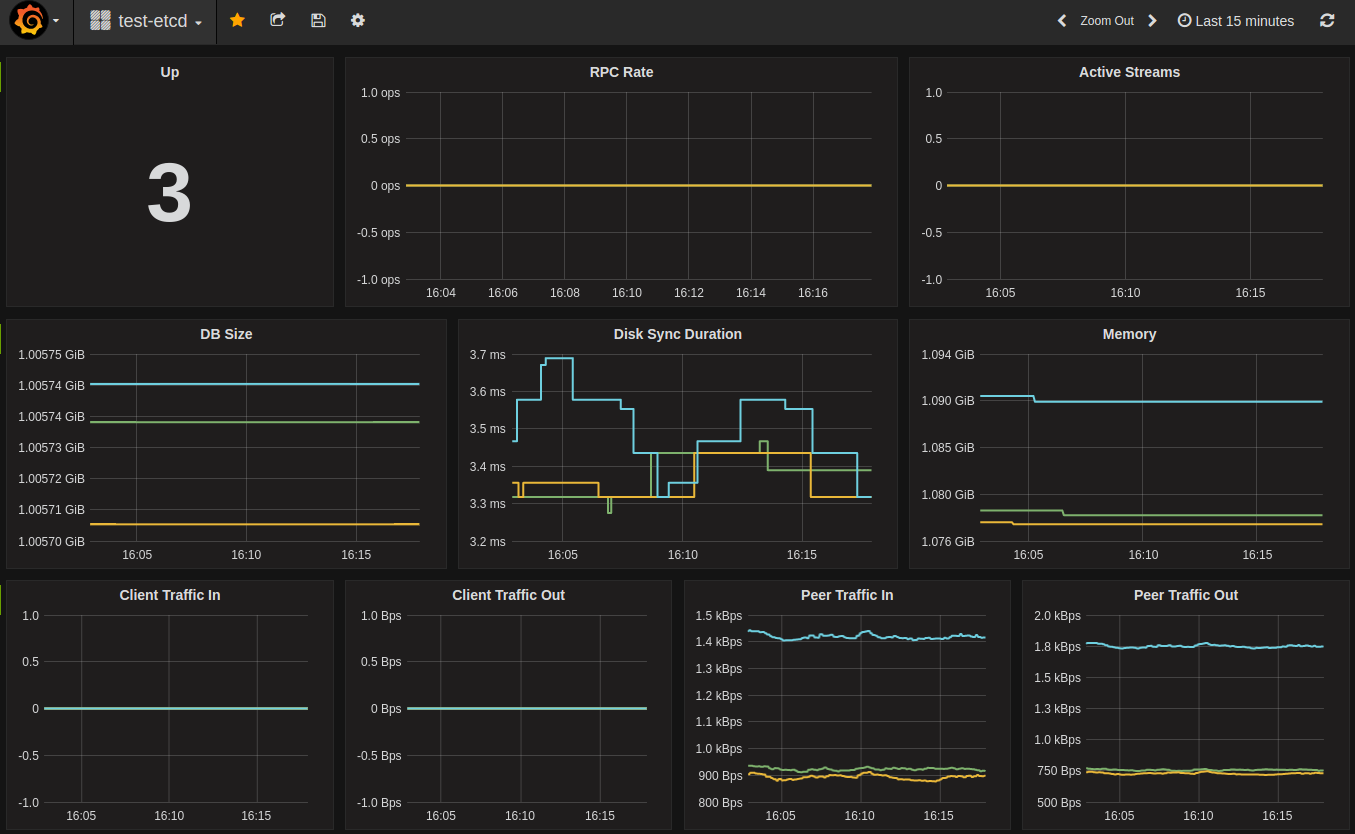
Verteiltes Tracing
In v3.5 wurde etcd um Unterstützung für verteiltes Tracing mit OpenTelemetry erweitert.
In etcd 3.7 die folgenden Tracing-Optionen ohne das frühere Präfix experimental verwenden.
Um verteiltes Tracing zu aktivieren, dem etcd-Server --enable-distributed-tracing=true übergeben. Mit der Option --distributed-tracing-sampling-rate=<number> wird zusätzlich festgelegt, wie viele Stichproben pro Million Spans erfasst werden; die Standardrate ist 0.
Das verteilte Tracing lässt sich konfigurieren, indem der etcd-Server mit folgenden optionalen Optionen gestartet wird:
-
--distributed-tracing-address- (Optional) - “localhost:4317” - Adresse des Tracing-Collectors. -
--distributed-tracing-service-name- (Optional) - “etcd” - Dienstname für verteiltes Tracing; muss für alle etcd-Instanzen gleich sein. -
--distributed-tracing-instance-id- (Optional) - Instanz-ID; ihre Angabe ist optional, wird aber dringend empfohlen. Sie muss für jede etcd-Instanz eindeutig sein.
Vor der Aktivierung des verteilten Tracings sicherstellen, dass ein OpenTelemetry-Endpunkt verfügbar ist. Weicht seine Adresse vom Standard ab, sie mit --distributed-tracing-address überschreiben. Da OpenTelemetry auf verschiedene Arten betrieben werden kann, enthält die Collector-Dokumentation
weitere Informationen.
Wie jedes Signal zur Beobachtung des Systems verursacht auch diese Funktion zusätzlichen Ressourcenbedarf. Nach unseren ersten Messungen kann die zusätzliche CPU-Last zwischen 2% - 4% liegen.
14 - Leistung
Leistung verstehen
etcd bietet eine stabile, dauerhaft hohe Leistung. Zwei Faktoren bestimmen die Leistung: Latenz und Durchsatz. Die Latenz ist die Zeit bis zum Abschluss einer Operation. Der Durchsatz ist die Gesamtzahl der in einem bestimmten Zeitraum abgeschlossenen Operationen. Nimmt etcd gleichzeitige Clientanfragen an, steigt die mittlere Latenz gewöhnlich mit dem Gesamtdurchsatz. In gängigen Cloud-Umgebungen, etwa auf einer standardmäßigen n-4-Instanz bei Google Compute Engine (GCE) oder einem vergleichbaren AWS-Instanztyp, schließt ein etcd-Cluster mit drei Mitgliedern bei geringer Last eine Anfrage in weniger als einer Millisekunde ab und kann bei hoher Last mehr als 30,000 Anfragen pro Sekunde verarbeiten.
etcd verwendet den Raft-Konsensalgorithmus, um Anfragen zwischen Mitgliedern zu replizieren und Einigkeit herzustellen. Die Konsensleistung, insbesondere die Commit-Latenz, wird durch zwei physikalische Grenzen bestimmt: die Latenz der Netzwerk-IO und die Latenz der Datenträger-IO. Die Mindestdauer einer etcd-Anfrage ergibt sich aus der Netzwerkumlaufzeit (Round Trip Time, RTT) zwischen den Mitgliedern zuzüglich der Zeit, die fdatasync benötigt, um die Daten dauerhaft zu speichern. Innerhalb eines Rechenzentrums kann die RTT mehrere Hundert Mikrosekunden betragen. Eine typische RTT innerhalb der USA liegt bei etwa 50ms und kann zwischen Kontinenten bis zu 400ms erreichen. Die typische fdatasync-Latenz einer rotierenden Festplatte liegt bei etwa 10ms, bei SSDs häufig unter 1ms. Um den Durchsatz zu erhöhen, bündelt etcd mehrere Anfragen und übergibt sie gemeinsam an Raft. Diese Bündelung ermöglicht etcd auch bei hoher Last einen hohen Durchsatz.
Weitere Teilsysteme beeinflussen die Gesamtleistung von etcd. Jede serialisierte etcd-Anfrage muss die boltdb-basierte MVCC-Speicherengine durchlaufen, was gewöhnlich einige zehn Mikrosekunden dauert. Regelmäßig erstellt etcd inkrementelle Snapshots der zuletzt angewendeten Anfragen und führt sie mit dem vorherigen Snapshot auf dem Datenträger zusammen. Dieser Vorgang kann eine Latenzspitze verursachen. Auf SSDs ist dies gewöhnlich unproblematisch, auf HDD kann sich die beobachtete Latenz jedoch verdoppeln. Auch laufende Kompaktierungen können die Leistung von etcd beeinflussen. Ihre Auswirkung ist glücklicherweise oft gering, da die Kompaktierung zeitlich gestaffelt erfolgt und so nicht mit regulären Anfragen um Ressourcen konkurriert. Das RPC-System gRPC bietet etcd eine klar definierte, erweiterbare API, verursacht aber auch zusätzliche Latenz, insbesondere bei lokalen Lesezugriffen.
Benchmarks
Die Leistung von etcd lässt sich mit dem enthaltenen CLI-Werkzeug benchmark messen.
Als Grundlage für einige Leistungskennzahlen dient ein etcd-Cluster mit drei Mitgliedern und folgender Hardwarekonfiguration:
- Google Cloud Compute Engine
- 3 Rechner mit 8 vCPUs + 16GB Arbeitsspeicher + 50GB SSD
- 1 Rechner (Client) mit 16 vCPUs + 30GB Arbeitsspeicher + 50GB SSD
- Ubuntu 17.04
- etcd 3.2.0, go 1.8.3
Mit dieser Konfiguration erreicht etcd ungefähr folgende Schreibleistung:
| Anzahl der Schlüssel | Schlüsselgröße in Bytes | Wertgröße in Bytes | Anzahl der Verbindungen | Anzahl der Clients | etcd-Zielserver | Mittlere Schreib-QPS | Mittlere Latenz pro Anfrage | Mittlerer Server-RSS |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | nur Leader | 583 | 1.6ms | 48 MB |
| 100,000 | 8 | 256 | 100 | 1000 | nur Leader | 44,341 | 22ms | 124MB |
| 100,000 | 8 | 256 | 100 | 1000 | alle Mitglieder | 50,104 | 20ms | 126MB |
Beispielbefehle:
Linearisierbare Leseanfragen beziehen ein Quorum von Clustermitgliedern in die Konsensbildung ein, um die neuesten Daten abzurufen. Serialisierbare Leseanfragen sind günstiger, da sie von einem beliebigen einzelnen etcd-Mitglied statt von einem Quorum bedient werden; dafür können sie veraltete Daten zurückgeben. etcd erreicht folgende Leseleistung:
| Anzahl der Anfragen | Schlüsselgröße in Bytes | Wertgröße in Bytes | Anzahl der Verbindungen | Anzahl der Clients | Konsistenz | Mittlere Lese-QPS | Mittlere Latenz pro Anfrage |
|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | Linearisierbar | 1,353 | 0.7ms |
| 10,000 | 8 | 256 | 1 | 1 | Serialisierbar | 2,909 | 0.3ms |
| 100,000 | 8 | 256 | 100 | 1000 | Linearisierbar | 141,578 | 5.5ms |
| 100,000 | 8 | 256 | 100 | 1000 | Serialisierbar | 185,758 | 2.2ms |
Beispielbefehle:
Beim erstmaligen Einrichten eines etcd-Clusters in einer neuen Umgebung wird empfohlen, den Benchmarktest auszuführen, um eine angemessene Leistung sicherzustellen. Latenz und Durchsatz des Clusters können empfindlich auf geringe Unterschiede in der Umgebung reagieren.
15 - Entwurf der Laufzeitrekonfiguration
Die Laufzeitrekonfiguration gehört zu den schwierigsten und fehleranfälligsten Funktionen eines verteilten Systems, insbesondere eines konsensbasierten Systems wie etcd.
Im Folgenden wird erläutert, wie die Befehle zur Laufzeitrekonfiguration von etcd entworfen wurden und wie wir diese Probleme gelöst haben.
Konfigurationsänderungen in zwei Phasen schützen den Cluster
In etcd muss jede Laufzeitrekonfiguration aus Sicherheitsgründen zwei Phasen durchlaufen. Um beispielsweise ein Mitglied hinzuzufügen, wird zunächst der Cluster über die neue Konfiguration informiert und anschließend das neue Mitglied gestartet.
Phase 1 – Den Cluster über die neue Konfiguration informieren
Um einem etcd-Cluster ein Mitglied hinzuzufügen, wird dies über einen API-Aufruf angefordert. Dies ist die einzige Möglichkeit, ein neues Mitglied zu einem bestehenden Cluster hinzuzufügen. Der API-Aufruf kehrt zurück, sobald sich der Cluster auf die Konfigurationsänderung geeinigt hat.
Phase 2 – Das neue Mitglied starten
Damit das neue etcd-Mitglied dem bestehenden Cluster beitritt, den korrekten Wert für initial-cluster angeben und initial-cluster-state auf existing setzen. Beim Start kontaktiert das Mitglied zunächst den bestehenden Cluster und prüft, ob dessen aktuelle Konfiguration mit der in initial-cluster angegebenen erwarteten Konfiguration übereinstimmt. Sobald das neue Mitglied erfolgreich gestartet ist, hat der Cluster die erwartete Konfiguration erreicht.
Die Aufteilung in zwei getrennte Phasen zwingt Benutzer dazu, Änderungen der Clustermitgliedschaft ausdrücklich vorzunehmen. Tatsächlich verschafft dies mehr Flexibilität und macht die Abläufe leichter nachvollziehbar. Wird beispielsweise versucht, ein neues Mitglied mit derselben ID wie ein bereits vorhandenes Mitglied hinzuzufügen, scheitert die Aktion sofort in der ersten Phase, ohne den laufenden Cluster zu beeinträchtigen. Ein ähnlicher Schutz verhindert, dass neue Mitglieder versehentlich hinzugefügt werden. Versucht ein neues etcd-Mitglied beizutreten, bevor der Cluster die Konfigurationsänderung angenommen hat, wird es vom Cluster nicht akzeptiert.
Ohne den ausdrücklichen Ablauf für Mitgliedschaftsänderungen wäre etcd anfällig für unerwartete Änderungen der Clustermitgliedschaft. Läuft etcd beispielsweise unter einem Init-System wie systemd, würde etcd nach der Entfernung über die Mitgliedschafts-API neu gestartet und beim Start erneut versuchen, dem Cluster beizutreten. Diese unerwartete Schleife würde sich jedes Mal wiederholen, wenn ein Mitglied über die API entfernt wird und systemd etcd nach einem Fehlschlag neu starten soll.
Wir gehen davon aus, dass die Laufzeitrekonfiguration nur selten erforderlich ist. Daher haben wir sie bewusst als ausdrücklichen, benutzergesteuerten Vorgang gestaltet, um die Konfigurationssicherheit zu gewährleisten und den Cluster unter klarer Kontrolle reibungslos zu betreiben.
Dauerhafter Quorumverlust erfordert einen neuen Cluster
Verliert ein Cluster dauerhaft die Mehrheit seiner Mitglieder, muss ein neuer Cluster aus einem alten Datenverzeichnis gestartet werden, um den vorherigen Zustand wiederherzustellen.
Es wäre durchaus möglich, ausgefallene Mitglieder zwangsweise aus dem bestehenden Cluster zu entfernen und ihn so wiederherzustellen. Wir unterstützen dieses Verfahren jedoch nicht, da es die normale Commit-Phase des Konsensverfahrens umgeht und somit unsicher ist. Ist das zu entfernende Mitglied tatsächlich noch aktiv oder wird die Entfernung über verschiedene Mitglieder desselben Clusters erzwungen, entstehen voneinander abweichende Cluster mit derselben clusterID. Dies ist sehr gefährlich und im Nachhinein schwer zu untersuchen oder zu beheben.
Bei einer korrekten Installation ist die Wahrscheinlichkeit eines dauerhaften Mehrheitsverlusts sehr gering. Das Problem ist jedoch schwerwiegend genug, um besondere Vorsorge zu rechtfertigen. Wir empfehlen dringend, vor dem produktiven Einsatz von etcd die Dokumentation zur Disaster Recovery zu lesen und Vorkehrungen für einen dauerhaften Mehrheitsverlust zu treffen.
Den öffentlichen Erkennungsdienst nicht für die Laufzeitrekonfiguration verwenden
Der öffentliche Erkennungsdienst sollte nur zur Initialisierung eines Clusters verwendet werden. Um ein Mitglied zu einem bestehenden Cluster hinzuzufügen, die API zur Laufzeitrekonfiguration verwenden.
Der Erkennungsdienst ist für die Initialisierung eines etcd-Clusters in einer Cloud-Umgebung gedacht, wenn die IP-Adressen aller Mitglieder noch nicht bekannt sind. Nach erfolgreicher Initialisierung sind diese IP-Adressen bekannt. Technisch sollte der Erkennungsdienst dann nicht mehr benötigt werden.
Der öffentliche Erkennungsdienst scheint eine bequeme Möglichkeit zur Laufzeitrekonfiguration zu sein, da er bereits alle Informationen zur Clusterkonfiguration besitzt. Die Abhängigkeit von ihm bringt jedoch Probleme mit sich:
-
Sie schafft externe Abhängigkeiten über den gesamten Lebenszyklus des Clusters hinweg, nicht nur während der Initialisierung. Bei Netzwerkproblemen zwischen dem Cluster und dem öffentlichen Erkennungsdienst wird der Cluster beeinträchtigt.
-
Der öffentliche Erkennungsdienst muss über den gesamten Lebenszyklus des Clusters hinweg dessen korrekte Laufzeitkonfiguration abbilden. Er muss Sicherheitsmechanismen gegen unerwünschte Aktionen bereitstellen, was schwierig ist.
-
Der öffentliche Erkennungsdienst muss Zehntausende von Clusterkonfigurationen aufbewahren. Das Backend unseres öffentlichen Erkennungsdiensts ist für diese Arbeitslast nicht ausgelegt.
Wird ein Erkennungsdienst mit Unterstützung für Laufzeitrekonfiguration benötigt, ist ein eigener privater Dienst die beste Wahl.
16 - Laufzeitrekonfiguration
etcd unterstützt die schrittweise Laufzeitrekonfiguration, mit der die Mitgliedschaft im Cluster während des Betriebs geändert werden kann.
Rekonfigurationsanfragen können nur verarbeitet werden, wenn die Mehrheit der Clustermitglieder funktioniert. Für den produktiven Betrieb wird dringend empfohlen, stets mehr als zwei Mitglieder zu verwenden. Das Entfernen eines Mitglieds aus einem Cluster mit zwei Mitgliedern ist unsicher, da auch dessen Mehrheit aus zwei Mitgliedern besteht. Tritt während der Entfernung ein Fehler auf, kann der Cluster möglicherweise nicht mehr weiterarbeiten und einen Neustart nach einem Mehrheitsausfall benötigen.
Weitere Informationen zum Entwurf der Laufzeitrekonfiguration bietet das Dokument zur Laufzeitrekonfiguration .
Anwendungsfälle für die Rekonfiguration
Dieser Abschnitt beschreibt einige häufige Gründe für die Rekonfiguration eines Clusters. Meist bestehen die erforderlichen Schritte aus Kombinationen des Hinzufügens und Entfernens von Mitgliedern. Diese werden weiter unten unter Operationen zur Clusterrekonfiguration erläutert.
Mehrere Rechner austauschen oder aufrüsten
Müssen mehrere Clustermitglieder wegen geplanter Wartungsarbeiten umziehen (Hardwareaufrüstung, Netzwerkunterbrechungen usw.), wird empfohlen, die Mitglieder nacheinander zu ändern.
Der Leader kann sicher entfernt werden; während der anschließenden Wahl gibt es jedoch eine kurze Ausfallzeit. Enthält der Cluster mehr als 50MB v2-Daten, wird empfohlen, das Datenverzeichnis des Mitglieds zu migrieren .
Clustergröße ändern
Eine Vergrößerung des Clusters kann die Fehlertoleranz und die Leseleistung verbessern. Da Clients von jedem Mitglied lesen können, erhöht eine größere Mitgliederzahl den gesamten Durchsatz serialisierbarer Lesezugriffe.
Eine Verkleinerung des Clusters kann die Schreibleistung verbessern, verringert aber seine Ausfallsicherheit. Schreiboperationen werden auf eine Mehrheit der Clustermitglieder repliziert, bevor sie als festgeschrieben gelten. Eine Verkleinerung senkt die erforderliche Mehrheit, sodass jede Schreiboperation schneller festgeschrieben wird.
Einen ausgefallenen Rechner ersetzen
Fällt ein Rechner durch einen Hardwaredefekt, ein beschädigtes Datenverzeichnis oder einen anderen schwerwiegenden Fehler aus, sollte er so schnell wie möglich ersetzt werden. Ausgefallene, aber noch nicht entfernte Rechner wirken sich ungünstig auf das Quorum aus und verringern die Toleranz gegenüber einem weiteren Ausfall.
Um den Rechner zu ersetzen, zunächst nach der Anleitung das Mitglied aus dem Cluster entfernen und anschließend ein neues Mitglied hinzufügen . Enthält der Cluster mehr als 50MB, wird empfohlen, das Datenverzeichnis des ausgefallenen Mitglieds zu migrieren , sofern es noch zugänglich ist.
Cluster nach einem Mehrheitsausfall neu starten
Geht die Mehrheit des Clusters verloren oder haben sich die IP-Adressen aller Knoten geändert, ist für eine sichere Wiederherstellung ein manueller Eingriff erforderlich. Die grundlegenden Schritte umfassen das Erstellen eines neuen Clusters mit den alten Daten , das Erzwingen eines einzelnen Mitglieds als Leader und schließlich das schrittweise Hinzufügen neuer Mitglieder zu diesem Cluster über die Laufzeitkonfiguration.
Cluster nach einem Minderheitsausfall wiederherstellen
Geht ein einzelnes Mitglied verloren, entspricht dies dem Ersetzen eines ausgefallenen Rechners. Die Schritte stehen unter Einen ausgefallenen Rechner ersetzen .
Operationen zur Clusterrekonfiguration
Für diese Anwendungsfälle lassen sich die jeweils erforderlichen Operationen wie folgt beschreiben.
Vor jeder Änderung muss eine einfache Mehrheit (ein Quorum) der etcd-Mitglieder verfügbar sein. Im Wesentlichen gilt dieselbe Anforderung für jede Art von Schreibzugriff auf etcd.
Alle Änderungen am Cluster müssen nacheinander erfolgen:
- Zum Aktualisieren der peerURLs eines einzelnen Mitglieds eine Aktualisierungsoperation ausführen
- Zum Ersetzen eines einzelnen intakten Mitglieds das alte Mitglied entfernen und danach ein neues hinzufügen
- Für eine Erweiterung von 3 auf 5 Mitglieder zwei Hinzufügeoperationen ausführen
- Für eine Verkleinerung von 5 auf 3 zwei Entfernungsoperationen ausführen
Alle Beispiele verwenden das mit etcd gelieferte Befehlszeilenwerkzeug etcdctl. Um die Mitgliedschaft ohne etcdctl zu ändern, die v3-gRPC-Mitglieder-API
verwenden.
Ein Mitglied aktualisieren
Bekannt gegebene Client-URLs aktualisieren
Um die bekannt gegebenen Client-URLs eines Mitglieds zu aktualisieren, dieses einfach mit der aktualisierten Option --advertise-client-urls oder Umgebungsvariablen ETCD_ADVERTISE_CLIENT_URLS neu starten. Das neu gestartete Mitglied veröffentlicht die aktualisierten URLs selbst. Eine falsch aktualisierte Client-URL beeinträchtigt den Zustand des etcd-Clusters nicht.
Bekannt gegebene Peer-URLs aktualisieren
Um die bekannt gegebenen Peer-URLs eines Mitglieds zu aktualisieren, sie zunächst ausdrücklich mit dem member-Befehl ändern und anschließend das Mitglied neu starten. Dieser zusätzliche Schritt ist erforderlich, da Peer-URL-Änderungen die clusterweite Konfiguration ändern und den Zustand des etcd-Clusters beeinflussen können.
Zum Aktualisieren der bekannt gegebenen Peer-URLs zunächst die ID des Zielmitglieds ermitteln. Alle Mitglieder mit etcdctl auflisten:
In diesem Beispiel wird update auf die Mitglieds-ID a8266ecf031671f3 angewendet und deren peerURLs-Wert in http://10.0.1.10:2380 geändert:
Ein Mitglied entfernen
Angenommen, die ID des zu entfernenden Mitglieds ist a8266ecf031671f3. Das Mitglied mit dem Befehl remove entfernen:
Das Zielmitglied beendet sich daraufhin selbst und protokolliert seine Entfernung:
Der Leader kann sicher entfernt werden, allerdings ist der Cluster während der Wahl eines neuen Leaders inaktiv. Diese Dauer entspricht normalerweise dem Wahlzeitlimit zuzüglich des Abstimmungsvorgangs.
Ein neues Mitglied hinzufügen
Das Hinzufügen eines Mitglieds erfolgt in zwei Schritten:
- Das neue Mitglied über die v3-gRPC-Mitglieder-API
oder den Befehl
etcdctl member addzum Cluster hinzufügen. - Das neue Mitglied mit der neuen Clusterkonfiguration starten, einschließlich der aktualisierten Mitgliederliste (vorhandene Mitglieder + neues Mitglied).
etcdctl fügt ein neues Mitglied hinzu, indem dessen Name
und bekannt gegebene Peer-URLs
angegeben werden:
etcdctl hat den Cluster über das neue Mitglied informiert und die für dessen erfolgreichen Start benötigten Umgebungsvariablen ausgegeben. Nun den neuen etcd-Prozess mit den passenden Optionen für das neue Mitglied starten:
Das neue Mitglied läuft als Teil des Clusters und beginnt sofort, zum übrigen Cluster aufzuschließen.
Beim Hinzufügen mehrerer Mitglieder empfiehlt es sich, jeweils ein einzelnes Mitglied zu konfigurieren und seinen korrekten Start zu prüfen, bevor weitere Mitglieder hinzukommen. Wird einem Cluster mit 1 Knoten ein neues Mitglied hinzugefügt, kann der Cluster erst weiterarbeiten, sobald dieses gestartet ist, da er für den Konsens nun zwei Mitglieder als Mehrheit benötigt. Dieses Verhalten tritt nur zwischen der Meldung des neuen Mitglieds durch etcdctl member add und dem erfolgreichen Verbindungsaufbau des neuen zum bestehenden Mitglied auf.
Ein neues Mitglied als Learner hinzufügen
Seit v3.4 unterstützt etcd das Hinzufügen eines neuen Mitglieds als Learner, also als nicht stimmberechtigtes Mitglied. Die Gründe und der Entwurf sind im Entwurfsdokument beschrieben. Um das Hinzufügen sicherer zu machen und die dabei entstehenden Clusterunterbrechungen zu verkürzen, empfiehlt es sich, das neue Mitglied zunächst als Learner hinzuzufügen, bis es aufgeholt hat. Dies lässt sich als Ablauf in drei Schritten beschreiben:
-
Das neue Mitglied über die gRPC-Mitglieder-API oder den Befehl
etcdctl member add --learnerals Learner hinzufügen. -
Das neue Mitglied mit der neuen Clusterkonfiguration starten, einschließlich der aktualisierten Mitgliederliste (vorhandene Mitglieder + neues Mitglied). Dieser Schritt ist genau derselbe wie zuvor.
-
Den neu hinzugefügten Learner über die gRPC-Mitglieder-API oder den Befehl
etcdctl member promotezu einem stimmberechtigten Mitglied befördern. Der etcd-Server prüft die Beförderungsanfrage, um die Betriebssicherheit zu gewährleisten. Erst wenn sein Raft-Log zum Log des Leaders aufgeholt hat, kann der Learner zum stimmberechtigten Mitglied befördert werden. Hat ein Learner-Mitglied noch nicht zum Raft-Log des Leaders aufgeholt, schlägt die Beförderungsanfrage fehl (Einzelheiten stehen im Abschnitt Fehlerfälle bei der Beförderung eines Mitglieds ). In diesem Fall sollte gewartet und die Anfrage später wiederholt werden.
In v3.4 begrenzt der etcd-Server die Zahl der Learner im Cluster auf einen. Dadurch soll vor allem die zusätzliche Last begrenzt werden, die dem Leader durch die Übertragung von Daten an den Learner entsteht.
Mit etcdctl member add und der Option --learner ein neues Mitglied als Learner zum Cluster hinzufügen.
Nachdem der neue etcd-Prozess für das hinzugefügte Learner-Mitglied gestartet wurde, den Learner mit etcdctl member promote zu einem stimmberechtigten Mitglied befördern.
Fehlerfälle beim Hinzufügen von Mitgliedern
Im folgenden Fall fehlt ein neuer Host in der Liste der aufgeführten Knoten. Handelt es sich um einen neuen Cluster, muss der Knoten zur Liste der anfänglichen Clustermitglieder hinzugefügt werden.
In diesem fehlgeschlagenen Beispiel startet das Mitglied mit einer Adresse (10.0.1.14:2380), die von der registrierten Peer-Adresse (10.0.1.13:2380) abweicht:
Startet etcd mit dem Datenverzeichnis eines entfernten Mitglieds, beendet es sich automatisch, sobald es sich mit einem aktiven Clustermitglied verbindet:
Fehlerfälle beim Hinzufügen eines Learner-Mitglieds
Ein Learner kann nicht hinzugefügt werden, wenn der Cluster bereits 1 Learner enthält (v3.4).
Fehlerfälle bei der Beförderung eines Learner-Mitglieds
Ein Learner kann nur zu einem stimmberechtigten Mitglied befördert werden, wenn er mit dem Leader synchron ist.
Die Beförderung eines Mitglieds, das kein Learner ist, schlägt fehl.
Die Beförderung eines Mitglieds, das im Cluster nicht existiert, schlägt fehl.
Strenge Rekonfigurationsprüfung (-strict-reconfig-check)
Wie oben beschrieben, empfiehlt es sich, neue Mitglieder einzeln zu konfigurieren und ihren korrekten Start zu prüfen, bevor weitere hinzukommen. Dieses schrittweise Vorgehen ist sehr wichtig: Ist ein neues Mitglied falsch konfiguriert, etwa mit falschen Peer-URLs, kann der Cluster sein Quorum verlieren. Der Quorumverlust entsteht, weil das neue Mitglied bei der Quorumberechnung mitgezählt wird, selbst wenn die übrigen Mitglieder es nicht erreichen können. Auch Verbindungsprobleme oder betriebliche Probleme können zum Quorumverlust führen.
Um dieses Problem zu vermeiden, bietet etcd die Option -strict-reconfig-check. Wird sie an etcd übergeben, lehnt etcd Rekonfigurationsanfragen ab, wenn die Anzahl gestarteter Mitglieder nach der Änderung kleiner als das Quorum des neu konfigurierten Clusters wäre.
Diese Option ist standardmäßig aktiviert.
17 - Unterstützte Plattformen
Unterstützungsstufen
etcd läuft auf verschiedenen Plattformen. Die gewährten Garantien hängen jedoch von der Unterstützungsstufe der jeweiligen Plattform ab:
- Stufe 1: vollständig von den etcd-Maintainern unterstützt; etcd besteht garantiert alle Tests einschließlich Funktions- und Robustheitstests.
- Stufe 2: etcd besteht garantiert Integrations- und Ende-zu-Ende-Tests, aber nicht unbedingt Funktions- oder Robustheitstests.
- Stufe 3: etcd lässt sich garantiert bauen, wird möglicherweise nur wenig oder gar nicht getestet und sollte daher als instabil betrachtet werden.
Aktuelle Unterstützung
Die folgende Tabelle führt die derzeit unterstützten Plattformen und ihre jeweilige etcd-Unterstützungsstufe auf:
| Architektur | Betriebssystem | Unterstützungsstufe | Maintainer |
|---|---|---|---|
| AMD64 | Linux | 1 | etcd-Maintainer |
| ARM64 | Linux | 1 | etcd-Maintainer |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
Nicht aufgeführte Plattformen werden nicht unterstützt.
Eine neue Plattform unterstützen
Möchten Sie als „offizieller“ Maintainer einer neuen Plattform zu etcd beitragen? Neben der Zusage, die Plattform zu unterstützen, müssen Sie eine kontinuierliche Integration (CI) für etcd einrichten, die abhängig von der Unterstützungsstufe die folgenden Anforderungen erfüllt:
| Kontinuierliche Integration für etcd | Stufe 1 | Stufe 2 | Stufe 3 |
|---|---|---|---|
| Build erfolgreich | ✓ | ✓ | ✓ |
| Unittests bestanden | ✓ | ✓ | |
| Integrations- und Ende-zu-Ende-Tests bestanden | ✓ | ✓ | |
| Robustheitstests bestanden | ✓ |
Ein Beispiel zur Einrichtung einer CI der Stufe 2 für ARM64 bietet etcd PR #12928 .
Nicht unterstützte Plattformen
Um den unbeabsichtigten Betrieb eines etcd-Servers auf einer nicht unterstützten Plattform zu vermeiden, gibt etcd eine Warnung aus und beendet sich sofort, sofern die Umgebungsvariable ETCD_UNSUPPORTED_ARCH nicht auf die Zielarchitektur gesetzt ist.
32-Bit-Systeme Auf 32-Bit-Systemen hat etcd aufgrund eines Fehlers in der Go-Laufzeitumgebung bekannte Probleme. Weitere Informationen bieten das Go-Issue #599 und der Fehlerhinweis zum Paket atomic .
18 - Versionierung
Dieses Dokument beschreibt die vom etcd-Projekt unterstützten Versionen.
Dienstversionierung und unterstützte Versionen
etcd-Versionen werden als x.y.z angegeben. Dabei ist x die Hauptversion, y die Nebenversion und z die Patchversion, entsprechend der Terminologie der semantischen Versionierung . Neue Nebenversionen können der API zusätzliche Funktionen hinzufügen.
Das etcd-Projekt pflegt Release-Branches für die aktuelle und die vorherige Version. Ist beispielsweise v3.5 die aktuelle Version, wird v3.4 unterstützt. Mit der Veröffentlichung von v3.6 endet die Unterstützung für v3.4.
Geeignete Fehlerbehebungen, einschließlich Sicherheitskorrekturen, können abhängig von Schweregrad und Machbarkeit auf diese beiden Release-Branches zurückportiert werden. Bei Bedarf werden daraus Patchversionen veröffentlicht.
Diese Entscheidung treffen die Maintainer des Projekts.
Die Version eines laufenden etcd-Clusters lässt sich mit etcdctl prüfen:
API-Versionierung
Die Antworten der v3-API sollten sich nach der Veröffentlichung von 3.0.0 nicht ändern; im Laufe der Zeit werden jedoch neue Funktionen hinzugefügt.
19 - Datenbeschädigung
etcd verfügt über eine integrierte automatische Erkennung von Datenbeschädigungen, damit die Zustände der Mitglieder nicht voneinander abweichen.
In etcd 3.7 die nachfolgenden Funktionsschalter und Optionen für Zeitintervalle verwenden. Die früheren experimentellen Optionen zur Prüfung auf Datenbeschädigungen wurden entfernt; siehe Konfigurationsoptionen .
Erkennung von Datenbeschädigungen aktivieren
Datenbeschädigungen lassen sich mit folgenden Prüfungen erkennen:
- Anfangsprüfung, aktiviert mit der Option
--feature-gates=InitialCorruptCheck=true. - Regelmäßige Prüfung folgender Hashwerte:
- Hashwert der kompaktierten Revision, aktiviert mit der Option
--feature-gates=CompactHashCheck=true. - Hashwert der neuesten Revision, aktiviert mit der Option
--corrupt-check-time.
- Hashwert der kompaktierten Revision, aktiviert mit der Option
Die Anfangsprüfung erfolgt während der Initialisierung des etcd-Mitglieds. Das Mitglied vergleicht seinen persistenten Zustand mit dem der anderen Mitglieder und beendet sich bei einer Abweichung.
Beide regelmäßigen Prüfungen werden in einem bereits laufenden Cluster vom Leader ausgeführt. Der Leader vergleicht seinen persistenten Zustand mit dem der anderen Mitglieder und löst bei einer Abweichung einen CORRUPT ALARM aus. Beide Prüfungen dienen demselben Zweck. Es lohnt sich jedoch, beide zu aktivieren, um Leistung und Erkennungszeit gegeneinander abzuwägen.
- Prüfung des Hashwerts der kompaktierten Revision – erfordert regelmäßige Kompaktierung, verursacht minimale Leistungseinbußen und kommt mit langsamen Followern zurecht.
- Prüfung des Hashwerts der neuesten Revision – verursacht hohe Leistungseinbußen und kommt weder mit langsamen Followern noch mit häufigen Kompaktierungen zurecht.
Hashwert der kompaktierten Revision prüfen
Bei Aktivierung mit der Option --feature-gates=CompactHashCheck=true wird die Prüfung einmal pro Minute ausgeführt.
Dies lässt sich mit der Option --compact-hash-check-time in folgendem Format anpassen: 1m – jede Minute, 1h – jede Stunde.
Diese Prüfung erweitert die Kompaktierung um die Berechnung einer Prüfsumme, die zwischen Clustermitgliedern verglichen werden kann.
Sie erfordert keinen zusätzlichen Datenbankscan und ist dadurch sehr kostengünstig, setzt aber eine regelmäßige Kompaktierung im Cluster voraus.
Hashwert der neuesten Revision prüfen
Die Aktivierung erfolgt mit der Option --corrupt-check-time; dabei muss ein Ausführungsintervall in folgendem Format angegeben werden: 1m – jede Minute, 1h – jede Stunde.
Wegen der hohen Leistungseinbußen wird ein Intervall von einigen Stunden empfohlen.
Für die Prüfung muss der gesamte etcd-Inhalt bei der angegebenen Revision gescannt werden, um eine Prüfsumme zu berechnen.
Ein Mitglied mit beschädigten Daten wiederherstellen
Es gibt drei Möglichkeiten, ein Mitglied mit beschädigten Daten wiederherzustellen:
- Persistenten Zustand des Mitglieds löschen
- Mitglied ersetzen
- Gesamten Cluster wiederherstellen
Nach der Wiederherstellung des Mitglieds kann der CORRUPT ALARM aufgehoben werden.
Persistenten Zustand des Mitglieds löschen
Der Zustand eines Mitglieds lässt sich wie folgt löschen:
- Die etcd-Instanz stoppen.
- Ein Backup des etcd-Datenverzeichnisses erstellen.
- Das Unterverzeichnis
snapaus dem etcd-Datenverzeichnis verschieben. etcdmit--initial-cluster-state=existingund den in--initial-clusteraufgeführten Clustermitgliedern starten.
Das etcd-Mitglied sollte daraufhin einen aktuellen Snapshot vom Leader herunterladen.
Mitglied ersetzen
Ein Mitglied lässt sich wie folgt ersetzen:
- Die etcd-Instanz stoppen.
- Ein Backup des etcd-Datenverzeichnisses erstellen.
- Das Datenverzeichnis entfernen.
- Das Mitglied durch Ausführen von
etcdctl member removeaus dem Cluster entfernen. - Es durch Ausführen von
etcdctl member addwieder hinzufügen etcdmit--initial-cluster-state=existingund den in--initial-clusteraufgeführten Clustermitgliedern starten.
Gesamten Cluster wiederherstellen
Der Cluster lässt sich wiederherstellen, indem ein Snapshot des aktuellen Leaders gespeichert und auf allen Mitgliedern wiederhergestellt wird.
etcdctl snapshot save gegen den Leader ausführen und dem Verfahren zur Wiederherstellung eines Clusters
folgen.