Dies ist die mehrseitige Druckansicht dieses Abschnitts. .
Patroni 4.1.5 Dokumentation
- 1: Einführung
- 2: Installation
- 3: Patroni-Konfiguration
- 4: Patroni REST API
- 5: patronictl
- 6: Replikaterstellung und Cluster-Initialisierung
- 7: Replikationsmodi
- 8: Standby-Cluster
- 9: Watchdog-Unterstützung
- 10: Cluster-Verwaltung pausieren und fortsetzen
- 11: DCS-Failsafe-Modus
- 12: Patroni mit Kubernetes verwenden
- 13: Citus-Unterstützung
- 14: Eine eigenständige Instanz in einen Patroni-Cluster überführen
- 15: Integration mit anderen Werkzeugen
- 16: Sicherheitshinweise
- 17: Hochverfügbarkeit über mehrere Rechenzentren
- 18: Häufige Fragen
- 19: Versionshinweise
- 20: Leitfaden zur Mitarbeit
Betrieb von Patroni auf Systemen mit begrenztem Arbeitsspeicher und Python 3.11+
Wenn Sie Patroni auf einem System mit strengen Speichergrenzen betreiben, beispielsweise mit vm.overcommit_memory=2 (für PostgreSQL empfohlen), und Python 3.11 oder neuer verwenden, kann unerwartetes Verhalten auftreten:
- Patroni scheint ordnungsgemäß zu funktionieren
- PostgreSQL läuft weiter
- Die REST API von Patroni reagiert nicht mehr
- Das Betriebssystem meldet, dass Patroni auf dem REST API-Port lauscht
- Die Patroni-Protokolle erscheinen normal; einmalig können jedoch folgende Meldungen auftreten:
Exception ignored in thread started by: <object repr() failed>,MemoryError - Die Kernel-Protokolle können Meldungen wie
not enough memory for the allocationenthalten
Dieses Verhalten wird durch einen Fehler in Python 3.11+ verursacht. Bei strengen Speichergrenzen kann der Start eines neuen Threads auf unbestimmte Zeit hängen bleiben, wenn nicht genügend freier Arbeitsspeicher verfügbar ist.
Empfohlene Lösung
Neuere Patroni-Versionen (4.1.1+, 4.0.8+) verringern die Auswirkungen dieses Problems, indem sie alle erforderlichen Threads früh beim Start erzeugen, bevor das System unter Speicherdruck gerät.
Weitere Empfehlungen (Linux, glibc)
Beim Betrieb mit vm.overcommit_memory=2 (für PostgreSQL empfohlen) empfehlen wir außerdem, Patroni mit den folgenden Umgebungsvariablen zu starten:
MALLOC_ARENA_MAX=1- verringert den von glibc für Anwendungen mit mehreren Threads reservierten virtuellen SpeicherPG_MALLOC_ARENA_MAX=- setzt den Wert vonMALLOC_ARENA_MAXfür PostgreSQL-Prozesse zurück, die Patroni startet.
Zusätzlich können Sie folgende Patroni-Konfigurationsparameter anpassen:
thread_stack_size- Stackgröße der von Patroni gestarteten Threads. Ein niedrigerer Wert verringert den Speicherbedarf des Patroni-Prozesses. Der von Patroni vorgegebene Standardwert ist512kB. Erhöhen Siethread_stack_size, wenn Patroni aufgrund von Stackproblemen abstürzt; andernfalls reicht der Standardwert aus.thread_pool_size- Größe des Threadpools, den Patroni für asynchrone Aufgaben und die REST API-Kommunikation mit anderen Mitgliedern bei der Leader-Wahl oder bei Failsafe-Prüfungen verwendet. Der Standardwert ist5und reicht für Cluster mit drei Knoten aus.restapi.thread_pool_size- Größe des Threadpools zur Bearbeitung von REST API-Anfragen. Der Standardwert ist5und erlaubt bis zu fünf parallele REST API-Anfragen. Anfragen mit SQL-Abfragen werden jedoch praktisch nacheinander verarbeitet, da nur eine Datenbankverbindung verwendet wird. Eine Erhöhung dieses Wertes bringt daher üblicherweise keinen Vorteil.
Patroni ist eine Vorlage für PostgreSQL-Lösungen zur Hochverfügbarkeit (HA) auf Basis von Python. Für eine möglichst breite Einsetzbarkeit unterstützt Patroni verschiedene verteilte Konfigurationsspeicher wie ZooKeeper , etcd , Consul oder Kubernetes . Datenbankentwickler, DBAs, DevOps-Fachleute und SREs, die PostgreSQL mit HA schnell in Rechenzentren oder anderswo bereitstellen möchten, finden darin hoffentlich ein hilfreiches Werkzeug.
Wir nennen Patroni eine „Vorlage“, weil es keineswegs ein universelles oder sofort einsatzbereites Replikationssystem ist. Es hat seine Besonderheiten und Einschränkungen. Setzen Sie es mit Bedacht ein. Es gibt viele Möglichkeiten, PostgreSQL hochverfügbar zu betreiben; eine Übersicht bietet die PostgreSQL-Dokumentation .
Derzeit unterstützte PostgreSQL-Versionen: 9.3 bis 18.
Hinweis für Citus-Anwender: Ab Version 3.0 integriert sich Patroni gut mit der Postgres-Datenbankerweiterung Citus . Weitere Informationen zur gemeinsamen Nutzung der Patroni-Hochverfügbarkeit mit einem verteilten Citus-Cluster finden Sie auf der Seite zur Citus-Unterstützung in der Patroni-Dokumentation.
Hinweis für Kubernetes-Anwender: Patroni kann direkt auf Kubernetes laufen. Lesen Sie dazu das Kapitel Kubernetes der Patroni-Dokumentation.
1 - Einführung
Patroni ist eine Vorlage für PostgreSQL-Lösungen zur Hochverfügbarkeit (HA) auf Basis von Python. Es entstand als Fork von Governor , einem Projekt von Compose, und enthält zahlreiche neue Funktionen.
Weitere Hintergrundinformationen:
- PostgreSQL-HA mit Kubernetes und Patroni , Vortrag von Josh Berkus auf der KubeCon 2016 (Video)
- Beitrag im Zalando-Tech-Blog vom Februar 2016
Entwicklungsstand
Patroni wird aktiv weiterentwickelt und nimmt Beiträge entgegen. Weitere Einzelheiten stehen im Abschnitt Mitwirken weiter unten.
Informationen zu neuen Versionen veröffentlichen wir hier .
Technische Voraussetzungen und Installation
Anleitungen zur Installation und zum Upgrade von Patroni auf verschiedenen Plattformen stehen hier .
Anzahl der PostgreSQL-Knoten planen
Patroni-/PostgreSQL-Knoten sind von den DCS-Knoten unabhängig (außer wenn Patroni RAFT selbst implementiert). Daher gibt es keine Mindestanzahl an Knoten. Ein Cluster aus einem Primärserver und einem Standby kann problemlos betrieben werden. Weitere Standby-Knoten können später hinzugefügt werden.
Cluster mit 2 Knoten (Primärserver + Standby) sind üblich und bieten automatisches Failover mit Hochverfügbarkeit. Während eines Failovers besteht vorübergehend keine Redundanz, bis der ausgefallene Knoten wieder beitritt.
DCS-Anforderungen: Der DCS (etcd, ZooKeeper, Consul) muss für zuverlässigen Konsens und Fehlertoleranz mit 3 oder 5 Knoten betrieben werden. Ein einzelner DCS-Cluster kann Informationen für Hunderte oder Tausende Patroni-Cluster speichern, die unterschiedliche namespace/scope-Kombinationen verwenden.
Ausführen und Konfigurieren
Der folgende Abschnitt setzt voraus, dass das Patroni-Repository von https://github.com/patroni/patroni
geklont wurde. Insbesondere werden die Beispielkonfigurationen postgres0.yml und postgres1.yml benötigt. Wurde Patroni mit pip installiert, können diese Dateien aus dem Git-Repository bezogen werden; ./patroni.py ist dann unten durch den Befehl patroni zu ersetzen.
Die folgenden Befehle verwenden die etcd-v2-API und erfordern eine etcd-Version mit Unterstützung für --enable-v2, etwa etcd 3.5. Bei etcd 3.6 oder neuer stattdessen die etcd3-Konfiguration von Patroni verwenden, da etcd 3.6 die Unterstützung der v2-API entfernt hat
.
Zum Einstieg die folgenden Befehle in verschiedenen Terminals ausführen:
> etcd --data-dir=data/etcd --enable-v2=true
> ./patroni.py postgres0.yml
> ./patroni.py postgres1.yml
Daraufhin startet ein hochverfügbarer Cluster. Verschiedene Einstellungen in den YAML-Dateien ausprobieren, um ihre Auswirkungen auf das Clusterverhalten zu beobachten. Einzelne Komponenten beenden, um das Verhalten des Systems zu testen.
Weitere Dateien postgres*.yml hinzufügen, um einen noch größeren Cluster zu erstellen.
Patroni stellt eine HAProxy -Konfiguration bereit, die der Anwendung einen einzelnen Endpunkt für Verbindungen zum Cluster-Leader bietet. Zur Einrichtung folgende Befehle ausführen:
> haproxy -f haproxy.cfg

> psql --host 127.0.0.1 --port 5000 postgres
YAML-Konfiguration
Ausführliche Informationen zu den Einstellungen für etcd, Consul und ZooKeeper stehen hier . Ein Beispiel enthält postgres0.yml .
Konfiguration über Umgebungsvariablen
Ausführliche Informationen zum Festlegen und Überschreiben von Einstellungen über Umgebungsvariablen stehen hier .
Replikationsmöglichkeiten
Patroni verwendet die Streaming-Replikation von Postgres, die standardmäßig asynchron arbeitet. In der asynchronen Replikationskonfiguration von Patroni lässt sich maximum_lag_on_failover setzen. Diese Einstellung verhindert die Hochstufung eines Followers bei einem Failover, wenn er mehr als die festgelegte Anzahl Bytes hinter dem Leader liegt. Ihr Wert sollte je nach geschäftlichen Anforderungen erhöht oder verringert werden. Für stärkere Garantien zur Dauerhaftigkeit kann auch synchrone Replikation verwendet werden. Einzelheiten stehen in der Dokumentation zu Replikationsmodi
.
Anwendungen sollten keine Superuser verwenden
Für Verbindungen aus Anwendungen immer einen Benutzer ohne Superuser-Rechte verwenden. Patroni benötigt Datenbankzugriff, um ordnungsgemäß zu funktionieren. Verwendet eine Anwendung einen Superuser, kann sie möglicherweise den gesamten Verbindungspool belegen, einschließlich der über superuser_reserved_connections für Superuser reservierten Verbindungen. Kann Patroni wegen eines vollen Verbindungspools nicht auf den Primärserver zugreifen, führt dies zu unerwünschtem Verhalten.
Die HA-Lösung testen
Das Testen einer HA-Lösung ist zeitaufwendig und umfasst viele Einflussgrößen. Dies gilt besonders für eine plattformübergreifende Anwendung. Dafür wird ein geschulter Systemadministrator oder Berater benötigt. Die Dokumentation kann dies nicht im Detail abdecken.
Folgende Teile der Infrastruktur sollten auf jeden Fall getestet werden:
- Netzwerk (sowohl das dem System vorgelagerte Netzwerk als auch die NICs selbst)
- Datenträger-IO
- Dateilimits (nofile unter Linux)
- RAM. Auch bei deaktiviertem oomkiller kann fehlender Arbeitsspeicher Probleme verursachen.
- CPU
- Ressourcenkonkurrenz bei der Virtualisierung (Überbelegung des Hypervisors)
- Sämtliche cgroup-Beschränkungen (wahrscheinlich im Zusammenhang mit den obigen Punkten)
kill -9für einen beliebigen postgres-Prozess (außer postmaster!). Dies simuliert einen Segmentation Fault recht gut.
Ein postmaster-Prozess sollte dagegen nicht mit kill -9 beendet werden, da das Beenden des Prozesses allein die zugrunde liegenden Bedingungen eines Ressourcenmangels oder anderer Infrastrukturfehler nicht nachbildet. Besteht die Sorge, dass die Infrastruktur unsicher ist und ein Angreifer kill -9 ausführen könnte, kann kein HA-Verfahren das beheben. Der Angreifer würde den Prozess einfach erneut beenden oder auf andere Weise Schaden anrichten.
2 - Installation
Voraussetzungen unter Mac OS
Zum Installieren der Voraussetzungen auf einem Mac folgenden Befehl ausführen:
Psycopg
Seit psycopg2-2.8
wird die Binärversion von psycopg2 nicht mehr standardmäßig installiert. Für die Installation aus dem Quellcode werden ein C-Compiler sowie die Entwicklungspakete für Postgres und Python benötigt. Da sich in Python keine Abhängigkeit in der Form psycopg2 OR psycopg2-binary angeben lässt, muss die Installationsart selbst gewählt werden.
Es stehen mehrere Möglichkeiten zur Verfügung:
- Den Paketmanager der Distribution verwenden.
- Bei der Installation von Patroni mit pip eines der Pakete
psycopg3,psycopg2oderpsycopg2-binaryin der Liste der Abhängigkeiten angeben.
Allgemeine Installation mit pip
Patroni lässt sich mit pip installieren:
Dabei kann dependencies leer sein oder aus einem oder mehreren der folgenden Einträge bestehen:
etcd oder etcd3
Modul python-etcd, um etcd als verteilten Konfigurationsspeicher (DCS) zu verwenden
consul
Modul py-consul, um Consul als DCS zu verwenden
zookeeper
Modul kazoo, um ZooKeeper als DCS zu verwenden
exhibitor
Modul kazoo, um Exhibitor als DCS zu verwenden (dieselben Abhängigkeiten wie für ZooKeeper)
kubernetes
Modul kubernetes
, um Kubernetes als DCS in Patroni zu verwenden
raft
Modul pysyncobj, um die Python-Implementierung von Raft als DCS zu verwenden
aws
boto3, um AWS-Callbacks zu verwenden
jsonlogger
Modul python-json-logger, um die Protokollierung
im JSON-Format zu aktivieren
systemd
systemd-python, um die sd_notify-Integration zu verwenden
all
Alle oben genannten Abhängigkeiten (außer der psycopg-Familie)
psycopg3
Modul psycopg[binary]>=3.0.0
psycopg2
Modul psycopg2>=2.5.4
psycopg2-binary
Modul psycopg2-binary
Um Patroni zusammen mit psycopg3, den Abhängigkeiten für etcd als DCS und den AWS-Callbacks zu installieren, lautet der Befehl beispielsweise:
Externe Werkzeuge, die in Skripten zur Replikaterstellung oder benutzerdefinierten Cluster-Initialisierung aufgerufen werden (z. B. WAL-E), sollten unabhängig von Patroni installiert werden.
Paketinstallation unter Linux
Für das verwendete Betriebssystem sind möglicherweise Patroni-Pakete verfügbar. Die Postgres-Community erstellt solche Pakete für:
- RHEL, RockyLinux, AlmaLinux;
- Debian und Ubuntu;
- SUSE Enterprise Linux.
Es gibt auch Pakete für direkte Abhängigkeiten von Patroni, etwa Python-Module, die möglicherweise nicht in den offiziellen Paketquellen des Betriebssystems enthalten sind.
Weitere Informationen stehen in der Dokumentation des PGDG-Repositorys .
Bei einem auf RedHat Enterprise Linux basierenden Betriebssystem werden möglicherweise zusätzlich Pakete aus EPEL benötigt; siehe die Dokumentation des EPEL-Repositorys .
Nach dem Einrichten des PGDG-Repositorys für das Betriebssystem kann Patroni installiert werden.
Die Patroni-Pakete werden von der Postgres-Community gepflegt, nicht von den Patroni-Entwicklern. Bei Unterstützungsbedarf zunächst im Postgres-Slack nachfragen.
Installation auf Debian-basierten Distributionen
Nach dem Einrichten des PGDG-Repositorys, siehe oben , Patroni mit apt installieren:
Installation auf RedHat-basierten Distributionen
Nach dem Einrichten des PGDG-Repositorys, siehe oben , Patroni mit etcd als DCS unter RHEL 9 (und davon abgeleiteten Distributionen) über dnf installieren:
Bietet die RedHat-basierte Distribution keine etcd-Pakete an, kann etcd aus PGDG installiert werden. Auf den für den DCS vorgesehenen Knoten folgende Befehle ausführen:
Falls erforderlich, die RHEL-Version im Repository durch 8 ersetzen, sodass sich pgdg-rhel8-extras ergibt. Auch auf RockyLinux, AlmaLinux, Oracle Linux usw. lautet der Repository-Name pgdg-rhelN-extras.
Installation unter SUSE Enterprise Linux
Für einige Abhängigkeiten müssen möglicherweise die SUSE-PackageHub-Repositorys aktiviert werden. Siehe die Dokumentation von SUSE PackageHub .
Unter SLES 15 kann Patroni nach dem Einrichten des PGDG-Repositorys, siehe oben , wie folgt installiert werden:
Mit aktiviertem SUSE-PackageHub-Repository lässt sich auch etcd installieren:
Upgrade
Ein Upgrade von Patroni ist sehr einfach: Die Softwareinstallation aktualisieren und den Patroni-Daemon auf jedem Knoten im Cluster neu starten.
Der Neustart des Patroni-Daemons führt jedoch zu einem Neustart der Postgres-Datenbank. Dies kann unter bestimmten Umständen ein Failover des Primärservers auslösen. Deshalb wird empfohlen, den Cluster bis zum Abschluss des Patroni-Daemon-Neustarts in den Wartungsmodus zu versetzen.
Dazu auf einem der Patroni-Knoten folgenden Befehl ausführen:
Anschließend auf jedem Clusterknoten das für das Betriebssystem erforderliche Paketupgrade durchführen:
Den Patroni-Daemon-Prozess auf jedem Knoten neu starten:
Abschließend die Postgres-Überwachung durch Patroni wieder aufnehmen und damit den Wartungsmodus beenden:
Der Cluster ist nun mit der neuen Patroni-Version wieder voll betriebsbereit.
3 - Patroni-Konfiguration
Es gibt 3 Arten der Patroni-Konfiguration:
-
Globale dynamische Konfiguration .
Diese Optionen werden im DCS (verteilter Konfigurationsspeicher) gespeichert und auf allen Clusterknoten angewendet. Die dynamische Konfiguration kann jederzeit mit dem Werkzeug patronictl_edit_config oder der REST API von Patroni festgelegt werden. Gehören die geänderten Optionen nicht zur Startkonfiguration, werden sie asynchron (beim nächsten Aufwachen der Verarbeitungsschleife) auf jedem Knoten angewendet; dessen Konfiguration wird anschließend neu geladen. Erfordert ein Knoten einen Neustart, um die Konfiguration anzuwenden (wenn sich Werte von PostgreSQL-Parametern mit dem Kontext postmaster geändert haben), wird dies durch das spezielle Flagpending_restartim JSON members.data gekennzeichnet. Zusätzlich zeigt der Knotenstatus"restart_pending": truean. -
Lokale Konfigurationsdatei (patroni.yml).
Diese Optionen werden in der Konfigurationsdatei definiert und haben Vorrang vor der dynamischen Konfiguration.patroni.ymlkann zur Laufzeit geändert und neu geladen werden (ohne Patroni neu zu starten), indem SIGHUP an den Patroni-Prozess gesendet, die REST-API-AnfragePOST /reloadgestellt oder patronictl_reload ausgeführt wird. Die lokale Konfiguration kann entweder aus einer einzelnen YAML-Datei oder einem Verzeichnis bestehen. Bei einem Verzeichnis werden alle darin enthaltenen YAML-Dateien nacheinander in sortierter Reihenfolge geladen. Ist ein Schlüssel in mehreren Dateien definiert, hat sein Vorkommen in der letzten Datei Vorrang. -
Umgebungskonfiguration .
Einige „lokale“ Konfigurationsparameter können über Umgebungsvariablen festgelegt oder überschrieben werden. Die Umgebungskonfiguration ist sehr nützlich in dynamischen Umgebungen, in denen einige Parameter nicht im Voraus bekannt sind (beispielsweise lässt sich beim Betrieb indockerdie externe IP-Adresse nicht im Voraus kennen).
Wichtige Regeln
Von Patroni gesteuerte PostgreSQL-Parameter
Einige PostgreSQL-Parameter müssen auf dem Primärserver und den Replikaten dieselben Werte haben. Für diese Parameter haben Werte aus den lokalen Patroni-Konfigurationsdateien oder aus Umgebungsvariablen keine Wirkung. Um ihre Werte zu ändern oder festzulegen, muss die gemeinsame Konfiguration im DCS geändert werden. Die folgende Liste enthält diese Parameter mit ihren Standard- und Mindestwerten:
- max_connections: Standardwert 100, Mindestwert 25
- max_locks_per_transaction: Standardwert 64, Mindestwert 32
- max_worker_processes: Standardwert 8, Mindestwert 2
- max_prepared_transactions: Standardwert 0, Mindestwert 0
- wal_level: Standardwert hot_standby, zulässige Werte: hot_standby, replica, logical
- track_commit_timestamp: Standardwert off
Für die folgenden Parameter verlangt PostgreSQL keine gleichen Werte auf dem Primärserver und allen Replikaten. Da ein Replikat jedoch jederzeit zum Primärserver werden kann, sind unterschiedliche Werte kaum sinnvoll; daher erlaubt Patroni das Festlegen ihrer Werte ausschließlich über die dynamische Konfiguration .
- max_wal_senders: Standardwert 10, Mindestwert 3
- max_replication_slots: Standardwert 10, Mindestwert 4
- wal_keep_segments: Standardwert 8, Mindestwert 1
- wal_keep_size: Standardwert 128MB, Mindestwert 16MB
- wal_log_hints: on
Diese Parameter werden auf sinnvolle Werte beziehungsweise die Einhaltung eines Mindestwerts geprüft.
Patroni steuert außerdem einige weitere Postgres-Parameter:
- listen_addresses - wird aus
postgresql.listenoder der UmgebungsvariablenPATRONI_POSTGRESQL_LISTENgesetzt - port - wird aus
postgresql.listenoder der UmgebungsvariablenPATRONI_POSTGRESQL_LISTENgesetzt - cluster_name - wird aus
scopeoder der UmgebungsvariablenPATRONI_SCOPEgesetzt - hot_standby: on
Zur Sicherheit werden die Parameter aus den obigen Listen in postgresql.conf geschrieben und als Argumentliste an postgres übergeben. Dadurch haben sie die höchste Priorität (ausgenommen wal_keep_segments und wal_keep_size), noch vor ALTER SYSTEM
.
Einige Parameter wie postgresql.listen und postgresql.data_dir können nur lokal festgelegt werden, also in der Patroni-Konfigurationsdatei oder über eine Konfigurationsvariable . In den meisten Fällen überschreibt die lokale Konfiguration die dynamische Konfiguration.
Beim Anwenden lokaler oder dynamischer Konfigurationsoptionen werden folgende Schritte ausgeführt:
- Der Knoten prüft zunächst, ob eine Datei
postgresql.base.confvorhanden oder der Parametercustom_confgesetzt ist. - Ist
custom_confgesetzt, dient die dort angegebene Datei als Basiskonfiguration;postgresql.base.confundpostgresql.confwerden ignoriert. - Ist
custom_confnicht gesetzt und existiertpostgresql.base.conf, enthält diese Datei die umbenannte „ursprüngliche“ Konfiguration und dient als Basiskonfiguration. - Ist weder
custom_confgesetzt nochpostgresql.base.confvorhanden, wird die ursprünglichepostgresql.confinpostgresql.base.confumbenannt und als Basiskonfiguration verwendet. - Die dynamischen Optionen werden (mit den obigen Ausnahmen) in
postgresql.confgeschrieben. Inpostgresql.confwird außerdem ein include für die Basiskonfiguration gesetzt (entwederpostgresql.base.confoder die Datei auscustom_conf). So lassen sich neue Optionen anwenden, ohne die Konfigurationsdatei erneut einzulesen, um das Vorhandensein des include zu prüfen. - Einige Parameter, die für die Clusterverwaltung durch Patroni wesentlich sind, werden über die Befehlszeile überschrieben.
- Wird eine Option geändert, die einen Neustart erfordert (hierfür sollten der Kontext in pg_settings und die tatsächlichen Werte dieser Optionen betrachtet werden), wird auf diesem Knoten das Flag pending_restart gesetzt. Dieses Flag wird bei jedem Neustart zurückgesetzt.
Die Parameter werden in der folgenden Reihenfolge angewendet (Laufzeitparameter haben die höchste Priorität):
- Parameter aus der Datei
postgresql.base.confladen (oder aus einercustom_conf-Datei, falls gesetzt) - Parameter aus der Datei
postgresql.confladen - Parameter aus der Datei
postgresql.auto.confladen - Laufzeitparameter über
-o --name=value
Dies ermöglicht die Konfiguration aller Knoten (2) sowie eines bestimmten Knotens mit ALTER SYSTEM (3) und stellt sicher, dass für den Betrieb von Patroni wesentliche Parameter durchgesetzt werden (4). Zugleich bleibt Raum für Konfigurationswerkzeuge, die postgresql.conf direkt ohne Beteiligung von Patroni verwalten (1).
PostgreSQL-Parameter mit Einfluss auf den gemeinsam genutzten Speicher
PostgreSQL hat einige Parameter, die die Größe des von ihnen verwendeten gemeinsam genutzten Speichers bestimmen:
- max_connections
- max_prepared_transactions
- max_locks_per_transaction
- max_wal_senders
- max_worker_processes
Änderungen dieser Parameter werden erst nach einem PostgreSQL-Neustart wirksam. Ihre Strukturen im gemeinsam genutzten Speicher dürfen auf den Standby-Knoten nicht kleiner sein als auf dem Primärserver.
Wie bereits erläutert, erlaubt Patroni Änderungen ihrer Werte nur über die dynamische Konfiguration . Dies umfasst üblicherweise:
- Änderungen mit patronictl_edit_config
anwenden (oder über den REST-API-Endpunkt
/config) - Knoten mit patronictl_restart
neu starten (oder über den REST-API-Endpunkt
/restart)
Hinweis: PostgreSQL-Knoten sollten mit dem Befehl patronictl_restart
oder über den REST-API-Endpunkt /restart neu gestartet werden. Der Versuch, PostgreSQL durch einen Neustart des Patroni-Daemons neu zu starten, etwa mit systemctl restart patroni, kann beim Neustart des Primärservers ein Failover im Cluster auslösen.
Da diese Einstellungen den gemeinsam genutzten Speicher steuern, ist beim Neustart der Knoten zusätzliche Sorgfalt erforderlich:
-
Wenn der Wert einer dieser Einstellungen erhöht werden soll:
- Zuerst alle Standbys neu starten
- Danach den Primärserver neu starten
-
Wenn der Wert einer dieser Einstellungen verringert werden soll:
- Zuerst den Primärserver neu starten
- Danach alle Standbys neu starten
Hinweis: Wenn nach einer Verringerung einer dieser Einstellungen alle Knoten auf einmal neu gestartet werden, ignoriert Patroni die Änderung und startet den Standby mit dem ursprünglichen Wert neu. Daher müssen die Standbys später erneut neu gestartet werden. So verhindert Patroni eine endlose Absturzschleife des Standbys: PostgreSQL beendet sich mit einer FATAL-Meldung, wenn einer dieser Parameter auf einen niedrigeren Wert gesetzt wird als den, den pg_controldata auf dem Standby-Knoten ausweist. Die Einstellung kann auf dem Standby also erst verringert werden, wenn dessen pg_controldata hinsichtlich dieser Änderungen auf dem Primärserver aktuell ist.
Weitere Informationen dazu enthält die Administrationsübersicht von PostgreSQL .
Patroni-Konfigurationsparameter
Auch die folgenden Patroni-Konfigurationsoptionen können nur dynamisch geändert werden:
- ttl: 30
- loop_wait: 10
- retry_timeout: 10
- maximum_lag_on_failover: 1048576
- max_timelines_history: 0
- check_timeline: false
- postgresql.use_slots: true
Bei einer Änderung dieser Optionen liest Patroni den entsprechenden Abschnitt der im DCS gespeicherten Konfiguration und ändert seine Laufzeitwerte.
Patroni-Knoten schreiben den Zustand der DCS-Optionen bei jeder Konfigurationsänderung in die Datei patroni.dynamic.json im Postgres-Datenverzeichnis. Nur der Leader darf diese Optionen aus der gespeicherten Datei wiederherstellen, wenn sie im DCS vollständig fehlen oder ungültig sind.
Konfiguration erzeugen und validieren
Patroni bietet Befehlszeilenschnittstellen zum Erzeugen und Validieren einer lokalen Patroni-Konfiguration
. Mit dem ausführbaren Programm patroni lässt sich:
- Eine lokale Patroni-Beispielkonfiguration erstellen;
- Eine Patroni-Konfigurationsdatei für die lokal laufende PostgreSQL-Instanz erstellen (etwa als Vorbereitung für die Patroni-Integration );
- Eine angegebene Patroni-Konfigurationsdatei validieren.
Patroni-Beispielkonfiguration
Beschreibung
Erzeugt eine Patroni-Beispielkonfigurationsdatei im Format yaml. Parameterwerte werden über die Umgebungskonfiguration
festgelegt. Sind sie dort nicht gesetzt, werden die Standardwerte von Patroni verwendet oder die Zeichenfolge #FIXME für Werte, die der Benutzer später festlegen sollte.
Einige Standardwerte werden anhand der lokalen Umgebung bestimmt:
- postgresql.listen: die von
getaddrinfoaufgelöste IP-Adresse zum Hostnamen des aktuellen Rechners, dengethostnamezurückgibt, und der Standardport5432.- postgresql.connect_address: die von
getaddrinfoaufgelöste IP-Adresse zum Hostnamen des aktuellen Rechners, dengethostnamezurückgibt, und der Standardport5432.- postgresql.authentication.rewind: wird nur definiert, wenn die PostgreSQL-Version anhand der Programmdatei ermittelt werden kann und mindestens 11 ist.
- restapi.listen: die von
getaddrinfoaufgelöste IP-Adresse zum Hostnamen des aktuellen Rechners, dengethostnamezurückgibt, und der Standardport8008.- restapi.connect_address: die von
getaddrinfoaufgelöste IP-Adresse zum Hostnamen des aktuellen Rechners, dengethostnamezurückgibt, und der Standardport8008.
Parameter
configfile - vollständiger Pfad zur Konfigurationsdatei, in der das Ergebnis gespeichert wird. Fehlt die Angabe, wird das Ergebnis an stdout ausgegeben.
Patroni-Konfiguration für eine laufende Instanz
Beschreibung
Erzeugt eine Patroni-Konfiguration im Format yaml für die lokal laufende PostgreSQL-Instanz. Für die Verbindung zu PostgreSQL wird entweder der angegebene DSN (hat Vorrang) oder die PostgreSQL-Umgebungsvariablen
verwendet. Ist kein Passwort angegeben, sollte es auf Aufforderung eingegeben werden.
Alle nicht internen GUCs der Quellinstanz von Postgres dienen als Quelle für die folgenden Patroni-Konfigurationsparameter, unabhängig davon, ob sie über eine Konfigurationsdatei, die postmaster-Befehlszeile oder Umgebungsvariablen gesetzt wurden:
- scope: Wert des GUC
cluster_name;- postgresql.listen: Werte der GUCs
listen_addressesundport;- postgresql.data_dir: Wert des GUC
data_directory;- postgresql.parameters: Werte der GUCs
archive_command,restore_command,archive_cleanup_command,recovery_end_command,ssl_passphrase_command,hba_file,ident_file,config_file;- bootstrap.dcs: alle anderen ermittelten PostgreSQL-GUCs.
Wird scope, postgresql.listen oder postgresql.data_dir nicht aus den Postgres-GUCs gesetzt, wird der jeweilige Wert aus der Umgebungskonfiguration
verwendet.
Weitere Regeln zur Bestimmung der Werte:
- name: Wert der Umgebungsvariablen
PATRONI_NAME, falls gesetzt, andernfalls der Hostname des aktuellen Rechners.- postgresql.bin_dir: Pfad zu den Postgres-Programmdateien, ermittelt aus der laufenden Instanz.
- postgresql.connect_address: die von
getaddrinfoaufgelöste IP-Adresse zum Hostnamen des aktuellen Rechners, dengethostnamezurückgibt, und der für die Verbindung zur Instanz verwendete Port oder der Wert des GUCport.- postgresql.authentication.superuser: die für die Verbindung zur Instanz verwendete Konfiguration;
- postgresql.pg_hba: die aus der
hba_fileder Quellinstanz gelesenen Zeilen.- postgresql.pg_ident: die aus der
ident_fileder Quellinstanz gelesenen Zeilen.- restapi.listen: die von
getaddrinfoaufgelöste IP-Adresse zum Hostnamen des aktuellen Rechners, dengethostnamezurückgibt, und der Standardport8008.- restapi.connect_address: die von
getaddrinfoaufgelöste IP-Adresse zum Hostnamen des aktuellen Rechners, dengethostnamezurückgibt, und der Standardport8008.
Weitere über die Umgebungskonfiguration definierte Parameter werden ebenfalls in die Konfiguration aufgenommen.
Parameter
configfile
Vollständiger Pfad zur Konfigurationsdatei, in der das Ergebnis gespeichert wird. Fehlt die Angabe, wird das Ergebnis an stdout ausgegeben.
dsn
Optionale DSN-Zeichenfolge für die lokale PostgreSQL-Instanz, aus der die GUC-Werte ermittelt werden sollen.
Patroni-Konfiguration validieren
Beschreibung
Validiert die angegebene Patroni-Konfiguration und gibt Informationen zu fehlgeschlagenen Prüfungen aus.
Parameter
configfile
Vollständiger Pfad zur zu prüfenden Konfigurationsdatei. Ist er nicht angegeben oder existiert die Datei nicht, wird versucht, die Konfiguration aus der Umgebungsvariablen PATRONI_CONFIGURATION oder, falls diese nicht gesetzt ist, aus den Patroni-Umgebungsvariablen
zu lesen.
--ignore-listen-port | -i
Optionales Flag, um bei der Validierung von configfile Bindungsfehler für bereits belegte listen-Ports zu ignorieren.
--print | -p
Optionales Flag, um die lokale Konfiguration (einschließlich der durch die Umgebungskonfiguration überschriebenen Werte) nach erfolgreicher Validierung auszugeben.
3.1 - Dynamische Konfigurationseinstellungen
Die dynamische Konfiguration wird im DCS (verteilter Konfigurationsspeicher) gespeichert und auf allen Clusterknoten angewendet.
Zum Ändern der dynamischen Konfiguration kann entweder das Werkzeug patronictl_edit_config oder die REST API von Patroni verwendet werden.
- loop_wait: Anzahl der Sekunden, die die Schleife schläft. Standardwert: 10, kleinster zulässiger Wert: 1
- ttl: TTL für den Erwerb der Leader-Sperre (in Sekunden). Sie entspricht der Zeitspanne bis zum Beginn eines automatischen Failovers. Standardwert: 30, kleinster zulässiger Wert: 20
- retry_timeout: Zeitüberschreitung für Wiederholungsversuche bei DCS- und PostgreSQL-Operationen (in Sekunden). Kürzer andauernde DCS- oder Netzwerkprobleme führen nicht dazu, dass Patroni den Leader herabstuft. Standardwert: 10, kleinster zulässiger Wert: 3
Beim Ändern von loop_wait, retry_timeout oder ttl muss folgende Regel eingehalten werden:
- maximum_lag_on_failover: maximaler Rückstand eines Followers in Bytes, mit dem er noch an der Leader-Wahl teilnehmen darf.
- primary_race_backoff: verschiebt die Leader-Wahl auf Standbys um
primary_race_backoffSekunden, wenn die WAL-Replikation vom Primärserver noch voranschreitet. Dies minimiert unnötige Failovers durch ein kurzzeitig nicht reagierendes Patroni. Standardwert: 0 (deaktiviert). - maximum_lag_on_syncnode: maximaler Rückstand eines synchronen Followers in Bytes, bevor er als fehlerhafter Kandidat gilt und durch einen fehlerfreien asynchronen Follower ersetzt wird. Bei mehr als einem Follower verwendet Patroni die höchste Replikat-LSN, andernfalls die aktuelle WAL-LSN des Leaders. Der Standardwert ist -1. Bei einem Wert von 0 oder weniger tauscht Patroni einen fehlerhaften synchronen Follower nicht aus. Den Wert ausreichend hoch wählen, damit Patroni bei hohem Transaktionsaufkommen synchrone Follower nicht häufig austauscht.
- max_timelines_history: maximale Anzahl der im DCS gespeicherten Einträge des Timeline-Verlaufs. Standardwert: 0. Bei 0 wird der vollständige Verlauf im DCS gespeichert.
- primary_start_timeout: Zeit, die ein Primärserver zur Erholung von Fehlern erhält, bevor ein Failover ausgelöst wird (in Sekunden). Der Standardwert beträgt 300 Sekunden. Bei 0 erfolgt das Failover nach Möglichkeit sofort nach Erkennung eines Absturzes. Bei asynchroner Replikation kann ein Failover zum Verlust von Transaktionen führen. Im schlimmsten Fall beträgt die Failover-Zeit bei Ausfall des Primärservers: loop_wait + primary_start_timeout + loop_wait. Ist primary_start_timeout jedoch null, beträgt sie nur loop_wait. Den Wert entsprechend der Abwägung zwischen Dauerhaftigkeit und Verfügbarkeit festlegen.
- primary_stop_timeout: Anzahl der Sekunden, die Patroni beim Stoppen von Postgres warten darf; wirkt nur bei aktiviertem synchronous_mode. Ist der Wert auf > 0 gesetzt und synchronous_mode aktiviert, sendet Patroni SIGKILL an den postmaster, wenn der Stoppvorgang länger als primary_stop_timeout dauert. Den Wert entsprechend der Abwägung zwischen Dauerhaftigkeit und Verfügbarkeit festlegen. Ist der Parameter nicht gesetzt oder auf <= 0 gesetzt, wird primary_stop_timeout nicht angewendet.
- synchronous_mode: aktiviert den synchronen Replikationsmodus. Mögliche Werte:
off,on,quorum. In diesem Modus verwaltet der Leadersynchronous_standby_names; nur der zuletzt bekannte Leader oder eines der synchronen Replikate darf an der Leader-Wahl teilnehmen. Der synchrone Modus gewährleistet, dass erfolgreich festgeschriebene Transaktionen bei einem Failover nicht verloren gehen. Dafür entfällt die Schreibverfügbarkeit, wenn Patroni die Dauerhaftigkeit der Transaktionen nicht sicherstellen kann. Einzelheiten enthält die Dokumentation der Replikationsmodi . - synchronous_mode_strict: verhindert das Deaktivieren der synchronen Replikation, wenn keine synchronen Replikate verfügbar sind, und blockiert dadurch alle Schreibzugriffe von Clients auf den Primärserver. Im prioritätsbasierten synchronen Modus (
synchronous_mode: on) setzt Patroni 4.1.5synchronous_standby_namesauf*, wenn kein geeignetes synchrones Replikat verfügbar ist. Einzelheiten enthält die Dokumentation der Replikationsmodi . - synchronous_node_count: bei aktiviertem synchronous_mode
verwaltet Patroni mit diesem Parameter die genaue Anzahl synchroner Standby-Instanzen und passt beim Hinzukommen und Ausscheiden von Mitgliedern den Zustand im DCS und den PostgreSQL-Parameter
synchronous_standby_namesan. Ist der Wert höher als die Anzahl geeigneter Knoten, wird er automatisch angepasst. Standardwert:1. - failsafe_mode: aktiviert den DCS-Failsafe-Modus
. Standardwert:
false. - postgresql:
- use_pg_rewind: bestimmt, ob pg_rewind verwendet wird. Standardwert:
false. Der Cluster muss mitdata page checksums(Option--data-checksumsfürinitdb) initialisiert worden sein und/oderwal_log_hintsmuss aufongesetzt sein, andernfalls funktioniertpg_rewindnicht. - use_slots: bestimmt, ob Replikationsslots verwendet werden. Standardwert unter PostgreSQL 9.4+:
true. - recovery_conf: zusätzliche Konfigurationseinstellungen, die beim Konfigurieren eines Followers in recovery.conf geschrieben werden. Ab PostgreSQL 12 gibt es keine recovery.conf mehr; dieser Abschnitt kann dennoch weiter verwendet werden, da Patroni dies transparent handhabt.
- parameters: Konfigurationsparameter (GUCs) für Postgres im Format
{max_connections: 100, wal_level: "replica", max_wal_senders: 10, wal_log_hints: "on"}. Viele davon sind für die Replikation erforderlich. - parameters_primary: (optional) rollenspezifische Parameterüberschreibungen für primary. Diese Werte werden mit den grundlegenden parameters zusammengeführt und überschreiben sie.
- parameters_replica: (optional) rollenspezifische Parameterüberschreibungen für replica. Diese Werte werden mit den grundlegenden parameters zusammengeführt und überschreiben sie.
- parameters_standby_leader: (optional) rollenspezifische Parameterüberschreibungen für standby_leader. Diese Werte werden mit den grundlegenden parameters zusammengeführt und überschreiben sie.
- pg_hba: Liste der Zeilen, aus denen Patroni
pg_hba.conferzeugt. Patroni ignoriert diesen Parameter, wenn der PostgreSQL-Parameterhba_fileauf einen anderen Wert als den Standardwert gesetzt ist.- - host all all 0.0.0.0/0 md5
- - host replication replicator 127.0.0.1/32 md5: Eine solche Zeile ist für die Replikation erforderlich.
- pg_hba_primary: (optional) rollenspezifische pg_hba-Einträge für primary. Sie ersetzen pg_hba vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_hba verwendet.
- pg_hba_replica: (optional) rollenspezifische pg_hba-Einträge für replica. Sie ersetzen pg_hba vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_hba verwendet.
- pg_hba_standby_leader: (optional) rollenspezifische pg_hba-Einträge für standby_leader. Sie ersetzen pg_hba vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_hba verwendet.
- pg_ident: Liste der Zeilen, aus denen Patroni
pg_ident.conferzeugt. Patroni ignoriert diesen Parameter, wenn der PostgreSQL-Parameterident_fileauf einen anderen Wert als den Standardwert gesetzt ist.- - mapname1 systemname1 pguser1
- - mapname1 systemname2 pguser2
- pg_ident_primary: (optional) rollenspezifische pg_ident-Einträge für primary. Sie ersetzen pg_ident vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_ident verwendet.
- pg_ident_replica: (optional) rollenspezifische pg_ident-Einträge für replica. Sie ersetzen pg_ident vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_ident verwendet.
- pg_ident_standby_leader: (optional) rollenspezifische pg_ident-Einträge für standby_leader. Sie ersetzen pg_ident vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_ident verwendet.
- use_pg_rewind: bestimmt, ob pg_rewind verwendet wird. Standardwert:
- standby_cluster: ist dieser Abschnitt definiert, soll ein Standby-Cluster initialisiert werden.
- host: Adresse des entfernten Knotens
- port: Port des entfernten Knotens
- primary_slot_name: auf dem entfernten Knoten für die Replikation zu verwendender Slot. Dieser Parameter ist optional; der Standardwert wird aus dem Instanznamen abgeleitet (siehe Funktion
slot_name_from_member_name). - create_replica_methods: geordnete Liste der Methoden, mit denen ein Standby-Leader vom entfernten Primärserver initialisiert werden kann. Sie kann sich von der in postgresql_settings definierten Liste unterscheiden.
- restore_command: Befehl zur Wiederherstellung von WAL-Einträgen des entfernten Primärservers auf den Knoten eines Standby-Clusters. Er kann sich von der in postgresql_settings definierten Liste unterscheiden.
- archive_cleanup_command: Bereinigungsbefehl für den Standby-Leader
- recovery_min_apply_delay: Wartezeit vor dem tatsächlichen Anwenden von WAL-Einträgen auf einem Standby-Leader
- member_slots_ttl: Aufbewahrungszeit physischer Replikationsslots für heruntergefahrene Replikate. Standardwert:
30min. Bei0bleibt das bisherige Verhalten erhalten (der Slot wird sofort entfernt, wenn der Mitgliedsschlüssel im DCS abläuft). Die Funktion wird erst ab PostgreSQL 11 unterstützt. - slots: definiert permanente Replikationsslots. Diese Slots bleiben bei einem Switchover/Failover erhalten. Nicht vorhandene permanente Slots werden von Patroni erstellt. Ab PostgreSQL 11 werden permanente physische Slots auf allen Knoten angelegt und ihre Position alle loop_wait Sekunden vorgerückt. Bei PostgreSQL-Versionen vor 11 werden permanente physische Replikationsslots nur auf dem aktuellen Primärserver verwaltet. Logische Slots werden mit einem Neustart vom Primärserver auf einen Standby kopiert; anschließend wird ihre Position bei Bedarf alle loop_wait Sekunden vorgerückt. Das Kopieren der Dateien logischer Slots erfolgt über eine
libpq-Verbindung mit den Zugangsdaten für rewind oder den Superuser (siehe Abschnitt postgresql.authentication). Die Position eines logischen Slots auf dem Replikat kann immer etwas hinter der des bisherigen Primärservers liegen. Daher sollte die Anwendung darauf vorbereitet sein, dass einige Nachrichten nach einem Failover erneut empfangen werden können. Am einfachsten lässt sich dies durch Verfolgen vonconfirmed_flush_lsnhandhaben. Permanente Replikationsslots erfordern, dass postgresql.use_slots auftruegesetzt ist. Sind permanente logische Replikationsslots definiert, aktiviert Patroni automatischhot_standby_feedback. Da das Failover logischer Replikationsslots unter PostgreSQL 9.6 und älter unsicher ist und PostgreSQL 10 einige wichtige Funktionen fehlen, wird diese Funktion nur unter PostgreSQL 11+ unterstützt.- my_slot_name: Name des permanenten Replikationsslots. Entspricht der Name des permanenten Slots dem Namen des aktuellen Knotens, wird er auf diesem Knoten nicht erstellt. Wird ein permanenter physischer Replikationsslot hinzugefügt, dessen Name dem eines Patroni-Mitglieds entspricht, stellt Patroni sicher, dass der erstellte Slot auch dann nicht entfernt wird, wenn das zugehörige Mitglied nicht mehr reagiert. Normalerweise würde Patroni den Slot in dieser Situation entfernen. Das kann nützlich sein, etwa wenn die von Mitgliedern verwendeten Replikationsslots während vorübergehender Ausfälle erhalten bleiben sollen oder bestehende Mitglieder in einen neuen Patroni-Cluster übernommen werden (siehe Eine eigenständige Instanz in einen Patroni-Cluster überführen
). Betreiber sollten jedoch darauf achten, solche Namensüberschneidungen nicht im DCS zu belassen, wenn der Slot nicht mehr benötigt wird, da sie den normalen Betrieb von Patroni beeinflussen.
- type: Slot-Typ. Möglich sind
physicaloderlogical. Bei einem logischen Slot müssen zusätzlichdatabaseundplugindefiniert werden. Bei einem physischen Slot kann optionalcluster_typedefiniert werden. - database: Name der Datenbank, in der logische Slots erstellt werden sollen.
- plugin: Name des Plugins für den logischen Slot.
- cluster_type: Clustertyp (
primaryoderstandby), auf dem der Slot ausschließlich erstellt werden soll. Andernfalls wird er nicht erstellt beziehungsweise ein bereits vorhandener Slot gelöscht.
- type: Slot-Typ. Möglich sind
- my_slot_name: Name des permanenten Replikationsslots. Entspricht der Name des permanenten Slots dem Namen des aktuellen Knotens, wird er auf diesem Knoten nicht erstellt. Wird ein permanenter physischer Replikationsslot hinzugefügt, dessen Name dem eines Patroni-Mitglieds entspricht, stellt Patroni sicher, dass der erstellte Slot auch dann nicht entfernt wird, wenn das zugehörige Mitglied nicht mehr reagiert. Normalerweise würde Patroni den Slot in dieser Situation entfernen. Das kann nützlich sein, etwa wenn die von Mitgliedern verwendeten Replikationsslots während vorübergehender Ausfälle erhalten bleiben sollen oder bestehende Mitglieder in einen neuen Patroni-Cluster übernommen werden (siehe Eine eigenständige Instanz in einen Patroni-Cluster überführen
). Betreiber sollten jedoch darauf achten, solche Namensüberschneidungen nicht im DCS zu belassen, wenn der Slot nicht mehr benötigt wird, da sie den normalen Betrieb von Patroni beeinflussen.
- ignore_slots: Liste von Gruppen von Replikationsslot-Eigenschaften; Patroni soll Slots ignorieren, die diesen Eigenschaften entsprechen. Diese Konfiguration/Funktion ist nützlich, wenn einige Replikationsslots außerhalb von Patroni verwaltet werden. Jede passende Teilmenge von Eigenschaften führt dazu, dass ein Slot ignoriert wird.
- name: Name des Replikationsslots.
- type: Slot-Typ. Möglich sind
physicaloderlogical. Bei einem logischen Slot können zusätzlichdatabaseund/oderplugindefiniert werden. - database: Datenbankname (beim Abgleich eines
logical-Slots). - plugin: Plugin für logische Dekodierung (beim Abgleich eines
logical-Slots).
Hinweis: slots ist eine Hashmap, ignore_slots dagegen ein Array. Beispiel:
Hinweis: Unter PostgreSQL v11 oder neuer verwaltet Patroni physische Replikationsslots auf allen Knoten, die potenziell Leader werden können. Replikatknoten halten dadurch WAL-Segmente vor, die andere Knoten möglicherweise benötigen. Ist ein Knoten nicht verfügbar und läuft sein Mitgliedsschlüssel im DCS ab, wird der zugehörige Replikationsslot nach member_slots_ttl entfernt (Standardwert 30min). Die Aufbewahrungszeit kann je nach Bedarf erhöht oder verringert werden. Bei einer statischen Clustertopologie (feste Anzahl von Knoten, deren Namen sich nie ändern) können alternativ permanente physische Replikationsslots mit den Namen der Knoten konfiguriert werden. So werden Slots nicht entfernt und WAL-Dateien nicht wiederverwendet, während ein Replikat vorübergehend ausgefallen ist:
Permanente Replikationsslots werden nur von primary/standby_leader zu Replikatknoten synchronisiert. Anwendungen sollen sie daher ausschließlich auf dem Leader-Knoten verwenden. Ihre Verwendung auf Replikatknoten führt zu unbegrenztem Wachstum von pg_wal auf allen anderen Knoten des Clusters. Ausgenommen sind physische Slots, deren Namen den Patroni-Mitgliedsnamen entsprechen (von Patroni erstellt und verwaltet). Diese werden zwischen allen Knoten synchronisiert, da sie für die Replikation untereinander verwendet werden.
Das Tag nostream auf einem Standby deaktiviert das Kopieren und Synchronisieren permanenter logischer Replikationsslots auf dem Knoten selbst sowie auf all seinen etwaigen kaskadierenden Replikaten.
3.2 - YAML-Konfigurationseinstellungen
Global/Allgemein
- thread_pool_size: Größe des Threadpools, mit dem Patroni asynchrone Aufgaben ausführt und während der Leader-Wahl oder bei Failsafe-Prüfungen über die REST API mit anderen Mitgliedern kommuniziert. Mindestwert:
5, Standardwert:5. - thread_stack_size: legt die Stackgröße für von Patroni gestartete Threads fest. Der Wert muss an
64kBausgerichtet sein. Mindestwert:64kB, Standardwert (von Patroni gesetzt):512kB. - name: Name des Hosts. Er muss im Cluster eindeutig sein.
- namespace: Pfad im Konfigurationsspeicher, unter dem Patroni Informationen über den Cluster speichert. Standardwert: “/service”
- scope: Clustername
Protokollierung
- type: legt das Protokollformat fest. Mögliche Werte sind plain und json. Für das Format json muss jsonlogger installiert sein. Der Standardwert ist plain.
- level: legt die allgemeine Protokollierungsstufe fest. Standardwert: INFO (siehe Dokumentation der Python-Protokollierung )
- traceback_level: legt die Stufe fest, auf der Tracebacks sichtbar sind. Standardwert: ERROR. Auf DEBUG setzen, wenn Tracebacks nur bei aktiviertem log.level=DEBUG sichtbar sein sollen.
- format: legt die Formatzeichenfolge für Protokolle fest. Beim Protokolltyp plain sollte das Format eine Zeichenfolge sein. Verfügbare Attribute stehen unter LogRecord-Attribute . Beim Protokolltyp json kann das Format neben einer Zeichenfolge auch eine Liste sein. Jeder Listeneintrag sollte einem LogRecord-Attribut entsprechen. Dabei wird nur der Feldname benötigt; %( und ) sollten weggelassen werden. Um ein Protokollfeld unter einem anderen Schlüsselnamen auszugeben, ein Dictionary verwenden: Der Schlüssel bezeichnet das Protokollfeld, der Wert den im Protokoll auszugebenden Feldnamen. Standardwert: %(asctime)s %(levelname)s: %(message)s
- dateformat: legt die Formatzeichenfolge für Datum und Uhrzeit fest (siehe Dokumentation zu formatTime() ).
- static_fields: fügt dem Protokoll zusätzliche Felder hinzu. Diese Option ist nur verfügbar, wenn der Protokolltyp auf json gesetzt ist.
- max_queue_size: Patroni verwendet eine zweistufige Protokollierung. Protokolleinträge werden in eine Warteschlange im Arbeitsspeicher geschrieben; ein separater Thread entnimmt sie und schreibt sie nach stderr oder in eine Datei. Die interne Warteschlange ist standardmäßig auf 1000 Einträge begrenzt, was für die Protokolle der letzten 1h20m ausreicht.
- dir: Verzeichnis für die Anwendungsprotokolle. Es muss existieren und für den Benutzer, der Patroni ausführt, beschreibbar sein. Ist dieser Wert gesetzt, bewahrt die Anwendung standardmäßig 4 Protokolldateien mit jeweils 25MB auf. Diese Aufbewahrungswerte lassen sich mit
file_numundfile_sizeanpassen (siehe unten). - mode: Berechtigungen für Protokolldateien (z. B.
0644). Ohne Angabe werden die Berechtigungen anhand des aktuellen umask-Werts gesetzt. - file_num: Anzahl der aufzubewahrenden Anwendungsprotokolle.
- file_size: Größe der Datei patroni.log (in Bytes), bei der eine Protokollrotation ausgelöst wird.
- loggers: dieser Abschnitt ermöglicht das Neufestlegen der Protokollierungsstufe je Python-Modul
- patroni.postmaster: WARNING
- urllib3: DEBUG
- deduplicate_heartbeat_logs: bei
truewerden aufeinanderfolgende identische Heartbeat-Protokolleinträge nicht ausgegeben. Standardwert:false.
Der Ausführungszeitpunkt der HA-Schleife kann bei der Diagnose von Failovers aufgrund erschöpfter Ressourcen und ähnlicher Probleme sehr wertvoll sein. Ist deduplicate_heartbeat_logs auf true gesetzt, wird für die Ausführung der HA-Schleife kein Protokolleintrag erzeugt (außer bei einem Leader-Wechsel). Diese möglicherweise nützliche Information steht dann in den Protokollen nicht zur Verfügung.
Das folgende Beispiel konfiguriert Patroni für die Protokollierung im JSON-Format.
Bootstrap-Konfiguration
Sobald Patroni den Cluster erstmals initialisiert und die Einstellungen im DCS gespeichert hat, haben spätere Änderungen am Abschnitt bootstrap.dcs der YAML-Konfiguration keine Wirkung mehr! Zum Ändern dieser Einstellungen entweder patronictl_edit_config
oder die REST API
von Patroni verwenden.
- bootstrap:
-
dcs: dieser Abschnitt wird nach der Initialisierung des neuen Clusters in
/<namespace>/<scope>/configdes angegebenen Konfigurationsspeichers geschrieben. Er enthält die globale dynamische Konfiguration des Clusters. Unterbootstrap.dcskönnen alle unter Dynamische Konfigurationseinstellungen beschriebenen Parameter angegeben werden. Nachdem Patroni den neuen Cluster initialisiert hat (Bootstrap), schreibt es diesen Abschnitt in/<namespace>/<scope>/configdes Konfigurationsspeichers. -
method: benutzerdefiniertes Skript zur Initialisierung dieses Clusters.
Einzelheiten enthält die Dokumentation benutzerdefinierter Bootstrap-Methoden . Bei Angabe von
initdbwird der standardmäßige Befehlinitdbverwendet.initdbwird auch aufgerufen, wenn die Konfigurationsdatei keinen Parametermethodenthält. -
initdb: (optional) Liste der an initdb zu übergebenden Optionen.
- - data-checksums: muss aktiviert sein, wenn pg_rewind unter 9.3 benötigt wird.
- - encoding: UTF8: Standardzeichencodierung für neue Datenbanken.
- - locale: UTF8: Standard-Locale für neue Datenbanken.
-
post_bootstrap oder post_init: Zusätzliches Skript, das nach der Initialisierung des Clusters ausgeführt wird. Es erhält eine Verbindungs-URL (mit dem Cluster-Superuser als Benutzername). Die Variable PGPASSFILE wird auf den Pfad der pgpass-Datei gesetzt.
-
Citus
Aktiviert die Integration von Patroni mit Citus . Ist sie konfiguriert, übernimmt Patroni die Registrierung der Citus-Worker-Knoten beim Coordinator. Weitere Informationen zur Citus-Unterstützung stehen hier .
- group: Citus-Gruppen-ID als Ganzzahl. Für den Coordinator
0verwenden, für Worker1,2usw. - database: Datenbank, in der die Erweiterung citus erstellt werden sollte. Sie muss auf dem Coordinator und allen Workern identisch sein. Derzeit wird nur eine Datenbank unterstützt.
Consul
Die meisten Parameter sind optional, aber host oder url muss angegeben werden.
- host: host:port des lokalen Consul-Agenten.
- url: URL des lokalen Consul-Agenten im Format: http(s)://host:port
- port: (optional) Consul-Port
- scheme: (optional) http oder https, Standardwert http
- token: (optional) ACL-Token
- verify: (optional) bestimmt, ob das SSL-Zertifikat bei HTTPS-Anfragen geprüft wird
- cacert: (optional) CA-Zertifikat. Falls vorhanden, wird die Validierung aktiviert.
- cert: (optional) Datei mit dem Clientzertifikat
- key: (optional) Datei mit dem Clientschlüssel. Kann leer sein, wenn der Schlüssel Bestandteil von cert ist.
- dc: (optional) Rechenzentrum, mit dem kommuniziert werden soll. Standardmäßig wird das Rechenzentrum des Hosts verwendet.
- consistency: (optional) wählt den Konsistenzmodus von Consul. Mögliche Werte:
default,consistentoderstale(Einzelheiten in der Consul-API-Referenz ) - checks: (optional) Liste der für die Sitzung verwendeten Consul Health Checks. Standardmäßig wird eine leere Liste verwendet.
- register_service: (optional) bestimmt, ob ein Dienst registriert wird, dessen Name durch den Parameter scope festgelegt ist und der je nach Knotenrolle das Tag master, primary, replica oder standby-leader erhält. Standardwert false
- service_tags: (optional) zusätzliche statische Tags für den Consul-Dienst neben der Rolle (
primary/replica/standby-leader). Standardmäßig wird eine leere Liste verwendet. - service_check_interval: (optional) Häufigkeit der Health Checks für die registrierte URL. Standardwert: ‘5s’.
- service_check_tls_server_name: (optional) überschreibt den SNI-Host bei TLS-Verbindungen; siehe auch die API-Referenz für Consul-Agent-Prüfungen .
token benötigt folgende ACL-Berechtigungen:
service_prefix "${scope}" {
    policy = "write"
}
key_prefix "${namespace}/${scope}" {
    policy = "write"
}
session_prefix "" {
    policy = "write"
}
etcd
Die meisten Parameter sind optional, aber einer der Parameter host, hosts, url, proxy oder srv muss angegeben werden.
- host: host:port des etcd-Endpunkts.
- hosts: Liste der etcd-Endpunkte im Format host1:port1,host2:port2,etc… Möglich sind eine durch Kommas getrennte Zeichenfolge oder eine YAML-Liste.
- use_proxies: ist dieser Parameter auf true gesetzt, behandelt Patroni hosts als Liste von Proxys und ermittelt nicht die Topologie des etcd-Clusters.
- url: URL für etcd.
- proxy: Proxy-URL für etcd. Bei einer Verbindung zu etcd über einen Proxy diesen Parameter anstelle von url verwenden.
- srv: Domain, in der nach SRV-Einträgen für die automatische Clustererkennung gesucht wird. Patroni fragt für die angegebene Domain diese SRV-Dienstnamen ab (in dieser Reihenfolge bis zum ersten Erfolg):
_etcd-client-ssl,_etcd-client,_etcd-ssl,_etcd,_etcd-server-ssl,_etcd-server. Werden SRV-Einträge für_etcd-server-ssloder_etcd-servergefunden, wird über das ETCD-Peer-Protokoll bei ETCD nach verfügbaren Mitgliedern gefragt. Andernfalls werden die Hosts aus den SRV-Einträgen verwendet. - srv_suffix: konfiguriert ein Suffix für den bei der Erkennung abgefragten SRV-Namen. Mit diesem Flag lassen sich mehrere etcd-Cluster unter derselben Domain unterscheiden. Es funktioniert nur zusammen mit srv. Sind beispielsweise
srv_suffix: fooundsrv: example.orggesetzt, wird folgende DNS-SRV-Abfrage ausgeführt:_etcd-client-ssl-foo._tcp.example.org(entsprechend für jeden möglichen ETCD-SRV-Dienstnamen). - protocol: (optional) http oder https; ohne Angabe wird http verwendet. Ist url oder proxy angegeben, wird das Protokoll daraus übernommen.
- username: (optional) Benutzername für die etcd-Authentifizierung.
- password: (optional) Passwort für die etcd-Authentifizierung.
- cacert: (optional) CA-Zertifikat. Falls vorhanden, wird die Validierung aktiviert.
- cert: (optional) Datei mit dem Clientzertifikat
- key: (optional) Datei mit dem Clientschlüssel. Kann leer sein, wenn der Schlüssel Bestandteil von cert ist.
Etcdv3
Damit Patroni mit dem etcd-Cluster über Protokollversion 3 arbeitet, muss in der Patroni-Konfigurationsdatei der Abschnitt etcd3 verwendet werden. Alle Konfigurationsparameter entsprechen denen für etcd.
Mit Protokollversion 2 erstellte Schlüssel sind mit Protokollversion 3 nicht sichtbar und umgekehrt. Daher ist ein Wechsel von etcd zu etcd3 allein durch Ändern der Patroni-Konfigurationsdatei nicht möglich. Zudem verwendet Patroni das gRPC-Gateway (Proxy) von etcd zur Kommunikation mit der V3 API, weshalb eine TLS-Authentifizierung über den Common Name nicht möglich ist.
ZooKeeper
- hosts: Liste der ZooKeeper-Clustermitglieder im Format: .
- use_ssl: (optional) bestimmt, ob SSL verwendet wird. Standardwert:
false. Beifalsewerden alle SSL-spezifischen Parameter ignoriert. - cacert: (optional) CA-Zertifikat. Falls vorhanden, wird die Validierung aktiviert.
- cert: (optional) Datei mit dem Clientzertifikat.
- key: (optional) Datei mit dem Clientschlüssel.
- key_password: (optional) Passwort für den Clientschlüssel.
- verify: (optional) bestimmt, ob das Zertifikat geprüft wird. Standardwert:
true. - set_acls: (optional) falls gesetzt, wird Kazoo so konfiguriert, dass es auf jeden neu erstellten ZNode eine Standard-ACL anwendet. ACLs können das Schema
x509(Standard) oder andere unterstützte ZooKeeper-Schemata wiedigestverwenden. Sie sollten als Dictionary angegeben werden, dessen Schlüssel der vollständige Principal (optional mit vorangestelltem Schema) und dessen Wert eine Liste von Berechtigungen ist. Als Berechtigungen sind eine oder mehrere ausCREATE,READ,WRITE,DELETE,ADMINoderALLmöglich. Beispiel:set_acls: {CN=principal1: [CREATE, READ], digest:principal2:+pjROuBuuwNNSujKyH8dGcEnFPQ=: [ALL]}. - auth_data: (optional) Zugangsdaten für die Verbindung. Sollte ein Dictionary mit
schemeals Schlüssel undcredentialals Wert sein. Standardwert ist ein leeres Dictionary.
Für SSL-Unterstützung muss kazoo>=2.6.0 installiert sein.
Exhibitor
- hosts: anfängliche Liste der Exhibitor-Knoten (ZooKeeper) im Format: ‘host1,host2,etc…’. Diese Liste wird bei jeder Änderung der Topologie des Exhibitor-Clusters (ZooKeeper) automatisch aktualisiert.
- poll_interval: Häufigkeit, mit der die Liste der ZooKeeper- und Exhibitor-Knoten von Exhibitor aktualisiert werden sollte.
- port: Exhibitor-Port.
Kubernetes
- bypass_api_service: (optional) bei der Kommunikation mit der Kubernetes API verwendet Patroni normalerweise den Dienst kubernetes
, dessen Adresse den Pods über die Umgebungsvariable
KUBERNETES_SERVICE_HOSTbereitgestellt wird. Istbypass_api_serviceauftruegesetzt, ermittelt Patroni die Liste der API-Knoten hinter dem Dienst und verbindet sich direkt mit ihnen. - namespace: (optional) Kubernetes-Namespace, in dem der Patroni-Pod läuft. Standardwert:
default. - labels: Labels im Format
{label1: value1, label2: value2}. Mit diesen Labels werden vorhandene Objekte (Pods sowie Endpoints oder ConfigMaps) gesucht, die zum aktuellen Cluster gehören. Außerdem setzt Patroni sie auf jedem von ihm erstellten Objekt (Endpoint oder ConfigMap). - scope_label: (optional) Name des Labels mit dem Clusternamen. Standardwert:
cluster-name. - bootstrap_labels: (optional) Labels im Format
{label1: value1, label2: value2}. Sie werden einem Patroni-Pod zugewiesen, wenn sein Zustandinitializing new cluster,running custom bootstrap script,starting after custom bootstrapodercreating replicaist. - role_label: (optional) Name des Labels mit der Rolle (
primary,replicaoder ein anderer benutzerdefinierter Wert). Patroni setzt dieses Label auf dem Pod, in dem es läuft. Standardwert:role. - leader_label_value: (optional) Wert des Pod-Labels, wenn die Postgres-Rolle
primaryist. Standardwert:primary. - follower_label_value: (optional) Wert des Pod-Labels, wenn die Postgres-Rolle
replicaist. Standardwert:replica. - standby_leader_label_value: (optional) Wert des Pod-Labels, wenn die Postgres-Rolle
standby_leaderist. Standardwert:primary. - tmp_role_label: (optional) Name des temporären Labels mit der Rolle (
primaryoderreplica). Der Wert dieses Labels entspricht immer dem Standardwert der jeweiligen Rolle. Nur bei Bedarf setzen. - use_endpoints: (optional) bei true verwendet Patroni Endpoints anstelle von ConfigMaps für die Leader-Wahl und zum Speichern des Clusterzustands.
- pod_ip: (optional) IP-Adresse des Pods, in dem Patroni läuft. Dieser Wert ist erforderlich, wenn
use_endpointsaktiviert ist, und wird beim Hochstufen von PostgreSQL im Pod zum Befüllen der Subsets des Leader-Endpoints verwendet. - ports: (optional) enthält das Service-Objekt einen Namen für den Port, muss derselbe Name im Endpoint-Objekt erscheinen; andernfalls funktioniert der Dienst nicht. Ist der Dienst beispielsweise als
{Kind: Service, spec: {ports: [{name: postgresql, port: 5432, targetPort: 5432}]}}definiert, musskubernetes.ports: [{"name": "postgresql", "port": 5432}]gesetzt werden. Patroni verwendet dies zum Aktualisieren der Subsets des Leader-Endpoints. Dieser Parameter wird nur verwendet, wennkubernetes.use_endpointsgesetzt ist. - cacert: (optional) gibt die CA_BUNDLE-Datei mit den Zertifikaten vertrauenswürdiger CAs an, die zum Prüfen der SSL-Zertifikate der Kubernetes API verwendet werden. Ohne Angabe verwendet Patroni den Wert aus dem ServiceAccount-Secret.
- retriable_http_codes: (optional) Liste der HTTP-Statuscodes der K8s API, bei denen ein erneuter Versuch erfolgt. Standardmäßig wiederholt Patroni die Anfrage bei
500,503und504oder wenn die Antwort der K8s API den HTTP-Headerretry-afterenthält.
Raft (veraltet)
-
self_addr:
ip:port, an dem auf Raft-Verbindungen gewartet wird.self_addrmuss von anderen Clusterknoten aus erreichbar sein. Ohne Angabe nimmt der Knoten nicht am Konsens teil. -
bind_addr: (optional)
ip:port, an dem auf Raft-Verbindungen gewartet wird. Ohne Angabe wirdself_addrverwendet. -
partner_addrs: Liste der anderen Patroni-Knoten im Cluster im Format:
-
data_dir: Verzeichnis zum Speichern des Raft-Logs und des Snapshots. Ohne Angabe wird das aktuelle Arbeitsverzeichnis verwendet.
-
password: (optional) verschlüsselt den Raft-Datenverkehr mit dem angegebenen Passwort; erfordert das Python-Modul
cryptography. -
min_timeout: (optional) minimale Zeitüberschreitung für Wahlen in der zugrunde liegenden Raft-Implementierung pysyncobj, in Sekunden. Muss größer als 3 *
append_entries_periodsein. Standardwert:0.4. -
max_timeout: (optional) maximale Zeitüberschreitung für Wahlen in der zugrunde liegenden Raft-Implementierung pysyncobj, in Sekunden. Muss größer als
min_timeoutsein. Standardwert:1.4. -
connection_timeout: (optional) Zeit in Sekunden, nach der eine Verbindung ohne Datenempfang als unterbrochen gilt. Muss größer oder gleich
max_timeoutsein. Standardwert:3.5. -
append_entries_period: (optional) Intervall in Sekunden zum Senden von Heartbeat-Befehlen (append_entries). Muss kleiner als ein Drittel von
min_timeoutsein. Standardwert:0.1. -
connection_retry_time: (optional) Intervall in Sekunden zwischen erneuten Verbindungsversuchen zu nicht erreichbaren Knoten. Standardwert:
5.0. -
leader_fallback_timeout: (optional) Zeit in Sekunden, nach der ein Leader ohne Antwort von der Mehrheit in den Follower-Zustand zurückkehrt. Muss größer als
append_entries_periodsein. Standardwert:30.0.
Diese Zeitüberschreitungsparameter sind in Netzwerken mit hoher Latenz nützlich, in denen die standardmäßigen Zeitüberschreitungen von pysyncobj zu kurz sind. Folgende Bedingungen müssen erfüllt sein: min_timeout > 3 * append_entries_period, max_timeout > min_timeout, connection_timeout >= max_timeout und leader_fallback_timeout > append_entries_period. Patroni prüft diese Bedingungen beim Start und verweigert den Start, wenn sie verletzt sind. Diese Werte können nicht zur Laufzeit geändert werden und erfordern einen Neustart.
[!WARNING]
Diese Einstellungen verlängern lediglich die Zeitüberschreitungen für Wahlen und Verbindungen in pysyncobj; sie verlängern nicht die Frist, die Patroni jedem einzelnen Raft-Befehl setzt. Jeder Raft-Befehl (Aktualisierung der Leader-Sperre, Schreiben des Clusterzustands) muss weiterhin innerhalb von retry_timeout (Standardwert 10) abgeschlossen sein. Bei Verbindungen mit sehr hoher Latenz – ungefähr ab einigen Sekunden Round-Trip-Zeit – kann ein einzelner Befehl retry_timeout überschreiten, selbst wenn connection_timeout deutlich über die RTT angehoben wurde. Der DCS erscheint dann als nicht erreichbar, und der Primärserver kann herabgestuft werden. Bei solchen Verbindungen müssen auch retry_timeout und ttl entsprechend angehoben werden; dabei muss loop_wait + 2 * retry_timeout <= ttl weiterhin gelten.
Kurze FAQ zur Raft-Implementierung
-
F: Wie lassen sich alle am Konsens beteiligten Knoten auflisten?
A:
syncobj_admin -conn host:port -status, wobei host:port die Adresse eines Clusterknotens ist. -
F: Ein am Konsens beteiligter Knoten ist ausgefallen, und seine IP-Adresse kann nicht für einen anderen Knoten wiederverwendet werden. Wie lässt sich dieser Knoten aus dem Konsens entfernen?
A:
syncobj_admin -conn host:port -remove host2:port2, wobeihost2:port2die Adresse des Knotens ist, der aus dem Konsens entfernt werden soll. -
F: Woher bekommt man das Werkzeug
syncobj_admin?A: Es wird zusammen mit dem Modul
pysyncobj(RAFT-Implementierung in Python) installiert, von dem Patroni abhängt. -
F: Kann ein Patroni-Knoten betrieben werden, ohne ihn in den Konsens aufzunehmen?
A: Ja, dazu
raft.self_addrin der Patroni-Konfiguration auskommentieren oder entfernen. -
F: Können Patroni und PostgreSQL auf nur zwei Knoten betrieben werden?
A: Ja, auf dem dritten Knoten kann
patroni_raft_controllerlaufen (ohne Patroni und PostgreSQL). Bei dieser Konfiguration kann ein Knoten vorübergehend ausfallen, ohne den Primärserver zu beeinträchtigen.
PostgreSQL
- postgresql:
-
authentication:
- superuser:
- username: Name des Superusers, der bei der Initialisierung (initdb) festgelegt und später von Patroni für Verbindungen zu Postgres verwendet wird.
- password: Passwort des Superusers, das bei der Initialisierung (initdb) festgelegt wird.
- sslmode: (optional) entspricht dem Verbindungsparameter sslmode
, der dem Client die Auswahl des Modus für die TLS-Aushandlung mit dem Server erlaubt. Einzelheiten zur Funktionsweise der einzelnen Modi stehen in der PostgreSQL-Dokumentation
. Der Standardmodus ist
prefer. - sslkey: (optional) entspricht dem Verbindungsparameter sslkey , der den Speicherort des geheimen Schlüssels für das Clientzertifikat angibt.
- sslpassword: (optional) entspricht dem Verbindungsparameter sslpassword
, der das Passwort für den in
sslkeyangegebenen geheimen Schlüssel festlegt. - sslcert: (optional) entspricht dem Verbindungsparameter sslcert , der den Speicherort des Clientzertifikats angibt.
- sslrootcert: (optional) entspricht dem Verbindungsparameter sslrootcert , der den Pfad zu einer Datei mit einem oder mehreren Zertifikaten von Zertifizierungsstellen (CA) angibt, mit denen der Client ein Serverzertifikat prüft.
- sslcrl: (optional) entspricht dem Verbindungsparameter sslcrl , der den Pfad zu einer Datei mit einer Zertifikatsperrliste angibt. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- sslcrldir: (optional) entspricht dem Verbindungsparameter sslcrldir , der den Pfad zu einem Verzeichnis mit Dateien angibt, die eine Zertifikatsperrliste enthalten. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- sslnegotiation: (optional) entspricht dem Verbindungsparameter sslnegotiation , der steuert, wie die SSL-Verschlüsselung mit dem Server ausgehandelt wird, falls SSL verwendet wird.
- gssencmode: (optional) entspricht dem Verbindungsparameter gssencmode , der bestimmt, ob und mit welcher Priorität eine sichere GSS-Verbindung über TCP/IP mit dem Server ausgehandelt wird.
- channel_binding: (optional) entspricht dem Verbindungsparameter channel_binding , der die Verwendung von Channel Binding durch den Client steuert.
- replication:
- username: Benutzername für die Replikation; der Benutzer wird bei der Initialisierung erstellt. Replikate verwenden ihn, um per Streaming-Replikation auf die Replikationsquelle zuzugreifen.
- password: Passwort für die Replikation; der Benutzer wird bei der Initialisierung erstellt.
- sslmode: (optional) entspricht dem Verbindungsparameter sslmode
, der dem Client die Auswahl des Modus für die TLS-Aushandlung mit dem Server erlaubt. Einzelheiten zur Funktionsweise der einzelnen Modi stehen in der PostgreSQL-Dokumentation
. Der Standardmodus ist
prefer. - sslkey: (optional) entspricht dem Verbindungsparameter sslkey , der den Speicherort des geheimen Schlüssels für das Clientzertifikat angibt.
- sslpassword: (optional) entspricht dem Verbindungsparameter sslpassword
, der das Passwort für den in
sslkeyangegebenen geheimen Schlüssel festlegt. - sslcert: (optional) entspricht dem Verbindungsparameter sslcert , der den Speicherort des Clientzertifikats angibt.
- sslrootcert: (optional) entspricht dem Verbindungsparameter sslrootcert , der den Pfad zu einer Datei mit einem oder mehreren Zertifikaten von Zertifizierungsstellen (CA) angibt, mit denen der Client ein Serverzertifikat prüft.
- sslcrl: (optional) entspricht dem Verbindungsparameter sslcrl , der den Pfad zu einer Datei mit einer Zertifikatsperrliste angibt. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- sslcrldir: (optional) entspricht dem Verbindungsparameter sslcrldir , der den Pfad zu einem Verzeichnis mit Dateien angibt, die eine Zertifikatsperrliste enthalten. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- sslnegotiation: (optional) entspricht dem Verbindungsparameter sslnegotiation , der steuert, wie die SSL-Verschlüsselung mit dem Server ausgehandelt wird, falls SSL verwendet wird.
- gssencmode: (optional) entspricht dem Verbindungsparameter gssencmode , der bestimmt, ob und mit welcher Priorität eine sichere GSS-Verbindung über TCP/IP mit dem Server ausgehandelt wird.
- channel_binding: (optional) entspricht dem Verbindungsparameter channel_binding , der die Verwendung von Channel Binding durch den Client steuert.
- rewind:
- username: (optional) Name des Benutzers für
pg_rewind; er wird bei der Initialisierung von Postgres 11+ erstellt und erhält alle erforderlichen Berechtigungen . - password: (optional) Passwort des Benutzers für
pg_rewind; er wird bei der Initialisierung erstellt. - sslmode: (optional) entspricht dem Verbindungsparameter sslmode
, der dem Client die Auswahl des Modus für die TLS-Aushandlung mit dem Server erlaubt. Einzelheiten zur Funktionsweise der einzelnen Modi stehen in der PostgreSQL-Dokumentation
. Der Standardmodus ist
prefer. - sslkey: (optional) entspricht dem Verbindungsparameter sslkey , der den Speicherort des geheimen Schlüssels für das Clientzertifikat angibt.
- sslpassword: (optional) entspricht dem Verbindungsparameter sslpassword
, der das Passwort für den in
sslkeyangegebenen geheimen Schlüssel festlegt. - sslcert: (optional) entspricht dem Verbindungsparameter sslcert , der den Speicherort des Clientzertifikats angibt.
- sslrootcert: (optional) entspricht dem Verbindungsparameter sslrootcert , der den Pfad zu einer Datei mit einem oder mehreren Zertifikaten von Zertifizierungsstellen (CA) angibt, mit denen der Client ein Serverzertifikat prüft.
- sslcrl: (optional) entspricht dem Verbindungsparameter sslcrl , der den Pfad zu einer Datei mit einer Zertifikatsperrliste angibt. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- sslcrldir: (optional) entspricht dem Verbindungsparameter sslcrldir , der den Pfad zu einem Verzeichnis mit Dateien angibt, die eine Zertifikatsperrliste enthalten. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- sslnegotiation: (optional) entspricht dem Verbindungsparameter sslnegotiation , der steuert, wie die SSL-Verschlüsselung mit dem Server ausgehandelt wird, falls SSL verwendet wird.
- gssencmode: (optional) entspricht dem Verbindungsparameter gssencmode , der bestimmt, ob und mit welcher Priorität eine sichere GSS-Verbindung über TCP/IP mit dem Server ausgehandelt wird.
- channel_binding: (optional) entspricht dem Verbindungsparameter channel_binding , der die Verwendung von Channel Binding durch den Client steuert.
- username: (optional) Name des Benutzers für
- superuser:
-
callbacks: Callback-Skripte, die bei bestimmten Aktionen ausgeführt werden. Patroni übergibt Aktion, Rolle und Clusternamen. (scripts/aws.py zeigt ein Beispiel für solche Skripte.)
- on_reload: führt dieses Skript aus, wenn das Neuladen der Konfiguration ausgelöst wird.
- on_restart: führt dieses Skript aus, wenn Postgres neu startet (ohne Rollenwechsel).
- on_role_change: führt dieses Skript aus, wenn Postgres hoch- oder herabgestuft wird.
- on_start: führt dieses Skript aus, wenn Postgres startet.
- on_stop: führt dieses Skript aus, wenn Postgres stoppt.
-
connect_address: IP-Adresse + Port, über die Postgres für andere Knoten und Anwendungen erreichbar ist.
-
proxy_address: IP-Adresse + Port, über die ein neben Postgres laufender Verbindungspool (z. B. PgBouncer) erreichbar ist. Der Wert wird als
proxy_urlin den Mitgliedsschlüssel im DCS geschrieben und kann für die Diensterkennung verwendet werden beziehungsweise nützlich sein. -
create_replica_methods: geordnete Liste der Erstellungsmethoden, mit denen ein Patroni-Knoten zu einem neuen Replikat wird. Die Standardmethode ist “basebackup”; andere Methoden verweisen auf Skripte, die jeweils mit einem eigenen Konfigurationseintrag konfiguriert werden. Weitere Erläuterungen enthält die Dokumentation benutzerdefinierter Methoden zur Replikaterstellung .
-
data_dir: Pfad zum Postgres-Datenverzeichnis, das bereits existiert oder von Patroni initialisiert werden soll.
-
config_dir: Pfad zum Postgres-Konfigurationsverzeichnis; standardmäßig das Datenverzeichnis. Es muss für Patroni beschreibbar sein.
-
bin_dir: (optional) Pfad zu den PostgreSQL-Programmdateien (pg_ctl, initdb, pg_controldata, pg_basebackup, postgres, pg_isready, pg_rewind). Ohne Angabe oder bei einer leeren Zeichenfolge werden die Programme über die Umgebungsvariable PATH gesucht.
-
bin_name: (optional) ermöglicht das Überschreiben der Postgres-Programmnamen bei einer benutzerdefinierten Postgres-Distribution:
- pg_ctl: (optional) benutzerdefinierter Name für die Programmdatei
pg_ctl. - initdb: (optional) benutzerdefinierter Name für die Programmdatei
initdb. - pg_controldata: (optional) benutzerdefinierter Name für die Programmdatei
pg_controldata. - pg_basebackup: (optional) benutzerdefinierter Name für die Programmdatei
pg_basebackup. - postgres: (optional) benutzerdefinierter Name für die Programmdatei
postgres. - pg_isready: (optional) benutzerdefinierter Name für die Programmdatei
pg_isready. - pg_rewind: (optional) benutzerdefinierter Name für die Programmdatei
pg_rewind.
- pg_ctl: (optional) benutzerdefinierter Name für die Programmdatei
-
listen: IP-Adresse + Port, an denen Postgres auf Verbindungen wartet; bei Streaming-Replikation müssen sie von anderen Clusterknoten aus erreichbar sein. Mehrere durch Kommas getrennte Adressen sind zulässig, sofern der Port nach der letzten Adresse mit einem Doppelpunkt angehängt wird, etwa
listen: 127.0.0.1,127.0.0.2:5432. Patroni verwendet die erste Adresse dieser Liste, um lokale Verbindungen zum PostgreSQL-Knoten aufzubauen. -
use_unix_socket: legt fest, dass Patroni für die Verbindung zum Cluster bevorzugt Unix-Sockets verwenden sollte. Standardwert:
false. Istunix_socket_directoriesdefiniert, verwendet Patroni daraus den ersten geeigneten Wert für die Verbindung zum Cluster und greift auf TCP zurück, wenn kein Wert geeignet ist. Istunix_socket_directoriesnicht inpostgresql.parametersangegeben, nimmt Patroni an, dass der Standardwert verwendet werden sollte, und lässthostin den Verbindungsparametern weg. -
use_unix_socket_repl: legt fest, dass Patroni für die Clusterverbindung des Replikationsbenutzers bevorzugt Unix-Sockets verwenden sollte. Standardwert:
false. Istunix_socket_directoriesdefiniert, verwendet Patroni daraus den ersten geeigneten Wert für die Verbindung zum Cluster und greift auf TCP zurück, wenn kein Wert geeignet ist. Istunix_socket_directoriesnicht inpostgresql.parametersangegeben, nimmt Patroni an, dass der Standardwert verwendet werden sollte, und lässthostin den Verbindungsparametern weg. -
pgpass: Pfad zur Passwortdatei .pgpass . Patroni erstellt diese Datei vor dem Ausführen von pg_basebackup, des Skripts post_init und in einigen weiteren Fällen. Der Speicherort muss für Patroni beschreibbar sein.
-
recovery_conf: zusätzliche Konfigurationseinstellungen, die beim Konfigurieren eines Followers in recovery.conf geschrieben werden.
-
custom_conf : Pfad zu einer optionalen benutzerdefinierten Datei
postgresql.conf, die anstelle vonpostgresql.base.confverwendet wird. Sie muss auf allen Clusterknoten existieren, für PostgreSQL lesbar sein und wird von ihrem Speicherort aus in die tatsächlichepostgresql.confeingebunden. Patroni überwacht diese Datei weder auf Änderungen noch erstellt es ein Backup davon. Ihre Einstellungen können dennoch durch Patronis eigene Konfigurationsmöglichkeiten überschrieben werden; Einzelheiten stehen unter Dynamische Konfiguration . -
parameters: Konfigurationsparameter (GUCs) für Postgres im Format
{ssl: "on", ssl_cert_file: "cert_file"}. -
parameters_primary: (optional) rollenspezifische Parameterüberschreibungen für primary. Diese Werte werden mit den grundlegenden parameters zusammengeführt und überschreiben sie.
-
parameters_replica: (optional) rollenspezifische Parameterüberschreibungen für replica. Diese Werte werden mit den grundlegenden parameters zusammengeführt und überschreiben sie.
-
parameters_standby_leader: (optional) rollenspezifische Parameterüberschreibungen für standby_leader. Diese Werte werden mit den grundlegenden parameters zusammengeführt und überschreiben sie.
-
pg_hba: Liste der Zeilen, aus denen Patroni
pg_hba.conferzeugt. Patroni ignoriert diesen Parameter, wenn der PostgreSQL-Parameterhba_fileauf einen anderen Wert als den Standardwert gesetzt ist. Zusammen mit der dynamischen Konfiguration vereinfacht dieser Parameter die Verwaltung vonpg_hba.conf.- - host all all 0.0.0.0/0 md5
- - host replication replicator 127.0.0.1/32 md5: Eine solche Zeile ist für die Replikation erforderlich.
-
pg_hba_primary: (optional) rollenspezifische pg_hba-Einträge für primary. Sie ersetzen pg_hba vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_hba verwendet.
-
pg_hba_replica: (optional) rollenspezifische pg_hba-Einträge für replica. Sie ersetzen pg_hba vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_hba verwendet.
-
pg_hba_standby_leader: (optional) rollenspezifische pg_hba-Einträge für standby_leader. Sie ersetzen pg_hba vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_hba verwendet.
-
pg_ident: Liste der Zeilen, aus denen Patroni
pg_ident.conferzeugt. Patroni ignoriert diesen Parameter, wenn der PostgreSQL-Parameterident_fileauf einen anderen Wert als den Standardwert gesetzt ist. Zusammen mit der dynamischen Konfiguration vereinfacht dieser Parameter die Verwaltung vonpg_ident.conf.- - mapname1 systemname1 pguser1
- - mapname1 systemname2 pguser2
-
pg_ident_primary: (optional) rollenspezifische pg_ident-Einträge für primary. Sie ersetzen pg_ident vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_ident verwendet.
-
pg_ident_replica: (optional) rollenspezifische pg_ident-Einträge für replica. Sie ersetzen pg_ident vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_ident verwendet.
-
pg_ident_standby_leader: (optional) rollenspezifische pg_ident-Einträge für standby_leader. Sie ersetzen pg_ident vollständig (keine Zusammenführung). Sind sie nicht definiert, wird pg_ident verwendet.
-
pg_ctl_timeout: Wartezeit für pg_ctl bei
start,stopoderrestart. Der Standardwert beträgt 60 Sekunden. -
use_pg_rewind: versucht, pg_rewind auf dem bisherigen Leader zu verwenden, wenn er dem Cluster als Replikat beitritt. Der Cluster muss mit
data page checksums(Option--data-checksumsfürinitdb) initialisiert worden sein und/oderwal_log_hintsmuss aufongesetzt sein, andernfalls funktioniertpg_rewindnicht. -
rewind: (optional) benutzerdefinierte Optionen für den Befehl
pg_rewind. Sie können als Liste von Zeichenfolgen und/oder Dictionaries mit jeweils einem Schlüssel-Wert-Paar angegeben werden. Zu den nicht zulässigen Optionen gehören:target-pgdata,source-pgdata,source-server,write-recovery-conf,dry-run,restore-target-wal,config-file,no-ensure-shutdown,versionundhelp. Beispiel: -
remove_data_directory_on_rewind_failure: ist diese Option aktiviert, entfernt Patroni das PostgreSQL-Datenverzeichnis und erstellt das Replikat neu. Andernfalls versucht es, dem neuen Leader zu folgen. Standardwert: false.
-
remove_data_directory_on_diverged_timelines: Patroni entfernt das PostgreSQL-Datenverzeichnis und erstellt das Replikat neu, wenn es auseinanderlaufende Timelines erkennt und der bisherige Primärserver nicht mit dem Streaming vom neuen Primärserver beginnen kann. Diese Option ist nützlich, wenn
pg_rewindnicht verwendet werden kann. Beim Prüfen auf auseinanderlaufende Timelines unter PostgreSQL v10 und älter versucht Patroni, sich mit den Replikationszugangsdaten zur Datenbank “postgres” zu verbinden. Daher sollte dieser Zugriff in pg_hba.conf erlaubt sein. Standardwert: false. -
replica_method: für jeden Eintrag in create_replica_methods außer basebackup wird ein gleichnamiger Konfigurationsabschnitt hinzugefügt. Er sollte mindestens “command” mit dem vollständigen Pfad zum auszuführenden Skript enthalten. Andere Konfigurationsparameter werden im Format “parameter=value” an das Skript übergeben.
-
pre_promote: Fencing-Skript, das während eines Failovers nach dem Erwerb der Leader-Sperre, aber vor dem Hochstufen des Replikats ausgeführt wird. Endet das Skript mit einem von null verschiedenen Code, stuft Patroni das Replikat nicht hoch und entfernt den Leader-Schlüssel aus dem DCS.
-
before_stop: Skript, das unmittelbar vor dem Stoppen von Postgres ausgeführt wird. Anders als ein Callback läuft dieses Skript synchron und blockiert das Herunterfahren bis zu seinem Abschluss. Sein Rückgabecode beeinflusst nicht, ob das Herunterfahren anschließend fortgesetzt wird.
-
REST API
- restapi:
- thread_pool_size: Größe des Threadpools, mit dem Patroni REST-API-Anfragen verarbeitet. Mindestwert:
5, Standardwert:5. - connect_address: IP-Adresse (oder Hostname) und Port für den Zugriff auf die REST API von Patroni. Alle Clustermitglieder müssen diese Adresse erreichen können. Sofern die Patroni-Installation nicht als lokale Demo gedacht ist, darf daher weder “localhost” noch eine Loopback-Adresse (also “localhost” oder “127.0.0.1”) verwendet werden. Die Adresse kann als Endpunkt für HTTP Health Checks (siehe unten den REST-API-Parameter “listen”), für Benutzerabfragen (direkt oder über die REST API) sowie für die Health Checks der Clustermitglieder während der Leader-Wahl dienen (etwa um festzustellen, ob der Leader noch läuft oder ob ein Knoten eine weiter fortgeschrittene WAL-Position hat als der abfragende Knoten). connect_address wird im Mitgliedsschlüssel im DCS gespeichert, sodass sich der Mitgliedsname in die Adresse für den Zugriff auf dessen REST API auflösen lässt.
- listen: IP-Adresse (oder Hostname) und Port, an denen Patroni für die REST API auf Verbindungen wartet, um die oben beschriebenen Health Checks und die Kommunikation zwischen den beteiligten Clusterknoten bereitzustellen. Dient außerdem zum Bereitstellen von Health-Check-Informationen für HAProxy (oder jeden anderen Load-Balancer, der HTTP-Prüfungen mit “OPTIONS” oder “GET” ausführen kann).
- authentication: (optional)
- username: Benutzername für die Basic-Authentifizierung zum Schutz unsicherer REST-API-Endpunkte.
- password: Passwort für die Basic-Authentifizierung zum Schutz unsicherer REST-API-Endpunkte.
- certfile: (optional) gibt die Datei mit dem Zertifikat im PEM-Format an. Ist certfile nicht angegeben oder leer, arbeitet der API-Server ohne SSL.
- keyfile: (optional) gibt die Datei mit dem geheimen Schlüssel im PEM-Format an.
- keyfile_password: (optional) gibt ein Passwort zum Entschlüsseln der Schlüsseldatei an.
- cafile: (optional) gibt die Datei mit dem CA_BUNDLE vertrauenswürdiger CA-Zertifikate an, die zum Prüfen der Clientzertifikate verwendet werden.
- ciphers: (optional) gibt die zulässigen Cipher Suites an (z. B. “ECDHE-RSA-AES256-GCM-SHA384:DHE-RSA-AES256-GCM-SHA384:ECDHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES128-GCM-SHA256:!SSLv1:!SSLv2:!SSLv3:!TLSv1:!TLSv1.1”)
- verify_client: (optional)
none(Standard),optionaloderrequired. Beinoneprüft die REST API keine Clientzertifikate. Beirequiredsind Clientzertifikate für alle REST-API-Aufrufe erforderlich. Beioptionalsind sie für alle unsicheren REST-API-Endpunkte erforderlich. Beirequiredist die Clientauthentifizierung erfolgreich, wenn die Prüfung der Zertifikatssignatur erfolgreich ist. Beioptionalwird das Clientzertifikat nur bei Anfragen mitPUT,POST,PATCHundDELETEgeprüft. - allowlist: (optional): legt die Hosts fest, die unsichere REST-API-Endpunkte aufrufen dürfen. Ein Eintrag kann ein Hostname, eine IP-Adresse oder eine Netzwerkadresse in CIDR-Schreibweise sein. Standardmäßig gilt
allow all. Istallowlistoderallowlist_include_membersgesetzt, werden alle nicht enthaltenen Zugriffe abgelehnt. - allowlist_include_members: (optional): bei
truedürfen andere im DCS registrierte Clustermitglieder auf unsichere REST-API-Endpunkte zugreifen (IP-Adresse oder Hostname werden ausapi_urldes Mitglieds übernommen). Vorsicht: Das Betriebssystem kann für ausgehende Verbindungen eine andere IP-Adresse verwenden. - http_extra_headers: (optional) HTTP-Header ermöglichen es dem REST-API-Server, zusätzliche Informationen mit einer HTTP-Antwort zu übertragen.
- https_extra_headers: (optional) HTTPS-Header ermöglichen es dem REST-API-Server, bei aktiviertem TLS zusätzliche Informationen mit einer HTTP-Antwort zu übertragen. Die in
http_extra_headersfestgelegten Zusatzinformationen werden ebenfalls übertragen. - request_queue_size: (optional): legt die Größe der Anfragewarteschlange für den TCP-Socket der Patroni REST API fest. Ist die Warteschlange voll, erhalten weitere Anfragen den Fehler “Connection denied”. Der Standardwert ist 5.
- server_tokens: (optional): konfiguriert den Wert des HTTP-Headers
Server.Minimal: Der Header enthält nur die Patroni-Version, etwaPatroni/4.0.0.ProductOnly: Der Header enthält nur den Produktnamen, etwaPatroni.Original(Standard): Der Header behält das ursprüngliche Verhalten bei und zeigt die Versionen von BaseHTTP und Python an, etwaBaseHTTP/0.6 Python/3.12.3.
- thread_pool_size: Größe des Threadpools, mit dem Patroni REST-API-Anfragen verarbeitet. Mindestwert:
Hier ein Beispiel für http_extra_headers und https_extra_headers:
Warnung
restapi.connect_addressmuss von allen Knoten des jeweiligen Patroni-Clusters aus erreichbar sein. Intern verwendet Patroni diese Adresse während der Leader-Wahl, um die Knoten mit dem geringsten Replikationsrückstand zu ermitteln.- Ist die Prüfung von Clientzertifikaten aktiviert (
restapi.verify_clientaufrequiredgesetzt), müssen außerdem gültige Clientzertifikate inctl.certfile,ctl.keyfile,ctl.keyfile_passwordangegeben werden. Andernfalls funktioniert Patroni nicht korrekt.
CTL
- ctl: (optional)
- authentication:
- username: Benutzername für die Basic-Authentifizierung beim Zugriff auf geschützte REST-API-Endpunkte. Ohne Angabe verwendet patronictl den Wert des REST-API-Parameters “username”.
- password: Passwort für die Basic-Authentifizierung beim Zugriff auf geschützte REST-API-Endpunkte. Ohne Angabe verwendet patronictl den Wert des REST-API-Parameters “password”.
- insecure: erlaubt Verbindungen zur REST API ohne Prüfung der SSL-Zertifikate.
- cacert: gibt die CA_BUNDLE-Datei oder das Verzeichnis mit Zertifikaten vertrauenswürdiger CAs an, die zum Prüfen der SSL-Zertifikate der REST API verwendet werden. Ohne Angabe verwendet patronictl den Wert des REST-API-Parameters “cafile”.
- certfile: gibt die Datei mit dem Clientzertifikat im PEM-Format an.
- keyfile: gibt die Datei mit dem geheimen Clientschlüssel im PEM-Format an.
- keyfile_password: gibt ein Passwort zum Entschlüsseln der Clientschlüsseldatei an.
- authentication:
Watchdog
- mode:
off,automaticoderrequired. Beioffist der Watchdog deaktiviert. Beiautomaticwird er verwendet, falls verfügbar, andernfalls ignoriert. Beirequiredwird der Knoten nur dann Leader, wenn der Watchdog erfolgreich aktiviert werden kann. - device: Pfad zum Watchdog-Gerät. Standardwert:
/dev/watchdog. - safety_margin: Sicherheitsabstand in Sekunden zwischen dem Auslösen des Watchdogs und dem Ablauf des Leader-Schlüssels.
Tags
- clonefrom:
trueoderfalse. Beitruebevorzugen andere Knoten möglicherweise diesen Knoten zur Initialisierung (als Quelle fürpg_basebackup). Haben mehrere Knoten das Tagclonefromauftruegesetzt, wird die Quelle für die Initialisierung zufällig ausgewählt. Standardwert:false. - noloadbalance:
trueoderfalse. Beitrueantwortet der Knoten auf den REST-API-Health-CheckGET /replicamit HTTP-Statuscode 503 und wird dadurch von der Lastverteilung ausgeschlossen. Standardwert:false. - replicatefrom: Name eines anderen Replikats, von dem repliziert werden soll. Dient zur Unterstützung kaskadierender Replikation.
- nosync:
trueoderfalse. Beitruewird der Knoten niemals als synchrones Replikat ausgewählt. - sync_priority: Ganzzahl, die die Priorität dieses Knotens bei der Auswahl synchroner Replikate bestimmt, wenn synchronous_mode
auf
ongesetzt ist. Knoten mit höherer Priorität werden gegenüber solchen mit niedrigerer Priorität bevorzugt. Istsync_priority0 oder negativ, darf dieser Knoten nicht in den PostgreSQL-Parametersynchronous_standby_namesaufgenommen werden (wie beinosync: true). Beachten Sie, dass dieser Parameter die entgegengesetzte Bedeutung zum Wertsync_priorityin der Sichtpg_stat_replicationhat. - nofailover:
trueoderfalse; steuert, ob dieser Knoten an der Leader-Wahl teilnehmen und Leader werden darf. Standardwert:false, das heißt, dieser Knoten darf_ an Leader-Wahlen teilnehmen. - failover_priority: Ganzzahl, die die Priorität dieses Knotens bei einem Failover bestimmt. Knoten mit höherer Priorität werden gegenüber solchen mit niedrigerer Priorität bevorzugt, wenn sie dieselbe Menge WAL empfangen beziehungsweise wiedergegeben haben. Knoten mit höherer Empfangs-/Wiedergabe-LSN werden jedoch unabhängig von ihrer Priorität bevorzugt. Ist
failover_priority0 oder negativ, darf dieser Knoten weder an der Leader-Wahl teilnehmen noch Leader werden (wie beinofailover: true). Bekannte Einschränkung:failover_priorityfunktioniert derzeit nicht mit Quorum-basierter synchroner Replikation . - nostream:
trueoderfalse. Beitrueverwendet der Knoten nicht das Replikationsprotokoll zum Streamen von WAL. Stattdessen nutzt er Archiv-Recovery (fallsrestore_commandkonfiguriert ist) und fragtpg_wal/pg_xlogregelmäßig ab. Dies deaktiviert außerdem das Kopieren und Synchronisieren permanenter logischer Replikationsslots auf dem Knoten selbst und allen seinen kaskadierenden Replikaten. Auf einem Primärserver hat dieses Tag keine Wirkung.
Nur einen der Parameter nofailover oder failover_priority angeben. nofailover: true entspricht failover_priority: 0; nofailover: false gibt dem Knoten die Priorität 1.
Neben diesen vordefinierten Tags können auch eigene hinzugefügt werden:
- key1:
true - key2:
false - key3:
1.4 - key4:
"RandomString"
Tags sind in der REST API und in patronictl_list sichtbar. Mit diesen Tags lässt sich auch die Funktionsfähigkeit einer Instanz prüfen. Ist das Tag für eine Instanz nicht definiert oder stimmt sein Wert nicht mit dem abgefragten Wert überein, wird HTTP-Statuscode 503 zurückgegeben.
3.3 - Umgebungskonfiguration
Einige in der Patroni-Konfigurationsdatei definierte Parameter können über Systemumgebungsvariablen überschrieben werden. Dieses Dokument listet alle von Patroni verarbeiteten Umgebungsvariablen auf. Die über diese Variablen gesetzten Werte haben stets Vorrang vor den Werten in der Patroni-Konfigurationsdatei.
Global/Allgemein
- PATRONI_CONFIGURATION: die gesamte Patroni-Konfiguration kann über die Umgebungsvariable PATRONI_CONFIGURATION festgelegt werden. In diesem Fall werden alle anderen Umgebungsvariablen ignoriert!
- PATRONI_THREAD_POOL_SIZE: Größe des Threadpools, mit dem Patroni asynchrone Aufgaben ausführt und während der Leader-Wahl oder bei Failsafe-Prüfungen über die REST API mit anderen Mitgliedern kommuniziert. Mindestwert:
5, Standardwert:5. - PATRONI_THREAD_STACK_SIZE: legt die Stackgröße für von Patroni gestartete Threads fest. Der Wert muss an
64kBausgerichtet sein. Mindestwert:64kB, Standardwert (von Patroni gesetzt):512kB. - PATRONI_NAME: Name des Knotens, auf dem die aktuelle Patroni-Instanz läuft. Er muss im Cluster eindeutig sein.
- PATRONI_NAMESPACE: Pfad im Konfigurationsspeicher, unter dem Patroni Informationen über den Cluster speichert. Standardwert: “/service”
- PATRONI_SCOPE: Clustername
- PG_MALLOC_ARENA_MAX: benutzerdefinierter Wert für die Umgebungsvariable
MALLOC_ARENA_MAXdes Prozessespostmaster. Ist er nicht gesetzt, erbtpostmasterden Wert vonMALLOC_ARENA_MAX.
Protokollierung
- PATRONI_LOG_TYPE: legt das Protokollformat fest. Mögliche Werte sind plain und json. Für das Format json muss jsonlogger installiert sein. Der Standardwert ist plain.
- PATRONI_LOG_LEVEL: legt die allgemeine Protokollierungsstufe fest. Standardwert: INFO (siehe Dokumentation der Python-Protokollierung )
- PATRONI_LOG_TRACEBACK_LEVEL: legt die Stufe fest, auf der Tracebacks sichtbar sind. Standardwert: ERROR. Auf DEBUG setzen, wenn Tracebacks nur bei aktiviertem PATRONI_LOG_LEVEL=DEBUG sichtbar sein sollen.
- PATRONI_LOG_FORMAT: legt die Formatzeichenfolge für Protokolle fest. Beim Protokolltyp plain sollte das Format eine Zeichenfolge sein. Verfügbare Attribute stehen unter LogRecord-Attribute . Beim Protokolltyp json kann das Format neben einer Zeichenfolge auch eine Liste sein. Jeder Listeneintrag sollte einem LogRecord-Attribut entsprechen. Dabei wird nur der Feldname benötigt; %( und ) sollten weggelassen werden. Um ein Protokollfeld unter einem anderen Schlüsselnamen auszugeben, ein Dictionary verwenden: Der Schlüssel bezeichnet das Protokollfeld, der Wert den im Protokoll auszugebenden Feldnamen. Standardwert: %(asctime)s %(levelname)s: %(message)s
- PATRONI_LOG_DATEFORMAT: legt die Formatzeichenfolge für Datum und Uhrzeit fest (siehe Dokumentation zu formatTime() ).
- PATRONI_LOG_STATIC_FIELDS: fügt dem Protokoll zusätzliche Felder hinzu. Diese Option ist nur beim Protokolltyp json verfügbar. Beispiel:
PATRONI_LOG_STATIC_FIELDS="{app: patroni}" - PATRONI_LOG_MAX_QUEUE_SIZE: Patroni verwendet eine zweistufige Protokollierung. Protokolleinträge werden in eine Warteschlange im Arbeitsspeicher geschrieben; ein separater Thread entnimmt sie und schreibt sie nach stderr oder in eine Datei. Die interne Warteschlange ist standardmäßig auf 1000 Einträge begrenzt, was für die Protokolle der letzten 1h20m ausreicht.
- PATRONI_LOG_DIR: Verzeichnis für die Anwendungsprotokolle. Es muss existieren und für den Benutzer, der Patroni ausführt, beschreibbar sein. Ist diese Umgebungsvariable gesetzt, bewahrt die Anwendung standardmäßig 4 Protokolldateien mit jeweils 25MB auf. Diese Aufbewahrungswerte lassen sich mit
PATRONI_LOG_FILE_NUMundPATRONI_LOG_FILE_SIZEanpassen (siehe unten). - PATRONI_LOG_MODE: Berechtigungen für Protokolldateien (z. B.
0644). Ohne Angabe werden die Berechtigungen anhand des aktuellen umask-Werts gesetzt. - PATRONI_LOG_FILE_NUM: Anzahl der aufzubewahrenden Anwendungsprotokolle.
- PATRONI_LOG_FILE_SIZE: Größe der Datei patroni.log (in Bytes), bei der eine Protokollrotation ausgelöst wird.
- PATRONI_LOG_LOGGERS: definiert die Protokollierungsstufe je Python-Modul neu. Beispiel:
PATRONI_LOG_LOGGERS="{patroni.postmaster: WARNING, urllib3: DEBUG}" - PATRONI_LOG_DEDUPLICATE_HEARTBEAT_LOGS: bei
truewerden aufeinanderfolgende identische Heartbeat-Protokolleinträge nicht ausgegeben. Standardwert:false.
Der Ausführungszeitpunkt der HA-Schleife kann bei der Diagnose von Failovers aufgrund erschöpfter Ressourcen und ähnlicher Probleme sehr wertvoll sein. Ist PATRONI_LOG_DEDUPLICATE_HEARTBEAT_LOGS auf true gesetzt, wird für die Ausführung der HA-Schleife kein Protokolleintrag erzeugt (außer bei einem Leader-Wechsel). Diese möglicherweise nützliche Information steht dann in den Protokollen nicht zur Verfügung.
Citus
Aktiviert die Integration von Patroni mit Citus . Ist sie konfiguriert, übernimmt Patroni die Registrierung der Citus-Worker-Knoten beim Coordinator. Weitere Informationen zur Citus-Unterstützung stehen hier .
- PATRONI_CITUS_GROUP: Citus-Gruppen-ID als Ganzzahl. Für den Coordinator
0verwenden, für Worker1,2usw. - PATRONI_CITUS_DATABASE: Datenbank, in der die Erweiterung citus erstellt werden sollte. Sie muss auf dem Coordinator und allen Workern identisch sein. Derzeit wird nur eine Datenbank unterstützt.
Consul
- PATRONI_CONSUL_HOST: host:port des lokalen Consul-Agenten.
- PATRONI_CONSUL_URL: URL des lokalen Consul-Agenten im Format: http(s)://host:port
- PATRONI_CONSUL_PORT: (optional) Consul-Port
- PATRONI_CONSUL_SCHEME: (optional) http oder https, Standardwert http
- PATRONI_CONSUL_TOKEN: (optional) ACL-Token
- PATRONI_CONSUL_VERIFY: (optional) bestimmt, ob das SSL-Zertifikat bei HTTPS-Anfragen geprüft wird
- PATRONI_CONSUL_CACERT: (optional) CA-Zertifikat. Falls vorhanden, wird die Validierung aktiviert.
- PATRONI_CONSUL_CERT: (optional) Datei mit dem Clientzertifikat
- PATRONI_CONSUL_KEY: (optional) Datei mit dem Clientschlüssel. Kann leer sein, wenn der Schlüssel Bestandteil des Zertifikats ist.
- PATRONI_CONSUL_DC: (optional) Rechenzentrum, mit dem kommuniziert werden soll. Standardmäßig wird das Rechenzentrum des Hosts verwendet.
- PATRONI_CONSUL_CONSISTENCY: (optional) wählt den Konsistenzmodus von Consul. Mögliche Werte:
default,consistentoderstale(Einzelheiten in der Consul-API-Referenz ) - PATRONI_CONSUL_CHECKS: (optional) Liste der für die Sitzung verwendeten Consul Health Checks. Standardmäßig wird eine leere Liste verwendet.
- PATRONI_CONSUL_REGISTER_SERVICE: (optional) bestimmt, ob ein Dienst registriert wird, dessen Name durch den Parameter scope festgelegt ist und der je nach Knotenrolle das Tag master, primary, replica oder standby-leader erhält. Standardwert false
- PATRONI_CONSUL_SERVICE_TAGS: (optional) zusätzliche statische Tags für den Consul-Dienst neben der Rolle (
primary/replica/standby-leader). Standardmäßig wird eine leere Liste verwendet. - PATRONI_CONSUL_SERVICE_CHECK_INTERVAL: (optional) Häufigkeit der Health Checks für die registrierte URL
- PATRONI_CONSUL_SERVICE_CHECK_TLS_SERVER_NAME: (optional) überschreibt den SNI-Host bei TLS-Verbindungen; siehe auch die API-Referenz für Consul-Agent-Prüfungen .
etcd
- PATRONI_ETCD_PROXY: Proxy-URL für etcd. Bei einer Verbindung zu etcd über einen Proxy diesen Parameter anstelle von PATRONI_ETCD_URL verwenden.
- PATRONI_ETCD_URL: URL für etcd im Format: http(s)://(username:password@)host:port
- PATRONI_ETCD_HOSTS: Liste der etcd-Endpunkte im Format ‘host1:port1’,‘host2:port2’,etc…
- PATRONI_ETCD_USE_PROXIES: ist dieser Parameter auf true gesetzt, behandelt Patroni hosts als Liste von Proxys und ermittelt nicht die Topologie des etcd-Clusters, sondern bleibt bei der festen Liste hosts.
- PATRONI_ETCD_PROTOCOL: http oder https; ohne Angabe wird http verwendet. Ist url oder proxy angegeben, wird das Protokoll daraus übernommen.
- PATRONI_ETCD_HOST: host:port des etcd-Endpunkts.
- PATRONI_ETCD_SRV: Domain, in der nach SRV-Einträgen für die automatische Clustererkennung gesucht wird. Patroni fragt für die angegebene Domain diese SRV-Dienstnamen ab (in dieser Reihenfolge bis zum ersten Erfolg):
_etcd-client-ssl,_etcd-client,_etcd-ssl,_etcd,_etcd-server-ssl,_etcd-server. Werden SRV-Einträge für_etcd-server-ssloder_etcd-servergefunden, wird über das ETCD-Peer-Protokoll bei ETCD nach verfügbaren Mitgliedern gefragt. Andernfalls werden die Hosts aus den SRV-Einträgen verwendet. - PATRONI_ETCD_SRV_SUFFIX: konfiguriert ein Suffix für den bei der Erkennung abgefragten SRV-Namen. Mit diesem Flag lassen sich mehrere etcd-Cluster unter derselben Domain unterscheiden. Es funktioniert nur zusammen mit PATRONI_ETCD_SRV. Sind beispielsweise
PATRONI_ETCD_SRV_SUFFIX=fooundPATRONI_ETCD_SRV=example.orggesetzt, wird folgende DNS-SRV-Abfrage ausgeführt:_etcd-client-ssl-foo._tcp.example.org(entsprechend für jeden möglichen ETCD-SRV-Dienstnamen). - PATRONI_ETCD_USERNAME: Benutzername für die etcd-Authentifizierung.
- PATRONI_ETCD_PASSWORD: Passwort für die etcd-Authentifizierung.
- PATRONI_ETCD_CACERT: CA-Zertifikat. Falls vorhanden, wird die Validierung aktiviert.
- PATRONI_ETCD_CERT: Datei mit dem Clientzertifikat.
- PATRONI_ETCD_KEY: Datei mit dem Clientschlüssel. Kann leer sein, wenn der Schlüssel Bestandteil des Zertifikats ist.
Etcdv3
Die Namen der Umgebungsvariablen für Etcdv3 entsprechen denen für etcd; im Variablennamen muss lediglich ETCD durch ETCD3 ersetzt werden. Beispiele: PATRONI_ETCD3_HOST, PATRONI_ETCD3_CACERT usw.
Mit Protokollversion 2 erstellte Schlüssel sind mit Protokollversion 3 nicht sichtbar und umgekehrt. Daher ist ein Wechsel von etcd zu Etcdv3 allein durch Ändern der Patroni-Konfiguration nicht möglich. Zudem verwendet Patroni das gRPC-Gateway (Proxy) von etcd zur Kommunikation mit der V3 API, weshalb eine TLS-Authentifizierung über den Common Name nicht möglich ist.
ZooKeeper
- PATRONI_ZOOKEEPER_HOSTS: durch Kommas getrennte Liste der ZooKeeper-Clustermitglieder: “‘host1:port1’,‘host2:port2’,’etc…’”. Jeder einzelne Eintrag muss in Anführungszeichen stehen!
- PATRONI_ZOOKEEPER_USE_SSL: (optional) bestimmt, ob SSL verwendet wird. Standardwert:
false. Beifalsewerden alle SSL-spezifischen Parameter ignoriert. - PATRONI_ZOOKEEPER_CACERT: (optional) CA-Zertifikat. Falls vorhanden, wird die Validierung aktiviert.
- PATRONI_ZOOKEEPER_CERT: (optional) Datei mit dem Clientzertifikat.
- PATRONI_ZOOKEEPER_KEY: (optional) Datei mit dem Clientschlüssel.
- PATRONI_ZOOKEEPER_KEY_PASSWORD: (optional) Passwort für den Clientschlüssel.
- PATRONI_ZOOKEEPER_VERIFY: (optional) bestimmt, ob das Zertifikat geprüft wird. Standardwert:
true. - PATRONI_ZOOKEEPER_SET_ACLS: (optional) falls gesetzt, wird Kazoo so konfiguriert, dass es auf jeden neu erstellten ZNode eine Standard-ACL anwendet. ACLs können das Schema
x509(Standard) oder andere unterstützte ZooKeeper-Schemata wiedigestverwenden. Sie sollten als Dictionary angegeben werden, dessen Schlüssel der vollständige Principal (optional mit vorangestelltem Schema) und dessen Wert eine Liste von Berechtigungen ist. Als Berechtigungen sind eine oder mehrere ausCREATE,READ,WRITE,DELETE,ADMINoderALLmöglich. Beispiel:set_acls: {CN=principal1: [CREATE, READ], digest:principal2:+pjROuBuuwNNSujKyH8dGcEnFPQ=: [ALL]}. - PATRONI_ZOOKEEPER_AUTH_DATA: (optional) Zugangsdaten für die Verbindung. Sollte ein Dictionary mit
schemeals Schlüssel undcredentialals Wert sein. Standardwert ist ein leeres Dictionary.
Für SSL-Unterstützung muss kazoo>=2.6.0 installiert sein.
Exhibitor
- PATRONI_EXHIBITOR_HOSTS: anfängliche Liste der Exhibitor-Knoten (ZooKeeper) im Format: ‘host1,host2,etc…’. Diese Liste wird bei jeder Änderung der Topologie des Exhibitor-Clusters (ZooKeeper) automatisch aktualisiert.
- PATRONI_EXHIBITOR_PORT: Exhibitor-Port.
Kubernetes
- PATRONI_KUBERNETES_BYPASS_API_SERVICE: (optional) bei der Kommunikation mit der Kubernetes API verwendet Patroni normalerweise den Dienst kubernetes
, dessen Adresse den Pods über die Umgebungsvariable
KUBERNETES_SERVICE_HOSTbereitgestellt wird. IstPATRONI_KUBERNETES_BYPASS_API_SERVICEauftruegesetzt, ermittelt Patroni die Liste der API-Knoten hinter dem Dienst und verbindet sich direkt mit ihnen. - PATRONI_KUBERNETES_NAMESPACE: (optional) Kubernetes-Namespace, in dem der Patroni-Pod läuft. Standardwert:
default. - PATRONI_KUBERNETES_LABELS: Labels im Format
{label1: value1, label2: value2}. Mit diesen Labels werden vorhandene Objekte (Pods sowie Endpoints oder ConfigMaps) gesucht, die zum aktuellen Cluster gehören. Außerdem setzt Patroni sie auf jedem von ihm erstellten Objekt (Endpoint oder ConfigMap). - PATRONI_KUBERNETES_SCOPE_LABEL: (optional) Name des Labels mit dem Clusternamen. Standardwert:
cluster-name. - PATRONI_KUBERNETES_BOOTSTRAP_LABELS: (optional) Labels im Format
{label1: value1, label2: value2}. Sie werden einem Patroni-Pod zugewiesen, wenn sein Zustandinitializing new cluster,running custom bootstrap script,starting after custom bootstrapodercreating replicaist. - PATRONI_KUBERNETES_ROLE_LABEL: (optional) Name des Labels mit der Rolle (
primary,replicaoder ein anderer benutzerdefinierter Wert). Patroni setzt dieses Label auf dem Pod, in dem es läuft. Standardwert:role. - PATRONI_KUBERNETES_LEADER_LABEL_VALUE: (optional) Wert des Pod-Labels, wenn die Postgres-Rolle
primaryist. Standardwert:primary. - PATRONI_KUBERNETES_FOLLOWER_LABEL_VALUE: (optional) Wert des Pod-Labels, wenn die Postgres-Rolle
replicaist. Standardwert:replica. - PATRONI_KUBERNETES_STANDBY_LEADER_LABEL_VALUE: (optional) Wert des Pod-Labels, wenn die Postgres-Rolle
standby_leaderist. Standardwert:primary. - PATRONI_KUBERNETES_TMP_ROLE_LABEL: (optional) Name des temporären Labels mit der Rolle (
primaryoderreplica). Der Wert dieses Labels entspricht immer dem Standardwert der jeweiligen Rolle. Nur bei Bedarf setzen. - PATRONI_KUBERNETES_USE_ENDPOINTS: (optional) bei true verwendet Patroni Endpoints anstelle von ConfigMaps für die Leader-Wahl und zum Speichern des Clusterzustands.
- PATRONI_KUBERNETES_POD_IP: (optional) IP-Adresse des Pods, in dem Patroni läuft. Dieser Wert ist erforderlich, wenn
PATRONI_KUBERNETES_USE_ENDPOINTSaktiviert ist, und wird beim Hochstufen von PostgreSQL im Pod zum Befüllen der Subsets des Leader-Endpoints verwendet. - PATRONI_KUBERNETES_PORTS: (optional) enthält das Service-Objekt einen Namen für den Port, muss derselbe Name im Endpoint-Objekt erscheinen; andernfalls funktioniert der Dienst nicht. Ist der Dienst beispielsweise als
{Kind: Service, spec: {ports: [{name: postgresql, port: 5432, targetPort: 5432}]}}definiert, mussPATRONI_KUBERNETES_PORTS='[{"name": "postgresql", "port": 5432}]'gesetzt werden. Patroni verwendet dies zum Aktualisieren der Subsets des Leader-Endpoints. Dieser Parameter wird nur verwendet, wennPATRONI_KUBERNETES_USE_ENDPOINTSgesetzt ist. - PATRONI_KUBERNETES_CACERT: (optional) gibt die CA_BUNDLE-Datei mit den Zertifikaten vertrauenswürdiger CAs an, die zum Prüfen der SSL-Zertifikate der Kubernetes API verwendet werden. Ohne Angabe verwendet Patroni den Wert aus dem ServiceAccount-Secret.
- PATRONI_RETRIABLE_HTTP_CODES: (optional) Liste der HTTP-Statuscodes der K8s API, bei denen ein erneuter Versuch erfolgt. Standardmäßig wiederholt Patroni die Anfrage bei
500,503und504oder wenn die Antwort der K8s API den HTTP-Headerretry-afterenthält.
Raft (veraltet)
- PATRONI_RAFT_SELF_ADDR:
ip:port, an dem auf Raft-Verbindungen gewartet wird.self_addrmuss von anderen Clusterknoten aus erreichbar sein. Ohne Angabe nimmt der Knoten nicht am Konsens teil. - PATRONI_RAFT_BIND_ADDR: (optional)
ip:port, an dem auf Raft-Verbindungen gewartet wird. Ohne Angabe wirdself_addrverwendet. - PATRONI_RAFT_PARTNER_ADDRS: Liste der anderen Patroni-Knoten im Cluster im Format
"'ip1:port1','ip2:port2'". Jeder einzelne Eintrag muss in Anführungszeichen stehen! - PATRONI_RAFT_DATA_DIR: Verzeichnis zum Speichern des Raft-Logs und des Snapshots. Ohne Angabe wird das aktuelle Arbeitsverzeichnis verwendet.
- PATRONI_RAFT_PASSWORD: (optional) verschlüsselt den Raft-Datenverkehr mit dem angegebenen Passwort; erfordert das Python-Modul
cryptography. - PATRONI_RAFT_MIN_TIMEOUT: (optional) minimale Zeitüberschreitung für Wahlen in der zugrunde liegenden Raft-Implementierung pysyncobj, in Sekunden. Muss größer als 3 *
PATRONI_RAFT_APPEND_ENTRIES_PERIODsein. Standardwert:0.4. - PATRONI_RAFT_MAX_TIMEOUT: (optional) maximale Zeitüberschreitung für Wahlen in der zugrunde liegenden Raft-Implementierung pysyncobj, in Sekunden. Muss größer als
PATRONI_RAFT_MIN_TIMEOUTsein. Standardwert:1.4. - PATRONI_RAFT_CONNECTION_TIMEOUT: (optional) Zeit in Sekunden, nach der eine Verbindung ohne Datenempfang als unterbrochen gilt. Muss größer oder gleich
PATRONI_RAFT_MAX_TIMEOUTsein. Standardwert:3.5. - PATRONI_RAFT_APPEND_ENTRIES_PERIOD: (optional) Intervall in Sekunden zum Senden von Heartbeat-Befehlen. Muss kleiner als ein Drittel von
PATRONI_RAFT_MIN_TIMEOUTsein. Standardwert:0.1. - PATRONI_RAFT_CONNECTION_RETRY_TIME: (optional) Intervall in Sekunden zwischen erneuten Verbindungsversuchen zu nicht erreichbaren Knoten. Standardwert:
5.0. - PATRONI_RAFT_LEADER_FALLBACK_TIMEOUT: (optional) Zeit in Sekunden, nach der ein Leader ohne Antwort von der Mehrheit in den Follower-Zustand zurückkehrt. Muss größer als
PATRONI_RAFT_APPEND_ENTRIES_PERIODsein. Standardwert:30.0.
Patroni prüft diese Bedingungen beim Start und verweigert den Start, wenn sie verletzt sind. Diese Werte können nicht zur Laufzeit geändert werden und erfordern einen Neustart. Einzelheiten einschließlich der Einschränkungen bei hoher Latenz stehen unter Raft-Einstellungen .
PostgreSQL
- PATRONI_POSTGRESQL_LISTEN: IP-Adresse + Port, an denen Postgres auf Verbindungen wartet. Mehrere durch Kommas getrennte Adressen sind zulässig, sofern der Port nach der letzten Adresse mit einem Doppelpunkt angehängt wird, etwa
listen: 127.0.0.1,127.0.0.2:5432. Patroni verwendet die erste Adresse dieser Liste, um lokale Verbindungen zum PostgreSQL-Knoten aufzubauen. - PATRONI_POSTGRESQL_CONNECT_ADDRESS: IP-Adresse + Port, über die Postgres für andere Knoten und Anwendungen erreichbar ist.
- PATRONI_POSTGRESQL_PROXY_ADDRESS: IP-Adresse + Port, über die ein neben Postgres laufender Verbindungspool (z. B. PgBouncer) erreichbar ist. Der Wert wird als
proxy_urlin den Mitgliedsschlüssel im DCS geschrieben und kann für die Diensterkennung verwendet werden beziehungsweise nützlich sein. - PATRONI_POSTGRESQL_DATA_DIR: Pfad zum Postgres-Datenverzeichnis, das bereits existiert oder von Patroni initialisiert werden soll.
- PATRONI_POSTGRESQL_CONFIG_DIR: Pfad zum Postgres-Konfigurationsverzeichnis; standardmäßig das Datenverzeichnis. Es muss für Patroni beschreibbar sein.
- PATRONI_POSTGRESQL_BIN_DIR: Pfad zu den PostgreSQL-Programmdateien (pg_ctl, initdb, pg_controldata, pg_basebackup, postgres, pg_isready, pg_rewind). Der Standardwert ist eine leere Zeichenfolge; dann werden die Programme über die Umgebungsvariable PATH gesucht.
- PATRONI_POSTGRESQL_BIN_PG_CTL: (optional) benutzerdefinierter Name für die Programmdatei
pg_ctl. - PATRONI_POSTGRESQL_BIN_INITDB: (optional) benutzerdefinierter Name für die Programmdatei
initdb. - PATRONI_POSTGRESQL_BIN_PG_CONTROLDATA: (optional) benutzerdefinierter Name für die Programmdatei
pg_controldata. - PATRONI_POSTGRESQL_BIN_PG_BASEBACKUP: (optional) benutzerdefinierter Name für die Programmdatei
pg_basebackup. - PATRONI_POSTGRESQL_BIN_POSTGRES: (optional) benutzerdefinierter Name für die Programmdatei
postgres. - PATRONI_POSTGRESQL_BIN_IS_READY: (optional) benutzerdefinierter Name für die Programmdatei
pg_isready. - PATRONI_POSTGRESQL_BIN_PG_REWIND: (optional) benutzerdefinierter Name für die Programmdatei
pg_rewind. - PATRONI_POSTGRESQL_PGPASS: Pfad zur Passwortdatei .pgpass . Patroni erstellt diese Datei vor dem Ausführen von pg_basebackup und in einigen weiteren Fällen. Der Speicherort muss für Patroni beschreibbar sein.
- PATRONI_REPLICATION_USERNAME: Benutzername für die Replikation; der Benutzer wird bei der Initialisierung erstellt. Replikate verwenden ihn, um per Streaming-Replikation auf die Replikationsquelle zuzugreifen.
- PATRONI_REPLICATION_PASSWORD: Passwort für die Replikation; der Benutzer wird bei der Initialisierung erstellt.
- PATRONI_REPLICATION_SSLMODE: (optional) entspricht dem Verbindungsparameter sslmode
, der dem Client die Auswahl des Modus für die TLS-Aushandlung mit dem Server erlaubt. Einzelheiten zur Funktionsweise der einzelnen Modi stehen in der PostgreSQL-Dokumentation
. Der Standardmodus ist
prefer. - PATRONI_REPLICATION_SSLKEY: (optional) entspricht dem Verbindungsparameter sslkey , der den Speicherort des geheimen Schlüssels für das Clientzertifikat angibt.
- PATRONI_REPLICATION_SSLPASSWORD: (optional) entspricht dem Verbindungsparameter sslpassword
, der das Passwort für den in
PATRONI_REPLICATION_SSLKEYangegebenen geheimen Schlüssel festlegt. - PATRONI_REPLICATION_SSLCERT: (optional) entspricht dem Verbindungsparameter sslcert , der den Speicherort des Clientzertifikats angibt.
- PATRONI_REPLICATION_SSLROOTCERT: (optional) entspricht dem Verbindungsparameter sslrootcert , der den Pfad zu einer Datei mit einem oder mehreren Zertifikaten von Zertifizierungsstellen (CA) angibt, mit denen der Client ein Serverzertifikat prüft.
- PATRONI_REPLICATION_SSLCRL: (optional) entspricht dem Verbindungsparameter sslcrl , der den Pfad zu einer Datei mit einer Zertifikatsperrliste angibt. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- PATRONI_REPLICATION_SSLCRLDIR: (optional) entspricht dem Verbindungsparameter sslcrldir , der den Pfad zu einem Verzeichnis mit Dateien angibt, die eine Zertifikatsperrliste enthalten. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- PATRONI_REPLICATION_SSLNEGOTIATION: (optional) entspricht dem Verbindungsparameter sslnegotiation , der steuert, wie die SSL-Verschlüsselung mit dem Server ausgehandelt wird, falls SSL verwendet wird.
- PATRONI_REPLICATION_GSSENCMODE: (optional) entspricht dem Verbindungsparameter gssencmode , der bestimmt, ob und mit welcher Priorität eine sichere GSS-Verbindung über TCP/IP mit dem Server ausgehandelt wird.
- PATRONI_REPLICATION_CHANNEL_BINDING: (optional) entspricht dem Verbindungsparameter channel_binding , der die Verwendung von Channel Binding durch den Client steuert.
- PATRONI_SUPERUSER_USERNAME: Name des Superusers, der bei der Initialisierung (initdb) festgelegt und später von Patroni für Verbindungen zu Postgres verwendet wird. Auch pg_rewind verwendet diesen Benutzer.
- PATRONI_SUPERUSER_PASSWORD: Passwort des Superusers, das bei der Initialisierung (initdb) festgelegt wird.
- PATRONI_SUPERUSER_SSLMODE: (optional) entspricht dem Verbindungsparameter sslmode
, der dem Client die Auswahl des Modus für die TLS-Aushandlung mit dem Server erlaubt. Einzelheiten zur Funktionsweise der einzelnen Modi stehen in der PostgreSQL-Dokumentation
. Der Standardmodus ist
prefer. - PATRONI_SUPERUSER_SSLKEY: (optional) entspricht dem Verbindungsparameter sslkey , der den Speicherort des geheimen Schlüssels für das Clientzertifikat angibt.
- PATRONI_SUPERUSER_SSLPASSWORD: (optional) entspricht dem Verbindungsparameter sslpassword
, der das Passwort für den in
PATRONI_SUPERUSER_SSLKEYangegebenen geheimen Schlüssel festlegt. - PATRONI_SUPERUSER_SSLCERT: (optional) entspricht dem Verbindungsparameter sslcert , der den Speicherort des Clientzertifikats angibt.
- PATRONI_SUPERUSER_SSLROOTCERT: (optional) entspricht dem Verbindungsparameter sslrootcert , der den Pfad zu einer Datei mit einem oder mehreren Zertifikaten von Zertifizierungsstellen (CA) angibt, mit denen der Client ein Serverzertifikat prüft.
- PATRONI_SUPERUSER_SSLCRL: (optional) entspricht dem Verbindungsparameter sslcrl , der den Pfad zu einer Datei mit einer Zertifikatsperrliste angibt. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- PATRONI_SUPERUSER_SSLCRLDIR: (optional) entspricht dem Verbindungsparameter sslcrldir , der den Pfad zu einem Verzeichnis mit Dateien angibt, die eine Zertifikatsperrliste enthalten. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- PATRONI_SUPERUSER_SSLNEGOTIATION: (optional) entspricht dem Verbindungsparameter sslnegotiation , der steuert, wie die SSL-Verschlüsselung mit dem Server ausgehandelt wird, falls SSL verwendet wird.
- PATRONI_SUPERUSER_GSSENCMODE: (optional) entspricht dem Verbindungsparameter gssencmode , der bestimmt, ob und mit welcher Priorität eine sichere GSS-Verbindung über TCP/IP mit dem Server ausgehandelt wird.
- PATRONI_SUPERUSER_CHANNEL_BINDING: (optional) entspricht dem Verbindungsparameter channel_binding , der die Verwendung von Channel Binding durch den Client steuert.
- PATRONI_REWIND_USERNAME: (optional) Name des Benutzers für
pg_rewind; er wird bei der Initialisierung von Postgres 11+ erstellt und erhält alle erforderlichen Berechtigungen . - PATRONI_REWIND_PASSWORD: (optional) Passwort des Benutzers für
pg_rewind; er wird bei der Initialisierung erstellt. - PATRONI_REWIND_SSLMODE: (optional) entspricht dem Verbindungsparameter sslmode
, der dem Client die Auswahl des Modus für die TLS-Aushandlung mit dem Server erlaubt. Einzelheiten zur Funktionsweise der einzelnen Modi stehen in der PostgreSQL-Dokumentation
. Der Standardmodus ist
prefer. - PATRONI_REWIND_SSLKEY: (optional) entspricht dem Verbindungsparameter sslkey , der den Speicherort des geheimen Schlüssels für das Clientzertifikat angibt.
- PATRONI_REWIND_SSLPASSWORD: (optional) entspricht dem Verbindungsparameter sslpassword
, der das Passwort für den in
PATRONI_REWIND_SSLKEYangegebenen geheimen Schlüssel festlegt. - PATRONI_REWIND_SSLCERT: (optional) entspricht dem Verbindungsparameter sslcert , der den Speicherort des Clientzertifikats angibt.
- PATRONI_REWIND_SSLROOTCERT: (optional) entspricht dem Verbindungsparameter sslrootcert , der den Pfad zu einer Datei mit einem oder mehreren Zertifikaten von Zertifizierungsstellen (CA) angibt, mit denen der Client ein Serverzertifikat prüft.
- PATRONI_REWIND_SSLCRL: (optional) entspricht dem Verbindungsparameter sslcrl , der den Pfad zu einer Datei mit einer Zertifikatsperrliste angibt. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- PATRONI_REWIND_SSLCRLDIR: (optional) entspricht dem Verbindungsparameter sslcrldir , der den Pfad zu einem Verzeichnis mit Dateien angibt, die eine Zertifikatsperrliste enthalten. Ein Client lehnt Verbindungen zu Servern ab, deren Zertifikat in dieser Liste enthalten ist.
- PATRONI_REWIND_SSLNEGOTIATION: (optional) entspricht dem Verbindungsparameter sslnegotiation , der steuert, wie die SSL-Verschlüsselung mit dem Server ausgehandelt wird, falls SSL verwendet wird.
- PATRONI_REWIND_GSSENCMODE: (optional) entspricht dem Verbindungsparameter gssencmode , der bestimmt, ob und mit welcher Priorität eine sichere GSS-Verbindung über TCP/IP mit dem Server ausgehandelt wird.
- PATRONI_REWIND_CHANNEL_BINDING: (optional) entspricht dem Verbindungsparameter channel_binding , der die Verwendung von Channel Binding durch den Client steuert.
REST API
- PATRONI_RESTAPI_THREAD_POOL_SIZE: Größe des Threadpools, mit dem Patroni REST-API-Anfragen verarbeitet. Mindestwert:
5, Standardwert:5. - PATRONI_RESTAPI_CONNECT_ADDRESS: IP-Adresse und Port für den Zugriff auf die REST API.
- PATRONI_RESTAPI_LISTEN: IP-Adresse und Port, an denen Patroni auf Verbindungen wartet, um Health-Check-Informationen für HAProxy bereitzustellen.
- PATRONI_RESTAPI_USERNAME: Benutzername für die Basic-Authentifizierung zum Schutz unsicherer REST-API-Endpunkte.
- PATRONI_RESTAPI_PASSWORD: Passwort für die Basic-Authentifizierung zum Schutz unsicherer REST-API-Endpunkte.
- PATRONI_RESTAPI_CERTFILE: gibt die Datei mit dem Zertifikat im PEM-Format an. Ist certfile nicht angegeben oder leer, arbeitet der API-Server ohne SSL.
- PATRONI_RESTAPI_KEYFILE: gibt die Datei mit dem geheimen Schlüssel im PEM-Format an.
- PATRONI_RESTAPI_KEYFILE_PASSWORD: gibt ein Passwort zum Entschlüsseln der Schlüsseldatei an.
- PATRONI_RESTAPI_CAFILE: gibt die Datei mit dem CA_BUNDLE vertrauenswürdiger CA-Zertifikate an, die zum Prüfen der Clientzertifikate verwendet werden.
- PATRONI_RESTAPI_CIPHERS: (optional) gibt die zulässigen Cipher Suites an (z. B. “ECDHE-RSA-AES256-GCM-SHA384:DHE-RSA-AES256-GCM-SHA384:ECDHE-RSA-AES128-GCM-SHA256:DHE-RSA-AES128-GCM-SHA256:!SSLv1:!SSLv2:!SSLv3:!TLSv1:!TLSv1.1”)
- PATRONI_RESTAPI_VERIFY_CLIENT:
none(Standard),optionaloderrequired. Beinoneprüft die REST API keine Clientzertifikate. Beirequiredsind Clientzertifikate für alle REST-API-Aufrufe erforderlich. Beioptionalsind sie für alle unsicheren REST-API-Endpunkte erforderlich. Beirequiredist die Clientauthentifizierung erfolgreich, wenn die Prüfung der Zertifikatssignatur erfolgreich ist. Beioptionalwird das Clientzertifikat nur bei Anfragen mitPUT,POST,PATCHundDELETEgeprüft. - PATRONI_RESTAPI_ALLOWLIST: (optional): legt die Hosts fest, die unsichere REST-API-Endpunkte aufrufen dürfen. Ein Eintrag kann ein Hostname, eine IP-Adresse oder eine Netzwerkadresse in CIDR-Schreibweise sein. Standardmäßig gilt
allow all. Istallowlistoderallowlist_include_membersgesetzt, werden alle nicht enthaltenen Zugriffe abgelehnt. - PATRONI_RESTAPI_ALLOWLIST_INCLUDE_MEMBERS: (optional): bei
truedürfen andere im DCS registrierte Clustermitglieder auf unsichere REST-API-Endpunkte zugreifen (IP-Adresse oder Hostname werden ausapi_urldes Mitglieds übernommen). Vorsicht: Das Betriebssystem kann für ausgehende Verbindungen eine andere IP-Adresse verwenden. - PATRONI_RESTAPI_HTTP_EXTRA_HEADERS: (optional) HTTP-Header ermöglichen es dem REST-API-Server, zusätzliche Informationen mit einer HTTP-Antwort zu übertragen.
- PATRONI_RESTAPI_HTTPS_EXTRA_HEADERS: (optional) HTTPS-Header ermöglichen es dem REST-API-Server, bei aktiviertem TLS zusätzliche Informationen mit einer HTTP-Antwort zu übertragen. Die in
http_extra_headersfestgelegten Zusatzinformationen werden ebenfalls übertragen. - PATRONI_RESTAPI_REQUEST_QUEUE_SIZE: (optional): legt die Größe der Anfragewarteschlange für den TCP-Socket der Patroni REST API fest. Ist die Warteschlange voll, erhalten weitere Anfragen den Fehler “Connection denied”. Der Standardwert ist 5.
- PATRONI_RESTAPI_SERVER_TOKENS: (optional) konfiguriert den Wert des HTTP-Headers
Server.Original(Standard) behält das ursprüngliche Verhalten bei und zeigt die Versionen von BaseHTTP und Python an, etwaBaseHTTP/0.6 Python/3.12.3.Minimal: Der Header enthält nur die Patroni-Version, etwaPatroni/4.0.0.ProductOnly: Der Header enthält nur den Produktnamen, etwaPatroni.
Warnung
PATRONI_RESTAPI_CONNECT_ADDRESSmuss von allen Knoten des jeweiligen Patroni-Clusters aus erreichbar sein. Intern verwendet Patroni diese Adresse während der Leader-Wahl, um die Knoten mit dem geringsten Replikationsrückstand zu ermitteln.- Ist die Prüfung von Clientzertifikaten aktiviert (
PATRONI_RESTAPI_VERIFY_CLIENTaufrequiredgesetzt), müssen außerdem gültige Clientzertifikate inPATRONI_CTL_CERTFILE,PATRONI_CTL_KEYFILE,PATRONI_CTL_KEYFILE_PASSWORDangegeben werden. Andernfalls funktioniert Patroni nicht korrekt.
CTL
- PATRONICTL_CONFIG_FILE: (optional) Pfad zur Konfigurationsdatei.
- PATRONI_CTL_USERNAME: (optional) Benutzername für die Basic-Authentifizierung beim Zugriff auf geschützte REST-API-Endpunkte. Ohne Angabe verwendet patronictl den Wert des REST-API-Parameters “username”.
- PATRONI_CTL_PASSWORD: (optional) Passwort für die Basic-Authentifizierung beim Zugriff auf geschützte REST-API-Endpunkte. Ohne Angabe verwendet patronictl den Wert des REST-API-Parameters “password”.
- PATRONI_CTL_INSECURE: (optional) erlaubt Verbindungen zur REST API ohne Prüfung der SSL-Zertifikate.
- PATRONI_CTL_CACERT: (optional) gibt die CA_BUNDLE-Datei oder das Verzeichnis mit Zertifikaten vertrauenswürdiger CAs an, die zum Prüfen der SSL-Zertifikate der REST API verwendet werden. Ohne Angabe verwendet patronictl den Wert des REST-API-Parameters “cafile”.
- PATRONI_CTL_CERTFILE: (optional) gibt die Datei mit dem Clientzertifikat im PEM-Format an.
- PATRONI_CTL_KEYFILE: (optional) gibt die Datei mit dem geheimen Clientschlüssel im PEM-Format an.
- PATRONI_CTL_KEYFILE_PASSWORD: (optional) gibt ein Passwort zum Entschlüsseln der Clientschlüsseldatei an.
4 - Patroni REST API
Patroni bietet eine umfangreiche REST API. Patroni selbst nutzt sie bei der Leader-Wahl, das Werkzeug patronictl für Failover, Switchover, Neuinitialisierung, Neustart und Neuladen sowie HAProxy und andere Load-Balancer für HTTP Health Checks. Sie kann auch zur Überwachung verwendet werden. Nachfolgend sind die REST-API-Endpunkte von Patroni aufgeführt.
Endpunkte für Health Checks
Bei allen GET-Anfragen für Health Checks gibt Patroni neben dem HTTP-Statuscode ein JSON-Dokument mit dem Zustand des Knotens zurück. Wenn das JSON-Dokument nicht gewünscht oder benötigt wird, kann anstelle von GET die Methode HEAD oder OPTIONS verwendet werden.
-
Die folgenden Anfragen an die REST API von Patroni liefern den HTTP-Statuscode 200 nur dann, wenn der Patroni-Knoten als Primärserver mit Leader-Lock läuft:
GET /GET /primaryGET /read-write
-
GET /standby-leader: Liefert den HTTP-Statuscode 200 nur dann, wenn der Patroni-Knoten als Leader in einem Standby-Cluster läuft. -
GET /leader: Liefert den HTTP-Statuscode 200, wenn der Patroni-Knoten den Leader-Lock hält. Anders als beiGET /primaryundGET /standby-leaderhängt diese Prüfung nicht davon ab, ob PostgreSQL alsprimaryoder alsstandby_leaderläuft. -
GET /replica: Endpunkt für den Health Check eines Replikats. Liefert den HTTP-Statuscode 200 nur dann, wenn der Patroni-Knoten den Zustandrunningund die Rollereplicahat und das Tagnoloadbalancenicht gesetzt ist. -
GET /replica?replication_state=<required state>: Endpunkt zur Prüfung eines Replikats. Prüft zusätzlich zu den Prüfungen vonreplica, ob der Replikationszustand dem geforderten Zustand entspricht. Vor allem mitreplication_state=streamingnützlich, um Replikate auszuschließen, die noch mittels Archiv-Recovery aufholen. -
GET /replica?lag=<max-lag>: Endpunkt zur Prüfung eines Replikats. Prüft zusätzlich zu den Prüfungen vonreplicaden Replikationsrückstand und liefert den Statuscode 200 nur dann, wenn er unter dem angegebenen Wert liegt. Aus Leistungsgründen wird der Schlüssel cluster.last_leader_operation aus dem DCS für die WAL-Position des Leaders und zur Berechnung des Rückstands des Replikats verwendet. max-lag kann in Bytes (als Ganzzahl) oder in lesbarer Form angegeben werden, z. B. 16kB, 64MB, 1GB.GET /replica?lag=1048576GET /replica?lag=1024kBGET /replica?lag=10MBGET /replica?lag=1GB
-
GET /replica?tag_key1=value1&tag_key2=value2: Endpunkt zur Prüfung eines Replikats. Prüft zusätzlich die benutzerdefinierten Tagskey1undkey2und ihre jeweiligen Werte im Abschnitt tags der YAML-Konfiguration. Wenn das Tag für eine Instanz nicht definiert ist oder der Wert in der YAML-Konfiguration nicht mit dem abgefragten Wert übereinstimmt, wird der HTTP-Statuscode 503 zurückgegeben.Bei den folgenden Anfragen wird der Status als Leader oder Standby-Leader geprüft. Daher berücksichtigt Patroni keine benutzerdefinierten Tags und ignoriert sie.
GET /?tag_key1=value1&tag_key2=value2GET /leader?tag_key1=value1&tag_key2=value2GET /primary?tag_key1=value1&tag_key2=value2GET /read-write?tag_key1=value1&tag_key2=value2GET /standby_leader?tag_key1=value1&tag_key2=value2GET /standby-leader?tag_key1=value1&tag_key2=value2
-
GET /read-only: Wie der obige Endpunkt, schließt aber auch den Primärserver ein. -
GET /synchronousoderGET /sync: Liefert den HTTP-Statuscode 200 nur dann, wenn der Patroni-Knoten als synchroner Standby läuft. -
GET /read-only-sync: Wie der obige Endpunkt, schließt aber auch den Primärserver ein. -
GET /quorum: Liefert den HTTP-Statuscode 200 nur dann, wenn dieser Patroni-Knoten auf dem Primärserver insynchronous_standby_namesals Quorum-Knoten aufgeführt ist. -
GET /read-only-quorum: Wie der obige Endpunkt, schließt aber auch den Primärserver ein. -
GET /asynchronousoderGET /async: Liefert den HTTP-Statuscode 200 nur dann, wenn der Patroni-Knoten als asynchroner Standby läuft. -
GET /asynchronous?lag=<max-lag>oderGET /async?lag=<max-lag>: Endpunkt zur Prüfung eines asynchronen Standbys. Prüft zusätzlich zu den Prüfungen vonasynchronousoderasyncden Replikationsrückstand und liefert den Statuscode 200 nur dann, wenn er unter dem angegebenen Wert liegt. Aus Leistungsgründen wird der Schlüssel cluster.last_leader_operation aus dem DCS für die WAL-Position des Leaders und zur Berechnung des Rückstands des Replikats verwendet. max-lag kann in Bytes (als Ganzzahl) oder in lesbarer Form angegeben werden, z. B. 16kB, 64MB, 1GB.GET /async?lag=1048576GET /async?lag=1024kBGET /async?lag=10MBGET /async?lag=1GB
-
GET /health: Liefert den HTTP-Statuscode 200 nur dann, wenn PostgreSQL läuft. -
GET /liveness: Liefert den HTTP-Statuscode 200, wenn die Heartbeat-Schleife von Patroni ordnungsgemäß läuft, und 503, wenn der letzte Durchlauf auf dem Primärserver mehr alsttlSekunden oder auf dem Replikat mehr als2*ttlSekunden zurückliegt. Kann fürlivenessProbeverwendet werden. -
GET /readiness?lag=<max-lag>&mode=apply|write: Liefert den HTTP-Statuscode 200, wenn der Patroni-Knoten als Leader läuft oder wenn PostgreSQL läuft, repliziert und nicht zu weit hinter dem Leader zurückliegt. Der Parameter lag legt den zulässigen Rückstand eines Standbys fest; sein Standardwert istmaximum_lag_on_failover. Der Rückstand kann in Bytes oder in lesbarer Form angegeben werden, beispielsweise 16kB, 64MB oder 1GB. Der Parameter mode legt fest, ob das WAL wiedergegeben (apply) oder lediglich empfangen (write) werden muss. Der Standardwert ist apply.Bei Verwendung als Kubernetes-
readinessProbestellt der Endpunkt sicher, dass frisch gestartete Pods erst dann bereit sind, wenn sie zum Leader aufgeholt haben. Zusammen mit einem PodDisruptionBudget verhindert dies, dass der Leader bei einem schrittweisen Neustart der Knoten zu früh beendet wird. Außerdem wird sichergestellt, dass Replikate, die mit der Replikation nicht Schritt halten können, keinen schreibgeschützten Datenverkehr bedienen. Der Endpunkt kann fürreadinessProbeverwendet werden, wenn Kubernetes-Endpunkte nicht für die Leader-Wahl genutzt werden können (OpenShift).
Der Endpunkt liveness benötigt nur sehr wenige Ressourcen und führt kein SQL aus. Die Prüfungen sollten so konfiguriert werden, dass sie etwa zu dem Zeitpunkt fehlschlagen, zu dem der Leader-Schlüssel abläuft. Beim Standardwert 30s für ttl könnten die Prüfungen beispielsweise wie folgt aussehen:
Endpunkt zur Überwachung
Patroni verwendet GET /patroni bei der Leader-Wahl. Der Endpunkt kann auch vom Überwachungssystem genutzt werden. Das von diesem Endpunkt erzeugte JSON-Dokument hat dieselbe Struktur wie die JSON-Dokumente der Endpunkte für Health Checks.
Beispiel: Ein funktionsfähiger Cluster
Beispiel: Ein Cluster ohne Leader-Lock
Beispiel: Ein Cluster ohne Leader-Lock mit aktiviertem DCS-Failsafe-Modus
Beispiel: Ein Cluster mit aktiviertem Pausenmodus
Die Patroni-Metriken lassen sich über den Endpunkt GET /metrics im Prometheus-Format abrufen.
PostgreSQL-Zustandswerte
Die Metrik patroni_postgres_state bildet den aktuellen Zustand der PostgreSQL-Instanz als Zahl ab. Das ist für Überwachungs- und Alarmierungssysteme nützlich, die Zustandsänderungen im Zeitverlauf verfolgen müssen. Die Zahlenwerte werden mit der statischen Methode PostgresqlState.get_metrics_description() erzeugt.
| Wert | Zustandsname | Beschreibung |
|---|---|---|
| 0 | initdb | Neuer Cluster wird initialisiert |
| 1 | initdb_failed | Initialisierung des neuen Clusters fehlgeschlagen |
| 2 | custom_bootstrap | Benutzerdefiniertes Bootstrap-Skript wird ausgeführt |
| 3 | custom_bootstrap_failed | Benutzerdefiniertes Bootstrap-Skript fehlgeschlagen |
| 4 | creating_replica | Replikat wird vom Primärserver erstellt |
| 5 | running | PostgreSQL läuft ordnungsgemäß |
| 6 | starting | PostgreSQL wird gestartet |
| 7 | bootstrap_starting | Start nach benutzerdefiniertem Bootstrap |
| 8 | start_failed | Start von PostgreSQL fehlgeschlagen |
| 9 | restarting | PostgreSQL wird neu gestartet |
| 10 | restart_failed | Neustart von PostgreSQL fehlgeschlagen |
| 11 | stopping | PostgreSQL wird angehalten |
| 12 | stopped | PostgreSQL ist angehalten |
| 13 | stop_failed | Anhalten von PostgreSQL fehlgeschlagen |
| 14 | crashed | PostgreSQL ist abgestürzt |
PostgreSQL-Zustandswerte
Diese Zahlenwerte sind fest und werden niemals geändert, um die Abwärtskompatibilität mit bestehenden Überwachungssystemen zu wahren. Falls künftig neue Zustände hinzukommen, erhalten sie neue Zahlenwerte, ohne die bestehenden zu ändern.
Endpunkte für den Cluster-Status
- Der Endpunkt
GET /clustererzeugt ein JSON-Dokument, das die aktuelle Topologie und den Zustand des Clusters beschreibt:
- Der Endpunkt
GET /historybietet einen Überblick über die Switchover- und Failover-Historie des Clusters. Das Format ähnelt stark dem Inhalt der History-Dateien im Verzeichnispg_wal. Der einzige Unterschied ist das Zeitstempelfeld, das angibt, wann die neue Timeline erstellt wurde.
Endpunkt für die Konfiguration
GET /config: Aktuelle Version der dynamischen Konfiguration abrufen:
PATCH /config: Bestehende Konfiguration ändern.
Der obige REST-API-Aufruf ändert die bestehende Konfiguration und gibt die neue Konfiguration zurück.
Nun prüfen, ob der Knoten diese Konfiguration verarbeitet hat. Zunächst sollte er alle 5 Sekunden Protokollzeilen ausgeben (loop_wait=5). Die Änderung von „max_connections“ erfordert einen Neustart, daher sollte das Flag „pending_restart“ angezeigt werden:
Parameter entfernen:
Um eine Einstellung zu entfernen (zurückzusetzen), genügt es, sie per Patch auf null zu setzen:
Der obige Aufruf entfernt postgresql.parameters.max_connections aus der dynamischen Konfiguration.
PUT /config: Eine bestehende dynamische Konfiguration kann auch bedingungslos vollständig überschrieben werden:
Endpunkte für Switchover und Failover
Switchover
Der Endpunkt /switchover funktioniert nur, wenn der Cluster funktionsfähig ist (ein Leader vorhanden ist). Er ermöglicht auch, einen Switchover zu einem bestimmten Zeitpunkt zu planen.
Beim Aufruf des Endpunkts /switchover kann ein Kandidat angegeben werden; anders als beim Endpunkt /failover ist dies jedoch nicht erforderlich. Wird kein Kandidat angegeben, nehmen alle geeigneten Knoten des Clusters an der Leader-Wahl teil, nachdem der Leader seine Rolle abgegeben hat.
Im JSON-Inhalt der POST-Anfrage muss das Feld leader angegeben werden. Die Felder candidate und scheduled_at sind optional und können verwendet werden, um einen Switchover zu einem bestimmten Zeitpunkt zu planen.
Je nach Situation können Anfragen unterschiedliche HTTP-Statuscodes und Antwortinhalte liefern. Der Statuscode 200 wird zurückgegeben, wenn der Switchover oder das Failover erfolgreich abgeschlossen wurde. Wurde der Switchover erfolgreich geplant, liefert Patroni den HTTP-Statuscode 202. Ist ein Fehler aufgetreten, wird ein Fehlerstatuscode (400, 412 oder 503) mit Einzelheiten im Antwortinhalt zurückgegeben.
Mit DELETE /switchover kann der aktuell geplante Switchover gelöscht werden.
Beispiel: Switchover zu einem beliebigen funktionsfähigen Standby durchführen
Beispiel: Switchover zu einem bestimmten Knoten durchführen
Beispiel: Switchover vom Leader zu einem beliebigen anderen funktionsfähigen Standby im Cluster zu einem bestimmten Zeitpunkt planen.
Failover
Der Endpunkt /failover kann für ein manuelles Failover verwendet werden, wenn keine funktionsfähigen Knoten vorhanden sind (z. B. zu einem asynchronen Standby, wenn alle synchronen Standbys für eine Hochstufung nicht funktionsfähig genug sind). Ein fehlender Leader ist jedoch keine Voraussetzung: Ein Failover kann auch in einem funktionsfähigen Cluster ausgeführt werden.
Im JSON-Inhalt der POST-Anfrage muss das Feld candidate angegeben werden. Wird das Feld leader angegeben, wird stattdessen ein Switchover ausgelöst.
Beispiel:
Bei Verwendung dieses Endpunkts ist äußerste Vorsicht geboten , da er unter bestimmten Umständen zu Datenverlust führen kann. In den meisten Fällen erfüllt der Switchover-Endpunkt die Anforderungen des Administrators.
Die Endpunkte POST /switchover und POST /failover werden von patronictl_switchover
bzw. patronictl_failover
verwendet.
DELETE /switchover wird von patronictl flush cluster-name switchover
verwendet.
| Failover | Switchover | |
|---|---|---|
| Angabe eines Leaders erforderlich | nein | ja |
| Angabe eines Kandidaten erforderlich | ja | nein |
| Im Pausenmodus ausführbar | ja | ja (nur zu einem bestimmten Kandidaten) |
| Planbar | nein | ja (sofern nicht im Pausenmodus) |
Vergleich von Failover und Switchover
Funktionsfähiger Standby
Ein Cluster-Mitglied sollte einige Prüfungen bestehen, um bei einem Switchover an der Leader-Wahl teilnehmen oder als Failover-/Switchover-Kandidat zum Leader werden zu können:
- über die Patroni API erreichbar sein;
- das Tag
nofailoverdarf nicht auftruegesetzt sein; - über einen voll funktionsfähigen Watchdog verfügen (falls die Konfiguration dies erfordert);
- bei einem Switchover in einem funktionsfähigen Cluster oder einem automatischen Failover den maximalen Replikationsrückstand nicht überschreiten (Konfigurationsparameter
maximum_lag_on_failover); - bei einem Switchover in einem funktionsfähigen Cluster oder einem automatischen Failover keine kleinere Timeline-Nummer als die Cluster-Timeline haben, wenn der Konfigurationsparameter
check_timelineauftruegesetzt ist; - im synchronen Modus
:
- Bei einem Switchover (mit oder ohne Kandidaten): unter den Mitgliedern des Schlüssels
/syncaufgeführt sein; - Bei einem Failover sowohl in funktionsfähigen als auch in nicht funktionsfähigen Clustern entfällt diese Prüfung.
- Bei einem Switchover (mit oder ohne Kandidaten): unter den Mitgliedern des Schlüssels
Bei einem manuellen Failover in einem Cluster ohne Leader darf ein Kandidat auch dann hochgestuft werden, wenn:
- er bei aktiviertem synchronem Modus nicht unter den Mitgliedern des Schlüssels
/syncaufgeführt ist; - sein Rückstand den maximal zulässigen Replikationsrückstand überschreitet;
- seine Timeline-Nummer kleiner als die zuletzt bekannte Cluster-Timeline ist.
Endpunkt für Neustarts
POST /restart: Mit dem AufrufPOST /restartkann Postgres auf dem jeweiligen Knoten neu gestartet werden. Im JSON-Inhalt derPOST-Anfrage können optional Bedingungen für den Neustart angegeben werden:- restart_pending: Boolescher Wert. Bei
truestartet Patroni PostgreSQL nur dann neu, wenn ein Neustart aussteht, um Änderungen an der PostgreSQL-Konfiguration anzuwenden. - role: Neustart nur durchführen, wenn die aktuelle Rolle des Knotens mit der Rolle aus der POST-Anfrage übereinstimmt.
- postgres_version: Neustart nur durchführen, wenn die aktuelle Postgres-Version kleiner als die in der POST-Anfrage angegebene ist.
- timeout: Wartezeit, bis PostgreSQL Verbindungen annimmt. Überschreibt
primary_start_timeout. - schedule: Zeitstempel mit Zeitzone; plant den Neustart für einen zukünftigen Zeitpunkt.
- restart_pending: Boolescher Wert. Bei
DELETE /restart: Geplanten Neustart löschen
Die Endpunkte POST /restart und DELETE /restart werden von patronictl_restart
bzw. patronictl flush cluster-name restart
verwendet.
Endpunkt zum Neuladen
Der Aufruf POST /reload weist Patroni an, die Konfigurationsdatei erneut einzulesen und anzuwenden. Dies entspricht dem Senden des Signals SIGHUP an den Patroni-Prozess. Wenn Postgres-Parameter geändert wurden, die einen Neustart erfordern (z. B. shared_buffers), muss Postgres weiterhin ausdrücklich neu gestartet werden, entweder über den Endpunkt POST /restart oder mithilfe von patronictl_restart
.
Der Endpunkt zum Neuladen wird von patronictl_reload verwendet.
Endpunkt zur Neuinitialisierung
POST /reinitialize: Initialisiert das PostgreSQL-Datenverzeichnis auf dem angegebenen Knoten neu. Der Aufruf darf nur auf Replikaten ausgeführt werden. Er entfernt das Datenverzeichnis und startet pg_basebackup oder eine alternative Methode zur Replikaterstellung
.
Der Aufruf kann fehlschlagen, wenn Patroni in einer Schleife versucht, ein ausgefallenes Postgres wiederherzustellen (neu zu starten). Um dieses Problem zu umgehen, kann im Anfrageinhalt {"force":true} angegeben werden.
Im Anfrageinhalt kann {“from-leader”:true} angegeben werden, um das Basis-Backup direkt vom Leader-Knoten zu beziehen. Dies ist nützlich, wenn die Neuinitialisierung bei einem Ausfall aller Replikatknoten ausgeführt wird.
Der Endpunkt zur Neuinitialisierung wird von patronictl_reinit verwendet.
5 - patronictl
Patroni bietet eine Befehlszeilenschnittstelle namens patronictl , die hauptsächlich mit der REST API von Patroni und dem DCS interagiert. Sie erleichtert die Durchführung von Vorgängen im Cluster und lässt sich sowohl manuell als auch in Skripten einfach verwenden.
Konfiguration
patronictl verwendet 3 Abschnitte der Konfiguration:
- ctl: Authentifizierung gegenüber der REST API von Patroni und Prüfung der Serveridentität. Weitere Einzelheiten finden sich unter ctl-Einstellungen ;
- restapi: Authentifizierung gegenüber der REST API von Patroni und Prüfung der Serveridentität. Wird nur verwendet, wenn die
ctl-Konfiguration nicht ausreicht. patronictl verwendet hauptsächlich den Abschnittrestapi.authentication(wennctl.authenticationfehlt) und die Einstellungrestapi.cafile(wennctl.cacertfehlt). Weitere Einzelheiten finden sich unter REST-API-Einstellungen ; - DCS (z. B. etcd): Verbindung und Authentifizierung gegenüber dem von Patroni verwendeten DCS.
Diese Konfigurationsoptionen können entweder aus Umgebungsvariablen oder aus einer Konfigurationsdatei stammen. Die obigen Abschnitte unter Konfiguration über Umgebungsvariablen bzw. YAML-Konfiguration erläutern, wie die Optionen über Umgebungsvariablen oder eine Konfigurationsdatei gesetzt werden können.
Die Verwendung von Umgebungsvariablen ist unkompliziert. Patronictl liest die Umgebungsvariablen und verwendet ihre Werte.
Bei Verwendung einer Konfigurationsdatei gibt es verschiedene Möglichkeiten, patronictl
die gewünschte Datei mitzuteilen. Standardmäßig versucht patronictl
, eine Konfigurationsdatei namens patronictl.yaml zu laden. Je nach System wird sie unter einem der folgenden Pfade erwartet:
- Mac OS X:
~/Library/Application Support/patroni - Mac OS X (POSIX):
~/.patroni - Unix:
~/.config/patroni - Unix (POSIX):
~/.patroni - Windows (mit Roaming):
C:\Users\<user>\AppData\Roaming\patroni - Windows (ohne Roaming):
C:\Users\<user>\AppData\Local\patroni
Dieses Verhalten lässt sich auf folgende Weise überschreiben:
- Die Umgebungsvariable
PATRONICTL_CONFIG_FILEauf den Pfad einer eigenen Konfigurationsdatei setzen; - Dem Befehlszeilenargument
-c/--config-filevon patronictl den Pfad einer eigenen Konfigurationsdatei übergeben.
Wenn patronictl
auf demselben Host wie der Daemon patroni ausgeführt wird, kann dieselbe Konfigurationsdatei verwendet werden, sofern sie alle von patronictl
benötigten Konfigurationsabschnitte enthält.
Verwendung
patronictl bietet mehrere praktische Operationen. Dieser Abschnitt beschreibt sie im Einzelnen.
Vor der Beschreibung der einzelnen Unterbefehle von patronictl folgt eine Übersicht der Befehlszeilenargumente von patronictl selbst:
-c / --config-file
Wie bereits erläutert, wird damit der Pfad zu einer Konfigurationsdatei für patronictl
angegeben.
-d / --dcs-url / --dcs
Eine Verbindungszeichenfolge für den von Patroni verwendeten DCS angeben.
Dieses Argument kann die DCS- und namespace-Einstellungen aus der Konfiguration von patronictl
überschreiben oder sie festlegen, falls sie dort fehlen.
Der Wert sollte das Format DCS://HOST:PORT/NAMESPACE haben, z. B. etcd3://localhost:2379/service, um eine Verbindung zu etcd v3 auf localhost herzustellen, wobei der Patroni-Cluster im Namensraum service gespeichert ist. Jeder im Argument fehlende Teil wird durch den Wert aus der Konfiguration oder den Standardwert ersetzt.
-k / --insecure
Flag zum Überspringen der Prüfung des SSL-Zertifikats des REST-API-Servers.
Dies ist das Aufrufschema für einen Befehl von patronictl :
Für das Aufrufschema gilt folgende Syntax:
- Optionen in eckigen Klammern sind optional;
- Optionen in geschweiften Klammern bedeuten, dass eine Option aus der Menge gewählt wird;
- Optionen mit
[, ... ]können mehrfach angegeben werden; - Angaben in Großbuchstaben stehen für Literale, denen ein Wert zugewiesen werden sollte.
Dieselbe Syntax wird in den folgenden Unterabschnitten bei der Beschreibung der Unterbefehle von patronictl
verwendet. Die dortigen Aufrufschemata der Unterbefehle ersetzen jeweils SUBCOMMAND im obigen Aufrufschema.
Die folgenden Unterabschnitte beschreiben alle von patronictl
implementierten Befehle. Für die Beispiele werden die Konfigurationsdateien aus dem GitHub-Repository von Patroni verwendet (postgres0.yml, postgres1.yml und postgres2.yml).
patronictl demote-cluster
Aufrufschema
Beschreibung
patronictl demote-cluster wandelt einen regulären Patroni-Cluster in einen Standby-Cluster
um.
Der Befehl ergänzt die dynamische Konfiguration um einen Abschnitt standby_cluster, der aus den angegebenen Verbindungsoptionen für den entfernten Primärserver erstellt wird. Anschließend wartet er, bis der Leader als Standby-Leader läuft. Vor der Konfigurationsänderung gibt er die aktuelle Cluster-Topologie aus. Eine Bestätigung fordert er an, sofern --force nicht verwendet wird.
Mindestens eine der Optionen --host, --port oder --restore-command muss angegeben werden.
Parameter
CLUSTER_NAME: Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--host: Adresse des entfernten Knotens.
--port: Port des entfernten Knotens.
--restore-command: Befehl zur Wiederherstellung von WAL-Einträgen vom entfernten Primärserver.
--primary-slot-name: Name des Replikationsslots auf dem entfernten Knoten, der für die Replikation verwendet werden soll.
--force: Flag zum Überspringen der Bestätigungsabfragen beim Herabstufen des Clusters.
Nützlich für Skripte.
Beispiele
Den Cluster zu einem Standby-Cluster herabstufen, der einem entfernten Primärserver-Endpunkt folgt:
patronictl dsn
Aufrufschema
Beschreibung
patronictl dsn ermittelt die Verbindungszeichenfolge für ein Mitglied des Patroni-Clusters.
Wenn mehrere Mitglieder den Parametern dieses Befehls entsprechen, wird eines davon ausgewählt, wobei der Primärserver Vorrang hat.
Parameter
CLUSTER_NAME: Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
-r / --role
Ein Mitglied mit der angegebenen Rolle auswählen.
Die Rolle kann einen der folgenden Werte haben:
leader: der Leader eines regulären Patroni-Clusters oder eines Patroni-Standby-Clusters; oderprimary: der Leader eines regulären Patroni-Clusters; oderstandby-leader: der Leader eines Patroni-Standby-Clusters; oderreplica: ein Replikat eines Patroni-Clusters; oderstandby: entsprichtreplica; oderany: beliebige Rolle. Entspricht dem Weglassen dieses Parameters; oder
-m / --member
Ein Mitglied des Clusters mit dem angegebenen Namen auswählen.
MEMBER_NAME ist der Name des Mitglieds.
--group
Ein Mitglied auswählen, das zur angegebenen Citus-Gruppe gehört.
CITUS_GROUP ist die ID der Citus-Gruppe.
Beispiele
DSN des Primärservers abrufen:
DSN des Knotens namens postgresql1 abrufen:
patronictl edit-config
Aufrufschema
Beschreibung
patronictl edit-config ändert die dynamische Konfiguration des Clusters und aktualisiert damit den DCS.
Beim Aufruf über ein TTY versucht der Befehl, einen Diff der dynamischen Konfiguration mit einem Pager anzuzeigen. Standardmäßig versucht er, less oder more zu verwenden. Für einen anderen Pager die Umgebungsvariable PAGER auf das gewünschte Programm setzen.
Parameter
CLUSTER_NAME: Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Die dynamische Konfiguration der angegebenen Citus-Gruppe ändern.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration citus.group zu lesen, sofern sie vorhanden ist.
CITUS_GROUP ist die ID der Citus-Gruppe.
-q / --quiet
Flag zum Überspringen der Anzeige des Konfigurations-Diffs.
-s / --set
Eine bestimmte dynamische Konfigurationsoption auf den angegebenen Wert setzen.
CONFIG ist der Pfad der dynamischen Konfiguration im YAML-Baum, dessen Ebenen durch . verbunden sind.
VALUE ist der Wert für CONFIG. Bei null wird CONFIG aus der dynamischen Konfiguration entfernt.
-p / --pg
Eine bestimmte dynamische Postgres-Konfigurationsoption auf den angegebenen Wert setzen.
Dies ist im Wesentlichen eine Kurzform für -s / --set, bei der CONFIG das Präfix postgresql.parameters. erhält.
PG_CONFIG ist der Name der zu setzenden Postgres-Konfigurationsoption.
PG_VALUE ist der Wert für PG_CONFIG. Bei null wird PG_CONFIG aus der dynamischen Konfiguration entfernt.
--apply
Die dynamische Konfiguration aus der angegebenen Datei anwenden.
Dies entspricht der Angabe mehrerer Optionen -s / --set, einer für jede Konfigurationsoption aus CONFIG_FILE.
CONFIG_FILE ist der Pfad zu einer Datei mit der anzuwendenden dynamischen Konfiguration im YAML-Format. Zum Lesen aus stdin den Wert - verwenden.
--replace
Die dynamische Konfiguration im DCS durch die dynamische Konfiguration aus der angegebenen Datei ersetzen.
CONFIG_FILE ist der Pfad zu einer Datei mit der neuen dynamischen Konfiguration im YAML-Format, die wirksam werden soll. Zum Lesen aus stdin den Wert - verwenden.
--force
Flag zum Überspringen der Bestätigungsabfragen beim Ändern der dynamischen Konfiguration.
Nützlich für Skripte.
Beispiele
Den Postgres-GUC max_connections ändern:
Die Einstellungen loop_wait und ttl ändern:
Die Einstellung maximum_lag_on_failover aus der dynamischen Konfiguration entfernen:
patronictl failover
Aufrufschema
Beschreibung
patronictl failover führt ein manuelles Failover im Cluster durch.
Der Befehl ist für nicht funktionsfähige Cluster vorgesehen, z. B. wenn:
- kein Leader vorhanden ist; oder
- in einem synchronen Cluster kein synchroner Standby verfügbar ist.
Er ermöglicht bei aktiviertem synchronem Modus auch ein Failover zu einem asynchronen Knoten.
patronictl failover kann auch in einem funktionsfähigen Cluster ausgeführt werden. Für diese Fälle wird jedoch patronictl switchover empfohlen.
Das Auslösen eines Failovers kann zu Datenverlust führen, je nachdem, wie aktuell das hochgestufte Replikat im Vergleich zum Primärserver ist.
Parameter
CLUSTER_NAME: Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Ein Failover in der angegebenen Citus-Gruppe durchführen.
CITUS_GROUP ist die ID der Citus-Gruppe.
--candidate
Der Knoten, der beim Failover hochgestuft werden soll.
CANDIDATE_NAME ist der Name des hochzustufenden Knotens.
--force
Flag zum Überspringen der Bestätigungsabfragen bei der Durchführung des Failovers.
Nützlich für Skripte.
Beispiele
Ein Failover zum Knoten postgresql2 durchführen:
patronictl flush
Aufrufschema
Beschreibung
patronictl flush verwirft geplante Ereignisse, sofern vorhanden.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
MEMBER_NAME
Geplante Ereignisse für die angegebenen Patroni-Mitglieder verwerfen.
Es können mehrere Mitglieder angegeben werden. Ohne Angabe von Mitgliedern werden alle berücksichtigt.
Wird nur beim Verwerfen geplanter Neustarts verwendet.
restart
Geplante Neustarts verwerfen.
switchover
Geplanten Switchover verwerfen.
--group
Geplante Ereignisse der angegebenen Citus-Gruppe verwerfen.
CITUS_GROUP ist die ID der Citus-Gruppe.
-r / --role
Geplante Ereignisse für Mitglieder mit der angegebenen Rolle verwerfen.
Die Rolle kann einen der folgenden Werte haben:
leader: der Leader eines regulären Patroni-Clusters oder eines Patroni-Standby-Clusters; oderprimary: der Leader eines regulären Patroni-Clusters; oderstandby-leader: der Leader eines Patroni-Standby-Clusters; oderreplica: ein Replikat eines Patroni-Clusters; oderstandby: entsprichtreplica; oderany: beliebige Rolle. Entspricht dem Weglassen dieses Parameters.
Wird nur beim Verwerfen geplanter Neustarts verwendet.
--force
Flag zum Überspringen der Bestätigungsabfragen beim Verwerfen geplanter Ereignisse.
Nützlich für Skripte.
Beispiele
Einen geplanten Switchover verwerfen:
Den geplanten Neustart aller Standby-Knoten verwerfen:
Den geplanten Neustart der Knoten postgresql0 und postgresql1 verwerfen:
patronictl history
Aufrufschema
Beschreibung
patronictl history zeigt die Historie der Failover- und Switchover-Ereignisse des Clusters, sofern vorhanden.
Die Ausgabe enthält folgende Informationen:
TL
Postgres-Timeline, auf der das Ereignis auftrat.
LSN
Postgres-LSN, an der das Ereignis auftrat.
Reason
Grund aus der Postgres-Datei .history.
Timestamp
Zeitpunkt des Ereignisses.
New Leader
Patroni-Mitglied, das bei diesem Ereignis hochgestuft wurde.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Die Ereignishistorie der angegebenen Citus-Gruppe anzeigen.
CITUS_GROUP ist die ID der Citus-Gruppe.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration citus.group zu lesen, sofern sie vorhanden ist.
-f / --format
Formatierung der Ereignisliste in der Ausgabe.
Das Format kann einen der folgenden Werte haben:
pretty: gibt die Historie als formatierte Tabelle aus; odertsv: gibt die Historie tabellarisch aus, mit durch\tgetrennten Spalten; oderjson: gibt die Historie im JSON-Format aus; oderyaml: gibt die Historie im YAML-Format aus.
Der Standardwert ist pretty.
Beispiele
Die Ereignishistorie anzeigen:
Die Ereignishistorie im YAML-Format anzeigen:
patronictl list
Aufrufschema
Beschreibung
patronictl list zeigt Informationen zum Patroni-Cluster und seinen Mitgliedern.
Die Ausgabe enthält folgende Informationen:
Cluster
Name des Patroni-Clusters.
Member
Name des Patroni-Mitglieds.
Host
Host, auf dem sich das Mitglied befindet.
Role
Aktuelle Rolle des Mitglieds.
Mögliche Werte sind:
Leader: der aktuelle Leader eines regulären Patroni-Clusters; oderStandby Leader: der aktuelle Leader eines Patroni-Standby-Clusters; oderSync Standby: ein synchroner Standby eines Patroni-Clusters mit aktiviertem synchronem Modus; oderReplica: ein regulärer Standby eines Patroni-Clusters.
State
Aktueller Zustand von Postgres im Patroni-Mitglied.
Einige Beispiele für mögliche Zustände:
running: wenn Postgres derzeit läuft;streaming: bei einem Replikat, wenn Postgres derzeit WAL per Streaming vom Primärserver empfängt;in archive recovery: bei einem Replikat, wenn Postgres derzeit WAL aus dem Archiv abruft;stopped: wenn Postgres heruntergefahren wurde;crashed: wenn Postgres abgestürzt ist.
TL
Aktuelle Postgres-Timeline im Patroni-Mitglied.
Receive LSN
Die letzte Write-Ahead-Log-Position, die das Mitglied per Streaming-Replikation empfangen und auf den Datenträger synchronisiert hat (pg_catalog.pg_last_(xlog|wal)_receive_(location|lsn)()).
Receive Lag
Replikationsrückstand zwischen der Position Receive LSN des Mitglieds und seiner Replikationsquelle in MB.
Replay LSN
Die letzte Write-Ahead-Log-Position, die bei der Recovery des Mitglieds wiedergegeben wurde (pg_catalog.pg_last_(xlog|wal)_replay_(location|lsn)()).
Replay Lag
Replikationsrückstand zwischen der Position Replay LSN des Mitglieds und seiner Replikationsquelle in MB.
Darüber hinaus kann die Ausgabe folgende Informationen enthalten:
System identifier
Postgres-Systemkennung.
Wird im Tabellenkopf angezeigt.
Wird nur beim Ausgabeformat pretty angezeigt.
Group
ID der Citus-Gruppe.
Wird im Tabellenkopf angezeigt.
Wird nur bei einem Citus-Cluster angezeigt.
Pending restart
* zeigt an, dass der Knoten einen Neustart benötigt, damit bestimmte Postgres-Konfigurationseinstellungen wirksam werden. Ein leerer Wert zeigt an, dass der Knoten keinen Neustart benötigt.
Wird als Attribut des Mitglieds angezeigt.
Wird angezeigt, wenn:
- die Ausgabe im Format
prettyodertsverfolgt und die erweiterte Ausgabe aktiviert ist; oder - der Knoten einen Neustart benötigt.
Scheduled restart
Zeitstempel des geplanten Neustarts der vom Patroni-Mitglied verwalteten Postgres-Instanz. Ein leerer Wert zeigt an, dass für das Mitglied kein Neustart geplant ist.
Wird als Attribut des Mitglieds angezeigt.
Wird angezeigt, wenn:
- die Ausgabe im Format
prettyodertsverfolgt und die erweiterte Ausgabe aktiviert ist; oder - für den Knoten ein Neustart geplant ist.
Tags
Enthält die für das Patroni-Mitglied gesetzten Tags. Ein leerer Wert zeigt an, dass entweder keine Tags konfiguriert wurden oder diese auf die Standardwerte gesetzt sind.
Wird als Attribut des Mitglieds angezeigt.
Wird angezeigt, wenn:
- die Ausgabe im Format
prettyodertsverfolgt und die erweiterte Ausgabe aktiviert ist; oder - der Knoten benutzerdefinierte Tags oder Standard-Tags mit abweichenden Werten hat.
Scheduled switchover
Zeitstempel des geplanten Switchovers für den Patroni-Cluster, sofern vorhanden.
Wird am Tabellenende angezeigt.
Wird nur angezeigt, wenn ein Switchover geplant ist und das Ausgabeformat pretty verwendet wird.
Maintenance mode
Ob die Cluster-Überwachung derzeit pausiert ist.
HinweisWird am Tabellenende angezeigt.
Wird nur angezeigt, wenn der Cluster pausiert ist und das Ausgabeformat
prettyverwendet wird.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Informationen zu Mitgliedern der angegebenen Citus-Gruppe anzeigen.
CITUS_GROUP ist die ID der Citus-Gruppe.
-e / --extended
Erweiterte Informationen anzeigen.
Die Attribute Pending restart, Scheduled restart und Tags auch dann anzeigen, wenn ihr Wert leer ist.
Gilt nur für die Ausgabeformate pretty und tsv.
-t / --timestamp
Vor den Informationen zum Cluster und seinen Mitgliedern einen Zeitstempel ausgeben.
-f / --format
Formatierung der Liste der Clustermitglieder in der Ausgabe.
Das Format kann einen der folgenden Werte haben:
pretty: gibt die Clustermitglieder als formatierte Tabelle aus; odertsv: gibt die Clustermitglieder tabellarisch aus, mit durch\tgetrennten Spalten; oderjson: gibt die Clustermitglieder im JSON-Format aus; oderyaml: gibt die Clustermitglieder im YAML-Format aus.
Der Standardwert ist pretty.
-W
Informationen automatisch alle 2 Sekunden aktualisieren.
-w / --watch
Informationen automatisch im angegebenen Intervall aktualisieren.
TIME ist das Aktualisierungsintervall in Sekunden.
Beispiele
Informationen zum Cluster als formatierte Tabelle anzeigen:
Informationen zum Cluster als formatierte Tabelle mit erweiterten Spalten anzeigen:
Informationen zum Cluster im YAML-Format mit Ausführungszeitstempel anzeigen:
patronictl pause
Aufrufschema
Beschreibung
patronictl pause versetzt den Patroni-Cluster vorübergehend in den Wartungsmodus und deaktiviert automatisches Failover.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Die angegebene Citus-Gruppe pausieren.
CITUS_GROUP ist die ID der Citus-Gruppe.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration citus.group zu lesen, sofern sie vorhanden ist.
--wait
Warten, bis alle Patroni-Mitglieder pausiert sind, bevor die Kontrolle an den Aufrufer zurückgegeben wird.
Beispiele
Den Cluster in den Wartungsmodus versetzen und warten, bis alle Knoten pausiert sind:
patronictl promote-cluster
Aufrufschema
Beschreibung
patronictl promote-cluster wandelt einen Standby-Cluster in einen regulären Patroni-Cluster um.
Der Befehl entfernt den Abschnitt standby_cluster aus der dynamischen Konfiguration und wartet, bis der Leader als Primärserver läuft. Vor der Konfigurationsänderung gibt er die aktuelle Cluster-Topologie aus. Eine Bestätigung fordert er an, sofern --force nicht verwendet wird.
Parameter
CLUSTER_NAME: Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--force: Flag zum Überspringen der Bestätigungsabfragen beim Hochstufen des Clusters.
Nützlich für Skripte.
Beispiele
Den Standby-Cluster hochstufen, sodass er als regulärer Patroni-Cluster läuft:
patronictl query
Aufrufschema
Beschreibung
patronictl query führt einen SQL-Befehl oder ein Skript auf einem Mitglied des Patroni-Clusters aus.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Die angegebene Citus-Gruppe abfragen.
CITUS_GROUP ist die ID der Citus-Gruppe.
-r / --role
Ein Mitglied mit der angegebenen Rolle auswählen.
Die Rolle kann einen der folgenden Werte haben:
leader: der Leader eines regulären Patroni-Clusters oder eines Patroni-Standby-Clusters; oderprimary: der Leader eines regulären Patroni-Clusters; oderstandby-leader: der Leader eines Patroni-Standby-Clusters; oderreplica: ein Replikat eines Patroni-Clusters; oderstandby: entsprichtreplica; oderany: beliebige Rolle. Entspricht dem Weglassen dieses Parameters.
-m / --member
Ein Mitglied mit dem angegebenen Namen auswählen.
MEMBER_NAME ist der Name des auszuwählenden Mitglieds.
-d / --dbname
Datenbank, zu der eine Verbindung hergestellt und auf der die Abfrage ausgeführt wird.
DBNAME ist der Name der Datenbank. Ohne Angabe wird USERNAME verwendet.
-U / --username
Benutzer für die Verbindung zur Datenbank.
USERNAME ist der Name des Benutzers. Ohne Angabe wird der Betriebssystembenutzer verwendet, der patronictl query ausführt.
--password
Das Passwort des Benutzers abfragen, der die Verbindung herstellt.
Da Patroni libpq verwendet, kann alternativ eine Datei ~/.pgpass erstellt oder die Umgebungsvariable PGPASSWORD gesetzt werden.
--format
Formatierung der Abfrageausgabe.
Das Format kann einen der folgenden Werte haben:
pretty: gibt das Abfrageergebnis als formatierte Tabelle aus; odertsv: gibt das Abfrageergebnis tabellarisch aus, mit durch\tgetrennten Spalten; oderjson: gibt das Abfrageergebnis im JSON-Format aus; oderyaml: gibt das Abfrageergebnis im YAML-Format aus.
Der Standardwert ist tsv.
-f / --file
Eine Datei als Quelle der auszuführenden Abfragebefehle verwenden.
FILE_NAME ist der Pfad zur Quelldatei.
-c / --command
Den angegebenen SQL-Befehl als Abfrage ausführen.
SQL_COMMAND ist der auszuführende SQL-Befehl.
--delimiter
Das Trennzeichen für die Ausgabe im Format tsv; ohne Angabe wird \t verwendet.
-W
Die Abfrage automatisch alle 2 Sekunden erneut ausführen.
-w / --watch
Die Abfrage automatisch im angegebenen Intervall erneut ausführen.
TIME ist das Intervall zwischen den Ausführungen in Sekunden.
Beispiele
Einen SQL-Befehl als Benutzer postgres ausführen und dessen Passwort abfragen:
Einen SQL-Befehl als Benutzer postgres ausführen und das Passwort aus der Umgebungsvariable von libpq beziehen:
Einen SQL-Befehl alle 2 Sekunden ausführen und das Ergebnis im Format pretty ausgeben:
Einen SQL-Befehl auf der Datenbank test ausführen und das Ergebnis im YAML-Format ausgeben:
Einen SQL-Befehl auf dem Mitglied postgresql2 ausführen:
Einen SQL-Befehl auf einem beliebigen Standby ausführen:
patronictl reinit
Aufrufschema
Beschreibung
patronictl reinit erstellt eine Postgres-Standby-Instanz neu, die von einem Replikatmitglied des Patroni-Clusters verwaltet wird.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
MEMBER_NAME
Name des Replikatmitglieds, dessen Postgres-Instanz neu erstellt werden soll.
Es können mehrere Replikatmitglieder angegeben werden. Ohne Angabe von Mitgliedern führt der Befehl keine Aktion aus.
--group
Ein Replikatmitglied der angegebenen Citus-Gruppe neu erstellen.
CITUS_GROUP ist die ID der Citus-Gruppe.
--wait
Warten, bis die Neuinitialisierung der Postgres-Standby-Knoten abgeschlossen ist.
--force
Flag zum Überspringen der Bestätigungsabfragen beim Neuerstellen von Postgres-Standby-Instanzen.
Nützlich für Skripte.
--from-leader
Flag zum direkten Beziehen des Basis-Backups vom Leader.
Beispiele
Das Neuerstellen aller Replikatmitglieder des Patroni-Clusters anfordern und die Kontrolle sofort an den Aufrufer zurückgeben:
Das Neuerstellen von postgresql2 anfordern und auf den Abschluss warten:
Das Neuerstellen von postgresql2 anfordern und das Basis-Backup direkt vom Leader beziehen:
patronictl reload
Aufrufschema
Beschreibung
patronictl reload fordert ein Neuladen der lokalen Konfiguration für ein oder mehrere Patroni-Mitglieder an.
Dabei wird auf der verwalteten Postgres-Instanz auch pg_ctl reload ausgelöst, selbst wenn sich nichts geändert hat.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
MEMBER_NAME
Das Neuladen der lokalen Konfiguration für die angegebenen Patroni-Mitglieder anfordern.
Es können mehrere Mitglieder angegeben werden. Ohne Angabe von Mitgliedern werden alle berücksichtigt.
--group
Ein Neuladen der Mitglieder der angegebenen Citus-Gruppe anfordern.
CITUS_GROUP ist die ID der Citus-Gruppe.
-r / --role
Mitglieder mit der angegebenen Rolle auswählen.
Die Rolle kann einen der folgenden Werte haben:
leader: der Leader eines regulären Patroni-Clusters oder eines Patroni-Standby-Clusters; oderprimary: der Leader eines regulären Patroni-Clusters; oderstandby-leader: der Leader eines Patroni-Standby-Clusters; oderreplica: ein Replikat eines Patroni-Clusters; oderstandby: entsprichtreplica; oderany: beliebige Rolle. Entspricht dem Weglassen dieses Parameters.
--force
Flag zum Überspringen der Bestätigungsabfragen beim Anfordern eines Neuladens der lokalen Konfiguration.
Nützlich für Skripte.
Beispiele
Das Neuladen der lokalen Konfiguration aller Mitglieder des Patroni-Clusters anfordern:
patronictl remove
Aufrufschema
Beschreibung
patronictl remove entfernt die Informationen zum Cluster aus dem DCS.
Dies ist ein interaktiver Vorgang.
Dieser Vorgang zerstört die Informationen zum Patroni-Cluster im DCS.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
--group
Die Informationen zum Patroni-Cluster entfernen, die zur angegebenen Citus-Gruppe gehören.
CITUS_GROUP ist die ID der Citus-Gruppe.
-f / --format
Formatierung der Mitgliederliste in der Ausgabe bei der Bestätigungsabfrage.
Das Format kann einen der folgenden Werte haben:
pretty: gibt die Mitglieder als formatierte Tabelle aus; odertsv: gibt die Mitglieder tabellarisch aus, mit durch\tgetrennten Spalten; oderjson: gibt die Mitglieder im JSON-Format aus; oderyaml: gibt die Mitglieder im YAML-Format aus.
Der Standardwert ist pretty.
Beispiele
Informationen zum Patroni-Cluster batman aus dem DCS entfernen:
patronictl restart
Aufrufschema
Beschreibung
patronictl restart fordert einen Neustart der Postgres-Instanz an, die von einem Mitglied des Patroni-Clusters verwaltet wird.
Der Neustart kann sofort ausgeführt oder für später geplant werden.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
--group
Den zur angegebenen Citus-Gruppe gehörenden Patroni-Cluster neu starten.
CITUS_GROUP ist die ID der Citus-Gruppe.
-r / --role
Mitglieder mit der angegebenen Rolle auswählen.
Die Rolle kann einen der folgenden Werte haben:
leader: der Leader eines regulären Patroni-Clusters oder eines Patroni-Standby-Clusters; oderprimary: der Leader eines regulären Patroni-Clusters; oderstandby-leader: der Leader eines Patroni-Standby-Clusters; oderreplica: ein Replikat eines Patroni-Clusters; oderstandby: entsprichtreplica; oderany: beliebige Rolle. Entspricht dem Weglassen dieses Parameters.
--any
Einen einzelnen, zufällig ausgewählten Knoten aus denjenigen neu starten, die den angegebenen Filtern entsprechen.
--pg-version
Nur Mitglieder auswählen, deren verwaltete Postgres-Instanz eine ältere als die angegebene Version hat.
PG_VERSION ist die zum Vergleich herangezogene Postgres-Version.
--pending
Nur Mitglieder auswählen, die als Pending restart markiert sind.
--timeout: Den Neustart abbrechen, wenn er länger als die angegebene Wartezeit dauert, und ein Failover zu einem Replikat durchführen, wenn das Problem auf dem Primärserver auftritt.
TIMEOUT ist die Wartezeit in Sekunden, bevor der Neustart abgebrochen wird.
--scheduled
Einen Neustart zum angegebenen Zeitpunkt planen.
TIMESTAMP ist der Zeitstempel, zu dem der Neustart erfolgen soll. Er ist in einem eindeutigen Format anzugeben, vorzugsweise mit Zeitzone. Mit dem Literal now kann der Neustart auch sofort ausgeführt werden.
--force
Flag zum Überspringen der Bestätigungsabfragen beim Anfordern von Neustarts.
Nützlich für Skripte.
Beispiele
Alle Mitglieder des Clusters sofort neu starten:
Ein zufällig ausgewähltes Mitglied des Clusters sofort neu starten:
Einen Neustart für 2023-09-13T18:00-03:00 planen:
patronictl resume
Aufrufschema
Beschreibung
patronictl resume beendet den Wartungsmodus des Patroni-Clusters und aktiviert automatisches Failover wieder.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Den Betrieb der angegebenen Citus-Gruppe fortsetzen.
CITUS_GROUP ist die ID der Citus-Gruppe.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration citus.group zu lesen, sofern sie vorhanden ist.
--wait
Warten, bis die Pause für alle Patroni-Mitglieder aufgehoben ist, bevor die Kontrolle an den Aufrufer zurückgegeben wird.
Beispiele
Den Wartungsmodus des Clusters beenden:
patronictl show-config
Aufrufschema
Beschreibung
patronictl show-config zeigt die im DCS gespeicherte dynamische Konfiguration des Clusters.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Die dynamische Konfiguration der angegebenen Citus-Gruppe anzeigen.
CITUS_GROUP ist die ID der Citus-Gruppe.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration citus.group zu lesen, sofern sie vorhanden ist.
Beispiele
Die dynamische Konfiguration des Clusters batman anzeigen:
patronictl switchover
Aufrufschema
Beschreibung
patronictl switchover führt einen Switchover im Cluster durch.
Der Befehl ist für funktionsfähige Cluster vorgesehen, z. B. wenn:
- ein Leader vorhanden ist;
- in einem synchronen Cluster synchrone Standbys verfügbar sind.
Bei einem nicht funktionsfähigen Cluster kommt stattdessen möglicherweise patronictl failover infrage.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Einen Switchover in der angegebenen Citus-Gruppe durchführen.
CITUS_GROUP ist die ID der Citus-Gruppe.
--leader / --primary
Den Leader angeben, der beim Switchover herabgestuft werden soll.
LEADER_NAME sollte mit dem Namen des aktuellen Leaders im Cluster übereinstimmen.
--candidate
Der Knoten, der beim Switchover hochgestuft werden und die Rolle des Primärservers übernehmen soll.
CANDIDATE_NAME ist der Name des hochzustufenden Knotens.
--scheduled
Einen Switchover zum angegebenen Zeitpunkt planen.
TIMESTAMP ist der Zeitstempel, zu dem der Switchover erfolgen soll. Er ist in einem eindeutigen Format anzugeben, vorzugsweise mit Zeitzone. Mit dem Literal now kann der Switchover auch sofort ausgeführt werden.
--force
Flag zum Überspringen der Bestätigungsabfragen bei der Durchführung des Switchovers.
Nützlich für Skripte.
Beispiele
Einen Switchover zum Knoten postgresql2 durchführen:
Einen Switchover zwischen postgresql0 und postgresql2 für 2023-09-13T18:00:00-03:00 planen:
patronictl topology
Aufrufschema
Beschreibung
patronictl topology zeigt Informationen zum Patroni-Cluster und seinen Mitgliedern als Baumansicht.
Die Ausgabe enthält folgende Informationen:
Cluster
Name des Patroni-Clusters.
Wird im Tabellenkopf angezeigt.
System identifier
Postgres-Systemkennung.
Wird im Tabellenkopf angezeigt.
Member
Name des Patroni-Mitglieds.
Diese Spalte zeigt die Mitglieder als Baumansicht ihrer Replikationsverbindungen.
Host
Host, auf dem sich das Mitglied befindet.
Role
Aktuelle Rolle des Mitglieds.
Mögliche Werte sind:
Leader: der aktuelle Leader eines regulären Patroni-Clusters; oderStandby Leader: der aktuelle Leader eines Patroni-Standby-Clusters; oderSync Standby: ein synchroner Standby eines Patroni-Clusters mit aktiviertem synchronem Modus; oderReplica: ein regulärer Standby eines Patroni-Clusters.
State
Aktueller Zustand von Postgres im Patroni-Mitglied.
Einige Beispiele für mögliche Zustände:
running: wenn Postgres derzeit läuft;streaming: bei einem Replikat, wenn Postgres derzeit WAL per Streaming vom Primärserver empfängt;in archive recovery: bei einem Replikat, wenn Postgres derzeit WAL aus dem Archiv abruft;stopped: wenn Postgres heruntergefahren wurde;crashed: wenn Postgres abgestürzt ist.
TL
Aktuelle Postgres-Timeline im Patroni-Mitglied.
Receive LSN
Die letzte Write-Ahead-Log-Position, die das Mitglied per Streaming-Replikation empfangen und auf den Datenträger synchronisiert hat (pg_catalog.pg_last_(xlog|wal)_receive_(location|lsn)()).
Receive Lag
Replikationsrückstand zwischen der Position Receive LSN des Mitglieds und seiner Replikationsquelle in MB.
Replay LSN
Die letzte Write-Ahead-Log-Position, die bei der Recovery des Mitglieds wiedergegeben wurde (pg_catalog.pg_last_(xlog|wal)_replay_(location|lsn)()).
Replay Lag
Replikationsrückstand zwischen der Position Replay LSN des Mitglieds und seiner Replikationsquelle in MB.
Darüber hinaus kann die Ausgabe folgende Informationen enthalten:
Group
ID der Citus-Gruppe.
Wird im Tabellenkopf angezeigt.
Wird nur bei einem Citus-Cluster angezeigt.
Pending restart
* zeigt an, dass der Knoten einen Neustart benötigt, damit bestimmte Postgres-Konfigurationseinstellungen wirksam werden. Ein leerer Wert zeigt an, dass der Knoten keinen Neustart benötigt.
Wird als Attribut des Mitglieds angezeigt.
Wird angezeigt, wenn der Knoten einen Neustart benötigt.
Scheduled restart
Zeitstempel des geplanten Neustarts der vom Patroni-Mitglied verwalteten Postgres-Instanz. Ein leerer Wert zeigt an, dass für das Mitglied kein Neustart geplant ist.
Wird als Attribut des Mitglieds angezeigt.
Wird angezeigt, wenn für den Knoten ein Neustart geplant ist.
Tags
Enthält die für das Patroni-Mitglied gesetzten Tags. Ein leerer Wert zeigt an, dass entweder keine Tags konfiguriert wurden oder diese auf die Standardwerte gesetzt sind.
Wird als Attribut des Mitglieds angezeigt.
Wird angezeigt, wenn der Knoten benutzerdefinierte Tags oder Standard-Tags mit abweichenden Werten hat.
Scheduled switchover
Zeitstempel des geplanten Switchovers für den Patroni-Cluster, sofern vorhanden.
Wird am Tabellenende angezeigt.
Wird nur angezeigt, wenn ein Switchover geplant ist.
Maintenance mode
Ob die Cluster-Überwachung derzeit pausiert ist.
HinweisWird am Tabellenende angezeigt.
Wird nur angezeigt, wenn der Cluster pausiert ist.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
Falls nicht angegeben, versucht patronictl
, den Wert aus der Konfiguration scope zu lesen, sofern sie vorhanden ist.
--group
Informationen zu Mitgliedern der angegebenen Citus-Gruppe anzeigen.
CITUS_GROUP ist die ID der Citus-Gruppe.
-W
Informationen automatisch alle 2 Sekunden aktualisieren.
-w / --watch
Informationen automatisch im angegebenen Intervall aktualisieren.
TIME ist das Aktualisierungsintervall in Sekunden.
Beispiele
Die Topologie des Clusters batman anzeigen – postgresql1 und postgresql2 replizieren von postgresql0:
patronictl version
Aufrufschema
Beschreibung
patronictl version ermittelt die Version der Anwendung patronictl
. Zusätzlich kann die Ausgabe Versionsinformationen zu Patroni-Clustern und ihren Mitgliedern enthalten.
Parameter
CLUSTER_NAME
Name des Patroni-Clusters.
MEMBER_NAME
Name des Mitglieds des Patroni-Clusters.
--group
Einen Patroni-Cluster mit der angegebenen Citus-Gruppe berücksichtigen.
CITUS_GROUP ist die ID der Citus-Gruppe.
Beispiele
Nur die Version von patronictl abrufen:
Die Version von patronictl
und aller Mitglieder des Clusters batman abrufen:
Die Version von patronictl
und der Mitglieder postgresql1 und postgresql2 des Clusters batman abrufen:
6 - Replikaterstellung und Cluster-Initialisierung
Patroni ermöglicht es, die Erstellung neuer Replikate anzupassen. Ebenso lässt sich festlegen, wie ein neuer, leerer Cluster initialisiert wird. Die beiden Vorgänge sind klar voneinander getrennt: Patroni erstellt Replikate nur dann, wenn der Schlüssel initialize für den Cluster im DCS vorhanden ist. Fehlt der Schlüssel initialize, führt Patroni die Cluster-Initialisierung ausschließlich auf dem ersten Knoten aus, der die Sperre für diesen Schlüssel erlangt.
Cluster-Initialisierung
PostgreSQL stellt den Befehl initdb zum Initialisieren eines neuen Clusters bereit; Patroni ruft ihn standardmäßig auf. In bestimmten Fällen, insbesondere beim Erstellen eines neuen Clusters als Kopie eines bestehenden, muss die eingebaute Methode durch eigene Aktionen ersetzt werden. Patroni kann benutzerdefinierte Skripte zur Cluster-Initialisierung ausführen und ihnen die erforderlichen Argumente wie Clustername und Pfad zum Datenverzeichnis übergeben. Dies wird im Abschnitt bootstrap der Patroni-Konfiguration festgelegt. Beispiel:
Jede benutzerdefinierte Initialisierungsmethode muss über die Einstellung method benannt werden und im gleichnamigen Abschnitt einen command definieren. Die spezielle Methode initdb aktiviert das Standardverhalten; in diesem Fall kann der Parameter method vollständig entfallen. Für command kann ein absoluter Pfad, ein Pfad relativ zum Arbeitsverzeichnis von Patroni oder ein in PATH verfügbarer Befehlsname angegeben werden. Zusätzlich zu den festen Parametern aus den Konfigurationsdateien übergibt Patroni zwei clusterspezifische Parameter:
--scope
Name des zu initialisierenden Clusters
--datadir
Pfad zum Datenverzeichnis der zu initialisierenden Clusterinstanz
Die Übergabe dieser beiden zusätzlichen Optionen lässt sich deaktivieren, indem der spezielle Parameter no_params auf True gesetzt wird.
Gibt das Initialisierungsskript 0 zurück, versucht Patroni, die damit erstellte PostgreSQL-Instanz zu konfigurieren und zu starten. Schlägt ein Zwischenschritt fehl oder gibt das Skript einen Wert ungleich null zurück, betrachtet Patroni die Initialisierung als fehlgeschlagen, räumt auf und gibt die initialize-Sperre frei, damit ein anderer Knoten die Initialisierung versuchen kann.
Ist im selben Abschnitt wie die benutzerdefinierte Initialisierungsmethode ein Block recovery_conf definiert, erzeugt Patroni vor dem Start der neu initialisierten Instanz eine recovery.conf (oder setzt bei PostgreSQL >= 12 die Recovery-Einstellungen in der Postgres-Konfiguration). Eine solche Recovery-Konfiguration sollte üblicherweise mindestens einen Parameter recovery_target_* enthalten und recovery_target_action auf promote setzen.
Ist keep_existing_recovery_conf definiert und auf True gesetzt, entfernt Patroni eine vorhandene Datei recovery.conf nicht (PostgreSQL <= 11). Ebenso entfernt Patroni in diesem Fall weder eine vorhandene recovery.signal noch eine standby.signal und überschreibt auch die konfigurierten Recovery-Einstellungen nicht (PostgreSQL >= 12). Dies ist bei der Initialisierung aus einem Backup mit Werkzeugen wie pgBackRest nützlich, die selbst die passende Recovery-Konfiguration erzeugen.
Alle weiteren Schlüssel-Wert-Paare in der Konfiguration der benutzerdefinierten Initialisierungsmethode werden außerdem als Argumente im Format --name=value an command übergeben. Beispiel:
Dadurch wird der konfigurierte command zusätzlich mit den Befehlszeilenargumenten --arg1=value1 --arg2=value2 aufgerufen.
Initialisierungsmethoden werden weder verkettet, noch wird bei einem Fehlschlag der gewählten Methode auf die Standardmethode zurückgegriffen.
Ein neuer Patroni-Cluster lässt sich beispielsweise mit folgender Konfiguration aus einem Barman-Backup initialisieren:
patroni_barman recover setzt voraus, dass auf dem Barman-Host sowohl Barman als auch pg-backup-api konfiguriert sind, damit barman recover über die Backup-API aus der Ferne ausgeführt werden kann. Das obige Beispiel verwendet nur einen Teil der verfügbaren Parameter. Weitere Informationen liefert patroni_barman recover --help.
Replikate erstellen
Patroni verwendet das bewährte pg_basebackup, um neue Replikate zu erstellen. Dafür ist eine laufende PostgreSQL-Quellinstanz erforderlich; eine eingebaute Bereinigung veralteter Backup-Dateien ist nicht vorhanden. Manche Anwender bevorzugen andere Backup-Lösungen wie WAL-E, pgBackRest, Barman oder eigene Skripte. Um all diese Fälle abzudecken, unterstützt Patroni benutzerdefinierte Skripte zum Klonen eines neuen Replikats. Sie werden im Konfigurationsblock postgresql eingerichtet:
Beispiel: wal_e
Beispiel: pgbackrest
Beispiel: Barman
patroni_barman recover setzt voraus, dass auf dem Barman-Host sowohl Barman als auch pg-backup-api konfiguriert sind, damit barman recover über die Backup-API aus der Ferne ausgeführt werden kann. Das obige Beispiel verwendet nur einen Teil der verfügbaren Parameter. Weitere Informationen liefert patroni_barman recover --help.
create_replica_methods legt die verfügbaren Methoden zur Replikaterstellung und ihre Ausführungsreihenfolge fest. Patroni beendet die Versuche bei der ersten Methode, die 0 zurückgibt. Für jede Methode sollte ein eigener Abschnitt in der Konfigurationsdatei den auszuführenden Befehl und alle zu übergebenden benutzerdefinierten Parameter aufführen. Sämtliche Parameter werden im Format --name=value übergeben. Zusätzlich zu den benutzerdefinierten Parametern übergibt Patroni einige clusterspezifische:
--scope
Cluster, zu dem dieses Replikat gehört
--datadir
Pfad zum Datenverzeichnis des Replikats
--role
Immer ‘replica’
--connstring
Verbindungszeichenfolge zum Clustermitglied, von dem geklont werden soll (Primärserver oder anderes Replikat). Der Benutzer in der Verbindungszeichenfolge kann SQL-Befehle und Befehle des Replikationsprotokolls ausführen.
Ist der spezielle Parameter no_leader aktiviert, darf Patroni die Methode zur Replikaterstellung auch dann aufrufen, wenn weder ein Leader noch Replikate laufen. In diesem Fall wird eine leere Verbindungszeichenfolge übergeben. Dies ist nützlich, um einen zuvor laufenden Cluster aus einem Binärbackup wiederherzustellen.
Ist der spezielle Parameter keep_data aktiviert, leert Patroni das PGDATA-Verzeichnis vor dem Aufruf der Wiederherstellung nicht.
Ist der spezielle Parameter no_params aktiviert, werden dem benutzerdefinierten Befehl keine clusterspezifischen Parameter automatisch hinzugefügt. Benutzerdefinierte Parameter werden weiterhin übergeben.
Die Methode basebackup ist ein Sonderfall: Sie wird verwendet, wenn create_replica_methods leer ist, kann aber auch ausdrücklich in create_replica_methods aufgeführt werden. Diese Methode initialisiert ein neues Replikat mit pg_basebackup. Das Basisbackup wird vom Leader bezogen, es sei denn, es gibt Replikate mit dem Tag clonefrom; dann dient eines dieser Replikate als Quelle für pg_basebackup. Die Methode funktioniert ohne Konfiguration, es kann jedoch ein Konfigurationsabschnitt basebackup angegeben werden. Es gelten dieselben Regeln wie für die Konfiguration anderer Methoden: Dort sollten nur lange Optionen (mit –) angegeben werden. Patroni akzeptiert weder das Überschreiben der Verbindungseinstellungen noch Optionen für Backups im tar-Format oder mit clientseitiger Komprimierung. Ab PostgreSQL 15 wird serverseitige Komprimierung mit compress: server-gzip oder compress: server-zstd unterstützt. Patroni filtert von ihm selbst gesteuerte Optionen und andere Komprimierungseinstellungen als serverseitige Komprimierung heraus, führt aber keine vollständige Validierung aller Optionsnamen und -werte durch. Werden symbolische Links für das WAL-Verzeichnis verwendet, muss der Benutzer außerdem den richtigen Pfad für --waldir als Option angeben, damit der symbolische Link nach dem Aufbau oder der Neuinitialisierung des Replikats erhalten bleibt. Diese Option wird allerdings erst seit v10 unterstützt.
Die basebackup-Parameter können entweder als Zuordnung (Schlüssel-Wert-Paare) oder als Liste angegeben werden. Jedes Listenelement kann ein Schlüssel-Wert-Paar oder ein einzelner Schlüssel sein (für Optionen ohne Wert, etwa --verbose). Die folgenden 2 Beispiele zeigen beide Formen:
und
Schlagen alle Methoden zur Replikaterstellung fehl, versucht Patroni im nächsten Durchlauf der Ereignisschleife erneut alle Methoden der Reihe nach.
7 - Replikationsmodi
Patroni verwendet die Streaming-Replikation von PostgreSQL. Weitere Informationen dazu stehen in der Postgres-Dokumentation . Standardmäßig konfiguriert Patroni PostgreSQL für asynchrone Replikation. Die Wahl des Replikationsverfahrens hängt von den geschäftlichen Anforderungen ab. Sowohl asynchrone als auch synchrone Replikation sowie andere HA-Lösungen sollten geprüft werden, um die passende Lösung zu bestimmen.
Dauerhaftigkeit im asynchronen Modus
Im asynchronen Modus darf der Cluster einige bereits festgeschriebene Transaktionen verlieren, um die Verfügbarkeit zu gewährleisten. Fällt der Primärserver aus oder wird er aus einem anderen Grund unerreichbar, stuft Patroni automatisch einen hinreichend funktionsfähigen Standby zum Primärserver hoch. Alle Transaktionen, die noch nicht auf diesen Standby repliziert wurden, verbleiben auf dem bisherigen Primärserver in einer „abgezweigten Zeitleiste“ und sind praktisch nicht wiederherstellbar1.
Die Menge der potenziell verlorenen Transaktionen wird durch den Parameter maximum_lag_on_failover gesteuert. Da die Position im Transaktionsprotokoll des Primärservers nicht in Echtzeit erfasst wird, ist der tatsächliche Datenverlust bei einem Failover im schlimmsten Fall auf maximum_lag_on_failover Bytes des Transaktionsprotokolls zuzüglich der in den letzten ttl Sekunden geschriebenen Daten begrenzt (im Durchschnitt loop_wait/2 Sekunden). Im normalen, stabilen Betrieb liegt die Replikationsverzögerung jedoch typischerweise deutlich unter einer Sekunde.
Standardmäßig berücksichtigt Patroni bei Leader-Wahlen nicht die aktuelle Zeitleiste der Replikate, was in manchen Fällen unerwünscht sein kann. Wird check_timeline auf true gesetzt, kann ein Knoten mit einer älteren Zeitleiste als der zuletzt bekannten Cluster-Zeitleiste oder mit einer nicht bestimmbaren Zeitleiste nicht neuer Leader werden.
Synchrone Replikation von PostgreSQL
Die synchrone Replikation von Postgres kann mit Patroni verwendet werden. Sie gewährleistet die Konsistenz im Cluster, indem sie bestätigt, dass Schreibvorgänge auf einem Sekundärserver gespeichert wurden, bevor dem verbundenen Client Erfolg gemeldet wird. Der Preis dafür sind höhere Latenzen und ein geringerer Schreibdurchsatz. Dieser Durchsatz wird von der Netzwerkleistung beeinflusst.
In gehosteten Rechenzentrumsumgebungen (wie AWS, Rackspace oder jedem Netzwerk außerhalb der eigenen Kontrolle) erhöht synchrone Replikation die Schwankungen der Schreibleistung erheblich. Kann der Leader seine Follower nicht mehr erreichen, wird er faktisch schreibgeschützt.
Für einen einfachen Test der synchronen Replikation folgende Zeilen zum Abschnitt parameters der YAML-Konfigurationsdateien hinzufügen:
Bei synchroner PostgreSQL-Replikation mindestens drei Postgres-Datenknoten verwenden, um die Schreibverfügbarkeit beim Ausfall eines Hosts zu gewährleisten.
Synchrone PostgreSQL-Replikation garantiert nicht unter allen Umständen, dass keine Transaktionen verloren gehen. Fallen der Primärserver und der derzeit als synchrones Replikat dienende Sekundärserver gleichzeitig aus, wird ein dritter Knoten hochgestuft, der möglicherweise nicht alle Transaktionen enthält.
Synchroner Modus
Darf eine Anwendung keine festgeschriebenen Transaktionen verlieren, kann der synchronous_mode von Patroni aktiviert werden. Bei aktiviertem synchronous_mode stuft Patroni einen Standby nur dann hoch, wenn sicher ist, dass er alle Transaktionen enthält, deren erfolgreiches Festschreiben dem Client möglicherweise bereits bestätigt wurde2. Das bedeutet, dass das System für Schreibzugriffe unverfügbar sein kann, obwohl einige Server erreichbar sind. Systemadministratoren können weiterhin manuelle Failover-Befehle verwenden, um einen Standby hochzustufen, auch wenn dadurch Transaktionen verloren gehen.
Das Aktivieren von synchronous_mode garantiert nicht unter allen Umständen, dass Commits auf mehreren Knoten dauerhaft gespeichert werden. Ist kein geeigneter Standby verfügbar, nimmt der Primärserver weiterhin Schreibvorgänge an, garantiert aber deren Replikation nicht. Fällt der Primärserver in diesem Modus aus, wird kein Standby hochgestuft. Sobald der bisherige Primärhost zurückkehrt, wird er automatisch hochgestuft, sofern kein Systemadministrator ein manuelles Failover durchgeführt hat. Durch dieses Verhalten ist der synchrone Modus auch für Cluster mit 2 Knoten geeignet.
Ist synchronous_mode
aktiviert, der strikte Modus deaktiviert und stürzt der einzige synchrone Standby ab, blockieren Commits, bis der nächste Patroni-Durchlauf den Primärserver in den Einzelbetrieb versetzt (Schreibverzögerung im schlimmsten Fall ttl Sekunden, im Durchschnitt loop_wait/2 Sekunden). Ein manuelles Herunterfahren oder Neustarten eines Standbys unterbricht die Commit-Verarbeitung nicht. Vor dem Herunterfahren von PostgreSQL signalisiert der Standby dem Primärserver, ihn von seiner Aufgabe als synchroner Standby zu entbinden.
Muss unbedingt gewährleistet sein, dass jeder Schreibvorgang auf mindestens zwei Knoten dauerhaft gespeichert wird, zusätzlich zu synchronous_mode
die Option synchronous_mode_strict aktivieren. Dieser Parameter verhindert, dass Patroni die synchrone Replikation auf dem Primärserver deaktiviert, wenn keine Kandidaten für einen synchronen Standby verfügbar sind. Synchrone Commits blockieren, bis ein synchrones Replikat verfügbar ist; Transaktionen mit den synchronous_commit-Werten off oder local umgehen diese Wartezeit.
Im prioritätsbasierten synchronen Modus (synchronous_mode: on) setzt Patroni 4.1.5 bei aktiviertem striktem Modus synchronous_standby_names auf *, wenn kein geeigneter synchroner Standby verfügbar ist, und gibt die Warnung "No standbys available!" aus. Commits warten dadurch weiterhin auf einen synchronen Standby. Der Platzhalter beschränkt Bestätigungen nicht auf die zuvor in /sync gespeicherten Mitgliedsnamen.
Ist das Tag nosync auf true gesetzt, schließt Patroni den Standby von seiner Auswahl synchroner Standbys aus. Dies wird für Standbys mit langsamer Netzwerkverbindung empfohlen, die als synchrone Standbys die Leistung beeinträchtigen würden. Das Tag nostream auf true zu setzen, hat dieselbe Wirkung.
Der synchrone Modus lässt sich mit patronictl edit-config oder über die REST-Schnittstelle von Patroni ein- und ausschalten. Eine Anleitung steht unter Dynamische Konfiguration
.
Hinweis: Aufgrund der Implementierung der synchronen Replikation in PostgreSQL können auch mit synchronous_mode_strict Transaktionen verloren gehen. Wird ein PostgreSQL-Backend abgebrochen, während es auf die Bestätigung der Replikation wartet (durch ein Abbruchpaket infolge einer clientseitigen Zeitüberschreitung oder durch einen Backend-Ausfall), werden die Transaktionsänderungen für andere Backends sichtbar. Diese Änderungen sind noch nicht repliziert und können bei der Hochstufung eines Standbys verloren gehen.
Synchroner Replikationsfaktor
Mit dem Parameter synchronous_node_count verwaltet Patroni die Anzahl synchroner Standby-Datenbanken. Sein Standardwert ist 1. Ist synchronous_mode
auf off gesetzt, hat er keine Wirkung. Bei aktiviertem Modus steuert Patroni die genaue Anzahl synchroner Standby-Datenbanken anhand von synchronous_node_count und passt beim Hinzukommen und Ausscheiden von Mitgliedern sowohl den Zustand im DCS als auch synchronous_standby_names in PostgreSQL an. Sind weniger geeignete Knoten verfügbar, kann Patroni weniger synchrone Standbys als angefordert verwenden; im strikten Quorum-Modus warten Commits jedoch weiterhin auf die konfigurierte Anzahl von Standby-Bestätigungen.
Maximaler Rückstand eines synchronen Knotens
Standardmäßig hält Patroni an Knoten fest, die laut Sicht pg_stat_replication als synchronous gelten, selbst wenn andere Knoten weiter fortgeschritten sind. Dadurch wird die Anzahl der Änderungen an synchronous_standby_names minimiert. Dieses Verhalten lässt sich mit maximum_lag_on_syncnode ändern. Der Parameter steuert, wie weit ein Replikat zurückliegen darf, um noch als „synchron“ zu gelten.
Bei mehr als einem Standby verwendet Patroni die höchste Replikat-LSN, andernfalls die aktuelle WAL-LSN des Leaders. Der Standardwert ist -1; bei einem Wert von 0 oder weniger unternimmt Patroni nichts, um einen beeinträchtigten synchronen Standby auszutauschen. Den Wert ausreichend hoch wählen, damit Patroni synchrone Standbys bei hohem Transaktionsaufkommen nicht zu häufig austauscht.
Implementierung des synchronen Modus
Im synchronen Modus verwaltet Patroni den Synchronisationszustand im DCS (Schlüssel /sync). Er enthält den zuletzt bekannten Primärserver und die aktuellen synchronen Standby-Datenbanken. Für Aktualisierungen gelten strenge Reihenfolgevorgaben, um folgende Invarianten zu gewährleisten:
- Ein Knoten muss immer dann als letzter Leader gekennzeichnet sein, wenn er Schreibtransaktionen annehmen kann. Ein Absturz von Patroni oder ein nicht herunterfahrendes PostgreSQL kann diese Invariante verletzen.
- Solange ein Knoten im DCS-Schlüssel
/syncals synchroner Standby veröffentlicht ist, muss er in PostgreSQL als synchroner Standby eingestellt sein. - Ein Knoten, der weder Leader noch aktueller synchroner Standby ist, darf sich nicht automatisch hochstufen.
Bei einer nicht leeren Menge synchroner Standbys weist Patroni synchronous_standby_names einen oder mehrere synchrone Standby-Knoten gemäß synchronous_node_count zu.
Bei jedem Durchlauf der HA-Schleife bewertet Patroni die Auswahl der synchronen Standby-Knoten neu. Sind die aktuell aufgeführten synchronen Standby-Knoten verbunden und haben sie nicht darum gebeten, ihren synchronen Status aufzuheben, bleiben sie ausgewählt. Andernfalls werden die für synchrone Replikation verfügbaren Clustermitglieder ausgewählt, die bei der Replikation am weitesten fortgeschritten sind.
Beispiel:
Schlüssel /config im DCS
Schlüssel /sync im DCS
postgresql.conf
Im obigen Beispiel gelten nur node1 und node2 als nachweislich synchron. Nur sie dürfen automatisch hochgestuft werden, wenn der Primärserver (node0) ausfällt.
Quorum-Commit-Modus
Ab PostgreSQL v10 unterstützt Patroni Quorum-basierte synchrone Replikation.
In diesem Modus verwaltet Patroni den Synchronisationszustand im DCS. Er enthält den zuletzt bekannten Primärserver, die für ein Quorum erforderliche Knotenzahl und die derzeit zur Quorum-Abstimmung berechtigten Knoten. Im stabilen Zustand stimmen der Leader und alle synchronen Standbys ab. Bei Aktualisierungen gelten strenge Reihenfolgevorgaben bezüglich Knotenhochstufung und synchronous_standby_names. So enthält zu jedem Zeitpunkt jede Teilmenge der Stimmberechtigten, die ein Quorum erreichen kann, mindestens einen Knoten mit dem letzten erfolgreichen Commit.
Bei jedem Durchlauf der HA-Schleife bewertet Patroni anhand der Knotenverfügbarkeit und der gewünschten Clusterkonfiguration die Auswahl synchroner Standbys sowie das Quorum neu. In PostgreSQL-Versionen nach 9.6 werden alle geeigneten Knoten als synchrone Standbys hinzugefügt, sobald ihre Replikation den Leader eingeholt hat.
Quorum-Commit hilft, die Latenzen im ungünstigsten Fall selbst im Normalbetrieb zu verringern, da andere Standbys eine höhere Replikationslatenz zu einem einzelnen Standby ausgleichen können.
Der Quorum-basierte synchrone Modus lässt sich aktivieren, indem synchronous_mode
mit patronictl edit-config oder über die REST-Schnittstelle von Patroni auf quorum gesetzt wird. Eine Anleitung steht unter Dynamische Konfiguration
.
Andere Parameter wie synchronous_node_count, maximum_lag_on_syncnode und synchronous_mode_strict funktionieren weiterhin wie bei synchronous_mode=on.
Ist im Quorum-Commit-Modus die Menge synchroner Standbys leer und erfordert der strikte Modus Bestätigungen von N Standbys, setzt Patroni 4.1.5 synchronous_standby_names auf ANY N (*).
Beispiel:
Schlüssel /config im DCS
Schlüssel /sync im DCS
postgresql.conf
Fällt der Primärserver (node0) im obigen Beispiel aus, haben zwei der Knoten node1, node2, node3 die letzte Transaktion empfangen; es ist jedoch unbekannt, welche. Um festzustellen, ob node1 die letzte Transaktion empfangen hat, muss seine LSN mit der LSN mindestens eines Knotens (quorum=1 im Schlüssel /sync) aus node2 und node3 verglichen werden. Liegt node1 gegenüber mindestens einem von ihnen nicht zurück, lässt sich garantieren, dass bei der Hochstufung von node1 kein für Benutzer sichtbarer Datenverlust auftritt.
-
Die Daten sind noch vorhanden, ihre Wiederherstellung erfordert aber manuelle Arbeit durch Spezialisten für Datenrettung. Darf Patroni mit
use_pg_rewindzurücksetzen, wird die abgezweigte Zeitleiste automatisch gelöscht, um den ausgefallenen Primärserver wieder in den Cluster aufzunehmen. Damituse_pg_rewindrichtig funktioniert, muss der Cluster mitdata page checksums(Option--data-checksumsfürinitdb) initialisiert worden sein und/oderwal_log_hintsmuss aufongesetzt sein. ↩︎ -
Clients können das Verhalten je Transaktion mit der PostgreSQL-Einstellung
synchronous_commitändern. Transaktionen mit densynchronous_commit-Wertenoffundlocalkönnen bei einem Failover verloren gehen, werden aber nicht durch Replikationsverzögerungen blockiert. ↩︎
8 - Standby-Cluster
Patroni unterstützt mit der Funktion „Standby-Cluster“ auch kaskadierende Replikation in ein entferntes Rechenzentrum (eine Region). Ein solcher Cluster besteht aus:
- einem „Standby-Leader“, der sich weitgehend wie ein normaler Cluster-Leader verhält, aber von einem entfernten Knoten repliziert.
- kaskadierenden Replikaten, die vom Standby-Leader replizieren.
Der Standby-Leader hält und aktualisiert eine Leader-Sperre im DCS. Läuft diese Sperre ab, wählen die kaskadierenden Replikate einen anderen Leader aus den Standbys.
Zwischen dem Standby-Cluster und dem Primärcluster, von dem er repliziert, besteht keine weitere Beziehung. Insbesondere dürfen sie nicht denselben DCS-Scope verwenden, wenn sie denselben DCS nutzen. Außer den Replikationsinformationen wissen sie nichts voneinander. Der Standby-Cluster erscheint außerdem nicht in der Ausgabe von patronictl_list oder patronictl_topology auf dem Primärcluster.
Für mehr Flexibilität lassen sich die Methoden zur Erstellung eines Replikats und zur Wiederherstellung von WAL-Einträgen im „Standby-Modus“ über den Schlüssel create_replica_methods
im Abschnitt standby_cluster
festlegen. Davon getrennt ist die Replikaterstellung, wenn der Cluster abgekoppelt ist und als normaler Cluster arbeitet: Sie wird durch create_replica_methods im Abschnitt postgresql gesteuert. Sowohl die „Standby“- als auch die „normalen“ create_replica_methods verweisen auf Schlüssel im Abschnitt postgresql.
Zur Konfiguration eines solchen Clusters muss in der Patroni-Konfiguration der Abschnitt standby_cluster angegeben werden:
Diese Optionen werden nur einmal während der Cluster-Initialisierung angewendet. Danach können sie ausschließlich über den DCS geändert werden.
Patroni erwartet postgresql.conf oder postgresql.conf.backup im PGDATA des entfernten Primärservers und startet nicht, wenn diese Datei nach einem Basisbackup fehlt. Liegt die postgresql.conf des entfernten Primärservers an einem anderen Ort, muss sie eigenständig nach PGDATA kopiert werden.
Werden Replikationsslots im Standby-Cluster verwendet, muss der entsprechende Replikationsslot auch im Primärcluster angelegt werden. Die Implementierung des Standby-Clusters erledigt dies nicht automatisch. Mit der Funktion für permanente Replikationsslots von Patroni kann im Primärcluster ein Replikationsslot verwaltet werden, dessen Name primary_slot_name entspricht – oder dessen Standardwert, falls primary_slot_name nicht angegeben ist.
Bietet der entfernte Standort keinen einzelnen Endpunkt für die Verbindung zum Primärserver, können alle Hosts des Quellclusters im Abschnitt standby_cluster.host aufgelistet werden. Enthält standby_cluster.host mehrere durch Kommas getrennte Hosts, führt Patroni Folgendes aus:
- Es ergänzt
primary_conninfoauf dem Standby-Leader umtarget_session_attrs=read-write. - Es verwendet
target_session_attrs=read-write, wenn geprüft wird, obpg_rewinderforderlich ist, oder wennpg_rewindauf allen Knoten des Standby-Clusters ausgeführt wird. - Damit
pg_rewinderfolgreich funktioniert, muss der Cluster mitdata page checksums(Option--data-checksumsfürinitdb) initialisiert worden sein und/oderwal_log_hintsmuss aufongesetzt sein. Andernfalls funktioniertpg_rewindnicht ordnungsgemäß.
Ein Standby-Cluster kann auch von einem anderen Standby-Cluster oder einem Standby-Mitglied des Primärclusters replizieren. Dafür muss im Abschnitt standby_cluster.host genau ein Host angegeben werden. Dabei ist jedoch zu beachten, dass pg_rewind in diesem Fall auf dem Standby-Cluster fehlschlägt.
Mitgliedsnamen (das Feld name in der Patroni-Konfiguration jedes Knotens) müssen im Primärcluster und in allen mit ihm verbundenen Standby-Clustern eindeutig sein.
Patroni setzt synchronous_standby_names auf dem Primärserver anhand der Mitgliedsnamen. Diese werden zugleich als application_name der jeweiligen Replikationsverbindung in pg_stat_replication verwendet. Hat ein Knoten eines Standby-Clusters denselben Namen wie ein Mitglied des Primärclusters, sieht PostgreSQL zwei Verbindungen mit identischen application_name-Werten. Durch diese Mehrdeutigkeit kann PostgreSQL die Anforderung an synchrone Replikation mit der Verbindung des Standby-Clusters statt mit der des vorgesehenen Primärcluster-Mitglieds erfüllen. PostgreSQL bestätigt Transaktionen dadurch vorzeitig als synchron festgeschrieben, obwohl sie auf dem richtigen Standby noch nicht dauerhaft gespeichert sind.
Dieser Fehler bleibt unbemerkt: Die Replikation läuft weiter und es werden keine Fehler protokolliert, doch der Cluster arbeitet faktisch ohne gültigen synchronen Standby. Fällt der Primärserver aus, droht Datenverlust.
9 - Watchdog-Unterstützung
Laufen mehrere PostgreSQL-Server gleichzeitig als Primärserver, können durch auseinanderlaufende Zeitleisten Transaktionen verloren gehen. Diese Situation wird auch als Split-Brain bezeichnet. Um sie zu vermeiden, muss Patroni sicherstellen, dass PostgreSQL nach Ablauf des Leader-Schlüssels im DCS keine Transaktions-Commits mehr annimmt. Unter normalen Umständen versucht Patroni dies zu erreichen, indem es PostgreSQL stoppt, sobald die Aktualisierung der Leader-Sperre aus irgendeinem Grund fehlschlägt. Dies kann jedoch aus verschiedenen Gründen scheitern:
- Patroni ist aufgrund eines Fehlers oder Speichermangels abgestürzt oder wurde versehentlich von einem Systemadministrator beendet.
- PostgreSQL fährt zu langsam herunter.
- Patroni kommt wegen hoher Systemlast, einer vom Hypervisor pausierten VM oder anderer Infrastrukturprobleme nicht zur Ausführung.
Um auch unter diesen Bedingungen korrektes Verhalten zu gewährleisten, unterstützt Patroni Watchdog-Geräte. Dies sind Software- oder Hardwaremechanismen, die das gesamte System zurücksetzen, wenn innerhalb eines bestimmten Zeitraums kein Keepalive-Heartbeat eintrifft. Sie bieten eine zusätzliche Absicherung, falls die üblichen Split-Brain-Schutzmechanismen von Patroni versagen.
Patroni versucht, den Watchdog vor der Hochstufung von PostgreSQL zum Primärserver zu aktivieren. Schlägt dies fehl und steht der Watchdog-Modus auf required, verweigert der Knoten die Leader-Rolle. Auch bei der Entscheidung über die Teilnahme an einer Leader-Wahl prüft Patroni, ob die Watchdog-Konfiguration die Leader-Rolle überhaupt zulässt. Nach der Herabstufung von PostgreSQL (etwa bei einem manuellen Failover) deaktiviert Patroni den Watchdog wieder. Ebenso wird der Watchdog deaktiviert, während Patroni pausiert ist.
Standardmäßig stellt Patroni den Watchdog so ein, dass er 5 Sekunden vor Ablauf der TTL auslöst. Mit den Standardwerten loop_wait=10 und ttl=30 hat die HA-Schleife dadurch mindestens 15 Sekunden (ttl - safety_margin - loop_wait) Zeit zum Abschluss, bevor das System zwangsweise zurückgesetzt wird. Für DCS-Zugriffe ist standardmäßig eine Zeitüberschreitung von 10 Sekunden konfiguriert. Ist der DCS beispielsweise wegen Netzwerkproblemen nicht verfügbar, bleiben Patroni und PostgreSQL damit mindestens 5 Sekunden (ttl - safety_margin - loop_wait - retry_timeout), um alle Clientverbindungen zu beenden.
Der Sicherheitsabstand ist die Zeit, die Patroni zwischen der Aktualisierung des Leader-Schlüssels und dem Keepalive für den Watchdog reserviert. Patroni versucht, unmittelbar nach Bestätigung der Aktualisierung des Leader-Schlüssels ein Keepalive zu senden. Wird der Patroni-Prozess genau im entscheidenden Moment längere Zeit angehalten, kann sich das Keepalive um mehr als den Sicherheitsabstand verzögern, ohne den Watchdog auszulösen. Dadurch entsteht ein Zeitfenster, in dem der Watchdog nicht vor Ablauf des Leader-Schlüssels auslöst und die Garantie somit nicht mehr gilt. Damit der Watchdog unter allen Umständen sicher auslöst, safety_margin auf -1 setzen. Dadurch beträgt die Watchdog-Frist ttl // 2, also die Hälfte der TTL. Wird diese Garantie benötigt, sollte wahrscheinlich ttl erhöht und/oder loop_wait sowie retry_timeout verringert werden.
Derzeit werden Watchdogs nur über die Linux-Watchdog-Geräteschnittstelle unterstützt.
Software-Watchdog unter Linux einrichten
Die Standardkonfiguration von Patroni versucht unter Linux, /dev/watchdog zu verwenden, sofern Patroni darauf zugreifen kann. Für die meisten Anwendungsfälle ist der im Linux-Kernel enthaltene Software-Watchdog ausreichend sicher.
Zum Aktivieren des Software-Watchdogs vor dem Start von Patroni folgende Befehle als root ausführen:
Für Tests kann es hilfreich sein, Neustarts durch das zusätzliche Argument soft_noboot=1 in der modprobe-Befehlszeile zu deaktivieren. Dann schreibt der Watchdog lediglich eine über dmesg sichtbare Zeile in den Kernel-Ringpuffer.
Nach erfolgreicher Aktivierung protokolliert Patroni Informationen über den Watchdog.
10 - Cluster-Verwaltung pausieren und fortsetzen
Ziel
Unter bestimmten Umständen muss Patroni die Verwaltung des Clusters vorübergehend aussetzen, den Clusterzustand aber weiterhin im DCS speichern. Mögliche Anwendungsfälle sind seltene Eingriffe wie Hauptversionsupgrades oder die Wiederherstellung nach Datenbeschädigungen. Dabei werden Knoten häufig aus Gründen gestartet und gestoppt, die Patroni nicht kennt. Einige Knoten werden möglicherweise sogar vorübergehend hochgestuft, wodurch die Annahme verletzt wird, dass nur ein Primärserver läuft. Patroni muss sich daher vom laufenden Cluster „abkoppeln“ können und eine Entsprechung zum Wartungsmodus von Pacemaker bereitstellen.
Implementierung
Im pausierten Modus ändert Patroni den Zustand von PostgreSQL nicht, mit folgenden Ausnahmen:
- Für jeden Knoten wird der Mitgliedsschlüssel im DCS mit den aktuellen Clusterinformationen aktualisiert. Dazu führt Patroni auf einem laufenden Mitgliedsknoten schreibgeschützte Abfragen aus.
- Für den Postgres-Primärserver mit der Leader-Sperre aktualisiert Patroni diese Sperre. Ist der Knoten mit der Leader-Sperre kein Primärserver mehr (d. h. nach einer manuellen Herabstufung), gibt Patroni die Sperre frei, statt den Knoten wieder hochzustufen.
- Manuelle, nicht zeitgesteuerte Neustarts, Failover/Switchover und Neuinitialisierungen sind erlaubt. Zeitgesteuerte Aktionen sind nicht erlaubt. Ein manuelles Switchover ist nur erlaubt, wenn der Zielknoten angegeben wird.
- Erkennt Patroni „parallele“ Primärserver, gibt es eine Warnung aus, stuft den Primärserver ohne Leader-Sperre jedoch nicht herab.
- Gibt es im Cluster keine Leader-Sperre, erlangt der laufende Primärserver die Sperre. Gibt es mehrere Primärserver, gewinnt der erste, der die Sperre erlangt. Gibt es überhaupt keinen Primärserver, versucht Patroni nicht, Replikate hochzustufen. Von dieser Regel gibt es eine Ausnahme: Fehlt die Leader-Sperre, weil sich der bisherige Primärserver infolge einer manuellen Hochstufung selbst herabgestuft hat, darf nur der in der Hochstufungsanfrage genannte Kandidat die Leader-Sperre übernehmen. Wird die neue Leader-Sperre vergeben (d. h. nach der manuellen Hochstufung eines Replikats), stellt Patroni sicher, dass Replikate, die zuvor vom bisherigen Leader gestreamt haben, auf den neuen wechseln.
- Ist Postgres gestoppt, versucht Patroni nicht, es zu starten. Wird Patroni gestoppt, versucht es nicht, die von ihm verwaltete Postgres-Instanz zu stoppen.
- Patroni versucht nicht, Replikationsslots zu entfernen, die weder ein anderes Clustermitglied repräsentieren noch in der Konfiguration der permanenten Slots aufgeführt sind.
Benutzerhandbuch
patronictl unterstützt die Befehle pause und resume .
Es kann auch eine PATCH /config-Anfrage mit {"pause": true/false/null} an die REST-API von Patroni gesendet werden, um den Schlüssel {namespace}/{cluster}/config im DCS zu aktualisieren.
11 - DCS-Failsafe-Modus
Das Problem
Patroni stützt sich bei der Leader-Wahl und der Erkennung von Netzwerkpartitionen stark auf den verteilten Konfigurationsspeicher (DCS). Ein Knoten darf Postgres also nur dann als Primärserver betreiben, wenn er die Leader-Sperre im DCS aktualisieren kann. Schlägt diese Aktualisierung fehl, wird Postgres sofort herabgestuft und schreibgeschützt gestartet. Wie wahrscheinlich dieses „Problem“ auftritt, hängt vom verwendeten DCS ab. Bei etcd, das ausschließlich für Patroni genutzt wird, ist die Wahrscheinlichkeit beispielsweise nahezu null; bei der K8s-API (mit etcd als Speicher) kann es häufiger auftreten.
Gründe für die aktuelle Implementierung
Eine Aktualisierung der Leader-Sperre kann hauptsächlich aus zwei Gründen fehlschlagen:
- Netzwerkpartitionierung
- Ausfall des DCS
Im Allgemeinen kann ein einzelner Knoten diese beiden Fälle nicht unterscheiden. Deshalb nimmt Patroni den schlimmsten Fall an: eine Netzwerkpartitionierung. Bei einem partitionierten Netzwerk können andere Knoten des Patroni-Clusters die Leader-Sperre erfolgreich übernehmen und Postgres zum Primärserver hochstufen. Um Split-Brain zu vermeiden, wird der bisherige Primärserver herabgestuft, bevor die Leader-Sperre abläuft.
DCS-Failsafe-Modus
Dafür wird die neue spezielle Option failsafe_mode eingeführt. Sie kann nur über die globale dynamische Konfiguration
aktiviert werden, die im DCS-Schlüssel /config gespeichert ist. Wenn der Failsafe-Modus aktiviert ist und die Aktualisierung der Leader-Sperre im DCS aus einem anderen Grund als einer Abweichung bei Version, Wert oder Index fehlschlägt, kann Postgres weiter als Primärserver laufen, sofern es alle bekannten Clustermitglieder über die REST-API von Patroni erreichen kann.
Implementierungsdetails
- Im DCS wird ein neuer, dauerhafter Schlüssel namens
/failsafeeingeführt. - Der Schlüssel
/failsafeenthält alle zu einem bestimmten Zeitpunkt bekannten Mitglieder des jeweiligen Patroni-Clusters. - Der aktuelle Leader verwaltet den Schlüssel
/failsafe. - Ein Mitglied darf nur dann an der Leader-Wahl teilnehmen und neuer Leader werden, wenn es im Schlüssel
/failsafeenthalten ist. - Besteht der Cluster aus einem einzigen Knoten, enthält der Schlüssel
/failsafeein einziges Mitglied. - Bei einem DCS-Ausfall kontaktiert der bestehende Primärserver alle im Schlüssel
/failsafeaufgeführten Mitglieder über die REST-APIPOST /failsafe. Er kann weiter als Primärserver laufen, wenn alle Replikate dies bestätigen. - Antwortet eines der Mitglieder nicht, wird der Primärserver herabgestuft.
- Replikate werten eingehende REST-API-Anfragen an
POST /failsafeals Zeichen dafür, dass der Primärserver noch aktiv ist. Diese Information wird fürttlSekunden zwischengespeichert.
Häufig gestellte Fragen
-
Warum MUSS der aktuelle Primärserver ALLE anderen Mitglieder erreichen? Können wir uns hier nicht auf ein Quorum verlassen?
Das ist eine gute Frage! Das Problem ist, dass DCS und Patroni unterschiedliche Sichtweisen auf das Quorum haben können. DCS-Knoten müssen gleichmäßig über die Verfügbarkeitszonen verteilt sein; für Patroni gibt es keine solche Regel und vor allem keinen Mechanismus, um sie einzuführen und durchzusetzen. Befindet sich die Mehrheit der Patroni-Knoten einschließlich des Primärservers im unterlegenen Teil des partitionierten Netzwerks und die Minderheit im siegreichen Teil, muss der Primärserver herabgestuft werden. Nur durch die Prüfung ALLER anderen Mitglieder lässt sich diese Situation erkennen.
-
Was geschieht, wenn ein Knoten oder Pod beendet wird, während der DCS ausgefallen ist?
Ist der DCS nicht erreichbar, wird in jedem Durchlauf der Heartbeat-Schleife (alle
loop_waitSekunden) geprüft, ob ALLE anderen Clustermitglieder erreichbar sind. Wird ein Pod oder Knoten beendet, schlägt diese Prüfung fehl und Postgres wird in den schreibgeschützten Zustand herabgestuft. Es kehrt erst dann zum normalen Betrieb zurück, wenn der DCS wiederhergestellt ist. -
Was geschieht, wenn alle Mitglieder des Patroni-Clusters verloren gehen, während der DCS ausgefallen ist?
Patroni kann so konfiguriert werden, dass es ein neues Replikat aus einem Backup erstellt, auch wenn der Cluster keinen Leader hat. Ist das neue Mitglied jedoch nicht im Schlüssel
/failsafeenthalten, kann es weder die Leader-Sperre übernehmen noch hochgestuft werden. -
Was geschieht, wenn der Primärserver den Zugriff auf den DCS verliert, die Replikate aber nicht?
Der Primärserver führt den Failsafe-Code aus und kontaktiert alle bekannten Replikate. Diese werten die Information als Zeichen dafür, dass der Primärserver aktiv ist, und starten auch dann keine Leader-Wahl, wenn die Leader-Sperre im DCS abgelaufen ist.
-
Wie wird der Failsafe-Modus aktiviert?
Vor der Aktivierung von
failsafe_modesicherstellen, dass die Patroni-Version auf allen Mitgliedern aktuell ist. Anschließend kann entweder die REST-APIPATCH /configoder patronictl edit-config -s failsafe_mode=true verwendet werden.
12 - Patroni mit Kubernetes verwenden
Patroni kann Kubernetes-Objekte verwenden, um den Clusterzustand zu speichern und den Leader-Schlüssel zu verwalten. Damit kann Postgres in einer Kubernetes-Umgebung ohne zusätzlichen Konsistenzspeicher betrieben werden; insbesondere ist keine zusätzliche etcd-Installation nötig. Patroni kann zwei verschiedene Arten von Kubernetes-Objekten zum Speichern der Leader- und Konfigurationsschlüssel verwenden. Die Auswahl erfolgt über kubernetes.use_endpoints oder die Umgebungsvariable PATRONI_KUBERNETES_USE_ENDPOINTS.
Endpoints verwenden
Obwohl dieser Modus empfohlen wird, ist er aus Kompatibilitätsgründen standardmäßig deaktiviert. Ist er aktiviert, speichert Patroni die Clusterkonfiguration und den Leader-Schlüssel in den Feldern metadata: annotations der jeweils angelegten Endpoints. Der Wechsel des Leaders ist sicherer als mit ConfigMaps, weil sowohl die Annotationen mit den Leader-Informationen als auch die tatsächlichen Adressen des laufenden Leader-Pods gleichzeitig in einem Schritt aktualisiert werden.
ConfigMaps verwenden
In diesem Modus erstellt Patroni ConfigMaps anstelle von Endpoints und speichert die Schlüssel in deren Metadaten. Der Wechsel des Leaders erfordert mindestens zwei Aktualisierungen: eine für die Leader-ConfigMap und eine weitere für den jeweiligen Endpoint.
Um den Datenverkehr zum Postgres-Leader zu leiten, muss der Kubernetes-Service für Postgres einen Label-Selektor mit dem in der Patroni-Konfiguration festgelegten role_label verwenden.
In einigen Fällen, etwa unter OpenShift, gibt es keine Alternative zu ConfigMaps.
Konfiguration
Die Kubernetes-Einstellungen und -Umgebungsvariablen von Patroni werden in den allgemeinen Kapiteln der Dokumentation beschrieben.
Rollen-Label anpassen
Standardmäßig setzt Patroni auf dem Pod, in dem es läuft, zur Rolle des Knotens passende Labels, beispielsweise role=primary. Schlüssel und Wert des Labels lassen sich mit kubernetes.role_label, kubernetes.leader_label_value, kubernetes.follower_label_value und kubernetes.standby_leader_label_value anpassen.
Beim Wechsel von den standardmäßigen Rollen-Labels zu eigenen Labels lässt sich die Ausfallzeit mit folgenden Migrationsschritten verringern:
- Dem Pod mit
kubernetes.tmp_role_labelein temporäres Label (etwatmp_role) hinzufügen, das den ursprünglichen Rollenwert verwendet. Nach dem Neustart der Pods setzt Patroni folgende Labels:
- Nachdem alle Pods aktualisiert wurden, den Service-Selektor auf das temporäre Label umstellen.
- Das eigene Rollen-Label hinzufügen (z. B.
kubernetes.leader_label_value=leadersetzen). Nach dem Neustart der Pods setzt Patroni folgende neue Labels:
- Nachdem alle Pods erneut aktualisiert wurden, den Service-Selektor auf den neuen Rollenwert umstellen.
- Abschließend das temporäre Label aus der Konfiguration entfernen und alle Pods aktualisieren.
Beispiele
- Der Ordner kubernetes im Patroni-Repository enthält Beispiele für das Docker-Image und das Kubernetes-Manifest zum Testen einer Patroni-Installation mit Kubernetes. Im aktuellen Zustand können wegen Berechtigungsproblemen keine PersistentVolumes verwendet werden.
- Ein voll ausgestattetes Docker-Image mit Unterstützung für Persistent Volumes bietet das Spilo-Projekt .
- Es gibt außerdem ein Helm-Chart zur Bereitstellung des Spilo-Images mit Patroni unter Kubernetes.
- Für den Betrieb vieler Datenbankcluster mit Patroni und Spilo bietet sich das Projekt postgres-operator an. Es implementiert das Operator-Muster zur Verwaltung von Spilo-Clustern.
13 - Citus-Unterstützung
Patroni vereinfacht die Bereitstellung von Citus-Clustern mit mehreren Knoten erheblich.
Kurzüberblick (TL;DR)
Es müssen nur wenige einfache Regeln beachtet werden:
- Die PostgreSQL-Datenbankerweiterung Citus muss auf allen Knoten verfügbar sein. Die älteste unterstützte Citus-Version ist 10.0. Um alle Vorteile transparenter Switchover und Worker-Neustarts zu nutzen, wird jedoch mindestens Citus 11.2 empfohlen.
- Der Cluster-Name (
scope) muss auf allen Citus-Knoten identisch sein! - Die Superuser-Zugangsdaten müssen auf dem Koordinator und allen Worker-Knoten identisch sein, und
pg_hba.confsollte den Superuser-Zugriff zwischen allen Knoten erlauben. - Der Zugriff auf die REST API des Koordinators sollte von den Worker-Knoten aus erlaubt sein. Beispielsweise sollten die Zugangsdaten identisch sein, und sofern Client-Zertifikate konfiguriert sind, muss der Koordinator die Zertifikate der Worker-Knoten akzeptieren.
- Den folgenden Abschnitt zu
patroni.yamlhinzufügen:
Anschließend muss nur noch Patroni gestartet werden; es übernimmt den Rest:
- Patroni setzt
bootstrap.dcs.synchronous_modeauf quorum , sofern nicht ausdrücklich ein anderer Wert festgelegt ist. - Die Erweiterung citus
wird automatisch zu
shared_preload_librarieshinzugefügt. - Wenn
max_prepared_transactionsin der globalen dynamischen Konfiguration nicht ausdrücklich gesetzt ist, setzt Patroni den Wert automatisch auf2*max_connections. - Der GUC-Wert
citus.local_hostnamewird vonlocalhostauf den Wert geändert, den Patroni für die Verbindung zur lokalen PostgreSQL-Instanz verwendet. Dieser Wert sollte in manchen Fällen vonlocalhostabweichen, da PostgreSQL dort möglicherweise nicht lauscht. - Die mit
citus.databaseangegebene Datenbank wird automatisch erstellt; anschließend wirdCREATE EXTENSION citusausgeführt. - Die aktuellen Superuser-Zugangsdaten
werden zur Tabelle
pg_dist_authinfohinzugefügt, um die Kommunikation zwischen Knoten zu ermöglichen. Diese Daten müssen ebenfalls aktualisiert werden, wenn später username/password/sslcert/sslkey des Superusers geändert werden! - Der Primärserver des Koordinators erkennt die Primärserver der Worker automatisch und fügt sie mit der Funktion
citus_add_node()zur Tabellepg_dist_nodehinzu. - Patroni pflegt
pg_dist_nodeauch dann, wenn auf dem Koordinator- oder einem Worker-Cluster ein Failover oder Switchover erfolgt.
patronictl
Koordinator- und Worker-Cluster sind physisch getrennte PostgreSQL-/Patroni-Cluster, die lediglich mithilfe der PostgreSQL-Datenbankerweiterung Citus logisch zusammengefasst werden. Daher lassen sie sich in den meisten Fällen nicht als eine einzige Einheit verwalten.
Im Verhalten von patronictl
ergeben sich zwei wesentliche Unterschiede zum üblichen Verhalten, wenn patroni.yaml den Abschnitt citus
enthält:
listundtopologygeben standardmäßig alle Mitglieder des Citus-Verbunds aus (Koordinatoren und Worker). Die neue SpalteGroupzeigt an, zu welcher Citus-Gruppe sie gehören.- Für alle Befehle von patronictl
gibt es die neue Option
--group. Bei einigen Befehlen kann der Standardwert für die Gruppe auspatroni.yamlübernommen werden. Beispielsweise aktiviertpatronictl pauseden Wartungsmodus standardmäßig für diegroup, die im Abschnitt citus festgelegt ist. Beipatronictl switchoveroderpatronictl removemuss die Gruppe hingegen ausdrücklich angegeben werden.
Beispiel einer Ausgabe von patronictl list
für einen Citus-Cluster:
postgres@coord1:~$ patronictl list demo
+ Citus cluster: demo ----------+----------------+---------+----+-------------+-----+------------+-----+
| Group | Member  | Host        | Role           | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+-------+---------+-------------+----------------+---------+----+-------------+-----+------------+-----+
|     0 | coord1  | 172.27.0.10 | Replica        | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
|     0 | coord2  | 172.27.0.6  | Quorum Standby | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
|     0 | coord3  | 172.27.0.4  | Leader         | running |  1 |             |     |            |     |
|     1 | work1-1 | 172.27.0.8  | Quorum Standby | running |  1 |   0/31D3198 |   0 |  0/31D3198 |   0 |
|     1 | work1-2 | 172.27.0.2  | Leader         | running |  1 |             |     |            |     |
|     2 | work2-1 | 172.27.0.5  | Quorum Standby | running |  1 |   0/31CDFC0 |   0 |  0/31CDFC0 |   0 |
|     2 | work2-2 | 172.27.0.7  | Leader         | running |  1 |             |     |            |     |
+-------+---------+-------------+----------------+---------+----+-------------+-----+------------+-----+
Mit der zusätzlichen Option --group ändert sich die Ausgabe wie folgt:
postgres@coord1:~$ patronictl list demo --group 0
+ Citus cluster: demo (group: 0, 7179854923829112860) -+-------------+-----+------------+-----+
| Member | Host        | Role           | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+--------+-------------+----------------+---------+----+-------------+-----+------------+-----+
| coord1 | 172.27.0.10 | Replica        | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
| coord2 | 172.27.0.6  | Quorum Standby | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
| coord3 | 172.27.0.4  | Leader         | running |  1 |             |     |            |     |
+--------+-------------+----------------+---------+----+-------------+-----+------------+-----+

postgres@coord1:~$ patronictl list demo --group 1
+ Citus cluster: demo (group: 1, 7179854923881963547) -+-------------+-----+------------+-----+
| Member  | Host       | Role           | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------+------------+----------------+---------+----+-------------+-----+------------+-----+
| work1-1 | 172.27.0.8 | Quorum Standby | running |  1 |   0/31D3198 |   0 |  0/31D3198 |   0 |
| work1-2 | 172.27.0.2 | Leader         | running |  1 |             |     |            |     |
+---------+------------+----------------+---------+----+-------------+-----+------------+-----+
Switchover eines Citus-Workers
Bei einem Switchover eines Citus-Worker-Knotens bietet Citus die Möglichkeit, diesen für die Anwendung nahezu transparent durchzuführen. Da sich die Anwendung mit dem Koordinator verbindet, der wiederum Verbindungen zu den Worker-Knoten herstellt, kann Citus den SQL-Datenverkehr auf dem Koordinator für die Shards eines Worker-Knotens pausieren. Der Switchover erfolgt dann, während der Datenverkehr auf dem Koordinator zurückgehalten wird. Der Datenverkehr wird fortgesetzt, sobald ein neuer Primärserver des Workers bereit ist, lesende und schreibende Abfragen anzunehmen.
Beispiel für patronictl switchover
auf einem Worker-Cluster:
postgres@coord1:~$ patronictl switchover demo
+ Citus cluster: demo ----------+----------------+---------+----+-------------+-----+------------+-----+
| Group | Member  | Host        | Role           | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+-------+---------+-------------+----------------+---------+----+-------------+-----+------------+-----+
|     0 | coord1  | 172.27.0.10 | Replica        | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
|     0 | coord2  | 172.27.0.6  | Quorum Standby | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
|     0 | coord3  | 172.27.0.4  | Leader         | running |  1 |             |     |            |     |
|     1 | work1-1 | 172.27.0.8  | Leader         | running |  1 |             |     |            |     |
|     1 | work1-2 | 172.27.0.2  | Quorum Standby | running |  1 |   0/31D3198 |   0 |  0/31D3198 |   0 |
|     2 | work2-1 | 172.27.0.5  | Quorum Standby | running |  1 |   0/31CDFC0 |   0 |  0/31CDFC0 |   0 |
|     2 | work2-2 | 172.27.0.7  | Leader         | running |  1 |             |     |            |     |
+-------+---------+-------------+----------------+---------+----+-------------+-----+------------+-----+
Citus group: 2
Primary [work2-2]:
Candidate ['work2-1'] []:
When should the switchover take place (e.g. 2024-08-26T08:02 )  [now]:
Current cluster topology
+ Citus cluster: demo (group: 2, 7179854924063375386) -+-------------+-----+------------+-----+
| Member  | Host       | Role           | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+---------+------------+----------------+---------+----+-------------+-----+------------+-----+
| work2-1 | 172.27.0.5 | Quorum Standby | running |  1 |   0/31CDFC0 |   0 |  0/31CDFC0 |   0 |
| work2-2 | 172.27.0.7 | Leader         | running |  1 |             |     |            |     |
+---------+------------+----------------+---------+----+-------------+-----+------------+-----+
Are you sure you want to switchover cluster demo, demoting current primary work2-2? [y/N]: y
2024-08-26 07:02:40.33003 Successfully switched over to "work2-1"
+ Citus cluster: demo (group: 2, 7179854924063375386) --------+---------+------------+---------+
| Member  | Host       | Role    | State   | TL | Receive LSN |     Lag | Replay LSN |     Lag |
+---------+------------+---------+---------+----+-------------+---------+------------+---------+
| work2-1 | 172.27.0.5 | Leader  | running |  1 |             |         |            |         |
| work2-2 | 172.27.0.7 | Replica | stopped |    |     unknown | unknown |    unknown | unknown |
+---------+------------+---------+---------+----+-------------+---------+------------+---------+

postgres@coord1:~$ patronictl list demo
+ Citus cluster: demo ----------+----------------+---------+----+-------------+-----+------------+-----+
| Group | Member  | Host        | Role           | State   | TL | Receive LSN | Lag | Replay LSN | Lag |
+-------+---------+-------------+----------------+---------+----+-------------+-----+------------+-----+
|     0 | coord1  | 172.27.0.10 | Replica        | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
|     0 | coord2  | 172.27.0.6  | Quorum Standby | running |  1 |   0/41C0368 |   0 |  0/41C0368 |   0 |
|     0 | coord3  | 172.27.0.4  | Leader         | running |  1 |             |     |            |     |
|     1 | work1-1 | 172.27.0.8  | Leader         | running |  1 |             |     |            |     |
|     1 | work1-2 | 172.27.0.2  | Quorum Standby | running |  1 |   0/31D3198 |   0 |  0/31D3198 |   0 |
|     2 | work2-1 | 172.27.0.5  | Leader         | running |  2 |             |     |            |     |
|     2 | work2-2 | 172.27.0.7  | Quorum Standby | running |  2 |   0/31CDFC0 |   0 |  0/31CDFC0 |   0 |
+-------+---------+-------------+----------------+---------+----+-------------+-----+------------+-----+
Auf der Koordinatorseite sieht das wie folgt aus:
# The worker primary notifies the coordinator that it is going to execute "pg_ctl stop".
2024-08-26 07:02:38,636 DEBUG: query(BEGIN, ())
2024-08-26 07:02:38,636 DEBUG: query(SELECT pg_catalog.citus_update_node(%s, %s, %s, true, %s), (3, '172.19.0.7-demoted', 5432, 10000))
# From this moment all application traffic on the coordinator to the worker group 2 is paused.

# The old worker primary is assigned as a secondary.
2024-08-26 07:02:40,084 DEBUG: query(SELECT pg_catalog.citus_update_node(%s, %s, %s, true, %s), (7, '172.19.0.7', 5432, 10000))

# The future worker primary notifies the coordinator that it acquired the leader lock in DCS and about to run "pg_ctl promote".
2024-08-26 07:02:40,085 DEBUG: query(SELECT pg_catalog.citus_update_node(%s, %s, %s, true, %s), (3, '172.19.0.5', 5432, 10000))

# The new worker primary just finished promote and notifies coordinator that it is ready to accept read-write traffic.
2024-08-26 07:02:41,485 DEBUG: query(COMMIT, ())
# From this moment the application traffic on the coordinator to the worker group 2 is unblocked.
Sekundärknoten
Ab Patroni v4.0.0 werden auch Citus-Sekundärknoten ohne das Tag
noloadbalance in pg_dist_node registriert. Um Sekundärknoten für schreibgeschützte Abfragen zu verwenden, müssen Anwendungen jedoch den GUC citus.use_secondary_nodes
ändern.
Ein Blick in den DCS
Der Citus-Cluster (Koordinator und Worker) wird im DCS als Verbund logisch zusammengehörender Patroni-Cluster gespeichert:
/service/batman/              # scope=batman
/service/batman/0/            # citus.group=0, coordinator
/service/batman/0/initialize
/service/batman/0/leader
/service/batman/0/members/
/service/batman/0/members/m1
/service/batman/0/members/m2
/service/batman/1/            # citus.group=1, worker
/service/batman/1/initialize
/service/batman/1/leader
/service/batman/1/members/
/service/batman/1/members/m3
/service/batman/1/members/m4
...
Dieser Ansatz wurde gewählt, weil sich bei den meisten DCS damit der gesamte Citus-Cluster mit einer einzigen rekursiven Leseanfrage abrufen lässt. Nur die Citus-Koordinatorknoten lesen den gesamten Baum, da sie die Worker-Knoten erkennen müssen. Worker-Knoten lesen lediglich den Teilbaum ihrer eigenen Gruppe und können in manchen Fällen auch den Teilbaum der Koordinatorgruppe lesen.
Citus auf Kubernetes
Da Kubernetes keine hierarchischen Strukturen unterstützt, muss die Citus-Gruppe in alle K8s-Objekte aufgenommen werden, die Patroni erstellt:
batman-0-leader  # the leader config map for the coordinator
batman-0-config  # the config map holding initialize, config, and history "keys"
...
batman-1-leader  # the leader config map for worker group 1
batman-1-config
...
Das Namensschema lautet also: ${scope}-${citus.group}-${type}.
Patroni erkennt alle Kubernetes-Objekte über den Label-Selektor . Daher müssen alle Pods mit Patroni&Citus sowie Endpoints/ConfigMaps Labels, die dem gemeinsamen Label-Selektor entsprechen haben, und Patroni muss über die Kubernetes-Einstellungen oder Umgebungsvariablen für ihre Verwendung konfiguriert werden.
Einige Beispiele für die Konfiguration von Patroni über Umgebungsvariablen der Pods:
- Für den Koordinator-Cluster
- Für den Worker-Cluster der Gruppe 2
In beiden Beispielen ist das Label citus-group gesetzt. Anhand dieses Labels erkennt Patroni, zu welcher Citus-Gruppe ein Objekt gehört. Zusätzlich gibt es die Umgebungsvariable PATRONI_CITUS_GROUP mit demselben Wert wie das Label citus-group. Wenn Patroni neue Kubernetes-Objekte (ConfigMaps oder Endpoints) erstellt, versieht es diese automatisch mit dem Label citus-group: ${env.PATRONI_CITUS_GROUP}:
Ein vollständiges Beispiel für die Bereitstellung von Patroni auf Kubernetes mit Citus-Unterstützung findet sich im Ordner kubernetes des Patroni-Repositories.
Dabei sind zwei Dateien relevant:
- Dockerfile.citus
- citus_k8s.yaml
Citus-Upgrades und PostgreSQL-Hauptversions-Upgrades
Zunächst die Dokumentation
zum Aktualisieren der Citus-Version lesen. Im Ablauf gibt es eine kleine Änderung: Beim Upgrade muss PostgreSQL mit patronictl restart
anstelle von systemctl restart neu gestartet werden.
Ein PostgreSQL-Hauptversions-Upgrade mit Citus ist etwas komplexer. Dafür müssen die Verfahren aus der Citus-Dokumentation zu Hauptversions-Upgrades mit denen aus der Patroni-Dokumentation zu PostgreSQL-Hauptversionsupgrade kombiniert werden. Dabei ist zu beachten, dass ein Citus-Cluster aus mehreren Patroni-Clustern (Koordinator und Worker) besteht, die alle unabhängig voneinander aktualisiert werden müssen.
14 - Eine eigenständige Instanz in einen Patroni-Cluster überführen
Dieser Abschnitt beschreibt, wie eine eigenständige PostgreSQL-Instanz in einen Patroni-Cluster überführt wird.
Zur Bereitstellung eines Patroni-Clusters ohne bestehende PostgreSQL-Instanz siehe Ausführen und Konfigurieren .
Vorgehen
Nachfolgend stehen die Schritte zur Übernahme eines bestehenden Postgres-Clusters in die Verwaltung durch Patroni. Dabei wird vorausgesetzt, dass alle Knoten des bestehenden Clusters aktuell laufen und die Postgres-Konfiguration während der Migration nicht geändert werden soll. Die Schritte:
-
Die Postgres-Benutzer wie im Abschnitt authentication der Patroni-Konfiguration beschrieben anlegen. Der folgende Codeblock enthält SQL-Beispiele zum Anlegen der Benutzer; Benutzernamen und Passwörter müssen an die eigene Umgebung angepasst werden. Sind die entsprechenden Benutzer bereits vorhanden, kann dieser Schritt entfallen.
-
Die folgenden Schritte auf allen Postgres-Knoten ausführen. Zuerst alle Schritte auf einem Knoten abschließen, bevor mit dem nächsten fortgefahren wird. Mit dem Primärknoten beginnen, anschließend die einzelnen Standby-Knoten bearbeiten:
- Wird Postgres über systemd betrieben, die systemd-Unit für Postgres deaktivieren. Dies ist erforderlich, weil Patroni das Starten und Stoppen des Postgres-Daemons übernimmt.
- Eine YAML-Konfigurationsdatei für Patroni erstellen. Dafür können die Werkzeuge zur Erzeugung und Validierung der Patroni-Konfiguration
verwendet werden.
- Hinweis (nur für den Primärknoten): Werden Replikationsslots zur Replikation zwischen Clustermitgliedern verwendet, wird empfohlen,
use_slotszu aktivieren und die bestehenden Replikationsslots über den Konfigurationseintragslotsals permanent zu konfigurieren. Bei aktiviertemuse_slotserstellt Patroni automatisch Replikationsslots für die Replikation zwischen Mitgliedern und entfernt Slots, die es nicht erkennt. Permanente Slots sorgen hier dafür, dass die bestehenden Slots während der Migration zu Patroni erhalten bleiben. Einzelheiten stehen unter Dynamische Konfiguration .
- Hinweis (nur für den Primärknoten): Werden Replikationsslots zur Replikation zwischen Clustermitgliedern verwendet, wird empfohlen,
- Patroni über die systemd-Service-Unit
patronistarten. Es erkennt automatisch, dass Postgres bereits läuft, und beginnt mit der Überwachung der Instanz.
-
Den Startvorgang von Postgres an Patroni übergeben. Dazu müssen die Clustermitglieder mit dem Befehl patronictl restart cluster-name member-name neu gestartet werden. Für eine möglichst kurze Ausfallzeit kann dieser Schritt aufgeteilt werden:
- Die Standby-Knoten sofort neu starten.
- Den Neustart des Primärknotens für ein Wartungsfenster planen.
-
Wurden in Schritt
2.2.permanente Slots konfiguriert, sollten sie mit dem Befehl patronictl edit-config cluster-name aus der Konfigurationslotsentfernt werden, sobald dierestart_lsnder von Patroni angelegten Slots dierestart_lsnder ursprünglichen Slots für die jeweiligen Mitglieder eingeholt hat. Durch das Entfernen aus der Konfigurationslotskann Patroni die ursprünglichen Slots aus dem Cluster löschen, sobald sie nicht mehr benötigt werden. Die folgende Beispielabfrage zeigt dierestart_lsnzweier Slots zum Vergleich:
Upgrade auf eine neue PostgreSQL-Hauptversion
Ein Upgrade auf eine neue Hauptversion mit pg_upgrade erfolgt nach folgendem Verfahren:
- Patroni stoppen.
- Die PostgreSQL-Binärdateien aktualisieren und pg_upgrade auf dem Primärknoten ausführen.
- patroni.yml aktualisieren.
- Den initialize-Schlüssel aus dem DCS entfernen oder den vollständigen Clusterzustand im DCS löschen. Letzteres lässt sich mit patronictl remove cluster-name erreichen. Dies ist nötig, weil der neue PostgreSQL-Cluster mit initdb initialisiert wird und dadurch eine neue PostgreSQL-Systemkennung erhält.
- Wurde der Clusterzustand im vorherigen Schritt gelöscht, kann patroni.dynamic.json aus dem alten in das neue Datenverzeichnis kopiert werden. So lassen sich einige zuvor gesetzte PostgreSQL-Parameter beibehalten.
- Patroni auf dem Primärknoten starten.
- Auf den Standby-Knoten die PostgreSQL-Binärdateien und patroni.yml aktualisieren sowie data_dir leeren.
- Patroni auf den Standby-Knoten starten und warten, bis die Replikation abgeschlossen ist.
PostgreSQL unterstützt die Ausführung von pg_upgrade auf Standby-Knoten nicht. Mit entsprechender Sachkenntnis kann anstelle des Leerens von data_dir auf den Standby-Knoten das unter https://www.postgresql.org/docs/current/pgupgrade.html beschriebene rsync-Verfahren versucht werden. Am sichersten ist es jedoch, die Daten von Patroni replizieren zu lassen.
Häufig gestellte Fragen
-
Beim Start meldet Patroni, dass es sich nicht an den PostgreSQL-Port binden kann.
listen_addressesundportinpostgresql.confsowiepostgresql.listeninpatroni.ymlüberprüfen. Auchpg_hba.confsollte diesen Zugriff erlauben. -
Nachdem Patroni zum Neustart des Knotens aufgefordert wurde, zeigt PostgreSQL die Fehlermeldung
could not open configuration file "/etc/postgresql/10/main/pg_hba.conf": No such file or directoryan.Je nach Verwaltung der PostgreSQL-Konfiguration kann dies verschiedene Ursachen haben. Wurde
postgresql.config_dirangegeben, erzeugt Patroni diepg_hba.confanhand der Einstellungen im Abschnitt bootstrap nur bei der Initialisierung eines neuen Clusters. In diesem Szenario warPGDATAnicht leer, daher fand keine Initialisierung statt. Diese Datei muss bereits vorher vorhanden sein.
15 - Integration mit anderen Werkzeugen
Patroni lässt sich mit anderen Werkzeugen der eigenen Umgebung integrieren. Die Liste der Beispiele in diesem Abschnitt ist nicht abschließend, gibt aber Anregungen für solche Integrationen.
Barman
Patroni liefert die Anwendung patroni_barman, die mit pg-backup-api kommuniziert und so Barman-Operationen aus der Ferne ermöglicht.
Diese Anwendung verfügt derzeit über die Unterbefehle: recover und config-switch.
patroni_barman recover
Der Unterbefehl recover kann als benutzerdefinierte Bootstrap-Methode oder als benutzerdefinierte Replikat-Erstellungsmethode verwendet werden. Weitere Informationen hierzu finden Sie in Replikaterstellung und Cluster-Initialisierung
.
patroni_barman config-switch
Der Unterbefehl config-switch ist als on_role_change-Callback in Patroni vorgesehen. Als Beispiel nehmen wir an, dass Sie WALs von Ihrem aktuellen Primärserver auf Ihren Barman-Host streamen. Im Falle eines Failovers im Cluster möchten Sie möglicherweise den WAL-Stream von dem neuen Primärserver starten. Dies erreichen Sie, indem Sie patroni_barman config-switch als on_role_change-Callback verwenden.
Dieser Unterbefehl basiert auf dem barman config-switch-Befehl, der dafür verantwortlich ist, die Konfiguration eines Barman-Servers durch Anwenden eines vordefinierten Modells auf ihn zu überschreiben. Dieser Befehl ist seit Barman 3.10 verfügbar. Weitere Einzelheiten finden Sie in der Barman-Dokumentation.
Dies ist ein Beispiel dafür, wie Sie Patroni konfigurieren können, um ein Konfigurationsmodell anzuwenden, falls dieser Patroni-Knoten zum Primärserver hochgestuft wird:
patroni_barman config-switch erfordert, dass sowohl Barman als auch pg-backup-api auf dem Barman-Host konfiguriert sind, damit ein entfernter barman config-switch über die Backup-API ausgeführt werden kann. Außerdem müssen die anzuwendenden Barman-Modelle bereits konfiguriert sein. Das obige Beispiel verwendet eine Teilmenge der verfügbaren Parameter. Weitere Informationen erhalten Sie durch Ausführen von patroni_barman config-switch --help und durch Konsultation der Barman-Dokumentation.
16 - Sicherheitshinweise
Ein Patroni-Cluster verfügt über zwei Schnittstellen, die vor unbefugtem Zugriff geschützt werden müssen: der verteilte Konfigurationsspeicher (DCS) und die REST-API von Patroni.
Schutz des DCS
Sowohl Patroni als auch patronictl speichern Daten im DCS und lesen sie daraus.
Auch wenn der DCS keine sensiblen Informationen enthält, ermöglicht er die Änderung einiger Einstellungen von Patroni/Postgres. Daher sollte zuerst der DCS selbst geschützt werden.
Die Details zum Schutz hängen vom verwendeten Typ des DCS ab. Die Authentifizierungs- und Verschlüsselungsparameter (Token/Basic-Auth/Client-Zertifikate) für die unterstützten DCS-Typen sind in den Einstellungen beschrieben.
Die allgemeine Empfehlung ist, TLS für die gesamte Kommunikation mit dem DCS zu aktivieren.
Schutz der REST-API
Der Schutz der REST-API ist eine komplexere Aufgabe.
Patroni selbst verwendet seine REST-API während der Leader-Wahl. Das Werkzeug patronictl nutzt sie für Failover, Switchover, Neuinitialisierungen, Neustarts und das Neuladen der Konfiguration. HAProxy oder andere Load-Balancer verwenden sie für HTTP-Health-Checks; außerdem kann sie zur Überwachung dienen.
Aus Sicherheitsperspektive enthält die REST-API sichere (GET-Anfragen, die nur Informationen abrufen) und unsichere (PUT-, POST-, PATCH- und DELETE-Anfragen, die den Zustand von Knoten ändern) Endpunkte.
Die unsicheren Endpunkte können durch HTTP-Basic-Auth geschützt werden, indem die Parameter restapi.authentication.username und restapi.authentication.password gesetzt werden. Es gibt keine Möglichkeit, die sicheren Endpunkte zu schützen, ohne TLS zu aktivieren.
Wenn TLS für die REST-API aktiviert und eine PKI eingerichtet ist, ist eine gegenseitige Authentifizierung zwischen API-Server und API-Client für alle Endpunkte möglich.
Die Parameter im Abschnitt restapi ermöglichen die TLS-Client-Authentifizierung beim Server. Je nach Wert des Parameters verify_client erfordert der API-Server eine erfolgreiche Überprüfung des Clientzertifikats sowohl für sichere als auch für unsichere API-Aufrufe (verify_client: required), nur für unsichere API-Aufrufe (verify_client: optional), oder für keine API-Aufrufe (verify_client: none).
Die Parameter im Abschnitt ctl ermöglichen die TLS-Server-Authentifizierung beim Client (dem Werkzeug patronictl
, das dieselbe Konfiguration wie Patroni verwendet). Mit insecure: true wird die Überprüfung des Serverzertifikats durch den Client deaktiviert. Weitere Details zu den TLS-Client-Parametern finden Sie in Einstellungen
.
Der Schutz der PostgreSQL-Datenbank selbst vor unbefugtem Zugriff liegt außerhalb des Umfangs dieses Dokuments und wird unter https://www.postgresql.org/docs/current/client-authentication.html behandelt.
17 - Hochverfügbarkeit über mehrere Rechenzentren
Die Hochverfügbarkeit eines PostgreSQL-Clusters über mehrere Rechenzentren basiert auf synchroner oder asynchroner Replikation (siehe Replikationsmodi ).
In beiden Fällen sind folgende Grundsätze wichtig:
- Postgres kann nur dann als Primärserver oder Standby-Leader laufen, wenn es den Leader-Schlüssel besitzt und aktualisieren kann.
- Die Anzahl der etcd-, ZooKeeper- oder Consul-Knoten sollte ungerade sein: 3 oder 5!
Synchrone Replikation
Ein Cluster über mehrere Rechenzentren (DC), der den Ausfall einer Zone automatisch verkraften soll, benötigt mindestens 3 Zonen.
Das Architekturdiagramm sieht folgendermaßen aus:
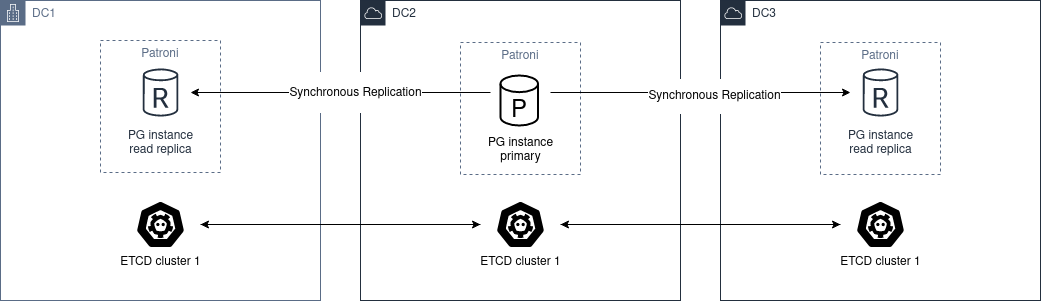
Ein Cluster aus etcd, ZooKeeper oder Consul muss über die verschiedenen Rechenzentren verteilt werden, mit mindestens 3 Knoten und jeweils einem Knoten pro Zone.
Für Postgres müssen mindestens 2 Knoten in unterschiedlichen Rechenzentren bereitgestellt werden. Anschließend muss synchronous_mode: true in der globalen dynamischen Konfiguration
gesetzt werden.
Dies aktiviert synchrone Replikation; der Primärserver wählt einen der Knoten als synchronen Knoten aus.
Asynchrone Replikation
Bei nur zwei Rechenzentren ist es besser, zwei unabhängige etcd-Cluster zu betreiben und im zweiten Rechenzentrum einen Patroni-Standby-Cluster einzurichten. Fällt der erste Standort aus, kann der standby_cluster MANUELL hochgestuft werden.
Das Architekturdiagramm sieht folgendermaßen aus:
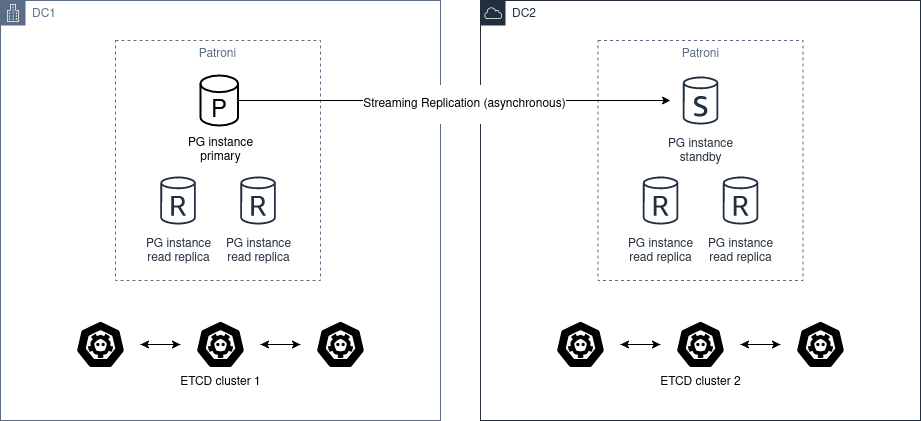
Eine automatische Hochstufung ist nicht möglich, da DC2 den Zustand von DC1 niemals sicher bestimmen kann.
In diesem Szenario sollte pg_ctl promote nicht verwendet werden. Stattdessen muss der funktionsfähige Cluster „manuell hochgestuft“ werden, indem der Abschnitt standby_cluster
aus der dynamischen Konfiguration
entfernt wird.
Läuft der Quellcluster noch und wird der Standby-Cluster hochgestuft, entsteht eine Split-Brain-Situation.
Um zum „ursprünglichen“ Zustand zurückzukehren, gibt es nur zwei Möglichkeiten:
- Den Abschnitt standby_cluster wieder hinzufügen. Dies löst
pg_rewindaus. Damitpg_rewindordnungsgemäß funktioniert, muss der Cluster mitdata page checksums(Option--data-checksumsfürinitdb) initialisiert worden sein und/oderwal_log_hintsmuss aufongesetzt sein. Dennoch kannpg_rewindaus anderen Gründen fehlschlagen. - Den Standby-Cluster vollständig neu aufbauen.
Vor der Hochstufung des Standby-Clusters muss manuell sichergestellt werden, dass der Quellcluster heruntergefahren ist (STONITH). Sobald DC1 wieder verfügbar ist, muss dessen Cluster in einen Standby-Cluster umgewandelt werden.
Zuvor kann die Datenbank manuell untersucht werden, um alle Änderungen zu extrahieren, die zwischen dem Ausfall der Netzwerkverbindung von DC1 zu DC2 und dem manuellen Stoppen des Clusters in DC1 erfolgt sind.
Die extrahierten Änderungen können anschließend auch manuell auf den Cluster in DC2 angewendet werden.
18 - Häufige Fragen
Dieser Abschnitt beantwortet die am häufigsten gestellten Fragen zu Patroni. Die Unterabschnitte behandeln jeweils unterschiedliche Themenbereiche.
Wir hoffen, dass sich damit die meisten Fragen klären lassen. Bei weiteren Fragen oder unerwarteten Problemen erläutern die Abschnitte Austausch und Fehler melden , wie Unterstützung angefragt oder Probleme gemeldet werden können.
Vergleich mit anderen HA-Lösungen
Warum benötigt Patroni einen separaten Cluster aus DCS-Knoten, während andere Lösungen wie repmgr ohne ihn auskommen?
HA-Lösungen lassen sich auf verschiedene Weise implementieren, jeweils mit Vor- und Nachteilen.
Software wie repmgr lässt die Knoten miteinander kommunizieren, um zu entscheiden, wann Maßnahmen ergriffen werden sollten.
Patroni stützt sich dagegen auf den im DCS gespeicherten Zustand. Der DCS dient Patroni als maßgebliche Informationsquelle für die Entscheidung, was zu tun ist.
Ein separater DCS-Cluster kann die Architektur aufwendiger machen. Dieser Ansatz verringert jedoch auch die Wahrscheinlichkeit von Split-Brain-Situationen im Postgres-Cluster.
Wie unterscheidet sich Patroni bei der Verwaltung von Postgres von anderen HA-Lösungen?
Patroni verwaltet sowohl die Hochverfügbarkeit des Postgres-Clusters als auch Postgres selbst.
Wenn noch keine Postgres-Knoten existieren, übernimmt Patroni die Initialisierung des Primärservers und der Standby-Knoten sowie die Verwaltung ihrer Postgres-Konfiguration. Existieren die Postgres-Knoten bereits, übernimmt Patroni die Verwaltung des Clusters.
Darüber hinaus verfügt Patroni über Selbstheilungsfunktionen. Wenn ein Primärserver ausfällt, führt Patroni ein Failover zu einem Replikat durch und versucht außerdem, den bisherigen Primärserver als Replikat des neuen Primärservers wieder einzubinden. Ebenso versucht Patroni, ein ausgefallenes Replikat wieder einzubinden.
Deshalb bezeichnen wir Patroni als „Vorlage für HA-Lösungen“. Es geht über die Verwaltung physischer Replikation hinaus und verwaltet Postgres als Ganzes.
DCS
Kann derselbe etcd-Cluster Daten von zwei oder mehr Patroni-Clustern speichern?
Ja, das ist möglich!
Informationen zu einem Patroni-Cluster werden im DCS unter einem Pfad gespeichert, dessen Präfix aus den Patroni-Einstellungen namespace und scope besteht.
Solange die Kombinationen aus namespace und scope der verschiedenen Patroni-Cluster nicht kollidieren, sollte derselbe DCS-Cluster Informationen zu mehreren Patroni-Clustern speichern können.
Was geschieht, wenn verschiedene Patroni-Cluster dieselbe Kombination aus namespace und scope sowie denselben DCS-Cluster verwenden?
Hat der zweite Cluster eine andere Postgres-Systemkennung, erkennt Patroni unter diesem DCS-Pfad inkompatible Daten. Außerhalb des Pause-Modus beendet es sich, statt den zweiten Cluster zu verwalten, weil es davon ausgeht, dass der gespeicherte Zustand zu einem anderen Cluster gehört und Patroni falsch konfiguriert wurde.
Für unterschiedliche Patroni-Cluster, die denselben DCS-Cluster nutzen, müssen unterschiedliche Kombinationen aus namespace / scope verwendet werden.
Was geschieht beim Verlust des DCS-Clusters?
Der DCS speichert im Wesentlichen den Status und die dynamische Konfiguration des Patroni-Clusters.
Als unmittelbare Folge wechseln alle Patroni-Cluster, die diesen DCS nutzen, in den schreibgeschützten Modus – sofern der DCS-Failsafe-Modus nicht aktiviert ist.
Was ist beim Verlust des DCS-Clusters zu tun?
Nach dem Verlust des DCS-Clusters sind drei Ergebnisse möglich:
- Der DCS-Cluster wird vollständig wiederhergestellt: Auf Patroni-Seite ist nichts zu tun. Sobald der DCS-Cluster wiederhergestellt ist, sollte auch Patroni wieder funktionsfähig werden;
- Der DCS-Cluster wird an derselben Stelle neu erstellt, und die Endpunkte bleiben unverändert. Auf Patroni-Seite sind keine Änderungen erforderlich;
- Ein neuer DCS-Cluster mit anderen Endpunkten wird erstellt. Die DCS-Endpunkte müssen in der Patroni-Konfiguration jedes Patroni-Knotens aktualisiert werden.
In den Szenarien 2. und 3. erstellt Patroni die Statusinformationen anhand des aktuellen Cluster-Zustands neu. Außerdem stellt es die dynamische Konfiguration im DCS aus der Backup-Datei patroni.dynamic.json wieder her, die im Postgres-Datenverzeichnis jedes Mitglieds des Patroni-Clusters gespeichert ist.
Was geschieht, wenn die Mehrheit im DCS-Cluster verloren geht?
Der DCS reagiert nicht mehr, woraufhin Patroni den aktuellen lesenden und schreibenden Postgres-Knoten herabstuft.
Dabei ist zu beachten: Patroni stützt seine Aktionen im Cluster auf den Zustand des DCS.
Mit dem DCS-Failsafe-Modus lassen sich die Auswirkungen dieser Situation abmildern.
patronictl
Muss patronictl
auf dem Patroni-Host ausgeführt werden?
Nein, das ist nicht erforderlich.
Bei Zugriff auf den Patroni-Host ist es praktisch, patronictl
dort auszuführen, da dieselbe Konfigurationsdatei des Agenten patroni auch für patronictl
verwendet werden kann.
patronictl ist jedoch im Wesentlichen ein Client und kann auch auf entfernten Rechnern ausgeführt werden. Es benötigt lediglich eine ausreichende Konfiguration, um den DCS und die REST API der Patroni-Mitglieder zu erreichen.
Warum werden die Informationen zu einem Patroni-Mitglied nicht mehr in der Ausgabe von patronictl list
angezeigt?
Die von patronictl list
angezeigten Informationen basieren auf dem Inhalt des DCS.
Wenn Informationen zu einem Mitglied aus dem DCS verschwunden sind, läuft der Patroni-Agent auf diesem Knoten sehr wahrscheinlich nicht mehr oder kann nicht mit dem DCS kommunizieren.
Da das Mitglied die Informationen nicht aktualisieren kann, laufen sie im DCS schließlich ab. Folglich erscheint das Mitglied nicht mehr in der Ausgabe von patronictl list
.
Warum sind die Informationen zu einem Patroni-Mitglied in der Ausgabe von patronictl list
nicht aktuell?
Die von patronictl list
angezeigten Informationen basieren auf dem Inhalt des DCS.
Standardmäßig aktualisiert Patroni diese Informationen etwa alle loop_wait Sekunden. Selbst wenn alles ordnungsgemäß funktioniert, können die im DCS gespeicherten Informationen also bis zu loop_wait Sekunden hinter dem tatsächlichen Zustand zurückliegen.
Dies gilt jedoch nicht ausnahmslos. Manche Patroni-Operationen aktualisieren die DCS-Informationen sofort.
Konfiguration
Was unterscheidet die dynamische von der lokalen Konfiguration?
Die dynamische (oder globale) Konfiguration wird im DCS gespeichert und auf alle Mitglieder des Patroni-Clusters angewendet. Sie sollte der bevorzugte Ort für Konfigurationseinstellungen sein.
Knotenspezifische Einstellungen oder Werte, die die globale Konfiguration überschreiben sollen, sollten nur auf dem jeweiligen Patroni-Mitglied als lokale Konfiguration gesetzt werden. Diese lokale Konfiguration kann über die Konfigurationsdatei oder über Umgebungsvariablen festgelegt werden.
Weitere Informationen unter Konfiguration .
Welche Konfigurationsarten gibt es in Patroni, und welche haben Vorrang?
Es gibt folgende Arten:
- Dynamische Konfiguration: gilt für alle Mitglieder;
- Lokale Konfiguration: gilt für das lokale Mitglied und überschreibt die dynamische Konfiguration;
- Umgebungskonfiguration: gilt für das lokale Mitglied und überschreibt sowohl die dynamische als auch die lokale Konfiguration.
Hinweis: Einige Postgres-GUCs können nur global, also über die dynamische Konfiguration, gesetzt werden. Außerdem erzwingt Patroni für manche GUCs einen fest programmierten Wert.
Weitere Informationen unter Konfiguration .
Gibt es eine Hilfe zum Erstellen der Patroni-Konfigurationsdatei?
Ja.
Mit patroni --generate-sample-config kann eine Patroni-Beispielkonfiguration erstellt werden. patroni --generate-config erstellt eine Patroni-Konfiguration auf Basis einer bestehenden Postgres-Instanz.
Weitere Einzelheiten finden sich unter Beispielkonfiguration erzeugen und Konfiguration erzeugen .
Parameter unter bootstrap.dcs wurden geändert, aber Patroni wendet die Änderungen nicht auf die Cluster-Mitglieder an. Woran liegt das?
Die unter bootstrap.dcs konfigurierten Werte werden nur bei der Initialisierung eines neuen Clusters verwendet. Während dieser Initialisierung werden sie in den DCS geschrieben.
Nach Abschluss der Initialisierung lässt sich die dynamische Konfiguration nur noch über den DCS ändern.
Weitere Einzelheiten folgen in der nächsten Frage.
Wie lässt sich die dynamische Konfiguration ändern?
Dafür muss die Konfiguration im DCS geändert werden. Dies ist auf folgende Weise möglich:
- Über
patronictl edit-config; oder - Mit einer
PATCH-Anfrage an den Konfigurationsendpunkt .
Wie lässt sich die lokale Konfiguration ändern?
Dafür muss die Konfigurationsdatei des jeweiligen Patroni-Mitglieds geändert und dem Patroni-Agenten das Signal SIGHUP gesendet werden. Dies ist auf folgende Weise möglich:
-
Eine
POST-Anfrage an den REST-API-Endpunkt zum Neuladen senden; oder -
patronictl reloadausführen; oder -
Dem Patroni-Prozess lokal das Signal
SIGHUPsenden:- Wurde Patroni über systemd gestartet, kann der Befehl
systemctl reload PATRONI_UNIT.serviceverwendet werden, wobeiPATRONI_UNITder Name des Patroni-Dienstes ist; oder - Wurde Patroni auf andere Weise gestartet, muss der Prozess
patroniermittelt undkill -s HUP PIDausgeführt werden. Dabei istPIDdie Prozess-ID des Prozessespatroni.
- Wurde Patroni über systemd gestartet, kann der Befehl
Hinweis: In manchen Fällen funktioniert das Neuladen mit patronictl reload
möglicherweise nicht:
- Abgelaufene REST-API-Zertifikate: Dies lässt sich mit der Option
-kvon patronictl umgehen; - Falsche Zugangsdaten: beispielsweise wenn die Zugangsdaten für
restapioderctlin der Konfigurationsdatei geändert werden und dieselbe Datei für Patroni und patronictl verwendet wird.
Wie lässt sich die Umgebungskonfiguration ändern?
Patroni liest die Umgebungskonfiguration nur beim Start ein.
Nach einer Änderung der Umgebungskonfiguration muss daher der jeweilige Patroni-Agent neu gestartet werden.
Darauf achten, kein Failover im Cluster auszulösen! Hierzu kann patronictl pause
hilfreich sein.
Wie lassen sich wiederholte Heartbeat-Protokollzeilen im Normalbetrieb reduzieren?
Wenn wiederholte Zeilen wie Lock owner: ... und no action. I am ... die Protokolle überladen, log.deduplicate_heartbeat_logs: true konfigurieren.
Dies kann entweder in der Patroni-YAML-Datei (Protokollierungseinstellungen
) oder mit PATRONI_LOG_DEDUPLICATE_HEARTBEAT_LOGS=true festgelegt werden.
Dabei ist zu beachten: Das Unterdrücken wiederholter Heartbeat-Meldungen reduziert das Protokollvolumen. Es entfällt aber auch die Sicht auf den Heartbeat jedes einzelnen Schleifendurchlaufs, die bei der Diagnose eines Failovers hilfreich sein kann.
Was geschieht, wenn ein Postgres-GUC geändert wird, der ein Neuladen erfordert?
Wenn die dynamische oder lokale Konfiguration wie in den vorherigen Fragen beschrieben geändert wird, übernimmt Patroni das Neuladen der Postgres-Konfiguration.
Was geschieht, wenn ein Postgres-GUC geändert wird, der einen Neustart erfordert?
Patroni markiert die betroffenen Mitglieder mit dem Flag pending restart.
Wann und wie die Mitglieder neu gestartet werden, muss selbst festgelegt werden. Der Neustart ist auf folgende Weise möglich:
- Über
patronictl restart; oder - Mit einer
POST-Anfrage an den Neustart-Endpunkt .
Hinweis: Einige Postgres-GUCs erfordern eine besondere Reihenfolge beim Neustart der Postgres-Knoten. Weitere Einzelheiten finden sich unter GUCs für gemeinsam genutzten Speicher .
Was unterscheidet etcd und etcd3 in der Patroni-Konfiguration?
etcd verwendet die API-Version 2 von etcd, während etcd3 die API-Version 3 von etcd verwendet.
Zu beachten ist, dass Informationen, die mit API-Version 2 gespeichert wurden, nicht mit API-Version 3 verwaltet werden können und umgekehrt.
Die Verwendung von etcd3 anstelle von etcd wird empfohlen, weil:
- API-Version 2 ab etcd v3.4 standardmäßig deaktiviert ist;
- API-Version 2 mit etcd v3.6 vollständig entfernt wurde.
use_slots ist in der Patroni-Konfiguration aktiviert. Wenn ein Cluster-Mitglied eine Zeit lang offline ist, wird sein Replikationsslot jedoch auf dem vorgelagerten Knoten gelöscht. Wie lässt sich das vermeiden?
Es gibt zwei Möglichkeiten:
member_slots_ttlkann angepasst werden (Standardwert30min, verfügbar seit Patroni4.0.0und ab PostgreSQL 11). Replikationsslots abwesender Mitglieder werden dann nicht entfernt, solange ihre Ausfallzeit unter dem konfigurierten Grenzwert liegt.- Für die Mitglieder können permanente physische Replikationsslots konfiguriert werden.
Seit Patroni 3.2.0 können Slots für Mitglieder als permanente, von Patroni verwaltete Slots eingerichtet werden.
Ab PostgreSQL 11 erstellt Patroni die permanenten physischen Slots auf allen Knoten, entfernt sie nicht und rückt ihre LSN auf allen Knoten entsprechend der vom Mitglied bereits konsumierten LSN vor.
Wird das betreffende Mitglied später entfernt, liegt die Anpassung der Konfiguration permanenter Slots in Ihrer Verantwortung. Andernfalls behält Patroni die Slots dauerhaft bei.
Hinweis: Auch vor Patroni 3.2.0 konnten Slots für Mitglieder als permanente physische Slots konfiguriert werden. Sie wurden jedoch nur auf dem aktuellen Leader verwaltet. Bei einem Failover oder Switchover wurden diese Slots auf dem neuen Leader erstellt. Dies garantierte aber nicht, dass dort alle WAL-Segmente für den abwesenden Knoten vorhanden waren.
Hinweis: Selbst mit Patroni 3.2.0 kann eine kleine Race Condition auftreten. Direkt bei der Erstellung auf dem Replikat kann der Slot weiter fortgeschritten sein als derselbe Slot auf dem Leader. Wenn niemand den Slot konsumiert, können nach einem Failover deshalb weiterhin Dateien fehlen. Daher wird die Konfiguration kontinuierlicher Archivierung empfohlen, um benötigtes WAL wiederherstellen oder PITR durchführen zu können.
Was unterscheidet loop_wait, retry_timeout und ttl?
Patroni führt regelmäßig einen sogenannten HA-Zyklus durch. Dabei prüft es den Zustand des Clusters anhand mehrerer Kontrollen und ergreift abhängig vom Ergebnis gegebenenfalls Maßnahmen, etwa ein Failover zu einem Standby.
loop_wait legt fest, wie lange Patroni in Sekunden vor dem nächsten HA-Prüfzyklus warten sollte.
retry_timeout legt die Wartezeit für Wiederholungsversuche beim DCS und bei Postgres fest. Reagiert der DCS beispielsweise länger als retry_timeout Sekunden nicht, kann Patroni den Primärserver vorsorglich herabstufen.
ttl legt die Lease-Dauer des leader-Locks im DCS fest. Kann der aktuelle Leader die Lease während seiner HA-Zyklen länger als ttl nicht erneuern, läuft sie ab. Dadurch wird eine leader race im Cluster ausgelöst.
Hinweis: Beim Ändern dieser Einstellungen ist zu beachten, dass Patroni die im Abschnitt Dynamische Konfiguration beschriebenen Regeln und Mindestwerte erzwingt.
Verwaltung von Postgres
Können Postgres-GUCs direkt in der Postgres-Konfiguration geändert werden?
Ja, dies sollte jedoch vermieden werden.
Patroni verwaltet die Postgres-Konfiguration und kann Änderungen an den Konfigurationsdateien später überschreiben.
Es gibt einige Möglichkeiten, die Konfiguration außerhalb der Verwaltung durch Patroni anzupassen:
- Postgres-GUCs über
$PGDATA/postgresql.base.confändern; oder postgresql.custom_conffestlegen. Diese Datei wird dann anstelle vonpostgresql.base.confverwendet und kann extern verwaltet werden; oder- GUCs mit
ALTER SYSTEM/ALTER DATABASE/ALTER USERändern.
Weitere Informationen finden sich im Abschnitt Wichtige Konfigurationsregeln .
In jedem Fall wird empfohlen, die gesamte Postgres-Konfiguration über Patroni zu verwalten. Das zentralisiert die Verwaltung und erleichtert bei Bedarf die Fehlersuche in Patroni.
Können Postgres-Knoten direkt neu gestartet werden?
Nein, Postgres sollte nicht direkt verwaltet werden!
Jeder Versuch, den Postgres-Server ohne Patroni neu zu starten, kann ein Failover im Cluster auslösen.
Wenn der Postgres-Server verwaltet werden muss, sind dafür die von Patroni bereitgestellten Verfahren zu verwenden.
Kann Patroni die Verwaltung eines bestehenden Postgres-Clusters übernehmen?
Ja, das ist möglich!
Eine ausführliche Anleitung findet sich unter Bestehende Daten übernehmen .
Wie verwaltet Patroni Postgres?
Patroni startet und stoppt Postgres durch Aufruf der ausführbaren Postgres-Dateien wie pg_ctl und postgres.
Daher MÜSSEN alle anderen Instanzen deaktiviert werden, die Postgres-Cluster verwalten könnten, etwa systemd-Units wie postgresql.service. Nur Patroni sollte Postgres-Instanzen im Cluster starten, stoppen und hochstufen können. Andernfalls können Split-Brain-Situationen entstehen. Fällt beispielsweise der als Primärserver laufende Knoten aus und die Unit postgresql.service ist aktiviert, kann diese Postgres wieder starten und dadurch einen Split Brain verursachen.
Konzepte und Voraussetzungen
Welche Anwendungen gehören zu Patroni?
Patroni wird im Wesentlichen mit zwei Anwendungen ausgeliefert:
patroni: Der Patroni-Agent verwaltet einen Postgres-Knoten;- patronictl : Ein Befehlszeilenwerkzeug zur Interaktion mit einem Patroni-Cluster (Switchover, Neustarts, Konfigurationsänderungen usw.). Weitere Informationen finden sich unter patronictl .
Was ist ein standby cluster in Patroni?
Ein Cluster, in dem kein Postgres-Primärserver läuft, also kein Mitglied mit Lese- und Schreibzugriff.
Solche Cluster replizieren Daten aus einem anderen Cluster und sind in der Regel für die Replikation zwischen Rechenzentren nützlich.
Der Leader des Clusters ist ein Standby, der Änderungen von einem entfernten Postgres-Knoten repliziert. Die übrigen Standbys sind für kaskadierende Replikation von diesem Leader-Mitglied konfiguriert.
Hinweis: Der Standby-Cluster weiß nichts über den Quellcluster, von dem er repliziert. Er kann sogar restore_command anstelle von WAL-Streaming verwenden und einen vollständig unabhängigen DCS-Cluster nutzen.
Weitere Einzelheiten finden sich unter Standby-Cluster .
Was ist ein leader in Patroni?
Ein leader in Patroni koordiniert gewissermaßen den Cluster.
In einem regulären Patroni-Cluster ist der leader der Knoten mit Lese- und Schreibzugriff.
In einem Patroni-Standby-Cluster repliziert der leader (auch als standby leader bezeichnet) von einem entfernten Postgres-Knoten und gibt diese Änderungen per kaskadierender Replikation an die anderen Mitglieder des Standby-Clusters weiter.
Benötigt Patroni eine Mindestanzahl an Postgres-Knoten im Cluster?
Nein, Patroni kann mit beliebig vielen Postgres-Knoten betrieben werden.
Dabei ist zu beachten: Patroni ist vom DCS entkoppelt.
Was bedeutet Pause
in Patroni?
Mit der von Patroni angebotenen Pause kann seine Verwaltung von Postgres vorübergehend zurückgenommen werden.
Dies ist vor allem bei Wartungsarbeiten am Cluster nützlich, wenn Patroni keine HA-Entscheidungen treffen soll, etwa ein Failover zu einem Standby beim Stoppen des Primärservers.
Weitere Informationen finden sich unter Pause .
Automatisches Failover
Wie funktioniert automatisches Failover in Patroni?
Das automatische Failover von Patroni basiert auf der sogenannten leader race.
Patroni speichert den Cluster-Status im DCS, darunter einen leader-Lock, der den Namen des Patroni-Mitglieds enthält, das aktuell der leader des Clusters ist.
Dieser leader-Lock hat eine Gültigkeitsdauer. Erneuert der Leader-Knoten die Lease des leader-Locks nicht rechtzeitig, läuft der Schlüssel im DCS schließlich ab.
Wenn der leader-Lock abläuft, wird die sogenannte leader race ausgelöst: Alle Knoten prüfen, ob sie die besten Kandidaten für die Übernahme der Rolle leader sind. Zu diesen Prüfungen gehören Aufrufe der REST API aller anderen Patroni-Mitglieder.
Alle Patroni-Mitglieder, die sich als besten Kandidaten für die Übernahme des leader-Locks ermitteln, versuchen, ihn zu übernehmen. Das erste Patroni-Mitglied, das den leader-Lock übernehmen kann, stuft sich zum Knoten mit Lese- und Schreibzugriff (oder zum standby leader) hoch. Die anderen werden so konfiguriert, dass sie ihm folgen.
Kann automatisches Failover im Patroni-Cluster vorübergehend deaktiviert werden?
Ja, das ist möglich!
Dazu kann der Cluster vorübergehend pausiert werden. Dies ist typischerweise bei Wartungsarbeiten nützlich.
Um automatisches Failover wieder zu aktivieren, muss lediglich die Pause des Clusters aufgehoben werden.
Weitere Informationen finden sich unter Pause .
Initialisierung und Erstellung von Standbys
Wie erstellt Patroni einen Postgres-Primärserver und einen Postgres-Standby?
Standardmäßig initialisiert Patroni einen neuen Cluster mit initdb und erstellt Standby-Knoten mit pg_basebackup aus einer Kopie des Mitglieds leader.
Dieses Verhalten lässt sich durch eigene Bootstrap-Methoden und Methoden zur Replikaterstellung anpassen.
Eigene Methoden sind beispielsweise nützlich, um Backups wiederherzustellen, die mit Werkzeugen wie pgBackRest oder Barman erstellt wurden.
Ausführliche Informationen finden sich unter Benutzerdefinierter Bootstrap und Benutzerdefinierte Replikaterstellung .
Überwachung
Wie lässt sich ein Patroni-Cluster überwachen?
Patroni stellt über seine REST API
einige praktische Endpunkte bereit:
/metrics: stellt Überwachungsmetriken in einem von Prometheus lesbaren Format bereit;/patroni: stellt den Status des lokalen Patroni/Postgres-Knotens im JSON-Format bereit. Die Informationen ähneln stark denen des Endpunkts/metrics.
Diese Endpunkte können für Überwachungsprüfungen verwendet werden.
19 - Versionshinweise
Version 4.1.5
Veröffentlicht am 2026-08-12
Verbesserungen der Kompatibilität
-
Kompatibilität mit PostgreSQL 14.24, 15.19, 16.15, 17.11, 18.6 (Alexander Kukushkin)
Die neue GUC
output_plugin_librarieswurde hinzugefügt. Sie beschränkt die Ausgabe-Plugins für die logische Dekodierung.
Verbesserungen
-
Verbindungsabbrüche der REST API auf Stufe
DEBUGstattWARNINGprotokollieren (Kyle McLaren)Die üblichen Varianten von „Client hat die Verbindung während des Schreibens getrennt“ werden unterdrückt, ohne die Behandlung tatsächlicher Fehler zu beeinträchtigen, die nicht die Verbindung betreffen.
Fehlerbehebungen
-
Ausrichtung bei der Validierung von
thread_stack_sizekorrigieren (Sundong Kim)Der Wert
alignedim Schemaeintrag fürthread_stack_sizewurde von65535auf65536korrigiert. Zuvor lehntepatroni --validate-configfast jeden realistischen Wert ab, einschließlich des Standardwerts524288, den der Daemon selbst anwendet. -
Bei der Validierung von
synchronous_modeauch'quorum'und Zeichenketten mit booleschen Werten akzeptieren (Eray Araz)patroni --validate-configlehnte zuvor Werte fürsynchronous_modewiequorumund boolesche Zeichenketten im PostgreSQL-Stil ab, die zur Laufzeit akzeptiert werden.
Version 4.1.4
Veröffentlicht am 2026-07-07
Fehlerbehebungen
-
Die Umgebungsvariable
NOTIFY_SOCKETvor Verwendung des Paketssystemdprüfen (Polina Bungina)Das Paket wird nur dann importiert und verwendet, wenn die Umgebungsvariable
NOTIFY_SOCKETgesetzt ist. Dadurch wird die AusnahmeFileNotFoundError: [Errno 2] No such file or directoryvermieden. -
Die Abfrage von
pg_replication_slotsvereinheitlichen (Polina Bungina)Eine fehlerhafte Behandlung der Werte
failoverundsyncedführte beim Entfernen fehlerhafter logischer Replikations-Slots zuKeyError-Ausnahmen. -
Versionsabhängige Authentifizierungsparameter bei der Konfigurationserzeugung berücksichtigen (Polina Bungina)
Der Befehl
patroni --generate-configentfernt anhand der über eine PostgreSQL-Verbindung ermittelten Version alle nicht anwendbaren Authentifizierungsparameter, die versehentlich aus der Umgebung übernommen wurden. -
pg_rewindbehandeln, während eine PostgreSQL-Instanz als Standby startet (Alexander Kukushkin)Wenn eine PostgreSQL-Instanz läuft, aber noch keine Verbindungen annimmt, wird auf die Informationen von
pg_controldatazurückgegriffen. -
Prometheus-Metriktyp für
patroni_postgres_timelinekorrigieren (Huseyin Demir)Die Metrik
patroni_postgres_timelinewird alsgaugestatt alscounterdeklariert, da sie nicht immer monoton steigt (sie kann beispielsweise auf 0 zurückgesetzt werden, wenn eine PostgreSQL-Instanz nicht läuft). -
Watchdog erst stoppen, wenn alle Client-Backends vollständig beendet sind (Alexander Kukushkin)
Wenn
primary_stop_timeoutkürzer als die minimale Watchdog-Zeitüberschreitung war und die Zeitüberschreitung beim Stoppen tatsächlich eintrat, deaktivierte Patroni zuvor den Watchdog, bevor alle Client-Backends beendet waren. -
Zeitüberschreitung einer Anweisung bei der Überwachungsabfrage behandeln (Alexander Kukushkin)
Bei einer Zeitüberschreitung der Anweisung wird auf die zwischengespeicherte Rolle zurückgegriffen, um eine Herabstufung des Primärservers zu vermeiden. Außerdem wird
pg_stat_statements.trackfür die Überwachungsabfrage zwingend aufnonegesetzt, um aufwendige GC-Aufrufe vonpg_stat_statementszu vermeiden. -
Von Patroni verwaltete Replikations-Slots mit
wal_status=lostlöschen (Alexander Kukushkin)Replikations-Slots mit
wal_status=lostsind nicht mehr verwendbar. Patroni löscht solche Slots jetzt und erstellt sie bei Bedarf neu. -
Rollendarstellung im Validierungsfehler für patronictl-Mitglieder korrigieren (Polina Bungina)
In der Ausnahmemeldung wird die korrekte Zeichenkettendarstellung verwendet. So werden fehlerhaft formatierte Meldungen wie
Error: No CtlPostgresqlRole.REPLICA among provided membersvermieden.
Version 4.1.3
Veröffentlicht am 2026-05-05
Verbesserungen der Stabilität
-
Falsch bezeichneten etcd-Fehler korrekt behandeln (Ants Aasma)
Aktuelle etcd-Versionen lösen den Fehler
Unknownaus, wenn während der Aktualisierung der Lease der etcd-Leader verloren geht. Patroni überschreibt den gemeldeten Fehlercode jetzt mitUnavailable.
Fehlerbehebungen
-
Version der ausführbaren Datei verwenden, wenn die Datei
PG_VERSIONfehlt (Polina Bungina)In manchen Fällen, etwa bei einem benutzerdefinierten Bootstrap, befindet sich die Datei
PG_VERSIONmöglicherweise nicht im Datenverzeichnis. Patroni behandelte die Version in diesem Fall als 0.0, was in Teilen der versionsabhängigen Logik zu Problemen führte. Mit dieser Korrektur versucht Patroni in solchen Fällen, die Version über die ausführbare Datei zu ermitteln. -
Initialisierung der Protokollierung umstrukturieren, damit frühe Protokollmeldungen nicht verloren gehen (Alexander Kukushkin)
PatroniLoggerwird vor dem Laden vonConfigerstellt, um frühe Protokollmeldungen zu erfassen. -
MONOTONIC_USECin die systemd-BenachrichtigungRELOADING=1aufnehmen (Alexander Kukushkin)systemd 257+ verlangt bei Diensten mit
Type=notify-reloadnebenRELOADING=1auchMONOTONIC_USEC. Ohne diese Angabe bleibtsystemctl reloadunbegrenzt hängen.
Verbesserungen
-
Crash-Recovery im Einzelbenutzermodus überspringen, wenn
backup_labelvorhanden ist (Vadim Ponomarev)Beim Start eines Replikats, das aus einem externen Backup wiederhergestellt wurde (ohne benutzerdefinierte Bootstrap-Methode), wird die Crash-Recovery im Einzelbenutzermodus übersprungen. PostgreSQL übernimmt sie stattdessen beim normalen Start.
-
Bei Ausführung unter
systemdohne das Paketpython-systemdwarnen (Alexander Kukushkin)Statt beim Start „systemd integration is not supported“ zu protokollieren, wird auf
NOTIFY_SOCKETgeprüft. Eine Warnung erfolgt nur, wenn Patroni tatsächlich untersystemdläuft und das Paketpython-systemdnicht installiert ist.
Version 4.1.2
Veröffentlicht am 2026-04-21
Verbesserungen der Systemd-Unterstützung
-
Unterstützung für den systemd-Unit-Typ
notify-reloadhinzufügen (Ronan Dunklau)Durch die Benachrichtigungen
RELOADING=1undREADY=1an systemd kannsystemctl reloadwarten, bis Patroni das Neuladen der Konfiguration tatsächlich verarbeitet hat. -
Beim Herunterfahren die Benachrichtigung
STOPPING=1an systemd senden (Alexander Kukushkin)Patroni benachrichtigt systemd jetzt entsprechend dem systemd-notify-Protokoll korrekt darüber, dass es heruntergefahren wird.
-
Benachrichtigungen von PostgreSQL an systemd verhindern (Alexander Kukushkin)
NotifyAccess=allwurde aus der systemd-Unit-Beispieldatei entfernt. Beim Start von PostgreSQL wirdNOTIFY_SOCKETaus der Umgebung gefiltert, damit PostgreSQL wederREADY=1nochSTOPPING=1an systemd sendet. Bei der Übernahme einer PostgreSQL-Instanz, die vor Patroni gestartet wurde und bereitsNOTIFY_SOCKETbesitzt, wird während des Herunterfahrens von PostgreSQL erneutREADY=1gesendet, um dessenSTOPPING=1entgegenzuwirken.
Version 4.1.1
Veröffentlicht am 2026-04-08
Verbesserungen der Stabilität
-
Kompatibilität mit Änderungen an Threads in python 3.11+ (Alexander Kukushkin)
Das Starten und Stoppen von Threads zur Laufzeit wird vermieden. Thread-Pools für die REST API und für die Ausführung asynchroner Aufgaben wurden eingeführt. Die globalen Einstellungen
thread_pool_sizeundrestapi.thread_pool_sizesind konfigurierbar. -
Kompatibilität mit python 3.14 (Alexander Kukushkin)
Tests werden mit python 3.14 ausgeführt und Kompatibilitätsprobleme behoben.
-
Kompatibilität mit den etcd-Sicherheitskorrekturen in v3.6.9, v3.5.28 und v3.4.42 (Alexander Kukushkin)
Diese etcd-Versionen behoben CVEs und änderten das Verhalten so, dass das Lesen der Clustertopologie und Lease-Keepalives ohne Authentifizierung nicht mehr zulässig sind. Patroni berücksichtigt dies jetzt durch Authentifizierung bei der Erkennung von Mitgliedern und bei Lease-Keepalives, erneute Authentifizierung bei Authentifizierungsfehlern sowie entsprechende Wiederholungen von Anfragen.
-
Verbesserte Fehlerbehandlung für etcd3 (Alexander Kukushkin)
Fehlerhafte JSON-Antworten werden behandelt, JSON-Fehler flexibler ausgewertet und interne etcd-Fehler besser gemeldet.
Fehlerbehebungen
-
Leader-Aktualisierung bei vorübergehendem Kubernetes-Fehler
403wiederholen (Sophia Ruan, Alexander Kukushkin)Wenn die Kubernetes-API vorübergehend
403 Permission Deniedzurückgibt (etwa bei vorübergehenden RBAC-Problemen), prüft Patroni jetzt, ob der aktuelle Knoten weiterhin Leader ist, und wiederholt die Leader-Aktualisierung innerhalb vonretry_timeout, statt den Knoten sofort herabzustufen. -
Problem beim Umbenennen des Leader-Knotens im synchronen Modus während einer Pause beheben (Alexander Kukushkin)
Der Schlüssel
/syncwurde nach dem Umbenennen des Leader-Knotens mit einem Patroni-Neustart während einer Pause (ohne Postgres-Neustart) nicht aktualisiert. Dadurch konnte Patroni nach dem nächsten Neustart ohne Pause keine Hochstufung durchführen. -
pg_rewind-Prüfung auslösen, wenn derselbe Primärserver seine Timeline erhöht hat (Alexander Kukushkin)Eine solche Timeline-Erhöhung kann durch Crash-Recovery im Einzelbenutzermodus mit anschließender Hochstufung nach Übernahme des Leader-Schlüssels entstehen, während andere Replikatknoten vom DCS isoliert sind. In diesem Fall lösten die Replikatknoten den
pg_rewind-Zustandsautomaten nicht aus, weil sich der Leader und damitprimary_conninfonicht geändert hatten. -
Superuser-Passwort beim Bootstrap mit
initdbnur schreiben, wenn es nicht leer ist (Michael Banck)Das Schreiben eines leeren Passworts beim Bootstrap mit
initdbführte zu Problemen. -
Fehler bei
failover_prioritymitsynchronous_mode=onbeheben (Alexander Kukushkin)Werte von
tag.failover_prioritywurden ignoriert, wennsynchronous_node_count > 1galt. -
Fehler beim Passwortvergleich in
primary_conninfobeheben (Alexander Kukushkin)Ab PostgreSQL 10 verwendet Patroni in
primary_conninfoeine Passwortdatei. Nach einer Änderung des Replikationspassworts in der YAML-Dateikonfiguration mit anschließendem Neuladen aktualisierte Patroni diese Passwortdatei nicht. -
Replikat mit dem Tag
nofailoverim Pause-Modus nicht neu starten (Alexander Kukushkin)Patroni startete zuvor ein manuell heruntergefahrenes PostgreSQL-Replikat im Pause-Modus, wenn dessen Tag
nofailoverauftruegesetzt war. -
check_recovery_conf()korrigieren, wenn PostgreSQL gerade startet (Alexander Kukushkin)Bei PostgreSQL v12 und neuer kann
pg_settingsnicht abgefragt werden, solange der Server noch startet und keine Verbindungen annimmt. Fehlende Recovery-Parameter werden jetzt beim Schreiben vonpostgresql.confdem internen Zustand hinzugefügt. Außerdem wurde die PrüfungPostgresql.is_starting()inHa.is_healthiest_node()wiederhergestellt. -
Benutzeroptionen im Dictionary-Format für
initdb/basebackupvalidieren (m4rrypro)Wenn Optionen für
initdboderbasebackupals Dictionary statt als Liste angegeben wurden, wurde die Validierung durchoption_is_allowed()umgangen, wodurch gesperrte Optionen verwendet werden konnten. -
Serverseitige Komprimierung für die Option
basebackupzulassen (m4rrypro)Die Option
compresswar fürbasebackupvollständig gesperrt. Seit PostgreSQL 15 ist serverseitige Komprimierung jedoch sinnvoll und funktioniert transparent mit dem Plain-Format. Clientseitige Komprimierung wird weiterhin abgelehnt. -
PostgreSQL-Konfiguration während eines benutzerdefinierten Bootstraps nicht neu laden (Alexander Kukushkin)
Ein benutzerdefinierter Bootstrap kann komplex sein und PostgreSQL mehrfach starten und stoppen. Das Neuladen der PostgreSQL-Konfiguration während dieses Vorgangs konnte zu unerwartetem Verhalten führen.
-
Prüfen, ob
postgresql.parametersein Dictionary ist (Alexander Kukushkin)Eine neue Konfiguration wird verworfen, wenn
postgresql.parameterskein Dictionary ist.
Version 4.1.0
Veröffentlicht am 2025-09-23
Neue Funktionen
-
Unterstützung für den systemd-Unit-Typ „notify“ hinzufügen (Ronan Dunklau)
Ohne den Unit-Typ notify ist es möglich, Patroni zu starten und ihm unmittelbar über systemd ein SIGHUP-Signal zu senden. Dadurch wird Patroni beendet, bevor es seine Signal-Handler einrichten konnte.
-
Informationen zu empfangener und wiedergegebener LSN sowie zum jeweiligen Rückstand in API und ctl bereitstellen (Polina Bungina)
Der Patroni-REST-API-Endpunkt
/clusterund der Befehlpatronictl listliefern jetzt für jedes Replikatmitglied die empfangene LSN, die wiedergegebene LSN, den Empfangsrückstand und den Wiedergaberückstand. -
Saubere Herabstufung zu einem Standby-Cluster sicherstellen (Polina Bungina)
Das Hinzufügen des Abschnitts standby_cluster in der dynamischen Konfiguration führt zu einer sauberen Herabstufung des Clusters.
-
Die Befehle
patronictl demote-clusterundpromote-clusterimplementieren (Polina Bungina)Die neuen Befehle zur Herabstufung und Hochstufung eines Clusters übernehmen sowohl die Bearbeitung der dynamischen Konfiguration als auch die Prüfung des Ergebnisstatus.
-
Tag
sync_priorityimplementieren (Polina Bungina)Dieser Parameter steuert die Priorität eines Mitglieds bei der Auswahl synchroner Replikate, wenn synchronous_mode auf
ongesetzt ist. -
Option
--printfür--validate-configimplementieren (Polina Bungina)Nach erfolgreicher Validierung wird die lokale Konfiguration ausgegeben, einschließlich der durch Umgebungsvariablen überschriebenen Einstellungen.
-
kubernetes.bootstrap_labelsimplementieren (Polina Bungina)Mit dieser Funktion können Labels definiert werden, die dem Pod eines Mitglieds in den Zuständen
initializing new cluster,running custom bootstrap script,starting after custom bootstrapodercreating replicazugewiesen werden. -
Konfigurationsoption zur Unterdrückung doppelter Heartbeat-Protokollmeldungen hinzufügen (Michael Morris)
Ist die Option auf
truegesetzt, werden aufeinanderfolgende identische Heartbeat-Protokollmeldungen nicht ausgegeben. -
Optionales Attribut
cluster_typefür permanente Replikations-Slots hinzufügen (Michael Banck)Damit lässt sich festlegen, ob ein bestimmter permanenter Replikations-Slot immer oder nur auf einem Primär- beziehungsweise Standby-Cluster erstellt werden soll.
-
HTTP-Server-Header konfigurierbar machen (David Grierson)
Der Konfigurationsparameter
restapi.server_tokenswurde eingeführt. Er ermöglicht es, die im HTTP-Server-Header offengelegten Informationen einzuschränken. -
Readiness-Prüfungen der API für die Replikation auf Replikatmitgliedern implementieren (Ants Aasma)
Die bisherige Implementierung betrachtete Replikate als bereit, sobald PostgreSQL gestartet war. Mit dieser Änderung gilt ein Replikat-Pod erst dann als bereit, wenn PostgreSQL repliziert und nicht zu weit hinter dem Leader zurückliegt.
Verbesserungen
-
Protokollstufe für Fehler bei der Watchdog-Konfiguration senken (Ants Aasma)
Die Protokollzeile
Could not activate Linux watchdog devicewird auf der Debug-Stufe ausgegeben, sofern der Watchdog nicht im Modusrequiredkonfiguriert ist. Zuvor wurde sie auf der Info-Stufe ausgegeben. -
written_lsnundlatest_end_lsnauspg_stat_wal_receivernutzen (Alexander Kukushkin)written_lsn, die tatsächliche Schreib-LSN, wird jetzt dem vonpg_last_wal_receive_lsn()gelieferten Wert vorgezogen, der tatsächlich die Flush-LSN ist.latest_end_lsnverweist auf die auf dem Quellhost dauerhaft auf den Datenträger geschriebene WAL-Position. Bei einem Primärserver ermöglicht dies eine genauere Berechnung des Wiedergaberückstands, da die im DCS gespeicherten Werte nur alleloop_waitSekunden aktualisiert werden. -
Interaktionen mit Slots vermeiden, die mit der Option
failover=trueerstellt wurden (Alexander Kukushkin)Diese Änderung ist erforderlich, damit die Funktion für logische Failover-Slots vollständig funktioniert.
-
PostgreSQL-Zustand zum REST-API-Endpunkt
/metricshinzufügen (Ivan Filianin)Informationen zum Zustand der PostgreSQL-Instanz sind jetzt in der Ausgabe des REST-API-Endpunkts
/metricsim Prometheus-Format verfügbar.
Version 4.0.7
Veröffentlicht am 2025-09-22
Neue Funktionen
-
Unterstützung für PostgreSQL 18 RC1 hinzufügen (Alexander Kukushkin)
Die Validierungsregeln für GUCs wurden erweitert. Patroni behandelt den neuen Hintergrund-Worker für I/O jetzt korrekt.
Fehlerbehebungen
-
Mögliches Problem bei der Auflösung von localhost zu IPv6 unter Windows beheben (András Váczi)
Bei der Konfiguration von
listen_addressesin PostgreSQL beschränken0.0.0.0oder127.0.0.1die Adressen, auf denen PostgreSQL lauscht auf IPv4 und schließen IPv6 aus. Auf typischen Windows-Systemen wirdlocalhostjedoch häufig standardmäßig zur IPv6-Adresse::1aufgelöst. Um Kompatibilität sicherzustellen, konfiguriert Patroni PostgreSQL auf Windows-Systemen jetzt so, dass es auf127.0.0.1statt auflocalhostlauscht. -
Globale Konfiguration nur zurückgeben, wenn der Schlüssel
/configim DCS vorhanden ist (Alexander Kukushkin)Die Patroni-REST-API gab eine leere Konfiguration zurück, statt einen Fehler auszulösen, wenn der Schlüssel
/configim DCS fehlte. -
Fehler beheben, durch den bei nicht verfügbarem etcd der Failsafe-Modus nicht ausgelöst wurde (Alexander Kukushkin)
Patroni behandelte
etcd3-Ausnahmen nicht immer korrekt, weshalb der Failsafe-Modus nicht ausgelöst wurde. -
Deadlock durch erneuten Eintritt in einen Signal-Handler beheben (Waynerv)
Bei Patroni in einem Docker-Container mit
PID=1kam es in bestimmten Fällen nach dem Empfang vonSIGCHLDzu einem Deadlock. -
Einen (permanenten) physischen Slot neu erstellen, wenn er kein WAL reserviert (Israel Barth Rubio)
Permanente physische Replikations-Slots, die außerhalb der Verwaltung durch Patroni ohne WAL-Reservierung erstellt wurden, verursachten den Fehler
replication slot cannot be advanced. Um dies zu vermeiden, erstellt Patroni solche Slots jetzt neu. -
Watch-Abbruchmeldungen in
etcd3korrekt behandeln (Alexander Kukushkin)Wenn
etcd3eine Abbruchmeldung an den Watch-Kanal sendet, wird die Verbindung nicht geschlossen. Dadurch verwendet Patroni veraltete Daten. Patroni löst dies jetzt, indem es die Schleife zum Lesen der in Blöcken übertragenen Antwort abbricht und die Verbindung auf seiner Seite schließt. -
Mit
pyopensslumschlosseneHTTPConnection-Sockets behandeln (Alexander Kukushkin)Patroni verwendete die durch
python-etcderzwungenenpyopenssl-Schnittstellen nicht korrekt.
Verbesserungen der Dokumentation
-
Hinweise zu Clustern mit 2 Knoten verbessern (Nikolay Samokhvalov)
Das Verhalten beim Failover und die Anforderungen an den DCS wurden präzisiert.
Version 4.0.6
Veröffentlicht am 2025-06-06
Fehlerbehebungen
-
Fehler beim Failover von einem Leader mit höherer Priorität beheben (Alexander Kukushkin)
Patroni ignoriert den früheren Leader mit höherer Priorität, wenn dieser dieselbe
LSNwie der aktuelle Knoten meldet. -
Berechtigungen für außerhalb von
PGDATAerstellte Dateienpostgresql.confkorrigieren (Michael Banck)Beim Erstellen der Datei
postgresql.confaußerhalb des VerzeichnissesPGDATAwird der systemweite umask-Wert berücksichtigt. -
Fehler beim Switchover mit
synchronous_mode=quorumbeheben (Alexander Kukushkin)Wenn ein Kandidat angegeben ist, werden die Quorum-Anforderungen nicht geprüft.
-
Veraltete etcd-Knoten durch Vergleich der Cluster-Amtszeit ignorieren (Alexander Kukushkin)
Der zuletzt bekannte Wert von „raft_term“ des etcd-Clusters wird gespeichert und beim Ausführen von Client-Anfragen mit dem von einem etcd-Knoten gemeldeten Wert von „raft_term“ verglichen.
-
PostgreSQL-Konfigurationsdateien bei
SIGHUPaktualisieren (Alexander Kukushkin)Zuvor ersetzte Patroni PostgreSQL-Konfigurationsdateien nur, wenn eine Änderung an der globalen oder lokalen Konfiguration erkannt wurde.
-
Von
etcd3ausgelöste AusnahmeUnavailablekorrekt behandeln (Alexander Kukushkin)Patroni wiederholte solche Anfragen zuvor auf demselben
etcd3-Knoten. Der Wechsel zu einem anderen Knoten ist jedoch die bessere Strategie. -
Lease-Behandlung von
etcd3verbessern (Alexander Kukushkin)Patroni erneuert die
etcd3-Lease mindestens einmal pro HA-Schleifendurchlauf. -
Bei Statuscode 409 während des Versuchs, den Leader-Lock zu erwerben, die Annotationen erneut prüfen (Alexander Kukushkin)
Dasselbe Verhalten wie beim Lesen des Leader-Objekts in Patroni-Version 4.0.3 wurde implementiert.
-
replay_lsnbeim Vorrücken von Slots berücksichtigen (Polina Bungina)Slots auf Replikaten werden nicht über
replay_lsnhinaus vorgerückt. Außerdem wird der Slot bis zur Positionreplay_lsnvorgerückt, wenn diese bereits größer als dieconfirmed_flush_lsndieses Slots auf dem Replikat ist, das Replikat aber die tatsächlicheLSN, an der sich der Slot auf dem Primärserver befindet, noch nicht wiedergegeben hat. -
Ausführung von
CHECKPOINTnach einer Hochstufung sicherstellen (Alexander Kukushkin)Es konnte vorkommen, dass die Checkpoint-Aufgabe beim Herabstufen nicht zurückgesetzt wurde, weil
CHECKPOINTnoch nicht abgeschlossen war. Dadurch wurde beim Auslösen der nächsten Hochstufung ein veraltetesresultverwendet. -
Gleichzeitige „offline“-Herabstufungen vermeiden (Alexander Kukushkin)
Bei langsamem Herunterfahren konnte die nächste Heartbeat-Schleife erneut die Methode zur DCS-Fehlerbehandlung aufrufen. Dies führte zur Warnung
AsyncExecutor is busy, demoting from the main threadund zu einem erneuten Start der Offline-Herabstufung. -
Wert von
data_dirvor dem Umbenennen des Datenverzeichnisses nach fehlgeschlagener Initialisierung normalisieren (Waynerv)Ein abschließender Schrägstrich im Parameterwert
data_dirunterbricht dadurch nicht mehr das Umbenennen nach einer fehlgeschlagenen Initialisierung. -
Prüfen, ob
synchronous_standby_namesden erwarteten Wert enthält (Alexander Kukushkin)Der Zustandsautomat für synchrone Replikation ohne Quorum prüfte zuvor den tatsächlichen Wert von
synchronous_standby_namesnicht. Dies führte dazu, dass ein veralteter Wert vonsynchronous_standby_namesverwendet wurde, wennpg_stat_replicationeine Teilmenge vonsynchronous_standby_nameswar.
Version 4.0.5
Veröffentlicht am 2025-02-20
Verbesserungen der Stabilität
-
Kompatibilität mit
python-json-logger>=3.1(Alexander Kukushkin)Die durch Verwendung der alten API erzeugten Warnungen wurden beseitigt.
-
Kompatibilität mit Python 3.13 (Alexander Kukushkin)
Tests werden mit Python 3.13 ausgeführt.
-
Kompatibilität mit
pyinstaller>=4.4(Joe Jensen)Wenn das Attribut
tocvonpyinstallerfehlt, wird auf das standardmäßigeiter_moduleszurückgegriffen. -
Probleme bei der Unterstützung von PostgreSQL 9.5 behoben (Alexander Kukushkin)
- Das Ausgabeformat von
pg_rewindwird korrekt behandelt. - Es wird berücksichtigt, dass das Format von
synchronous_standby_nameskeine Angabe von „num“ unterstützt.
- Das Ausgabeformat von
-
Kompatibilität mit den neuesten Änderungen in
urlparse(Alexander Kukushkin)urlparseakzeptiert keine URLs mit mehreren Hosts und den Zeichen[]mehr. Um das Problem zu umgehen, werden nach Möglichkeit die nativen Wrapper vonPQconninfoParse()auslibpqverwendet. Die eigene Implementierung wird nur noch für älterepsycopg2-Versionen genutzt, die gegen eine veraltetelibpq-Version gelinkt sind.
Fehlerbehebungen
-
Bei der Neustartbestätigung nur die tatsächlich neu zu startenden Mitglieder angezeigt (András Váczi)
Zuvor listete die Bestätigung bei
patronictl restart <clustername> --pendingalle Mitglieder auf, unabhängig davon, ob bei ihnen ein Neustart ausstand. -
Lang laufende Aufgaben beim Stoppen von Patroni abgebrochen und Datenverzeichnis bei fehlgeschlagenem Replikat-Bootstrap entfernt (Alexander Kukushkin)
Zuvor konnte Patroni während eines Replikat-Bootstraps stoppen, während
pg_basebackup/wal-g/pgBackRest/barmanoder ähnliche Programme weiterliefen. -
Clusternamen mit Schrägstrich in
patronictl edit-configkorrekt behandelt (Antoni Mur)Ein Schrägstrich in
cluster_namewird durch einen Unterstrich ersetzt. -
Zu frühes Löschen physischer Slots vermieden (Alexander Kukushkin)
Nach einem Failover wird das Entfernen physischer Replikationsslots mit
xminaufgeschoben: auf dem neuen Primärserver bis zu dessen Hochstufung, auf Replikaten bis ein Leader im Cluster vorhanden ist. -
Alle von subprocess in
controldata()ausgelösten Ausnahmen behandelt (Alexander Kukushkin)Patroni behandelte nicht alle Ausnahmen korrekt, die beim Aufruf des Werkzeugs
pg_controldataauftreten können. -
Fehler behoben, durch den der Slot für einen früheren Leader beim Failover nicht erhalten blieb (Alexander Kukushkin)
Patroni verlässt sich nicht mehr fälschlich auf die Anwesenheit von Mitgliedern im DCS, während beim Failover der Schlüssel
/memberdes früheren Leaders genau zur selben Zeit abläuft. -
Mehrere Fehler im Quorum-Zustandsautomaten behoben (Alexander Kukushkin)
- Bei der Prüfung, ob funktionsfähige Knoten für die Leader-Wahl vorhanden sind, müssen vor der Herabstufung die Quorum-Anforderungen berücksichtigt werden. Andernfalls kann der frühere Leader in Recovery gelangen und nur von asynchronen Knoten umgeben sein.
QuorumStateResolverbehandelte den Fall nicht korrekt, dass ein Replikatknoten schnell beitrat und sich wieder trennte.
Verbesserungen
-
Fehlermeldung für eine leere Konfigurationsdatei oder einen Inhalt, der kein Dictionary ist, verbessert (Julian)
Bei der Prüfung, ob die Patroni-Konfigurationsdatei ein gültiges
Mapping-Objekt enthält, wird eine aussagekräftigere Ausnahme ausgelöst.
Version 4.0.4
Veröffentlicht am 2024-11-22
Verbesserungen der Stabilität
-
Kompatibilität mit dem Modul
py-consulhinzugefügt (Alexander Kukushkin)Das Modul
python-consulwird seit Langem nicht mehr gepflegt;py-consulist der offizielle Ersatz. Die Rückwärtskompatibilität mit python-consul bleibt erhalten. -
Kompatibilität mit dem Modul
prettytable>=3.12.0hinzugefügt (Alexander Kukushkin)Warnungen zu veralteten Funktionen wurden behoben.
-
Kompatibilität mit dem Modul
ydiff==1.4.2(Alexander Kukushkin)Kompatibilitätsprobleme mit der neuesten Version wurden behoben, die Version in
requirements.txteingeschränkt und ein Kompatibilitätstest für die neueste Version eingeführt.
Fehlerbehebungen
-
Callback
on_role_changenach fehlgeschlagener Recovery des Primärservers ausgeführt (Polina Bungina, Alexander Kukushkin)on_role_changewird zusätzlich für einen Primärserver aufgerufen, der nach einem Absturz nicht starten konnte. Dadurch steigt die Wahrscheinlichkeit, dass der Callback ausgeführt wird, auch wenn der anschließende Start als Replikat fehlschlägt. -
Thread-Leck in
patronictl list -Wbehoben (Alexander Kukushkin)Das DCS-Instanzobjekt wird zwischengespeichert, um das Thread-Leck zu vermeiden.
-
Nur unterstützte Parameter in die Verbindungszeichenkette geschrieben (Alexander Kukushkin)
Patroni übergab zuvor in neueren Versionen eingeführte Parameter in der Verbindungszeichenkette, was zu Verbindungsfehlern führte.
Version 4.0.3
Veröffentlicht am 2024-10-18
Fehlerbehebungen
-
pgauditbei der Benutzererstellung deaktiviert, damit Passwörter nicht offengelegt werden (kviset)Bei aktivierter Erweiterung
pgauditprotokollierte Patroni bei der Erstellung die Passwörter fürsuperuser,replicationundrewind. -
Problem bei gemischten Installationen mit Primärserver vor Patroni v4 und Replikaten mit v4+ behoben (Alexander Kukushkin)
Wenn auf dem Leader eine Patroni-Version vor 4.0.0 läuft, wird
xlog_locationaus dem Schlüssel/membersverwendet, statt die Slot-Position eines Mitglieds aus/statuszu lesen. Das bisherige Verhalten führte zur Ansammlung von WAL auf Replikaten. -
Gültige PostgreSQL-GUCs ohne Patroni-Validator nicht ignoriert (Polina Bungina)
Wenn eine GUC keinen Patroni-Validator besitzt, aber tatsächlich gültig ist, wird sie weiterhin anhand von
postgres --describe-configgeprüft.
Verbesserungen
-
Bei Statuscode 409 beim Lesen des Leader-Objekts in K8s die Annotationen erneut geprüft (Alexander Kukushkin)
Eine zusätzliche Aktualisierung wird vermieden, wenn Patroni die
PATCH-Anfrage abgebrochen hat, diese das Ziel aber erfolgreich aktualisiert hat. -
Clientseitige Verbindungsoption
sslnegotiationunterstützt (Alexander Kukushkin)sslnegotiationwurde der endgültigen PostgreSQL-Version 17 hinzugefügt.
Version 4.0.2
Veröffentlicht am 2024-09-17
Fehlerbehebungen
-
Ausnahmen beim Auffinden von Dateien zur Konfigurationsvalidierung behandelt (Alexander Kukushkin)
Verzeichnisse werden übersprungen, wenn Patroni keine ausreichenden Berechtigungen zum Auflisten besitzt.
-
Inaktive physische Hot-Replikationsslots halten kein
xminmehr fest (Alexander Kukushkin, Polina Bungina)Seit Version 3.2.0 erstellt Patroni auf Replikaten physische Replikationsslots für alle Mitglieder und rückt sie regelmäßig mit
pg_replication_slot_advance()vor. Ist jedoch aus irgendeinem Grundhot_standby_feedbackaktiviert und wird der Primärserver zum Replikat herabgestuft, wird derNOT NULL-Wert vonxminder nun inaktiven Slots an den neuen Primärserver zurückgemeldet. Dadurch rückt derxmin-Horizont nicht vor und vacuum kann tote Tupel nicht entfernen. Mit dieser Korrektur erstellt Patroni physische Replikationsslots neu, die inaktiv sein sollten, aber einenNOT NULL-Wert fürxminbesitzen. -
Unbehandelten
DCSErrorwährend der Startphase behoben (Waynerv)Vor der Prüfung auf Eindeutigkeit des Knotennamens wird die Verbindung zum DCS sichergestellt.
-
GUCs aus
CMDLINE_OPTIONSbeim Abfragen vonpg_settingsausdrücklich eingeschlossen (Alexander Kukushkin)Wenn Patroni einen laufenden Standby übernimmt, werden alle GUCs wiederhergestellt, die als Befehlszeilenparameter an postmaster übergeben werden. Dies ergänzt die Fehlerbehebung aus Patroni 3.2.2.
-
Fehler in der Anführungszeichenlogik von
synchronous_standby_namesbehoben (Alexander Kukushkin)Laut PostgreSQL-Dokumentation müssen die Schlüsselwörter
ANYundFIRSTin doppelte Anführungszeichen gesetzt werden. Patroni tat dies zuvor nicht. -
Überschreitung des Wertebereichs für Verbindungs-Keepalives behoben (hadizamani021)
Der anhand von
ttlberechnete Wert der Optionkeepaliveüberschreitet nicht mehr den für die aktuelle Plattform zulässigen Höchstwert.
Version 4.0.1
Veröffentlicht am 2024-08-30
Fehlerbehebung
-
Patroni erstellte unnötige Replikationsslots für sich selbst (Alexander Kukushkin)
Dies geschah, wenn
nameGroßbuchstaben oder Sonderzeichen enthielt.
Version 4.0.0
Veröffentlicht am 2024-08-29
- Diese Version schließt die Ablösung des Begriffs „master“ durch „primary“ ab. Damit sind einige inkompatible Änderungen verbunden; lesen Sie die Versionshinweise sorgfältig. Das Upgrade auf Patroni 4+ funktioniert nur zuverlässig, wenn Patroni 3.1.0 oder neuer verwendet wird. Ein direktes Upgrade von einer älteren Version auf 4+ ist möglich, kann aber zu unerwartetem Verhalten führen, wenn der Primärserver ausfällt, während die übrigen Knoten andere Patroni-Versionen ausführen.
Inkompatible Änderungen
- Beim Entfernen des nicht inklusiven Begriffs „master“ aus dem Patroni-Code wurden folgende inkompatible Änderungen eingeführt:
- Auf Kubernetes setzt Patroni das Label
rolestandardmäßig aufprimary. Um das bisherige Verhalten beizubehalten und Ausfallzeiten oder langwierige, komplexe Migrationen zu vermeiden, können die Parameterkubernetes.leader_label_valueundkubernetes.standby_leader_label_valueaufmastergesetzt werden. Weitere Informationen finden sich hier . - Die Patroni-Rolle wird als
primarystatt alsmasterin den DCS geschrieben. - Die von der Patroni-REST-API zurückgegebene Rolle wurde von
masterinprimarygeändert. - Die Patroni-REST-API akzeptiert
role=masterin Anfragen an die Endpunkte/switchover,/failoverund/restartnicht mehr. - Der REST-API-Endpunkt
/metricsmeldet die Metrikpatroni_masternicht mehr. - patronictl
akzeptiert die Option
--masterfür keinen Befehl mehr. Stattdessen sollten--leaderoder--primaryverwendet werden. - Die Option
no_masterin der deklarativen Konfiguration benutzerdefinierter Methoden zur Replikaterstellung wird nicht mehr als besondere Option behandelt; verwenden Sie stattdessenno_leader. - Das Skript
patroni_wale_restoreakzeptiert die Option--no_masternicht mehr. - Das Skript
patroni_barmanakzeptiert die Option--role=masternicht mehr. - Allen Callback-Skripten wird bei der Ausführung die Option
role=primarystattrole=masterübergeben.
- Auf Kubernetes setzt Patroni das Label
patronictl failoverakzeptiert die seit Patroni 3.2.0 veraltete Option--leadernicht mehr.- Die seit Patroni 3.2.0 veraltete Funktion zur Benutzererstellung im Konfigurationsabschnitt
bootstrap.userswurde entfernt.
Neue Funktionen
-
Quorumbasiertes Failover (Ants Aasma, Alexander Kukushkin)
Diese Funktion implementiert quorumbasierte synchrone Replikation, die ab PostgreSQL v10 verfügbar ist. Sie hilft, selbst im Normalbetrieb die maximal auftretenden Latenzen zu verringern, weil eine höhere Replikationslatenz zu einem Standby durch andere Standbys ausgeglichen werden kann. Patroni implementiert zusätzliche Schutzmaßnahmen gegen jeden für Benutzer sichtbaren Datenverlust, indem es den Failover-Kandidaten anhand der zuletzt empfangenen Transaktion auswählt.
-
Citus-Sekundärknoten in
pg_dist_noderegistriert (Alexander Kukushkin)Patroni verwaltet jetzt in
pg_dist_nodedie Liste der Knoten mitrole==replica,state==runningund ohne den Tagnoloadbalance. -
Aufbewahrungsdauer der Replikationsslots von Mitgliedern konfigurierbar gemacht (Alexander Kukushkin)
Der globale Konfigurationsparameter
member_slots_ttlwird unterstützt. Er steuert, wie lange die Replikationsslots eines Mitglieds erhalten bleiben sollen, wenn dessen Mitgliedsschlüssel fehlt. -
Berechtigungen für von Patroni erstellte Protokolldateien konfigurierbar gemacht (Alexander Kukushkin)
Für von Patroni erstellte Protokolldateien können bestimmte Berechtigungen festgelegt werden. Ohne Angabe werden die Berechtigungen anhand des aktuellen Werts von
umaskgesetzt. -
Kompatibilität mit PostgreSQL 17 beta3 (Alexander Kukushkin)
Die Validierungsregeln für GUCs wurden erweitert. Patroni behandelt beim Herunterfahren alle neuen Hilfs-Backends und setzt
dbnameinprimary_conninfo, da dies für die Synchronisierung logischer Replikationsslots erforderlich ist. -
Option
--ignore-listen-portfür die Validierung der Patroni-Konfiguration implementiert (Sahil Naphade)Bei der Ausführung von
patroni --validate-configkönnen bereits belegte Ports ignoriert werden.
Verbesserungen
-
wal_log_hintskonfigurierbar gemacht (Paul_Kim)Damit lässt sich der Mehraufwand durch aktiviertes
wal_log_hintsvermeiden, wennuse_pg_rewindaufoffgesetzt ist. -
Befehl
pg_basebackupauf StufeDEBUGprotokolliert (Waynerv)Dies erleichtert die Diagnose fehlgeschlagener Initialisierungen.
Fehlerbehebungen
-
Permanente Slots für kaskadierende Knoten im Failsafe-Modus vorgerückt (Alexander Kukushkin)
Bei aktiviertem Failsafe-Modus werden die Slots kaskadierender Replikate auf dem Primärserver korrekt vorgerückt. Dazu wird die Antwort der Replikate auf die REST-API-Anfrage
POST /failsafeum derenxlog_locationergänzt. -
Auswahl des aktuellen Knotens als synchronen Knoten verhindert (Alexander Kukushkin)
Es kann „etwas“ vom aktuellen Primärserver streamen, dessen
application_namedem Namen des Primärservers entspricht. Patroni behandelte diese Situation nicht korrekt. Dadurch konnte der Primärserver als synchroner Knoten deklariert werden, was anschließend Switchovers blockierte. -
restapi.allowlist_include_membersbei POST /failsafe ignoriert (Alexander Kukushkin) -
Validierung von GUCs verbessert (Polina Bungina)
Wegen der zusätzlichen Validierung durch
postgres --describe-configkonnten GUCs, die dort nicht aufgeführt waren, zuvor nicht über die Patroni-Konfiguration gesetzt werden. Diese Einschränkung wurde entfernt. -
Bei erkannten Unix-Sockets eine Zeile mit
localhostzur Datei.pgpasshinzugefügt (Alexander Kukushkin)Patroni ergänzt
.pgpassum eine weitere Zeile, wenn der angegebene Parameterhostmit/beginnt. Damit wird der Sonderfall abgedeckt, dasshostdem Pfad des standardmäßigen Socket-Verzeichnisses entspricht. -
Probleme bei der Protokollierung behoben (Waynerv)
In den Protokollen der Failsafe-Behandlung wurde die korrekte Anfrage-URL festgelegt und die Reihenfolge der Zeitstempel im Protokoll der postmaster-Prüfung korrigiert.
Version 3.3.2
Veröffentlicht am 2024-07-11
Fehlerbehebungen
-
Natives synchrones Replikationsverhalten von Postgres korrigiert (Israel Barth Rubio)
Seit Einführung von synchronous_mode in Patroni funktionierte die native synchrone Replikation von Postgres nicht. Mit dieser Korrektur setzt Patroni
synchronous_standby_namesauf den vom Benutzer konfigurierten Wert, sofern ein solcher vorhanden ist, wenn synchronous_mode deaktiviert ist. -
Ungültigwerden logischer Slots auf einem Standby behandelt (Polina Bungina)
Seit PG16 können logische Replikationsslots auf einem Standby aufgrund des Horizonts ungültig werden. Patroni erzwingt jetzt das Kopieren, also die Neuerstellung, ungültiger Slots.
-
Race Condition beim Vorrücken und Kopieren logischer Slots behoben (Alexander Kukushkin)
Aufgrund dieses Fehlers konnte ein ungültiger logischer Replikationsslot mehrfach mit einem PostgreSQL-Neustart kopiert werden.
Version 3.3.1
Veröffentlicht am 2024-06-17
Verbesserungen der Stabilität
-
Kompatibilität mit Python 3.12 (Alexander Kukushkin)
Ein neues Attribut von
logging.LogRecordwird berücksichtigt.
Fehlerbehebungen
-
Endlose Rekursion bei der Verarbeitung von
replicatefrom-Tags behoben (Alexander Kukushkin)Im Zuge dieser Korrektur wurden außerdem die Prüfung
is_physical_slot()verbessert und die Dokumentation angepasst. -
Falsche Rollenmeldungen in Standby-Clustern behoben (Alexander Kukushkin)
synchronous_standby_namesund synchrone Replikation funktionieren nur auf einem tatsächlichen Primärserver. Bei kaskadierender Replikation werden sie von Postgres schlicht ignoriert. Vor dieser Korrektur meldetenpatronictl listundGET /clustermanche Knoten fälschlich als synchron. -
Verfügbarkeit der GUC
allow_in_place_tablespaceskorrigiert (Polina Bungina)allow_in_place_tablespaceswurde nicht nur PostgreSQL 15 hinzugefügt, sondern auch auf PostgreSQL 10-14 zurückportiert.
Version 3.3.0
Veröffentlicht am 2024-04-04
Alle älteren Patroni-Versionen sind mit ydiff>=1.3 inkompatibel.
Folgende Möglichkeiten stehen zur „Behebung“ des Problems zur Verfügung:
- Patroni auf die neueste Version aktualisieren
- Nach der Installation von Patroni
ydiff<1.3installieren - Das Modul
cdiffinstallieren
Neue Funktionen
-
Übergabe von
auth_dataan den Zookeeper-Client ermöglicht (Aras Mumcuyan)Damit können die für die Verbindung zu verwendenden Authentifizierungsdaten angegeben werden.
-
Contrib-Skript für die Integration von
Barmanhinzugefügt (Israel Barth Rubio)Die Anwendung
patroni_barmanermöglicht die entfernte Ausführung vonBarman-Operationen. Sie kann als benutzerdefinierte Bootstrap- oder Replikaterstellungsmethode oder als Callbackon_role_changeverwendet werden. Weitere Informationen finden sich hier . -
Protokollformat
JSONunterstützt (alisalemmi)Neben
plain, dem Standard, unterstützt Patroni jetzt das Protokollformatjson. Dafür muss die Bibliothekpython-json-logger>=2.0.2installiert sein. -
Informationen zu
pending_restart_reasonangezeigt (Polina Bungina)Erweiterte Informationen zu den PostgreSQL-Parametern werden bereitgestellt, die das Setzen des Kennzeichens
pending_restartverursacht haben. Sowohlpatronictl listals auch der REST-API-Endpunkt/patronizeigen jetzt die Parameternamen und deren Unterschiede alspending_restart_reasonan. -
Tag
nostreamimplementiert (Grigory Smolkin)Wenn
nostreamauftruegesetzt ist, verwendet der Knoten nicht das Replikationsprotokoll zum Streamen von WAL, sondern die Archiv-Recovery, sofernrestore_commandkonfiguriert ist. Außerdem werden das Kopieren und Synchronisieren permanenter logischer Replikationsslots auf dem Knoten selbst und allen seinen kaskadierenden Replikaten deaktiviert.
Verbesserungen
-
Validierung des Abschnitts
logimplementiert (Alexander Kukushkin)Bisher prüfte der Validator nicht, ob die angegebene Protokollierungskonfiguration korrekt war.
-
Protokollierung von Änderungen an PostgreSQL-Parametern verbessert (Polina Bungina)
Alte Werte werden in ein menschenlesbares Format umgewandelt und Abweichungen zwischen
pg_controldataund der globalen Patroni-Konfiguration protokolliert.
Fehlerbehebungen
-
Nicht zulässige Optionen von
pg_basebackupkorrekt herausgefiltert (Israel Barth Rubio)Aufgrund eines Fehlers filterte Patroni unzulässige Optionen für die Replikat-Bootstrap-Methode
basebackupnicht korrekt heraus, wenn sie im Format- setting: valueangegeben wurden. -
Behandlung von
etcd3-Authentifizierungsfehlern korrigiert (Alexander Kukushkin)Bei einem
etcd3-Authentifizierungsfehler wird immer ein Wiederholungsversuch durchgeführt, sofern die Authentifizierung nicht unmittelbar vor Ausführung der Anfrage erfolgte. Außerdem werden Watcher bei erneuter Authentifizierung nicht neu gestartet. -
Logik zum Auffinden von Validierungsdateien verbessert (Waynerv)
Nach Möglichkeit wird die Bibliothek
importlibverwendet, um Dateien mit verfügbaren Konfigurationsparametern zu finden, ab Python 3.9+. Diese Implementierung ist stabiler und beeinträchtigt keine Patroni-Distributionen auf Basis vonzip-Archiven. -
target_session_attrsnur bei mehreren Hosts im Abschnitt standby_cluster verwendet (Alexander Kukushkin)target_session_attrs=read-writewird auf dem Standby-Leader nur noch dann zuprimary_conninfohinzugefügt, wennstandby_cluster.hostmehrere durch Kommas getrennte Hosts enthält. -
Kompatibilitätscode für Version 1.3+ der Bibliothek
ydiffhinzugefügt (Alexander Kukushkin)Patroni nutzt Teile der nicht öffentlichen API von
ydiff, da dieses eigentlich als Terminalwerkzeug und nicht als Python-Modul gedacht ist. Die API-Änderung in 1.3 machte ältere Patroni-Versionen leider funktionsunfähig.
Version 3.2.2
Veröffentlicht am 2024-01-17
Fehlerbehebungen
-
Wiederherstellung des initialize-Schlüssels durch ein Replikat nach dem Löschen des DCS verhindert (Alexander Kukushkin)
Dies geschah in der Methode, in der Patroni einen eigenständigen PG-Cluster übernehmen sollte.
-
Konsistentes Lesen beim Abruf eines gerade aktualisierten sync-Schlüssels aus Consul verwendet (Alexander Kukushkin)
Consul bietet keine Schnittstelle, um
ModifyIndexfür einen gerade aktualisierten Schlüssel sofort zu ermitteln. Daher ist ein ausdrücklicher Lesevorgang erforderlich. Weil veraltete Leseergebnisse standardmäßig erlaubt sind, wurde dabei manchmal eine veraltete Schlüsselversion abgerufen. -
Postgres-Konfiguration wird neu geladen, wenn ein Parameter, der einen Neustart erfordert, auf seinen ursprünglichen Wert zurückgesetzt wurde (Polina Bungina)
Zuvor aktualisierte Patroni die Konfiguration nicht, sondern setzte lediglich
pending_restartzurück. -
Fälschlich invertierte Logik der Bestätigungsabfrage beim Failover zu einem asynchronen Kandidaten im synchronen Modus korrigiert (Polina Bungina)
Das Problem bestand nur in patronictl .
-
Leader von Failover-Kandidaten in patronictl ausgeschlossen (Polina Bungina)
In einem funktionsfähigen Cluster hat ein Failover zum vorhandenen Leader keine Wirkung.
-
Citus-Datenbank und -Erweiterung idempotent erstellt (Alexander Kukushkin, Zhao Junwang)
Dadurch können sie im Skript
post_bootstraperstellt werden, wenn weitere Abhängigkeiten zur Citus-Datenbank hinzugefügt werden müssen. -
Widersprüchlichen Tag
nofailovernicht herausgefiltert (Polina Bungina)Die auf einem Knoten gesetzte Konfiguration
{nofailover: false, failover_priority: 0}hinderte ihn an der Teilnahme an der Leader-Wahl. Er sollte jedoch teilnehmen dürfen, da der TagnofailoverVorrang haben sollte. -
Problem mit durch PyInstaller eingefrorenen Anwendungen behoben (Sophia Ruan)
freeze_support()wurde nachargparseaufgerufen, weshalb Patroni Postgres nicht starten konnte. -
Fehler im Konfigurationsgenerator für patronictl und Citus behoben (Israel Barth Rubio)
Der Fehler verhinderte, dass über Umgebungsvariablen gesetzte Konfigurationsparameter für patronictl und Citus in die erzeugte Konfiguration geschrieben wurden.
-
Recovery-GUCs und einige von Patroni verwaltete Parameter bei der Übernahme eines laufenden Standbys wiederhergestellt (Alexander Kukushkin)
Ab Postgres v12 konnte Patroni Postgres nicht neu starten und meldete einen fehlenden
portin einer internen Struktur. -
Korrekturen am Kennzeichen
pending_restart(Polina Bungina)pending_restartwird während eines benutzerdefinierten Bootstraps mitrecovery_target_action = promotenicht bereitgestellt. Dasselbe gilt, wenn jemandhot_standbyoderwal_log_hintsetwa überALTER SYSTEMgeändert hat.
Version 3.2.1
Veröffentlicht am 2023-11-30
Fehlerbehebungen
-
Zulässige Werte des Arguments
--formatin patronictl begrenzt (Alexander Kukushkin)Zuvor wurden beliebige Zeichenketten akzeptiert und bei einem unbekannten Wert keine Ausgabe erzeugt.
-
Vor Freigabe des Leader-Schlüssels wird geprüft, ob Replikatknoten beim Herunterfahren die Checkpoint-LSN erhalten haben (Alexander Kukushkin)
Zuvor wurde in manchen Fällen die LSN des SWITCH-Eintrags verwendet, auf den bei aktiviertem Archivmodus ein CHECKPOINT folgt. Dadurch musste der frühere Primärserver manchmal
pg_rewindausführen; Datenverlust entstand dabei jedoch nicht. -
Bei der Prüfung auf Eindeutigkeit des Knotennamens eine tatsächliche HTTP-Anfrage ausgeführt (Alexander Kukushkin)
Beim Betrieb von Patroni in Containern kann der Datenverkehr über
docker-proxygeleitet werden, das auf dem Port lauscht und eingehende Verbindungen annimmt. Dies führte zu falsch positiven Ergebnissen. -
Citus-Unterstützung mit etcd v2 korrigiert (Alexander Kukushkin)
Patroni konnte mit etcd v2 keinen neuen Citus-Cluster bereitstellen.
-
Verhalten von
pg_rewindmit Postgres v16+ korrigiert (Alexander Kukushkin)In v16 änderte sich das Format der Fehlermeldung von
pg_waldump, sodass Patronipg_rewindauch dann aufrief, wenn dies nicht erforderlich war. -
Fehler beim benutzerdefinierten Bootstrap behoben (Alexander Kukushkin)
Patroni wandte das Argument
--command, das selbst der Bootstrap-Befehl ist, fälschlich an. -
Problem mit REST-API-Endpunkten für Health Checks behoben (Sophia Ruan)
Nach einem Postgres-Neustart konnte der Zustand von Postgres als
unknownzurückgegeben werden, weil Verbindungen nicht korrekt geschlossen worden waren. -
Ausgabe von
postgres --describe-configzwischengespeichert (Waynerv)Sie dient dazu, die für die Validierung der PostgreSQL-Konfiguration verfügbaren GUCs zu ermitteln. Eine Änderung dieser Liste während der Patroni-Laufzeit wird nicht erwartet.
Version 3.2.0
Veröffentlicht am 2023-10-25
Hinweis auf veraltete Funktionen
- Die Unterstützung für
bootstrap.userswird in Version 4.0.0 entfernt. Falls nach der Bereitstellung eines neuen Clusters Benutzer erstellt werden müssen, verwenden Sie dazu den Hookbootstrap.post_bootstrap.
Inkompatible Änderungen
-
Regel
loop_wait + 2*retry_timeout <= ttlerzwungen und kleinste mögliche Werte fest vorgegeben (Alexander Kukushkin)Mindestwerte:
loop_wait=2,retry_timeout=3,ttl=20. Kleinere Werte oder Werte, die die Regel verletzen, werden angepasst; eine Warnung wird in den Patroni-Protokollen ausgegeben.
Neue Funktionen
-
Failover-Priorität (Mark Pekala)
Mit
tags.failover_prioritykann ein Knoten jetzt bei der Leader-Wahl bevorzugt werden. Weitere Einzelheiten enthält die Dokumentation zu Tags (ref tags). -
patroni --generate-config [--dsn DSN]undpatroni --generate-sample-configimplementiert (Polina Bungina)Damit kann eine Konfigurationsdatei für einen laufenden PostgreSQL-Cluster oder eine Beispielkonfiguration für einen neuen Patroni-Cluster erzeugt werden.
-
Eigene Verbindung zu Postgres für die Patroni-REST-API verwendet (Alexander Kukushkin)
Dies hilft, eine Blockierung der Heartbeat-Hauptschleife bei hoher Systemlast zu vermeiden.
-
Einige Endpunkte um den
namedes Knotens ergänzt (sskserk)Beim Überwachungsendpunkt wird
namenebenscopehinzugefügt; beim Metrikendpunkt wirdnamein die Tags aufgenommen. -
Failover und Switchover strikt unterschieden (Polina Bungina)
Protokollmeldungen werden präziser und ein Failover zu einem asynchronen Knoten in einem funktionsfähigen synchronen Cluster wird ermöglicht.
-
Verhalten permanenter physischer Replikationsslots an permanente logische Slots angeglichen (Alexander Kukushkin)
Permanente physische Replikationsslots werden auf allen Knoten erstellt, die Leader werden dürfen. Auf Standby-Knoten wird
restart_lsnder Slots mitpg_replication_slot_advance()vorgerückt. -
Angabe des Namespace über das Argument
--dcsin patronictl ermöglicht (Israel Barth Rubio)Dies kann nützlich sein, wenn patronictl ohne Konfigurationsdatei verwendet wird.
-
Zusätzliche Parameter in der Konfiguration benutzerdefinierter Bootstraps unterstützt (Israel Barth Rubio)
Zuvor konnten benutzerdefinierte Argumente nur an
commandangehängt werden; jetzt lassen sie sich als Mapping angeben.
Verbesserungen
-
GUC
citus.local_hostnamewird auf denselben Wert gesetzt, den Patroni für die Verbindung zu Postgres verwendet (Alexander Kukushkin)In manchen Fällen benötigt Citus eine Verbindung zum lokalen Postgres. Standardmäßig wird dafür
localhostverwendet, das jedoch nicht immer verfügbar ist.
Fehlerbehebungen
-
Einstellung synchronous_mode in einem Standby-Cluster ignoriert (Polina Bungina)
Postgres unterstützt keine kaskadierende synchrone Replikation. Die Berücksichtigung von synchronous_mode führte daher zum Fehlschlagen eines Switchovers im Standby-Cluster.
-
SIGCHLD für den Callback
on_reloadbehandelt (Alexander Kukushkin)Andernfalls entsteht ein Zombie-Prozess, der erst bei der nächsten Ausführung von
on_reloadaufgeräumt wird. -
Fehler
AuthOldRevisionbei der Arbeit mit etcd v3 behandelt (Alexander Kukushkin, Kenny Do)Der Fehler wird ausgelöst, wenn etcd JWT verwendet und die Benutzerdatenbank in etcd aktualisiert wird.
Version 3.1.2
Veröffentlicht am 2023-09-26
Fehlerbehebungen
-
Fehler bei Prüfungen von
wal_keep_sizebehoben (Alexander Kukushkin)Die GUC
wal_keep_sizebesitzt normalerweise eine Einheit; Patroni konnte ihren Wert nicht inintumwandeln. Dadurch wurde anschließend der Wert vonbootstrap.dcsnicht in den Schlüssel/configgeschrieben. -
Inkonsistenzen zwischen dem Schlüssel
/syncundsynchronous_standby_nameserkannt und behoben (Alexander Kukushkin)Normalerweise aktualisiert Patroni
/syncundsynchronous_standby_namesin einer genau festgelegten Reihenfolge. Bei einem Fehler oder wenn jemandsynchronous_standby_namesmanuell zurücksetzte, geriet Patroni jedoch in einen inkonsistenten Zustand. Dadurch konnte ein Failover zu einem asynchronen Knoten erfolgen. -
GUC-Werte bei der Übernahme eines laufenden Postgres gelesen (Alexander Kukushkin)
Bei einem Neustart im Pause-Modus entfernte Patroni die GUC
synchronous_standby_namesauspostgresql.conf. Um dieses und ähnliche Probleme zu vermeiden, liest Patroni den GUC-Wert, wenn es einen bereits laufenden Postgres übernimmt. -
Störende Warnungen bei der Prüfung auf Eindeutigkeit des Knotens unterdrückt (Alexander Kukushkin)
Bei einem schnellen Patroni-Neustart erzeugt
urllib3Meldungen der StufeWARNING.
Version 3.1.1
Veröffentlicht am 2023-09-20
Fehlerbehebungen
-
Failsafe-Zustand bei der Hochstufung zurückgesetzt (ChenChangAo)
Erfolgte ein Switchover oder Failover kurz nach Aktivierung des Failsafe-Modus, stufte sich der neu hochgestufte Primärserver selbst herab, sobald Failsafe wieder inaktiv wurde.
-
Nutzlose Warnungen in patronictl unterdrückt (Alexander Kukushkin)
Wenn patronictl dieselbe Datei patroni.yaml wie Patroni verwendet und auf das Verzeichnis
PGDATAzugreifen kann, wurden möglicherweise störende Warnungen zu falschen Werten in der globalen Konfiguration angezeigt. -
Synchronen Modus in einem Sonderfall ausdrücklich aktiviert (Alexander Kukushkin)
Wenn keine Replikate vom Primärserver streamten, wurde der synchrone Modus tatsächlich nie aktiviert.
-
Fehler bei der Validierung ganzzahliger Werte von
0behoben (Israel Barth Rubio)Meist verursachte dies keine Probleme, sondern nur Warnungen.
-
Keine logischen Slots für Standby-Cluster zurückgegeben (Alexander Kukushkin)
Patroni kann in einem Standby-Cluster keine logischen Replikationsslots erstellen. Daher sollten sie ignoriert werden, wenn sie in der globalen Konfiguration definiert sind.
-
Anzeige des Docstrings in der Ausgabe von
patronictl --helpvermieden (Israel Barth Rubio)Das Modul
clickbenötigt dafür einen besonderen Hinweis. -
Fehler bei
kubernetes.standby_leader_label_valuebehoben (Alexander Kukushkin)Diese Funktion hatte tatsächlich nie funktioniert.
-
Systemkennung des Clusters wieder in der Ausgabe von
patronictl listangezeigt (Polina Bungina)Das Problem entstand bei der Implementierung der Citus-Unterstützung. Dort muss die Kennung ausgeblendet werden, da sie für den Coordinator und alle Worker unterschiedlich ist.
-
Methode
write_leader_optimein der Kubernetes-Implementierung überschrieben (Alexander Kukushkin)Die Methode soll die LSN beim Herunterfahren in das Endpoint- oder ConfigMap-Objekt des Leaders schreiben, wenn kein funktionsfähiges Replikat als neuer Primärserver zur Verfügung steht.
-
Gestopptes Postgres wird während einer Pause nicht gestartet (Alexander Kukushkin)
Aufgrund einer Race Condition nahm Patroni fälschlich an, der Standby müsse neu gestartet werden, weil sich Recovery-Parameter wie
primary_conninfogeändert hätten. -
Fehler im Befehl
patronictl querybehoben (Israel Barth Rubio)Der Befehl funktionierte nicht, wenn nur
-moder keines der Argumente-rund-mangegeben wurde. -
Ganzzahlige Parameter auf der Befehlszeile zum Start von postgres korrekt behandelt (Polina Bungina)
Wurden Werte als Zeichenketten angegeben und nicht in Ganzzahlen umgewandelt, wurde
max_prepared_transactionsfür Citus-Cluster anhand vonmax_connectionsfalsch berechnet. -
Bei der Entscheidung über
pg_rewindnicht aufpg_stat_wal_receiververtraut (Alexander Kukushkin)Der von
pg_stat_wal_receivergemeldete Wertreceived_tlikonnte der tatsächlich wiedergegebenen Timeline voraus sein. Dagegen ist die vonIDENTIFY_SYSTEMüber die Replikationsverbindung gemeldete Timeline immer korrekt.
Version 3.1.0
Veröffentlicht am 2023-08-03
Inkompatible Änderungen
-
Bedeutung von
restapi.keyfileundrestapi.certfilegeändert (Alexander Kukushkin)Zuvor verwendete Patroni
restapi.keyfileundrestapi.certfileersatzweise als Client-Zertifikate, wenn die entsprechenden Konfigurationsparameter im Abschnittctlfehlten.
Wenn die Prüfung von Client-Zertifikaten aktiviert ist (restapi.verify_client ist auf required gesetzt), müssen außerdem gültige Client-Zertifikate in ctl.certfile, ctl.keyfile und ctl.keyfile_password angegeben werden. Ohne diese Angaben funktioniert Patroni nicht korrekt.
Neue Funktionen
-
Rollenlabel von Pods konfigurierbar gemacht (Waynerv)
Die Werte können über
kubernetes.leader_label_value,kubernetes.follower_label_valueundkubernetes.standby_leader_label_valueangepasst werden. Diese Funktion wird beim Wechsel von der Rollemasterzuprimarysehr nützlich sein. Weitere Informationen zur Funktion und den Migrationsschritten finden sich hier .
Verbesserungen
-
Verschiedene Verbesserungen an
patroni --validate-config(Alexander Kukushkin)Die Parametervalidierung für verschiedene DCS sowie die Abschnitte
bootstrap.dcs,ctl,restapiund watchdog wurde verbessert. -
Postgres wird außerhalb der Recovery gestartet, wenn es während der Recovery bei laufendem Patroni abgestürzt ist (Alexander Kukushkin)
Dies kann die Recovery-Zeit verkürzen und hilft, unnötige Timeline-Erhöhungen zu vermeiden.
-
Unnötige Aktualisierungen des Schlüssels
/statusvermieden (Alexander Kukushkin)Wenn keine permanenten logischen Slots vorhanden waren, aktualisierte Patroni
/statusbei jedem Heartbeat-Schleifendurchlauf, selbst wenn sich die LSN auf dem Primärserver nicht weiterbewegt hatte. -
Verhindert, dass ein Primärserver mit veraltetem Zustand die Leader-Wahl gewinnt (Alexander Kukushkin)
Wenn Patroni wegen Ressourcenmangels längere Zeit nicht reagiert hat, prüft es vor dem Erwerb der Leader-Sperre zusätzlich, ob auf keinem anderen Knoten Postgres hochgestuft wurde.
-
Validierung bestimmter PostgreSQL-Parameter sichtbar gemacht (Alexander Kukushkin, Feike Steenbergen)
Wenn die Validierung von
max_connections,max_wal_senders,max_prepared_transactions,max_locks_per_transaction,max_replication_slotsodermax_worker_processesfehlschlug, verwendete Patroni einen geeigneten Standardwert. Zusätzlich wird jetzt eine Warnung ausgegeben. -
Berechtigungen für in
PGDATAerstellte Dateien und Verzeichnisse gesetzt (Alexander Kukushkin)Alle von Patroni erstellten Dateien hatten nur Lese- und Schreibberechtigungen für den Eigentümer. Dadurch funktionierten Backup-Werkzeuge nicht, die unter einem anderen Benutzer laufen und Gruppenleserechte benötigen. Patroni berücksichtigt jetzt die Berechtigungen von
PGDATAund setzt die Berechtigungen aller innerhalb vonPGDATAerstellten Dateien und Verzeichnisse korrekt.
Fehlerbehebungen
-
archive_commandüber eine Shell ausgeführt (Waynerv)Patroni kann vor einer Crash-Recovery im Einzelbenutzermodus oder vor
pg_rewindeinige WAL-Segmente archivieren. Enthielt archive_command Shell-Operatoren wie&&, funktionierte dies mit Patroni nicht. -
Prüfungen beim Herunterfahren während eines Switchovers korrigiert (Polina Bungina)
Es konnte vorkommen, dass der angegebene Kandidat noch streamte und den Shutdown-Checkpoint noch nicht erhalten hatte, der Leader-Schlüssel aber entfernt wurde, weil andere Knoten funktionsfähig waren.
-
Prüfung auf Primärserver korrigiert (Alexander Kukushkin)
Während der Leader-Wahl konnten Replikate nicht erkennen, dass Postgres auf dem alten Leader weiterhin als Primärserver lief.
-
patronictl listkorrigiert (Alexander Kukushkin)Das Feld für den Clusternamen fehlte in den Ausgabeformaten
tsv,jsonundyaml. -
Verhalten von
pg_rewindnach einer Pause korrigiert (Alexander Kukushkin)Unter bestimmten Bedingungen konnte Patroni nach dem Verlassen des Wartungsmodus den fälschlich als Primärserver laufenden Knoten nicht mit
pg_rewindwieder in den Cluster eingliedern. -
Fehler in der etcd-v3-Implementierung behoben (Alexander Kukushkin)
Der interne KV-Cache wird ungültig gemacht, wenn eine Schlüsselaktualisierung mit dem Feld
create_revision/mod_revisionaufgrund einer Revisionsabweichung fehlschlägt. -
Verhalten von Replikaten in einem pausierten Standby-Cluster korrigiert (Alexander Kukushkin)
Wenn der Leader-Schlüssel abläuft, folgen Replikate im Standby-Cluster nicht dem entfernten Knoten, sondern behalten
primary_conninfounverändert bei.
Version 3.0.4
Veröffentlicht am 2023-07-13
Neue Funktionen
-
Replikationsstatus von Standby-Knoten sichtbar gemacht (Alexander Kukushkin)
Für PostgreSQL 9.6+ meldet Patroni den Replikationszustand als
streaming, wenn der Standby von einem anderen Knoten streamt. Besteht keine Replikationsverbindung und istrestore_commandgesetzt, wirdin archive recoverygemeldet. Der Zustand ist in den Schlüsselnmemberim DCS, in der REST API und in der Ausgabe vonpatronictl listsichtbar.
Verbesserungen
-
Fehlermeldungen mit etcd v3 verbessert (Alexander Kukushkin)
War ein etcd-v3-Cluster nicht erreichbar, meldete Patroni, dass es auf die Endpunkte
/v2nicht zugreifen könne. -
Nach Möglichkeit Quorum-Lesezugriffe in patronictl verwendet (Alexander Kukushkin)
etcd- oder Consul-Cluster konnten nur noch lesbar sein, während aus Sicht von patronictl alles in Ordnung war. Jetzt schlägt der Zugriff mit einer Fehlermeldung fehl.
-
Split-Brain durch doppelte Namen in der Konfiguration verhindert (Mark Pekala)
Beim Start prüft Patroni, ob im DCS ein Knoten mit demselben Namen registriert ist, und versucht, dessen REST API abzufragen. Ist diese erreichbar, beendet sich Patroni mit einem Fehler. Dies schützt vor menschlichen Fehlern.
-
Postgres wird außerhalb der Recovery gestartet, wenn es bei laufendem Patroni abgestürzt ist (Alexander Kukushkin)
Dies kann die Recovery-Zeit verkürzen und hilft, unnötige Timeline-Erhöhungen zu vermeiden.
Fehlerbehebungen
-
SSL-Zertifikate der REST API wurden bei Empfang von SIGHUP nicht neu geladen (Israel Barth Rubio)
Die Regression wurde in 3.0.3 eingeführt.
-
Validierung ganzzahliger GUCs für Parameter wie
max_connectionskorrigiert (Feike Steenbergen)Patroni akzeptierte numerische Werte in Anführungszeichen nicht. Die Regression wurde in 3.0.3 eingeführt.
-
Problem mit synchronous_mode behoben (Alexander Kukushkin)
txid_current()wird mitsynchronous_commit=offausgeführt, damit es bei aktiviertemsynchronous_mode_strictnicht versehentlich auf fehlende synchrone Standbys wartet.
Version 3.0.3
Veröffentlicht am 2023-06-22
Neue Funktionen
-
Kompatibilität mit PostgreSQL 16 beta1 (Alexander Kukushkin)
Die Validierungsregeln für GUCs wurden erweitert.
-
Validator für PostgreSQL-GUCs erweiterbar gemacht (Israel Barth Rubio)
Validierungsregeln werden aus YAML-Dateien im Verzeichnis
patroni/postgresql/available_parameters/geladen. Die Dateien werden alphabetisch sortiert und nacheinander angewendet. Damit sind benutzerdefinierte Validatoren für von der Standarddistribution abweichende Postgres-Distributionen möglich. -
Option
restapi.request_queue_sizehinzugefügt (Andrey Zhidenkov, Aleksei Sukhov)Sie legt die Größe der Anfragewarteschlange für den von der Patroni-REST-API verwendeten TCP-Socket fest. Ist die Warteschlange voll, erhalten weitere Anfragen den Fehler “Connection denied”. Der Standardwert ist 5.
-
initdbbeim Bootstrap eines neuen Clusters direkt aufgerufen (Matt Baker)Zuvor wurde es über
pg_ctlaufgerufen, was eine besondere Behandlung der Anführungszeichen für die aninitdbübergebenen Parameter erforderte. -
Hook vor dem Stoppen hinzugefügt (Le Duane)
Der Hook kann über
postgresql.before_stopkonfiguriert werden und wird unmittelbar vorpg_ctl stopausgeführt. Sein Exit-Code beeinflusst den Vorgang des Herunterfahrens nicht. -
Benutzerdefinierte Namen für Postgres-Programme unterstützt (Israel Barth Rubio, Polina Bungina)
In einer benutzerdefinierten Postgres-Distribution können die Programme unter anderen Namen als in der Community-Distribution kompiliert sein. Benutzerdefinierte Programmnamen lassen sich über
postgresql.bin_name.*und die UmgebungsvariablenPATRONI_POSTGRESQL_BIN_*konfigurieren.
Verbesserungen
-
Verschiedene Verbesserungen an
patroni --validate-config(Polina Bungina)bootstrap.initdbist nun optional. Es ist nur für neue Cluster erforderlich, dochpatroni --validate-configbeanstandete bisher sein Fehlen in der Konfiguration.- Bei leerem oder nicht gesetztem
postgresql.bin_dirwird kein Fehler ausgelöst. Stattdessen wird zunächst im standardmäßigen PATH nach Postgres-Programmen gesucht. - Der Abschnitt
postgresql.authentication.rewindist nun optional. Fehlt er, verwendet Patroni den Superuser.
-
Fehlermeldungen in patronictl verbessert (Israel Barth Rubio)
Das Symbol
\nwurde wörtlich statt als tatsächlicher Zeilenumbruch dargestellt.
Fehlerbehebungen
-
Problem in der Citus-Unterstützung behoben (Alexander Kukushkin)
Wenn während eines Switchovers der REST-API-Aufruf vom hochgestuften Worker zum Coordinator fehlschlug, blieb die betreffende Citus-Gruppe auf unbestimmte Zeit blockiert.
-
etcd3-URL in der Option--dcs-urlvon patronictl zugelassen (Israel Barth Rubio)Der Versuch, über die Option
--dcs-urlvon patronictl eineetcd3-URL zu übergeben, führte zu einer Ausnahme.
Version 3.0.2
Veröffentlicht am 2023-03-24
Version 3.0.2 stellt die Unterstützung für Python-Versionen vor 3.6 ein.
Neue Funktionen
-
Status synchroner Standby-Replikate zum Endpunkt
/metricshinzugefügt (Thomas von Dein, Alexander Kukushkin)Zuvor wurden nur
primary/standby_leader/replicagemeldet. -
Benutzerfreundliche Behandlung von
PAGERin patronictl (Israel Barth Rubio)Der Pager kann über die Umgebungsvariable
PAGERkonfiguriert werden, die die Standardprogrammelessundmoreüberschreibt. -
HTTP-Statuscodes für wiederholbare K8s-Anfragen konfigurierbar gemacht (Alexander Kukushkin)
Auf manchen verwalteten Plattformen kann der Statuscode
401 Unauthorizedauftreten; das Problem behebt sich bisweilen nach einigen Wiederholungsversuchen.
Verbesserungen
-
hot_standbywird während eines benutzerdefinierten Bootstraps nur aufoffgesetzt, wennrecovery_target_actionaufpromotegesetzt ist (Alexander Kukushkin)Dies war erforderlich, damit
recovery_target_action=pausekorrekt funktioniert. -
Verhindert, dass der Callback
on_reloadandere Callbacks beendet (Alexander Kukushkin)on_start/on_stop/on_role_changedienen üblicherweise zum Hinzufügen und Entfernen einer virtuellen IP.on_reloadsollte diese nicht beeinträchtigen. -
AWS-Callback-Beispielskript auf
IMDSFetcherumgestellt (Polina Bungina)IMDSv2benötigt ein Token;IMDSFetcherkümmert sich transparent darum.
Fehlerbehebungen
-
patronictl switchoverfür einen Citus-Cluster auf Kubernetes korrigiert (Lukáš Lalinský)Der Befehl funktionierte für andere Namespaces als
defaultnicht. -
Bei unbekannter Hauptversion wird nicht in
PGDATAgeschrieben (Alexander Kukushkin)War
PGDATAunmittelbar nach dem Start leer, etwa weil es noch nicht eingehängt war, nahm Patroni eine falsche PostgreSQL-Version an und erstellte fälschlichrecovery.conf, selbst wenn die tatsächliche Hauptversion v10+ war. -
Fehler bei Citus-Metadaten nach einem Coordinator-Failover behoben (Alexander Kukushkin)
Der Aufruf von
citus_set_coordinator_host()löst keine Metadatensynchronisierung aus, sodass die Änderung auf Worker-Knoten nicht sichtbar war. Das Problem wird durch den Wechsel zucitus_update_node()behoben. -
Bei „Ausfall“ aller etcd-Knoten auf die Hosts aus der Konfigurationsdatei zurückgegriffen (Alexander Kukushkin)
Die Topologie des etcd-Clusters kann sich im Laufe der Zeit ändern; Patroni versucht, ihr zu folgen. Sind irgendwann alle Knoten nicht mehr erreichbar, verwendet Patroni bei erneuten Verbindungsversuchen eine Kombination der Knoten aus der Konfiguration und der zuletzt bekannten Topologie.
Version 3.0.1
Veröffentlicht am 2023-02-16
Fehlerbehebungen
-
Korrekter Rollenname wird an ein Callback-Skript
on_role_changeübergeben. (Alexander Kukushkin, Polina Bungina)Patroni übergab bei der Hochstufung fälschlich die Rolle
promotedan ein Callback-Skripton_role_change. Der übergebene Rollenname wurde wieder aufmastergeändert. Diese Regression wurde in 3.0.0 eingeführt.
Version 3.0.0
Veröffentlicht am 2023-01-30
Diese Version ergänzt die Integration mit Citus und ermöglicht es, vorübergehende DCS-Ausfälle ohne Herabstufung des Primärservers zu überstehen.
-
Version 3.0.0 ist die letzte Version mit Unterstützung für Python 2.7. Die nächste Version wird Python-Versionen vor 3.7 nicht mehr unterstützen.
-
Die RAFT-Unterstützung ist veraltet. Sie wird nach besten Kräften weiter gepflegt, es wird jedoch weder eine Garantie noch Verantwortung für mögliche Probleme übernommen.
-
Diese Version ist der erste Schritt zur Ablösung von „master“ durch „primary“. Ein zuverlässiges Upgrade auf die nächste Hauptversion ist nur von mindestens Version 3.0.0 aus möglich.
Neue Funktionen
-
DCS-Failsafe-Modus (Alexander Kukushkin, Polina Bungina)
Wenn diese Funktion aktiviert ist, kann ein Patroni-Cluster vorübergehende DCS-Ausfälle überstehen. Weitere Einzelheiten enthält die Dokumentation .
-
Citus-Unterstützung (Alexander Kukushkin, Polina Bungina, Jelte Fennema)
Patroni ermöglicht die einfache Bereitstellung und Verwaltung von Citus -Clustern mit HA. Weitere Informationen finden sich hier .
Verbesserungen
-
Wiederkehrende Fehler beim Löschen unbekannter, aber aktiver Replikationsslots unterdrückt (Michael Banck)
Patroni schreibt diese Protokollmeldungen weiterhin, jedoch nur auf Stufe DEBUG.
-
Nur eine Überwachungsabfrage pro HA-Schleifendurchlauf ausgeführt (Alexander Kukushkin)
Bei aktivierter synchroner Replikation war dies bisher nicht der Fall.
-
Nur das zuletzt fehlgeschlagene Datenverzeichnis wird behalten (William Albertus Dembo)
Nach einem fehlgeschlagenen Bootstrap benannte Patroni das Verzeichnis $PGDATA bisher mit einem Zeitstempelsuffix um. Jetzt lautet das Suffix
.failed. Existiert ein solches Verzeichnis bereits, wird es vor dem Umbenennen entfernt. -
Prüfung synchroner Replikationsverbindungen verbessert (Alexander Kukushkin)
Wird ein neuer Host zu
synchronous_standby_nameshinzugefügt, wird er im DCS erst dann als synchron eingetragen, wenn er nebenpg_stat_replication.sync_state = 'sync'auch zum Primärserver aufgeholt hat.
Entfernte Funktionen
-
patronictl scaffoldentfernt (Alexander Kukushkin)Sein einziger Zweck war eine behelfsmäßige Möglichkeit, Standby-Cluster zu betreiben.
Version 2.1.7
Veröffentlicht am 2023-01-04
Fehlerbehebungen
-
Kleine Inkompatibilitäten mit älteren Python-Modulen behoben (Alexander Kukushkin)
Sie verhinderten das Bauen oder Ausführen von Patroni unter Debian buster/Ubuntu bionic.
Version 2.1.6
Veröffentlicht am 2022-12-30
Verbesserungen
-
Störende Ausnahmen beim Schließen von SSL-Sockets behoben (Alexander Kukushkin)
HAProxy schließt Verbindungen, sobald es den HTTP-Statuscode empfangen hat. Dadurch blieb Patroni keine Zeit, die SSL-Verbindung ordnungsgemäß zu schließen.
-
Beispiel-Dockerfile für arm64 angepasst (Polina Bungina)
Die expliziten Angaben
amd64undx86_64wurden entfernt;libnss_files.so.*wird nicht entfernt.
Sicherheitsverbesserungen
-
search_path=pg_catalogfür Verbindungen außerhalb des Replikationsprotokolls erzwungen (Alexander Kukushkin)Da Patroni stark auf Superuser-Verbindungen angewiesen ist, soll es vor möglichen Angriffen über benutzerdefinierte Funktionen und/oder Operatoren im Schema
publicgeschützt werden, die denselben Namen und dieselbe Signatur wie entsprechende Objekte inpg_cataloghaben. Dazu wirdsearch_path=pg_catalogfür alle von Patroni erstellten Verbindungen außer Replikationsverbindungen erzwungen. -
Aufzeichnung von Passwörtern in
pg_stat_statementsverhindert (Feike Steenbergen)Dazu wird beim Anlegen von Benutzern
pg_stat_statements.track_utility=offgesetzt.
Fehlerbehebungen
-
proxy_addressals optional deklariert (Denis Laxalde)Die Option ist tatsächlich nicht erforderlich.
-
Verhalten der Option insecure verbessert (Alexander Kukushkin)
Die Option
insecurevon ctl funktionierte nicht richtig, wenn für REST-API-Anfragen Clientzertifikate verwendet wurden. -
Watchdog-Konfiguration beim Bootstrap eines neuen Clusters aus
bootstrap.dcsübernommen (Matt Baker)Bisher konfigurierte Patroni den Watchdog beim Bootstrap eines neuen Clusters zunächst mit Standardwerten, statt die zum Bootstrap des DCS verwendete Konfiguration zu übernehmen.
-
Behandlung von Dateiendungen bei der Suche nach ausführbaren Dateien unter WIN32 korrigiert (Martín Marqués)
.exewird nur angehängt, wenn der Dateiname noch keine Endung hat. -
Einstellung der Consul-TTL korrigiert (Alexander Kukushkin)
Beim Setzen des Werts im HTTPClient wurde
ttl/2.0verwendet, in der Eigenschaft der Klasse jedoch vergessen, den aktuellen Wert mit 2 zu multiplizieren. Dadurch war die Consul-TTL um den Faktor zwei falsch.
Entfernte Funktionen
-
patronictl configureentfernt (Polina Bungina)Eine separate Erstellung der patronictl -Konfiguration ist nicht mehr nötig.
Version 2.1.5
Veröffentlicht am 2022-11-28
Diese Version verbessert die Kompatibilität mit PostgreSQL 15 und erklärt die Unterstützung für etcd v3 für produktionsreif. Patroni auf Raft bleibt im Beta-Stadium.
Neue Funktionen
-
patroni --validate-configverbessert (Denis Laxalde)Bei ungültiger Konfiguration erfolgt der Abbruch mit Code 1; Fehler werden auf stderr ausgegeben.
-
Replikationsslots werden im pausierten Modus nicht entfernt (Alexander Kukushkin)
Patroni erstellt oder entfernt physische Replikationsslots automatisch, wenn Mitglieder dem Cluster beitreten oder ihn verlassen. Im pausierten Modus werden Slots nicht mehr entfernt.
-
Anfragemethode
HEADfür Überwachungsendpunkte unterstützt (Robert Cutajar)Wird sie anstelle von
GETverwendet, gibt Patroni nur den HTTP-Statuscode zurück. -
behave-Tests unter Windows unterstützt (Alexander Kukushkin)
Der neue REST-API-Endpunkt
POST /sigtermermöglicht es, ein geordnetes Herunterfahren von Patroni (SIGTERM) unter Windows nachzubilden. -
postgresql.proxy_addresseingeführt (Alexander Kukushkin)Der Wert wird als
proxy_urlin den Mitgliedsschlüssel im DCS geschrieben und kann zur Diensterkennung verwendet werden.
Stabilitätsverbesserungen
-
pg_replication_slot_advance()wird aus einem Thread aufgerufen (Alexander Kukushkin)Auf stark ausgelasteten Clustern mit vielen logischen Replikationsslots beeinträchtigte der Aufruf von
pg_replication_slot_advance()die HA-Hauptschleife und konnte zum Ablauf des Mitgliedsschlüssels führen. -
Möglicherweise fehlende WAL-Dateien werden vor dem Aufruf von
pg_rewindauf dem alten Primärserver archiviert (Polina Bungina)War der Primärserver nach einem Absturz längere Zeit ausgefallen, konnten einige WAL-Dateien sowohl im Archiv als auch auf dem neuen Primärserver fehlen.
pg_rewindkonnte diese Dateien vom alten Primärserver entfernen, sodass dieser nicht mehr als Standby gestartet werden konnte. Das Archivieren von WAL-Dateien im Zustandreadyverringert dieses Risiko und verbessert die kontinuierliche Archivierung insgesamt. -
Fehler
403beim Versuch, einen Kubernetes-Service anzulegen, werden ignoriert (Nick Hudson, Polina Bungina)Erfolglose Versuche, den möglicherweise bereits vorhandenen Service anzulegen, überfluteten die Patroni-Protokolle.
-
Liveness-Prüfung verbessert (Alexander Kukushkin)
Die Liveness-Prüfung schlägt fehl, wenn die Heartbeat-Schleife auf dem Primärserver länger als
ttloder auf einem Replikat länger als2*ttlläuft. Dadurch kann sie unter Kubernetes als Alternative zum Watchdog verwendet werden. -
Bei einem Switchover versucht nur ein synchroner Knoten, die Sperre zu übernehmen (Alexander Kukushkin, Polina Bungina)
Zuvor bestand eine geringe Chance, dass ein asynchrones Mitglied auf dem aktuellen Stand Leader wurde, wenn ein manuelles Switchover ohne Zielangabe ausgeführt wurde.
-
Klonen während des Cluster-Bootstraps verhindert (Ants Aasma)
Eine Methode zur Replikaterstellung, die keinen Leader benötigt, darf während des laufenden Cluster-Bootstraps nicht gestartet werden.
-
Kompatibilität mit kazoo-2.9.0 (Alexander Kukushkin)
Je nach Python-Version kann
SequentialThreadingHandler.select()die AusnahmenTypeErrorundIOErrorauslösen, wennselect()auf einem geschlossenen Socket aufgerufen wird. -
SSL-Verbindung wird vor dem Socket ausdrücklich geschlossen (Alexander Kukushkin)
Ohne diesen Schritt kam es mit OpenSSL 3.0 zu Fehlern
unexpected eof while reading. -
Kompatibilität mit
prettytable>=2.2.0(Alexander Kukushkin)Durch interne API-Änderungen wurde die Überschrift mit dem Clusternamen in der falschen Zeile angezeigt.
Fehlerbehebungen
-
Abgelaufene Token bei etcd lease_grant behandelt (monsterxx03)
Bei einem Fehler wird ein neues Token geholt und die Anfrage wiederholt.
-
Fehler im Endpunkt
GET /read-only-syncbehoben (Alexander Kukushkin)Er wurde in der vorherigen Version eingeführt und hatte tatsächlich nie funktioniert.
-
Verschwundener Speicher des Datenverzeichnisses behandelt (Alexander Kukushkin)
Patroni prüft regelmäßig, ob PGDATA vorhanden und nicht leer ist. Bei Speicherproblemen löst
os.listdir()jedochOSErroraus, wodurch die Heartbeat-Schleife unterbrochen wurde. -
master_stop_timeoutbeim Warten auf das Ende von Benutzer-Backends angewendet (Alexander Kukushkin)Ein vermeintliches Benutzer-Backend kann tatsächlich ein Hintergrundprozess sein, etwa der Citus Maintenance Daemon, der sich nicht beendet.
-
*:<port>fürpostgresql.listenzugelassen (Denis Laxalde)patroni --validate-configmeldete diesen Wert als ungültig. -
Zeitüberschreitungen in Raft korrigiert (Alexander Kukushkin)
Beim Start versuchen Patroni oder patronictl, die Raft-Clustertopologie von bekannten Mitgliedern abzurufen. Diese Aufrufe erfolgten ohne geeignete Zeitbegrenzung.
-
Consul-Service nach einer Tokenänderung zwingend aktualisiert (John A. Lotoski)
Ohne die Aktualisierung entstanden Fehler wie “rpc error making call: rpc error making call: ACL not found”.
Version 2.1.4
Veröffentlicht am 2022-06-01
Neue Funktionen
-
Verhalten von
pg_rewindauf typischen Debian-/Ubuntu-Systemen verbessert (Gunnar “Nick” Bluth)Bei Postgres-Installationen mit
postgresql.confaußerhalb des Datenverzeichnisses (z. B. Ubuntu-/Debian-Pakete) kannpg_rewind --restore-target-walden Wert vonrestore_commandnicht ermitteln. -
TLSServerNamefür Consul-Service-Prüfungen einstellbar (Michael Gmelin)Dies ist nützlich, wenn Prüfungen über IP-Adressen erfolgen und der Consul-
node_namekein FQDN ist. -
Unterstützung für
ppc64leim Watchdog hinzugefügt (Jean-Michel Scheiwiler)Außerdem wurde die Watchdog-Unterstützung auf einigen Nicht-x86-Plattformen korrigiert.
-
Callback aws.py von
botoaufboto3umgestellt (Alexander Kukushkin)
boto2.x wird seit 2018 nicht mehr gepflegt und funktioniert mit Python 3.9 nicht.
-
Service-Account-Token unter K8s regelmäßig erneuert (Haitao Li)
Seit Kubernetes v1.21 laufen Service-Account-Token nach 1 Stunde ab.
-
Überwachungsendpunkt
/read-only-synchinzugefügt (Dennis4b)Er ähnelt
/read-only, berücksichtigt aber nur synchrone Replikate.
Stabilitätsverbesserungen
-
Logische Replikationsslots werden bei abweichender Konfiguration der logischen Dekodierung nicht auf Replikate kopiert (Alexander Kukushkin)
Ein Replikat kopiert einen logischen Replikationsslot nicht mehr vom Primärserver, wenn dieser nicht zu den Konfigurationsoptionen
pluginoderdatabasepasst. Zuvor erfolgte diese Prüfung erst, nachdem das Replikat den Slot kopiert hatte und damit gestartet war. Dies führte zu unnötigen, wiederholten Neustarts. -
Recovery-Konfigurationsparameter für PostgreSQL v12+ gesondert behandelt (Alexander Kukushkin)
Beim Start als Replikat sollte Patroni
postgresql.confaktualisieren und einen Neustart bzw. ein Neuladen ausführen können, wenn sich die Leader-Adresse geändert hat. Dazu werden die aktuellen Parameterwerte zwischengespeichert, statt sie auspg_settingsabzufragen. -
IPv6-Adressen in
postgresql.listenbesser behandelt (Alexander Kukushkin)Da
listeneinen Port enthält, werden IPv6-Adressen häufig in eckige Klammern gesetzt. Diese wurden bei mehreren IP-Adressen in der Liste nicht korrekt entfernt. -
Zugangsdaten von
replicationfür die Divergenzprüfung nur unter PostgreSQL v10 und älter verwendet (Alexander Kukushkin)Ist
rewindaktiviert, verwendet Patroni auf neueren Postgres-Versionen wieder entwedersuperuser- oderrewind-Zugangsdaten.
Fehlerbehebungen
-
Fehlenden Import von
dateutil.parserergänzt (Wesley Mendes)Die Tests schlugen nur deshalb nicht fehl, weil das Modul auch aus anderen Modulen importiert wurde.
-
Sichergestellt, dass die Annotation
optimeeine Zeichenfolge ist (Sebastian Hasler)In bestimmten Fällen versuchte Patroni, sie als Zahl zu übergeben.
-
Fehlgeschlagene Versuche mit
pg_rewindbesser behandelt (Alexander Kukushkin)Wird der Primärserver während
pg_rewindunerreichbar, bleibt$PGDATAin einem beschädigten Zustand zurück. Anschließend entfernt Patroni das Datenverzeichnis, auch wenn die Konfiguration dies nicht erlaubt. -
Annotationen
slotswerden bei noch nicht bereitem PostgreSQL nicht aus der Leader-ConfigMapbzw. dem Leader-Endpointentfernt (Alexander Kukushkin)Wird kein Wert für
slotsübergeben, behält die Annotation ihren aktuellen Wert. -
Nebenläufigkeitsproblem mit K8s-API-Watchern behandelt (Alexander Kukushkin)
Unter bestimmten, unbekannten Bedingungen können Watcher veralten, wodurch
attempt_to_acquire_leader()mit HTTP-Statuscode 409 fehlschlagen kann. In diesem Fall werden die Watcher-Verbindungen zurückgesetzt und neu aufgebaut.
Version 2.1.3
Veröffentlicht am 2022-02-18
Neue Funktionen
-
Verschlüsselte TLS-Schlüssel für patronictl unterstützt (Alexander Kukushkin)
Die Konfiguration erfolgt über
ctl.keyfile_passwordoder die UmgebungsvariablePATRONI_CTL_KEYFILE_PASSWORD. -
Weitere Metriken zum Endpunkt /metrics hinzugefügt (Alexandre Pereira)
Konkret sind dies
patroni_pending_restartundpatroni_is_paused. -
Mehrere Hosts in der Standby-Cluster-Konfiguration zugelassen (Michael Banck)
Repliziert der Standby-Cluster von einem Patroni-Cluster, kann clientseitiges Failover nützlich sein, das
libpqseit PostgreSQL v10 unterstützt. Dazu setzenprimary_conninfoauf dem Standby-Leader undpg_rewinddie Optiontarget_session_attrs=read-writein der Verbindungszeichenfolge. Die Dateipgpasswird mit mehreren Zeilen erzeugt, einer pro Host. StattCHECKPOINTauf den Knoten des Primärclusters aufzurufen, wartet der Standby-Cluster darauf, dasspg_controlaktualisiert wird.
Stabilitätsverbesserungen
-
Kompatibilität mit älterem
psycopg2(Alexander Kukushkin)Beispielsweise enthält das über Ubuntu-18.04-Pakete installierte
psycopg2die AusnahmeUndefinedFilenoch nicht. -
etcd3-Watcher wird neu gestartet, wenn kein etcd-Knoten antwortet (Alexander Kukushkin)Solange der Watcher aktiv ist, liefert
get_cluster()weiterhin veraltete Informationen, selbst wenn alle etcd-Knoten ausfallen. -
Leader-Sperre im pausierten Standby-Cluster wird nicht entfernt (Alexander Kukushkin)
Zuvor wurde die Sperre nur von einem als Primärserver laufenden Knoten aufrechterhalten, nicht von einem Standby-Leader.
Fehlerbehebungen
-
Fehler beim Bootstrap des Standby-Leaders behoben (Alexander Kukushkin)
Patroni betrachtete den Bootstrap als fehlgeschlagen, wenn Postgres nach 60 Sekunden noch keine Verbindungen annahm. Der Fehler wurde mit Version 2.1.2 eingeführt.
-
Fehler beim Failover auf einen kaskadierenden Standby behoben (Alexander Kukushkin)
Bei der Ermittlung der auf einem kaskadierenden Standby anzulegenden Slots wurde nicht berücksichtigt, dass der Leader fehlen könnte.
-
Kleine Probleme im Validator für die Postgres-Konfiguration behoben (Alexander Kukushkin)
Die Validierung von Ganzzahlparametern, die mit PostgreSQL v14 eingeführt wurden, schlug fehl, weil ihre Minimal- und Maximalwerte in validator.py in Anführungszeichen standen.
-
Replikationszugangsdaten bei der Prüfung des Leader-Status verwendet (Alexander Kukushkin)
Es kann vorkommen, dass
remove_data_directory_on_diverged_timelinesgesetzt ist, aber keinerewind_credentialsdefiniert sind und Superuser-Zugriff zwischen den Knoten nicht erlaubt ist. -
Fehler “port in use” beim Austausch des REST-API-Zertifikats behoben (Ants Aasma)
Beim Zertifikatswechsel bestand eine Race Condition mit gleichzeitig laufenden API-Anfragen. War während des Austauschs eine Anfrage aktiv, schlug der Austausch mit einem Portbelegungsfehler fehl, und Patroni blieb ohne aktiven API-Server hängen.
-
Fehler beim Cluster-Bootstrap mit
%im Passwort behoben (Bastien Wirtz)Die Bootstrap-Methode führt den
DO-Block mit korrekt in Anführungszeichen gesetzten Parametern aus. Die Methodecursor.execute()kam jedoch mit einer übergebenen leeren Parameterliste nicht zurecht. -
Ausnahme “AttributeError: no attribute ’leader’” behoben (Hrvoje Milković)
Sie konnte auftreten, wenn der synchrone Modus aktiviert und der Inhalt des DCS gelöscht worden war.
-
Fehler bei der Prüfung auf divergierende Zeitleisten behoben (Alexander Kukushkin)
Patroni nahm fälschlich an, dass die Zeitleisten auseinanderliefen. Für pg_rewind war dies unproblematisch. War pg_rewind jedoch nicht erlaubt und
remove_data_directory_on_diverged_timelinesgesetzt, wurde der bisherige Leader dadurch neu initialisiert.
Version 2.1.2
Veröffentlicht am 2021-12-03
Neue Funktionen
-
Kompatibilität mit
psycopg>=3.0(Alexander Kukushkin)Standardmäßig wird
psycopg2bevorzugt.psycopg>=3.0wird nur verwendet, wennpsycopg2fehlt oder zu alt ist. -
Feld
dcs_last_seenzur REST-API hinzugefügt (Michael Banck)Das Feld enthält den letzten Zeitpunkt, zu dem ein Clustermitglied erfolgreich mit dem DCS kommuniziert hat, als Unix-Epoch-Zeit. Dies hilft, Netzwerkpartitionen zu erkennen und/oder zu analysieren.
-
Leader-Sperre wird freigegeben, wenn
pg_controldata“shut down” meldet (Alexander Kukushkin)Um langsame Switchover- oder Herunterfahrvorgänge bei langsamem oder fehlschlagendem
archive_commandzu beheben, entfernt Patroni den Leader-Schlüssel, sobaldpg_controldataPGDATA als saubershut downmeldet und geprüft wurde, dass mindestens ein Replikat alle Änderungen empfangen hat. Erfüllt kein Replikat diese Bedingung, wird der Leader-Schlüssel nicht entfernt; das bisherige Verhalten bleibt bestehen und Patroni aktualisiert die Sperre weiterhin. -
Verbindungsparameter
sslcrldirunterstützt (Kostiantyn Nemchenko)Der neue Verbindungsparameter wurde mit PostgreSQL v14 eingeführt.
-
ACLs für ZNodes in ZooKeeper konfigurierbar (Alwyn Davis)
Die neue Konfigurationsoption
zookeeper.set_aclsveranlasst Kazoo, auf jeden angelegten ZNode eine Standard-ACL anzuwenden.
Stabilitätsverbesserungen
-
Nächster Wiederherstellungsversuch bis zum nächsten HA-Durchlauf verzögert (Alexander Kukushkin)
War Postgres beispielsweise wegen eines vollen Datenträgers abgestürzt und konnte deshalb nicht starten, versuchte Patroni die Wiederherstellung zu häufig und überflutete die Protokolle.
-
Protokolleintrag vor der möglicherweise länger dauernden Herabstufung hinzugefügt (Michael Banck)
Eine Herabstufung kann einige Zeit dauern; anhand der Protokolle war nicht unbedingt erkennbar, was gerade geschah.
-
Statusmeldungen “I am” verbessert (Michael Banck)
no action. I am a secondary ({0})gegenüberno action. I am ({0}), a secondary -
wal_keep_segmentsbei der Umrechnung inwal_keep_sizein eine Ganzzahl umgewandelt (Jorge Solórzano)wal_keep_segmentskann in der globalen dynamischen Konfiguration als Zeichenfolge angegeben werden. Wegen der dynamischen Typisierung von Python wurde dann einfach die Zeichenfolge vervielfacht. Beispiel:wal_keep_segments: "100"wurde in100100100100100100100100100100100100100100100100MBumgewandelt. -
Bei aktivierter synchroner Replikation Switchover nur auf synchrone Knoten zugelassen (Alexander Kukushkin)
Außerdem tritt der Knoten bei der Leader-Wahl nur gegen bekannte synchrone Knoten an.
-
Zwischengespeicherte Rolle als Rückfallwert bei langsamem Postgres verwendet (Alexander Kukushkin)
In Extremfällen kann Postgres so langsam sein, dass die normale Überwachungsabfrage nicht innerhalb weniger Sekunden endet. Eine nicht korrekt behandelte Ausnahme durch
statement_timeoutkonnte dazu führen, dass Postgres beim Ablauf des Leader-Schlüssels oder einer fehlgeschlagenen Aktualisierung nicht rechtzeitig herabgestuft wurde. Bei einer solchen Ausnahme verwendet Patroni die zwischengespeicherterole, um festzustellen, ob Postgres als Primärserver läuft. -
Unnötige Aktualisierungen des Mitglieds-ZNodes vermieden (Alexander Kukushkin)
Wenn sich keine Werte in den Mitgliedsdaten geändert haben, sollte keine Aktualisierung erfolgen.
-
Checkpoint nach der Hochstufung optimiert (Alexander Kukushkin)
CHECKPOINTwird vermieden, wenn die neueste Zeitleiste bereits inpg_controlgespeichert ist. Dadurch entfällt ein unnötigerCHECKPOINTunmittelbar nach der Initialisierung eines neuen Clusters mitinitdb. -
Mitglieder ohne
nofailoverbei der Wahl synchroner Knoten bevorzugt (Alexander Kukushkin)Zuvor wurden synchrone Knoten allein anhand des Replikationsrückstands gewählt. Ein Knoten mit dem Tag
nofailoverhatte daher dieselbe Chance wie jeder andere Knoten, synchron zu werden. Dieses Verhalten war verwirrend und gefährlich, weil beim Ausfall des Primärservers kein automatisches Failover möglich war. -
Doppelte Hosts aus dem etcd-Machine-Cache entfernt (Michael Banck)
Die veröffentlichten Client-URLs im etcd-Cluster können falsch konfiguriert sein. In diesem Fall ist das Entfernen von Duplikaten in Patroni eine einfache Verbesserung.
Fehlerbehebungen
-
Temporäre Replikationsslots bei der Slot-Verwaltung übersprungen (Alexander Kukushkin)
Seit v10 erstellt
pg_basebackupeinen temporären Replikationsslot für das WAL-Streaming. Patroni versuchte, ihn zu löschen, weil der Slotname unbekannt erschien. Zur Behebung werden bei der Abfrage der Sichtpg_replication_slotsalle temporären Slots übersprungen. -
Zeitüberschreitungen bei
pg_replication_slot_advance()verhindert (Alexander Kukushkin)Patroni verwendete hier den Standardwert von
statement_timeout. Schlug der Aufruf einmal fehl, war es sehr wahrscheinlich, dass er sich nicht mehr erholte, was zu einem wachsendenpg_walund zu Bloat inpg_catalogführte. -
/statuswurde bei einer Herabstufung nicht aktualisiert (Alexander Kukushkin)Nach der Herabstufung von PostgreSQL aktualisiert der alte Leader die letzte LSN im DCS. Mit
2.1.0wurde der neue Schlüssel/statuseingeführt, die optime wurde jedoch weiterhin nach/optime/leadergeschrieben. -
DCS-Ausnahmen bei der Herabstufung behandelt (Alexander Kukushkin)
Während der Herabstufung des Primärservers wegen einer fehlgeschlagenen Aktualisierung der Leader-Sperre kann der DCS vollständig ausfallen und
get_cluster()eine Ausnahme auslösen. Ohne korrekte Behandlung blieb Postgres gestoppt, bis der DCS wieder verfügbar war. -
use_unix_socket_replfunktionierte in einigen Fällen nicht (Alexander Kukushkin)Insbesondere betraf dies Fälle ohne gesetztes
postgresql.unix_socket_directories. Patroni sollte dann den Standardwert vonlibpqverwenden. -
Mehrere Probleme mit der REST-API von Patroni behoben (Alexander Kukushkin)
clusters_unlockedwar manchmal nicht definiert, wodurch Ausnahmen im EndpunktGET /metricsentstanden. Außerdem nahm die Fehlerbehandlung an, dass das Tupelconnect_addressstets zwei Elemente enthält; bei IPv6 können es tatsächlich mehr sein. -
Vor der Entscheidung über einen Rewind das Ende der Recovery des neu hochgestuften Knotens abgewartet (Alexander Kukushkin)
Bis zur tatsächlichen Hochstufung und Erstellung der neuen Zeitleiste kann einige Zeit vergehen. Ohne diese Wartezeit konnten Replikate fälschlich folgern, dass kein Rewind nötig sei.
-
Fehlende Zeitleisten in der History-Datei bei der Rewind-Entscheidung behandelt (Alexander Kukushkin)
Fehlte die aktuelle Zeitleiste eines Replikats in der History-Datei des Primärservers, nahm das Replikat fälschlich an, dass kein Rewind nötig sei.
Version 2.1.1
Veröffentlicht am 2021-08-19
Neue Funktionen
-
Unterstützung für ETCD-SRV-Namenssuffixe (David Pavlicek)
etcd kann mehrere etcd-Cluster unter derselben Domain unterscheiden; dies wird nun auch von Patroni unterstützt.
-
Verlauf um den neuen Leader ergänzt (huiyalin525)
Die Ausgabe von
patronictl historyerhält dafür eine neue Spalte. -
CA-Bündel für die Kubernetes-Konfiguration innerhalb des Clusters konfigurierbar (Aron Parsons)
Standardmäßig verwendet Patroni
/var/run/secrets/kubernetes.io/serviceaccount/ca.crt. Die neue Funktion erlaubt die Angabe eines eigenenkubernetes.cacert. -
Dynamisches Registrieren und Abmelden als Consul-Service sowie Ändern von Tags unterstützt (Tommy Li)
Zuvor war dafür ein Patroni-Neustart erforderlich.
Fehlerbehebungen
-
Unnötiges Neuladen der REST-API vermieden (Alexander Kukushkin)
Die vorherige Version führte das Neuladen von REST-API-Zertifikaten ein, wenn diese auf dem Datenträger geändert wurden. Leider wurde unmittelbar nach dem Start bedingungslos neu geladen.
-
Clustermitglieder werden bei gesetztem
etcd.use_proxiesnicht aufgelöst (Alexander Kukushkin)Beim Start prüft Patroni den Zustand des etcd-Clusters, indem es die Mitgliederliste abfragt. Zusätzlich versuchte es, deren Hostnamen aufzulösen. Dies ist bei etcd-Zugriffen über einen Proxy unnötig und erzeugte überflüssige Warnungen.
-
Zeilen mit NULL-Werten in
pg_stat_replicationübersprungen (Alexander Kukushkin)Offenbar kann die Sicht
pg_stat_replicationNULL-Werte inreplay_lsn,flush_lsnoderwrite_lsnenthalten, selbst wennstate = 'streaming'gilt.
Version 2.1.0
Veröffentlicht am 2021-07-06
Diese Version ergänzt die Kompatibilität mit PostgreSQL v14, erhält logische Replikationsslots über Failover/Switchover hinweg, unterstützt eine Allowlist für die REST-API und reduziert die Protokollausgabe auf eine Zeile pro Heartbeat.
Neue Funktionen
-
Kompatibilität mit PostgreSQL v14 (Alexander Kukushkin)
Die WAL-Wiedergabe wird fortgesetzt, wenn Patroni selbst nicht im „Pause“-Modus ist. Sie kann durch die Änderung bestimmter Parameter auf dem Primärserver, etwa
max_connections, „pausiert“ sein. -
Failover für logische Slots (Alexander Kukushkin)
Logische Replikationsslots bleiben unter PostgreSQL v11+ über Failover/Switchover hinweg erhalten. Der Slot wird mit einem Neustart vom Primärserver auf das Replikat kopiert und später mit pg_replication_slot_advance() vorgerückt. Dadurch ist der Slot schon vor dem Failover vorhanden und es sollten keine Ereignisse verloren gehen. Einige Ereignisse können jedoch mehrfach zugestellt werden.
-
Allowlist für die REST-API von Patroni implementiert (Alexander Kukushkin)
Ist sie konfiguriert, dürfen nur IP-Adressen, die den Regeln entsprechen, unsichere Endpunkte aufrufen. Zusätzlich lassen sich die IP-Adressen der Clustermitglieder automatisch in die Liste aufnehmen.
-
Replikationsverbindungen über Unix-Sockets unterstützt (Mohamad El-Rifai)
Zuvor verwendete Patroni für Replikationsverbindungen stets TCP, was bei der SSL-Prüfung Probleme verursachen konnte. Unix-Sockets ermöglichen es, den Replikationsbenutzer von der SSL-Prüfung auszunehmen.
-
Health Checks anhand benutzerdefinierter Tags (Arman Jafari Tehrani)
Neben den vordefinierten Tags: können beliebig viele eigene Tags angegeben werden. Sie erscheinen in
patronictl listund in der REST-API und lassen sich nun auch in Health Checks verwenden. -
Prometheus-Endpunkt
/metricshinzugefügt (Mark Mercado, Michael Banck)Der Endpunkt stellt dieselben Metriken wie
/patronibereit. -
Patroni-Protokolle weniger ausführlich (Alexander Kukushkin)
Im Normalbetrieb wird pro Durchlauf der HA-Schleife nur eine Zeile geschrieben.
Inkompatible Änderungen
-
Die bisherige Funktion
permanent logical replication slotsfunktioniert unter PostgreSQL v10 und älter nicht mehr (Alexander Kukushkin)Die Strategie, logische Slots erst nach der Hochstufung anzulegen, kann nicht garantieren, dass keine logischen Ereignisse verloren gehen, und wird daher deaktiviert.
-
Der Endpunkt
/leaderliefert immer 200, wenn der Knoten die Sperre hält (Alexander Kukushkin)Beim Hochstufen eines Standby-Clusters müssen bisher die Health Checks des Load-Balancers angepasst werden. Dies ist umständlich und wird leicht vergessen. Deshalb wird das Verhalten des Health-Check-Endpunkts
/leadergeändert: Er gibt 200 zurück, unabhängig davon, ob der Cluster normal oder ein standby_cluster ist.
Verbesserungen der Raft-Unterstützung
-
Zuverlässige Verschlüsselung des Raft-Datenverkehrs (Alexander Kukushkin)
Durch verschiedene Probleme in
PySyncObjwar die Verschlüsselungsunterstützung sehr instabil. -
DNS-Probleme in der Raft-Implementierung behandelt (Alexander Kukushkin)
Wurden
self_addrund/oderpartner_addrsüber DNS-Namen statt IP-Adressen konfiguriert, löstePySyncObjsie praktisch nur einmal beim Erstellen des Objekts auf. Dies verursachte Probleme, wenn derselbe Knoten mit einer anderen IP-Adresse zurückkehrte.
Stabilitätsverbesserungen
-
Kompatibilität mit
psycopg2-2.9+(Alexander Kukushkin)In
psycopg2wirdautocommit = Trueim Blockwith connectionignoriert, wodurch Verbindungen über das Replikationsprotokoll fehlschlagen. -
Übermäßig häufige HA-Durchläufe mit ZooKeeper behoben (Alexander Kukushkin)
Aktualisierungen von Mitglieds-ZNodes lösten eine Kettenreaktion aus, sodass die HA-Schleifen mehrfach direkt hintereinander liefen.
-
REST-API-Zertifikat wird nach Änderung auf dem Datenträger neu geladen (Michael Todorovic)
Wurde die Zertifikatsdatei direkt ersetzt, führte Patroni kein Neuladen aus.
-
Kein pgpass-Verzeichnis bei Kerberos-Authentifizierung angelegt (Kostiantyn Nemchenko)
Kerberos- und Passwortauthentifizierung schließen sich gegenseitig aus.
-
Kleine Probleme beim benutzerdefinierten Cluster-Bootstrap behoben (Alexander Kukushkin)
Postgres wird nur für eine PITR mit
hot_standby=offgestartet und nach deren Abschluss neu gestartet.
Fehlerbehebungen
-
Kompatibilität mit
kazoo-2.7+(Alexander Kukushkin)Da Patroni Wiederholungsversuche selbst verwaltet, ist es auf das frühere Verhalten von
kazooangewiesen, Anfragen an einen ZooKeeper-Cluster sofort zu verwerfen, wenn keine Verbindungen verfügbar sind. -
Version des etcd-v3-Clusters wird bei bekannter Proxy-Verbindung ausdrücklich abgefragt (Alexander Kukushkin)
Patroni greift über gRPC-gateway auf etcd-v3-Cluster zu. Je nach Clusterversion müssen unterschiedliche Endpunkte (
/v3,/v3betaoder/v3alpha) verwendet werden. Die Version wurde bisher nur zusammen mit der Clustertopologie ermittelt, was bei Proxy-Verbindungen nie geschah.
Version 2.0.2
Veröffentlicht am 2021-02-22
Neue Funktionen
-
Extern verwaltete Replikationsslots können ignoriert werden (James Coleman)
Patroni versucht, ihm unbekannte Replikationsslots zu entfernen. Es gibt jedoch Fälle, in denen Slots extern verwaltet werden sollten. Nun lässt sich konfigurieren, welche Slots nicht entfernt werden sollen.
-
Einschränkung der Cipher Suites für die REST-API unterstützt (Gunnar “Nick” Bluth)
Die Konfiguration erfolgt über
restapi.ciphersoder die UmgebungsvariablePATRONI_RESTAPI_CIPHERS. -
Verschlüsselte TLS-Schlüssel für die REST-API unterstützt (Jonathan S. Katz)
Die Konfiguration erfolgt über
restapi.keyfile_passwordoder die UmgebungsvariablePATRONI_RESTAPI_KEYFILE_PASSWORD. -
REST-API-Zugangsdaten in konstanter Zeit verglichen (Alex Brasetvik)
hmac.compare_digest()ersetzt==, das für Timing-Angriffe anfällig ist. -
Synchrone Knoten anhand des Replikationsrückstands gewählt (Krishna Sarabu)
Überschreitet der Replikationsrückstand eines synchronen Knotens den konfigurierten Schwellwert, kann dieser auf asynchron umgestellt und/oder durch einen anderen Knoten ersetzt werden. Das Verhalten wird mit
maximum_lag_on_syncnodegesteuert.
Stabilitätsverbesserungen
-
Postgres wird beim benutzerdefinierten Bootstrap mit
hot_standby = offgestartet (Igor Yanchenko)Bei einem benutzerdefinierten Bootstrap stellt Patroni das Basisbackup wieder her, startet Postgres und wartet auf das Ende der Recovery. Einige PostgreSQL-Parameter dürfen auf einem Standby nicht kleiner sein als auf dem Primärserver. Ist der aus WAL wiederhergestellte neue Wert höher als der konfigurierte, bricht Postgres mit PANIC ab. Um dies zu vermeiden, erfolgt die benutzerdefinierte Initialisierung ohne
hot_standby-Modus. -
Warnung bei nicht funktionsfähigem erforderlichem Watchdog hinzugefügt (Nicolas Thauvin)
Ist das Watchdog-Gerät im Modus required nicht beschreibbar oder fehlt es, kann das Mitglied nicht hochgestuft werden. Eine neue Warnung zeigt, wo nach der Fehlkonfiguration gesucht werden sollte.
-
Ausführlichere Meldungen bei Recovery im Einzelbenutzermodus (Alexander Kukushkin)
Erkennt Patroni, dass PostgreSQL nicht sauber heruntergefahren wurde, führt es in bestimmten Fällen eine Crash-Recovery aus, indem es Postgres im Einzelbenutzermodus startet. Schlug diese Recovery etwa wegen fehlenden Speicherplatzes fehl, wurden die Fehler bisher verschluckt.
-
Kompatibilität mit dem Modul
python-consul2ergänzt (Alexander Kukushkin, Wilfried Roset)Das bewährte
python-consulwird seit einigen Jahren nicht mehr gepflegt. Deshalb entstand ein Fork mit neuen Funktionen und Fehlerbehebungen. -
bypass_api_servicewird bei patronictl nicht verwendet (Alexander Kukushkin)Läuft ein K8s-Pod in einem anderen Namespace als
default, hat er nicht unbedingt genügend Berechtigungen, um den Endpunkt kubernetes abzufragen. In diesem Fall gibt Patroni eine Warnung aus und ignoriertbypass_api_service. Bei patronictl war diese Warnung störend. -
raft.data_dirwird erstellt, falls es fehlt, oder auf Schreibbarkeit geprüft (Mark Mercado)Dies verbessert Benutzerfreundlichkeit und Bedienbarkeit.
Fehlerbehebungen
-
Neustart oder Hochstufung wird bei Verlust der Leader-Sperre im pausierten Modus nicht unterbrochen (Alexander Kukushkin)
Im pausierten Modus darf Postgres ohne Sperre als Primärserver laufen.
-
Problem mit
shutdown_request()in der REST-API behoben (Nicolas Limage)Um SSL-Verbindungen besser zu behandeln und den Handshake bis zum Threadstart zu verzögern, überschreibt Patroni einige Methoden von
HTTPServer.shutdown_request()war dabei vergessen worden. -
Wartezeit bei Verwendung von ZooKeeper korrigiert (Alexander Kukushkin)
Zwischen den Ausführungen des HA-Codes konnte Patroni bis zu doppelt so lange wie vorgesehen schlafen.
-
Ungültige
os.symlink()-Aufrufe beim Verschieben des Datenverzeichnisses nach fehlgeschlagenem Bootstrap korrigiert (Andrew L’Ecuyer)Bei fehlgeschlagenem Bootstrap benennt Patroni Datenverzeichnis, pg_wal und alle Tablespaces um. Danach werden die symbolischen Links aktualisiert, damit das Dateisystem konsistent bleibt. Deren Erstellung schlug fehl, weil
srcunddstvertauscht waren. -
Fehler in post_bootstrap() behoben (Alexander Kukushkin)
War kein Superuser-Passwort konfiguriert, konnte Patroni das Skript
post_initnicht aufrufen, wodurch der gesamte Bootstrap fehlschlug. -
Problem mit pg_rewind im Standby-Cluster behoben (Alexander Kukushkin)
Wenn der Superuser-Name von
postgresabwich, schlugpg_rewindim Standby-Cluster fehl, weil die Verbindungszeichenfolge keinen Datenbanknamen enthielt. -
Abbruch nur bei ausdrücklich fehlgeschlagener Authentifizierung mit etcd v3 (Alexander Kukushkin)
Beim Start ermittelt Patroni die Topologie des etcd-Clusters und authentifiziert sich bei Bedarf. War einer der etcd-Server unerreichbar, versuchte Patroni die Authentifizierung auf diesem Server und brach ab, statt es beim nächsten Knoten erneut zu versuchen.
-
Leere Rückgabe von psutil cmdline() behandelt (Alexander Kukushkin)
Zombie-Prozesse sind weiterhin Kindprozesse des postmaster, besitzen aber kein cmdline().
-
Umgebungsvariable
PATRONI_KUBERNETES_USE_ENDPOINTSals booleschen Wert behandelt (Alexander Kukushkin)Ohne diese Behandlung ließ sich
kubernetes.use_endpointsnicht über die Umgebung deaktivieren. -
Fehler bei gleichzeitigen Endpoint-Aktualisierungen besser behandelt (Alexander Kukushkin)
Patroni fragt das aktuelle Endpoint-Objekt ausdrücklich ab, prüft, ob der aktuelle Pod weiterhin die Leader-Sperre hält, und wiederholt die Aktualisierung.
Version 2.0.1
Veröffentlicht am 2020-10-01
Neue Funktionen
-
moreals Pager inpatronictl edit-configverwendet, wennlessfehlt (Pavel Golub)Unter Windows ist dies
more.com. Außerdem wurde inrequirements.txtcdiffdurchydiffersetzt; patronictl unterstützt aus Kompatibilitätsgründen weiterhin beide. -
bind_addrundpasswordfürraftunterstützt (Alexander Kukushkin)raft.bind_addrkann beim Betrieb hinter NAT nützlich sein.raft.passwordaktiviert die Verschlüsselung des Datenverkehrs und erfordert das Modulcryptography. -
Verbindungsparameter
sslpasswordunterstützt (Kostiantyn Nemchenko)Dieser Parameter wurde mit PostgreSQL 13 eingeführt.
Stabilitätsverbesserungen
-
Verhalten im pausierten Modus geändert (Alexander Kukushkin)
- Patroni ruft die Methode
bootstrapnicht auf, wenn das VerzeichnisPGDATAfehlt oder leer ist. - Patroni beendet sich bei abweichender sysid im pausierten Modus nicht, sondern protokolliert nur eine Warnung.
- Im pausierten Modus versucht ein Knoten nicht, den Leader-Schlüssel zu übernehmen, wenn Postgres außerhalb der Recovery läuft und Schreibzugriffe annimmt, die sysid aber nicht zum initialize-Schlüssel passt.
- Patroni ruft die Methode
-
master_start_timeoutbei der Crash-Recovery angewendet (Alexander Kukushkin)Stürzt Postgres auf dem Leader-Knoten ab, führt Patroni eine Crash-Recovery durch, indem es Postgres im Einzelbenutzermodus startet. Währenddessen wird die Leader-Sperre aktualisiert. Ist die Crash-Recovery nach
master_start_timeoutSekunden nicht beendet, bricht Patroni sie zwangsweise ab und gibt die Leader-Sperre frei. -
Extra
secureaus denurllib3-Abhängigkeiten entfernt (Alexander Kukushkin)Der einzige Grund für die ursprüngliche Aufnahme war die Abhängigkeit von
ipaddressfür Python 2.7.
Fehlerbehebungen
-
Fehler in
Kubernetes.update_leader()behoben (Alexander Kukushkin)Eine unbehandelte Ausnahme verhinderte die Herabstufung des Primärservers, wenn die Aktualisierung des Leader-Objekts fehlschlug.
-
Hängendes patronictl bei Verwendung von RAFT behoben (Alexander Kukushkin)
Wird patronictl mit der Patroni-Konfiguration verwendet, sollte
self_addrzupartner_addrshinzugefügt werden. -
Fehler in
get_guc_value()behoben (Alexander Kukushkin)Patroni konnte unter PostgreSQL 12 den Wert von
restore_commandnicht ermitteln, sodass das Nachladen fehlender WAL-Dateien fürpg_rewindnicht funktionierte.
Version 2.0.0
Veröffentlicht am 2020-09-02
Diese Version verbessert die Kompatibilität mit PostgreSQL 13, unterstützt mehrere synchrone Standbys, verbessert den Umgang mit pg_rewind erheblich, ergänzt etcd v3 sowie Patroni auf reinem RAFT (ohne etcd, Consul oder ZooKeeper) und ermöglicht den optionalen Aufruf des Fencing-Skripts pre_promote.
Unterstützung für PostgreSQL 13
-
Kein Aufruf von
on_reloadbei der Hochstufung zumstandby_leaderunter PostgreSQL 13+ (Alexander Kukushkin)Bei der Hochstufung zum
standby_leaderwirdprimary_conninfogeändert, die Rolle aktualisiert und Postgres neu geladen. Da sichon_role_changeundon_reloadpraktisch doppeln, ruft Patroni nuron_role_changeauf. -
Verbindungsparameter
gssencmodeundchannel_bindingunterstützt (Alexander Kukushkin)PostgreSQL 12 führte
gssencmodeund PostgreSQL 13channel_bindingein. Diese Verbindungsparameter können nun verwendet werden, wenn sie im Abschnittpostgresql.authenticationdefiniert sind. -
Umbenennung von
wal_keep_segmentsinwal_keep_sizeberücksichtigt (Alexander Kukushkin)Bei einer Fehlkonfiguration (
wal_keep_segmentsunter 13 oderwal_keep_sizeunter älteren Versionen) passt Patroni die Konfiguration automatisch an. -
pg_rewindunter 13 nach Möglichkeit mit--restore-target-walverwendet (Alexander Kukushkin)Unter PostgreSQL 13 prüft Patroni, ob
restore_commandkonfiguriert ist, und weistpg_rewindan, es zu verwenden.
Neue Funktionen
-
Patroni auf reinem RAFT unterstützt (Alexander Kukushkin)
Dies ermöglicht den Betrieb von Patroni ohne Abhängigkeiten von Drittanbietern wie etcd, Consul oder ZooKeeper. Für HA werden entweder drei Patroni-Knoten oder zwei Patroni-Knoten und ein Knoten mit
patroni_raft_controllerbenötigt. Weitere Informationen stehen in der Dokumentation . -
etcd-v3-Protokoll über gRPC-gateway unterstützt (Alexander Kukushkin)
etcd 3.0 erschien vor mehr als vier Jahren; in etcd 3.4 ist v2 standardmäßig deaktiviert. Da v2 möglicherweise vollständig aus etcd entfernt wird, wurde die Unterstützung für etcd v3 in Patroni implementiert. Zur Verwendung muss in der Patroni-Konfigurationsdatei ausdrücklich der Abschnitt
etcd3angelegt werden. -
Mehrere synchrone Standbys unterstützt (Krishna Sarabu)
Damit kann ein Cluster mit mehr als einem synchronen Replikat betrieben werden. Die maximale Zahl synchroner Replikate steuert der neue Parameter
synchronous_node_count. Sein Standardwert ist 1; bei synchronous_mode gleichoffhat er keine Wirkung. -
Optionaler Aufruf des Skripts
pre_promotehinzugefügt (Sergey Dudoladov)Anders als Callbacks wird
pre_promotesynchron nach dem Erlangen der Leader-Sperre, aber vor der Hochstufung von Postgres aufgerufen. Schlägt das Skript fehl oder endet es mit einem Rückgabecode ungleich null, gibt der aktuelle Knoten die Leader-Sperre frei. -
Konfigurationsverzeichnisse unterstützt (Floris van Nee)
YAML-Dateien im Verzeichnis werden in alphabetischer Reihenfolge geladen und angewendet.
-
Erweiterte Validierung von PostgreSQL-Parametern (Alexander Kukushkin)
Unterstützt die aktuelle PostgreSQL-Version einen Parameter nicht oder ist sein Wert falsch, entfernt Patroni den Parameter vollständig oder versucht, den Wert zu korrigieren.
-
Hauptthread nach Abschluss des erzwungenen Checkpoints nach einer Hochstufung aufgeweckt (Alexander Kukushkin)
Replikate warten auf die Checkpoint-Anzeige im Mitgliedsschlüssel des Leaders im DCS. Dieser Schlüssel wird normalerweise nur einmal pro HA-Durchlauf aktualisiert. Ohne das Aufwecken des Hauptthreads müssten Replikate bis zu
loop_waitSekunden länger als nötig warten. -
Sicht
pg_stat_wal_receiverunter 9.6+ verwendet (Alexander Kukushkin)Die Sicht enthält aktuelle Werte für
primary_conninfoundprimary_slot_name, während der Inhalt vonrecovery.confveraltet sein kann. -
IPv6-Adressen in der Patroni-Konfigurationsdatei besser behandelt (Mateusz Kowalski)
IPv6-Adressen sollen in eckigen Klammern stehen; Patroni erwartete sie jedoch ohne Klammern. Nun werden beide Formate unterstützt.
-
Consul-Konfigurationsparameter
service_tagshinzugefügt (Robert Edström)Er eignet sich zur dynamischen Diensterkennung, etwa durch Load-Balancer.
-
SSL-Unterstützung für ZooKeeper implementiert (Kostiantyn Nemchenko)
Dafür ist
kazoo>=2.6.0erforderlich. -
Option
no_paramsfür benutzerdefinierte Bootstrap-Methoden implementiert (Kostiantyn Nemchenko)Damit können
wal-g,pgBackRestund andere Backup-Werkzeuge ohne umschließende Shellskripte aufgerufen werden. -
WAL und Tablespaces nach fehlgeschlagener Initialisierung verschoben (Feike Steenbergen)
Bei
reinitentfernte Patroni bereits nebenPGDATAauch das über einen symbolischen Link eingebundene WAL-Verzeichnis und die Tablespaces. Nun führtmove_data_directory()einen ähnlichen Vorgang aus: WAL-Verzeichnis und Tablespaces werden umbenannt und die symbolischen Links in PGDATA aktualisiert.
Verbesserungen der pg_rewind-Unterstützung
-
Prüfung auf divergierende Zeitleisten verbessert (Alexander Kukushkin)
Ein Rewind ist nicht nötig, wenn die auf dem Replikat wiedergegebene Position nicht über den Umschaltpunkt hinausgeht oder das Ende des Checkpoint-Eintrags auf dem bisherigen Primärserver dem Umschaltpunkt entspricht. Um das Ende des Checkpoint-Eintrags zu ermitteln, wird
pg_waldumpverwendet und dessen Ausgabe ausgewertet. -
Das Nachladen fehlender WAL-Dateien wird versucht, wenn
pg_rewindsie meldet (Alexander Kukushkin)Ein von
pg_rewindbenötigtes WAL-Segment kann bereits auspg_walverschwunden sein. Dann kannpg_rewinddie Checkpoint-Position vor dem Divergenzpunkt nicht finden. Seit PostgreSQL 13 kannpg_rewindfehlende WAL-Dateien überrestore_commandnachladen. Bei älteren PostgreSQL-Versionen wertet Patroni die Fehler eines fehlgeschlagenen Rewind-Versuchs aus und versucht selbst, die fehlende WAL-Datei überrestore_commandabzurufen. -
Neue Zeitleisten im Standby-Cluster erkannt und bei Bedarf Rewind oder Neuinitialisierung ausgelöst (Alexander Kukushkin)
Der standby_cluster ist vom Primärcluster entkoppelt und erfährt daher nicht sofort von Leader-Wahlen und Zeitleistenwechseln. Um sie zu erkennen, prüft der
standby_leaderregelmäßig, ob neue History-Dateien inpg_walvorhanden sind. -
Ausgabe des Verlaufsprotokolls gekürzt und übersichtlicher gestaltet (Alexander Kukushkin)
Bei der Prüfung, ob
pg_rewinderforderlich ist, kann Patroni die History-Datei des Primärservers protokollieren. Diese wächst mit jedem Failover/Switchover und belegt schließlich zu viele Zeilen, die überwiegend wenig hilfreich sind. Statt der Rohdaten zeigt Patroni nur noch 3 Zeilen vor und 2 Zeilen nach der aktuellen Replikat-Zeitleiste an.
Verbesserungen unter K8s
-
Python-Modul kubernetes entfernt (Alexander Kukushkin)
Der offizielle Python-Client für Kubernetes enthält viel automatisch generierten Code und ist daher sehr umfangreich. Patroni verwendet nur einen kleinen Teil der K8s-API-Endpunkte, deren Unterstützung sich leicht direkt implementieren ließ.
-
Umgehen des Service kubernetes ermöglicht (Alexander Kukushkin)
Unter K8s kommuniziert Patroni normalerweise über den Service kubernetes mit der K8s-API. Dessen Adresse steht in
KUBERNETES_SERVICE_HOST. Wie andere Services wird auch kubernetes vonkube-proxybehandelt, das je nach Konfiguration ein Userspace-Programm oderiptableszur Weiterleitung verwendet. Die direkte Verbindung zu den K8s-Master-Knoten ohne diese Zwischenkomponente ermöglicht eine bessere Wiederholungsstrategie und verringert das Risiko, dass Postgres bei Upgrades der K8s-Master-Knoten herabgestuft wird. -
HA-Schleifen aller Pods eines Patroni-Clusters synchronisiert (Alexander Kukushkin)
Ohne dies verlängerte sich die Fehlererkennungszeit von
ttlaufttl + loop_wait. -
referencesundnodenamein den Adressen der Subsets unter K8s ausgefüllt (Alexander Kukushkin)Einige Load-Balancer sind auf diese Angaben angewiesen.
-
Mögliche Race Conditions in
update_leader()behoben (Alexander Kukushkin)Gleichzeitige Aktualisierungen der Leader-ConfigMap oder des Leader-Endpoints außerhalb von Patroni können
update_leader()scheitern lassen. In diesem Fall prüft Patroni erneut, ob der aktuelle Knoten die Leader-Sperre noch besitzt, und wiederholt die Aktualisierung. -
Patchen nicht vorhandener Konfiguration ausdrücklich verboten (Alexander Kukushkin)
Bei anderen DCS als kubernetes schlägt ein PATCH-Aufruf mit einer Ausnahme fehl, weil
cluster.configden WertNonehat. Unter Kubernetes wurde stattdessen die Konfigurationsannotation angelegt. Dadurch konnte nach Abschluss der Initialisierung die Bootstrap-Konfiguration nicht geschrieben werden. -
Fehler im pausierten Modus behoben (Alexander Kukushkin)
Fehlte der Leader-Schlüssel, entfernten Replikate
primary_conninfound starteten Postgres neu, obwohl sie nichts tun sollten.
Verbesserungen der REST-API
-
TLS-Handshake bis zum Start des Arbeitsthreads verzögert (Alexander Kukushkin, Ben Harris)
Fand der TLS-Handshake im API-Thread statt und sendete der Client keine Daten, wurde dieser Thread blockiert (DoS-Risiko).
-
basic-authin der REST-API unabhängig vom Clientzertifikat geprüft (Alexander Kukushkin)Bisher wurde nur das Clientzertifikat geprüft. Beide Prüfungen unabhängig auszuführen, ist ein berechtigter Anwendungsfall.
-
Doppeltes
CRLFnach den HTTP-Headern einerOPTIONS-Anfrage geschrieben (Sergey Burladyan)HAProxy kam mit einem einzelnen
CRLFzurecht, während der Consul-Health-Check eine unterbrochene Verbindung und ein unerwartetes EOF meldete. -
GET /clusterzeigte veraltete Mitgliedsinformationen für ZooKeeper (Alexander Kukushkin)Der Endpunkt verwendete die interne Clustersicht von Patroni. Für Patroni selbst war dies unproblematisch; nach außen müssen jedoch aktuelle Informationen angezeigt werden, insbesondere zum Replikationsrückstand.
-
Health Checks für Standby-Cluster korrigiert (Alexander Kukushkin)
GET /standby-leaderantwortete für einen Primärserver undGET /masterfür einenstandby_leaderfälschlich mit 200. -
DELETE /switchoverimplementiert (Alexander Kukushkin)Der REST-API-Aufruf löscht ein geplantes Switchover.
-
Endpunkte
/readinessund/livenesserstellt (Alexander Kukushkin)Sie können nützlich sein, um beeinträchtigte Pods aus den Subset-Adressen zu entfernen, wenn der K8s-Service mit Label-Selektoren verwendet wird.
-
REST-API-Health-Checks
GET /replicaundGET /asyncerweitert (Krishna Sarabu, Alexander Kukushkin)Die Prüfungen unterstützen nun das optionale Schlüsselwort
?lag=<max-lag>und antworten nur dann mit 200, wenn der Rückstand kleiner als der angegebene Wert ist. Dabei ist zu beachten, dass die WAL-Position des Leaders nur alleloop_waitSekunden aktualisiert wird! -
Benutzerdefinierte HTTP-Header in REST-API-Antworten unterstützt (Yogesh Sharma)
Dies kann bei Anfragen aus einem Browser nützlich sein.
Verbesserungen in patronictl
-
Kein Aufruf eines nicht vorhandenen Leaders durch
patronictl pause(Alexander Kukushkin)Beim Pausieren eines Clusters ohne Leader unter K8s warnte patronictl , dass das Mitglied “None” nicht erreichbar sei.
-
Fehlendes
conn_urleines Mitglieds behandelt (Alexander Kukushkin)Unter K8s kann ein Pod die erforderlichen Annotationen noch nicht besitzen, weil Patroni noch nicht läuft. Dies ließ patronictl fehlschlagen.
-
Ausgabe der Clustertopologie als ASCII-Darstellung hinzugefügt (Maxim Fedotov, Alexander Kukushkin)
Dies gibt einen hilfreichen Überblick über Cluster mit kaskadierender Replikation.
-
patronictl flush switchoverimplementiert (Alexander Kukushkin)Bisher konnte
patronictl flushnur geplante Neustarts abbrechen.
Fehlerbehebungen
-
Attributfehler beim Cluster-Bootstrap mit vorhandenem PGDATA (Krishna Sarabu)
Beim Anlegen oder Aktualisieren von
/historygriff Patroni auf ein ObjektClusterConfigzu, das im DCS noch nicht angelegt war. -
Ausnahmebehandlung für Consul verbessert (Alexander Kukushkin)
Eine unbehandelte Ausnahme in
touch_member()ließ den gesamten Patroni-Prozess abstürzen. -
synchronous_commit=localfür das Skriptpost_initerzwungen (Alexander Kukushkin)Beim Anlegen der Benutzer (
replication,rewind) tat Patroni dies bereits; beipost_initwar es übersehen worden. Setzte das Skript den Wert nicht selbst, konnte die Initialisierung im synchronous_mode nicht abgeschlossen werden. -
maxsizeim Consul-Pool-Manager erhöht (ponvenkates)Der Standardwert
size=1erzeugte einige Warnungen. -
Patroni meldete Postgres fälschlich als laufend (Alexander Kukushkin)
Der Zustand wurde beispielsweise nicht aktualisiert, wenn Postgres wegen eines vollen Datenträgers abstürzte.
-
*statt fehlender oder leerer Werte inpgpassgeschrieben (Alexander Kukushkin)War etwa
standby_cluster.portnicht angegeben, wurde die Dateipgpassfehlerhaft erzeugt. -
Erstellung eines physischen Replikationsslots für den Leader mit Sonderzeichen im Namen übersprungen (Krishna Sarabu)
Bei definierten
slotsschien Patroni für den Leader einen ungenutzten Slot anzulegen, wenn dessen Name Sonderzeichen wie ‘-’ enthielt, etwa “abc-us-1”. -
Entfernen einer nicht vorhandenen
pg_hba.confbeim benutzerdefinierten Bootstrap vermieden (Krishna Sarabu)Patroni schlug fehl, wenn
pg_hba.confnach dem benutzerdefinierten Bootstrap außerhalb vonpgdatalag.
Version 1.6.5
Veröffentlicht am 2020-08-23
Neue Funktionen
-
Zeitüberschreitung beim Stoppen des Primärservers (Krishna Sarabu)
Anzahl der Sekunden, die Patroni beim Stoppen von Postgres warten darf. Wirkt nur bei aktiviertem synchronous_mode . Ist der Wert größer als 0 und synchronous_mode aktiviert, sendet Patroni
SIGKILLan den Postmaster, wenn das Stoppen länger als der mitmaster_stop_timeoutfestgelegte Wert dauert. Der Wert ist entsprechend der gewünschten Abwägung zwischen Dauerhaftigkeit und Verfügbarkeit zu wählen. Ist der Parameter nicht gesetzt oder nicht positiv, hatmaster_stop_timeoutkeine Wirkung. -
Keinen permanenten physischen Slot mit dem Namen des Primärservers erstellen (Alexander Kukushkin)
Ein häufiges Problem ist, dass der Primärserver WAL-Segmente wiederverwendet, während das Replikat ausgefallen ist. Für statische Cluster mit einer festen Anzahl von Knoten und unveränderlichen Namen gibt es nun eine gute Lösung: Die Namen aller Knoten unter
slotsaufführen. Dann entfernt der Primärserver den Slot nicht, wenn der Knoten ausgefallen ist (also nicht im DCS registriert ist). -
Erster Entwurf einer Konfigurationsvalidierung (Igor Yanchenko)
Mit
patroni --validate-config patroni.yamllässt sich die Patroni-Konfiguration validieren. -
Maximale Länge der Timeline-Historie konfigurierbar machen (Krishna Sarabu)
Patroni schreibt die Historie von Failover und Switchover in den Schlüssel
/historyim DCS. Mit der Zeit wird dieser Schlüssel groß, obwohl meist nur die letzten Zeilen von Interesse sind. Mitmax_timelines_historylässt sich die maximale Anzahl der im DCS gespeicherten Einträge der Timeline-Historie festlegen. -
Kompatibilität mit Kazoo 2.7.0 (Danyal Prout)
Die Signaturen einiger nicht öffentlicher Methoden von Kazoo wurden geändert, auf die Patroni angewiesen war.
Verbesserungen in patronictl
-
Tags der Mitglieder anzeigen (Kostiantyn Nemchenko, Alexander Kukushkin)
Tags werden für jeden Knoten einzeln konfiguriert. Bisher gab es keine einfache Möglichkeit, sich einen Überblick darüber zu verschaffen.
-
Ausgabe der Mitglieder verbessern (Alexander Kukushkin)
Der redundante Cluster-Name wird nur noch im Tabellenkopf angezeigt, nicht mehr in jeder Zeile.
-
Mit Fehler abbrechen, wenn eine ausdrücklich angegebene Konfigurationsdatei nicht gefunden wird (Kaarel Moppel)
Zuvor gab patronictl lediglich eine
DEBUG-Meldung aus. -
Fehler in patronictl durch nicht initialisierten K8s-Pod beheben (Alexander Kukushkin)
Patroni ist unter K8s auf bestimmte Pod-Annotationen angewiesen. Wenn einer der Patroni-Pods startet oder stoppt, liegt noch keine gültige Annotation vor, und patronictl brach mit einer Ausnahme ab.
Stabilitätsverbesserungen
-
Nach fehlgeschlagenem LIST-Aufruf an den K8s-API-Server 1 Sekunde warten (Alexander Kukushkin)
Dies verhindert vor allem eine Flut von Protokollmeldungen, hilft aber auch dabei, dem Hauptthread weiterhin Rechenzeit zu ermöglichen.
-
Anfrage wiederholen, wenn die K8s-API den HTTP-Header
retry-afterzurückgibt (Alexander Kukushkin)Bei Überlastung durch Anfragen kann der K8s-API-Server um einen erneuten Versuch bitten.
-
KUBERNETES_-Umgebungsvariablen aus der Umgebung des Postmasters entfernen (Feike Steenbergen)PostgreSQL benötigt die Umgebungsvariablen
KUBERNETES_nicht. Sind sie für den Postmaster verfügbar, können jedoch auch Backends und reguläre Datenbankbenutzer darauf zugreifen, etwa über pl/perl. -
Tablespaces bei der Neuinitialisierung bereinigen (Krishna Sarabu)
Bei der Neuinitialisierung entfernte Patroni nur
PGDATAund ließ benutzerdefinierte Tablespace-Verzeichnisse bestehen. Dadurch geriet Patroni in eine Schleife wiederholter Neuinitialisierungen. Bisher ließ sich das Problem mit einem Skript für einen benutzerdefinierten Bootstrap umgehen. -
Nach der Hochstufung ausdrücklich
CHECKPOINTausführen (Alexander Kukushkin)Dadurch verkürzt sich die Zeit, bis der neue Primärserver für
pg_rewindverwendbar ist. -
etcd-Mitglieder gezielt aktualisieren (Alexander Kukushkin)
Schlägt eine Anfrage bei allen Mitgliedern des etcd-Clusters fehl, prüft Patroni vor dem nächsten Versuch erneut die
A- oderSRV-Einträge auf Änderungen der IPs/Hosts. -
Fehlende Werte aus
pg_controldataüberspringen (Feike Steenbergen)Werte fehlen, wenn ausführbare Dateien einer Version verwendet werden, die nicht zu PGDATA passt. Patroni versucht dennoch, Postgres zu starten. Postgres meldet dann die abweichende Hauptversion und bricht mit einem Fehler ab.
Fehlerbehebungen
-
SSL-Prüfung für Consul bei Bedarf deaktivieren (Julien Riou)
Ab einer bestimmten Version von
urllib3musscert_reqsausdrücklich aufssl.CERT_NONEgesetzt werden, um die SSL-Prüfung tatsächlich zu deaktivieren. -
Nicht in jedem Durchlauf der HA-Schleife eine Replikationsverbindung öffnen (Alexander Kukushkin)
Diese Regression wurde in 1.6.4 eingeführt.
-
Callback
on_role_changeauf einem ausgefallenen Primärserver aufrufen (Alexander Kukushkin)Unter bestimmten Umständen konnte die virtuelle IP am alten Primärserver verbleiben. Diese Regression wurde in 1.4.5 eingeführt.
-
Rewind-Zustand zurücksetzen, wenn Postgres nach erfolgreichem pg_rewind gestartet wurde (Alexander Kukushkin)
Aufgrund dieses Fehlers startete Patroni im Pausenmodus ein manuell heruntergefahrenes Postgres wieder.
-
Bei der Prüfung von
recovery.confden Wert vonrecovery_min_apply_delayinmsumrechnenWar
recovery_min_apply_delayunter einer PostgreSQL-Version vor 12 konfiguriert, startete Patroni das Replikat endlos neu. -
Kompatibilität mit PyInstaller (Alexander Kukushkin)
PyInstaller bündelt Python-Anwendungen zu eigenständig ausführbaren Dateien. Die Kompatibilität ging beim Wechsel von
forkzuspawnfürmultiprocessingverloren.
Version 1.6.4
Veröffentlicht am 2020-01-27
Neue Funktionen
-
Option
--waitfürpatronictl reinitimplementieren (Igor Yanchenko)Mit der Option
--waitwartet Patronictl auf den Abschluss vonreinit. -
Weitere Verbesserungen der Windows-Unterstützung (Igor Yanchenko, Alexander Kukushkin)
- Alle für Integrationstests verwendeten Shell-Skripte wurden in Python neu geschrieben.
- Auf Nicht-POSIX-Systemen wird Postgres mit
pg_ctl killgestoppt. - Es wird nicht versucht, Unix-Domain-Sockets zu verwenden.
Stabilitätsverbesserungen
-
Sicherstellen, dass
unix_socket_directoriesundstats_temp_directoryexistieren (Igor Yanchenko)Beim Start von Patroni und Postgres wird geprüft, ob
unix_socket_directoriesundstats_temp_directoryexistieren, andernfalls wird versucht, sie anzulegen. Schlägt das Anlegen fehl, beendet sich Patroni. -
Sicherstellen, dass
postgresql.pgpassan einem Ort liegt, auf den Patroni Schreibzugriff hat (Igor Yanchenko)Ohne Schreibzugriff beendet sich Patroni mit einer Ausnahme.
-
Consul-Prüfung
serfHealthstandardmäßig deaktivieren (Kostiantyn Nemchenko)Selbst bei kleinen Netzwerkproblemen führt eine fehlgeschlagene
serfHealth-Prüfung dazu, dass alle dem Knoten zugeordneten Sessions ungültig werden. Dadurch geht der Leader-Schlüssel deutlich vor Ablauf vonttlverloren, was unerwünschte Neustarts von Replikaten und möglicherweise eine Herabstufung des Primärservers verursacht. -
TCP-Keepalives für Verbindungen zur K8s-API konfigurieren (Alexander Kukushkin)
Werden nach TTL Sekunden keine Daten vom Socket empfangen, kann die Verbindung als unterbrochen gelten.
-
Protokollierung von Passwörtern bei der Benutzererstellung vermeiden (Alexander Kukushkin)
Wird das Passwort zurückgewiesen oder ist die Protokollierung ausführlich beziehungsweise gar nicht konfiguriert, kann das Passwort in den Postgres-Protokollen landen. Um dies zu vermeiden, setzt Patroni
log_statement,log_min_duration_statementundlog_min_error_statementvor dem Versuch, einen Benutzer zu erstellen oder zu aktualisieren, auf sichere Werte.
Fehlerbehebungen
-
Auf kaskadierenden Replikaten
restore_commandaus der Konfiguration standby_cluster verwenden (Alexander Kukushkin)Der
standby_leadertat dies bereits seit Einführung der Funktion. Geschieht dies nicht auch auf Replikaten, können sie möglicherweise nicht zum Standby-Leader aufholen. -
Vom Standby-Cluster gemeldete Timeline aktualisieren (Alexander Kukushkin)
Bei einem Timeline-Wechsel replizierte der Standby-Cluster korrekt vom Primärserver, aber patronictl meldete die alte Timeline.
-
Bestimmte Recovery-Parameter in custom_conf zulassen (Alexander Kukushkin)
Bei der Validierung der Recovery-Parameter auf einem Replikat überspringt Patroni
archive_cleanup_command,promote_trigger_file,recovery_end_command,recovery_min_apply_delayundrestore_command, wenn sie nicht in der Patroni-Konfiguration, sondern in anderen Dateien alspostgresql.auto.confoderpostgresql.conffestgelegt sind. -
Behandlung von PostgreSQL-Parametern mit Punkt im Namen verbessern (Alexander Kukushkin)
Solche Parameter können von Erweiterungen definiert werden, wobei die Einheit nicht unbedingt eine Zeichenkette ist. Eine Wertänderung kann einen Neustart erfordern, etwa bei
pg_stat_statements.max. -
Ausnahmebehandlung beim Herunterfahren verbessern (Alexander Kukushkin)
Beim Herunterfahren versucht Patroni, seinen Status im DCS zu aktualisieren. Ist der DCS nicht erreichbar, kann eine Ausnahme auftreten. Die fehlende Ausnahmebehandlung verhinderte das Beenden des Protokollierungsthreads.
Version 1.6.3
Veröffentlicht am 2019-12-05
Fehlerbehebungen
-
Passwort bei der Ausführung von
pg_rewindnicht offenlegen (Alexander Kukushkin)Der Fehler wurde mit #1301 eingeführt.
-
Verbindungsparameter aus
postgresql.authenticationaufpg_basebackupund benutzerdefinierte Methoden zur Replikaterstellung anwenden (Alexander Kukushkin)Diese verwendeten eine URL-artige Verbindungszeichenfolge, weshalb die Parameter nie angewendet wurden.
Version 1.6.2
Veröffentlicht am 2019-12-05
Neue Funktionen
-
patroni --versionimplementieren (Igor Yanchenko)Der Befehl gibt die aktuelle Patroni-Version aus und beendet sich.
-
HTTP-Header
user-agentfür alle HTTP-Anfragen setzen (Alexander Kukushkin)Patroni kommuniziert über HTTP mit den APIs von Consul, etcd und Kubernetes. Ein gezielt zusammengesetzter
user-agent(z. B.Patroni/1.6.2 Python/3.6.8 Linux) kann bei der Fehlersuche und Überwachung hilfreich sein. -
Protokollstufe für Ausnahme-Tracebacks konfigurierbar machen (Igor Yanchenko)
Bei
log.traceback_level=DEBUGwerden Tracebacks nur angezeigt, wennlog.level=DEBUGgesetzt ist. Das Standardverhalten bleibt unverändert.
Stabilitätsverbesserungen
-
Beim Suchen des in der Konfigurationsdatei benötigten Moduls nicht alle DCS-Module importieren (Alexander Kukushkin)
Wird beispielsweise nur Zookeeper benötigt, müssen die Module für etcd, Consul und Kubernetes nicht importiert werden. Das reduziert den Speicherverbrauch und vermeidet die INFO-Meldungen
Failed to import smth. -
Python-Modul
requestsaus den expliziten Abhängigkeiten entfernen (Alexander Kukushkin)Es wurde für keine kritische Funktion verwendet, verursachte aber bei neuen Versionen von
urllib3zahlreiche Probleme. -
Behandlung von
etcd.hostsals kommagetrennter Zeichenkette statt YAML-Array verbessern (Igor Yanchenko)Zuvor führte das Format
host1:port1, host2:port2(mit Leerzeichen nach dem Komma) zu einem Fehler.
Verbesserungen der Bedienbarkeit
-
In patronictl keine Auswahl aus einer leeren Mitgliederliste verlangen (Igor Yanchenko)
Bei einem falschen Cluster-Namen wird eine Ausnahme ausgelöst, statt zur Auswahl eines Mitglieds aus einer leeren Liste aufzufordern.
-
Aussagekräftigere Fehlermeldung, wenn sich die REST API nicht an eine Adresse binden kann (Igor Yanchenko)
Für unerfahrene Nutzer kann die Ursache anhand eines Python-Stacktraces schwer zu erkennen sein.
Fehlerbehebungen
-
Berechnung von
wal_bufferskorrigieren (Alexander Kukushkin)In PostgreSQL 11 wurde die Basiseinheit von Blöcken mit 8 kB auf Bytes geändert.
-
passfileinprimary_conninfonur unter PostgreSQL 10+ verwenden (Alexander Kukushkin)Bei älteren Versionen ist die Funktion von
passfilenur gewährleistet, wenn die neueste Version vonlibpqinstalliert ist.
Version 1.6.1
Veröffentlicht am 2019-11-15
Neue Funktionen
-
Umgebungsvariable
PATRONICTL_CONFIG_FILEhinzufügen (msvechla)Damit lässt sich das Argument
--config-filefür patronictl über die Umgebung konfigurieren. -
patronictl historyimplementieren (Alexander Kukushkin)Der Befehl zeigt die Historie von Failover und Switchover.
-
Bei
pg_rewindden Wert-c statement_timeout=0inPGOPTIONSübergeben (Alexander Kukushkin)Dadurch wird verhindert, dass eine von pg_rewind ausgeführte Anweisung abgebrochen wird, weil
statement_timeoutauf dem Server sehr niedrig eingestellt ist. -
Niedrigere Werte für die PostgreSQL-Konfiguration zulassen (Soulou)
Patroni ließ für einige PostgreSQL-Konfigurationsparameter keine Werte unterhalb fest programmierter Grenzen zu. Die zulässigen Mindestwerte wurden gesenkt; die Standardwerte bleiben unverändert.
-
Zertifikatsbasierte Authentifizierung ermöglichen (Jonathan S. Katz)
Diese Funktion ermöglicht zertifikatsbasierte Authentifizierung für Superuser-, Replikations- und Rewind-Konten. Außerdem kann der gewünschte
sslmodefür die Verbindung festgelegt werden. -
In
primary_conninfoanstelle des Passwortspassfileverwenden (Alexander Kukushkin)Dadurch müssen für postgresql.conf keine Berechtigungen von
600gesetzt werden. -
pg_ctl reloadunabhängig von Konfigurationsänderungen ausführen (Alexander Kukushkin)Manche Konfigurationsdateien werden möglicherweise nicht von Patroni verwaltet. Beim Neuladen über die REST API oder durch Senden von SIGHUP an den Patroni-Prozess wird üblicherweise erwartet, dass auch Postgres neu geladen wird. Zuvor geschah dies nicht, wenn der Abschnitt
postgresqlder Patroni-Konfiguration unverändert war. -
Alle Recovery-Parameter vergleichen, nicht nur
primary_conninfo(Alexander Kukushkin)Zuvor prüfte die Methode
check_recovery_conf()nur Änderungen anprimary_conninfound berücksichtigte keine anderen Recovery-Parameter. -
Einige Recovery-Parameter ohne Neustart anwenden können (Alexander Kukushkin)
Ab PostgreSQL 12 lassen sich folgende Recovery-Parameter ohne Neustart ändern:
archive_cleanup_command,promote_trigger_file,recovery_end_commandundrecovery_min_apply_delay. Diese Liste wird in künftigen Postgres-Versionen erweitert, und Patroni wird dies automatisch unterstützen. -
Änderung von
use_slotsim laufenden Betrieb ermöglichen (Alexander Kukushkin)Zuvor mussten dafür Patroni neu gestartet und Slots manuell entfernt werden.
-
Beim Start von Postgres nur Umgebungsvariablen mit dem Präfix
PATRONI_entfernen (Cody Coons)Dadurch werden zahlreiche Probleme beim Einsatz verschiedener Foreign Data Wrappers gelöst.
Stabilitätsverbesserungen
-
Bei der Arbeit mit der K8s-API LIST + WATCH verwenden (Alexander Kukushkin)
Dadurch lassen sich Objektänderungen (Pods, Endpoints/ConfigMaps) effizient empfangen, und die K8s-Masterknoten werden weniger belastet.
-
Ablauf verbessern, wenn PGDATA beim Bootstrap nicht leer ist (Alexander Kukushkin)
Laut dem Quellcode von
initdbkann PGDATA als leer gelten, wenn es lediglichlost+foundund.dotfilesenthält. Patroni verhält sich nun ebenso. IstPGDATAnicht leer und aus Sicht vonpg_controldatazugleich ungültig, meldet Patroni einen Fehler und beendet sich. -
Aufwendigen Aufruf von
os.listdir()in jedem HA-Schleifendurchlauf vermeiden (Alexander Kukushkin)Unter hoher IO-Last kann
os.listdir()mehrere Sekunden oder sogar Minuten benötigen und die HA-Schleife von Patroni erheblich beeinträchtigen. Wegen ausbleibender Aktualisierungen kann dadurch sogar der Leader-Schlüssel aus dem DCS verschwinden. Eine bessere und weniger aufwendige Prüfung, ob PGDATA nicht leer ist, besteht darin, das Vorhandensein der Dateiglobal/pg_controlin PGDATA zu prüfen. Dies wird nun verwendet. -
Verbesserungen an der Protokollierungsinfrastruktur (Alexander Kukushkin)
Zuvor konnten beim Herunterfahren die letzten Protokollzeilen verloren gehen, weil der Protokollierungsthread ein
daemon-Thread war. -
Unter Python 3.4+ die Multiprocessing-Startmethode
spawnverwenden (Maciej Kowalczyk)In Python besteht ein bekanntes Problem beim Zusammenspiel von Threads und Multiprocessing. Der Wechsel von der Standardmethode
forkzuspawnwird als Umgehung empfohlen. Andernfalls kann der Prozess zum Starten des Postmasters hängen bleiben, und Patroni meldet endlosINFO: restarting after failure in progress, obwohl Postgres tatsächlich läuft.
Verbesserungen der REST API
-
Prüfung von Client-Zertifikaten in der REST API ermöglichen (Alexander Kukushkin)
Bei
verify_clientmit dem Wertrequiredprüft Patroni Client-Zertifikate für alle REST-API-Aufrufe. Beioptionalwerden Client-Zertifikate für alle unsicheren REST-API-Endpunkte geprüft. -
Bei der Health-Check-Anfrage
GET /replicaden Antwortcode 503 zurückgeben, wenn Postgres nicht läuft (Alexander Anikin)Postgres kann längere Zeit in der Recovery verbringen, bevor es Client-Verbindungen annimmt.
-
Endpunkte
/historyund/clusterimplementieren (Alexander Kukushkin)Der Endpunkt
/historyzeigt den Inhalt des Schlüsselshistoryim DCS. Der Endpunkt/clusterzeigt alle Cluster-Mitglieder und Betriebsinformationen, etwa ausstehende oder geplante Neustarts beziehungsweise Switchover.
Verbesserungen der etcd-Unterstützung
-
Bei internem etcd-RAFT-Fehler erneut versuchen (Alexander Kukushkin)
Beim Herunterfahren sendet ein etcd-Knoten
response code=300, data='etcdserver: server stopped'. Dies führte dazu, dass Patroni den Primärserver herabstufte. -
Wiederholungsversuche für etcd-Anfragen nicht zu früh aufgeben (Alexander Kukushkin)
Bei Netzwerkproblemen hatte Patroni die Liste der etcd-Knoten schnell ausgeschöpft und gab auf, ohne die gesamte Zeit
retry_timeoutzu nutzen. Dies konnte zur Herabstufung des Primärservers führen.
Fehlerbehebungen
-
synchronous_commitbeim Erteilen von Ausführungsrechten an den Benutzer fürpg_rewinddeaktivieren (kremius)Beim Bootstrap mit
synchronous_mode_strict: truewartete die AnweisungGRANT EXECUTEunbegrenzt, da keine synchronen Standby-Knoten verfügbar waren. -
Speicherleck unter Python 3.7 beheben (Alexander Kukushkin)
Patroni verwendet
ThreadingMixInzur Verarbeitung von REST-API-Anfragen. Seit Python 3.7 sind die für jede Anfrage erzeugten Threads standardmäßig keine Daemon-Threads. -
Race Conditions bei asynchronen Aktionen beheben (Alexander Kukushkin)
Es konnte vorkommen, dass
patronictl reinit --forcedurch den Versuch überschrieben wurde, ein gestopptes Postgres wiederherzustellen. Dadurch versuchte Patroni, Postgres zu starten, während das Basis-Backup noch lief. -
Race Condition in der Methode
postmaster_start_time()beheben (Alexander Kukushkin)Wird die Methode aus dem REST-API-Thread ausgeführt, muss ein separates Cursor-Objekt erstellt werden.
-
Fehler bei der Hochstufung synchroner Standbys mit Großbuchstaben im Namen beheben (Alexander Kukushkin)
Der Name wurde in Kleinbuchstaben umgewandelt, weil Postgres beim Vergleich von
application_namemit dem Wert insynchronous_standby_namesebenso vorging. -
Vor dem Start eines neuen Callbacks alle Kindprozesse zusammen mit dem Callback-Prozess beenden (Alexander Kukushkin)
Andernfalls lassen sich Callbacks in Bash nur schwer implementieren, und es können schließlich zwei Callbacks gleichzeitig laufen.
-
Problem mit ‘start failed’ beheben (Alexander Kukushkin)
Unter bestimmten Bedingungen konnte der Postgres-Zustand auf ‘start failed’ gesetzt werden, obwohl Postgres lief.
Version 1.6.0
Veröffentlicht am 2019-08-05
Diese Version ergänzt die Kompatibilität mit PostgreSQL 12, ermöglicht pg_rewind ohne Superuser unter PostgreSQL 11 und neuer und aktiviert die IPv6-Unterstützung.
Neue Funktionen
-
Psycopg2 aus den Abhängigkeiten entfernen; separate Installation erforderlich (Alexander Kukushkin)
Ab 2.8.0 wurde
psycopg2in zwei Pakete aufgeteilt:psycopg2undpsycopg2-binary. Beide konnten gleichzeitig an derselben Stelle im Dateisystem installiert werden. Um Abhängigkeitsprobleme zu verringern, bleibt die Installationsmethode den Nutzern überlassen. Die verfügbaren Möglichkeiten beschreibt die Dokumentation . -
Kompatibilität mit PostgreSQL 12 (Alexander Kukushkin)
Ab PostgreSQL 12 gibt es keine
recovery.confmehr; alle bisherigen Recovery-Parameter wurden in GUCs umgewandelt. Zum Schutz vorALTER SYSTEM SET primary_conninfound ähnlichen Änderungen analysiert Patronipostgresql.auto.confund entfernt daraus alle Standby- und Recovery-Parameter. Die Patroni-Konfiguration bleibt abwärtskompatibel: Obwohlrestore_commandnun ein GUC ist, kann es weiterhin im Abschnittpostgresql.recovery_conf.restore_commandangegeben werden. Patroni schreibt es für PostgreSQL 12 inpostgresql.conf. -
pg_rewindohne Superuser unter PostgreSQL 11 und neuer ermöglichen (Alexander Kukushkin)Für diese Funktion müssen
usernameundpasswordim Abschnittpostgresql.authentication.rewindder Patroni-Konfigurationsdatei festgelegt werden. Bei einem bestehenden Cluster muss der Benutzer manuell erstellt und für einige Funktionen die BerechtigungGRANT EXECUTEerteilt werden. Weitere Einzelheiten finden sich in der PostgreSQL-Dokumentation . -
Tatsächliche und gewünschte Werte von
primary_conninfoauf Replikaten gezielt vergleichen (Alexander Kukushkin)Dies kann einen Neustart des Replikats vermeiden, wenn ein bestehender Primärserver-/Standby-Cluster auf die Verwaltung durch Patroni umgestellt wird.
-
IPv6-Unterstützung (Alexander Kukushkin)
Es gab zwei wesentliche Probleme: Der REST-API-Dienst von Patroni lauschte nur auf
0.0.0.0, und IPv6-Adressen inapi_urlundconn_urlwurden nicht korrekt in eckige Klammern gesetzt. -
Kerberos-Unterstützung (Ajith Vilas, Alexander Kukushkin)
Damit kann zwischen Postgres-Knoten Kerberos-Authentifizierung verwendet werden, anstatt Passwörter in der Patroni-Konfigurationsdatei festzulegen.
-
pg_ident.confverwalten (Alexander Kukushkin)Diese Funktion arbeitet ähnlich wie
pg_hba.conf: Istpostgresql.pg_identin der Konfigurationsdatei oder im DCS definiert, schreibt Patroni dessen Wert inpg_ident.conf. Ist jedochpostgresql.parameters.ident_filedefiniert, geht Patroni davon aus, dasspg_identextern verwaltet wird, und aktualisiert die Datei nicht.
Verbesserungen der REST API
-
Endpunkt
/healthhinzufügen (Wilfried Roset)Er gibt nur dann den HTTP-Statuscode 200 zurück, wenn PostgreSQL läuft.
-
Endpunkte
/read-onlyund/read-writehinzufügen (Julien Riou)Der Endpunkt
/read-onlyverteilt Lesezugriffe auf Replikate und den Primärserver. Der Endpunkt/read-writeist ein Alias für/primary,/leaderund/master. -
REST-API-Socket mit
SSLContextumschließen (Julien Riou)ssl.wrap_socket()ist veraltet und ließ weiterhin Protokolle wie TLS 1.1 zu, die demnächst ebenfalls veraltet sein würden.
Verbesserungen der Protokollierung
-
Zweistufige Protokollierung (Alexander Kukushkin)
Alle Protokollmeldungen werden zunächst in eine Warteschlange im Arbeitsspeicher geschrieben und später asynchron aus einem separaten Thread nach stderr oder in eine Datei ausgegeben. Die maximale Größe der Warteschlange ist begrenzt und konfigurierbar. Wird die Grenze erreicht, gehen Protokollmeldungen verloren. Dies ist weiterhin besser, als die HA-Schleife zu blockieren.
-
Debug-Protokollierung für API-Aufrufe mit GET/OPTIONS einschließlich Latenz aktivieren (Jan Tomsa)
Dies erleichtert die Fehlersuche bei Health Checks durch HAProxy, Consul oder andere Werkzeuge, die den Primärserver beziehungsweise die Replikate ermitteln.
-
In Retry abgefangene Ausnahmen protokollieren (Daniel Kucera)
Sobald die maximale Anzahl von Versuchen oder die Wartezeit erreicht ist, wird die letzte Ausnahme protokolliert. Dies soll die Fehlersuche bei gestörter Kommunikation mit dem DCS erleichtern.
Verbesserungen in patronictl
-
Dialoge für geplante Switchover und Neustarts verbessern (Rafia Sabih)
Zuvor berücksichtigten die Dialoge geplante Aktionen nicht und waren dadurch irreführend.
-
Existenz der Konfigurationsdatei prüfen (Wilfried Roset)
Wenn die angegebene Datei nicht existiert, wird dies ausdrücklich gemeldet, statt es stillschweigend zu ignorieren und damit Missverständnisse zu begünstigen.
-
Ersatzwert für
EDITORhinzufügen (Wilfried Roset)War die Umgebungsvariable
EDITORnicht definiert, brachpatronictl edit-configmitPatroniCtlExceptionab. Die neue Strategie versucht zunächsteditor, dannvi, das auf den meisten Systemen verfügbar sein sollte.
Verbesserungen der Consul-Unterstützung
-
Konsistenzmodus für Consul konfigurierbar machen (Jan Tomsa)
Weitere Informationen zum Konsistenzmodus finden sich hier .
-
Consul-Konfiguration bei SIGHUP neu laden (Cameron Daniel Kucera, Alexander Kukushkin)
Dies ist besonders nützlich, wenn der Wert von
tokengeändert wird.
Fehlerbehebungen
-
Sonderfall bei Switchover/Failover beheben (Sharoon Thomas)
Die Variable
scheduled_atkann undefiniert sein, wenn die REST API nicht erreichbar ist und stattdessen der DCS verwendet wird. -
Bei benutzerdefiniertem Bootstrap trust für localhost in
pg_hba.conffreigeben (Alexander Kukushkin)Zuvor war dies nur für unix_socket freigegeben, was zahlreiche Fehler verursachte:
FATAL: no pg_hba.conf entry for replication connection from host "127.0.0.1", user "replicator" -
Synchronen Knoten auch dann als funktionsfähig einstufen, wenn der bisherige Leader weiter fortgeschritten ist (Alexander Kukushkin)
Verliert der Primärserver den Zugriff auf den DCS, startet er Postgres im schreibgeschützten Modus neu. Andere Knoten können den alten Primärserver jedoch möglicherweise weiterhin über die REST API erreichen. In diesem Fall wurde der synchrone Standby nicht hochgestuft, weil der alte Primärserver eine weiter fortgeschrittene WAL-Position meldete.
-
Fehlerbehebungen für Standby-Cluster (Alexander Kukushkin)
Der Bootstrap eines Replikats in einem Standby-Cluster bei nicht erreichbarem standby_leader wird ermöglicht. Hinzu kommen einige kleinere Korrekturen.
Version 1.5.6
Veröffentlicht am 2019-08-03
Neue Funktionen
-
Zugriff auf einen etcd-Cluster über mehrere Proxys unterstützen (Alexander Kukushkin)
Ein etcd-Cluster ist möglicherweise nur über mehrere Proxys und nicht direkt erreichbar. In diesem Fall ermittelt Patroni die etcd-Topologie nicht, sondern verwendet die Proxy-Hosts reihum. Das Verhalten wird über
etcd.use_proxiesgesteuert. -
Callback-Verhalten bei Rollenänderung eines Knotens ändern (Alexander Kukushkin)
Wechselt die Rolle von
masteroderstandby_leaderzureplicaoder vonreplicazustandby_leader, wird statton_restartnun der Callbackon_role_changeaufgerufen. -
Startverfahren für Postgres ändern (Alexander Kukushkin)
Statt sich selbst auszuführen, wird
multiprocessing.Processverwendet. Die Postmaster-PID wird übermultiprocessing.Pipean den Patroni-Prozess übertragen. Zuvor wurden Pipes verwendet, wodurch stdin beim Postmaster-Prozess geschlossen blieb.
Fehlerbehebungen
-
Von der REST API zurückgegebene Rolle des Standby-Leaders korrigieren (Alexander Kukushkin)
Fälschlicherweise wurde
replicastattstandby_leaderzurückgegeben. -
Auf das Ende eines Callbacks warten, wenn er nicht beendet werden kann (Julien Tachoires)
Patroni hat nicht genügend Rechte, um ein unter
sudolaufendes Callback-Skript zu beenden. Dadurch wurde der neue Callback verworfen. Kann das laufende Skript nicht beendet werden, wartet Patroni nun auf dessen Abschluss und führt anschließend den nächsten Callback aus. -
Sperrdauer der Methode dcs.get_cluster verkürzen (Alexander Kukushkin)
Weil die Sperre gehalten wurde, beeinträchtigte ein langsamer DCS die REST-API-Health-Checks und führte zu Fehlalarmen.
-
Bereinigung von PGDATA verbessern, wenn
pg_wal/pg_xlogein symbolischer Link ist (Julien Tachoires)In diesem Fall entfernt Patroni Dateien ausdrücklich aus dem Zielverzeichnis.
-
Unnötige Verwendung von os.path.relpath entfernen (Ants Aasma)
Die Funktion muss das Arbeitsverzeichnis auflösen können. Dies schlägt fehl, wenn Patroni in einem Verzeichnis gestartet wird, das später aus dem Dateisystem entfernt wird.
-
Bei der Kommunikation mit etcd keine SSL-Version erzwingen (Alexander Kukushkin)
Aus unbekanntem Grund basiert python3-etcd unter Debian und Ubuntu nicht auf der neuesten Paketversion und erzwingt deshalb TLSv1, das von etcd v3 nicht unterstützt wird. Dieses Problem wurde auf Patroni-Seite behoben.
Version 1.5.5
Veröffentlicht am 2019-02-15
Diese Version ermöglicht die automatische Neuinitialisierung des bisherigen Primärservers, verbessert die Ausgabe von patronictl list und behebt mehrere Fehler.
Neue Funktionen
-
Umgebungsvariablen
PATRONI_ETCD_PROTOCOL,PATRONI_ETCD_USERNAMEundPATRONI_ETCD_PASSWORDunterstützen (Étienne M)Zuvor konnten diese Werte nur in der Konfigurationsdatei oder als Teil von
PATRONI_ETCD_URLfestgelegt werden, was nicht immer praktisch ist. -
Automatische Neuinitialisierung des bisherigen Primärservers ermöglichen (Alexander Kukushkin)
Ist pg_rewind deaktiviert oder nicht verwendbar, kann der bisherige Primärserver aufgrund auseinanderlaufender Timelines möglicherweise nicht als neues Replikat starten. In diesem Fall hilft nur, das Datenverzeichnis zu löschen und die Instanz neu zu initialisieren. Dieses Verhalten lässt sich mit
postgresql.remove_data_directory_on_diverged_timelinesändern. Ist die Option gesetzt, löscht Patroni das Datenverzeichnis und initialisiert den bisherigen Primärserver automatisch neu. -
Timeline-Informationen in patronictl list anzeigen (Alexander Kukushkin)
Dies erleichtert das Erkennen veralteter Replikate. Außerdem enthält
Hostden Zusatz ‘:{port}’, wenn der Port vom Standardwert abweicht oder mehrere Mitglieder auf demselben Host laufen. -
Einen Headless Service für den Endpoint $SCOPE-config erstellen (Alexander Kukushkin)
Der Endpoint „config“ enthält die clusterweite Patroni- und Postgres-Konfiguration, die History-Datei und vor allem den Schlüssel
initialize. Beim Neustart oder Upgrade eines Kubernetes-Masterknotens werden Endpoints ohne zugehörige Services entfernt. Der Headless Service verhindert dies.
Fehlerbehebungen
-
Lesezeitlimit für die blockierende Leader-Watch-Abfrage anpassen (Alexander Kukushkin)
Laut Consul-Dokumentation wird das tatsächliche Antwortzeitlimit um eine kleine zufällige Wartezeit erhöht, die zur angegebenen maximalen Wartezeit addiert wird. Dadurch werden die Aufwachzeitpunkte gleichzeitiger Anfragen verteilt. Dadurch verlängert sich die maximale Dauer um bis zu
wait / 16. Hier wirdwait / 15oder 1 Sekunde addiert, je nachdem, welcher Wert größer ist. -
Bei Verbindungen zu Postgres über das Replikationsprotokoll immer replication=1 verwenden (Alexander Kukushkin)
Ab Postgres 10 akzeptiert eine Zeile mit database=replication in pg_hba.conf keine Verbindungen mit dem Parameter replication=database.
-
Für einen Standby-Cluster mit ausschließlicher WAL-Nutzung kein primary_conninfo in recovery.conf schreiben (Alexander Kukushkin)
Obwohl in der Konfiguration standby_cluster weder
hostnochportdefiniert war, schrieb Patroniprimary_conninfoinrecovery.conf. Dies ist nutzlos und verursachte zahlreiche Fehler.
Version 1.5.4
Veröffentlicht am 2019-01-15
Diese Version führt eine flexible Protokollierung ein und behebt mehrere Fehler.
Neue Funktionen
-
Verbesserungen an der Protokollierungsinfrastruktur (Alexander Kukushkin, Lucas Capistrant, Alexander Anikin)
Die Protokollierung lässt sich nun sowohl über Umgebungsvariablen als auch über die Patroni-Konfigurationsdatei konfigurieren. Damit kann die Konfiguration im laufenden Betrieb geändert werden: durch Aktualisieren der Datei und anschließendes Neuladen oder Senden von SIGHUP an den Patroni-Prozess. Standardmäßig schreibt Patroni Protokolle nach stderr. Nun können sie auch direkt in eine Datei geschrieben und beim Erreichen einer bestimmten Größe rotiert werden. Außerdem werden ein eigenes Datumsformat und die gezielte Einstellung der Protokollstufe für jedes Python-Modul unterstützt.
-
Berücksichtigung der aktuellen Timeline bei der Leader-Wahl ermöglichen (Alexander Kukushkin)
Ein Knoten konnte sich als den am besten geeigneten einstufen, obwohl er sich nicht auf der zuletzt bekannten Timeline befand. Um seine Hochstufung in solchen Fällen zu verhindern, kann
check_timelineauftruegesetzt werden. Das Standardverhalten bleibt unverändert. -
Anforderungen an Superuser-Zugangsdaten lockern
Libpq kann Verbindungen ohne ausdrückliche Angabe von Benutzername oder Passwort öffnen. Je nach Situation verwendet es die Datei pgpass oder die Authentifizierungsmethode trust in pg_hba.conf. Da pg_rewind ebenfalls libpq verwendet, gilt dort dasselbe Verhalten.
-
Consul-Service-Registrierung und Prüfintervall über Umgebungsvariablen konfigurierbar machen (Alexander Kukushkin)
Die Service-Registrierung in Consul wurde in 1.5.0 eingeführt, ließ sich bisher aber nur über patroni.yaml aktivieren.
Stabilitätsverbesserungen
-
Bei benutzerdefiniertem Bootstrap archive_mode auf off setzen (Alexander Kukushkin)
WAL- und History-Dateien sollen erst archiviert werden, wenn der Cluster vollständig funktionsfähig ist. Dies ist besonders hilfreich, wenn der benutzerdefinierte Bootstrap pg_upgrade verwendet.
-
Beim Laden der globalen Konfiguration während des Starts fünf Sekunden zwischen Versuchen warten (Alexander Kukushkin)
So wird der DCS beim Start von Patroni nicht durch ständige Anfragen belastet.
-
Anzahl der Fehlermeldungen beim Herunterfahren verringern (Alexander Kukushkin)
Sie waren harmlos, aber lästig und teilweise beunruhigend.
-
Lese- und Schreibrechte für recovery.conf bereits beim Erstellen ausdrücklich absichern (Lucas Capistrant)
Nur der Benutzer patroni/postgres soll diese Datei lesen können, da sie den Replikationsbenutzernamen und das Passwort enthält.
-
Ausnahmen von HTTPServer an die Protokollierung weiterleiten (Julien Riou)
Standardmäßig wurden diese Ausnahmen auf der Standardausgabe protokolliert und störten dadurch die regulären Protokolle.
Fehlerbehebungen
-
Umleitung von stderr nach stdout beim pg_ctl-Prozess entfernen (Cody Coons)
Durch das Erben von stderr vom Patroni-Hauptprozess werden alle Postgres-Protokolle zusammen mit allen Patroni-Protokollen sichtbar. Dies ist in Containern sehr nützlich, da beide mit Standardwerkzeugen wie docker logs oder kubectl erfasst werden können. Außerdem behebt die Änderung einen Fehler, bei dem Patroni die Postmaster-PID nicht ermitteln konnte, wenn Postgres Warnungen nach stderr schrieb.
-
Zeitlimit zum Deregistrieren der Consul-Service-Prüfung im Go-Zeitformat angeben (Pavel Kirillov)
Ohne ausdrückliche Zeiteinheit schlug die Registrierung fehl.
-
Prüfungen der Konfiguration von standby_cluster lockern (Dmitry Dolgov, Alexander Kukushkin)
Bisher wurden nur Zeichenketten als gültige Werte akzeptiert. Daher konnte port nicht als Ganzzahl und create_replica_methods nicht als Liste angegeben werden.
Version 1.5.3
Veröffentlicht am 2018-12-03
Version mit Kompatibilitätsverbesserungen und Fehlerbehebungen.
-
Stabilität bei der Verwendung von Python 3 mit Zookeeper verbessern (Alexander Kukushkin)
Eine Änderung von
loop_waitführte dazu, dass Patroni die Verbindung zu Zookeeper trennte und nicht erneut herstellte. -
Kompatibilität mit Postgres 9.3 wiederherstellen (Alexander Kukushkin)
Beim Öffnen einer Replikationsverbindung sollte replication=1 angegeben werden, da 9.3 replication=‘database’ nicht versteht.
-
Consul-Session mindestens einmal pro HA-Schleifendurchlauf erneuern und Behandlung von Session-Ausnahmen verbessern (Alexander Kukushkin)
Ein Neustart des lokalen Consul-Agenten macht alle dem Knoten zugeordneten Sessions ungültig. Eine verspätete Erneuerung und unzureichende Behandlung von Session-Fehlern führten zur Herabstufung des Primärservers.
Version 1.5.2
Veröffentlicht am 2018-11-26
Version mit Kompatibilitätsverbesserungen und Fehlerbehebungen.
-
Kompatibilität mit kazoo-2.6.0 (Alexander Kukushkin)
Um angemessene Zeitlimits für Anfragen sicherzustellen, definiert Patroni die Methode create_connection des Moduls python-kazoo neu. Die neueste Kazoo-Version änderte den Aufruf von create_connection geringfügig.
-
Absturz von Patroni beim Verlust des Leaders im Consul-Cluster beheben (Alexander Kukushkin)
Ursache war eine fehlerhafte Implementierung der Methode touch_member: Sie sollte einen booleschen Wert zurückgeben und keine Ausnahmen auslösen.
Version 1.5.1
Veröffentlicht am 2018-11-01
Diese Version unterstützt permanente Replikationsslots sowie pgBackRest und behebt mehrere Fehler.
Neue Funktionen
-
Permanente Replikationsslots (Alexander Kukushkin)
Permanente Replikationsslots bleiben bei Failover und Switchover erhalten. Patroni erstellt die konfigurierten Slots auf dem neuen Primärserver unmittelbar nach der Hochstufung. Die Slots lassen sich mit
patronictl edit-configkonfigurieren. Die anfängliche Konfiguration kann auch unter bootstrap.dcs erfolgen. -
pgBackRest-Unterstützung hinzufügen (Yogesh Sharma)
pgBackRest kann in ein bestehendes Verzeichnis $PGDATA wiederherstellen. Dabei werden seit dem letzten Backup unveränderte Dateien übersprungen, was die Wiederherstellung beschleunigt. Zur Unterstützung dieser Funktion wurde der Parameter
keep_dataeingeführt. Weitere Beispiele enthält der Abschnitt Methode zur Replikaterstellung .
Fehlerbehebungen
-
Fehlerbehebungen im Ablauf für Standby-Cluster (Alexander Kukushkin)
Weitere Einzelheiten finden sich unter https://github.com/patroni/patroni/pull/823 .
-
REST-API-Health-Check bei pausierter Cluster-Verwaltung und nicht erreichbarem DCS korrigieren (Alexander Kukushkin)
Diese Regression wurde mit https://github.com/patroni/patroni/commit/90cf930036a9d5249265af15d2b787ec7517cf57 eingeführt.
Version 1.5.0
Veröffentlicht am 2018-09-20
Diese Version ermöglicht den Betrieb eines Patroni-HA-Clusters im Standby-Modus, führt experimentelle Windows-Unterstützung ein und bietet einen neuen Konfigurationsparameter zur Registrierung des PostgreSQL-Dienstes in Consul.
Neue Funktionen
-
Standby-Cluster (Dmitry Dolgov)
Ein oder mehrere Patroni-Knoten können einen Standby-Cluster bilden, der neben dem Primärcluster läuft, etwa in einem anderen Rechenzentrum. Er besteht aus Standbys, die vom Primärserver des Primärclusters replizieren. Alle PostgreSQL-Knoten im Standby-Cluster sind Replikate. Eines davon wählt sich selbst für die direkte Replikation vom entfernten Primärserver aus; die anderen replizieren kaskadierend von diesem Replikat. Eine ausführlichere Beschreibung und Konfigurationsbeispiele finden sich hier .
-
Dienste in Consul registrieren (Pavel Kirillov, Alexander Kukushkin)
Ist
register_servicein der Consul-Konfiguration aktiviert, registriert der Knoten einen Dienst mit dem Namenscopeund dem Tagmaster,replicaoderstandby-leader. -
Experimentelle Windows-Unterstützung (Pavel Golub)
Patroni kann nun unter Windows ausgeführt werden. Diese Unterstützung ist jedoch neu und wurde noch nicht so ausgiebig in der Praxis getestet wie die Linux-Variante. Rückmeldungen sind willkommen!
Verbesserungen in patronictl
-
Flag patronictl -k/–insecure und Unterstützung für restapi-Zertifikate hinzufügen (Wilfried Roset)
War die REST API durch selbstsignierte Zertifikate geschützt, schlug deren Prüfung durch patronictl bisher fehl. Es gab keine Möglichkeit, die Prüfung zu deaktivieren. Nun kann patronictl so konfiguriert werden, dass es die Zertifikatsprüfung vollständig überspringt. Alternativ können CA- und Client-Zertifikate im Konfigurationsabschnitt ctl: angegeben werden.
-
Mitglieder mit nofailover-Tag aus der Ausgabe von patronictl switchover/failover ausschließen (Alexander Anikin)
Zuvor wurden diese Mitglieder bei interaktivem Switchover oder Failover über patronictl fälschlicherweise als Kandidaten vorgeschlagen.
Stabilitätsverbesserungen
-
Ausgabezeilen von pg_controldata ohne Schlüssel-Wert-Paar nicht auswerten (Alexander Anikin)
Unter bestimmten Umständen gibt pg_controldata Zeilen ohne Doppelpunkt aus. Dadurch entstand beim Auswerten der pg_controldata-Ausgabe ein Fehler im Patroni-Code, der das eigentliche Problem verdeckte. Solche Zeilen stammen häufig aus einer Warnung, die pg_controldata vor der regulären Ausgabe anzeigt, etwa wenn die Hauptversion der ausführbaren Datei nicht mit der des PostgreSQL-Datenverzeichnisses übereinstimmt.
-
Mitgliedsnamen in Fehlermeldungen während der Leader-Wahl aufnehmen (Jan Mussler)
Während der Leader-Wahl verbindet sich Patroni mit allen bekannten Cluster-Mitgliedern und fragt ihren Status ab. Dieser wird einschließlich des Mitgliedsnamens im Patroni-Protokoll festgehalten. War ein Mitglied nicht erreichbar, enthielt die Fehlermeldung bisher nur die URL, jedoch nicht seinen Namen.
-
WAL-Position unmittelbar beim Erstellen des Replikationsslots reservieren (Alexander Kukushkin)
Seit 9.6 bietet die Funktion
pg_create_physical_replication_slotden zusätzlichen booleschen Parameterimmediately_reserve. Beifalse, dem Standardwert, reserviert der Slot die WAL-Position erst mit der ersten Client-Verbindung. Zwischen seiner Erstellung und der ersten Verbindung können deshalb vom Client benötigte Segmente verloren gehen. -
Fehler bei strikt synchroner Replikation beheben (Alexander Kukushkin)
Bei
synchronous_mode_strict: trueträgt Patroni in manchen Fällen*insynchronous_standby_namesein. Dadurch wechselt der Synchronisationszustand der meisten Replikationsverbindungen zupotential. Bisher konnte Patroni dann keinen synchronen Kandidaten auswählen, da es nur Verbindungen im Zustandasyncberücksichtigte.
Version 1.4.6
Veröffentlicht am 2018-08-14
Fehlerbehebungen und Stabilitätsverbesserungen
Diese Version behebt einen kritischen Fehler, bei dem der Patroni-API-Endpunkt /master für einen Knoten, der kein Primärserver war, 200 zurückgab. Es handelte sich um einen Meldefehler und nicht um einen tatsächlichen Split Brain. Unter bestimmten Umständen konnten Clients jedoch an einen schreibgeschützten Knoten weitergeleitet werden.
-
Status is_leader beim Herabstufen zurücksetzen (Alexander Kukushkin, Oleksii Kliukin)
Sicherstellen, dass ein herabgestuftes Cluster-Mitglied bei einem Aufruf der API /master nicht mehr mit Code 200 antwortet.
-
Neues Feld „cluster_unlocked“ zur API-Ausgabe hinzufügen (Dmitry Dolgov)
Das Feld zeigt an, ob im Cluster ein Primärserver läuft. Es kann verwendet werden, wenn sich außer einem einzelnen Replikat kein anderer Knoten abfragen lässt.
Version 1.4.5
Veröffentlicht am 2018-08-03
Neue Funktionen
-
Protokollierung beim Anwenden einer neuen Postgres-Konfiguration verbessern (Don Seiler)
Patroni protokolliert die Namen und Werte geänderter Parameter.
-
Kompatibilität mit Python 3.7 (Christoph Berg)
async ist in python3.7 ein reserviertes Schlüsselwort.
-
Beim Herunterfahren eines Mitglieds dessen Zustand im DCS auf “stopped” setzen (Tony Sorrentino)
Dadurch zeigt der Befehl “patronictl list” den Zustand des Mitglieds als “stopped” an.
-
Protokollmeldung verbessern, wenn eine veraltete postmaster.pid zu einem laufenden Prozess passt (Ants Aasma)
Die bisherige Meldung war äußerst verwirrend.
-
Funktion patronictl reload implementieren (Don Seiler)
Zuvor ließ sich die Konfiguration nur durch einen REST-API-Aufruf oder durch Senden von SIGHUP an den Patroni-Prozess neu laden.
-
Beim Start als Replikat einige Parameter aus controldata übernehmen und anwenden (Alexander Kukushkin)
Der Wert von
max_connectionsund einigen weiteren Parametern in der globalen Konfiguration kann niedriger sein als der tatsächlich vom Primärserver verwendete Wert. Dann kann das Replikat nicht starten und sollte manuell korrigiert werden. Patroni übernimmt dies nun: Es liest den Wert auspg_controldata, wendet ihn an, startet Postgres und setzt das Flagpending_restart. -
Beim Start von Postgres LD_LIBRARY_PATH verwenden, sofern gesetzt (Chris Fraser)
Beim Start von Postgres reichte Patroni die Umgebungsvariablen PATH, LC_ALL und LANG weiter, sofern sie gesetzt waren. Nun geschieht dies auch mit LD_LIBRARY_PATH. Dies sollte helfen, wenn PostgreSQL an einem nicht standardmäßigen Ort installiert wurde.
-
create_replica_method in create_replica_methods umbenennen (Dmitry Dolgov)
Der neue Name verdeutlicht, dass es sich um ein Array handelt. Der alte Name bleibt aus Gründen der Abwärtskompatibilität unterstützt.
Fehlerbehebungen und Stabilitätsverbesserungen
-
Bedingung für den Start eines Replikats nach pg_rewind im Pausenmodus korrigieren (Oleksii Kliukin)
Ein Replikat, das pg_rewind bereits ausgeführt hat, wird nicht erneut gestartet.
-
Beim Health Check des Primärservers nur dann 200 zurückgeben, wenn update_lock erfolgreich war (Alexander Kukushkin)
So wird verhindert, dass sich der bisherige, herabgestufte Primärserver bei einer Netzwerkpartition des DCS weiterhin als Primärserver meldet.
-
Kompatibilität mit dem neuen Consul-Modul korrigieren (Alexander Kukushkin)
Seit v1.1.0 verwendet python-consul eine geänderte interne API und übergibt Abfrageparameter als
liststatt alsdict. -
Ausnahmen aus dem REST-API-Thread von Patroni beim Herunterfahren abfangen (Alexander Kukushkin)
Aufgrund dieser nicht abgefangenen Ausnahmen lief PostgreSQL beim Herunterfahren weiter.
-
Crash-Recovery nur ausführen, wenn Postgres als Primärserver läuft (Alexander Kukushkin)
pg_controldatamuss ‘in production’, ‘shutting down’ oder ‘in crash recovery’ melden. In allen anderen Fällen ist keine Crash-Recovery erforderlich. -
Behandlung von Konfigurationsfehlern verbessern (Henning Jacobs, Alexander Kukushkin)
Viele Parameter, einschließlich
restapi.listen, lassen sich im laufenden Betrieb ändern, indem die Patroni-Konfigurationsdatei aktualisiert und SIGHUP an den Patroni-Prozess gesendet wird. Diese Korrektur beseitigt schwer verständliche Ausnahmen aus dem Thread ‘restapi’, wenn Parameter ungültige Werte erhalten.
Version 1.4.4
Veröffentlicht am 2018-05-22
Verbesserungen der Stabilität
-
Race Condition in poll_failover_result beheben (Alexander Kukushkin)
Sie wirkte sich weder auf Failover noch auf Switchover direkt aus. In seltenen Fällen wurde der Erfolg jedoch zu früh gemeldet, sobald der frühere Leader den Lock freigab. Dadurch entstand die Meldung ‘Failed over to “None”’ statt ‘Failed over to “desired-node”’.
-
Groß- und Kleinschreibung bei Postgres-Parameternamen ignorieren (Alexander Kukushkin)
Die meisten Postgres-Parameter haben Namen in snake_case. Es gibt jedoch drei Ausnahmen: DateStyle, IntervalStyle und TimeZone. Postgres akzeptiert diese Parameter auch mit anderer Groß- und Kleinschreibung (etwa timezone = ‘some/tzn’). Patroni konnte solche abweichend geschriebenen Parameternamen dagegen nicht in pg_settings finden und ignorierte sie deshalb.
-
Start beim Anhängen an laufendes postgres abbrechen, wenn der Cluster nicht initialisiert ist (Alexander Kukushkin)
Patroni kann sich an eine bereits laufende Postgres-Instanz anhängen. Dabei muss Patroni unbedingt zuerst auf dem Primärserver gestartet werden, bevor die Replikate an der Reihe sind.
-
Verhalten von patronictl scaffold korrigieren (Alexander Kukushkin)
An
touch_memberwird ein dict-Objekt statt einer JSON-kodierten Zeichenkette übergeben; die DCS-Implementierung übernimmt die Kodierung. -
Primärserver bei fehlgeschlagener Aktualisierung des Leader-Schlüssels während einer Pause nicht herabstufen (Alexander Kukushkin)
Während Wartungsarbeiten kann ein DCS Schreibanfragen ablehnen, während er Leseanfragen weiterhin beantwortet. In diesem Fall versetzte Patroni den Postgres-Primärserver zuvor in einen schreibgeschützten Modus, nachdem die Aktualisierung des Leader-Locks im DCS fehlgeschlagen war.
-
Replikations-Slots synchronisieren, wenn Patroni einen neuen postmaster-Prozess erkennt (Alexander Kukushkin)
Nach einem Postgres-Neustart muss Patroni sicherstellen, dass die Liste der Replikations-Slots seinen Erwartungen entspricht.
-
Nach Beendigung einer Pause sysid prüfen und Replikations-Slots synchronisieren (Alexander Kukushkin)
Im Modus
maintenancekann das Datenverzeichnis vollständig neu geschrieben worden sein. Daher muss geprüft werden, obDatabase system identifierweiterhin zum Cluster gehört und die Replikations-Slots dem von Patroni erwarteten Zustand entsprechen. -
Mögliches Startproblem bei gestopptem Postgres mit vorhandener postmaster-Lock-Datei im Datenverzeichnis beheben (Alexander Kukushkin)
Die Wiederverwendung der PID aus der postmaster-Lock-Datei wird erkannt. Dieses Problem tritt eher auf, wenn Patroni und Postgres in einem Docker-Container laufen.
-
Schutz vor versehentlichem Löschen der DCS-Inhalte verbessern (Alexander Kukushkin)
Patroni enthält umfangreiche Logik, um in diesem Fall ein Failover zu verhindern, und kann außerdem alle Schlüssel wiederherstellen. Bis zu dieser Änderung schaltete das versehentliche Löschen des Schlüssels /config jedoch den Pause-Modus für 1 Durchlauf der HA-Schleife aus.
-
Bei ungültiger System-ID nicht beenden (Oleksii Kliukin)
Patroni wird nicht beendet, wenn die System-ID des Clusters leer ist oder die Validierung nicht besteht. In diesem Fall muss der Cluster höchstwahrscheinlich neu initialisiert werden; darauf wird in der Ergebnismeldung hingewiesen. Patroni wird nicht beendet, da andernfalls keine Neuinitialisierung möglich wäre.
Kompatibilität mit Kubernetes 1.10+
-
Prüfung auf leere subsets hinzufügen (Cody Coons)
Seit Kubernetes 1.10.0+ wird
Endpoints.subsetsalsNonestatt als[]zurückgegeben.
Verbesserungen beim Bootstrap
-
Löschen von recovery.conf optional machen (Brad Nicholson)
Wenn
bootstrap.<custom_bootstrap_method_name>.keep_existing_recovery_confdefiniert und aufTruegesetzt ist, entfernt Patroni die vorhandene Dateirecovery.confnicht. Dies ist beim Bootstrap aus einem Backup mit Werkzeugen wie pgBackRest nützlich, die eine passenderecovery.conferzeugen. -
Optionen für die integrierte basebackup-Methode zulassen (Oleksii Kliukin)
Der integrierten basebackup-Methode können jetzt Optionen übergeben werden, indem der Abschnitt
basebackupin der Konfiguration definiert wird, ähnlich wie bei benutzerdefinierten Methoden zur Replikaterstellung. Der Unterschied liegt im akzeptierten Format des Abschnittsbasebackup: Da pg_basebackup sowohl Optionen mit--key=valueals auch mit--keyakzeptiert, kann der Abschnitt entweder ein Dictionary mit Schlüssel-Wert-Paaren oder eine Liste aus Dictionaries mit jeweils einem Eintrag beziehungsweise aus einzelnen Schlüsseln für Optionen ohne Wert enthalten. Weitere Beispiele enthält der Abschnitt Methode zur Replikaterstellung .
Version 1.4.3
Veröffentlicht am 2018-03-05
Verbesserungen der Protokollierung
-
Protokollstufe über Umgebungsvariablen konfigurierbar machen (Andy Newton, Keyvan Hedayati)
PATRONI_LOGLEVELlegt die allgemeine Protokollstufe fest.PATRONI_REQUESTS_LOGLEVELlegt die Protokollstufe für alle HTTP-Anfragen fest, etwa Aufrufe der Kubernetes-API. Die Namen der möglichen Protokollstufen stehen in Dokumentation zur Python-Protokollierung .
Verbesserungen der Stabilität und Fehlerbehebungen
-
etcd-Clustertopologie nach einer Watch-Zeitüberschreitung nicht erneut ermitteln (Alexander Kukushkin)
War nur ein Host in der etcd-Konfiguration angegeben und genau dieser nicht erreichbar, begann Patroni mit der Ermittlung der Clustertopologie, ohne jemals erfolgreich zu sein. Stattdessen sollte es lediglich zum nächsten verfügbaren Knoten wechseln.
-
Inhalt von bootstrap.pg_hba nach einem benutzerdefinierten Bootstrap in eine pg_hba.conf schreiben (Alexander Kukushkin)
Das Verhalten entspricht jetzt dem üblichen Bootstrap mit
initdb. -
Einzelbenutzermodus wartete auf Benutzereingaben und wurde nie beendet (Alexander Kukushkin)
Die Regression wurde in https://github.com/patroni/patroni/pull/576 eingeführt.
Version 1.4.2
Veröffentlicht am 2018-01-30
Verbesserungen in patronictl
-
Geplantes Failover in geplantes Switchover umbenennen (Alexander Kukushkin)
Failover und Switchover wurden in Version 1.4 getrennt.
patronictl listmeldete jedoch weiterhinScheduled failoverstattScheduled switchover. -
Informationen zu ausstehenden Neustarts anzeigen (Alexander Kukushkin)
Manche Konfigurationsänderungen erfordern einen Postgres-Neustart. Patroni gab darauf bereits in der REST API und beim Schreiben des Knotenstatus in den DCS einen Hinweis, dieser ließ sich jedoch nicht einfach anzeigen.
-
show-config mit cluster_name aus der Konfigurationsdatei nutzbar machen (Alexander Kukushkin)
Dies funktioniert ähnlich wie bei
patronictl edit-config.
Verbesserungen der Stabilität
-
Aufruf von pg_controldata während des Bootstraps vermeiden (Alexander Kukushkin)
Während initdb oder eines benutzerdefinierten Bootstraps gibt es ein Zeitfenster, in dem pgdata nicht leer ist, pg_control aber noch nicht geschrieben wurde. Ein Aufruf von pg_controldata schlug dann mit Fehlermeldungen fehl.
-
Von psutil ausgelöste Ausnahmen behandeln (Alexander Kukushkin)
cmdline wird bei jedem Aufruf der Methode
cmdline()gelesen und ausgewertet. Wenn der untersuchte Prozess inzwischen beendet wurde, wirdNoSuchProcessausgelöst.
Verbesserungen der Kubernetes-Unterstützung
-
Fehler der k8s-API nicht unterdrücken (Alexander Kukushkin)
Ein Aufruf der Kubernetes-API kann aus verschiedenen Gründen fehlschlagen. In manchen Fällen sollte der Aufruf wiederholt werden, in anderen sollten die Fehlermeldung und der Stacktrace der Ausnahme protokolliert werden. Diese Änderung hilft bei der Diagnose von Kubernetes-Berechtigungsproblemen.
-
Kubernetes-Beispiel-Dockerfile auf Installation von Patroni aus dem master-Branch umstellen (Maciej Szulik)
Zuvor wurde der inzwischen veraltete Branch
feature/k8sverwendet. -
Passende RBAC-Konfiguration für Patroni auf k8s hinzufügen (Maciej Szulik)
Ein Service Account für die Pods des Clusters, eine Rolle mit ausschließlich den notwendigen Berechtigungen und ein RoleBinding zur Verknüpfung von Service Account und Rolle wurden hinzugefügt.
Version 1.4.1
Veröffentlicht am 2018-01-17
Korrekturen in patronictl
-
Aktuellen Leader nicht in der vorgeschlagenen Liste der Failover-Ziele anzeigen. (Alexander Kukushkin)
patronictl failover kann auch dann funktionieren, wenn der Cluster einen Leader hat. Dieser sollte aus der Liste der möglichen Failover-Ziele ausgeschlossen werden.
-
patronictl switchover mit der alten Patroni-API kompatibel machen (Alexander Kukushkin)
Schlägt der REST-API-Aufruf POST /switchover mit Statuscode 501 fehl, wird er erneut ausgeführt, diesmal jedoch am Endpunkt /failover.
Version 1.4
Veröffentlicht am 2018-01-10
Diese Version unterstützt Kubernetes als DCS. Damit kann Patroni als Cloud-nativer Agent in Kubernetes ohne zusätzliche Bereitstellung von etcd, Zookeeper oder Consul laufen.
Upgrade-Hinweis
Bei der Installation von Patroni über pip werden Abhängigkeiten wie Bibliotheken für etcd, Zookeeper, Consul oder Kubernetes sowie Unterstützung für AWS nicht mehr automatisch installiert. Um sie zu aktivieren, müssen sie im Befehl pip install ausdrücklich aufgeführt werden, beispielsweise mit pip install 'patroni[etcd,kubernetes]'.
Kubernetes-Unterstützung
Ein Kubernetes-basierter DCS wurde implementiert. Die Metadaten der Endpoints speichern die Konfiguration und den Leader-Schlüssel. Das Metadatenfeld in den Pod-Definitionen speichert die mitgliederbezogenen Daten. Neben Endpoints unterstützt Patroni auch ConfigMaps. Weitere Informationen zu dieser Funktion finden sich im Kubernetes-Kapitel der Dokumentation .
Verbesserungen der Stabilität
-
postmaster-Prozess in ein eigenes Objekt auslagern (Ants Aasma)
Dieses Objekt identifiziert einen laufenden postmaster-Prozess anhand von PID und Startzeit. Es vereinfacht das Erkennen und Beheben von Situationen, in denen der postmaster ohne Wissen von Patroni neu gestartet wurde oder das Postgres-Verzeichnis aus dem Dateisystem verschwunden ist.
-
Anzahl der von Patroni pro HA-Schleifendurchlauf ausgeführten SELECTs minimieren (Alexander Kukushkin)
Bei jedem HA-Schleifendurchlauf benötigt Patroni den Recovery-Status und die absolute WAL-Position. Dazu führt Patroni jetzt nur ein SELECT aus, statt zwei auf dem Replikat und drei auf dem Primärserver.
-
Leader-Schlüssel beim Herunterfahren nur entfernen, wenn der Lock gehalten wird (Ants Aasma)
Das bedingungslose Entfernen erzeugte unnötige und irreführende Ausnahmen.
Verbesserungen in patronictl
-
Befehl version zu patronictl hinzufügen (Ants Aasma)
Er zeigt die installierte Patroni-Version an. Wird der Clustername angegeben, zeigt er außerdem die Versionen laufender Patroni-Instanzen.
-
Angabe des Arguments cluster_name für einige patronictl-Befehle optional machen (Alexander Kukushkin, Ants Aasma)
Dies funktioniert, wenn patronictl eine gewöhnliche Patroni-Konfigurationsdatei mit definiertem
scopeverwendet. -
Informationen zu geplantem Switchover und Wartungsmodus anzeigen (Alexander Kukushkin)
Zuvor waren diese Informationen nur über Patroni-Protokolle oder direkt aus dem DCS verfügbar.
-
patronictl reinitverbessern (Alexander Kukushkin)patronictl reinitweigerte sich manchmal fortzufahren, wenn Patroni mit anderen Aktionen beschäftigt war, insbesondere mit dem Versuch, postgres zu starten. patronictl bot keine Befehle zum Abbrechen solcher lang laufenden Aktionen. Die einzige, gefährliche Umgehung bestand im manuellen Löschen eines Datenverzeichnisses. Die neue Implementierung vonreinitbricht andere lang laufende Aktionen zwangsweise ab, bevor sie mit der Neuinitialisierung fortfährt. -
Option
--waitinpatronictl pauseundpatronictl resumeimplementieren (Alexander Kukushkin)Damit wartet patronictl , bis alle Knoten im Cluster die angeforderte Aktion bestätigt haben. Dazu wird der Schalter pause für jeden Knoten im DCS und über die REST API bereitgestellt.
-
patronictl failoverinpatronictl switchoverumbenennen (Alexander Kukushkin)Das bisherige
failoverkonnte tatsächlich nur ein Switchover durchführen und verweigerte die Ausführung in einem Cluster ohne Leader. -
Verhalten von
patronictl failoverändern (Alexander Kukushkin)Der Befehl funktioniert auch ohne Leader. In diesem Fall muss jedoch ausdrücklich angegeben werden, welcher Knoten neuer Leader werden soll.
Informationen zu Timeline und Historie bereitstellen
-
Aktuelle Timeline im DCS und über die API bereitstellen (Alexander Kukushkin)
Für jedes Clustermitglied werden Informationen zur aktuellen Timeline gespeichert. Diese Informationen sind über die API zugänglich und werden im DCS gespeichert.
-
Historie der Hochstufungen im DCS-Schlüssel /history speichern (Alexander Kukushkin)
Zusätzlich wird die um den Zeitpunkt der jeweiligen Hochstufung ergänzte Timeline-Historie im DCS-Schlüssel /history gespeichert und bei jeder Hochstufung aktualisiert.
Endpunkte zur Abfrage synchroner und asynchroner Replikate hinzufügen
- Neue Endpunkte /sync und /async hinzufügen (Alexander Kukushkin, Oleksii Kliukin)
Diese Endpunkte, auch als /synchronous und /asynchronous verfügbar, geben 200 ausschließlich für synchrone beziehungsweise asynchrone Replikate zurück. Mit
noloadbalancemarkierte Replikate sind ausgeschlossen.
Mehrere Hosts für etcd zulassen
-
Neuen Parameter
hostszur etcd-Konfiguration hinzufügen (Alexander Kukushkin)Dieser Parameter sollte die anfängliche Hostliste enthalten, anhand derer die laufenden Mitglieder des etcd-Clusters ermittelt und in eine Liste aufgenommen werden. Wird diese Liste ermittelter Hosts während des Betriebs aus irgendeinem Grund ausgeschöpft, sodass kein Host daraus mehr verfügbar ist, greift Patroni wieder auf die anfängliche Liste im Parameter
hostszurück.
Version 1.3.6
Veröffentlicht am 2017-11-10
Verbesserungen der Stabilität
-
Beim Prüfen, ob postgres läuft, die Startzeit des Prozesses verifizieren. (Ants Aasma)
Nach einem Absturz, der postmaster.pid nicht entfernt, kann ein neuer Prozess dieselbe PID erhalten. Dadurch liefert is_running() fälschlich ein positives Ergebnis, was zu verschiedenen Fehlverhalten führt.
-
PostgreSQL vor dem Bootstrap herunterfahren, wenn das Datenverzeichnis verloren gegangen ist (ainlolcat)
Wird das Datenverzeichnis auf dem Primärserver zwangsweise entfernt, kann der Postgres-Prozess noch eine Zeit lang weiterlaufen. Dadurch kann er das anstelle des früheren Primärservers erstellte Replikat am Starten oder Replizieren hindern. Mit dieser Korrektur speichert Patroni die PID und Startzeit des postmaster zwischen und kann den alten postmaster beenden, wenn dieser nach dem Entfernen seines Datenverzeichnisses noch läuft.
-
Nach dem Ausfall des Postgres-Primärservers Crash-Recovery im Einzelbenutzermodus durchführen (Alexander Kukushkin)
Wurde postgres nicht sauber heruntergefahren, ist ein sofortiger Start als Standby unsicher und
pg_rewindkann nicht ausgeführt werden. Die Crash-Recovery im Einzelbenutzermodus wird nur durchgeführt, wennpg_rewindaktiviert ist oder derzeit kein Primärserver vorhanden ist.
Verbesserungen für Consul
-
Angabe einer Rechenzentrumskonfiguration für Consul ermöglichen (Vilius Okockis, Alexander Kukushkin)
Zuvor kommunizierte Patroni immer mit dem Rechenzentrum des Hosts, auf dem es lief.
-
Token immer im HTTP-Header X-Consul-Token senden (Alexander Kukushkin)
Wenn
consul.tokenin der Patroni-Konfiguration definiert ist, wird es immer im HTTP-Header ‘X-Consul-Token’ gesendet. Das Modul python-consul versucht, mit der Consul-REST-API übereinzustimmen. Diese akzeptiert bei der Session-API kein Token als Abfrageparameter, der Header ‘X-Consul-Token’ funktioniert jedoch weiterhin. -
Session-TTL anpassen, wenn der angegebene Wert unter dem kleinstmöglichen liegt (Stas Fomin, Alexander Kukushkin)
Die in der Patroni-Konfiguration angegebene TTL kann unter dem von Consul unterstützten Mindestwert liegen. Dann kann der Consul-Agent keine neue Session erstellen. Ohne Session kann Patroni keine Member- und Leader-Schlüssel im Consul-KV-Speicher erstellen, wodurch der Cluster nicht ordnungsgemäß funktioniert.
Weitere Verbesserungen
-
Benutzerdefiniertes Protokollformat über die Umgebungsvariable
PATRONI_LOGFORMATdefinieren (Stas Fomin)Zeitstempel und ähnliche Felder in Patroni-Protokollen können deaktiviert werden, wenn sie bereits durch die Systemprotokollierung hinzugefügt werden, üblicherweise bei der Ausführung von Patroni als Dienst.
Version 1.3.5
Veröffentlicht am 2017-10-12
Fehlerbehebung
-
Rolle auf ‘uninitialized’ setzen, wenn das Datenverzeichnis entfernt wurde (Alexander Kukushkin)
Lief der Knoten als Primärserver, verhinderte dies ein Failover.
Verbesserung der Stabilität
-
Nach einem erfolglosen Versuch, postgres zu starten, versuchen, postmaster im Einzelbenutzermodus auszuführen (Alexander Kukushkin)
Dieses Problem tritt üblicherweise auf, wenn ein als Primärserver laufender Knoten beendet wurde und die Timelines auseinanderliefen. Ist in
recovery.confeinrestore_commanddefiniert, bricht postgres den Start mit hoher Wahrscheinlichkeit ab und lässt controldata unverändert. Dadurch kannpg_rewind, das ein sauberes Herunterfahren voraussetzt, nicht verwendet werden.
Verbesserungen für Consul
-
Angabe von Health Checks beim Erstellen einer Session ermöglichen (Alexander Kukushkin)
Ohne Angabe verwendet Consul „serfHealth“. Einerseits ermöglicht dies das schnelle Erkennen eines isolierten Primärservers; andererseits kann Patroni dadurch kurze Netzwerkverzögerungen nicht tolerieren.
Fehlerbehebung
-
Watchdog unter Python 3 korrigieren (Ants Aasma)
Die Schnittstelle des Aufrufs ioctl() wurde falsch verstanden. Bei mutable=False gibt fcntl.ioctl() tatsächlich den arg-Puffer zurück. Unter Python2 funktionierte dies zufällig, weil ein Vergleich von int und str keinen Fehler auslöste. Fehler werden tatsächlich durch Auslösen von IOError unter Python2 und OSError unter Python3 gemeldet.
Version 1.3.4
Veröffentlicht am 2017-09-08
Verschiedene Verbesserungen für Consul
-
Consul-Token als Header übergeben (Andrew Colin Kissa)
Header sind jetzt der bevorzugte Weg, um das Token an die Consul-API zu übergeben.
-
Erweiterte Konfiguration für Consul (Alexander Kukushkin)
scheme,tokensowie Client- und CA-Zertifikate können angegeben werden; siehe Details . -
Kompatibilität mit python-consul-0.7.1 und neuer (Alexander Kukushkin)
Das neue Modul python-consul hat die Signatur einiger Methoden geändert.
-
Die Meldung “Could not take out TTL lock” wurde nie protokolliert (Alexander Kukushkin)
Dies ist kein kritischer Fehler, aber fehlende geeignete Protokollierung erschwert die Untersuchung von Problemen.
synchronous_standby_names mit quote_ident in Anführungszeichen setzen
-
Beim Schreiben von
synchronous_standby_namesinpostgresql.confmuss der Wert in Anführungszeichen gesetzt werden (Alexander Kukushkin)Geschieht dies nicht korrekt, deaktiviert PostgreSQL effektiv die synchrone Replikation und arbeitet weiter.
Verschiedene Fehlerbehebungen im Pause-Zustand, überwiegend im Zusammenhang mit dem Watchdog (Alexander Kukushkin)
- Keine Keepalives senden, wenn der Watchdog nicht aktiv ist
- Aktivierung des Watchdogs im Pause-Modus vermeiden
- Korrekten Postgres-Zustand im Pause-Modus setzen
- Keine Abfragen über die API ausführen, wenn postgres gestoppt ist
Version 1.3.3
Veröffentlicht am 2017-08-04
Fehlerbehebungen
- Die synchrone Replikation wurde kurz nach der Hochstufung deaktiviert, auch wenn synchronous_mode_strict eingeschaltet war (Alexander Kukushkin)
- Leere Datei
pg_ident.conferstellen, wenn sie nach der Wiederherstellung aus dem Backup fehlt (Alexander Kukushkin) - Zugriff in
pg_hba.confauf alle Datenbanken öffnen, nicht nur auf postgres (Franco Bellagamba)
Version 1.3.2
Veröffentlicht am 2017-07-31
Fehlerbehebung
- patronictl edit-config funktionierte mit ZooKeeper nicht (Alexander Kukushkin)
Version 1.3.1
Veröffentlicht am 2017-07-28
Fehlerbehebung
- Failover über die API war aufgrund einer Änderung in
_MemberStatusdefekt (Alexander Kukushkin)
Version 1.3
Veröffentlicht am 2017-07-27
Version 1.3 ermöglicht benutzerdefinierten Bootstrap, verbessert die Unterstützung für pg_rewind erheblich, erweitert den synchronen Modus, ergänzt patronictl um die Bearbeitung der Konfiguration und implementiert Watchdog-Unterstützung unter Linux. Außerdem ist dies die erste Version, die mit PostgreSQL 10 korrekt funktioniert.
Upgrade-Hinweis
Es sind keine Kompatibilitätsprobleme mit der neuen Patroni-Version bekannt. Die Konfiguration aus Version 1.2 sollte unverändert funktionieren. Für das Upgrade können neue Pakete installiert und Patroni anschließend neu gestartet werden, was einen PostgreSQL-Neustart verursacht. Alternativ kann Patroni zunächst in den Pause-Modus versetzt, dann auf allen Knoten des Clusters neu gestartet und der Pause-Modus zum Schluss beendet werden. Patroni versucht im Pause-Modus nicht, PostgreSQL zu stoppen oder zu starten.
Benutzerdefinierter Bootstrap
-
Ablauf des Cluster-Bootstraps konfigurierbar machen (Alexander Kukushkin)
Bei der Initialisierung des allerersten Knotens im Cluster können benutzerdefinierte Bootstrap-Skripte statt
initdbverwendet werden. Der Bootstrap-Befehl erhält den Clusternamen und den Pfad zum Datenverzeichnis. Der resultierende Cluster kann für Recovery konfiguriert werden, sodass ein Bootstrap aus einem Backup mit Point-in-Time-Recovery möglich ist. Eine ausführlichere Beschreibung dieser Funktion enthält die Dokumentationsseite .
Intelligentere pg_rewind-Unterstützung
-
Anhand der Timeline-Unterschiede zum aktuellen Primärserver entscheiden, ob pg_rewind ausgeführt werden muss (Alexander Kukushkin)
Zuvor hatte Patroni feste Bedingungen zum Auslösen von pg_rewind: beim Start eines früheren Primärservers, bei einem Switchover zum festgelegten Knoten für jeden anderen Knoten im Cluster oder wenn ein Replikat mit dem Tag nofailover vorhanden war. Allen diesen Fällen ist gemeinsam, dass ein Replikat dem neuen Primärserver voraus sein kann. In manchen Fällen tat pg_rewind nichts, in anderen wurde es trotz Notwendigkeit nicht ausgeführt. Statt sich auf diese begrenzte Regelliste zu verlassen, vergleicht Patroni jetzt die WAL-Positionen von Primärserver und Replikat über das Streaming-Replikationsprotokoll, um zuverlässig zu entscheiden, ob das Replikat einen Rewind benötigt.
Strikter synchroner Replikationsmodus
-
Unterstützung für synchrone Replikation um einen strikten Modus erweitern (James Sewell, Alexander Kukushkin)
Wenn synchronous_mode aktiviert ist und keine Replikate mit dem Primärserver verbunden sind, deaktiviert Patroni normalerweise die synchrone Replikation, damit der Primärserver für Schreibzugriffe verfügbar bleibt. Die Option
synchronous_mode_strictändert dies: Ist sie gesetzt, deaktiviert Patroni die synchrone Replikation bei fehlenden Replikaten nicht und blockiert damit alle Clients, die Daten auf den Primärserver schreiben. Zusätzlich zur Garantie des synchronen Modus, Datenverlust durch automatisches Failover zu verhindern, stellt der strikte Modus sicher, dass jeder Schreibvorgang dauerhaft auf zwei Knoten gespeichert wird oder ganz unterbleibt, wenn der Cluster nur einen Knoten enthält.
Konfigurationsbearbeitung mit patronictl
-
Bearbeitung der Konfiguration zu patronictl hinzufügen (Ants Aasma, Alexander Kukushkin)
patronictl kann die im DCS gespeicherte dynamische Clusterkonfiguration bearbeiten. Unterstützt werden die Angabe von Parametern und Werten über die Befehlszeile, der Aufruf von $EDITOR und die Übernahme einer Konfiguration aus einer YAML-Datei.
Linux-Watchdog-Unterstützung
-
Watchdog-Unterstützung für Linux implementieren (Ants Aasma)
Der Linux-Software-Watchdog wird unterstützt, um einen Knoten neu zu starten, auf dem Patroni nicht läuft oder nicht reagiert, beispielsweise wegen hoher Last. Der Linux-Software-Watchdog startet den nicht reagierenden Knoten neu. Im Abschnitt watchdog der Patroni-Konfiguration können das zu verwendende Watchdog-Gerät, standardmäßig
/dev/watchdog, und der Modus on, automatic oder off konfiguriert werden. Weitere Informationen enthält die Watchdog-Dokumentation .
Unterstützung für PostgreSQL 10 hinzufügen
- Patroni ist mit allen bisher veröffentlichten Betaversionen von PostgreSQL 10 kompatibel. Auch für die endgültige Veröffentlichung von PostgreSQL 10 wird Kompatibilität erwartet.
Kleinere Verbesserungen im Zusammenhang mit PostgreSQL
-
pg_hba.conf über die Patroni-Konfigurationsdatei oder die dynamische Konfiguration im DCS definieren (Alexander Kukushkin)
Der Inhalt von
pg_hba.confkann im Unterabschnittpg_hbades Konfigurationsabschnittspostgresqldefiniert werden. Dies vereinfacht die Verwaltung vonpg_hba.confauf mehreren Knoten, da sie nur einmal im DCS definiert werden muss, statt sich auf jedem Knoten anzumelden, sie manuell zu ändern und die Konfiguration neu zu laden.Wenn der Abschnitt definiert ist, ersetzt sein Inhalt die aktuelle
pg_hba.confvollständig. Patroni ignoriert ihn, wenn der PostgreSQL-Parameterhba_filegesetzt ist. -
Verbindung zum lokalen PostgreSQL-Cluster über einen UNIX-Socket unterstützen (Alexander Kukushkin)
Die Option
use_unix_socketwurde zum Abschnittpostgresqlder Patroni-Konfiguration hinzugefügt. Wenn sie auf true gesetzt ist und die PostgreSQL-Optionunix_socket_directoriesnicht leer ist, verwendet Patroni deren ersten Wert zur Verbindung mit dem lokalen PostgreSQL-Cluster. Istunix_socket_directoriesnicht definiert, nimmt Patroni den Standardwert an und lässt den Parameterhostin der PostgreSQL-Verbindungszeichenkette vollständig weg. -
Änderung der Superuser- und Replikationszugangsdaten beim Neuladen unterstützen (Alexander Kukushkin)
-
Speichern von Konfigurationsdateien außerhalb des PostgreSQL-Datenverzeichnisses unterstützen (@jouir)
Die neue Konfigurationsdirektive
config_dirwurde zum Abschnittpostgresqlhinzugefügt. Sie verweist standardmäßig auf das Datenverzeichnis und muss für Patroni beschreibbar sein.
Fehlerbehebungen und Verbesserungen der Stabilität
-
Ausnahmen EtcdEventIndexCleared und EtcdWatcherCleared behandeln (Alexander Kukushkin)
Wenn etcd einen Watch-Vorgang beendet, wird durch Vermeidung nutzloser Wiederholungen eine schnellere Wiederherstellung erreicht.
-
Endlose Fehlerschleifen bei etcd-Ausfällen beseitigen und übermäßige Protokollausgaben reduzieren (Ants Aasma)
Beim zweiten und jedem weiteren etcd-Verbindungsfehler werden sofortige Wiederholungen und die Ausgabe von Stacktraces im Protokoll vermieden.
-
Locale-Variablen beim Forken von PostgreSQL-Prozessen exportieren (Oleksii Kliukin)
Dies vermeidet den schwerwiegenden Fehler
postmaster became multithreaded during startupbei nicht englischen Locales und einem mit NLS gebauten PostgreSQL. -
Zusätzliche Prüfungen beim Löschen des Replikations-Slots (Alexander Kukushkin)
In manchen Fällen hindert der WAL-Sender Patroni daran, den Replikations-Slot zu löschen.
-
Namen von Replikations-Slots gemäß den PostgreSQL-Namensregeln auf 63 (NAMEDATALEN - 1) Zeichen kürzen (Nick Scott)
-
Race Condition beheben, durch die Patroni zusätzliche Verbindungen zum PostgreSQL-Cluster öffnete (Alexander Kukushkin)
-
Leader-Schlüssel freigeben, wenn der Knoten mit leerem Datenverzeichnis neu startet (Alex Kerney)
-
Asynchronen Executor beim Bootstrap ohne Leader als beschäftigt markieren (Alexander Kukushkin)
Andernfalls konnten Fehler auftreten, die besagten, der Knoten gehöre zu einem anderen Cluster. Denn Patroni setzte den normalen Betrieb fort, während eine Bootstrap-Methode ausgeführt wurde, die keinen Leader im Cluster benötigt.
-
WAL-E-Methode zur Replikaterstellung verbessern (Joar Wandborg, Alexander Kukushkin).
- Beim Auswerten des WAL-E-Basisbackups csv.DictReader verwenden und ISO-Datumsangaben akzeptieren, bei denen Datum und Uhrzeit durch ein Leerzeichen getrennt sind.
- Abruf der aktuellen WAL-Position vom Replikat unterstützen, um die wiederherzustellende WAL-Menge abzuschätzen. Zuvor rief der Code Systeminformationsfunktionen auf, die nur auf dem Primärserver verfügbar waren.
Version 1.2
Veröffentlicht am 2016-12-13
Diese Version verbessert die Handhabung synchroner Replikation erheblich, macht den Startvorgang und Failover zuverlässiger, unterstützt PostgreSQL 9.6 und behebt zahlreiche Fehler. Außerdem wurde die Dokumentation einschließlich dieser Versionshinweise nach https://patroni.readthedocs.io verlagert.
Synchrone Replikation
-
Unterstützung für synchrone Replikation hinzufügen. (Ants Aasma)
Die neue Konfigurationsvariable synchronous_mode wurde hinzugefügt. Wenn sie aktiviert ist, verwaltet Patroni
synchronous_standby_names, um die synchrone Replikation zu aktivieren, sobald funktionsfähige Standbys verfügbar sind. Im synchronen Modus führt Patroni ein automatisches Failover nur zu einem Standby durch, der zum Zeitpunkt des Primärserver-Ausfalls synchron repliziert hat. Dadurch geht in diesem Fall keine für Benutzer sichtbare Transaktion verloren. Eine ausführliche Beschreibung und Implementierungsdetails enthält die Funktionsdokumentation .
Verbesserungen der Zuverlässigkeit
-
Die im Schlüssel
leader optimegespeicherte Leader-Position nicht aktualisieren, wenn PostgreSQL nicht zu 100% funktionsfähig ist. Sofort herabstufen, wenn die Aktualisierung des Leader-Schlüssels fehlschlägt. (Alexander Kukushkin) -
Nicht funktionsfähige Knoten aus der Liste möglicher Quellen zum Klonen neuer Replikate ausschließen. (Alexander Kukushkin)
-
Wiederholungs- und Zeitüberschreitungsstrategie für Consul ähnlich wie für etcd implementieren. (Alexander Kukushkin)
-
--dcsund--config-fileauf alle Optionen in patronictl anwenden. (Alexander Kukushkin) -
Alle Postgres-Parameter in postgresql.conf schreiben. (Alexander Kukushkin)
Dadurch kann das von Patroni konfigurierte PostgreSQL allein mit
pg_ctlgestartet werden. -
Ausnahmen vermeiden, wenn die Konfiguration keine Benutzer enthält. (Kirill Pushkin)
-
Pausieren eines nicht funktionsfähigen Clusters zulassen. Vor dieser Korrektur brach patronictl ab, wenn der Knoten, auf dem die Pause ausgeführt werden sollte, nicht funktionsfähig war. (Alexander Kukushkin)
-
Watch-Funktion für den Leader verbessern. (Alexander Kukushkin)
Zuvor beobachteten Replikate immer den Leader-Schlüssel und warteten, bis die Wartezeit ablief oder sich der Leader-Schlüssel änderte. Mit dieser Änderung beobachten sie ihn nur, wenn PostgreSQL auf dem Replikat im Zustand
runningist, und nicht, wenn PostgreSQL gestoppt ist, startet oder neu gestartet wird. -
Race Conditions bei der Behandlung von SIGCHLD als PID 1 vermeiden. (Alexander Kukushkin)
In Docker-Containern konnte zuvor eine Race Condition auftreten, weil derselbe Prozess in Patroni sowohl neue Prozesse erzeugte als auch deren SIGCHLD behandelte. Diese Änderung verwendet fork/execs für Patroni und überlässt dem ursprünglichen Prozess mit PID 1 die Behandlung der Signale von Kindprozessen.
-
WAL-E-Wiederherstellung korrigieren. (Oleksii Kliukin)
Zuvor verwendete die WAL-E-Wiederherstellung den Schalter
no_master, um den Primärserver überhaupt nicht zu konsultieren. Dadurch bevorzugte Patroni immer die Wiederherstellung aus WAL gegenüberpg_basebackup. Diese Änderung stellt die ursprüngliche Bedeutung vonno_masterwieder her: Die WAL-E-Wiederherstellung von Patroni kann auch dann als Replikationsmethode gewählt werden, wenn der Primärserver nicht läuft. Letzteres wird anhand der an die Methode übergebenen Verbindungszeichenkette geprüft. Außerdem wird der Wiederholungsmechanismus robuster und weitere kleinere Probleme werden behandelt. -
Asynchronen Cache für DNS-Auflösung implementieren. (Alexander Kukushkin)
Dadurch werden Fehler vermieden, wenn DNS vorübergehend nicht verfügbar ist, etwa aufgrund übermäßigen eingehenden Datenverkehrs auf dem Knoten.
-
Startzustand und Zeitüberschreitung für den Primärserver-Start implementieren. (Ants Aasma, Alexander Kukushkin)
Zuvor wartete
pg_ctlbis zu einer Zeitüberschreitung und fuhr anschließend fort, als würde PostgreSQL laufen. Dadurch wurde PostgreSQL in Listen als laufend angezeigt, obwohl dies nicht zutraf. Eine Race Condition konnte zu einem Failover, einer Crash-Recovery oder einer durch Failover unterbrochenen Crash-Recovery mit ausgelassenem Rewind führen. Diese Änderung ergänzt den Parametermaster_start_timeoutund den neuen Zustandstartingfür die HA-Hauptschleife. Wennmaster_start_timeoutauf 0 gesetzt ist, erfolgt nach einem Primärserver-Absturz sofort ein Failover, sobald ein geeigneter Kandidat vorhanden ist. Andernfalls wartet Patroni nach dem Versuch, PostgreSQL auf dem Primärserver zu starten, für die Dauer der Zeitüberschreitung und führt anschließend nach Möglichkeit ein Failover durch. Manuelle Failover-Anfragen werden bei einem Primärserver-Absturz auch vor Ablauf der Zeitüberschreitung berücksichtigt.Der Parameter
timeoutwurde zum API-Endpunktrestartund zu patronictl hinzugefügt. Ist er gesetzt und dauert ein Neustart länger als die angegebene Zeit, gilt PostgreSQL als nicht funktionsfähig und die anderen Knoten dürfen den Leader-Lock übernehmen. -
Verhalten von
pg_rewindim Pause-Modus korrigieren. (Ants Aasma)Ein unnötiger Neustart im Pause-Modus wird vermieden, wenn Patroni einen Rewind für erforderlich hält, dieser aber nicht möglich ist, etwa weil
pg_rewindfehlt. Wenn im fürpg_rewindrelevanten Abschnitt der Patroni-Konfiguration die Authentifizierung fürsuperuserfehlt, wird auf die Standardwerte vonlibpqfürsuperuserzurückgegriffen, standardmäßig den Betriebssystembenutzer. -
Ausführung von Callbacks serialisieren. Vor Ausführung eines neuen Callbacks den vorherigen desselben Typs beenden. Erzeugung von Zombie-Prozessen beim Ausführen von Callbacks beheben. (Alexander Kukushkin)
-
Hochstufung eines früheren Primärservers vermeiden, wenn der Leader-Schlüssel im DCS gesetzt ist, seine Aktualisierung jedoch fehlschlägt. (Alexander Kukushkin)
Dadurch wird verhindert, dass ein aktueller Primärserver seine Rolle beibehält, wenn er zusammen mit einer Minderheit der Knoten in etcd oder einem anderen DCS isoliert ist, der „inkonsistente Lesezugriffe“ erlaubt.
Verschiedenes
-
Konfigurationsoption
post_initfür den Bootstrap hinzufügen. (Alejandro Martínez)Patroni ruft das als Argument dieser Option angegebene Skript unmittelbar nach
initdbund dem Start von PostgreSQL für einen neuen Cluster auf. Das Skript erhält eine Verbindungs-URL mitsuperuser. Wenn ein Passwort angegeben ist, setzt PatroniPGPASSFILEauf die Datei.pgpass, die das Passwort enthält. Schlägt das Skript fehl, schlägt auch die Patroni-Initialisierung fehl. Dies ist nützlich, um Benutzer hinzuzufügen oder Erweiterungen im neuen Cluster zu erstellen. -
Unterstützung für PostgreSQL 9.6 implementieren. (Alexander Kukushkin)
wal_level = replicawird als Synonym fürhot_standbyverwendet, sodass beim Wechsel zwischen beiden kein pending_restart-Schalter gesetzt wird. (Alexander Kukushkin)
Verbesserungen der Dokumentation
-
Ablaufdiagramm der Patroni-Hauptschleife hinzufügen. (Alejandro Martínez, Alexander Kukushkin)
-
README um das Helm-Chart und Links zu den Versionshinweisen ergänzen. (Lauri Apple)
-
Patroni-Dokumentation zu
Read the Docsverlagern. Die aktuelle Dokumentation ist unter https://patroni.readthedocs.io verfügbar. (Oleksii Kliukin)Dadurch lässt sich die Dokumentation auf verschiedenen Geräten einschließlich Smartphones einfach lesen und durchsuchen.
-
Paket auf semantische Versionierung umstellen. (Oleksii Kliukin)
Patroni folgt dem Versionsschema major.minor.patch, damit kleine, aber kritische Fehlerbehebungen keine neue Minor-Version erfordern. Versionshinweise werden nur für die Minor-Version veröffentlicht und enthalten alle Patches.

Version 1.1
Veröffentlicht am 2016-09-07
Diese Version verbessert die Verwaltung von Patroni-Clustern durch den Pause-Modus und die Wartung durch geplante und bedingte Neustarts. Sie macht die Interaktion von Patroni mit etcd oder Zookeeper robuster und erweitert patronictl erheblich.
Upgrade-Hinweis
Beim Upgrade von Versionen unter 1.0 sind die Hinweise zu Änderungen an Zugangsdaten und Konfigurationsformat in den Versionshinweisen zu 1.0 zu beachten.
Pause-Modus
-
Pause-Modus einführen, um Patroni vorübergehend von der Verwaltung einer PostgreSQL-Instanz zu entkoppeln (Murat Kabilov, Alexander Kukushkin, Oleksii Kliukin).
Zuvor musste Patroni mit SIGKILL beendet werden, um es zu stoppen, ohne PostgreSQL zu beenden. Der neue Pause-Modus entkoppelt Patroni clusterweit von PostgreSQL, ohne Patroni zu beenden. Er ähnelt dem Wartungsmodus von Pacemaker. Patroni aktualisiert weiterhin die Member- und Leader-Schlüssel im DCS, startet und stoppt den PostgreSQL-Server dabei aber nicht und führt auch keine Neustarts durch. Es gibt einige Ausnahmen: Manuelle Failover, Neuinitialisierungen und Neustarts bleiben beispielsweise erlaubt. Eine ausführliche Beschreibung dieser Funktion ist verfügbar.
Außerdem unterstützt patronictl die neuen Befehle pause
und resume, um den Pause-Modus ein- und auszuschalten.
Geplante und bedingte Neustarts
-
Bedingungen zum API-Befehl restart hinzufügen (Oleksii Kliukin)
Diese Änderung erweitert Patroni-Neustarts um Bedingungen, die vor dem Neustart geprüft werden können. Dazu gehören Neustarts abhängig von der PostgreSQL-Rolle als Primärserver oder Replikat, die Prüfung der PostgreSQL-Versionsnummer und Neustarts nur dann, wenn sie zum Anwenden von Konfigurationsänderungen erforderlich sind.
-
Geplante Neustarts hinzufügen (Oleksii Kliukin)
Neustarts können jetzt für einen späteren Zeitpunkt geplant werden. Pro Knoten wird nur ein geplanter Neustart unterstützt. Er kann gelöscht werden, wenn er nicht mehr benötigt wird. Geplante und bedingte Neustarts können kombiniert werden. So lassen sich beispielsweise PostgreSQL-Minor-Upgrades nachts ausführen und nur Instanzen mit veralteter Minor-Version neu starten, ohne Postgres-spezifische Logik in Administrationsskripte aufzunehmen.
-
Unterstützung für bedingte und geplante Neustarts zu patronictl hinzufügen (Murat Kabilov).
patronictl restart unterstützt mehrere neue Optionen. Außerdem gibt es den Befehl patronictl flush zum Löschen geplanter Aktionen.
Robuste DCS-Interaktion
-
Kazoo-Zeitüberschreitungen abhängig von loop_wait setzen (Alexander Kukushkin)
Ursprünglich wurden ping_timeout und connect_timeout aus der ausgehandelten Session-Zeitüberschreitung berechnet. Patronis loop_wait wurde nicht berücksichtigt. Dadurch konnte ein einzelner Wiederholungsversuch länger als die Session-Zeitüberschreitung dauern, sodass Patroni den Lock freigeben und sich herabstufen musste.
Diese Änderung setzt die Ping- und Verbindungszeitüberschreitung auf die Hälfte von loop_wait. Dadurch werden Verbindungsprobleme schneller erkannt und es bleibt genug Zeit für einen erneuten Verbindungsversuch, bevor der Lock verloren geht.
-
etcd-Topologie erst nach erfolgreicher ursprünglicher Anfrage aktualisieren (Alexander Kukushkin)
Die Aktualisierung der dem Client bekannten etcd-Topologie wird bis nach der ursprünglichen Anfrage aufgeschoben. Beim Abruf der Clustertopologie werden die Zeitüberschreitungen für Wiederholungen abhängig von der bekannten Anzahl der Knoten im etcd-Cluster festgelegt. Dadurch zieht der Client das Ergebnis der Anfrage einer aktuellen Knotenliste vor.
Beide Änderungen machen Patroni-Verbindungen zum DCS bei Netzwerkproblemen robuster.
Patronictl, Überwachung und Konfiguration
-
Informationen über streamende Replikate über die API zurückgeben (Feike Steenbergen)
Zuvor gab es keinen zuverlässigen Weg, Patroni nach PostgreSQL-Instanzen zu fragen, die keine Änderungen streamen, beispielsweise wegen Verbindungsproblemen. Diese Änderung stellt den Inhalt von pg_stat_replication über den Endpunkt /patroni bereit.
-
Befehl patronictl scaffold hinzufügen (Oleksii Kliukin)
Ein Befehl zum Erstellen einer Clusterstruktur in etcd wurde hinzugefügt. Der Cluster wird mit benutzerdefinierter sysid und benutzerdefiniertem Leader erstellt; sowohl Leader- als auch Member-Schlüssel werden dauerhaft angelegt. Dies ist für sogenannte Konfigurationen ohne Primärserver nützlich, bei denen ein nur aus Replikaten bestehender Patroni-Cluster von einem externen Primärserver repliziert, der Patroni nicht kennt. Anschließend kann der Leader-Schlüssel entfernt werden, wodurch einer der Patroni-Knoten hochgestuft und der ursprüngliche Primärserver durch einen Patroni-basierten HA-Cluster ersetzt wird.
-
Konfigurationsoption
bin_dirzur Angabe der PostgreSQL-Programme hinzufügen (Ants Aasma)Auf Linux-Distributionen, die die gleichzeitige Installation mehrerer PostgreSQL-Versionen unterstützen, ist die ausdrückliche Angabe des Verzeichnisses der PostgreSQL-Programme nützlich.
-
Überschreiben des Konfigurationsdateipfads mit
custom_confermöglichen (Alejandro Martínez)Benutzerdefinierte Pfade zu Konfigurationsdateien, die Patroni nicht verwaltet, sind möglich; siehe Details .
Fehlerbehebungen und Codeverbesserungen
-
Patroni mit dem neuen Versionsschema ab PostgreSQL 10 kompatibel machen (Feike Steenbergen)
Patroni versteht bei bedingten Neustarts anhand der PostgreSQL-Version auch 2-stellige Versionsnummern.
-
pkgutil zum Auffinden von DCS-Modulen verwenden (Alexander Kukushkin)
Statt Verzeichnisse manuell zu durchlaufen, wird das dafür vorgesehene Python-Modul zum Auffinden von DCS-Modulen verwendet.
-
Beim Start von Patroni immer den Callback on_start aufrufen (Alexander Kukushkin)
Zuvor rief Patroni beim Anhängen an einen bereits laufenden Knoten mit korrekter Rolle keinen Callback auf. Da Callbacks häufig zum Weiterleiten von Client-Verbindungen dienen, konnte der laufende Knoten dadurch im Verbindungsschema unregistriert bleiben. Mit dieser Korrektur ruft Patroni on_start auch dann auf, wenn es sich an einen bereits laufenden Knoten anhängt.
-
Aktive Replikations-Slots nicht löschen (Murat Kabilov, Oleksii Kliukin)
Aktive physische Replikations-Slots auf dem Primärserver werden nicht gelöscht; PostgreSQL kann solche Slots ohnehin nicht löschen. Diese Änderung ermöglicht Replikate und Verbraucher auf dem Primärserver, die nicht von Patroni verwaltet werden.
-
Patroni-Verbindungen beim Start einer PostgreSQL-Instanz schließen (Alexander Kukushkin)
Patroni schließt beim Start eines PostgreSQL-Knotens zwingend alle bisherigen Verbindungen. Dadurch wird vermieden, dass alte Verbindungen wiederverwendet werden, nachdem postmaster mit SIGKILL beendet wurde.
-
Ungültige Zeichen beim Ableiten von Slot-Namen aus Mitgliedsnamen ersetzen (Ants Aasma)
Standby-Namen, die nicht den Namensregeln für Slots entsprechen, führen nicht mehr zum Fehlschlagen der Slot-Erstellung und des Standby-Starts. Bindestriche in Slot-Namen werden durch Unterstriche ersetzt, alle anderen in Slot-Namen unzulässigen Zeichen durch ihre Unicode-Codepoints.
Version 1.0
Veröffentlicht am 2016-07-05
Diese Version führt die globale dynamische Konfiguration ein, mit der PostgreSQL- und Patroni-Konfigurationsparameter für den gesamten HA-Cluster dynamisch geändert werden können. Außerdem enthält sie zahlreiche Fehlerbehebungen.
Upgrade-Hinweis
Beim Upgrade von v0.90 oder früher müssen stets alle Replikate vor dem Primärserver aktualisiert werden. Da Replikationszugangsdaten nicht mehr im DCS gespeichert werden, kann sich ein altes Replikat nicht mit dem neuen Primärserver verbinden.
Dynamische Konfiguration
-
Dynamische globale Konfiguration implementieren (Alexander Kukushkin)
Der neue REST-API-Endpunkt /config stellt PostgreSQL- und Patroni-Konfigurationsparameter bereit, die global für den gesamten HA-Cluster, also Primärserver und alle Replikate, gesetzt werden sollten. Diese Parameter werden im DCS gespeichert und können in vielen Fällen ohne Unterbrechung von PostgreSQL oder Patroni angewendet werden. Wenn bestimmte Werte einen PostgreSQL-Neustart erfordern, setzt Patroni den besonderen, über die API sichtbaren Schalter „pending restart“. In diesem Fall sollte der Neustart manuell über die API ausgelöst werden.
SIGHUP an Patroni oder eine POST-Anfrage an /reload veranlasst Patroni, die Konfigurationsdatei erneut einzulesen.
Welche Parameter geändert werden können und in welcher Reihenfolge verschiedene Konfigurationsquellen verarbeitet werden, beschreibt die Patroni-Konfiguration .
Das Format der Konfigurationsdatei hat sich seit v0.90 geändert. Patroni ist weiterhin mit alten Konfigurationsdateien kompatibel. Um die Bootstrap-Parameter zu nutzen, müssen sie jedoch angepasst werden. Es wird empfohlen, die Dateien anhand der Dokumentation zur dynamischen Konfiguration zu aktualisieren.
Flexiblere Konfiguration*
-
PostgreSQL-Konfiguration und Namen der Datenbank, mit der Patroni sich verbindet, konfigurierbar machen (Misja Hoebe)
Die Konfigurationsparameter
databaseundconfig_base_namewurden eingeführt. Dies ermöglicht unter anderem den Betrieb von Patroni mit PipelineDB und anderen PostgreSQL-Forks. -
Einstellung einiger Patroni-Konfigurationsparameter über die Umgebung ermöglichen (Alexander Kukushkin)
Dazu gehören Scope, Knotenname, Namespace und Geheimnisse. Dies erleichtert den Betrieb von Patroni in einer dynamischen Umgebung wie Kubernetes. Weitere Einzelheiten enthält die Übersicht der unterstützten Umgebungsvariablen .
-
Integrierten Patroni-Docker-Container zur Nutzung der umgebungsbasierten Konfiguration aktualisieren (Feike Steenbergen).
-
Zookeeper-Unterstützung zum Patroni-Docker-Image hinzufügen (Alexander Kukushkin)
-
Konfigurationsoptionen für Zookeeper und Exhibitor trennen (Alexander Kukushkin)
-
Patroni-Code zum Einlesen der Konfiguration in patronictl wiederverwenden (Alexander Kukushkin)
Dadurch kann patronictl die umgebungsbasierte Konfiguration nutzen.
-
Anwendungsnamen in primary_conninfo auf den Knotennamen setzen (Alexander Kukushkin)
Dies vereinfacht die Identifizierung und Konfiguration synchroner Replikation für einen bestimmten Knoten.
Verbesserungen der Stabilität, Sicherheit und Bedienbarkeit
-
sysid zurücksetzen und pg_controldata während der Wiederherstellung eines Backups nicht aufrufen (Alexander Kukushkin)
Diese Änderung reduziert die überflüssigen Meldungen der Patroni-API-Health-Checks während der langwierigen Initialisierung eines Knotens aus einem Backup.
-
Mehrere Sonderfälle von pg_rewind beheben (Alexander Kukushkin)
pg_rewind wird nicht ausgeführt, wenn der Quellcluster kein Primärserver ist.
Außerdem wird das Datenverzeichnis nach einem fehlgeschlagenen Rewind nicht entfernt, sofern nicht der neue Parameter remove_data_directory_on_rewind_failure auf true gesetzt ist. Standardmäßig ist er false.
-
Passwörter aus der Replikations-Verbindungszeichenkette im DCS entfernen (Alexander Kukushkin)
Zuvor verwendete Patroni immer die Replikationszugangsdaten aus der Postgres-URL im DCS. Jetzt werden die Zugangsdaten aus der Patroni-Konfiguration übernommen. Die Geheimnisse, also Replikationsbenutzername und -passwort, sind nicht mehr im DCS offengelegt.
-
Asynchrone Abläufe rund um den Aufruf demote korrigieren (Alexander Kukushkin)
Die Herabstufung läuft jetzt vollständig asynchron, ohne Interaktionen mit dem DCS zu blockieren.
-
patronictl den Authorization-Header immer senden lassen, wenn er konfiguriert ist (Alexander Kukushkin)
Dadurch kann patronictl „geschützte“ Anfragen wie Neustart oder Neuinitialisierung senden, wenn Patroni dafür eine Autorisierung verlangt.
-
Ausnahme SystemExit korrekt behandeln (Alexander Kukushkin)
Dadurch werden Probleme vermieden, bei denen Patroni nach Empfang von SIGTERM nicht ordnungsgemäß beendet wurde.
-
HAProxy-Beispielvorlagen für confd (Alexander Kukushkin)
Mit confd wird aus dem Patroni-Zustand im DCS eine HAProxy-Konfiguration erzeugt und dynamisch angepasst.
-
Dokumentation verbessern und umstrukturieren, damit sie für neue Benutzer leichter zugänglich ist (Lauri Apple)
-
API muss während pg_ctl stop role=master melden (Alexander Kukushkin)
Dadurch werden Callback-Aufrufe zuverlässiger, insbesondere beim Stoppen des Clusters. Außerdem wurde die Option
pg_ctl_timeouteingeführt, um die Zeitüberschreitung für Start-, Stopp- und Neustartaufrufe überpg_ctlfestzulegen. -
Wiederholungslogik in etcd korrigieren (Alexander Kukushkin)
Wiederholungen werden vorhersehbarer und robuster.
-
Zookeeper-Code gegen kurze Netzwerkunterbrechungen robuster machen (Alexander Kukushkin)
Kürzere Verbindungszeitüberschreitungen ermöglichen häufigere Verbindungsversuche zu Zookeeper.
Version 0.90
Veröffentlicht am 2016-04-27
Diese Version unterstützt Consul, ergänzt den Tag noloadbalance, ändert das Verhalten des Tags clonefrom und verbessert die Handhabung von pg_rewind sowie das Steuerungsprogramm patronictl.
Consul-Unterstützung
-
Consul-Unterstützung implementieren (Alexander Kukushkin)
Patroni kann neben etcd und Zookeeper auch Consul verwenden. Die Verbindungsparameter können in der YAML-Datei konfiguriert werden.
Neue und verbesserte Tags
-
Tag noloadbalance implementieren (Alexander Kukushkin)
Mit diesem Tag meldet Patroni dem Load-Balancer stets, dass das Replikat nicht verfügbar ist.
-
Implementierung des Tags clonefrom ändern (Alexander Kukushkin)
Zuvor musste bei clonefrom ein Knotenname angegeben werden, wodurch ein markiertes Replikat zwingend von diesem Knoten geklont wurde. Die neue Implementierung macht clonefrom zu einem booleschen Tag: Ist er auf true gesetzt, wird das Replikat zum möglichen Klon-Ursprung für andere Replikate. Gibt es mehrere Kandidaten, wählt das Replikat zufällig einen davon aus.
Verbesserungen der Stabilität und Sicherheit
-
Zahlreiche Verbesserungen der Zuverlässigkeit (Alexander Kukushkin)
Überflüssige Fehlermeldungen werden entfernt, die Stabilität des Failovers verbessert und Sonderfälle beim Lesen aus dem DCS, Herunterfahren, Herabstufen und erneuten Eingliedern des früheren Leaders behandelt.
-
Systemskript verbessern, damit beim Stoppen keine Kindprozesse von Patroni beendet werden (Jan Keirse, Alexander Kukushkin)
Zuvor sendete systemd beim Stoppen von Patroni auch ein Signal an PostgreSQL. Da Patroni selbst ebenfalls versuchte, PostgreSQL zu stoppen, wurden zwei verschiedene Anfragen zum Herunterfahren gesendet: zuerst smart, dann fast. Dadurch trennten sich Replikate zu früh und ein früherer Primärserver konnte nach der Herabstufung nicht wieder beitreten. Die Korrektur stammt von Jan, die vorausgehende Untersuchung von Alexander.
-
Fälle beseitigen, in denen der frühere Primärserver vor dem erneuten Beitritt als Replikat pg_rewind nicht aufrufen konnte (Oleksii Kliukin)
Zuvor wurde pg_rewind nur nach einem Absturz des früheren Primärservers aufgerufen. Jetzt wird pg_rewind für den früheren Primärserver immer ausgeführt, sofern pg_rewind auf dem System vorhanden ist. Damit wird der Fall behoben, dass der Primärserver heruntergefahren wird, bevor die Replikate die letzten Änderungen erhalten haben, etwa beim Herunterfahren im Modus „smart“.
-
Zahlreiche Verbesserungen an Unit- und Akzeptanztests, insbesondere Unterstützung für Zookeeper und Consul (Alexander Kukushkin).
-
Travis CI beschleunigen und Unterstützung für Tests mit Zookeeper (Exhibitor) und Consul implementieren (Alexander Kukushkin)
Sowohl Unit- als auch Akzeptanztests werden bei jedem Commit oder Pull Request automatisch mit etcd, Zookeeper und Consul ausgeführt.
-
Umgebungsvariablen vor dem Aufruf von PostgreSQL-Befehlen aus Patroni bereinigen (Feike Steenbergen)
Dadurch wird verhindert, dass über eine Verbindung zum von Patroni verwalteten PostgreSQL-Cluster Systemumgebungsvariablen ausgelesen werden können.
Änderungen an Konfiguration und Steuerung
-
Konfiguration von patronictl und Patroni vereinheitlichen (Feike Steenbergen)
patronictl kann dieselbe Konfigurationsdatei wie Patroni selbst verwenden.
-
Einlesen der Konfiguration aus Umgebungsvariablen durch Patroni ermöglichen (Oleksii Kliukin)
Dies vereinfacht die automatische Erzeugung einer Patroni-Konfiguration oder das Zusammenführen einer Konfiguration aus verschiedenen Quellen.
-
Datenbanksystemkennung in die von der API zurückgegebenen Informationen aufnehmen (Feike Steenbergen)
-
delete_cluster für alle verfügbaren DCS implementieren (Alexander Kukushkin)
Dadurch unterstützt patronictl neben etcd auch andere DCS.
Version 0.80
Veröffentlicht am 2016-03-14
Diese Version unterstützt kaskadierende Replikation und vereinfacht die Patroni-Verwaltung durch geplante Failover. Für die Migration auf diese Version können ältere Patroni-Versionen, insbesondere 0.78, zusammen mit ihr verwendet werden. Die Funktionen für geplante Failover und kaskadierende Replikation funktionieren jedoch nur mit Patroni 0.80 und neuer.
Kaskadierende Replikation
- Unterstützung für die Tags replicatefrom und clonefrom auf Patroni-Knoten hinzufügen (Oleksii Kliukin).
Mit dem Tag replicatefrom kann ein Replikat einen beliebigen Knoten als Quelle verwenden; dies muss nicht der Primärserver sein. clonefrom bietet dasselbe für das anfängliche Backup. Zusammen ermöglichen sie die vollständige Unterstützung kaskadierender Replikation in Patroni.
- Ausführung von Replikationsmethoden zur Initialisierung eines Replikats auch ohne aktive Replikationsverbindung unterstützen (Oleksii Kliukin).
Dies ist nützlich, um Replikate aus auf S3 oder FTP gespeicherten Snapshots zu erstellen. Eine Replikationsmethode, die keine aktive Replikationsverbindung benötigt, sollte no_master: true in der YAML-Konfiguration angeben. Besteht eine Replikationsverbindung, werden diese Skripte weiterhin der Reihe nach aufgerufen.
Verbesserungen in Patronictl, API und DCS
-
Geplante Failover implementieren (Feike Steenbergen).
Mit patronictl oder API-Aufrufen können Failover für einen bestimmten zukünftigen Zeitpunkt geplant werden.
-
Unterstützung für die Parameter dbuser und password in patronictl hinzufügen (Feike Steenbergen).
-
PostgreSQL-Version zur Ausgabe des Health Checks hinzufügen (Feike Steenbergen).
-
Zookeeper-Unterstützung in patronictl verbessern (Oleksandr Shulgin)
-
Auf python-etcd 0.4.3 migrieren (Alexander Kukushkin)
Konfiguration
- Beispielskript zur Systemkonfiguration für Patroni hinzufügen (Jan Keirse).
- Fehler beheben, durch den Patroni bei DB-Verbindungen den in der Konfigurationsdatei angegebenen Superuser-Namen ignorierte (Alexander Kukushkin).
- Behandlung von CTRL-C korrigieren, indem für den von Patroni gestarteten postmaster eine eigene Session-ID und Prozessgruppe erstellt wird (Alexander Kukushkin).
Tests
-
Akzeptanztests mit behave hinzufügen, um reale Patroni-Betriebsszenarien zu prüfen (Alexander Kukushkin, Oleksii Kliukin).
Die Tests können manuell mit dem Befehl behave gestartet werden. Sie werden außerdem automatisch bei Pull Requests und nach Commits ausgeführt.
Versionshinweise zu einigen älteren Versionen finden sich auf der GitHub-Seite des Projekts .
20 - Leitfaden zur Mitarbeit
Austausch
Bei Fragen, für interaktive Hilfe zur Fehlerbehebung oder zum Austausch mit anderen Patroni-Nutzern steht der Kanal #patroni im PostgreSQL-Slack zur Verfügung.
Fehler melden
Vor dem Melden eines Fehlers sicherstellen, dass er mit der neuesten Patroni-Version reproduzierbar ist! Außerdem sorgfältig prüfen, ob das Problem bereits in unserem Issue-Tracker erfasst ist.
Tests ausführen
Voraussetzungen für die Ausführung von behave-Tests:
- Die PostgreSQL-Pakete einschließlich der contrib -Module müssen installiert sein.
- Die ausführbaren PostgreSQL-Dateien müssen im
PATHverfügbar sein. Gegebenenfalls müssen sie zum Suchpfad hinzugefügt werden, etwa mitPATH=/usr/lib/postgresql/11/bin:$PATH python -m behave. - Für Tests mit externen DCS (z. B. etcd, Consul und Zookeeper) müssen die Pakete installiert sein und die jeweiligen Dienste laufen. Sie müssen unverschlüsselte/ungeschützte Verbindungen auf localhost und dem Standardport annehmen. Bei etcd oder Consul kann die behave-Testsuite die Dienste starten, wenn die ausführbaren Dateien im
PATHverfügbar sind.
Abhängigkeiten installieren:
Nach der Installation aller Abhängigkeiten können die verschiedenen Testsuiten ausgeführt werden:
Testen mit tox
Für tox-Tests muss neben Python nur eine Abhängigkeit installiert werden:
Für die Ausführung der Docker-basierten behave-Tests muss außerdem Docker installiert sein.
Die Tox-Konfiguration in tox.ini enthält „Umgebungen“ für die folgenden Aufgaben:
- lint: Python-Code mit
flake8prüfen - test: Unit-Tests mit
pytestfür alle verfügbaren Python-Interpreter; erzeugt bei erkanntem TTY HTML-Berichte, andernfalls XML-Berichte - dep: Konflikte zwischen Paketabhängigkeiten mit
pipdeptreeerkennen - type: statische Typprüfung mit
pyright - black: Codeformatierung mit
black - docker-build: Docker-Image für die Umgebung
behaveerstellen - docker-cmd: beliebigen Befehl mit dem obigen Image ausführen
- docker-behave-etcd: tox für behave-Tests mit dem obigen Image ausführen
- py*behave: behave mit den verfügbaren Python-Interpretern ausführen (ohne Docker, obwohl genau dies innerhalb der Docker-Container aufgerufen wird)
- docs: Dokumentation mit
sphinxerstellen
tox ausführen
Um die Standardliste der Umgebungen dep, lint, test und docs auszuführen, genügt:
Die Umgebungen test können mit dem Label test ausgeführt werden:
Die Docker-Tests für behave können mit dem Label behave ausgeführt werden:
Entsprechend hat docs das Label docs.
Alle anderen Umgebungen können über ihre jeweiligen Namen ausgeführt werden:
Mit factors können auch Teilmengen der Umgebungen ausgewählt werden. Beispielsweise lassen sich alle Umgebungen für Python 3.10 wie folgt ausführen:
Dies entspricht der Ausführung aller nachfolgend aufgeführten Umgebungen:
Alle konfigurierten Kombinationen von Umgebungen lassen sich mit tox (>=v4) wie folgt auflisten:
Die Umgebungen test und docs versuchen nach Abschluss der Aufgabe, die HTML-Ausgabedateien zu öffnen, sofern tox in einem aktiven Terminal läuft. Dies soll die lokale Arbeit mit diesen Umgebungen erleichtern. Auf einem Mac wird dazu open aufgerufen, unter Linux xdg-open. Für einen anderen Befehl die Umgebungsvariable OPEN_CMD auf dessen Namen oder Pfad setzen. Schlägt dieser Schritt fehl, schlägt dadurch nicht der gesamte Durchlauf fehl. Zum Deaktivieren dieser Funktion die Umgebungsvariable OPEN_CMD auf den wirkungslosen Befehl : setzen.
Behave-Tests
Behave-Tests mit -m behave erstellen Docker-Images auf Basis der PG_MAJOR-Versionen 12 bis 18 und führen anschließend alle behave-Tests aus. Dies kann recht lange dauern. Daher kann es sinnvoll sein, den Umfang auf eine bestimmte Postgres-Version, bestimmte Funktionen oder einzelne Schritte zu begrenzen.
Um die Postgres-Version festzulegen, den vollständigen Namen der gewünschten abhängigen Umgebung zum Erstellen des Images angeben, gefolgt vom Namen der behave-Umgebung. Beispielsweise für Postgres 14:
Um hingegen eine bestimmte Funktion zu testen, können Positionsargumente an behave übergeben werden. Der folgende Befehl führt das behave-Testszenario für die Watchdog-Funktion mit allen Postgres-Versionen aus.
Beide Möglichkeiten lassen sich auch kombinieren.
Einen Pull Request einreichen
- Einen Fork des Repositories erstellen, die Codeänderungen entwickeln und testen.
- Die Änderungen in der Benutzerdokumentation berücksichtigen.
- Einen Pull Request mit einer klaren Beschreibung des Ziels der Änderungen einreichen. Falls nötig, einen bestehenden Issue verlinken.
Rückmeldung zum Pull Request erfolgt so bald wie möglich.
Viel Spaß beim Entwickeln mit Patroni ;-)