Vue imprimable multi-pages de cette section. .
Internes
1 - Protocole du service de découverte
Le protocole de service de découverte aide un nouveau membre etcd à découvrir tous les autres membres du cluster pendant la phase d’amorçage, en utilisant un jeton de découverte partagé et une liste de points de terminaison.
Le protocole de service de découverte n’est utilisé que pendant la phase d’amorçage du cluster, et ne peut pas être utilisé pour la reconfiguration en temps réel ou la surveillance du cluster.
Le protocole utilise un nouveau jeton de découverte pour amorcer un unique cluster etcd. Souvenez-vous qu’un jeton de découverte ne peut représenter qu’un seul cluster etcd. Dès que le protocole de découverte associé à ce jeton est lancé, même s’il échoue en cours de route, il ne doit pas être utilisé pour amorcer un autre cluster etcd.
Le reste de cet article explique le processus de découverte à l’aide d’exemples correspondant à un cluster de découverte auto-hébergé.
Notez que ce document ne concerne que la découverte v3. Consultez le document précédent pour plus de détails sur la découverte v2 .
Workflow du protocole
L’idée du protocole de découverte consiste à utiliser un cluster etcd interne pour coordonner le démarrage d’un nouveau cluster. Tout d’abord, tous les nouveaux membres interagissent avec le service de découverte et contribuent à générer la liste de membres attendue. Ensuite, chaque nouveau membre démarre son serveur en utilisant cette liste, ce qui permet d’obtenir la même fonctionnalité que l’option -initial-cluster.
Dans l’exemple de workflow suivant, nous allons lister chaque étape du protocole à l’aide de la commande etcdctl afin de faciliter la compréhension, et nous supposons que l’hôte http://example.com:2379 héberge un cluster etcd pour le service de découverte.
Par convention, le protocole de découverte etcd utilise le préfixe de clé /_etcd/registry.
Création d’un nouveau jeton de découverte
Générez un jeton unique qui identifiera le nouveau cluster. Ce jeton sera utilisé comme préfixe unique dans l’espace de clés de découverte aux étapes suivantes. Une méthode simple consiste à utiliser uuidgen :
Spécification de la taille attendue du cluster
Le jeton de découverte attend une taille de cluster qui doit être précisée. Cette taille est utilisée par le service de découverte pour savoir quand il a trouvé tous les membres qui formeront initialement le cluster.
En général, la taille du cluster est de 3, 5 ou 7. Consultez taille optimale du cluster pour plus de détails.
Mise en marche des processus etcd
Définissez le jeton de découverte ${UUID} sur le drapeau --discovery-token, et définissez les points de terminaison du cluster etcd qui prend en charge le service de découverte sur le drapeau --discovery-endpoints. Cela activera la découverte v3 pour amorcer le cluster etcd.
Chaque processus etcd suivra les étapes internes suivantes si les drapeaux --discovery-token et --discovery-endpoints sont fournis.
Si le service de découverte active l’authentification par certificat client, configurez les drapeaux suivants. Leur utilisation suit exactement le même schéma que l’utilisation de etcdctl pour communiquer avec un cluster etcd.
Si le service de découverte active l’authentification basée sur les rôles, configurez les drapeaux suivants. Leur utilisation suit exactement le même schéma que l’utilisation de etcdctl pour communiquer avec un cluster etcd.
Les valeurs par défaut de temps ou de délai d’attente peuvent également être modifiées à l’aide des drapeaux suivants, qui s’utilisent exactement de la même manière que etcdctl pour communiquer avec un cluster etcd.
S’enregistrer lui-même
La première action entreprise par chaque processus etcd consiste à s’inscrire dans le cluster nouvellement créé en tant que membre. Cela se fait en créant l’ID de membre comme clé dans la clé de registre complète.
Vérification du statut
Il vérifie la taille attendue du cluster et l’état d’inscription, puis détermine l’action suivante.
Si le nombre de membres enregistrés reste insuffisant, l’attente sera poursuivie jusqu’à l’apparition d’autres membres.
Si le nombre de membres enregistrés est supérieur à la taille attendue N, le système considère les N premiers membres enregistrés comme la liste des membres du cluster. Si le membre lui-même figure dans cette liste, la procédure de découverte réussit, et il récupère tous les pairs à partir de la liste des membres. Sinon, la procédure de découverte échoue, car le cluster est plein.
Le membre peut vérifier l’état du cluster même avant de s’être enregistré. Il peut donc échouer rapidement si le cluster est plein.
En attente de tous les membres
Le processus d’attente continue à surveiller le préfixe de clé /_etcd/registry/${UUID}/members jusqu’à la découverte de tous les membres.
2 - Conventions de journalisation
etcd utilise la bibliothèque zap pour la journalisation de la sortie de l’application, catégorisée en niveaux. Le niveau d’un message de journalisation est déterminé selon les conventions suivantes :
-
Les journaux DebugLevel sont généralement volumineux et sont habituellement désactivés en production.
- Exemples :
- Envoyer un message normal à un pair distant
- Écrire une entrée de journal sur le disque
- Exemples :
-
InfoLevel est la priorité de journalisation par défaut.
- Exemples :
- Configuration au démarrage
- Commencer à effectuer un instantané
- Ajouter un nouveau nœud au cluster
- Ajouter un nouvel utilisateur au sous-système d’authentification
- Exemples :
-
Les journaux WarnLevel sont plus importants que ceux de niveau Info, mais ne nécessitent pas de revue humaine individuelle.
- Exemples :
- Échec de l’envoi d’un message Raft à un pair distant
- Échec de réception d’un message de battement de cœur dans le délai d’élection configuré
- Exemples :
-
Les journaux ErrorLevel sont de haute priorité. Si une application fonctionne correctement, elle ne devrait générer aucun journal de niveau erreur.
- Exemples :
- Échec de l’allocation d’espace disque pour le WAL
- Exemples :
-
PanicLevel enregistre un message, puis déclenche une panique.
- Exemples :
- Échec du codage des messages Raft
- Exemples :
-
FatalLevel enregistre un message, puis appelle os.Exit(1).
- Exemples :
- Échec de la sauvegarde de l’instantané Raft
- Exemples :
3 - Modules Go
Le projet etcd (à partir de la version 3.5) est organisé en plusieurs modules golang hébergés dans un dépôt unique .
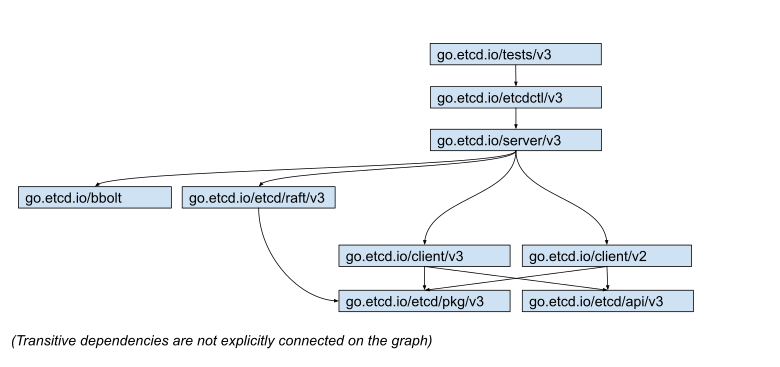
Les modules suivants sont disponibles :
-
go.etcd.io/etcd/api/v3 - contient les définitions d’API (protos et bibliothèques générées à partir de protos) qui définissent le protocole de communication entre les clients et le serveur etcd.
-
go.etcd.io/etcd/pkg/v3 - ensemble de packages d’utilitaires utilisés par etcd sans être spécifiques à etcd lui-même. Un package doit être placé ici uniquement s’il pourrait éventuellement être déplacé vers son propre dépôt à l’avenir. Évitez d’ajouter ici du code qui a de nombreuses dépendances, car celles-ci deviendraient automatiquement des dépendances de la bibliothèque cliente (que nous souhaitons garder légère).
-
go.etcd.io/etcd/client/v3 - bibliothèque cliente utilisée pour contacter etcd sur le réseau (grpc). Recommandée pour toute utilisation nouvelle d’etcd.
-
go.etcd.io/etcd/client/v2 - bibliothèque cliente héritée utilisée pour contacter etcd via le protocole HTTP. Dépréciée. Tout usage nouveau devrait dépendre de la bibliothèque /v3.
-
go.etcd.io/etcd/raft/v3 - implémentation du protocole de consensus distribué. Ne devrait pas contenir de code spécifique à etcd.
-
go.etcd.io/etcd/server/v3 - implémentation etcd. Le code de ce package est interne à etcd et ne devrait pas être utilisé par des projets externes. La structure du package et l’API peuvent évoluer au sein des versions mineures.
-
go.etcd.io/etcd/etcdctl/v3 - un outil en ligne de commande permettant d’accéder à etcd et de le gérer.
-
go.etcd.io/etcd/tests/v3 - un module qui contient tous les tests d’intégration d’etcd. Remarque : Tous les tests unitaires (rapides et n’exigeant pas de dépendances entre modules) devraient être conservés dans les modules locaux au code testé.
-
go.etcd.io/bbolt - implémentation d’un arbre B persistant. Hébergé dans un dépôt séparé : https://github.com/etcd-io/bbolt .
Opérations
-
Tous les modules etcd devraient être publiés en versions identiques, par exemple :
go.etcd.io/etcd/client/v3@v3.5.10doit dépendre dego.etcd.io/etcd/api/v3@v3.5.10.La mise à jour cohérente des versions peut être effectuée à l’aide de :
-
Les modules publiés devraient être étiquetés conformément aux règles https://golang.org/ref/mod#vcs-version , c’est-à-dire que chaque module devrait recevoir sa propre étiquette. La mise en étiquette peut être effectuée à l’aide de :
-
Tous les modules etcd devraient dépendre des mêmes versions des dépendances sous-jacentes. Cela peut être vérifié à l’aide de :
-
Les fichiers go.mod ne doivent pas contenir de dépendances non utilisées et doivent respecter le format
go mod tidy. Cette vérification est effectuée par : -
Pour déclencher des actions sur tous les modules (par exemple, formater automatiquement tous les fichiers), veuillez utiliser/étendre le script suivant :
Avenir
À terme, nous souhaitons faire évoluer les modules etcd vers le modèle suivant :
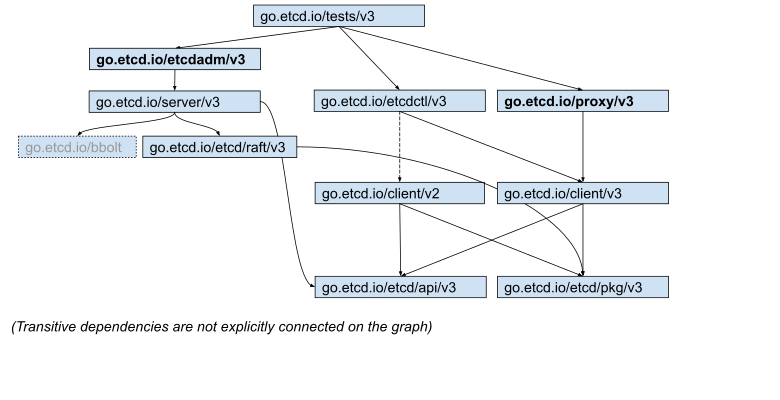
Cela suppose :
- Séparation d’etcdmigrate/etcdadm à partir du binaire etcdctl. Grâce à cela, etcdctl deviendrait clairement un wrapper en ligne de commande autour de l’API client réseau, tandis que etcdmigrate/etcdadm prendrait en charge les opérations physiques directes sur les fichiers de stockage etcd.
- Séparation d’etcd-proxy à partir du binaire ./etcd, car il contient du code plus expérimental et donc des risques et des dépendances supplémentaires.
- Dépréciation du support du protocole v2.