これはセクションの複数ページ印刷用ビューです。 .
学習
- 1: データモデル
- 2: etcdクライアントの設計
- 3: etcdの学習者メンバーの設計
- 4: etcd v3の認証設計
- 5: etcd API
- 6: etcdの永続ストレージファイル
- 7: etcd APIの保証
- 8: etcdと他のキー・バリューストアの比較
- 9: 用語集
1 - データモデル
etcdは、更新頻度の低いデータを確実に保存し、信頼できる監視クエリーを提供するように設計されています。etcdはキー・バリューペアの過去のバージョンを公開し、低コストのスナップショットと過去のイベントの監視(「タイムトラベルクエリー」)を実現します。永続的な多版型同時実行制御のデータモデルは、このような用途に適しています。
etcdは、多版型の永続的な キー・バリューストアにデータを保存します。永続的なキー・バリューストアは、値が新しいデータで置き換えられても、キー・バリューペアの以前のバージョンを保持します。このキー・バリューストアは実質的に不変です。操作は既存の構造をその場で更新せず、更新を反映した新しい構造を常に生成します。変更後も、キーの過去のすべてのバージョンにアクセスし、監視できます。データストアが時間とともに無制限に増大し、古いバージョンを保持し続けるのを防ぐため、ストアをコンパクションして、更新によって古くなったデータの最も古いバージョンを取り除くことができます。
論理的な構造
ストアの論理的な構造は、平坦なバイナリーキー空間です。キー空間には、バイト列のキーを辞書順に並べたインデックスがあるため、範囲クエリーを低コストで実行できます。
キー空間は複数のリビジョンを保持します。ストアを作成した時点のリビジョンは1です。アトミックな変更操作(たとえば、トランザクション操作には複数の操作が含まれることがあります)のたびに、キー空間に新しいリビジョンが作成されます。過去のリビジョンが保持するすべてのデータは変更されません。キーの古いバージョンには、過去のリビジョンを通じて引き続きアクセスできます。同様に、リビジョンにもインデックスが付けられるため、ウォッチャーでリビジョンの範囲を効率的に扱えます。領域を節約するためにストアをコンパクションすると、コンパクションリビジョンより前のリビジョンが削除されます。リビジョンは、クラスターの存続期間を通じて単調に増加します。
キーの作成から削除までを1つの世代とします。各キーは1つ以上の世代を持つことがあります。キーを作成すると、そのキーのバージョンが増加します。現在のリビジョンにキーが存在しなければ、1から始まります。キーを削除すると、そのキーのトゥームストーンが生成され、バージョンが0にリセットされて現在の世代が終了します。キーを変更するたびにバージョンが増加するため、バージョンはキーの世代内で単調に増加します。コンパクションを行うと、そのリビジョンより前に終了したすべての世代が削除されます。また、コンパクションリビジョンより前に設定された値は、最新のものを除いて削除されます。
物理的な構造
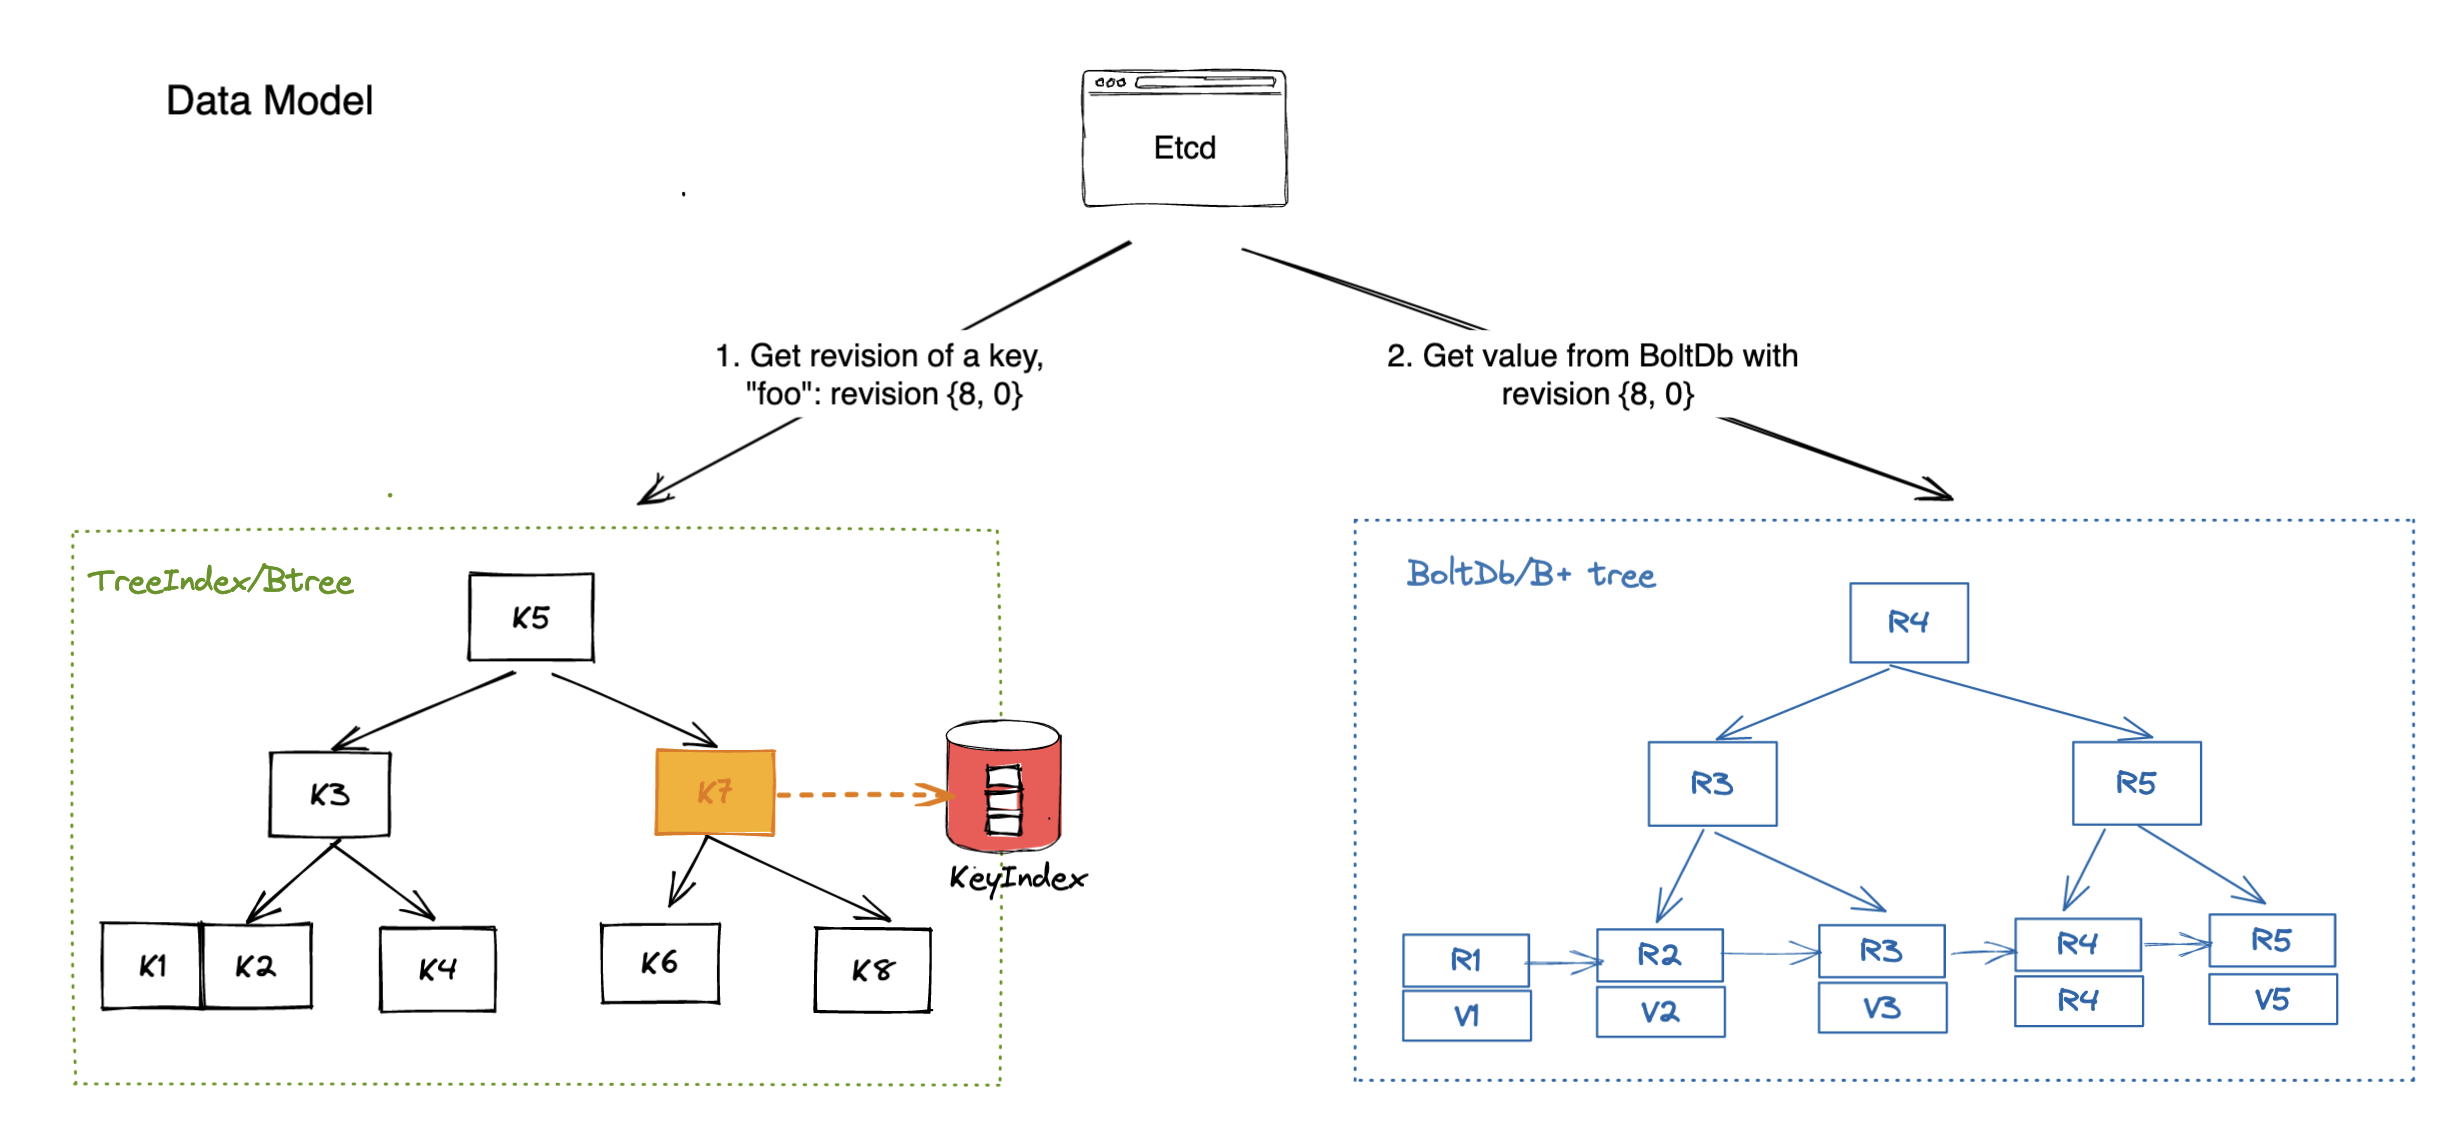
etcdは、永続的なb+tree にキー・バリューペアとして物理データを保存します。効率のため、ストアの状態の各リビジョンは、直前のリビジョンとの差分だけを保持します。1つのリビジョンが、ツリー内の複数のキーに対応することもあります。
キー・バリューペアのキーは、3つの要素からなるタプル(major, sub, type)です。majorは、そのキーを保持するストアのリビジョンです。subは、同じリビジョン内のキーを区別します。typeは、特殊な値に使う省略可能な接尾辞です(値がトゥームストーンを含む場合のtなど)。キー・バリューペアの値は、直前のリビジョンからの変更、つまり1つの差分を保持します。b+treeは、キーのバイト列の辞書順で並びます。リビジョン間の差分に対する範囲検索は高速で、あるリビジョンから別のリビジョンまでの変更をすばやく見つけられます。コンパクションは、古くなったキー・バリューペアを削除します。
etcdは、キーに対する範囲クエリーを高速化するため、メモリー内に補助的なbtree インデックスも保持します。btreeインデックスのキーは、ユーザーに公開されるストアのキーです。値は、永続的なb+tree内の変更へのポインターです。コンパクションは、無効になったポインターを削除します。
全体として、etcdはbtreeからリビジョン情報を取得し、そのリビジョンをキーにしてb+treeから値を取得します(下図)。
2 - etcdクライアントの設計
etcdクライアントの設計
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
はじめに
etcdサーバーの堅牢性は、長年にわたる障害注入テストで実証されています。複雑なアプリケーションロジックの大半は、etcdサーバーとそのデータストアがすでに処理しています。たとえば、クラスターのメンバーシップはクライアントから透過的に扱われ、Raftレイヤーが提案をリーダーに転送します。サーバーの構成要素が正しく動作していても、クライアントと組み合わせたときに、障害下での正しさと高可用性を保証するには、別の複雑なプロトコル群が必要です。理想的には、etcdサーバーが多数の物理マシンを1つの論理クラスターとして提供し、クライアントがレプリカ間の自動フェイルオーバーを実装します。このドキュメントでは、クライアントのアーキテクチャに関する判断と実装の詳細を説明します。
用語集
clientv3:etcd v3 API用の、etcd公式Goクライアントです。
clientv3-grpc1.0:grpc-go v1.0.x
を使う公式クライアント実装で、etcd v3.1の最新版で使用されています。
clientv3-grpc1.7:grpc-go v1.7.x
を使う公式クライアント実装で、etcd v3.2とv3.3の最新版で使用されています。
clientv3-grpc1.23:grpc-go v1.23.x
を使う公式クライアント実装で、etcd v3.4の最新版で使用されています。
バランサー:再試行とフェイルオーバーの仕組みを実装する、etcdクライアントのロードバランサーです。etcdクライアントには、複数のエンドポイント間で負荷を自動的に分散することが求められます。
エンドポイント:クライアントが接続できるetcdサーバーのエンドポイントの一覧です。通常、etcdクラスターの3個または5個のクライアントURLです。
固定エンドポイント:複数のエンドポイントが設定されている場合、v3.3以下のクライアントバランサーは、etcdクラスターへの接続総数を抑えるため、1つのエンドポイントだけを選んでTCP接続を確立します。v3.4では、バランサーがリクエストごとに固定エンドポイントをラウンドロビンで選び、負荷をより均等に分散します。
クライアント接続:gRPC Dialによってetcdサーバーとの間に確立されたTCP接続です。
サブ接続:gRPCのSubConnインターフェースです。各サブ接続は、アドレスのリストを持ちます。バランサーは、解決したアドレスのリストからSubConnを作成します。gRPCのClientConnは、複数のSubConnに対応できます。たとえば、example.comが解決された10.10.10.1と10.10.10.2は、2つのサブ接続になります。etcd v3.4のバランサーは内部リゾルバーを使い、エンドポイントごとに1つのサブ接続を確立します。
一時的な切断:gRPCサーバーが、code Unavailable
のステータスエラーを返すことです。
クライアントの要件
正しさ。サーバーの障害によってリクエストが失敗することはあります。しかし、グローバルな順序の性質、破損データを書き込まないこと、変更操作を多くても1回だけ実行する意味論、監視がイベントの一部だけを観測しないことなど、一貫性の保証に違反することはありません。
活性。サーバーは故障したり、一時的に切断されたりすることがあります。どちらの場合も、クライアントは処理を進められるべきです。そうするよう設定されていない限り、オフラインのサーバーの復帰を待ってデッドロックすべきではありません 。理想的には、クライアントがHTTP/2のpingで利用不能なサーバーを検出し、明確なエラーメッセージを伴って他のノードにフェイルオーバーします。
効率性。クライアントは、最小限のリソースで効率的に動作するべきです。エンドポイントの切り替え後は、それまでのTCP接続を正常に閉じる べきです。フェイルオーバー機構は、障害ノードに対して無駄な再試行を繰り返さず、次に接続するレプリカを的確に予測するべきです。
移植性。公式クライアントは明確に文書化され、その実装を他の言語バインディングにも適用できることが求められます。言語バインディング間で、エラー処理は一貫しているべきです。etcdはgRPCを全面的に採用しているため、その実装もgRPCの長期的な設計目標に沿うべきです。たとえば、差し替え可能な再試行ポリシーは、gRPCの再試行 と互換性を持つべきです。クライアントのバージョン間のアップグレードは、動作を中断させないものであるべきです。
クライアントの概要
etcdクライアントは、次の構成要素を実装しています。
- etcdクラスターへのgRPC接続を確立するバランサー
- etcdサーバーへRPCを送信するAPIクライアント
- 失敗したリクエストを再試行するか、エンドポイントを切り替えるかを決めるエラーハンドラー
初期接続の確立方法(TLSの設定など)、Protocol Buffersメッセージをエンコードしてサーバーに送信する方法、ストリーミングRPCの処理方法などは、言語によって異なる場合があります。ただし、etcdサーバーが返すエラーは同じです。エラー処理と再試行ポリシーも同じであるべきです。
たとえば、etcdサーバーが"rpc error: code = Unavailable desc = etcdserver: request timed out"を返す場合、これは再試行が想定される一時的なエラーです。一方、rpc error: code = InvalidArgument desc = etcdserver: key is not providedは、リクエストが無効であり、再試行するべきでないことを意味します。Goクライアントはgoogle.golang.org/grpc/status.FromError、Javaクライアントはio.grpc.Status.fromThrowableでエラーを解析できます。
clientv3-grpc1.0:バランサーの概要
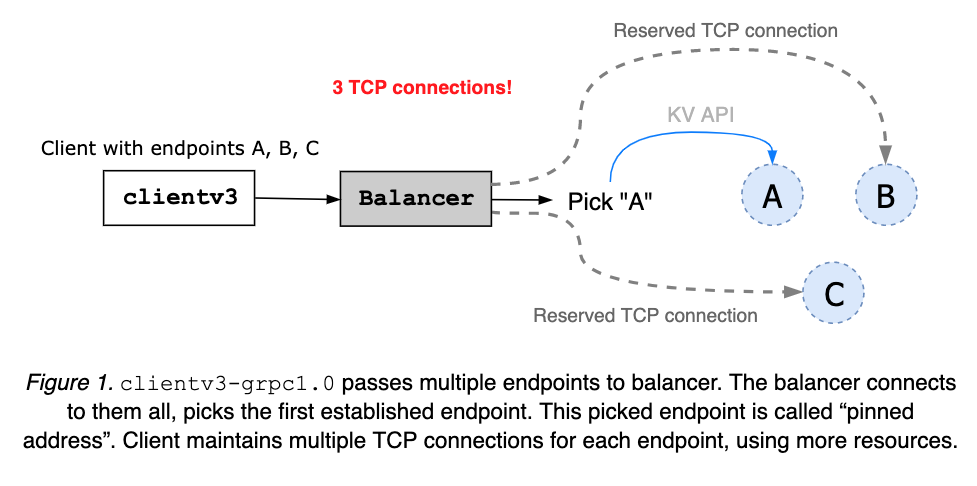
clientv3-grpc1.0は、複数のetcdエンドポイントが設定されると、複数のTCP接続を維持します。その中から1つのアドレスを選び、クライアントのすべてのリクエストの送信に使用します。固定したアドレスは、クライアントオブジェクトが閉じられるまで維持します(図1)。エラーを受け取ると、クライアントはランダムに別のアドレスを選んで再試行します。
clientv3-grpc1.0:バランサーの制限
clientv3-grpc1.0は複数のTCP接続を開くため、バランサーのフェイルオーバーを高速化できる可能性がありますが、より多くのリソースが必要です。バランサーは、ノードの健全性やクラスターのメンバーシップを把握していません。そのため、障害が起きたノードや、ネットワーク分断されたノードに接続したまま動けなくなることがあります。
clientv3-grpc1.7:バランサーの概要
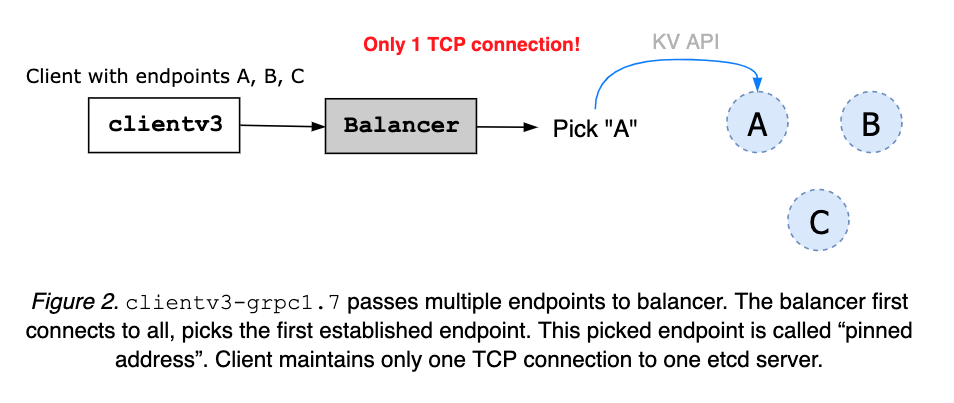
clientv3-grpc1.7は、選択したetcdサーバーへのTCP接続を1つだけ維持します。複数のクラスターエンドポイントが指定されると、クライアントはまずすべてへの接続を試みます。1つの接続が確立すると、バランサーはそのアドレスを固定し、他の接続を閉じます(図2)。固定したアドレスは、クライアントオブジェクトが閉じられるまで維持します。サーバーまたはクライアント側のネットワーク障害によるエラーは、クライアントのエラーハンドラーに渡されます(図3)。
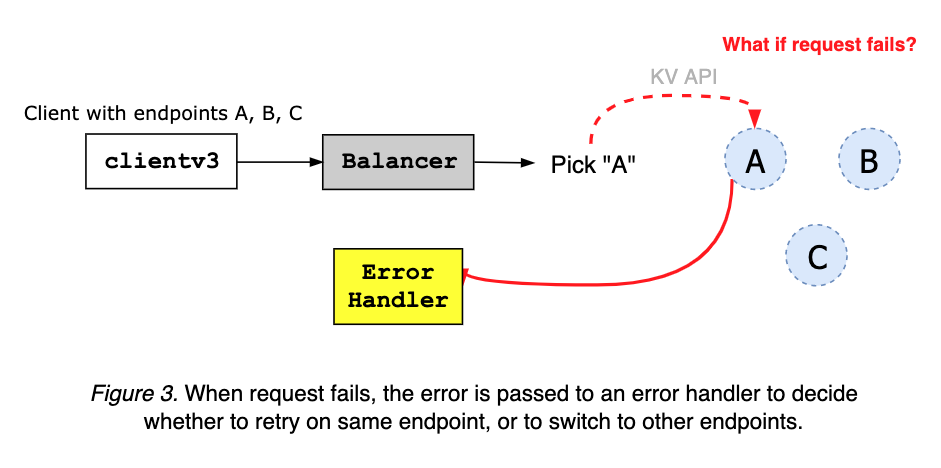
クライアントのエラーハンドラーはgRPCサーバーからエラーを受け取り、エラーコードとメッセージに基づいて、同じエンドポイントで再試行するか、別のアドレスに切り替えるかを決めます(図4と図5)。
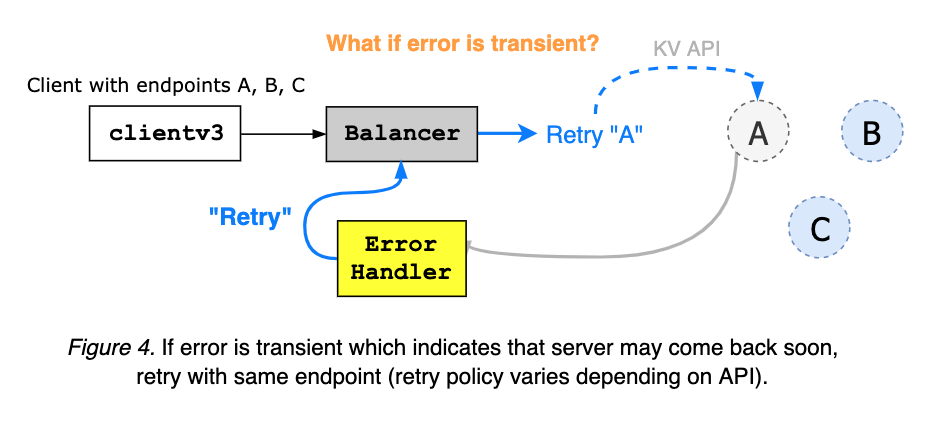
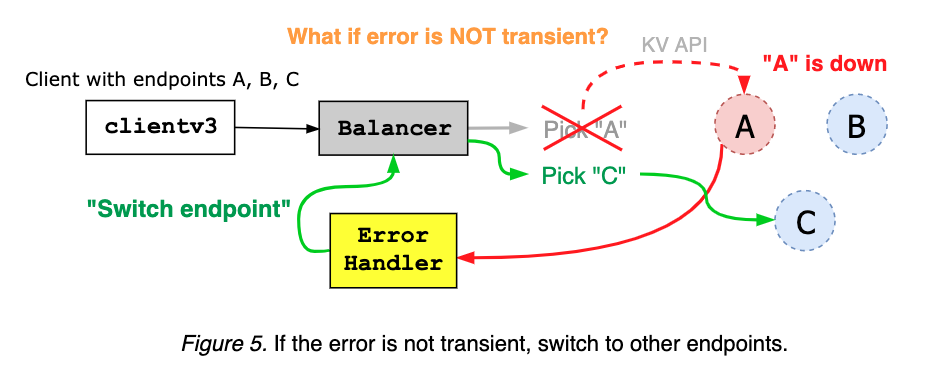
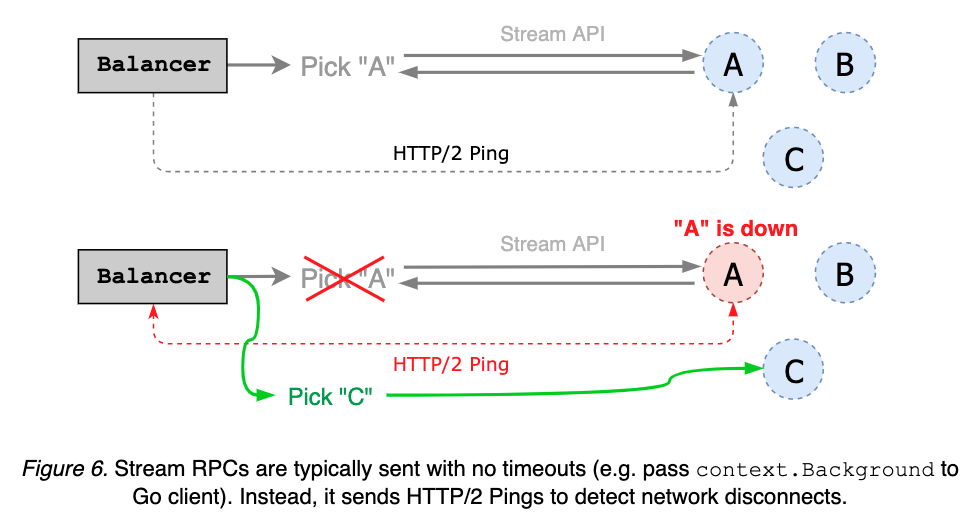
WatchやKeepAliveなどのストリーミングRPCは、タイムアウトを設定せずに要求されることがよくあります。その代わりに、クライアントはHTTP/2のpingを定期的に送信して、固定エンドポイントの状態を確認できます。サーバーがpingに応答しなければ、バランサーは他のエンドポイントに切り替えます(図6)。
clientv3-grpc1.7:バランサーの制限
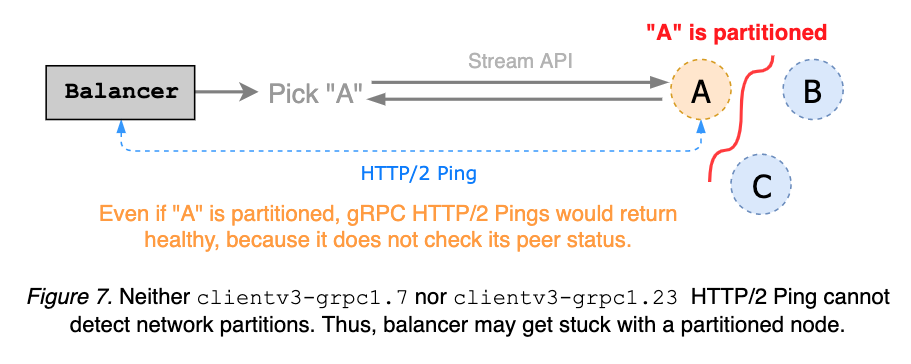
clientv3-grpc1.7のバランサーは、HTTP/2のキープアライブを送信し、ストリーミングリクエストの切断を検出します。これはgRPCサーバーへの単純なping機構であり、クラスターのメンバーシップを考慮しないため、ネットワーク分断を検出できません。分断されたgRPCサーバーもクライアントのpingに応答できるため、バランサーがそのノードに接続したまま動けなくなることがあります。理想的には、キープアライブのpingが分断を検出し、リクエストのタイムアウト前にエンドポイントの切り替えを引き起こすべきです(etcd#8673
と図7を参照)。
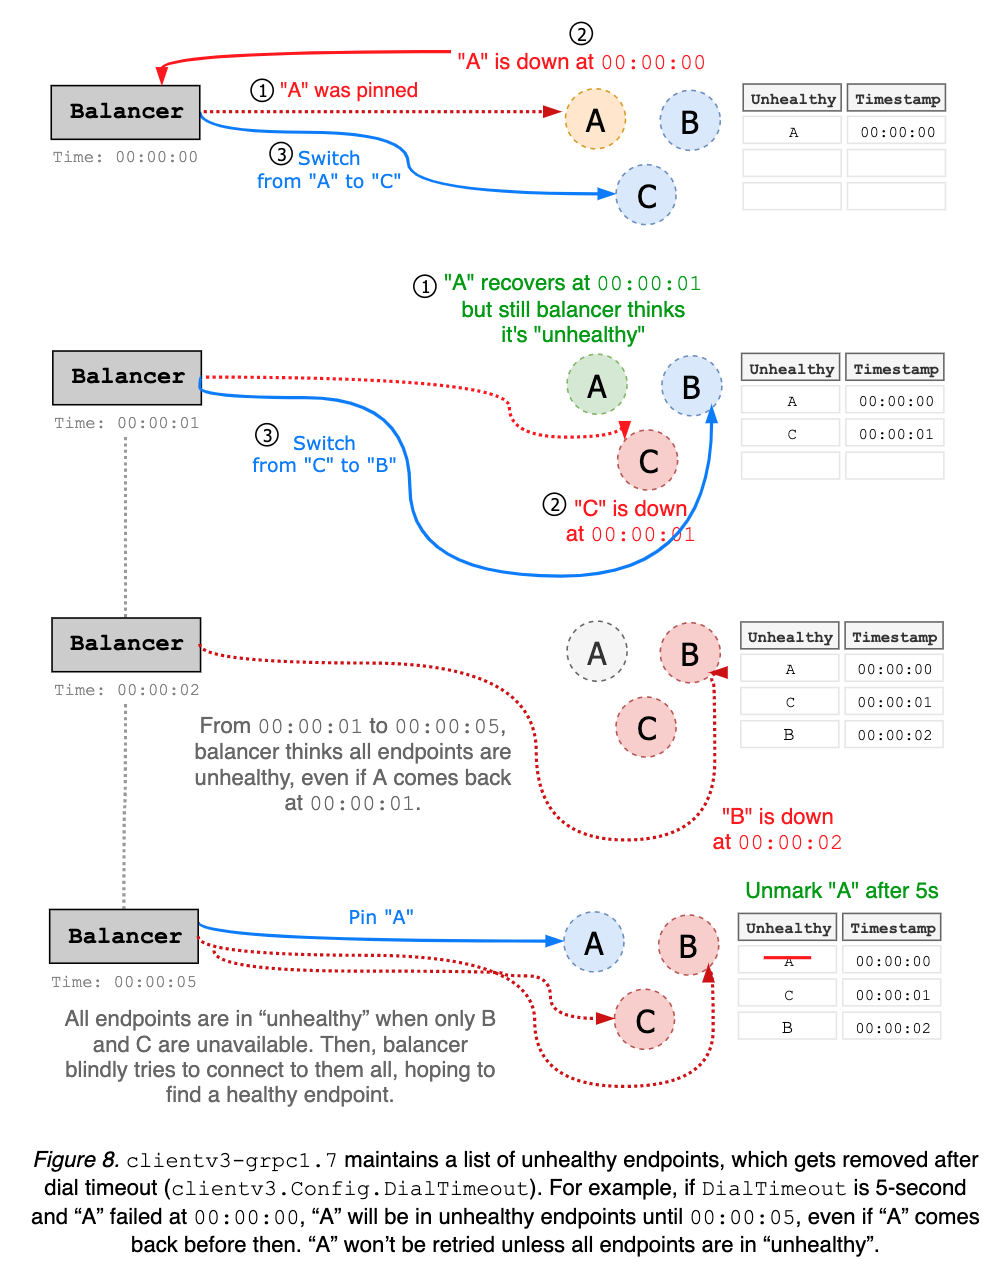
clientv3-grpc1.7のバランサーは、健全でないエンドポイントの一覧を維持します。切断されたアドレスはこの一覧に追加され、待機時間が過ぎるまで利用不能と見なされます。待機時間は接続タイムアウトと同じ値に固定され、デフォルトは5秒です。バランサーは、エンドポイントが健全でないと誤判定することがあります。たとえば、エンドポイントAが除外リストに入った直後に復帰しても、その後5秒間は使用できません(図8)。
clientv3-grpc1.0にも、上記と同じ問題がありました。
アップストリームのgRPC Goは、すでに新しいバランサーインターフェースに移行していました。たとえば、clientv3-grpc1.7の内部のバランサー実装は、新しいgRPCバランサーを使用しながら、古いバランサーの動作との整合性を保とうとしています。互換性はおおむね維持されていましたが、etcdクライアントは微妙な互換性破壊の影響を受けていました
。また、gRPCのメンテナーは、古いバランサーインターフェースに依存しない
ことを推奨しています。一般に、アップストリームからより良いサポートを受けるには、最新のgRPCリリースに追従するのが最善です。再試行ポリシーなどの新機能も、gRPC 1.7ブランチにはバックポートされない可能性があります。そのため、etcdサーバーとクライアントの両方を、最新のgRPCバージョンに移行する必要があります。
clientv3-grpc1.23:バランサーの概要
clientv3-grpc1.7は古いgRPCインターフェースと密結合しており、gRPC依存関係をアップグレードするたびにクライアントの動作が壊れていました。開発とデバッグの作業の大半が、その動作の変化への対処に費やされました。その結果、サーバーの接続性に関する誤った前提を抱えた、過度に複雑な実装になりました。
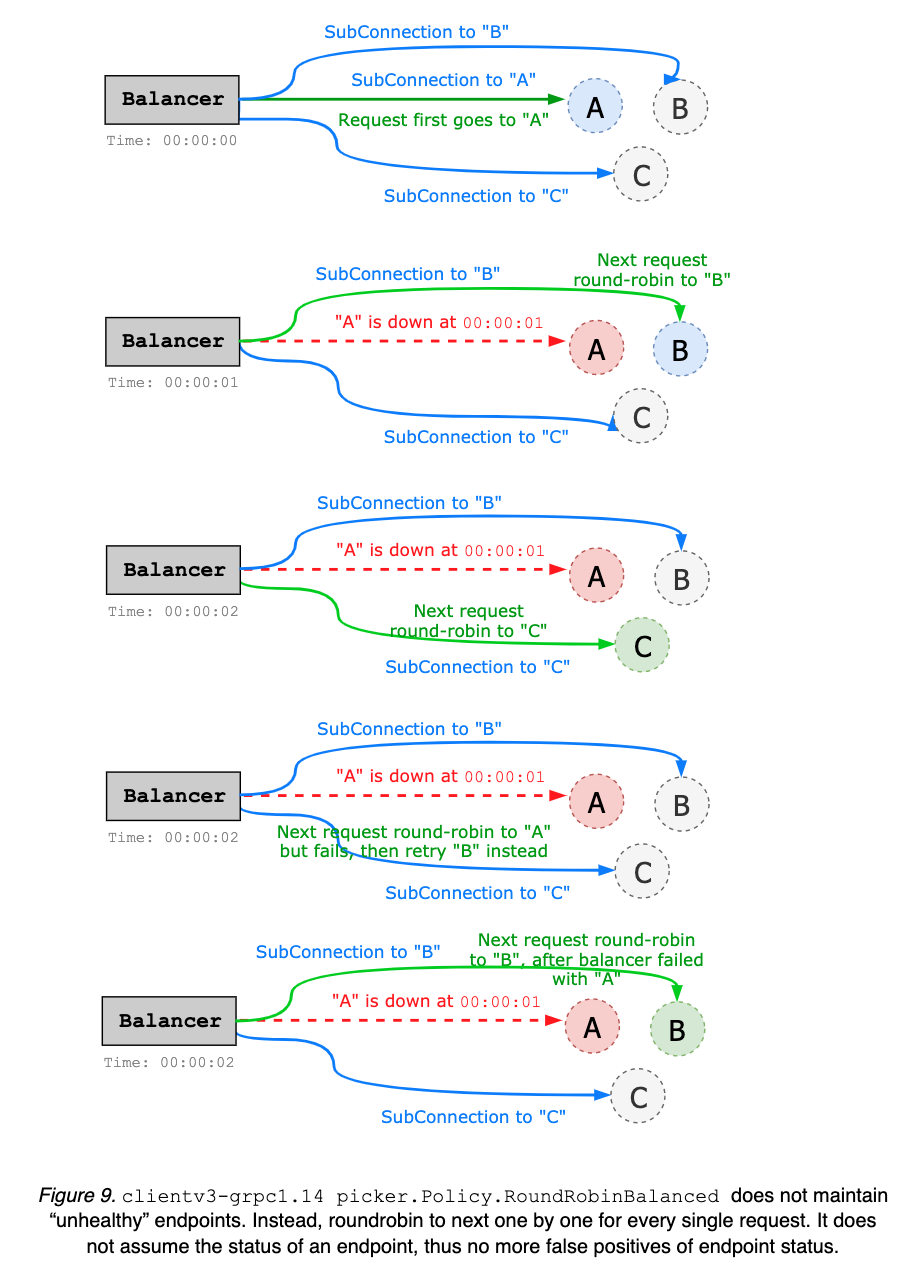
clientv3-grpc1.23の主な目的は、バランサーのフェイルオーバーロジックを単純化することです。古くなる可能性のある、健全でないエンドポイントの一覧を維持するのではなく、現在のエンドポイントから切断されるたびに、次のエンドポイントへ単純にラウンドロビンで移ります。エンドポイントの状態を仮定しないため、複雑な状態追跡は不要です(図8と上記を参照)。すべての後方互換性を維持し、内部だけを変更しているため、clientv3-grpc1.23へのアップグレードに問題はないはずです。
内部的には、複数のエンドポイントが指定されると、clientv3-grpc1.23はエンドポイントごとに1つ、複数のサブ接続を作成します。一方、clientv3-grpc1.7は固定エンドポイントへの接続を1つだけ作成します(図9)。たとえば、5ノードのクラスターでは、clientv3-grpc1.23のバランサーは5つのTCP接続を必要とし、clientv3-grpc1.7は1つだけを必要とします。TCP接続のプールを保持することで、clientv3-grpc1.23はより多くのリソースを使用する可能性がありますが、フェイルオーバー性能に優れた、より柔軟なロードバランサーを提供します。デフォルトの負荷分散ポリシーはラウンドロビンですが、他の方式(power of two、リーダーの選択など)にも容易に拡張できます。clientv3-grpc1.23は、gRPCのリゾルバーグループを使用し、バランサーの選択ポリシーを実装することで、複雑な負荷分散処理をアップストリームのgRPCに委ねます。一方、clientv3-grpc1.7は、各gRPC接続とバランサーのフェイルオーバーを独自に処理するため、実装が複雑になります。clientv3-grpc1.23は、gRPC内部のエラーを自動処理し、バックオフなどの高度な再試行ポリシーも可能にする、gRPCのインターセプターチェーンで再試行を実装しています。clientv3-grpc1.7は、再試行のためにgRPCエラーを独自に解釈します。
clientv3-grpc1.23:バランサーの制限
各エンドポイントの状態をキャッシュすれば、改善できる余地があります。たとえば、バランサーがあらかじめ各サーバーにpingを送り、健全な接続先候補の一覧を維持して、ラウンドロビン時にその情報を使用できます。また、切断時に健全なエンドポイントを優先することもできます。ただし、バランサーの実装が複雑になる可能性があるため、後のバージョンで対応できます。
クライアント側のキープアライブのpingは、依然としてネットワーク分断を考慮していません。ストリーミングリクエストは、分断されたノードで進行できなくなることがあります。クラスターのメンバーシップを把握するには、高度なヘルスチェックサービスを実装する必要があります(詳細はetcd#8673 を参照)。
現在、再試行ロジックはインターセプターとして独自に処理しています。gRPC公式の再試行 を使えば、単純化できる可能性があります。
3 - etcdの学習者メンバーの設計
etcdの学習者メンバー
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
背景
メンバーシップの再構成は、運用上の最も大きな課題の1つでした。よくある課題を確認します。
1. 新しいクラスターメンバーがリーダーに過負荷をかける
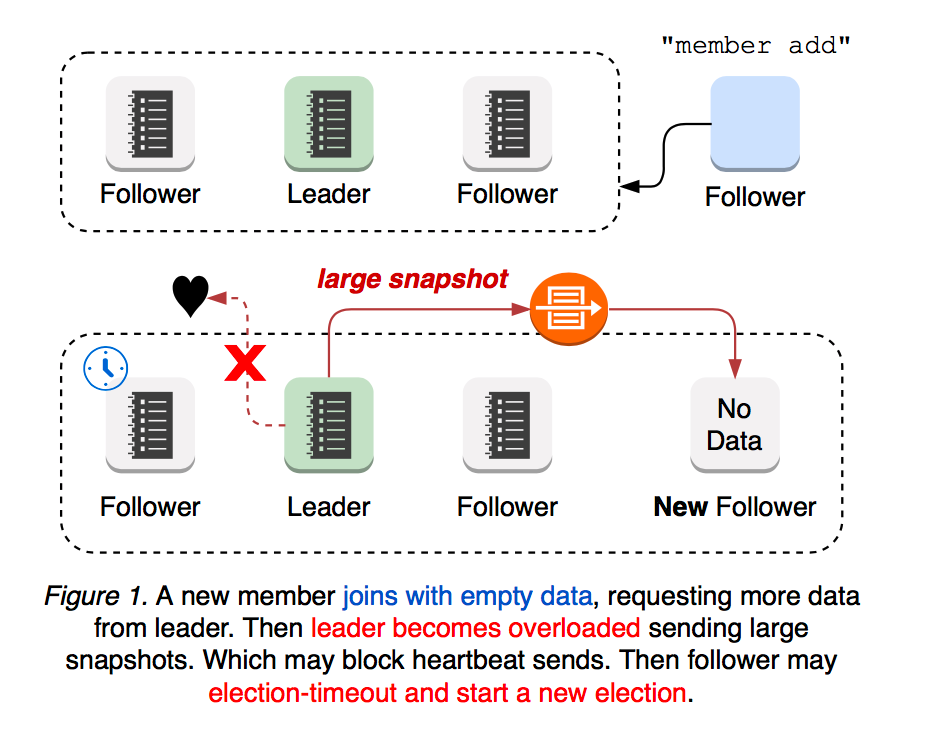
新たに参加したetcdメンバーはデータを持たない状態から開始するため、リーダーのログに追いつくまで、リーダーに多くの更新を要求します。これによってリーダーのネットワークが過負荷になりやすくなり、フォロワーへのハートビートが滞ったり失われたりします。その場合、フォロワーの選挙タイムアウトが発生し、新しいリーダー選挙が始まる可能性があります。つまり、新しいメンバーを加えたクラスターでは、リーダー選挙が起きやすくなります。リーダー選挙と、その後の新しいメンバーへの更新の伝播は、どちらもクラスターを一時的に利用不能にする原因になりやすい処理です(図1)。
2. ネットワーク分断の各状況
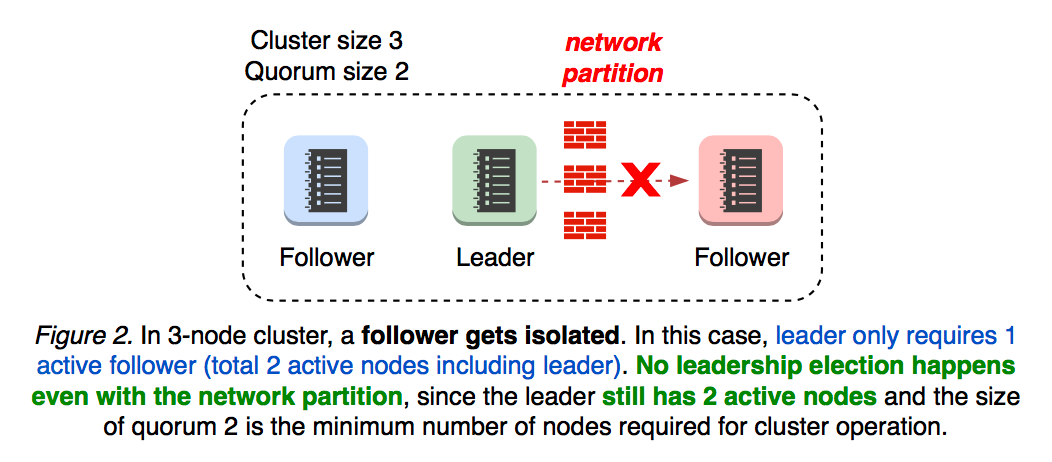
ネットワーク分断が起きるとどうなるでしょうか。リーダーが属する側の状況によって異なります。リーダー側が稼働中のクォーラムを維持していれば、クラスターは動作し続けます(図2)。
2.1 リーダーの孤立
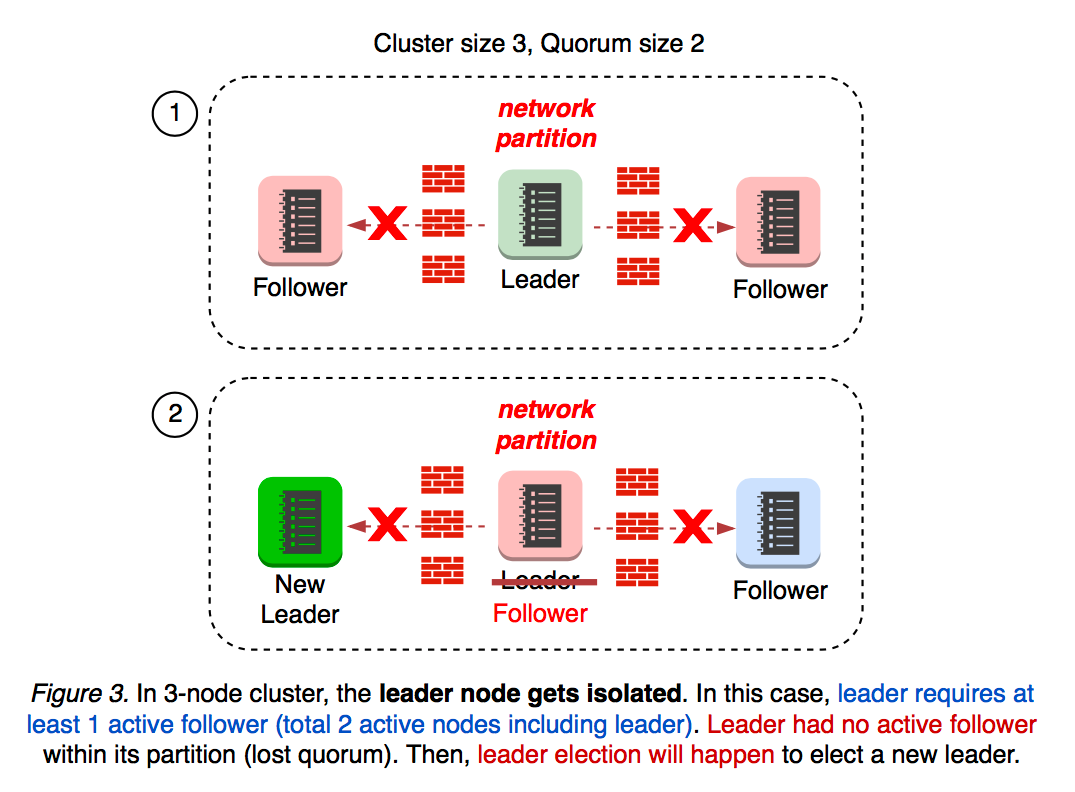
リーダーがクラスターの他のメンバーから孤立すると、どうなるでしょうか。リーダーは各フォロワーの進捗を監視しています。クォーラムとの接続を失うとフォロワーに戻るため、クラスターの可用性に影響します(図3)。
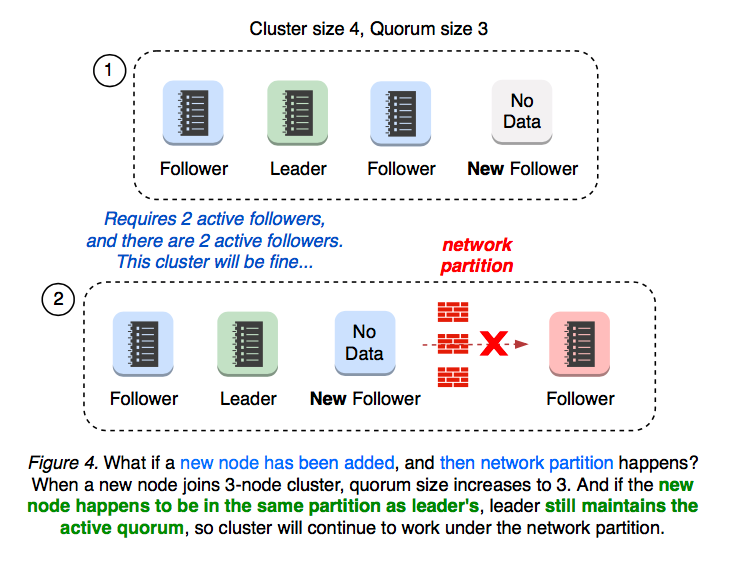
3ノードのクラスターに新しいノードを追加すると、クラスターサイズは4、クォーラムのサイズは3になります。新しいノードが参加した後にネットワーク分断が起きた場合はどうでしょうか。分断後に、新しいメンバーがどちら側に位置するかによって異なります。
2.2 クラスターの3+1への分断
新しいノードがリーダーと同じ側にあれば、リーダーは稼働中の3ノードのクォーラムを維持します。リーダー選挙は発生せず、クラスターの可用性にも影響しません(図4)。
2.3 クラスターの2+2への分断
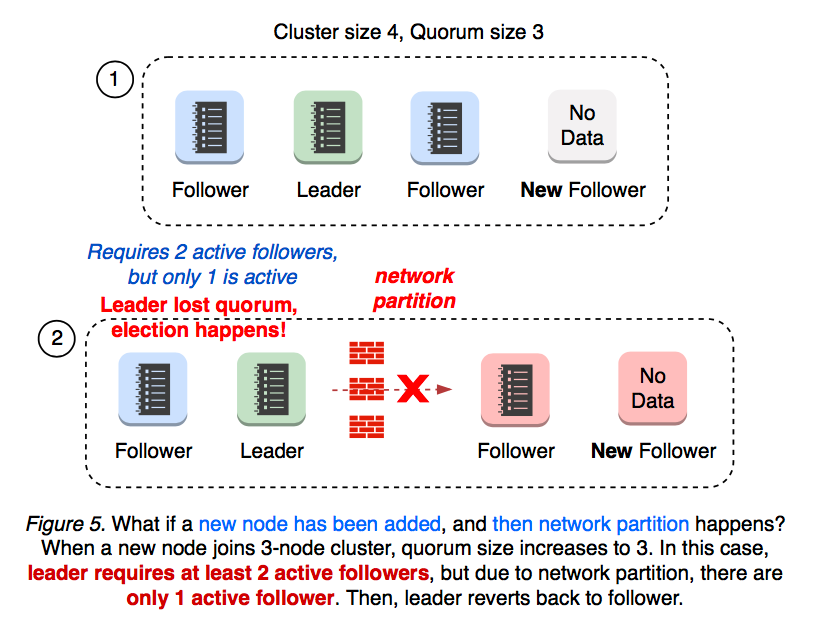
クラスターが2ノードずつに分断されると、どちら側も3ノードのクォーラムを維持できません。この場合、リーダー選挙が発生します(図5)。
2.4 クォーラムの喪失
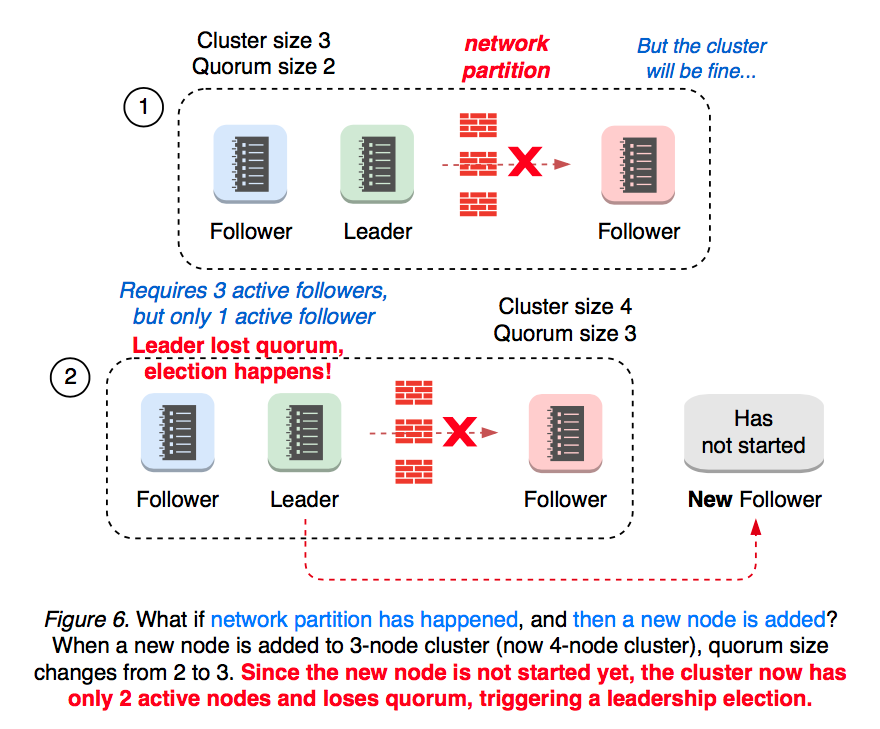
先にネットワーク分断が起き、その後で新しいメンバーを追加するとどうなるでしょうか。分断された3ノードのクラスターでは、すでに1つのフォロワーが切断されています。新しいメンバーを追加すると、クォーラムは2から3に変わります。クラスターの4ノード中、稼働しているのは2ノードだけになるため、クォーラムを失い、新しいリーダー選挙が始まります(図6)。
メンバーの追加はクォーラムのサイズを変える可能性があるため、健全でないノードを置き換えるときは、常に先に“member remove”を行うことを推奨します。
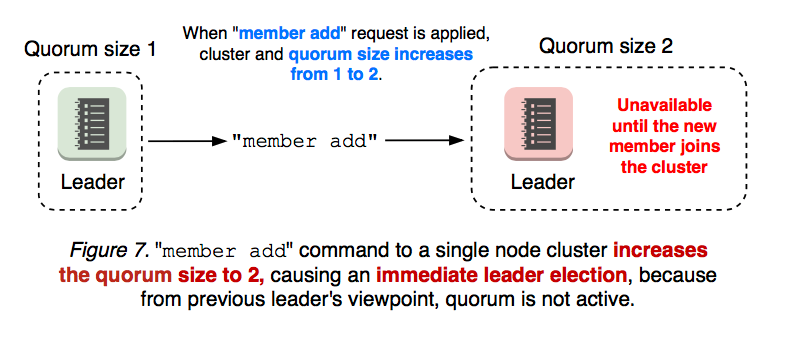
1ノードのクラスターに新しいメンバーを追加すると、クォーラムのサイズは2に変わります。それまでのリーダーが、稼働中のクォーラムがないことを認識すると、直ちにリーダー選挙が始まります。これは、“member add”が2段階の処理だからです。ユーザーはまず“member add”コマンドを適用し、その後で新しいノードのプロセスを起動する必要があります(図7)。
3. クラスターの設定ミス
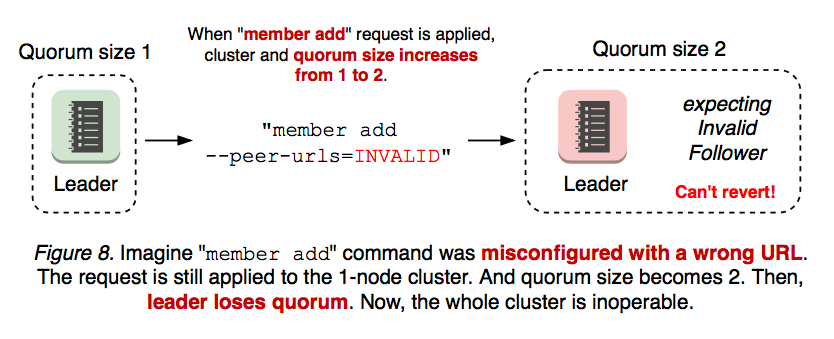
さらに悪いのは、追加したメンバーの設定が誤っている場合です。メンバーシップの再構成は、“etcdctl member add”と、指定したピアURLでetcdサーバープロセスを起動する、2段階の処理です。つまり、URLの値が無効であっても、“member add”コマンドはURLにかかわらず適用されます。最初の段階で無効なURLを適用すると、次の段階で新しいetcdを起動することすらできません。いったんクラスターがクォーラムを失うと、メンバーシップの変更を元に戻す方法はありません(図8)。
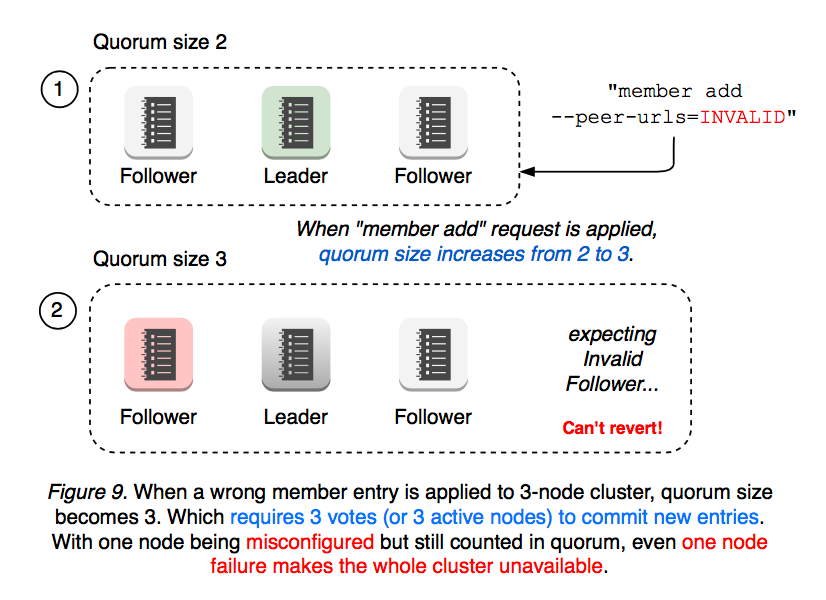
複数ノードのクラスターでも同じです。たとえば、2つのメンバーが停止(1つは故障、もう1つは設定ミス)し、2つが稼働していても、クラスターのメンバーシップを変更するには少なくとも3票が必要です(図9)。
このように、単純な設定ミスでクラスター全体が動作不能になることがあります。その場合、運用担当者はetcd --force-new-clusterフラグを使って、手動でクラスターを再作成する必要があります。etcdはKubernetesに不可欠なサービスになっているため、ごく短い停止でもユーザーに大きな影響を与える可能性があります。etcdでこうした操作を簡単にするために、何を改善できるでしょうか。特に、リーダー選挙はクラスターの可用性にとって極めて重要です。クォーラムのサイズを変えずに、メンバーシップの再構成の影響を小さくできるでしょうか。新しいノードが追いつくまで、リーダーへの更新要求を最小限にして待機できるでしょうか。メンバーシップの設定ミスを常に元に戻せるようにし、より安全に扱えるでしょうか。誤ったmember addコマンドでクラスターが停止することがあってはいけません。新しいメンバーを追加するとき、ユーザーがネットワーク構成を気にする必要はあるでしょうか。ノードの配置や発生中のネットワーク分断にかかわらず、member add APIを動作させられるでしょうか。
Raftの学習者メンバー
前のセクションで挙げた可用性の問題を軽減するため、Raft §4.2.1 では、新しいノード状態“Learner”を導入しています。このノードは、リーダーのログに追いつくまで、投票権のないメンバーとしてクラスターに参加します。
v3.4の機能
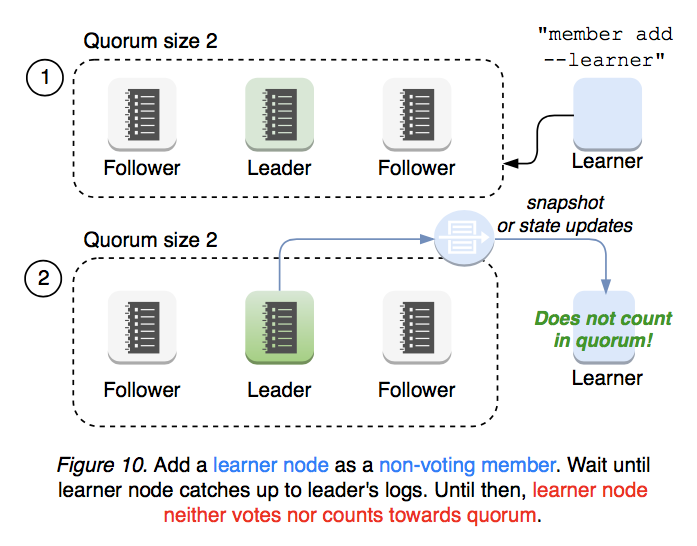
新しい学習者ノードを追加するための運用作業は、できるだけ少なくするべきです。member add --learnerコマンドで新しい学習者メンバーを追加します。学習者メンバーは投票権を持たずにクラスターに参加しますが、リーダーからすべてのデータを受信します(図10)。
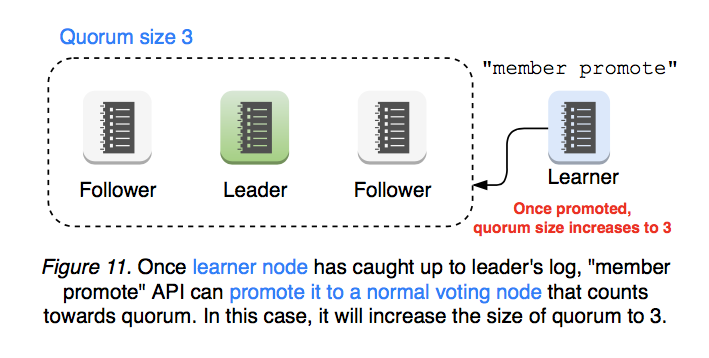
学習者メンバーがリーダーの進捗に追いつくと、member promote APIで投票メンバーに昇格できます。昇格後は、クォーラムの構成員として数えられます(図11)。
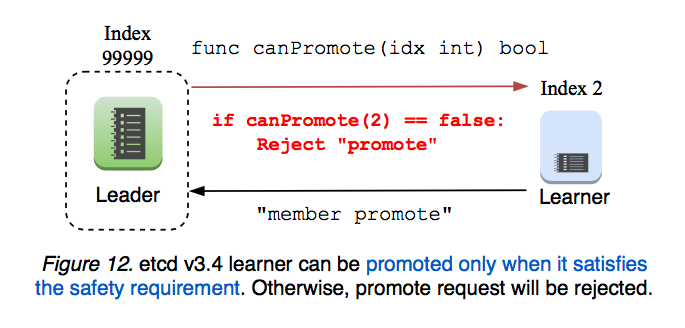
etcdサーバーは、操作の安全性を確保するため、昇格リクエストを検証します。学習者メンバーを投票メンバーに昇格できるのは、そのログがリーダーのログに追いついた後だけです(図12)。
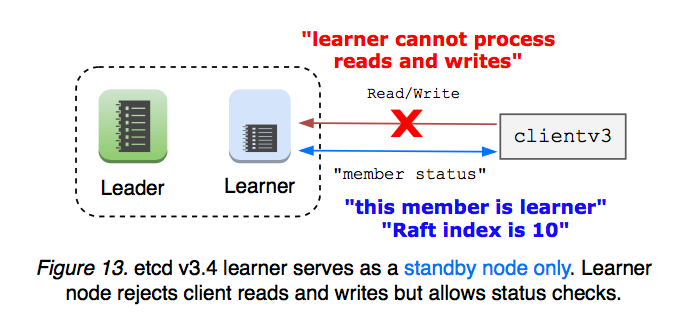
学習者メンバーは、昇格するまで待機ノードとしてのみ機能します。学習者メンバーにリーダーシップを移譲することはできません。学習者メンバーはクライアントの読み書きを拒否します。そのため、クライアントのバランサーはリクエストを学習者メンバーに送らないようにするべきです。これは、学習者メンバーがリーダーにRead Indexリクエストを発行する必要がないことを意味します。この制限によって、v3.4リリースでの初期実装を単純化しています(図13)。
また、etcdはクラスターが持てる学習者メンバーの総数を制限し、ログの複製でリーダーが過負荷になるのを防ぎます。学習者メンバーが自ら昇格することはありません。etcdは学習者メンバーの状態情報と安全性チェックを提供しますが、昇格するかどうかの最終判断は、クラスターの運用担当者が行わなければなりません。
今後のリリースに向けた機能案
新規メンバーの初期状態を学習者に統一し、デフォルトにする:学習者メンバーはクォーラムのサイズを変えないため、新規メンバーのデフォルト状態を学習者にすれば、メンバーシップの再構成の安全性が大幅に向上します。設定ミスがあっても、クォーラムを失わずに常に元に戻せます。
投票メンバーへの昇格を完全に自動化する:学習者メンバーがリーダーのログに追いついたら、クラスターが自動的に昇格させられます。ユーザーが一定のしきい値を定義し、その要件が満たされると、学習者メンバーが自ら投票メンバーに昇格します。ユーザーから見れば、“member add”コマンドは今と同じように動作しつつ、学習者メンバーの機能によって安全性が高まります。
学習者を待機用のフェイルオーバーノードにする:学習者メンバーは待機ノードとして参加し、クラスターの可用性が損なわれると自動的に昇格します。
学習者を読み取り専用にする:学習者メンバーは、昇格しない読み取り専用ノードとしても機能できます。弱い一貫性のモードでは、リーダーからデータを受信するだけで、書き込みを処理しません。コンセンサスの負担なしにローカルで読み取りを処理すると、リーダーの負荷を大幅に減らせますが、古いデータを返す可能性があります。強い一貫性のモードでは、最新のデータを返すためにリーダーへread indexを要求しますが、書き込みは引き続き拒否します。
学習者メンバーとMirror Makerの比較
etcdは、watch APIを使ってキーの作成と更新を別のクラスターに継続的に中継する“mirror maker”を実装しています。ミラーリングは、初期同期が完了すれば、通常は遅延の増加が小さい仕組みです。学習者メンバーとミラーリングは、どちらも既存のデータを読み取り専用で複製するために使える点で共通しています。ただし、ミラーリングは線形化可能性を保証しません。ネットワーク切断中に以前のキー・バリューが破棄されていることがあるため、クライアントは監視レスポンスを検証して正しい順序を確認する必要があります。したがって、ミラーには順序の保証がありません。一貫性と引き換えに最小の遅延が必要な場合(データセンター間など)にはミラーを使用します。すべての履歴データとその順序を維持するには、学習者メンバーを使用します。
付録:v3.4の学習者メンバーの実装
“MemberAdd” APIに“Learner”ノードの種類を公開する。
etcdクライアントは、“MemberAdd” APIに学習者ノード用のフラグを追加します。etcdサーバーのハンドラーは、pb.ConfChangeAddLearnerNode型のメンバーシップ変更エントリーを適用します。コマンドの適用後、サーバーはetcd --initial-cluster-state=existingフラグを指定してクラスターに参加します。この学習者ノードは、投票も、クォーラムの構成員として数えられることもありません。
学習者メンバーはまだ遅れている可能性があり、クォーラムにも数えられないため、etcdサーバーは学習者メンバーにリーダーシップを移譲してはいけません。学習者メンバーが多いほどリーダーが伝播するデータが増えるため、etcdサーバーはクラスターが持てる学習者メンバーを1つに制限します。クライアントは学習者ノードと通信できますが、学習者メンバーは直列化可能読み取りとメンバー状態API以外のすべてのリクエストを拒否します。これは初期実装を単純にするためです。将来的には、クラスターのデータを継続的にミラーリングする読み取り専用サーバーとして、学習者メンバーを拡張できます。クライアントのバランサーは、学習者ノードのエンドポイントを除外する補助関数を提供しなければなりません。そうしなければ、学習者メンバーへ送ったリクエストが失敗する可能性があります。クライアントのメンバー同期の呼び出しは、学習者というノードの種類を考慮するべきです。クライアントのエンドポイント更新の呼び出しも同様です。
MemberListとMemberStatusのレスポンスは、どのノードが学習者かを示すべきです。
“MemberPromote” APIを追加する。
Raft内部では、学習者ノードに対する2回目のMemberAdd呼び出しが、そのノードを投票メンバーに昇格させます。リーダーは、各フォロワーと学習者メンバーの進捗を保持します。学習者メンバーがスナップショットメッセージの処理を完了していなければ、昇格リクエストを拒否します。昇格リクエストを受け付けるのは、学習者ノードが健全であり、リーダーと同期済み、または差分がしきい値以内の場合に限ります。たとえば、学習者メンバーに複製するエントリー数がスナップショット件数の1/10未満なら、昇格後にリーダーが学習者メンバーへスナップショットを送る必要が生じる可能性は低くなります。これらのロジックはすべてetcdserverパッケージに固定されており、設定で変更することはできません。
参考資料
- 元のGitHub Issue:etcd#9161
- ユースケース:etcd#3715
- ユースケース:etcd#8888
- ユースケース:etcd#10114
4 - etcd v3の認証設計
v2の認証システムを再利用しない理由
v3プロトコルは、v2のようなRESTfulインターフェースではなく、gRPCを通信に使用します。この新しいプロトコルによって、v2の設計を見直し、改善する機会が得られました。たとえば、v3の認証は接続単位で行い、v2の低速なリクエスト単位の認証から改善されています。また、次のセクションで説明するとおり、v2の認証の意味論は、一貫性を考えるうえで実際には扱いにくい面があります。v3には、v2の認証システムの欠点を解消する、明確に定義された認証機構の説明と実装があります。
機能要件
- リクエスト単位ではなく、接続単位の認証
- gRPC APIに、ユーザーIDとパスワードによる認証を実装する
- 認証ポリシーの変更後は、認証を更新しなければならない
- v2と同じように、シンプルで使いやすい機能を提供する
- v3は、v2のディレクトリ構造とは異なり、平坦なキー空間を提供する。権限チェックは、区間との照合で行う
- v2の認証より強い一貫性保証を持つ
必要な主な変更
- クライアントは、認証付きのリクエストを送信する前に、認証だけに使用する専用の接続を作成しなければならない
- Raftコマンド(
etcdserverpb.InternalRaftRequest)に、権限情報(ユーザーIDと認可時のリビジョン)を追加する - 各リクエストの権限チェックを、APIレイヤーではなく、状態機械のレイヤーで行う
権限メタデータの一貫性
認証のメタデータも、etcdに保存する他のデータと同様に、etcdのRaftプロトコルが制御するストレージに保存し、管理する必要があります。これは、etcdクラスター全体の可用性と一貫性を損なわないために必要です。メタデータ(権限情報など)の読み書きに、クォーラムを超える、すべてのノードの合意が必要なら、単一ノードの障害でクラスター全体が停止する可能性があります。すべてのノードの同時の合意を要求すると、利用可能なクォーラムが存在していても、メンバーのいずれかが停止していれば、通常の読み書きリクエストのチェックを完了できません。この全会一致方式は、結果的にクラスターの可用性を低下させます。一貫した順序付けから合意が得られるため、Raftのクォーラムに基づくコンセンサスで十分です。
etcd v2プロトコルの認証機構には、扱いの難しい点があります。メタデータの一貫性は上記のように動作するべきですが、実際はそうなっていません。各権限チェックは、クライアントリクエストを受信したetcdメンバーが、フォロワーであっても処理します(server/etcdserver/api/v2http/client.go)。そのため、古いメタデータに基づいてチェックする可能性があります。
メタデータが古いままになるということは、運用担当者がetcdctlを実行しても、認証構成がすぐには反映されないことを意味します。したがって、古いメタデータがいつまで有効なのかを知る方法がありません。通常、構成変更はコマンドの実行直後に反映されます。しかし、高負荷の状況などでは不整合な状態が長引き、ユーザーや開発者にとって直感に反する状況が生じることがあります。そのため、このような回避策 が必要になります。
権限の不整合は線形化されたリクエストにとって安全でない
認証状態の不整合が最も深刻になるのは、書き込み時です。運用担当者があるユーザーの書き込みを無効にしても、書き込みがキー・バリューストアに対してだけ順序付けられ、認証システムに対しては順序付けられていなければ、書き込みが成功する可能性があります。認証ストアとキー・バリューストアの両方に対する順序付けがなければ、古い権限を利用した攻撃を受けるおそれがあります。
したがって、etcdの状態機械に権限チェックのロジックを追加するべきです。各状態機械は、適用段階で自身の権限情報に基づいてリクエストをチェックするべきです。そのため、認証情報は古くなっていてはいけません。
設計と実装
認証
まず、クライアントはユーザーIDとパスワードを認証するためだけのgRPC接続を作成しなければなりません。etcdサーバーは、認証レスポンスを返します。成功時には認証トークン、失敗時にはエラーを返します。クライアントはAPIリクエストを行うとき、この認証トークンを使ってetcdに認証情報を提示できます。
認証トークンの要求に使ったクライアント接続は、通常、破棄します。その接続には新しいトークンの認証情報を設定できないためです。gRPCには、接続の作成(grpc.Dial()の呼び出し)後にRPCごとの認証情報を追加する方法がありません。したがって、接続を通じて取得したトークンを、その接続に割り当てることはできません。トークンを使用するには、新しい接続が必要です。
Authenticate() RPCの実装に関する注意事項
Authenticate() RPCは、指定されたユーザー名とパスワードに基づいて認証トークンを生成します。etcdは、Goのbcryptパッケージを使って、設定されたパスワードを保存し、入力されたパスワードを検証します。bcryptのパスワード検証は設計上、計算コストが高く、一般的なx64サーバーで約100msかかります。そのため、この検証を状態機械の適用段階で行うと、etcdクラスター全体で1秒当たり約10件のAuthenticate()リクエストしか処理できず、性能上の問題になります。
性能を確保するため、v3の認証機構はetcdのAPIレイヤーでパスワードを検証し、Raftの外部で並列化できるようにしています。ただし、これにより、検査時点と使用時点の差(TOCTOU)による権限上の問題が生じる可能性があります。
- クライアントAが
Authenticate()リクエストを送信する - APIレイヤーが
Authenticate()のパスワード検証部分を処理する - 別のクライアントBが
ChangePassword()リクエストを送信し、サーバーがそれを完了する - 状態機械のレイヤーが、Aの
Authenticate()のリビジョン番号取得部分を処理する - サーバーがAに成功を返す
- Aは、古いパスワードで認証された状態になる
この状況を避けるため、APIレイヤーは認証ストアのリビジョン番号に基づくバージョン番号の検証を行います。パスワードの検証時に、APIレイヤーは認証ストアのリビジョン番号を保存します。パスワードの検証に成功した後、保存したリビジョン番号を最新のリビジョン番号と比較します。番号が異なれば、別の処理が認証メタデータを更新したことになるため、検証をやり直します。この仕組みにより、古いパスワードに基づく認証の成功を防げます。
APIレイヤーでのトークンの解決
Authenticate()で認証した後、クライアントは認証を使用しない場合と同様にgRPC接続を作成できます。既存の初期化処理に加え、新しく作成した接続にトークンを関連付ける必要があります。このための機能を、grpc.WithPerRPCCredentials()が提供します。
クライアントからの各認証付きリクエストにはトークンが含まれます。サーバー側では、grpc.metadata.FromIncomingContext()でトークンを取得できます。サーバーは、誰がリクエストを発行し、そのユーザーがいつ認可されたかを取得できます。この情報はAPIレイヤーによって、Raftログエントリー(etcdserverpb.InternalRaftRequest)のヘッダー(etcdserverpb.RequestHeader.Usernameとetcdserverpb.RequestHeader.AuthRevision)に設定されます。
状態機械での権限チェック
etcdserverpb.RequestHeader内の認証情報は、状態機械の適用段階でチェックされます。この段階では、認証ストアの最新リビジョンに基づいて、要求されたキーに対する権限がユーザーに付与されているかを確認します。
2種類のトークン:simpleとJWT
トークンには、simpleとJWTの2種類があります。simpleトークンは、本番での使用を想定していません。暗号署名がなく、サーバーがトークンとユーザーの対応関係を状態として追跡する必要があるため、開発時のテスト用です。本番環境では、暗号署名と検証を行うJWTトークンの使用を推奨します。実装上、JWTはステートレスです。トークン自体にユーザー名やリビジョンなどのメタデータを含められるため、サーバーはトークンとメタデータの対応関係を記憶する必要がありません。
simpleトークンには、既知の問題#18437 があります。etcdサーバー内ではトークンをAPIレイヤーで解決し、simpleトークンは状態を保持します。この処理は線形化可能なチェックで保護されていないため、etcdメンバーが前の認証リクエストを処理し終える前に、次のリクエストを受信することがあります。その場合、メンバーはクライアントに"invalid auth token"エラーを返す可能性があります。この問題は、ネットワーク状態が良いノードでは通常まれですが、大きな遅延があると発生することがあります。回避策として、アプリケーション側にこのエラーを処理する再試行の仕組みを実装できます。
JWTトークンの直接設定
標準のAuthenticate() RPCの流れに加え、etcdはクライアントにJWTトークンを直接設定する方法をサポートしています。これにより、生成、検証、ローテーションを含むJWTトークンのライフサイクル全体を、アプリケーションがetcdの外部で管理できます。
用途と処理の流れ
この方法は、次の場合に役立ちます。
- etcdとは別のトークン管理システムが、JWTトークンの生成とライフサイクルを管理する
- アプリケーションが、外部の仕組み(環境変数や構成サービスなど)を通じて署名済みのJWTトークンを受け取る
- トークンのライフサイクルを、etcdによる自動生成ではなく、クライアントアプリケーションだけで管理する必要がある
一般的な流れは、次のとおりです。
- etcdとは別の外部の発行元が、ユーザー名とその他のクレームを含む、署名付きのJWTトークンを生成する
- アプリケーションが署名済みトークンを受け取り、etcdクライアントに設定する
- クライアントが、
Authenticate()を呼び出さずに、リクエストにJWTトークンを直接付けて送信する - etcdサーバーが、設定された公開鍵でトークンの署名を検証し、トークン内のユーザー名に基づいてアクセスを許可する
- トークンの有効期限が切れる前に、アプリケーションが外部の発行元から新しいトークンを取得する
- アプリケーションが、更新されたトークンを使って新しいクライアントを作成する(トークンの更新にはクライアントの再作成が必要)
標準の認証との違い
標準のAuthenticate()の流れでは、次のように動作します。
- クライアントが、ユーザー名とパスワードを指定して
Authenticate()を呼び出す - etcdがトークンを生成して返す
- クライアントが、後続のリクエストにこのトークンを自動的に使用する
- トークンの更新には、再度
Authenticate()を呼び出す必要がある
JWTトークンを直接設定する場合は、次のように動作します。
- 署名済みのJWTトークンを使ってクライアントを初期化する
- クライアントは
Authenticate()を呼び出さない - すべてのリクエストで、そのトークンを直接使用する
- 有効期限前の新しいトークンの取得と、クライアントのライフサイクル管理は、クライアントアプリケーションが担う
有効なトークンがない場合のAuthStatus
JWTトークンを自ら管理するアプリケーションをサポートするため、AuthStatus RPCは、認証が有効かどうかの確認と、現在のauthRevisionの取得ができるように設計されています。これは、トークンの有効期限が切れ、外部のトークンプロバイダーから新しい有効なトークンを取得するために最新のリビジョンが必要となるリカバリー時に重要です。
この機能がなければ、トークンの有効期限切れによって現在のauthRevisionを取得できず、新しいトークンを生成できないデッドロックに陥る可能性があります。
KVSモデルとファイルシステムモデルの違いに関する注意事項
etcd v3はKVSであり、ファイルシステムではありません。そのため、正確なキー名、または["start key", "end key")のようなキー範囲の形式で、ユーザーに権限を付与できます。これは、存在しないキーに対しても権限を付与できることを意味します。意図しない権限の付与に注意してください。ファイルシステムに似たシステム(ChubbyやZooKeeperなど)では、inodeのようなデータ構造に権限情報を含められます。そのため、スティッキービットの場合を除き、存在しないキーに権限を付与することはできません。
etcd v3のモデルでは、ファイルシステムに似たシステムとは異なり、メタデータの複数回の検索が必要です。最悪の場合の検索コストは、ユーザーに権限が付与されたキーと区間の総数になります。v3の平坦なキー空間は、各inodeが権限メタデータを含むUnixのファイルシステムモデルとはまったく異なるため、このコストは避けられません。実際には、メタデータはキャッシュの効果が得られるほど小さいため、深刻な問題にはなりません。
5 - etcd API
このドキュメントでは、etcd v3 APIの中心となる設計の概要を説明します。 etcd v3.5で非推奨となったetcd v2 APIとは異なることに注意してください。 すべてを網羅するものではなく、使用頻度の低いAPI呼び出しに話を広げずに、etcdを理解するために必要な基本的な考え方に焦点を当てます。 etcdのすべてのAPIは、etcdサーバーが処理するリモートプロシージャコール(RPC)を分類したgRPCサービス で定義されています。 etcdのすべてのRPCの完全な一覧は、gRPC API一覧 にMarkdown形式で記載されています。
gRPCサービス
etcdサーバーに送信するすべてのAPIリクエストは、gRPCのリモートプロシージャコールです。etcdのRPCは、機能に基づいてサービスに分類されます。
etcdのキー空間を扱う主要なサービスは、次のとおりです。
- KV - キー・バリューペアを作成、更新、取得、削除します。
- Watch - キーの変更を監視します。
- Lease - クライアントのキープアライブメッセージを処理するプリミティブを提供します。
クラスター自体を管理するサービスは、次のとおりです。
- Auth - ユーザーを認証するための、ロールに基づく認証機構です。
- Cluster - メンバーシップ情報と構成機能を提供します。
- Maintenance - リカバリー用スナップショットの作成、ストアのデフラグメンテーション、メンバーごとの状態情報の取得を行います。
リクエストとレスポンス
etcdのすべてのRPCは同じ形式に従います。各RPCは、NameRequestを引数に取り、NameResponseをレスポンスとして返す関数Nameを持ちます。たとえば、Range RPCの定義は次のとおりです。
レスポンスヘッダー
etcd APIのすべてのレスポンスには、そのレスポンスに関するクラスターのメタデータを含むヘッダーが付属します。
- Cluster_ID - レスポンスを生成したクラスターのIDです。
- Member_ID - レスポンスを生成したメンバーのIDです。
- Revision - レスポンス生成時のキー・バリューストアのリビジョンです。
- Raft_Term - レスポンス生成時のメンバーのRaftの任期です。
アプリケーションは、Cluster_IDまたはMember_IDフィールドを読み取り、意図したクラスター(メンバー)と通信していることを確認できます。
Revisionフィールドから、キー・バリューストアの最新のリビジョンを取得できます。これは、過去のリビジョンを指定してtime travel queryを実行し、リクエスト時点での最新のリビジョンを知りたい場合に特に役立ちます。
Raft_Termを使うと、クラスターが新しいリーダー選挙を完了したことを検出できます。
Key-Value API
Key-Value APIは、etcd内に保存されたキー・バリューペアを操作します。通常、etcdに対するリクエストの大半はキー・バリューのリクエストです。
システムのプリミティブ
キー・バリューペア
キー・バリューペアは、キー・バリューAPIで操作できる最小単位です。各キー・バリューペアは、protobuf形式 で定義された複数のフィールドを持ちます。
- Key - バイト列で表したキーです。空のキーは許可されません。
- Value - バイト列で表した値です。
- Version - キーのバージョンです。削除するとバージョンはゼロにリセットされ、キーを変更するたびにバージョンが増加します。
- Create_Revision - キーが最後に作成されたリビジョンです。
- Mod_Revision - キーが最後に変更されたリビジョンです。
- Lease - キーに関連付けられたリースのIDです。leaseが0の場合、キーにリースは関連付けられていません。
etcdは、キーと値に加え、キーのメッセージの一部としてリビジョンのメタデータも付与します。このリビジョン情報は、作成時刻と変更時刻によってキーに順序を付け、分散同期のための並行処理制御に役立ちます。etcdクライアントの分散共有ロック は、作成リビジョンを使ってロックの所有権を待ちます。同様に、変更リビジョンは、ソフトウェアトランザクショナルメモリー の読み取り集合の競合の検出や、リーダー選挙 の更新の待機に使用します。
リビジョン
etcdは、キー空間が変更されるたびに増加する、クラスター全体の64ビットカウンターであるストアリビジョンを保持します。リビジョンはグローバルな論理時計として機能し、ストアへのすべての更新を順序付けます。新しいリビジョンが表す変更は差分です。リビジョンに関連付けられるデータは、ストアを変更したデータです。内部的には、新しいリビジョンとは、増加したリビジョンをキーとして、バックエンドのB+treeに変更を書き込むことを意味します。
etcdの多版型同時実行制御 バックエンドを考えると、リビジョンの有用性がさらに分かります。MVCCモデルでは、過去のキーのリビジョンを保持するため、キー・バリューストアを過去のリビジョンの状態で参照できます。クラスター管理者は、この履歴の保持ポリシーを設定して、ストレージを細かく管理できます。通常、etcdはタイマーによってキーの古いリビジョンを破棄します。一般的なetcdクラスターは、更新によって古くなったキーのデータを数時間保持します。これにより、一時的なネットワーク障害だけでなく、クライアントの長時間の切断にも確実に対処できます。ウォッチャーは、最後に観測した過去のリビジョンから再開するだけです。同様に、特定の時点のストアを読み取るには、読み取りリクエストにリビジョンを指定すると、そのリビジョンがコミットされた時点のキー空間の状態からキーを返せます。
キー範囲
etcdのデータモデルは、平坦なバイナリーキー空間上のすべてのキーにインデックスを付けます。これは、キーをディレクトリにまとめる階層構造を使う他のキー・バリューストアとは異なります。キーはディレクトリ単位ではなく、キーの区間[a, b)で列挙します。
etcdでは、この区間を「範囲」と呼ぶことがよくあります。範囲に対する操作は、ディレクトリに対する操作より表現力があります。階層型ストアと同様に、[a, a+1)による単一キーの検索(例:[‘a’, ‘a\x00’)は’a’を検索)や、ディレクトリの深さに従ってキーをエンコードすることによるディレクトリ検索をサポートします。さらに、区間では接頭辞も表せます。たとえば、区間['a', 'b')は、文字列’a’を接頭辞に持つすべてのキーを検索します。
慣例として、リクエストの範囲はkeyとrange_endフィールドで表します。keyフィールドは範囲の最初のキーで、空にしないでください。range_endは、範囲の最後のキーの次のキーです。range_endが指定されていないか空の場合、範囲にはkey引数だけが含まれます。range_endがkeyに1を加えたもの(例:“aa”+1 == “ab”、“a\xff”+1 == “b”)の場合、その範囲はkeyを接頭辞に持つすべてのキーを表します。keyとrange_endの両方が’\0’の場合、その範囲はすべてのキーを表します。range_endが’\0’の場合、その範囲はkey引数以上のすべてのキーを表します。
Range
RangeRequestを受け取るRange API呼び出しで、キー・バリューストアからキーを取得します。
- Key, Range_End - 取得するキー範囲です。
- Limit - リクエストで返すキーの最大数です。limitを0に設定すると、上限なしとして扱います。
- Revision - 範囲の取得に使用するキー・バリューストアの時点です。revisionがゼロ以下の場合、最新のキー・バリューストアを対象とします。リビジョンがすでにコンパクションされている場合、レスポンスとしてErrCompactedを返します。
- Sort_Order - ソートするリクエストの順序です。
- Sort_Target - ソート対象のキー・バリューのフィールドです。
- Serializable - 範囲リクエストで、メンバーローカルの直列化可能読み取りを使用するように設定します。Rangeはデフォルトで線形化可能であり、クラスターの現在のコンセンサスを反映します。性能と可用性を高めるため、直列化可能な範囲リクエストは、古いデータを読み取る可能性と引き換えに、クラスター内の他のノードとのコンセンサスを必要とせず、ローカルに処理されます。
- Keys_Only - 値を返さず、キーだけを返します。
- Count_Only - 範囲内のキーの数だけを返します。
- Min_Mod_Revision - キーの変更リビジョンの下限です。それより小さい変更リビジョンを除外します。
- Max_Mod_Revision - キーの変更リビジョンの上限です。それより大きい変更リビジョンを除外します。
- Min_Create_Revision - キーの作成リビジョンの下限です。それより小さい作成リビジョンを除外します。
- Max_Create_Revision - キーの作成リビジョンの上限です。それより大きい作成リビジョンを除外します。
クライアントは、Range呼び出しからRangeResponseメッセージを受信します。
- Kvs - 範囲リクエストに一致するキー・バリューペアの一覧です。
Count_Onlyを設定すると、Kvsは空になります。 - More -
limitが設定されている場合、要求した範囲内に返すべきキーがまだあるかどうかを示します。 - Count - 範囲リクエストを満たすキーの総数です。
キー範囲が大きく、レスポンス全体をバッファーに保持したくない場合は、RangeStream を参照してください。
RangeStream
RangeStreamはRangeと同じ結果セットを返しますが、サーバーがレスポンスを一連のチャンクに分割し、クライアントへストリーミングします。これにより、サーバーとクライアントのどちらも、大きな範囲全体をメモリーに保持する必要がなくなります。RangeStreamは、Rangeと同じRangeRequestを受け付けます。
クライアントは、RangeStream呼び出しからRangeStreamResponseメッセージのストリームを受信します。
各チャンクのフィールドは、次のように設定されます。
- Kvs - 各チャンクは、結果の重複しない一部分を保持します。すべてのチャンクの
kvsを到着順に連結すると、1回のRange呼び出しと同じキー集合が得られます。 - Header, More, Count - ストリームがエラーなく完了した場合に限り、最後のチャンクにだけ設定されます。それより前のチャンクでは、これらのフィールドはゼロ値のままです。各チャンクの
range_responseにproto.Mergeを適用すると、Rangeが返すものと同等のRangeResponseが得られます。
ストリームがエラーで終了した場合、有効なheader、more、countを持つチャンクはありません。
ストリーム内のすべてのチャンクは、同じリビジョンを対象に処理されます。リクエストにRevisionが設定されていない場合、サーバーはストリームの開始時に最新のコミット済みリビジョンを取得し、残りのストリームでも同じリビジョンを使います。
RangeStreamは、独自のソート順序やリビジョンフィルター(min_mod_revision、max_mod_revision、min_create_revision、max_create_revision)をサポートしません。どちらかを使用したリクエストは、Unimplementedを返します。etcdのgRPCプロキシもRangeStreamをサポートしません。
RangeStreamを処理する一般的な方法は、次の2つです。
- 各チャンクを個別に処理する。 結果全体を集める前に、キーが届くたびにデコードして処理したい、高い性能が求められる場面に適しています。クライアントはチャンクを順に読み、各チャンクの
kvsを処理します。ストリームが正常に終了した後、最後のチャンクからheader、more、countを読み取ります。 - 単一のレスポンスにまとめる。 単項の
Rangeと同等の結果が必要な場合に適しています。クライアントは、各チャンクのrange_responseを、たとえばproto.Mergeで1つのRangeResponseにマージします。マージ後の結果には、すべてのkvsと、最後のチャンクのheader、more、countが含まれます。Goクライアントは、この処理を補助するclientv3.GetStreamToGetResponseを提供します。
Put
PutRequestを受け取るPut呼び出しで、キー・バリューストアにキーを保存します。
- Key - キー・バリューストアに格納するキーの名前です。
- Value - キー・バリューストア内のキーに関連付ける、バイト列の値です。
- Lease - キー・バリューストア内のキーに関連付けるリースIDです。leaseが0の場合、リースがないことを示します。
- Prev_Kv - 設定されている場合、この
Putリクエストによる更新前のキー・バリューペアのデータを返します。 - Ignore_Value - 設定されている場合、現在の値を変更せずにキーを更新します。キーが存在しない場合はエラーを返します。
- Ignore_Lease - 設定されている場合、現在のリースを変更せずにキーを更新します。キーが存在しない場合はエラーを返します。
クライアントは、Put呼び出しからPutResponseメッセージを受信します。
- Prev_Kv -
PutRequestでPrev_Kvを設定していた場合、Putによって上書きされたキー・バリューペアです。
範囲の削除
DeleteRangeRequestを受け取るDeleteRange呼び出しで、キーの範囲を削除します。
- Key, Range_End - 削除するキー範囲です。
- Prev_Kv - 設定されている場合、削除したキー・バリューペアの内容を返します。
クライアントは、DeleteRange呼び出しからDeleteRangeResponseメッセージを受信します。
- Deleted - 削除したキーの数です。
- Prev_Kv -
DeleteRange操作で削除したすべてのキー・バリューペアの一覧です。
トランザクション
トランザクションは、キー・バリューストア上のアトミックなIf/Then/Else構造です。リクエストをアトミックなブロック(then/else)にまとめ、キー・バリューストアの内容に基づいて実行条件(if)を設定するプリミティブを提供します。トランザクションは、意図しない並行更新からキーを保護すること、比較交換操作を構築すること、より高度な並行処理制御を開発することに使用できます。
トランザクションは、1つのリクエスト内で複数のリクエストをアトミックに処理できます。キー・バリューストアの変更では、そのトランザクションによってストアのリビジョンが増加するのは1回だけで、生成されるすべてのイベントが同じリビジョンを持つことを意味します。ただし、1つのトランザクション内で同じキーを複数回変更することは禁止されています。
すべてのトランザクションには、If文のように、複数の比較の論理積による実行条件があります。各比較は、ストア内の1つのキーを検査します。値の有無、指定した値との比較、キーのリビジョンやバージョンを確認できます。異なる2つの比較は、同じキーにも異なるキーにも適用できます。すべての比較はアトミックに適用されます。すべてがtrueの場合、トランザクションは成功とされ、etcdはthen / successリクエストブロックを適用します。それ以外は失敗とされ、else / failureリクエストブロックを適用します。
各比較は、Compareメッセージとしてエンコードされます。
- Result - 論理比較演算の種類です(等しい、より小さい、など)。
- Target - 比較するキー・バリューのフィールドです。キーのバージョン、作成リビジョン、変更リビジョン、値のいずれかです。
- Key - 比較対象のキーです。
- Target_Union - 比較のためにユーザーが指定するデータです。
比較ブロックを処理した後、トランザクションはリクエストのブロックを適用します。ブロックは、RequestOpメッセージのリストです。
- Request_Range -
RangeRequestです。 - Request_Put -
PutRequestです。キーは一意でなければなりません。他のPutsやDeletesとキーが重複してはいけません。 - Request_Delete_Range -
DeleteRangeRequestです。PutsやDeletesのリクエストとキーが重複してはいけません。
以上をまとめ、TxnRequestを受け取るTxn API呼び出しでトランザクションを発行します。
- Compare - トランザクションの実行条件となる、条件の論理積を表す述語のリストです。
- Success - すべての比較の評価結果がtrueの場合に処理するリクエストのリストです。
- Failure - いずれかの比較の評価結果がfalseの場合に処理するリクエストのリストです。
クライアントは、Txn呼び出しからTxnResponseメッセージを受信します。
- Succeeded -
Compareの評価結果がtrueかfalseかを示します。 - Responses - succeededがtrueの場合は
Successブロック、falseの場合はFailureを適用した結果に対応するレスポンスのリストです。
Responsesリストは、適用したRequestOpリストの結果に対応し、各レスポンスはResponseOpとしてエンコードされます。
内部の各レスポンスに含まれるResponseHeaderは、どのような用途でも解釈しないでください。
最新のリビジョンを取得する必要がある場合、クライアントは常にTxnResponseの最上位のResponseHeaderを確認してください。
Watch API
Watch APIは、キーの変更を非同期に監視する、イベントに基づくインターフェースを提供します。etcdの監視は、現在または過去の指定したリビジョンから継続的に監視してキーの変更を待ち、キーの更新をクライアントへストリーミングします。
イベント
すべてのキーの各変更は、Eventメッセージで表されます。Eventメッセージは、更新データと更新の種類を提供します。
- Type - イベントの種類です。PUTは、キーに新しいデータが保存されたことを示します。DELETEは、キーが削除されたことを示します。
- KV - イベントに関連付けられたKeyValueです。PUTイベントは現在のkvペアを含みます。kv.Version=1のPUTイベントは、キーが作成されたことを示します。DELETEイベントは、変更リビジョンが削除時のリビジョンに設定された、削除済みのキーを含みます。
- Prev_KV - イベント直前のリビジョンにおける、そのキーのキー・バリューペアです。帯域幅を節約するため、監視で明示的に有効にした場合にだけ設定されます。
監視ストリーム
監視は長時間継続するリクエストであり、gRPCストリームでイベントデータをストリーミングします。監視ストリームは双方向です。クライアントはストリームに書き込んで監視を設定し、ストリームから読み取って監視イベントを受信します。イベントに監視ごとの識別子を付けることで、1つの監視ストリームに多数の異なる監視を多重化できます。この多重化によって、中核のetcdクラスターのメモリー使用量と接続の負担を減らせます。
監視イベントに関する保証については、etcd APIの保証 を参照してください。
クライアントは、Watchが返したストリームでWatchCreateRequestを送信して、監視を作成します。
- Key, Range_End - 監視するキー範囲です。
- Start_Revision - 監視を開始するリビジョン(そのリビジョンを含む)で、省略可能です。指定しない場合、監視作成レスポンスのヘッダーにあるリビジョンの次からイベントをストリーミングします。最後のコンパクションリビジョンから、利用可能なイベント履歴全体を監視できます。
- Progress_Notify - 設定されている場合、最近のイベントがなければ、監視はイベントを含まないWatchResponseを定期的に受信します。これは、切断されたウォッチャーを、最近の既知のリビジョンから復旧したい場合に役立ちます。通知の送信頻度は、etcdサーバーが現在の負荷に基づいて決定します。
- Filters - サーバー側で除外するイベントの種類のリストです。
- Prev_Kv - 設定されている場合、監視はイベント発生前のキー・バリューデータを受信します。上書きされたデータの確認に役立ちます。
クライアントは、WatchCreateRequestへの応答として、または既存の監視で新しいイベントが発生した場合に、WatchResponseを受信します。
- Watch_ID - レスポンスに対応する監視のIDです。
- Created - 監視作成リクエストへのレスポンスである場合にtrueに設定されます。クライアントはIDを保存し、そのストリームで監視イベントを受信するようにしてください。作成したウォッチャーへ送信されるすべてのイベントは、同じwatch_idを持ちます。
- Canceled - 監視キャンセルリクエストへのレスポンスである場合にtrueに設定されます。キャンセルされたウォッチャーには、それ以降のイベントは送信されません。
- Compact_Revision - ウォッチャーがコンパクション済みリビジョンで監視しようとすると、etcdで利用可能な最小の過去のリビジョンに設定されます。これは、コンパクション済みリビジョンでウォッチャーを作成した場合や、ウォッチャーがキー・バリューストアの進行に追いつけない場合に発生します。ウォッチャーはキャンセルされます。同じstart_revisionで新しい監視を作成しても失敗します。
- Events - 指定した監視IDに対応する、新しいイベントを順に並べたリストです。
クライアントが監視イベントの受信を停止するには、WatchCancelRequestを発行します。
- Watch_ID - これ以上イベントを送信しないようキャンセルする監視のIDです。
Lease API
リースは、クライアントの生存を検出する仕組みです。クラスターは、生存時間付きのリースを付与します。指定したTTL期間内にetcdクラスターがkeepAliveを受信しなければ、リースは期限切れになります。
リースとキー・バリューストアを結び付けるため、各キーには最大1つのリースを関連付けられます。リースが期限切れになるか取り消されると、そのリースに関連付けられたすべてのキーが削除されます。期限切れになった各キーは、イベント履歴に削除イベントを生成します。
リースの取得
LeaseGrantRequestを受け取るLeaseGrant API呼び出しで、リースを取得します。
- TTL - 秒単位の希望する生存時間です。
- ID - リースに要求するIDです。IDを0に設定すると、etcdがIDを選択します。
クライアントは、LeaseGrant呼び出しからLeaseGrantResponseを受信します。
- ID - 付与されたリースのIDです。
- TTL - サーバーが選択した、秒単位のリースの生存時間です。
- ID - 取り消すリースのIDです。リースを取り消すと、関連付けられたすべてのキーが削除されます。
キープアライブ
リースは、LeaseKeepAlive API呼び出しで作成した双方向ストリームで更新します。クライアントがリースを更新するときは、ストリームでLeaseKeepAliveRequestを送信します。
- ID - 維持するリースのIDです。
キープアライブストリームは、LeaseKeepAliveResponseで応答します。
- ID - 新しいTTLで更新されたリースです。
- TTL - リースに残された、秒単位の新しい生存時間です。
6 - etcdの永続ストレージファイル
このドキュメントでは、etcdの永続ストレージの形式、つまり命名、内容、開発者が内容を調べるためのツールを説明します。今後、ストレージモデルの変更に合わせて内容を拡充することを想定しています。etcd開発者のデータリカバリーに役立つことを目的としています。
前提知識
次の記事は、このドキュメントを読むための背景知識として役立ちます。
- etcdのデータモデルの概要
- Raftの概要 (特に「5.3 ログの複製」のセクション)。
概要
長期間保持されるファイル
| ファイル名 | 主な用途 |
|---|---|
./member/snap/db |
bboltのb+treeです。適用済みのすべてのデータ、メンバーシップの認可情報、メタデータを保存します。最後に適用したWALログのインデックス("consistent_index")を把握しています。 |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap |
定期的に作成する旧v2ストアのスナップショットで、次を含みます。
etcd v3以降、その内容は/snap/dbファイルの内容と重複しています。 |
/member/snap/000000000007a178.snap.db |
レプリカが大きく遅れた場合に、etcdリーダーからダウンロードする完全なbboltスナップショットです。 内容の種類は、 このファイルは、次の2つの場合に使用します。
このファイルは、リカバリーが完了しても削除されません(全内容が./member/snap/dbファイルに反映されます)。定期的(30s)にファイルを削除します。
ここでも、直近の |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal |
Raftの先行書き込みログで、Raftが受け付けた最近のトランザクション、定期的なスナップショット、CRCレコードを含みます。 直近の スナップショットの作成頻度が低すぎると、 |
./member/wal/0.tmp (or .../1.tmp) |
次の先行書き込みログファイルのために事前に割り当てる領域です。 WALログの容量不足により、アラームを発報することもできずにRaftが停止するのを防ぎます。 |
一時ファイル
etcdの内部処理中には、短時間だけ存在する次のようなファイルが見られることがあります。
| ファイル | 主な用途 |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken |
スナップショットファイルを読み込めない場合、ファイル名を‘broken’に変更します。
最新のファイルの読み込みは、etcdの起動時に試みます。 または、etcdctlのbackup/migrateコマンド実行時にも行います。 |
./member/snap/tmp071677638 (random suffix) |
リーダーのmsgSnapリクエスト、つまり指定したスナップショットからストレージをリカバリーする要求に応じて、レプリカ上に作成する一時的なbboltファイルです。
内容の取得が正常に完了すると、ファイルをリネームし、 etcd/issues/12837を参照してください。etcd 3.5で修正されています。 |
/member/snap/db.tmp.071677638 (random suffix) |
デフラグメンテーション処理中に、バックエンドの内容(/member/snap/db)のコピーを保持する一時ファイルです。処理が正常に完了すると、/member/snap/dbにリネームし、元のバックエンドを置き換えます。 etcdサーバーの起動時に、これらのファイルを削除します。 |
bbolt b+tree: member/snap/db
このファイルは、Raftログの特定の時点まで適用された、etcdの主要な内容を保持します(consistent_index を参照)。
物理的な構成
bboltストレージは、物理的にはb+tree
として構成されます。b-treeの物理ページをその場で変更することはありません1。代わりに、空きページ一覧から回収した新しいページへ内容をコピーし、古いページにアクセスする可能性のある未終了のトランザクションがなくなった時点で、そのページを空きページ一覧に追加します。この処理により、未終了のROトランザクションは、一貫した過去のストレージ状態を参照できます。RWトランザクションは排他的であり、他のすべてのRWトランザクションをブロックします。
大きな値は、複数の連続したページに保存します。ページの回収処理と、異なる大きさの連続したページ領域を割り当てる必要性が組み合わさり、bboltストレージの断片化が進むことがあります。
bboltファイルが自動で縮小することはありません。デフラグメンテーション時にだけ、末尾に一定の空きページ領域を確保した、サイズを切り詰めた新しいファイルに書き換えられます。
論理的な構成
bboltストレージはバケットに分かれています。各バケットには、キー(byte[]->value byte[]のペア)を辞書順に保存します。以下は、etcd(バージョン3.5時点)で使用するバケットとキーの一覧です。
| バケット | キー | 値の例 | 説明 |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT}
|
nil |
いずれかのメンバーで問題が検出されたことを示します。 |
| auth | "authRevision" | ""(空)またはBigEndian.PutUint64 |
RolesまたはUsersを変更すると、トランザクションのコミット時にこのフィールドが増加します。 この値は、認可処理中の楽観的ロックにだけ使用します。 |
| authRoles | 文字列の[roleName] | authpb.Roleをマーシャリングした値 |
|
| authUsers | 文字列の[userName] | authpb.Userをマーシャリングした値 |
|
| cluster | "clusterVersion" | "3.5.0"(文字列) |
コンセンサスで合意した共通ストレージバージョンのマイナーバージョンです。 |
| "downgrade" | JSON: {
"target-version": "3.4.0"
"enabled": true/false
}
|
直近の v3.5以降 |
|
| key |
[revisionId]をbytesToRev{main,sub}でエンコードしたものです。 キー・バリューの削除は、末尾に't'を付けてマーシャリングします(「トゥームストーン」として)。 |
mvccpb.KeyValueをマーシャリングしたproto(key, create_rev, mod_rev, version, value, lease id) |
|
| lease | leasepb.Leaseをマーシャリングしたproto(ID, TTL, RemainingTTL) |
注意:LeaseCheckpointが延長するのはRemainingTTLだけです。TTLは元のGrantの値です。 注意2:TTLは、未定義の「現在」からの秒数として永続化します。クラッシュを繰り返すサーバーは、リースを解放しません!!! |
|
| members | [memberId]を16進数の文字列にしたもの:"8e9e05c52164694d" |
JSON文字列にシリアライズしたMember構造体:
{
  "id":10276657743932975437,
  "peerURLs":[
  "http://localhost:2380"],
  "name":"default",
  "clientURLs": ["http://localhost:2379"]
}
|
合意済みのクラスターのメンバーシップ情報です。 |
| members_removed | [memberId]を16進数の文字列にしたもの:"8e9e05c52164694d" |
[]byte("removed") |
削除されたすべてのメンバーのIDです。削除済みのメンバーが、同じIDで再び追加されないことを確認するために使います。 このフィールドは現在(3.4)、V2ストアから読み取り、V3からは読み取りません。https://github.com/etcd-io/etcd/pull/12820を参照してください。 |
| meta | "consistent_index" | uint64のバイト列(BigEndian) | bolt DBストレージに最後に適用したWALエントリーのオフセットを表します。 |
| "scheduledCompactRev" | bytesToRev{main,sub}でエンコードした値(16バイト) | コンパクションリクエストの後にクラッシュした場合に、コンパクションを再初期化するために使います。 | |
| "finishedCompactRev" | bytesToRev{main,sub}でエンコードした値(16バイト) | ストアで直近にコンパクションが正常に完了したリビジョン(https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | etcd 3.5以降 | ||
| "term" | etcd 3.5以降 | ||
| "storage-version" |
ツール
bbolt
bboltには、ファイルの内容を調べるためのコマンドラインツールがあります。
使用例:
指定したbboltファイルのすべてのバケットを列挙する
特定のキー・バリューペアを読み取る
etcd-dump-db
etcd-dump-dbは、etcd v3のバックエンド(bbolt)の内容を列挙するために使用できます。
その他の例は、https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db を参照してください。
WAL:先行書き込みログ
先行書き込みログは、提案を保存するためのRaftの永続ストレージです。リーダーはまず自分のログに提案を保存し、その後、Raftプロトコルでフォロワーに並行して複製します。各フォロワーは、リーダーに複製の完了を応答する前に、自身のWALに提案を永続化します。
etcdで使用するWALログは、標準的なRaftモデルと次の2点で異なります。
- インデックス付きのエントリーだけでなく、Raftの軽量なスナップショットとhard-stateも永続化します。そのため、WALログだけで、そのメンバーのRaft状態全体をリカバリーできます。
- 追記専用です。エントリーをその場で上書きせず、ファイルに後から追記した同じインデックスのエントリーが、以前のエントリーを置き換えます。
ファイル名
WALログファイルは、次のパターンで命名します。
例:./member/wal/0000000000000010-00000000000bf1e6.wal
つまり、ファイル名には次の情報が16進数で含まれます。
- WALログファイルの連番
- ファイル内の最初のエントリーまたはスナップショットのインデックス 特に、最初のファイル“0000000000000000-0000000000000000.wal”には、index=0の初期スナップショットレコードが含まれます。
物理的な内容
WALログファイルは、一連の「フレーム 」を含みます。各フレームには、次のものが含まれます。
- マーシャリングしたwalpb.Record (3)の長さを格納する、LittleEndian 2でエンコードしたuint64。
- パディング:フレーム全体のサイズを整列(mod 8)させるための、必要な数の0バイト。
- マーシャリングしたwalpb.Record
のデータ:
- type - 下記のdataフィールドの解釈を決める、intでエンコードされた列挙値。
- data - typeによって異なり、通常はマーシャリングしたproto。
- crc - WALログの作成以降、このレプリカ上のすべてのログレコードの“data”フィールドを連結したもの(typeは含まない)のCRC-32チェックサム。CRCは、Raftでコミットされなかったものも含め、すべてのレコードを対象とすることに注意してください。
現在のファイルが64*10^6バイトを超えると、ファイルを「分割」し、新しいファイルを開始します。
論理的な内容
先行書き込みログファイルは、論理的には次を含みます。
Raftpb.Entry:Raftリーダーが複製した最近の提案です。一部は「コミット済み」と見なされ、残りは論理的に上書きされる可能性があります。Raftpb.HardState(term,commit,vote):「コミット済み」、つまり過半数のサーバーに複製されたログエントリーのインデックスに関する、定期的で非常に頻繁な情報です。このエントリーは、変更・上書きされないことが保証され、バックエンド(v2、v3)に適用できます。また、選挙に関する変更があったかを示す“term”と、現在の任期でこのレプリカが投票したメンバーを表すvoteも含みます。walpb.Snapshot(term, index):Raft状態の定期的なスナップショットです。DBの内容は含まず、スナップショットのログインデックスとRaftの任期だけを保持します。- V2ストアの内容は、別の*.storeファイルに保存します。
- V3ストアの内容はbboltファイルに保持し、エントリーが適用されると、その内容が暗黙のスナップショットになります。
- crc32チェックサムレコード(各ファイルの先頭)。ファイルの残りの部分のCRC検査を再開するために使用します。
etcdserverpb.Metadata(node_id, cluster_id)- ログが表すクラスターとレプリカを識別します。
各WALログファイルは、次の順序で構成されます。
-
CRC-32フレーム。それ以前のすべてのファイルからの累積crcで、最初のファイルでは0です。
-
Metadataフレーム(クラスターとレプリカのID)
-
最初のWALファイルの場合だけ:
- 空のSnapshotフレーム(Index:0, Term: 0)。 すべてのエントリーに「先行する」スナップショットがある、という不変条件を維持するためのフレームです。
最初以外のWALファイル(2番目以降)の場合:
- HardStateフレーム。
-
entry、hard-state、snapshotレコードの混在
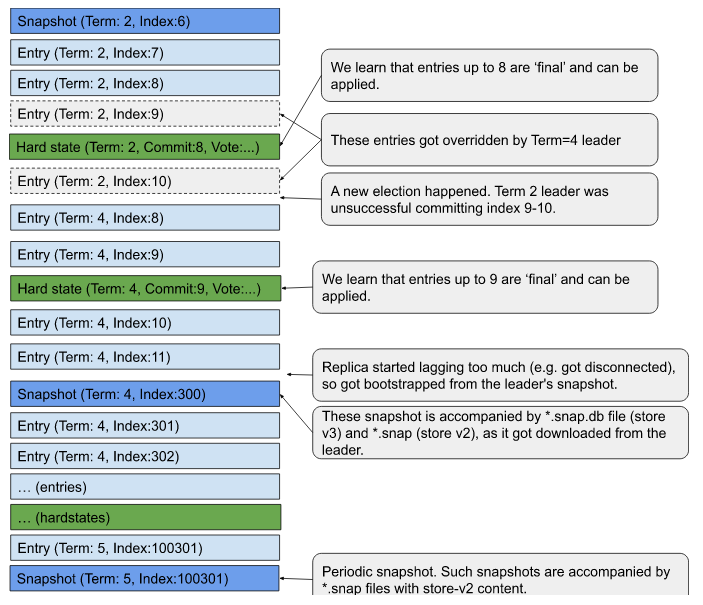
WALログは、同じインデックスのエントリーを複数含むことがあります。これは、Raftの論文 の図7で説明される状況で発生します。etcdのWALログは追記専用なので、同じインデックスの新しいエントリーを追記することで、以前のエントリーを上書きします。
特に、WALの読み取り時には、古いエントリーを新しいエントリーで上書きする処理 が行われます。そのため、entry.index <= HardState.commitを満たすエントリーの最後のバージョンだけが確定済みと見なせます。index > HardState.commitのエントリーは変更される可能性があります。
WALログの“term”は、単調であることが想定されています。
WALログのインデックスには、次の性質が想定されています。
- いずれかのスナップショットから始まる。
- 同じ‘term’に属する間は、そのスナップショット以降、順に増加する。
- 任期が変わるとインデックスが減少することもあるが、新しい値は、最新のHardState.commitより大きい。
- index >= HardState.commitを満たす任意のインデックスで新しいスナップショットが作られることがあり、そこからインデックスの新しい列が始まる。
ツール
etcd-dump-logs
etcdのWALログは、etcd-dump-logs ツールで読み取れます。
次の点に注意してください。
- このツールが表示するのはEntriesだけです。WALログファイル内のすべてのレコード(Snapshots、HardStates)を表示するわけではありません。
- エントリーの「上書き」は自動的に適用されます。同じインデックスの新しいエントリーで上書きされた場合、このツールは最後の値だけを表示します。
- このツールは、ログ末尾の未コミットのエントリーも表示します。HardState.commitIndexの情報は表示しないため、エントリーが確定済みかどうかは分かりません。
ストアV2のスナップショット:member/snap/{term}-{index}.snap
ファイル名
member/snap/{term}-{index}.snap
ファイル名はここ
で、("%016x-%016x.snap") の形式で生成されます。16進数でエンコードした次の2つの要素を使います。
- term -> スナップショット出力時のRaftの任期(選挙間の期間)
- index -> スナップショット出力時に最後に適用した提案のインデックス
作成
*.snapファイルは、Snapshotter.SaveSnap メソッドによって作成されます。
このファイルの作成には、次の2つの契機があります。
- およそ–snapshot-count=(v3.7.0のデフォルトは10,000)件の提案を適用するたびに、新しいファイルを作成します。提案をバッチで受け取り、バッチの最後でのみスナップショットの作成を検討し、最終的な作成処理も非同期でスケジュールするため、件数は概数です。 –snapshot-countというフラグ名は、かなり誤解を招きやすいものです。制御するのは、最後のスナップショットのインデックスと、最後に適用した提案のインデックスとの差 だからです。
- Raftがレプリカに、スナップショットからのリストアを要求した場合です。レプリカはネットワークでスナップショット(msgSnapメッセージ)を受信すると、WALログにも軽量なチェックポイントとして記録します。これにより、WALログの末尾には、常に有効なスナップショットがあり、その後にエントリーが続くことが保証されます。これによって、WALログに連続性の欠落が生じるのを防ぎます。
現在、このファイルはWALログのSnapshotエントリーと、おおむね31-1で対応しています。v2ストアの廃止に伴い、ファイルの書き込みは完全に停止される見込みです(3.5.xでは任意、3.6.xでは必須)。
内容
ファイルは、マーシャリングしたsnapdb.snapshot proto
(uint32 crc, bytes data)を含みます。
その’data’フィールドには、Raftpb.Snapshot が格納されます。
(bytes data, SnapshotMetadata{index, term, conf } metadata),
最後に、入れ子になったdataには、JSONにシリアライズしたv2ストアの内容 が格納されます。
具体的には、次の内容を含みます。
- Term
- Index
- メンバーシップのデータ:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- ストレージのバージョン:/0/version-> 3.5.0
ツール
protoc
etcdのルートディレクトリで次のコマンドを実行すると、ファイルの内容を確認できます。
同様に、‘data’フィールドを取り出し、Raftpb.Snapshot としてデコードできます。
etcd 3.4の*.snapファイルにある、JSONにシリアライズしたv2ストアの内容の例
変更
このセクションは、etcdのバージョン間で導入されたファイル形式の変更を記載するために設けています。
7 - etcd APIの保証
etcdは、一貫性と耐久性を備えたキー・バリューストアです。 キー・バリューストアはgRPCサービス を通じて公開されます。 etcdは、分散システムで最も強い一貫性と耐久性の保証を提供します。 この仕様では、etcd APIが提供する保証を列挙します。
対象のAPI
KV APIは、キー・バリューストアの直接の読み取りと操作を提供します。 Watch APIは、キー・バリューストアの変更の購読を提供します。 Lease APIは、キーへの生存時間の割り当てを提供します。
KV APIとWatch APIのどちらでも、キーの最新バージョンだけでなく、 コンパクション操作によって制限される連続した履歴の範囲内で、 過去のバージョンにもアクセスできます。
KV APIの呼び出しは直ちに反映されますが、Watch APIの応答には上限のない遅延が生じます。 正常に動作するetcdクラスターでは、イベント発生から10ms程度の遅延で監視イベントが届くことを期待できます。 ただし、遅延に上限はなく、健全でないクラスターではイベントが届かないこともあります。
KV API
etcdは、すべてのKV API呼び出しに対し、耐久性と厳密な直列化可能性を保証します。 これは、分散トランザクションデータベースシステムにおける最も強い分離保証です。
耐久性
完了した操作にはすべて耐久性があります。アクセス可能なデータも、すべて永続化済みのデータです。 読み取りが、まだ永続化されていないデータを返すことはありません。
厳密な直列化可能性
KVサービスの操作はアトミックであり、操作の実時間の順序と整合する全順序で実行されます。 この全順序はリビジョン によって表されます。 詳細は厳密な直列化可能性 を参照してください。
入れ子のTXNを含まないトランザクションでは、操作の実行順序は 操作リストの順序と一致することが保証されるため、トランザクション内の GETレスポンスは安定しています。 入れ子のTXNを含むトランザクションでは、実行順序は規定されていません。
厳密な直列化可能性は、より理解しやすい、次の弱い保証も満たします。
原子性
すべてのAPIリクエストはアトミックです。操作は全体が完了するか、まったく実行されないかのいずれかです。 監視リクエストでは、1つの操作が生成するすべてのイベントが1つの監視レスポンスに含まれます。 監視が、単一の操作のイベントの一部だけを観測することはありません。
線形化可能性
クライアントの観点では、線形化可能性は動作を考えやすくする有用な性質を提供します。
元の論文
から、明快な説明を引用します。
線形化可能性は、並行するプロセスが適用する各操作が、 その呼び出しから応答までの間のある時点で、 瞬時に有効になるかのように見せます。
たとえば、クライアントが時点1(t1)で書き込みを完了したとします。 t2(t2 > t1)で読み取りを発行したクライアントは、少なくとも t1で完了した書き込みと同じか、それより新しい値を受け取るはずです。ただし、 読み取りが実際に完了するのはt3になる場合があります。線形化可能性は、 読み取りの開始時点t2から完了時点t3までの間のある時点で最新だった値を 返すことを保証します。読み取りの開始前に完了した書き込みはすべて反映されます。 t2とt3の間に発生した並行する書き込みは、反映される場合も、されない場合もあります。 返却値が、読み取りの完了時点で最新の値である必要はありません。
etcdは、その他のすべての操作について、デフォルトで線形化可能性を保証します。
ただし、線形化されたリクエストはRaftコンセンサス処理を経由する必要があるため、
線形化可能性にはコストが伴います。読み取りリクエストのレイテンシーを下げ、
スループットを高めるために、クライアントはリクエストの一貫性モードを
serializableに設定できます。このモードでは、クォーラムに対して古いデータに
アクセスする可能性がありますが、線形化されたアクセスがその都度のコンセンサスに
依存することによる性能上の負担をなくせます。
Watch API
監視は、イベントについて次のことを保証します。
- 順序性:イベントはリビジョン順に並びます。 すでに送信されたイベントより時間的に前のイベントが、後から監視に現れることはありません。 入れ子のTXNを含まないトランザクションでは、生成されるイベントの順序は 操作リストの順序と一致することが保証されます。 入れ子のTXNを含むトランザクションでは、生成されるイベントの順序は 規定されていません。
- 一意性:同じイベントが監視に2回現れることはありません。
- 信頼性:利用可能な履歴の範囲内で、イベント列の一部が欠落することはありません。 イベントが時間順にa < b < cと並んでいる場合、 監視がイベントaとcを受信したなら、bが利用可能な履歴の範囲内にある限り、 bも受信することが保証されます。
- 原子性:イベントのリストは、完全なリビジョンを含むことが保証されます。 同じリビジョンで行われた複数のキーの更新が、複数のイベントリストに 分割されることはありません。
- 再開可能性:切断前に監視イベントで最後に受信したリビジョンが履歴の範囲内にある限り、 そのリビジョンの次から新しい監視を開始することで、 切断された監視を再開できます。
- ブックマーク可能性:進捗通知イベントは、あるリビジョンまでのすべてのイベントが すでに配信済みであることを保証します。
etcdは、監視操作の線形化可能性を保証しません。他の操作との正しい順序を確保するため、 ユーザーは監視イベントのリビジョンを確認する必要があります。
Lease API
etcdはリースの仕組み を提供します。リースの主な用途は、 分散ロックなどの分散協調の仕組みを実装することです。 リース自体の仕組みは単純です。grant APIで作成し、put APIでキーに関連付け、 revoke APIで取り消すことができ、実時間の生存時間(TTL)が過ぎると期限切れになります。 ただし、正しい分散協調の仕組みを実装するには、 APIとその使用上の重要な性質 を理解しておく必要があります。
etcd固有の定義
操作の完了
etcdの操作は、コンセンサスを通じてコミットされ、etcdのストレージエンジンによって
「実行」、つまり永続的に保存された時点で完了と見なされます。
クライアントはetcdサーバーからレスポンスを受信することで、操作の完了を認識します。
タイムアウトした場合や、クライアントとetcdメンバーの間でネットワークが途絶した場合、
クライアントには操作の状態を判断できないことがあります。また、etcdはリーダー選挙が
発生すると操作を中止する場合があります。このとき、クライアントの未完了のリクエストに対して、
etcdはabortレスポンスを送信しません。
リビジョン
キー・バリューストアを変更するetcdの操作には、増加するリビジョンが1つ割り当てられます。 トランザクション操作はキー・バリューストアを複数回変更することがありますが、 割り当てられるリビジョンは1つだけです。操作によって変更されたキー・バリューペアの リビジョン属性は、その操作のリビジョンと同じ値を持ちます。 リビジョンは、キー・バリューストアの論理時計として使用できます。 リビジョンが大きいキー・バリューペアは、リビジョンが小さいキー・バリューペアより後に 変更されています。同じリビジョンを持つ2つのキー・バリューペアは、 1つの操作によって「同時に」変更されています。
8 - etcdと他のキー・バリューストアの比較
「etcd」という名前は、Unixの「/etc」フォルダーと、distributed systems(分散システム)の頭文字「d」に由来します。「/etc」フォルダーは単一システムの構成データを保存する場所ですが、etcdは大規模な分散システムの構成情報を保存します。つまり、分散した(distributed)「/etc」が「etcd」です。
etcdは、大規模な分散システムの汎用的な基盤として設計されています。対象となるのは、スプリットブレインでの動作を決して許容せず、そのためには可用性を犠牲にすることもいとわないシステムです。etcdは、一貫性と耐障害性を保ってメタデータを保存します。etcdクラスターは、最高水準の安定性、信頼性、拡張性、性能を備えたキー・バリューストレージの提供を目指しています。
分散システムは、構成管理、サービス検出、分散処理の調整のために、一貫性のあるキー・バリューストアとしてetcdを使用します。多くの組織 が、コンテナースケジューラー、サービス検出サービス、分散データストレージなどの本番システムをetcdで実装しています。etcdを使う代表的な分散処理のパターンには、リーダー選出 、分散ロック 、マシンの生存監視があります。
ユースケース
- Container Linux by CoreOS:Container Linux 上のアプリケーションでは、Linuxカーネルが無停止で自動更新されます。Container Linuxは、更新の調整にlocksmith を使用します。Locksmithはetcd上に分散セマフォを実装し、どの時点でも再起動するのがクラスターの一部だけになるようにします。
- Kubernetes は、サービス検出とクラスター管理のために構成データをetcdに保存します。etcdの一貫性は、サービスを正しくスケジュールし、動作させるために不可欠です。Kubernetes APIサーバーは、クラスターの状態をetcdに永続化します。また、etcdのwatch APIでクラスターを監視し、重要な構成変更を展開します。
比較表
etcdが適しているように見えても、他の技術的な判断と同じく、慎重に検討してください。このドキュメントはetcdチームが執筆しています。技術と機能を公平に比較することが理想ですが、著者の専門知識や考え方は当然etcd寄りです。その点を踏まえて利用してください。
以下の表は、etcdと主な代替製品の違いを一目で確認するための早見表です。各列の補足や詳細は、表の後のセクションで説明します。
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| 並行処理のプリミティブ | GoのLock RPC 、Election RPC 、コマンドラインのロック 、コマンドラインの選挙 、レシピ | Javaの外部ライブラリーcuratorのレシピ | 組み込みのロックAPI | 存在してもまれ |
| 線形化可能読み取り | 対応 | 非対応 | 対応 | 製品による |
| 多版型同時実行制御 | 対応 | 非対応 | 非対応 | 製品による |
| トランザクション | フィールド比較、読み取り、書き込み | バージョン検査、書き込み | フィールド比較、ロック、読み取り、書き込み | SQL形式 |
| 変更通知 | 過去と現在のキー区間 | 現在のキーとディレクトリ | 現在のキーと接頭辞 | トリガー(一部) |
| ユーザー権限 | ロールベース | ACL | ACL | 製品による(テーブル単位のGRANT 、データベース単位のロール ) |
| HTTP/JSON API | 対応 | 非対応 | 対応 | まれ |
| メンバーシップの再構成 | 対応 | >3.5.0 | 対応 | 対応 |
| 信頼性を保てるデータベースの最大サイズ | 数GB | 数百MB(場合によっては数GB) | 数百MB | TB以上 |
| 読み取りを線形化する最小レイテンシー | ネットワークRTT | 読み取りの線形化なし | RTT + fsync | クロックバリア(原子時計、NTP) |
ZooKeeper
ZooKeeperは、分散システムの調整とメタデータの保存という、etcdと同じ問題を解決します。ただし、etcdはZooKeeperの設計と実装に関する開発・運用経験を、後発として生かせます。ZooKeeperから得られた教訓はetcdの設計に確実に反映され、Kubernetesのような大規模システムのサポートに役立っています。etcdがZooKeeperに対して改善した点には、次のものがあります。
- クラスターのメンバーシップの動的な再構成
- 高負荷下での安定した読み書き
- 多版型同時実行制御のデータモデル
- 通知せずにイベントを取りこぼすことのない、信頼できるキーの監視
- 接続とセッションを切り離すリースのプリミティブ
- 安全な分散共有ロックのAPI
さらに、etcdは多くの言語とフレームワークを標準でサポートしています。ZooKeeperは独自のJute RPCプロトコルを使用し、サポートする言語バインディング
が制限されます。一方、etcdのクライアントプロトコルは、Go、C++、Javaなどの言語バインディングを持つ、広く使われているRPCフレームワークgRPC
に基づいています。また、gRPCはHTTP上のJSONにシリアライズできるため、curlのような汎用コマンドラインツールでも通信できます。多様な選択肢から選べるため、単一の固定された技術群でetcdの周辺を固めるのではなく、それぞれの環境に合ったツールを使ってetcd上にシステムを構築できます。
機能、サポート、安定性を考えると、一貫性のあるキー・バリューストアとしてZooKeeperを採用する予定の新しいアプリケーションは、代わりにetcdを選ぶのがよいでしょう。
Consul
Consulは、サービス検出を一通り提供するフレームワークです。ヘルスチェック、障害検出、DNSサービスを内蔵しています。また、RESTfulなHTTP APIを持つキー・バリューストアも公開しています。Consul 1.0の時点では 、キー・バリュー操作におけるストレージシステムの拡張性は、etcdやZooKeeperなどに及びません。数百万のキーを必要とするシステムでは、大きなレイテンシーやメモリーへの負荷に悩まされます。キー・バリューAPIには、特に、複数バージョンのキー、条件付きトランザクション、信頼できるストリーミング監視が欠けています。
etcdとConsulは、異なる問題を解決します。分散した一貫性のあるキー・バリューストアが必要なら、Consulよりetcdが適しています。クラスターのサービス検出を一通り揃えたい場合、etcdの機能だけでは足りません。Kubernetes、Consul、SmartStackを選んでください。
NewSQL (Cloud Spanner, CockroachDB, TiDB)
etcdとNewSQLデータベース(Cockroach 、TiDB 、Google Spanner など)は、いずれも高可用性と強いデータ一貫性の保証を提供します。ただし、システム設計の前提が大きく異なるため、クライアントAPIと性能の特性も大きく異なります。
NewSQLデータベースは、データセンターをまたいで水平に拡張することを目的としています。通常、データを、離れた場所にあることもある複数の一貫性を持つ複製グループ(シャード)に分割し、TB以上の規模のデータセットを保存します。このような拡張方式は、クロックを待つことによる長いレイテンシーがあり、更新の依存関係グラフがおおむね局所的であることを想定するため、分散協調にはあまり適しません。データはテーブルに整理され、etcdより豊かな意味論を持つSQL形式のクエリー機能を備えますが、その分、クエリーの処理、計画、最適化は複雑になります。
メタデータの保存や分散アプリケーションの調整には、etcdを選んでください。数GBを超えるデータを保存する場合や、完全なSQLクエリーが必要な場合は、NewSQLデータベースを選んでください。
メタデータにetcdを使う
etcdは、単一の一貫性を持つ複製グループ内ですべてのデータを複製します。一貫した順序を保ちながら数GBまでのデータを保存するには、これが最も効率的な方式です。クラスターの状態の各変更には、単調増加するカウンターから、etcdでリビジョンと呼ぶ、グローバルに一意のIDが割り当てられます。これによって変更の順序を判断できます。1つの変更が複数のキーを変えることもあります。複製グループが1つだけなので、変更リクエストはコミットのためにRaftプロトコルを経由するだけで済みます。コンセンサスの対象を1つの複製グループに限定することで、etcdは単純なプロトコルで分散した一貫性を実現しながら、低レイテンシーと高スループットを達成します。
etcdの複製方式は、データのシャーディングがないため、水平には拡張できません。対して、NewSQLデータベースは通常、複数の一貫性を持つ複製グループにデータを分割し、TB以上の規模のデータセットを保存します。ただし、各変更にグローバルに一意で増加するIDを割り当てるには、各リクエストが複製グループ間の追加の調整プロトコルを経由する必要があります。この追加の調整段階では、グローバルIDで競合が起こり、順序を付けるリクエストが再試行を迫られる可能性があります。その結果、方式は複雑になり、厳密な順序付けでは、通常etcdより性能が低下します。
プロセスの調整など、主にメタデータやその順序を扱うアプリケーションにはetcdを選んでください。複数のデータセンターにまたがる大きなデータストアが必要で、強いグローバルな順序の性質にあまり依存しない場合は、NewSQLデータベースを選んでください。
分散協調にetcdを使う
etcdは、イベントの監視、リース、選挙、分散共有ロックなどの分散協調のプリミティブを標準で提供します。ただし、分散共有ロックには分かりにくい性質があるため、使用時には注意が必要です。詳細は後述します。これらのプリミティブは、etcd開発者が保守し、サポートしています。このようなプリミティブを外部ライブラリーに任せるのは、分散ソフトウェアの基盤を開発する責任を放棄し、実質的にシステムを未完成のままにすることです。NewSQLデータベースは通常、こうした分散協調のプリミティブを第三者が作成することを想定しています。同様に、ZooKeeperにも、協調処理のレシピを集めた独立した別のライブラリー があることはよく知られています。組み込みのロックAPIを提供するConsulでさえ、「確実な方法ではない 」と断っています。
理論上は、強い一貫性を持つ任意のストレージシステムの上に、これらのプリミティブを構築できます。しかし、アルゴリズムには微妙な点が多く、一見動いているロックアルゴリズムが、要求の一斉集中やタイミングのずれによって突然破綻することも珍しくありません。さらに、トランザクショナルメモリーなど、etcdがサポートする他のプリミティブは、etcdのMVCCデータモデルに依存しています。単に強い一貫性があるだけでは不十分です。
分散協調にetcdを選ぶことは、運用上の悩みを防ぎ、開発の労力を減らすことにつながります。
ロックとリースの使用上の注意
etcdは、リースの仕組み とそのetcdでの実装 に基づくロックAPI を提供します。リースの基本的な考え方は、サーバーが要求元のクライアントに、リースと呼ぶトークンを付与するというものです。サーバーは付与時にTTLをリースに関連付けます。TTLを超える時間の経過を検出すると、サーバーはリースを取り消します。クライアントは、取り消されていないリースを保持している間、そのリースに関連付けられたリソースへのアクセス権を所有していると主張できます。etcdの場合、そのリソースはetcdのキー空間内のキーです。etcdは、この方式でロックAPIを提供します。ただし、ロックAPIだけを相互排他の仕組みとして使うことはできません。ロックという名前は、歴史的な理由 によるものです。一方、以下で説明するように、ロックAPIは相互排他を最適化する仕組みとして使用できます。
リースの仕組みで最も重要なのは、TTLが物理的な時間間隔として定義されることです。サーバーもクライアントも、自身の時計で時間の経過を測ります。そのため、サーバーはリースを取り消しているのに、クライアントはまだ所有していると主張する状況が起こり得ます。
では、リースの仕組みは、ロックの相互排他をどのように保証するのでしょうか。実際には、リース自体は相互排他を保証しません。リースを所有していても、その所有者がリソースのロックを保持しているとは保証できません。
etcd自身のキーへの相互アクセスをetcdのロックで制御する場合、相互排他はバージョン番号の検証によって実装されます。これは、Consulなどの他のシステムでcompare and swapと呼ばれることもあります。PutやTxnなどのetcdのRPCでは、操作に必要なリビジョン番号やリースIDの条件を指定できます。条件が満たされなければ、操作は失敗することがあります。この仕組みによって、etcdはクライアントに分散ロックを提供します。つまり、クライアントは自身のリクエストがetcdクラスターで正常に完了したとき、キーのロックを取得していることを認識します。
分散ロックに関する文献にも、同様の設計が記載されています。
- Chubbyの論文 では、sequencerという概念が導入されています。ここでは、sequencerはetcdのリビジョン番号とリースIDの組み合わせにほぼ相当すると解釈しています。
- 分散ロックの実装方法 では、Martin Kleppmannがfencing tokenという考え方を紹介しています。著者らは、etcdではリビジョン番号がfencing tokenに相当すると解釈しています。
- 分散システムにおける同期時計の実用的な使用法 には、Thorがバージョン番号の検証とリースに基づく分散ロック機構を実装しているという説明があります。
etcdや他のシステムは、バージョン番号の検証で相互排他を実現するのに、なぜリースを提供するのでしょうか。リースは、中止されるリクエストの数を減らすための最適化機構を提供するからです。
etcdのキーは、リースとバージョン番号の検証によって効率的にロックできます。ただし、etcdと関係のないリソースを保護するには、そのリソース側にも、etcdのキーのようなバージョン番号の検証と、レプリカ間の一貫性の仕組みが必要です。etcdのロック機能だけでは、外部リソースを保護できません。
9 - 用語集
このドキュメントでは、etcdのドキュメント、コマンドライン、ソースコードで使う各種用語を定義します。
アラーム
クラスターの信頼性を維持するために運用担当者の介入が必要になると、etcdサーバーはアラームを発報します。
認証
認証は、etcdリソースに対するユーザーのアクセス権限を管理します。
クライアント
クライアントはetcdクラスターに接続し、キー・バリューペアの取得、データの書き込み、更新の監視などのサービスリクエストを発行します。
クラスター
クラスターは複数のメンバーで構成されます。
各メンバーのノードは、Raftコンセンサスプロトコルに従ってログを複製します。クラスターはメンバーから提案を受け取り、コミットしてローカルストアに適用します。
コンパクション
コンパクションは、指定したリビジョンより前のetcdのイベント履歴と、更新によって古くなったキーをすべて破棄します。etcdのバックエンドデータベースのストレージ領域を回収するために使用します。
選挙
etcdクラスターは、Raftコンセンサスプロトコルの一環として、メンバー間でリーダーを選出する選挙を行います。
エンドポイント
etcdのサービスまたはリソースを指すURLです。
キー
ユーザーが定義した値をetcdに保存し、取得するための、ユーザー定義の識別子です。
キー範囲
単一のキー、a <= x < bを満たすすべてのxからなる辞書順の区間、または指定したキーより大きいすべてのキーを含む集合です。
キー空間
etcdクラスター内のすべてのキーの集合です。
リース
更新可能な短期の契約です。有効期限が切れると、関連付けられたキーが削除されます。
メンバー
etcdクラスターのサービス提供に参加する論理的なetcdサーバーです。
変更リビジョン
指定したキーに対する最後の書き込みを含む最初のリビジョンです。
ピア
ピアは、同じクラスターに属する別のメンバーです。
提案
提案は、Raftプロトコルを経由する必要があるリクエスト(書き込みリクエストや構成変更リクエストなど)です。
クォーラム
クラスターの状態を変更するためのコンセンサスに必要な、稼働中のメンバー数です。etcdでは、クォーラムに達するためにメンバーの過半数が必要です。
リビジョン
1から始まり、キー空間が変更されるたびに増加する、クラスター全体の64ビットカウンターです。
ロール
キー範囲の集合に対する権限の単位です。アクセス制御のために、ユーザーの集合に付与できます。
スナップショット
ある時点のetcdクラスターの状態を保存したバックアップです。
ストア
クラスターのキー空間を支える物理ストレージです。
任期
任期は、Raftアルゴリズムの各リーダー選挙に関連付けられた、単調増加する整数です。 1つの任期で選出されるリーダーは1つだけで、リーダーが変わると任期が増加します。
トランザクション
アトミックに実行される操作の集合です。トランザクション内で変更されたすべてのキーは、同じ変更リビジョンを持ちます。
キーのバージョン
キーの作成以降に行われた書き込みの回数で、1から始まります。存在しないキーや削除されたキーのバージョンは0です。
ウォッチャー
クライアントはウォッチャーを開き、指定したキー範囲の更新を監視します。