Это многостраничная версия текущего раздела для печати. .
Внутреннее устройство
1 - Протокол службы обнаружения
Протокол службы обнаружения помогает новому участнику etcd найти остальных участников на этапе начальной инициализации кластера с помощью общего токена обнаружения и списка конечных точек.
Протокол используется только во время начальной инициализации и не может использоваться для реконфигурации во время выполнения или мониторинга кластера.
Один новый токен обнаружения предназначен для инициализации одного уникального кластера etcd. Один токен может представлять только один кластер. После запуска протокола для токена его нельзя использовать для инициализации другого кластера etcd, даже если первый процесс завершился с ошибкой на полпути.
Далее процесс обнаружения рассматривается на примере самостоятельно размещённого кластера обнаружения.
Этот документ относится только к обнаружению v3. Обнаружение v2 подробнее описано в предыдущем документе .
Рабочий процесс протокола
Протокол использует внутренний кластер etcd для координации начальной инициализации нового кластера. Сначала все новые участники взаимодействуют со службой обнаружения и совместно формируют ожидаемый список участников. Затем каждый участник запускает свой сервер с этим списком, что выполняет ту же функцию, что и флаг -initial-cluster.
В примере ниже каждый шаг для наглядности показан с помощью команды etcdctl. Предполагается, что на http://example.com:2379 работает кластер etcd, обслуживающий службу обнаружения.
По соглашению протокол обнаружения etcd использует префикс ключей /_etcd/registry.
Создание нового токена обнаружения
Создайте уникальный токен, идентифицирующий новый кластер. На следующих шагах он будет уникальным префиксом в пространстве ключей обнаружения. Простой способ создать токен — использовать uuidgen:
Указание ожидаемого размера кластера
Для токена обнаружения необходимо указать размер кластера. Служба использует его, чтобы определить, когда найдены все участники, изначально формирующие кластер.
Обычно размер кластера равен 3, 5 или 7. Подробнее см. в разделе оптимального размера кластера .
Запуск процессов etcd
Передайте токен обнаружения ${UUID} флагу --discovery-token, а конечные точки кластера etcd, обслуживающего службу обнаружения, — флагу --discovery-endpoints. Это включает обнаружение v3 для начальной инициализации кластера etcd.
Если заданы флаги --discovery-token и --discovery-endpoints, каждый процесс etcd выполняет следующие шаги автоматически.
Если служба обнаружения использует аутентификацию по клиентским сертификатам, настройте следующие флаги. Они применяются точно так же, как при обращении etcdctl к кластеру etcd.
Если служба обнаружения использует ролевую аутентификацию, настройте следующие флаги. Они применяются точно так же, как при обращении etcdctl к кластеру etcd.
Значения времени и тайм-аутов по умолчанию можно также изменить следующими флагами, которые применяются точно так же, как при обращении etcdctl к кластеру etcd.
Саморегистрация
Сначала каждый процесс etcd регистрирует себя как участника нового кластера. Для этого ID участника создаётся как ключ по полному пути в реестре.
Проверка состояния
Процесс проверяет ожидаемый размер кластера и состояние регистрации, а затем выбирает следующее действие.
Если зарегистрированных участников пока недостаточно, процесс ожидает появления остальных.
Если зарегистрированных участников больше ожидаемого размера N, первые N участников принимаются за список кластера. Если текущий участник входит в список, процедура обнаружения завершается успешно и получает из списка всех одноранговых участников. Если его в списке нет, процедура завершается ошибкой, сообщающей, что кластер заполнен.
Участник может проверить состояние кластера ещё до саморегистрации, поэтому при заполненном кластере отказ может произойти быстро.
Ожидание всех участников
Процесс продолжает наблюдать за префиксом ключей /_etcd/registry/${UUID}/members, пока не найдёт всех участников.
2 - Соглашения по ведению журнала
etcd использует библиотеку zap для записи сообщений приложения, разделённых по уровням. Уровень сообщения в журнале определяется в соответствии со следующими соглашениями:
-
Журналы уровня DebugLevel, как правило, объёмные и обычно отключены в рабочей среде.
- Примеры:
- Отправка обычного сообщения удалённому узлу
- Сохранение записи журнала на диск
- Примеры:
-
InfoLevel является приоритетом ведения журнала по умолчанию.
- Примеры:
- Конфигурация при запуске
- Начало создания снимка
- Добавление нового узла в кластер
- Добавление нового пользователя в подсистему аутентификации
- Примеры:
-
Журналы уровня WarnLevel более важны, чем Info, но не требуют отдельной проверки человеком.
- Примеры:
- Неудача при отправке сообщения Raft удалённому узлу
- Неудача при получении сообщения heartbeat в течение заданного тайм-аута выборов
- Примеры:
-
Журналы уровня ErrorLevel имеют высокий приоритет. Если приложение работает без сбоев, оно не должно генерировать журналы уровня ошибок.
- Примеры:
- Неудача выделения дискового пространства для WAL
- Примеры:
-
PanicLevel записывает сообщение, а затем вызывает панику.
- Примеры:
- Сбой при кодировании сообщений Raft
- Примеры:
-
FatalLevel записывает сообщение, а затем вызывает os.Exit(1).
- Примеры:
- Неудача при сохранении снимка Raft
- Примеры:
3 - Модули Golang
Начиная с версии 3.5 проект etcd организован как несколько модулей Golang , размещённых в одном репозитории .
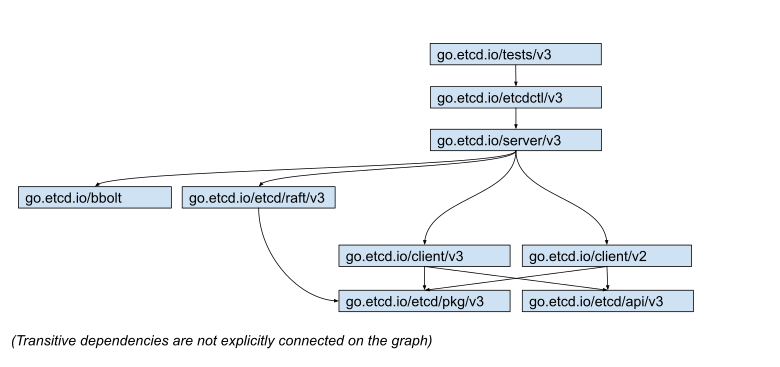
Проект включает следующие модули:
-
go.etcd.io/etcd/api/v3 — определения API, например protos и созданные из proto библиотеки, которые задают протокол взаимодействия между клиентами и сервером etcd.
-
go.etcd.io/etcd/pkg/v3 — набор вспомогательных пакетов, используемых etcd, но не зависящих от его специфики. Пакет следует размещать здесь только в том случае, если в будущем его можно будет вынести в отдельный репозиторий. Не добавляйте сюда код с большим числом собственных зависимостей: они автоматически станут зависимостями клиентской библиотеки, которую важно сохранять легковесной.
-
go.etcd.io/etcd/client/v3 — клиентская библиотека для сетевого обращения к etcd по grpc. Рекомендуется для всех новых применений etcd.
-
go.etcd.io/etcd/client/v2 — прежняя клиентская библиотека для обращения к etcd по протоколу HTTP. Устарела. Все новые применения должны зависеть от библиотеки /v3.
-
go.etcd.io/etcd/raft/v3 — реализация протокола распределённого консенсуса. Не должна содержать код, специфичный для etcd.
-
go.etcd.io/etcd/server/v3 — реализация etcd. Код этого пакета является внутренним и не предназначен для внешних проектов. Структура пакета и API могут меняться между минорными версиями.
-
go.etcd.io/etcd/etcdctl/v3 — инструмент командной строки для доступа к etcd и управления им.
-
go.etcd.io/etcd/tests/v3 — модуль со всеми интеграционными тестами etcd. Обратите внимание: все модульные тесты — быстрые и не требующие межмодульных зависимостей — должны храниться в локальном модуле рядом с тестируемым кодом.
-
go.etcd.io/bbolt — реализация постоянного b-tree. Размещается в отдельном репозитории: https://github.com/etcd-io/bbolt .
Операции
-
Все модули etcd должны выпускаться с одинаковыми версиями; например,
go.etcd.io/etcd/client/v3@v3.5.10должен зависеть отgo.etcd.io/etcd/api/v3@v3.5.10.Согласованно обновить версии можно командой:
-
Выпущенные модули должны получать теги по правилам https://golang.org/ref/mod#vcs-version , то есть каждому модулю требуется собственный тег. Создать теги можно командой:
-
Все модули etcd должны зависеть от одинаковых версий базовых зависимостей. Это проверяется командой:
-
Файлы go.mod не должны содержать неиспользуемых зависимостей и должны соответствовать формату
go mod tidy. Проверка выполняется командой: -
Для запуска действий во всех модулях, например автоматического форматирования всех файлов, используйте или расширьте следующий скрипт:
Будущее
В качестве целевой модели предлагается развивать модули etcd следующим образом:
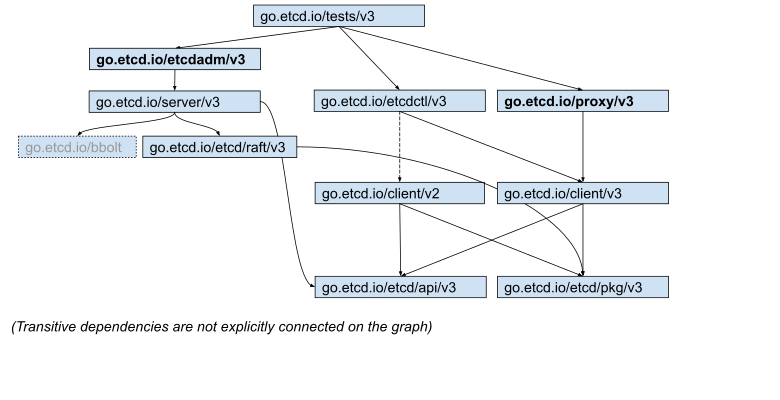
Предполагается:
- Вынести etcdmigrate/etcdadm из бинарного файла etcdctl. Тогда etcdctl станет однозначной оболочкой командной строки над сетевым клиентским API, а etcdmigrate/etcdadm будет выполнять прямые физические операции с файлами хранилища etcd.
- Вынести etcd-proxy из бинарного файла ./etcd: он содержит больше экспериментального кода, а значит несёт дополнительные риски и зависимости.
- Прекратить поддержку протокола v2.