Dies ist die mehrseitige Druckansicht dieses Abschnitts. .
etcd 3.7 Dokumentation
-
1: Aufgaben
- 1.1: Aufgaben für Betreiber
-
1.2: Aufgaben für Entwickler
- 1.2.1: Aus etcd lesen
- 1.2.2: In etcd schreiben
- 1.2.3: Schlüssel anhand eines Präfixes abrufen
- 1.2.4: Schlüssel löschen
- 1.2.5: Mehrere Schreibvorgänge in einer Transaktion ausführen
- 1.2.6: Schlüssel überwachen
- 1.2.7: Eine Lease erstellen
- 1.2.8: Sperren erstellen
- 2: Schnellstart
- 3: Demo
- 4: Installation
- 5: Funktionsschalter
- 6: FAQ
- 7: Bibliotheken und Werkzeuge
-
8: Metriken
- 9: Fehler melden
- 10: Optimierung
-
11: Interne Architektur
- 11.1: Protokoll des Discovery-Dienstes
- 11.2: Konventionen für die Protokollierung
- 11.3: Go-Module
-
12: Grundlagen
- 12.1: Datenmodell
- 12.2: Design des etcd-Clients
- 12.3: Design der Learner in etcd
- 12.4: Authentifizierungsdesign von etcd v3
- 12.5: etcd-API
- 12.6: Dateien der persistenten Speicherung in etcd
- 12.7: Garantien der etcd-API
- 12.8: etcd im Vergleich mit anderen Schlüssel-Wert-Speichern
- 12.9: Glossar
-
13: Entwicklerhandbuch
- 13.1: Protokoll des Discovery-Dienstes
- 13.2: Einen lokalen Cluster einrichten
- 13.3: Mit etcd arbeiten
- 13.4: Warum ein gRPC-Gateway
- 13.5: gRPC-Namensauflösung und Discovery
- 13.6: etcd in eine Go-Anwendung einbetten
- 13.7: Systemgrenzen
- 13.8: etcd-Funktionen
- 13.9: API-Referenz
- 13.10: API-Referenz: Nebenläufigkeit
-
14: Betriebshandbuch
-
14.1: Anleitungen zur Authentifizierung
- 14.1.1: Authentifizierung
- 14.1.2: Rollenbasierte Zugriffskontrolle
- 14.2: Konfigurationsoptionen
- 14.3: Sicherheitsmodell für den Datentransport
- 14.4: Anleitung zur Clusterbildung
- 14.5: etcd-Cluster als Kubernetes-StatefulSet ausführen
- 14.6: etcd-Cluster in Containern ausführen
- 14.7: Ausfallarten
- 14.8: Recovery nach einem Totalausfall
- 14.9: etcd-Gateway
- 14.10: gRPC-Proxy
- 14.11: Hardwareempfehlungen
- 14.12: Wartung
- 14.13: etcd überwachen
- 14.14: Leistung
- 14.15: Entwurf der Laufzeitrekonfiguration
- 14.16: Laufzeitrekonfiguration
- 14.17: Unterstützte Plattformen
- 14.18: Versionierung
- 14.19: Datenbeschädigung
-
14.1: Anleitungen zur Authentifizierung
- 15: Benchmarks
- 16: Downgrades
-
17: Upgrades
- 17.1: Upgrades von etcd-Clustern und -Anwendungen
- 17.2: Upgrade von etcd v3.6 auf v3.7
- 17.3: Upgrade von etcd v3.5 auf v3.6
- 17.4: Upgrade von etcd 3.4 auf 3.5
- 17.5: Upgrade von etcd 3.3 auf 3.4
- 17.6: Upgrade von etcd 3.2 auf 3.3
- 17.7: Upgrade von etcd 3.1 auf 3.2
- 17.8: Upgrade von etcd 3.0 auf 3.1
- 17.9: Upgrade von etcd 2.3 auf 3.0
-
18: Triage
- 18.1: Richtlinien zur Issue-Triage
- 18.2: PR-Verwaltung
etcd ist ein verteilter Schlüssel-Wert-Speicher mit starker Konsistenz. Diese Anleitungen behandeln die Installation und den Betrieb von etcd, die Entwicklung von Anwendungen mit seinen APIs, den internen Aufbau, Leistungsmessungen sowie Upgrades und Downgrades von Clustern innerhalb der Versionsreihe 3.7.
Beginnen Sie mit dem Schnellstart für einen lokalen Ein-Mitglied-Cluster, der Installation für unterstützte Installationswege oder dem Betriebshandbuch für Produktionsumgebungen.
1 - Aufgaben
1.1 - Aufgaben für Betreiber
1.1.1 - Einen etcd-Democluster einrichten
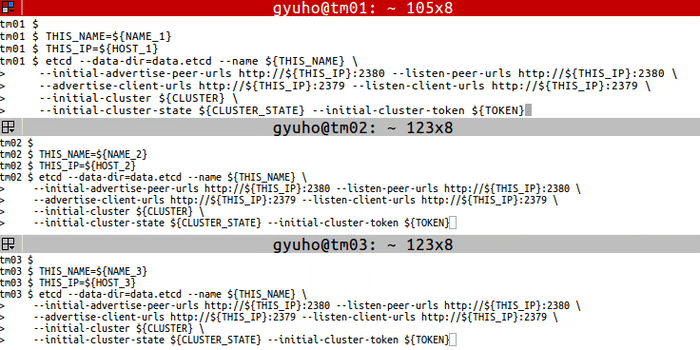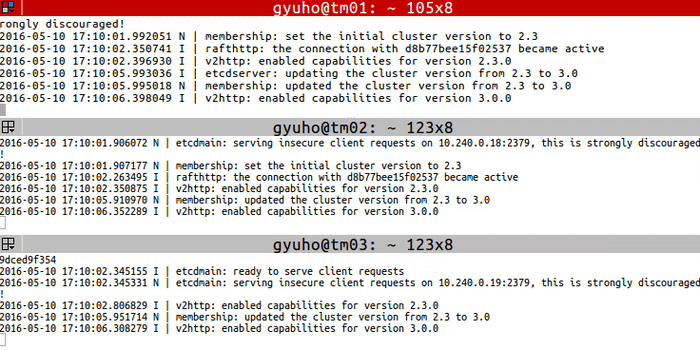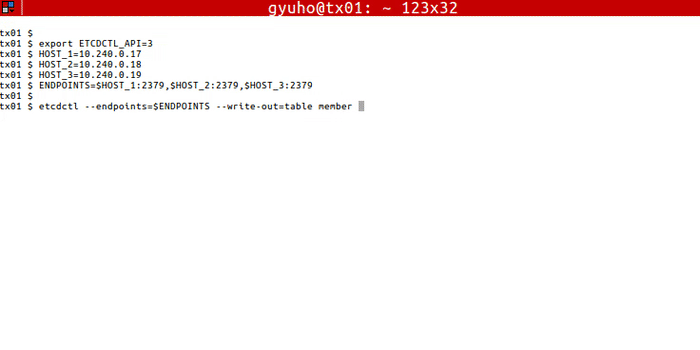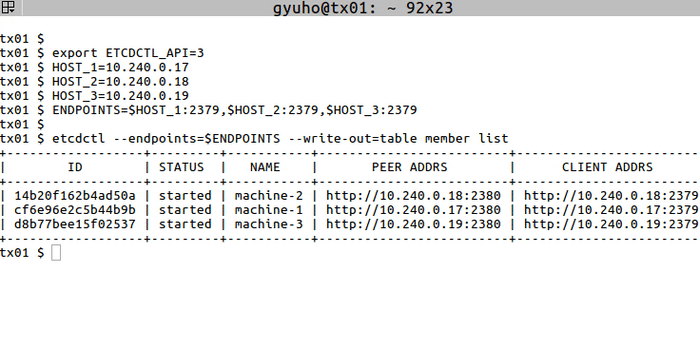
Auf jedem etcd-Knoten die Clustermitglieder angeben:
Auf jedem Rechner Folgendes ausführen:
Oder unseren öffentlichen Discovery-Dienst verwenden:
Damit ist etcd einsatzbereit! So lässt sich mit etcdctl eine Verbindung zu etcd herstellen:
1.1.2 - Eine Leader-Wahl in einem etcd-Cluster durchführen
Voraussetzungen
Eine Leader-Wahl durchführen
Mit dem Befehl etcdctl werden Leader-Wahlen in einem etcd-Cluster durchgeführt. Er stellt sicher, dass jeweils nur ein Client Leader werden kann.
etcdctl --endpoints=$ENDPOINTS elect <election-name> [proposal]
Optionen
--endpoints : $ENDPOINTS
Adresse jedes Mitglieds des etcd-Clusters.
election-nameZeichenfolge
Eine Zeichenfolge als Kennung der Wahl. Alle Teilnehmer, die um die Leader-Rolle konkurrieren, müssen denselben Wahlnamen verwenden.
leader-nameZeichenfolge
Vorschlagswert des neuen Leaders.
Beispiel
1.1.3 - Den Clusterstatus prüfen
Voraussetzungen
etcdundetcdctlinstallieren
Gesamtstatus prüfen
Mit endpoint status den Gesamtstatus jedes über die Option --endpoints angegebenen Endpunkts prüfen:
Optionen
Funktionsfähigkeit prüfen
Mit endpoint health die Funktionsfähigkeit jedes über die Option --endpoints angegebenen Endpunkts prüfen:
Optionen
KV-Hash prüfen
Mit endpoint hashkv den Hash des KV-Verlaufs jedes über die Option --endpoints angegebenen Endpunkts prüfen:
Optionen
Von übergeordneten Befehlen geerbte Optionen
Beispiele
1.1.4 - Die Datenbank sichern
Voraussetzungen
Einen Snapshot der Datenbank erstellen
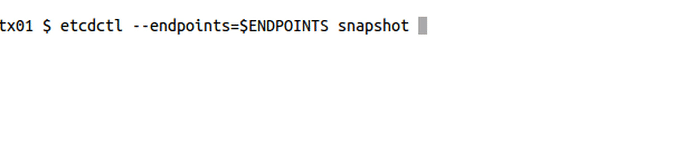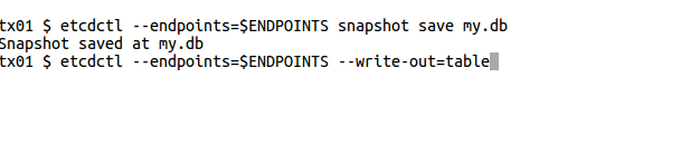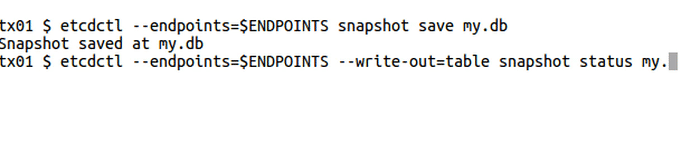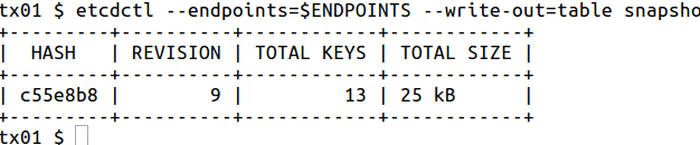
snapshot zum Speichern eines Snapshots der etcd-Datenbank zu einem bestimmten Zeitpunkt:
Globale Optionen
etcdctl
Ein Snapshot kann nur von einem einzelnen etcd-Knoten angefordert werden. Daher sollte die Option --endpoints nur einen Endpunkt enthalten.
etcdutl
Beispiel
1.1.5 - Mitglieder hinzufügen und entfernen
member zum Hinzufügen, Entfernen und Aktualisieren von Mitgliedern:
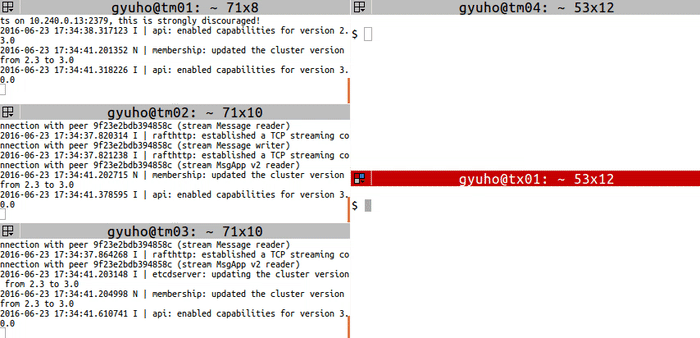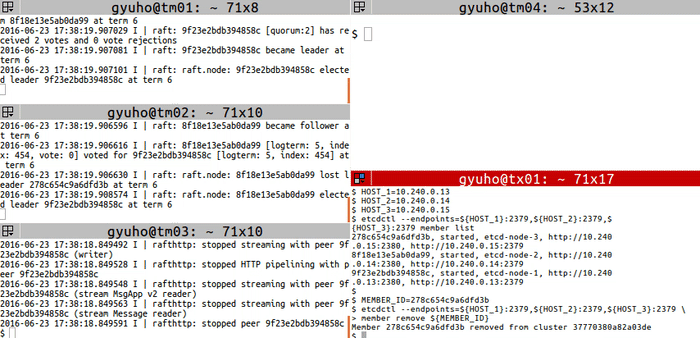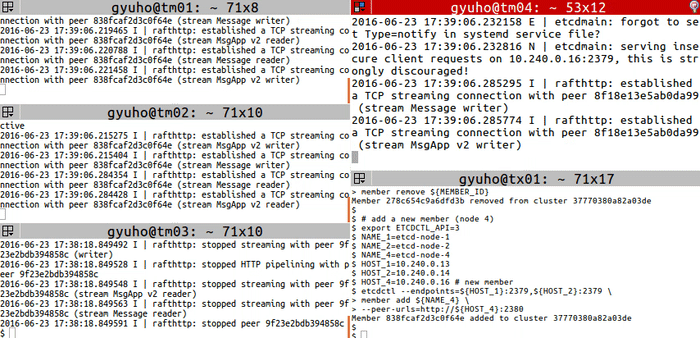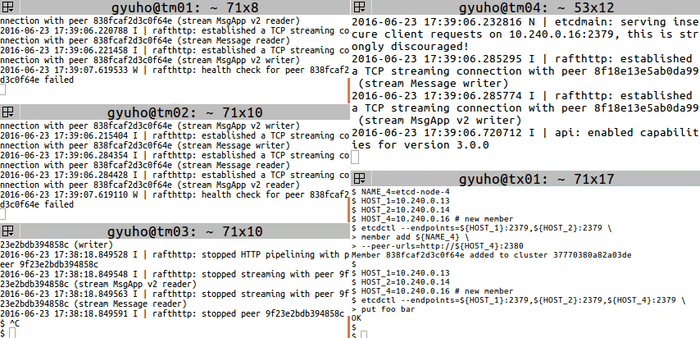
Anschließend ein Mitglied mit den Befehlen member remove und member add ersetzen:
Danach das neue Mitglied mit der Option --initial-cluster-state existing starten:
1.2 - Aufgaben für Entwickler
1.2.1 - Aus etcd lesen
Voraussetzungen
etcdctlinstallieren
Vorgehensweise
Mit dem Unterbefehl get aus etcd lesen:
Dabei gilt:
fooist der angeforderte SchlüsselHello World!ist der abgerufene Wert
Für eine formatierte Ausgabe:
Dabei gibt write-out="json" JSON aus, in dem sowohl der Schlüssel als auch der Wert base64-kodiert sind.
1.2.2 - In etcd schreiben
Voraussetzungen
etcdctlinstallieren
Vorgehensweise
Mit dem Unterbefehl put ein Schlüssel-Wert-Paar schreiben:
Dabei gilt:
fooist der Schlüsselname"Hello World!"ist der in Anführungszeichen eingeschlossene Wert
1.2.3 - Schlüssel anhand eines Präfixes abrufen
Voraussetzungen
Schlüssel anhand eines Präfixes abrufen
Globale Optionen
Optionen
Beispiel
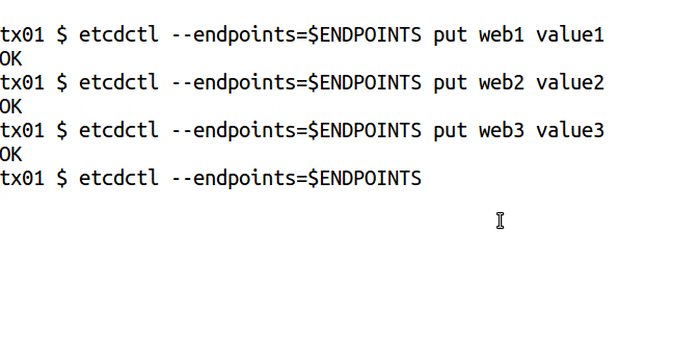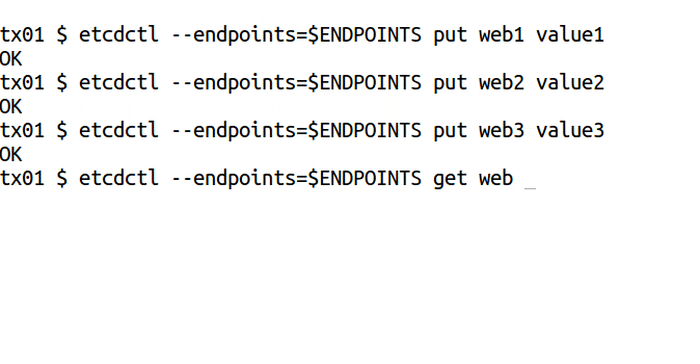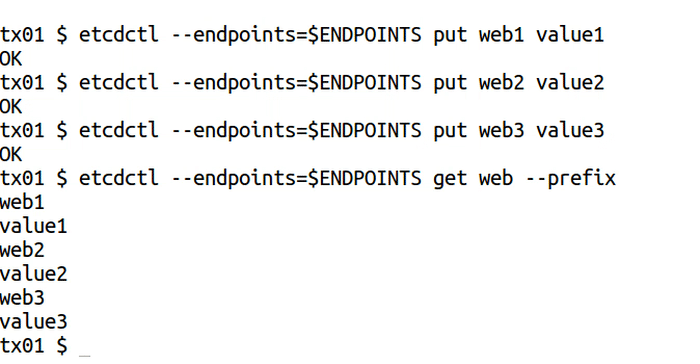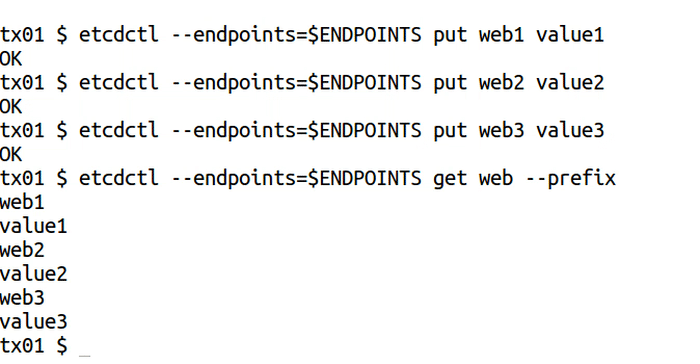
1.2.4 - Schlüssel löschen
Voraussetzungen
etcdundetcdctlinstallieren
Schlüssel hinzufügen oder löschen
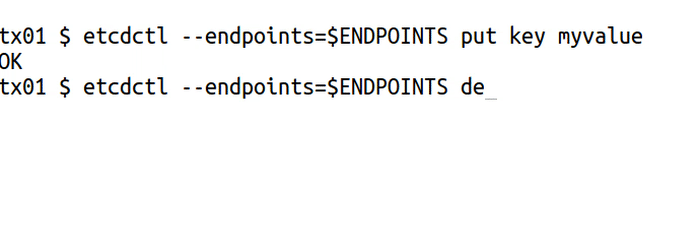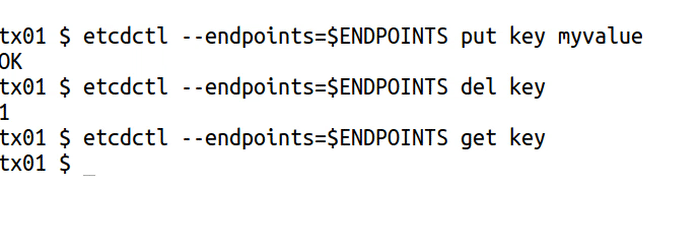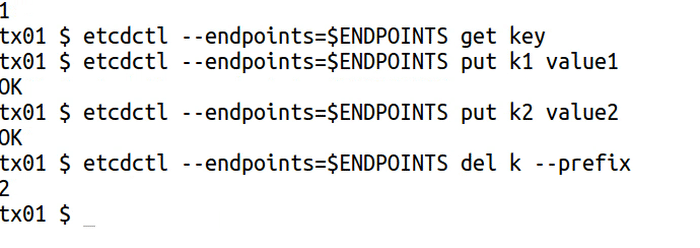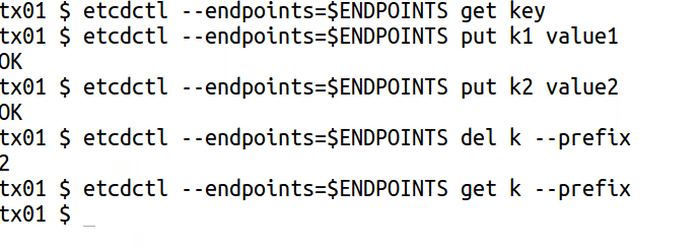
del zum Entfernen des angegebenen Schlüssels oder Schlüsselbereichs:
Optionen
Von übergeordneten Befehlen geerbte Optionen
Beispiele
1.2.5 - Mehrere Schreibvorgänge in einer Transaktion ausführen
Voraussetzungen
etcdundetcdctlinstallieren.- Ein laufender
etcd-Cluster.
Begriffe
Im Folgenden werden wichtige Begriffe aus dem unten stehenden Beispiel definiert.
| Begriffe | Definition |
|---|---|
| etcdctl | Das Befehlszeilenwerkzeug zur Interaktion mit dem etcd-Server. |
Befehl txn
|
Der Befehl txn ist eine Abkürzung für „transaction“ (Transaktion). Er liest mehrere etcd-Anfragen von der Standardeingabe und wendet sie als eine einzige atomare Transaktion an. Eine Transaktion besteht aus einer Liste von Bedingungen, einer Liste von Anfragen für den Fall, dass alle Bedingungen erfüllt sind, und einer Liste von Anfragen für den Fall, dass mindestens eine Bedingung nicht erfüllt ist. Weitere Informationen unter etcdctl-Befehle für Schlüssel-Wert-Paare
. |
compare |
Die Klausel compare innerhalb einer Transaktion (txn) prüft eine Bedingung und entscheidet dadurch, ob die Operationen der Transaktion ausgeführt werden sollen. Änderungen werden nur angewendet, wenn der aktuelle Zustand des Schlüssel-Wert-Speichers den erwarteten Bedingungen entspricht. Dies erhält die Datenkonsistenz und verhindert Konflikte bei nebenläufigen Zugriffen. Der Aufbau des Befehls wird im folgenden Abschnitt Eine Transaktion ausführen
gezeigt. |
Transaktionen
txn zum Verarbeiten aller Anfragen in einer Transaktion:
Mit Transaktionen in etcd lassen sich mehrere Operationen atomar ausführen: Entweder werden alle Operationen angewendet oder keine. Das ist entscheidend, um bei zusammengehörigen Aktualisierungen die Datenkonsistenz zu wahren. Weitere Informationen zu Transaktionen enthält die API-Dokumentation .
Beispiel
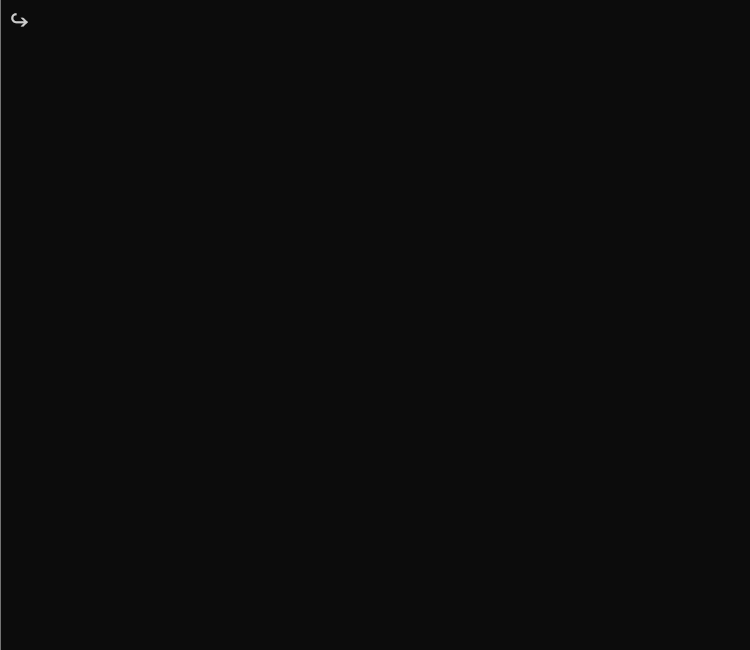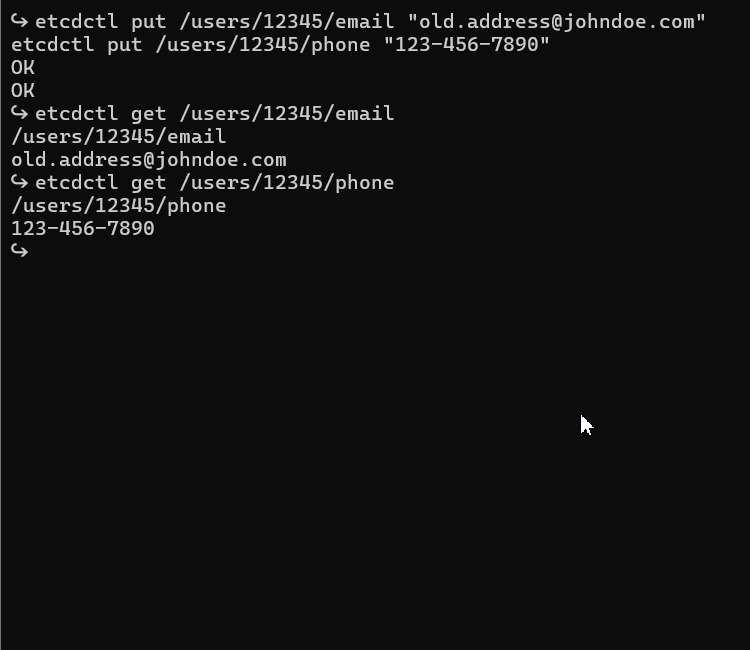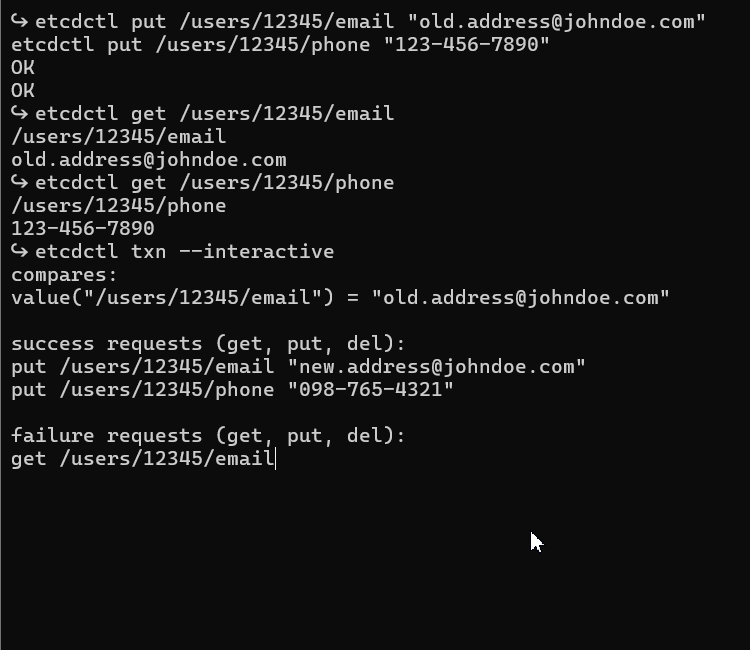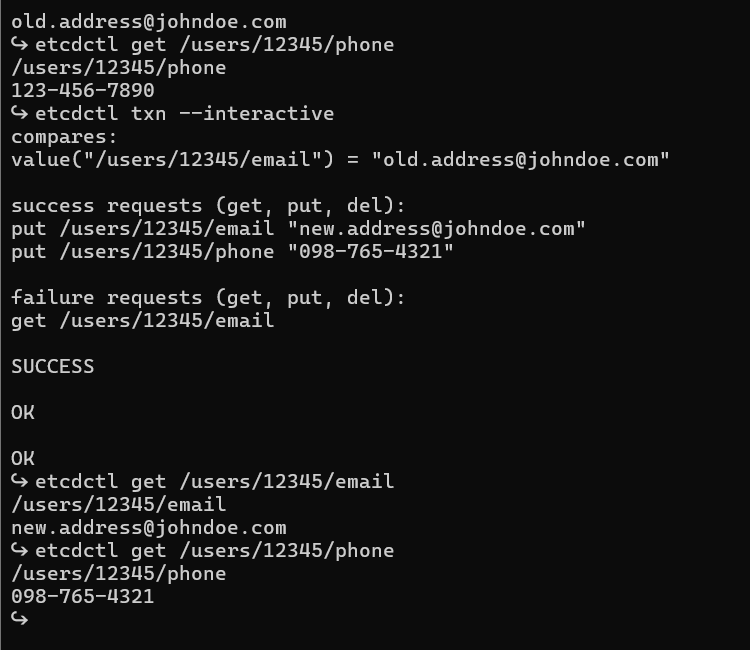
Angenommen, die E-Mail-Adresse und Telefonnummer eines Benutzers sollen in einer einzigen Transaktion aktualisiert werden. So werden beide Änderungen gemeinsam angewendet.
0. Verwendete Variablen und Optionen
| Variablen |
|---|
/users/{<user_id>/email : etcd-Schlüssel für die E-Mail-Adresse eines Benutzers. |
/users/<user_id>/phone : etcd-Schlüssel für die Telefonnummer eines Benutzers. |
| Optionen |
--interactive
: Option zur manuellen Eingabe von Transaktionsdaten |
1. Anfangsdaten einrichten
Zunächst einen Benutzer mit einigen Anfangsdaten erstellen.
2. Eine Transaktion ausführen
Die E-Mail-Adresse und Telefonnummer des Benutzers in einer einzigen Transaktion aktualisieren.
- Vergleich: Prüfen, ob die aktuelle E-Mail-Adresse “old.address@johndoe.com ” lautet. So wird die Transaktion nur fortgesetzt, wenn die Daten dem erwarteten Zustand entsprechen.
- Erfolg: Bei erfolgreichem Vergleich sowohl die E-Mail-Adresse als auch die Telefonnummer aktualisieren.
- Fehlschlag: Schlägt der Vergleich fehl, die aktuelle E-Mail-Adresse abrufen, um zu verstehen, warum die Transaktion nicht fortgesetzt wurde.
Wichtige Hinweise
- Atomarität: Die Transaktion stellt sicher, dass E-Mail-Adresse und Telefonnummer gemeinsam aktualisiert werden. Ist die Anfangsbedingung (der Vergleich) nicht erfüllt, wird keine der beiden Änderungen angewendet.
- Konsistenz: Transaktionen erhalten die Datenkonsistenz, insbesondere bei mehreren zusammengehörigen Aktualisierungen.
- Mehrere put-Operationen für denselben Schlüssel vermeiden: Innerhalb einer einzigen Transaktion nicht mehrere Werte für denselben Schlüssel schreiben, da dies zu unerwarteten Ergebnissen führen kann. Jeder Schlüssel sollte pro Transaktion nur einmal aktualisiert werden.
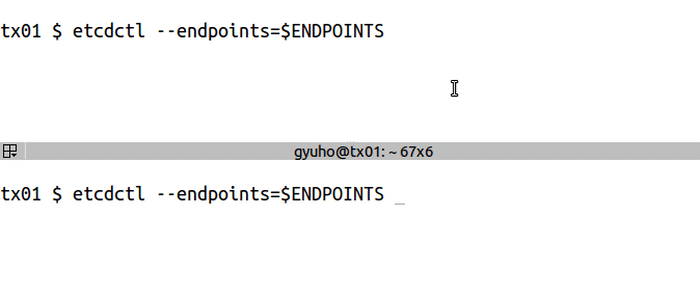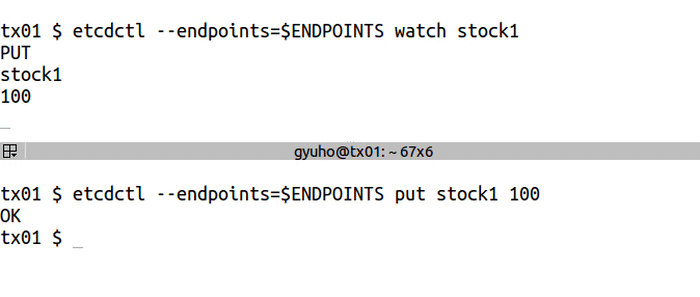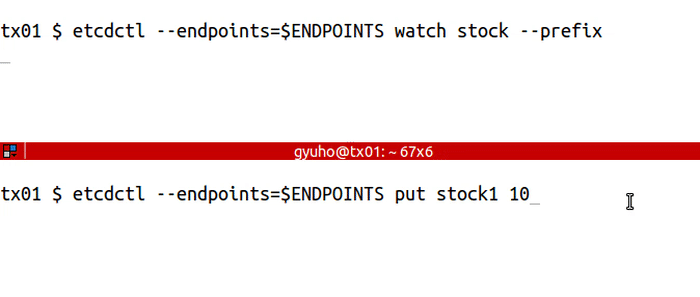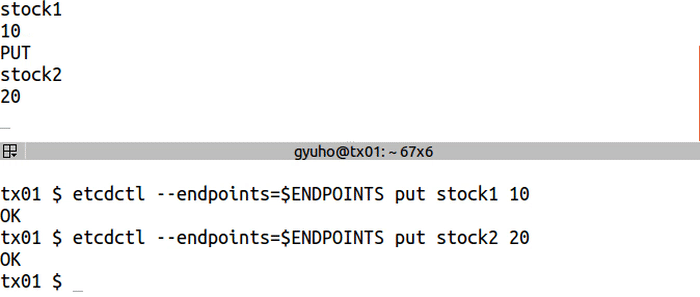
1.2.6 - Schlüssel überwachen
Voraussetzungen
etcdundetcdctlinstallieren
Schlüssel überwachen
watch für Benachrichtigungen über künftige Änderungen:
Optionen
Von übergeordneten Befehlen geerbte Optionen
Beispiele
1.2.7 - Eine Lease erstellen
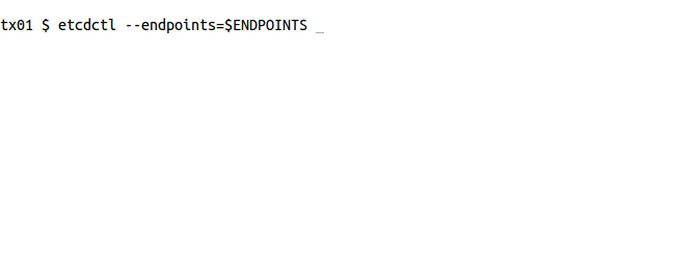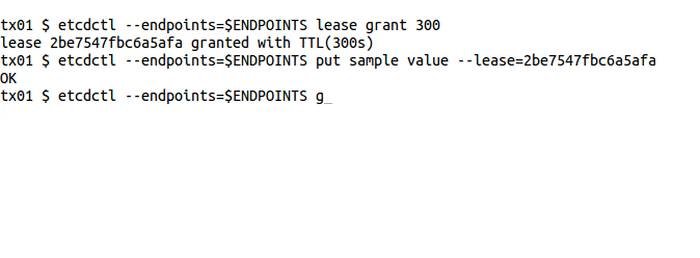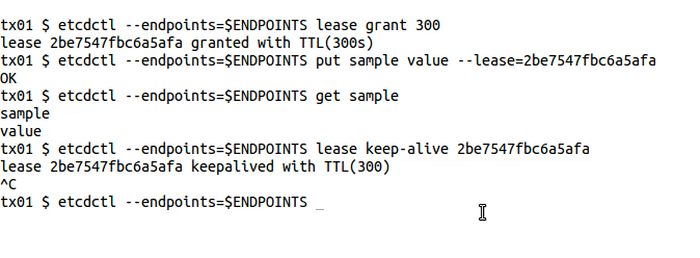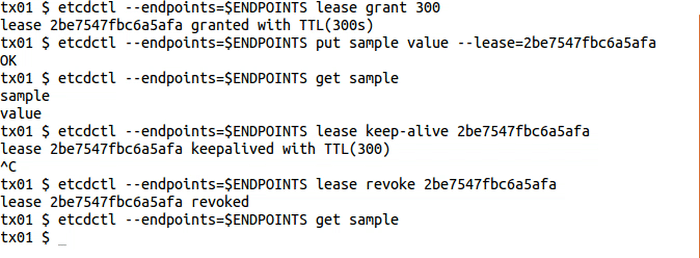
lease zum Schreiben mit TTL:
1.2.8 - Sperren erstellen
LOCK erwirbt einen verteilten Mutex mit einem bestimmten Namen. Sobald die Sperre erworben wurde, bleibt sie bis zum Beenden von etcdctl bestehen.
Voraussetzungen
etcdundetcdctlinstallieren
Eine Sperre erstellen
lock für eine verteilte Sperre:
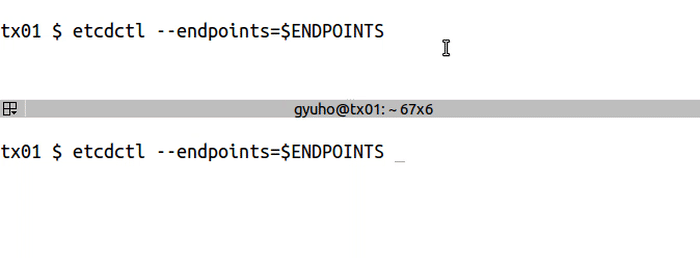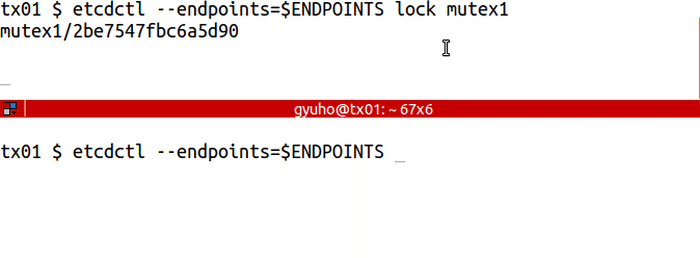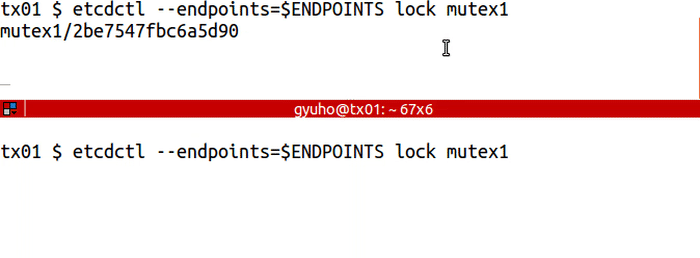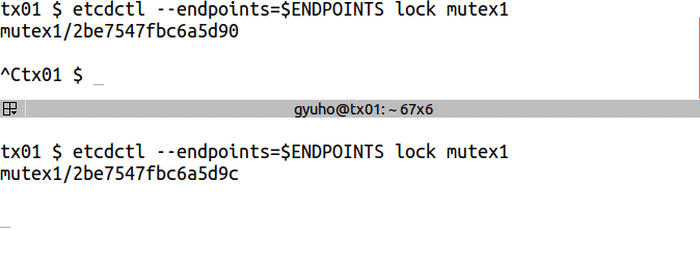
Optionen
- endpoints – definiert eine durch Kommas getrennte Liste der Rechneradressen im Cluster.
- ttl – Zeitüberschreitung der Sperrsitzung in Sekunden.
2 - Schnellstart
Befolgen Sie diese Anweisungen, um einen lokalen Ein-Mitglied-Cluster mit etcd zu installieren, zu starten und zu testen:
-
Installieren Sie etcd aus vorkompilierten Binärdateien oder aus dem Quellcode. Weitere Einzelheiten finden Sie in der Installationsanleitung .
WarnungWichtig: Führen Sie unbedingt den letzten Schritt der Installationsanleitung aus, um zu prüfen, ob
etcdüber Ihren Suchpfad aufrufbar ist. -
Starten Sie
etcd:HinweisHinweis: Die Ausgabe von
etcdbesteht aus Protokollen — Protokolle auf Info-Ebene können ignoriert werden. -
Verwenden Sie in einem anderen Terminal
etcdctl, um einen Schlüssel festzulegen: -
Rufen Sie den Schlüssel aus demselben Terminal ab:
Was kommt als Nächstes?
Erfahren Sie auf den folgenden Seiten mehr über weitere Möglichkeiten zur Konfiguration und Nutzung von etcd:
-
Wenn Sie Entwickler sind:
- Erkunden Sie die gRPC-API .
- Informieren Sie sich über Sprachanbindungen und Werkzeuge .
-
Wenn Sie Betreiber oder Administrator sind:
- Richten Sie einen Cluster mit mehreren Rechnern ein.
- Erfahren Sie, wie Sie etcd konfigurieren .
- Verwenden Sie TLS, um einen etcd-Cluster abzusichern .
- Optimieren Sie etcd .
3 - Demo
Diese Beispiele zeigen die grundlegenden Vorgehensweisen für die Arbeit mit einem etcd-Cluster.
Authentifizierung
auth,user,role für die Authentifizierung:
4 - Installation
Voraussetzungen
Vor der Installation von etcd die folgenden Seiten lesen:
Vorkompilierte Binärdateien installieren
Am einfachsten lässt sich etcd aus vorkompilierten Binärdateien installieren:
-
Unter Veröffentlichungen die komprimierte Archivdatei für die gewünschte Plattform herunterladen. Dabei Version v3.7.2 oder neuer wählen.
-
Die Archivdatei entpacken. Dadurch entsteht ein Verzeichnis mit den Binärdateien.
-
Die ausführbaren Binärdateien zum Suchpfad hinzufügen. Dazu die Binärdateien beispielsweise umbenennen und/oder in ein Verzeichnis im Suchpfad verschieben (etwa
/usr/local/bin) oder das im vorigen Schritt erstellte Verzeichnis zum Suchpfad hinzufügen. -
In einer Shell prüfen, ob
etcdim Suchpfad liegt:
Aus dem Quellcode bauen
Für etcd v3.7.2 Go ab Version 1.26 verwenden; das Release legt die Go-Toolchain auf Version 1.26.8 fest. Mit den folgenden Schritten lässt sich etcd aus dem Quellcode bauen:
-
Das etcd-Repository als ZIP-Datei herunterladen und entpacken oder das Repository mit folgendem Befehl klonen.
Zum Bauen aus
main@HEADdie Option-b v3.7.2weglassen. -
Das Verzeichnis wechseln:
-
Das Build-Skript ausführen:
Die Binärdateien befinden sich im Verzeichnis
bin. -
Den vollständigen Pfad zum Verzeichnis
binzum Suchpfad hinzufügen, zum Beispiel: -
Prüfen, ob
etcdim Suchpfad liegt:
Installation über Betriebssystempakete
Hinweis: Bei der Installation von etcd über Paketmanager des Betriebssystems können veraltete Versionen installiert werden. Diese Pakete werden vom etcd-Projekt weder automatisch gepflegt noch offiziell unterstützt. Betriebssystempakete daher mit Vorsicht verwenden.
Für die verschiedenen Betriebssysteme gibt es unterschiedliche Möglichkeiten, etcd zu installieren. Im Folgenden werden einige Beispiele gezeigt.
MacOS (Homebrew)
- Homebrew aktualisieren:
- etcd installieren:
- Installation überprüfen
Linux
etcd lässt sich zwar über die offiziellen Repositories und Paketmanager vieler großer Linux-Distributionen installieren, die angebotenen Versionen können jedoch erheblich veraltet sein. Von dieser Installationsweise wird daher dringend abgeraten.
Für Linux wird die Installation aus vorkompilierten Binärdateien oder mit Homebrew empfohlen.
Homebrew unter Linux
Homebrew läuft auch unter Linux und kann aktuelle Softwareversionen bereitstellen.
-
Voraussetzungen
-
Homebrew aktualisieren:
-
-
Vorgehensweise
-
Mit
brewinstallieren:
-
-
Ergebnis
-
Die Installation durch Abrufen der Version überprüfen:
Die Ausgabe oben ist ein Beispiel. Homebrew kann eine andere Patchversion bereitstellen; die tatsächlich installierte Version mit
etcd --versionprüfen.
-
Docker
etcd verwendet gcr.io/etcd-development/etcd
als primäre Container-Registry und quay.io/coreos/etcd
als sekundäre.
etcd mit Docker ausführen:
Installation im Rahmen einer Kubernetes-Installation
Installation überprüfen
Eine etwas ausführlichere Funktionsprüfung der Installation bietet der Schnellstart .
5 - Funktionsschalter
Diese Seite gibt einen Überblick über die verschiedenen Funktionsschalter, die Administratoren für etcd festlegen können.
Die Entwicklungsphasen einer Funktion werden unter Funktionsphasen erläutert.
Überblick
Funktionsschalter sind eine Menge von key=value-Paaren, die etcd-Funktionen beschreiben.
Mit der Befehlszeilenoption --feature-gates lassen sich diese Funktionen in etcd ein- oder ausschalten.
etcd ermöglicht das Aktivieren oder Deaktivieren einer Gruppe von Funktionsschaltern.
Mit der Option -h lässt sich die vollständige Liste der Funktionsschalter anzeigen.
Zum Festlegen der Funktionsschalter der Option --feature-gates auf der Befehlszeile eine Liste von Funktionspaaren zuweisen:
Alternativ feature-gates in der YAML-Konfigurationsdatei angeben:
Änderung an der Struktur embed.Config
In 3.6 wird das Feld ServerFeatureGate zu embed.Config hinzugefügt. Es sollte die unten aufgeführten experimentellen Felder ersetzen:
Funktionsschalter für Alpha- oder Beta-Funktionen
Die folgenden Tabellen fassen die Funktionsschalter zusammen, die für etcd gesetzt werden können.
| Funktion | Standardwert | Phase | Einzelheiten |
|---|---|---|---|
| CompactHashCheck | false | Alpha | Ermöglicht dem Leader, die Kompaktierungs-Hashes der Follower regelmäßig zu prüfen. |
| InitialCorruptCheck | false | Alpha | Ermöglicht die Prüfung auf Datenkorruption, bevor Client- oder Peer-Verkehr bedient wird. |
| LeaseCheckpoint | false | Alpha | Ermöglicht dem Leader, regelmäßig Checkpoints an andere Mitglieder zu senden, damit die verbleibende TTL bei einem Leader-Wechsel nicht zurückgesetzt wird. |
| LeaseCheckpointPersist | false | Alpha | Ermöglicht das dauerhafte Speichern von remainingTTL, um eine unbegrenzte automatische Verlängerung langlebiger Leases zu verhindern. |
| SetMemberLocalAddr | false | Alpha | Ermöglicht es, die erste in initial-advertise-peer-urls angegebene lokale Adresse, die keine Loopback-Adresse ist, bei der Kommunikation mit einem Peer als lokale Adresse zu verwenden. |
| StopGRPCServiceOnDefrag | false | Alpha | Ermöglicht es dem gRPC-Dienst von etcd, während der Defragmentierung keine Clientanfragen mehr zu bedienen. |
| TxnModeWriteWithSharedBuffer | true | Beta | Ermöglicht einer Schreibtransaktion, für ihre schreibgeschützten Prüfoperationen einen gemeinsamen Puffer zu verwenden. |
Eine Funktion verwenden
Funktionsphasen
Eine Funktion kann sich in der Phase Alpha, Beta, GA oder Veraltet befinden. Eine Alpha-Funktion bedeutet:
- Standardmäßig deaktiviert.
- Möglicherweise fehlerhaft. Durch das Aktivieren der Funktion können Fehler auftreten.
- Die Unterstützung der Funktion kann jederzeit ohne Ankündigung eingestellt werden.
- Die API kann sich in einer späteren Softwareversion ohne Ankündigung inkompatibel ändern.
- Aufgrund des erhöhten Fehlerrisikos und der fehlenden langfristigen Unterstützung nur für kurzlebige Testcluster empfohlen.
Eine Beta-Funktion bedeutet:
- Standardmäßig aktiviert.
- Die Funktion ist gründlich getestet. Ihre Aktivierung gilt als sicher.
- Die Unterstützung der Funktion insgesamt wird nicht eingestellt, Einzelheiten können sich jedoch ändern.
- Nur für nicht geschäftskritische Einsatzzwecke empfohlen, da bei breiterer Nutzung neue, schwer erkennbare Fehler entdeckt werden können.
Bitte Beta-Funktionen ausprobieren und Rückmeldungen dazu geben! Nach dem Ende der Beta-Phase lassen sich weitere Änderungen möglicherweise nicht mehr sinnvoll umsetzen.
Eine Funktion mit allgemeiner Verfügbarkeit (GA) wird auch als stabile Funktion bezeichnet. Das bedeutet:
- Die Funktion ist immer aktiviert und lässt sich nicht deaktivieren.
- Der zugehörige Funktionsschalter wird nicht mehr benötigt.
- Stabile Versionen von Funktionen werden in vielen nachfolgenden Softwareversionen enthalten sein.
Eine veraltete Funktion bedeutet:
- Der Funktionsschalter wird nicht mehr verwendet.
- Die Funktion hat den Status GA erreicht oder wurde entfernt.
6 - FAQ
Allgemeines zu etcd
Was ist etcd?
etcd ist ein konsistenter, verteilter Schlüssel-Wert-Speicher. Es wird hauptsächlich als separater Koordinationsdienst in verteilten Systemen verwendet und ist für kleine Datenmengen ausgelegt, die vollständig in den Arbeitsspeicher passen.
Wie wird etcd ausgesprochen?
etcd wird /ˈɛtsiːdiː/ ausgesprochen und bedeutet „verteiltes etc-Verzeichnis“.
Müssen Clients Anfragen an den etcd-Leader senden?
Raft arbeitet mit einem Leader; dieser bearbeitet alle Clientanfragen, die einen Konsens im Cluster erfordern. Der Client muss jedoch nicht wissen, welcher Knoten der Leader ist. Jede an einen Follower gesendete Anfrage, die Konsens benötigt, wird automatisch an den Leader weitergeleitet. Anfragen ohne Konsensanforderung (etwa serialisierbare Lesezugriffe) kann jedes Clustermitglied verarbeiten.
Konfiguration
Worin unterscheiden sich listen-<client,peer>-urls, advertise-client-urls und initial-advertise-peer-urls?
listen-client-urls und listen-peer-urls legen die lokalen Adressen fest, an die sich der etcd-Server bindet, um eingehende Verbindungen anzunehmen. Um einen Port auf allen Schnittstellen zu überwachen, 0.0.0.0 als IP-Adresse zum Lauschen angeben.
advertise-client-urls und initial-advertise-peer-urls legen die Adressen fest, über die etcd-Clients oder andere etcd-Mitglieder den etcd-Server erreichen sollten. Die bekannt gegebenen Adressen müssen von den entfernten Rechnern erreichbar sein. In einer Produktionsumgebung keine Adressen wie localhost oder 0.0.0.0 bekannt geben, da diese von entfernten Rechnern nicht erreichbar sind.
Warum aktualisiert eine Änderung von --listen-peer-urls oder --initial-advertise-peer-urls nicht die in etcdctl member list bekannt gegebenen Peer-URLs?
Die bekannt gegebenen Peer-URLs eines Mitglieds stammen beim ersten Clusterstart aus --initial-advertise-peer-urls. Werden nach dem Start des Mitglieds die Adressen zum Lauschen für Peers oder die anfänglich bekannt gegebenen Peer-Adressen geändert, beeinflusst dies die veröffentlichten Peer-URLs nicht. Änderungen müssen vom Quorum bestätigt werden, um einen Split-Brain-Zustand der Mitgliedschaftskonfiguration zu vermeiden. Mit etcdctl member update lassen sich die Peer-URLs eines Mitglieds aktualisieren.
Bereitstellung
Systemanforderungen
Da etcd Daten auf den Datenträger schreibt, hängt seine Leistung stark von dessen Leistung ab. Daher wird eine SSD dringend empfohlen. Um zu prüfen, ob ein Datenträger für etcd schnell genug ist, kann ein Benchmarkwerkzeug wie fio verwendet werden. Ein Beispiel dazu gibt es hier . Um Leistungseinbußen oder eine unbeabsichtigte Überlastung des Schlüssel-Wert-Speichers zu verhindern, setzt etcd eine konfigurierbare Speicherplatzquote durch, die standardmäßig 2GB beträgt. Um Auslagerung oder Speichermangel zu vermeiden, sollte der Rechner mindestens so viel RAM haben, wie die Quote vorsieht. Für normale Umgebungen wird eine maximale Größe von 8GB empfohlen; überschreitet der konfigurierte Wert diese Grenze, warnt etcd beim Start. Bei CoreOS wird ein etcd-Cluster üblicherweise auf dedizierten Rechnern mit CoreOS Container Linux betrieben, die mindestens einen Zweikernprozessor, 2GB RAM und 80GB SSD-Speicher besitzen. Die Leistung hängt wesentlich von der Arbeitslast ab; vor dem Produktiveinsatz bitte testen. Weitere Empfehlungen stehen unter Hardware .
Die stabilste Produktionsumgebung ist Linux auf der amd64-Architektur; weitere Informationen unter Unterstützte Plattformen .
Warum eine ungerade Anzahl von Clustermitgliedern?
In einem etcd-Cluster muss die Mehrheit der Knoten, das Quorum, Änderungen am Clusterzustand zustimmen. Bei einem Cluster mit n Mitgliedern beträgt das Quorum (n/2)+1. Bei einem Cluster mit ungerader Mitgliederzahl erhöht das Hinzufügen eines Knotens immer die für das Quorum erforderliche Knotenzahl. Obwohl ein zusätzlicher Knoten wegen der höheren Rechnerzahl vorteilhaft erscheint, verschlechtert sich die Fehlertoleranz: Ohne Quorumverlust dürfen weiterhin genauso viele Knoten ausfallen, doch es gibt mehr Knoten, die ausfallen können. Kann der Cluster keine weiteren Ausfälle mehr verkraften, ist das Hinzufügen eines Knotens vor dem Entfernen von Knoten gefährlich. Kann sich der neue Knoten nicht beim Cluster registrieren (etwa wegen einer falsch konfigurierten Adresse), geht das Quorum dauerhaft verloren.
Wie groß darf ein Cluster maximal sein?
Theoretisch gibt es keine feste Grenze. Ein etcd-Cluster sollte jedoch wahrscheinlich nicht mehr als sieben Knoten haben. Der Google-Chubby-Sperrdienst , der etcd ähnelt und bei Google seit vielen Jahren weit verbreitet ist, empfiehlt fünf Knoten. Ein etcd-Cluster mit 5 Mitgliedern kann den Ausfall von zwei Mitgliedern verkraften, was in den meisten Fällen ausreicht. Größere Cluster bieten zwar eine bessere Fehlertoleranz, ihre Schreibleistung leidet jedoch darunter, dass Daten auf mehr Rechner repliziert werden müssen.
Was bedeutet Fehlertoleranz?
Ein etcd-Cluster arbeitet, solange ein Quorum seiner Mitglieder hergestellt werden kann. Geht das Quorum durch vorübergehende Netzwerkfehler (etwa Partitionierungen) verloren, setzt etcd den Betrieb automatisch und sicher fort, sobald das Netzwerk wieder funktioniert und das Quorum wiederhergestellt ist; Raft gewährleistet die Clusterkonsistenz. Für den Fall eines Stromausfalls speichert etcd das Raft-Protokoll dauerhaft auf dem Datenträger. Es spielt das Protokoll bis zum Zeitpunkt des Ausfalls erneut ab und nimmt wieder am Cluster teil. Bei einem dauerhaften Hardwareausfall kann der Knoten durch Rekonfiguration im laufenden Betrieb aus dem Cluster entfernt werden.
Eine ungerade Mitgliederzahl wird empfohlen. Ein Cluster mit ungerader Mitgliederzahl verkraftet dieselbe Zahl von Ausfällen wie ein Cluster mit gerader Mitgliederzahl, benötigt dafür aber weniger Knoten. Der Vergleich zeigt den Unterschied:
| Clustergröße | Mehrheit | Fehlertoleranz |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
| 8 | 5 | 3 |
| 9 | 5 | 4 |
Ein Mitglied hinzuzufügen, um eine gerade Clustergröße zu erreichen, bringt keine zusätzliche Fehlertoleranz. Ebenso gewährleistet eine ungerade Mitgliederzahl bei einer Aufteilung des Netzwerks in zwei Partitionen, dass stets eine Mehrheitspartition vorhanden ist, die weiterarbeiten und nach dem Ende der Partitionierung als maßgebliche Datenquelle dienen kann.
Funktioniert etcd bei Bereitstellungen über Regionen oder Rechenzentren hinweg?
Eine Bereitstellung über mehrere Regionen verbessert die Fehlertoleranz von etcd, da die Mitglieder in getrennten Ausfallbereichen liegen. Der Preis ist eine höhere Latenz für Konsensanfragen über Rechenzentrumsgrenzen hinweg. Da etcd für den Konsens ein Quorum seiner Mitglieder benötigt, fällt diese zusätzliche Latenz ins Gewicht: Mindestens die Mehrheit der Clustermitglieder muss auf Konsensanfragen antworten. Außerdem müssen Clusterdaten auf alle Peers repliziert werden, wodurch auch Bandbreitenkosten entstehen.
Bei längeren Latenzen kann die Standardkonfiguration von etcd häufige Wahlen oder Heartbeat-Zeitüberschreitungen verursachen. Hinweise zum Anpassen der Zeitüberschreitungen für Bereitstellungen mit hoher Latenz enthält der Abschnitt Optimierung .
Betrieb
Wie wird ein Backup eines etcd-Clusters erstellt?
etcdctl stellt den Befehl snapshot zum Erstellen von Backups bereit. Weitere Einzelheiten unter Backup
.
Sollte vor dem Entfernen eines nicht funktionsfähigen Mitglieds ein neues hinzugefügt werden?
Beim Ersetzen eines etcd-Knotens ist es wichtig, zuerst das Mitglied zu entfernen und dann seinen Ersatz hinzuzufügen.
etcd verwendet verteilten Konsens auf Basis eines Quorummodells: (n/2)+1 Mitglieder, also die Mehrheit, müssen einem Vorschlag zustimmen, bevor er im Cluster festgeschrieben werden kann. Solche Vorschläge umfassen Schlüssel-Wert-Aktualisierungen und Änderungen der Mitgliedschaft. Dieses Modell schließt Inkonsistenzen durch Split Brain vollständig aus. Der Nachteil ist, dass ein dauerhafter Quorumverlust katastrophal ist.
Für die Mitgliedschaft bedeutet dies: Ist in einem Cluster mit 3 Mitgliedern 1 Mitglied ausgefallen, kann der Cluster weiterhin Fortschritte machen, denn das Quorum beträgt 2 und 2 Mitglieder sind noch aktiv. Wird dem Cluster mit 3 Mitgliedern jedoch ein neues Mitglied hinzugefügt, steigt das Quorum auf 3, da für die Mehrheit von 4 Mitgliedern 3 Stimmen erforderlich sind. Wegen des gestiegenen Quorums bringt das zusätzliche Mitglied keinen Gewinn an Fehlertoleranz; der Ausfall eines weiteren Knotens würde den Cluster weiterhin unwiederherstellbar machen.
Außerdem birgt das neue Mitglied ein Risiko: Es könnte falsch konfiguriert sein oder dem Cluster nicht beitreten können. Dann lässt sich das Quorum nicht wiederherstellen. Der Cluster hat zwei ausgefallene und zwei aktive Mitglieder, benötigt aber drei Stimmen für eine Änderung der Mitgliedschaft, um das misslungene Hinzufügen rückgängig zu machen. etcd lehnt standardmäßig Versuche ab, Mitglieder hinzuzufügen, wenn sie den Cluster auf diese Weise zum Ausfall bringen könnten.
Wird dagegen zuerst das ausgefallene Mitglied aus der Clustermitgliedschaft entfernt, sinkt die Mitgliederzahl auf 2 und das Quorum bleibt bei 2. Auch das anschließende Hinzufügen eines neuen Mitglieds hält das Quorum bei 2. Selbst wenn sich der neue Knoten nicht starten lässt, können die verbleibenden aktiven Mitglieder das neue Mitglied daher weiterhin durch ein Quorum entfernen.
Warum akzeptiert etcd meine Änderungen der Mitgliedschaft nicht?
etcd setzt strict-reconfig-check, um Rekonfigurationsanfragen abzulehnen, die zum Quorumverlust führen würden. Auf das Quorum zu verzichten ist sehr riskant, insbesondere bei einem bereits beeinträchtigten Cluster. Bei Quorumverlust mag es verlockend sein, die Quorumprüfung zu deaktivieren, um ein neues Mitglied hinzuzufügen. Dies könnte jedoch den gesamten Cluster inkonsistent machen. Für viele Anwendungen würde das Problem dadurch noch schlimmer; eine Beschädigung der Datenträgergeometrie gehört zu den erschreckendsten möglichen Folgen.
Warum verliert etcd bei Spitzen der Datenträgerlatenz seinen Leader?
Dieses Verhalten ist beabsichtigt: Die Datenträgerlatenz gehört zur Beurteilung der Funktionsfähigkeit des Leaders. Angenommen, der Cluster-Leader benötigt eine Minute, um eine Aktualisierung des Raft-Logs per fsync auf den Datenträger zu schreiben, während die Wahlzeitüberschreitung des etcd-Clusters eine Sekunde beträgt. Auch wenn der Leader Netzwerknachrichten innerhalb des Wahlintervalls verarbeiten kann, etwa Heartbeats senden, ist er praktisch nicht verfügbar: Er kann keine neuen Vorschläge festschreiben, weil er auf den langsamen Datenträger wartet. Verliert der Cluster wegen Datenträgerlatenzen häufig seinen Leader, versuchen, die Datenträgereinstellungen oder die Zeitparameter von etcd zu optimieren .
Was bedeutet die etcd-Warnung “request ignored (cluster ID mismatch)”?
Jeder neue etcd-Cluster erzeugt aus der anfänglichen Clusterkonfiguration und einem vom Benutzer angegebenen eindeutigen Wert für initial-cluster-token eine neue Cluster-ID. Eindeutige Cluster-IDs schützen etcd vor Wechselwirkungen zwischen Clustern, die den Cluster beschädigen könnten.
Diese Warnung tritt üblicherweise auf, nachdem ein alter Cluster abgebaut wurde und einige seiner Peer-Adressen für einen neuen Cluster wiederverwendet werden. Läuft noch ein etcd-Prozess des alten Clusters, versucht er, den neuen Cluster zu kontaktieren. Dieser erkennt die abweichende Cluster-ID, ignoriert die Anfrage und gibt die Warnung aus. Häufig lässt sich die Warnung beseitigen, indem sichergestellt wird, dass verschiedene Cluster keine gemeinsamen Peer-Adressen haben.
Was bedeutet “mvcc: database space exceeded” und wie lässt sich das beheben?
Das Datenmodell von etcd mit Mehrversionen-Nebenläufigkeitskontrolle
bewahrt einen exakten Verlauf des Schlüsselraums. Ohne regelmäßige Kompaktierung dieses Verlaufs, etwa durch Setzen von --auto-compaction-mode und --auto-compaction-retention, wird etcd seinen Speicherplatz irgendwann aufbrauchen. Bei knappem Speicherplatz löst etcd einen Speicherplatzquotenalarm aus, um den Cluster vor weiteren Schreibzugriffen zu schützen. Solange der Alarm aktiv ist, beantwortet etcd Schreibanfragen mit dem Fehler mvcc: database space exceeded.
So lässt sich der Speicherplatzquotenalarm beheben:
- Den Verlauf von etcd kompaktieren .
- Jeden etcd-Endpunkt defragmentieren .
- Den Alarm deaktivieren .
Was bedeutet die etcd-Warnung “etcdserver/api/v3rpc: transport: http2Server.HandleStreams failed to read frame: read tcp 127.0.0.1:2379->127.0.0.1:43020: read: connection reset by peer”?
Dies ist eine gRPC-seitige Warnung, wenn ein Server ein TCP-RST-Flag empfängt, weil clientseitige Streams vorzeitig geschlossen wurden. Ein Client schließt beispielsweise seine Verbindung, bevor der gRPC-Server alle HTTP/2-Frames in der TCP-Warteschlange verarbeitet hat. Auf Serverseite können dabei Daten verloren gegangen sein; solange die Clientverbindung bereits geschlossen wurde, ist das jedoch unproblematisch.
Nur alte gRPC-Versionen
protokollieren dies. etcd >=v3.2.13 protokolliert es standardmäßig auf der Stufe DEBUG
, sodass es nur mit aktivierter Option --log-level=debug sichtbar ist.
Leistung
Wie sollte etcd einem Benchmark unterzogen werden?
Das Werkzeug benchmark ausprobieren. Aktuelle Benchmark-Ergebnisse stehen zum Vergleich bereit.
Was bedeutet die etcd-Warnung “apply entries took too long”?
Nachdem die Mehrheit der etcd-Mitglieder dem Festschreiben einer Anfrage zugestimmt hat, wendet jeder etcd-Server die Anfrage auf seinen Datenspeicher an und speichert das Ergebnis dauerhaft auf dem Datenträger. Selbst mit einem langsamen mechanischen Datenträger oder einem virtualisierten Netzwerkdatenträger wie Amazons EBS oder Googles PD sollte das Anwenden einer Anfrage normalerweise weniger als 50 Millisekunden dauern. Übersteigt die durchschnittliche Anwendungsdauer 100 Millisekunden, warnt etcd, dass das Anwenden der Einträge zu lange dauert.
Meist wird dieses Problem durch einen langsamen Datenträger verursacht. Möglicherweise konkurrieren etcd und andere Anwendungen um Datenträgerzugriffe, oder der Datenträger ist schlicht zu langsam, etwa ein gemeinsam genutzter virtualisierter Datenträger. Um einen langsamen Datenträger als Ursache auszuschließen, backend_commit_duration_seconds überwachen (die p99-Dauer sollte unter 25ms liegen) und so prüfen, ob der Datenträger ausreichend schnell ist. Ist er zu langsam, lässt sich das Problem in der Regel durch einen dedizierten oder schnelleren Datenträger für etcd lösen.
Die zweithäufigste Ursache ist ein Mangel an CPU-Zeit. Zeigt die Überwachung der CPU-Nutzung des Rechners eine hohe Auslastung, reicht die Rechenkapazität für etcd möglicherweise nicht aus. In der Regel hilft es, etcd auf einen dedizierten Rechner zu verlagern, die Ressourcenisolierung der Prozesse mit cgroups zu verstärken oder dem etcd-Serverprozess mit renice eine höhere Priorität zu geben.
Aufwendige Benutzeranfragen, die auf zu viele Schlüssel zugreifen, etwa das Abrufen des gesamten Schlüsselraums, können ebenfalls lange Anwendungslatenzen verursachen. Zugriffe auf weniger als einige Hundert Schlüssel pro Anfrage sollten jedoch immer schnell sein.
Beseitigt keiner dieser Vorschläge die Warnungen, bitte ein Issue erstellen und ausführliche Protokolle, Überwachungsdaten, Metriken sowie gegebenenfalls Informationen zur Arbeitslast beifügen.
Was bedeutet die etcd-Warnung “failed to send out heartbeat on time”?
etcd verwendet ein auf einem Leader basierendes Konsensprotokoll für konsistente Datenreplikation und Log-Ausführung. Die Clustermitglieder wählen einen einzigen Leader; alle anderen Mitglieder werden Follower. Der gewählte Leader muss regelmäßig Heartbeats an seine Follower senden, um seine Rolle beizubehalten. Erhalten Follower innerhalb eines Wahlintervalls keine Heartbeats, nehmen sie einen Leader-Ausfall an und lösen eine Wahl aus. Sendet ein noch laufender Leader seine Heartbeats nicht rechtzeitig, ist die Wahl unnötig und wird wahrscheinlich durch unzureichende Ressourcen ausgelöst. Um solche Funktionsstörungen zu erkennen, warnt etcd, wenn der Leader zwei Heartbeat-Intervalle auslässt, dass ein Heartbeat nicht rechtzeitig gesendet wurde.
Meist wird dieses Problem durch einen langsamen Datenträger verursacht. Bevor der Leader Heartbeats mit angehängten Metadaten sendet, muss er die Metadaten möglicherweise dauerhaft auf dem Datenträger speichern. Möglicherweise konkurrieren etcd und andere Anwendungen um Datenträgerzugriffe, oder der Datenträger ist schlicht zu langsam, etwa ein gemeinsam genutzter virtualisierter Datenträger. Um einen langsamen Datenträger als Ursache auszuschließen, wal_fsync_duration_seconds überwachen (die p99-Dauer sollte unter 10ms liegen) und so prüfen, ob der Datenträger ausreichend schnell ist. Ist er zu langsam, lässt sich das Problem in der Regel durch einen dedizierten oder schnelleren Datenträger für etcd lösen. Ob ein Datenträger schnell genug für etcd ist, lässt sich mit einem Benchmarkwerkzeug wie fio prüfen. Ein Beispiel steht hier .
Die zweithäufigste Ursache ist ein Mangel an CPU-Zeit. Zeigt die Überwachung der CPU-Nutzung des Rechners eine hohe Auslastung, reicht die Rechenkapazität für etcd möglicherweise nicht aus. In der Regel hilft es, etcd auf einen dedizierten Rechner zu verlagern, die Ressourcenisolierung der Prozesse mit cgroups zu verstärken oder dem etcd-Serverprozess mit renice eine höhere Priorität zu geben.
Auch ein langsames Netzwerk kann dieses Problem verursachen. Zeigen die Netzwerkmetriken zwischen den etcd-Rechnern lange Latenzen oder eine hohe Verlustrate, reicht die Netzwerkkapazität für etcd möglicherweise nicht aus. In der Regel hilft es, die etcd-Mitglieder in ein weniger ausgelastetes Netzwerk zu verlagern. Bei einem über mehrere Rechenzentren verteilten etcd-Cluster sind lange Latenzen zwischen den Mitgliedern jedoch zu erwarten. Für solche Bereitstellungen heartbeat-interval ungefähr auf die Umlaufzeit zwischen den Rechnern einstellen und election-timeout auf mindestens 5 * heartbeat-interval setzen. Einzelheiten enthält die Dokumentation zur Optimierung
.
Beseitigt keiner dieser Vorschläge die Warnungen, bitte ein Issue erstellen und ausführliche Protokolle, Überwachungsdaten, Metriken sowie gegebenenfalls Informationen zur Arbeitslast beifügen.
Was bedeutet die etcd-Warnung “snapshotting is taking more than x seconds to finish …”?
etcd sendet einen Snapshot seines vollständigen Schlüssel-Wert-Speichers, um langsame Follower auf den aktuellen Stand zu bringen und Backups zu erstellen. Langsame Snapshot-Übertragungen erhöhen die MTTR. Nimmt der Cluster Daten mit hohem Durchsatz auf, können langsame Follower in einen Livelock geraten: Sie benötigen bereits einen neuen Snapshot, bevor sie den vorherigen vollständig empfangen haben. Um langsame Snapshot-Übertragungen zu erkennen, warnt etcd, wenn das Senden eines Snapshots länger als dreißig Sekunden dauert und die für eine 1Gbps-Verbindung erwartete Übertragungszeit überschreitet.
7 - Bibliotheken und Werkzeuge
Die unten aufgeführten Bibliotheken und Werkzeuge von Drittanbietern, die nicht unter https://github.com/etcd-io gehostet werden, werden vom etcd-Team weder getestet noch gepflegt. Es wird empfohlen, sich vor der Verwendung darüber zu informieren und sie zu prüfen.
Werkzeuge
- etcdctl - Ein Befehlszeilenclient für etcd
- etcd-dump - Befehlszeilenwerkzeug zum Exportieren und Wiederherstellen von etcd.
- etcd-fs - FUSE-Dateisystem für etcd
- etcddir - Echtzeitsynchronisierung zwischen etcd und einem lokalen Verzeichnis. Funktioniert unter Windows und Linux.
- etcd-browser - Ein webbasierter Schlüssel-Wert-Editor für etcd mit AngularJS
- etcd-lock - Implementierung von Master-Wahl und verteilten Lese-/Schreibsperren mit etcd – Unterstützt v2
- etcd-console - Ein webbasierter Schlüssel-Wert-Editor für etcd mit PHP
- etcd-viewer - Ein in Java geschriebener Editor und Betrachter für den etcd-Schlüssel-Wert-Speicher
- etcdtool - etcd-Verzeichnisse als JSON/YAML/TOML exportieren, importieren und bearbeiten sowie mit JSON-Schema validieren
- etcdloadtest - Ein Befehlszeilenclient für Lasttests mit etcd ab Version 3.0.
- etcd-tui - Eine moderne Terminaloberfläche (TUI) für die Interaktion mit einer etcd-Datenbank. Durch Schlüssel navigieren, Werte anzeigen, Daten filtern und den etcd-Cluster direkt im Terminal verwalten.
- etcdfinder - Eine sehr schnelle, moderne Weboberfläche (UI) für etcd mit Sofortsuche. Unterstützt sowohl etcd v2 als auch v3.
- lucas - Ein webbasierter Betrachter für Schlüssel-Wert-Paare in Kubernetes-Clustern mit etcd3.0+.
- etcd-manager - Eine moderne, effiziente, plattformübergreifende und kostenlose GUI samt Clientwerkzeug für etcd 3.x. Verfügbar für Windows, Linux und Mac.
- etcd-backup-restore - Werkzeug für regelmäßige inkrementelle Backups und die Wiederherstellung von etcd.
- etcd-druid - Ein Kubernetes-Operator zum Bereitstellen von etcd-Clustern und zur Verwaltung des laufenden Betriebs (day-2).
- etcdadm - Ein Befehlszeilenwerkzeug zum Betreiben eines etcd-Clusters.
- etcd-defrag - Ein einfacher bedienbares und intelligenteres Werkzeug zur Defragmentierung von etcd.
- etcdhelper - Ein etcd-Plugin für die IntelliJ-Plattform.
Bibliotheken
Die folgenden Abschnitte führen etcd-Clientbibliotheken nach Programmiersprache auf.
Go
- etcd/client/v3 - Der offiziell gepflegte Go-Client für v3
- go-etcd - Der veraltete offizielle Client. Kann für ältere etcd-Versionen (<2.0.0) nützlich sein.
- encWrapper - encWrapper ist ein Verschlüsselungs-Wrapper für die Keys API/KV des etcd-Clients.
Java
- coreos/jetcd - Unterstützt v3
- justinsb/jetcd
- cdancy/etcd-rest - Verwendet jclouds für eine vollständige Implementierung der v2-API.
- IBM/etcd-java
Scala
- maciej/etcd-client - Unterstützt v2. Vollständig asynchroner Client auf Basis von Akka HTTP
- eiipii/etcdhttpclient - Unterstützt v2. Asynchroner HTTP-Client auf Basis von Netty und Scala Futures.
- mingchuno/etcd4s - Unterstützt v3 über gRPC, mit optionaler Unterstützung für Akka Stream.
Perl
- hexfusion/perl-net-etcd - Unterstützt die HTTP-API des gRPC-Gateways für v3
- robn/p5-etcd - Unterstützt v2
Python
- kragniz/python-etcd3 - Client für v3
- jplana/python-etcd - Unterstützt v2
- russellhaering/txetcd - Eine Python-Bibliothek für Twisted
- cholcombe973/autodock - Ein Werkzeug zur Automatisierung von Docker-Bereitstellungen
- lisael/aioetcd - (Python 3.4+) Client mit Asyncio-Koroutinen (Unterstützt v2)
- txaio-etcd - Asynchrone Clientbibliothek ausschließlich für etcd v3, für Twisted (heute) und asyncio (künftig)
- dims/etcd3-gateway - Bibliothek für die etcd-v3-API über das HTTP-gRPC-Gateway
- aioetcd3 - (Python 3.6+) etcd-v3-API für asyncio
- Revolution1/etcd3-py - (python2.7 und python3.5+) Python-Client für etcd v3 über das gRPC-JSON-Gateway
Node
- mixer/etcd3 - Unterstützt v3
- stianeikeland/node-etcd - Unterstützt v2 (mit Coffeescript)
- lavagetto/nodejs-etcd - Unterstützt v2
- deedubs/node-etcd-config - Unterstützt v2
Ruby
- iconara/etcd-rb
- jpfuentes2/etcd-ruby
- ranjib/etcd-ruby - Unterstützt v2
- davissp14/etcdv3-ruby - Unterstützt v3
C
- apache/celix/etcdlib - Unterstützt v2
- jdarcy/etcd-api - Unterstützt v2
- shafreeck/cetcd - Unterstützt v2
C++
- edwardcapriolo/etcdcpp - Unterstützt v2
- suryanathan/etcdcpp - Unterstützt v2 (mit Warteoperationen)
- nokia/etcd-cpp-api - Unterstützt v2
- etcd-cpp-apiv3/etcd-cpp-apiv3 - Unterstützt v3
Clojure
- aterreno/etcd-clojure
- dwwoelfel/cetcd - Unterstützt v2
- rthomas/clj-etcd - Unterstützt v2
Erlang
- marshall-lee/etcd.erl - Unterstützt v2
- zhongwencool/eetcd - Unterstützt v3+ (nur GRPC)
Elixir
- team-telnyx/etcdex - Unterstützt v3+ (nur GRPC)
.NET
- wangjia184/etcdnet - Unterstützt v2
- drusellers/etcetera
- shubhamranjan/dotnet-etcd - Unterstützt v3+ (nur GRPC)
- SimplifyNet/Etcd.Microsoft.Extensions.Configuration
PHP
- linkorb/etcd-php
- activecollab/etcd
- ouqiang/etcd-php - Client für das gRPC-Gateway von v3
Haskell
R
Nim
Tcl
- efrecon/etcd-tcl - Unterstützt v2, außer wait.
Rust
- jimmycuadra/rust-etcd - Unterstützt v2
Gradle
- gradle-etcd-rest-plugin - Unterstützt v2
Lua
- api7/lua-resty-etcd - Unterstützt v2 und v3 (HTTP-API des gRPC-Gateways)
Werkzeuge zur Bereitstellung
Chef-Integrationen
Chef-Cookbooks
BOSH-Releases
Projekte, die etcd verwenden
- Nutzer von etcd-Raft - Projekte, die die Raft-Bibliotheksimplementierung von etcd verwenden.
- Apache APISIX - Ein API-Gateway, das etcd als Konfigurationsspeicher verwendet.
- apache/celix - Eine für C und C++ angepasste Implementierung der OSGi-Spezifikation
- binocarlos/yoda - etcd + ZeroMQ
- blox/blox - Eine Sammlung von Open-Source-Projekten zur Containerverwaltung und -orchestrierung mit AWS ECS
- calavera/active-proxy - Ein mit etcd konfigurierter HTTP-Proxy
- chain/chain - Software zum Betreiben hochskalierbarer zugangsbeschränkter Blockchain-Netzwerke und zum Herstellen von Verbindungen zu ihnen
- derekchiang/etcdplus - Eine Sammlung verteilter Synchronisationsprimitive auf Basis von etcd
- go-discover - Diensterkennung in Go
- gleicon/goreman - Zweig des Go-Foreman-Klons mit etcd-Unterstützung
- garethr/hiera-etcd - Puppet-hiera-Backend mit etcd
- mattn/etcd-vim - Schlüssel mit SET und GET direkt in vim schreiben und lesen
- mattn/etcdenv - „env“-Shebang mit etcd-Integration
- kelseyhightower/confd - Lokale Anwendungskonfigurationsdateien mit Vorlagen und Daten aus etcd verwalten
- configdb - Eine relationale REST-Abstraktion über beliebigen Datenbank-Backends zum Speichern von Konfigurationen und Inventaren.
- kubernetes/kubernetes - Von Google eingeführte Verwaltung für Containercluster.
- mailgun/vulcand - HTTP-Proxy, der etcd als Konfigurations-Backend verwendet.
- duedil-ltd/discodns - Einfacher DNS-Nameserver, der etcd als Datenbank für Namen und Einträge verwendet.
- skynetservices/skydns - RFC-konformer DNS-Server
- xordataexchange/crypt - Werte mit GPG-Verschlüsselung sicher in etcd speichern
- spf13/viper - Go-Konfigurationsbibliothek; liest Werte aus ENV, pflags, Dateien und etcd, mit optionaler Verschlüsselung
- lytics/metafora - Go-Bibliothek für verteilte Aufgaben
- ryandoyle/nss-etcd - Ein GNU-libc-NSS-Modul zur Namensauflösung aus etcd.
- Gru - Orchestrierung mit Go leicht gemacht
- Vitess - Vitess ist ein Datenbank-Clustersystem zur horizontalen Skalierung von MySQL.
- lclarkmichalek/etcdhcp - DHCP-Server, der etcd für Persistenz und Koordination verwendet.
- openstack/networking-vpp - Ein Netzwerktreiber, der die FD.io-VPP-Datenebene programmiert, um virtuelle Cloud-Netzwerke für OpenStack bereitzustellen
- OpenStack - OpenStack-Dienste können etcd als Basisdienst verwenden.
- CoreDNS - CoreDNS ist ein DNS-Server mit verketteten Plugins und Teil von CNCF und Kubernetes
- Uber M3 - M3: Ubers Open-Source-Metrikplattform für Prometheus im großen Maßstab
- Rook - Speicherorchestrierung für Kubernetes
- Patroni - Eine Vorlage für PostgreSQL-Hochverfügbarkeit mit ZooKeeper, etcd oder Consul
- Trillian - Trillian implementiert einen Merkle-Baum, dessen Inhalte aus einer Datenspeicherschicht bereitgestellt werden, um die Skalierung auf extrem große Bäume zu ermöglichen.
- purpleidea/mgmt - Verteilte, ereignisgesteuerte, parallele Konfigurationsverwaltung der nächsten Generation!
- Portworx/kvdb - Die interne kvdb zum Speichern der Portworx-Clusterkonfiguration.
- Apache Pulsar - Apache Pulsar ist eine quelloffene, verteilte Messaging- und Streaming-Plattform für die Cloud.
8 - Metriken
etcd verwendet Prometheus zur Bereitstellung von Metriken. Sie lassen sich für Echtzeitüberwachung und Fehlersuche nutzen. etcd speichert seine Metriken nicht dauerhaft; beim Neustart eines Mitglieds werden sie zurückgesetzt.
Die verfügbaren Metriken lassen sich am einfachsten mit cURL am Metrikendpunkt /metrics abrufen. Das Format wird in der Prometheus-Dokumentation
beschrieben.
Mit der Prometheus-Einstiegsanleitung lässt sich ein Prometheus-Server zum Sammeln von etcd-Metriken starten.
Die Benennung der Metriken folgt den empfohlenen bewährten Verfahren von Prometheus
. Ein Metrikname enthält etcd oder etcd_debugging als Namensraumpräfix sowie ein Präfix für das Subsystem (zum Beispiel wal und etcdserver).
Metriken im Namensraum etcd
Metriken mit dem Präfix etcd dienen der Überwachung und Alarmierung. Sie sind stabile Metriken auf hoher Abstraktionsebene. Änderungen an diesen Metriken werden in den Versionshinweisen aufgeführt.
Metriken zu etcd2 sind im v2-Metrikleitfaden dokumentiert.
Server
Diese Metriken beschreiben den Zustand des etcd-Servers. Um Ausfälle oder Probleme für die Fehlersuche zu erkennen, sollten die Servermetriken jedes etcd-Clusters im Produktivbetrieb genau überwacht werden.
Alle diese Metriken haben das Präfix etcd_server_
| Name | Beschreibung | Typ |
|---|---|---|
| has_leader | Ob ein Leader vorhanden ist. 1 bedeutet vorhanden, 0 bedeutet nicht vorhanden. | Gauge |
| leader_changes_seen_total | Anzahl der beobachteten Leader-Wechsel. | Counter |
| proposals_committed_total | Gesamtzahl der festgeschriebenen Konsensvorschläge. | Gauge |
| proposals_applied_total | Gesamtzahl der angewendeten Konsensvorschläge. | Gauge |
| proposals_pending | Aktuelle Anzahl der ausstehenden Vorschläge. | Gauge |
| proposals_failed_total | Gesamtzahl der beobachteten fehlgeschlagenen Vorschläge. | Counter |
has_leader zeigt an, ob das Mitglied einen Leader hat. Ohne Leader ist ein Mitglied vollständig nicht verfügbar. Hat kein Mitglied im Cluster einen Leader, ist der gesamte Cluster vollständig nicht verfügbar.
leader_changes_seen_total zählt die Leader-Wechsel, die das Mitglied seit seinem Start beobachtet hat. Häufige Leader-Wechsel beeinträchtigen die Leistung von etcd erheblich. Sie weisen auch auf einen instabilen Leader hin, möglicherweise aufgrund von Netzwerkverbindungsproblemen oder übermäßiger Last auf dem etcd-Cluster.
proposals_committed_total erfasst die Gesamtzahl der festgeschriebenen Konsensvorschläge. In einem funktionsfähigen Cluster sollte dieser Gauge-Wert mit der Zeit steigen. Mehrere funktionsfähige Mitglieder eines etcd-Clusters können zum selben Zeitpunkt unterschiedliche Gesamtzahlen festgeschriebener Vorschläge haben. Mögliche Gründe dafür sind das Nachholen von Daten von Peers nach dem Start, ein Rückstand gegenüber dem Leader oder die Rolle als Leader, der deshalb die meisten Commits hat. Wichtig ist, diese Metrik über alle Clustermitglieder hinweg zu beobachten: Ein dauerhaft großer Rückstand eines einzelnen Mitglieds gegenüber seinem Leader deutet darauf hin, dass das Mitglied langsam oder nicht funktionsfähig ist.
proposals_applied_total erfasst die Gesamtzahl der angewendeten Konsensvorschläge. Der etcd-Server wendet jeden festgeschriebenen Vorschlag asynchron an. Der Unterschied zwischen proposals_committed_total und proposals_applied_total sollte normalerweise gering sein (selbst unter hoher Last innerhalb weniger Tausend). Steigt die Differenz weiter an, weist dies auf eine Überlastung des etcd-Servers hin. Das kann bei aufwendigen Abfragen geschehen, etwa umfangreichen Bereichsabfragen oder großen txn-Operationen.
proposals_pending zeigt an, wie viele Vorschläge zum Festschreiben anstehen. Eine steigende Zahl ausstehender Vorschläge deutet auf hohe Clientlast hin oder darauf, dass das Mitglied Vorschläge nicht festschreiben kann.
proposals_failed_total hängt normalerweise mit zwei Problemen zusammen: vorübergehenden Fehlern während einer Leader-Wahl oder längeren Ausfällen durch den Verlust des Quorums im Cluster.
Datenträger
Diese Metriken beschreiben den Zustand der Datenträgeroperationen.
Alle diese Metriken haben das Präfix etcd_disk_.
| Name | Beschreibung | Typ |
|---|---|---|
| wal_fsync_duration_seconds | Latenzverteilungen der von wal aufgerufenen fsync-Operationen | Histogram |
| backend_commit_duration_seconds | Latenzverteilungen der vom Backend aufgerufenen commit-Operationen. | Histogram |
wal_fsync wird aufgerufen, wenn etcd seine Protokolleinträge auf dem Datenträger dauerhaft speichert, bevor es sie anwendet.
backend_commit wird aufgerufen, wenn etcd einen inkrementellen Snapshot seiner neuesten Änderungen auf dem Datenträger festschreibt.
Hohe Latenzen bei Datenträgeroperationen (wal_fsync_duration_seconds oder backend_commit_duration_seconds) weisen häufig auf Datenträgerprobleme hin. Sie können hohe Anfragelatenzen verursachen oder den Cluster instabil machen.
Netzwerk
Diese Metriken beschreiben den Zustand des Netzwerks.
Alle diese Metriken haben das Präfix etcd_network_
| Name | Beschreibung | Typ |
|---|---|---|
| peer_sent_bytes_total | Gesamtzahl der an den Peer mit der ID To gesendeten Bytes. |
Counter(To) |
| peer_received_bytes_total | Gesamtzahl der vom Peer mit der ID From empfangenen Bytes. |
Counter(From) |
| peer_sent_failures_total | Gesamtzahl der Sendefehler zum Peer mit der ID To. |
Counter(To) |
| peer_received_failures_total | Gesamtzahl der Empfangsfehler vom Peer mit der ID From. |
Counter(From) |
| peer_round_trip_time_seconds | Histogramm der Umlaufzeiten zwischen Peers. | Histogram(To) |
| client_grpc_sent_bytes_total | Gesamtzahl der an gRPC-Clients gesendeten Bytes. | Counter |
| client_grpc_received_bytes_total | Gesamtzahl der von gRPC-Clients empfangenen Bytes. | Counter |
peer_sent_bytes_total zählt die Gesamtzahl der an einen bestimmten Peer gesendeten Bytes. Normalerweise sendet das Leader-Mitglied mehr Daten als andere Mitglieder, da es die replizierten Daten überträgt.
peer_received_bytes_total zählt die Gesamtzahl der von einem bestimmten Peer empfangenen Bytes. Normalerweise empfangen Follower-Mitglieder nur Daten vom Leader-Mitglied.
gRPC-Anfragen
Diese Metriken werden über go-grpc-prometheus bereitgestellt.
Metriken im Namensraum etcd_debugging
Die Metriken mit dem Präfix etcd_debugging dienen der Fehlersuche. Sie hängen stark von der Implementierung ab und ändern sich häufig. In neuen etcd-Versionen können sie ohne Vorwarnung geändert oder entfernt werden. Einige dieser Metriken können zum Präfix etcd wechseln, sobald sie stabiler sind.
Snapshot
| Name | Beschreibung | Typ |
|---|---|---|
| snapshot_save_total_duration_seconds | Verteilungen der Gesamtlatenz der von snapshot aufgerufenen save-Operationen | Histogram |
Eine ungewöhnlich lange Snapshot-Dauer (snapshot_save_total_duration_seconds) weist auf Datenträgerprobleme hin und kann den Cluster instabil machen.
Von Prometheus bereitgestellte Metriken
Die Prometheus-Clientbibliothek stellt zahlreiche Metriken in den Namensräumen go und process bereit. Einige sind besonders interessant.
| Name | Beschreibung | Typ |
|---|---|---|
| process_open_fds | Anzahl offener Dateideskriptoren. | Gauge |
| process_max_fds | Maximale Anzahl offener Dateideskriptoren. | Gauge |
Prozessmetriken wie process_open_fds und process_max_fds werden derzeit auf Darwin-Systemen (macOS) nicht unterstützt.
Eine hohe Nutzung von Dateideskriptoren (process_open_fds), also nahe am Limit des Prozesses (process_max_fds), weist auf eine mögliche Erschöpfung der Dateideskriptoren hin. Sind keine Dateideskriptoren mehr verfügbar, kann etcd mit einer Panic abbrechen, weil es keine neuen WAL-Dateien erstellen kann.
Generierte Liste der Metriken
9 - Fehler melden
Fehler in einem Teil des etcd-Projekts oder in seiner Dokumentation bitte durch Erstellen eines Issues melden. Wir nehmen Fehler und Mängel sehr ernst und halten kein Problem für zu klein. Vor dem Erstellen eines Fehlerberichts bitte prüfen, ob dasselbe Problem bereits gemeldet wurde.
Damit Fehlerberichte präzise und leicht verständlich sind, sollten sie möglichst folgende Eigenschaften haben:
-
Konkret. Möglichst viele Einzelheiten angeben: Version, Umgebung, Konfiguration usw. Bei Fehlern im Betrieb des etcd-Servers bitte das etcd-Protokoll beifügen (besonders wichtig ist das Startprotokoll mit der etcd-Konfiguration).
-
Reproduzierbar. Die Schritte zum Reproduzieren des Problems angeben. Wir wissen, dass sich manche Probleme nur schwer reproduzieren lassen; in solchen Fällen bitte die Schritte angeben, die zum Problem führen könnten. Wenn möglich, dem Fehlerbericht das betroffene etcd-Datenverzeichnis und den Stacktrace beifügen.
-
Isoliert. Den Fehler möglichst mit einem Minimum an Abhängigkeiten isolieren und reproduzieren. Zu viele Abhängigkeiten in einem Fehlerbericht verlangsamen die Behebung erheblich. Die Fehlersuche in externen Systemen, die etcd verwenden, liegt außerhalb unseres Zuständigkeitsbereichs. Wir geben aber gern Hinweise zur weiteren Suche oder helfen bei der Verwendung von etcd selbst.
-
Einmalig. Keine bereits vorhandenen Fehlerberichte duplizieren.
-
Abgegrenzt. Pro Bericht nur einen Fehler melden. Keinen weiteren Fehler an einen bestehenden Bericht anhängen.
Vor dem Erstellen eines Fehlerberichts kann es hilfreich sein, Elika Etemads Artikel über gute Fehlerberichte zu lesen.
Zur Eingrenzung eines Fehlers fragen wir möglicherweise nach weiteren Informationen. Doppelte Fehlerberichte werden geschlossen.
Häufig gestellte Fragen
Einen Stacktrace abrufen
Die etcd-Version abrufen
etcd-Konfiguration und Protokoll beim Betrieb als systemd-Dienst ‘etcd2.service’ abrufen
Aufgrund eines Fehlers in systemd kann journald die letzten Protokollzeilen verlieren, wenn seine Prozesse enden. Wenn journalctl meldet, dass etcd ohne eine fatal- oder panic-Meldung beendet wurde, mit sudo journalctl -f -t etcd2 versuchen, das vollständige Protokoll abzurufen.
10 - Optimierung
Die Standardeinstellungen von etcd sollten für Installationen in einem lokalen Netzwerk mit geringer durchschnittlicher Netzwerklatenz gut geeignet sein. Beim Einsatz von etcd über mehrere Rechenzentren oder Netzwerke mit hoher Latenz hinweg kann es jedoch nötig sein, das Heartbeat-Intervall und die Wahlzeitüberschreitung anzupassen.
Das Netzwerk ist nicht die einzige Latenzquelle. Langsame Datenträger auf Leader und Follower können jede Anfrage und Antwort beeinträchtigen. Jede dieser Zeitüberschreitungen bezieht sich auf die gesamte Zeit von der Anfrage bis zur erfolgreichen Antwort des anderen Rechners.
Zeitparameter
Das zugrunde liegende verteilte Konsensprotokoll verwendet zwei getrennte Zeitparameter, damit Knoten die Leader-Rolle übergeben können, wenn ein Knoten blockiert oder offline geht. Der erste Parameter heißt Heartbeat-Intervall. Er legt fest, wie oft der Leader seinen Followern mitteilt, dass er weiterhin Leader ist.
Als bewährte Vorgehensweise sollte der Parameter ungefähr auf die Umlaufzeit zwischen den Mitgliedern gesetzt werden. Standardmäßig verwendet etcd ein Heartbeat-Intervall von 100ms.
Der zweite Parameter heißt Wahlzeitüberschreitung. Er legt fest, wie lange ein Follower-Knoten ohne Heartbeat wartet, bevor er selbst versucht, Leader zu werden. Standardmäßig verwendet etcd eine Wahlzeitüberschreitung von 1000ms.
Bei der Anpassung dieser Werte ist eine Abwägung nötig. Für das Heartbeat-Intervall wird ungefähr das Maximum der durchschnittlichen Umlaufzeiten (RTT) zwischen den Mitgliedern empfohlen, in der Regel bei etwa 0.5-1.5x der Umlaufzeit. Ist das Heartbeat-Intervall zu kurz, sendet etcd unnötige Nachrichten und beansprucht dadurch mehr CPU- und Netzwerkressourcen. Ein zu langes Heartbeat-Intervall führt dagegen zu einer langen Wahlzeitüberschreitung. Bei einer längeren Wahlzeitüberschreitung dauert es länger, den Ausfall eines Leaders zu erkennen. Am einfachsten lässt sich die Umlaufzeit (RTT) mit dem PING-Werkzeug messen.
Die Wahlzeitüberschreitung sollte anhand des Heartbeat-Intervalls und der durchschnittlichen Umlaufzeit zwischen den Mitgliedern festgelegt werden. Sie muss mindestens das 10-Fache der Umlaufzeit betragen, um Schwankungen im Netzwerk zu berücksichtigen. Beträgt die Umlaufzeit zwischen den Mitgliedern beispielsweise 10ms, sollte die Wahlzeitüberschreitung mindestens 100ms betragen.
Die Obergrenze der Wahlzeitüberschreitung beträgt 50000ms (50s). Dieser Wert sollte nur bei einem weltweit verteilten etcd-Cluster verwendet werden. Auf dem US-Festland ist eine Umlaufzeit von 130ms realistisch, zwischen den USA und Japan etwa 350-400ms. Bei schwankender Netzwerkleistung oder regelmäßigen Paketverzögerungen bzw. -verlusten können mehrere Wiederholungen nötig sein, um ein Paket erfolgreich zu senden. Daher sind 5s eine sichere Obergrenze für die weltweite Umlaufzeit. Da die Wahlzeitüberschreitung eine Größenordnung über der Broadcast-Zeit liegen sollte, sind bei ~5s für einen weltweit verteilten Cluster 50 Sekunden ein angemessenes Maximum.
Heartbeat-Intervall und Wahlzeitüberschreitung sollten für alle Mitglieder eines Clusters gleich sein. Unterschiedliche Werte für etcd-Mitglieder können die Stabilität des Clusters beeinträchtigen.
Die Standardwerte lassen sich auf der Befehlszeile überschreiben:
Die Werte werden in Millisekunden angegeben.
Snapshots
etcd hängt alle Schlüsseländerungen an eine Protokolldatei an. Dieses Protokoll wächst unbegrenzt und enthält den vollständigen linearen Verlauf aller Änderungen an den Schlüsseln. Für wenig genutzte Cluster eignet sich ein vollständiger Verlauf gut; stark genutzte Cluster müssten jedoch ein großes Protokoll mitführen.
Um ein riesiges Protokoll zu vermeiden, erstellt etcd regelmäßig Snapshots. Sie ermöglichen die Kompaktierung des Protokolls: Der aktuelle Systemzustand wird gespeichert, alte Protokolle werden entfernt.
Snapshots optimieren
Raft-Snapshots werden nach einer konfigurierten Anzahl angewendeter Einträge erstellt; etcd 3.7 verwendet das V2-Backend nicht mehr. Standardmäßig erfolgt dies nach jeweils 10,000 Änderungen. Wenn der Arbeitsspeicher- und Datenträgerverbrauch von etcd zu hoch ist, versuchen, den Snapshot-Schwellenwert mit folgender Befehlszeilenoption zu senken:
Datenträger
Ein etcd-Cluster reagiert sehr empfindlich auf Datenträgerlatenzen. Da etcd Vorschläge dauerhaft in seinem Protokoll speichern muss, können Datenträgerzugriffe anderer Prozesse lange fsync-Latenzen verursachen. Dadurch kann etcd Heartbeats verpassen, was zu Zeitüberschreitungen bei Anfragen und zum vorübergehenden Verlust des Leaders führt. Mit hoher Priorität für Datenträgerzugriffe kann ein etcd-Server unter Umständen stabil neben diesen Prozessen laufen.
Unter Linux lässt sich die Priorität der Datenträgerzugriffe von etcd mit ionice konfigurieren:
Netzwerk
Wenn der etcd-Leader viele gleichzeitige Clientanfragen bedient, kann eine Netzwerküberlastung die Verarbeitung von Peer-Anfragen der Follower verzögern. Dies äußert sich auf den Follower-Knoten in Fehlermeldungen zum Sendepuffer:
Diese Fehler lassen sich möglicherweise beheben, indem der Peer-Verkehr von etcd gegenüber dem Clientverkehr priorisiert wird. Unter Linux kann der Peer-Verkehr mit dem Mechanismus zur Verkehrssteuerung priorisiert werden:
Zum Aufheben von tc Folgendes ausführen:
CPU
Da etcd sehr empfindlich auf Latenz reagiert, lässt sich die Leistung unter Linux weiter optimieren, indem der CPU-Governor auf den Modus performance oder conservative gesetzt wird.
Unter Linux lässt sich der CPU-Governor auf den Modus performance setzen:
11 - Interne Architektur
11.1 - Protokoll des Discovery-Dienstes
Das Protokoll des Discovery-Dienstes hilft einem neuen etcd-Mitglied, während der Clusterinitialisierung alle anderen Mitglieder über ein gemeinsames Discovery-Token und eine Endpunktliste zu finden.
Das Protokoll des Discovery-Dienstes wird nur während der Clusterinitialisierung verwendet. Es kann nicht zur Neukonfiguration im laufenden Betrieb oder zur Clusterüberwachung genutzt werden.
Das Protokoll verwendet ein neues Discovery-Token, um einen eindeutigen etcd-Cluster zu initialisieren. Ein Discovery-Token kann nur einen etcd-Cluster repräsentieren. Sobald das Discovery-Protokoll mit diesem Token startet, darf es nicht zur Initialisierung eines anderen etcd-Clusters verwendet werden, auch wenn der Vorgang auf halbem Weg fehlschlägt.
Der Rest dieses Artikels erläutert den Discovery-Ablauf anhand von Beispielen für einen selbst betriebenen Discovery-Cluster.
Dieses Dokument behandelt ausschließlich v3-Discovery. Einzelheiten zu v2-Discovery enthält die frühere Dokumentation.
Protokollablauf
Das Discovery-Protokoll nutzt einen internen etcd-Cluster, um die Initialisierung eines neuen Clusters zu koordinieren. Zuerst kommunizieren alle neuen Mitglieder mit dem Discovery-Dienst und helfen dabei, die erwartete Mitgliederliste zu erstellen. Anschließend initialisiert jedes neue Mitglied seinen Server anhand dieser Liste. Sie erfüllt dieselbe Funktion wie die Option -initial-cluster.
Im folgenden Beispielablauf wird jeder Protokollschritt zur Veranschaulichung mit einem etcdctl-Befehl dargestellt. Dabei wird angenommen, dass unter http://example.com:2379 ein etcd-Cluster für den Discovery-Dienst läuft.
Das etcd-Discovery-Protokoll verwendet vereinbarungsgemäß das Schlüsselpräfix /_etcd/registry.
Ein neues Discovery-Token erstellen
Ein eindeutiges Token erzeugen, das den neuen Cluster identifiziert. In den folgenden Schritten dient es als eindeutiges Präfix im Discovery-Schlüsselraum. Mit uuidgen lässt es sich einfach erzeugen:
Die erwartete Clustergröße angeben
Für das Discovery-Token muss eine Clustergröße angegeben werden. Anhand dieser Größe erkennt der Discovery-Dienst, wann er alle Mitglieder gefunden hat, die den Cluster anfänglich bilden sollen.
Üblicherweise beträgt die Clustergröße 3, 5 oder 7. Weitere Einzelheiten enthält der Abschnitt zur optimalen Clustergröße .
etcd-Prozesse starten
Das Discovery-Token ${UUID} mit der Option --discovery-token und die Endpunkte des etcd-Clusters hinter dem Discovery-Dienst mit der Option --discovery-endpoints angeben. Damit wird v3-Discovery zur Initialisierung des etcd-Clusters aktiviert.
Wenn die Optionen --discovery-token und --discovery-endpoints angegeben sind, führt jeder etcd-Prozess intern die folgenden Schritte aus.
Wenn der Discovery-Dienst die Authentifizierung mit Client-Zertifikaten aktiviert hat, die folgenden Optionen konfigurieren. Ihre Verwendung entspricht genau der Verwendung von etcdctl zur Kommunikation mit einem etcd-Cluster.
Wenn der Discovery-Dienst rollenbasierte Authentifizierung aktiviert hat, die folgenden Optionen konfigurieren. Ihre Verwendung entspricht genau der Verwendung von etcdctl zur Kommunikation mit einem etcd-Cluster.
Die Standardwerte für Zeitintervalle und Zeitüberschreitungen können ebenfalls über die folgenden Optionen geändert werden. Ihre Verwendung entspricht genau der Verwendung von etcdctl zur Kommunikation mit einem etcd-Cluster.
Selbstregistrierung
Zuerst registriert sich jeder etcd-Prozess als Mitglied des angegebenen neuen Clusters. Dazu legt er seine Mitglieds-ID als Schlüssel unter dem vollständigen Registrierungsschlüssel an.
Status prüfen
Er prüft die erwartete Clustergröße und den Registrierungsstatus und entscheidet dann über den nächsten Schritt.
Wenn noch nicht genügend Mitglieder registriert sind, wartet er auf weitere Mitglieder.
Wenn die Anzahl registrierter Mitglieder die erwartete Größe N übersteigt, gelten die ersten N registrierten Mitglieder als Mitgliederliste des Clusters. Ist das Mitglied selbst in dieser Liste enthalten, ist der Discovery-Vorgang erfolgreich, und es ermittelt alle Peers anhand der Mitgliederliste. Ist es nicht enthalten, endet der Discovery-Vorgang mit der Fehlermeldung, dass der Cluster bereits voll ist.
Das Mitglied kann den Clusterstatus bereits vor seiner Registrierung prüfen. So kann es frühzeitig mit einem Fehler abbrechen, wenn der Cluster bereits voll ist.
Auf alle Mitglieder warten
Der Wartevorgang beobachtet das Schlüsselpräfix /_etcd/registry/${UUID}/members, bis alle Mitglieder gefunden sind.
11.2 - Konventionen für die Protokollierung
etcd verwendet die Bibliothek zap , um Anwendungsausgaben nach Stufen gegliedert zu protokollieren. Die Stufe einer Protokollmeldung richtet sich nach diesen Konventionen:
-
DebugLevel-Meldungen sind meist umfangreich und im Produktivbetrieb üblicherweise deaktiviert.
- Beispiele:
- Eine normale Nachricht an einen entfernten Peer senden
- Einen Protokolleintrag auf den Datenträger schreiben
- Beispiele:
-
InfoLevel ist die standardmäßige Protokollierungspriorität.
- Beispiele:
- Startkonfiguration
- Einen Snapshot beginnen
- Einen neuen Knoten zum Cluster hinzufügen
- Einen neuen Benutzer zum Authentifizierungssubsystem hinzufügen
- Beispiele:
-
WarnLevel-Meldungen sind wichtiger als Info-Meldungen, müssen aber nicht einzeln von einer Person geprüft werden.
- Beispiele:
- Fehler beim Senden einer Raft-Nachricht an einen entfernten Peer
- Keine Heartbeat-Nachricht innerhalb des konfigurierten Wahlzeitlimits empfangen
- Beispiele:
-
ErrorLevel-Meldungen haben hohe Priorität. Wenn eine Anwendung störungsfrei läuft, sollte sie keine Meldungen dieser Stufe erzeugen.
- Beispiele:
- Fehler beim Zuweisen von Datenträgerspeicher für das WAL
- Beispiele:
-
PanicLevel protokolliert eine Meldung und löst anschließend eine Panic aus.
- Beispiele:
- Fehler beim Kodieren von Raft-Nachrichten
- Beispiele:
-
FatalLevel protokolliert eine Meldung und ruft anschließend os.Exit(1) auf.
- Beispiele:
- Fehler beim Speichern eines Raft-Snapshots
- Beispiele:
11.3 - Go-Module
Das etcd-Projekt ist seit Version 3.5 in mehrere Go-Module gegliedert, die in einem gemeinsamen Repository liegen.
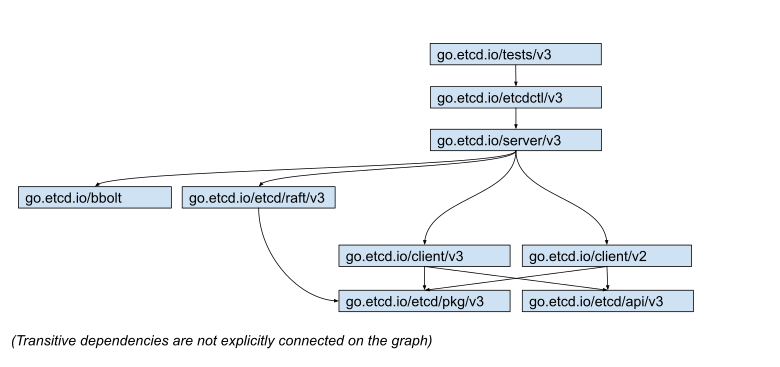
Es gibt folgende Module:
-
go.etcd.io/etcd/api/v3 - enthält API-Definitionen (wie Protos und daraus generierte Bibliotheken), die das Kommunikationsprotokoll zwischen etcd-Clients und -Servern festlegen.
-
go.etcd.io/etcd/pkg/v3 - Sammlung von Hilfspaketen, die etcd verwendet, die jedoch nicht spezifisch für etcd sind. Ein Paket gehört nur dann hierher, wenn es künftig in ein eigenes Repository ausgelagert werden könnte. Hier sollte kein Code mit vielen eigenen Abhängigkeiten hinzugefügt werden, da diese automatisch zu Abhängigkeiten der Client-Bibliothek werden, die wir schlank halten möchten.
-
go.etcd.io/etcd/client/v3 - Client-Bibliothek für den Zugriff auf etcd über das Netzwerk (grpc). Für alle neuen Anwendungen von etcd empfohlen.
-
go.etcd.io/etcd/client/v2 - alte Client-Bibliothek für den Zugriff auf etcd über das HTTP-Protokoll. Veraltet. Alle neuen Anwendungen sollten die Bibliothek /v3 verwenden.
-
go.etcd.io/etcd/raft/v3 - Implementierung des verteilten Konsensprotokolls. Sollte keinen etcd-spezifischen Code enthalten.
-
go.etcd.io/etcd/server/v3 - etcd-Implementierung. Der Code in diesem Paket ist für den internen Gebrauch in etcd bestimmt und sollte von externen Projekten nicht verwendet werden. Der Paketaufbau und die API können sich innerhalb von Minor-Versionen ändern.
-
go.etcd.io/etcd/etcdctl/v3 - ein Befehlszeilenwerkzeug für den Zugriff auf und die Verwaltung von etcd.
-
go.etcd.io/etcd/tests/v3 - ein Modul mit allen Integrationstests von etcd. Hinweis: Alle Unit-Tests, die schnell sind und keine modulübergreifenden Abhängigkeiten benötigen, sollten in den jeweiligen Modulen beim getesteten Code liegen.
-
go.etcd.io/bbolt - Implementierung eines persistenten B-Baums. Liegt in einem separaten Repository: https://github.com/etcd-io/bbolt .
Abläufe
-
Alle etcd-Module sollten mit denselben Versionen veröffentlicht werden, z. B. muss
go.etcd.io/etcd/client/v3@v3.5.10vongo.etcd.io/etcd/api/v3@v3.5.10abhängen.Die Versionen lassen sich mit folgendem Befehl einheitlich aktualisieren:
-
Veröffentlichte Module sollten gemäß den Regeln unter https://golang.org/ref/mod#vcs-version mit Tags versehen werden. Jedes Modul sollte also einen eigenen Tag erhalten. Die Tags lassen sich mit folgendem Befehl setzen:
-
Alle etcd-Module sollten dieselben Versionen ihrer zugrunde liegenden Abhängigkeiten verwenden. Dies lässt sich folgendermaßen überprüfen:
-
Die go.mod-Dateien dürfen keine ungenutzten Abhängigkeiten enthalten und müssen dem Format von
go mod tidyentsprechen. Dies wird folgendermaßen überprüft: -
Um Aktionen über alle Module hinweg auszuführen, etwa alle Dateien automatisch zu formatieren, das folgende Skript verwenden oder erweitern:
Zukunft
Als langfristiges Ziel möchten wir die Entwicklung der etcd-Module hin zum folgenden Modell prüfen:
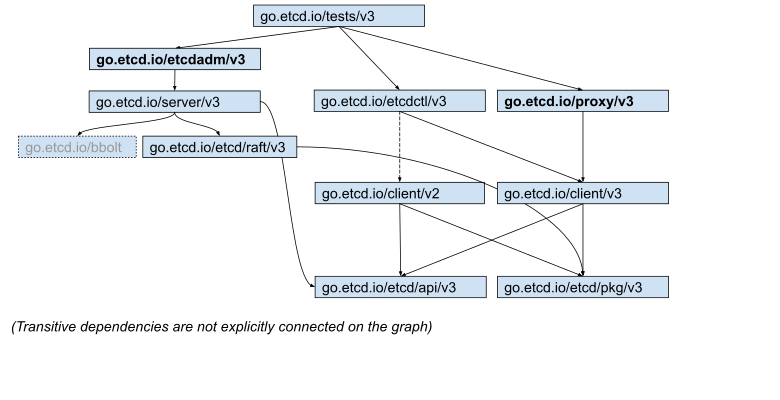
Dies setzt Folgendes voraus:
- etcdmigrate/etcdadm aus der etcdctl-Binärdatei ausgliedern. Dadurch würde etcdctl klar zu einer Befehlszeilenhülle für die Netzwerk-Client-API, während etcdmigrate/etcdadm direkte physische Operationen auf den Speicherdateien von etcd unterstützen würden.
- etcd-proxy aus der Binärdatei ./etcd ausgliedern, da er mehr experimentellen Code und somit zusätzliche Risiken und Abhängigkeiten enthält.
- Die Unterstützung des v2-Protokolls als veraltet einstufen.
12 - Grundlagen
12.1 - Datenmodell
etcd ist darauf ausgelegt, selten aktualisierte Daten zuverlässig zu speichern und zuverlässige Watch-Abfragen bereitzustellen. etcd macht frühere Versionen von Schlüssel-Wert-Paaren zugänglich, um kostengünstige Snapshots und die Beobachtung historischer Ereignisse zu ermöglichen („Zeitreiseabfragen“). Ein persistentes Datenmodell mit Mehrversions-Nebenläufigkeitskontrolle eignet sich gut für diese Anwendungsfälle.
etcd speichert Daten in einem persistenten Schlüssel-Wert-Speicher mit mehreren Versionen. Dieser bewahrt die vorherige Version eines Schlüssel-Wert-Paars auf, wenn dessen Wert durch neue Daten ersetzt wird. Der Schlüssel-Wert-Speicher ist praktisch unveränderlich: Seine Operationen aktualisieren die Struktur nicht an Ort und Stelle, sondern erzeugen stets eine neue, aktualisierte Struktur. Alle früheren Versionen von Schlüsseln bleiben nach einer Änderung zugänglich und können beobachtet werden. Damit der Datenspeicher nicht unbegrenzt wächst und alte Versionen dauerhaft vorhält, kann er kompaktiert werden, um die ältesten Versionen ersetzter Daten zu entfernen.
Logische Sicht
Die logische Sicht auf den Speicher ist ein flacher binärer Schlüsselraum. Ein lexikalisch sortierter Index über Schlüssel aus Bytefolgen ermöglicht kostengünstige Bereichsabfragen.
Der Schlüsselraum verwaltet mehrere Revisionen. Beim Anlegen des Speichers ist die erste Revision 1. Jede atomare ändernde Operation erzeugt eine neue Revision des Schlüsselraums; eine Transaktionsoperation kann beispielsweise mehrere Operationen enthalten. Alle Daten früherer Revisionen bleiben unverändert. Alte Schlüsselversionen sind über frühere Revisionen weiterhin zugänglich. Auch die Revisionen sind indiziert, sodass Watcher effizient Revisionsbereiche durchlaufen können. Wird der Speicher zur Platzersparnis kompaktiert, werden die Revisionen vor der Kompaktierungsrevision entfernt. Revisionen steigen während der gesamten Lebensdauer eines Clusters monoton an.
Das Leben eines Schlüssels umfasst eine Generation von der Erstellung bis zur Löschung. Jeder Schlüssel kann eine oder mehrere Generationen haben. Das Anlegen eines Schlüssels erhöht seine Version, beginnend bei 1, falls der Schlüssel in der aktuellen Revision nicht existiert. Das Löschen erzeugt einen Tombstone für den Schlüssel und beendet dessen aktuelle Generation, indem seine Version auf 0 zurückgesetzt wird. Jede Änderung eines Schlüssels erhöht seine Version. Versionen steigen daher innerhalb einer Schlüsselgeneration monoton an. Bei einer Kompaktierung werden alle Generationen entfernt, die vor der Kompaktierungsrevision endeten. Auch alle vor dieser Revision gesetzten Werte außer dem jeweils neuesten werden entfernt.
Physische Sicht
etcd speichert die physischen Daten als Schlüssel-Wert-Paare in einem persistenten B+-Baum . Aus Effizienzgründen enthält jede Revision des Speicherzustands nur die Differenz zur vorherigen Revision. Einer einzelnen Revision können mehrere Schlüssel im Baum entsprechen.
Der Schlüssel eines Schlüssel-Wert-Paars ist ein 3-Tupel (major, sub, type). Major ist die Speicherrevision, die den Schlüssel enthält. Sub unterscheidet Schlüssel innerhalb derselben Revision. Type ist ein optionales Suffix für besondere Werte, etwa t, wenn der Wert einen Tombstone enthält. Der Wert des Schlüssel-Wert-Paars enthält die Änderung gegenüber der vorherigen Revision, also eine Differenz zu ihr. Der B+-Baum ist lexikalisch nach den Bytes der Schlüssel sortiert. Bereichssuchen über Revisionsdifferenzen sind schnell; so lassen sich Änderungen zwischen zwei bestimmten Revisionen rasch ermitteln. Die Kompaktierung entfernt veraltete Schlüssel-Wert-Paare.
etcd hält außerdem einen sekundären B-Baum -Index im Arbeitsspeicher, um Bereichsabfragen über Schlüssel zu beschleunigen. Die Schlüssel in diesem Index sind die für Benutzer sichtbaren Schlüssel des Speichers. Der Wert ist ein Zeiger auf die Änderung im persistenten B+-Baum. Die Kompaktierung entfernt ungültig gewordene Zeiger.
etcd ermittelt also die Revisionsinformationen aus dem B-Baum und verwendet anschließend die Revision als Schlüssel, um den Wert aus dem B+-Baum abzurufen (siehe unten).
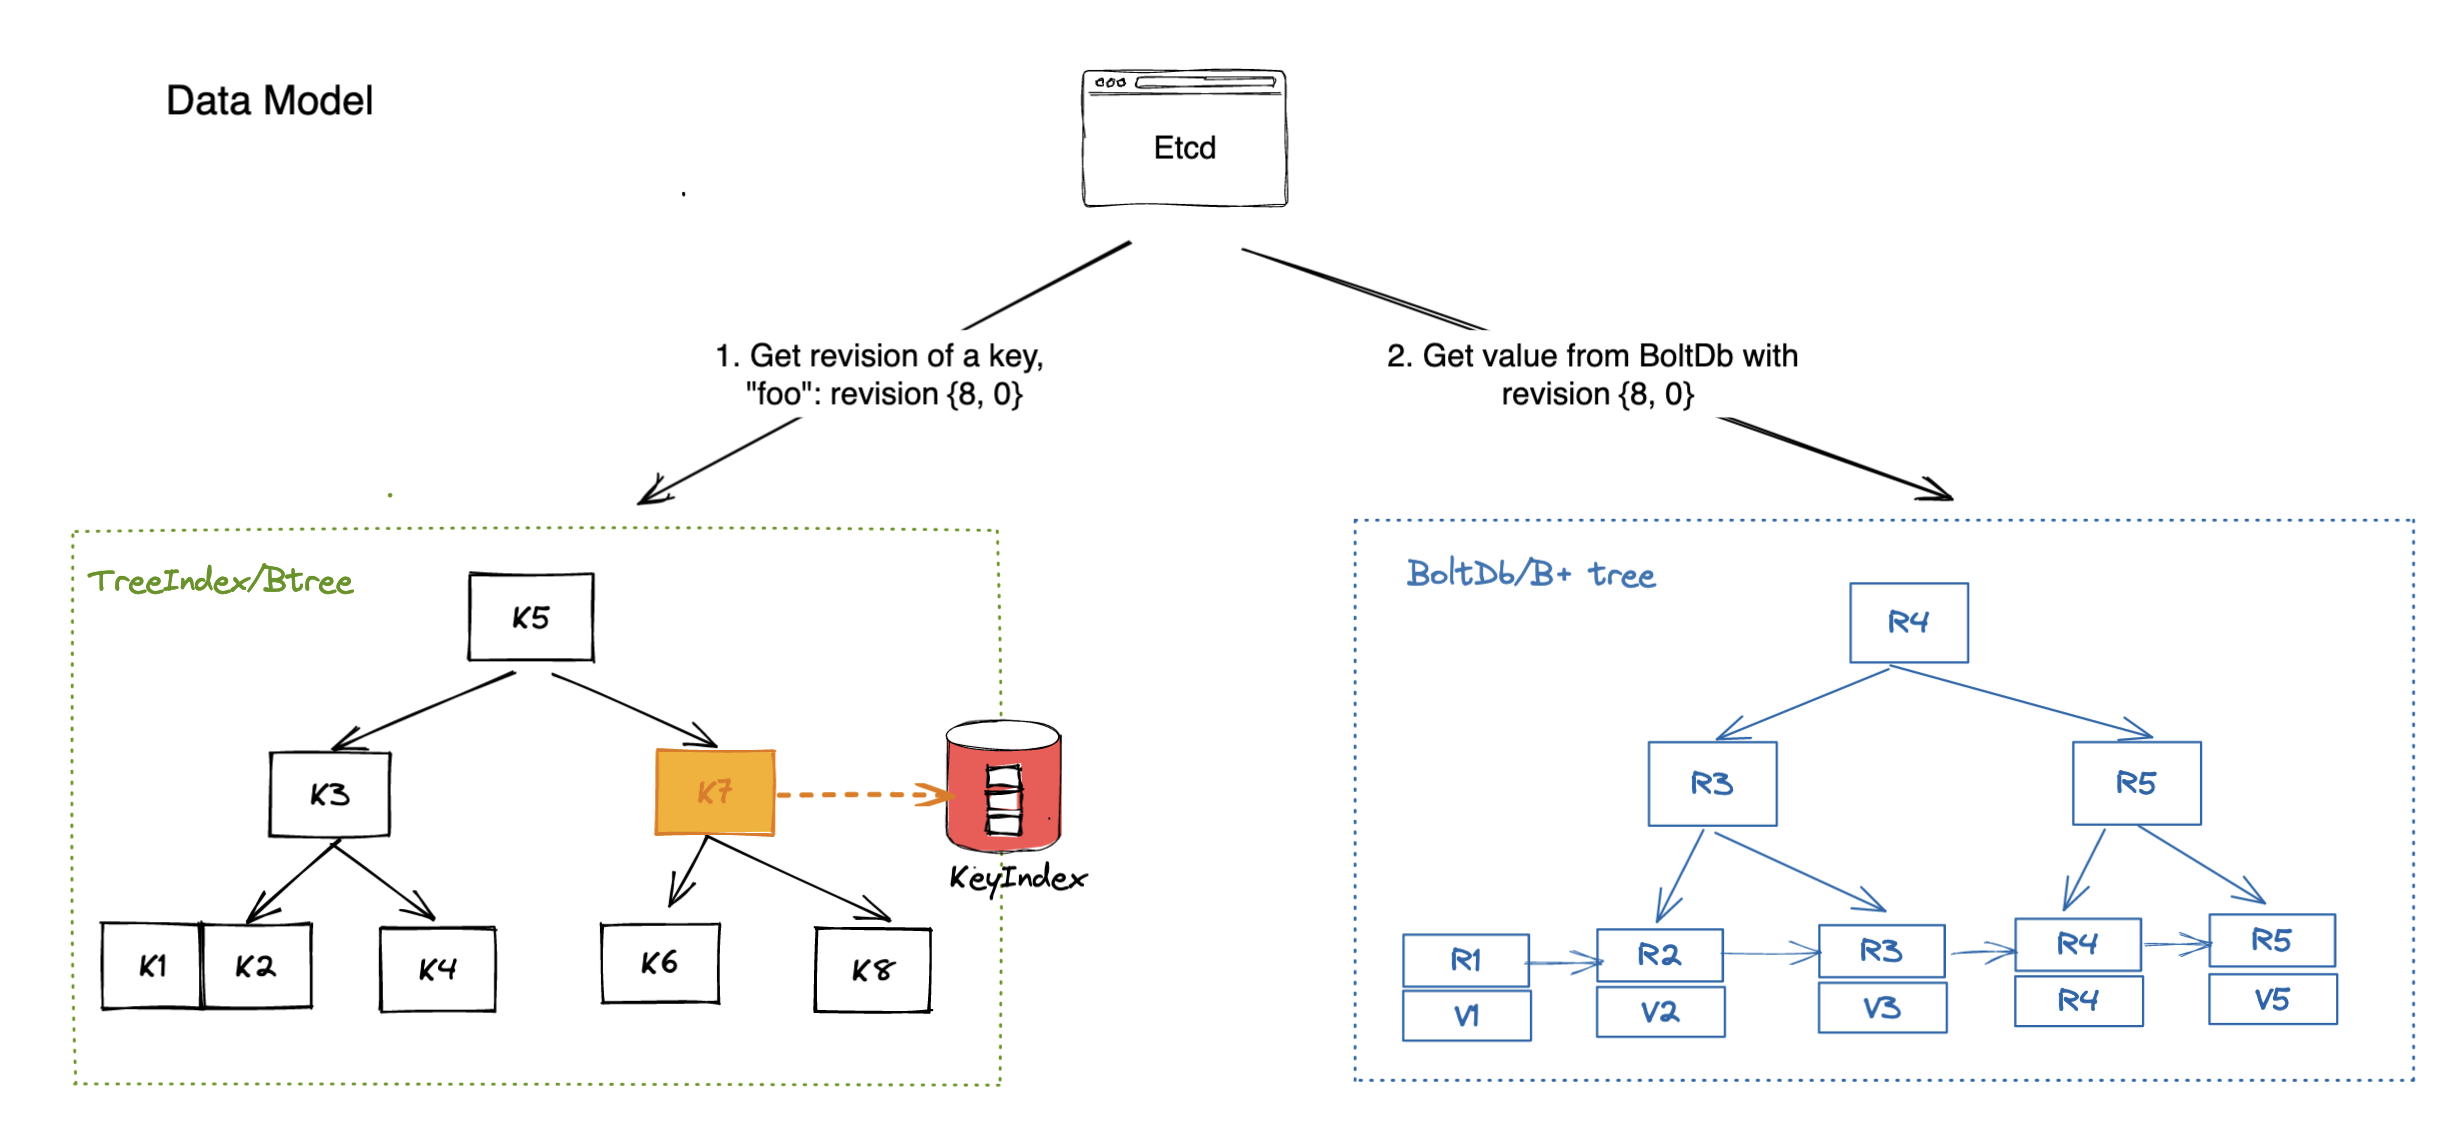
12.2 - Design des etcd-Clients
Design des etcd-Clients
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Einleitung
Der etcd-Server hat seine Robustheit in jahrelangen Tests mit gezielt ausgelösten Fehlern bewiesen. Die meiste komplexe Anwendungslogik übernimmt bereits der etcd-Server mit seinen Datenspeichern. Beispielsweise bleibt die Clustermitgliedschaft für Clients transparent, da die Raft-Schicht Vorschläge an den Leader weiterleitet. Auch wenn die Serverkomponenten korrekt arbeiten, erfordert ihr Zusammenspiel mit dem Client weitere komplexe Protokolle, um Korrektheit und Hochverfügbarkeit auch bei Fehlern zu gewährleisten. Idealerweise bietet der etcd-Server eine einzige logische Clustersicht auf viele physische Rechner, während der Client automatisches Failover zwischen Replikaten implementiert. Dieses Dokument beschreibt die Architekturentscheidungen des Clients und die Details ihrer Implementierung.
Glossar
clientv3: Offizieller Go-Client von etcd für die etcd-v3-API.
clientv3-grpc1.0: Offizielle Client-Implementierung mit grpc-go v1.0.x
, die in der neuesten Version von etcd v3.1 verwendet wird.
clientv3-grpc1.7: Offizielle Client-Implementierung mit grpc-go v1.7.x
, die in den neuesten Versionen von etcd v3.2 und v3.3 verwendet wird.
clientv3-grpc1.23: Offizielle Client-Implementierung mit grpc-go v1.23.x
, die in der neuesten Version von etcd v3.4 verwendet wird.
Load-Balancer: Lastverteiler des etcd-Clients, der Wiederholungs- und Failover-Mechanismen implementiert. Der etcd-Client sollte die Last automatisch auf mehrere Endpunkte verteilen.
Endpunkte: Eine Liste von etcd-Serverendpunkten, mit denen sich Clients verbinden können. Üblicherweise sind dies 3 oder 5 Client-URLs eines etcd-Clusters.
Fest zugeordneter Endpunkt: Bei mehreren konfigurierten Endpunkten wählt der Client-Load-Balancer in Versionen <= v3.3 nur einen Endpunkt für eine TCP-Verbindung aus, um die Gesamtzahl offener Verbindungen zum etcd-Cluster gering zu halten. In v3.4 wechselt der Load-Balancer für jede Anfrage im Round-Robin-Verfahren zwischen den fest zugeordneten Endpunkten und verteilt die Last dadurch gleichmäßiger.
Client-Verbindung: Eine über gRPC Dial aufgebaute TCP-Verbindung zu einem etcd-Server.
Unterverbindung: Die gRPC-Schnittstelle SubConn. Jede Unterverbindung enthält eine Adressliste. Der Load-Balancer erstellt aus einer Liste aufgelöster Adressen eine SubConn. Eine gRPC ClientConn kann mehreren SubConn entsprechen, etwa wenn example.com auf 10.10.10.1 und 10.10.10.2 zweier Unterverbindungen aufgelöst wird. Der Load-Balancer von etcd v3.4 verwendet einen internen Resolver, um für jeden Endpunkt eine Unterverbindung aufzubauen.
Vorübergehender Verbindungsabbruch: Wenn der gRPC-Server einen Statusfehler vom Typ code Unavailable
zurückgibt.
Anforderungen an den Client
Korrektheit. Bei Serverfehlern können Anfragen fehlschlagen. Konsistenzgarantien werden jedoch nie verletzt: Eigenschaften der globalen Reihenfolge, kein Schreiben beschädigter Daten, At-most-once-Semantik für ändernde Operationen, keine Beobachtung unvollständiger Ereignisse durch Watches usw.
Fortschrittsgarantie. Server können ausfallen oder kurzzeitig die Verbindung verlieren. Clients sollten in beiden Fällen Fortschritte machen. Sie sollten beim Warten auf die Rückkehr eines offline gegangenen Servers niemals dauerhaft blockieren , sofern dies nicht ausdrücklich konfiguriert ist. Idealerweise erkennen Clients nicht verfügbare Server mit HTTP/2-Pings und wechseln mit verständlichen Fehlermeldungen zu anderen Knoten.
Effizienz. Clients sollten mit minimalem Ressourcenverbrauch wirksam arbeiten: Nach einem Endpunktwechsel sollten vorherige TCP-Verbindungen geordnet geschlossen werden. Der Failover-Mechanismus sollte das nächste geeignete Replikat für eine Verbindung bestimmen, ohne Ressourcen durch wiederholte Versuche an ausgefallenen Knoten zu verschwenden.
Portierbarkeit. Der offizielle Client sollte klar dokumentiert sein, und seine Implementierung sollte sich auf Anbindungen anderer Sprachen übertragen lassen. Die Fehlerbehandlung sollte über die Sprachanbindungen hinweg konsistent sein. Da etcd vollständig auf gRPC setzt, sollte sich die Implementierung eng an den langfristigen Entwurfszielen von gRPC orientieren. Beispielsweise sollte eine austauschbare Wiederholungsrichtlinie mit gRPC-Wiederholungen kompatibel sein. Upgrades zwischen zwei Client-Versionen sollten den Betrieb nicht unterbrechen.
Client-Überblick
Der etcd-Client implementiert die folgenden Komponenten:
- einen Load-Balancer, der gRPC-Verbindungen zu einem etcd-Cluster aufbaut,
- einen API-Client, der RPCs an einen etcd-Server sendet, und
- eine Fehlerbehandlung, die entscheidet, ob eine fehlgeschlagene Anfrage wiederholt oder der Endpunkt gewechselt wird.
Sprachen können sich darin unterscheiden, wie die erste Verbindung aufgebaut wird, etwa durch TLS-Konfiguration, wie Protocol-Buffer-Nachrichten kodiert und an den Server gesendet werden, wie Streaming-RPCs verarbeitet werden usw. Die vom etcd-Server zurückgegebenen Fehler sind jedoch dieselben. Entsprechend sollten auch Fehlerbehandlung und Wiederholungsrichtlinie gleich sein.
Beispielsweise kann der etcd-Server "rpc error: code = Unavailable desc = etcdserver: request timed out" zurückgeben, einen vorübergehenden Fehler, bei dem Wiederholungen erwartet werden. Oder er gibt rpc error: code = InvalidArgument desc = etcdserver: key is not provided zurück. Dies bedeutet, dass die Anfrage ungültig war und nicht wiederholt werden sollte. Der Go-Client kann Fehler mit google.golang.org/grpc/status.FromError auswerten, der Java-Client mit io.grpc.Status.fromThrowable.
clientv3-grpc1.0: Überblick über den Load-Balancer
Bei mehreren konfigurierten etcd-Endpunkten hält clientv3-grpc1.0 mehrere TCP-Verbindungen offen. Anschließend wählt er eine Adresse und sendet darüber alle Client-Anfragen. Die fest zugeordnete Adresse bleibt erhalten, bis das Client-Objekt geschlossen wird (siehe Abbildung 1). Wenn der Client einen Fehler erhält, wählt er zufällig eine andere Adresse und versucht es erneut.
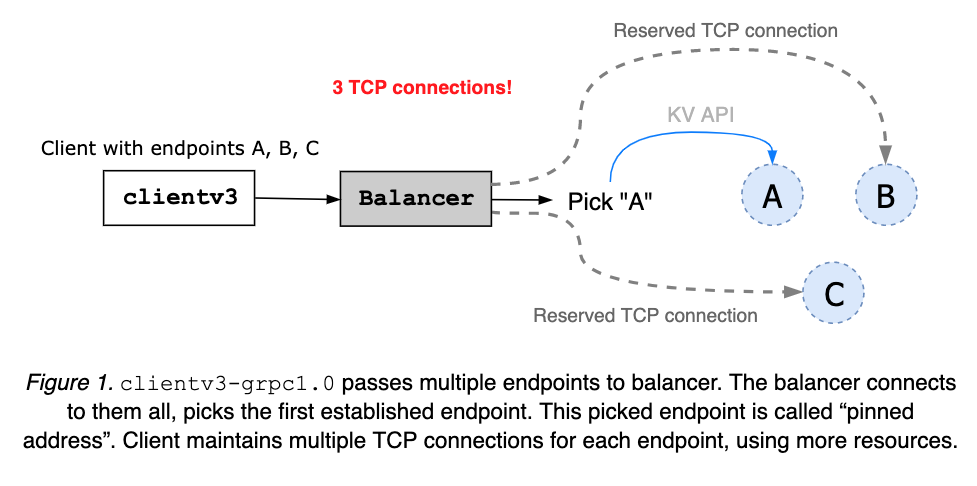
clientv3-grpc1.0: Einschränkungen des Load-Balancers
Die mehreren TCP-Verbindungen von clientv3-grpc1.0 können ein schnelleres Failover des Load-Balancers ermöglichen, benötigen aber mehr Ressourcen. Der Load-Balancer kennt weder den Zustand der Knoten noch ihre Clustermitgliedschaft. Daher kann er an einem ausgefallenen oder durch eine Netzwerkpartition abgetrennten Knoten hängen bleiben.
clientv3-grpc1.7: Überblick über den Load-Balancer
clientv3-grpc1.7 hält nur eine TCP-Verbindung zu einem ausgewählten etcd-Server offen. Bei mehreren angegebenen Clusterendpunkten versucht ein Client zunächst, sich mit allen zu verbinden. Sobald eine Verbindung steht, ordnet der Load-Balancer die Adresse fest zu und schließt die anderen Verbindungen (siehe Abbildung 2). Die Adresse soll zugeordnet bleiben, bis das Client-Objekt geschlossen wird. Ein Fehler des Servers oder des Client-Netzwerks wird an die Fehlerbehandlung des Clients weitergeleitet (siehe Abbildung 3).
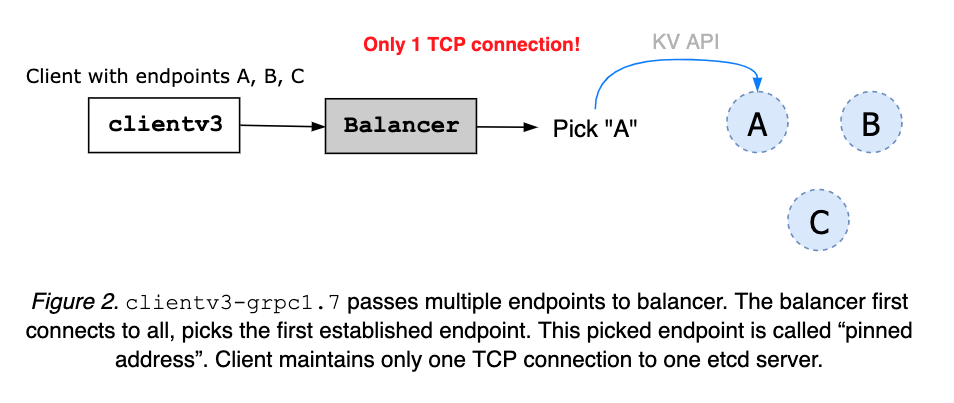
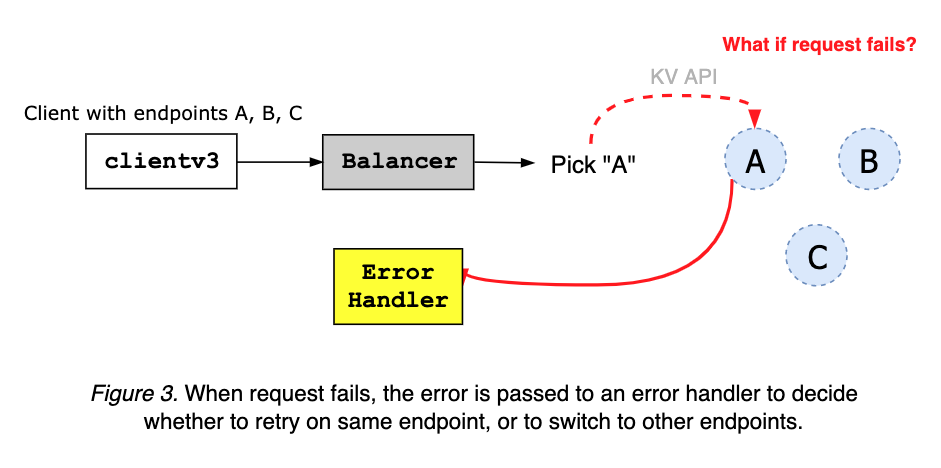
Die Fehlerbehandlung des Clients erhält einen Fehler vom gRPC-Server und entscheidet anhand von Fehlercode und Meldung, ob dieselbe Anfrage am selben Endpunkt wiederholt oder zu einer anderen Adresse gewechselt wird (siehe Abbildung 4 und Abbildung 5).
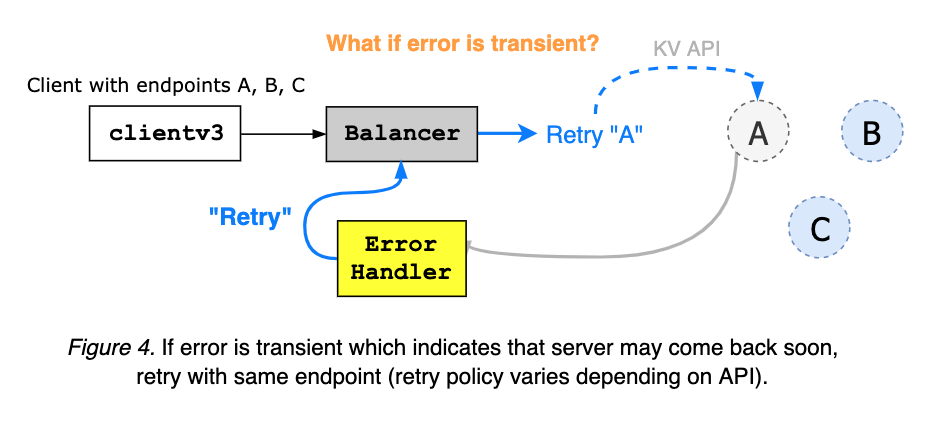
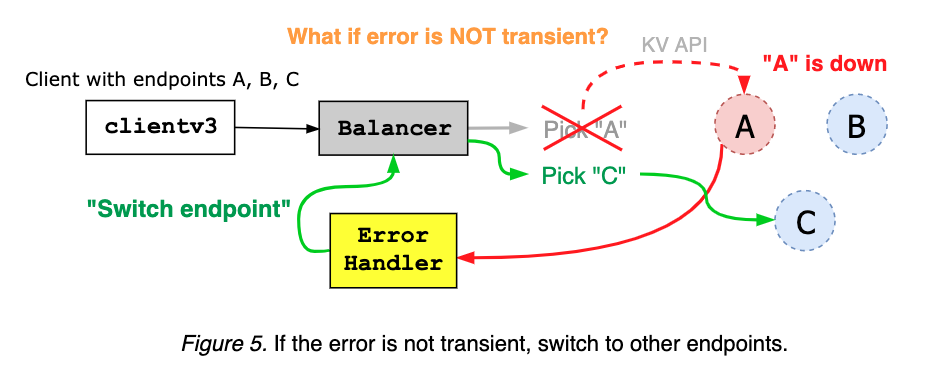
Streaming-RPCs wie Watch und KeepAlive werden häufig ohne Zeitlimit angefordert. Stattdessen kann der Client regelmäßig HTTP/2-Pings senden, um den Zustand eines fest zugeordneten Endpunkts zu prüfen. Antwortet der Server nicht auf den Ping, wechselt der Load-Balancer zu anderen Endpunkten (siehe Abbildung 6).
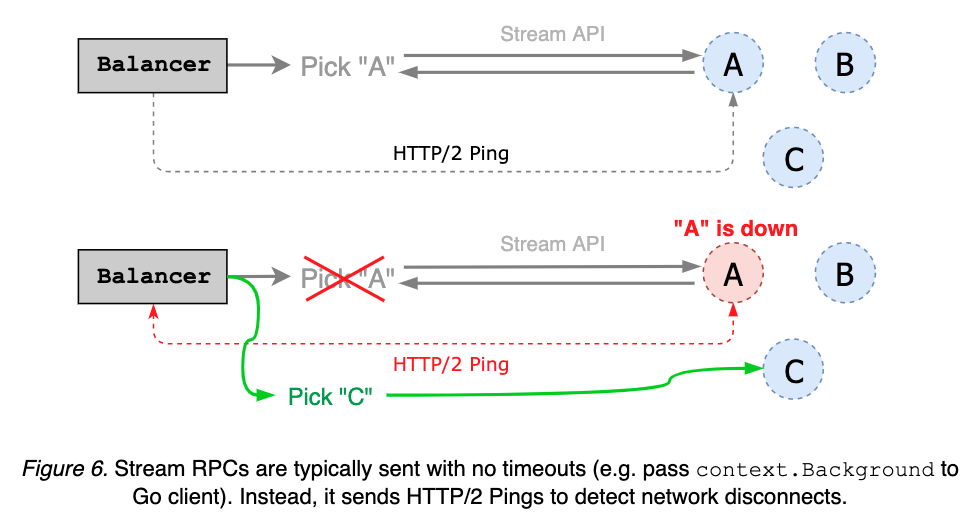
clientv3-grpc1.7: Einschränkungen des Load-Balancers
Der Load-Balancer von clientv3-grpc1.7 sendet HTTP/2-Keepalives, um Verbindungsabbrüche bei Streaming-Anfragen zu erkennen. Dieser einfache Ping-Mechanismus für gRPC-Server berücksichtigt keine Clustermitgliedschaft und kann daher Netzwerkpartitionen nicht erkennen. Da ein abgetrennter gRPC-Server weiterhin auf Client-Pings antworten kann, kann der Load-Balancer an diesem Knoten hängen bleiben. Idealerweise erkennt der Keepalive-Ping die Partition und löst vor Ablauf des Anfragezeitlimits einen Endpunktwechsel aus (siehe etcd#8673
und Abbildung 7).
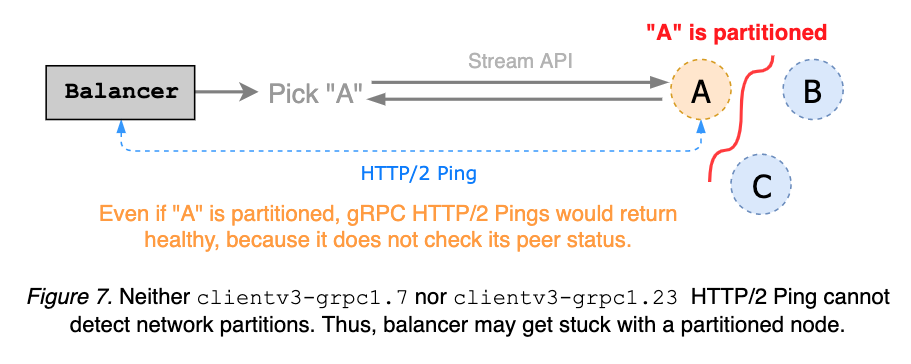
Der Load-Balancer von clientv3-grpc1.7 führt eine Liste nicht funktionsfähiger Endpunkte. Adressen mit abgebrochener Verbindung werden dieser Liste hinzugefügt und gelten bis zum Ende einer Wartezeit als nicht verfügbar. Diese Wartezeit ist fest an das Verbindungsaufbau-Zeitlimit mit einem Standardwert von 5 Sekunden gekoppelt. Der Load-Balancer kann Endpunkte fälschlich als nicht funktionsfähig einstufen. Beispielsweise kann Endpunkt A unmittelbar nach Aufnahme in die Sperrliste zurückkehren, bleibt aber dennoch für die nächsten 5 Sekunden unbenutzbar (siehe Abbildung 8).
clientv3-grpc1.0 hatte dieselben oben beschriebenen Probleme.
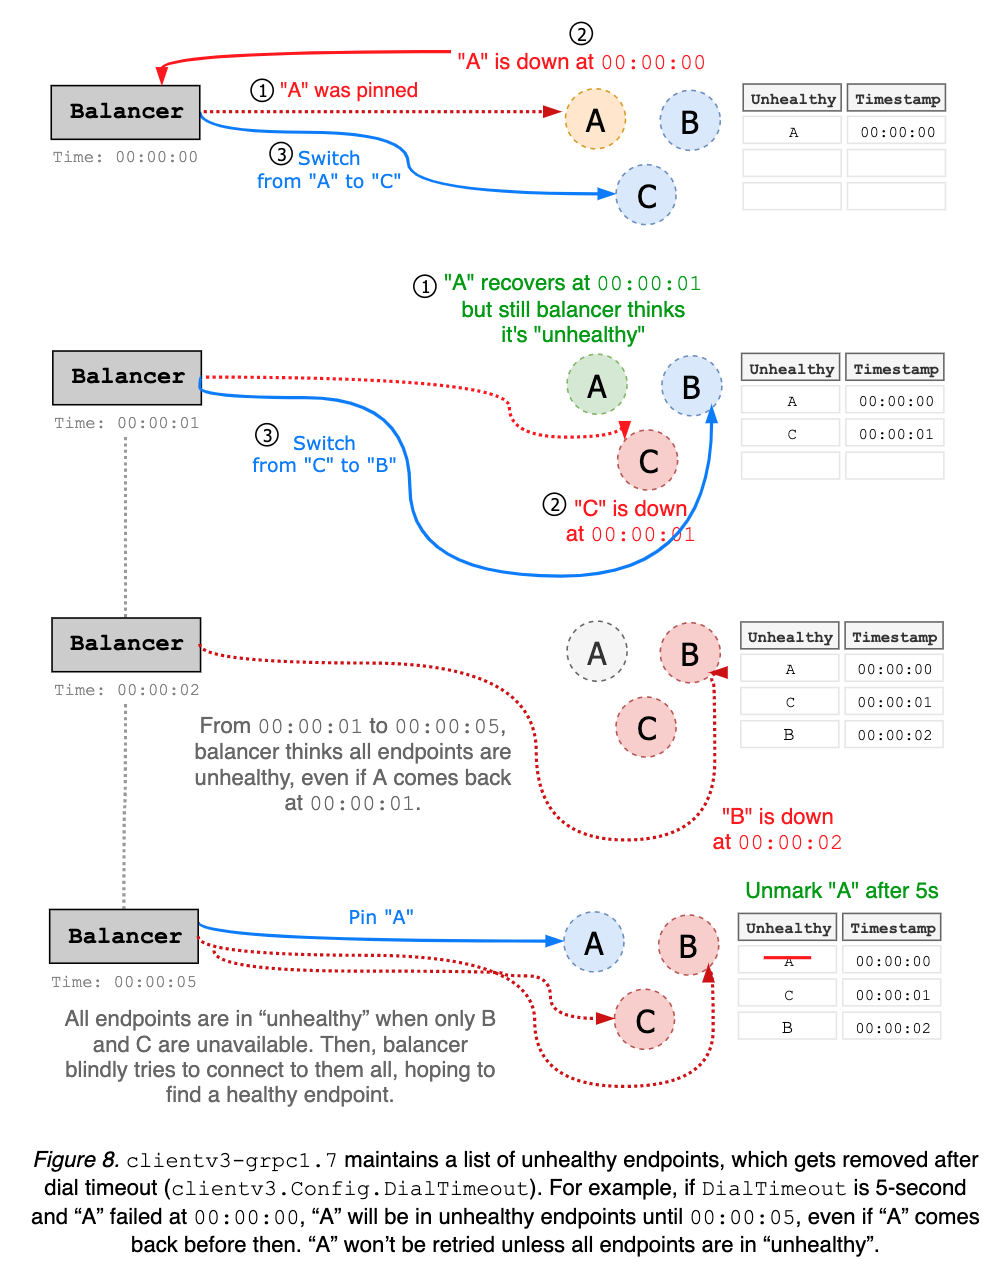
Das Upstream-Projekt gRPC Go war bereits auf die neue Load-Balancer-Schnittstelle umgestiegen. So verwendet die zugrunde liegende Implementierung von clientv3-grpc1.7 den neuen gRPC-Load-Balancer und versucht dabei, das Verhalten des alten beizubehalten. Obwohl die Kompatibilität recht gut erhalten blieb, war der etcd-Client dennoch von subtilen inkompatiblen Änderungen betroffen
. Zudem empfiehlt der gRPC-Maintainer, sich nicht auf die alte Load-Balancer-Schnittstelle zu stützen
. Für bessere Unterstützung durch Upstream ist es generell am besten, mit den neuesten gRPC-Versionen Schritt zu halten. Neue Funktionen wie Wiederholungsrichtlinien werden möglicherweise nicht auf den gRPC-1.7-Zweig zurückportiert. Daher müssen sowohl etcd-Server als auch -Client auf die neuesten gRPC-Versionen umsteigen.
clientv3-grpc1.23: Überblick über den Load-Balancer
clientv3-grpc1.7 ist so eng an die alte gRPC-Schnittstelle gekoppelt, dass jedes Upgrade der gRPC-Abhängigkeit das Client-Verhalten beeinträchtigte. Der Großteil der Entwicklungs- und Fehlersucharbeit floss in die Behebung dieser Verhaltensänderungen. Dadurch wurde die Implementierung übermäßig komplex und beruhte auf falschen Annahmen über Serververbindungen.
Das Hauptziel von clientv3-grpc1.23 ist eine einfachere Failover-Logik des Load-Balancers. Statt eine möglicherweise veraltete Liste nicht funktionsfähiger Endpunkte zu führen, wechselt er bei jedem Verbindungsabbruch zum aktuellen Endpunkt im Round-Robin-Verfahren zum nächsten. Er trifft keine Annahmen über den Endpunktzustand. Eine komplexe Zustandsverfolgung ist daher nicht mehr nötig (siehe Abbildung 8 und die vorangehenden Erläuterungen). Ein Upgrade auf clientv3-grpc1.23 sollte problemlos sein: Alle Änderungen waren intern und bewahrten die vollständige Abwärtskompatibilität.
Bei mehreren Endpunkten erstellt clientv3-grpc1.23 intern mehrere Unterverbindungen, eine pro Endpunkt. clientv3-grpc1.7 erstellt dagegen nur eine Verbindung zu einem fest zugeordneten Endpunkt (siehe Abbildung 9). In einem Cluster mit 5 Knoten benötigt der Load-Balancer von clientv3-grpc1.23 beispielsweise 5 TCP-Verbindungen, während clientv3-grpc1.7 nur eine benötigt. Durch den erhaltenen TCP-Verbindungspool kann clientv3-grpc1.23 mehr Ressourcen verbrauchen, bietet aber eine flexiblere Lastverteilung mit besserer Failover-Leistung. Standardmäßig wird Round Robin verwendet; andere Verfahren wie „Power of Two“ oder die Auswahl des Leaders lassen sich leicht ergänzen. clientv3-grpc1.23 verwendet eine gRPC-Resolver-Gruppe und implementiert eine Auswahlrichtlinie für den Load-Balancer, um die komplexe Lastverteilung an Upstream-gRPC zu delegieren. clientv3-grpc1.7 verwaltet dagegen jede gRPC-Verbindung und das Failover selbst, was die Implementierung verkompliziert. clientv3-grpc1.23 implementiert Wiederholungen in der gRPC-Interceptor-Kette, die interne gRPC-Fehler automatisch behandelt und fortgeschrittene Wiederholungsrichtlinien wie Backoff ermöglicht. clientv3-grpc1.7 wertet gRPC-Fehler für Wiederholungen dagegen selbst aus.
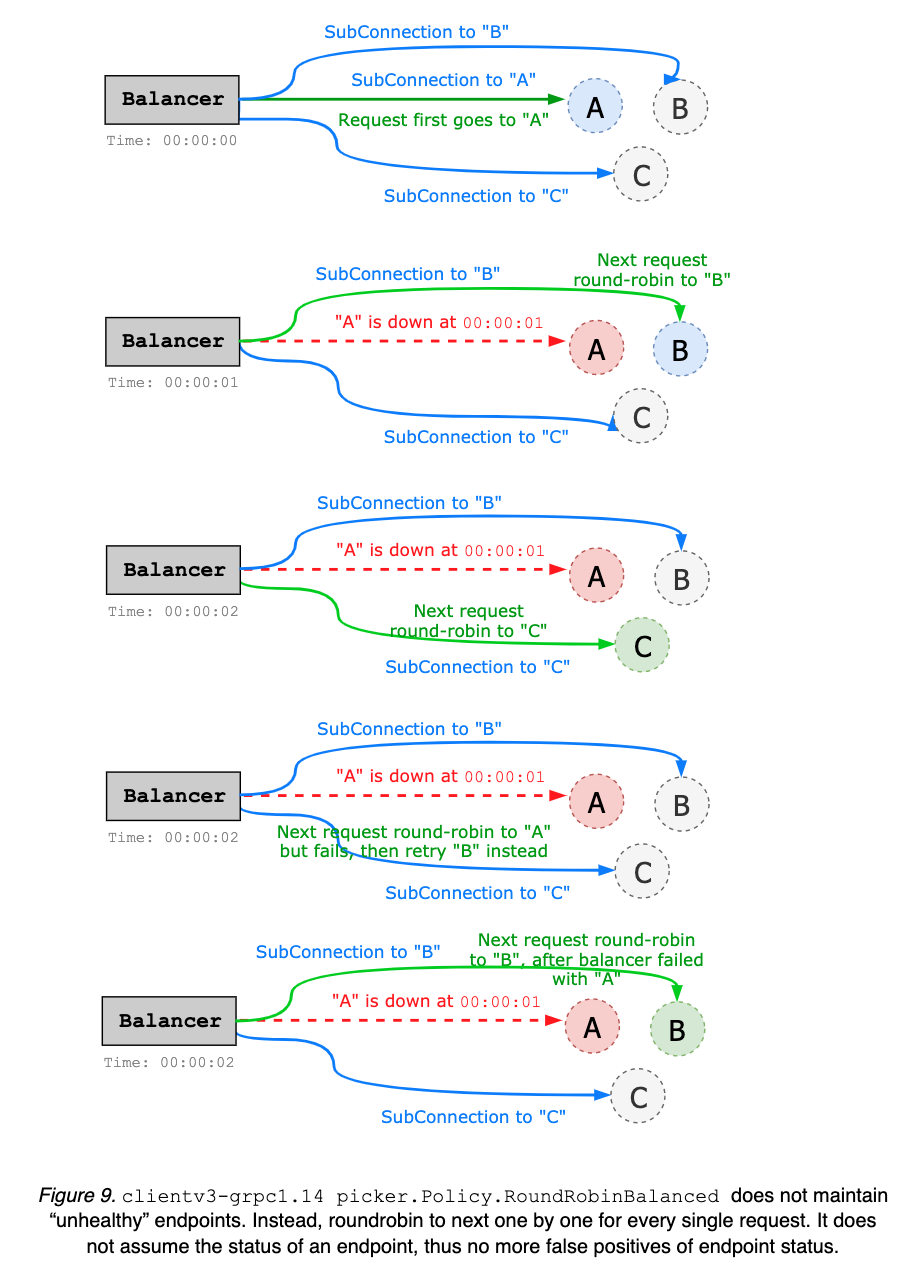
clientv3-grpc1.23: Einschränkungen des Load-Balancers
Verbesserungen sind durch Zwischenspeichern des Zustands jedes Endpunkts möglich. Beispielsweise kann der Load-Balancer vorab jeden Server anpingen, um eine Liste funktionsfähiger Kandidaten zu führen und diese Informationen beim Round-Robin-Verfahren zu nutzen. Oder er kann nach einem Verbindungsabbruch funktionsfähige Endpunkte bevorzugen. Dies kann die Implementierung verkomplizieren und deshalb in späteren Versionen behandelt werden.
Der clientseitige Keepalive-Ping berücksichtigt weiterhin keine Netzwerkpartitionen. Streaming-Anfragen können an einem abgetrennten Knoten hängen bleiben. Um die Clustermitgliedschaft zu berücksichtigen, muss ein erweiterter Health-Check-Dienst implementiert werden (Einzelheiten unter etcd#8673 ).
Derzeit wird die Wiederholungslogik manuell als Interceptor umgesetzt. Dies kann durch offizielle gRPC-Wiederholungen vereinfacht werden.
12.3 - Design der Learner in etcd
Learner in etcd
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Hintergrund
Die Neukonfiguration der Clustermitgliedschaft zählt zu den größten Herausforderungen im Betrieb. Im Folgenden werden häufige Schwierigkeiten betrachtet.
1. Ein neues Clustermitglied überlastet den Leader
Ein neu beigetretenes etcd-Mitglied startet ohne Daten und fordert daher zusätzliche Aktualisierungen vom Leader an, bis es dessen Logstand erreicht hat. Dadurch kann das Netzwerk des Leaders leichter überlastet werden, sodass seine Heartbeats an Follower blockiert oder verworfen werden. In diesem Fall kann bei einem Follower das Wahlzeitlimit ablaufen und eine neue Leader-Wahl auslösen. Ein Cluster mit einem neuen Mitglied ist somit anfälliger für Leader-Wahlen. Sowohl die Wahl als auch die anschließende Übertragung der Aktualisierungen an das neue Mitglied können Zeiträume verursachen, in denen der Cluster nicht verfügbar ist (siehe Abbildung 1).
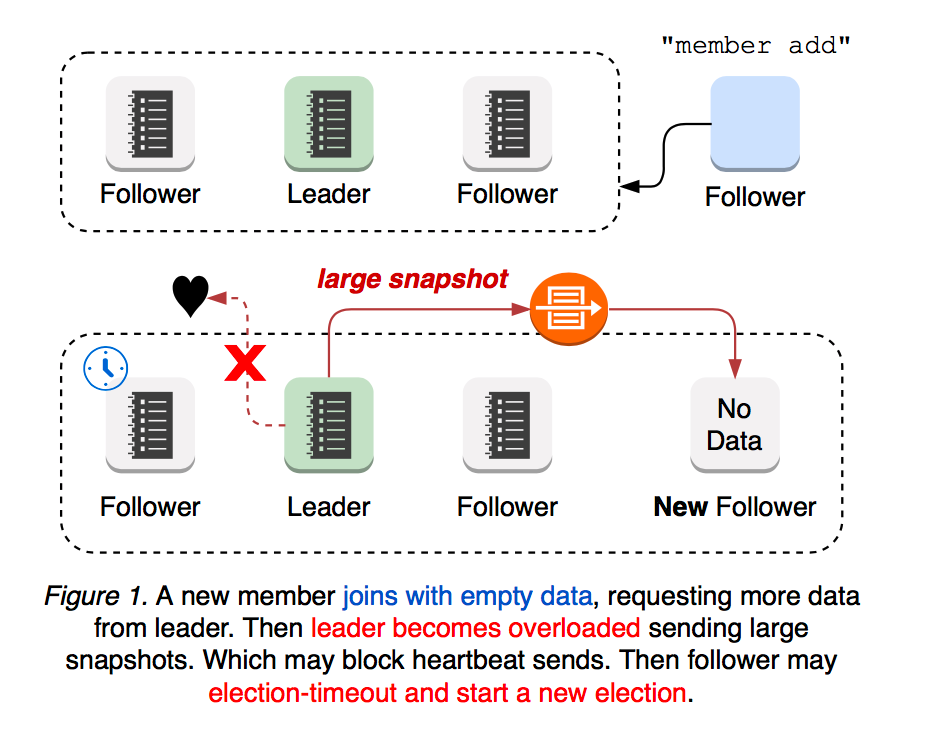
2. Szenarien mit Netzwerkpartitionen
Was passiert bei einer Netzwerkpartition? Das hängt von der Partition des Leaders ab. Verfügt der Leader weiterhin über ein aktives Quorum, arbeitet der Cluster weiter (siehe Abbildung 2).
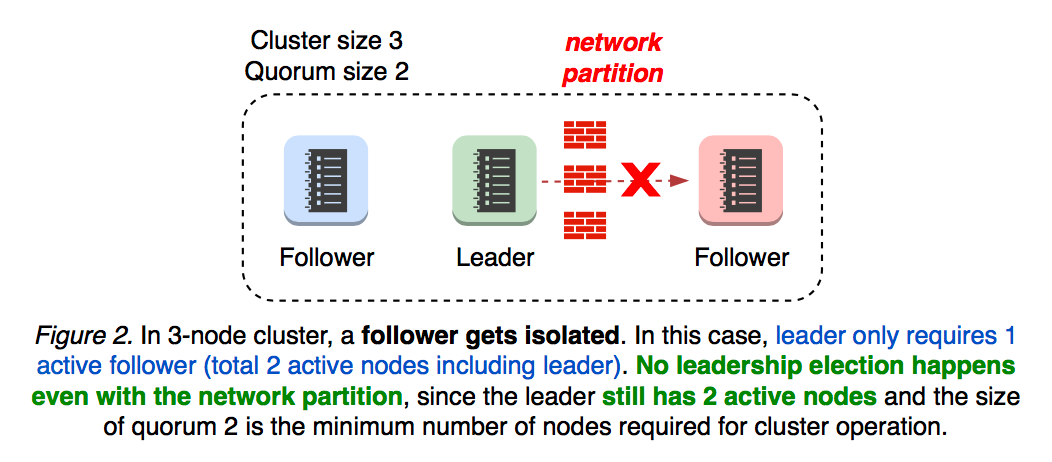
2.1 Isolation des Leaders
Was passiert, wenn der Leader vom Rest des Clusters isoliert wird? Der Leader überwacht den Fortschritt jedes Followers. Verliert er die Verbindung zum Quorum, kehrt er in die Follower-Rolle zurück. Dies beeinträchtigt die Clusterverfügbarkeit (siehe Abbildung 3).
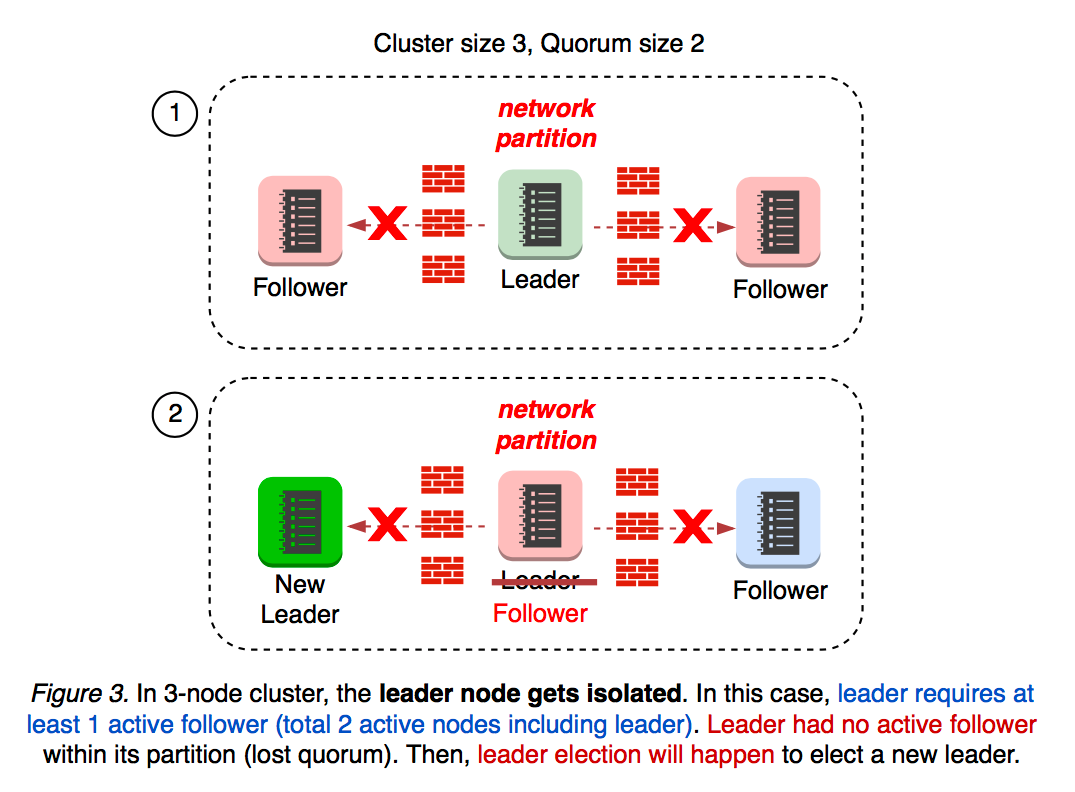
Wird einem Cluster mit 3 Knoten ein neuer Knoten hinzugefügt, steigt die Clustergröße auf 4 und die Quorumgröße auf 3. Was passiert, wenn nach dem Beitritt eines neuen Knotens eine Netzwerkpartition auftritt? Das hängt davon ab, in welcher Partition sich das neue Mitglied anschließend befindet.
2.2 Clusteraufteilung 3+1
Befindet sich der neue Knoten in derselben Partition wie der Leader, verfügt dieser weiterhin über ein aktives Quorum von 3. Es findet keine Leader-Wahl statt, und die Clusterverfügbarkeit bleibt unbeeinträchtigt (siehe Abbildung 4).
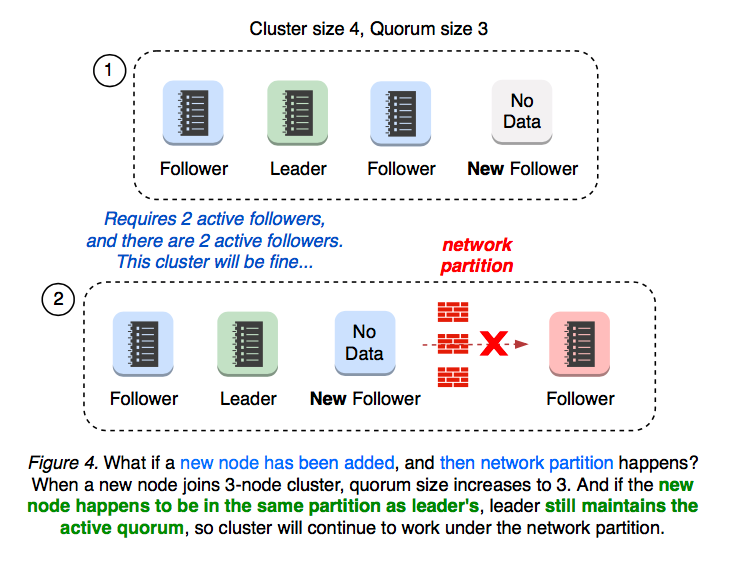
2.3 Clusteraufteilung 2+2
Wird der Cluster in 2 und 2 Knoten aufgeteilt, erreicht keine Partition das Quorum von 3. In diesem Fall findet eine Leader-Wahl statt (siehe Abbildung 5).
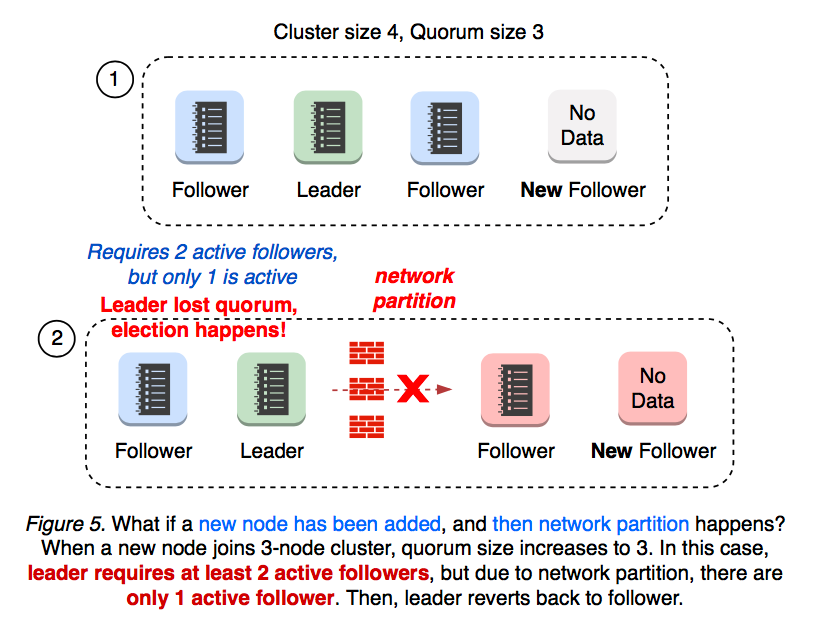
2.4 Quorum verloren
Was passiert, wenn zuerst eine Netzwerkpartition auftritt und danach ein neues Mitglied hinzugefügt wird? In einem partitionierten Cluster mit 3 Knoten ist bereits ein Follower abgetrennt. Wird ein neues Mitglied hinzugefügt, steigt das Quorum von 2 auf 3. Der Cluster hat nun nur 2 aktive von 4 Knoten, verliert dadurch sein Quorum und beginnt eine neue Leader-Wahl (siehe Abbildung 6).
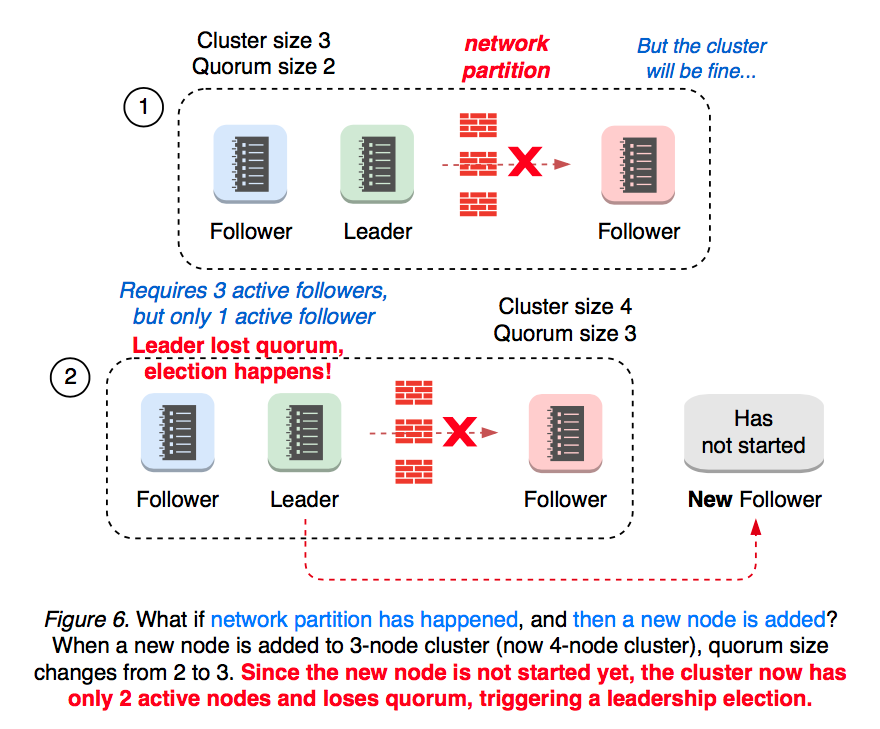
Da das Hinzufügen eines Mitglieds die Quorumgröße ändern kann, wird beim Ersetzen eines nicht funktionsfähigen Knotens stets empfohlen, zuerst „member remove“ auszuführen.
Das Hinzufügen eines neuen Mitglieds zu einem Cluster mit 1 Knoten erhöht die Quorumgröße auf 2. Sobald der bisherige Leader feststellt, dass das Quorum nicht aktiv ist, löst dies unmittelbar eine Leader-Wahl aus. Der Grund: „member add“ ist ein Vorgang mit 2 Schritten, bei dem der Benutzer zuerst den Befehl „member add“ ausführen und anschließend den Prozess des neuen Knotens starten muss (siehe Abbildung 7).
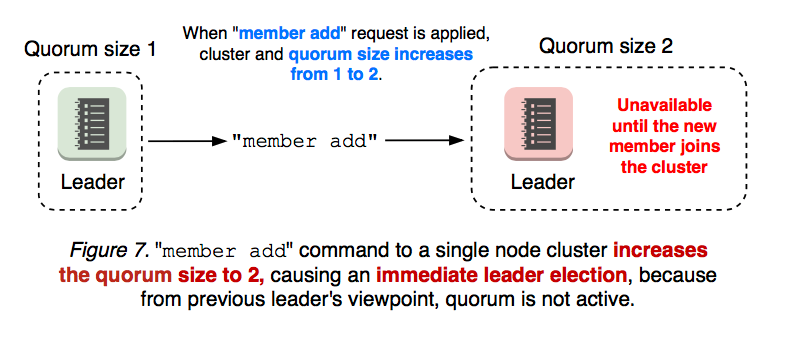
3. Fehlkonfigurationen des Clusters
Noch problematischer ist ein falsch konfiguriertes hinzugefügtes Mitglied. Die Neukonfiguration der Mitgliedschaft besteht aus zwei Schritten: „etcdctl member add“ und dem Start eines etcd-Serverprozesses mit der angegebenen Peer-URL. Der Befehl „member add“ wird also unabhängig von der URL angewendet, selbst wenn diese ungültig ist. Werden im ersten Schritt ungültige URLs verwendet, kann der zweite Schritt den neuen etcd-Prozess nicht einmal starten. Sobald der Cluster sein Quorum verliert, lässt sich die Mitgliedschaftsänderung nicht mehr rückgängig machen (siehe Abbildung 8).
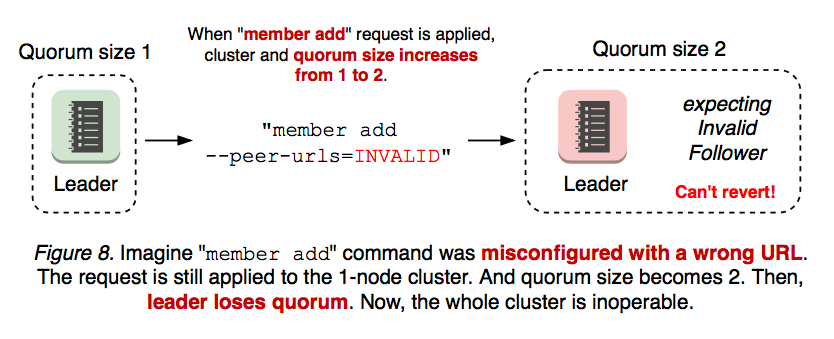
Dasselbe gilt für einen Cluster mit mehreren Knoten. Beispielsweise hat der Cluster zwei nicht verfügbare Mitglieder, eines ausgefallen und eines falsch konfiguriert, sowie zwei aktive Mitglieder. Er benötigt nun aber mindestens 3 Stimmen, um die Clustermitgliedschaft zu ändern (siehe Abbildung 9).
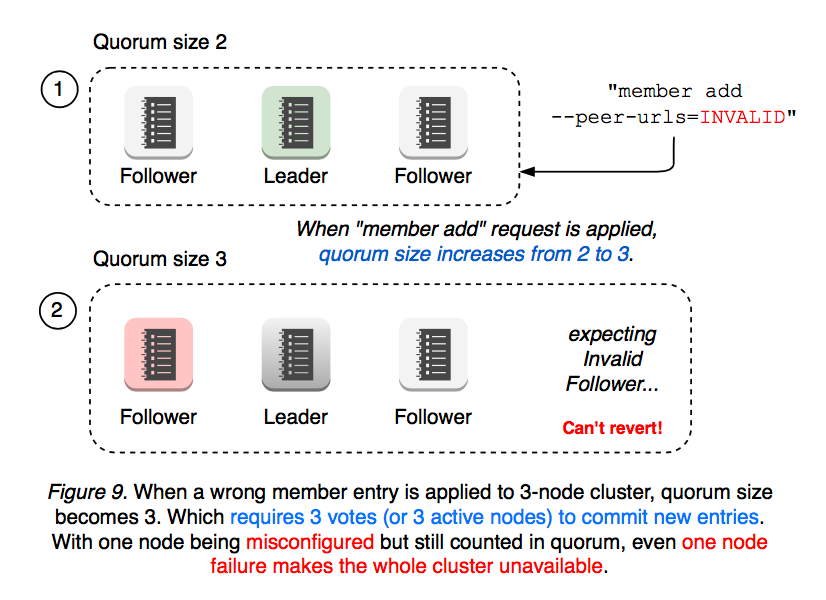
Wie gezeigt, kann eine einfache Fehlkonfiguration den gesamten Cluster funktionsunfähig machen. In diesem Fall muss ein Betreiber den Cluster manuell mit der Option etcd --force-new-cluster neu erstellen. Da etcd für Kubernetes zu einem betriebskritischen Dienst geworden ist, können selbst kürzeste Ausfälle erhebliche Auswirkungen auf Benutzer haben. Wie lassen sich solche etcd-Operationen vereinfachen? Besonders entscheidend für die Clusterverfügbarkeit ist die Leader-Wahl: Lässt sich die Neukonfiguration der Mitgliedschaft weniger störend gestalten, indem die Quorumgröße unverändert bleibt? Kann ein neuer Knoten zunächst inaktiv bleiben und nur die nötigsten Aktualisierungen vom Leader anfordern, bis er aufgeholt hat? Lassen sich Fehlkonfigurationen der Mitgliedschaft immer rückgängig machen und sicherer behandeln, sodass ein falscher Befehl zum Hinzufügen eines Mitglieds niemals den Cluster ausfallen lässt? Sollte ein Benutzer beim Hinzufügen eines Mitglieds die Netzwerktopologie berücksichtigen müssen? Kann die API zum Hinzufügen von Mitgliedern unabhängig von der Lage der Knoten und bestehenden Netzwerkpartitionen funktionieren?
Raft-Learner
Um die im vorigen Abschnitt beschriebenen Verfügbarkeitslücken zu verringern, führt Raft §4.2.1 den neuen Knotenzustand „Learner“ ein. Ein solcher Knoten tritt dem Cluster als nicht stimmberechtigtes Mitglied bei, bis er den Logstand des Leaders erreicht hat.
Funktionen in v3.4
Ein Betreiber sollte möglichst wenig Aufwand haben, um einen neuen Learner-Knoten hinzuzufügen. Der Befehl member add --learner fügt einen Learner hinzu, der als nicht stimmberechtigtes Mitglied beitritt, aber dennoch alle Daten vom Leader empfängt (siehe Abbildung 10).
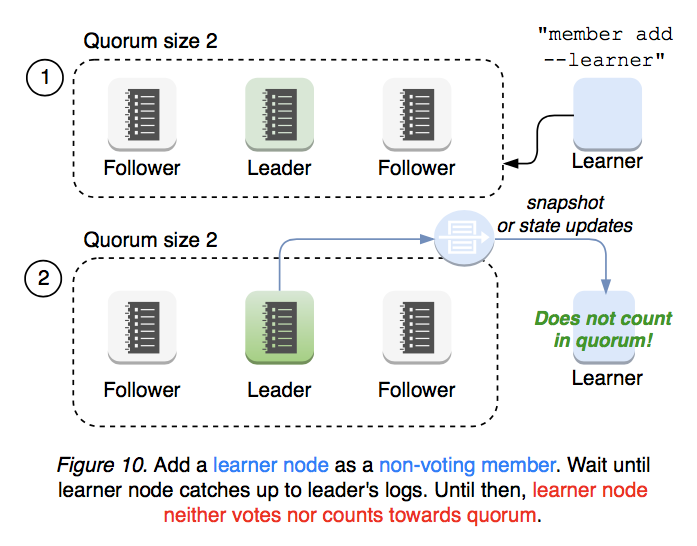
Hat ein Learner den Fortschritt des Leaders eingeholt, kann er über die API member promote zu einem stimmberechtigten Mitglied hochgestuft werden und zählt dann zum Quorum (siehe Abbildung 11).
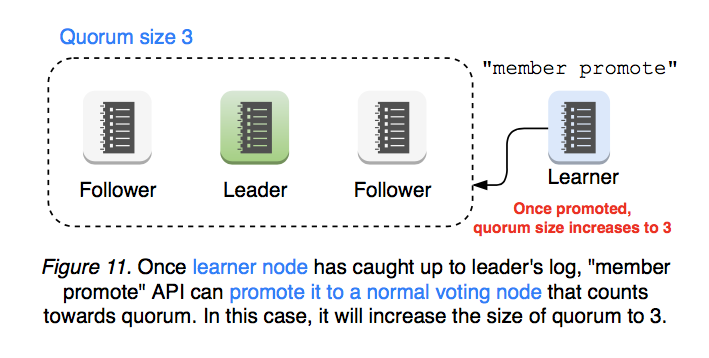
Der etcd-Server validiert die Hochstufungsanfrage, um einen sicheren Betrieb zu gewährleisten. Erst wenn sein Log den Stand des Leaders erreicht hat, kann ein Learner zu einem stimmberechtigten Mitglied hochgestuft werden (siehe Abbildung 12).
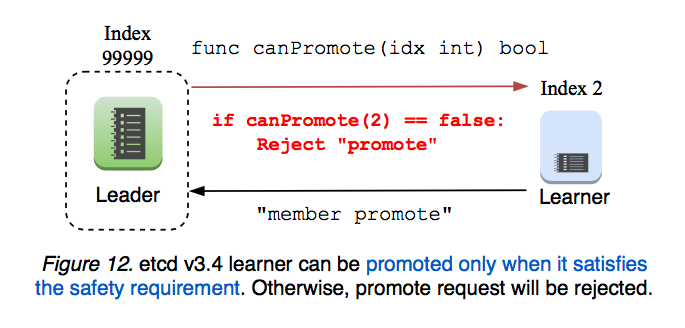
Bis zur Hochstufung dient ein Learner nur als Standby-Knoten: Die Führungsrolle kann ihm nicht übertragen werden. Ein Learner lehnt Lese- und Schreibanfragen von Clients ab; der Client-Load-Balancer sollte keine Anfragen an ihn weiterleiten. Daher muss ein Learner keine Read-Index-Anfragen an den Leader senden. Diese Einschränkung vereinfacht die erste Learner-Implementierung in v3.4 (siehe Abbildung 13).
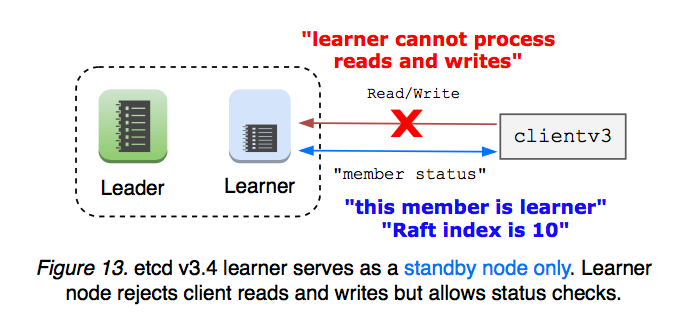
Außerdem begrenzt etcd die Gesamtzahl der Learner in einem Cluster, um eine Überlastung des Leaders durch Logreplikation zu vermeiden. Ein Learner stuft sich niemals selbst hoch. etcd liefert Statusinformationen über Learner und Sicherheitsprüfungen; die endgültige Entscheidung über eine Hochstufung muss jedoch der Clusterbetreiber treffen.
Vorgeschlagene Funktionen für künftige Versionen
Learner als einzigen Anfangszustand und Standard festlegen: Wird der Anfangszustand neuer Mitglieder auf Learner gesetzt, erhöht dies die Sicherheit der Mitgliedschaftsneukonfiguration erheblich, da Learner die Quorumgröße nicht verändern. Fehlkonfigurationen lassen sich dann immer rückgängig machen, ohne das Quorum zu verlieren.
Die Hochstufung zum stimmberechtigten Mitglied vollständig automatisieren: Sobald ein Learner den Logstand des Leaders erreicht hat, kann der Cluster ihn automatisch hochstufen. Der Benutzer legt bestimmte von etcd benötigte Schwellenwerte fest. Sind die Anforderungen erfüllt, stuft sich der Learner selbst zu einem stimmberechtigten Mitglied hoch. Aus Benutzersicht würde „member add“ wie bisher funktionieren, aber dank der Learner-Funktion mehr Sicherheit bieten.
Learner als Standby-Knoten für Failover verwenden: Ein Learner tritt als Standby-Knoten bei und wird automatisch hochgestuft, wenn die Clusterverfügbarkeit beeinträchtigt ist.
Learner nur für Lesezugriffe verwenden: Ein Learner kann als ausschließlich lesender Knoten dienen, der nie hochgestuft wird. In einem Modus mit schwacher Konsistenz empfängt er nur Daten vom Leader und verarbeitet keine Schreibvorgänge. Lokale Lesezugriffe ohne Konsensaufwand würden die Last des Leaders erheblich verringern, können aber veraltete Daten liefern. In einem Modus mit starker Konsistenz fordert der Learner einen Leseindex vom Leader an, um die neuesten Daten bereitzustellen, lehnt Schreibvorgänge aber weiterhin ab.
Learner und Mirror Maker im Vergleich
etcd implementiert „mirror maker“ mit der Watch-API, um Schlüsselerstellungen und -aktualisierungen fortlaufend an einen separaten Cluster weiterzuleiten. Nach Abschluss der anfänglichen Synchronisierung verursacht die Spiegelung gewöhnlich nur geringe zusätzliche Latenz. Learner und Spiegelung überschneiden sich darin, dass beide vorhandene Daten für reine Lesezugriffe replizieren können. Die Spiegelung garantiert jedoch keine Linearisierbarkeit. Bei Netzwerkunterbrechungen können frühere Schlüssel-Wert-Paare bereits verworfen worden sein, und von Clients wird erwartet, die Watch-Antworten auf korrekte Reihenfolge zu prüfen. Eine Spiegelung bietet daher keine Reihenfolgegarantie. Spiegelung eignet sich für minimale Latenz, etwa zwischen Rechenzentren, auf Kosten der Konsistenz. Learner eignen sich, um alle historischen Daten und deren Reihenfolge zu erhalten.
Anhang: Learner-Implementierung in v3.4
Den Knotentyp “Learner” in der API “MemberAdd” verfügbar machen.
Der etcd-Client ergänzt die API „MemberAdd“ um eine Option für Learner-Knoten. Der Server-Handler von etcd wendet einen Mitgliedschaftsänderungseintrag vom Typ pb.ConfChangeAddLearnerNode an. Nach Anwendung des Befehls tritt ein Server mit der Option etcd --initial-cluster-state=existing dem Cluster bei. Dieser Learner-Knoten ist weder stimmberechtigt noch zählt er zum Quorum.
Der etcd-Server darf die Führungsrolle keinem Learner übertragen, da dieser noch zurückliegen kann und nicht zum Quorum zählt. Der etcd-Server begrenzt die Anzahl der Learner pro Cluster auf einen: Je mehr Learner vorhanden sind, desto mehr Daten muss der Leader verteilen. Clients können mit einem Learner-Knoten kommunizieren, dieser lehnt jedoch alle Anfragen außer serialisierbaren Lesezugriffen und der API für den Mitgliedsstatus ab. Das vereinfacht die erste Implementierung. Künftig kann ein Learner zu einem ausschließlich lesenden Server erweitert werden, der Clusterdaten fortlaufend spiegelt. Der Client-Load-Balancer muss eine Hilfsfunktion bereitstellen, um den Endpunkt eines Learner-Knotens auszuschließen. Andernfalls können Anfragen an den Learner fehlschlagen. Der Client-Aufruf zur Mitgliedersynchronisierung sollte den Knotentyp Learner berücksichtigen, ebenso der Aufruf zur Aktualisierung der Client-Endpunkte.
Die Antworten von MemberList und MemberStatus sollten angeben, welcher Knoten ein Learner ist.
Die API “MemberPromote” hinzufügen.
Raft-intern stuft ein zweiter MemberAdd-Aufruf für den Learner-Knoten diesen zu einem stimmberechtigten Mitglied hoch. Der Leader verwaltet den Fortschritt jedes Followers und Learners. Hat der Learner die Verarbeitung seiner Snapshot-Nachricht noch nicht abgeschlossen, wird die Hochstufungsanfrage abgelehnt. Sie wird genau dann angenommen, wenn der Learner-Knoten funktionsfähig ist und mit dem Leader synchron ist oder die Differenz innerhalb des Schwellenwerts liegt. Beispielsweise muss die Zahl der an den Learner zu replizierenden Einträge unter 1/10 der Snapshot-Anzahl liegen; damit ist es weniger wahrscheinlich, dass der Leader selbst nach der Hochstufung einen Snapshot an den Learner senden müsste. Diese gesamte Logik ist im Paket etcdserver fest codiert und nicht konfigurierbar.
Referenzen
- Ursprüngliches GitHub-Issue: etcd#9161
- Anwendungsfall: etcd#3715
- Anwendungsfall: etcd#8888
- Anwendungsfall: etcd#10114
12.4 - Authentifizierungsdesign von etcd v3
Warum das Authentifizierungssystem von v2 nicht wiederverwenden?
Das v3-Protokoll verwendet gRPC als Transport anstelle einer RESTful-Schnittstelle wie in v2. Das neue Protokoll bietet die Gelegenheit, den Entwurf von v2 weiterzuentwickeln und zu verbessern. Beispielsweise authentifiziert v3 pro Verbindung, während die langsamere Authentifizierung in v2 pro Anfrage erfolgt. Zudem erschwert die Semantik der v2-Authentifizierung in der Praxis Überlegungen zur Konsistenz, wie die nächsten Abschnitte erläutern. Für v3 gibt es eine klar definierte Beschreibung und Implementierung des Authentifizierungsmechanismus, die die Schwächen des v2-Systems behebt.
Funktionale Anforderungen
- Authentifizierung pro Verbindung statt pro Anfrage
- Auf Benutzer-ID und Passwort basierende Authentifizierung für die gRPC-API
- Die Authentifizierung muss nach Änderungen der Authentifizierungsrichtlinie erneuert werden
- Die Funktionalität sollte so einfach und nützlich sein wie in v2
- v3 bietet einen flachen Schlüsselraum statt der Verzeichnisstruktur von v2. Berechtigungen werden durch Intervallabgleich geprüft.
- Sie sollte stärkere Konsistenzgarantien als die v2-Authentifizierung bieten
Wesentliche erforderliche Änderungen
- Ein Client muss vor dem Senden authentifizierter Anfragen eine eigene Verbindung ausschließlich zur Authentifizierung aufbauen
- Berechtigungsinformationen (Benutzer-ID und autorisierte Revision) zu den Raft-Befehlen (
etcdserverpb.InternalRaftRequest) hinzufügen - Die Berechtigungen jeder Anfrage werden in der Zustandsmaschinenschicht statt in der API-Schicht geprüft
Konsistenz der Berechtigungsmetadaten
Die Authentifizierungsmetadaten sollten wie andere Daten in etcd im Speicher abgelegt und verwaltet werden, den das Raft-Protokoll von etcd kontrolliert. Das ist erforderlich, um Verfügbarkeit und Konsistenz des gesamten etcd-Clusters zu erhalten. Wenn das Lesen oder Schreiben der Metadaten, etwa von Berechtigungsinformationen, die Zustimmung jedes Knotens und damit mehr als ein Quorum benötigt, kann der Ausfall eines einzelnen Knotens den gesamten Cluster anhalten. Müssen alle Knoten gleichzeitig zustimmen, lässt sich die Prüfung gewöhnlicher Lese- und Schreibanfragen nicht abschließen, sobald ein Clustermitglied ausfällt, selbst wenn noch ein Quorum verfügbar ist. Dieses Einstimmigkeitsverfahren verschlechtert letztlich die Clusterverfügbarkeit. Der auf einem Quorum basierende Raft-Konsens sollte ausreichen, da die Übereinstimmung aus einer konsistenten Reihenfolge folgt.
Der Authentifizierungsmechanismus des etcd-v2-Protokolls hat eine problematische Eigenschaft: Die Metadatenkonsistenz sollte wie oben beschrieben funktionieren, tut es aber nicht. Jede Berechtigungsprüfung wird von dem etcd-Mitglied durchgeführt, das die Client-Anfrage empfängt (server/etcdserver/api/v2http/client.go), einschließlich Follower-Mitgliedern. Die Prüfung kann daher auf veralteten Metadaten beruhen.
Aufgrund dieser möglichen Veraltung wird die Authentifizierungskonfiguration nicht zwingend wirksam, sobald Betreiber etcdctl ausführen. Es lässt sich daher nicht feststellen, wie lange veraltete Metadaten noch gelten. In der Praxis wird die Konfigurationsänderung unmittelbar nach der Befehlsausführung wirksam. Unter hoher Last kann der inkonsistente Zustand jedoch länger anhalten und für Benutzer und Entwickler unerwartete Situationen verursachen. Dafür ist eine Umgehungslösung wie diese erforderlich.
Inkonsistente Berechtigungen gefährden linearisierte Anfragen
Ein inkonsistenter Authentifizierungszustand ist bei Schreibvorgängen am schwerwiegendsten. Selbst wenn ein Betreiber einem Benutzer das Schreiben verbietet, kann ein Schreibvorgang erfolgreich abgeschlossen werden, sofern seine Reihenfolge nur gegenüber dem Schlüssel-Wert-Speicher, nicht aber gegenüber dem Authentifizierungssystem festgelegt ist. Ohne eine Reihenfolge über Authentifizierungsspeicher und Schlüssel-Wert-Speicher hinweg ist das System für Angriffe mit veralteten Berechtigungen anfällig.
Deshalb sollte die Berechtigungsprüfung in die Zustandsmaschine von etcd aufgenommen werden. Jede Zustandsmaschine sollte Anfragen in der Apply-Phase anhand ihrer Berechtigungsinformationen prüfen. Die Authentifizierungsinformationen dürfen dabei nicht veraltet sein.
Entwurf und Implementierung
Authentifizierung
Zunächst muss ein Client eine gRPC-Verbindung ausschließlich zur Authentifizierung seiner Benutzer-ID und seines Passworts aufbauen. Ein etcd-Server antwortet bei Erfolg mit einem Authentifizierungstoken, bei Fehlschlag mit einem Fehler. Der Client kann das Token verwenden, um sich bei API-Anfragen gegenüber etcd auszuweisen.
Die Client-Verbindung, über die das Authentifizierungstoken angefordert wurde, wird üblicherweise verworfen; sie kann die Anmeldedaten des neuen Tokens nicht übertragen. gRPC bietet nämlich keine Möglichkeit, nach dem Verbindungsaufbau durch grpc.Dial() Anmeldedaten pro RPC hinzuzufügen. Ein Client kann einer Verbindung daher kein Token zuweisen, das er über diese Verbindung erhalten hat. Zur Verwendung des Tokens benötigt er eine neue Verbindung.
Hinweise zur Implementierung des RPC Authenticate()
Der RPC Authenticate() erzeugt anhand eines angegebenen Benutzernamens und Passworts ein Authentifizierungstoken. etcd verwendet das Go-Paket bcrypt, um ein konfiguriertes Passwort zu speichern und ein angegebenes Passwort dagegen zu prüfen. Die Passwortprüfung von bcrypt ist absichtlich rechenaufwendig und dauert auf einem gewöhnlichen x64-Server fast 100ms. Diese Prüfung in der Apply-Phase der Zustandsmaschine würde daher Leistungsprobleme verursachen: Der gesamte etcd-Cluster könnte nur knapp 10 Authenticate()-Anfragen pro Sekunde verarbeiten.
Aus Leistungsgründen prüft der v3-Authentifizierungsmechanismus Passwörter in der API-Schicht von etcd, wo dies außerhalb von Raft parallelisiert werden kann. Dadurch können jedoch Berechtigungslücken zwischen Prüf- und Verwendungszeitpunkt entstehen (Time-of-check/Time-of-use, TOCTOU):
- Client A sendet eine Anfrage
Authenticate() - Die API-Schicht führt die Passwortprüfung von
Authenticate()aus - Ein anderer Client B sendet eine Anfrage
ChangePassword(), die der Server abschließt - Die Zustandsmaschinenschicht ermittelt die Revisionsnummer für
Authenticate()von A - Der Server meldet A Erfolg
- A ist nun mit einem veralteten Passwort authentifiziert
Um diese Situation zu vermeiden, führt die API-Schicht eine Validierung der Versionsnummer anhand der Revisionsnummer des Authentifizierungsspeichers durch. Während der Passwortprüfung speichert sie dessen Revisionsnummer. Nach erfolgreicher Prüfung vergleicht sie die gespeicherte mit der neuesten Revisionsnummer. Unterscheiden sich die Nummern, wurden die Authentifizierungsmetadaten zwischenzeitlich aktualisiert, und die Prüfung wird wiederholt. Dieser Mechanismus verhindert eine erfolgreiche Prüfung anhand eines veralteten Passworts.
Ein Token in der API-Schicht auflösen
Nach der Authentifizierung mit Authenticate() kann ein Client wie ohne Authentifizierung eine gRPC-Verbindung aufbauen. Zusätzlich zum bestehenden Initialisierungsablauf muss er das Token der neu erstellten Verbindung zuordnen. grpc.WithPerRPCCredentials() bietet die dafür erforderliche Funktion.
Jede authentifizierte Client-Anfrage enthält ein Token. Serverseitig lässt es sich mit grpc.metadata.FromIncomingContext() abrufen. Der Server kann daraus ermitteln, wer die Anfrage stellt und wann der Benutzer autorisiert wurde. Die API-Schicht trägt diese Informationen in den Header (etcdserverpb.RequestHeader.Username und etcdserverpb.RequestHeader.AuthRevision) eines Raft-Logeintrags (etcdserverpb.InternalRaftRequest) ein.
Berechtigungen in der Zustandsmaschine prüfen
Die Authentifizierungsinformationen in etcdserverpb.RequestHeader werden in der Apply-Phase der Zustandsmaschine geprüft. Dabei wird anhand der neuesten Revision des Authentifizierungsspeichers geprüft, ob der Benutzer Zugriff auf die angeforderten Schlüssel hat.
Zwei Token-Typen: simple und JWT
Es gibt zwei Token-Typen: simple und JWT. Das simple-Token ist nicht für den Produktivbetrieb vorgesehen. Diese Token sind nicht kryptografisch signiert, und die Server müssen die Zuordnung zwischen Token und Benutzern als Zustand verwalten. Sie sind für Entwicklungstests gedacht. Für produktive Bereitstellungen sollten JWT-Token verwendet werden, da sie kryptografisch signiert und geprüft werden. Aus Implementierungssicht ist JWT zustandslos. Ein JWT-Token kann Metadaten wie Benutzernamen und Revision enthalten, sodass Server die Zuordnung zwischen Token und Metadaten nicht speichern müssen.
Für simple-Token ist das Problem #18437 bekannt. Auf etcd-Servern werden Token in der API-Schicht aufgelöst, und simple-Token sind zustandsbehaftet. Der Vorgang ist nicht durch eine linearisierbare Prüfung geschützt. Daher kann ein etcd-Mitglied die vorherige Authentifizierungsanfrage noch nicht vollständig verarbeitet haben, wenn die nächste eintrifft. In diesem Fall kann es dem Client den Fehler “invalid auth token” zurückgeben. Auf einem Knoten mit guten Netzwerkbedingungen tritt dieses Problem gewöhnlich selten auf; bei hoher Latenz ist es jedoch möglich. Als Umgehungslösung können Anwendungen bei diesem Fehler einen Wiederholungsmechanismus einsetzen.
JWT-Token direkt setzen
Zusätzlich zum Standardablauf über den RPC Authenticate() unterstützt etcd das direkte Setzen von JWT-Token auf Client-Ebene. Dadurch können Anwendungen den gesamten Lebenszyklus von JWT-Token außerhalb von etcd verwalten, einschließlich Erzeugung, Validierung und Rotation.
Anwendungsfall und Ablauf
Dieser Ansatz ist sinnvoll, wenn:
- Ein separates Token-Verwaltungssystem außerhalb von etcd die Erzeugung und den Lebenszyklus der JWT-Token übernimmt
- Anwendungen bereits signierte JWT-Token über einen externen Mechanismus erhalten, etwa Umgebungsvariablen oder einen Konfigurationsdienst
- Der Token-Lebenszyklus vollständig von der Client-Anwendung statt durch die automatische Token-Erzeugung von etcd verwaltet werden muss
Der typische Ablauf ist:
- Eine externe Instanz außerhalb von etcd erzeugt ein signiertes JWT-Token, das den Benutzernamen und weitere Claims enthält
- Die Anwendung erhält das signierte Token und konfiguriert damit den etcd-Client
- Der Client sendet das JWT-Token direkt mit den Anfragen, ohne
Authenticate()aufzurufen - Der etcd-Server prüft die Token-Signatur mit seinem konfigurierten öffentlichen Schlüssel und gewährt Zugriff anhand des Benutzernamens im Token
- Vor Ablauf des Tokens ruft die Anwendung ein neues Token von der externen Instanz ab
- Die Anwendung erstellt einen neuen Client mit dem aktualisierten Token; Token-Aktualisierungen erfordern eine Neuerstellung des Clients
Unterschiede zur Standardauthentifizierung
Beim Standardablauf mit Authenticate():
- Der Client ruft
Authenticate()mit Benutzername und Passwort auf - etcd erzeugt ein Token und gibt es zurück
- Der Client verwendet dieses Token automatisch für nachfolgende Anfragen
- Zum Erneuern des Tokens muss
Authenticate()erneut aufgerufen werden
Beim direkten Setzen von JWT-Token:
- Der Client wird mit einem bereits signierten JWT-Token initialisiert
- Der Client ruft
Authenticate()nicht auf - Das Token wird direkt in allen Anfragen verwendet
- Die Client-Anwendung ist dafür verantwortlich, vor Ablauf neue Token zu beschaffen und den Lebenszyklus des Clients zu verwalten
AuthStatus ohne gültiges Token
Um Anwendungen mit eigener JWT-Token-Verwaltung zu unterstützen, ermöglicht der RPC AuthStatus Clients festzustellen, ob die Authentifizierung aktiviert ist, und die aktuelle authRevision abzurufen. Das ist für Wiederherstellungsszenarien wichtig, in denen ein Token abgelaufen ist und der Client die neueste Revision benötigt, um von seinem externen Token-Anbieter ein neues gültiges Token zu erhalten.
Ohne diese Möglichkeit könnte ein abgelaufenes Token verhindern, dass ein Client die aktuelle authRevision ermittelt. Dies könnte zu einer Blockade führen, in der kein neues Token erzeugt werden kann.
Unterschiede zwischen KVS-Modellen und Dateisystemmodellen
etcd v3 ist ein KVS und kein Dateisystem. Daher können Benutzern Berechtigungen für einen exakten Schlüsselnamen oder einen Schlüsselbereich wie ["start key", "end key") erteilt werden. Berechtigungen für nicht vorhandene Schlüssel sind somit möglich. Benutzer sollten auf unbeabsichtigt erteilte Berechtigungen achten. In dateisystemähnlichen Systemen wie Chubby oder ZooKeeper kann eine inode-ähnliche Datenstruktur die Berechtigungsinformationen enthalten. Dort können keine Berechtigungen für nicht vorhandene Schlüssel erteilt werden, abgesehen vom Fall der Sticky Bits.
Anders als dateisystemähnliche Systeme erfordert das Modell von etcd v3 mehrere Metadatenabfragen. Im ungünstigsten Fall entspricht der Suchaufwand der Summe aller Schlüssel und Intervalle, für die der Benutzer Berechtigungen hat. Dieser Aufwand lässt sich nicht vermeiden, weil sich der flache Schlüsselraum von v3 grundlegend vom Unix-Dateisystemmodell unterscheidet, bei dem jeder inode Berechtigungsmetadaten enthält. In der Praxis ist der Aufwand kein ernstes Problem, da die Metadaten klein genug sind, um vom Caching zu profitieren.
12.5 - etcd-API
Dieses Dokument gibt einen Überblick über den grundlegenden Entwurf der etcd-v3-APIs. Diese sind nicht mit der etcd-v2-API zu verwechseln, die seit etcd v3.5 veraltet ist. Der Überblick ist keineswegs vollständig. Er konzentriert sich auf die Grundideen, die zum Verständnis von etcd nötig sind, ohne durch seltenere API-Aufrufe abzulenken. Alle etcd-APIs sind in gRPC-Diensten definiert, die die vom etcd-Server verstandenen Remote Procedure Calls (RPCs) nach Funktionen gliedern. Eine vollständige Liste aller etcd-RPCs ist in Markdown in der gRPC-API-Übersicht dokumentiert.
gRPC-Dienste
Jede API-Anfrage an einen etcd-Server ist ein gRPC-Remote-Procedure-Call. Die RPCs von etcd werden nach ihrer Funktion in Dienste eingeteilt.
Für die Arbeit mit dem Schlüsselraum von etcd sind folgende Dienste wichtig:
- KV - Erstellt, aktualisiert, liest und löscht Schlüssel-Wert-Paare.
- Watch - Überwacht Änderungen an Schlüsseln.
- Lease - Grundoperationen zum Verarbeiten von Keepalive-Nachrichten der Clients.
Den Cluster selbst verwalten folgende Dienste:
- Auth - Rollenbasierter Authentifizierungsmechanismus zur Authentifizierung von Benutzern.
- Cluster - Liefert Mitgliedschaftsinformationen und Konfigurationsfunktionen.
- Maintenance - Erstellt Snapshots für die Wiederherstellung, defragmentiert den Speicher und liefert Statusinformationen pro Mitglied.
Anfragen und Antworten
Alle RPCs in etcd folgen demselben Format. Jeder RPC hat eine Funktion Name, die NameRequest als Argument entgegennimmt und NameResponse als Antwort zurückgibt. Beispielsweise lautet die Beschreibung des RPC Range:
Antwortheader
Alle Antworten der etcd-API enthalten einen Antwortheader mit Clustermetadaten zur Antwort:
- Cluster_ID - Die ID des Clusters, der die Antwort erzeugt.
- Member_ID - Die ID des Mitglieds, das die Antwort erzeugt.
- Revision - Die Revision des Schlüssel-Wert-Speichers beim Erzeugen der Antwort.
- Raft_Term - Der Raft-Term des Mitglieds beim Erzeugen der Antwort.
Eine Anwendung kann das Feld Cluster_ID oder Member_ID lesen, um sicherzustellen, dass sie mit dem beabsichtigten Cluster beziehungsweise Mitglied kommuniziert.
Anwendungen können über das Feld Revision die neueste Revision des Schlüssel-Wert-Speichers ermitteln. Das ist besonders nützlich, wenn sie eine historische Revision für eine Zeitreiseabfrage angeben und die zum Anfragezeitpunkt neueste Revision kennen möchten.
Mit Raft_Term können Anwendungen erkennen, wann der Cluster eine neue Leader-Wahl abgeschlossen hat.
Schlüssel-Wert-API
Die Schlüssel-Wert-API bearbeitet die in etcd gespeicherten Schlüssel-Wert-Paare. Der Großteil der Anfragen an etcd sind üblicherweise Schlüssel-Wert-Anfragen.
Grundoperationen des Systems
Schlüssel-Wert-Paar
Ein Schlüssel-Wert-Paar ist die kleinste Einheit, die die Schlüssel-Wert-API bearbeiten kann. Jedes Paar hat mehrere Felder, die im Protobuf-Format definiert sind:
- Key - Schlüssel als Bytes. Ein leerer Schlüssel ist nicht zulässig.
- Value - Wert als Bytes.
- Version - Version ist die Version des Schlüssels. Eine Löschung setzt sie auf null zurück, und jede Änderung des Schlüssels erhöht sie.
- Create_Revision - Revision der letzten Erstellung des Schlüssels.
- Mod_Revision - Revision der letzten Änderung des Schlüssels.
- Lease - Die ID der dem Schlüssel zugeordneten Lease. Ist lease 0, ist dem Schlüssel keine Lease zugeordnet.
Zusätzlich zu Schlüssel und Wert fügt etcd der Schlüsselnachricht Revisionsmetadaten hinzu. Diese Informationen ordnen Schlüssel nach Erstellungs- und Änderungszeitpunkt, was für die Nebenläufigkeitskontrolle bei verteilter Synchronisierung nützlich ist. Die verteilten gemeinsamen Sperren des etcd-Clients verwenden die Erstellungsrevision, um auf den Besitz einer Sperre zu warten. Entsprechend dient die Änderungsrevision dazu, Konflikte in der Lesemenge von Software Transactional Memory zu erkennen und auf Aktualisierungen bei der Leader-Wahl zu warten.
Revisionen
etcd verwaltet einen clusterweiten 64-Bit-Zähler, die Speicherrevision, der bei jeder Änderung des Schlüsselraums erhöht wird. Die Revision dient als globale logische Uhr und ordnet alle Speicheraktualisierungen sequenziell. Die durch eine neue Revision repräsentierte Änderung ist inkrementell: Einer Revision sind die Daten zugeordnet, die den Speicher geändert haben. Intern bedeutet eine neue Revision, die Änderungen mit der erhöhten Revision als Schlüssel in den B+-Baum des Backends zu schreiben.
Besonders nützlich sind Revisionen im Backend mit Mehrversions-Nebenläufigkeitskontrolle von etcd. Das MVCC-Modell erlaubt eine Sicht auf den Schlüssel-Wert-Speicher aus früheren Revisionen, da historische Schlüsselrevisionen erhalten bleiben. Clusteradministratoren können die Aufbewahrungsrichtlinie für diesen Verlauf zur gezielten Speicherverwaltung konfigurieren. Üblicherweise verwirft etcd alte Schlüsselrevisionen zeitgesteuert. Ein typischer etcd-Cluster bewahrt ersetzte Schlüsseldaten mehrere Stunden auf. Das ermöglicht auch die zuverlässige Behandlung langer Client-Verbindungsunterbrechungen statt nur kurzer Netzwerkausfälle: Watcher setzen einfach ab der letzten beobachteten historischen Revision fort. Ebenso können Leseanfragen mit einer Revision versehen werden, um Schlüssel aus der Sicht des Schlüsselraums zu dem Zeitpunkt zurückzugeben, an dem diese Revision bestätigt wurde.
Schlüsselbereiche
Das Datenmodell von etcd indiziert alle Schlüssel in einem flachen binären Schlüsselraum. Es unterscheidet sich damit von anderen Schlüssel-Wert-Speichern, die Schlüssel hierarchisch in Verzeichnissen organisieren. Schlüssel werden über Schlüsselintervalle [a, b) statt nach Verzeichnissen aufgelistet.
Diese Intervalle werden in etcd häufig als Bereiche bezeichnet. Bereichsoperationen sind leistungsfähiger als Verzeichnisoperationen. Wie ein hierarchischer Speicher unterstützen Intervalle einzelne Schlüsselabfragen über [a, a+1), etwa [‘a’, ‘a\x00’) zum Abrufen von ‘a’, und Verzeichnisabfragen durch Kodierung der Schlüssel nach Verzeichnistiefe. Darüber hinaus können Intervalle auch Präfixe abbilden: Das Intervall ['a', 'b') ruft beispielsweise alle Schlüssel mit dem Präfix ‘a’ ab.
Vereinbarungsgemäß werden Bereiche einer Anfrage durch die Felder key und range_end angegeben. Das Feld key ist der erste Schlüssel des Bereichs und sollte nicht leer sein. range_end ist der Schlüssel nach dem letzten Schlüssel des Bereichs. Ist range_end nicht angegeben oder leer, enthält der Bereich nur das Argument key. Ist range_end gleich key plus eins, etwa “aa”+1 == “ab” oder “a\xff”+1 == “b”, umfasst der Bereich alle Schlüssel mit dem Präfix key. Sind key und range_end beide ‘\0’, umfasst der Bereich alle Schlüssel. Ist range_end ‘\0’, umfasst der Bereich alle Schlüssel größer oder gleich dem Argument key.
Range
Schlüssel werden mit dem API-Aufruf Range aus dem Schlüssel-Wert-Speicher abgerufen. Er nimmt eine RangeRequest entgegen:
- Key, Range_End - Der abzurufende Schlüsselbereich.
- Limit - Die maximale Anzahl der für die Anfrage zurückgegebenen Schlüssel. Der Wert 0 bedeutet keine Begrenzung.
- Revision - Der für den Bereich zu verwendende Zeitpunkt im Schlüssel-Wert-Speicher. Ist revision kleiner oder gleich null, bezieht sich der Bereich auf den neuesten Stand. Wurde die Revision kompaktiert, wird ErrCompacted zurückgegeben.
- Sort_Order - Die Reihenfolge für sortierte Anfragen.
- Sort_Target - Das Schlüssel-Wert-Feld, nach dem sortiert wird.
- Serializable - Legt fest, dass die Bereichsanfrage serialisierbare, auf das Mitglied beschränkte Lesezugriffe verwendet. Standardmäßig ist Range linearisierbar und spiegelt den aktuellen Konsens des Clusters wider. Für bessere Leistung und Verfügbarkeit auf Kosten möglicherweise veralteter Leseergebnisse wird eine serialisierbare Bereichsanfrage lokal bearbeitet, ohne einen Konsens mit anderen Clusterknoten herstellen zu müssen.
- Keys_Only - Gibt nur die Schlüssel, nicht die Werte zurück.
- Count_Only - Gibt nur die Anzahl der Schlüssel im Bereich zurück.
- Min_Mod_Revision - Die Untergrenze für Änderungsrevisionen von Schlüsseln; kleinere Änderungsrevisionen werden herausgefiltert.
- Max_Mod_Revision - Die Obergrenze für Änderungsrevisionen von Schlüsseln; größere Änderungsrevisionen werden herausgefiltert.
- Min_Create_Revision - Die Untergrenze für Erstellungsrevisionen von Schlüsseln; kleinere Erstellungsrevisionen werden herausgefiltert.
- Max_Create_Revision - Die Obergrenze für Erstellungsrevisionen von Schlüsseln; größere Erstellungsrevisionen werden herausgefiltert.
Der Client erhält vom Aufruf Range eine Nachricht RangeResponse:
- Kvs - Die Liste der Schlüssel-Wert-Paare, die der Bereichsanfrage entsprechen. Wenn
Count_Onlygesetzt ist, istKvsleer. - More - Gibt bei gesetztem
limitan, ob im angeforderten Bereich weitere Schlüssel zurückzugeben sind. - Count - Die Gesamtzahl der Schlüssel, die die Bereichsanfrage erfüllen.
Für große Schlüsselbereiche, deren vollständige Antwort nicht zwischengespeichert werden soll, siehe RangeStream .
RangeStream
RangeStream liefert dieselbe Ergebnismenge wie Range, der Server teilt die Antwort jedoch in eine Folge von Blöcken auf und überträgt sie als Stream an den Client. So muss keine Seite große Bereiche vollständig im Arbeitsspeicher zwischenspeichern. RangeStream akzeptiert dieselbe RangeRequest wie Range.
Der Client erhält vom Aufruf RangeStream einen Stream von RangeStreamResponse-Nachrichten:
Belegung der Felder über die Blöcke hinweg:
- Kvs - Jeder Block enthält einen disjunkten Teil des Ergebnisses. Werden die
kvsaller Blöcke in ihrer Empfangsreihenfolge aneinandergehängt, ergibt sich dieselbe Schlüsselmenge wie bei einem einzelnenRange-Aufruf. - Header, More, Count - Werden nur im letzten Block gesetzt, und nur wenn der Stream ohne Fehler endet. In früheren Blöcken behalten diese Felder ihre Nullwerte. Wird
proto.Mergeauf dierange_responsejedes Blocks angewendet, entsteht eineRangeResponse, die der Antwort vonRangeentspricht.
Endet der Stream mit einem Fehler, enthält kein Block einen gültigen Wert für header, more oder count.
Alle Blöcke des Streams werden anhand derselben Revision bereitgestellt. Ist Revision in der Anfrage nicht gesetzt, erfasst der Server beim Start des Streams die neueste bestätigte Revision und verwendet sie für den restlichen Stream weiter.
RangeStream unterstützt weder benutzerdefinierte Sortierreihenfolgen noch Revisionsfilter (min_mod_revision, max_mod_revision, min_create_revision, max_create_revision). Anfragen, die eines davon verwenden, liefern Unimplemented. Auch der gRPC-Proxy von etcd unterstützt RangeStream nicht.
Es gibt zwei übliche Arten, einen RangeStream zu verarbeiten:
- Jeden Block unabhängig verarbeiten. Geeignet für Szenarien mit hohen Leistungsanforderungen, in denen der Client Schlüssel beim Eintreffen dekodieren und verarbeiten möchte, statt zuerst das gesamte Ergebnis zu sammeln. Der Client durchläuft die Blöcke und verarbeitet die jeweiligen
kvs. Nachdem der Stream fehlerfrei beendet wurde, liest erheader,moreodercountaus dem letzten Block. - Eine einzelne Antwort zusammensetzen. Geeignet, wenn der Client ein Ergebnis wie bei einem unären
Range-Aufruf benötigt. Er führt dierange_responsejedes Blocks zu einerRangeResponsezusammen, etwa mitproto.Merge. Das Ergebnis enthält die vollständigenkvssowieheader,moreundcountaus dem letzten Block. Der Go-Client bietet dafür die Hilfsfunktionclientv3.GetStreamToGetResponse.
Put
Schlüssel werden mit dem Aufruf Put im Schlüssel-Wert-Speicher gespeichert. Er nimmt eine PutRequest entgegen:
- Key - Der Name des Schlüssels, der in den Schlüssel-Wert-Speicher geschrieben werden soll.
- Value - Der Wert als Bytes, der dem Schlüssel im Schlüssel-Wert-Speicher zugeordnet werden soll.
- Lease - Die Lease-ID, die dem Schlüssel im Schlüssel-Wert-Speicher zugeordnet werden soll. Der Lease-Wert 0 bedeutet keine Lease.
- Prev_Kv - Wenn gesetzt, enthält die Antwort die Daten des Schlüssel-Wert-Paars vor der Aktualisierung durch diese
Put-Anfrage. - Ignore_Value - Wenn gesetzt, wird der Schlüssel aktualisiert, ohne seinen aktuellen Wert zu ändern. Existiert der Schlüssel nicht, wird ein Fehler zurückgegeben.
- Ignore_Lease - Wenn gesetzt, wird der Schlüssel aktualisiert, ohne seine aktuelle Lease zu ändern. Existiert der Schlüssel nicht, wird ein Fehler zurückgegeben.
Der Client erhält vom Aufruf Put eine Nachricht PutResponse:
- Prev_Kv - Das durch
Putüberschriebene Schlüssel-Wert-Paar, wennPrev_Kvin derPutRequestgesetzt war.
Schlüsselbereich löschen
Schlüsselbereiche werden mit dem Aufruf DeleteRange gelöscht. Er nimmt eine DeleteRangeRequest entgegen:
- Key, Range_End - Der zu löschende Schlüsselbereich.
- Prev_Kv - Wenn gesetzt, wird der Inhalt der gelöschten Schlüssel-Wert-Paare zurückgegeben.
Der Client erhält vom Aufruf DeleteRange eine Nachricht DeleteRangeResponse:
- Deleted - Anzahl der gelöschten Schlüssel.
- Prev_Kv - Eine Liste aller durch die Operation
DeleteRangegelöschten Schlüssel-Wert-Paare.
Transaktion
Eine Transaktion ist ein atomares If/Then/Else-Konstrukt über dem Schlüssel-Wert-Speicher. Sie bietet eine Grundoperation, die Anfragen zu atomaren Blöcken, also then/else, zusammenfasst und deren Ausführung anhand des Speicherinhalts bedingt, also if. Transaktionen können Schlüssel vor unbeabsichtigten gleichzeitigen Aktualisierungen schützen, Compare-and-swap-Operationen bilden und als Grundlage einer übergeordneten Nebenläufigkeitskontrolle dienen.
Eine Transaktion kann mehrere Anfragen atomar in einer einzigen Anfrage verarbeiten. Bei Änderungen des Schlüssel-Wert-Speichers bedeutet dies, dass die Speicherrevision für die Transaktion nur einmal erhöht wird und alle erzeugten Ereignisse dieselbe Revision haben. Derselbe Schlüssel darf innerhalb einer einzelnen Transaktion jedoch nicht mehrfach geändert werden.
Alle Transaktionen werden durch eine Konjunktion von Vergleichen abgesichert, ähnlich einer If-Anweisung. Jeder Vergleich prüft einen einzelnen Schlüssel im Speicher. Er kann prüfen, ob ein Wert fehlt oder vorhanden ist, ihn mit einem angegebenen Wert vergleichen oder die Revision beziehungsweise Version eines Schlüssels prüfen. Zwei verschiedene Vergleiche können denselben oder unterschiedliche Schlüssel betreffen. Alle Vergleiche werden atomar angewendet. Sind alle wahr, gilt die Transaktion als erfolgreich, und etcd wendet ihren then- beziehungsweise success-Anfrageblock an. Andernfalls gilt sie als fehlgeschlagen, und der else- beziehungsweise failure-Anfrageblock wird angewendet.
Jeder Vergleich wird als Nachricht Compare kodiert:
- Result - Die Art der logischen Vergleichsoperation, etwa gleich oder kleiner als.
- Target - Das zu vergleichende Schlüssel-Wert-Feld: Version, Erstellungsrevision, Änderungsrevision oder Wert des Schlüssels.
- Key - Der Schlüssel für den Vergleich.
- Target_Union - Die vom Benutzer angegebenen Daten für den Vergleich.
Nach dem Verarbeiten des Vergleichsblocks wendet die Transaktion einen Anfrageblock an. Ein Block ist eine Liste von RequestOp-Nachrichten:
- Request_Range - Eine
RangeRequest. - Request_Put - Eine
PutRequest. Die Schlüssel müssen eindeutig sein. Sie darf keine Schlüssel mit anderen Put- oder Delete-Anfragen gemeinsam haben. - Request_Delete_Range - Eine
DeleteRangeRequest. Sie darf keine Schlüssel mit Put- oder Delete-Anfragen gemeinsam haben.
Zusammengesetzt wird eine Transaktion mit dem API-Aufruf Txn ausgeführt, der eine TxnRequest entgegennimmt:
- Compare - Eine Liste von Prädikaten, die eine Konjunktion von Bedingungen zur Absicherung der Transaktion repräsentiert.
- Success - Eine Liste von Anfragen, die verarbeitet werden, wenn alle Vergleiche true ergeben.
- Failure - Eine Liste von Anfragen, die verarbeitet werden, wenn ein Vergleich false ergibt.
Der Client erhält vom Aufruf Txn eine Nachricht TxnResponse:
- Succeeded - Gibt an, ob
Comparetrue oder false ergab. - Responses - Eine Liste von Antworten auf die Ergebnisse der Anwendung des Blocks
Success, wenn succeeded true ist, beziehungsweiseFailure, wenn succeeded false ist.
Die Liste Responses entspricht den Ergebnissen der angewendeten Liste RequestOp. Jede Antwort ist als ResponseOp kodiert:
Der in jeder inneren Antwort enthaltene ResponseHeader sollte in keiner Weise ausgewertet werden.
Wenn Clients die neueste Revision benötigen, sollten sie immer den obersten ResponseHeader in TxnResponse prüfen.
Watch-API
Die API Watch bietet eine ereignisbasierte Schnittstelle zur asynchronen Überwachung von Schlüsseländerungen. Ein etcd-Watch wartet auf Änderungen, indem er ab einer angegebenen aktuellen oder historischen Revision fortlaufend beobachtet und Schlüsselaktualisierungen an den Client zurückstreamt.
Ereignisse
Jede Änderung an jedem Schlüssel wird durch Event-Nachrichten dargestellt. Eine Event-Nachricht enthält sowohl die Daten als auch die Art der Aktualisierung:
- Type - Die Art des Ereignisses. PUT zeigt an, dass neue Daten unter dem Schlüssel gespeichert wurden. DELETE zeigt an, dass der Schlüssel gelöscht wurde.
- KV - Der dem Ereignis zugeordnete KeyValue. Ein PUT-Ereignis enthält das aktuelle kv-Paar. Ein PUT-Ereignis mit kv.Version=1 zeigt die Erstellung eines Schlüssels an. Ein DELETE-Ereignis enthält den gelöschten Schlüssel, dessen Änderungsrevision auf die Revision der Löschung gesetzt ist.
- Prev_KV - Das Schlüssel-Wert-Paar aus der Revision unmittelbar vor dem Ereignis. Um Bandbreite zu sparen, wird es nur gesetzt, wenn der Watch dies ausdrücklich aktiviert hat.
Watch-Streams
Watches sind lang laufende Anfragen und übertragen Ereignisdaten über gRPC-Streams. Ein Watch-Stream ist bidirektional: Der Client schreibt in den Stream, um Watches einzurichten, und liest daraus, um Watch-Ereignisse zu empfangen. Ein einzelner Stream kann viele verschiedene Watches multiplexen, indem er Ereignisse mit einer Kennung pro Watch versieht. Dieses Multiplexing verringert den Speicherbedarf und den Verbindungsaufwand im eigentlichen etcd-Cluster.
Garantien für Watch-Ereignisse sind unter Garantien der etcd-API beschrieben.
Ein Client erstellt einen Watch, indem er eine WatchCreateRequest über einen von Watch zurückgegebenen Stream sendet:
- Key, Range_End - Der zu beobachtende Schlüsselbereich.
- Start_Revision - Eine optionale Revision, ab der einschließlich beobachtet wird. Ist sie nicht angegeben, werden Ereignisse nach der Revision im Antwortheader der Watch-Erstellung gestreamt. Der gesamte verfügbare Ereignisverlauf kann ab der letzten Kompaktierungsrevision beobachtet werden.
- Progress_Notify - Wenn gesetzt und keine aktuellen Ereignisse vorliegen, erhält der Watch regelmäßig eine WatchResponse ohne Ereignisse. Das ist nützlich, wenn Clients einen unterbrochenen Watcher ab einer kürzlich bekannt gewordenen Revision wiederherstellen möchten. Der etcd-Server entscheidet anhand der aktuellen Serverlast, wie häufig er Benachrichtigungen sendet.
- Filters - Eine Liste von Ereignistypen, die serverseitig herausgefiltert werden sollen.
- Prev_Kv - Wenn gesetzt, erhält der Watch die Schlüssel-Wert-Daten vor dem Ereignis. So lässt sich erkennen, welche Daten überschrieben wurden.
Als Antwort auf eine WatchCreateRequest oder bei einem neuen Ereignis für einen eingerichteten Watch erhält der Client eine WatchResponse:
- Watch_ID - Die ID des Watches, zu dem die Antwort gehört.
- Created - Wird auf true gesetzt, wenn die Antwort zu einer Anfrage zum Erstellen eines Watches gehört. Der Client sollte die ID speichern und die Ereignisse für den Watch im Stream erwarten. Alle an den erstellten Watcher gesendeten Ereignisse haben dieselbe watch_id.
- Canceled - Wird auf true gesetzt, wenn die Antwort zu einer Anfrage zum Abbrechen eines Watches gehört. An den abgebrochenen Watcher werden keine weiteren Ereignisse gesendet.
- Compact_Revision - Wird auf die kleinste in etcd verfügbare historische Revision gesetzt, wenn ein Watcher versucht, eine kompaktierte Revision zu beobachten. Dies geschieht beim Erstellen eines Watchers an einer kompaktierten Revision oder wenn er den Fortschritt des Schlüssel-Wert-Speichers nicht einholen kann. Der Watcher wird abgebrochen; das Erstellen neuer Watches mit derselben start_revision schlägt fehl.
- Events - Eine geordnete Liste neuer Ereignisse für die angegebene Watch-ID.
Wenn der Client keine weiteren Ereignisse für einen Watch empfangen möchte, sendet er eine WatchCancelRequest:
- Watch_ID - Die ID des abzubrechenden Watches, damit keine weiteren Ereignisse übertragen werden.
Lease-API
Leases sind ein Mechanismus zur Erkennung, ob Clients noch aktiv sind. Der Cluster gewährt Leases mit einer Lebensdauer. Eine Lease läuft ab, wenn der etcd-Cluster innerhalb eines angegebenen TTL-Zeitraums kein keepAlive empfängt.
Um Leases mit dem Schlüssel-Wert-Speicher zu verknüpfen, kann jeder Schlüssel höchstens einer Lease zugeordnet werden. Läuft eine Lease ab oder wird sie widerrufen, werden alle ihr zugeordneten Schlüssel gelöscht. Jeder abgelaufene Schlüssel erzeugt ein Löschereignis im Ereignisverlauf.
Leases erhalten
Leases werden mit dem API-Aufruf LeaseGrant angefordert. Er nimmt eine LeaseGrantRequest entgegen:
- TTL - Die als Richtwert angegebene Lebensdauer in Sekunden.
- ID - Die angeforderte ID der Lease. Ist ID auf 0 gesetzt, wählt etcd eine ID aus.
Der Client erhält vom Aufruf LeaseGrant eine LeaseGrantResponse:
- ID - Die Lease-ID der gewährten Lease.
- TTL - Die vom Server gewählte Lebensdauer der Lease in Sekunden.
- ID - Die Lease-ID der zu widerrufenden Lease. Beim Widerruf werden alle zugeordneten Schlüssel gelöscht.
Keepalives
Leases werden über einen bidirektionalen Stream erneuert, der mit dem API-Aufruf LeaseKeepAlive erstellt wird. Möchte der Client eine Lease erneuern, sendet er eine LeaseKeepAliveRequest über den Stream:
- ID - Die Lease-ID der am Leben zu haltenden Lease.
Der Keepalive-Stream antwortet mit einer LeaseKeepAliveResponse:
- ID - Die Lease, die mit einer neuen TTL erneuert wurde.
- TTL - Die neue verbleibende Lebensdauer der Lease in Sekunden.
12.6 - Dateien der persistenten Speicherung in etcd
Dieses Dokument erläutert das Format der persistenten Speicherung in etcd: Benennung, Inhalt und Werkzeuge, mit denen Entwickler die Dateien untersuchen können. Künftig sollte es um Änderungen am Speichermodell erweitert werden. Es richtet sich an etcd-Entwickler und soll sie bei der Datenwiederherstellung unterstützen.
Voraussetzungen
Die folgenden Artikel liefern hilfreiche Hintergrundinformationen zu diesem Dokument:
- Überblick über das Datenmodell von etcd
- Überblick über Raft , insbesondere Abschnitt „5.3 Logreplikation“.
Überblick
Langlebige Dateien
| Dateiname | Zweck |
|---|---|
./member/snap/db |
bbolt B+-Baum, der alle angewendeten Daten, Informationen zur Mitgliedschaft und Autorisierung sowie Metadaten speichert. Er kennt den zuletzt angewendeten WAL-Index ("consistent_index"). |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap |
Regelmäßige Snapshots des alten v2-Speichers, mit:
Seit etcd v3 ist dieser Inhalt gegenüber den /snap/db-Dateien redundant. Regelmäßig (30s) werden diese Dateien bereinigt, wobei die letzten |
/member/snap/000000000007a178.snap.db |
Ein vollständiger heruntergeladener bbolt-Snapshot vom etcd-Leader, falls das Replikat zu weit zurücklag. Enthält dieselbe Art von Daten wie die Datei ( Die Datei wird in 2 Fällen verwendet:
Die Datei wird nach Abschluss der Wiederherstellung nicht gelöscht (der gesamte Inhalt wurde dann in ./member/snap/db übernommen). Regelmäßig (30s) werden die Dateien bereinigt.
Auch hier bleiben |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal |
Write-Ahead-Logs von Raft, mit aktuellen von Raft akzeptierten Transaktionen, regelmäßigen Snapshots oder CRC-Einträgen. Die neuesten Bei zu seltenen Snapshots können mehr als |
./member/wal/0.tmp (or .../1.tmp) |
Vorab zugewiesener Speicherplatz für die nächste Write-Ahead-Log-Datei. Verhindert, dass Raft wegen fehlender WAL-Kapazität blockiert, ohne einen Alarm auslösen zu können. |
Temporäre Dateien
Während der internen Verarbeitung von etcd können mehrere kurzlebige Dateien auftreten:
| Datei | Zweck |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken |
Snapshot-Dateien werden in „broken“ umbenannt, wenn sie nicht geladen werden können.
Der Versuch, die neueste Datei zu laden, erfolgt, wenn etcd gestartet wird. Oder während der backup/migrate-Befehle von etcdctl. |
./member/snap/tmp071677638 (random suffix) |
Temporäre bbolt-Datei, die auf Replikaten als Antwort auf die msgSnap-Anfrage des Leaders erstellt wird, also auf dessen Aufforderung, den Speicher aus dem angegebenen Snapshot wiederherzustellen.
Nach erfolgreichem vollständigem Abruf des Inhalts wird die Datei umbenannt in: Siehe etcd/issues/12837. In etcd 3.5 behoben. |
/member/snap/db.tmp.071677638 (random suffix) |
Eine temporäre Datei, die während der Defragmentierung eine Kopie des Backend-Inhalts (/member/snap/db) enthält. Nach erfolgreichem Abschluss wird sie in /member/snap/db umbenannt und ersetzt das ursprüngliche Backend. Beim Start des etcd-Servers werden diese Dateien bereinigt. |
bbolt-B+-Baum: member/snap/db
Diese Datei enthält die Hauptdaten von etcd, angewendet bis zu einer bestimmten Position im Raft-Log (siehe consistent_index ).
Physischer Aufbau
Der Speicher von „better bolt“ ist physisch als B+-Baum
organisiert. Die physischen Seiten des B-Baums werden niemals an Ort und Stelle geändert1. Stattdessen wird ihr Inhalt auf eine neue Seite kopiert, die aus der Liste freier Seiten stammt. Die alte Seite wird dieser Liste hinzugefügt, sobald keine offene Transaktion mehr auf sie zugreifen könnte. Dadurch sieht eine offene RO-Transaktion einen konsistenten historischen Speicherzustand. Die RW-Transaktion ist exklusiv und blockiert alle anderen RW-Transaktionen.
Große Werte werden auf mehreren zusammenhängenden Seiten gespeichert. Die Wiederverwendung von Seiten zusammen mit der nötigen Zuweisung zusammenhängender Seitenbereiche unterschiedlicher Größe kann zu einer zunehmenden Fragmentierung des bbolt-Speichers führen.
Die bbolt-Datei schrumpft niemals von selbst. Nur bei der Defragmentierung kann sie in eine neue Datei mit einem Puffer freier Seiten am Ende und verkleinerter Dateigröße umgeschrieben werden.
Logischer Aufbau
Der bbolt-Speicher ist in Buckets unterteilt. In jedem Bucket werden Schlüssel (Paare vom Typ byte[]->value byte[]) in lexikografischer Reihenfolge gespeichert. Die folgende Liste zeigt die von etcd verwendeten Buckets mit Stand Version 3.5 und ihre Schlüssel.
| Bucket | Schlüssel | Beispielwert | Beschreibung |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT}
|
nil |
Zeigt an, dass bei einem Mitglied Probleme erkannt wurden. |
| auth | "authRevision" | "" (leer) oder BigEndian.PutUint64 |
Jede Änderung an Rollen oder Benutzern erhöht dieses Feld beim Bestätigen der Transaktion. Der Wert dient ausschließlich zur optimistischen Sperrung während des Autorisierungsvorgangs. |
| authRoles | [roleName] als Zeichenfolge | authpb.Role serialisiert |
|
| authUsers | [userName] als Zeichenfolge | authpb.User serialisiert |
|
| cluster | "clusterVersion" | "3.5.0" (string) |
Minor-Version der durch Konsens vereinbarten gemeinsamen Speicherversion. |
| "downgrade" | JSON: {
"target-version": "3.4.0"
"enabled": true/false
}
|
Speichert die Absicht dauerhaft, die durch die neueste Anfrage Seit v3.5 |
|
| key |
[revisionId], kodiert mit bytesToRev{main,sub} Löschungen von Schlüssel-Wert-Paaren werden mit einem abschließenden 't' als „Tombstone“ serialisiert |
mvccpb.KeyValue als serialisiertes Proto (key, create_rev, mod_rev, version, value, lease id) |
|
| lease | leasepb.Lease als serialisiertes Proto (ID, TTL, RemainingTTL) |
Hinweis: LeaseCheckpoint verlängert nur RemainingTTL. TTL stammt weiterhin vom ursprünglichen Grant. Hinweis2: TTLs werden in Sekunden ab einem nicht definierten „jetzt“ gespeichert. Ein ständig abstürzender und neu startender Server gibt keine Leases frei!!! |
|
| members | [memberId] hexadezimal als Zeichenfolge: "8e9e05c52164694d" |
Als JSON-Zeichenfolge serialisierte Member-Struktur:
{
  "id":10276657743932975437,
  "peerURLs":[
  "http://localhost:2380"],
  "name":"default",
  "clientURLs": ["http://localhost:2379"]
}
|
Durch Konsens vereinbarte Informationen zur Clustermitgliedschaft. |
| members_removed | [memberId] hexadezimal als Zeichenfolge: "8e9e05c52164694d" |
[]byte("removed") |
IDs aller entfernten Mitglieder. Damit wird geprüft, dass ein entferntes Mitglied niemals unter derselben ID erneut hinzugefügt wird. Das Feld wird derzeit (3.4) aus dem V2-Speicher und niemals aus V3 gelesen. Siehe https://github.com/etcd-io/etcd/pull/12820 |
| meta | "consistent_index" | uint64-Bytes (BigEndian) | Repräsentiert den Offset des letzten auf den bolt-DB-Speicher angewendeten WAL-Eintrags. |
| "scheduledCompactRev" | bytesToRev{main,sub} kodiert. (16 Bytes) | Dient zur erneuten Initialisierung der Kompaktierung, wenn nach einer Kompaktierungsanfrage ein Absturz aufgetreten ist. | |
| "finishedCompactRev" | bytesToRev{main,sub} kodiert. (16 Bytes) | Revision, bis zu der der Speicher zuletzt erfolgreich kompaktiert wurde (https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | Seit etcd 3.5 | ||
| "term" | Seit etcd 3.5 | ||
| "storage-version" |
Werkzeuge
bbolt
bbolt bietet ein Befehlszeilenwerkzeug zum Untersuchen des Dateiinhalts.
Anwendungsbeispiele:
Alle Buckets einer bbolt-Datei auflisten:
Ein bestimmtes Schlüssel-Wert-Paar lesen:
etcd-dump-db
etcd-dump-db kann den Inhalt des etcd-v3-Backends (bbolt) auflisten.
Weitere Beispiele: https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db
WAL: Write-Ahead-Log
Das Write-Ahead-Log ist ein persistenter Raft-Speicher für Vorschläge. Zuerst speichert der Leader den Vorschlag in seinem Log und repliziert ihn anschließend gleichzeitig über das Raft-Protokoll an die Follower. Jeder Follower speichert den Vorschlag dauerhaft in seinem WAL, bevor er dem Leader die Replikation bestätigt.
Das in etcd verwendete WAL unterscheidet sich in 2 Punkten vom kanonischen Raft-Modell:
- Es speichert nicht nur indizierte Einträge dauerhaft, sondern auch kleine Raft-Snapshots und HardState. So lässt sich der gesamte Raft-Zustand eines Mitglieds allein aus dem WAL wiederherstellen.
- Es wird nur angehängt. Einträge werden nicht an Ort und Stelle überschrieben; ein später in der Datei angehängter Eintrag mit demselben Index ersetzt den vorherigen logisch.
Dateinamen
Die WAL-Dateien werden nach folgendem Muster benannt:
Beispiel: ./member/wal/0000000000000010-00000000000bf1e6.wal
Die Dateinamen enthalten also hexadezimal kodiert:
- Die fortlaufende Nummer der WAL-Datei
- Den Index des ersten Eintrags oder Snapshots in der Datei. Insbesondere enthält die erste Datei „0000000000000000-0000000000000000.wal“ den anfänglichen Snapshot-Eintrag mit index=0.
Physischer Inhalt
Die WAL-Datei enthält eine Folge von „Frames “. Jeder Frame enthält:
- Eine in LittleEndian 2 kodierte uint64-Zahl mit der Länge des serialisierten walpb.Record (3).
- Auffüllung: Eine Anzahl von 0-Bytes, sodass die Größe des gesamten Frames ausgerichtet ist (mod 8)
- Serialisierte walpb.Record
-Daten:
- type - Als int kodierte Aufzählung, die die Interpretation des folgenden data-Felds bestimmt
- data - Je nach type gewöhnlich ein serialisiertes Proto
- crc - CRC-32-Prüfsumme aller zusammengefassten „data“-Felder ohne type in allen Logeinträgen dieses Replikats seit Erstellung des WAL. CRC berücksichtigt ALLE Einträge, auch wenn sie nicht durch Raft bestätigt wurden.
Eine neue Datei beginnt, sobald die aktuelle Datei 64*10^6 Bytes überschreitet.
Logischer Inhalt
Auf logischer Ebene enthalten Write-Ahead-Log-Dateien:
Raftpb.Entry:Aktuelle vom Raft-Leader replizierte Vorschläge. Einige gelten als bestätigt, andere können noch logisch überschrieben werden.Raftpb.HardState(term,commit,vote):Regelmäßige, sehr häufige Informationen über den Index eines bestätigten Logeintrags, der also auf die Mehrheit der Server repliziert wurde. Er wird garantiert nicht mehr geändert oder überschrieben und kann auf die Backends v2 und v3 angewendet werden. Enthalten sind außerdem ein „term“ als Hinweis auf wahlbezogene Änderungen sowie eine Stimme: das Mitglied, für das das aktuelle Replikat im aktuellen Term gestimmt hat.walpb.Snapshot(term, index):Regelmäßige Snapshots des Raft-Zustands ohne DB-Inhalt, nur mit Snapshot-Logindex und Raft-Term- Der Inhalt des V2-Speichers liegt in separaten *.store-Dateien.
- Der Inhalt des V3-Speichers wird in der bbolt-Datei verwaltet und bildet einen impliziten Snapshot, sobald die Einträge dort angewendet sind.
- Ein crc32-Prüfsummeneintrag am Anfang jeder Datei, um die CRC-Prüfung für den Rest der Datei fortzusetzen.
etcdserverpb.Metadata(node_id, cluster_id)- Identifiziert den Cluster und das Replikat, für die das Log steht.
Jede WAL-Datei besteht in dieser Reihenfolge aus:
-
CRC-32-Frame mit der fortlaufenden crc aller vorherigen Dateien, 0 für die erste Datei.
-
Metadaten-Frame mit Cluster- und Replikat-IDs
-
Nur für die erste WAL-Datei:
- Leerer Snapshot-Frame (Index:0, Term: 0). Er stellt die Invariante sicher, dass allen Einträgen ein Snapshot vorausgeht.
Für spätere WAL-Dateien (ab der 2.):
- HardState-Frame.
-
Mischung aus Entry-, HardState- und Snapshot-Einträgen
Das WAL kann mehrere Einträge mit demselben Index enthalten. Dies kann in den in Abbildung 7. der Raft-Veröffentlichung beschriebenen Fällen auftreten. Da an das etcd-WAL nur angehängt wird, werden Einträge durch Anhängen eines neuen Eintrags mit demselben Index überschrieben.
Insbesondere ersetzt die Leselogik alte Einträge durch neuere Einträge . Daher kann nur die jeweils letzte Version von Einträgen mit entry.index <= HardState.commit als endgültig gelten. Einträge mit index > HardState.commit können sich noch ändern.
Es wird erwartet, dass die Terms im WAL monoton sind.
Für die Indizes im WAL wird Folgendes erwartet:
- Sie beginnen bei einem Snapshot.
- Nach diesem Snapshot steigen sie fortlaufend, solange sie im selben Term bleiben.
- Bei einem Term-Wechsel kann der Index sinken, jedoch nur auf einen neuen Wert oberhalb des neuesten HardState.commit.
- Ein neuer Snapshot kann mit jedem Index >= HardState.commit auftreten und beginnt eine neue Indexfolge.
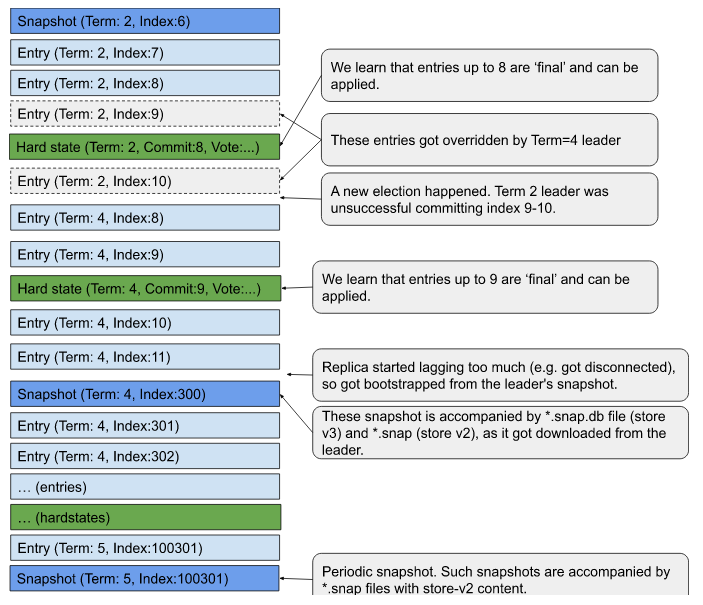
Werkzeuge
etcd-dump-logs
WAL-Dateien von etcd können mit dem Werkzeug etcd-dump-logs gelesen werden:
Zu beachten:
- Das Werkzeug zeigt nur Entries und nicht alle WAL-Einträge wie Snapshots und HardStates in den WAL-Dateien.
- Es berücksichtigt automatisch das Überschreiben von Einträgen. Wurde ein Eintrag durch einen neueren mit demselben Index überschrieben, wird nur der endgültige Wert ausgegeben.
- Es gibt auch unbestätigte Einträge vom Ende des LOG aus, ohne Informationen zu HardState.commitIndex. Daher ist nicht erkennbar, ob diese Einträge endgültig sind.
Snapshots des V2-Speichers: member/snap/{term}-{index}.snap
Dateinamen:
member/snap/{term}-{index}.snap
Die Dateinamen werden hier
mit ("%016x-%016x.snap") erzeugt und verwenden 2 hexadezimal kodierte Bestandteile:
- term -> Raft-Term, also der Zeitraum zwischen Wahlen, zum Zeitpunkt der Snapshot-Erstellung
- index -> Index des zuletzt angewendeten Vorschlags zum Zeitpunkt der Snapshot-Erstellung
Erstellung
Die *.snap-Dateien werden von der Methode Snapshotter.SaveSnap erstellt.
Es gibt 2 Auslöser für die Erstellung dieser Dateien:
- Ungefähr alle –snapshot-count=(standardmäßig 10,000 in v3.7.0) angewendeten Vorschläge wird eine neue Datei erstellt. Dies ist nur ein Näherungswert, da Vorschläge gebündelt eintreffen können, ein Snapshot erst am Ende eines solchen Pakets geprüft und der Snapshot-Vorgang schließlich asynchron eingeplant wird. Der Optionsname –snapshot-count ist recht irreführend, da er die Differenz der Indexwerte zwischen dem letzten Snapshot und dem zuletzt angewendeten Vorschlag steuert.
- Raft fordert das Replikat auf, sich aus einem Snapshot wiederherzustellen. Während das Replikat den Snapshot über eine msgSnap-Nachricht empfängt, hält es ihn auch als kleinen Checkpoint im WAL fest. Damit ist garantiert, dass am Ende des WAL stets ein gültiger Snapshot gefolgt von Einträgen steht. Mögliche Lücken im WAL werden so vermieden.
Derzeit entsprechen die Dateien ungefähr3 im Verhältnis 1-1 den Snapshot-Einträgen im WAL. Mit der Stilllegung des v2-Speichers wird erwartet, dass diese Dateien überhaupt nicht mehr geschrieben werden, optional ab 3.5.x und verpflichtend ab 3.6.x.
Inhalt
Die Datei enthält das serialisierte snapdb.snapshot-Proto
(uint32 crc, bytes data),
das im Feld ‘data’ einen Raftpb.Snapshot enthält:
(bytes data, SnapshotMetadata{index, term, conf } metadata),
Die verschachtelten Daten enthalten schließlich den JSON-serialisierten Inhalt des v2-Speichers .
Insbesondere enthalten sind:
- Term
- Index
- Mitgliedschaftsdaten:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- Speicherversion: /0/version-> 3.5.0
Werkzeuge
protoc
Der folgende Befehl zeigt den Dateiinhalt an, wenn er im Stammverzeichnis von etcd ausgeführt wird:
Ebenso lässt sich das Feld ‘data’ extrahieren und als Raftpb.Snapshot dekodieren.
Beispiel für JSON-serialisierten v2-Speicherinhalt in *.snap-Dateien von etcd 3.4:
Änderungen
Dieser Abschnitt ist für die Beschreibung von Dateiformatänderungen zwischen etcd-Versionen vorgesehen.
-
Die Metadatenseiten am Anfang der bbolt-Datei werden an Ort und Stelle geändert. ↩︎
-
Inkonsistent, da die meisten uint-Werte in Big Endian geschrieben werden ↩︎
-
Der anfängliche Snapshot mit index:0 am Anfang des WAL ist keiner *.snap-Datei zugeordnet. Zudem können alte *.snap-Dateien oder WAL-Dateien bereinigt werden. ↩︎
12.7 - Garantien der etcd-API
etcd ist ein konsistenter und dauerhafter Schlüssel-Wert-Speicher. Der Zugriff erfolgt über gRPC-Dienste . etcd bietet die stärksten Konsistenz- und Dauerhaftigkeitsgarantien für ein verteiltes System. Diese Spezifikation führt die API-Garantien von etcd auf.
Betrachtete APIs
- KV-APIs
- Watch-APIs
- Lease-APIs
Die KV-API ermöglicht das direkte Lesen und Bearbeiten des Schlüssel-Wert-Speichers. Mit der Watch-API lassen sich Änderungen am Schlüssel-Wert-Speicher abonnieren. Mit der Lease-API lässt sich einem Schlüssel eine Lebensdauer zuweisen.
Die KV- und Watch-APIs erlauben den Zugriff nicht nur auf die neuesten Schlüsselversionen, sondern auch auf frühere Versionen innerhalb eines zusammenhängenden Verlaufsfensters, das durch eine Kompaktierungsoperation begrenzt wird.
Ein Aufruf der KV-API wirkt unmittelbar, während die Watch-API mit einer nicht begrenzten Verzögerung zurückkehrt. In einem korrekt arbeitenden etcd-Cluster sollten Watch-Ereignisse etwa 10ms nach ihrem Auftreten sichtbar werden. Es gibt jedoch keine Obergrenze; in gestörten Clustern kommen Ereignisse möglicherweise nie an.
KV-APIs
etcd gewährleistet Dauerhaftigkeit und strikte Serialisierbarkeit für alle KV-API-Aufrufe. Dies sind die stärksten Isolationsgarantien verteilter transaktionaler Datenbanksysteme.
Dauerhaftigkeit
Alle abgeschlossenen Operationen sind dauerhaft. Auch alle zugänglichen Daten sind dauerhaft gespeichert. Ein Lesezugriff gibt niemals Daten zurück, die noch nicht dauerhaft gespeichert wurden.
Strikte Serialisierbarkeit
Operationen des KV-Dienstes sind atomar und erfolgen in einer totalen Ordnung, die ihrer Echtzeitreihenfolge entspricht. Diese totale Ordnung ergibt sich aus der Revision . Weitere Informationen zur strikten Serialisierbarkeit .
Bei Transaktionen ohne verschachtelte TXNs entspricht die Ausführungsreihenfolge garantiert jener in der Operationsliste. Dadurch sind die GET-Antworten innerhalb der Transaktion stabil. Bei Transaktionen mit verschachtelten TXNs ist die Ausführungsreihenfolge nicht festgelegt.
Strikte Serialisierbarkeit impliziert weitere, schwächere Garantien, die möglicherweise leichter verständlich sind:
Atomarität
Alle API-Anfragen sind atomar: Eine Operation wird entweder vollständig oder gar nicht abgeschlossen. Bei Watch-Anfragen befinden sich alle von einer Operation erzeugten Ereignisse in einer Watch-Antwort. Ein Watch beobachtet niemals nur einen Teil der Ereignisse einer einzelnen Operation.
Linearisierbarkeit
Aus Sicht des Clients bietet Linearisierbarkeit nützliche Eigenschaften, die das Nachvollziehen des Verhaltens erleichtern.
Die folgende klare Beschreibung stammt aus der
Originalveröffentlichung
: Linearisierbarkeit erweckt den Eindruck, dass jede von nebenläufigen Prozessen ausgeführte Operation zu einem Zeitpunkt zwischen ihrem Aufruf und ihrer Antwort augenblicklich wirksam wird.
Angenommen, ein Client schließt einen Schreibvorgang zum Zeitpunkt 1 (t1) ab. Ein Client, der zu t2 mit t2 > t1 einen Lesevorgang startet, sollte einen Wert erhalten, der mindestens so aktuell ist wie der zuvor zu t1 abgeschlossene Schreibvorgang. Der Lesevorgang wird möglicherweise aber erst zu t3 abgeschlossen. Linearisierbarkeit garantiert, dass er den neuesten Wert zu einem Zeitpunkt zwischen seinem Beginn zu t2 und seinem Abschluss zu t3 zurückgibt. Er berücksichtigt alle vor seinem Beginn abgeschlossenen Schreibvorgänge. Ein gleichzeitiger Schreibvorgang zwischen t2 und t3 kann berücksichtigt werden oder auch nicht; der zurückgegebene Wert muss beim Abschluss des Lesevorgangs nicht der neueste sein.
etcd gewährleistet standardmäßig Linearisierbarkeit für alle anderen Operationen.
Sie hat jedoch ihren Preis, da linearisierte Anfragen den Raft-Konsensprozess durchlaufen müssen.
Für geringere Latenzen und höheren Durchsatz bei Leseanfragen können Clients deren Konsistenzmodus
auf serializable setzen. Dabei können gegenüber dem Quorum veraltete Daten gelesen werden,
doch der Leistungsnachteil linearisierter Zugriffe durch ihre Abhängigkeit vom laufenden Konsens entfällt.
Watch-APIs
Watches bieten folgende Garantien für Ereignisse:
- Geordnet - Ereignisse sind nach Revision geordnet. Ein Ereignis erscheint niemals in einem Watch, wenn es zeitlich vor einem bereits ausgegebenen Ereignis liegt. Bei Transaktionen ohne verschachtelte TXNs entspricht die Reihenfolge der erzeugten Ereignisse garantiert der Reihenfolge in der Operationsliste. Bei Transaktionen mit verschachtelten TXNs ist sie nicht festgelegt.
- Eindeutig - Ein Ereignis erscheint niemals zweimal in einem Watch.
- Zuverlässig - Innerhalb des verfügbaren Verlaufsfensters geht niemals eine Teilfolge einer Ereignisfolge verloren. Sind Ereignisse zeitlich als a < b < c geordnet und empfängt der Watch a und c, empfängt er garantiert auch b, sofern b im verfügbaren Verlaufsfenster liegt.
- Atomar - Eine Ereignisliste umfasst garantiert vollständige Revisionen. Aktualisierungen mehrerer Schlüssel in derselben Revision werden nicht auf mehrere Ereignislisten aufgeteilt.
- Fortsetzbar - Ein unterbrochener Watch kann durch einen neuen Watch fortgesetzt werden, der nach der letzten vor der Unterbrechung in einem Watch-Ereignis empfangenen Revision beginnt, sofern diese Revision noch im Verlaufsfenster liegt.
- Mit Fortschrittsmarken - Fortschrittsbenachrichtigungen garantieren, dass alle Ereignisse bis zu einer Revision bereits ausgeliefert wurden.
etcd gewährleistet keine Linearisierbarkeit für Watch-Operationen. Von Benutzern wird erwartet, die Revision von Watch-Ereignissen zu prüfen, um ihre korrekte Reihenfolge gegenüber anderen Operationen sicherzustellen.
Lease-APIs
etcd bietet einen Lease-Mechanismus . Der wichtigste Anwendungsfall einer Lease ist die Implementierung verteilter Koordinationsmechanismen wie verteilter Sperren. Der Mechanismus selbst ist einfach: Eine Lease kann mit der Grant-API erstellt, mit der Put-API einem Schlüssel zugeordnet und mit der Revoke-API widerrufen werden. Sie läuft nach ihrer anhand der realen Uhrzeit gemessenen Lebensdauer (TTL) ab. Um korrekte verteilte Koordinationsmechanismen zu implementieren, müssen Benutzer jedoch die wesentlichen Eigenschaften der APIs und ihrer Verwendung kennen.
etcd-spezifische Definitionen
Abgeschlossene Operation
Eine etcd-Operation gilt als abgeschlossen, wenn sie durch Konsens bestätigt und damit von der
Speicherengine von etcd „ausgeführt“, also dauerhaft gespeichert wurde. Der Client weiß, dass eine
Operation abgeschlossen ist, sobald er eine Antwort vom etcd-Server erhält. Bei einer Zeitüberschreitung
oder einer Netzwerkunterbrechung zwischen Client und etcd-Mitglied kann ihr Status für den Client jedoch
ungewiss sein. etcd kann Operationen auch während einer Leader-Wahl abbrechen. In diesem Fall sendet
etcd keine abort-Antworten auf ausstehende Client-Anfragen.
Revision
Einer etcd-Operation, die den Schlüssel-Wert-Speicher ändert, wird genau eine steigende Revision zugewiesen. Eine Transaktionsoperation kann den Speicher mehrfach ändern, erhält aber nur eine Revision. Das Revisionsattribut eines durch die Operation geänderten Schlüssel-Wert-Paars hat denselben Wert wie die Revision der Operation. Die Revision kann als logische Uhr des Schlüssel-Wert-Speichers dienen. Ein Paar mit einer größeren Revision wurde nach einem Paar mit einer kleineren Revision geändert. Zwei Schlüssel-Wert-Paare mit derselben Revision wurden durch eine Operation „gleichzeitig“ geändert.
12.8 - etcd im Vergleich mit anderen Schlüssel-Wert-Speichern
Der Name „etcd“ entstand aus zwei Ideen: dem Unix-Verzeichnis “/etc” und verteilten Systemen, auf Englisch „distributed systems“. Im Verzeichnis “/etc” liegen Konfigurationsdaten eines einzelnen Systems, während etcd Konfigurationsinformationen für große verteilte Systeme speichert. Aus „/etc“ und dem Anfangsbuchstaben von „distributed“ wird somit „etcd“.
etcd ist als allgemeine Grundlage für große verteilte Systeme ausgelegt. Diese Systeme tolerieren keinen Split-Brain-Betrieb und nehmen dafür Einschränkungen der Verfügbarkeit in Kauf. etcd speichert Metadaten konsistent und fehlertolerant. Ein etcd-Cluster soll einen Schlüssel-Wert-Speicher mit erstklassiger Stabilität, Zuverlässigkeit, Skalierbarkeit und Leistung bieten.
Verteilte Systeme verwenden etcd als konsistenten Schlüssel-Wert-Speicher für Konfigurationsverwaltung, Diensterkennung und die Koordination verteilter Arbeit. Viele Organisationen nutzen etcd für Produktivsysteme wie Container-Scheduler, Dienste zur Diensterkennung und verteilte Datenspeicherung. Häufige verteilte Entwurfsmuster mit etcd sind Leader-Wahlen , verteilte Sperren und die Überwachung der Erreichbarkeit von Rechnern.
Anwendungsfälle
- Container Linux von CoreOS: Anwendungen auf Container Linux erhalten automatische Linux-Kernel-Updates ohne Ausfallzeit. Container Linux koordiniert Updates mit locksmith . Locksmith implementiert über etcd ein verteiltes Semaphor, das sicherstellt, dass zu jedem Zeitpunkt nur ein Teil des Clusters neu startet.
- Kubernetes speichert Konfigurationsdaten für Diensterkennung und Clusterverwaltung in etcd. Die Konsistenz von etcd ist für die korrekte Einplanung und den Betrieb von Diensten entscheidend. Der Kubernetes-API-Server speichert den Clusterzustand dauerhaft in etcd. Er verwendet die Watch-API von etcd, um den Cluster zu überwachen und kritische Konfigurationsänderungen auszurollen.
Vergleichstabelle
Vielleicht erscheint etcd bereits passend. Wie bei jeder Technologieentscheidung ist jedoch Vorsicht geboten. Diese Dokumentation wurde vom etcd-Team verfasst. Obwohl ein unvoreingenommener Vergleich von Technik und Funktionen das Ziel ist, begünstigen Fachkenntnisse und Vorlieben der Autoren offensichtlich etcd. Nur nach Anweisung verwenden.
Die folgende Tabelle bietet einen schnellen Überblick über die Unterschiede zwischen etcd und seinen beliebtesten Alternativen. Weitere Erläuterungen und Einzelheiten zu jeder Spalte folgen in den Abschnitten nach der Tabelle.
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| Grundoperationen für Nebenläufigkeit | Lock-RPCs , Election-RPCs , Sperren per Befehlszeile , Wahlen per Befehlszeile , Rezepte in Go | Externe Curator-Rezepte in Java | Native Sperr-API | Selten , wenn überhaupt |
| Linearisierbare Lesezugriffe | Ja | Nein | Ja | Manchmal |
| Mehrversions-Nebenläufigkeitskontrolle | Ja | Nein | Nein | Manchmal |
| Transaktionen | Feldvergleiche, Lesen, Schreiben | Versionsprüfungen, Schreiben | Feldvergleich, Sperren, Lesen, Schreiben | Im SQL-Stil |
| Änderungsbenachrichtigungen | Historische und aktuelle Schlüsselintervalle | Aktuelle Schlüssel und Verzeichnisse | Aktuelle Schlüssel und Präfixe | Trigger (manchmal) |
| Benutzerberechtigungen | Rollenbasiert | ACLs | ACLs | Unterschiedlich (GRANT pro Tabelle, Rollen pro Datenbank) |
| API für HTTP/JSON | Ja | Nein | Ja | Selten |
| Neukonfiguration der Mitgliedschaft | Ja | >3.5.0 | Ja | Ja |
| Maximal zuverlässig nutzbare Datenbankgröße | Mehrere Gigabyte | Hunderte Megabyte (manchmal mehrere Gigabyte) | Hunderte MB | Terabyte und mehr |
| Minimale Latenz zur Linearisierung von Lesezugriffen | Netzwerk-RTT | Keine Linearisierung von Lesezugriffen | RTT + fsync | Uhrzeitbarrieren (Atomuhr, NTP) |
ZooKeeper
ZooKeeper löst dasselbe Problem wie etcd: die Koordination verteilter Systeme und die Speicherung von Metadaten. etcd kann jedoch auf Entwicklungs- und Betriebserfahrungen mit dem Entwurf und der Implementierung von ZooKeeper zurückgreifen. Diese Erfahrungen haben den Entwurf von etcd geprägt und dabei geholfen, große Systeme wie Kubernetes zu unterstützen. Zu den Verbesserungen von etcd gegenüber ZooKeeper gehören:
- Dynamische Neukonfiguration der Clustermitgliedschaft
- Stabile Lese- und Schreibzugriffe unter hoher Last
- Ein Datenmodell mit Mehrversions-Nebenläufigkeitskontrolle
- Zuverlässige Schlüsselüberwachung, die niemals unbemerkt Ereignisse verwirft
- Lease-Grundoperationen, die Verbindungen von Sitzungen entkoppeln
- APIs für sichere verteilte gemeinsame Sperren
Darüber hinaus unterstützt etcd unmittelbar zahlreiche Sprachen und Frameworks. ZooKeeper verwendet sein eigenes, ausschließlich dort eingesetztes Jute-RPC-Protokoll, das die unterstützten Sprachanbindungen
begrenzt. Das Client-Protokoll von etcd basiert dagegen auf gRPC
, einem verbreiteten RPC-Framework mit Anbindungen für Go, C++, Java und weitere Sprachen. gRPC lässt sich außerdem als JSON über HTTP serialisieren, sodass auch allgemeine Befehlszeilenwerkzeuge wie curl damit kommunizieren können. Dank dieser Auswahl lassen sich Systeme mit ihren nativen Werkzeugen auf etcd aufbauen, statt sie mit einem einzigen festen Technologiesatz um etcd herum zu entwickeln.
Unter Berücksichtigung von Funktionen, Unterstützung und Stabilität sind neue Anwendungen, die ZooKeeper als konsistenten Schlüssel-Wert-Speicher einsetzen wollen, gut beraten, stattdessen etcd zu wählen.
Consul
Consul ist ein umfassendes Framework zur Diensterkennung. Es bietet integrierte Health Checks, Ausfallerkennung und DNS-Dienste. Außerdem stellt Consul einen Schlüssel-Wert-Speicher mit RESTful-HTTP-APIs bereit. Beim Stand von Consul 1.0 skaliert dieser Speicher bei Schlüssel-Wert-Operationen weniger gut als Systeme wie etcd oder ZooKeeper. Systeme mit Millionen Schlüsseln leiden unter hohen Latenzen und Speicherdruck. Der Schlüssel-Wert-API fehlen insbesondere Mehrversionsschlüssel, bedingte Transaktionen und zuverlässige Streaming-Watches.
etcd und Consul lösen unterschiedliche Probleme. Für einen verteilten konsistenten Schlüssel-Wert-Speicher ist etcd die bessere Wahl. Für eine umfassende Diensterkennung im Cluster reichen die Funktionen von etcd nicht aus; dafür eignen sich Kubernetes, Consul oder SmartStack.
NewSQL (Cloud Spanner, CockroachDB, TiDB)
Sowohl etcd als auch NewSQL-Datenbanken wie Cockroach , TiDB und Google Spanner bieten starke Datenkonsistenzgarantien und Hochverfügbarkeit. Die deutlich unterschiedlichen Systementwurfsparameter führen jedoch zu deutlich unterschiedlichen Client-APIs und Leistungseigenschaften.
NewSQL-Datenbanken sind für horizontale Skalierung über Rechenzentren hinweg ausgelegt. Sie verteilen Daten üblicherweise auf mehrere konsistente Replikationsgruppen, sogenannte Shards, die weit auseinanderliegen können, und speichern Datenmengen im Terabyte-Bereich und darüber. Für verteilte Koordination eignet sich diese Skalierung schlecht: Das Warten auf Uhren verursacht hohe Latenzen, und Aktualisierungen werden mit weitgehend lokalen Abhängigkeitsgraphen erwartet. Die Daten sind in Tabellen organisiert und lassen sich mit SQL-artigen Abfragen mit umfangreicherer Semantik als bei etcd abfragen. Dafür steigt jedoch die Komplexität der Verarbeitung sowie der Planung und Optimierung von Abfragen.
Für Metadatenspeicherung oder die Koordination verteilter Anwendungen eignet sich etcd. Sollen mehr als einige GB Daten gespeichert werden oder sind vollständige SQL-Abfragen erforderlich, eignet sich eine NewSQL-Datenbank.
etcd für Metadaten verwenden
etcd repliziert alle Daten innerhalb einer einzigen konsistenten Replikationsgruppe. Für bis zu einige GB Daten mit konsistenter Reihenfolge ist dies der effizienteste Ansatz. Jede Änderung des Clusterzustands, die mehrere Schlüssel betreffen kann, erhält aus einem monoton steigenden Zähler eine global eindeutige ID, in etcd Revision genannt. Anhand dieser ID lässt sich die Reihenfolge bestimmen. Da es nur eine Replikationsgruppe gibt, muss die Änderungsanfrage zur Bestätigung nur das Raft-Protokoll durchlaufen. Durch die Begrenzung des Konsenses auf eine Replikationsgruppe erreicht etcd verteilte Konsistenz mit einem einfachen Protokoll bei geringer Latenz und hohem Durchsatz.
Die Replikation von etcd lässt sich mangels Daten-Sharding nicht horizontal skalieren. NewSQL-Datenbanken verteilen Daten dagegen üblicherweise auf mehrere konsistente Replikationsgruppen und speichern Datenmengen im Terabyte-Bereich und darüber. Um jeder Änderung eine global eindeutige, steigende ID zuzuweisen, muss jede Anfrage jedoch ein zusätzliches Koordinationsprotokoll zwischen den Replikationsgruppen durchlaufen. Dieser zusätzliche Schritt kann Konflikte um die globale ID verursachen und geordnete Anfragen zur Wiederholung zwingen. Das Ergebnis ist ein komplexerer Ansatz mit üblicherweise schlechterer Leistung als etcd bei strikter Reihenfolge.
Wenn eine Anwendung vor allem Metadaten oder deren Reihenfolge verarbeitet, etwa zur Prozesskoordination, eignet sich etcd. Benötigt sie einen großen Datenspeicher über mehrere Rechenzentren hinweg und ist nicht stark auf eine strikte globale Reihenfolge angewiesen, eignet sich eine NewSQL-Datenbank.
etcd für verteilte Koordination verwenden
etcd bietet direkt Grundoperationen für verteilte Koordination, darunter Ereignis-Watches, Leases, Wahlen und verteilte gemeinsame Sperren. Bei letzteren müssen Benutzer allerdings nicht offensichtliche Eigenschaften beachten, die unten erläutert werden. Diese Grundoperationen werden von den etcd-Entwicklern gepflegt und unterstützt. Sie externen Bibliotheken zu überlassen, würde die Verantwortung für die Entwicklung grundlegender verteilter Software abgeben und das System im Wesentlichen unvollständig lassen. NewSQL-Datenbanken erwarten üblicherweise, dass Drittanbieter solche Grundoperationen entwickeln. Ebenso verfügt ZooKeeper bekanntlich über eine separate, unabhängige Bibliothek mit Koordinationsrezepten. Consul bietet eine native Sperr-API, weist aber sogar entschuldigend darauf hin, dass sie „keine absolut sichere Methode “ sei.
Theoretisch lassen sich diese Grundoperationen auf jedem Speichersystem mit starker Konsistenz aufbauen. Die Algorithmen sind jedoch oft subtil: Schnell entsteht ein scheinbar funktionierender Sperralgorithmus, der plötzlich an gleichzeitig aufwachenden Wartenden, dem Thundering-Herd-Problem, oder Zeitabweichungen scheitert. Außerdem hängen weitere von etcd unterstützte Grundoperationen wie transaktionaler Speicher vom MVCC-Datenmodell ab; starke Konsistenz allein reicht nicht aus.
Für verteilte Koordination kann die Wahl von etcd Betriebsprobleme vermeiden helfen und Entwicklungsaufwand sparen.
Hinweise zur Verwendung von Sperren und Leases
etcd bietet Sperr-APIs , die auf dem Lease-Mechanismus und dessen Implementierung in etcd basieren. Die Grundidee: Ein Server gewährt einem anfragenden Client ein Token namens Lease und ordnet ihm eine TTL zu. Stellt der Server fest, dass mehr Zeit als die TTL vergangen ist, widerruft er die Lease. Solange der Client eine nicht widerrufene Lease hält, kann er beanspruchen, den Zugriff auf eine zugeordnete Ressource zu besitzen. Bei etcd ist diese Ressource ein Schlüssel im Schlüsselraum. Auf diesem Prinzip beruhen die Sperr-APIs von etcd. Für sich allein gewährleisten sie jedoch keinen gegenseitigen Ausschluss. Die Bezeichnung „lock“ hat historische Gründe . Wie unten beschrieben, können die Sperr-APIs den gegenseitigen Ausschluss jedoch optimieren.
Der wichtigste Aspekt des Lease-Mechanismus ist, dass die TTL als physisches Zeitintervall definiert ist. Server und Client messen den Zeitablauf jeweils mit ihrer eigenen Uhr. Daher kann der Server die Lease bereits widerrufen haben, während der Client weiterhin behauptet, sie zu besitzen.
Wie gewährleistet der Lease-Mechanismus dann den gegenseitigen Ausschluss der Sperren? Tatsächlich gewährleistet er selbst keinen gegenseitigen Ausschluss. Der Besitz einer Lease garantiert nicht, dass ihr Besitzer eine Sperre auf der Ressource hält.
Wenn etcd-Sperren den gegenseitigen Zugriff auf Schlüssel von etcd selbst steuern, wird der gegenseitige Ausschluss durch die Validierung von Versionsnummern implementiert. In anderen Systemen wie Consul wird dies manchmal Compare and Swap genannt. In etcd-RPCs wie Put oder Txn lassen sich erforderliche Bedingungen für Revisionsnummer und Lease-ID der Operationen angeben. Sind diese nicht erfüllt, kann die Operation fehlschlagen. Mit diesem Mechanismus stellt etcd verteilte Sperren für Clients bereit. Ein Client weiß also, dass er die Sperre eines Schlüssels erwirbt, wenn der etcd-Cluster seine Anfragen erfolgreich abschließt.
Die Literatur zu verteilten Sperren beschreibt ähnliche Entwürfe:
- Die Veröffentlichung zu Chubby führt den Begriff Sequencer ein. Nach unserem Verständnis entspricht er nahezu der Kombination aus Revisionsnummer und Lease-ID in etcd.
- In Verteilte Sperren implementieren stellt Martin Kleppmann das Konzept des Fencing-Tokens vor. Nach Auffassung der Autoren entspricht dieses Token bei etcd der Revisionsnummer.
- Praktische Anwendungen synchronisierter Uhren in verteilten Systemen beschreibt, wie Thor verteilte Sperren auf Grundlage von Versionsnummernvalidierung und Leases implementiert.
Warum bieten etcd und andere Systeme Leases, wenn sie gegenseitigen Ausschluss durch Versionsnummernvalidierung gewährleisten? Leases dienen als Optimierung, um die Anzahl abgebrochener Anfragen zu verringern.
Schlüssel in etcd lassen sich dank Leases und Versionsnummernvalidierung effizient sperren. Müssen Benutzer Ressourcen außerhalb von etcd schützen, müssen diese wie etcd-Schlüssel eine Versionsnummernvalidierung und konsistente Replikate bereitstellen. Die Sperrfunktion von etcd allein kann externe Ressourcen nicht schützen.
12.9 - Glossar
Dieses Dokument definiert die verschiedenen Begriffe, die in der etcd-Dokumentation, der Befehlszeile und dem Quellcode verwendet werden.
Alarm
Der etcd-Server löst einen Alarm aus, wenn ein Eingriff des Betreibers erforderlich ist, damit der Cluster zuverlässig bleibt.
Authentifizierung
Die Authentifizierung verwaltet die Zugriffsberechtigungen von Benutzern auf etcd-Ressourcen.
Client
Ein Client verbindet sich mit dem etcd-Cluster, um Dienstanfragen zu stellen, etwa zum Abrufen von Schlüssel-Wert-Paaren, zum Schreiben von Daten oder zum Beobachten von Änderungen.
Cluster
Ein Cluster besteht aus mehreren Mitgliedern.
Der Knoten in jedem Mitglied folgt dem Raft-Konsensprotokoll, um Logs zu replizieren. Der Cluster empfängt Vorschläge von Mitgliedern, bestätigt sie und wendet sie auf den lokalen Speicher an.
Kompaktierung
Die Kompaktierung verwirft den gesamten etcd-Ereignisverlauf und die ersetzten Schlüssel vor einer bestimmten Revision. Sie dient dazu, Speicherplatz in der Backend-Datenbank von etcd zurückzugewinnen.
Wahl
Der etcd-Cluster hält im Rahmen des Raft-Konsensprotokolls Wahlen unter seinen Mitgliedern ab, um einen Leader zu bestimmen.
Endpunkt
Eine URL, die auf einen etcd-Dienst oder eine etcd-Ressource verweist.
Schlüssel
Ein benutzerdefinierter Bezeichner zum Speichern und Abrufen benutzerdefinierter Werte in etcd.
Schlüsselbereich
Eine Schlüsselmenge, die entweder einen einzelnen Schlüssel, ein lexikalisches Intervall für alle x mit a <= x < b oder alle Schlüssel größer als ein bestimmter Schlüssel enthält.
Schlüsselraum
Die Menge aller Schlüssel in einem etcd-Cluster.
Lease
Eine kurzlebige, verlängerbare Vereinbarung, die bei ihrem Ablauf die ihr zugeordneten Schlüssel löscht.
Mitglied
Ein logischer etcd-Server, der am Betrieb eines etcd-Clusters beteiligt ist.
Änderungsrevision
Die erste Revision, die den letzten Schreibvorgang für einen bestimmten Schlüssel enthält.
Peer
Ein Peer ist ein anderes Mitglied desselben Clusters.
Vorschlag
Ein Vorschlag ist eine Anfrage, etwa eine Schreibanfrage oder eine Anfrage zur Konfigurationsänderung, die das Raft-Protokoll durchlaufen muss.
Quorum
Die Anzahl aktiver Mitglieder, die für einen Konsens zur Änderung des Clusterzustands benötigt wird. etcd benötigt eine Mehrheit der Mitglieder, um ein Quorum zu erreichen.
Revision
Ein clusterweiter 64-Bit-Zähler, der bei 1 beginnt und bei jeder Änderung des Schlüsselraums erhöht wird.
Rolle
Eine Einheit von Berechtigungen für eine Menge von Schlüsselbereichen, die zur Zugriffskontrolle einer Menge von Benutzern zugewiesen werden kann.
Snapshot
Ein Backup des etcd-Clusterzustands zu einem bestimmten Zeitpunkt.
Speicher
Der physische Speicher, in dem der Schlüsselraum des Clusters abgelegt ist.
Term
Ein Term ist eine monoton steigende Ganzzahl, die im Raft-Algorithmus jeder Leader-Wahl zugeordnet wird. Pro Term kann es nur einen gewählten Leader geben. Bei einem Leader-Wechsel wird der Term erhöht.
Transaktion
Eine atomar ausgeführte Menge von Operationen. Alle in einer Transaktion geänderten Schlüssel haben dieselbe Änderungsrevision.
Schlüsselversion
Die Anzahl der Schreibvorgänge für einen Schlüssel seit seiner Erstellung, beginnend bei 1. Die Version eines nicht vorhandenen oder gelöschten Schlüssels ist 0.
Watcher
Ein Client öffnet einen Watcher, um Änderungen in einem bestimmten Schlüsselbereich zu beobachten.
13 - Entwicklerhandbuch
13.1 - Protokoll des Discovery-Dienstes
Diese Seite dokumentiert das ältere v2-Discovery-Protokoll, das in etcd 3.7 entfernt wurde. Für eine neue v3.7-Installation das v3-Discovery-Protokoll verwenden.
Das Protokoll des Discovery-Dienstes hilft einem neuen etcd-Mitglied, während der Clusterinitialisierung alle anderen Mitglieder über eine gemeinsame Discovery-URL zu finden.
Das Protokoll des Discovery-Dienstes wird nur während der Clusterinitialisierung verwendet. Es kann nicht zur Neukonfiguration im laufenden Betrieb oder zur Clusterüberwachung genutzt werden.
Das Protokoll verwendet ein neues Discovery-Token, um einen eindeutigen etcd-Cluster zu initialisieren. Ein Discovery-Token kann nur einen etcd-Cluster repräsentieren. Sobald das Discovery-Protokoll mit diesem Token startet, darf es nicht zur Initialisierung eines anderen etcd-Clusters verwendet werden, auch wenn der Vorgang auf halbem Weg fehlschlägt.
Der Rest dieses Artikels erläutert den Discovery-Ablauf anhand von Beispielen für einen selbst betriebenen Discovery-Cluster. Der öffentliche Discovery-Dienst discovery.etcd.io funktioniert ebenso, bietet jedoch eine zusätzliche Schicht, die unübersichtliche URLs verbirgt, UUIDs automatisch erzeugt und einen gewissen Schutz vor übermäßig vielen Anfragen bietet. Im Kern verwendet auch der öffentliche Discovery-Dienst einen etcd-Cluster als Datenspeicher, wie in diesem Dokument beschrieben.
Protokollablauf
Das Discovery-Protokoll nutzt einen internen etcd-Cluster, um die Initialisierung eines neuen Clusters zu koordinieren. Zuerst kommunizieren alle neuen Mitglieder mit dem Discovery-Dienst und helfen dabei, die erwartete Mitgliederliste zu erstellen. Anschließend initialisiert jedes neue Mitglied seinen Server anhand dieser Liste. Sie erfüllt dieselbe Funktion wie die Option -initial-cluster.
Im folgenden Beispielablauf wird jeder Protokollschritt zur Veranschaulichung im curl-Format dargestellt.
Das etcd-Discovery-Protokoll verwendet vereinbarungsgemäß das Schlüsselpräfix _etcd/registry. Wenn unter http://example.com ein etcd-Cluster für den Discovery-Dienst läuft, lautet die vollständige URL zum Discovery-Schlüsselraum http://example.com/v2/keys/_etcd/registry. Sie wird im Beispiel als URL-Präfix verwendet.
Ein neues Discovery-Token erstellen
Ein eindeutiges Token erzeugen, das den neuen Cluster identifiziert. In den folgenden Schritten dient es als eindeutiges Präfix im Discovery-Schlüsselraum. Mit uuidgen lässt es sich einfach erzeugen:
Die erwartete Clustergröße angeben
Für das Discovery-Token muss eine Clustergröße angegeben werden. Anhand dieser Größe erkennt der Discovery-Dienst, wann er alle Mitglieder gefunden hat, die den Cluster anfänglich bilden sollen.
Üblicherweise beträgt die Clustergröße 3, 5 oder 7. Weitere Einzelheiten enthält der Abschnitt zur optimalen Clustergröße .
etcd-Prozesse starten
Die Discovery-URL mit der Option -discovery angeben und die etcd-Prozesse starten. Jeder etcd-Prozess führt intern die folgenden Schritte aus, wenn die Option -discovery angegeben ist.
Selbstregistrierung
Zuerst registriert sich der etcd-Prozess unter der Discovery-URL als Mitglied. Dazu legt er die Mitglieds-ID als Schlüssel unter der Discovery-URL an.
Status prüfen
Er prüft die erwartete Clustergröße und den Registrierungsstatus unter der Discovery-URL und entscheidet dann über den nächsten Schritt.
Wenn noch nicht genügend Mitglieder registriert sind, wartet er auf die übrigen Mitglieder.
Wenn die Anzahl registrierter Mitglieder die erwartete Größe N übersteigt, gelten die ersten N registrierten Mitglieder als Mitgliederliste des Clusters. Ist das Mitglied selbst in dieser Liste enthalten, ist der Discovery-Vorgang erfolgreich, und es ermittelt alle Peers anhand der Mitgliederliste. Ist es nicht enthalten, endet der Discovery-Vorgang mit der Fehlermeldung, dass der Cluster bereits voll ist.
In der etcd-Implementierung kann das Mitglied den Clusterstatus bereits vor seiner Registrierung prüfen. So kann es frühzeitig mit einem Fehler abbrechen, wenn der Cluster bereits voll ist.
Auf alle Mitglieder warten
Der Wartevorgang ist in der etcd-API-Dokumentation ausführlich beschrieben.
Er wartet, bis alle Mitglieder gefunden sind.
Öffentlicher Discovery-Dienst
CoreOS Inc. betreibt unter https://discovery.etcd.io/ einen öffentlichen Discovery-Dienst mit einigen Funktionen, die die Nutzung erleichtern.
Schlüsselpräfix verbergen
Der öffentliche Discovery-Dienst leitet https://discovery.etcd.io/${UUID} zum dahinterliegenden etcd-Cluster auf den Schlüssel unter /v2/keys/_etcd/registry um. Er verbirgt das Registrierungsschlüsselpräfix, damit die Discovery-URL kurz und lesbar bleibt.
Neues Token abrufen
Der Erzeugungsvorgang im Dienst folgt den Schritten von Ein neues Discovery-Token erstellen bis Die erwartete Clustergröße angeben .
Discovery-Status prüfen
Der Status dieses Discovery-Tokens einschließlich der registrierten Rechner lässt sich durch Abfragen des Werts der UUID prüfen.
Open-Source-Repository
Das Repository befindet sich unter https://github.com/coreos/discovery.etcd.io . Damit lässt sich ein eigener Discovery-Dienst erstellen.
13.2 - Einen lokalen Cluster einrichten
Für Test- und Entwicklungsumgebungen ist die Konfiguration eines lokalen Clusters der schnellste und einfachste Weg. Für eine produktive Bereitstellung siehe den Abschnitt Cluster einrichten .
Lokaler eigenständiger Cluster
Einen Cluster starten
Mit folgendem Befehl wird ein eigenständiger etcd-Cluster bereitgestellt:
Wenn die Binärdatei etcd nicht im aktuellen Arbeitsverzeichnis liegt, befindet sie sich möglicherweise unter $GOPATH/bin/etcd oder /usr/local/bin/etcd. Den Befehl entsprechend ausführen.
Das laufende etcd-Mitglied nimmt unter localhost:2379 Client-Anfragen entgegen.
Mit dem Cluster arbeiten
Mit etcdctl lässt sich mit dem laufenden Cluster arbeiten:
-
Ein beispielhaftes Schlüssel-Wert-Paar im Cluster speichern:
Wenn OK ausgegeben wird, wurde das Schlüssel-Wert-Paar erfolgreich gespeichert.
-
Den Wert von
fooabrufen:Wenn
barzurückgegeben wird, funktioniert die Interaktion mit dem etcd-Cluster wie erwartet.
Lokaler Cluster mit mehreren Mitgliedern
Einen Cluster starten
Im Stammverzeichnis des etcd-Git-Repositorys liegt eine Procfile, mit der sich ein lokaler Cluster mit mehreren Mitgliedern einfach konfigurieren lässt. Zum Starten eines solchen Clusters in das Stammverzeichnis des etcd-Quellbaums wechseln und Folgendes ausführen:
-
goremaninstallieren, um auf Procfile basierende Anwendungen zu steuern: -
Einen Cluster mit
goremanund der mitgelieferten Procfile von etcd starten:Die Mitglieder starten. Sie nehmen Client-Anfragen unter
localhost:2379,localhost:22379beziehungsweiselocalhost:32379entgegen.
Mit dem Cluster arbeiten
Mit etcdctl lässt sich mit dem laufenden Cluster arbeiten:
-
Die Mitgliederliste ausgeben:
Die Liste der etcd-Mitglieder wird wie folgt angezeigt:
-
Ein beispielhaftes Schlüssel-Wert-Paar im Cluster speichern:
Wenn OK ausgegeben wird, wurde das Schlüssel-Wert-Paar erfolgreich gespeichert.
Fehlertoleranz testen
Um die Fehlertoleranz von etcd zu testen, ein Mitglied beenden und versuchen, den Schlüssel abzurufen.
-
Den Prozessnamen des Mitglieds ermitteln, das angehalten werden soll.
Die
Procfileenthält die Eigenschaften des Clusters mit mehreren Mitgliedern. Als Beispiel dient das Mitglied mit dem Prozessnamenetcd2. -
Das Mitglied anhalten:
-
Einen Schlüssel speichern:
-
Den im vorherigen Schritt gespeicherten Schlüssel abrufen:
-
Einen Schlüssel vom angehaltenen Mitglied abrufen:
Der Befehl sollte wegen der fehlgeschlagenen Verbindung eine Fehlermeldung anzeigen:
-
Das angehaltene Mitglied neu starten:
-
Den Schlüssel vom neu gestarteten Mitglied abrufen:
Der Neustart des Mitglieds stellt die Verbindung wieder her.
etcdctlkann den Schlüssel nun erfolgreich abrufen. Weitere Informationen zur Arbeit mit etcd enthält der Abschnitt Mit etcd arbeiten .
13.3 - Mit etcd arbeiten
Benutzer arbeiten mit etcd meist, indem sie den Wert eines Schlüssels schreiben oder lesen. Dieser Abschnitt beschreibt dies anhand von etcdctl, einem Befehlszeilenwerkzeug zur Interaktion mit dem etcd-Server. Die erläuterten Konzepte sollten auch für die gRPC-APIs und die APIs der Client-Bibliotheken gelten.
etcdctl v3.7 verwendet die v3-API. Die v2-API und die Versionsauswahl über ETCDCTL_API wurden entfernt.
Die folgenden Beispiele enthalten historische Befehlsausgaben; die angezeigten Versionsnummern können daher von Ihrer Installation abweichen. Frühere etcd-Versionen hielten v2- und v3-Schlüssel in getrennten Speichern. Migrieren Sie vorhandene v2-Daten vor dem Upgrade auf v3.7.
Versionen ermitteln
Die etcdctl-Version und die API-Version des Servers helfen dabei, die passenden Befehle für verschiedene etcd-Operationen zu bestimmen.
Mit folgendem Befehl lassen sich die Versionen ermitteln:
Einen Schlüssel schreiben
Anwendungen speichern Schlüssel im etcd-Cluster, indem sie Werte unter diesen Schlüsseln schreiben. Jeder gespeicherte Schlüssel wird über das Raft-Protokoll auf alle Mitglieder des etcd-Clusters repliziert, um Konsistenz und Zuverlässigkeit zu gewährleisten.
Mit folgendem Befehl wird der Wert des Schlüssels foo auf bar gesetzt:
Ein Schlüssel kann durch Zuordnen einer Lease auch für einen festgelegten Zeitraum gesetzt werden.
Mit folgendem Befehl wird der Wert des Schlüssels foo1 für 10s auf bar1 gesetzt.
Die Lease-ID 1234abcd im obigen Befehl ist die ID, die beim Erstellen der Lease mit 10s Laufzeit zurückgegeben wird. Diese ID kann anschließend dem Schlüssel zugeordnet werden.
Schlüssel lesen
Anwendungen können Schlüsselwerte aus einem etcd-Cluster lesen. Abfragen können einen einzelnen Schlüssel oder einen Schlüsselbereich lesen.
Angenommen, im etcd-Cluster sind folgende Schlüssel gespeichert:
Mit folgendem Befehl wird der Wert des Schlüssels foo gelesen:
Mit folgendem Befehl wird der Wert des Schlüssels foo im Hexadezimalformat gelesen:
Mit folgendem Befehl wird nur der Wert des Schlüssels foo gelesen:
Mit folgendem Befehl werden die Schlüssel von foo bis foo3 abgefragt:
foo3 ist ausgeschlossen, da der Bereich dem halboffenen Intervall [foo, foo3) entspricht, das foo3 nicht enthält.
Mit folgendem Befehl werden alle Schlüssel mit dem Präfix foo abgefragt:
Mit folgendem Befehl werden alle Schlüssel mit dem Präfix foo abgefragt und die Ergebnisse auf 2 begrenzt:
Mit folgendem Befehl werden alle Schlüssel mit dem Präfix foo über den RPC RangeStream
abgefragt. Das Ergebnis ist mit dem eines unären Range-Aufrufs identisch:
--stream unterstützt weder --order noch --sort-by noch Revisionsfilter.
Frühere Schlüsselversionen lesen
Anwendungen möchten möglicherweise ersetzte Versionen eines Schlüssels lesen. Beispielsweise kann eine Anwendung durch Zugriff auf eine frühere Schlüsselversion zu einer alten Konfiguration zurückkehren. Oder sie kann durch den Schlüsselverlauf über mehrere Anfragen hinweg eine konsistente Sicht auf mehrere Schlüssel erhalten. Da jede Änderung am Schlüssel-Wert-Speicher des etcd-Clusters dessen globale Revision erhöht, kann eine Anwendung ersetzte Schlüssel durch Angabe einer älteren etcd-Revision lesen.
Angenommen, im etcd-Cluster sind bereits folgende Schlüssel gespeichert:
Das folgende Beispiel zeigt den Zugriff auf frühere Schlüsselversionen:
Schlüssel lesen, deren Bytewert größer oder gleich dem angegebenen Schlüssel ist
Anwendungen möchten möglicherweise Schlüssel lesen, deren Bytewert größer oder gleich dem des angegebenen Schlüssels ist.
Angenommen, im etcd-Cluster sind bereits folgende Schlüssel gespeichert:
Mit folgendem Befehl werden Schlüssel gelesen, deren Bytewert größer oder gleich dem des Schlüssels b ist:
Schlüssel löschen
Anwendungen können einen einzelnen Schlüssel oder einen Schlüsselbereich aus einem etcd-Cluster löschen.
Angenommen, im etcd-Cluster sind bereits folgende Schlüssel gespeichert:
Mit folgendem Befehl wird der Schlüssel foo gelöscht:
Mit folgendem Befehl werden die Schlüssel von foo bis foo9 gelöscht:
Mit folgendem Befehl wird der Schlüssel zoo gelöscht und das gelöschte Schlüssel-Wert-Paar zurückgegeben:
Mit folgendem Befehl werden Schlüssel mit dem Präfix zoo gelöscht:
Mit folgendem Befehl werden Schlüssel gelöscht, deren Bytewert größer oder gleich dem des Schlüssels b ist:
Schlüsseländerungen beobachten
Anwendungen können einen Schlüssel oder einen Schlüsselbereich beobachten, um sämtliche Aktualisierungen zu überwachen.
Mit folgendem Befehl wird der Schlüssel foo beobachtet:
Mit folgendem Befehl wird der Schlüssel foo im Hexadezimalformat beobachtet:
Mit folgendem Befehl wird der Schlüsselbereich von foo bis foo9 beobachtet:
Mit folgendem Befehl werden Schlüssel mit dem Präfix foo beobachtet:
Mit folgendem Befehl werden die beiden Schlüssel foo und zoo beobachtet:
Historische Schlüsseländerungen beobachten
Anwendungen möchten möglicherweise historische Änderungen an Schlüsseln in etcd beobachten. Beispielsweise kann eine Anwendung alle Änderungen eines Schlüssels empfangen wollen. Solange sie mit etcd verbunden bleibt, genügt dafür watch. Fällt jedoch die Anwendung oder etcd aus, kann während des Ausfalls eine Änderung auftreten, die die Anwendung nicht in Echtzeit empfängt. Um die Zustellung der Aktualisierung zu garantieren, muss die Anwendung historische Schlüsseländerungen beobachten können. Dazu kann sie wie beim Lesen früherer Schlüsselversionen eine historische Revision für einen Watch angeben.
Angenommen, die folgende Folge von Operationen wurde ausgeführt:
Das folgende Beispiel zeigt die Beobachtung historischer Änderungen:
Das folgende Beispiel beobachtet erst ab der letzten historischen Änderung:
Watch-Fortschritt
Anwendungen möchten möglicherweise den Fortschritt eines Watches prüfen, um die Aktualität seines Streams zu bestimmen. Wird ein Watch beispielsweise zur Aktualisierung eines Caches verwendet, kann es hilfreich sein zu wissen, ob der Cache gegenüber der Revision eines Quorum-Lesezugriffs veraltet ist.
In einer interaktiven Watch-Sitzung kann mit dem Befehl “progress” eine Fortschrittsanfrage gestellt werden. Sie fordert den etcd-Server auf, eine Fortschrittsbenachrichtigung im Watch-Stream zu senden:
Die Revisionsnummer in der Fortschrittsantwort stammt vom lokalen etcd-Serverknoten, mit dem der Watch-Stream verbunden ist. Ist dieser Knoten durch eine Netzwerkpartition abgetrennt und nicht Teil des Quorums, kann diese Revision niedriger sein als die Revision eines Quorum-Lesezugriffs auf einen nicht abgetrennten etcd-Serverknoten.
Kompaktierte Revisionen
Wie erwähnt, bewahrt etcd Revisionen auf, damit Anwendungen frühere Schlüsselversionen lesen können. Damit sich jedoch kein unbegrenzt großer Verlauf ansammelt, ist es wichtig, frühere Revisionen zu kompaktieren. Nach der Kompaktierung entfernt etcd historische Revisionen und gibt Ressourcen für die spätere Nutzung frei. Alle ersetzten Daten mit Revisionen vor der Kompaktierungsrevision sind dann nicht mehr verfügbar.
Mit folgendem Befehl werden die Revisionen kompaktiert:
Die aktuelle Revision des etcd-Servers lässt sich mit einem get-Befehl im JSON-Format für einen beliebigen vorhandenen oder nicht vorhandenen Schlüssel ermitteln. Das folgende Beispiel verwendet mykey, das im etcd-Server nicht existiert:
Leases gewähren
Anwendungen können vom etcd-Cluster Leases für Schlüssel anfordern. Wird ein Schlüssel einer Lease zugeordnet, ist seine Lebensdauer an die der Lease gebunden, die ihrerseits durch eine Time-to-live (TTL) bestimmt wird. Jede Lease hat eine Mindest-TTL, die die Anwendung bei der Anforderung angibt. Ihre tatsächliche TTL ist mindestens so groß wie die Mindest-TTL und wird vom etcd-Cluster gewählt. Sobald sie verstrichen ist, läuft die Lease ab, und alle zugeordneten Schlüssel werden gelöscht.
Mit folgendem Befehl wird eine Lease gewährt:
Leases widerrufen
Anwendungen widerrufen Leases anhand ihrer Lease-ID. Dabei werden alle der Lease zugeordneten Schlüssel gelöscht.
Angenommen, die folgende Folge von Operationen wurde ausgeführt:
Mit folgendem Befehl wird dieselbe Lease widerrufen:
Leases am Leben halten
Anwendungen können eine Lease am Leben halten, indem sie deren TTL erneuern und so ihren Ablauf verhindern.
Angenommen, die folgende Folge von Operationen wurde ausgeführt:
Mit folgendem Befehl wird dieselbe Lease am Leben gehalten:
Lease-Informationen abrufen
Anwendungen möchten möglicherweise Informationen über Leases abrufen, um sie zu erneuern oder zu prüfen, ob eine Lease noch existiert oder bereits abgelaufen ist. Sie möchten möglicherweise auch wissen, welchen Schlüsseln eine bestimmte Lease zugeordnet ist.
Angenommen, die folgende Folge von Operationen wurde ausgeführt:
Mit folgendem Befehl werden Informationen zur Lease abgerufen:
Mit folgendem Befehl werden Informationen zur Lease einschließlich der ihr zugeordneten Schlüssel abgerufen:
13.4 - Warum ein gRPC-Gateway
etcd v3 verwendet gRPC als Nachrichtenprotokoll. Das etcd-Projekt enthält einen gRPC-basierten Go-Client und das Befehlszeilenwerkzeug etcdctl zur Kommunikation mit einem etcd-Cluster über gRPC. Für Sprachen ohne gRPC-Unterstützung stellt etcd ein JSON-gRPC-Gateway bereit. Dieses Gateway dient als RESTful-Proxy, der HTTP/JSON-Anfragen in gRPC-Nachrichten übersetzt.
Das gRPC-Gateway verwenden
Das Gateway akzeptiert eine JSON-Abbildung
der Protocol-Buffer
-Nachrichtendefinitionen von etcd. Die Felder key und value sind als Byte-Arrays definiert und müssen deshalb in JSON base64-kodiert sein. Die folgenden Beispiele verwenden curl, jeder andere HTTP/JSON-Client sollte jedoch ebenso funktionieren.
Hinweise
Der Endpunkt des gRPC-Gateways hat sich seit etcd v3.3 geändert:
- etcd v3.2 und frühere Versionen verwenden ausschließlich
[CLIENT-URL]/v3alpha/*. - etcd v3.3 verwendet
[CLIENT-URL]/v3beta/*und behält[CLIENT-URL]/v3alpha/*bei. - etcd v3.4 verwendet
[CLIENT-URL]/v3/*und behält[CLIENT-URL]/v3beta/*bei.[CLIENT-URL]/v3alpha/*ist veraltet.
- etcd v3.5 und spätere Versionen verwenden ausschließlich
[CLIENT-URL]/v3/*.[CLIENT-URL]/v3beta/*ist veraltet.
Das gRPC-Gateway unterstützt keine Authentifizierung über den TLS Common Name.
Schlüssel schreiben und lesen
Die Dienste /v3/kv/range und /v3/kv/put zum Lesen und Schreiben von Schlüsseln verwenden:
Schlüssel beobachten
Den Dienst /v3/watch zum Beobachten von Schlüsseln verwenden:
Transaktionen
Eine Transaktion mit /v3/kv/txn ausführen:
Authentifizierung
Die Authentifizierung mit dem Dienst /v3/auth einrichten:
Mit /v3/auth/authenticate bei etcd authentifizieren, um ein Authentifizierungstoken zu erhalten:
Den Header Authorization auf das Authentifizierungstoken setzen, um einen Schlüssel mit Authentifizierungsdaten abzurufen:
Fehlerantworten
Das gRPC-Gateway übersetzt den gRPC-Status in HTTP-Statuscodes und einen JSON-Fehlerinhalt.
Ab etcd v3.6 änderte die Aktualisierung auf grpc-gateway v2 die Fehlerbehandlung
(siehe den Hinweis zur Fehlerbehandlung
im v2-Migrationsleitfaden).
Das Verhalten des Gateways entspricht nun google.rpc.Status (code, message,
details), wie im API-Fehlermodell von Google
beschrieben.
Ältere grpc-gateway-Versionen enthielten außerdem ein error-Feld
auf oberster Ebene. Dieses Feld wird in etcd v3.6 und neueren Versionen nicht unterstützt.
Clients sollten den HTTP-Statuscode als vorrangigen Hinweis auf Erfolg oder
Fehlschlag behandeln. Schlägt eine Anfrage fehl, sollten Clients das Feld message
als wichtigste Quelle für Fehlerinformationen verwenden und zusätzliche Details
zur weiteren Einordnung heranziehen.
Swagger
Generierte Swagger -API-Definitionen stehen unter rpc.swagger.json bereit.
13.5 - gRPC-Namensauflösung und Discovery
etcd stellt einen gRPC-Resolver für ein alternatives Namenssystem bereit, das Endpunkte aus etcd abruft, um gRPC-Dienste zu finden. Der zugrunde liegende Mechanismus beobachtet Änderungen an Schlüsseln, deren Präfix der Dienstname ist.
Diese Funktion ist experimentell, da sie vom Paket google.golang.org/grpc/resolver abhängt, das in grpc-go noch experimentell ist.
etcd-Discovery mit go-grpc verwenden
Der etcd-Client stellt einen gRPC-Resolver bereit, der gRPC-Endpunkte mit einem etcd-Backend auflöst. Der Resolver wird mit einem etcd-Client initialisiert:
Dienstendpunkte verwalten
Der etcd-Resolver betrachtet alle Schlüssel unter dem Präfix des Auflösungsziels, gefolgt von einem “/” (z. B. “foo/bar/my-service/”),
mit JSON-kodierten Werten (früher go-grpc naming.Update) als mögliche Dienstendpunkte.
Durch Anlegen neuer Schlüssel werden Endpunkte zum Dienst hinzugefügt; durch Löschen der Schlüssel werden sie entfernt.
Einen Endpunkt hinzufügen
Neue Endpunkte lassen sich mit etcdctl zum Dienst hinzufügen:
Die Methode endpoints.Manager des etcd-Clients kann ebenfalls neue Endpunkte mit einem zu Addr passenden Schlüssel registrieren:
Um beim Verbindungsaufbau zu einem Dienst mit mehreren Endpunkten Round-Robin-Lastverteilung zu aktivieren, kann die Verbindung mit dem internen Round-Robin-Load-Balancer von grpc eingerichtet werden:
Einen Endpunkt löschen
Hosts lassen sich mit etcdctl aus dem Dienst entfernen:
Die Methode endpoints.Manager des etcd-Clients unterstützt auch das Löschen von Endpunkten:
Einen Endpunkt mit einer Lease registrieren
Die Registrierung eines Endpunkts mit einer Lease stellt sicher, dass er aus dem Dienst entfernt wird, wenn der Host keinen Keepalive-Heartbeat mehr aufrechterhalten kann, etwa bei einem Ausfall des Rechners:
In Go:
Endpunkte atomar aktualisieren
Um mehrere Endpunkte in einer einzigen Transaktion zu ändern, kann endpoints.Manager direkt verwendet werden:
13.6 - etcd in eine Go-Anwendung einbetten
embed von etcd einen etcd-Server innerhalb Ihrer Anwendung ausführenDas Go-Paket embed von etcd bietet eine einfache Möglichkeit, einen etcd-Server direkt in Ihre Anwendung einzubetten.
Weitere Einzelheiten enthält die Dokumentation des Pakets embed .
13.7 - Systemgrenzen
Maximale Anfragegröße
etcd ist für kleine Schlüssel-Wert-Paare ausgelegt, wie sie für Metadaten typisch sind. Größere Anfragen funktionieren, können jedoch die Latenz anderer Anfragen erhöhen. Standardmäßig beträgt die maximale Größe einer Anfrage 1.5 MiB. Diese Grenze lässt sich über die Option --max-request-bytes des etcd-Servers konfigurieren.
Maximale Speichergröße
Die standardmäßige Speichergrenze beträgt 2 GiB und lässt sich über die Option --quota-backend-bytes konfigurieren. Für normale Umgebungen werden maximal 8 GiB empfohlen. etcd gibt beim Start eine Warnung aus, wenn der konfigurierte Wert diese Größe überschreitet.
13.8 - etcd-Funktionen
Dieses Dokument gibt einen Überblick über die Funktionen von etcd und das Verfahren, nach dem sie als veraltet eingestuft werden. Wie Funktionen in etcd entwickelt werden, erläutern diese Entwicklungsrichtlinien .
Die Funktionen von etcd werden in drei Stufen eingeteilt: experimentell, stabil und unsicher. Mit etcd --help lässt sich die Liste der Funktionen anzeigen.
Experimentell
Um frühzeitig Rückmeldungen zu erhalten, werden neue Funktionen üblicherweise als experimentelle Funktionen eingeführt. Sie sind am Optionsnamen zu erkennen, der mit --experimental beginnen sollte. Bei der Verwendung einer experimentellen Funktion sind folgende Punkte zu beachten:
- Sie kann Fehler enthalten, da sie noch nicht ausreichend von Benutzern getestet wurde. Nach dem Aktivieren funktioniert sie möglicherweise nicht wie erwartet.
- Sie ist standardmäßig deaktiviert.
- Die Unterstützung einer solchen Funktion kann jederzeit ohne Ankündigung eingestellt werden
- Sie kann in der nächsten Minor- oder Major-Version entfernt werden, ohne die Richtlinie zur Einstufung als veraltet einzuhalten, sofern sie nicht in die stabile Stufe übergeht.
- Das Projektteam freut sich über Fehlermeldungen zu experimentellen Funktionen. Diese Probleme können jedoch eine geringere Priorität erhalten als Probleme mit stabilen Funktionen.
- Eine experimentelle Funktionsoption wird als veraltet eingestuft , sobald die Funktion die stabile Stufe erreicht. Benutzer sollten möglichst bald auf die stabile Funktionsoption umsteigen.
Stabil
Dies ist die häufigste Stufe von Funktionen in etcd. Eine stabile Funktion zeichnet sich durch Folgendes aus:
- Sie wird im Rahmen der unterstützten etcd-Versionen unterstützt.
- Sie kann standardmäßig aktiviert sein.
- Die Einstellung der Unterstützung muss der Richtlinie zur Einstufung als veraltet folgen.
Unsicher
Unsichere Funktionen sind selten und werden im Abschnitt Unsafe feature: der etcd-Nutzungsdokumentation aufgeführt. Sie sind standardmäßig deaktiviert. Sie sollten mit Vorsicht und gemäß der Dokumentation verwendet werden. Eine unsichere Funktion kann in der nächsten Minor- oder Major-Version entfernt werden, ohne die Richtlinie zur Einstufung als veraltet einzuhalten.
Funktionen als veraltet einstufen
Experimentell
Eine experimentelle Funktion wird als veraltet eingestuft, sobald sie die stabile Stufe erreicht.
- Die Dokumentation der experimentellen Funktion zeigt einen Hinweis auf die Einstufung als veraltet und empfiehlt die entsprechende stabile Funktionsoption, z. B.
DEPRECATED. Use <feature-name> instead. - Eine als veraltet eingestufte Funktion wird in der darauffolgenden Version entfernt.
Stabil
Im Zuge der Projektentwicklung kann es nötig werden, auch eine stabile Funktion als veraltet einzustufen und zu entfernen. In diesem Fall gilt:
- Die Dokumentation der Funktion zeigt vor der Version, für die die Einstufung als veraltet geplant ist, eine Warnmeldung, z. B.
To be deprecated in <release>.. Ist bereits eine neue Funktion als Ersatz für die mitTo be deprecatedgekennzeichnete Funktion geplant, wird auch darauf hingewiesen, z. B.Use <feature-name> instead.. - Die Funktion wird in der geplanten Version als veraltet eingestuft. Ab dann zeigt ihre Dokumentation einen entsprechenden Hinweis und empfiehlt eine verwandte stabile Funktion, z. B.
DEPRECATED. Use <feature-name> instead. - Eine als veraltet eingestufte Funktion wird in der darauffolgenden Version entfernt.
13.9 - API-Referenz
Diese API-Referenz wird automatisch aus den angegebenen .proto-Dateien erzeugt.
Dienst Auth (api/etcdserverpb/rpc.proto)
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| AuthEnable | AuthEnableRequest | AuthEnableResponse | AuthEnable aktiviert die Authentifizierung. |
| AuthDisable | AuthDisableRequest | AuthDisableResponse | AuthDisable deaktiviert die Authentifizierung. |
| AuthStatus | AuthStatusRequest | AuthStatusResponse | AuthStatus zeigt den Authentifizierungsstatus an. |
| Authenticate | AuthenticateRequest | AuthenticateResponse | Authenticate verarbeitet eine Authentifizierungsanfrage. |
| UserAdd | AuthUserAddRequest | AuthUserAddResponse | UserAdd fügt einen neuen Benutzer hinzu. Der Benutzername darf nicht leer sein. |
| UserGet | AuthUserGetRequest | AuthUserGetResponse | UserGet ruft ausführliche Benutzerinformationen ab. |
| UserList | AuthUserListRequest | AuthUserListResponse | UserList ruft eine Liste aller Benutzer ab. |
| UserDelete | AuthUserDeleteRequest | AuthUserDeleteResponse | UserDelete löscht einen angegebenen Benutzer. |
| UserChangePassword | AuthUserChangePasswordRequest | AuthUserChangePasswordResponse | UserChangePassword ändert das Passwort eines angegebenen Benutzers. |
| UserGrantRole | AuthUserGrantRoleRequest | AuthUserGrantRoleResponse | UserGrantRole weist einem angegebenen Benutzer eine Rolle zu. |
| UserRevokeRole | AuthUserRevokeRoleRequest | AuthUserRevokeRoleResponse | UserRevokeRole entzieht einem angegebenen Benutzer eine Rolle. |
| RoleAdd | AuthRoleAddRequest | AuthRoleAddResponse | RoleAdd fügt eine neue Rolle hinzu. Der Rollenname darf nicht leer sein. |
| RoleGet | AuthRoleGetRequest | AuthRoleGetResponse | RoleGet ruft ausführliche Rolleninformationen ab. |
| RoleList | AuthRoleListRequest | AuthRoleListResponse | RoleList ruft Listen aller Rollen ab. |
| RoleDelete | AuthRoleDeleteRequest | AuthRoleDeleteResponse | RoleDelete löscht eine angegebene Rolle. |
| RoleGrantPermission | AuthRoleGrantPermissionRequest | AuthRoleGrantPermissionResponse | RoleGrantPermission gewährt einer angegebenen Rolle eine Berechtigung für einen bestimmten Schlüssel oder Bereich. |
| RoleRevokePermission | AuthRoleRevokePermissionRequest | AuthRoleRevokePermissionResponse | RoleRevokePermission entzieht einer angegebenen Rolle eine Berechtigung für einen Schlüssel oder Bereich. |
Dienst Cluster (api/etcdserverpb/rpc.proto)
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| MemberAdd | MemberAddRequest | MemberAddResponse | MemberAdd fügt dem Cluster ein Mitglied hinzu. |
| MemberRemove | MemberRemoveRequest | MemberRemoveResponse | MemberRemove entfernt ein vorhandenes Mitglied aus dem Cluster. |
| MemberUpdate | MemberUpdateRequest | MemberUpdateResponse | MemberUpdate aktualisiert die Mitgliedskonfiguration. |
| MemberList | MemberListRequest | MemberListResponse | MemberList listet alle Mitglieder des Clusters auf. |
| MemberPromote | MemberPromoteRequest | MemberPromoteResponse | MemberPromote stuft ein Mitglied von einem nicht stimmberechtigten Raft-Learner zu einem stimmberechtigten Raft-Mitglied hoch. |
Dienst KV (api/etcdserverpb/rpc.proto)
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| Range | RangeRequest | RangeResponse | Range ruft die Schlüssel im Bereich aus dem Schlüssel-Wert-Speicher ab. |
| Put | PutRequest | PutResponse | Put schreibt den angegebenen Schlüssel in den Schlüssel-Wert-Speicher. Eine Put-Anfrage erhöht die Revision des Schlüssel-Wert-Speichers und erzeugt ein Ereignis im Ereignisverlauf. |
| DeleteRange | DeleteRangeRequest | DeleteRangeResponse | DeleteRange löscht den angegebenen Bereich aus dem Schlüssel-Wert-Speicher. Eine Löschanfrage erhöht die Revision des Schlüssel-Wert-Speichers und erzeugt für jeden gelöschten Schlüssel ein Löschereignis im Ereignisverlauf. |
| Txn | TxnRequest | TxnResponse | Txn verarbeitet mehrere Anfragen in einer einzigen Transaktion. Eine Txn-Anfrage erhöht die Revision des Schlüssel-Wert-Speichers und erzeugt für jede abgeschlossene Anfrage Ereignisse mit derselben Revision. Derselbe Schlüssel darf innerhalb einer Transaktion nicht mehrfach geändert werden. |
| Compact | CompactionRequest | CompactionResponse | Compact kompaktiert den Ereignisverlauf im Schlüssel-Wert-Speicher von etcd. Der Schlüssel-Wert-Speicher sollte regelmäßig kompaktiert werden, da der Ereignisverlauf andernfalls unbegrenzt weiterwächst. |
Dienst Lease (api/etcdserverpb/rpc.proto)
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| LeaseGrant | LeaseGrantRequest | LeaseGrantResponse | LeaseGrant erstellt eine Lease, die abläuft, wenn der Server innerhalb einer vorgegebenen Lebensdauer kein keepAlive empfängt. Läuft die Lease ab, laufen alle ihr zugeordneten Schlüssel ebenfalls ab und werden gelöscht. Jeder abgelaufene Schlüssel erzeugt ein Löschereignis im Ereignisverlauf. |
| LeaseRevoke | LeaseRevokeRequest | LeaseRevokeResponse | LeaseRevoke widerruft eine Lease. Alle ihr zugeordneten Schlüssel laufen ab und werden gelöscht. |
| LeaseKeepAlive | LeaseKeepAliveRequest | LeaseKeepAliveResponse | LeaseKeepAlive hält die Lease am Leben, indem es Keepalive-Anfragen vom Client zum Server und Keepalive-Antworten vom Server zum Client als Streams überträgt. |
| LeaseTimeToLive | LeaseTimeToLiveRequest | LeaseTimeToLiveResponse | LeaseTimeToLive ruft Informationen zur Lease ab. |
| LeaseLeases | LeaseLeasesRequest | LeaseLeasesResponse | LeaseLeases listet alle vorhandenen Leases auf. |
Dienst Maintenance (api/etcdserverpb/rpc.proto)
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| Alarm | AlarmRequest | AlarmResponse | Alarm aktiviert, deaktiviert und erfragt Alarme zum Zustand des Clusters. |
| Status | StatusRequest | StatusResponse | Status ruft den Status des Mitglieds ab. |
| Defragment | DefragmentRequest | DefragmentResponse | Defragment defragmentiert die Backend-Datenbank eines Mitglieds, um Speicherplatz zurückzugewinnen. |
| Hash | HashRequest | HashResponse | Hash berechnet den Hash des gesamten Backend-Schlüsselraums einschließlich der Buckets key, lease und weiterer Buckets im Speicher. Dies ist NUR für Tests vorgesehen! Im Produktivbetrieb mit laufenden Transaktionen darf man sich nicht darauf verlassen, da die Hash-Operation keine MVCC-Sperren hält. Für Konsistenzprüfungen des Buckets “key” stattdessen die API “HashKV” verwenden. |
| HashKV | HashKVRequest | HashKVResponse | HashKV berechnet den Hash aller MVCC-Schlüssel bis zu einer angegebenen Revision. Es durchläuft nur den Bucket “key” im Backend-Speicher. |
| Snapshot | SnapshotRequest | SnapshotResponse | Snapshot sendet einen Snapshot des gesamten Backends eines Mitglieds über einen Stream an einen Client. |
| MoveLeader | MoveLeaderRequest | MoveLeaderResponse | MoveLeader fordert den aktuellen Leader-Knoten auf, seine Führungsrolle an den vorgesehenen Empfänger zu übertragen. |
| Downgrade | DowngradeRequest | DowngradeResponse | Downgrade fordert ein Downgrade der Clusterversion an, prüft dessen Durchführbarkeit oder bricht es ab. Seit etcd 3.5 unterstützt. |
Dienst Watch (api/etcdserverpb/rpc.proto)
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| Watch | WatchRequest | WatchResponse | Watch beobachtet aktuelle oder bereits vergangene Ereignisse. Ein- und Ausgabe sind Streams: Der Eingabestream dient zum Erstellen und Abbrechen von Watchern, der Ausgabestream überträgt Ereignisse. Ein Watch-RPC kann mehrere Schlüsselbereiche beobachten und Ereignisse für mehrere Watches gleichzeitig streamen. Der gesamte Ereignisverlauf kann ab der letzten Kompaktierungsrevision beobachtet werden. |
Nachricht AlarmMember (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| memberID | memberID ist die ID des Mitglieds, dem der ausgelöste Alarm zugeordnet ist. | uint64 |
| alarm | alarm ist der Typ des ausgelösten Alarms. | AlarmType |
Nachricht AlarmRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action ist die Art der auszuführenden Alarmanfrage. Die Aktion kann Alarmzustände abrufen (GET), einen Alarm aktivieren (ACTIVATE) oder einen ausgelösten Alarm deaktivieren (DEACTIVATE). | AlarmAction |
| memberID | memberID ist die ID des Mitglieds, dem der Alarm zugeordnet ist. Ist memberID 0, umfasst die Alarmanfrage alle Mitglieder. | uint64 |
| alarm | alarm ist der bei dieser Anfrage zu berücksichtigende Alarmtyp. | AlarmType |
Nachricht AlarmResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| alarms | alarms ist eine Liste der Alarme, die der Alarmanfrage zugeordnet sind. | (Slice von) AlarmMember |
Nachricht AuthDisableRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht AuthDisableResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthEnableRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht AuthEnableResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthRoleAddRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name ist der Name der Rolle, die dem Authentifizierungssystem hinzugefügt werden soll. | string |
Nachricht AuthRoleAddResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthRoleDeleteRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
Nachricht AuthRoleDeleteResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthRoleGetRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
Nachricht AuthRoleGetResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| header | ResponseHeader | |
| perm | (Slice von) authpb.Permission |
Nachricht AuthRoleGrantPermissionRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name ist der Name der Rolle, der die Berechtigung erteilt wird. | string |
| perm | perm ist die Berechtigung, die der Rolle erteilt werden soll. | authpb.Permission |
Nachricht AuthRoleGrantPermissionResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthRoleListRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht AuthRoleListResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (Slice von) string |
Nachricht AuthRoleRevokePermissionRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string | |
| key | bytes | |
| range_end | bytes |
Nachricht AuthRoleRevokePermissionResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthStatusRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht AuthStatusResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| enabled | bool | |
| authRevision | authRevision ist die aktuelle Revision des Authentifizierungsspeichers | uint64 |
Nachricht AuthUserAddRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string | |
| options | authpb.UserAddOptions | |
| hashedPassword | string |
Nachricht AuthUserAddResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthUserChangePasswordRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name ist der Name des Benutzers, dessen Passwort geändert wird. | string |
| password | password ist das neue Passwort des Benutzers. Dieses Feld wird in der API-Schicht entfernt. | string |
| hashedPassword | hashedPassword ist der Hashwert des neuen Passworts des Benutzers. Dieses Feld wird in der API-Schicht initialisiert. | string |
Nachricht AuthUserChangePasswordResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthUserDeleteRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | name ist der Name des zu löschenden Benutzers. | string |
Nachricht AuthUserDeleteResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthUserGetRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string |
Nachricht AuthUserGetResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (Slice von) string |
Nachricht AuthUserGrantRoleRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| user | user ist der Name des Benutzers, dem eine angegebene Rolle zugewiesen werden sollte. | string |
| role | role ist der Name der Rolle, die dem Benutzer zugewiesen werden soll. | string |
Nachricht AuthUserGrantRoleResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthUserListRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht AuthUserListResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| users | (Slice von) string |
Nachricht AuthUserRevokeRoleRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| role | string |
Nachricht AuthUserRevokeRoleResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht AuthenticateRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string |
Nachricht AuthenticateResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| token | token ist ein autorisiertes Token, das in nachfolgenden RPCs verwendet werden kann | string |
Nachricht CompactionRequest (api/etcdserverpb/rpc.proto)
CompactionRequest kompaktiert den Schlüssel-Wert-Speicher bis zu einer angegebenen Revision. Alle ersetzten Schlüssel mit einer Revision unterhalb der Kompaktierungsrevision werden entfernt.
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | revision ist die Revision des Schlüssel-Wert-Speichers für die Kompaktierungsoperation. | int64 |
| physical | Wenn physical gesetzt ist, wartet der RPC, bis die Kompaktierung physisch auf die lokale Datenbank angewendet wurde und die kompaktierten Einträge vollständig aus der Backend-Datenbank entfernt sind. | bool |
Nachricht CompactionResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht Compare (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| result | result ist die logische Vergleichsoperation für diesen Vergleich. | CompareResult |
| target | target ist das Schlüssel-Wert-Feld, das für den Vergleich geprüft werden soll. | CompareTarget |
| key | key ist der Schlüssel, auf den die Vergleichsoperation angewendet wird. | bytes |
| target_union | oneof | |
| version | version ist die Version des angegebenen Schlüssels | int64 |
| create_revision | create_revision ist die Erstellungsrevision des angegebenen Schlüssels | int64 |
| mod_revision | mod_revision ist die Revision der letzten Änderung des angegebenen Schlüssels. | int64 |
| value | value ist der Wert des angegebenen Schlüssels als Bytes. | bytes |
| lease | lease ist die Lease-ID des angegebenen Schlüssels. | int64 |
| range_end | range_end vergleicht das angegebene target mit allen Schlüsseln im Bereich [key, range_end). Weitere Informationen zu Schlüsselbereichen enthält RangeRequest. | bytes |
Nachricht DefragmentRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht DefragmentResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht DeleteRangeRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key ist der erste zu löschende Schlüssel im Bereich. | bytes |
| range_end | range_end ist der Schlüssel nach dem letzten zu löschenden Schlüssel im Bereich [key, range_end). Ist range_end nicht angegeben, enthält der Bereich nur das Argument key. Ist range_end gleich dem angegebenen Schlüssel plus eins, umfasst der Bereich alle Schlüssel mit diesem Präfix, also dem angegebenen Schlüssel. Ist range_end ‘\0’, umfasst der Bereich alle Schlüssel größer oder gleich dem Argument key. | bytes |
| prev_kv | Ist prev_kv gesetzt, ruft etcd vor dem Löschen die vorherigen Schlüssel-Wert-Paare ab. Diese werden in der Löschantwort zurückgegeben. | bool |
Nachricht DeleteRangeResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| deleted | deleted ist die Anzahl der durch die Bereichslöschanfrage gelöschten Schlüssel. | int64 |
| prev_kvs | Ist prev_kv in der Anfrage gesetzt, werden die vorherigen Schlüssel-Wert-Paare zurückgegeben. | (Slice von) mvccpb.KeyValue |
Nachricht DowngradeInfo (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| enabled | enabled gibt an, ob für den Cluster ein Downgrade aktiviert ist. | bool |
| targetVersion | targetVersion ist die Zielversion des Downgrades. | string |
Nachricht DowngradeRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | action ist die Art der auszuführenden Downgrade-Anfrage. Die Aktion kann die Zielversion validieren (VALIDATE), die Clusterversion herabsetzen (DOWNGRADE) oder den laufenden Downgrade-Vorgang abbrechen (CANCEL). | DowngradeAction |
| version | version ist die Zielversion des Downgrades. | string |
Nachricht DowngradeResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version ist die aktuelle Clusterversion. | string |
Nachricht DowngradeVersionTestRequest (api/etcdserverpb/rpc.proto)
DowngradeVersionTestRequest wird nur für Tests verwendet. Die Version in dieser Anfrage wird als Version des WAL-Eintrags gelesen. Ist die Downgrade-Zielversion kleiner als diese Version, ist das Downgrade im laufenden Betrieb oder die Offline-Migration nicht sicher und sollte daher nicht zugelassen werden.
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ver | string |
Nachricht HashKVRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | revision ist die Revision des Schlüssel-Wert-Speichers für die Hash-Operation. | int64 |
Nachricht HashKVResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash ist der Hashwert, der aus den MVCC-Schlüsseln des antwortenden Mitglieds bis zu einer angegebenen Revision berechnet wurde. | uint32 |
| compact_revision | compact_revision ist die Kompaktierungsrevision des Schlüssel-Wert-Speichers zu Beginn der Hash-Berechnung. | int64 |
| hash_revision | hash_revision ist die Revision, bis zu der der Hash berechnet wird. | int64 |
Nachricht HashRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht HashResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hash ist der Hashwert, der aus dem KV-Backend des antwortenden Mitglieds berechnet wurde. | uint32 |
Nachricht LeaseCheckpoint (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Lease-ID, für die ein Checkpoint erstellt werden soll. | int64 |
| remaining_TTL | Remaining_TTL ist die verbleibende Zeit bis zum Ablauf der Lease. | int64 |
Nachricht LeaseCheckpointRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| checkpoints | (Slice von) LeaseCheckpoint |
Nachricht LeaseCheckpointResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht LeaseGrantRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| TTL | TTL ist die empfohlene Lebensdauer in Sekunden. Für eine abgelaufene Lease wird -1 zurückgegeben. | int64 |
| ID | ID ist die angeforderte ID der Lease. Ist ID auf 0 gesetzt, wählt der Lease-Geber eine ID aus. | int64 |
Nachricht LeaseGrantResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID ist die Lease-ID der gewährten Lease. | int64 |
| TTL | TTL ist die vom Server gewählte Lebensdauer der Lease in Sekunden. | int64 |
| error | string |
Nachricht LeaseKeepAliveRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Lease-ID der am Leben zu haltenden Lease. | int64 |
Nachricht LeaseKeepAliveResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID ist die Lease-ID aus der Keepalive-Anfrage. | int64 |
| TTL | TTL ist die neue Lebensdauer der Lease. | int64 |
Nachricht LeaseLeasesRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht LeaseLeasesResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| leases | (Slice von) LeaseStatus |
Nachricht LeaseRevokeRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Lease-ID der zu widerrufenden Lease. Wird die ID widerrufen, werden alle zugeordneten Schlüssel gelöscht. | int64 |
Nachricht LeaseRevokeResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht LeaseStatus (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | int64 |
Nachricht LeaseTimeToLiveRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Lease-ID der Lease. | int64 |
| keys | keys wird auf true gesetzt, um alle dieser Lease zugeordneten Schlüssel abzufragen. | bool |
Nachricht LeaseTimeToLiveResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | ID ist die Lease-ID aus der Keepalive-Anfrage. | int64 |
| TTL | TTL ist die verbleibende TTL der Lease in Sekunden; die Lease läuft in weniger als TTL+1 Sekunden ab. | int64 |
| grantedTTL | GrantedTTL ist die bei der Erstellung oder Verlängerung der Lease anfänglich gewährte Zeit in Sekunden. | int64 |
| keys | Keys ist die Liste der dieser Lease zugeordneten Schlüssel. | (Slice von) bytes |
Nachricht Member (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Mitglieds-ID dieses Mitglieds. | uint64 |
| name | name ist der menschenlesbare Name des Mitglieds. Ist das Mitglied nicht gestartet, ist name eine leere Zeichenfolge. | string |
| peerURLs | peerURLs ist die Liste der URLs, die das Mitglied dem Cluster zur Kommunikation bereitstellt. | (Slice von) string |
| clientURLs | clientURLs ist die Liste der URLs, die das Mitglied Clients zur Kommunikation bereitstellt. Ist das Mitglied nicht gestartet, ist clientURLs leer. | (Slice von) string |
| isLearner | isLearner gibt an, ob das Mitglied ein Raft-Learner ist. | bool |
Nachricht MemberAddRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| peerURLs | peerURLs ist die Liste der URLs, die das hinzugefügte Mitglied zur Kommunikation mit dem Cluster verwendet. | (Slice von) string |
| isLearner | isLearner gibt an, ob das hinzugefügte Mitglied ein Raft-Learner ist. | bool |
Nachricht MemberAddResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| member | member enthält die Mitgliedsinformationen des hinzugefügten Mitglieds. | Member |
| members | members ist eine Liste aller Mitglieder nach dem Hinzufügen des neuen Mitglieds. | (Slice von) Member |
Nachricht MemberListRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| linearizable | bool |
Nachricht MemberListResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members ist eine Liste aller dem Cluster zugeordneten Mitglieder. | (Slice von) Member |
Nachricht MemberPromoteRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Mitglieds-ID des hochzustufenden Mitglieds. | uint64 |
Nachricht MemberPromoteResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members ist eine Liste aller Mitglieder nach der Hochstufung des Mitglieds. | (Slice von) Member |
Nachricht MemberRemoveRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Mitglieds-ID des zu entfernenden Mitglieds. | uint64 |
Nachricht MemberRemoveResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members ist eine Liste aller Mitglieder nach dem Entfernen des Mitglieds. | (Slice von) Member |
Nachricht MemberUpdateRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | ID ist die Mitglieds-ID des zu aktualisierenden Mitglieds. | uint64 |
| peerURLs | peerURLs ist die neue Liste der URLs, die das Mitglied zur Kommunikation mit dem Cluster verwendet. | (Slice von) string |
Nachricht MemberUpdateResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | members ist eine Liste aller Mitglieder nach der Aktualisierung des Mitglieds. | (Slice von) Member |
Nachricht MoveLeaderRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| targetID | targetID ist die Knoten-ID des neuen Leaders. | uint64 |
Nachricht MoveLeaderResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
Nachricht PutRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key ist der Schlüssel als Bytes, der in den Schlüssel-Wert-Speicher geschrieben werden soll. | bytes |
| value | value ist der Wert als Bytes, der dem Schlüssel im Schlüssel-Wert-Speicher zugeordnet werden soll. | bytes |
| lease | lease ist die Lease-ID, die dem Schlüssel im Schlüssel-Wert-Speicher zugeordnet werden soll. Der Lease-Wert 0 bedeutet, dass keine Lease zugeordnet ist. | int64 |
| prev_kv | Ist prev_kv gesetzt, ruft etcd vor der Änderung das vorherige Schlüssel-Wert-Paar ab. Dieses wird in der Put-Antwort zurückgegeben. | bool |
| ignore_value | Ist ignore_value gesetzt, aktualisiert etcd den Schlüssel mit seinem aktuellen Wert. Wenn der Schlüssel nicht existiert, wird ein Fehler zurückgegeben. | bool |
| ignore_lease | Ist ignore_lease gesetzt, aktualisiert etcd den Schlüssel mit seiner aktuellen Lease. Wenn der Schlüssel nicht existiert, wird ein Fehler zurückgegeben. | bool |
Nachricht PutResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| prev_kv | Ist prev_kv in der Anfrage gesetzt, wird das vorherige Schlüssel-Wert-Paar zurückgegeben. | mvccpb.KeyValue |
Nachricht RangeRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key ist der erste Schlüssel des Bereichs. Ist range_end nicht angegeben, sucht die Anfrage nur nach key. | bytes |
| range_end | range_end ist die obere Grenze des angeforderten Bereichs [key, range_end). Ist range_end ‘\0’, umfasst der Bereich alle Schlüssel >= key. Ist range_end key plus eins, etwa “aa”+1 == “ab” oder “a\xff”+1 == “b”, ruft die Bereichsanfrage alle Schlüssel mit dem Präfix key ab. Sind key und range_end beide ‘\0’, gibt die Bereichsanfrage alle Schlüssel zurück. | bytes |
| limit | limit begrenzt die Anzahl der für die Anfrage zurückgegebenen Schlüssel. Der Wert 0 bedeutet keine Begrenzung. | int64 |
| revision | revision ist der für den Bereich zu verwendende Zeitpunkt im Schlüssel-Wert-Speicher. Ist revision kleiner oder gleich null, bezieht sich der Bereich auf den neuesten Stand des Schlüssel-Wert-Speichers. Wurde die Revision bereits kompaktiert, wird ErrCompacted zurückgegeben. | int64 |
| sort_order | sort_order ist die Reihenfolge der zurückgegebenen sortierten Ergebnisse. | SortOrder |
| sort_target | sort_target ist das Schlüssel-Wert-Feld, nach dem sortiert wird. | SortTarget |
| serializable | serializable legt fest, dass die Bereichsanfrage serialisierbare, auf das Mitglied beschränkte Lesezugriffe verwendet. Bereichsanfragen sind standardmäßig linearisierbar. Linearisierbare Anfragen haben eine höhere Latenz und einen geringeren Durchsatz als serialisierbare Anfragen, spiegeln aber den aktuellen Konsens des Clusters wider. Für bessere Leistung auf Kosten möglicherweise veralteter Leseergebnisse wird eine serialisierbare Bereichsanfrage lokal bearbeitet, ohne einen Konsens mit anderen Clusterknoten herstellen zu müssen. | bool |
| keys_only | Wenn keys_only gesetzt ist, werden nur die Schlüssel und nicht die Werte zurückgegeben. | bool |
| count_only | Wenn count_only gesetzt ist, wird nur die Anzahl der Schlüssel im Bereich zurückgegeben. | bool |
| min_mod_revision | min_mod_revision ist die Untergrenze für die Änderungsrevisionen der zurückgegebenen Schlüssel. Alle Schlüssel mit kleineren Änderungsrevisionen werden herausgefiltert. | int64 |
| max_mod_revision | max_mod_revision ist die Obergrenze für die Änderungsrevisionen der zurückgegebenen Schlüssel. Alle Schlüssel mit größeren Änderungsrevisionen werden herausgefiltert. | int64 |
| min_create_revision | min_create_revision ist die Untergrenze für die Erstellungsrevisionen der zurückgegebenen Schlüssel. Alle Schlüssel mit kleineren Erstellungsrevisionen werden herausgefiltert. | int64 |
| max_create_revision | max_create_revision ist die Obergrenze für die Erstellungsrevisionen der zurückgegebenen Schlüssel. Alle Schlüssel mit größeren Erstellungsrevisionen werden herausgefiltert. | int64 |
Nachricht RangeResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| kvs | kvs ist die Liste der Schlüssel-Wert-Paare, die der Bereichsanfrage entsprechen. Bei einer Anfrage nach count ist kvs leer. | (Slice von) mvccpb.KeyValue |
| more | more gibt an, ob im angeforderten Bereich weitere Schlüssel zurückzugeben sind. | bool |
| count | count wird auf Anfrage auf die tatsächliche Anzahl der Schlüssel im Bereich gesetzt. Anders als Kvs bleibt es von Begrenzungen und Filtern wie Min/Max, Create/Modify und Revisions unbeeinflusst und gibt die vollständige Anzahl im angegebenen Bereich wieder. | int64 |
Nachricht RequestOp (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request | request ist eine Vereinigung der von einer Transaktion akzeptierten Anfragetypen. | oneof |
| request_range | RangeRequest | |
| request_put | PutRequest | |
| request_delete_range | DeleteRangeRequest | |
| request_txn | TxnRequest |
Nachricht ResponseHeader (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| cluster_id | cluster_id ist die ID des Clusters, der die Antwort gesendet hat. | uint64 |
| member_id | member_id ist die ID des Mitglieds, das die Antwort gesendet hat. | uint64 |
| revision | revision ist die Revision des Schlüssel-Wert-Speichers zum Zeitpunkt der Anwendung der Anfrage. Bei Aufrufen ohne Zugriff auf den Schlüssel-Wert-Speicher ist sie nicht gesetzt und daher 0. Bei Watch-Fortschrittsantworten zeigt header.revision den Fortschritt an. Alle künftig in diesem Stream empfangenen Ereignisse haben garantiert eine höhere Revisionsnummer als header.revision. | int64 |
| raft_term | raft_term ist der Raft-Term zum Zeitpunkt der Anwendung der Anfrage. | uint64 |
Nachricht ResponseOp (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| response | response ist eine Vereinigung der von einer Transaktion zurückgegebenen Antworttypen. | oneof |
| response_range | RangeResponse | |
| response_put | PutResponse | |
| response_delete_range | DeleteRangeResponse | |
| response_txn | TxnResponse |
Nachricht SnapshotRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht SnapshotResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | header enthält die aktuellen Informationen zum Schlüssel-Wert-Speicher. Der erste Header im Snapshot-Stream gibt den Zeitpunkt des Snapshots an. | ResponseHeader |
| remaining_bytes | remaining_bytes ist die Anzahl der Blob-Bytes, die nach dieser Nachricht noch gesendet werden | uint64 |
| blob | blob enthält den nächsten Teil des Snapshots im Snapshot-Stream. | bytes |
| version | Im Snapshot gespeicherte Version des Speicherschemas. Sie wird aus dem lokalen Backend des Mitglieds gelesen und kann von dessen Binärversion abweichen. Gibt an, welche etcd-Speicherversion beim Wiederherstellen des Snapshots unterstützt werden muss. | string |
Nachricht StatusRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht StatusResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | version ist die Binärversion des antwortenden etcd-Mitglieds. Die Version des Speicherschemas wird separat in storageVersion angegeben. | string |
| dbSize | dbSize ist die physisch zugewiesene Größe der Backend-Datenbank des antwortenden Mitglieds in Bytes. | int64 |
| leader | leader ist die Mitglieds-ID, die das antwortende Mitglied für den aktuellen Leader hält. | uint64 |
| raftIndex | raftIndex ist der aktuelle bestätigte Raft-Index des antwortenden Mitglieds. | uint64 |
| raftTerm | raftTerm ist der aktuelle Raft-Term des antwortenden Mitglieds. | uint64 |
| raftAppliedIndex | raftAppliedIndex ist der aktuelle angewendete Raft-Index des antwortenden Mitglieds. | uint64 |
| errors | errors enthält Alarm- und Zustandsinformationen sowie den Status. | (Slice von) string |
| dbSizeInUse | dbSizeInUse ist die logisch verwendete Größe der Backend-Datenbank des antwortenden Mitglieds in Bytes. | int64 |
| isLearner | isLearner gibt an, ob das Mitglied ein Raft-Learner ist. | bool |
| storageVersion | storageVersion ist die Version der db-Datei. Sie kann gegenüber der angestrebten Clusterversion verzögert aktualisiert werden. | string |
| dbSizeQuota | dbSizeQuota ist das konfigurierte etcd-Speicherkontingent in Bytes, also der über die Option –quota-backend-bytes an die etcd-Instanz übergebene Wert | int64 |
| downgradeInfo | downgradeInfo gibt an, ob ein Downgrade-Vorgang läuft. | DowngradeInfo |
Nachricht TxnRequest (api/etcdserverpb/rpc.proto)
Aus dem Google-PaxosDB-Papier: Unsere Implementierung beruht auf einer leistungsfähigen Grundoperation namens MultiOp. Alle anderen Datenbankoperationen außer der Iteration sind als einzelner MultiOp-Aufruf implementiert. Eine MultiOp wird atomar angewendet und besteht aus drei Komponenten: 1. Einer Liste von Prüfungen namens guard. Jede Prüfung in guard prüft einen einzelnen Datenbankeintrag. Sie kann prüfen, ob ein Wert fehlt oder vorhanden ist, oder ihn mit einem angegebenen Wert vergleichen. Zwei verschiedene Prüfungen in guard können denselben oder unterschiedliche Datenbankeinträge betreffen. Alle Prüfungen in guard werden ausgeführt, und MultiOp gibt die Ergebnisse zurück. Sind alle Prüfungen wahr, führt MultiOp t op aus (siehe Punkt 2 unten), andernfalls f op (siehe Punkt 3 unten). 2. Einer Liste von Datenbankoperationen namens t op. Jede Operation ist eine Einfüge-, Lösch- oder Suchoperation und betrifft einen einzelnen Datenbankeintrag. Zwei verschiedene Operationen können denselben oder unterschiedliche Datenbankeinträge betreffen. Diese Operationen werden ausgeführt, wenn guard true ergibt. 3. Einer Liste von Datenbankoperationen namens f op. Wie t op, wird jedoch ausgeführt, wenn guard false ergibt.
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| compare | compare ist eine Liste von Prädikaten, die eine Konjunktion von Bedingungen repräsentiert. Sind die Vergleiche erfolgreich, werden die success-Anfragen der Reihe nach verarbeitet, und die Antwort enthält deren Antworten in derselben Reihenfolge. Schlagen die Vergleiche fehl, werden die failure-Anfragen der Reihe nach verarbeitet, und die Antwort enthält deren Antworten in derselben Reihenfolge. | (Slice von) Compare |
| success | success ist eine Liste von Anfragen, die angewendet werden, wenn compare true ergibt. | (Slice von) RequestOp |
| failure | failure ist eine Liste von Anfragen, die angewendet werden, wenn compare false ergibt. | (Slice von) RequestOp |
Nachricht TxnResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| succeeded | succeeded wird auf true gesetzt, wenn compare true ergab, andernfalls auf false. | bool |
| responses | responses ist eine Liste von Antworten auf die Ergebnisse der Anwendung von success, falls succeeded true ist, beziehungsweise failure, falls succeeded false ist. | (Slice von) ResponseOp |
Nachricht WatchCancelRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| watch_id | watch_id ist die ID des abzubrechenden Watchers, damit keine weiteren Ereignisse übertragen werden. | int64 |
Nachricht WatchCreateRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | key ist der Schlüssel, der zur Beobachtung registriert werden soll. | bytes |
| range_end | range_end ist das Ende des zu beobachtenden Bereichs [key, range_end). Ist range_end nicht angegeben, wird nur das Argument key beobachtet. Ist range_end gleich ‘\0’, werden alle Schlüssel größer oder gleich dem Argument key beobachtet. Ist range_end gleich dem angegebenen Schlüssel plus eins, werden alle Schlüssel mit diesem Präfix, also dem angegebenen Schlüssel, beobachtet. | bytes |
| start_revision | start_revision ist eine optionale Revision, ab der einschließlich beobachtet wird. Ohne start_revision beginnt die Beobachtung „jetzt“. | int64 |
| progress_notify | Wenn progress_notify gesetzt ist und keine aktuellen Ereignisse vorliegen, sendet der etcd-Server regelmäßig eine WatchResponse ohne Ereignisse an den neuen Watcher. Das ist nützlich, wenn Clients einen unterbrochenen Watcher ab einer kürzlich bekannt gewordenen Revision wiederherstellen möchten. Der etcd-Server kann anhand der aktuellen Last entscheiden, wie häufig er Benachrichtigungen sendet. | bool |
| filters | filters filtert die Ereignisse serverseitig, bevor sie an den Watcher zurückgesendet werden. | (Slice von) FilterType |
| prev_kv | Ist prev_kv gesetzt, erhält der erstellte Watcher den vorherigen KV vor dem Ereignis. Wurde der vorherige KV bereits kompaktiert, wird nichts zurückgegeben. | bool |
| watch_id | Wird watch_id angegeben und ist ungleich null, wird sie diesem Watcher zugewiesen. Da das Erstellen eines Watchers in etcd kein synchroner Vorgang ist, lässt sich damit beim Erstellen mehrerer Watcher im selben Stream die richtige Reihenfolge sicherstellen. Wird ein Watcher mit einer im Stream bereits verwendeten ID erstellt, wird ein Fehler zurückgegeben. | int64 |
| fragment | fragment ermöglicht das Aufteilen großer Revisionen auf mehrere Watch-Antworten. | bool |
Nachricht WatchProgressRequest (api/etcdserverpb/rpc.proto)
Fordert an, dass der Fortschrittsstatus eines Watch-Streams so bald wie möglich im Watch-Antwortstream gesendet wird.
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
Nachricht WatchRequest (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request_union | request_union ist eine Anfrage zum Erstellen eines neuen Watchers oder zum Abbrechen eines vorhandenen Watchers. | oneof |
| create_request | WatchCreateRequest | |
| cancel_request | WatchCancelRequest | |
| progress_request | WatchProgressRequest |
Nachricht WatchResponse (api/etcdserverpb/rpc.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| watch_id | watch_id ist die ID des Watchers, zu dem die Antwort gehört. | int64 |
| created | created wird auf true gesetzt, wenn die Antwort zu einer Anfrage zum Erstellen eines Watches gehört. Der Client sollte watch_id speichern und die Ereignisse für den erstellten Watcher im selben Stream erwarten. Alle an diesen Watcher gesendeten Ereignisse enthalten dieselbe watch_id. | bool |
| canceled | canceled wird auf true gesetzt, wenn die Antwort zu einer Anfrage zum Abbrechen eines Watches gehört oder start_revision bereits kompaktiert wurde. An den abgebrochenen Watcher werden keine weiteren Ereignisse gesendet. | bool |
| compact_revision | compact_revision wird auf den kleinsten Index gesetzt, wenn ein Watcher versucht, einen bereits kompaktierten Index zu beobachten. Dies geschieht beim Erstellen eines Watchers an einer kompaktierten Revision oder wenn der Watcher den Fortschritt des Schlüssel-Wert-Speichers nicht einholen kann. Der Client sollte den Watcher als abgebrochen behandeln und nicht erneut versuchen, einen Watcher mit derselben start_revision zu erstellen. | int64 |
| cancel_reason | cancel_reason gibt den Grund für den Abbruch des Watchers an. | string |
| fragment | fragment ist true, wenn eine große Watch-Antwort auf mehrere Antworten aufgeteilt wurde. | bool |
| events | (Slice von) mvccpb.Event |
Nachricht Event (api/mvccpb/kv.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| type | type ist die Art des Ereignisses. Ist type ein PUT, wurden neue Daten unter dem Schlüssel gespeichert. Ist type ein DELETE, wurde der Schlüssel gelöscht. | EventType |
| kv | kv enthält den KeyValue für das Ereignis. Ein PUT-Ereignis enthält das aktuelle kv-Paar. Ein PUT-Ereignis mit kv.Version=1 zeigt die Erstellung eines Schlüssels an. Ein DELETE/EXPIRE-Ereignis enthält den gelöschten Schlüssel, dessen Änderungsrevision auf die Revision der Löschung gesetzt ist. | KeyValue |
| prev_kv | prev_kv enthält das Schlüssel-Wert-Paar vor dem Ereignis. | KeyValue |
Nachricht KeyValue (api/mvccpb/kv.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| key | key ist der Schlüssel als Bytes. Ein leerer Schlüssel ist nicht zulässig. | bytes |
| create_revision | create_revision ist die Revision der letzten Erstellung dieses Schlüssels. | int64 |
| mod_revision | mod_revision ist die Revision der letzten Änderung dieses Schlüssels. | int64 |
| version | version ist die Version des Schlüssels. Eine Löschung setzt die Version auf null zurück, und jede Änderung des Schlüssels erhöht seine Version. | int64 |
| value | value ist der unter dem Schlüssel gespeicherte Wert als Bytes. | bytes |
| lease | lease ist die ID der dem Schlüssel zugeordneten Lease. Wenn diese Lease abläuft, wird der Schlüssel gelöscht. Ist lease 0, ist dem Schlüssel keine Lease zugeordnet. | int64 |
Nachricht Lease (server/lease/leasepb/lease.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| ID | int64 | |
| TTL | int64 | |
| RemainingTTL | int64 |
Nachricht LeaseInternalRequest (server/lease/leasepb/lease.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| LeaseTimeToLiveRequest | etcdserverpb.LeaseTimeToLiveRequest |
Nachricht LeaseInternalResponse (server/lease/leasepb/lease.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| LeaseTimeToLiveResponse | etcdserverpb.LeaseTimeToLiveResponse |
Nachricht Permission (api/authpb/auth.proto)
Permission ist eine einzelne Entität
| Feld | Beschreibung | Typ |
|---|---|---|
| permType | Type | |
| key | bytes | |
| range_end | bytes |
Nachricht Role (api/authpb/auth.proto)
Role ist ein einzelner Eintrag im Bucket authRoles
| Feld | Beschreibung | Typ |
|---|---|---|
| name | bytes | |
| keyPermission | (Slice von) Permission |
Nachricht User (api/authpb/auth.proto)
User ist ein einzelner Eintrag im Bucket authUsers
| Feld | Beschreibung | Typ |
|---|---|---|
| name | bytes | |
| password | bytes | |
| roles | (Slice von) string | |
| options | UserAddOptions |
Nachricht UserAddOptions (api/authpb/auth.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| no_password | bool |
13.10 - API-Referenz: Nebenläufigkeit
Diese API-Referenz wird automatisch aus den angegebenen .proto-Dateien erzeugt.
Dienst Lock (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
Der Lock-Dienst stellt clientseitige Sperrfunktionen als gRPC-Schnittstelle bereit.
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| Lock | LockRequest | LockResponse | Lock erwirbt eine verteilte gemeinsame Sperre für einen bestimmten Sperrnamen. Bei Erfolg gibt es einen eindeutigen Schlüssel zurück, der so lange existiert, wie der Aufrufer die Sperre hält. Mit diesem Schlüssel und Transaktionen lässt sich zuverlässig sicherstellen, dass etcd nur aktualisiert wird, während der Aufrufer die Sperre besitzt. Die Sperre wird gehalten, bis Unlock für den Schlüssel aufgerufen wird oder die dem Besitzer zugeordnete Lease abläuft. |
| Unlock | UnlockRequest | UnlockResponse | Unlock nimmt einen von Lock zurückgegebenen Schlüssel entgegen und gibt die Sperre frei. Anschließend wird der nächste auf die Sperre wartende Lock-Aufrufer geweckt und erhält die Sperre. |
Nachricht LockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| name | name ist der Bezeichner der zu erwerbenden verteilten gemeinsamen Sperre. | bytes |
| lease | lease ist die ID der Lease, die dem Besitz der Sperre zugeordnet wird. Läuft die Lease ab oder wird sie widerrufen, während sie die Sperre hält, wird die Sperre automatisch freigegeben. Aufrufe von Lock mit derselben Lease werden als einmaliger Erwerb behandelt; zweimaliges Sperren mit derselben Lease hat keine zusätzliche Wirkung. | int64 |
Nachricht LockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| key | key ist ein Schlüssel, der in etcd existiert, solange der Lock-Aufrufer die Sperre besitzt. Benutzer sollten diesen Schlüssel nicht ändern, da die Sperre sonst ein undefiniertes Verhalten zeigen kann. | bytes |
Nachricht UnlockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| key | key ist der von Lock vergebene Schlüssel, der den Besitz der Sperre repräsentiert. | bytes |
Nachricht UnlockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
Dienst Election (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
Der Election-Dienst stellt clientseitige Wahlfunktionen als gRPC-Schnittstelle bereit.
| Methode | Anfragetyp | Antworttyp | Beschreibung |
|---|---|---|---|
| Campaign | CampaignRequest | CampaignResponse | Campaign wartet darauf, bei einer Wahl die Führung zu übernehmen, und gibt bei Erfolg einen LeaderKey zurück, der die Führungsrolle repräsentiert. Der LeaderKey kann anschließend verwendet werden, um neue Werte für die Wahl zu veröffentlichen, API-Anfragen durch Transaktionen vom fortbestehenden Besitz der Führungsrolle abhängig zu machen und von der Führungsrolle zurückzutreten. |
| Proclaim | ProclaimRequest | ProclaimResponse | Proclaim ersetzt den vom Leader veröffentlichten Wert durch einen neuen Wert. |
| Leader | LeaderRequest | LeaderResponse | Leader gibt den aktuell für die Wahl veröffentlichten Wert zurück, sofern vorhanden. |
| Observe | LeaderRequest | LeaderResponse | Observe überträgt die von den gewählten Leadern veröffentlichten Werte in ihrer Reihenfolge als Stream. |
| Resign | ResignRequest | ResignResponse | Resign gibt die Führungsrolle der Wahl frei, sodass andere Kandidaten sie übernehmen können. |
Nachricht CampaignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| name | name ist der Bezeichner der Wahl, für die die Kandidatur gilt. | bytes |
| lease | lease ist die ID der Lease, die der Führungsrolle der Wahl zugeordnet ist. Läuft die Lease vor dem Rücktritt ab oder wird sie widerrufen, geht die Führungsrolle auf den nächsten Kandidaten über, sofern vorhanden. | int64 |
| value | value ist der anfänglich veröffentlichte Wert, der gesetzt wird, wenn der Kandidat die Wahl gewinnt. | bytes |
Nachricht CampaignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| leader | leader beschreibt die Ressourcen, die zum Halten der Führungsrolle der Wahl verwendet werden. | LeaderKey |
Nachricht LeaderKey (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| name | name ist der Wahlbezeichner, der dem Schlüssel für die Führungsrolle entspricht. | bytes |
| key | key ist ein opaker Schlüssel, der den Besitz der Führungsrolle der Wahl repräsentiert. Wird der Schlüssel gelöscht, geht die Führungsrolle verloren. | bytes |
| rev | rev ist die Erstellungsrevision des Schlüssels. In Transaktionen lässt sich damit der Besitz der Führungsrolle prüfen, indem die Erstellungsrevision des Schlüssels mit rev verglichen wird. | int64 |
| lease | lease ist die Lease-ID des gewählten Leaders. | int64 |
Nachricht LeaderRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| name | name ist der Wahlbezeichner für die Informationen zur Führungsrolle. | bytes |
Nachricht LeaderResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| kv | kv ist das Schlüssel-Wert-Paar, das die neueste Aktualisierung des Leaders repräsentiert. | mvccpb.KeyValue |
Nachricht ProclaimRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| leader | leader repräsentiert den Besitz der Führungsrolle der Wahl. | LeaderKey |
| value | value ist eine Aktualisierung, die den aktuellen Wert des Leaders überschreiben soll. | bytes |
Nachricht ProclaimResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
Nachricht ResignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| leader | leader ist die Führungsrolle, die durch den Rücktritt aufgegeben werden soll. | LeaderKey |
Nachricht ResignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
Nachricht Event (api/mvccpb/kv.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| type | type ist die Art des Ereignisses. Ist type ein PUT, wurden neue Daten unter dem Schlüssel gespeichert. Ist type ein DELETE, wurde der Schlüssel gelöscht. | EventType |
| kv | kv enthält den KeyValue für das Ereignis. Ein PUT-Ereignis enthält das aktuelle kv-Paar. Ein PUT-Ereignis mit kv.Version=1 zeigt die Erstellung eines Schlüssels an. Ein DELETE/EXPIRE-Ereignis enthält den gelöschten Schlüssel, dessen Änderungsrevision auf die Revision der Löschung gesetzt ist. | KeyValue |
| prev_kv | prev_kv enthält das Schlüssel-Wert-Paar vor dem Ereignis. | KeyValue |
Nachricht KeyValue (api/mvccpb/kv.proto)
| Feld | Beschreibung | Typ |
|---|---|---|
| key | key ist der Schlüssel als Bytes. Ein leerer Schlüssel ist nicht zulässig. | bytes |
| create_revision | create_revision ist die Revision der letzten Erstellung dieses Schlüssels. | int64 |
| mod_revision | mod_revision ist die Revision der letzten Änderung dieses Schlüssels. | int64 |
| version | version ist die Version des Schlüssels. Eine Löschung setzt die Version auf null zurück, und jede Änderung des Schlüssels erhöht seine Version. | int64 |
| value | value ist der unter dem Schlüssel gespeicherte Wert als Bytes. | bytes |
| lease | lease ist die ID der dem Schlüssel zugeordneten Lease. Wenn diese Lease abläuft, wird der Schlüssel gelöscht. Ist lease 0, ist dem Schlüssel keine Lease zugeordnet. | int64 |
14 - Betriebshandbuch
14.1 - Anleitungen zur Authentifizierung
14.1.1 - Authentifizierung
auth,user,role für die Authentifizierung:
Hinweis:
Dies ist lediglich ein Entwurf, der um weitere Informationen zur Authentifizierung ergänzt und aktualisiert werden muss. Der obige Text ist nur ein Codebeispiel.
14.1.2 - Rollenbasierte Zugriffskontrolle
Überblick
Die Authentifizierung wurde in etcd 2.1 eingeführt. Die etcd-v3-API hat die API und die Benutzeroberfläche der Authentifizierungsfunktion geringfügig angepasst, um dem neuen Datenmodell besser gerecht zu werden. Diese Anleitung hilft dabei, eine grundlegende Authentifizierung und rollenbasierte Zugriffskontrolle in etcd v3 einzurichten.
Besondere Benutzer und Rollen
Es gibt einen besonderen Benutzer, root, und eine besondere Rolle, root.
Benutzer root
Der Benutzer root, der uneingeschränkten Zugriff auf etcd hat, muss vor der Aktivierung der Authentifizierung angelegt werden. Der Benutzer root ist für Verwaltungsaufgaben vorgesehen: die Verwaltung von Rollen und gewöhnlichen Benutzern. Der Benutzer root muss die Rolle root haben und darf alles in etcd ändern.
Rolle root
Die Rolle root kann neben dem root-Benutzer jedem Benutzer zugewiesen werden. Ein Benutzer mit der Rolle root hat sowohl globalen Lese- und Schreibzugriff als auch die Berechtigung, die Authentifizierungskonfiguration des Clusters zu ändern. Darüber hinaus gewährt die Rolle root Rechte für die allgemeine Clusterwartung, einschließlich der Änderung der Clustermitgliedschaft, der Defragmentierung des Speichers und der Erstellung von Snapshots.
Benutzer verwalten
Der Unterbefehl user von etcdctl übernimmt alle Aufgaben rund um Benutzerkonten.
Benutzer lassen sich wie folgt auflisten:
Ein Benutzer lässt sich einfach so anlegen:
Beim Anlegen eines neuen Benutzers wird ein neues Passwort abgefragt. Mit der Option --interactive=false kann das Passwort über die Standardeingabe übergeben werden. Auch --new-user-password kann zur Übergabe des Passworts verwendet werden.
Ein Benutzer, der sich nicht mit einem Passwort authentifizieren kann, lässt sich ebenfalls anlegen:
Ein solcher Benutzer kann sich nur über den TLS Common Name authentifizieren .
etcd unterstützt keine Authentifizierung mit einem leeren Passwort über --user username:. Beispielsweise kann sich ein mit leerem Passwort angelegter Benutzer wie etcdctl user add anonymous:'' nicht über Anfragen mit Benutzername und Passwort authentifizieren; Anfragen wie etcdctl --user anonymous: get foo schlagen mit user name is empty fehl.
Einem Benutzer lassen sich Rollen wie folgt zuweisen und entziehen:
Die Einstellungen des Benutzers lassen sich wie folgt anzeigen:
Das Passwort eines Benutzers lässt sich wie folgt ändern:
Bei der Passwortänderung wird erneut ein neues Passwort abgefragt. Mit der Option --interactive=false kann das Passwort über die Standardeingabe übergeben werden.
Ein Konto löschen:
Rollen verwalten
Der Unterbefehl role von etcdctl übernimmt alle Aufgaben rund um die Zugriffskontrolle für einzelne Rollen, die Benutzern zugewiesen wurden.
Rollen auflisten:
Eine neue Rolle anlegen:
Eine Rolle hat kein Passwort; sie definiert lediglich eine neue Menge von Zugriffsrechten.
Rollen erhalten Zugriff auf einen einzelnen Schlüssel oder einen Schlüsselbereich.
Der Bereich kann als Intervall [start-key, end-key) angegeben werden, wobei start-key in alphabetischer, lexikografischer Reihenfolge kleiner als end-key sein sollte.
Der Zugriff kann zum Lesen, zum Schreiben oder für beides gewährt werden, wie in den folgenden Beispielen:
Die gewährten Rechte lassen sich jederzeit anhand der Rolle anzeigen:
Der Entzug von Berechtigungen folgt demselben Prinzip:
Ebenso das vollständige Löschen einer Rolle:
Authentifizierung aktivieren
Für die Aktivierung der Authentifizierung sind mindestens die folgenden Schritte erforderlich. Der Administrator kann Benutzer und Rollen nach Belieben vor oder nach der Aktivierung der Authentifizierung einrichten.
Sicherstellen, dass der root-Benutzer angelegt ist:
Authentifizierung aktivieren:
Danach läuft etcd mit aktivierter Authentifizierung. Um sie aus beliebigem Grund zu deaktivieren, dient der entsprechende Gegenbefehl:
Schutzumfang der Authentifizierung
Wenn die Authentifizierung mit etcdctl auth enable aktiviert wird, schützt sie die Operationen der V3-gRPC-API (get, put, delete, watch usw.).
Die HTTP-Endpunkte /metrics und /health verwenden einen separaten Handler und werden nicht durch die V3-RBAC-Authentifizierung geschützt. Dadurch können Prometheus und Load-Balancer Metriken ohne gRPC-Authentifizierung abrufen, während die Schlüssel-Wert-Daten weiterhin geschützt sind.
Diese Endpunkte zur Überwachung lassen sich wie folgt absichern:
- mTLS mit
--cert-file,--key-fileund--client-cert-authaktivieren - Oder die Metriken mit
--listen-metrics-urlsan eine private Schnittstelle binden - Oder den Zugriff durch Netzwerkrichtlinien/Firewallregeln beschränken
Mit etcdctl authentifizieren
etcdctl unterstützt zur Authentifizierung eine ähnliche Option wie curl.
Das Passwort kann interaktiv abgefragt werden:
Das Passwort kann auch mit der Befehlszeilenoption --password übergeben werden:
Ansonsten bleiben alle etcdctl-Befehle unverändert. Benutzer und Rollen können weiterhin angelegt und geändert werden; dafür ist jedoch die Authentifizierung durch einen Benutzer mit der root-Rolle erforderlich.
TLS Common Name verwenden
Ab Version v3.2 wird beim Start eines etcd-Servers mit der Option --client-cert-auth=true das Feld Common Name (CN) im TLS-Zertifikat des Clients als etcd-Benutzer verwendet. In diesem Fall authentifiziert der Common Name den Benutzer, und der Client benötigt kein Passwort. Wenn sowohl 1. --client-cert-auth=true übergeben wird und der Client einen CN bereitstellt als auch 2. der Client Benutzername und Passwort übergibt, hat die Authentifizierung mit Benutzername und Passwort Vorrang. Diese Funktion kann nicht mit gRPC-proxy und gRPC-gateway verwendet werden. gRPC-proxy terminiert TLS vom Client, sodass alle Clients ein Zertifikat des Proxys gemeinsam nutzen. gRPC-gateway verwendet intern eine TLS-Verbindung, um HTTP-Anfragen in gRPC-Anfragen umzuwandeln, und unterliegt daher derselben Einschränkung. Die Clients können ihren CN deshalb nicht korrekt an den Server übermitteln. gRPC-proxy meldet einen Fehler und beendet sich, wenn ein angegebenes Zertifikat einen nicht leeren CN enthält. gRPC-proxy gibt einen Fehler zurück, der auf den nicht leeren CN im Zertifikat des Clients hinweist.
Hinweise zur Passwortstärke
etcdctl und die etcd-API erzwingen beim Anlegen von Benutzern oder beim Ändern ihrer Passwörter keine bestimmte Passwortlänge. Die Durchsetzung solcher Anforderungen liegt in der Verantwortung des Administrators. Um Sicherheitsrisiken durch schwache Passwörter zu vermeiden, können die Authentifizierung über den TLS Common Name
und Benutzer verwendet werden, die mit der Option --no-password angelegt wurden.
14.2 - Konfigurationsoptionen
etcd lässt sich auf folgende Arten konfigurieren:
- Befehlszeilenoptionen
- Umgebungsvariablen: Zu jeder Option gehört eine gleichnamige Umgebungsvariable,
deren Name jedoch mit
ETCD_beginnt und in Großbuchstaben mit Unterstrichen als Worttrennern geschrieben wird. Beispielsweise entspricht--some-flagder VariablenETCD_SOME_FLAG. - Konfigurationsdatei
Achtung: Werden verschiedene Konfigurationsarten kombiniert, gelten die folgenden Regeln.
- Befehlszeilenoptionen haben Vorrang vor Umgebungsvariablen.
- Wird eine Konfigurationsdatei angegeben, werden alle Befehlszeilenoptionen und Umgebungsvariablen ignoriert.
Befehlszeilenoptionen
Die Optionen werden im Folgenden im Format --flag-name DEFAULT_VALUE dargestellt.
Diese importierte Referenz enthält einige ältere v2-Optionen als Kontext für die Migration. In etcd 3.7 sind --enable-v2 und der v2-Proxy-Modus nicht verfügbar. Die veraltete Option --v2-deprecation ignoriert Benutzereingaben und erzwingt ihren Standardwert. Vor der Verwendung älterer Optionen die Ausgabe von etcd --help für die installierte Version prüfen.
Die folgende Optionsliste ist aufgrund laufender Entwicklungsänderungen möglicherweise nicht aktuell. Die neuesten verfügbaren Optionen lassen sich mit etcd --help oder in der etcd-Hilfe
nachschlagen.
Hinweis: Einzelheiten zu neuen, aktualisierten und als veraltet markierten Optionen in v3.7 stehen in CHANGELOG-3.7.md .
Mitglied
Clusterbildung
Sicherheit
Authentifizierung
Profiling und Überwachung
Protokollierung
Hinweis: Mehrere --experimental-*-Optionen wurden in v3.7 in stabile Optionen überführt oder umbenannt.
Veraltete Optionen unbedingt durch die unten aufgeführten stabilen Entsprechungen ersetzen.
Verteiltes Tracing
v2-Proxy
Der v2-Proxy wurde vor v3.7 entfernt. Die folgenden Optionen bleiben nur als historische Migrationsreferenz erhalten und dürfen nicht an einen etcd-v3.7-Server übergeben werden.
Funktionen
Funktionsschalter
Unsichere Funktionen
Warnung: Die Verwendung unsicherer Funktionen kann die Garantien des Konsensprotokolls außer Kraft setzen!
Konfigurationsdatei
Eine etcd-Konfigurationsdatei besteht aus einer YAML-Map. Ihre Schlüssel sind die Namen der Befehlszeilenoptionen und ihre Werte die jeweiligen Optionswerte.
Um diese Datei zu verwenden, ihren Pfad als Wert der Option --config-file oder der Umgebungsvariablen ETCD_CONFIG_FILE angeben.
Ein Beispiel bietet die etcd.conf.yml-Beispieldatei .
Zeitdauerfelder wie --grpc-keepalive-min-time, --grpc-keepalive-interval,
--grpc-keepalive-timeout, --backend-batch-interval, --corrupt-check-time,
--compact-hash-check-time, --compaction-sleep-interval,
--watch-progress-notify-interval, --warning-apply-duration,
--warning-unary-request-duration und --downgrade-check-time akzeptieren
als Befehlszeilenoptionen menschenlesbare Zeichenfolgen (z. B. 10m, 5s),
in einer Konfigurationsdatei jedoch nur ganzzahlige Werte in
Nanosekunden. Dies ist eine bekannte Einschränkung der Go-Standardbibliothek
,
bei der time.Duration als einfache Ganzzahl deserialisiert wird.
Beispiel für ein Intervall von 10 Minuten für Watch-Fortschrittsmeldungen in einer Konfigurationsdatei:
14.3 - Sicherheitsmodell für den Datentransport
etcd unterstützt automatisches TLS sowie die Authentifizierung über Clientzertifikate sowohl für die Kommunikation zwischen Clients und Servern als auch zwischen Peers (Servern bzw. innerhalb des Clusters). etcd aktiviert weder die RBAC-basierte Authentifizierung noch die Authentifizierung auf der Transportschicht standardmäßig, um den Einstieg in die Datenbank zu erleichtern. Eine Änderung dieses Standards würde außerdem die Kompatibilität des seit 2013 bestehenden Projekts brechen. Ein etcd-Cluster ohne aktivierte Sicherheitsfunktionen kann seine Daten beliebigen Clients zugänglich machen.
Für den Einstieg werden zunächst ein CA-Zertifikat und ein signiertes Schlüsselpaar für ein Mitglied benötigt. Es wird empfohlen, für jedes Clustermitglied ein neues Schlüsselpaar zu erstellen und zu signieren.
Das Werkzeug cfssl bietet eine einfache Schnittstelle zur Zertifikatserzeugung; ein Beispiel für seine Verwendung steht hier . Alternativ hilft diese Anleitung zum Erzeugen selbstsignierter Schlüsselpaare .
Die folgende Optionsliste ist aufgrund laufender Entwicklungsänderungen möglicherweise nicht aktuell. Die neuesten verfügbaren Optionen lassen sich mit etcd --help oder in der etcd-Hilfe
nachschlagen.
Grundlegende Einrichtung
etcd akzeptiert mehrere zertifikatsbezogene Konfigurationsoptionen, entweder als Befehlszeilenoptionen oder als Umgebungsvariablen:
Kommunikation zwischen Client und Server:
--cert-file=<path>: Zertifikat für SSL/TLS-Verbindungen zu etcd. Ist diese Option gesetzt, kann advertise-client-urls das HTTPS-Schema verwenden.
--key-file=<path>: Schlüssel für das Zertifikat. Muss unverschlüsselt sein.
--client-cert-auth: Ist diese Option gesetzt, prüft etcd alle eingehenden HTTPS-Anfragen auf ein von der vertrauenswürdigen CA signiertes Clientzertifikat. Anfragen ohne gültiges Clientzertifikat schlagen fehl. Ist die Authentifizierung
aktiviert, liefert das Zertifikat die Anmeldedaten für den im Feld Common Name angegebenen Benutzernamen.
--trusted-ca-file=<path>: Vertrauenswürdige Zertifizierungsstelle.
--auto-tls: Automatisch erzeugte, selbstsignierte Zertifikate für TLS-Verbindungen mit Clients verwenden.
Peer-Kommunikation (zwischen Servern bzw. innerhalb des Clusters):
Die Peer-Optionen funktionieren genauso wie die Optionen für die Kommunikation zwischen Client und Server:
--peer-cert-file=<path>: Zertifikat für SSL/TLS-Verbindungen zwischen Peers. Es wird sowohl beim Lauschen auf der Peer-Adresse als auch beim Senden von Anfragen an andere Peers verwendet.
--peer-key-file=<path>: Schlüssel für das Zertifikat. Muss unverschlüsselt sein.
--peer-client-cert-auth: Ist diese Option gesetzt, prüft etcd alle eingehenden Peer-Anfragen aus dem Cluster auf gültige Clientzertifikate, die von der angegebenen CA signiert wurden.
--peer-trusted-ca-file=<path>: Vertrauenswürdige Zertifizierungsstelle.
--peer-auto-tls: Automatisch erzeugte, selbstsignierte Zertifikate für TLS-Verbindungen zwischen Peers verwenden.
Wird ein Zertifikat für Client-Server- oder Peer-Verbindungen angegeben, muss auch der Schlüssel gesetzt sein. Alle diese Konfigurationsoptionen sind ebenfalls über Umgebungsvariablen wie ETCD_TRUSTED_CA_FILE, ETCD_PEER_TRUSTED_CA_FILE usw. verfügbar.
Gemeinsame Optionen:
--cipher-suites: Kommagetrennte Liste unterstützter TLS-Cipher-Suites zwischen Server und Client sowie zwischen Peers (bei leerem Wert automatisch von Go befüllt).
--tls-min-version=<version> Legt die niedrigste von etcd unterstützte TLS-Version fest.
--tls-max-version=<version> Legt die höchste von etcd unterstützte TLS-Version fest. Ohne Angabe wird die höchste von Go unterstützte Version verwendet.
keyUsage und extendedKeyUsage in TLS-Zertifikaten
Beim Erzeugen von X.509-Zertifikaten zur Absicherung des etcd-Datentransports sollten die Zertifikate
je nach ihrer Rolle passende Felder für keyUsage und
extendedKeyUsage enthalten. etcd verwendet zur Zertifikatsprüfung die Go-Bibliotheken
crypto/tls und crypto/x509,
die diese Verwendungszwecke beim TLS-Handshake durchsetzen.
Die folgende Tabelle fasst die empfohlenen Verwendungszwecke für gängige Zertifikatsrollen zusammen:
| Zertifikatsrolle | keyUsage | extendedKeyUsage |
|---|---|---|
| Server (Client-Server-Verbindung) | digitalSignature, keyEncipherment | serverAuth |
| Client | digitalSignature, keyEncipherment | clientAuth |
| Peer (Server-Server-Verbindung) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
Hinweise:
- Ist
--peer-client-cert-authaktiviert, werden Peer-Zertifikate für gegenseitiges TLS zwischen etcd-Mitgliedern verwendet und benötigen daher sowohlserverAuthals auchclientAuth. - Clientzertifikate für
--client-cert-authsolltenclientAuthenthalten.
Beispiel 1: Transportsicherheit zwischen Client und Server mit HTTPS
Dafür ein CA-Zertifikat (ca.crt) und ein signiertes Schlüsselpaar (server.crt, server.key) bereithalten.
etcd schrittweise für einfache HTTPS-Transportsicherheit konfigurieren:
Der Start sollte problemlos gelingen. Die Konfiguration lässt sich anschließend durch HTTPS-Kommunikation mit etcd testen:
Der Befehl sollte einen erfolgreichen Handshake anzeigen. Da selbstsignierte Zertifikate mit einer eigenen Zertifizierungsstelle verwendet werden, muss die CA mit der Option --cacert an curl übergeben werden. Alternativ kann das CA-Zertifikat zum Verzeichnis der vertrauenswürdigen Systemzertifikate hinzugefügt werden, gewöhnlich /etc/pki/tls/certs oder /etc/ssl/certs.
Benutzer von OSX 10.9+: curl 7.30.0 auf OSX 10.9+ versteht keine auf der Befehlszeile übergebenen Zertifikate.
Stattdessen die Testdatei ca.crt direkt in den Schlüsselbund importieren oder curl die Option -k übergeben, um Fehler zu ignorieren.
Für einen Test ohne -k den Befehl open ./tests/fixtures/ca/ca.crt ausführen und den Anweisungen folgen.
Dieses Zertifikat nach dem Test unbedingt entfernen!
Falls eine andere Lösung bekannt ist, teilen Sie uns diese mit.
Beispiel 2: Authentifizierung zwischen Client und Server mit HTTPS-Clientzertifikaten
Bisher kann der etcd-Client die Serveridentität prüfen und Transportsicherheit herstellen. Mit Clientzertifikaten lässt sich darüber hinaus unbefugter Zugriff auf etcd verhindern.
Die Clients übermitteln ihre Zertifikate an den Server. Dieser prüft, ob das Zertifikat von der angegebenen CA signiert wurde, und entscheidet, ob er die Anfrage bedient.
Dafür werden dieselben Dateien wie im ersten Beispiel benötigt, außerdem ein von derselben Zertifizierungsstelle signiertes Schlüsselpaar für den Client (client.crt, client.key).
Nun dieselbe Anfrage wie oben an diesen Server senden:
Der Server sollte die Anfrage ablehnen:
Damit sie erfolgreich ist, muss das von der CA signierte Clientzertifikat an den Server übergeben werden:
Die Ausgabe sollte Folgendes enthalten:
Außerdem die Antwort des Servers:
Cipher-Suites angeben, um schwache TLS-Cipher-Suites zu sperren.
Der TLS-Handshake schlägt fehl, wenn das Client Hello ungültige Cipher-Suites anfordert.
Zum Beispiel:
Clientanfragen müssen dann eine der auf dem Server angegebenen Cipher-Suites verwenden:
Beispiel 3: Transportsicherheit und Clientzertifikate in einem Cluster
etcd unterstützt dasselbe Modell für die Peer-Kommunikation, also die Kommunikation zwischen etcd-Mitgliedern eines Clusters.
Angenommen, ca.crt sowie zwei Mitglieder mit eigenen, von dieser CA signierten Schlüsselpaaren (member1.crt & member1.key, member2.crt & member2.key) sind vorhanden. Dann wird etcd wie folgt gestartet:
Die etcd-Mitglieder bilden einen Cluster. Die gesamte Kommunikation zwischen dessen Mitgliedern wird verschlüsselt und anhand der Clientzertifikate authentifiziert. Die Ausgabe von etcd zeigt, dass die für Verbindungen verwendeten Adressen HTTPS nutzen.
Beispiel 4: Automatische Transportsicherheit mit selbstsignierten Zertifikaten
Werden ClientAutoTLS und PeerAutoTLS angegeben, sind die von etcd automatisch erzeugten Client- und Peer-Zertifikate nur 1 Jahr gültig. Mit der Option –self-signed-cert-validity lässt sich die Gültigkeitsdauer der Zertifikate in Jahren festlegen.
Für Fälle, in denen die Kommunikation verschlüsselt, aber nicht authentifiziert werden muss, kann etcd seine Nachrichten mit automatisch erzeugten, selbstsignierten Zertifikaten verschlüsseln. Dies vereinfacht die Bereitstellung, da Zertifikate und Schlüssel nicht außerhalb von etcd verwaltet werden müssen.
etcd mit den Optionen --auto-tls und --peer-auto-tls so konfigurieren, dass es selbstsignierte Zertifikate für Client- und Peer-Verbindungen verwendet:
Selbstsignierte Zertifikate authentifizieren keine Identität, daher gibt curl einen Fehler zurück:
Um die Prüfung der Zertifikatskette zu deaktivieren, curl mit der Option -k aufrufen:
Hinweise zu DNS SRV
Seit v3.1.0 (außer v3.2.9) authentifiziert die Initialisierung über SRV-Erkennung ServerName anhand der Stammdomäne aus der Option --discovery-srv. Dies soll Zertifikatsangriffe nach dem Man-in-the-Middle-Prinzip verhindern, indem ein passender Stammdomänenname im Feld Subject Alternative Name (SAN) des Zertifikats verlangt wird. Beispielsweise authentifiziert etcd --discovery-srv=etcd.local Peers und Clients nur dann, wenn die bereitgestellten Zertifikate die Stammdomäne etcd.local als Eintrag im Feld Subject Alternative Name (SAN) enthalten.
Hinweise zum etcd-Proxy
Dieser Abschnitt beschreibt den historischen v2-Proxy, der inzwischen entfernt wurde. Für etcd 3.7 den v3-gRPC-Proxy verwenden.
Bei einer abgesicherten Clientverbindung terminiert der etcd-Proxy TLS vom Client und verwendet für die Kommunikation mit etcd-Mitgliedern seinen eigenen Schlüssel und sein eigenes Zertifikat aus --peer-key-file und --peer-cert-file.
Der Proxy kommuniziert mit etcd-Mitgliedern sowohl über deren --advertise-client-urls als auch über deren --advertise-peer-urls. Er leitet Clientanfragen an die bekannt gegebenen Client-URLs der Mitglieder weiter und synchronisiert die anfängliche Clusterkonfiguration über deren bekannt gegebene Peer-URLs.
Ist für ein etcd-Mitglied die Clientauthentifizierung aktiviert, muss der Administrator sicherstellen, dass das in --peer-cert-file des Proxys angegebene Peer-Zertifikat für diese Authentifizierung gültig ist. Ist auch die Peerauthentifizierung aktiviert, muss das Peer-Zertifikat des Proxys dafür ebenfalls gültig sein.
Hinweise zur TLS-Authentifizierung
Seit v3.2.0 werden TLS-Zertifikate bei jeder Clientverbindung neu geladen . Dadurch lassen sich ablaufende Zertifikate ersetzen, ohne die etcd-Server zu stoppen: Die alten Zertifikate werden einfach mit neuen überschrieben. Das Aktualisieren bei jeder Verbindung sollte keinen allzu großen Zusatzaufwand verursachen, könnte aber künftig durch eine Caching-Schicht verbessert werden. Beispieltests stehen hier .
Seit v3.2.0
lehnt der Server eingehende Peer-Zertifikate mit falschem IP-SAN ab
. Enthält ein Peer-Zertifikat beispielsweise IP-Adressen im Feld Subject Alternative Name (SAN), authentifiziert der Server einen Peer nur, wenn dessen entfernte IP-Adresse einer dieser Adressen entspricht. Dies soll den Beitritt unbefugter Endpunkte zum Cluster verhindern. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die tatsächliche IP-Adresse von Peer B ist dabei 10.138.0.2, nicht 10.138.0.27. Versucht Peer B dem Cluster beizutreten, lehnt Peer A ihn mit dem Fehler x509: certificate is valid for 10.138.0.27, not 10.138.0.2 ab, weil Bs entfernte IP-Adresse nicht mit der Adresse im Feld Subject Alternative Name (SAN) übereinstimmt.
Seit v3.2.0
löst der Server TLS-DNSNames bei der Prüfung von SAN auf
. Enthält ein Peer-Zertifikat im Feld Subject Alternative Name (SAN) nur DNS-Namen und keine IP-Adressen, authentifiziert der Server den Peer nur, wenn die Vorwärtsauflösung dieser Namen (dig b.com) eine zur entfernten IP-Adresse passende Adresse ergibt. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die entfernte IP-Adresse von Peer B ist dabei 10.138.0.2. Versucht B dem Cluster beizutreten, löst Peer A den eingehenden Host b.com auf, um die Liste seiner IP-Adressen zu erhalten (z. B. mit dig b.com). Enthält die Liste die IP-Adresse 10.138.0.2 nicht, lehnt A den Peer B mit dem Fehler tls: 10.138.0.2 does not match any of DNSNames ["b.com"] ab.
Seit v3.2.2
akzeptiert der Server Verbindungen bei passender IP-Adresse ohne Prüfung der DNS-Einträge
. Enthält ein Peer-Zertifikat im Feld Subject Alternative Name (SAN) sowohl IP-Adressen als auch DNS-Namen und stimmt die entfernte IP-Adresse mit einer dieser IP-Adressen überein, akzeptiert der Server die Verbindung ohne weitere Prüfung der DNS-Namen. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die entfernte IP-Adresse von Peer B ist dabei 10.138.0.2, und invalid.domain ist ein ungültiger Host. Versucht B dem Cluster beizutreten, authentifiziert Peer A ihn erfolgreich, da das Feld Subject Alternative Name (SAN) eine gültige, passende IP-Adresse enthält. Weitere Einzelheiten stehen in Issue #8206
.
Seit v3.2.5
unterstützt der Server die Rückwärtsauflösung für DNS-SAN mit Platzhaltern
. Enthält ein Peer-Zertifikat im Feld Subject Alternative Name (SAN) nur DNS-Namen und keine IP-Adressen, führt der Server zunächst eine Rückwärtsauflösung der entfernten IP-Adresse durch, um die zugehörigen Namen zu erhalten (z. B. nslookup IPADDR). Er akzeptiert die Verbindung, wenn einer dieser Namen exakt oder über einen Platzhalter mit einem DNS-Namen des Peer-Zertifikats übereinstimmt. Andernfalls führt er für jeden DNS-Eintrag des Peer-Zertifikats eine Vorwärtsauflösung durch (z. B. example.default.svc bei einem Eintrag *.example.default.svc). Er akzeptiert die Verbindung dann nur, wenn die aufgelösten Adressen des Hosts die entfernte IP-Adresse des Peers enthalten. Der CSR von Peer B (mit cfssl) könnte beispielsweise so aussehen:
Die entfernte IP-Adresse von Peer B ist dabei 10.138.0.2. Versucht B dem Cluster beizutreten, löst Peer A die IP-Adresse 10.138.0.2 rückwärts auf, um die Liste der Hostnamen zu erhalten. Anschließend vergleicht er diese Hostnamen exakt oder über Platzhalter mit den DNS-Namen im Feld Subject Alternative Name (SAN) von Bs Zertifikat. Schlägt sowohl die Rückwärts- als auch die Vorwärtsauflösung fehl, gibt er den Fehler "tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"] zurück. Weitere Einzelheiten stehen in Issue #8268
.
v3.3.0
ergänzt die Option etcd --peer-cert-allowed-cn
, um eine CN-basierte Authentifizierung (Common Name) für Verbindungen zwischen Peers
zu unterstützen. Bei der TLS-Initialisierung von Kubernetes werden dynamische Zertifikate für etcd-Mitglieder und andere Systemkomponenten erzeugt (z. B. API-Server, kubelet usw.). Separate CAs für jede Komponente ermöglichen eine strengere Zugriffskontrolle für den etcd-Cluster, sind aber häufig aufwendig zu pflegen. Mit –peer-cert-allowed-cn kann ein Knoten auch bei gemeinsam genutzten CAs nur mit passendem Common Name beitreten. Der Abgleich ist ein exakter Zeichenfolgenvergleich mit dem Feld Common Name (CN) des Zertifikats; Platzhalter und Präfixvergleiche werden nicht unterstützt. Für die Filterung anhand von Hostnamen mit –peer-cert-allowed-hostname oder –client-cert-allowed-hostname wird die Go-Funktion x509.Certificate.VerifyHostname() verwendet. Sie unterstützt sowohl exakte Hostnamen als auch Platzhaltereinträge (z. B. *.example.com). Beispielsweise wird jedes Mitglied eines Clusters mit 3 Knoten mit folgenden CSRs (mit cfssl) eingerichtet:
Wird --peer-cert-allowed-cn etcd.local angegeben, werden nur Peers mit passenden Common Names authentifiziert. Knoten mit anderen CNs in ihren CSRs oder einem anderen --peer-cert-allowed-cn werden abgelehnt:
Jeder Prozess sollte wie folgt gestartet werden:
v3.2.19
und v3.3.4
beheben das erneute Laden von TLS, wenn das SAN-Feld des Zertifikats nur IP-Adressen und keine Domänennamen enthält
. Ein Mitglied könnte beispielsweise mit folgenden CSRs (mit cfssl) eingerichtet sein:
In Go ruft der Server (*tls.Config).GetCertificate zum erneuten Laden von TLS genau dann auf, wenn sein Feld (*tls.Config).Certificates leer ist oder (*tls.ClientHelloInfo).ServerName nicht leer ist und eine gültige SNI vom Client enthält. Früher befüllte etcd (*tls.Config).Certificates beim ersten TLS-Handshake des Clients immer, sodass es nicht leer war. Daher musste der Client stets eine passende SNI liefern, um die TLS-Prüfung zu bestehen und (*tls.Config).GetCertificate zum erneuten Laden der TLS-Dateien auszulösen.
Bei einem Zertifikat, dessen SAN-Feld keine Domänennamen, sondern nur IP-Adressen enthält
, wird jedoch *tls.ClientHelloInfo mit leerem Feld ServerName angefordert. Dadurch wird beim ersten TLS-Handshake kein erneutes Laden ausgelöst. Das ist problematisch, wenn abgelaufene Zertifikate im laufenden Betrieb ersetzt werden müssen.
Nun wird (*tls.Config).Certificates beim ersten TLS-Handshake des Clients leer angelegt, um zunächst (*tls.Config).GetCertificate auszulösen und anschließend die übrigen Zertifikate bei jeder neuen TLS-Verbindung zu laden, selbst wenn die SNI des Clients leer ist, etwa bei Zertifikaten, die nur IP-Adressen enthalten.
Hinweise zur Host-Zulassungsliste
Die Option etcd --host-whitelist legt die zulässigen Hostnamen aus HTTP-Clientanfragen fest. Die Richtlinie für Clientursprünge schützt ungesicherte etcd-Server vor „DNS Rebinding“
. Dabei kann eine beliebige Website einfach einen autorisierten DNS-Namen erstellen und ihn auf "localhost" oder eine andere Adresse verweisen lassen. Dadurch werden alle HTTP-Endpunkte eines auf "localhost" lauschenden etcd-Servers zugänglich und somit für DNS-Rebinding-Angriffe anfällig. Weitere Einzelheiten stehen in CVE-2018-5702
.
Die Richtlinie für Clientursprünge funktioniert wie folgt:
- Ist die Clientverbindung über HTTPS abgesichert, alle Hostnamen zulassen.
- Ist die Clientverbindung nicht abgesichert und
"HostWhitelist"nicht leer, nur HTTP-Anfragen zulassen, deren Host-Feld in der Zulassungsliste steht.
Für strengere Kontrolle wird diese Richtlinie unabhängig davon durchgesetzt, ob die Authentifizierung aktiviert ist.
Standardmäßig verwenden etcd --host-whitelist und embed.Config.HostWhitelist den Wert *, sodass alle Hostnamen zugelassen sind. Eine leere Zulassungsliste erlaubt ebenfalls alle Hostnamen. Bei der Angabe von Hostnamen werden Loopback-Adressen nicht automatisch hinzugefügt. Um Loopback-Schnittstellen zuzulassen, sie manuell in die Zulassungsliste aufnehmen (z. B. "localhost", "127.0.0.1" usw.).
Häufig gestellte Fragen
Warum erscheint bei der TLS-Clientauthentifizierung ein SSLv3 alert handshake failure?
Das Paket crypto/tls von golang prüft vor der Verwendung des öffentlichen Zertifikatsschlüssels dessen Verwendungszweck.
Damit dieser Schlüssel zur Clientauthentifizierung verwendet werden kann, muss bei seiner Erstellung clientAuth zu Extended Key Usage hinzugefügt werden.
Dazu wie folgt vorgehen:
Den folgenden Abschnitt zu openssl.cnf hinzufügen:
Bei der Zertifikatserstellung unbedingt mit der Option -extensions darauf verweisen:
Bei der Peerauthentifizierung mit Zertifikaten erscheint “certificate is valid for 127.0.0.1, not $MY_IP”
Sicherstellen, dass die Zertifikate mit der öffentlichen IP-Adresse des Mitglieds als Subject Name signiert werden. Das Werkzeug etcd-ca bietet beispielsweise die Option --ip= für seinen Befehl new-cert.
Das Zertifikat muss für den FQDN des Mitglieds im Subject Name signiert werden; die IP-Adresse über Subject Alternative Names (kurz IP SANs) ergänzen. Das Werkzeug etcd-ca bietet die Option --domain= für seinen Befehl new-cert; auch openssl kann dies
.
Verschlüsselt etcd Daten auf Datenträgern?
Nein. etcd verschlüsselt keine auf Datenträgern gespeicherten Schlüssel-Wert-Daten. Für die Verschlüsselung von in etcd gespeicherten Daten gibt es unter anderem folgende Möglichkeiten:
- Clientanwendungen die Daten ver- und entschlüsseln lassen
- Eine Funktion des zugrunde liegenden Speichersystems zur Verschlüsselung gespeicherter Daten verwenden, etwa dm-crypt
Warum erscheint die Protokollwarnung “directory X exist without recommended permission -rwx——”?
Wenn etcd bestimmte neue Verzeichnisse erstellt, setzt es deren Dateiberechtigungen auf 700, um unberechtigten Zugriff möglichst zu verhindern. Hat der Benutzer ein Verzeichnis bereits mit eigenen Einstellungen angelegt, verwendet etcd dieses vorhandene Verzeichnis und protokolliert eine Warnung, falls die Berechtigungen von 700 abweichen.
14.4 - Anleitung zur Clusterbildung
Überblick
Der statische Start eines etcd-Clusters setzt voraus, dass jedes Mitglied ein anderes Mitglied des Clusters kennt. In manchen Fällen sind die IP-Adressen der Clustermitglieder im Voraus noch nicht bekannt. Dann lässt sich der etcd-Cluster mithilfe eines Erkennungsdiensts initialisieren.
Sobald ein etcd-Cluster läuft, werden Mitglieder über die Laufzeitrekonfiguration hinzugefügt oder entfernt. Für ein besseres Verständnis des zugrunde liegenden Entwurfs empfehlen wir das Entwurfsdokument zur Laufzeitkonfiguration .
Diese Anleitung behandelt folgende Verfahren zur Initialisierung eines etcd-Clusters:
Mit jedem Verfahren wird ein etcd-Cluster aus drei Rechnern mit folgenden Eigenschaften erstellt:
| Name | Adresse | Hostname |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Statisch
Da Mitglieder, Adressen und Größe des Clusters vor dem Start bekannt sind, lässt sich mit der Option initial-cluster eine Offline-Konfiguration zur Initialisierung verwenden. Auf jedem Rechner werden entweder die folgenden Umgebungsvariablen oder Befehlszeilenoptionen gesetzt:
Die in initial-cluster angegebenen URLs sind die bekannt gegebenen Peer-URLs. Sie sollten also dem Wert von initial-advertise-peer-urls auf den jeweiligen Knoten entsprechen.
Werden zu Testzwecken mehrere Cluster mit derselben Konfiguration gestartet oder ein einzelner Cluster wiederholt erstellt und gelöscht, wird dringend empfohlen, jedem Cluster einen eindeutigen initial-cluster-token zuzuweisen. Dadurch kann etcd eindeutige Cluster- und Mitglieds-IDs erzeugen, selbst wenn die Konfigurationen ansonsten exakt übereinstimmen. Dies kann etcd vor Wechselwirkungen zwischen Clustern schützen, die diese beschädigen könnten.
etcd lauscht auf listen-client-urls
, um Clientverkehr anzunehmen. Ein etcd-Mitglied gibt die unter advertise-client-urls
angegebenen URLs an andere Mitglieder, Proxys und Clients weiter. Sicherstellen, dass die vorgesehenen Clients die advertise-client-urls erreichen können. Ein häufiger Fehler ist, advertise-client-urls auf localhost zu setzen oder den Standardwert beizubehalten, obwohl entfernte Clients etcd erreichen sollen.
Auf jedem Rechner etcd mit diesen Optionen starten:
Die mit --initial-cluster beginnenden Befehlszeilenparameter werden bei späteren Starts von etcd ignoriert. Nach der Erstinitialisierung können die Umgebungsvariablen oder Befehlszeilenoptionen entfernt werden. Muss die Konfiguration später geändert werden, etwa um Mitglieder hinzuzufügen oder zu entfernen, hilft die Anleitung zur Laufzeitkonfiguration
.
TLS
etcd unterstützt verschlüsselte Kommunikation über das TLS-Protokoll. TLS-Kanäle können sowohl den internen Clusterverkehr zwischen Peers als auch den Clientverkehr verschlüsseln. Dieser Abschnitt zeigt Beispiele zur Einrichtung eines Clusters mit TLS für Peers und Clients. Weitere Einzelheiten zur TLS-Unterstützung von etcd enthält die Sicherheitsanleitung .
Selbstsignierte Zertifikate
Ein Cluster mit selbstsignierten Zertifikaten verschlüsselt den Verkehr und authentifiziert seine Verbindungen. Für den Start eines solchen Clusters sollte jedes Mitglied ein eigenes Schlüsselpaar (member.crt, member.key) besitzen, das von einem gemeinsamen CA-Zertifikat des Clusters (ca.crt) signiert wurde, sowohl für Peer- als auch für Clientverbindungen. Zertifikate können nach dem etcd-Beispiel zur TLS-Einrichtung
erzeugt werden.
Auf jedem Rechner würde etcd mit diesen Optionen gestartet:
Automatisch erzeugte Zertifikate
Benötigt der Cluster verschlüsselte Kommunikation, aber keine authentifizierten Verbindungen, kann etcd so konfiguriert werden, dass es seine Schlüssel automatisch erzeugt. Bei der Initialisierung erstellt jedes Mitglied eigene Schlüssel anhand seiner bekannt gegebenen IP-Adressen und Hosts.
Auf jedem Rechner würde etcd mit diesen Optionen gestartet:
Fehlerfälle
Im folgenden Beispiel fehlt der neue Host in der Liste der aufgeführten Knoten. Handelt es sich um einen neuen Cluster, muss der Knoten zur Liste der anfänglichen Clustermitglieder hinzugefügt werden.
In diesem Beispiel soll ein Knoten (infra0) einer anderen Adresse (127.0.0.1:2380) zugeordnet werden als der in der Clusterliste aufgeführten (10.0.1.10:2380). Soll dieser Knoten auf mehreren Adressen lauschen, müssen alle Adressen in der Konfigurationsanweisung “initial-cluster” enthalten sein.
Ist ein Peer mit anderen Konfigurationsargumenten eingerichtet und versucht, diesem Cluster beizutreten, meldet etcd eine abweichende Cluster-ID und beendet sich.
Erkennung
In manchen Fällen sind die IP-Adressen der Cluster-Peers im Voraus noch nicht bekannt. Dies ist bei Cloud-Anbietern oder Netzwerken mit DHCP üblich. Dann wird anstelle einer statischen Konfiguration ein bestehender etcd-Cluster verwendet, um einen neuen zu initialisieren. Dieser Vorgang heißt „Erkennung“ (Discovery).
Für die Erkennung stehen zwei Verfahren zur Verfügung:
- etcd-Erkennungsdienst
- DNS-SRV-Einträge
etcd-Erkennung
Die Beispiele für den Erkennungsdienst in diesem Abschnitt beschreiben das ältere v2-Protokoll, das in etcd 3.7 entfernt wurde. Für einen neuen v3.7-Cluster v3-Discovery oder die statische Initialisierung bzw. DNS-SRV-Verfahren in dieser Anleitung verwenden.
Für ein besseres Verständnis des Protokollentwurfs empfehlen wir die Dokumentation zum Protokoll des Erkennungsdiensts.
Lebensdauer einer Erkennungs-URL
Eine Erkennungs-URL identifiziert einen eindeutigen etcd-Cluster. Für die Initialisierung eines neuen Clusters verwenden alle etcd-Instanzen gemeinsam eine neue Erkennungs-URL, statt eine vorhandene wiederzuverwenden.
Erkennungs-URLs sollten außerdem NUR für die Erstinitialisierung eines Clusters verwendet werden. Wie die Mitgliedschaft eines bereits laufenden Clusters geändert wird, beschreibt die Anleitung zur Laufzeitrekonfiguration .
Eigener etcd-Erkennungsdienst
Die Erkennung verwendet einen vorhandenen Cluster zur Initialisierung. Bei Verwendung eines privaten etcd-Clusters eine URL wie folgt erstellen:
Durch Setzen des Schlüssels size unter der URL wird eine Erkennungs-URL mit der erwarteten Clustergröße 3 erstellt.
In diesem Fall lautet die zu verwendende URL https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83. Die etcd-Mitglieder verwenden beim Start das Verzeichnis https://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83 zur Registrierung.
Für jedes Mitglied muss die Namensoption einen anderen Wert angeben. Hostname oder machine-id können eine gute Wahl sein. Andernfalls scheitert die Erkennung an doppelten Namen.
Nun etcd für jedes Mitglied mit den entsprechenden Optionen starten:
Dadurch registriert sich jedes Mitglied beim eigenen etcd-Erkennungsdienst. Sobald alle Rechner registriert sind, startet der Cluster.
Öffentlicher etcd-Erkennungsdienst
Ist kein bestehender Cluster verfügbar, den öffentlichen Erkennungsdienst unter discovery.etcd.io verwenden. Mit folgendem Befehl über den Endpunkt “new” eine private Erkennungs-URL erstellen:
Dies erstellt den Cluster mit einer anfänglichen Größe von 3 Mitgliedern. Wird keine Größe angegeben, gilt der Standardwert 3.
Für jedes Mitglied muss die Namensoption einen anderen Wert angeben, andernfalls scheitert die Erkennung an doppelten Namen. Hostname oder machine-id können eine gute Wahl sein.
Nun etcd für jedes Mitglied mit den entsprechenden Optionen starten:
Dadurch registriert sich jedes Mitglied beim Erkennungsdienst. Sobald alle Mitglieder registriert sind, startet der Cluster.
Mit der Umgebungsvariablen ETCD_DISCOVERY_PROXY lässt sich etcd anweisen, einen HTTP-Proxy für die Verbindung zum Erkennungsdienst zu verwenden.
Fehler- und Warnfälle
Fehler des Erkennungsservers
Warnungen
Diese harmlose Warnung zeigt an, dass die Erkennungs-URL auf diesem Rechner ignoriert wird.
DNS-Erkennung
DNS-SRV-Einträge
können als Erkennungsverfahren verwendet werden.
Mit der Option --discovery-srv lässt sich die DNS-Domäne festlegen, unter der die SRV-Einträge für die Erkennung liegen.
Mit --discovery-srv example.com werden DNS-SRV-Einträge in der angegebenen Reihenfolge gesucht:
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
Wird _etcd-server-ssl._tcp.example.com gefunden, versucht etcd die Initialisierung über TLS.
Damit Clients den etcd-Cluster finden, werden folgende DNS-SRV-Einträge in der angegebenen Reihenfolge gesucht:
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
Wird _etcd-client-ssl._tcp.example.com gefunden, versuchen Clients, über SSL/TLS mit dem etcd-Cluster zu kommunizieren.
Verwendet etcd TLS, muss der SRV-Eintrag für die Erkennung (z. B. example.com) zusammen mit dem Hostnamen im DNS-SAN des SSL-Zertifikats enthalten sein. Andernfalls scheitert die Clusterbildung mit Protokollmeldungen wie dieser:
Verwendet etcd TLS ohne eine eigene Zertifizierungsstelle, muss die Erkennungsdomäne (z. B. example.com) zur Domäne des SRV-Eintrags (z. B. infra1.example.com) passen. Dies erschwert Angriffe mit gefälschten SRV-Einträgen, die auf eine andere Domäne verweisen. Diese Domäne könnte zwar ein gültiges PKI-Zertifikat besitzen, aber von einem unbekannten Dritten kontrolliert werden.
Die Option -discovery-srv-name legt zusätzlich ein Suffix für den während der Erkennung abgefragten SRV-Namen fest.
Mit ihr lassen sich mehrere etcd-Cluster unter derselben Domäne unterscheiden.
Sind beispielsweise discovery-srv=example.com und -discovery-srv-name=foo gesetzt, werden folgende DNS-SRV-Abfragen gestellt:
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
DNS-SRV-Einträge erstellen
Den etcd-Cluster über DNS initialisieren
etcd-Clustermitglieder können Domänennamen oder IP-Adressen bekannt geben; die Initialisierung löst DNS-A-Einträge auf.
Seit 3.2 lehnen --listen-peer-urls und --listen-client-urls Domänennamen für die Bindung an Netzwerkschnittstellen ab (3.1 gibt Warnungen aus).
Die aufgelöste Adresse in --initial-advertise-peer-urls muss mit einer der aufgelösten Adressen der SRV-Ziele übereinstimmen. Das etcd-Mitglied liest die aufgelöste Adresse, um festzustellen, ob es zu dem in den SRV-Einträgen definierten Cluster gehört.
Der Cluster kann auch mit IP-Adressen anstelle von Domänennamen initialisiert werden:
Seit v3.1.0 (außer v3.2.9) authentifiziert der Server bei TLS-Konfiguration von etcd --discovery-srv=example.com Peers und Clients nur dann, wenn die angegebenen Zertifikate die Stammdomäne example.com als Eintrag im Feld Subject Alternative Name (SAN) enthalten. Siehe Hinweise zu DNS SRV
.
Gateway
Das etcd-Gateway ist ein einfacher TCP-Proxy, der Netzwerkdaten an den etcd-Cluster weiterleitet. Weitere Informationen bietet die Gateway-Anleitung .
Proxy
Frühere etcd-Versionen unterstützten über --proxy einen Proxymodus
nur für v2. Dieser Modus wurde entfernt und kann mit etcd 3.7 nicht verwendet werden. Für die v3-API den gRPC-Proxy
verwenden.
Historische v2-Proxy-Installationen beschreibt die Clusterdokumentation der etcd-Version 2.3 .
14.5 - etcd-Cluster als Kubernetes-StatefulSet ausführen
Im Folgenden wird gezeigt, wie die statische Initialisierung als Kubernetes-StatefulSet erfolgt.
Beispielmanifest
Dieses Manifest enthält einen Service und ein StatefulSet zur Bereitstellung eines statischen etcd-Clusters in Kubernetes.
Wird der Inhalt des Manifests in eine Datei namens etcd.yaml kopiert, lässt es sich mit diesem Befehl auf einen Cluster anwenden.
Nach dem Anwenden warten, bis die Pods bereit sind.
Der im Beispiel verwendete Container enthält etcdctl, das direkt innerhalb der Pods aufgerufen werden kann.
Für eine Bereitstellung mit einem selbstsignierten Zertifikat die auskommentierten Konfigurationsüberschriften beginnend mit ## TLS beachten; dort stehen Werte, deren Kommentierung aufgehoben werden kann. Ein Abschnitt weiter unten enthält zusätzliche Anweisungen zum Erzeugen eines Zertifikats mit cert-manager.
Zertifikate erzeugen
In diesem Abschnitt wird Helm verwendet, um einen Operator namens cert-manager zu installieren.
Ist cert-manager im Cluster installiert, lassen sich dort selbstsignierte Zertifikate erzeugen. Die erzeugten Zertifikate werden in einem Secret-Objekt abgelegt, das als Dateien in Container eingebunden werden kann.
Dies ist der Helm-Befehl zur Installation von cert-manager.
Dies ist eine beispielhafte ClusterIssuer-Konfiguration zum Erzeugen selbstsignierter Zertifikate.
Dieses Manifest erzeugt Certificate-Objekte für die Client- und Serverzertifikate und verweist dabei auf den ClusterIssuer “selfsigned”. Die dnsNames sollten eine vollständige Liste gültiger Hostnamen für die von cert-manager erzeugten Zertifikate enthalten.
14.6 - etcd-Cluster in Containern ausführen
Die folgende Anleitung zeigt, wie etcd mit Docker über die statische Initialisierung ausgeführt wird.
Docker
Um die etcd-API für Clients außerhalb des Docker-Hosts bereitzustellen, die IP-Adresse des Container-Hosts verwenden. Weitere Informationen zum Ermitteln der IP-Adresse bietet docker inspect
. Alternativ dem Befehl docker run die Option --net=host übergeben, damit der Container keinen separaten Netzwerkstack erhält.
etcd mit einem einzelnen Knoten ausführen
Bei der Konfiguration von etcd die IP-Adresse des Hosts verwenden:
Ein Docker-Volume zur Speicherung der etcd-Daten konfigurieren:
Die neueste Version von etcd ausführen (zum Zeitpunkt der Erstellung dieses Dokuments v3.7.2):
Das Clustermitglied auflisten:
Einen etcd-Cluster mit 3 Knoten ausführen
etcdctl mit API-Version 3 ausführen:
Physische Hardware
Für die Bereitstellung eines etcd-Clusters mit 3 Knoten auf physischer Hardware können die Beispiele im baremetal-Repository hilfreich sein.
Ein Zertifikatsvolume einhängen
Der veröffentlichte etcd-Container enthält keine standardmäßigen Stammzertifikate. Um HTTPS mit Zertifikaten zu verwenden, denen eine Stammzertifizierungsstelle vertraut (z. B. für die Diensterkennung), ein Zertifikatsverzeichnis in den etcd-Container einhängen:
Der folgende rkt-Befehl ist ein historisches Beispiel. Seine v2-Discovery-Konfiguration ist mit etcd 3.7 nicht kompatibel; für aktuelle Bereitstellungen die Beispiele zur statischen Initialisierung oben verwenden.
Das folgende Docker-Beispiel verwendet das oben gesetzte NODE1 und zeigt das Einhängen eines Zertifikatsvolumes mit statischer Initialisierung.
14.7 - Ausfallarten
In großen Rechnerinstallationen treten häufig Ausfälle auf. Ein Rechner fällt aus, wenn seine Hardware oder Software nicht ordnungsgemäß funktioniert. Bei Stromausfällen oder Netzwerkproblemen können mehrere Rechner gleichzeitig ausfallen. Auch mehrere Ausfallarten können zugleich auftreten; es ist nahezu unmöglich, alle denkbaren Ausfallszenarien aufzuzählen.
Dieser Abschnitt ordnet Ausfälle nach Arten ein und erläutert, wie etcd sie toleriert. Die meisten, wenn nicht alle Benutzer können einen konkreten Ausfall einer dieser Arten zuordnen. Um auf seltene oder nicht behebbare Ausfälle vorbereitet zu sein, stets Backups des etcd-Clusters erstellen.
Ausfall einer Minderheit der Follower
Wenn Follower ausfallen, aber weniger als die Hälfte aller Clustermitglieder ausgefallen ist und der Leader weiterhin verfügbar bleibt, kann der etcd-Cluster weiterhin Anfragen annehmen und ohne größere Beeinträchtigung weiterarbeiten. Beispielsweise beeinträchtigt der Ausfall von zwei Followern den Betrieb eines etcd-Clusters mit fünf Mitgliedern nicht. Clients verlieren jedoch die Verbindung zu den ausgefallenen Mitgliedern. Clientbibliotheken sollten solche Unterbrechungen bei Leseanfragen vor Benutzern verbergen, indem sie automatisch Verbindungen zu anderen Mitgliedern herstellen. Betreiber sollten damit rechnen, dass diese neuen Verbindungen die Systemlast auf den anderen Mitgliedern erhöhen.
Ausfall des Leaders
Wenn ein Leader ausfällt, wählt der etcd-Cluster automatisch einen neuen Leader. Diese Wahl erfolgt nicht unmittelbar nach dem Ausfall. Sie dauert ungefähr so lange wie das Wahlzeitlimit, da die Ausfallerkennung auf Zeitüberschreitungen beruht.
Während der Leaderwahl kann der Cluster keine Schreiboperationen verarbeiten. Schreibanfragen, die während der Wahl eingehen, werden zur Verarbeitung in eine Warteschlange gestellt, bis ein neuer Leader gewählt ist.
Schreiboperationen, die bereits an den alten Leader gesendet, aber noch nicht festgeschrieben wurden, können verloren gehen. Der neue Leader kann alle nicht festgeschriebenen Einträge des vorherigen Leaders überschreiben. Aus Benutzersicht können einige Schreibanfragen nach der Wahl eines neuen Leaders mit einer Zeitüberschreitung enden. Bereits festgeschriebene Schreiboperationen gehen jedoch niemals verloren.
Der neue Leader verlängert automatisch die Zeitlimits aller Leases. Dieser Mechanismus stellt sicher, dass eine Lease nicht vor Ablauf ihrer gewährten TTL verfällt, selbst wenn sie vom alten Leader gewährt wurde.
Ausfall einer Mehrheit
Wenn die Mehrheit der Clustermitglieder ausfällt, fällt der etcd-Cluster aus und kann keine weiteren Schreiboperationen annehmen.
Der etcd-Cluster kann sich erst von einem Mehrheitsausfall erholen, wenn die Mehrheit der Mitglieder wieder verfügbar ist. Kann eine Mehrheit der Mitglieder nicht wieder online gehen, muss der Betreiber eine Disaster Recovery einleiten, um den Cluster wiederherzustellen.
Sobald eine Mehrheit der Mitglieder wieder funktioniert, wählt der etcd-Cluster automatisch einen neuen Leader und kehrt in einen intakten Zustand zurück. Der neue Leader verlängert automatisch die Zeitlimits aller Leases. Dieser Mechanismus stellt sicher, dass keine Lease wegen serverseitiger Nichtverfügbarkeit abläuft.
Netzwerkpartition
Eine Netzwerkpartition ähnelt dem Ausfall einer Minderheit der Follower oder dem Ausfall des Leaders. Sie teilt den etcd-Cluster in zwei Teile: einen mit einer Mehrheit und einen mit einer Minderheit der Mitglieder. Die Mehrheitsseite bildet den verfügbaren Cluster; die Minderheitsseite ist nicht verfügbar. In etcd gibt es kein „Split Brain“, da Clustermitglieder ausdrücklich hinzugefügt oder entfernt werden und jede solche Änderung von der aktuellen Mehrheit der Mitglieder genehmigt wird.
Befindet sich der Leader auf der Mehrheitsseite, entspricht der Ausfall aus Sicht der Mehrheit dem Ausfall einer Minderheit der Follower. Befindet er sich auf der Minderheitsseite, entspricht dies einem Leaderausfall. Der Leader auf der Minderheitsseite tritt zurück, und die Mehrheitsseite wählt einen neuen Leader.
Sobald die Netzwerkpartition aufgehoben ist, erkennt die Minderheitsseite automatisch den Leader der Mehrheitsseite an und stellt ihren Zustand wieder her.
Ausfall während der Initialisierung
Die Initialisierung eines Clusters ist nur erfolgreich, wenn alle erforderlichen Mitglieder erfolgreich starten. Tritt während der Initialisierung ein Fehler auf, die Datenverzeichnisse aller Mitglieder entfernen und den Cluster mit einem neuen cluster-token oder einem neuen Discovery-Token erneut initialisieren.
Natürlich lässt sich ein während der Initialisierung ausgefallener Cluster ebenso wie ein laufender Cluster wiederherstellen. Da aber keine Daten wiederherzustellen sind, kostet seine Wiederherstellung fast immer mehr Zeit und Ressourcen als die Initialisierung eines neuen Clusters.
14.8 - Recovery nach einem Totalausfall
etcd ist dafür ausgelegt, Rechnerausfälle zu verkraften. Ein etcd-Cluster erholt sich automatisch von vorübergehenden Ausfällen (z. B. Neustarts von Rechnern) und toleriert bei N Mitgliedern bis zu (N-1)/2 dauerhafte Ausfälle. Fällt ein Mitglied dauerhaft aus, etwa durch einen Hardwaredefekt oder eine Datenbeschädigung auf dem Datenträger, verliert es den Zugriff auf den Cluster. Verliert der Cluster dauerhaft mehr als (N-1)/2 Mitglieder, kommt es zum Totalausfall: Das Quorum geht unwiederbringlich verloren. Ohne Quorum kann der Cluster keinen Konsens mehr erreichen und daher keine weiteren Aktualisierungen annehmen.
Für die Recovery nach einem Totalausfall bietet etcd v3 Snapshot- und Wiederherstellungsfunktionen, mit denen sich der Cluster ohne Verlust von v3-Schlüsseldaten neu erstellen lässt. Zur Wiederherstellung von v2-Schlüsseln siehe das v2-Administrationshandbuch .
Einen Snapshot des Schlüsselraums erstellen
Für die Wiederherstellung eines Clusters wird zunächst ein Snapshot des Schlüsselraums eines etcd-Mitglieds benötigt. Ein Snapshot kann entweder mit etcdctl snapshot save von einem laufenden Mitglied erstellt oder durch Kopieren der Datei member/snap/db aus einem etcd-Datenverzeichnis gewonnen werden. Der folgende Befehl speichert beispielsweise einen Snapshot des von $ENDPOINT bereitgestellten Schlüsselraums in der Datei snapshot.db:
Bei einem Snapshot aus der Datei member/snap/db können Daten verloren gehen, die noch nicht in diese Datei geschrieben wurden, sich aber bereits im Ordner wal (Write-Ahead-Log) befinden.
Status eines Snapshots
Mit dem Befehl etcdutl snapshot status lässt sich ermitteln, welche Revision und welchen Hashwert ein Snapshot enthält:
Einen Cluster wiederherstellen
Revisionsunterschied
Bei der Wiederherstellung eines Clusters können bestehende Clients feststellen, dass die Revision um viele Hundert oder Tausend zurückspringt. Ein Snapshot enthält nämlich nur die Datenhistorie bis zum Zeitpunkt seiner Erstellung, während der aktuelle Zustand bereits weiter fortgeschritten sein kann.
Dies ist besonders beim Betrieb von Kubernetes mit etcd problematisch. Dort können Controller und Operatoren sogenannte informers verwenden, die als lokale Caches dienen und über Watches über Aktualisierungen benachrichtigt werden. Die Wiederherstellung auf eine ältere Revision aktualisiert diese Caches möglicherweise nicht korrekt und kann dadurch unvorhersehbares und inkonsistentes Verhalten der Controller verursachen.
Bei der Wiederherstellung aus einem Snapshot wird dringend empfohlen, die nachfolgend beschriebene „Revisionserhöhung“ zu verwenden, wenn bekannte Nutzer der Watch-API vorhanden sind, lokale Kopien von etcd-Daten zwischengespeichert werden oder generell Kubernetes eingesetzt wird.
Aus einem Snapshot wiederherstellen
Zur Wiederherstellung eines Clusters genügt eine einzelne Snapshot-Datei “db”. Eine Clusterwiederherstellung mit etcdutl snapshot restore erstellt neue etcd-Datenverzeichnisse; alle Mitglieder sollten denselben Snapshot verwenden. Bei der Wiederherstellung werden einige Snapshot-Metadaten überschrieben, insbesondere die Mitglieds-ID und die Cluster-ID. Das Mitglied verliert damit seine bisherige Identität. Dieses Überschreiben verhindert, dass das neue Mitglied versehentlich einem bestehenden Cluster beitritt. Um einen Cluster aus einem Snapshot zu starten, muss die Wiederherstellung daher einen neuen logischen Cluster erstellen.
Eine einfache Wiederherstellung lässt sich wie folgt ausführen:
Integritätsprüfungen
Die Integrität eines Snapshots kann bei der Wiederherstellung optional geprüft werden. Ein mit etcdctl snapshot save erstellter Snapshot enthält einen Integritätshash, den etcdutl snapshot restore prüft. Wird der Snapshot aus dem Datenverzeichnis kopiert, fehlt dieser Hash; die Wiederherstellung ist dann nur mit --skip-hash-check möglich.
Mit Revisionserhöhung wiederherstellen
Damit die Revisionen nach einer Wiederherstellung niemals zurückgehen, kann die Option --bump-revision angegeben werden. Sie nimmt eine 64-Bit-Ganzzahl entgegen, die angibt, wie viele Revisionen zur aktuellen Revision des Snapshots addiert werden sollen. Da jeder Schreibzugriff auf etcd die Revision um eins erhöht, kann eine Erhöhung um 1'000'000'000 einen eine Woche alten Snapshot abdecken, sofern etcd weniger als 1500 Schreibzugriffe pro Sekunde verarbeitet.
Im Zusammenhang mit Kubernetes-Controllern ist es wichtig, mit --mark-compacted auch alle Revisionen einschließlich der Erhöhung als kompaktiert zu markieren. Dies stellt sicher, dass alle Watches beendet werden und etcd keine Anfragen zu Revisionen beantwortet, die nach der Snapshot-Erstellung entstanden sind. Dadurch werden die Informer-Caches effektiv ungültig.
Ein vollständiger Aufruf kann so aussehen:
Mit aktualisierter Mitgliedschaft wiederherstellen
Die Mitglieder eines etcd-Clusters werden in etcd selbst gespeichert und über den Raft-Konsensalgorithmus verwaltet. Ist das Quorum vollständig verloren, kann neu entschieden werden, wo und wie der neue Cluster gebildet wird, beispielsweise mit vollständig neuen Mitgliedern.
Bei der Wiederherstellung aus einem Snapshot kann die neue Mitgliedschaft wie folgt direkt in den Datenspeicher übernommen werden:
Dies stellt sicher, dass sich der neu aufgebaute Cluster ausschließlich mit den anderen wiederhergestellten Mitgliedern mit dem angegebenen Token verbindet und nicht mit älteren Mitgliedern, die möglicherweise noch laufen und Verbindungen aufzubauen versuchen.
Alternativ kann beim Start von etcd --force-new-cluster angegeben werden, um die Clustermitgliedschaft zu überschreiben und vorhandene Anwendungsdaten beizubehalten. Davon wird jedoch dringend abgeraten, da dies eine Panic auslöst, wenn andere Mitglieder des vorherigen Clusters noch laufen. Unbedingt regelmäßig Snapshots speichern.
End-2-End-Beispiel
Einen Snapshot von einem laufenden Cluster erstellen:
Aufbauend auf dem vorherigen Beispiel werden im Folgenden neue etcd-Datenverzeichnisse (m1.etcd, m2.etcd, m3.etcd) für einen Cluster mit drei Mitgliedern erstellt:
Anschließend etcd mit den neuen Datenverzeichnissen starten:
Der wiederhergestellte etcd-Cluster sollte nun verfügbar sein und den Schlüsselraum aus dem Snapshot bereitstellen.
Ab etcd v3.6 kann etcdctl nur zum Erstellen eines Snapshots der Daten verwendet werden; zur Wiederherstellung aus einem Snapshot dient etcdutl. Wird --data-dir nicht angegeben, ist der Standardwert von --data-dir gleich <name>.etcd, wobei <name> dem Wert von --name entspricht. Wurde beispielsweise --data-dir nicht angegeben und heißen die Mitglieder m1, m2 und m3, lauten die --data-dir-Verzeichnisse m1.etcd, m2.etcd und m3.etcd.
14.9 - etcd-Gateway
Was ist das etcd-Gateway?
Das etcd-Gateway ist ein einfacher TCP-Proxy, der Netzwerkdaten an den etcd-Cluster weiterleitet. Es ist zustandslos und transparent: Es untersucht weder Clientanfragen noch greift es in Clusterantworten ein. Es terminiert keine TLS-Verbindungen, führt keine TLS-Handshakes im Namen seiner Clients durch und prüft nicht, ob eine Verbindung abgesichert ist.
Das Gateway unterstützt mehrere etcd-Serverendpunkte und verwendet ein einfaches Round-Robin-Verfahren. Es leitet nur an verfügbare Endpunkte weiter und verbirgt Ausfälle vor seinen Clients. Weitere Wiederholungsstrategien, etwa gewichtetes Round-Robin, können künftig unterstützt werden.
Wann das etcd-Gateway sinnvoll ist
Jede Anwendung, die auf etcd zugreift, muss zunächst die Adresse eines Clientendpunkts des etcd-Clusters kennen. Greifen mehrere Anwendungen auf demselben Server auf denselben etcd-Cluster zu, muss trotzdem jede Anwendung dessen bekannt gegebene Clientendpunkte kennen. Wird der etcd-Cluster so umkonfiguriert, dass er andere Endpunkte hat, muss möglicherweise auch jede Anwendung ihre Endpunktliste aktualisieren. Diese umfassende Umkonfiguration ist aufwendig und fehleranfällig.
Das etcd-Gateway löst dieses Problem, indem es einen stabilen lokalen Endpunkt bereitstellt. In einer typischen Konfiguration läuft auf jedem Rechner ein Gateway, das auf einer lokalen Adresse lauscht; jede etcd-Anwendung verbindet sich mit ihrem lokalen Gateway. Dadurch muss nur das Gateway seine Endpunkte aktualisieren, statt jede einzelne Anwendung anzupassen.
Um Änderungen der Clusterendpunkte automatisch weiterzugeben, läuft das etcd-Gateway also auf jedem Rechner, auf dem mehrere Anwendungen auf denselben etcd-Cluster zugreifen.
Wann das etcd-Gateway nicht sinnvoll ist
- Leistungssteigerung
Das Gateway ist nicht dafür ausgelegt, die Leistung eines etcd-Clusters zu verbessern. Es bietet weder Caching noch die Zusammenführung von Watches oder die Bündelung von Anfragen. Das etcd-Team entwickelt einen Caching-Proxy, der die Skalierbarkeit von Clustern verbessern soll.
- Betrieb auf einem Clusterverwaltungssystem
Fortgeschrittene Clusterverwaltungssysteme wie Kubernetes unterstützen Diensterkennung von Haus aus. Anwendungen können über einen DNS-Namen oder eine vom System verwaltete virtuelle IP-Adresse auf einen etcd-Cluster zugreifen. Beispielsweise entspricht kube-proxy dem etcd-Gateway.
Das etcd-Gateway starten
Als Beispiel dient ein etcd-Cluster mit folgenden statischen Endpunkten:
| Name | Adresse | Hostname | Port |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
Das etcd-Gateway mit folgendem Befehl für diese statischen Endpunkte starten:
Alternativ bei einer Diensterkennung über DNS die folgenden DNS-SRV-Einträge betrachten:
Das etcd-Gateway mit folgendem Befehl starten, damit es die Endpunkte aus den DNS-SRV-Einträgen abruft:
Konfigurationsoptionen
etcd-Cluster
–endpoints
- Kommagetrennte Liste von etcd-Serverzielen, an die Clientverbindungen weitergeleitet werden.
- Standard:
127.0.0.1:2379 - Der Port muss enthalten sein.
- Ungültiges Beispiel:
https://127.0.0.1:2379(das Gateway terminiert TLS nicht). Das Gateway prüft weder das HTTP-Schema noch die Anfragen; es leitet Anfragen lediglich an die angegebenen Endpunkte weiter.
–discovery-srv
- DNS-Domäne, über die Clusterendpunkte mithilfe von SRV-Einträgen initialisiert werden.
- Standard: (nicht gesetzt)
Netzwerk
–listen-addr
- Schnittstelle und Port, an die gebunden wird, um Clientanfragen anzunehmen.
- Standard:
127.0.0.1:23790
–retry-delay
- Wartezeit vor einem erneuten Verbindungsversuch zu ausgefallenen Endpunkten.
- Standard: 1m0s
- Ungültiges Beispiel: “123” (das Format erwartet eine Zeiteinheit)
Sicherheit
–insecure-discovery
- SRV-Einträge akzeptieren, die unsicher oder für Man-in-the-Middle-Angriffe anfällig sind.
- Standard:
false
–trusted-ca-file
- Pfad zur TLS-CA-Datei des Clients für den etcd-Cluster, um die bei der SRV-Erkennung zurückgegebenen Endpunkte zu überprüfen. Sie wird NUR zur Authentifizierung der gefundenen Endpunkte verwendet, nicht zum Aufbau von Verbindungen für die Datenübertragung. Das Gateway terminiert niemals TLS-Verbindungen und erstellt keine TLS-Verbindungen im Namen seiner Clients.
- Standard: (nicht gesetzt)
14.10 - gRPC-Proxy
Der gRPC-Proxy ist ein zustandsloser etcd-Reverse-Proxy auf der gRPC-Schicht (L7). Er soll die gesamte Verarbeitungslast auf dem zentralen etcd-Cluster verringern. Für horizontale Skalierbarkeit führt er Watch- und Lease-API-Anfragen zusammen. Um den Cluster vor missbräuchlich arbeitenden Clients zu schützen, speichert er Anfragen für Schlüsselbereiche zwischen.
Der gRPC-Proxy unterstützt mehrere etcd-Serverendpunkte. Beim Start wählt er zufällig einen davon aus. Dieser Endpunkt bedient alle Anfragen, bis der Proxy einen Endpunktausfall erkennt. Dann wechselt der gRPC-Proxy zu einem anderen Endpunkt, sofern verfügbar, um Ausfälle vor seinen Clients zu verbergen. Weitere Wiederholungsstrategien, etwa gewichtetes Round-Robin, können künftig unterstützt werden.
Skalierbare Watch-API
Der gRPC-Proxy führt mehrere Client-Watcher (c-watchers) für denselben Schlüssel oder Bereich zu einem einzelnen Watcher (s-watcher) zusammen, der mit einem etcd-Server verbunden ist. Der Proxy verteilt alle Ereignisse des s-watcher an seine c-watchers.
Wenn N Clients denselben Schlüssel beobachten, kann ein gRPC-Proxy die Watch-Last auf dem etcd-Server von N auf 1 reduzieren. Durch den Einsatz mehrerer gRPC-Proxys lässt sich die Serverlast weiter verteilen.
Im folgenden Beispiel beobachten drei Clients den Schlüssel A. Der gRPC-Proxy führt die drei Watcher zusammen und erstellt einen einzelnen Watcher am etcd-Server.
Einschränkungen
Um mehrere Client-Watcher effizient zu einem einzelnen Watcher zusammenzuführen, ordnet der gRPC-Proxy neue c-watchers nach Möglichkeit einem vorhandenen s-watcher zu. Dieser gemeinsame s-watcher kann wegen Netzwerkverzögerungen oder gepufferter, noch nicht zugestellter Ereignisse hinter dem etcd-Server zurückliegen. Ist keine Watch-Revision angegeben, garantiert der gRPC-Proxy nicht, dass der c-watcher bei der neuesten Revision des Speichers zu beobachten beginnt. Beobachtet ein Client beispielsweise direkt über einen etcd-Server mit Revision 1000, beginnt dieser Watcher bei Revision 1000. Bei einem Watch über den gRPC-Proxy kann der Client hingegen bereits bei Revision 990 beginnen.
Ähnliche Einschränkungen gelten für den Abbruch. Beim Abbrechen eines Watchers kann die Revision des etcd-Servers höher sein als die Revision in der Abbruchantwort.
Diese beiden Einschränkungen sollten in den meisten Anwendungsfällen keine Probleme verursachen. Künftig kann es zusätzliche Optionen geben, die den Watcher zwingen, den gRPC-Proxy zu umgehen, um genauere Revisionen in Antworten zu erhalten.
Skalierbare Lease-API
Um seine Leases aufrechtzuerhalten, muss ein Client mindestens einen gRPC-Stream zu einem etcd-Server aufbauen und darüber regelmäßig Heartbeats senden. Bei einer etcd-Arbeitslast mit umfangreicher Lease-Aktivität über viele Clients hinweg können diese Streams zu einer übermäßigen CPU-Auslastung beitragen. Um die Gesamtzahl der Streams auf dem zentralen Cluster zu verringern, unterstützt der Proxy die Zusammenführung von Lease-Streams.
Wenn N Clients Leases aktualisieren, reduziert ein einzelner gRPC-Proxy die Stream-Last auf dem etcd-Server von N auf 1. Zusätzliche gRPC-Proxys können die Streams weiter auf mehrere Proxys verteilen.
Im folgenden Beispiel aktualisieren drei Clients drei unabhängige Leases (L1, L2 und L3). Der gRPC-Proxy führt die drei Lease-Streams der Clients (c-streams) zu einem einzelnen Stream zur Aufrechterhaltung von Leases (s-stream) zusammen, der mit einem etcd-Server verbunden ist. Der Proxy leitet die clientseitigen Lease-Heartbeats von den c-streams an den s-stream weiter und sendet die Antworten anschließend an die jeweiligen c-streams zurück.
Schutz vor missbräuchlich arbeitenden Clients
Der gRPC-Proxy speichert Antworten auf Anfragen zwischen, sofern dies keine Konsistenzanforderungen verletzt. Dadurch kann er den etcd-Server vor missbräuchlich arbeitenden Clients schützen, die Anfragen in engen for-Schleifen senden.
Den etcd-gRPC-Proxy starten
Als Beispiel dient ein etcd-Cluster mit folgenden statischen Endpunkten:
| Name | Adresse | Hostname |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
Den etcd-gRPC-Proxy mit folgendem Befehl für diese statischen Endpunkte starten:
Der etcd-gRPC-Proxy startet und lauscht auf Port 2379. Er leitet Clientanfragen an einen der drei oben angegebenen Endpunkte weiter.
Anfragen über den Proxy senden:
Synchronisierung der Clientendpunkte und Namensauflösung
Der Proxy kann seine Endpunkte zur Diensterkennung registrieren, indem er an einen benutzerdefinierten Endpunkt schreibt. Dies dient zwei Zwecken. Erstens können Clients ihre Endpunkte mit einer Menge von Proxyendpunkten synchronisieren, um Hochverfügbarkeit zu erreichen. Zweitens stellt dies Endpunkte für die gRPC-Namensauflösung von etcd bereit.
Proxys durch Angabe eines benutzerdefinierten Präfixes registrieren:
Der Proxy führt bei der Abfrage der Mitgliederliste alle seine Mitglieder auf:
Dadurch können Clients Proxyendpunkte automatisch über Sync erkennen:
Wird ein Proxy ohne Resolver-Präfix konfiguriert,
gibt die Mitgliederlisten-API des grpc-proxy dessen eigene advertise-client-url zurück:
Namensräume
Angenommen, eine Anwendung erwartet die volle Kontrolle über den gesamten Schlüsselraum, der etcd-Cluster wird aber mit anderen Anwendungen geteilt. Damit alle Anwendungen ohne gegenseitige Beeinträchtigung laufen können, kann der Proxy den etcd-Schlüsselraum so aufteilen, dass Clients scheinbar auf den vollständigen Schlüsselraum zugreifen. Wird dem Proxy die Option --namespace übergeben, werden alle eingehenden Clientanfragen so umgeschrieben, dass die Schlüssel ein benutzerdefiniertes Präfix erhalten. Zugriffe auf den etcd-Cluster erfolgen unter diesem Präfix; der Proxy entfernt es aus den Antworten. Für den Client wirkt es, als gäbe es überhaupt kein Präfix.
Um einen Namensraum für einen Proxy festzulegen, ihn mit --namespace starten:
Bei Zugriffen auf den Proxy wird nun im etcd-Cluster transparent das Präfix vorangestellt:
TLS-Terminierung
Der gRPC-Proxy kann TLS zu einem abgesicherten etcd-Cluster terminieren und dafür einen unverschlüsselten lokalen Endpunkt bereitstellen.
Zum Ausprobieren einen Ein-Mitglied-Cluster von etcd mit HTTPS für Clients starten:
Prüfen, ob der Clientport HTTPS bereitstellt:
Anschließend einen gRPC-Proxy auf localhost:12379 starten, der sich mithilfe der Clientzertifikate mit dem etcd-Endpunkt https://localhost:2379 verbindet:
Abschließend die TLS-Terminierung testen, indem über HTTP ein Schlüssel in den Proxy geschrieben wird:
Metriken und Zustandsprüfung
Der gRPC-Proxy stellt für die durch --endpoints definierten etcd-Mitglieder die Endpunkte /health und Prometheus /metrics bereit. Alternativ lässt sich mit der Option --metrics-addr eine zusätzliche URL definieren, die sowohl auf /metrics als auch auf /health antwortet.
Bekanntes Problem
Die Hauptschnittstelle des Proxys bedient sowohl HTTP2 als auch HTTP/1.1. Ist der Proxy wie im obigen Beispiel mit TLS eingerichtet, muss bei Anfragen eines Clients wie cURL an die lauschende Schnittstelle ausdrücklich HTTP/1.1 als Protokoll eingestellt werden, damit /metrics oder /health zurückgegeben werden. Die mit --metrics-addr eingerichtete zweite Schnittstelle hat diese Anforderung nicht.
14.11 - Hardwareempfehlungen
etcd läuft für Entwicklung und Tests in der Regel auch mit begrenzten Ressourcen gut; die Entwicklung mit etcd auf einem Laptop oder einer günstigen Cloud-Instanz ist üblich. Für den produktiven Betrieb von etcd-Clustern helfen jedoch einige Hardwarehinweise bei der sachgerechten Verwaltung. Diese Empfehlungen sind keine starren Regeln, sondern ein guter Ausgangspunkt für eine robuste Produktivinstallation. Wie immer sollten Installationen vor dem produktiven Einsatz mit simulierten Arbeitslasten getestet werden.
CPUs
Nur wenige etcd-Installationen benötigen viel CPU-Leistung. Typische Cluster kommen für einen reibungslosen Betrieb mit zwei bis vier Kernen aus. Stark ausgelastete etcd-Installationen, die Tausende von Clients oder Zehntausende von Anfragen pro Sekunde bedienen, sind meist durch die CPU begrenzt, da etcd Anfragen aus dem Arbeitsspeicher bedienen kann. Solche Installationen benötigen gewöhnlich acht bis sechzehn dedizierte Kerne.
Arbeitsspeicher
etcd hat einen vergleichsweise geringen Speicherbedarf, seine Leistung hängt aber dennoch von ausreichend Arbeitsspeicher ab. Ein etcd-Server speichert Schlüssel-Wert-Daten umfassend zwischen und verwendet den größten Teil des übrigen Speichers zur Verwaltung von Watchern. Typischerweise reichen 8GB aus. Für große Installationen mit Tausenden von Watchern und Millionen von Schlüsseln entsprechend 16GB bis 64GB Arbeitsspeicher vorsehen.
Datenträger
Schnelle Datenträger sind der wichtigste Faktor für Leistung und Stabilität einer etcd-Installation.
Ein langsamer Datenträger erhöht die Latenz von etcd-Anfragen und kann die Clusterstabilität beeinträchtigen. Da das Konsensprotokoll von etcd auf der dauerhaften Speicherung von Metadaten in einem Log beruht, muss eine Mehrheit der Clustermitglieder jede Anfrage auf den Datenträger schreiben. Zusätzlich schreibt etcd seinen Zustand schrittweise als Checkpoints auf den Datenträger, um dieses Log kürzen zu können. Dauern diese Schreiboperationen zu lange, können Heartbeats ihr Zeitlimit überschreiten und eine Wahl auslösen, was die Clusterstabilität beeinträchtigt. Ob ein Datenträger für etcd schnell genug ist, lässt sich im Allgemeinen mit einem Benchmarkwerkzeug wie fio ermitteln. Ein Beispiel steht hier .
etcd reagiert sehr empfindlich auf die Schreiblatenz von Datenträgern. Typischerweise sind 50 sequenzielle IOPS erforderlich (z. B. eine Festplatte mit 7200 RPM). Für stark ausgelastete Cluster werden 500 sequenzielle IOPS empfohlen (z. B. eine typische lokale SSD oder ein leistungsfähiges virtualisiertes Blockgerät). Die meisten Cloud-Anbieter veröffentlichen parallele statt sequenzieller IOPS; die veröffentlichten parallelen IOPS können 10x höher als die sequenziellen IOPS sein. Um die tatsächlichen sequenziellen IOPS zu messen, empfiehlt sich ein Datenträger-Benchmarkwerkzeug wie diskbench oder fio .
etcd benötigt nur eine mäßige Datenträgerbandbreite. Eine höhere Bandbreite verkürzt aber die Wiederherstellungszeit, wenn ein ausgefallenes Mitglied zum Cluster aufschließen muss. Typischerweise lassen sich mit 10MB/s 100MB Daten innerhalb von 15 Sekunden wiederherstellen. Für große Cluster werden mindestens 100MB/s empfohlen, um 1GB Daten innerhalb von 15 Sekunden wiederherzustellen.
Für die Speicherung von etcd nach Möglichkeit eine SSD verwenden. Eine SSD bietet gewöhnlich niedrigere und weniger schwankende Schreiblatenzen als eine rotierende Festplatte und verbessert damit Stabilität und Zuverlässigkeit von etcd. Bei rotierenden Festplatten die schnellstmöglichen Modelle wählen (15,000 RPM). RAID 0 ist ebenfalls ein wirksames Mittel, die Datenträgergeschwindigkeit zu erhöhen, sowohl bei Festplatten als auch bei SSDs. Bei mindestens drei Clustermitgliedern sind RAID-Varianten mit Spiegelung und/oder Parität nicht erforderlich; die konsistente Replikation von etcd sorgt bereits für Hochverfügbarkeit.
Netzwerk
etcd-Installationen mit mehreren Mitgliedern profitieren von einem schnellen und zuverlässigen Netzwerk. Da etcd sowohl Konsistenz als auch Partitionstoleranz gewährleisten muss, führt ein unzuverlässiges Netzwerk mit Unterbrechungen durch Partitionen zu schlechter Verfügbarkeit. Niedrige Latenz ermöglicht eine schnelle Kommunikation zwischen etcd-Mitgliedern. Hohe Bandbreite kann die Wiederherstellungszeit eines ausgefallenen Mitglieds verkürzen. Für gängige etcd-Installationen reicht 1GbE aus. Bei großen etcd-Clustern verkürzt ein 10GbE-Netzwerk die mittlere Wiederherstellungszeit.
etcd-Mitglieder nach Möglichkeit innerhalb eines einzigen Rechenzentrums bereitstellen, um zusätzliche Latenz zu vermeiden und die Wahrscheinlichkeit von Netzwerkpartitionen zu verringern. Wird ein separater Ausfallbereich in einem anderen Rechenzentrum benötigt, ein möglichst nahe gelegenes Rechenzentrum wählen. Weitere Informationen zu Installationen über mehrere Rechenzentren hinweg enthält die Dokumentation zur Optimierung .
Beispiele für Hardwarekonfigurationen
Im Folgenden stehen einige beispielhafte Hardwarekonfigurationen für AWS- und GCE-Umgebungen. Wie bereits erwähnt, gilt auch hier: Administratoren sollten eine etcd-Installation vor dem produktiven Einsatz mit einer simulierten Arbeitslast testen.
Diese Konfigurationen setzen voraus, dass die Rechner ausschließlich für etcd vorgesehen sind. Werden darauf neben etcd weitere Anwendungen ausgeführt, können Ressourcenkonflikte entstehen und den Cluster instabil machen.
Kleiner Cluster
Ein kleiner Cluster bedient weniger als 100 Clients und weniger als 200 Anfragen pro Sekunde und speichert höchstens 100MB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 50 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56.25 |
| GCE | n1-standard-2 + 50GB PD SSD | 2 | 7.5 | 1500 | 25 |
Mittlerer Cluster
Ein mittlerer Cluster bedient weniger als 500 Clients und weniger als 1,000 Anfragen pro Sekunde und speichert höchstens 500MB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 250 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93.75 |
| GCE | n1-standard-4 + 150GB PD SSD | 4 | 15 | 4500 | 75 |
Großer Cluster
Ein großer Cluster bedient weniger als 1,500 Clients und weniger als 10,000 Anfragen pro Sekunde und speichert höchstens 1GB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 1,000 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250GB PD SSD | 8 | 30 | 7500 | 125 |
Sehr großer Cluster
Ein sehr großer Cluster bedient mehr als 1,500 Clients und mehr als 10,000 Anfragen pro Sekunde und speichert mehr als 1GB Daten.
Beispielarbeitslast: ein Kubernetes-Cluster mit 3,000 Knoten
| Anbieter | Typ | vCPUs | Arbeitsspeicher (GB) | Maximale parallele IOPS | Datenträgerbandbreite (MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16,000 | 250 |
| GCE | n1-standard-16 + 500GB PD SSD | 16 | 60 | 15,000 | 250 |
14.12 - Wartung
Überblick
Ein etcd-Cluster muss regelmäßig gewartet werden, um zuverlässig zu bleiben. Je nach Anforderungen der etcd-Anwendung lässt sich diese Wartung gewöhnlich automatisieren und ohne Ausfallzeiten oder erhebliche Leistungseinbußen durchführen.
Alle Wartungsaufgaben in etcd dienen der Verwaltung der Speicherressourcen, die der etcd-Schlüsselraum belegt. Speicherplatzkontingente sichern gegen eine unzureichende Begrenzung der Schlüsselraumgröße ab: Wird der Speicherplatz eines etcd-Mitglieds knapp, löst ein Kontingent clusterweite Alarme aus, die das System in einen Wartungsmodus mit eingeschränktem Funktionsumfang versetzen. Damit weiterhin Platz für Schreibzugriffe auf den Schlüsselraum vorhanden ist, muss dessen Historie kompaktiert werden. Der Speicherplatz selbst kann durch Defragmentierung der etcd-Mitglieder zurückgewonnen werden. Regelmäßige Snapshot-Backups des Zustands eines etcd-Mitglieds ermöglichen schließlich die Wiederherstellung nach unbeabsichtigtem logischem Datenverlust oder nach Datenbeschädigungen durch Bedienfehler.
Aufbewahrung des Raft-Logs
etcd --snapshot-count legt fest, wie viele angewendete Raft-Einträge vor der Kompaktierung im Arbeitsspeicher gehalten werden. Sobald --snapshot-count erreicht ist, speichert der Server zunächst die Snapshot-Daten dauerhaft auf dem Datenträger und entfernt anschließend alte Einträge. Fordert ein langsamer Follower Logs vor einem kompaktierten Index an, sendet der Leader den Snapshot und zwingt den Follower damit, seinen Zustand zu überschreiben.
Ein höherer Wert für --snapshot-count hält bis zum Snapshot mehr Raft-Einträge im Arbeitsspeicher und verursacht damit eine wiederkehrend höhere Speichernutzung
. Da der Leader die neuesten Raft-Einträge länger aufbewahrt, hat ein langsamer Follower mehr Zeit, vor dem nächsten Snapshot des Leaders aufzuschließen. --snapshot-count stellt somit einen Kompromiss zwischen höherem Speicherbedarf und besserer Verfügbarkeit langsamer Follower dar.
In v3.2 wurde der Standardwert von --snapshot-count von 10,000 auf 100,000 geändert
. In v3.7.0 beträgt der Standardwert 10,000.
Werte von --snapshot-count über 100,000 können den Schreibdurchsatz beeinträchtigen. Eine größere Anzahl von Objekten im Arbeitsspeicher kann die Markierungsphase des Go-GC, runtime.scanobject
, verlangsamen; eine seltene Speicherfreigabe verlangsamt außerdem die Speicherzuweisung. Die Leistung hängt von Arbeitslast und Systemumgebung ab. Generell beeinträchtigt eine zu häufige Kompaktierung jedoch Clusterverfügbarkeit und Schreibdurchsatz. Eine zu seltene Kompaktierung ist ebenfalls schädlich, da sie den Garbage Collector von Go zu stark belastet. Weitere Untersuchungsergebnisse bietet Leistungsaspekte von etcd und Raft verstehen
.
Kompaktierung der Historie: Schlüssel-Wert-Datenbank der v3-API
Da etcd eine genaue Historie seines Schlüsselraums führt, sollte diese regelmäßig kompaktiert werden, um Leistungseinbußen und letztlich eine Erschöpfung des Speicherplatzes zu vermeiden. Die Kompaktierung der Schlüsselraumhistorie entfernt alle Informationen zu Schlüsseln, die vor einer bestimmten Revision des Schlüsselraums ersetzt wurden. Der von diesen Schlüsseln belegte Platz steht danach für weitere Schreibzugriffe auf den Schlüsselraum zur Verfügung.
Der Schlüsselraum lässt sich automatisch mit der zeitfensterbasierten Aufbewahrungsrichtlinie von etcd oder manuell mit etcdctl kompaktieren. etcdctl ermöglicht eine genaue Steuerung der Kompaktierung; die automatische Kompaktierung eignet sich für Anwendungen, die die Schlüsselhistorie nur für einen bestimmten Zeitraum benötigen.
Eine mit etcdctl ausgelöste Kompaktierung funktioniert wie folgt:
Revisionen vor der Kompaktierungsrevision sind danach nicht mehr zugänglich:
Automatische Kompaktierung
etcd lässt sich mit den Optionen --auto-compaction-mode und --auto-compaction-retention so konfigurieren, dass es den Schlüsselraum automatisch kompaktiert. Es gibt zwei Kompaktierungsmodi: periodic (Standard) und revision.
Periodische Kompaktierung
Die periodische Kompaktierung bewahrt ein zeitbasiertes Fenster der Schlüsselraumhistorie auf:
Der Aufbewahrungswert legt fest, wie viel Historie erhalten bleibt. Ein Datensatz wird erst ungefähr diese Zeitspanne nach seiner Erstellung kompaktiert. Dadurch können langsame Watcher innerhalb des Aufbewahrungsfensters noch aufschließen.
Ist die Aufbewahrungsdauer größer als 1 Stunde, kompaktiert etcd stündlich und behält dabei das vollständige Aufbewahrungsfenster bei. Beträgt die Aufbewahrungsdauer 1 Stunde oder weniger, erfolgt die Kompaktierung im Abstand dieser Dauer.
Bei --auto-compaction-retention=10h wartet etcd beispielsweise 10 Stunden bis zur ersten Kompaktierung und kompaktiert danach stündlich:
Die empfohlenen Werte hängen vom Anwendungsfall ab:
- Häufige Aktualisierungen derselben Schlüssel: ein kurzer Zeitraum wie
1hoder30m - Seltene Aktualisierungen: ein längerer Zeitraum wie
24h,48hoder72h - Allgemeiner Standardwert:
10h
Revisionsbasierte Kompaktierung
Die revisionsbasierte Kompaktierung bewahrt eine feste Anzahl von Revisionen auf:
etcd prüft alle 5 Minuten und kompaktiert bei "latest revision" - 1000. Ist die neueste Revision beispielsweise 30000, erfolgt die Kompaktierung bei Revision 29000.
Defragmentierung
Nach der Kompaktierung des Schlüsselraums kann die Backend-Datenbank intern fragmentiert sein. Interne Fragmentierung bezeichnet Platz, den das Backend wiederverwenden kann, der aber weiterhin Speicherplatz belegt. Beim Kompaktieren alter Revisionen entstehen Lücken in der Backend-Datenbank, wodurch etcd intern fragmentiert wird. Fragmentierter Platz steht etcd zur Verfügung, dem Dateisystem des Hosts jedoch nicht. Das Löschen von Anwendungsdaten gibt also keinen Speicherplatz auf dem Datenträger frei.
Die Defragmentierung gibt diesen Speicherplatz an das Dateisystem zurück. Sie wird für jedes Mitglied einzeln ausgelöst, um clusterweite Latenzspitzen vermeiden zu können.
Ein etcd-Mitglied mit dem Befehl etcdctl defrag defragmentieren:
Die Defragmentierung eines laufenden Mitglieds blockiert während des Neuaufbaus seines Zustands alle Lese- und Schreibzugriffe auf Daten.
Eine Defragmentierungsanfrage wird nicht im Cluster repliziert, sondern nur auf dem lokalen Knoten ausgeführt. Alle Mitglieder mit der Option --endpoints angeben oder mit --cluster alle Clustermitglieder automatisch ermitteln lassen.
Defragmentierung für alle Endpunkte des Clusters ausführen, zu dem der Standardendpunkt gehört:
Um ein etcd-Datenverzeichnis direkt zu defragmentieren, während etcd nicht läuft, folgenden Befehl verwenden:
Speicherplatzkontingent
Das Speicherplatzkontingent in etcd stellt einen zuverlässigen Clusterbetrieb sicher. Ohne ein solches Kontingent kann etcd bei einem übermäßig großen Schlüsselraum an Leistung verlieren oder schlicht den gesamten Speicherplatz aufbrauchen, was zu unvorhersehbarem Clusterverhalten führt. Überschreitet die Backend-Datenbank des Schlüsselraums eines beliebigen Mitglieds das Kontingent, löst etcd einen clusterweiten Alarm aus. Dieser versetzt den Cluster in einen Wartungsmodus, der nur das Lesen und Löschen von Schlüsseln erlaubt. Erst nachdem genügend Platz im Schlüsselraum freigegeben, die Backend-Datenbank defragmentiert und der Kontingentalarm aufgehoben wurde, kann der Cluster den normalen Betrieb wieder aufnehmen.
Standardmäßig verwendet etcd ein konservatives Speicherplatzkontingent, das für die meisten Anwendungen geeignet ist. Es lässt sich jedoch auf der Befehlszeile in Bytes konfigurieren:
Das Kontingent lässt sich mit einer Schleife ausschöpfen:
Durch das Entfernen überflüssiger Daten aus dem Schlüsselraum und die Defragmentierung der Backend-Datenbank liegt der Cluster wieder innerhalb des Kontingents:
Die Metrik etcd_mvcc_db_total_size_in_use_in_bytes zeigt die tatsächliche Datenbankbelegung nach einer Kompaktierung der Historie. etcd_debugging_mvcc_db_total_size_in_bytes zeigt dagegen die Datenbankgröße einschließlich freien Platzes, der noch auf Defragmentierung wartet. Letztere steigt nur, wenn Erstere nahe an ihr liegt. Nähern sich beide Metriken dem Kontingent, ist daher eine Kompaktierung der Historie erforderlich, um das Auslösen des Speicherplatzkontingents zu vermeiden.
Ab v3.4 heißt etcd_debugging_mvcc_db_total_size_in_bytes nun etcd_mvcc_db_total_size_in_bytes.
Eine Put/Txn/LeaseGrant-Anfrage kann den Fehler ErrGRPCNoSpace zurückgeben, obwohl der Schreibzugriff im Backend erfolgreich ist. etcd prüft das Speicherplatzkontingent sowohl auf der API-Schicht als auch auf der internen Apply-Schicht. Die Apply-Schicht löst lediglich den Alarm NOSPACE aus, ohne die weitere Ausführung der Transaktion zu blockieren.
Snapshot-Backup
Regelmäßige Snapshots des etcd-Clusters dienen als dauerhaftes Backup des etcd-Schlüsselraums. Durch regelmäßige Snapshots der Backend-Datenbank eines etcd-Mitglieds lässt sich ein etcd-Cluster auf einen Zeitpunkt mit einem nachweislich intakten Zustand zurücksetzen.
Ein Snapshot wird mit etcdctl erstellt:
14.13 - etcd überwachen
Jeder etcd-Server stellt über HTTP-Endpunkte auf seinem Clientport lokale Überwachungsinformationen bereit. Diese Daten helfen sowohl bei der Prüfung des Systemzustands als auch bei der Fehlersuche im Cluster.
Debug-Endpunkt
Ist --log-level=debug gesetzt, stellt der etcd-Server auf seinem Clientport unter dem Pfad /debug Informationen zur Fehlersuche bereit. --log-level=debug mit Bedacht setzen, da dies die Leistung beeinträchtigt und eine ausführliche Protokollierung verursacht.
Der Endpunkt /debug/pprof ist der standardmäßige Profiling-Endpunkt der Go-Laufzeitumgebung. Damit lassen sich CPU-, Heap-, Mutex- und Goroutine-Nutzung untersuchen. Im folgenden Beispiel ermittelt go tool pprof die 10 Funktionen, in denen etcd die meiste Zeit verbringt:
Der Endpunkt /debug/requests stellt gRPC-Traces und Leistungsstatistiken für einen Webbrowser bereit. Hier ist beispielsweise eine Range-Anfrage für den Schlüssel abc zu sehen:
Metrikendpunkt
Jeder etcd-Server stellt Metriken unter dem Pfad /metrics auf seinem Clientport sowie optional an den mit --listen-metrics-urls angegebenen Adressen bereit.
Die Metriken lassen sich mit curl abrufen:
Health Check
Seit v3.3.0 antworten alle mit --listen-metrics-urls angegebenen Adressen neben /metrics auch auf den Endpunkt /health. Dies ist hilfreich, wenn der Standardendpunkt mit gegenseitiger TLS-Authentifizierung (Clientauthentifizierung) konfiguriert ist, ein Load-Balancer oder Überwachungsdienst aber weiterhin Zugriff auf den Health Check benötigt.
Seit v3.4 gibt es die beiden neuen Endpunkte /livez und /readyz.
- Der Endpunkt
/livezzeigt an, ob der Prozess lebt oder neu gestartet werden muss. - Der Endpunkt
/readyzzeigt an, ob der Prozess bereit ist, Anfragen zu bedienen.
Die Entwurfsdetails der Endpunkte sind im KEP dokumentiert.
Jeder Endpunkt umfasst mehrere einzelne Health Checks. Mit dem Parameter verbose lassen sich Einzelheiten und Status der Prüfungen ausgeben, beispielsweise:
Die Antwort sieht dann etwa so aus:
Die HTTP-API unterstützt auch den Ausschluss einzelner Prüfungen, beispielsweise:
Prometheus
Ein Überwachungsdienst mit Prometheus ist der einfachste Weg, die Metriken von etcd zu erfassen und aufzuzeichnen.
Zunächst Prometheus installieren:
Die Endpunkte des etcd-Clusters als Abrufziele von Prometheus festlegen:
Den Prometheus-Handler einrichten:
Prometheus ruft nun alle 10 Sekunden die Metriken von etcd ab.
Alarmierung
Für etcd-v3-Cluster gibt es einen Satz von Standardalarmen für Prometheus.
Die job-Labels müssen möglicherweise an die jeweiligen Anforderungen angepasst werden. Die Regeln wurden für einen einzelnen Cluster geschrieben; daher werden Labels empfohlen, die für einen Cluster eindeutig sind.
Grafana
Grafana unterstützt Prometheus von Haus aus; dazu einfach eine Prometheus-Datenquelle hinzufügen:
Anschließend die standardmäßige etcd-Dashboardvorlage
importieren und anpassen. Heißt die Prometheus-Datenquelle beispielsweise my-etcd, müssen auch die Werte der datasource-Felder im JSON my-etcd lauten.
Beispieldashboard:
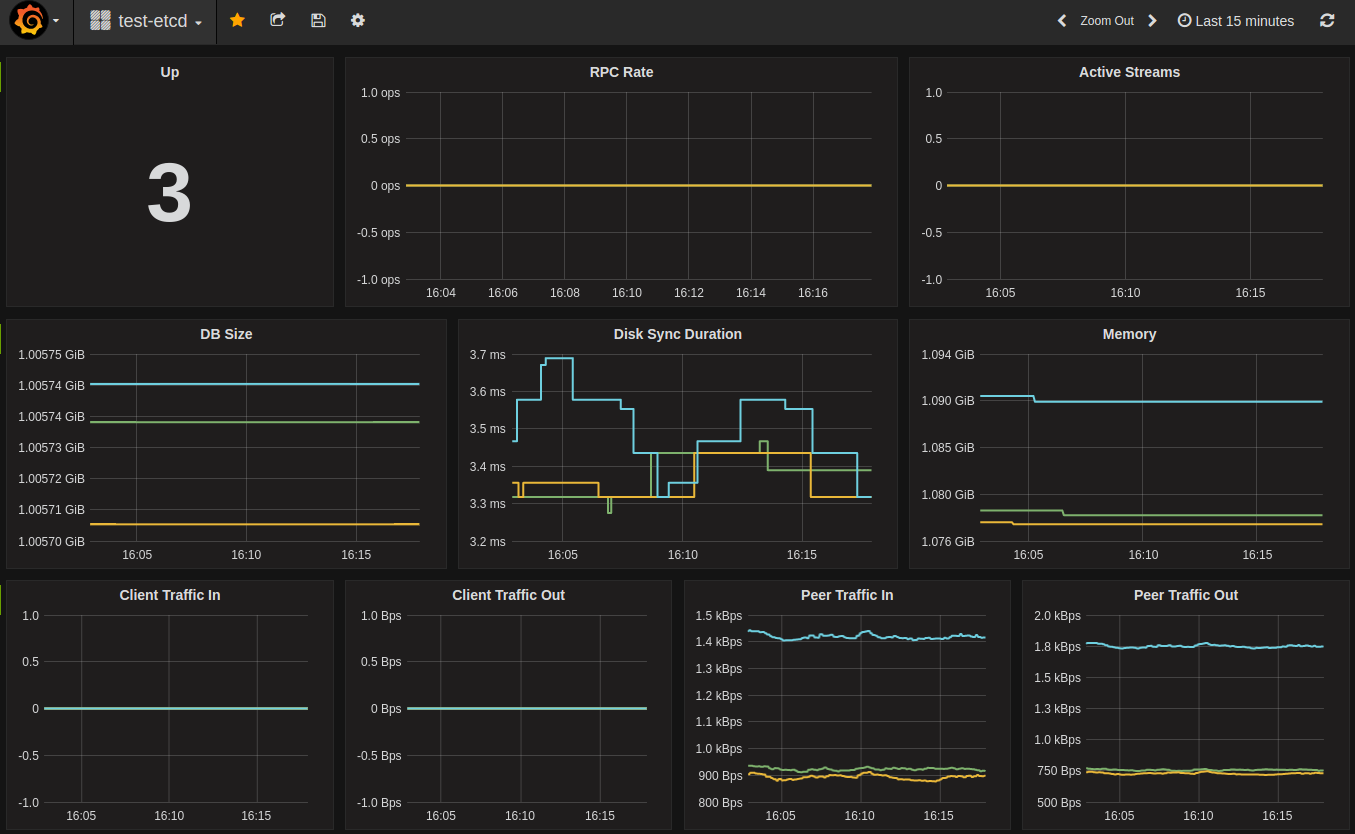
Verteiltes Tracing
In v3.5 wurde etcd um Unterstützung für verteiltes Tracing mit OpenTelemetry erweitert.
In etcd 3.7 die folgenden Tracing-Optionen ohne das frühere Präfix experimental verwenden.
Um verteiltes Tracing zu aktivieren, dem etcd-Server --enable-distributed-tracing=true übergeben. Mit der Option --distributed-tracing-sampling-rate=<number> wird zusätzlich festgelegt, wie viele Stichproben pro Million Spans erfasst werden; die Standardrate ist 0.
Das verteilte Tracing lässt sich konfigurieren, indem der etcd-Server mit folgenden optionalen Optionen gestartet wird:
-
--distributed-tracing-address- (Optional) - “localhost:4317” - Adresse des Tracing-Collectors. -
--distributed-tracing-service-name- (Optional) - “etcd” - Dienstname für verteiltes Tracing; muss für alle etcd-Instanzen gleich sein. -
--distributed-tracing-instance-id- (Optional) - Instanz-ID; ihre Angabe ist optional, wird aber dringend empfohlen. Sie muss für jede etcd-Instanz eindeutig sein.
Vor der Aktivierung des verteilten Tracings sicherstellen, dass ein OpenTelemetry-Endpunkt verfügbar ist. Weicht seine Adresse vom Standard ab, sie mit --distributed-tracing-address überschreiben. Da OpenTelemetry auf verschiedene Arten betrieben werden kann, enthält die Collector-Dokumentation
weitere Informationen.
Wie jedes Signal zur Beobachtung des Systems verursacht auch diese Funktion zusätzlichen Ressourcenbedarf. Nach unseren ersten Messungen kann die zusätzliche CPU-Last zwischen 2% - 4% liegen.
14.14 - Leistung
Leistung verstehen
etcd bietet eine stabile, dauerhaft hohe Leistung. Zwei Faktoren bestimmen die Leistung: Latenz und Durchsatz. Die Latenz ist die Zeit bis zum Abschluss einer Operation. Der Durchsatz ist die Gesamtzahl der in einem bestimmten Zeitraum abgeschlossenen Operationen. Nimmt etcd gleichzeitige Clientanfragen an, steigt die mittlere Latenz gewöhnlich mit dem Gesamtdurchsatz. In gängigen Cloud-Umgebungen, etwa auf einer standardmäßigen n-4-Instanz bei Google Compute Engine (GCE) oder einem vergleichbaren AWS-Instanztyp, schließt ein etcd-Cluster mit drei Mitgliedern bei geringer Last eine Anfrage in weniger als einer Millisekunde ab und kann bei hoher Last mehr als 30,000 Anfragen pro Sekunde verarbeiten.
etcd verwendet den Raft-Konsensalgorithmus, um Anfragen zwischen Mitgliedern zu replizieren und Einigkeit herzustellen. Die Konsensleistung, insbesondere die Commit-Latenz, wird durch zwei physikalische Grenzen bestimmt: die Latenz der Netzwerk-IO und die Latenz der Datenträger-IO. Die Mindestdauer einer etcd-Anfrage ergibt sich aus der Netzwerkumlaufzeit (Round Trip Time, RTT) zwischen den Mitgliedern zuzüglich der Zeit, die fdatasync benötigt, um die Daten dauerhaft zu speichern. Innerhalb eines Rechenzentrums kann die RTT mehrere Hundert Mikrosekunden betragen. Eine typische RTT innerhalb der USA liegt bei etwa 50ms und kann zwischen Kontinenten bis zu 400ms erreichen. Die typische fdatasync-Latenz einer rotierenden Festplatte liegt bei etwa 10ms, bei SSDs häufig unter 1ms. Um den Durchsatz zu erhöhen, bündelt etcd mehrere Anfragen und übergibt sie gemeinsam an Raft. Diese Bündelung ermöglicht etcd auch bei hoher Last einen hohen Durchsatz.
Weitere Teilsysteme beeinflussen die Gesamtleistung von etcd. Jede serialisierte etcd-Anfrage muss die boltdb-basierte MVCC-Speicherengine durchlaufen, was gewöhnlich einige zehn Mikrosekunden dauert. Regelmäßig erstellt etcd inkrementelle Snapshots der zuletzt angewendeten Anfragen und führt sie mit dem vorherigen Snapshot auf dem Datenträger zusammen. Dieser Vorgang kann eine Latenzspitze verursachen. Auf SSDs ist dies gewöhnlich unproblematisch, auf HDD kann sich die beobachtete Latenz jedoch verdoppeln. Auch laufende Kompaktierungen können die Leistung von etcd beeinflussen. Ihre Auswirkung ist glücklicherweise oft gering, da die Kompaktierung zeitlich gestaffelt erfolgt und so nicht mit regulären Anfragen um Ressourcen konkurriert. Das RPC-System gRPC bietet etcd eine klar definierte, erweiterbare API, verursacht aber auch zusätzliche Latenz, insbesondere bei lokalen Lesezugriffen.
Benchmarks
Die Leistung von etcd lässt sich mit dem enthaltenen CLI-Werkzeug benchmark messen.
Als Grundlage für einige Leistungskennzahlen dient ein etcd-Cluster mit drei Mitgliedern und folgender Hardwarekonfiguration:
- Google Cloud Compute Engine
- 3 Rechner mit 8 vCPUs + 16GB Arbeitsspeicher + 50GB SSD
- 1 Rechner (Client) mit 16 vCPUs + 30GB Arbeitsspeicher + 50GB SSD
- Ubuntu 17.04
- etcd 3.2.0, go 1.8.3
Mit dieser Konfiguration erreicht etcd ungefähr folgende Schreibleistung:
| Anzahl der Schlüssel | Schlüsselgröße in Bytes | Wertgröße in Bytes | Anzahl der Verbindungen | Anzahl der Clients | etcd-Zielserver | Mittlere Schreib-QPS | Mittlere Latenz pro Anfrage | Mittlerer Server-RSS |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | nur Leader | 583 | 1.6ms | 48 MB |
| 100,000 | 8 | 256 | 100 | 1000 | nur Leader | 44,341 | 22ms | 124MB |
| 100,000 | 8 | 256 | 100 | 1000 | alle Mitglieder | 50,104 | 20ms | 126MB |
Beispielbefehle:
Linearisierbare Leseanfragen beziehen ein Quorum von Clustermitgliedern in die Konsensbildung ein, um die neuesten Daten abzurufen. Serialisierbare Leseanfragen sind günstiger, da sie von einem beliebigen einzelnen etcd-Mitglied statt von einem Quorum bedient werden; dafür können sie veraltete Daten zurückgeben. etcd erreicht folgende Leseleistung:
| Anzahl der Anfragen | Schlüsselgröße in Bytes | Wertgröße in Bytes | Anzahl der Verbindungen | Anzahl der Clients | Konsistenz | Mittlere Lese-QPS | Mittlere Latenz pro Anfrage |
|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | Linearisierbar | 1,353 | 0.7ms |
| 10,000 | 8 | 256 | 1 | 1 | Serialisierbar | 2,909 | 0.3ms |
| 100,000 | 8 | 256 | 100 | 1000 | Linearisierbar | 141,578 | 5.5ms |
| 100,000 | 8 | 256 | 100 | 1000 | Serialisierbar | 185,758 | 2.2ms |
Beispielbefehle:
Beim erstmaligen Einrichten eines etcd-Clusters in einer neuen Umgebung wird empfohlen, den Benchmarktest auszuführen, um eine angemessene Leistung sicherzustellen. Latenz und Durchsatz des Clusters können empfindlich auf geringe Unterschiede in der Umgebung reagieren.
14.15 - Entwurf der Laufzeitrekonfiguration
Die Laufzeitrekonfiguration gehört zu den schwierigsten und fehleranfälligsten Funktionen eines verteilten Systems, insbesondere eines konsensbasierten Systems wie etcd.
Im Folgenden wird erläutert, wie die Befehle zur Laufzeitrekonfiguration von etcd entworfen wurden und wie wir diese Probleme gelöst haben.
Konfigurationsänderungen in zwei Phasen schützen den Cluster
In etcd muss jede Laufzeitrekonfiguration aus Sicherheitsgründen zwei Phasen durchlaufen. Um beispielsweise ein Mitglied hinzuzufügen, wird zunächst der Cluster über die neue Konfiguration informiert und anschließend das neue Mitglied gestartet.
Phase 1 – Den Cluster über die neue Konfiguration informieren
Um einem etcd-Cluster ein Mitglied hinzuzufügen, wird dies über einen API-Aufruf angefordert. Dies ist die einzige Möglichkeit, ein neues Mitglied zu einem bestehenden Cluster hinzuzufügen. Der API-Aufruf kehrt zurück, sobald sich der Cluster auf die Konfigurationsänderung geeinigt hat.
Phase 2 – Das neue Mitglied starten
Damit das neue etcd-Mitglied dem bestehenden Cluster beitritt, den korrekten Wert für initial-cluster angeben und initial-cluster-state auf existing setzen. Beim Start kontaktiert das Mitglied zunächst den bestehenden Cluster und prüft, ob dessen aktuelle Konfiguration mit der in initial-cluster angegebenen erwarteten Konfiguration übereinstimmt. Sobald das neue Mitglied erfolgreich gestartet ist, hat der Cluster die erwartete Konfiguration erreicht.
Die Aufteilung in zwei getrennte Phasen zwingt Benutzer dazu, Änderungen der Clustermitgliedschaft ausdrücklich vorzunehmen. Tatsächlich verschafft dies mehr Flexibilität und macht die Abläufe leichter nachvollziehbar. Wird beispielsweise versucht, ein neues Mitglied mit derselben ID wie ein bereits vorhandenes Mitglied hinzuzufügen, scheitert die Aktion sofort in der ersten Phase, ohne den laufenden Cluster zu beeinträchtigen. Ein ähnlicher Schutz verhindert, dass neue Mitglieder versehentlich hinzugefügt werden. Versucht ein neues etcd-Mitglied beizutreten, bevor der Cluster die Konfigurationsänderung angenommen hat, wird es vom Cluster nicht akzeptiert.
Ohne den ausdrücklichen Ablauf für Mitgliedschaftsänderungen wäre etcd anfällig für unerwartete Änderungen der Clustermitgliedschaft. Läuft etcd beispielsweise unter einem Init-System wie systemd, würde etcd nach der Entfernung über die Mitgliedschafts-API neu gestartet und beim Start erneut versuchen, dem Cluster beizutreten. Diese unerwartete Schleife würde sich jedes Mal wiederholen, wenn ein Mitglied über die API entfernt wird und systemd etcd nach einem Fehlschlag neu starten soll.
Wir gehen davon aus, dass die Laufzeitrekonfiguration nur selten erforderlich ist. Daher haben wir sie bewusst als ausdrücklichen, benutzergesteuerten Vorgang gestaltet, um die Konfigurationssicherheit zu gewährleisten und den Cluster unter klarer Kontrolle reibungslos zu betreiben.
Dauerhafter Quorumverlust erfordert einen neuen Cluster
Verliert ein Cluster dauerhaft die Mehrheit seiner Mitglieder, muss ein neuer Cluster aus einem alten Datenverzeichnis gestartet werden, um den vorherigen Zustand wiederherzustellen.
Es wäre durchaus möglich, ausgefallene Mitglieder zwangsweise aus dem bestehenden Cluster zu entfernen und ihn so wiederherzustellen. Wir unterstützen dieses Verfahren jedoch nicht, da es die normale Commit-Phase des Konsensverfahrens umgeht und somit unsicher ist. Ist das zu entfernende Mitglied tatsächlich noch aktiv oder wird die Entfernung über verschiedene Mitglieder desselben Clusters erzwungen, entstehen voneinander abweichende Cluster mit derselben clusterID. Dies ist sehr gefährlich und im Nachhinein schwer zu untersuchen oder zu beheben.
Bei einer korrekten Installation ist die Wahrscheinlichkeit eines dauerhaften Mehrheitsverlusts sehr gering. Das Problem ist jedoch schwerwiegend genug, um besondere Vorsorge zu rechtfertigen. Wir empfehlen dringend, vor dem produktiven Einsatz von etcd die Dokumentation zur Disaster Recovery zu lesen und Vorkehrungen für einen dauerhaften Mehrheitsverlust zu treffen.
Den öffentlichen Erkennungsdienst nicht für die Laufzeitrekonfiguration verwenden
Der öffentliche Erkennungsdienst sollte nur zur Initialisierung eines Clusters verwendet werden. Um ein Mitglied zu einem bestehenden Cluster hinzuzufügen, die API zur Laufzeitrekonfiguration verwenden.
Der Erkennungsdienst ist für die Initialisierung eines etcd-Clusters in einer Cloud-Umgebung gedacht, wenn die IP-Adressen aller Mitglieder noch nicht bekannt sind. Nach erfolgreicher Initialisierung sind diese IP-Adressen bekannt. Technisch sollte der Erkennungsdienst dann nicht mehr benötigt werden.
Der öffentliche Erkennungsdienst scheint eine bequeme Möglichkeit zur Laufzeitrekonfiguration zu sein, da er bereits alle Informationen zur Clusterkonfiguration besitzt. Die Abhängigkeit von ihm bringt jedoch Probleme mit sich:
-
Sie schafft externe Abhängigkeiten über den gesamten Lebenszyklus des Clusters hinweg, nicht nur während der Initialisierung. Bei Netzwerkproblemen zwischen dem Cluster und dem öffentlichen Erkennungsdienst wird der Cluster beeinträchtigt.
-
Der öffentliche Erkennungsdienst muss über den gesamten Lebenszyklus des Clusters hinweg dessen korrekte Laufzeitkonfiguration abbilden. Er muss Sicherheitsmechanismen gegen unerwünschte Aktionen bereitstellen, was schwierig ist.
-
Der öffentliche Erkennungsdienst muss Zehntausende von Clusterkonfigurationen aufbewahren. Das Backend unseres öffentlichen Erkennungsdiensts ist für diese Arbeitslast nicht ausgelegt.
Wird ein Erkennungsdienst mit Unterstützung für Laufzeitrekonfiguration benötigt, ist ein eigener privater Dienst die beste Wahl.
14.16 - Laufzeitrekonfiguration
etcd unterstützt die schrittweise Laufzeitrekonfiguration, mit der die Mitgliedschaft im Cluster während des Betriebs geändert werden kann.
Rekonfigurationsanfragen können nur verarbeitet werden, wenn die Mehrheit der Clustermitglieder funktioniert. Für den produktiven Betrieb wird dringend empfohlen, stets mehr als zwei Mitglieder zu verwenden. Das Entfernen eines Mitglieds aus einem Cluster mit zwei Mitgliedern ist unsicher, da auch dessen Mehrheit aus zwei Mitgliedern besteht. Tritt während der Entfernung ein Fehler auf, kann der Cluster möglicherweise nicht mehr weiterarbeiten und einen Neustart nach einem Mehrheitsausfall benötigen.
Weitere Informationen zum Entwurf der Laufzeitrekonfiguration bietet das Dokument zur Laufzeitrekonfiguration .
Anwendungsfälle für die Rekonfiguration
Dieser Abschnitt beschreibt einige häufige Gründe für die Rekonfiguration eines Clusters. Meist bestehen die erforderlichen Schritte aus Kombinationen des Hinzufügens und Entfernens von Mitgliedern. Diese werden weiter unten unter Operationen zur Clusterrekonfiguration erläutert.
Mehrere Rechner austauschen oder aufrüsten
Müssen mehrere Clustermitglieder wegen geplanter Wartungsarbeiten umziehen (Hardwareaufrüstung, Netzwerkunterbrechungen usw.), wird empfohlen, die Mitglieder nacheinander zu ändern.
Der Leader kann sicher entfernt werden; während der anschließenden Wahl gibt es jedoch eine kurze Ausfallzeit. Enthält der Cluster mehr als 50MB v2-Daten, wird empfohlen, das Datenverzeichnis des Mitglieds zu migrieren .
Clustergröße ändern
Eine Vergrößerung des Clusters kann die Fehlertoleranz und die Leseleistung verbessern. Da Clients von jedem Mitglied lesen können, erhöht eine größere Mitgliederzahl den gesamten Durchsatz serialisierbarer Lesezugriffe.
Eine Verkleinerung des Clusters kann die Schreibleistung verbessern, verringert aber seine Ausfallsicherheit. Schreiboperationen werden auf eine Mehrheit der Clustermitglieder repliziert, bevor sie als festgeschrieben gelten. Eine Verkleinerung senkt die erforderliche Mehrheit, sodass jede Schreiboperation schneller festgeschrieben wird.
Einen ausgefallenen Rechner ersetzen
Fällt ein Rechner durch einen Hardwaredefekt, ein beschädigtes Datenverzeichnis oder einen anderen schwerwiegenden Fehler aus, sollte er so schnell wie möglich ersetzt werden. Ausgefallene, aber noch nicht entfernte Rechner wirken sich ungünstig auf das Quorum aus und verringern die Toleranz gegenüber einem weiteren Ausfall.
Um den Rechner zu ersetzen, zunächst nach der Anleitung das Mitglied aus dem Cluster entfernen und anschließend ein neues Mitglied hinzufügen . Enthält der Cluster mehr als 50MB, wird empfohlen, das Datenverzeichnis des ausgefallenen Mitglieds zu migrieren , sofern es noch zugänglich ist.
Cluster nach einem Mehrheitsausfall neu starten
Geht die Mehrheit des Clusters verloren oder haben sich die IP-Adressen aller Knoten geändert, ist für eine sichere Wiederherstellung ein manueller Eingriff erforderlich. Die grundlegenden Schritte umfassen das Erstellen eines neuen Clusters mit den alten Daten , das Erzwingen eines einzelnen Mitglieds als Leader und schließlich das schrittweise Hinzufügen neuer Mitglieder zu diesem Cluster über die Laufzeitkonfiguration.
Cluster nach einem Minderheitsausfall wiederherstellen
Geht ein einzelnes Mitglied verloren, entspricht dies dem Ersetzen eines ausgefallenen Rechners. Die Schritte stehen unter Einen ausgefallenen Rechner ersetzen .
Operationen zur Clusterrekonfiguration
Für diese Anwendungsfälle lassen sich die jeweils erforderlichen Operationen wie folgt beschreiben.
Vor jeder Änderung muss eine einfache Mehrheit (ein Quorum) der etcd-Mitglieder verfügbar sein. Im Wesentlichen gilt dieselbe Anforderung für jede Art von Schreibzugriff auf etcd.
Alle Änderungen am Cluster müssen nacheinander erfolgen:
- Zum Aktualisieren der peerURLs eines einzelnen Mitglieds eine Aktualisierungsoperation ausführen
- Zum Ersetzen eines einzelnen intakten Mitglieds das alte Mitglied entfernen und danach ein neues hinzufügen
- Für eine Erweiterung von 3 auf 5 Mitglieder zwei Hinzufügeoperationen ausführen
- Für eine Verkleinerung von 5 auf 3 zwei Entfernungsoperationen ausführen
Alle Beispiele verwenden das mit etcd gelieferte Befehlszeilenwerkzeug etcdctl. Um die Mitgliedschaft ohne etcdctl zu ändern, die v3-gRPC-Mitglieder-API
verwenden.
Ein Mitglied aktualisieren
Bekannt gegebene Client-URLs aktualisieren
Um die bekannt gegebenen Client-URLs eines Mitglieds zu aktualisieren, dieses einfach mit der aktualisierten Option --advertise-client-urls oder Umgebungsvariablen ETCD_ADVERTISE_CLIENT_URLS neu starten. Das neu gestartete Mitglied veröffentlicht die aktualisierten URLs selbst. Eine falsch aktualisierte Client-URL beeinträchtigt den Zustand des etcd-Clusters nicht.
Bekannt gegebene Peer-URLs aktualisieren
Um die bekannt gegebenen Peer-URLs eines Mitglieds zu aktualisieren, sie zunächst ausdrücklich mit dem member-Befehl ändern und anschließend das Mitglied neu starten. Dieser zusätzliche Schritt ist erforderlich, da Peer-URL-Änderungen die clusterweite Konfiguration ändern und den Zustand des etcd-Clusters beeinflussen können.
Zum Aktualisieren der bekannt gegebenen Peer-URLs zunächst die ID des Zielmitglieds ermitteln. Alle Mitglieder mit etcdctl auflisten:
In diesem Beispiel wird update auf die Mitglieds-ID a8266ecf031671f3 angewendet und deren peerURLs-Wert in http://10.0.1.10:2380 geändert:
Ein Mitglied entfernen
Angenommen, die ID des zu entfernenden Mitglieds ist a8266ecf031671f3. Das Mitglied mit dem Befehl remove entfernen:
Das Zielmitglied beendet sich daraufhin selbst und protokolliert seine Entfernung:
Der Leader kann sicher entfernt werden, allerdings ist der Cluster während der Wahl eines neuen Leaders inaktiv. Diese Dauer entspricht normalerweise dem Wahlzeitlimit zuzüglich des Abstimmungsvorgangs.
Ein neues Mitglied hinzufügen
Das Hinzufügen eines Mitglieds erfolgt in zwei Schritten:
- Das neue Mitglied über die v3-gRPC-Mitglieder-API
oder den Befehl
etcdctl member addzum Cluster hinzufügen. - Das neue Mitglied mit der neuen Clusterkonfiguration starten, einschließlich der aktualisierten Mitgliederliste (vorhandene Mitglieder + neues Mitglied).
etcdctl fügt ein neues Mitglied hinzu, indem dessen Name
und bekannt gegebene Peer-URLs
angegeben werden:
etcdctl hat den Cluster über das neue Mitglied informiert und die für dessen erfolgreichen Start benötigten Umgebungsvariablen ausgegeben. Nun den neuen etcd-Prozess mit den passenden Optionen für das neue Mitglied starten:
Das neue Mitglied läuft als Teil des Clusters und beginnt sofort, zum übrigen Cluster aufzuschließen.
Beim Hinzufügen mehrerer Mitglieder empfiehlt es sich, jeweils ein einzelnes Mitglied zu konfigurieren und seinen korrekten Start zu prüfen, bevor weitere Mitglieder hinzukommen. Wird einem Cluster mit 1 Knoten ein neues Mitglied hinzugefügt, kann der Cluster erst weiterarbeiten, sobald dieses gestartet ist, da er für den Konsens nun zwei Mitglieder als Mehrheit benötigt. Dieses Verhalten tritt nur zwischen der Meldung des neuen Mitglieds durch etcdctl member add und dem erfolgreichen Verbindungsaufbau des neuen zum bestehenden Mitglied auf.
Ein neues Mitglied als Learner hinzufügen
Seit v3.4 unterstützt etcd das Hinzufügen eines neuen Mitglieds als Learner, also als nicht stimmberechtigtes Mitglied. Die Gründe und der Entwurf sind im Entwurfsdokument beschrieben. Um das Hinzufügen sicherer zu machen und die dabei entstehenden Clusterunterbrechungen zu verkürzen, empfiehlt es sich, das neue Mitglied zunächst als Learner hinzuzufügen, bis es aufgeholt hat. Dies lässt sich als Ablauf in drei Schritten beschreiben:
-
Das neue Mitglied über die gRPC-Mitglieder-API oder den Befehl
etcdctl member add --learnerals Learner hinzufügen. -
Das neue Mitglied mit der neuen Clusterkonfiguration starten, einschließlich der aktualisierten Mitgliederliste (vorhandene Mitglieder + neues Mitglied). Dieser Schritt ist genau derselbe wie zuvor.
-
Den neu hinzugefügten Learner über die gRPC-Mitglieder-API oder den Befehl
etcdctl member promotezu einem stimmberechtigten Mitglied befördern. Der etcd-Server prüft die Beförderungsanfrage, um die Betriebssicherheit zu gewährleisten. Erst wenn sein Raft-Log zum Log des Leaders aufgeholt hat, kann der Learner zum stimmberechtigten Mitglied befördert werden. Hat ein Learner-Mitglied noch nicht zum Raft-Log des Leaders aufgeholt, schlägt die Beförderungsanfrage fehl (Einzelheiten stehen im Abschnitt Fehlerfälle bei der Beförderung eines Mitglieds ). In diesem Fall sollte gewartet und die Anfrage später wiederholt werden.
In v3.4 begrenzt der etcd-Server die Zahl der Learner im Cluster auf einen. Dadurch soll vor allem die zusätzliche Last begrenzt werden, die dem Leader durch die Übertragung von Daten an den Learner entsteht.
Mit etcdctl member add und der Option --learner ein neues Mitglied als Learner zum Cluster hinzufügen.
Nachdem der neue etcd-Prozess für das hinzugefügte Learner-Mitglied gestartet wurde, den Learner mit etcdctl member promote zu einem stimmberechtigten Mitglied befördern.
Fehlerfälle beim Hinzufügen von Mitgliedern
Im folgenden Fall fehlt ein neuer Host in der Liste der aufgeführten Knoten. Handelt es sich um einen neuen Cluster, muss der Knoten zur Liste der anfänglichen Clustermitglieder hinzugefügt werden.
In diesem fehlgeschlagenen Beispiel startet das Mitglied mit einer Adresse (10.0.1.14:2380), die von der registrierten Peer-Adresse (10.0.1.13:2380) abweicht:
Startet etcd mit dem Datenverzeichnis eines entfernten Mitglieds, beendet es sich automatisch, sobald es sich mit einem aktiven Clustermitglied verbindet:
Fehlerfälle beim Hinzufügen eines Learner-Mitglieds
Ein Learner kann nicht hinzugefügt werden, wenn der Cluster bereits 1 Learner enthält (v3.4).
Fehlerfälle bei der Beförderung eines Learner-Mitglieds
Ein Learner kann nur zu einem stimmberechtigten Mitglied befördert werden, wenn er mit dem Leader synchron ist.
Die Beförderung eines Mitglieds, das kein Learner ist, schlägt fehl.
Die Beförderung eines Mitglieds, das im Cluster nicht existiert, schlägt fehl.
Strenge Rekonfigurationsprüfung (-strict-reconfig-check)
Wie oben beschrieben, empfiehlt es sich, neue Mitglieder einzeln zu konfigurieren und ihren korrekten Start zu prüfen, bevor weitere hinzukommen. Dieses schrittweise Vorgehen ist sehr wichtig: Ist ein neues Mitglied falsch konfiguriert, etwa mit falschen Peer-URLs, kann der Cluster sein Quorum verlieren. Der Quorumverlust entsteht, weil das neue Mitglied bei der Quorumberechnung mitgezählt wird, selbst wenn die übrigen Mitglieder es nicht erreichen können. Auch Verbindungsprobleme oder betriebliche Probleme können zum Quorumverlust führen.
Um dieses Problem zu vermeiden, bietet etcd die Option -strict-reconfig-check. Wird sie an etcd übergeben, lehnt etcd Rekonfigurationsanfragen ab, wenn die Anzahl gestarteter Mitglieder nach der Änderung kleiner als das Quorum des neu konfigurierten Clusters wäre.
Diese Option ist standardmäßig aktiviert.
14.17 - Unterstützte Plattformen
Unterstützungsstufen
etcd läuft auf verschiedenen Plattformen. Die gewährten Garantien hängen jedoch von der Unterstützungsstufe der jeweiligen Plattform ab:
- Stufe 1: vollständig von den etcd-Maintainern unterstützt; etcd besteht garantiert alle Tests einschließlich Funktions- und Robustheitstests.
- Stufe 2: etcd besteht garantiert Integrations- und Ende-zu-Ende-Tests, aber nicht unbedingt Funktions- oder Robustheitstests.
- Stufe 3: etcd lässt sich garantiert bauen, wird möglicherweise nur wenig oder gar nicht getestet und sollte daher als instabil betrachtet werden.
Aktuelle Unterstützung
Die folgende Tabelle führt die derzeit unterstützten Plattformen und ihre jeweilige etcd-Unterstützungsstufe auf:
| Architektur | Betriebssystem | Unterstützungsstufe | Maintainer |
|---|---|---|---|
| AMD64 | Linux | 1 | etcd-Maintainer |
| ARM64 | Linux | 1 | etcd-Maintainer |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
Nicht aufgeführte Plattformen werden nicht unterstützt.
Eine neue Plattform unterstützen
Möchten Sie als „offizieller“ Maintainer einer neuen Plattform zu etcd beitragen? Neben der Zusage, die Plattform zu unterstützen, müssen Sie eine kontinuierliche Integration (CI) für etcd einrichten, die abhängig von der Unterstützungsstufe die folgenden Anforderungen erfüllt:
| Kontinuierliche Integration für etcd | Stufe 1 | Stufe 2 | Stufe 3 |
|---|---|---|---|
| Build erfolgreich | ✓ | ✓ | ✓ |
| Unittests bestanden | ✓ | ✓ | |
| Integrations- und Ende-zu-Ende-Tests bestanden | ✓ | ✓ | |
| Robustheitstests bestanden | ✓ |
Ein Beispiel zur Einrichtung einer CI der Stufe 2 für ARM64 bietet etcd PR #12928 .
Nicht unterstützte Plattformen
Um den unbeabsichtigten Betrieb eines etcd-Servers auf einer nicht unterstützten Plattform zu vermeiden, gibt etcd eine Warnung aus und beendet sich sofort, sofern die Umgebungsvariable ETCD_UNSUPPORTED_ARCH nicht auf die Zielarchitektur gesetzt ist.
32-Bit-Systeme Auf 32-Bit-Systemen hat etcd aufgrund eines Fehlers in der Go-Laufzeitumgebung bekannte Probleme. Weitere Informationen bieten das Go-Issue #599 und der Fehlerhinweis zum Paket atomic .
14.18 - Versionierung
Dieses Dokument beschreibt die vom etcd-Projekt unterstützten Versionen.
Dienstversionierung und unterstützte Versionen
etcd-Versionen werden als x.y.z angegeben. Dabei ist x die Hauptversion, y die Nebenversion und z die Patchversion, entsprechend der Terminologie der semantischen Versionierung . Neue Nebenversionen können der API zusätzliche Funktionen hinzufügen.
Das etcd-Projekt pflegt Release-Branches für die aktuelle und die vorherige Version. Ist beispielsweise v3.5 die aktuelle Version, wird v3.4 unterstützt. Mit der Veröffentlichung von v3.6 endet die Unterstützung für v3.4.
Geeignete Fehlerbehebungen, einschließlich Sicherheitskorrekturen, können abhängig von Schweregrad und Machbarkeit auf diese beiden Release-Branches zurückportiert werden. Bei Bedarf werden daraus Patchversionen veröffentlicht.
Diese Entscheidung treffen die Maintainer des Projekts.
Die Version eines laufenden etcd-Clusters lässt sich mit etcdctl prüfen:
API-Versionierung
Die Antworten der v3-API sollten sich nach der Veröffentlichung von 3.0.0 nicht ändern; im Laufe der Zeit werden jedoch neue Funktionen hinzugefügt.
14.19 - Datenbeschädigung
etcd verfügt über eine integrierte automatische Erkennung von Datenbeschädigungen, damit die Zustände der Mitglieder nicht voneinander abweichen.
In etcd 3.7 die nachfolgenden Funktionsschalter und Optionen für Zeitintervalle verwenden. Die früheren experimentellen Optionen zur Prüfung auf Datenbeschädigungen wurden entfernt; siehe Konfigurationsoptionen .
Erkennung von Datenbeschädigungen aktivieren
Datenbeschädigungen lassen sich mit folgenden Prüfungen erkennen:
- Anfangsprüfung, aktiviert mit der Option
--feature-gates=InitialCorruptCheck=true. - Regelmäßige Prüfung folgender Hashwerte:
- Hashwert der kompaktierten Revision, aktiviert mit der Option
--feature-gates=CompactHashCheck=true. - Hashwert der neuesten Revision, aktiviert mit der Option
--corrupt-check-time.
- Hashwert der kompaktierten Revision, aktiviert mit der Option
Die Anfangsprüfung erfolgt während der Initialisierung des etcd-Mitglieds. Das Mitglied vergleicht seinen persistenten Zustand mit dem der anderen Mitglieder und beendet sich bei einer Abweichung.
Beide regelmäßigen Prüfungen werden in einem bereits laufenden Cluster vom Leader ausgeführt. Der Leader vergleicht seinen persistenten Zustand mit dem der anderen Mitglieder und löst bei einer Abweichung einen CORRUPT ALARM aus. Beide Prüfungen dienen demselben Zweck. Es lohnt sich jedoch, beide zu aktivieren, um Leistung und Erkennungszeit gegeneinander abzuwägen.
- Prüfung des Hashwerts der kompaktierten Revision – erfordert regelmäßige Kompaktierung, verursacht minimale Leistungseinbußen und kommt mit langsamen Followern zurecht.
- Prüfung des Hashwerts der neuesten Revision – verursacht hohe Leistungseinbußen und kommt weder mit langsamen Followern noch mit häufigen Kompaktierungen zurecht.
Hashwert der kompaktierten Revision prüfen
Bei Aktivierung mit der Option --feature-gates=CompactHashCheck=true wird die Prüfung einmal pro Minute ausgeführt.
Dies lässt sich mit der Option --compact-hash-check-time in folgendem Format anpassen: 1m – jede Minute, 1h – jede Stunde.
Diese Prüfung erweitert die Kompaktierung um die Berechnung einer Prüfsumme, die zwischen Clustermitgliedern verglichen werden kann.
Sie erfordert keinen zusätzlichen Datenbankscan und ist dadurch sehr kostengünstig, setzt aber eine regelmäßige Kompaktierung im Cluster voraus.
Hashwert der neuesten Revision prüfen
Die Aktivierung erfolgt mit der Option --corrupt-check-time; dabei muss ein Ausführungsintervall in folgendem Format angegeben werden: 1m – jede Minute, 1h – jede Stunde.
Wegen der hohen Leistungseinbußen wird ein Intervall von einigen Stunden empfohlen.
Für die Prüfung muss der gesamte etcd-Inhalt bei der angegebenen Revision gescannt werden, um eine Prüfsumme zu berechnen.
Ein Mitglied mit beschädigten Daten wiederherstellen
Es gibt drei Möglichkeiten, ein Mitglied mit beschädigten Daten wiederherzustellen:
- Persistenten Zustand des Mitglieds löschen
- Mitglied ersetzen
- Gesamten Cluster wiederherstellen
Nach der Wiederherstellung des Mitglieds kann der CORRUPT ALARM aufgehoben werden.
Persistenten Zustand des Mitglieds löschen
Der Zustand eines Mitglieds lässt sich wie folgt löschen:
- Die etcd-Instanz stoppen.
- Ein Backup des etcd-Datenverzeichnisses erstellen.
- Das Unterverzeichnis
snapaus dem etcd-Datenverzeichnis verschieben. etcdmit--initial-cluster-state=existingund den in--initial-clusteraufgeführten Clustermitgliedern starten.
Das etcd-Mitglied sollte daraufhin einen aktuellen Snapshot vom Leader herunterladen.
Mitglied ersetzen
Ein Mitglied lässt sich wie folgt ersetzen:
- Die etcd-Instanz stoppen.
- Ein Backup des etcd-Datenverzeichnisses erstellen.
- Das Datenverzeichnis entfernen.
- Das Mitglied durch Ausführen von
etcdctl member removeaus dem Cluster entfernen. - Es durch Ausführen von
etcdctl member addwieder hinzufügen etcdmit--initial-cluster-state=existingund den in--initial-clusteraufgeführten Clustermitgliedern starten.
Gesamten Cluster wiederherstellen
Der Cluster lässt sich wiederherstellen, indem ein Snapshot des aktuellen Leaders gespeichert und auf allen Mitgliedern wiederhergestellt wird.
etcdctl snapshot save gegen den Leader ausführen und dem Verfahren zur Wiederherstellung eines Clusters
folgen.
15 - Benchmarks
Benchmarks
etcd-Benchmarks werden regelmäßig veröffentlicht und im Folgenden für jede Version dokumentiert:
Benchmarks zum Speicherverbrauch
Hier wird der erwartete Speicherverbrauch in verschiedenen Szenarien erfasst.
15.1 - Benchmark zum Speicherverbrauch der Speicherschicht
Zwei Komponenten der etcd-Speicherschicht beanspruchen physischen Speicher. Der etcd-Prozess legt einen Index im Arbeitsspeicher an, um Schlüssel schneller nachzuschlagen. Der vom Betriebssystem verwaltete Seitencache des Prozesses hält kürzlich vom Datenträger gelesene Daten zur schnellen Wiederverwendung vor.
Der Index im Arbeitsspeicher enthält alle Schlüssel in einer B-Baum -Datenstruktur, zusammen mit Zeigern auf die Daten (die Werte) auf dem Datenträger. Jeder Schlüssel im B-Baum kann mehrere Zeiger enthalten, die auf verschiedene Versionen seiner Werte verweisen. Der theoretische Speicherverbrauch des Index lässt sich daher mit folgender Formel näherungsweise berechnen:
N * (c1 + avg_key_size) + N * (avg_versions_of_key) * (c2 + size_of_pointer)
Dabei ist c1 der Zusatzaufwand für Schlüsselmetadaten und c2 der Zusatzaufwand für Versionsmetadaten.
Die Grafik zeigt den detaillierten Aufbau des B-Baum-Index im Arbeitsspeicher.
Der Seitencache wird vom Betriebssystem verwaltet und in diesem Dokument nicht näher behandelt.
Testumgebung
etcd-Version
GCE-Rechnertyp n1-standard-2
- 7.5 GB Arbeitsspeicher
- 2x CPUs
Speicherverbrauch des Index im Arbeitsspeicher
Dieser Test misst ausschließlich den Speicherverbrauch des Index im Arbeitsspeicher. Ziel ist, die oben genannten Werte c1 und c2 zu bestimmen und die feste Grenze des Speicherverbrauchs der Speicherschicht zu verstehen.
Wir berechnen den Speicherverbrauch mit der Go-Funktion runtime.ReadMemStats. Dazu ermitteln wir die Differenz der insgesamt zugewiesenen Bytes vor und nach dem Erstellen des Index. Dies bildet den Speicherverbrauch des Index selbst nicht exakt ab, zeigt aber das ungefähre Verbrauchsmuster.
| N | Versionen | Schlüsselgröße | Speicherverbrauch |
|---|---|---|---|
| 100K | 1 | 64bytes | 22MB |
| 100K | 5 | 64bytes | 39MB |
| 1M | 1 | 64bytes | 218MB |
| 1M | 5 | 64bytes | 432MB |
| 100K | 1 | 256bytes | 41MB |
| 100K | 5 | 256bytes | 65MB |
| 1M | 1 | 256bytes | 409MB |
| 1M | 5 | 256bytes | 506MB |
Aus den Ergebnissen lassen sich c1=120bytes und c2=30bytes berechnen. Da c1 und c2 die einzigen Unbekannten in der Formel sind, reichen zwei Datensätze zu ihrer Berechnung aus. Die Werte c1=120bytes und c2=30bytes sind die Mittelwerte der 4 berechneten Wertepaarungen für c1 und c2. Bei kleinen Schlüssel-Wert-Paaren ist der Zusatzaufwand für Schlüsselmetadaten mit 50% weiterhin beträchtlich. Gegenüber dem alten Speicher mit mindestens 1000% Zusatzaufwand ist dies jedoch eine erhebliche Verbesserung.
Gesamter Speicherverbrauch
Der gesamte Speicherverbrauch erfasst, wie viel RSS etcd mit der Speicherschicht beansprucht. Die Größe der Werte sollte den gesamten Speicherverbrauch von etcd nur wenig beeinflussen, da die Werte auf dem Datenträger liegen und nur häufig verwendete Werte im Arbeitsspeicher verbleiben, verwaltet vom Seitencache des Betriebssystems.
| N | Versionen | Schlüsselgröße | Wertgröße | Speicherverbrauch |
|---|---|---|---|---|
| 100K | 1 | 64bytes | 256bytes | 40MB |
| 100K | 5 | 64bytes | 256bytes | 89MB |
| 1M | 1 | 64bytes | 256bytes | 470MB |
| 1M | 5 | 64bytes | 256bytes | 880MB |
| 100K | 1 | 64bytes | 1KB | 102MB |
| 100K | 5 | 64bytes | 1KB | 164MB |
| 1M | 1 | 64bytes | 1KB | 587MB |
| 1M | 5 | 64bytes | 1KB | 836MB |
Die Ergebnisse zeigen, dass die Größe der Werte den Speicherverbrauch nicht wesentlich beeinflusst. Er steigt geringfügig, weil der Seitencache des Betriebssystems mehr Daten vorhält.
15.2 - Benchmark zum Speicherverbrauch von Watches
Die Watch-Funktionen werden aktiv weiterentwickelt; ihr Speicherverbrauch kann sich dabei ändern. Wir erwarten nicht, dass er die unten angegebenen Werte wesentlich übersteigt.
Ein wesentliches Ziel von etcd ist die Unterstützung sehr vieler Watcher mit einer außerordentlich großen Zahl von Watch-Registrierungen. Angestrebt werden O(10k) Clients, O(100K) Watch-Streams (O(10) Streams pro Client) und insgesamt O(10M) Watch-Registrierungen (O(100) pro Stream). Der Speicherverbrauch der einzelnen Watch-Registrierungen macht den größten Teil des gesamten Speicherverbrauchs von etcd aus und steht deshalb im Mittelpunkt der aktuellen und künftigen Optimierungen.
Drei zusammengehörige Komponenten der Watch-Funktion von etcd beanspruchen physischen Speicher: jede grpc.Conn, jeder Watch-Stream und jede einzelne Watch-Registrierung. grpc.Conn verwaltet die tatsächliche TCP-Verbindung und weitere gRPC-Verbindungszustände. Jede grpc.Conn beansprucht O(10kb) Speicher und kann mehrere Watch-Streams haben.
Jeder Watch-Stream ist eine eigenständige HTTP2-Verbindung, die weitere O(10kb) Speicher beansprucht. Mehrere Watch-Registrierungen können sich einen Watch-Stream teilen.
Eine Watch-Registrierung ist die eigentliche Struktur, die Änderungen im Schlüssel-Wert-Speicher verfolgt. Jede Registrierung sollte nur < O(1kb) beanspruchen.
Der theoretische Speicherverbrauch von Watch lässt sich mit folgender Formel näherungsweise berechnen:
memory = c1 * number_of_conn + c2 * avg_number_of_stream_per_conn + c3 * avg_number_of_watch_stream
Testumgebung
etcd-Version
GCE-Rechnertyp n1-standard-2
- 7.5 GB Arbeitsspeicher
- 2x CPUs
Gesamter Speicherverbrauch
Der gesamte Speicherverbrauch erfasst, wie viel RSS etcd mit den Client-Watchern beansprucht. Obwohl das Ergebnis um bis zu 10% schwanken kann, ist es aussagekräftig: Ziel ist, den ungefähren Speicherverbrauch und das Muster der Speicherzuweisungen zu verstehen.
Aus dem Benchmark-Ergebnis lassen sich näherungsweise c1 = 17kb, c2 = 18kb und c3 = 350bytes berechnen. Jede zusätzliche Clientverbindung beansprucht also 17kb Speicher, jeder zusätzliche Stream 18kb und jede weitere Watch-Registrierung nur 350bytes. Ein einzelner etcd-Server kann im Normalfall Millionen von Watch-Registrierungen mit wenigen GB Arbeitsspeicher verwalten.
| Clients | Streams pro Client | Watch-Registrierungen pro Stream | Watch-Registrierungen insgesamt | Speicherverbrauch |
|---|---|---|---|---|
| 1k | 1 | 1 | 1k | 50MB |
| 2k | 1 | 1 | 2k | 90MB |
| 5k | 1 | 1 | 5k | 200MB |
| 1k | 10 | 1 | 10k | 217MB |
| 2k | 10 | 1 | 20k | 417MB |
| 5k | 10 | 1 | 50k | 980MB |
| 1k | 50 | 1 | 50k | 1001MB |
| 2k | 50 | 1 | 100k | 1960MB |
| 5k | 50 | 1 | 250k | 4700MB |
| 1k | 50 | 10 | 500k | 1171MB |
| 2k | 50 | 10 | 1M | 2371MB |
| 5k | 50 | 10 | 2.5M | 5710MB |
| 1k | 50 | 100 | 5M | 2380MB |
| 2k | 50 | 100 | 10M | 4672MB |
| 5k | 50 | 100 | 25M | OOM |
15.3 - Benchmarks für etcd v3
Physische Rechner
GCE-Rechnertyp n1-highcpu-2
- 1x dedizierte lokale SSD, unter /var/lib/etcd eingebunden
- 1x dedizierter langsamer Datenträger für das Betriebssystem
- 1.8 GB Arbeitsspeicher
- 2x CPUs
- etcd-Version 2.2.0
etcd-Cluster
1 etcd-Mitglied im v3-Demomodus
Testverfahren
Das Benchmarkwerkzeug für etcd v3 verwenden.
Leistung
Einen einzelnen Schlüssel lesen
| Schlüsselgröße in Bytes | Anzahl der Clients | Lese-QPS | 90. Latenzperzentil (ms) |
|---|---|---|---|
| 256 | 1 | 2716 | 0.4 |
| 256 | 64 | 16623 | 6.1 |
| 256 | 256 | 16622 | 21.7 |
Die Leistung ist nahezu gleich wie mit einem leeren Server-Handler.
Einen einzelnen Schlüssel nach dem Schreiben lesen
| Schlüsselgröße in Bytes | Anzahl der Clients | Lese-QPS | 90. Latenzperzentil (ms) |
|---|---|---|---|
| 256 | 1 | 2269 | 0.5 |
| 256 | 64 | 13582 | 8.6 |
| 256 | 256 | 13262 | 47.5 |
Mit einem leeren Server-Handler beeinflusst ein einzelner put-Vorgang die Leistung nicht. Der Leistungsrückgang dürfte daher durch das Speicherpaket verursacht werden.
15.4 - Benchmarks für etcd v2.2.0-rc-memory
Physischer Rechner
GCE-Rechnertyp n1-standard-2
- 1x dedizierte lokale SSD, unter /var/lib/etcd eingebunden
- 1x dedizierter langsamer Datenträger für das Betriebssystem
- 7.5 GB Arbeitsspeicher
- 2x CPUs
etcd
Testverfahren
Einen etcd-Cluster mit 3 Mitgliedern starten, von denen jedes 2 Kerne verwendet.
Schlüsselnamen sind stets 64 Bytes lang, was einer angemessenen durchschnittlichen Schlüssellänge entspricht.
Maximaler Speicherverbrauch
- etcd kann den maximalen Speicherverbrauch erreichen, wenn ein Follower ausgefallen ist und der Leader fortlaufend Snapshots sendet.
max RSSist der höchste in 3 Durchläufen gemessene Speicherverbrauch.
| Wertgröße in Bytes | Schlüsselanzahl | Datenmenge(MB) | max. RSS(MB) | Verhältnis max. RSS/Datenmenge auf dem Leader |
|---|---|---|---|---|
| 128 | 50000 | 6 | 433 | 72x |
| 128 | 100000 | 12 | 659 | 54x |
| 128 | 200000 | 24 | 1466 | 61x |
| 1024 | 50000 | 48 | 1253 | 26x |
| 1024 | 100000 | 96 | 2344 | 24x |
| 1024 | 200000 | 192 | 4361 | 22x |
Schwellenwert für die Datenmenge
- Wenn etcd den Schwellenwert für die Datenmenge erreicht, kann es leicht zu einer Leader-Wahl kommen, und ein Teil der Vorschläge kann verworfen werden.
- In den meisten Fällen sollte der etcd-Cluster reibungslos arbeiten, solange er den Schwellenwert nicht erreicht. Arbeitet er wegen unzureichender Ressourcen nicht zuverlässig, die Datenmenge reduzieren.
| Wertgröße in Bytes | Begrenzung der Schlüsselanzahl | Empfohlener Schwellenwert für die Datenmenge(MB) | Verbrauchter RSS(MB) |
|---|---|---|---|
| 128 | 400K | 48 | 2400 |
| 1024 | 300K | 292 | 6500 |
15.5 - Benchmarks für etcd v2.2.0-rc
Physischer Rechner
GCE-Rechnertyp n1-highcpu-2
- 1x dedizierte lokale SSD, unter /var/lib/etcd eingebunden
- 1x dedizierter langsamer Datenträger für das Betriebssystem
- 1.8 GB Arbeitsspeicher
- 2x CPUs
etcd-Cluster
3 Mitglieder mit etcd 2.2.0-rc, jeweils auf einem eigenen Rechner.
Versionsdetails:
Außerdem bilden wir aus 3 Mitgliedern mit etcd 2.1.0 im Alpha-Stadium einen Cluster, um die Ausgangsleistung zu ermitteln. Der verwendete etcd-Commit ist c7146bd5 , derselbe wie im etcd-2.1-Benchmark .
Testverfahren
Einen weiteren Rechner einrichten und mit dem HTTP-Benchmarkwerkzeug hey Anfragen an jedes etcd-Mitglied senden. Eine ausführliche Anleitung enthält der Leitfaden zur Benchmark-Entwicklung .
Leistung
Einen einzelnen Schlüssel lesen
| Schlüsselgröße in Bytes | Anzahl der Clients | etcd-Zielserver | Lese-QPS | 90. Latenzperzentil (ms) |
|---|---|---|---|---|
| 64 | 1 | nur Leader | 2804 (-5%) | 0.4 (+0%) |
| 64 | 64 | nur Leader | 17816 (+0%) | 5.7 (-6%) |
| 64 | 256 | nur Leader | 18667 (-6%) | 20.4 (+2%) |
| 256 | 1 | nur Leader | 2181 (-15%) | 0.5 (+25%) |
| 256 | 64 | nur Leader | 17435 (-7%) | 6.0 (+9%) |
| 256 | 256 | nur Leader | 18180 (-8%) | 21.3 (+3%) |
| 64 | 64 | alle Server | 46965 (-4%) | 2.1 (+0%) |
| 64 | 256 | alle Server | 55286 (-6%) | 7.4 (+6%) |
| 256 | 64 | alle Server | 46603 (-6%) | 2.1 (+5%) |
| 256 | 256 | alle Server | 55291 (-6%) | 7.3 (+4%) |
Einen einzelnen Schlüssel schreiben
| Schlüsselgröße in Bytes | Anzahl der Clients | etcd-Zielserver | Schreib-QPS | 90. Latenzperzentil (ms) |
|---|---|---|---|---|
| 64 | 1 | nur Leader | 76 (+22%) | 19.4 (-15%) |
| 64 | 64 | nur Leader | 2461 (+45%) | 31.8 (-32%) |
| 64 | 256 | nur Leader | 4275 (+1%) | 69.6 (-10%) |
| 256 | 1 | nur Leader | 64 (+20%) | 16.7 (-30%) |
| 256 | 64 | nur Leader | 2385 (+30%) | 31.5 (-19%) |
| 256 | 256 | nur Leader | 4353 (-3%) | 74.0 (+9%) |
| 64 | 64 | alle Server | 2005 (+81%) | 49.8 (-55%) |
| 64 | 256 | alle Server | 4868 (+35%) | 81.5 (-40%) |
| 256 | 64 | alle Server | 1925 (+72%) | 47.7 (-59%) |
| 256 | 256 | alle Server | 4975 (+36%) | 70.3 (-36%) |
Erklärung der Leistungsänderungen
-
Die Lese-QPS sinken in den meisten Szenarien um 5~8%. Der Grund ist, dass etcd für jede Speicheroperation Speichermetriken erfasst. Diese sind für Überwachung und Fehlersuche wichtig, weshalb der Rückgang vertretbar ist.
-
Die Schreib-QPS an den Leader steigen um 20~30%. Dies liegt daran, dass wir die Raft-Hauptschleife von der Schleife zum Anwenden der Einträge entkoppeln, sodass sie sich nicht gegenseitig blockieren.
-
Die Schreib-QPS an alle Server steigen um 30~80%, weil Follower den neuesten Commit-Index früher erhalten und Vorschläge schneller festschreiben können.
15.6 - Benchmarks für etcd v2.2.0
Physische Rechner
GCE-Rechnertyp n1-highcpu-2
- 1x dedizierte lokale SSD, als etcd-Datenverzeichnis eingebunden
- 1x dedizierter langsamer Datenträger für das Betriebssystem
- 1.8 GB Arbeitsspeicher
- 2x CPUs
etcd-Cluster
3 etcd-2.2.0-Mitglieder, jeweils auf einem eigenen Rechner.
Versionsdetails:
Testverfahren
Einen weiteren Rechner außerhalb des etcd-Clusters einrichten und das HTTP-Benchmarkwerkzeug hey
mit einem Patch zur Wiederverwendung von Verbindungen ausführen, um Anfragen an jedes Clustermitglied zu senden. Die Benchmark-Anleitung
enthält den Patch und die Schritte zum Reproduzieren unserer Vorgehensweise.
Die Leistung wird aus den Ergebnissen von 100 Benchmark-Durchläufen berechnet.
Leistung
Leseleistung für einen einzelnen Schlüssel
| Schlüsselgröße in Bytes | Anzahl der Clients | etcd-Zielserver | Durchschnitt der Lese-QPS | Standardabweichung der Lese-QPS | Durchschnitt des 90. Latenzperzentils (ms) | Standardabweichung der Latenz |
|---|---|---|---|---|---|---|
| 64 | 1 | nur Leader | 2303 | 200 | 0.49 | 0.06 |
| 64 | 64 | nur Leader | 15048 | 685 | 7.60 | 0.46 |
| 64 | 256 | nur Leader | 14508 | 434 | 29.76 | 1.05 |
| 256 | 1 | nur Leader | 2162 | 214 | 0.52 | 0.06 |
| 256 | 64 | nur Leader | 14789 | 792 | 7.69 | 0.48 |
| 256 | 256 | nur Leader | 14424 | 512 | 29.92 | 1.42 |
| 64 | 64 | alle Server | 45752 | 2048 | 2.47 | 0.14 |
| 64 | 256 | alle Server | 46592 | 1273 | 10.14 | 0.59 |
| 256 | 64 | alle Server | 45332 | 1847 | 2.48 | 0.12 |
| 256 | 256 | alle Server | 46485 | 1340 | 10.18 | 0.74 |
Schreibleistung für einen einzelnen Schlüssel
| Schlüsselgröße in Bytes | Anzahl der Clients | etcd-Zielserver | Durchschnitt der Schreib-QPS | Standardabweichung der Schreib-QPS | Durchschnitt des 90. Latenzperzentils (ms) | Standardabweichung der Latenz |
|---|---|---|---|---|---|---|
| 64 | 1 | nur Leader | 55 | 4 | 24.51 | 13.26 |
| 64 | 64 | nur Leader | 2139 | 125 | 35.23 | 3.40 |
| 64 | 256 | nur Leader | 4581 | 581 | 70.53 | 10.22 |
| 256 | 1 | nur Leader | 56 | 4 | 22.37 | 4.33 |
| 256 | 64 | nur Leader | 2052 | 151 | 36.83 | 4.20 |
| 256 | 256 | nur Leader | 4442 | 560 | 71.59 | 10.03 |
| 64 | 64 | alle Server | 1625 | 85 | 58.51 | 5.14 |
| 64 | 256 | alle Server | 4461 | 298 | 89.47 | 36.48 |
| 256 | 64 | alle Server | 1599 | 94 | 60.11 | 6.43 |
| 256 | 256 | alle Server | 4315 | 193 | 88.98 | 7.01 |
Leistungsänderungen
-
Da etcd jetzt für jeden API-Aufruf Metriken erfasst, scheinen die Lese-QPS in den meisten Szenarien geringfügig zu sinken. Angesichts der umfangreichen Informationen für Überwachung und Fehlersuche wurde dieser minimale Leistungsverlust als vertretbar eingeschätzt.
-
Die Schreib-QPS an Cluster-Leader scheinen leicht gestiegen zu sein. Ursache ist die Entkopplung der Hauptschleife von den Schleifen zum Anwenden der Einträge in der Raft-Logik von etcd. Dadurch entfallen mehrere gegenseitige Blockierungen.
-
Die Schreib-QPS an alle Mitglieder scheinen erheblich gestiegen zu sein, weil Follower den neuesten Commit-Index jetzt früher erhalten und Vorschläge schneller festschreiben.
15.7 - Benchmarks für etcd v2.1.0
Physische Rechner
GCE-Rechnertyp n1-highcpu-2
- 1x dedizierte lokale SSD, unter /var/lib/etcd eingebunden
- 1x dedizierter langsamer Datenträger für das Betriebssystem
- 1.8 GB Arbeitsspeicher
- 2x CPUs
- etcd-Version 2.1.0 alpha
etcd-Cluster
3 etcd-Mitglieder, jeweils auf einem eigenen Rechner
Testverfahren
Einen weiteren Rechner einrichten und mit dem HTTP-Benchmarkwerkzeug hey Anfragen an jedes etcd-Mitglied senden. Eine ausführliche Anleitung enthält der Leitfaden zur Benchmark-Entwicklung .
Leistung
Einen einzelnen Schlüssel lesen
| Schlüsselgröße in Bytes | Anzahl der Clients | etcd-Zielserver | Lese-QPS | 90. Latenzperzentil (ms) |
|---|---|---|---|---|
| 64 | 1 | nur Leader | 1534 | 0.7 |
| 64 | 64 | nur Leader | 10125 | 9.1 |
| 64 | 256 | nur Leader | 13892 | 27.1 |
| 256 | 1 | nur Leader | 1530 | 0.8 |
| 256 | 64 | nur Leader | 10106 | 10.1 |
| 256 | 256 | nur Leader | 14667 | 27.0 |
| 64 | 64 | alle Server | 24200 | 3.9 |
| 64 | 256 | alle Server | 33300 | 11.8 |
| 256 | 64 | alle Server | 24800 | 3.9 |
| 256 | 256 | alle Server | 33000 | 11.5 |
Einen einzelnen Schlüssel schreiben
| Schlüsselgröße in Bytes | Anzahl der Clients | etcd-Zielserver | Schreib-QPS | 90. Latenzperzentil (ms) |
|---|---|---|---|---|
| 64 | 1 | nur Leader | 60 | 21.4 |
| 64 | 64 | nur Leader | 1742 | 46.8 |
| 64 | 256 | nur Leader | 3982 | 90.5 |
| 256 | 1 | nur Leader | 58 | 20.3 |
| 256 | 64 | nur Leader | 1770 | 47.8 |
| 256 | 256 | nur Leader | 4157 | 105.3 |
| 64 | 64 | alle Server | 1028 | 123.4 |
| 64 | 256 | alle Server | 3260 | 123.8 |
| 256 | 64 | alle Server | 1033 | 121.5 |
| 256 | 256 | alle Server | 3061 | 119.3 |
16 - Downgrades
16.1 - Downgrades von etcd-Clustern und -Anwendungen
Dieser Abschnitt enthält Dokumente speziell zu Downgrades von etcd-Clustern und -Anwendungen.
Downgrade eines etcd-v3.x-Clusters
16.2 - Downgrade von etcd v3.7 auf v3.6
Im Allgemeinen kann das Downgrade von etcd v3.7 auf v3.6 als schrittweises Downgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.7-Prozesse nacheinander stoppen und durch etcd-v3.6-Prozesse ersetzen.
- Nach dem Aktivieren des Downgrades stehen dem Cluster die neuen Funktionen von v3.7 nicht mehr zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Downgrade beginnen .
Checklisten für das Downgrade
Wichtige Unterschiede zwischen v3.7 und v3.6:
Unterschiede bei Flags
v3.7 führt keine neuen Flags ein. Ein v3.6-Prozess akzeptiert daher jedes Flag einer v3.7-Konfiguration, und beim Downgrade sind keine Konfigurationsänderungen erforderlich.
Der Vergleich basiert auf den Versionen v3.7.0-rc.0 und v3.6.13. Die tatsächlichen Unterschiede hängen von Ihrer Patch-Version ab; prüfen Sie sie zunächst mit diff <(etcd-3.7/bin/etcd -h | grep \\-\\-) <(etcd-3.6/bin/etcd -h | grep \\-\\-).
Die veralteten --experimental-*-Flags, die in v3.7 entfernt wurden, sind in v3.6 noch vorhanden. Fügen Sie sie nach dem Downgrade jedoch nicht wieder hinzu; verwenden Sie ihre nicht experimentellen Gegenstücke oder --feature-gates-Einträge, die in beiden Versionen funktionieren.
Unterschiede bei Prometheus-Metriken
Checklisten für das Server-Downgrade
Downgrade-Voraussetzungen
Damit das schrittweise Downgrade reibungslos verläuft, muss der laufende Cluster fehlerfrei sein. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Downgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Downgrade in der Produktionsumgebung durchführen.
Laden Sie vor Beginn das Snapshot-Backup herunter . Falls beim Downgrade etwas schiefgeht, können Sie mit diesem Backup ein Rollback auf die bestehende etcd-Version durchführen.
Laden Sie vor Beginn das neueste Release von etcd v3.6 herunter.
Gemischte Versionen
Während des Downgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt als heruntergestuft, sobald das Downgrade mit etcdctl downgrade enable 3.6 aktiviert wurde. Intern wird die Gesamtversion des Clusters auf die Zielversion des Downgrades gesetzt, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Rollback
Erstellen Sie vor dem Downgrade Ihres etcd-Clusters ein Snapshot-Backup des Clusters und laden Sie es herunter . Mit diesem Snapshot lässt sich der Cluster bei Bedarf in seinen Zustand vor dem Downgrade zurückversetzen. Falls während des Downgrades Probleme auftreten, sollten Benutzer zunächst deren Ursache ermitteln und beheben.
Wenn das Downgrade nach Ausführung von etcdctl downgrade enable begonnen hat und sich der Cluster noch in einem Zustand mit gemischten Versionen befindet, also mindestens ein Mitglied weiterhin v3.7 verwendet, können Benutzer das laufende Downgrade durch Ausführen von etcdctl downgrade cancel abbrechen und alle heruntergestuften Mitglieder mit den ursprünglichen v3.7-Binärdateien neu starten.
Sobald alle Mitglieder auf v3.6 heruntergestuft wurden, gilt das Downgrade des Clusters als vollständig abgeschlossen. Wenn Benutzer danach zur ursprünglichen Version zurückkehren möchten, sollten sie dem offiziellen Upgrade-Leitfaden folgen, um Konsistenz zu gewährleisten und Datenbeschädigungen zu vermeiden.
Downgrade-Verfahren
Dieses Beispiel zeigt das Downgrade eines etcd-v3.7-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft. Die folgende Ausgabe stammt aus einem tatsächlichen Durchlauf mit etcd v3.7.0-rc.0 und etcd v3.6.13 auf einem einzelnen Host mit drei Loopback-Ports; der Cluster war kurz zuvor von v3.6.13 aktualisiert worden.
Schritt 1: Downgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.7.x?
Schritt 2: Snapshot-Backup vom Leader herunterladen
Laden Sie das Snapshot-Backup herunter , um das Downgrade bei Problemen rückgängig machen zu können:
Schritt 3: Zielversion des Downgrades validieren
Validieren Sie die Zielversion des Downgrades, bevor Sie das Downgrade aktivieren:
- Wir unterstützen nur Downgrades um jeweils eine Nebenversion. Ein Downgrade von v3.7 auf v3.5 ist beispielsweise nicht zulässig.
- Fahren Sie erst mit dem nächsten Schritt fort, wenn die Validierung erfolgreich war.
Schritt 4: Downgrade aktivieren
Nach dem Aktivieren des Downgrades beginnt der Cluster, das Protokoll von v3.6 zu verwenden, der Zielversion des Downgrades. Außerdem migriert etcd das Schema automatisch auf die Zielversion des Downgrades, was normalerweise sehr schnell geschieht. Prüfen Sie den Endpunktstatus und bestätigen Sie, dass die Speicherversion aller Server auf v3.6 migriert wurde, bevor Sie mit dem nächsten Schritt fortfahren.
Sobald das Downgrade aktiviert wurde, verwendet der Cluster weiterhin das Protokoll von v3.6, auch wenn auf allen Servern noch die v3.7-Binärdatei läuft, sofern das Downgrade nicht mit etcdctl downgrade cancel abgebrochen wird.
Schritt 5: Einen bestehenden etcd-Server stoppen
Prüfen Sie vor dem Stoppen des Servers, ob er der Leader ist. Wir empfehlen, den Leader zuletzt herunterzustufen. Wenn der zu stoppende Server der Leader ist, können Sie einen Teil der Ausfallzeit vermeiden, indem Sie vor dem Stoppen dieses Servers mit move-leader die Führungsrolle auf einen anderen Server übertragen.
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
Schritt 6: Den etcd-Server mit derselben Konfiguration neu starten
Starten Sie den etcd-Server mit derselben Konfiguration, aber mit der etcd-v3.6-Binärdatei neu.
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der etcd-v3.6-Binärdatei wieder fehlerfrei ist:
Anders als v3.5 meldet der Statusendpunkt von v3.6 die Downgrade-Informationen. Daher zeigen heruntergestufte Mitglieder bis zum Abschluss des Downgrades weiterhin DOWNGRADE ENABLED als true sowie ihre Speicherversion an.
Schritt 7: Schritt 5 und Schritt 6 für die übrigen Mitglieder wiederholen
Sobald alle Mitglieder heruntergestuft wurden, wird das Downgrade automatisch abgeschlossen und DOWNGRADE ENABLED auf false zurückgesetzt. Prüfen Sie den Zustand und Status des Clusters und bestätigen Sie, dass die Nebenversion aller Mitglieder und die Speicherversion v3.6 sind:
Im Protokoll des Leaders sollten Sie eine Meldung ähnlich der folgenden sehen können:
16.3 - Downgrade von etcd v3.6 auf v3.5
Im Allgemeinen kann das Downgrade von etcd v3.6 auf v3.5 als schrittweises Downgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.6-Prozesse nacheinander stoppen und durch etcd-v3.5-Prozesse ersetzen.
- Nach dem Aktivieren des Downgrades stehen dem Cluster die neuen Funktionen von v3.6 nicht mehr zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Downgrade beginnen .
Checklisten für das Downgrade
Wichtige inkompatible Änderungen von v3.6 auf v3.5:
Unterschiede bei Flags
Wenn Sie eines der folgenden Flags in Ihren v3.6-Konfigurationen verwenden, entfernen Sie es beim Downgrade auf v3.5, benennen Sie es um oder ändern Sie den Standardwert entsprechend.
Der Vergleich basiert auf den Versionen v3.6.0 und v.3.5.18. Die tatsächlichen Unterschiede hängen von Ihrer Patch-Version ab; prüfen Sie sie zunächst mit diff <(etcd-3.6/bin/etcd -h | grep \\-\\-) <(etcd-3.5/bin/etcd -h | grep \\-\\-).
Unterschiede bei Prometheus-Metriken
Checklisten für das Server-Downgrade
Downgrade-Voraussetzungen
Damit das schrittweise Downgrade reibungslos verläuft, muss der laufende Cluster fehlerfrei sein. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Downgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Downgrade in der Produktionsumgebung durchführen.
Laden Sie vor Beginn das Snapshot-Backup herunter . Falls beim Downgrade etwas schiefgeht, können Sie mit diesem Backup ein Rollback auf die bestehende etcd-Version durchführen.
Laden Sie vor Beginn das neueste Release von etcd v3.5 herunter.
Gemischte Versionen
Während des Downgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt als heruntergestuft, sobald das Downgrade mit etcdctl downgrade enable 3.5 aktiviert wurde. Intern wird die Gesamtversion des Clusters auf die Zielversion des Downgrades gesetzt, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Rollback
Erstellen Sie vor dem Downgrade Ihres etcd-Clusters ein Snapshot-Backup des Clusters und laden Sie es herunter . Mit diesem Snapshot lässt sich der Cluster bei Bedarf in seinen Zustand vor dem Downgrade zurückversetzen. Falls während des Downgrades Probleme auftreten, sollten Benutzer zunächst deren Ursache ermitteln und beheben.
Wenn das Downgrade nach Ausführung von etcdctl downgrade enable begonnen hat und sich der Cluster noch in einem Zustand mit gemischten Versionen befindet, also mindestens ein Mitglied weiterhin v3.6 verwendet, können Benutzer das laufende Downgrade durch Ausführen von etcdctl downgrade cancel abbrechen und alle heruntergestuften Mitglieder mit den ursprünglichen v3.6-Binärdateien neu starten.
Sobald alle Mitglieder auf v3.5 heruntergestuft wurden, gilt das Downgrade des Clusters als vollständig abgeschlossen. Wenn Benutzer danach zur ursprünglichen Version zurückkehren möchten, sollten sie dem offiziellen Upgrade-Leitfaden folgen, um Konsistenz zu gewährleisten und Datenbeschädigungen zu vermeiden.
Downgrade-Verfahren
Dieses Beispiel zeigt das Downgrade eines etcd-v3.6-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
Schritt 1: Downgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.6.x?
Schritt 2: Snapshot-Backup vom Leader herunterladen
Laden Sie das Snapshot-Backup herunter , um das Downgrade bei Problemen rückgängig machen zu können.
Schritt 3: Zielversion des Downgrades validieren
Validieren Sie die Zielversion des Downgrades, bevor Sie das Downgrade aktivieren:
- Wir unterstützen nur Downgrades um jeweils eine Nebenversion. Ein Downgrade von v3.6 auf v3.4 ist beispielsweise nicht zulässig.
- Fahren Sie erst mit dem nächsten Schritt fort, wenn die Validierung erfolgreich war.
Schritt 4: Downgrade aktivieren
Nach dem Aktivieren des Downgrades beginnt der Cluster, das Protokoll von v3.5 zu verwenden, der Zielversion des Downgrades. Außerdem migriert etcd das Schema automatisch auf die Zielversion des Downgrades, was normalerweise sehr schnell geschieht. Prüfen Sie den Endpunktstatus und bestätigen Sie, dass die Speicherversion aller Server auf v3.5 migriert wurde, bevor Sie mit dem nächsten Schritt fortfahren.
Sobald das Downgrade aktiviert wurde, verwendet der Cluster weiterhin das Protokoll von v3.5, auch wenn auf allen Servern noch die v3.6-Binärdatei läuft, sofern das Downgrade nicht mit etcdctl downgrade cancel abgebrochen wird.
Schritt 5: Einen bestehenden etcd-Server stoppen
Prüfen Sie vor dem Stoppen des Servers, ob er der Leader ist. Wir empfehlen, den Leader zuletzt herunterzustufen.
Wenn der zu stoppende Server der Leader ist, können Sie einen Teil der Ausfallzeit vermeiden, indem Sie vor dem Stoppen dieses Servers mit move-leader die Führungsrolle auf einen anderen Server übertragen.
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
Schritt 6: Den etcd-Server mit derselben Konfiguration neu starten (ohne die in v3.5 entfernten oder ersetzten Flags)
Starten Sie den etcd-Server mit derselben Konfiguration, aber mit der neuen etcd-Binärdatei neu.
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.5-Binärdatei wieder fehlerfrei ist:
Beim v3.5-Server wird DOWNGRADE ENABLED als false angezeigt, weil die Downgrade-Informationen im Statusendpunkt von v3.5 nicht implementiert sind. Für den Cluster ist das Downgrade zu diesem Zeitpunkt weiterhin aktiviert.
Schritt 7: Schritt 5 und Schritt 6 für die übrigen Mitglieder wiederholen
Sobald alle Mitglieder heruntergestuft wurden, prüfen Sie den Zustand und Status des Clusters und bestätigen Sie, dass die Nebenversion aller Mitglieder v3.5 und die Speicherversion leer ist:
Im Protokoll des Leaders sollten Sie eine Meldung ähnlich der folgenden sehen können:
16.4 - Downgrade von etcd 3.5 auf 3.4
Im Allgemeinen kann das Downgrade von etcd 3.5 auf 3.4 als schrittweises Downgrade ohne Ausfallzeit erfolgen:
- Die etcd-3.5-Prozesse nacheinander stoppen und durch etcd-3.4-Prozesse ersetzen.
- Sobald ein 3.4-Prozess gestartet wurde, stehen dem Cluster die neuen Funktionen von 3.5 nicht mehr zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Downgrade beginnen .
Checklisten für das Downgrade
Wenn in Ihrem Cluster die Authentifizierung aktiviert ist, wird ein schrittweises Downgrade von 3.5 nicht unterstützt, da 3.5 ein Format von WAL-Einträgen zur Authentifizierung ändert . Sie können den Anweisungen zur Authentifizierung folgen, um zunächst die Authentifizierung zu deaktivieren und alle Benutzer zu löschen.
Wichtige inkompatible Änderungen von 3.5 auf 3.4:
Unterschiede bei Flags
Wenn Sie eines der folgenden Flags in Ihren 3.5-Konfigurationen verwenden, entfernen Sie es beim Downgrade auf 3.4, benennen Sie es um oder ändern Sie den Standardwert entsprechend.
Der Vergleich basiert auf den Versionen 3.5.14 und v.3.4.33. Die tatsächlichen Unterschiede hängen von Ihrer Patch-Version ab; prüfen Sie sie zunächst mit diff <(etcd-3.5/bin/etcd -h | grep \\-\\-) <(etcd-3.4/bin/etcd -h | grep \\-\\-).
etcd --logger zap
3.4 verwendet standardmäßig --logger=capnslog, während 3.5 standardmäßig --logger=zap verwendet.
Wenn Sie weiterhin zap verwenden möchten, müssen Sie es ausdrücklich angeben.
Unterschiede bei Prometheus-Metriken
Checklisten für das Server-Downgrade
Downgrade-Voraussetzungen
Damit das schrittweise Downgrade reibungslos verläuft, muss der laufende Cluster fehlerfrei sein. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Die 3.4-Version, auf die das Downgrade erfolgen soll, muss >= 3.4.32 sein.
Vorbereitung
Testen Sie vor einem etcd-Downgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Downgrade in der Produktionsumgebung durchführen.
Laden Sie vor Beginn das Snapshot-Backup herunter
. Falls beim Downgrade etwas schiefgeht, können Sie mit diesem Backup ein Rollback
auf die bestehende etcd-Version durchführen. Beachten Sie, dass der Befehl snapshot nur die v3-Daten sichert. Informationen zu v2-Daten finden Sie unter Backup des v2-Datenspeichers
.
Laden Sie vor Beginn das neueste Release von etcd 3.4 herunter und stellen Sie sicher, dass seine Version >= 3.4.32 ist.
Gemischte Versionen
Während des Downgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt als heruntergestuft, sobald eines seiner Mitglieder auf Version 3.4 heruntergestuft wurde. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Einschränkungen
Hinweis: Wenn der Cluster nur v3-Daten und keine v2-Daten enthält, gilt diese Einschränkung nicht.
Wenn der Cluster einen v2-Datenbestand von mehr als 50MB bereitstellt, kann es bis zu zwei Minuten dauern, bis jedes neu heruntergestufte Mitglied zum bestehenden Cluster aufgeschlossen hat. Prüfen Sie die Größe eines aktuellen Snapshots, um die Gesamtdatenmenge abzuschätzen. Anders ausgedrückt ist es am sichersten, zwischen den Downgrades der einzelnen Mitglieder jeweils 2 Minuten zu warten.
Bei einer deutlich größeren Gesamtdatenmenge von 100MB oder mehr kann dieser einmalige Vorgang noch länger dauern. Administratoren sehr großer etcd-Cluster dieser Größenordnung können vor dem Downgrade das etcd-Team kontaktieren; wir beraten Sie gern zum Vorgehen.
Rollback
Wenn ein Mitglied auf 3.4 heruntergestuft wurde, wird die Cluster-Version auf 3.4 heruntergestuft, und der Betrieb ist mit „3.4“ kompatibel. Für ein Rollback müssten Sie den Anweisungen zum Upgrade von etcd 3.4 auf 3.5 folgen.
Laden Sie das Snapshot-Backup herunter , um das Downgrade auch nach einem vollständig abgeschlossenen Downgrade des Clusters rückgängig machen zu können.
Downgrade-Verfahren
Dieses Beispiel zeigt das Downgrade eines etcd-3.5-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
Schritt 1: Downgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit 3.5.x?
Schritt 2: Snapshot-Backup vom Leader herunterladen
Laden Sie das Snapshot-Backup herunter , um das Downgrade bei Problemen rückgängig machen zu können.
Schritt 3: Einen bestehenden etcd-Server stoppen
Prüfen Sie vor dem Stoppen des Servers, ob er der Leader ist.
Wenn der zu stoppende Server der Leader ist, können Sie einen Teil der Ausfallzeit vermeiden, indem Sie vor dem Stoppen dieses Servers mit move-leader die Führungsrolle auf einen anderen Server übertragen.
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
Schritt 4: Den etcd-Server mit derselben Konfiguration + --next-cluster-version-compatible neu starten
Starten Sie den etcd-Server mit derselben Konfiguration, aber mit der neuen etcd-Binärdatei und --next-cluster-version-compatible neu.
Das neue etcd 3.4 veröffentlicht seine Informationen im Cluster. Zu diesem Zeitpunkt beginnt der Cluster, das Protokoll von 3.4 zu verwenden, der niedrigsten gemeinsamen Version.
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-3.4-Binärdatei wieder fehlerfrei ist:
Noch nicht heruntergestufte Mitglieder protokollieren Informationen wie die folgenden:
Schritt 5: Schritt 3 und Schritt 4 für die übrigen Mitglieder wiederholen
Sobald alle Mitglieder heruntergestuft wurden, prüfen Sie den Zustand und die Version des Clusters:
17 - Upgrades
17.1 - Upgrades von etcd-Clustern und -Anwendungen
Dieser Abschnitt enthält Dokumente speziell zu Upgrades von etcd-Clustern und -Anwendungen.
Upgrade-Richtlinie
Beachten Sie vor einem Upgrade, dass etcd nur die folgenden beiden Upgrade-Fälle unterstützt:
- Patch-Upgrade: Upgrade zwischen Patch-Releases innerhalb derselben Nebenversion (z. B. 3.7.0 - 3.7.1).
- Upgrade der Nebenversion: Upgrade um jeweils eine Nebenversion (z. B. 3.6 - 3.7). Upgrades, die eine Nebenversion überspringen, werden nicht unterstützt und schlagen wahrscheinlich fehl. Aktualisieren Sie auf die neueste Patch-Version, bevor Sie auf die nächste Nebenversion aktualisieren.
Upgrade eines etcd-v3.x-Clusters
- Upgrade von etcd 3.0 auf 3.1
- Upgrade von etcd 3.1 auf 3.2
- Upgrade von etcd 3.2 auf 3.3
- Upgrade von etcd 3.3 auf 3.4
- Upgrade von etcd 3.4 auf 3.5
- Upgrade von etcd 3.5 auf 3.6
- Upgrade von etcd 3.6 auf 3.7
Upgrade von etcd v2.3
17.2 - Upgrade von etcd v3.6 auf v3.7
Im Allgemeinen kann das Upgrade von etcd v3.6 auf v3.7 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.6-Prozesse nacheinander stoppen und durch etcd-v3.7-Prozesse ersetzen.
- Sobald alle v3.7-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.7 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
3.6 aktualisieren
Stellen Sie vor dem Upgrade auf 3.7 sicher, dass alle Ihre 3.6-Mitglieder auf 3.6.11 oder höher aktualisiert sind. Frühere 3.6-Patch-Releases sind möglicherweise nicht mit einem Rolling Upgrade auf 3.7 kompatibel.
V2-Speicher
Der v2-Speicher wurde in v3.7 vollständig entfernt. Die v2-HTTP-API (--enable-v2), die v2-auf-v3-Emulation (--experimental-enable-v2v3), der v2-Discovery-Dienst, das Paket client/v2 und das Laden von v2-Snapshot-Dateien sind sämtlich entfallen. Siehe die Verweise auf inkompatible Änderungen in CHANGELOG-3.7
.
Wenn Sie von einem 3.6-Cluster aktualisieren, sind diese Flags bereits nicht mehr vorhanden, und es sind keine Maßnahmen erforderlich. Wenn Sie von einem älteren Release mit benutzerdefinierten v2-Daten wechseln, folgen Sie vor dem Upgrade dem v2-Migrationsleitfaden .
Go-Refactoring
v3.7 enthält umfangreiche interne Umstrukturierungen, die normale Upgrades nicht betreffen, bei Upgrades benutzerdefinierter Integrationen jedoch berücksichtigt werden sollten:
- Migration von
gogo/protobufzur Standardimplementierunggoogle.golang.org/protobuf(verfolgt in #14533 ). - Migration der veralteten Bibliotheken für Protokollierung und Tags aus
go-grpc-middlewarev1 zu den v2-Interceptors (#20420 ). - Die OpenTelemetry-gRPC-Interceptors wurden auf
otelgrpcv0.61.0 aktualisiert; dabei wurden die veraltetenUnaryServerInterceptorundStreamServerInterceptordurchNewServerHandlerersetzt (#20017 ).
Wenn Sie etcd als Bibliothek einbetten, gegen die clientv3-API bauen oder von internen Paketen abhängen, prüfen Sie vor dem Upgrade das Änderungsprotokoll
.
Entfernte Flags
Alle veralteten --experimental-*-Flags wurden in v3.7 entfernt (#19959
). In v3.6 wurde jedes davon entweder durch ein gleichnamiges nicht experimentelles Flag oder durch einen --feature-gates-Eintrag ersetzt. Wenn Sie noch eines dieser Flags gesetzt haben, ersetzen Sie es vor dem Rolling Upgrade auf v3.7 durch die entsprechende v3.6-Variante; andernfalls kann der v3.7-Prozess nicht starten.
Die Zuordnung jedes entfernten Flags zu seinem nicht experimentellen Gegenstück oder --feature-gates-Eintrag finden Sie im Upgrade-Leitfaden von v3.5 auf v3.6
.
Hinzugefügte Flags
Keine.
Flags mit neuen Standardwerten
Keine.
Checklisten für das Server-Upgrade
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf v3.7 zu aktualisieren, muss der laufende Cluster v3.6.11 oder höher verwenden. Falls er eine ältere Nebenversion verwendet, führen Sie zunächst ein Upgrade auf v3.6 durch; etcd unterstützt nur Upgrades um jeweils eine Nebenversion.
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Laden Sie vor Beginn das Snapshot-Backup herunter . Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Rollback auf die bestehende etcd-Version durchführen.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version v3.7 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Rollback
Erstellen Sie vor dem Upgrade Ihres etcd-Clusters ein Snapshot-Backup des Clusters und laden Sie es herunter . Mit diesem Snapshot lässt sich der Cluster bei Bedarf in seinen Zustand vor dem Upgrade zurückversetzen. Falls während des Upgrades Probleme auftreten, sollten Benutzer zunächst deren Ursache ermitteln und beheben. Solange sich der Cluster noch in einem Zustand mit gemischten Versionen befindet, also mindestens ein Mitglied weiterhin v3.6 verwendet, können sie entweder die Binärdatei oder das Image durch die alte Version v3.6 ersetzen oder den Cluster direkt aus dem Snapshot wiederherstellen. In diesem gemischten Zustand arbeitet der Cluster weiterhin als v3.6-Cluster, sodass ein Rollback ohne formelles Downgrade-Verfahren möglich ist.
Sobald jedoch alle Mitglieder auf v3.7 aktualisiert wurden, gilt der Cluster als vollständig aktualisiert, und ein Rollback durch Austausch der Binärdateien ist nicht mehr möglich. Falls das Upgrade schiefgeht, bestehen in diesem Fall die einzigen Recovery-Möglichkeiten darin, den vor dem Upgrade erstellten Snapshot wiederherzustellen oder dem offiziellen Downgrade-Leitfaden zu folgen.
Upgrade-Verfahren
Dieses Beispiel zeigt das Upgrade eines etcd-v3.6-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft. Die folgende Ausgabe stammt aus einem tatsächlichen Durchlauf mit etcd v3.6.12 und etcd v3.7.0-rc.0 auf einem einzelnen Host mit drei Loopback-Ports.
Schritt 1: Upgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.6.11 oder höher?
Schritt 2: Snapshot-Backup vom Leader herunterladen
Laden Sie das Snapshot-Backup herunter , um bei Problemen ein Downgrade durchführen zu können.
Der etcd-Leader enthält garantiert die neuesten Anwendungsdaten. Rufen Sie den Snapshot daher vom Leader ab:
Schritt 3: Einen bestehenden etcd-Server stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde. Der Leader überträgt die Führungsrolle, bevor er sich beendet:
Schritt 4: Den etcd-Server mit derselben Konfiguration neu starten
Starten Sie den etcd-Server mit derselben Konfiguration, aber mit der neuen etcd-Binärdatei neu.
Das neue etcd v3.7 veröffentlicht seine Informationen im Cluster. Zu diesem Zeitpunkt verwendet der Cluster weiterhin das Protokoll von v3.6, der niedrigsten gemeinsamen Version.
{"level":"info","ts":"2026-06-02T07:01:58.920780+0300","caller":"membership/cluster.go:296","msg":"set cluster version from store","cluster-version":"3.6"}
{"level":"info","ts":"2026-06-02T07:01:58.979186+0300","caller":"etcdserver/server.go:1828","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","cluster-id":"7dee9ba76d59ed53","publish-timeout":"7s"}
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.7-Binärdatei wieder fehlerfrei ist:
Noch nicht aktualisierte Mitglieder und das aktualisierte Mitglied protokollieren Meldungen zum Zustand mit gemischten Versionen, bis der gesamte Cluster aktualisiert wurde. Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.7 aktualisiert wurden.
Schritt 5: Schritt 3 und Schritt 4 für die übrigen Mitglieder wiederholen
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf v3.7:
{"level":"info","ts":"2026-06-02T07:02:36.054783+0300","caller":"etcdserver/server.go:2311","msg":"updating cluster version using v3 API","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059345+0300","caller":"membership/cluster.go:593","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059409+0300","caller":"etcdserver/server.go:2326","msg":"cluster version is updated","cluster-version":"3.7"}
17.3 - Upgrade von etcd v3.5 auf v3.6
Im Allgemeinen kann das Upgrade von etcd v3.5 auf v3.6 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.5-Prozesse nacheinander stoppen und durch etcd-v3.6-Prozesse ersetzen.
- Sobald alle v3.6-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.6 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
3.5 aktualisieren
Stellen Sie vor dem Upgrade auf 3.6 sicher, dass alle Ihre 3.5-Mitglieder auf 3.5.32 oder höher aktualisiert sind
. Die Patch-Releases 3.5.24 bis 3.5.26 beheben mehrere mögliche Upgrade-Hindernisse; 3.5.32
ergänzt --v2-deprecation=write-only-skip-check und erweitert etcdutl check v2store um die Prüfung von WAL-Einträgen zusätzlich zum v2-Snapshot.
V2-Speicher
Wenn das Flag --enable-v2 nicht konfiguriert oder auf false gesetzt ist, sind keine weiteren Maßnahmen erforderlich.
Wenn --enable-v2 konfiguriert ist, führen Sie den Befehl etcdutl check v2store aus, um zu prüfen, ob der v2store Daten enthält, die nicht zur Mitgliedschaft gehören (benutzerdefinierte Daten). Sind keine benutzerdefinierten Daten vorhanden, kann das Flag gefahrlos entfernt werden. Andernfalls finden Sie weitere Einzelheiten im v2-Migrationsleitfaden
.
Hinzugefügte Flags
Entfernte Flags
Veraltete Flags
Das Flag etcd --experimental-bootstrap-defrag-threshold-megabytes ist veraltet.
Das Flag etcd --experimental-compaction-batch-limit ist veraltet.
Das Flag etcd --experimental-compact-hash-check-time ist veraltet.
Das Flag etcd --experimental-compaction-sleep-interval ist veraltet.
Das Flag etcd --experimental-corrupt-check-time ist veraltet.
Das Flag etcd --experimental-enable-distributed-tracing ist veraltet.
Das Flag etcd --experimental-distributed-tracing-address ist veraltet.
Das Flag etcd --experimental-distributed-tracing-instance-id ist veraltet.
Das Flag etcd --experimental-distributed-tracing-sampling-rate ist veraltet.
Das Flag etcd --experimental-distributed-tracing-service-name ist veraltet.
Das Flag etcd --experimental-downgrade-check-time ist veraltet.
Das Flag etcd --experimental-max-learners ist veraltet.
Das Flag etcd --experimental-memory-mlock ist veraltet.
Das Flag etcd --experimental-peer-skip-client-san-verification ist veraltet.
Das Flag etcd --experimental-snapshot-catchup-entries ist veraltet.
Das Flag etcd --experimental-warning-apply-duration ist veraltet.
Das Flag etcd --experimental-warning-unary-request-duration ist veraltet.
Das Flag etcd --experimental-watch-progress-notify-interval ist veraltet.
Experimentelle v3.5-Flags durch Funktionsschalter ersetzen
Entsprechender Funktionsschalter für etcd --experimental-compact-hash-check-enabled=true
Entsprechender Funktionsschalter für etcd --experimental-initial-corrupt-check=true
Entsprechender Funktionsschalter für etcd --experimental-enable-lease-checkpoint=true
Entsprechender Funktionsschalter für etcd --experimental-enable-lease-checkpoint-persist=true
Entsprechender Funktionsschalter für etcd --experimental-stop-grpc-service-on-defrag=true
Entsprechender Funktionsschalter für etcd --experimental-txn-mode-write-with-shared-buffer=false
Flags mit neuen Standardwerten
Ursprüngliches Standard-Flag etcd --snapshot-count=100000
Ursprüngliches Standard-Flag etcd --v2-deprecation='not-yet'
Ursprüngliches Standard-Flag etcd --discovery-fallback='proxy'
Unterschiede bei Prometheus-Metriken
Checklisten für das Server-Upgrade
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf v3.6 zu aktualisieren, muss der laufende Cluster Version v3.5 oder höher verwenden. Falls er eine ältere Version als v3.5 verwendet, führen Sie vor dem Upgrade auf v3.6 zunächst ein Upgrade auf v3.5 durch.
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Laden Sie vor Beginn das Snapshot-Backup herunter
. Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Rollback
auf die bestehende etcd-Version durchführen. Beachten Sie, dass der Befehl snapshot nur die v3-Daten sichert.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version v3.6 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Rollback
Erstellen Sie vor dem Upgrade Ihres etcd-Clusters ein Snapshot-Backup des Clusters und laden Sie es herunter . Mit diesem Snapshot lässt sich der Cluster bei Bedarf in seinen Zustand vor dem Upgrade zurückversetzen. Falls während des Upgrades Probleme auftreten, sollten Benutzer zunächst deren Ursache ermitteln und beheben. Solange sich der Cluster noch in einem Zustand mit gemischten Versionen befindet, also mindestens ein Mitglied weiterhin v3.5 verwendet, können sie entweder die Binärdatei oder das Image durch die alte Version v3.5 ersetzen oder den Cluster direkt aus dem Snapshot wiederherstellen. In diesem gemischten Zustand arbeitet der Cluster weiterhin als v3.5-Cluster, sodass ein Rollback ohne formelles Downgrade-Verfahren möglich ist.
Sobald jedoch alle Mitglieder auf v3.6 aktualisiert wurden, gilt der Cluster als vollständig aktualisiert. Der bloße Austausch der Binärdateien ist dann kein gültiges Rollback-Verfahren mehr. Für die Recovery kann entweder der vor dem Upgrade erstellte Snapshot wiederhergestellt oder der offizielle Downgrade-Leitfaden befolgt werden, um zur ursprünglichen Version zurückzukehren und dabei Konsistenz zu gewährleisten sowie Datenbeschädigungen zu vermeiden.
Upgrade-Verfahren
Dieses Beispiel zeigt das Upgrade eines etcd-v3.5-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
Schritt 1: Upgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.5.x?
Schritt 2: Snapshot-Backup vom Leader herunterladen
Laden Sie das Snapshot-Backup herunter , um bei Problemen ein Downgrade durchführen zu können.
Der etcd-Leader enthält garantiert die neuesten Anwendungsdaten. Rufen Sie den Snapshot daher vom Leader ab:
Schritt 3: Einen bestehenden etcd-Server stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
Schritt 4: Den etcd-Server mit derselben Konfiguration neu starten
Starten Sie den etcd-Server mit derselben Konfiguration, aber mit der neuen etcd-Binärdatei neu.
Das neue etcd v3.6 veröffentlicht seine Informationen im Cluster. Zu diesem Zeitpunkt verwendet der Cluster weiterhin das Protokoll von v3.5, der niedrigsten gemeinsamen Version.
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.889+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"bf9071f4639c75cc","from":"3.0","to":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.894+0530","caller":"etcdserver/server.go:1686","msg":"published local member to cluster through raft","local-member-id":"bf9071f4639c75cc","local-member-attributes":"{Name:node1 ClientURLs:[http://127.0.0.1:2379]}","cluster-id":"59a05384c9b79ee","publish-timeout":"7s"}
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.6-Binärdatei wieder fehlerfrei ist:
Noch nicht aktualisierte Mitglieder protokollieren Warnungen wie die folgenden, bis der gesamte Cluster aktualisiert wurde.
Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.6 aktualisiert wurden:
Schritt 5: Schritt 3 und Schritt 4 für die übrigen Mitglieder wiederholen
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf v3.6:
Mitglied 1:
{"level":"info","ts":"2025-03-01T04:58:32.375+0530","caller":"etcdserver/server.go:2149","msg":"updating cluster version using v3 API","from":"3.5","to":"3.6"}{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"etcdserver/server.go:2164","msg":"cluster version is updated","cluster-version":"3.6"}
Mitglied 2:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"91bc3c398fb3c146","from":"3.5","to":"3.6"}
Mitglied 3:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"fd422379fda50e48","from":"3.5","to":"3.6"}
17.4 - Upgrade von etcd 3.4 auf 3.5
Im Allgemeinen kann das Upgrade von etcd 3.4 auf 3.5 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.4-Prozesse nacheinander stoppen und durch etcd-v3.5-Prozesse ersetzen.
- Sobald alle v3.5-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.5 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
Bei der Migration von v2 ohne v3-Daten
löst der etcd-Server v3.2+ eine Panic aus, wenn etcd aus vorhandenen Snapshots wiederhergestellt wird, aber keine v3-Datei ETCD_DATA_DIR/member/snap/db vorhanden ist. Dies tritt auf, wenn der Server von v2 migriert wurde, ohne zuvor v3-Daten zu enthalten. Dadurch wird auch ein versehentlicher Verlust von v3-Daten verhindert (z. B. könnte die Datei db verschoben worden sein). etcd verlangt, dass weitere Migrationen nach der Migration auf v3 nur mit v3-Daten erfolgen können. Führen Sie kein Upgrade auf neuere v3-Versionen durch, bevor der v3.0-Server v3-Daten enthält.
Wenn in Ihrem Cluster die Authentifizierung aktiviert ist, wird ein Rolling Upgrade von 3.4 oder einer älteren Version nicht unterstützt, da 3.5 ein Format von WAL-Einträgen zur Authentifizierung ändert .
Wichtige inkompatible Änderungen in 3.5.
Veraltete Prometheus-Metrik etcd_debugging_mvcc_db_total_size_in_bytes
v3.5 hat die Prometheus-Metrik etcd_debugging_mvcc_db_total_size_in_bytes in etcd_mvcc_db_total_size_in_bytes überführt, um die Überwachung des etcd-Speichers zu fördern. Außerdem stuft v3.5 etcd_debugging_mvcc_db_total_size_in_bytes vollständig als veraltet ein.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Veraltete Prometheus-Metrik etcd_debugging_mvcc_put_total
v3.5 hat die Prometheus-Metrik etcd_debugging_mvcc_put_total in etcd_mvcc_put_total überführt, um die Überwachung des etcd-Speichers zu fördern. Außerdem stuft v3.5 etcd_debugging_mvcc_put_total vollständig als veraltet ein.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Veraltete Prometheus-Metrik etcd_debugging_mvcc_delete_total
v3.5 hat die Prometheus-Metrik etcd_debugging_mvcc_delete_total in etcd_mvcc_delete_total überführt, um die Überwachung des etcd-Speichers zu fördern. Außerdem stuft v3.5 etcd_debugging_mvcc_delete_total vollständig als veraltet ein.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Veraltete Prometheus-Metrik etcd_debugging_mvcc_txn_total
v3.5 hat die Prometheus-Metrik etcd_debugging_mvcc_txn_total in etcd_mvcc_txn_total überführt, um die Überwachung des etcd-Speichers zu fördern. Außerdem stuft v3.5 etcd_debugging_mvcc_txn_total vollständig als veraltet ein.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Veraltete Prometheus-Metrik etcd_debugging_mvcc_range_total
v3.5 hat die Prometheus-Metrik etcd_debugging_mvcc_range_total in etcd_mvcc_range_total überführt, um die Überwachung des etcd-Speichers zu fördern. Außerdem stuft v3.5 etcd_debugging_mvcc_range_total vollständig als veraltet ein.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
etcd --logger capnslog ist veraltet
v3.5 verwendet standardmäßig --logger=zap, um mehrere Protokollausgaben und strukturierte Protokollierung zu unterstützen.
etcd --logger=capnslog ist seit v3.5 veraltet, und jetzt ist --logger=zap der Standard.
v3.4 unterstützt zusätzlich etcd --logger=zap für strukturierte Protokollierung und mehrere Protokollausgaben. Das Hauptziel ist, die automatisierte Überwachung von etcd zu fördern, statt erst bei auftretenden Fehlern die Serverprotokolle durchzusehen. Die künftige Entwicklung soll die Protokollausgabe von etcd auf ein Minimum reduzieren und die Überwachung mit Metriken und Alarmen erleichtern. etcd --logger=capnslog wird in v3.5 als veraltet eingestuft.
etcd --log-output ist veraltet
v3.4 hat etcd --log-output in --log-outputs umbenannt
, um mehrere Protokollausgaben zu unterstützen.
etcd --log-output ist seit v3.5 veraltet.
Veraltetes Flag etcd --debug (jetzt --log-level=debug)
Das Flag etcd --debug ist veraltet.
etcd --log-package-levels ist veraltet
Das Flag etcd --log-package-levels für capnslog ist veraltet.
Jetzt ist etcd --logger=zap der Standard.
[CLIENT-URL]/config/local/log ist veraltet
Der Endpunkt /config/local/log wird in v3.5 als veraltet eingestuft, ebenso das Flag etcd --log-package-levels.
Geänderte HTTP-Endpunkte des gRPC-Gateways (/v3beta ist veraltet)
Vorher
Nachher
/v3beta wurde im Release 3.5 entfernt.
Checklisten für das Server-Upgrade
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf 3.5 zu aktualisieren, muss der laufende Cluster Version 3.4 oder höher verwenden. Falls er eine ältere Version als 3.4 verwendet, führen Sie vor dem Upgrade auf 3.5 zunächst ein Upgrade auf 3.4 durch.
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Laden Sie vor Beginn das Snapshot-Backup herunter
. Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Downgrade
auf die bestehende etcd-Version durchführen. Beachten Sie, dass der Befehl snapshot nur die v3-Daten sichert. Informationen zu v2-Daten finden Sie unter Backup des v2-Datenspeichers
.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version 3.5 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Einschränkungen
Hinweis: Wenn der Cluster nur v3-Daten und keine v2-Daten enthält, gilt diese Einschränkung nicht.
Wenn der Cluster einen v2-Datenbestand von mehr als 50MB bereitstellt, kann es bis zu zwei Minuten dauern, bis jedes neu aktualisierte Mitglied zum bestehenden Cluster aufgeschlossen hat. Prüfen Sie die Größe eines aktuellen Snapshots, um die Gesamtdatenmenge abzuschätzen. Anders ausgedrückt ist es am sichersten, zwischen den Upgrades der einzelnen Mitglieder jeweils 2 Minuten zu warten.
Bei einer deutlich größeren Gesamtdatenmenge von 100MB oder mehr kann dieser einmalige Vorgang noch länger dauern. Administratoren sehr großer etcd-Cluster dieser Größenordnung können vor dem Upgrade das etcd-Team kontaktieren; wir beraten Sie gern zum Vorgehen.
Downgrade
Wenn alle Mitglieder auf v3.5 aktualisiert wurden, wird der Cluster auf v3.5 aktualisiert; ein Downgrade aus diesem abgeschlossenen Zustand ist nicht möglich. Solange jedoch noch ein einziges Mitglied v3.4 verwendet, bleiben der Cluster und sein Betrieb auf „v3.4“. Aus diesem Zustand mit gemischten Versionen ist es möglich, auf allen Mitgliedern wieder eine etcd-v3.4-Binärdatei zu verwenden.
Laden Sie das Snapshot-Backup herunter , um ein Downgrade des Clusters auch nach einem vollständig abgeschlossenen Upgrade zu ermöglichen.
Upgrade-Verfahren
Dieses Beispiel zeigt das Upgrade eines etcd-v3.4-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
Schritt 1: Upgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.4.x?
Schritt 2: Snapshot-Backup vom Leader herunterladen
Laden Sie das Snapshot-Backup herunter , um bei Problemen ein Downgrade durchführen zu können.
Der etcd-Leader enthält garantiert die neuesten Anwendungsdaten. Rufen Sie den Snapshot daher vom Leader ab:
Schritt 3: Einen bestehenden etcd-Server stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
Schritt 4: Den etcd-Server mit derselben Konfiguration neu starten
Starten Sie den etcd-Server mit derselben Konfiguration, aber mit der neuen etcd-Binärdatei neu.
Das neue etcd v3.5 veröffentlicht seine Informationen im Cluster. Zu diesem Zeitpunkt verwendet der Cluster weiterhin das Protokoll von v3.4, der niedrigsten gemeinsamen Version.
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.4"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.5-Binärdatei wieder fehlerfrei ist:
Noch nicht aktualisierte Mitglieder protokollieren Warnungen wie die folgenden, bis der gesamte Cluster aktualisiert wurde.
Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.5 aktualisiert wurden:
Schritt 5: Schritt 3 und Schritt 4 für die übrigen Mitglieder wiederholen
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf 3.5:
Mitglied 1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.5"}
Mitglied 2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
Mitglied 3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
17.5 - Upgrade von etcd 3.3 auf 3.4
Im Allgemeinen kann das Upgrade von etcd 3.3 auf 3.4 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.3-Prozesse nacheinander stoppen und durch etcd-v3.4-Prozesse ersetzen.
- Sobald alle v3.4-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.4 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
Bei der Migration von v2 ohne v3-Daten
löst der etcd-Server v3.2+ eine Panic aus, wenn etcd aus vorhandenen Snapshots wiederhergestellt wird, aber keine v3-Datei ETCD_DATA_DIR/member/snap/db vorhanden ist. Dies tritt auf, wenn der Server von v2 migriert wurde, ohne zuvor v3-Daten zu enthalten. Dadurch wird auch ein versehentlicher Verlust von v3-Daten verhindert (z. B. könnte die Datei db verschoben worden sein). etcd verlangt, dass weitere Migrationen nach der Migration auf v3 nur mit v3-Daten erfolgen können. Führen Sie kein Upgrade auf neuere v3-Versionen durch, bevor der v3.0-Server v3-Daten enthält.
Wichtige inkompatible Änderungen in 3.4.
ETCDCTL_API=3 etcdctl wird zum Standard
ETCDCTL_API=3 ist jetzt der Standard.
etcd --enable-v2=false wird zum Standard
etcd --enable-v2=false
ist jetzt der Standard.
Das bedeutet, dass der etcd-v3.4-Server keine v2-API-Anfragen bedient, sofern nicht etcd --enable-v2=true angegeben wird.
Wenn die v2-API verwendet wurde, aktivieren Sie die v2-API unbedingt in v3.4:
Andere HTTP-APIs funktionieren weiterhin (z. B. [CLIENT-URL]/metrics, [CLIENT-URL]/health, v3-gRPC-Gateway).
Veraltete Flags etcd --ca-file und etcd --peer-ca-file
Die Flags --ca-file und --peer-ca-file sind veraltet; sie sind bereits seit v2.1 veraltet.
Beachten Sie, dass das Setzen dieses Parameters auch die Client-Zertifikatsauthentifizierung automatisch aktiviert, unabhängig vom Wert von --client-cert-auth.
Veralteter Fehler grpc.ErrClientConnClosing
grpc.ErrClientConnClosing ist seit gRPC >= 1.10 veraltet
.
grpc.WithBlock für den Verbindungsaufbau des Clients erforderlich
Der neue Client-Balancer
verwendet einen asynchronen Resolver, um Endpunkte an die gRPC-Funktion zum Verbindungsaufbau zu übergeben. Daher benötigt der v3.4-Client die Option grpc.WithBlock beim Verbindungsaufbau, um zu warten, bis die zugrunde liegende Verbindung hergestellt ist.
Prometheus-Metrik etcd_debugging_mvcc_db_total_size_in_bytes wird als veraltet eingestuft
v3.4 überführt die Prometheus-Metrik etcd_debugging_mvcc_db_total_size_in_bytes in etcd_mvcc_db_total_size_in_bytes, um die Überwachung des etcd-Speichers zu fördern.
etcd_debugging_mvcc_db_total_size_in_bytes wird in v3.4 aus Gründen der Abwärtskompatibilität weiterhin bereitgestellt. In v3.5 wird sie vollständig als veraltet eingestuft.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Prometheus-Metrik etcd_debugging_mvcc_put_total wird als veraltet eingestuft
v3.4 überführt die Prometheus-Metrik etcd_debugging_mvcc_put_total in etcd_mvcc_put_total, um die Überwachung des etcd-Speichers zu fördern.
etcd_debugging_mvcc_put_total wird in v3.4 aus Gründen der Abwärtskompatibilität weiterhin bereitgestellt. In v3.5 wird sie vollständig als veraltet eingestuft.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Prometheus-Metrik etcd_debugging_mvcc_delete_total wird als veraltet eingestuft
v3.4 überführt die Prometheus-Metrik etcd_debugging_mvcc_delete_total in etcd_mvcc_delete_total, um die Überwachung des etcd-Speichers zu fördern.
etcd_debugging_mvcc_delete_total wird in v3.4 aus Gründen der Abwärtskompatibilität weiterhin bereitgestellt. In v3.5 wird sie vollständig als veraltet eingestuft.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Prometheus-Metrik etcd_debugging_mvcc_txn_total wird als veraltet eingestuft
v3.4 überführt die Prometheus-Metrik etcd_debugging_mvcc_txn_total in etcd_mvcc_txn_total, um die Überwachung des etcd-Speichers zu fördern.
etcd_debugging_mvcc_txn_total wird in v3.4 aus Gründen der Abwärtskompatibilität weiterhin bereitgestellt. In v3.5 wird sie vollständig als veraltet eingestuft.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Prometheus-Metrik etcd_debugging_mvcc_range_total wird als veraltet eingestuft
v3.4 überführt die Prometheus-Metrik etcd_debugging_mvcc_range_total in etcd_mvcc_range_total, um die Überwachung des etcd-Speichers zu fördern.
etcd_debugging_mvcc_range_total wird in v3.4 aus Gründen der Abwärtskompatibilität weiterhin bereitgestellt. In v3.5 wird sie vollständig als veraltet eingestuft.
Beachten Sie, dass Metriken im Namensraum etcd_debugging_* als experimentell gekennzeichnet sind. Im Zuge der Verbesserung des Überwachungsleitfadens können wir weitere Metriken hochstufen.
Flag etcd --log-output wird als veraltet eingestuft (jetzt --log-outputs)
etcd --log-output wird in --log-outputs umbenannt
, um mehrere Protokollausgaben zu unterstützen. etcd --logger=capnslog unterstützt nicht mehrere Protokollausgaben.
etcd --log-output wird in v3.5 als veraltet eingestuft. etcd --logger=capnslog wird in v3.5 als veraltet eingestuft.
v3.4 unterstützt zusätzlich etcd --logger=zap --log-outputs=stderr für strukturierte Protokollierung und mehrere Protokollausgaben. Das Hauptziel ist, die automatisierte Überwachung von etcd zu fördern, statt erst bei auftretenden Fehlern die Serverprotokolle durchzusehen. Die künftige Entwicklung soll die Protokollausgabe von etcd auf ein Minimum reduzieren und die Überwachung mit Metriken und Alarmen erleichtern. etcd --logger=capnslog wird in v3.5 als veraltet eingestuft.
Feldtyp von log-outputs in etcd --config-file in []string geändert
Da log-outputs (früherer Feldname log-output) jetzt mehrere Ausgabeziele akzeptiert, muss das Feld log-outputs in der YAML-Konfigurationsdatei von etcd wie unten gezeigt auf den Typ []string geändert werden:
embed.Config.LogOutput in embed.Config.LogOutputs umbenannt
embed.Config.LogOutput wurde in embed.Config.LogOutputs umbenannt
, um mehrere Protokollausgaben zu unterstützen. Außerdem wurde der Typ von embed.Config.LogOutput von string in []string geändert
, um mehrere Protokollausgaben zu unterstützen.
v3.5 stuft capnslog als veraltet ein
v3.5 wird das Flag etcd --log-package-levels für capnslog als veraltet einstufen; etcd --logger=zap --log-outputs=stderr wird zum Standard. v3.5 wird den Endpunkt [CLIENT-URL]/config/local/log als veraltet einstufen.
Flag etcd --debug wird als veraltet eingestuft (jetzt --log-level=debug)
v3.4 stuft das Flag etcd --debug
als veraltet ein. Verwenden Sie stattdessen das Flag etcd --log-level=debug.
Veraltetes Feld pkg/transport.TLSInfo.CAFile
Das Feld pkg/transport.TLSInfo.CAFile ist veraltet.
embed.Config.SnapCount in embed.Config.SnapshotCount geändert
Zur Übereinstimmung mit dem Flag-Namen etcd --snapshot-count wurde das Feld embed.Config.SnapCount in embed.Config.SnapshotCount umbenannt:
etcdserver.ServerConfig.SnapCount in etcdserver.ServerConfig.SnapshotCount geändert
Zur Übereinstimmung mit dem Flag-Namen etcd --snapshot-count wurde das Feld etcdserver.ServerConfig.SnapCount in etcdserver.ServerConfig.SnapshotCount umbenannt:
Geänderte Funktionssignatur im Paket wal
Die Funktionssignaturen von wal wurden geändert, um einen strukturierten Logger zu unterstützen.
Geänderter Typ IntervalTree im Paket pkg/adt
pkg/adt.IntervalTree ist jetzt als interface definiert.
embed.Config.SetupLogging ist veraltet
embed.Config.SetupLogging wurde entfernt, um fehlerhafte Protokollierungskonfigurationen zu verhindern; die Einrichtung erfolgt jetzt automatisch.
Geänderte HTTP-Endpunkte des gRPC-Gateways (/v3beta durch /v3 ersetzt)
Vorher
Nachher
Anfragen an /v3beta-Endpunkte werden an /v3 umgeleitet; /v3beta wird im Release 3.5 entfernt.
Veraltete Container-Image-Tags
latest und Image-Tags für Nebenversionen sind veraltet:
Checklisten für das Server-Upgrade
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf 3.4 zu aktualisieren, muss der laufende Cluster Version 3.3 oder höher verwenden. Falls er eine ältere Version als 3.3 verwendet, führen Sie vor dem Upgrade auf 3.4 zunächst ein Upgrade auf 3.3 durch.
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Laden Sie vor Beginn das Snapshot-Backup herunter
. Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Downgrade
auf die bestehende etcd-Version durchführen. Beachten Sie, dass der Befehl snapshot nur die v3-Daten sichert. Informationen zu v2-Daten finden Sie unter Backup des v2-Datenspeichers
.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version 3.4 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Einschränkungen
Hinweis: Wenn der Cluster nur v3-Daten und keine v2-Daten enthält, gilt diese Einschränkung nicht.
Wenn der Cluster einen v2-Datenbestand von mehr als 50MB bereitstellt, kann es bis zu zwei Minuten dauern, bis jedes neu aktualisierte Mitglied zum bestehenden Cluster aufgeschlossen hat. Prüfen Sie die Größe eines aktuellen Snapshots, um die Gesamtdatenmenge abzuschätzen. Anders ausgedrückt ist es am sichersten, zwischen den Upgrades der einzelnen Mitglieder jeweils 2 Minuten zu warten.
Bei einer deutlich größeren Gesamtdatenmenge von 100MB oder mehr kann dieser einmalige Vorgang noch länger dauern. Administratoren sehr großer etcd-Cluster dieser Größenordnung können vor dem Upgrade das etcd-Team kontaktieren; wir beraten Sie gern zum Vorgehen.
Downgrade
Wenn alle Mitglieder auf v3.4 aktualisiert wurden, wird der Cluster auf v3.4 aktualisiert; ein Downgrade aus diesem abgeschlossenen Zustand ist nicht möglich. Solange jedoch noch ein einziges Mitglied v3.3 verwendet, bleiben der Cluster und sein Betrieb auf „v3.3“. Aus diesem Zustand mit gemischten Versionen ist es möglich, auf allen Mitgliedern wieder eine etcd-v3.3-Binärdatei zu verwenden.
Laden Sie das Snapshot-Backup herunter , um ein Downgrade des Clusters auch nach einem vollständig abgeschlossenen Upgrade zu ermöglichen.
Upgrade-Verfahren
Dieses Beispiel zeigt das Upgrade eines etcd-v3.3-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
Schritt 1: Upgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.3.x?
Schritt 2: Snapshot-Backup vom Leader herunterladen
Laden Sie das Snapshot-Backup herunter , um bei Problemen ein Downgrade durchführen zu können.
Der etcd-Leader enthält garantiert die neuesten Anwendungsdaten. Rufen Sie den Snapshot daher vom Leader ab:
Schritt 3: Einen bestehenden etcd-Server stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
Schritt 4: Den etcd-Server mit derselben Konfiguration neu starten
Starten Sie den etcd-Server mit derselben Konfiguration, aber mit der neuen etcd-Binärdatei neu.
Das neue etcd v3.4 veröffentlicht seine Informationen im Cluster. Zu diesem Zeitpunkt verwendet der Cluster weiterhin das Protokoll von v3.3, der niedrigsten gemeinsamen Version.
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.3"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.3"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.4-Binärdatei wieder fehlerfrei ist:
Noch nicht aktualisierte Mitglieder protokollieren Warnungen wie die folgenden, bis der gesamte Cluster aktualisiert wurde.
Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.4 aktualisiert wurden:
Schritt 5: Schritt 3 und Schritt 4 für die übrigen Mitglieder wiederholen
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf 3.4:
Mitglied 1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.4"}
Mitglied 2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
Mitglied 3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
17.6 - Upgrade von etcd 3.2 auf 3.3
Im Allgemeinen kann das Upgrade von etcd 3.2 auf 3.3 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.2-Prozesse nacheinander stoppen und durch etcd-v3.3-Prozesse ersetzen.
- Sobald alle v3.3-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.3 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
Bei der Migration von v2 ohne v3-Daten
löst der etcd-Server v3.2+ eine Panic aus, wenn etcd aus vorhandenen Snapshots wiederhergestellt wird, aber keine v3-Datei ETCD_DATA_DIR/member/snap/db vorhanden ist. Dies tritt auf, wenn der Server von v2 migriert wurde, ohne zuvor v3-Daten zu enthalten. Dadurch wird auch ein versehentlicher Verlust von v3-Daten verhindert (z. B. könnte die Datei db verschoben worden sein). etcd verlangt, dass weitere Migrationen nach der Migration auf v3 nur mit v3-Daten erfolgen können. Führen Sie kein Upgrade auf neuere v3-Versionen durch, bevor der v3.0-Server v3-Daten enthält.
Wenn Sie Authentifizierung aktivieren und Leases mit kurzer TTL verwenden, tritt mit hoher Wahrscheinlichkeit ein Problem
auf, das zu Dateninkonsistenzen führt. Es wird dringend empfohlen, zunächst auf 3.2.31+ zu aktualisieren, um dieses Problem zu beheben, und erst anschließend auf 3.3. Wenn ein Benutzer ohne Berechtigung während des Upgrades eine LeaseRevoke-Anfrage an den 3.3-Knoten sendet, kann dies außerdem weiterhin Datenbeschädigungen verursachen. Stellen Sie daher vor dem Upgrade am besten sicher, dass solche unzulässigen Aufrufe in Ihrer Umgebung nicht vorkommen. Einzelheiten finden Sie in #11691
.
Wichtige inkompatible Änderungen in 3.3.
Werttyp des Flags etcd --auto-compaction-retention in string geändert
Das Flag --auto-compaction-retention wurde so geändert, dass es Zeichenfolgenwerte akzeptiert
, und zwar mit feinerer Granularität
. Da --auto-compaction-retention jetzt Zeichenfolgenwerte akzeptiert, muss das Feld auto-compaction-retention in der YAML-Konfigurationsdatei von etcd auf den Typ string geändert werden. Bisher konnte --config-file etcd.config.yaml das Feld auto-compaction-retention: 24 enthalten; jetzt muss es auto-compaction-retention: "24" oder auto-compaction-retention: "24h" lauten. Bei der Konfiguration --auto-compaction-mode periodic --auto-compaction-retention "24h" muss der Zeitdauerwert des Flags --auto-compaction-retention für die Go-Funktion time.ParseDuration
gültig sein.
*etcdserver.ServerConfig in etcdserver.ServerConfig geändert
etcdserver.EtcdServer hat den Typ seines Mitgliedsfelds von *etcdserver.ServerConfig in etcdserver.ServerConfig geändert. Außerdem akzeptiert etcdserver.NewServer jetzt etcdserver.ServerConfig anstelle von *etcdserver.ServerConfig.
Vorher und nachher (z. B. k8s.io/kubernetes/test/e2e_node/services/etcd.go )
Feld embed.Config.LogOutput hinzugefügt
Beachten Sie, dass dieses Feld in v3.4 in embed.Config.LogOutputs mit dem Typ []string umbenannt wurde. Weitere Einzelheiten finden Sie im Upgrade-Leitfaden für v3.4
.
Das Feld LogOutput wurde zu embed.Config hinzugefügt:
Bisher wurden gRPC-Serverwarnungen in etcdserver protokolliert.
Ab v3.3 sind gRPC-Serverprotokolle standardmäßig deaktiviert.
Beachten Sie, dass die Methode embed.Config.SetupLogging seit v3.4 veraltet ist. Weitere Einzelheiten finden Sie im Upgrade-Leitfaden für v3.4
.
Setzen Sie das Feld embed.Config.Debug auf true, um gRPC-Serverprotokolle zu aktivieren.
Geänderte Antwort des Endpunkts /health
Bisher gab [endpoint]:[client-port]/health einen manuell serialisierten JSON-Wert zurück. 3.3 definiert jetzt die Struktur etcdhttp.Health
.
Beachten Sie, dass etcdhttp.Health in v3.3.0-rc.0, v3.3.0-rc.1 und v3.3.0-rc.2 die booleschen Felder "health" und "errors" besitzt. Aus Gründen der Abwärtskompatibilität haben wir das Feld "health" auf den Typ string zurückgesetzt und das Feld "errors" entfernt. Weitere Zustandsinformationen werden über separate APIs bereitgestellt.
Geänderte HTTP-Endpunkte des gRPC-Gateways (/v3alpha durch /v3beta ersetzt)
Vorher
Nachher
Anfragen an /v3alpha-Endpunkte werden an /v3beta umgeleitet; /v3alpha wird im Release 3.4 entfernt.
Geänderte Obergrenzen für die Anfragegröße
3.3 erlaubt jetzt benutzerdefinierte Größenlimits für Anfragen sowohl auf der Server- als auch auf der Clientseite. In früheren Versionen (v3.2.10, v3.2.11) war die Größe der Antworten an Clients auf nur 4 MiB begrenzt.
Serverseitige Anfragelimits lassen sich mit dem Flag --max-request-bytes konfigurieren:
Oder konfigurieren Sie das Feld embed.Config.MaxRequestBytes:
Ohne Angabe beträgt das serverseitige Limit standardmäßig 1.5 MiB.
Clientseitige Anfragelimits müssen anhand der serverseitigen Limits konfiguriert werden.
Ohne Angabe beträgt das clientseitige Sendelimit standardmäßig 2 MiB (1.5 MiB + zusätzliche gRPC-Bytes) und das Empfangslimit math.MaxInt32. Weitere Einzelheiten finden Sie in der clientv3-godoc-Dokumentation
.
Geänderte Funktionssignaturen der Wrapper für direkte gRPC-Clients
3.3 ändert die Funktionssignaturen des gRPC-Client-Wrappers von clientv3. Diese Änderung war erforderlich, um benutzerdefinierte grpc.CallOption für Nachrichtengrößenlimits
zu unterstützen.
Vorher und nachher
Geänderter Fehlertyp der clientv3-API Snapshot
Bisher gab die clientv3-API Snapshot unverarbeitete Fehler vom Typ [grpc/*status.statusError] zurück. v3.3 wandelt diese Fehler jetzt in die entsprechenden öffentlichen Fehlertypen um, um mit anderen APIs konsistent zu sein.
Vorher
Nachher
Geänderte Ausgabe des Befehls etcdctl lease timetolive
Bisher gab der Befehl lease timetolive LEASE_ID bei einer abgelaufenen Lease -1s als verbleibende Sekunden aus. 3.3 gibt jetzt klarere Meldungen aus.
Vorher
Nachher
Geänderte Importe von golang.org/x/net/context
clientv3 hat golang.org/x/net/context als veraltet eingestuft. Wenn ein Projekt golang.org/x/net/context in anderem Code als eingebundene Abhängigkeit mitführt (z. B. in von etcd generiertem Protocol-Buffer-Code) und github.com/coreos/etcd/clientv3 importiert, wird zum Kompilieren Go 1.9+ benötigt.
Vorher
Nachher
Geänderte gRPC-Abhängigkeit
3.3 benötigt jetzt grpc/grpc-go
v1.7.5.
grpclog.Logger ist veraltet
grpclog.Logger ist zugunsten von grpclog.LoggerV2
veraltet. clientv3.Logger ist jetzt grpclog.LoggerV2.
Vorher
Nachher
grpc.ErrClientConnTimeout ist veraltet
Bisher wurde bei Zeitüberschreitungen beim Verbindungsaufbau des Clients der Fehler grpc.ErrClientConnTimeout zurückgegeben. 3.3 gibt stattdessen context.DeadlineExceeded zurück (siehe #8504
).
Vorher
Nachher
Geänderte offizielle Container-Registry
etcd verwendet jetzt gcr.io/etcd-development/etcd
als primäre und quay.io/coreos/etcd
als sekundäre Container-Registry.
Vorher
Nachher
Upgrades auf >= v3.3.14
v3.3.14 musste einige Funktionen aus 3.4 aufnehmen, wobei versucht wurde, die Unterschiede zwischen den Implementierungen des Client-Balancers möglichst gering zu halten. Dieses Release behebt „kube-apiserver 1.13.x verweigert die Arbeit, wenn der erste etcd-Server nicht verfügbar ist“ (kubernetes#72102) .
grpc.ErrClientConnClosing ist seit gRPC >= 1.10 veraltet
.
Der neue Client-Balancer
verwendet einen asynchronen Resolver, um Endpunkte an die gRPC-Funktion zum Verbindungsaufbau zu übergeben. Daher benötigt v3.3.14
oder höher die Option grpc.WithBlock beim Verbindungsaufbau, um zu warten, bis die zugrunde liegende Verbindung hergestellt ist.
Eine vollständige Liste der Änderungen finden Sie im Änderungsprotokoll (CHANGELOG) .
Checklisten für das Server-Upgrade
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf 3.3 zu aktualisieren, muss der laufende Cluster Version 3.2 oder höher verwenden. Falls er eine ältere Version als 3.2 verwendet, führen Sie vor dem Upgrade auf 3.3 zunächst ein Upgrade auf 3.2 durch.
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Erstellen Sie vor Beginn ein Backup der etcd-Daten
. Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Downgrade
auf die bestehende etcd-Version durchführen. Beachten Sie, dass der Befehl snapshot nur die v3-Daten sichert. Informationen zu v2-Daten finden Sie unter Backup des v2-Datenspeichers
.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version 3.3 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Einschränkungen
Hinweis: Wenn der Cluster nur v3-Daten und keine v2-Daten enthält, gilt diese Einschränkung nicht.
Wenn der Cluster einen v2-Datenbestand von mehr als 50MB bereitstellt, kann es bis zu zwei Minuten dauern, bis jedes neu aktualisierte Mitglied zum bestehenden Cluster aufgeschlossen hat. Prüfen Sie die Größe eines aktuellen Snapshots, um die Gesamtdatenmenge abzuschätzen. Anders ausgedrückt ist es am sichersten, zwischen den Upgrades der einzelnen Mitglieder jeweils 2 Minuten zu warten.
Bei einer deutlich größeren Gesamtdatenmenge von 100MB oder mehr kann dieser einmalige Vorgang noch länger dauern. Administratoren sehr großer etcd-Cluster dieser Größenordnung können vor dem Upgrade das etcd-Team kontaktieren; wir beraten Sie gern zum Vorgehen.
Downgrade
Wenn alle Mitglieder auf v3.3 aktualisiert wurden, wird der Cluster auf v3.3 aktualisiert; ein Downgrade aus diesem abgeschlossenen Zustand ist nicht möglich. Solange jedoch noch ein einziges Mitglied v3.2 verwendet, bleiben der Cluster und sein Betrieb auf „v3.2“. Aus diesem Zustand mit gemischten Versionen ist es möglich, auf allen Mitgliedern wieder eine etcd-v3.2-Binärdatei zu verwenden.
Erstellen Sie ein Backup des Datenverzeichnisses aller etcd-Mitglieder, um ein Downgrade des Clusters auch nach einem vollständig abgeschlossenen Upgrade zu ermöglichen.
Upgrade-Verfahren
Dieses Beispiel zeigt das Upgrade eines etcd-v3.2-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
1. Upgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.2.x?
2. Den bestehenden etcd-Prozess stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
An dieser Stelle empfiehlt es sich, ein Backup der etcd-Daten zu erstellen , um bei Problemen ein Downgrade durchführen zu können:
3. Die etcd-v3.3-Binärdatei einsetzen und den neuen etcd-Prozess starten
Das neue etcd v3.3 veröffentlicht seine Informationen im Cluster:
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.3-Binärdatei wieder fehlerfrei ist:
Aktualisierte Mitglieder protokollieren Warnungen wie die folgenden, bis der gesamte Cluster aktualisiert ist. Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.3 aktualisiert wurden:
4. Schritt 2 bis Schritt 3 für alle anderen Mitglieder wiederholen
5. Abschluss
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf 3.3:
17.7 - Upgrade von etcd 3.1 auf 3.2
Im Allgemeinen kann das Upgrade von etcd 3.1 auf 3.2 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.1-Prozesse nacheinander stoppen und durch etcd-v3.2-Prozesse ersetzen.
- Sobald alle v3.2-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.2 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
Bei der Migration von v2 ohne v3-Daten
löst der etcd-Server v3.2+ eine Panic aus, wenn etcd aus vorhandenen Snapshots wiederhergestellt wird, aber keine v3-Datei ETCD_DATA_DIR/member/snap/db vorhanden ist. Dies tritt auf, wenn der Server von v2 migriert wurde, ohne zuvor v3-Daten zu enthalten. Dadurch wird auch ein versehentlicher Verlust von v3-Daten verhindert (z. B. könnte die Datei db verschoben worden sein). etcd verlangt, dass weitere Migrationen nach der Migration auf v3 nur mit v3-Daten erfolgen können. Führen Sie kein Upgrade auf neuere v3-Versionen durch, bevor der v3.0-Server v3-Daten enthält.
Wichtige inkompatible Änderungen in 3.2.
Geänderter Standardwert für snapshot-count
Ein höherer Wert für --snapshot-count hält bis zum Snapshot mehr Raft-Einträge im Speicher und führt dadurch zu wiederholt höherer Speichernutzung
. Da der Leader die neuesten Raft-Einträge länger vorhält, hat ein langsamer Follower mehr Zeit, vor dem Snapshot des Leaders aufzuholen. --snapshot-count stellt einen Kompromiss zwischen höherer Speichernutzung und besserer Verfügbarkeit langsamer Follower dar.
Seit v3.2 wurde der Standardwert von --snapshot-count von 10,000 auf 100,000 geändert
.
Geänderte gRPC-Abhängigkeit (>=3.2.10)
3.2.10 oder höher benötigt jetzt grpc/grpc-go
v1.7.5 (<=3.2.9 benötigt v1.2.1).
grpclog.Logger ist veraltet
grpclog.Logger ist zugunsten von grpclog.LoggerV2
veraltet. clientv3.Logger ist jetzt grpclog.LoggerV2.
Vorher
Nachher
grpc.ErrClientConnTimeout ist veraltet
Bisher wurde bei Zeitüberschreitungen beim Verbindungsaufbau des Clients der Fehler grpc.ErrClientConnTimeout zurückgegeben. 3.2 gibt stattdessen context.DeadlineExceeded zurück (siehe #8504
).
Vorher
Nachher
Geänderte Obergrenzen für die Anfragegröße (>=3.2.10)
3.2.10 und 3.2.11 erlauben benutzerdefinierte Größenlimits für Anfragen auf der Serverseite. >=3.2.12 erlaubt benutzerdefinierte Größenlimits für Anfragen sowohl auf der Server- als auch auf der Clientseite. In früheren Versionen (v3.2.10, v3.2.11) war die Größe der Antworten an Clients auf nur 4 MiB begrenzt.
Serverseitige Anfragelimits lassen sich mit dem Flag --max-request-bytes konfigurieren:
Oder konfigurieren Sie das Feld embed.Config.MaxRequestBytes:
Ohne Angabe beträgt das serverseitige Limit standardmäßig 1.5 MiB.
Clientseitige Anfragelimits müssen anhand der serverseitigen Limits konfiguriert werden.
Ohne Angabe beträgt das clientseitige Sendelimit standardmäßig 2 MiB (1.5 MiB + zusätzliche gRPC-Bytes) und das Empfangslimit math.MaxInt32. Weitere Einzelheiten finden Sie in der clientv3-godoc-Dokumentation
.
Geänderte Wrapper für direkte gRPC-Clients
3.2.12 oder höher ändert die Funktionssignaturen des gRPC-Client-Wrappers von clientv3. Diese Änderung war erforderlich, um benutzerdefinierte grpc.CallOption für Nachrichtengrößenlimits
zu unterstützen.
Vorher und nachher
Geänderte API clientv3.Lease.TimeToLive
Bisher gab die API clientv3.Lease.TimeToLive bei einer nicht vorhandenen Lease-ID lease.ErrLeaseNotFound zurück. 3.2 gibt stattdessen TTL=-1 in der Antwort und keinen Fehler zurück (siehe #7305
).
Vorher
Nachher
clientv3.NewFromConfigFile nach clientv3.yaml.NewConfig verschoben
clientv3.NewFromConfigFile wurde nach yaml.NewConfig verschoben.
Vorher
Nachher
Änderung an --listen-peer-urls und --listen-client-urls
3.2 weist jetzt Domainnamen für --listen-peer-urls und --listen-client-urls zurück (3.1 gibt nur Warnungen aus), da ein Domainname für die Bindung an eine Netzwerkschnittstelle ungültig ist. Stellen Sie sicher, dass diese URLs korrekt als scheme://IP:port formatiert sind.
Weitere Hintergründe finden Sie in Issue #6336 .
Checklisten für das Server-Upgrade
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf 3.2 zu aktualisieren, muss der laufende Cluster Version 3.1 oder höher verwenden. Falls er eine ältere Version als 3.1 verwendet, führen Sie vor dem Upgrade auf 3.2 zunächst ein Upgrade auf 3.1 durch.
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Erstellen Sie vor Beginn ein Backup der etcd-Daten
. Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Downgrade
auf die bestehende etcd-Version durchführen. Beachten Sie, dass der Befehl snapshot nur die v3-Daten sichert. Informationen zu v2-Daten finden Sie unter Backup des v2-Datenspeichers
.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version 3.2 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Einschränkungen
Hinweis: Wenn der Cluster nur v3-Daten und keine v2-Daten enthält, gilt diese Einschränkung nicht.
Wenn der Cluster einen v2-Datenbestand von mehr als 50MB bereitstellt, kann es bis zu zwei Minuten dauern, bis jedes neu aktualisierte Mitglied zum bestehenden Cluster aufgeschlossen hat. Prüfen Sie die Größe eines aktuellen Snapshots, um die Gesamtdatenmenge abzuschätzen. Anders ausgedrückt ist es am sichersten, zwischen den Upgrades der einzelnen Mitglieder jeweils 2 Minuten zu warten.
Bei einer deutlich größeren Gesamtdatenmenge von 100MB oder mehr kann dieser einmalige Vorgang noch länger dauern. Administratoren sehr großer etcd-Cluster dieser Größenordnung können vor dem Upgrade das etcd-Team kontaktieren; wir beraten Sie gern zum Vorgehen.
Downgrade
Wenn alle Mitglieder auf v3.2 aktualisiert wurden, wird der Cluster auf v3.2 aktualisiert; ein Downgrade aus diesem abgeschlossenen Zustand ist nicht möglich. Solange jedoch noch ein einziges Mitglied v3.1 verwendet, bleiben der Cluster und sein Betrieb auf „v3.1“. Aus diesem Zustand mit gemischten Versionen ist es möglich, auf allen Mitgliedern wieder eine etcd-v3.1-Binärdatei zu verwenden.
Erstellen Sie ein Backup des Datenverzeichnisses aller etcd-Mitglieder, um ein Downgrade des Clusters auch nach einem vollständig abgeschlossenen Upgrade zu ermöglichen.
Upgrade-Verfahren
Dieses Beispiel zeigt das Upgrade eines etcd-v3.1-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
1. Upgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.1.x?
2. Den bestehenden etcd-Prozess stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
An dieser Stelle empfiehlt es sich, ein Backup der etcd-Daten zu erstellen , um bei Problemen ein Downgrade durchführen zu können:
3. Die etcd-v3.2-Binärdatei einsetzen und den neuen etcd-Prozess starten
Das neue etcd v3.2 veröffentlicht seine Informationen im Cluster:
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.2-Binärdatei wieder fehlerfrei ist:
Aktualisierte Mitglieder protokollieren Warnungen wie die folgenden, bis der gesamte Cluster aktualisiert ist. Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.2 aktualisiert wurden:
4. Schritt 2 bis Schritt 3 für alle anderen Mitglieder wiederholen
5. Abschluss
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf 3.2:
17.8 - Upgrade von etcd 3.0 auf 3.1
Im Allgemeinen kann das Upgrade von etcd 3.0 auf 3.1 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v3.0-Prozesse nacheinander stoppen und durch etcd-v3.1-Prozesse ersetzen.
- Sobald alle v3.1-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.1 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
Bei der Migration von v2 ohne v3-Daten
löst der etcd-Server v3.2+ eine Panic aus, wenn etcd aus vorhandenen Snapshots wiederhergestellt wird, aber keine v3-Datei ETCD_DATA_DIR/member/snap/db vorhanden ist. Dies tritt auf, wenn der Server von v2 migriert wurde, ohne zuvor v3-Daten zu enthalten. Dadurch wird auch ein versehentlicher Verlust von v3-Daten verhindert (z. B. könnte die Datei db verschoben worden sein). etcd verlangt, dass weitere Migrationen nach der Migration auf v3 nur mit v3-Daten erfolgen können. Führen Sie kein Upgrade auf neuere v3-Versionen durch, bevor der v3.0-Server v3-Daten enthält.
Überwachung
Die folgenden Metriken aus v3.0.x sind zugunsten von go-grpc-prometheus veraltet:
etcd_grpc_requests_totaletcd_grpc_requests_failed_totaletcd_grpc_active_streamsetcd_grpc_unary_requests_duration_seconds
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf 3.1 zu aktualisieren, muss der laufende Cluster Version 3.0 oder höher verwenden. Falls er eine ältere Version als 3.0 verwendet, führen Sie vor dem Upgrade auf 3.1 zunächst ein Upgrade auf 3.0 durch.
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl endpoint health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Erstellen Sie vor Beginn ein Backup der etcd-Daten
. Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Downgrade
auf die bestehende etcd-Version durchführen. Beachten Sie, dass der Befehl snapshot nur die v3-Daten sichert. Informationen zu v2-Daten finden Sie unter Backup des v2-Datenspeichers
.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version 3.1 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Einschränkungen
Hinweis: Wenn der Cluster nur v3-Daten und keine v2-Daten enthält, gilt diese Einschränkung nicht.
Wenn der Cluster einen v2-Datenbestand von mehr als 50MB bereitstellt, kann es bis zu zwei Minuten dauern, bis jedes neu aktualisierte Mitglied zum bestehenden Cluster aufgeschlossen hat. Prüfen Sie die Größe eines aktuellen Snapshots, um die Gesamtdatenmenge abzuschätzen. Anders ausgedrückt ist es am sichersten, zwischen den Upgrades der einzelnen Mitglieder jeweils 2 Minuten zu warten.
Bei einer deutlich größeren Gesamtdatenmenge von 100MB oder mehr kann dieser einmalige Vorgang noch länger dauern. Administratoren sehr großer etcd-Cluster dieser Größenordnung können vor dem Upgrade das etcd-Team kontaktieren; wir beraten Sie gern zum Vorgehen.
Downgrade
Wenn alle Mitglieder auf v3.1 aktualisiert wurden, wird der Cluster auf v3.1 aktualisiert; ein Downgrade aus diesem abgeschlossenen Zustand ist nicht möglich. Solange jedoch noch ein einziges Mitglied v3.0 verwendet, bleiben der Cluster und sein Betrieb auf „v3.0“. Aus diesem Zustand mit gemischten Versionen ist es möglich, auf allen Mitgliedern wieder eine etcd-v3.0-Binärdatei zu verwenden.
Erstellen Sie ein Backup des Datenverzeichnisses aller etcd-Mitglieder, um ein Downgrade des Clusters auch nach einem vollständig abgeschlossenen Upgrade zu ermöglichen.
Upgrade-Verfahren
Dieses Beispiel zeigt das Upgrade eines etcd-v3.0-Clusters mit 3 Mitgliedern, der auf einem lokalen Rechner läuft.
1. Upgrade-Voraussetzungen prüfen
Ist der Cluster fehlerfrei und läuft er mit v3.0.x?
2. Den bestehenden etcd-Prozess stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
An dieser Stelle empfiehlt es sich, ein Backup der etcd-Daten zu erstellen , um bei Problemen ein Downgrade durchführen zu können:
3. Die etcd-v3.1-Binärdatei einsetzen und den neuen etcd-Prozess starten
Das neue etcd v3.1 veröffentlicht seine Informationen im Cluster:
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.1-Binärdatei wieder fehlerfrei ist:
Aktualisierte Mitglieder protokollieren Warnungen wie die folgenden, bis der gesamte Cluster aktualisiert ist. Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.1 aktualisiert wurden:
4. Schritt 2 bis Schritt 3 für alle anderen Mitglieder wiederholen
5. Abschluss
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf 3.1:
17.9 - Upgrade von etcd 2.3 auf 3.0
Im Allgemeinen kann das Upgrade von etcd 2.3 auf 3.0 als Rolling Upgrade ohne Ausfallzeit erfolgen:
- Die etcd-v2.3-Prozesse nacheinander stoppen und durch etcd-v3.0-Prozesse ersetzen.
- Sobald alle v3.0-Prozesse laufen, stehen dem Cluster die neuen Funktionen von v3.0 zur Verfügung.
Lesen Sie zur Vorbereitung den Rest dieses Leitfadens, bevor Sie mit dem Upgrade beginnen .
Checklisten für das Upgrade
Bei der Migration von v2 ohne v3-Daten
löst der etcd-Server v3.2+ eine Panic aus, wenn etcd aus vorhandenen Snapshots wiederhergestellt wird, aber keine v3-Datei ETCD_DATA_DIR/member/snap/db vorhanden ist. Dies tritt auf, wenn der Server von v2 migriert wurde, ohne zuvor v3-Daten zu enthalten. Dadurch wird auch ein versehentlicher Verlust von v3-Daten verhindert (z. B. könnte die Datei db verschoben worden sein). etcd verlangt, dass weitere Migrationen nach der Migration auf v3 nur mit v3-Daten erfolgen können. Führen Sie kein Upgrade auf neuere v3-Versionen durch, bevor der v3.0-Server v3-Daten enthält.
Upgrade-Voraussetzungen
Um eine bestehende etcd-Installation auf 3.0 zu aktualisieren, muss der laufende Cluster Version 2.3 oder höher verwenden. Falls er eine ältere Version als 2.3 verwendet, aktualisieren Sie vor dem Upgrade auf 3.0 zunächst auf 2.3 .
Außerdem muss der laufende Cluster fehlerfrei sein, damit das Rolling Upgrade reibungslos verläuft. Prüfen Sie den Zustand des Clusters mit dem Befehl etcdctl cluster-health, bevor Sie fortfahren.
Vorbereitung
Testen Sie vor einem etcd-Upgrade immer die von etcd abhängigen Dienste in einer Staging-Umgebung, bevor Sie das Upgrade in der Produktionsumgebung durchführen.
Erstellen Sie vor Beginn ein Backup des etcd-Datenverzeichnisses . Falls beim Upgrade etwas schiefgeht, können Sie mit diesem Backup ein Downgrade auf die bestehende etcd-Version durchführen.
Gemischte Versionen
Während des Upgrades unterstützt ein etcd-Cluster Mitglieder mit gemischten etcd-Versionen und verwendet das Protokoll der niedrigsten gemeinsamen Version. Der Cluster gilt erst als aktualisiert, wenn alle Mitglieder auf Version 3.0 aktualisiert wurden. Intern handeln die etcd-Mitglieder untereinander die Gesamtversion des Clusters aus, die die gemeldete Version und die unterstützten Funktionen bestimmt.
Einschränkungen
Bei einer Gesamtdatenmenge von mehr als 50MB kann es bis zu 2 Minuten dauern, bis das neu aktualisierte Mitglied zum bestehenden Cluster aufgeschlossen hat. Prüfen Sie die Größe eines aktuellen Snapshots, um die Gesamtdatenmenge abzuschätzen. Anders ausgedrückt ist es am sichersten, zwischen den Upgrades der einzelnen Mitglieder jeweils 2 Minuten zu warten.
Bei einer deutlich größeren Gesamtdatenmenge von 100MB oder mehr kann dieser einmalige Vorgang noch länger dauern. Administratoren sehr großer etcd-Cluster dieser Größenordnung können vor dem Upgrade das etcd-Team kontaktieren; wir beraten Sie gern zum Vorgehen.
Downgrade
Wenn alle Mitglieder auf v3.0 aktualisiert wurden, wird der Cluster auf v3.0 aktualisiert; ein Downgrade aus diesem abgeschlossenen Zustand ist nicht möglich. Solange jedoch noch ein einziges Mitglied v2.3 verwendet, bleiben der Cluster und sein Betrieb auf „v2.3“. Aus diesem Zustand mit gemischten Versionen ist es möglich, auf allen Mitgliedern wieder eine etcd-v2.3-Binärdatei zu verwenden.
Erstellen Sie ein Backup des Datenverzeichnisses aller etcd-Mitglieder, um ein Downgrade des Clusters auch nach einem vollständig abgeschlossenen Upgrade zu ermöglichen.
Upgrade-Verfahren
Dieses Beispiel beschreibt das Upgrade eines etcd-v2.3-Clusters mit drei Mitgliedern, der auf einem lokalen Rechner läuft.
1. Upgrade-Voraussetzungen prüfen.
Ist der Cluster fehlerfrei und läuft er mit v.2.3.x?
2. Den bestehenden etcd-Prozess stoppen
Wenn ein etcd-Prozess gestoppt wird, protokollieren die anderen Cluster-Mitglieder erwartete Fehler. Dies ist normal, da die Verbindung zu einem Cluster-Mitglied (vorübergehend) unterbrochen wurde:
An dieser Stelle empfiehlt es sich, ein Backup des etcd-Datenverzeichnisses zu erstellen , um bei Problemen ein Downgrade durchführen zu können:
3. Die etcd-v3.0-Binärdatei einsetzen und den neuen etcd-Prozess starten
Das neue etcd v3.0 veröffentlicht seine Informationen im Cluster:
Prüfen Sie, ob jedes Mitglied und anschließend der gesamte Cluster mit der neuen etcd-v3.0-Binärdatei wieder fehlerfrei ist:
Aktualisierte Mitglieder protokollieren Warnungen wie die folgenden, bis der gesamte Cluster aktualisiert ist. Dies ist zu erwarten und endet, sobald alle etcd-Cluster-Mitglieder auf v3.0 aktualisiert wurden:
4. Schritt 2 bis Schritt 3 für alle anderen Mitglieder wiederholen
5. Abschluss
Sobald alle Mitglieder aktualisiert wurden, meldet der Cluster den erfolgreichen Abschluss des Upgrades auf 3.0:
Weitere Hinweise
- Die Umgebungsvariablen von etcdctl wurden aktualisiert. Wenn
ETCDCTL_API=2 etcdctl cluster-healthordnungsgemäß funktioniert, aberETCDCTL_API=3 etcdctl endpoints healthmitError: grpc: timed out when dialingantwortet, verwenden Sie unbedingt die neuen Variablennamen .
Bekannte Probleme
- etcd < v3.1 funktioniert nicht ordnungsgemäß, wenn es mit Go > v1.7 gebaut wurde. Weitere Informationen finden Sie in Issue 6951 .
- Wenn in den etcd-Serverprotokollen ein Fehler wie
transport: http2Client.notifyError got notified that the client transport was broken unexpected EOF.erscheint, stellen Sie sicher, dass etcd als vorgefertigtes Release vorliegt oder mit (etcd v3.1+ & go v1.7+) oder (etcd <v3.1 & go v1.6.x) gebaut wurde. - Das Hinzufügen eines v3-Knotens zu einem v2.3-Cluster während des Upgrades wird nicht unterstützt und könnte Panics auslösen. Weitere Informationen finden Sie in Issue 7249 . Gemischte Versionen von etcd-Mitgliedern sind nur während der v3-Migration zulässig. Schließen Sie die Upgrades ab, bevor Sie die Mitgliedschaft ändern.
18 - Triage
18.1 - Richtlinien zur Issue-Triage
Zweck
Die Verwaltung von Issues beschleunigen.
Die Issues für etcd sind unter https://github.com/etcd-io/etcd/issues
aufgeführt
und werden mit Labels gekennzeichnet. Ein als Fehler erkanntes Issue erhält beispielsweise das Label area/bug . Neue Issues haben zunächst keine Labels; üblicherweise ergänzen die Maintainer und aktiven Mitwirkenden von etcd sie anhand ihrer Erkenntnisse. Die vollständige Liste der Labels steht unter
https://github.com/kubernetes/kubernetes/labels
Hier einige praktische vordefinierte Suchen nach Issues:
Geltungsbereich
Diese Richtlinien dienen als grundlegendes Dokument zur Sichtung und Einordnung neuer Issues in etcd. Alle sind eingeladen, bei der Verwaltung von Issues und PRs mitzuhelfen. Die hier beschriebenen Arbeiten und Verantwortlichkeiten richten sich jedoch an die Maintainer und aktiven Mitwirkenden von etcd.
Prüfen, ob ein Issue einen Fehler beschreibt
Prüfen, ob tatsächlich ein Fehler vorliegt. Falls nicht, die Erkenntnisse in einem Kommentar festhalten und triviale Issues schließen. Bei nicht trivialen Issues die Rückmeldung der meldenden Person abwarten, um mögliche Einwände zu berücksichtigen. Antwortet sie innerhalb von 30 Tagen nicht, das Issue schließen. Lässt sich das Problem nicht reproduzieren oder werden weitere Informationen benötigt, einen Kommentar für die meldende Person hinterlassen.
Inaktive Issues
Issues mit unzureichenden Angaben sollten geschlossen werden, wenn die meldende Person innerhalb von 60 Tagen keine Informationen nachliefert.
Doppelte Issues
Bei einem doppelten Issue einen entsprechenden Kommentar mit einem Verweis auf das ursprüngliche Issue hinterlassen und das Duplikat schließen.
Issues außerhalb von etcd
Manche gemeldeten Issues betreffen tatsächlich andere Projekte, die etcd verwendet, etwa grpc oder golang. In solchen Fällen sollte die meldende Person gebeten werden, ein Issue im zuständigen Projekt zu eröffnen. Das Issue schließen, sofern nicht ein Maintainer und die meldende Person es zur Nachverfolgung offen halten möchten.
Wichtige Labels prüfen
Sicherstellen, dass das Issue Labels für die betroffenen Bereiche hat, geeignete Verantwortliche zugewiesen sind und ein Meilenstein festgelegt ist. Fehlende Labels ergänzen. Lassen sich Labels wegen fehlender Berechtigungen nicht zuweisen oder lässt sich das richtige Label nicht bestimmen, ist das in Ordnung; bei Bedarf die Maintainer kontaktieren.
Bei Bedarf die verantwortliche Person erinnern
Wenn für ein von einem Entwickler übernommenes Issue innerhalb von 30 Tagen kein PR erstellt wurde, die verantwortliche Person kontaktieren und sie bei Bedarf bitten, einen PR zu erstellen oder die Zuständigkeit freizugeben.
18.2 - PR-Verwaltung
Zweck
Die PR-Verwaltung beschleunigen.
Die PRs für etcd sind unter https://github.com/etcd-io/etcd/pulls
aufgeführt.
Ein PR kann verschiedene Labels, einen Meilenstein, Reviewer usw. haben. Die vollständige Liste der Labels steht unter
https://github.com/kubernetes/kubernetes/labels
Hier einige praktische Suchbeispiele für PRs:
Geltungsbereich
Diese Richtlinien dienen als grundlegendes Dokument zur Verwaltung von PRs in etcd. Alle sind eingeladen, bei der PR-Verwaltung mitzuhelfen. Die hier beschriebenen Arbeiten und Verantwortlichkeiten richten sich jedoch an die Maintainer und aktiven Mitwirkenden von etcd.
Inaktive PRs bearbeiten
Die verantwortliche Person für den PR erinnern, wenn Review-Kommentare innerhalb von 15 Tagen nicht bearbeitet wurden. Antwortet sie innerhalb von 90 Tagen nicht, den PR nach Möglichkeit mit einem neuen Commit aktualisieren. Ist das nicht möglich, sollte der inaktive PR nach 180 Tagen geschlossen werden.
Bei Bedarf Reviewer erinnern
Reviewer reagieren zeitnah. Da alle viel zu tun haben, nach einer Review-Anfrage jedoch etwas Zeit lassen, falls keine schnelle Antwort kommt. Bleibt die Antwort 10 Tage lang aus, können sie durch einen Kommentar im PR, eine E-Mail oder eine Slack-Nachricht kontaktiert werden.
Wichtige Labels prüfen
Sicherstellen, dass dem PR geeignete Reviewer zugewiesen sind und ein Meilenstein festgelegt ist. Fehlende Zuweisungen oder andere wichtige Labels ergänzen. Lässt sich das richtige Label nicht bestimmen, einen Kommentar hinterlassen, damit die Maintainer es bei Bedarf festlegen können.