Design des etcd-Clients
Design des etcd-Clients
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
Einleitung
Der etcd-Server hat seine Robustheit in jahrelangen Tests mit gezielt ausgelösten Fehlern bewiesen. Die meiste komplexe Anwendungslogik übernimmt bereits der etcd-Server mit seinen Datenspeichern. Beispielsweise bleibt die Clustermitgliedschaft für Clients transparent, da die Raft-Schicht Vorschläge an den Leader weiterleitet. Auch wenn die Serverkomponenten korrekt arbeiten, erfordert ihr Zusammenspiel mit dem Client weitere komplexe Protokolle, um Korrektheit und Hochverfügbarkeit auch bei Fehlern zu gewährleisten. Idealerweise bietet der etcd-Server eine einzige logische Clustersicht auf viele physische Rechner, während der Client automatisches Failover zwischen Replikaten implementiert. Dieses Dokument beschreibt die Architekturentscheidungen des Clients und die Details ihrer Implementierung.
Glossar
clientv3: Offizieller Go-Client von etcd für die etcd-v3-API.
clientv3-grpc1.0: Offizielle Client-Implementierung mit grpc-go v1.0.x
, die in der neuesten Version von etcd v3.1 verwendet wird.
clientv3-grpc1.7: Offizielle Client-Implementierung mit grpc-go v1.7.x
, die in den neuesten Versionen von etcd v3.2 und v3.3 verwendet wird.
clientv3-grpc1.23: Offizielle Client-Implementierung mit grpc-go v1.23.x
, die in der neuesten Version von etcd v3.4 verwendet wird.
Load-Balancer: Lastverteiler des etcd-Clients, der Wiederholungs- und Failover-Mechanismen implementiert. Der etcd-Client sollte die Last automatisch auf mehrere Endpunkte verteilen.
Endpunkte: Eine Liste von etcd-Serverendpunkten, mit denen sich Clients verbinden können. Üblicherweise sind dies 3 oder 5 Client-URLs eines etcd-Clusters.
Fest zugeordneter Endpunkt: Bei mehreren konfigurierten Endpunkten wählt der Client-Load-Balancer in Versionen <= v3.3 nur einen Endpunkt für eine TCP-Verbindung aus, um die Gesamtzahl offener Verbindungen zum etcd-Cluster gering zu halten. In v3.4 wechselt der Load-Balancer für jede Anfrage im Round-Robin-Verfahren zwischen den fest zugeordneten Endpunkten und verteilt die Last dadurch gleichmäßiger.
Client-Verbindung: Eine über gRPC Dial aufgebaute TCP-Verbindung zu einem etcd-Server.
Unterverbindung: Die gRPC-Schnittstelle SubConn. Jede Unterverbindung enthält eine Adressliste. Der Load-Balancer erstellt aus einer Liste aufgelöster Adressen eine SubConn. Eine gRPC ClientConn kann mehreren SubConn entsprechen, etwa wenn example.com auf 10.10.10.1 und 10.10.10.2 zweier Unterverbindungen aufgelöst wird. Der Load-Balancer von etcd v3.4 verwendet einen internen Resolver, um für jeden Endpunkt eine Unterverbindung aufzubauen.
Vorübergehender Verbindungsabbruch: Wenn der gRPC-Server einen Statusfehler vom Typ code Unavailable
zurückgibt.
Anforderungen an den Client
Korrektheit. Bei Serverfehlern können Anfragen fehlschlagen. Konsistenzgarantien werden jedoch nie verletzt: Eigenschaften der globalen Reihenfolge, kein Schreiben beschädigter Daten, At-most-once-Semantik für ändernde Operationen, keine Beobachtung unvollständiger Ereignisse durch Watches usw.
Fortschrittsgarantie. Server können ausfallen oder kurzzeitig die Verbindung verlieren. Clients sollten in beiden Fällen Fortschritte machen. Sie sollten beim Warten auf die Rückkehr eines offline gegangenen Servers niemals dauerhaft blockieren , sofern dies nicht ausdrücklich konfiguriert ist. Idealerweise erkennen Clients nicht verfügbare Server mit HTTP/2-Pings und wechseln mit verständlichen Fehlermeldungen zu anderen Knoten.
Effizienz. Clients sollten mit minimalem Ressourcenverbrauch wirksam arbeiten: Nach einem Endpunktwechsel sollten vorherige TCP-Verbindungen geordnet geschlossen werden. Der Failover-Mechanismus sollte das nächste geeignete Replikat für eine Verbindung bestimmen, ohne Ressourcen durch wiederholte Versuche an ausgefallenen Knoten zu verschwenden.
Portierbarkeit. Der offizielle Client sollte klar dokumentiert sein, und seine Implementierung sollte sich auf Anbindungen anderer Sprachen übertragen lassen. Die Fehlerbehandlung sollte über die Sprachanbindungen hinweg konsistent sein. Da etcd vollständig auf gRPC setzt, sollte sich die Implementierung eng an den langfristigen Entwurfszielen von gRPC orientieren. Beispielsweise sollte eine austauschbare Wiederholungsrichtlinie mit gRPC-Wiederholungen kompatibel sein. Upgrades zwischen zwei Client-Versionen sollten den Betrieb nicht unterbrechen.
Client-Überblick
Der etcd-Client implementiert die folgenden Komponenten:
- einen Load-Balancer, der gRPC-Verbindungen zu einem etcd-Cluster aufbaut,
- einen API-Client, der RPCs an einen etcd-Server sendet, und
- eine Fehlerbehandlung, die entscheidet, ob eine fehlgeschlagene Anfrage wiederholt oder der Endpunkt gewechselt wird.
Sprachen können sich darin unterscheiden, wie die erste Verbindung aufgebaut wird, etwa durch TLS-Konfiguration, wie Protocol-Buffer-Nachrichten kodiert und an den Server gesendet werden, wie Streaming-RPCs verarbeitet werden usw. Die vom etcd-Server zurückgegebenen Fehler sind jedoch dieselben. Entsprechend sollten auch Fehlerbehandlung und Wiederholungsrichtlinie gleich sein.
Beispielsweise kann der etcd-Server "rpc error: code = Unavailable desc = etcdserver: request timed out" zurückgeben, einen vorübergehenden Fehler, bei dem Wiederholungen erwartet werden. Oder er gibt rpc error: code = InvalidArgument desc = etcdserver: key is not provided zurück. Dies bedeutet, dass die Anfrage ungültig war und nicht wiederholt werden sollte. Der Go-Client kann Fehler mit google.golang.org/grpc/status.FromError auswerten, der Java-Client mit io.grpc.Status.fromThrowable.
clientv3-grpc1.0: Überblick über den Load-Balancer
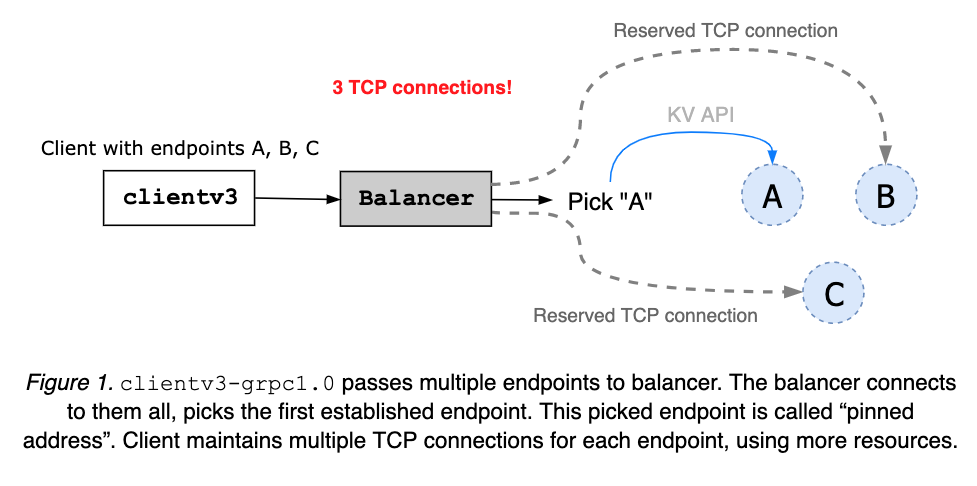
Bei mehreren konfigurierten etcd-Endpunkten hält clientv3-grpc1.0 mehrere TCP-Verbindungen offen. Anschließend wählt er eine Adresse und sendet darüber alle Client-Anfragen. Die fest zugeordnete Adresse bleibt erhalten, bis das Client-Objekt geschlossen wird (siehe Abbildung 1). Wenn der Client einen Fehler erhält, wählt er zufällig eine andere Adresse und versucht es erneut.
clientv3-grpc1.0: Einschränkungen des Load-Balancers
Die mehreren TCP-Verbindungen von clientv3-grpc1.0 können ein schnelleres Failover des Load-Balancers ermöglichen, benötigen aber mehr Ressourcen. Der Load-Balancer kennt weder den Zustand der Knoten noch ihre Clustermitgliedschaft. Daher kann er an einem ausgefallenen oder durch eine Netzwerkpartition abgetrennten Knoten hängen bleiben.
clientv3-grpc1.7: Überblick über den Load-Balancer
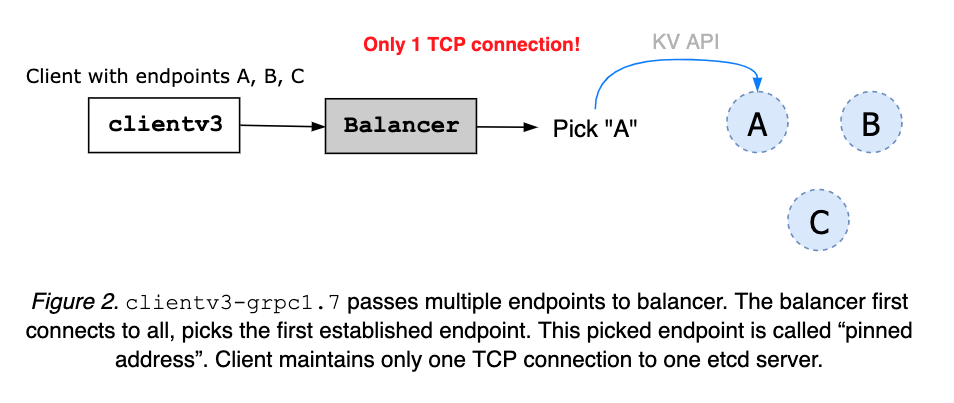
clientv3-grpc1.7 hält nur eine TCP-Verbindung zu einem ausgewählten etcd-Server offen. Bei mehreren angegebenen Clusterendpunkten versucht ein Client zunächst, sich mit allen zu verbinden. Sobald eine Verbindung steht, ordnet der Load-Balancer die Adresse fest zu und schließt die anderen Verbindungen (siehe Abbildung 2). Die Adresse soll zugeordnet bleiben, bis das Client-Objekt geschlossen wird. Ein Fehler des Servers oder des Client-Netzwerks wird an die Fehlerbehandlung des Clients weitergeleitet (siehe Abbildung 3).
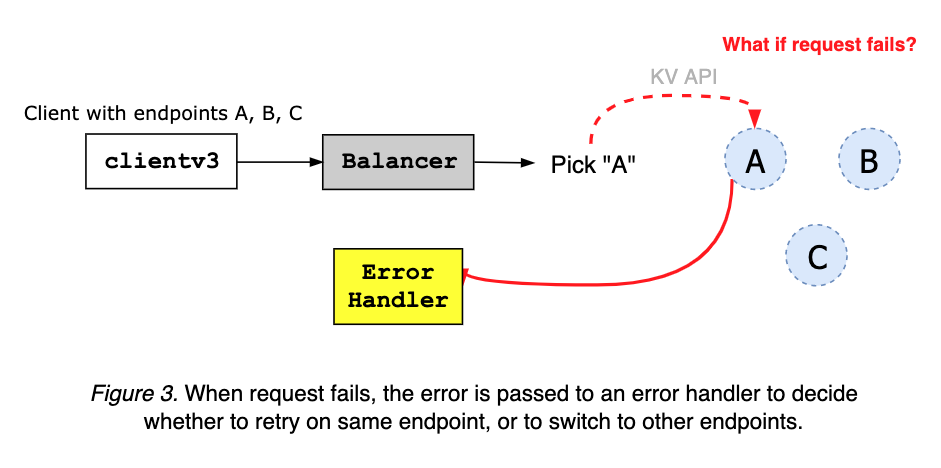
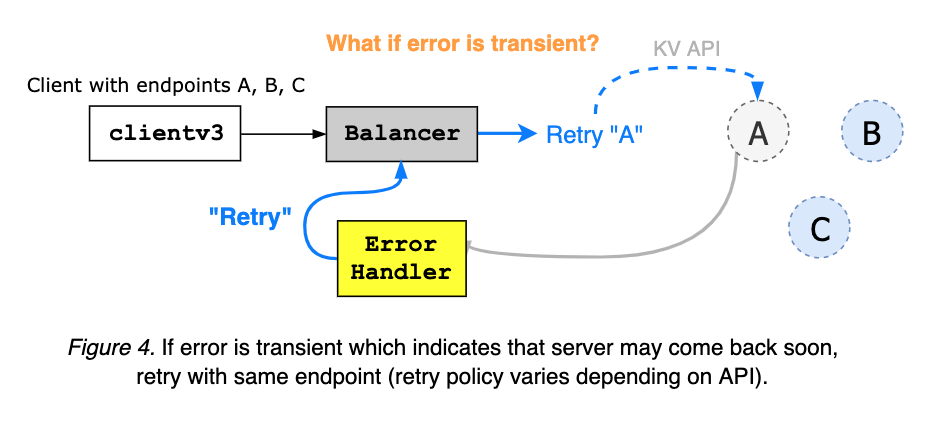
Die Fehlerbehandlung des Clients erhält einen Fehler vom gRPC-Server und entscheidet anhand von Fehlercode und Meldung, ob dieselbe Anfrage am selben Endpunkt wiederholt oder zu einer anderen Adresse gewechselt wird (siehe Abbildung 4 und Abbildung 5).
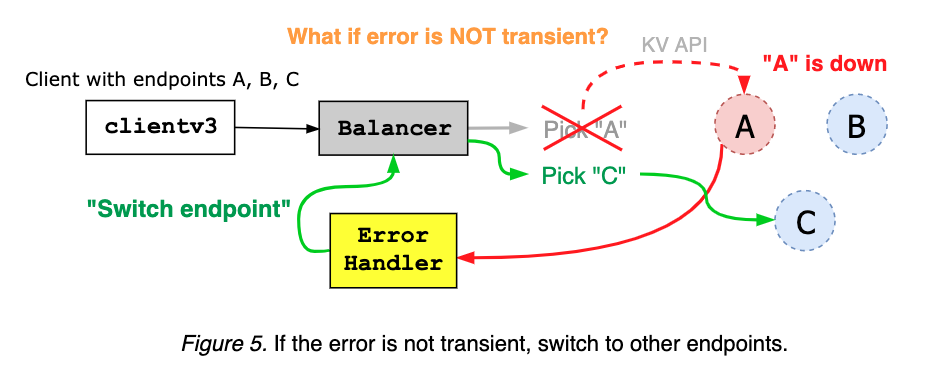
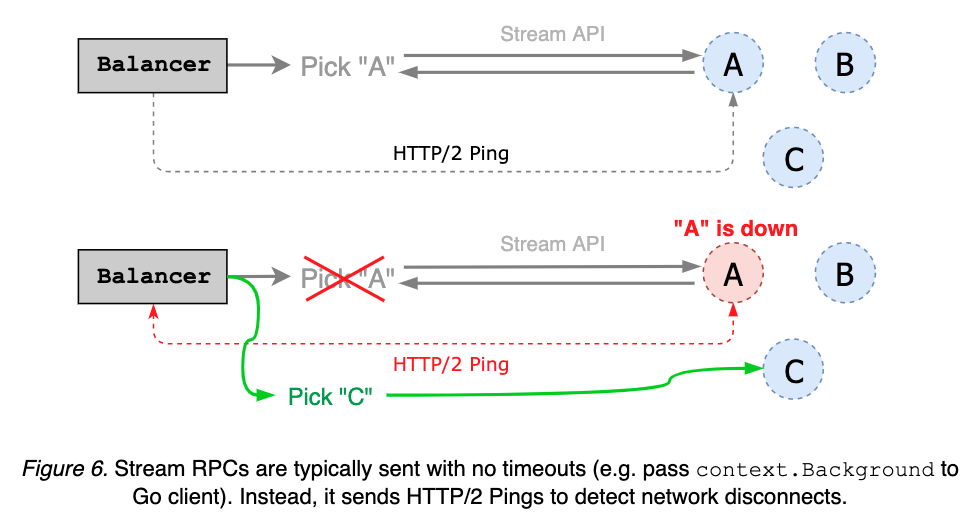
Streaming-RPCs wie Watch und KeepAlive werden häufig ohne Zeitlimit angefordert. Stattdessen kann der Client regelmäßig HTTP/2-Pings senden, um den Zustand eines fest zugeordneten Endpunkts zu prüfen. Antwortet der Server nicht auf den Ping, wechselt der Load-Balancer zu anderen Endpunkten (siehe Abbildung 6).
clientv3-grpc1.7: Einschränkungen des Load-Balancers
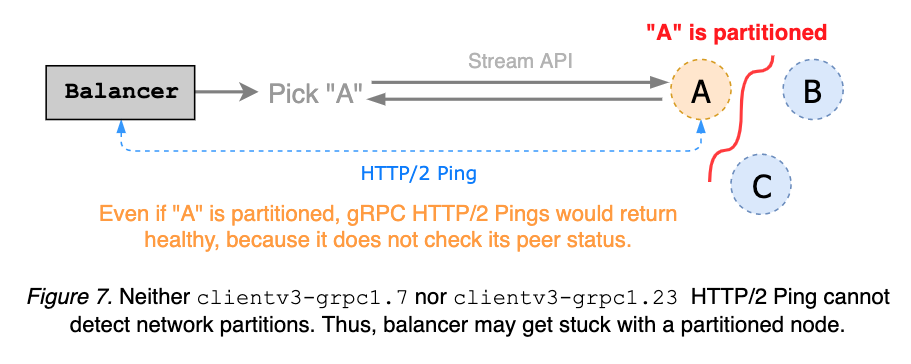
Der Load-Balancer von clientv3-grpc1.7 sendet HTTP/2-Keepalives, um Verbindungsabbrüche bei Streaming-Anfragen zu erkennen. Dieser einfache Ping-Mechanismus für gRPC-Server berücksichtigt keine Clustermitgliedschaft und kann daher Netzwerkpartitionen nicht erkennen. Da ein abgetrennter gRPC-Server weiterhin auf Client-Pings antworten kann, kann der Load-Balancer an diesem Knoten hängen bleiben. Idealerweise erkennt der Keepalive-Ping die Partition und löst vor Ablauf des Anfragezeitlimits einen Endpunktwechsel aus (siehe etcd#8673
und Abbildung 7).
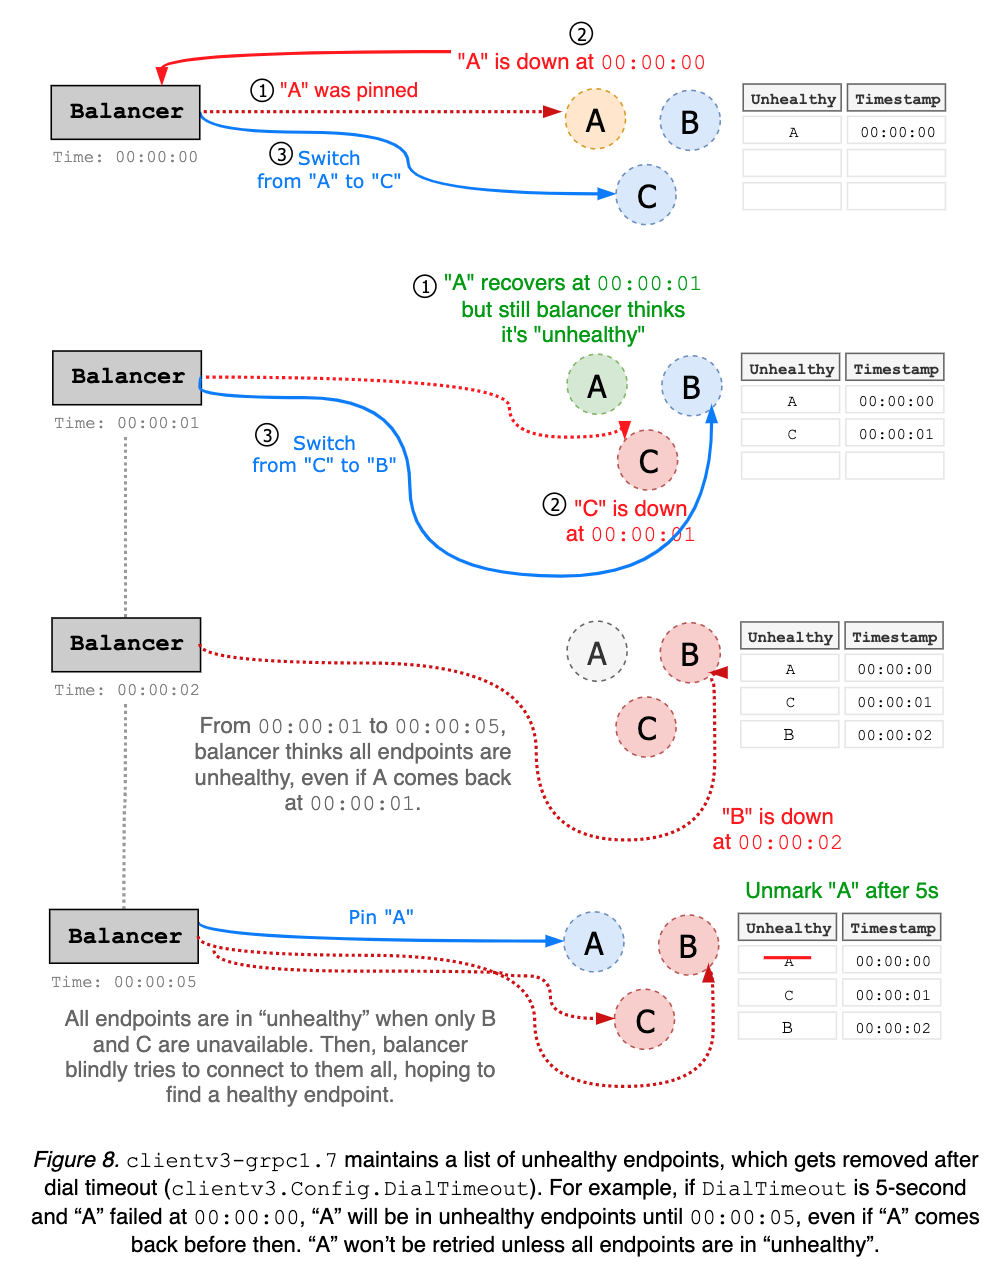
Der Load-Balancer von clientv3-grpc1.7 führt eine Liste nicht funktionsfähiger Endpunkte. Adressen mit abgebrochener Verbindung werden dieser Liste hinzugefügt und gelten bis zum Ende einer Wartezeit als nicht verfügbar. Diese Wartezeit ist fest an das Verbindungsaufbau-Zeitlimit mit einem Standardwert von 5 Sekunden gekoppelt. Der Load-Balancer kann Endpunkte fälschlich als nicht funktionsfähig einstufen. Beispielsweise kann Endpunkt A unmittelbar nach Aufnahme in die Sperrliste zurückkehren, bleibt aber dennoch für die nächsten 5 Sekunden unbenutzbar (siehe Abbildung 8).
clientv3-grpc1.0 hatte dieselben oben beschriebenen Probleme.
Das Upstream-Projekt gRPC Go war bereits auf die neue Load-Balancer-Schnittstelle umgestiegen. So verwendet die zugrunde liegende Implementierung von clientv3-grpc1.7 den neuen gRPC-Load-Balancer und versucht dabei, das Verhalten des alten beizubehalten. Obwohl die Kompatibilität recht gut erhalten blieb, war der etcd-Client dennoch von subtilen inkompatiblen Änderungen betroffen
. Zudem empfiehlt der gRPC-Maintainer, sich nicht auf die alte Load-Balancer-Schnittstelle zu stützen
. Für bessere Unterstützung durch Upstream ist es generell am besten, mit den neuesten gRPC-Versionen Schritt zu halten. Neue Funktionen wie Wiederholungsrichtlinien werden möglicherweise nicht auf den gRPC-1.7-Zweig zurückportiert. Daher müssen sowohl etcd-Server als auch -Client auf die neuesten gRPC-Versionen umsteigen.
clientv3-grpc1.23: Überblick über den Load-Balancer
clientv3-grpc1.7 ist so eng an die alte gRPC-Schnittstelle gekoppelt, dass jedes Upgrade der gRPC-Abhängigkeit das Client-Verhalten beeinträchtigte. Der Großteil der Entwicklungs- und Fehlersucharbeit floss in die Behebung dieser Verhaltensänderungen. Dadurch wurde die Implementierung übermäßig komplex und beruhte auf falschen Annahmen über Serververbindungen.
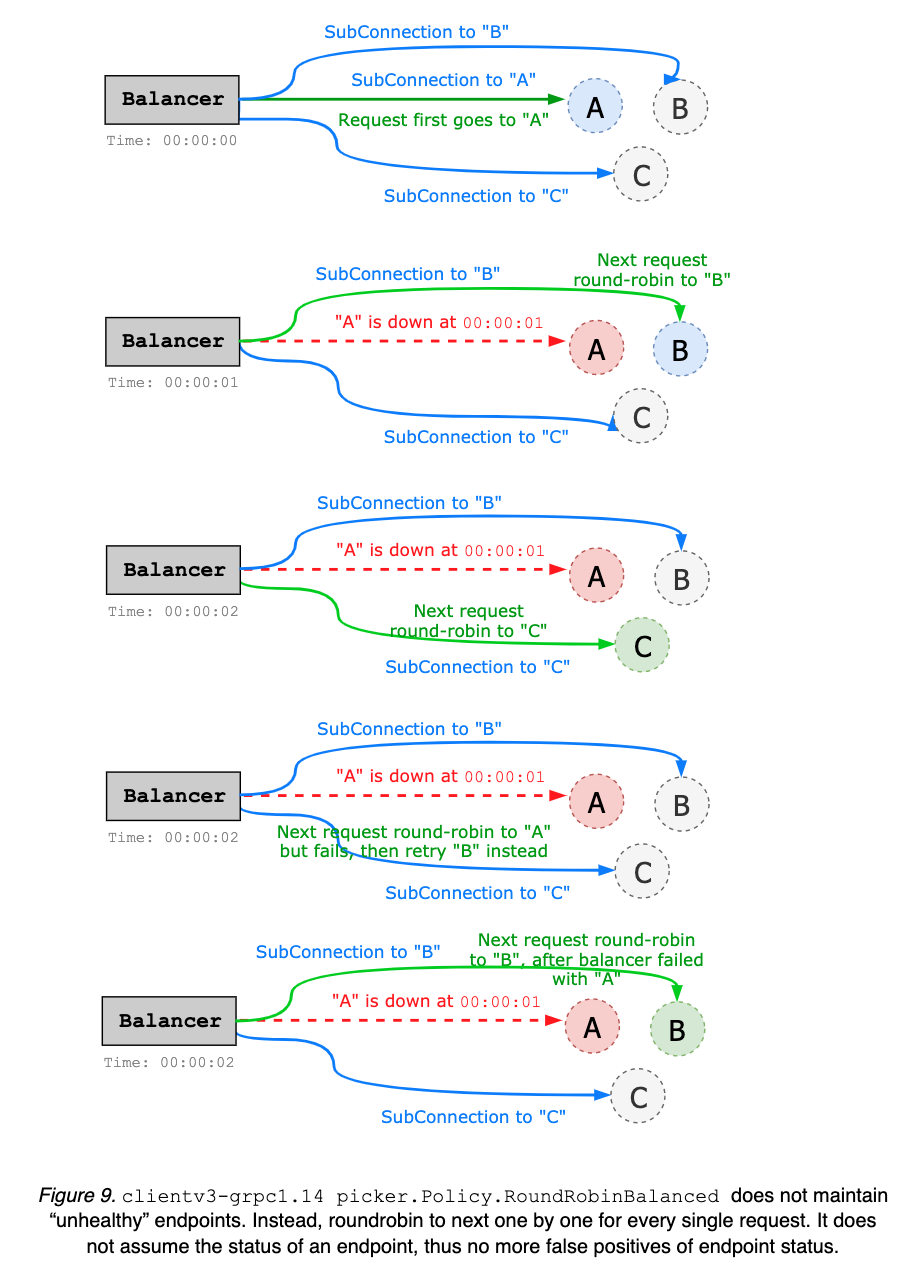
Das Hauptziel von clientv3-grpc1.23 ist eine einfachere Failover-Logik des Load-Balancers. Statt eine möglicherweise veraltete Liste nicht funktionsfähiger Endpunkte zu führen, wechselt er bei jedem Verbindungsabbruch zum aktuellen Endpunkt im Round-Robin-Verfahren zum nächsten. Er trifft keine Annahmen über den Endpunktzustand. Eine komplexe Zustandsverfolgung ist daher nicht mehr nötig (siehe Abbildung 8 und die vorangehenden Erläuterungen). Ein Upgrade auf clientv3-grpc1.23 sollte problemlos sein: Alle Änderungen waren intern und bewahrten die vollständige Abwärtskompatibilität.
Bei mehreren Endpunkten erstellt clientv3-grpc1.23 intern mehrere Unterverbindungen, eine pro Endpunkt. clientv3-grpc1.7 erstellt dagegen nur eine Verbindung zu einem fest zugeordneten Endpunkt (siehe Abbildung 9). In einem Cluster mit 5 Knoten benötigt der Load-Balancer von clientv3-grpc1.23 beispielsweise 5 TCP-Verbindungen, während clientv3-grpc1.7 nur eine benötigt. Durch den erhaltenen TCP-Verbindungspool kann clientv3-grpc1.23 mehr Ressourcen verbrauchen, bietet aber eine flexiblere Lastverteilung mit besserer Failover-Leistung. Standardmäßig wird Round Robin verwendet; andere Verfahren wie „Power of Two“ oder die Auswahl des Leaders lassen sich leicht ergänzen. clientv3-grpc1.23 verwendet eine gRPC-Resolver-Gruppe und implementiert eine Auswahlrichtlinie für den Load-Balancer, um die komplexe Lastverteilung an Upstream-gRPC zu delegieren. clientv3-grpc1.7 verwaltet dagegen jede gRPC-Verbindung und das Failover selbst, was die Implementierung verkompliziert. clientv3-grpc1.23 implementiert Wiederholungen in der gRPC-Interceptor-Kette, die interne gRPC-Fehler automatisch behandelt und fortgeschrittene Wiederholungsrichtlinien wie Backoff ermöglicht. clientv3-grpc1.7 wertet gRPC-Fehler für Wiederholungen dagegen selbst aus.
clientv3-grpc1.23: Einschränkungen des Load-Balancers
Verbesserungen sind durch Zwischenspeichern des Zustands jedes Endpunkts möglich. Beispielsweise kann der Load-Balancer vorab jeden Server anpingen, um eine Liste funktionsfähiger Kandidaten zu führen und diese Informationen beim Round-Robin-Verfahren zu nutzen. Oder er kann nach einem Verbindungsabbruch funktionsfähige Endpunkte bevorzugen. Dies kann die Implementierung verkomplizieren und deshalb in späteren Versionen behandelt werden.
Der clientseitige Keepalive-Ping berücksichtigt weiterhin keine Netzwerkpartitionen. Streaming-Anfragen können an einem abgetrennten Knoten hängen bleiben. Um die Clustermitgliedschaft zu berücksichtigen, muss ein erweiterter Health-Check-Dienst implementiert werden (Einzelheiten unter etcd#8673 ).
Derzeit wird die Wiederholungslogik manuell als Interceptor umgesetzt. Dies kann durch offizielle gRPC-Wiederholungen vereinfacht werden.