Hochverfügbarkeit über mehrere Rechenzentren
Die Hochverfügbarkeit eines PostgreSQL-Clusters über mehrere Rechenzentren basiert auf synchroner oder asynchroner Replikation (siehe Replikationsmodi ).
In beiden Fällen sind folgende Grundsätze wichtig:
- Postgres kann nur dann als Primärserver oder Standby-Leader laufen, wenn es den Leader-Schlüssel besitzt und aktualisieren kann.
- Die Anzahl der etcd-, ZooKeeper- oder Consul-Knoten sollte ungerade sein: 3 oder 5!
Synchrone Replikation
Ein Cluster über mehrere Rechenzentren (DC), der den Ausfall einer Zone automatisch verkraften soll, benötigt mindestens 3 Zonen.
Das Architekturdiagramm sieht folgendermaßen aus:
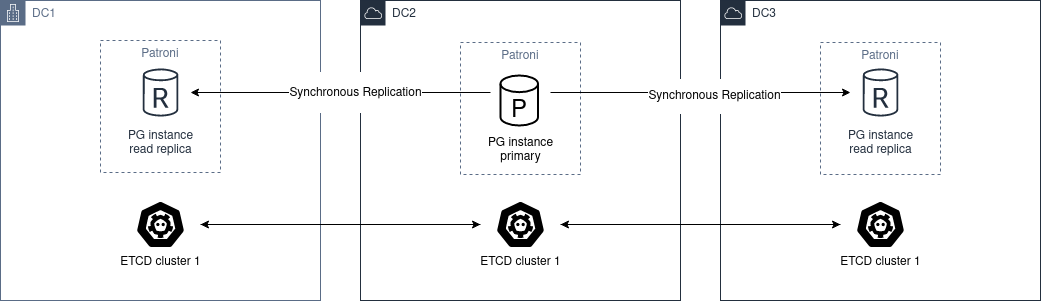
Ein Cluster aus etcd, ZooKeeper oder Consul muss über die verschiedenen Rechenzentren verteilt werden, mit mindestens 3 Knoten und jeweils einem Knoten pro Zone.
Für Postgres müssen mindestens 2 Knoten in unterschiedlichen Rechenzentren bereitgestellt werden. Anschließend muss synchronous_mode: true in der globalen dynamischen Konfiguration
gesetzt werden.
Dies aktiviert synchrone Replikation; der Primärserver wählt einen der Knoten als synchronen Knoten aus.
Asynchrone Replikation
Bei nur zwei Rechenzentren ist es besser, zwei unabhängige etcd-Cluster zu betreiben und im zweiten Rechenzentrum einen Patroni-Standby-Cluster einzurichten. Fällt der erste Standort aus, kann der standby_cluster MANUELL hochgestuft werden.
Das Architekturdiagramm sieht folgendermaßen aus:
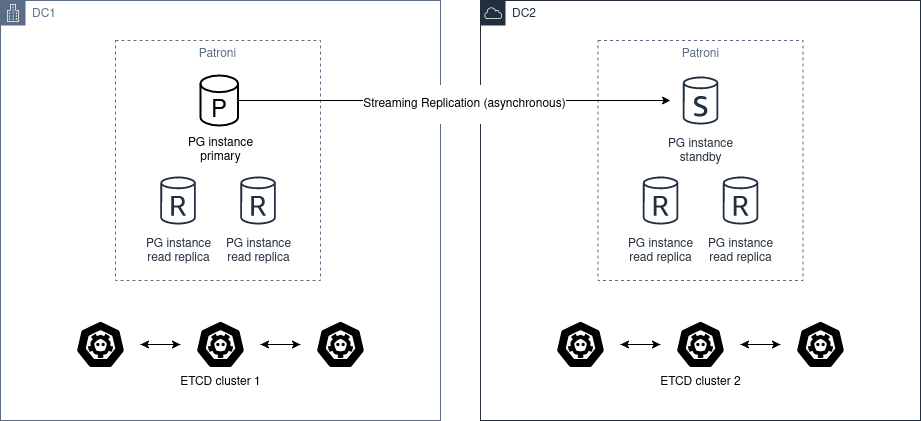
Eine automatische Hochstufung ist nicht möglich, da DC2 den Zustand von DC1 niemals sicher bestimmen kann.
In diesem Szenario sollte pg_ctl promote nicht verwendet werden. Stattdessen muss der funktionsfähige Cluster „manuell hochgestuft“ werden, indem der Abschnitt standby_cluster
aus der dynamischen Konfiguration
entfernt wird.
Läuft der Quellcluster noch und wird der Standby-Cluster hochgestuft, entsteht eine Split-Brain-Situation.
Um zum „ursprünglichen“ Zustand zurückzukehren, gibt es nur zwei Möglichkeiten:
- Den Abschnitt standby_cluster wieder hinzufügen. Dies löst
pg_rewindaus. Damitpg_rewindordnungsgemäß funktioniert, muss der Cluster mitdata page checksums(Option--data-checksumsfürinitdb) initialisiert worden sein und/oderwal_log_hintsmuss aufongesetzt sein. Dennoch kannpg_rewindaus anderen Gründen fehlschlagen. - Den Standby-Cluster vollständig neu aufbauen.
Vor der Hochstufung des Standby-Clusters muss manuell sichergestellt werden, dass der Quellcluster heruntergefahren ist (STONITH). Sobald DC1 wieder verfügbar ist, muss dessen Cluster in einen Standby-Cluster umgewandelt werden.
Zuvor kann die Datenbank manuell untersucht werden, um alle Änderungen zu extrahieren, die zwischen dem Ausfall der Netzwerkverbindung von DC1 zu DC2 und dem manuellen Stoppen des Clusters in DC1 erfolgt sind.
Die extrahierten Änderungen können anschließend auch manuell auf den Cluster in DC2 angewendet werden.