Мониторинг etcd
Каждый сервер etcd предоставляет локальные сведения мониторинга через конечные точки HTTP на клиентском порту. Эти данные полезны для проверки состояния системы и отладки кластера.
Конечная точка отладки
Если задан --log-level=debug, сервер etcd экспортирует отладочные сведения по
пути /debug на клиентском порту. Используйте --log-level=debug осторожно:
он снижает производительность и включает подробное ведение журнала.
/debug/pprof — стандартная конечная точка профилирования среды выполнения Go.
Она позволяет профилировать использование CPU, кучи, мьютексов и goroutine.
В примере go tool pprof получает 10 функций, на которые etcd тратит больше всего времени:
Конечная точка /debug/requests показывает трассировки gRPC и статистику
производительности в веб-браузере. Например, так выглядит запрос Range для ключа abc:
Конечная точка метрик
Каждый сервер etcd экспортирует метрики по пути /metrics на клиентском порту
и, необязательно, по адресам из --listen-metrics-urls.
Метрики можно получить с помощью curl:
Проверка состояния
Начиная с v3.3.0, все адреса из --listen-metrics-urls отвечают не только через
/metrics, но и через /health. Это полезно, когда стандартная конечная точка
защищена взаимной клиентской аутентификацией TLS, но балансировщику нагрузки или
службе мониторинга всё ещё нужен доступ к проверке состояния.
Начиная с v3.4 добавлены две конечные точки: /livez и /readyz.
/livezпоказывает, работает ли процесс или его необходимо перезапустить;/readyzпоказывает, готов ли процесс обслуживать трафик.
Архитектура конечных точек описана в KEP .
Каждая конечная точка включает несколько отдельных проверок. Параметр verbose
выводит подробности проверок и их состояние, например:
Ответ будет выглядеть примерно так:
API HTTP также позволяет исключать отдельные проверки, например:
Prometheus
Самый простой способ получать и сохранять метрики etcd — запустить службу мониторинга Prometheus .
Сначала установите Prometheus:
Настройте сборщик Prometheus на конечные точки кластера etcd:
Запустите обработчик Prometheus:
Теперь Prometheus будет собирать метрики etcd каждые 10 секунд.
Оповещения
Для кластеров etcd v3 доступен набор стандартных оповещений Prometheus.
Метки job может потребоваться адаптировать к конкретной задаче. Правила рассчитаны на один кластер, поэтому рекомендуется выбирать уникальные для кластера метки.
Grafana
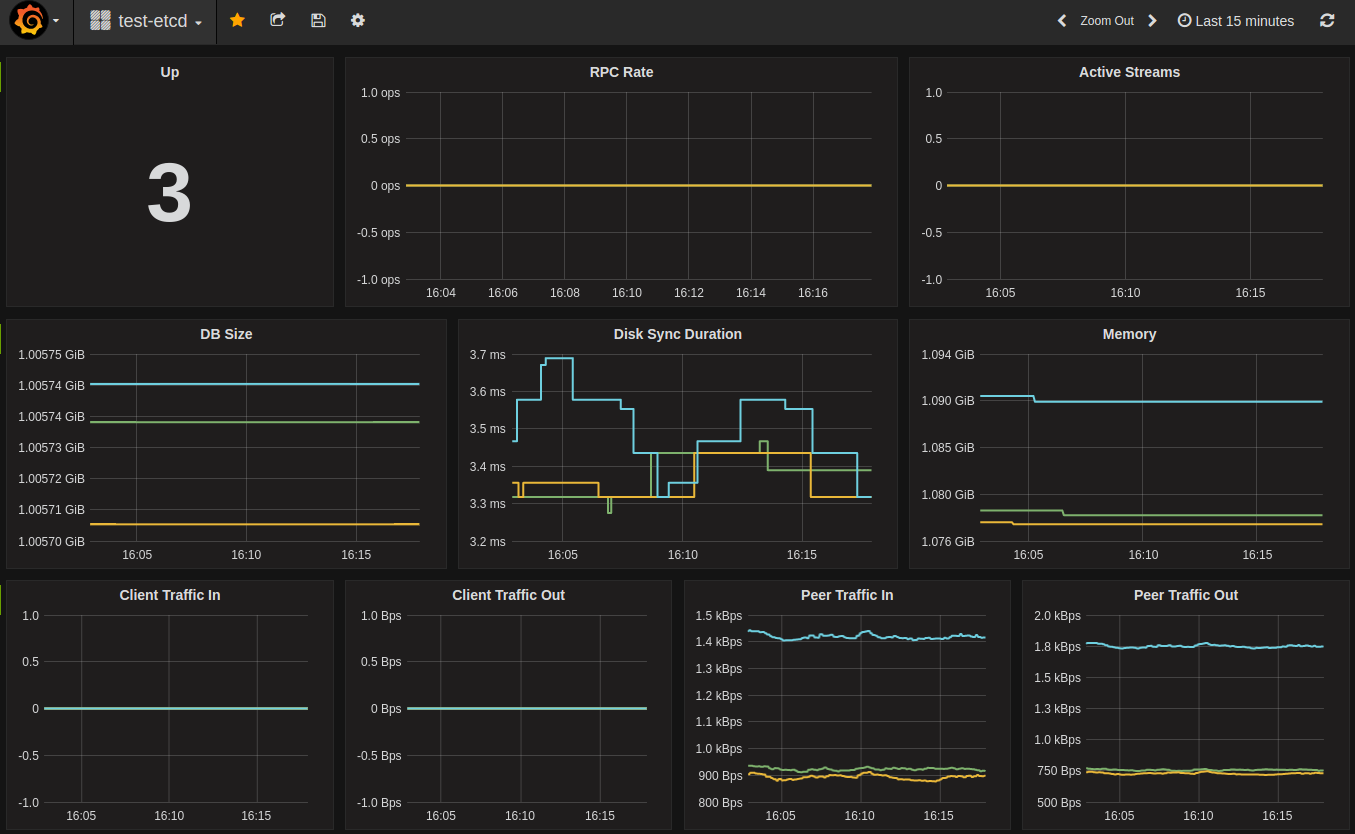
Grafana имеет встроенную поддержку Prometheus; добавьте источник данных Prometheus:
Затем импортируйте стандартный шаблон панели etcd
и настройте его.
Например, если источник данных Prometheus называется my-etcd, поля datasource
в JSON также должны иметь значение my-etcd.
Пример панели:
Распределённая трассировка
В v3.5 etcd добавлена распределённая трассировка с помощью OpenTelemetry .
В etcd 3.7 используйте приведённые ниже флаги трассировки без прежнего экспериментального префикса.
Чтобы включить распределённую трассировку, передайте серверу etcd
--enable-distributed-tracing=true и флаг
--distributed-tracing-sampling-rate=<number>, задающий число
выборок на миллион спанов. Частота выборки по умолчанию — 0.
Настройте распределённую трассировку, запустив сервер etcd со следующими необязательными флагами:
-
--distributed-tracing-address- (необязательно) - “localhost:4317” - адрес сборщика трассировок. -
--distributed-tracing-service-name- (необязательно) - “etcd” - имя службы распределённой трассировки, которое должно быть одинаковым для всех экземпляров etcd. -
--distributed-tracing-instance-id- (необязательно) - идентификатор экземпляра; хотя параметр необязателен, его настоятельно рекомендуется задать, и он должен быть уникальным для каждого экземпляра etcd.
Перед включением распределённой трассировки убедитесь, что конечная точка
OpenTelemetry доступна. Если её адрес отличается от стандартного, переопределите
его флагом --distributed-tracing-address. Варианты запуска
OpenTelemetry описаны в документации сборщика
.
Как и любой сигнал наблюдаемости, эта возможность расходует ресурсы. По первым измерениям дополнительные затраты CPU могут составлять от 2% до 4%.