etcd überwachen
Jeder etcd-Server stellt über HTTP-Endpunkte auf seinem Clientport lokale Überwachungsinformationen bereit. Diese Daten helfen sowohl bei der Prüfung des Systemzustands als auch bei der Fehlersuche im Cluster.
Debug-Endpunkt
Ist --log-level=debug gesetzt, stellt der etcd-Server auf seinem Clientport unter dem Pfad /debug Informationen zur Fehlersuche bereit. --log-level=debug mit Bedacht setzen, da dies die Leistung beeinträchtigt und eine ausführliche Protokollierung verursacht.
Der Endpunkt /debug/pprof ist der standardmäßige Profiling-Endpunkt der Go-Laufzeitumgebung. Damit lassen sich CPU-, Heap-, Mutex- und Goroutine-Nutzung untersuchen. Im folgenden Beispiel ermittelt go tool pprof die 10 Funktionen, in denen etcd die meiste Zeit verbringt:
Der Endpunkt /debug/requests stellt gRPC-Traces und Leistungsstatistiken für einen Webbrowser bereit. Hier ist beispielsweise eine Range-Anfrage für den Schlüssel abc zu sehen:
Metrikendpunkt
Jeder etcd-Server stellt Metriken unter dem Pfad /metrics auf seinem Clientport sowie optional an den mit --listen-metrics-urls angegebenen Adressen bereit.
Die Metriken lassen sich mit curl abrufen:
Health Check
Seit v3.3.0 antworten alle mit --listen-metrics-urls angegebenen Adressen neben /metrics auch auf den Endpunkt /health. Dies ist hilfreich, wenn der Standardendpunkt mit gegenseitiger TLS-Authentifizierung (Clientauthentifizierung) konfiguriert ist, ein Load-Balancer oder Überwachungsdienst aber weiterhin Zugriff auf den Health Check benötigt.
Seit v3.4 gibt es die beiden neuen Endpunkte /livez und /readyz.
- Der Endpunkt
/livezzeigt an, ob der Prozess lebt oder neu gestartet werden muss. - Der Endpunkt
/readyzzeigt an, ob der Prozess bereit ist, Anfragen zu bedienen.
Die Entwurfsdetails der Endpunkte sind im KEP dokumentiert.
Jeder Endpunkt umfasst mehrere einzelne Health Checks. Mit dem Parameter verbose lassen sich Einzelheiten und Status der Prüfungen ausgeben, beispielsweise:
Die Antwort sieht dann etwa so aus:
Die HTTP-API unterstützt auch den Ausschluss einzelner Prüfungen, beispielsweise:
Prometheus
Ein Überwachungsdienst mit Prometheus ist der einfachste Weg, die Metriken von etcd zu erfassen und aufzuzeichnen.
Zunächst Prometheus installieren:
Die Endpunkte des etcd-Clusters als Abrufziele von Prometheus festlegen:
Den Prometheus-Handler einrichten:
Prometheus ruft nun alle 10 Sekunden die Metriken von etcd ab.
Alarmierung
Für etcd-v3-Cluster gibt es einen Satz von Standardalarmen für Prometheus.
Die job-Labels müssen möglicherweise an die jeweiligen Anforderungen angepasst werden. Die Regeln wurden für einen einzelnen Cluster geschrieben; daher werden Labels empfohlen, die für einen Cluster eindeutig sind.
Grafana
Grafana unterstützt Prometheus von Haus aus; dazu einfach eine Prometheus-Datenquelle hinzufügen:
Anschließend die standardmäßige etcd-Dashboardvorlage
importieren und anpassen. Heißt die Prometheus-Datenquelle beispielsweise my-etcd, müssen auch die Werte der datasource-Felder im JSON my-etcd lauten.
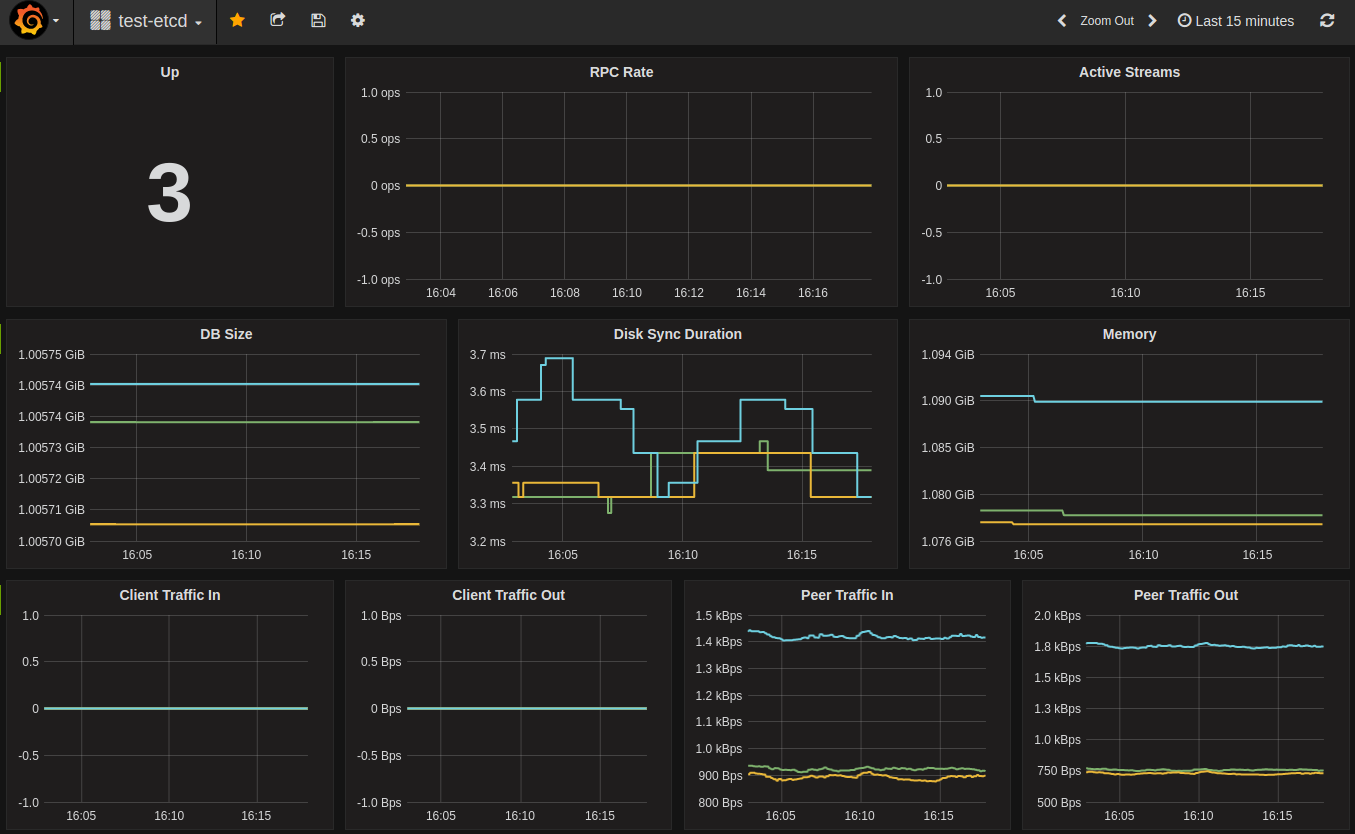
Beispieldashboard:
Verteiltes Tracing
In v3.5 wurde etcd um Unterstützung für verteiltes Tracing mit OpenTelemetry erweitert.
In etcd 3.7 die folgenden Tracing-Optionen ohne das frühere Präfix experimental verwenden.
Um verteiltes Tracing zu aktivieren, dem etcd-Server --enable-distributed-tracing=true übergeben. Mit der Option --distributed-tracing-sampling-rate=<number> wird zusätzlich festgelegt, wie viele Stichproben pro Million Spans erfasst werden; die Standardrate ist 0.
Das verteilte Tracing lässt sich konfigurieren, indem der etcd-Server mit folgenden optionalen Optionen gestartet wird:
-
--distributed-tracing-address- (Optional) - “localhost:4317” - Adresse des Tracing-Collectors. -
--distributed-tracing-service-name- (Optional) - “etcd” - Dienstname für verteiltes Tracing; muss für alle etcd-Instanzen gleich sein. -
--distributed-tracing-instance-id- (Optional) - Instanz-ID; ihre Angabe ist optional, wird aber dringend empfohlen. Sie muss für jede etcd-Instanz eindeutig sein.
Vor der Aktivierung des verteilten Tracings sicherstellen, dass ein OpenTelemetry-Endpunkt verfügbar ist. Weicht seine Adresse vom Standard ab, sie mit --distributed-tracing-address überschreiben. Da OpenTelemetry auf verschiedene Arten betrieben werden kann, enthält die Collector-Dokumentation
weitere Informationen.
Wie jedes Signal zur Beobachtung des Systems verursacht auch diese Funktion zusätzlichen Ressourcenbedarf. Nach unseren ersten Messungen kann die zusätzliche CPU-Last zwischen 2% - 4% liegen.