etcdクライアントの設計
etcdクライアントの設計
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
はじめに
etcdサーバーの堅牢性は、長年にわたる障害注入テストで実証されています。複雑なアプリケーションロジックの大半は、etcdサーバーとそのデータストアがすでに処理しています。たとえば、クラスターのメンバーシップはクライアントから透過的に扱われ、Raftレイヤーが提案をリーダーに転送します。サーバーの構成要素が正しく動作していても、クライアントと組み合わせたときに、障害下での正しさと高可用性を保証するには、別の複雑なプロトコル群が必要です。理想的には、etcdサーバーが多数の物理マシンを1つの論理クラスターとして提供し、クライアントがレプリカ間の自動フェイルオーバーを実装します。このドキュメントでは、クライアントのアーキテクチャに関する判断と実装の詳細を説明します。
用語集
clientv3:etcd v3 API用の、etcd公式Goクライアントです。
clientv3-grpc1.0:grpc-go v1.0.x
を使う公式クライアント実装で、etcd v3.1の最新版で使用されています。
clientv3-grpc1.7:grpc-go v1.7.x
を使う公式クライアント実装で、etcd v3.2とv3.3の最新版で使用されています。
clientv3-grpc1.23:grpc-go v1.23.x
を使う公式クライアント実装で、etcd v3.4の最新版で使用されています。
バランサー:再試行とフェイルオーバーの仕組みを実装する、etcdクライアントのロードバランサーです。etcdクライアントには、複数のエンドポイント間で負荷を自動的に分散することが求められます。
エンドポイント:クライアントが接続できるetcdサーバーのエンドポイントの一覧です。通常、etcdクラスターの3個または5個のクライアントURLです。
固定エンドポイント:複数のエンドポイントが設定されている場合、v3.3以下のクライアントバランサーは、etcdクラスターへの接続総数を抑えるため、1つのエンドポイントだけを選んでTCP接続を確立します。v3.4では、バランサーがリクエストごとに固定エンドポイントをラウンドロビンで選び、負荷をより均等に分散します。
クライアント接続:gRPC Dialによってetcdサーバーとの間に確立されたTCP接続です。
サブ接続:gRPCのSubConnインターフェースです。各サブ接続は、アドレスのリストを持ちます。バランサーは、解決したアドレスのリストからSubConnを作成します。gRPCのClientConnは、複数のSubConnに対応できます。たとえば、example.comが解決された10.10.10.1と10.10.10.2は、2つのサブ接続になります。etcd v3.4のバランサーは内部リゾルバーを使い、エンドポイントごとに1つのサブ接続を確立します。
一時的な切断:gRPCサーバーが、code Unavailable
のステータスエラーを返すことです。
クライアントの要件
正しさ。サーバーの障害によってリクエストが失敗することはあります。しかし、グローバルな順序の性質、破損データを書き込まないこと、変更操作を多くても1回だけ実行する意味論、監視がイベントの一部だけを観測しないことなど、一貫性の保証に違反することはありません。
活性。サーバーは故障したり、一時的に切断されたりすることがあります。どちらの場合も、クライアントは処理を進められるべきです。そうするよう設定されていない限り、オフラインのサーバーの復帰を待ってデッドロックすべきではありません 。理想的には、クライアントがHTTP/2のpingで利用不能なサーバーを検出し、明確なエラーメッセージを伴って他のノードにフェイルオーバーします。
効率性。クライアントは、最小限のリソースで効率的に動作するべきです。エンドポイントの切り替え後は、それまでのTCP接続を正常に閉じる べきです。フェイルオーバー機構は、障害ノードに対して無駄な再試行を繰り返さず、次に接続するレプリカを的確に予測するべきです。
移植性。公式クライアントは明確に文書化され、その実装を他の言語バインディングにも適用できることが求められます。言語バインディング間で、エラー処理は一貫しているべきです。etcdはgRPCを全面的に採用しているため、その実装もgRPCの長期的な設計目標に沿うべきです。たとえば、差し替え可能な再試行ポリシーは、gRPCの再試行 と互換性を持つべきです。クライアントのバージョン間のアップグレードは、動作を中断させないものであるべきです。
クライアントの概要
etcdクライアントは、次の構成要素を実装しています。
- etcdクラスターへのgRPC接続を確立するバランサー
- etcdサーバーへRPCを送信するAPIクライアント
- 失敗したリクエストを再試行するか、エンドポイントを切り替えるかを決めるエラーハンドラー
初期接続の確立方法(TLSの設定など)、Protocol Buffersメッセージをエンコードしてサーバーに送信する方法、ストリーミングRPCの処理方法などは、言語によって異なる場合があります。ただし、etcdサーバーが返すエラーは同じです。エラー処理と再試行ポリシーも同じであるべきです。
たとえば、etcdサーバーが"rpc error: code = Unavailable desc = etcdserver: request timed out"を返す場合、これは再試行が想定される一時的なエラーです。一方、rpc error: code = InvalidArgument desc = etcdserver: key is not providedは、リクエストが無効であり、再試行するべきでないことを意味します。Goクライアントはgoogle.golang.org/grpc/status.FromError、Javaクライアントはio.grpc.Status.fromThrowableでエラーを解析できます。
clientv3-grpc1.0:バランサーの概要
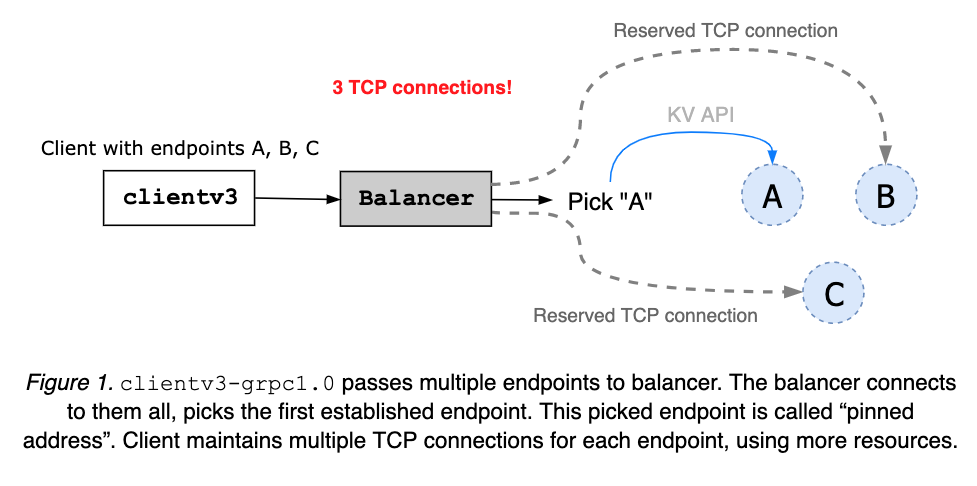
clientv3-grpc1.0は、複数のetcdエンドポイントが設定されると、複数のTCP接続を維持します。その中から1つのアドレスを選び、クライアントのすべてのリクエストの送信に使用します。固定したアドレスは、クライアントオブジェクトが閉じられるまで維持します(図1)。エラーを受け取ると、クライアントはランダムに別のアドレスを選んで再試行します。
clientv3-grpc1.0:バランサーの制限
clientv3-grpc1.0は複数のTCP接続を開くため、バランサーのフェイルオーバーを高速化できる可能性がありますが、より多くのリソースが必要です。バランサーは、ノードの健全性やクラスターのメンバーシップを把握していません。そのため、障害が起きたノードや、ネットワーク分断されたノードに接続したまま動けなくなることがあります。
clientv3-grpc1.7:バランサーの概要
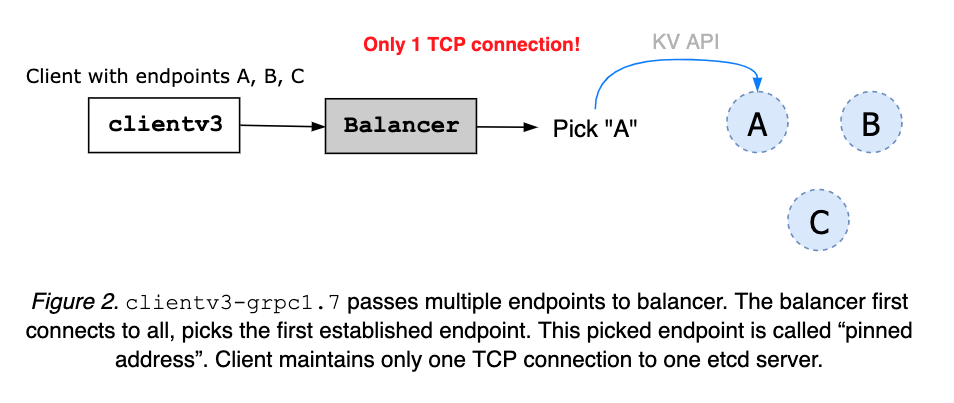
clientv3-grpc1.7は、選択したetcdサーバーへのTCP接続を1つだけ維持します。複数のクラスターエンドポイントが指定されると、クライアントはまずすべてへの接続を試みます。1つの接続が確立すると、バランサーはそのアドレスを固定し、他の接続を閉じます(図2)。固定したアドレスは、クライアントオブジェクトが閉じられるまで維持します。サーバーまたはクライアント側のネットワーク障害によるエラーは、クライアントのエラーハンドラーに渡されます(図3)。
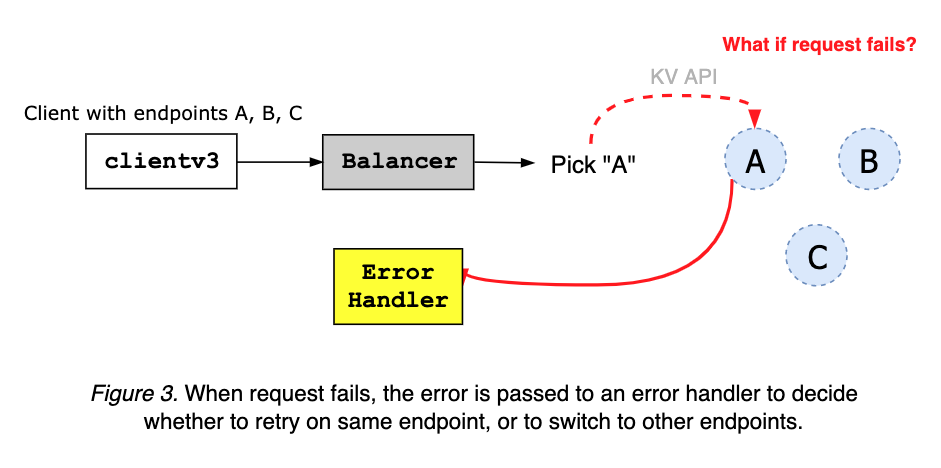
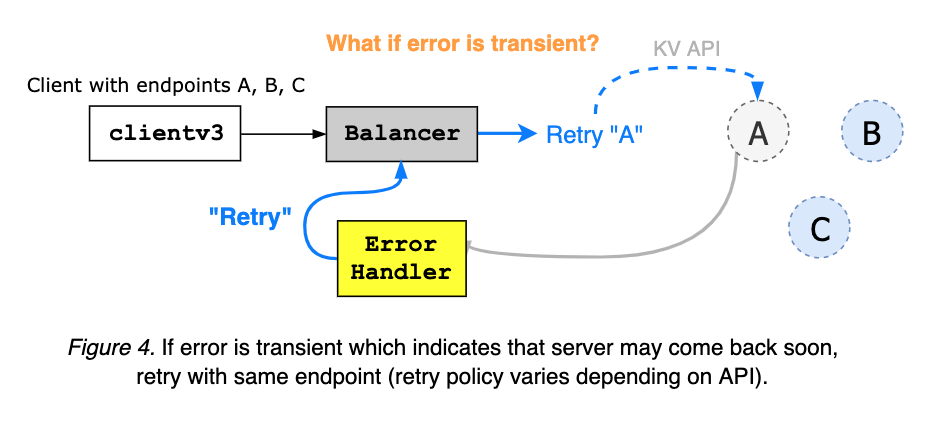
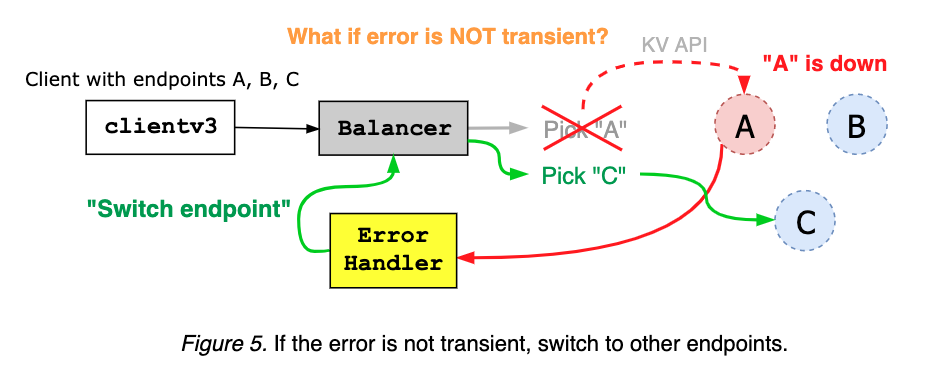
クライアントのエラーハンドラーはgRPCサーバーからエラーを受け取り、エラーコードとメッセージに基づいて、同じエンドポイントで再試行するか、別のアドレスに切り替えるかを決めます(図4と図5)。
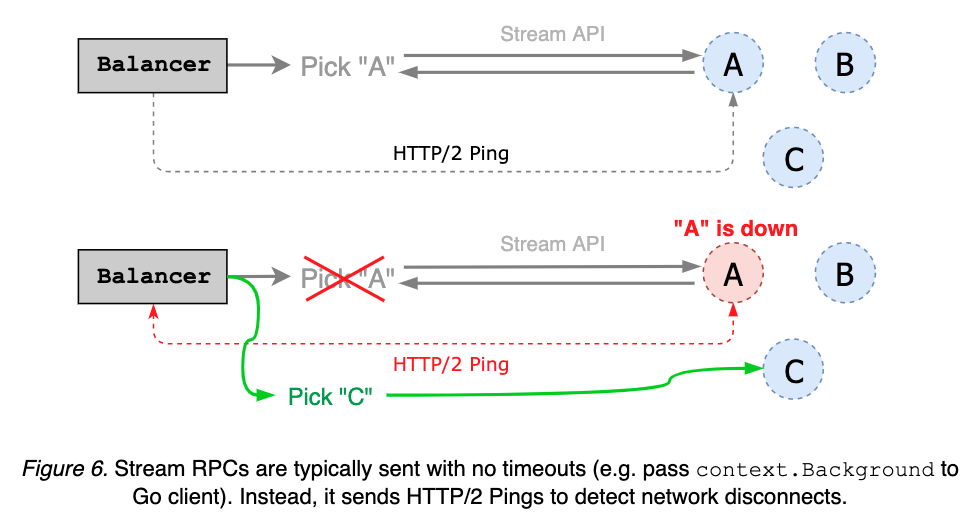
WatchやKeepAliveなどのストリーミングRPCは、タイムアウトを設定せずに要求されることがよくあります。その代わりに、クライアントはHTTP/2のpingを定期的に送信して、固定エンドポイントの状態を確認できます。サーバーがpingに応答しなければ、バランサーは他のエンドポイントに切り替えます(図6)。
clientv3-grpc1.7:バランサーの制限
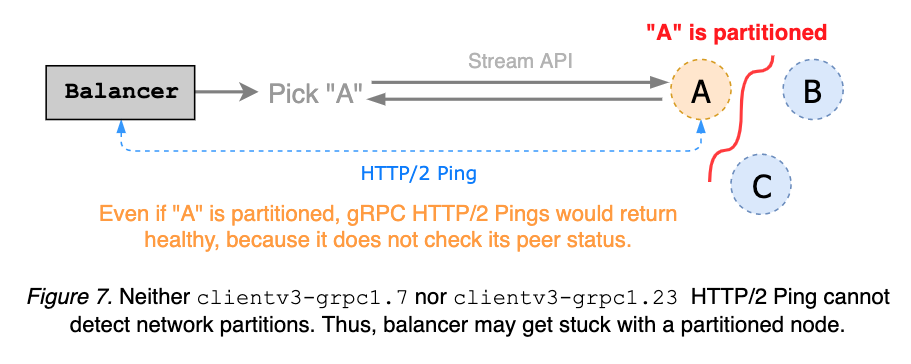
clientv3-grpc1.7のバランサーは、HTTP/2のキープアライブを送信し、ストリーミングリクエストの切断を検出します。これはgRPCサーバーへの単純なping機構であり、クラスターのメンバーシップを考慮しないため、ネットワーク分断を検出できません。分断されたgRPCサーバーもクライアントのpingに応答できるため、バランサーがそのノードに接続したまま動けなくなることがあります。理想的には、キープアライブのpingが分断を検出し、リクエストのタイムアウト前にエンドポイントの切り替えを引き起こすべきです(etcd#8673
と図7を参照)。
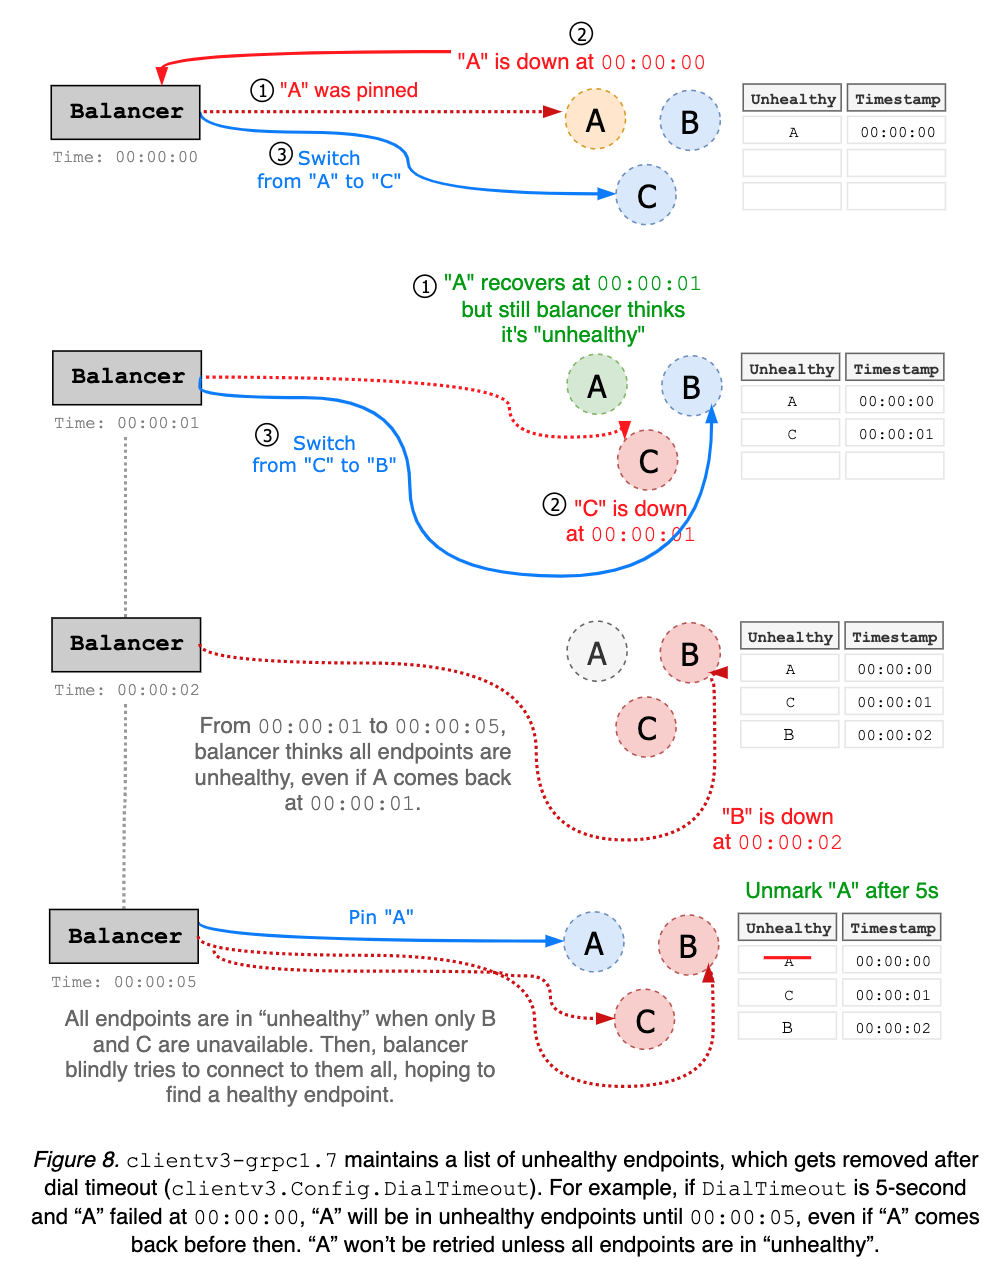
clientv3-grpc1.7のバランサーは、健全でないエンドポイントの一覧を維持します。切断されたアドレスはこの一覧に追加され、待機時間が過ぎるまで利用不能と見なされます。待機時間は接続タイムアウトと同じ値に固定され、デフォルトは5秒です。バランサーは、エンドポイントが健全でないと誤判定することがあります。たとえば、エンドポイントAが除外リストに入った直後に復帰しても、その後5秒間は使用できません(図8)。
clientv3-grpc1.0にも、上記と同じ問題がありました。
アップストリームのgRPC Goは、すでに新しいバランサーインターフェースに移行していました。たとえば、clientv3-grpc1.7の内部のバランサー実装は、新しいgRPCバランサーを使用しながら、古いバランサーの動作との整合性を保とうとしています。互換性はおおむね維持されていましたが、etcdクライアントは微妙な互換性破壊の影響を受けていました
。また、gRPCのメンテナーは、古いバランサーインターフェースに依存しない
ことを推奨しています。一般に、アップストリームからより良いサポートを受けるには、最新のgRPCリリースに追従するのが最善です。再試行ポリシーなどの新機能も、gRPC 1.7ブランチにはバックポートされない可能性があります。そのため、etcdサーバーとクライアントの両方を、最新のgRPCバージョンに移行する必要があります。
clientv3-grpc1.23:バランサーの概要
clientv3-grpc1.7は古いgRPCインターフェースと密結合しており、gRPC依存関係をアップグレードするたびにクライアントの動作が壊れていました。開発とデバッグの作業の大半が、その動作の変化への対処に費やされました。その結果、サーバーの接続性に関する誤った前提を抱えた、過度に複雑な実装になりました。
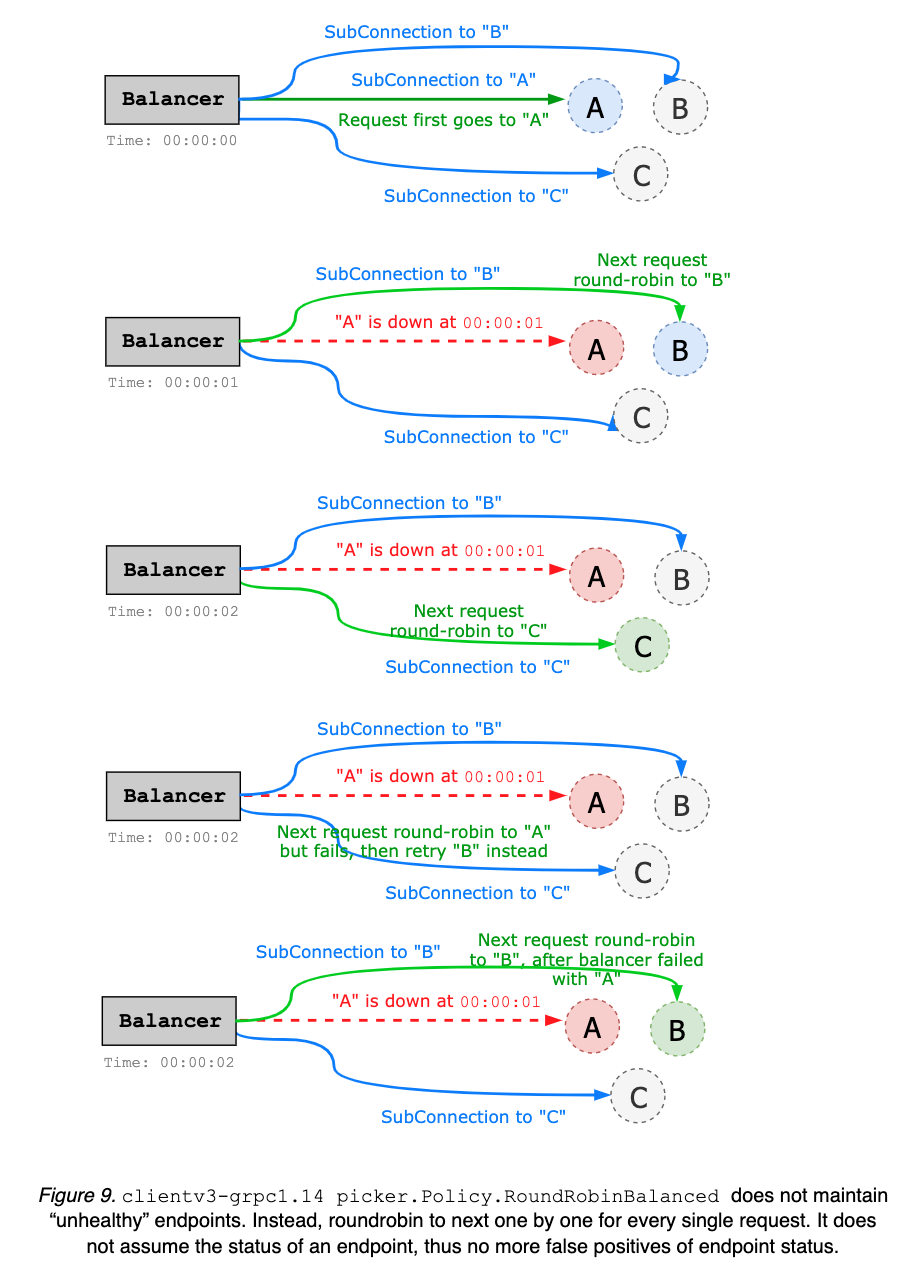
clientv3-grpc1.23の主な目的は、バランサーのフェイルオーバーロジックを単純化することです。古くなる可能性のある、健全でないエンドポイントの一覧を維持するのではなく、現在のエンドポイントから切断されるたびに、次のエンドポイントへ単純にラウンドロビンで移ります。エンドポイントの状態を仮定しないため、複雑な状態追跡は不要です(図8と上記を参照)。すべての後方互換性を維持し、内部だけを変更しているため、clientv3-grpc1.23へのアップグレードに問題はないはずです。
内部的には、複数のエンドポイントが指定されると、clientv3-grpc1.23はエンドポイントごとに1つ、複数のサブ接続を作成します。一方、clientv3-grpc1.7は固定エンドポイントへの接続を1つだけ作成します(図9)。たとえば、5ノードのクラスターでは、clientv3-grpc1.23のバランサーは5つのTCP接続を必要とし、clientv3-grpc1.7は1つだけを必要とします。TCP接続のプールを保持することで、clientv3-grpc1.23はより多くのリソースを使用する可能性がありますが、フェイルオーバー性能に優れた、より柔軟なロードバランサーを提供します。デフォルトの負荷分散ポリシーはラウンドロビンですが、他の方式(power of two、リーダーの選択など)にも容易に拡張できます。clientv3-grpc1.23は、gRPCのリゾルバーグループを使用し、バランサーの選択ポリシーを実装することで、複雑な負荷分散処理をアップストリームのgRPCに委ねます。一方、clientv3-grpc1.7は、各gRPC接続とバランサーのフェイルオーバーを独自に処理するため、実装が複雑になります。clientv3-grpc1.23は、gRPC内部のエラーを自動処理し、バックオフなどの高度な再試行ポリシーも可能にする、gRPCのインターセプターチェーンで再試行を実装しています。clientv3-grpc1.7は、再試行のためにgRPCエラーを独自に解釈します。
clientv3-grpc1.23:バランサーの制限
各エンドポイントの状態をキャッシュすれば、改善できる余地があります。たとえば、バランサーがあらかじめ各サーバーにpingを送り、健全な接続先候補の一覧を維持して、ラウンドロビン時にその情報を使用できます。また、切断時に健全なエンドポイントを優先することもできます。ただし、バランサーの実装が複雑になる可能性があるため、後のバージョンで対応できます。
クライアント側のキープアライブのpingは、依然としてネットワーク分断を考慮していません。ストリーミングリクエストは、分断されたノードで進行できなくなることがあります。クラスターのメンバーシップを把握するには、高度なヘルスチェックサービスを実装する必要があります(詳細はetcd#8673 を参照)。
現在、再試行ロジックはインターセプターとして独自に処理しています。gRPC公式の再試行 を使えば、単純化できる可能性があります。