これはセクションの複数ページ印刷用ビューです。 .
etcd 3.7 ドキュメント
-
1: タスク
-
1.1: 運用担当者向けタスク
- 1.1.1: デモ用etcdクラスターをセットアップする方法
- 1.1.2: etcdクラスターでリーダー選出を行う方法
- 1.1.3: クラスターの状態を確認する方法
- 1.1.4: データベースの保存方法
- 1.1.5: メンバーを追加・削除する方法
-
1.2: 開発者向けタスク
- 1.2.1: etcdからの読み取り
- 1.2.2: etcdへの書き込み
- 1.2.3: プレフィックスでキーを取得する方法
- 1.2.4: キーの削除方法
- 1.2.5: トランザクションで複数の書き込みを行う方法
- 1.2.6: キーの監視方法
- 1.2.7: リースの作成方法
- 1.2.8: ロックの作成方法
-
1.1: 運用担当者向けタスク
- 2: クイックスタート
- 3: デモ
- 4: インストール
- 5: フィーチャーゲート
- 6: よくある質問
- 7: ライブラリーとツール
-
8: メトリクス
- 9: バグの報告
- 10: チューニング
-
11: 内部実装
- 11.1: ディスカバリーサービスのプロトコル
- 11.2: ログの規約
- 11.3: Goモジュール
-
12: 学習
- 12.1: データモデル
- 12.2: etcdクライアントの設計
- 12.3: etcdの学習者メンバーの設計
- 12.4: etcd v3の認証設計
- 12.5: etcd API
- 12.6: etcdの永続ストレージファイル
- 12.7: etcd APIの保証
- 12.8: etcdと他のキー・バリューストアの比較
- 12.9: 用語集
-
13: 開発者ガイド
- 13.1: 検出サービスのプロトコル
- 13.2: ローカルクラスターの構築
- 13.3: etcdの操作
- 13.4: gRPCゲートウェイを使う理由
- 13.5: gRPCの名前解決と検出
- 13.6: Goアプリケーションへのetcdの組み込み
- 13.7: システムの制限
- 13.8: etcdの機能
- 13.9: APIリファレンス
- 13.10: APIリファレンス:並行処理
-
14: 運用ガイド
-
14.1: 認証ガイド
- 14.1.1: 認証
- 14.1.2: ロールベースのアクセス制御
- 14.2: 設定オプション
- 14.3: 通信のセキュリティーモデル
- 14.4: クラスター構成ガイド
- 14.5: Kubernetes StatefulSetとしてのetcdクラスターの実行
- 14.6: コンテナ内でのetcdクラスターの実行
- 14.7: 障害の種類
- 14.8: 災害復旧
- 14.9: etcdゲートウェイ
- 14.10: gRPCプロキシー
- 14.11: ハードウェアの推奨事項
- 14.12: 保守
- 14.13: etcdの監視
- 14.14: 性能
- 14.15: 実行時再構成の設計
- 14.16: 実行時再構成
- 14.17: サポート対象プラットフォーム
- 14.18: バージョン管理
- 14.19: データ破損
-
14.1: 認証ガイド
-
15: ベンチマーク
- 15.1: ストレージのメモリー使用量ベンチマーク
- 15.2: 監視のメモリー使用量ベンチマーク
- 15.3: etcd v3のベンチマーク
- 15.4: etcd v2.2.0-rc-memoryのベンチマーク
- 15.5: etcd v2.2.0-rcのベンチマーク
- 15.6: etcd v2.2.0のベンチマーク
- 15.7: etcd v2.1.0のベンチマーク
-
16: アップグレード
- 16.1: etcdクラスターとアプリケーションのアップグレード
- 16.2: etcdをv3.6からv3.7にアップグレード
- 16.3: etcdをv3.5からv3.6にアップグレード
- 16.4: etcdを3.4から3.5にアップグレード
- 16.5: etcdを3.3から3.4にアップグレード
- 16.6: etcdを3.2から3.3にアップグレード
- 16.7: etcdを3.1から3.2にアップグレード
- 16.8: etcdを3.0から3.1にアップグレード
- 16.9: etcdを2.3から3.0にアップグレード
-
17: ダウングレード
- 17.1: etcdクラスターとアプリケーションのダウングレード
- 17.2: etcdをv3.7からv3.6にダウングレード
- 17.3: etcdをv3.6からv3.5にダウングレード
- 17.4: etcdを3.5から3.4にダウングレード
-
18: トリアージ
- 18.1: Issueのトリアージガイドライン
- 18.2: PRの管理
1 - タスク
1.1 - 運用担当者向けタスク
1.1.1 - デモ用etcdクラスターをセットアップする方法
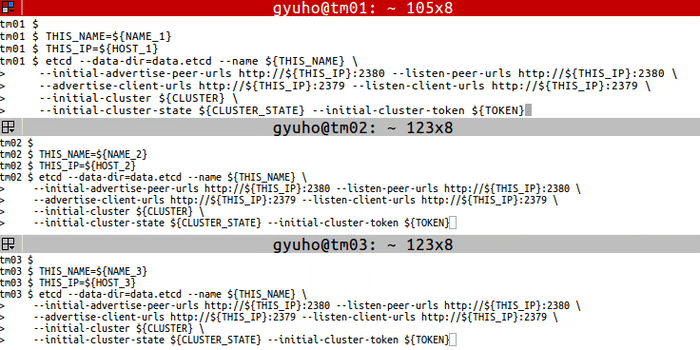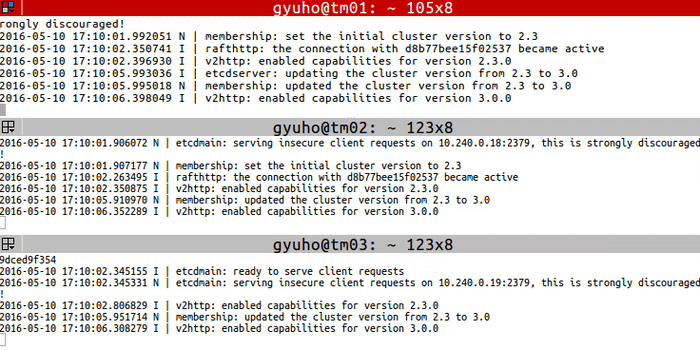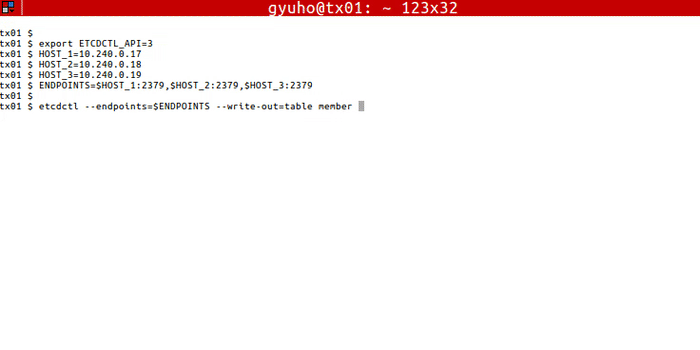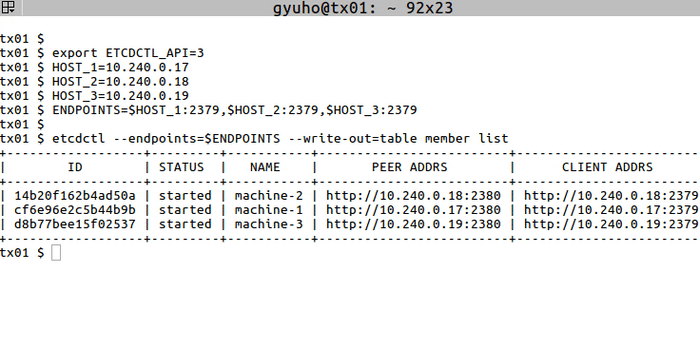
各etcdノードで、クラスターのメンバーを指定します。
各マシンで次のコマンドを実行します。
または、公開ディスカバリーサービスを使用します。
これでetcdの準備ができました。etcdctlでetcdに接続するには、次のコマンドを使用します。
1.1.2 - etcdクラスターでリーダー選出を行う方法
前提条件
リーダー選出を行う
etcdctlコマンドは、etcdクラスターでリーダー選出を行うために使用します。一度にリーダーになれるクライアントが1つだけであることを保証します。
etcdctl --endpoints=$ENDPOINTS elect <election-name> [proposal]
オプション
--endpoints : $ENDPOINTS
各etcdクラスターメンバーのアドレス。
election-namestring
選出を識別する文字列です。リーダーの地位を競うすべての参加者は、同じ選出名を使用する必要があります。
leader-namestring
新しいリーダーの提案値。
例
1.1.3 - クラスターの状態を確認する方法
前提条件
etcdとetcdctlをインストールします。
全体の状態の確認
endpoint statusを使用して、--endpointsフラグで指定した各エンドポイントの全体の状態を確認します。
オプション
健全性の確認
endpoint healthを使用して、--endpointsフラグで指定した各エンドポイントが正常かどうかを確認します。
オプション
KVハッシュの確認
endpoint hashkvを使用して、--endpointsフラグで指定した各エンドポイントのKV履歴のハッシュを確認します。
オプション
親コマンドから継承したオプション
例
1.1.4 - データベースの保存方法
前提条件
- etcdctlとetcdutlをインストール します。
- ローカルクラスターをセットアップ します。
データベースのスナップショットを取得する
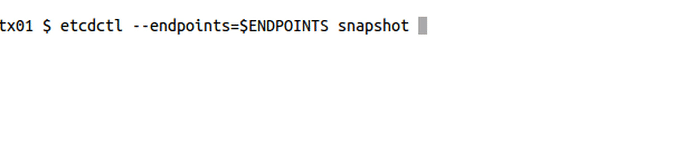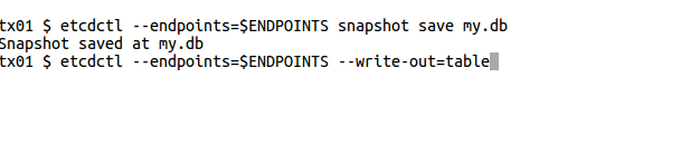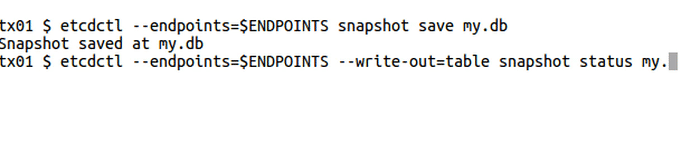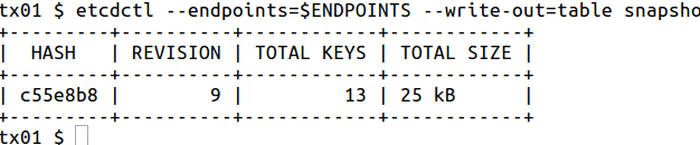
etcdデータベースのある時点のスナップショットを保存するsnapshot:
グローバルオプション
etcdctl
スナップショットを要求できるetcdノードは1つだけなので、--endpointsフラグにはエンドポイントを1つだけ指定することをお勧めします。
etcdutl
例
1.1.5 - メンバーを追加・削除する方法
memberを使用して、メンバーシップの追加、削除、更新を行います。
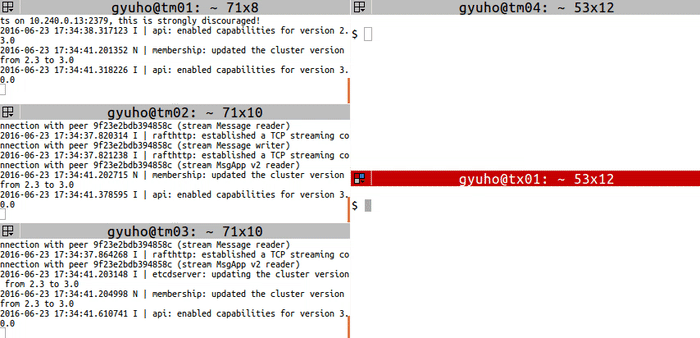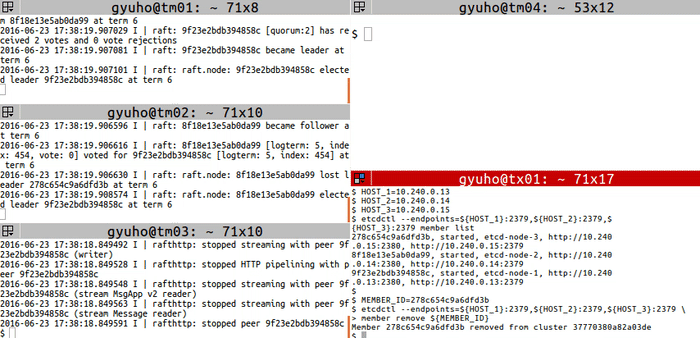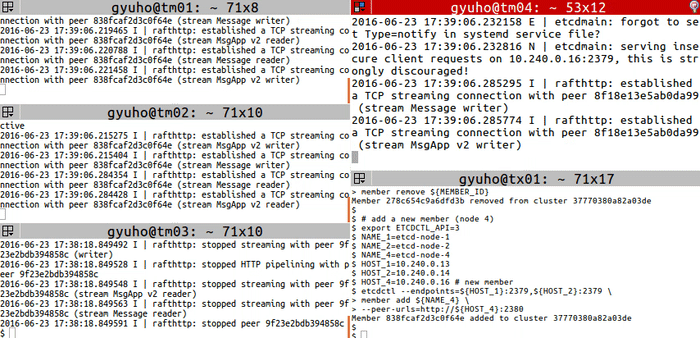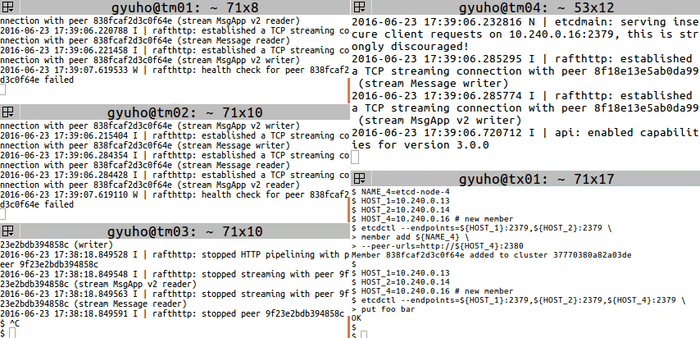
次に、member removeとmember addコマンドでメンバーを置き換えます。
続いて、--initial-cluster-state existingフラグを指定して新しいメンバーを起動します。
1.2 - 開発者向けタスク
1.2.1 - etcdからの読み取り
前提条件
etcdctlをインストールします。
手順
getサブコマンドを使用して、etcdから読み取ります。
各要素の意味は次のとおりです。
fooは要求したキーです。Hello World!は取得した値です。
出力形式を指定する場合は、次のように実行します。
ここで、write-out="json"を指定すると、キーと値の両方がbase64でエンコードされたJSONが返されます。
1.2.2 - etcdへの書き込み
前提条件
etcdctlをインストールします。
手順
putサブコマンドを使用して、キー・バリューペアを書き込みます。
各要素の意味は次のとおりです。
fooはキーの名前です。"Hello World!"は引用符で囲んだ値です。
1.2.3 - プレフィックスでキーを取得する方法
前提条件
- etcdctlをインストール します。
- ローカルクラスターをセットアップ します。
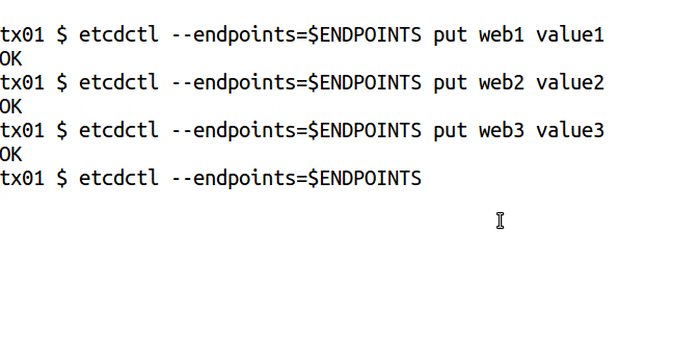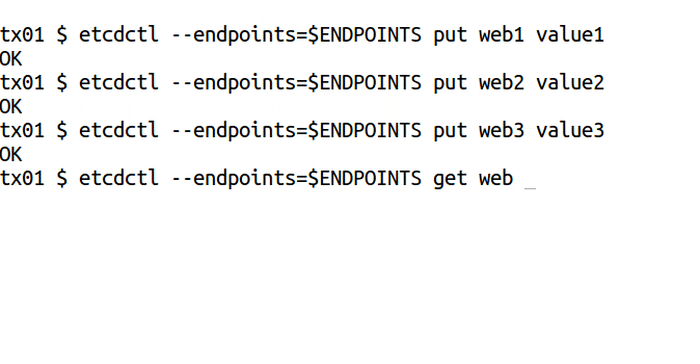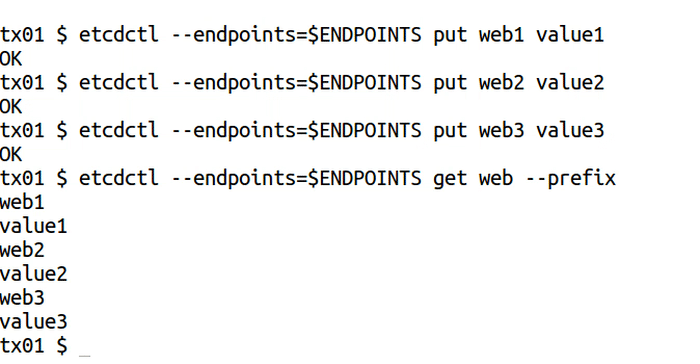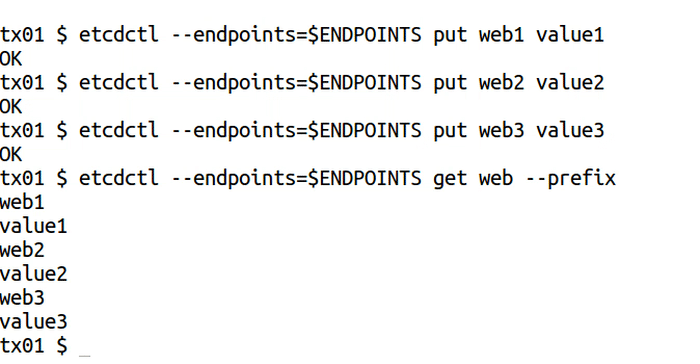
プレフィックスでキーを取得する
グローバルオプション
オプション
例
1.2.4 - キーの削除方法
前提条件
etcdとetcdctlをインストールします。
キーの追加または削除
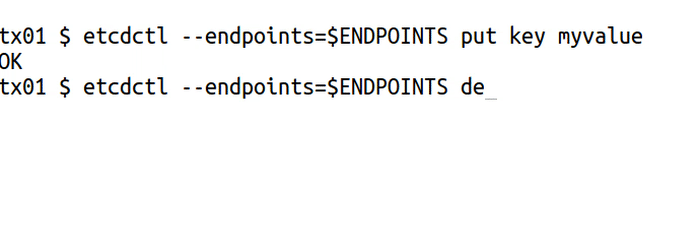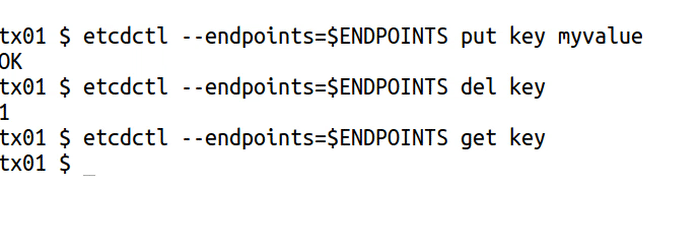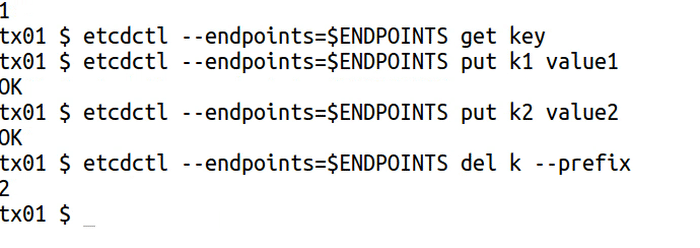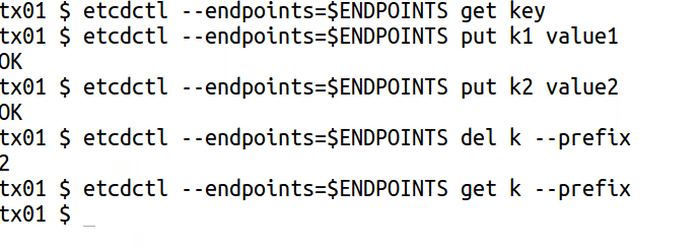
指定したキーまたはキー範囲を削除するdel:
オプション
親コマンドから継承されるオプション
例
1.2.5 - トランザクションで複数の書き込みを行う方法
前提条件
etcdとetcdctlがインストールされていること。etcdクラスターが稼働していること。
用語
以下の例 で使用する主な用語を定義します。
| 用語 | 定義 |
|---|---|
| etcdctl | etcdサーバーを操作するコマンドラインツール。 |
txn
コマンド |
txnは「transaction」の略です。複数のetcdリクエストを標準入力から読み込み、単一の不可分なトランザクションとして適用します。トランザクションは、条件のリスト、すべての条件が真の場合に適用するリクエストのリスト、いずれかの条件が偽の場合に適用するリクエストのリストで構成されます。詳細はetcdctlのキー・バリューコマンド
を参照してください。 |
compare |
トランザクション(txn)内のcompare句は、その処理を実行するかどうかを決める条件判定です。キー・バリューストアの現在の状態が期待する条件に一致する場合にのみ変更を適用することで、データの整合性を維持し、並行処理での競合を防ぎます。コマンドの構成は、以下のトランザクションの実行
を参照してください。 |
トランザクション
txnを使用して、すべてのリクエストを1つのトランザクションで処理します。
etcdのトランザクションでは、複数の操作を不可分に実行し、すべての操作を適用するか、どれも適用しないかのいずれかとなることを保証します。これは、関連する更新を行う際のデータ整合性の維持に不可欠です。トランザクションの詳細はAPIドキュメント を参照してください。
例
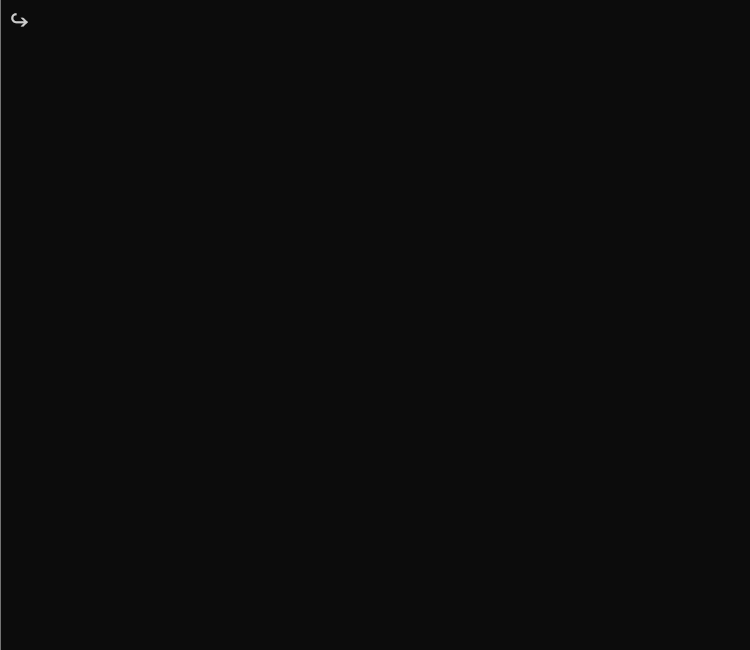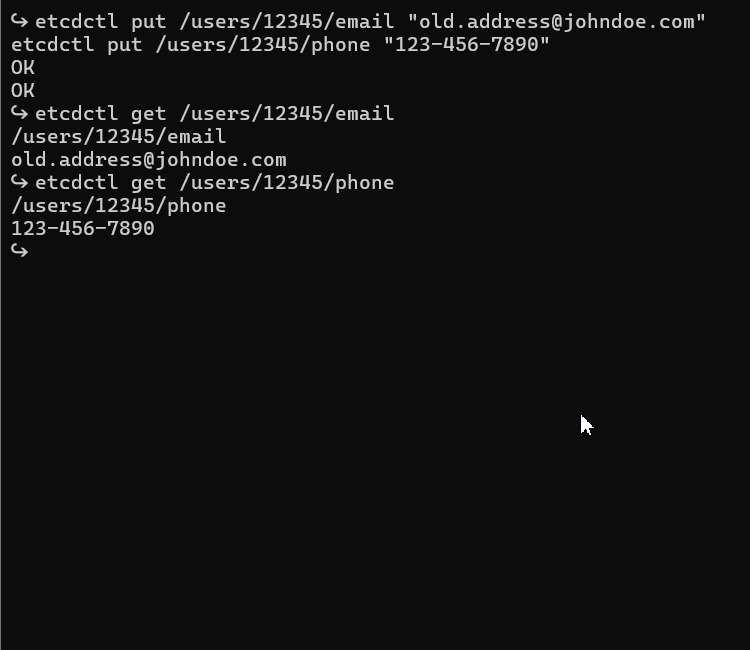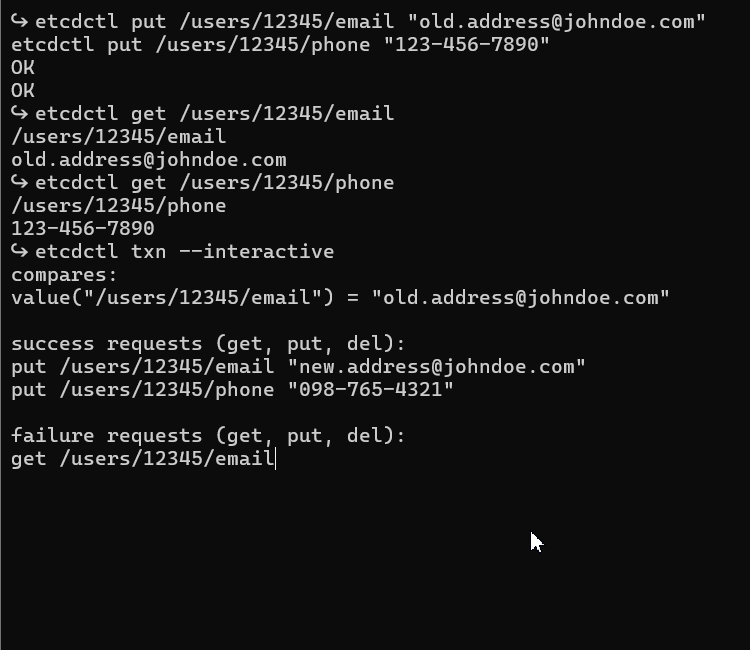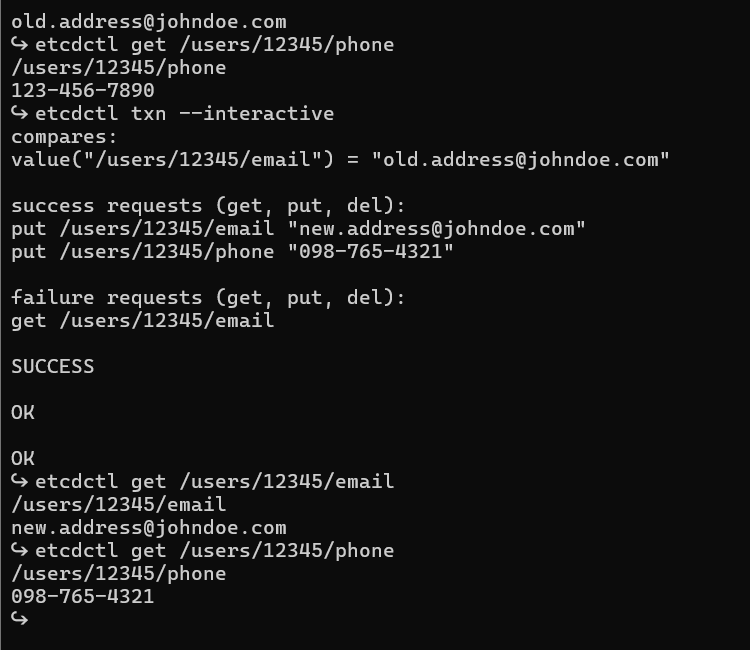
ユーザーのメールアドレスと電話番号を1つのトランザクションで更新する場合を考えます。これにより、両方の更新がまとめて適用されることを保証します。
0. 使用する変数とフラグ
| 変数 |
|---|
/users/{<user_id>/email:ユーザーのメールアドレスを表すetcdキー。 |
/users/<user_id>/phone:ユーザーの電話番号を表すetcdキー。 |
| フラグ |
--interactive
:トランザクションのデータを手動で入力できるようにするフラグ。 |
1. 初期データの設定
まず、初期データを持つユーザーを作成します。
2. トランザクションの実行
ユーザーのメールアドレスと電話番号を1つのトランザクションで更新します。
- 比較:現在のメールアドレスが「old.address@johndoe.com 」であるかを確認します。これにより、データが期待どおりの場合にのみトランザクションを実行します。
- 成功:比較結果が真なら、メールアドレスと電話番号の両方を更新します。
- 失敗:比較に失敗した場合は、現在のメールアドレスを取得し、トランザクションが実行されなかった理由を確認します。
重要な注意点
- 原子性:トランザクションにより、メールアドレスと電話番号がまとめて更新されることを保証します。最初の条件(比較)を満たさなければ、どちらの更新も適用されません。
- 整合性:トランザクションを使用すると、特に複数の関連する更新を扱う場合に、データの整合性を維持できます。
- 同じキーへの複数回のputを避ける:予期しない結果を招く可能性があるため、1つのトランザクション内で同じキーに複数の値をputしないでください。各キーの更新は、1トランザクションにつき1回にすることを推奨します。
1.2.6 - キーの監視方法
前提条件
etcdとetcdctlをインストールします。
キーの監視
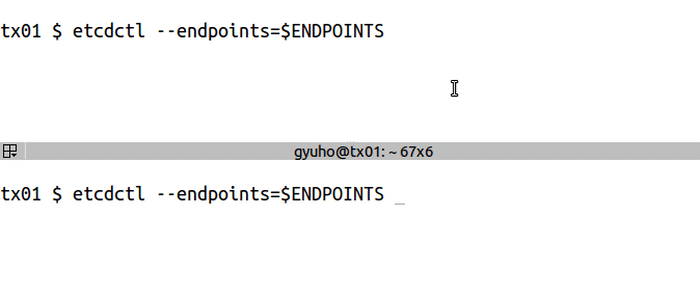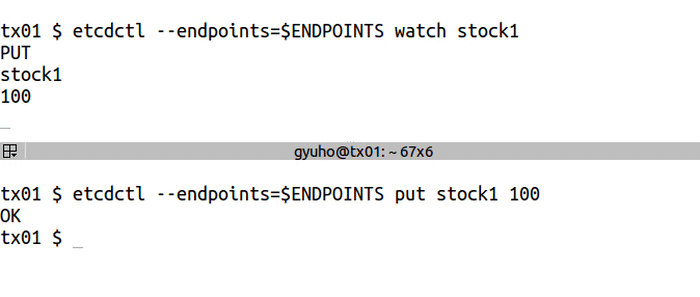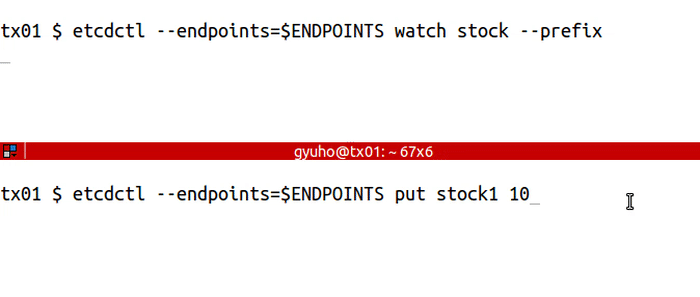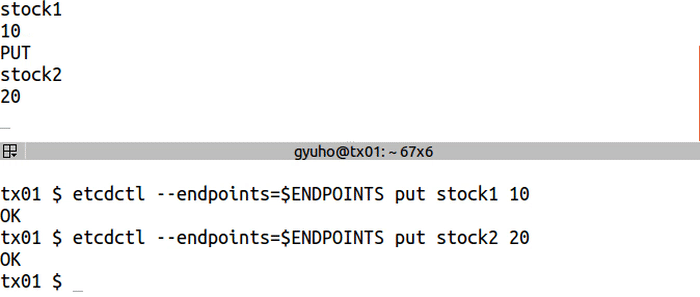
今後の変更の通知を受け取るwatch:
オプション
親コマンドから継承されるオプション
例
1.2.7 - リースの作成方法
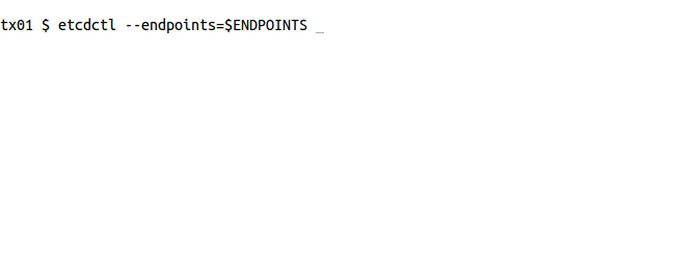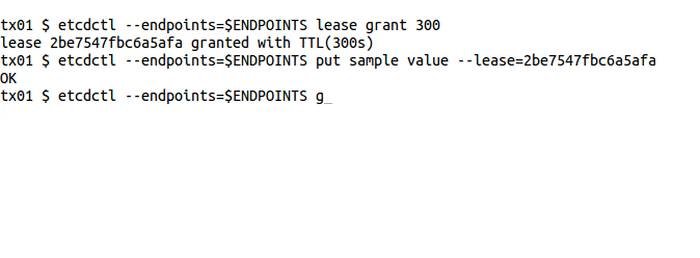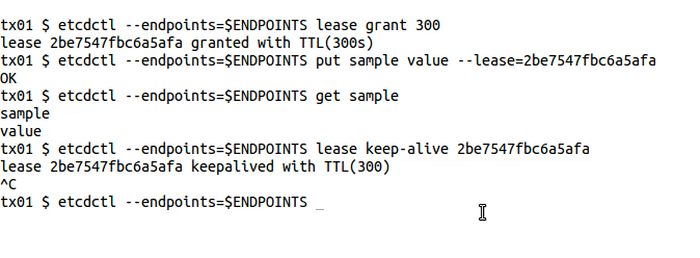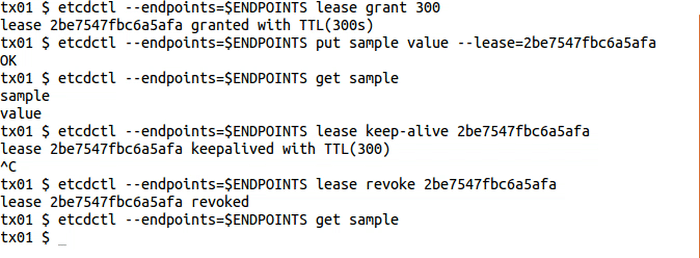
TTLを指定した書き込みに使用するlease:
1.2.8 - ロックの作成方法
LOCKは、指定された名前の分散ミューテックスを取得します。取得したロックは、etcdctlが終了するまで保持されます。
前提条件
etcdとetcdctlをインストールします。
ロックの作成
分散ロックに使用するlock:
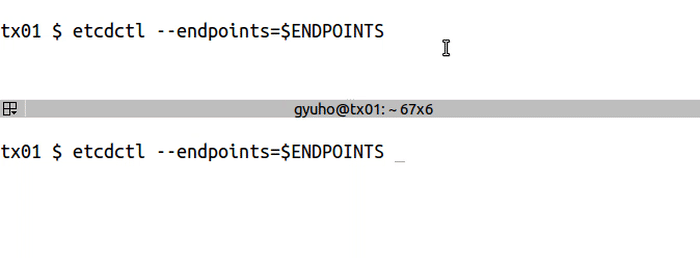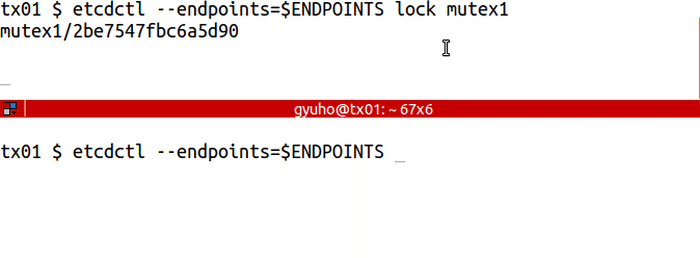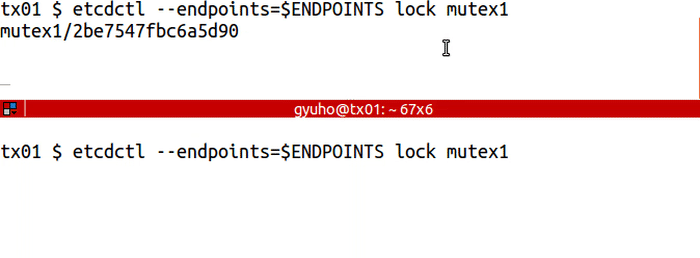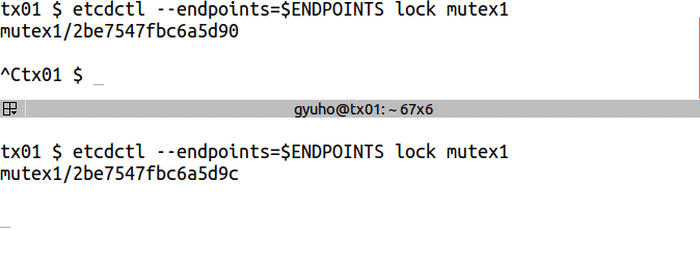
オプション
- endpoints - クラスター内のマシンのアドレスを、コンマ区切りのリストで指定します。
- ttl - ロックセッションのタイムアウトを秒単位で指定します。
2 - クイックスタート
次の手順に従って、単一メンバーのetcdクラスターをローカルにインストールし、実行してテストします。
-
ビルド済みのバイナリーまたはソースからetcdをインストールします。詳細はインストール を参照してください。
警告重要:インストール手順の最後のステップを必ず実行し、
etcdが検索パスに含まれていることを確認してください。 -
etcdを起動します。注記注意:
etcdの出力はログ です—infoレベルのログは無視できます。 -
別のターミナルから、
etcdctlを使用してキーを設定します。 -
同じターミナルからキーを取得します。
次のステップ
etcdの構成方法と使用方法について、詳しくは次のページを参照してください。
-
開発者向け:
- gRPC API を確認します。
- 言語バインディングとツール を探します。
-
運用担当者または管理者向け:
- 複数マシンのクラスター をセットアップします。
- etcdの構成方法 を学びます。
- TLSを使用してetcdクラスターを保護 します。
- etcdをチューニング します。
3 - デモ
この一連の例では、etcdクラスターを操作するための基本的な手順を示します。
認証
認証に使用するauth、user、role:
4 - インストール
要件
etcdをインストールする前に、次のページを参照してください。
ビルド済みバイナリーのインストール
etcdを最も簡単にインストールする方法は、ビルド済みバイナリーを使用することです。
-
リリース一覧 から、使用するプラットフォームの圧縮アーカイブをダウンロードします。 リリースはv3.7.2 以降を選択してください。
-
アーカイブを展開します。バイナリーを含むディレクトリが作成されます。
-
実行可能バイナリーにパスを通します。たとえば、必要に応じてバイナリーの名前を変更して パスの通ったディレクトリ(
/usr/local/binなど)へ移動するか、 前の手順で作成されたディレクトリをパスに追加します。 -
シェルから、
etcdにパスが通っていることを確認します。
ソースからのビルド
etcd v3.7.2では、Goバージョン1.26以降 を使用してください。このリリースはGo 1.26.8のツールチェーンを指定しています。 次の手順でソースからetcdをビルドできます。
-
etcdリポジトリをzipファイルとしてダウンロード して展開するか、 次のコマンドでリポジトリをクローンします。
main@HEADからビルドするには、-b v3.7.2フラグを省略します。 -
ディレクトリを移動します。
-
ビルドスクリプトを実行します。
バイナリーは
binディレクトリに生成されます。 -
binディレクトリの絶対パスをパスに追加します。例: -
etcdにパスが通っていることを確認します。
OSパッケージによるインストール
免責事項:OSのパッケージマネージャーによるetcdのインストールでは、古いバージョンが提供される場合があります。これらは自動的に保守されておらず、etcdプロジェクトの公式サポート対象でもありません。そのため、OSパッケージは慎重に使用してください。
オペレーティングシステムごとにさまざまなetcdのインストール方法があります。以下はその一例です。
MacOS(Homebrew)
- Homebrewを更新します。
- etcdをインストールします。
- インストールを確認します。
Linux
多くの主要なLinuxディストリビューションでは、公式リポジトリとパッケージマネージャーからetcdをインストールできますが、公開されているバージョンが大幅に古い場合があります。そのため、この方法でのインストールは避けることを強く推奨します。
Linuxへのetcdのインストールには、ビルド済みバイナリー またはHomebrewの使用を推奨します。
LinuxでのHomebrew
HomebrewはLinuxでも動作 し、新しいバージョンのソフトウェアを提供できます。
-
前提条件
-
Homebrewを更新します。
-
-
手順
-
brewでインストールします。
-
-
結果
-
バージョンを取得してインストールを確認します。
上記の出力は一例です。Homebrewが提供するパッチバージョンは異なる場合があるため、
etcd --versionで実際にインストールされたバージョンを確認してください。
-
Docker
etcdは、主なコンテナーレジストリとしてgcr.io/etcd-development/etcd
を、
副次的なレジストリとしてquay.io/coreos/etcd
を使用します。
Dockerでetcdを実行するには、次のコマンドを使用します。
Kubernetesのインストールの一環としてのインストール
インストールの確認
インストールが正常に行われたことをもう少し詳しく確認するには、クイックスタート を参照してください。
5 - フィーチャーゲート
このページでは、管理者がetcdに指定できる各種フィーチャーゲートの概要を説明します。
機能の各段階については、機能の段階 を参照してください。
概要
フィーチャーゲートは、etcdの機能を表すkey=valueペアの集合です。
etcdのコマンドラインフラグ--feature-gatesで、各機能を有効または無効にできます。
etcdでは、一連のフィーチャーゲートを有効または無効にできます。
すべてのフィーチャーゲートを確認するには、-hフラグを使用します。
フィーチャーゲートを設定するには、コマンドラインで--feature-gatesフラグに機能のペアのリストを指定します。
または、YAML設定ファイルでfeature-gatesを指定します。
embed.Config構造体の変更
3.6では、embed.ConfigにServerFeatureGateフィールドが追加されました。以下の実験的なフィールドは、このフィールドに置き換えることを推奨します。
AlphaまたはBeta機能のフィーチャーゲート
etcdに設定できるフィーチャーゲートを、次の表にまとめます。
| 機能 | デフォルト | 段階 | 詳細 |
|---|---|---|---|
| CompactHashCheck | false | Alpha | リーダーがフォロワーのコンパクションハッシュを定期的に確認できるようにします。 |
| InitialCorruptCheck | false | Alpha | クライアントやピアからのトラフィックを処理する前に、データの破損を確認できるようにします。 |
| LeaseCheckpoint | false | Alpha | リーダーが他のメンバーに定期的にチェックポイントを送信し、リーダー変更時に残りのTTLがリセットされるのを防ぎます。 |
| LeaseCheckpointPersist | false | Alpha | remainingTTLを永続化し、長期間有効なリースが無期限に自動更新されるのを防ぎます。 |
| SetMemberLocalAddr | false | Alpha | ピアとの通信時に、initial-advertise-peer-urlsで最初に指定されたループバック以外のローカルアドレスを、ローカルアドレスとして使用できるようにします。 |
| StopGRPCServiceOnDefrag | false | Alpha | デフラグメンテーション中、etcdのgRPCサービスがクライアントリクエストの処理を停止できるようにします。 |
| TxnModeWriteWithSharedBuffer | true | Beta | 書き込みトランザクションが読み取り専用の確認処理で共有バッファーを使用できるようにします。 |
機能の使用
機能の段階
機能の段階には、Alpha、Beta、GA、Deprecatedがあります。 Alphaの機能には、次の特性があります。
- デフォルトでは無効です。
- バグがある可能性があります。有効にするとバグが表面化する場合があります。
- 予告なく、いつでもサポートが打ち切られる可能性があります。
- 後のソフトウェアリリースで、APIが予告なく互換性のない形で変更される可能性があります。
- バグのリスクが高く、長期的なサポートもないため、 短期間のテスト用クラスターでのみ使用することを推奨します。
Betaの機能には、次の特性があります。
- デフォルトで有効です。
- 十分にテストされており、有効にしても安全と考えられています。
- 詳細が変わることはあっても、機能全体のサポートが打ち切られることはありません。
- 利用が広がることで、見つけにくい新たなバグが発見される可能性があるため、 業務上重要ではない用途に限って使用することを推奨します。
Beta機能を試し、フィードバックをお寄せください。 Beta段階を終えた後では、それ以上の変更が現実的でなくなる可能性があります。
一般提供(GA)の機能は、安定版の機能とも呼ばれます。次の特性があります。
- 常に有効で、無効にはできません。
- 対応するフィーチャーゲートは不要になります。
- 安定版の機能は、その後の多くのバージョンのリリースでも提供されます。
非推奨(Deprecated)の機能には、次の特性があります。
- フィーチャーゲートは使用されなくなっています。
- 機能はGAに移行したか、削除されています。
6 - よくある質問
etcdの概要
etcdとは何ですか?
etcdは、整合性のある分散キー・バリューストアです。主に分散システム内で、独立した協調サービスとして使用されます。全体をメモリーに収められる少量のデータを保持するように設計されています。
etcdはどう発音しますか?
etcdの発音は**/ˈɛtsiːdiː/**で、「分散したetcディレクトリ」を意味します。
クライアントはetcdのリーダーにリクエストを送る必要がありますか?
Raft はリーダーを基盤とする仕組みで、クラスターのコンセンサスが必要なクライアントリクエストはすべてリーダーが処理します。ただし、クライアントはどのノードがリーダーかを知る必要はありません。コンセンサスが必要なリクエストをフォロワーに送信すると、自動的にリーダーへ転送されます。コンセンサスを必要としないリクエスト(直列化可能読み取りなど)は、どのクラスターメンバーでも処理できます。
設定
listen-<client,peer>-urls、advertise-client-urls、initial-advertise-peer-urlsの違いは何ですか?
listen-client-urlsとlisten-peer-urlsは、etcdサーバーが着信接続を受け付けるためにバインドするローカルアドレスを指定します。すべてのインターフェースのポートで待ち受けるには、待ち受けIPアドレスに0.0.0.0を指定します。
advertise-client-urlsとinitial-advertise-peer-urlsは、etcdクライアントや他のetcdメンバーがetcdサーバーに接続する際に使用するアドレスを指定します。通知するアドレスは、リモートマシンから到達可能でなければなりません。localhostや0.0.0.0などはリモートマシンから到達できないため、本番環境では通知しないでください。
--listen-peer-urlsや--initial-advertise-peer-urlsを変更しても、etcdctl member listに表示されるピアURLが更新されないのはなぜですか?
メンバーが通知するピアURLは、クラスターの初回起動時の--initial-advertise-peer-urlsから取得されます。メンバーを起動した後に待ち受けピアURLや初期通知ピアURLを変更しても、外部に通知するピアURLは変わりません。メンバーシップ設定のスプリットブレインを避けるため、変更にはクォーラムの合意が必要だからです。メンバーのピアURLを更新するには、etcdctl member updateを使用します。
デプロイ
システム要件
etcdはデータをディスクに書き込むため、その性能はディスクの性能に大きく依存します。このため、SSDを強く推奨します。ディスクがetcdにとって十分に高速かどうかを評価する方法の1つは、fio などのディスクベンチマークツールを使用することです。実施例はこちら を参照してください。性能低下やキー・バリューストアへの意図しない過負荷を防ぐため、etcdは設定可能なストレージサイズのクォータを適用します。デフォルトは2GBです。スワップやメモリー不足を避けるには、少なくともこのクォータを賄える容量のRAMを確保することを推奨します。通常の環境で推奨される最大サイズは8GBで、設定値がこれを超える場合、etcdは起動時に警告します。CoreOSでは通常、最低でもデュアルコアプロセッサー、2GBのRAM、80GBのSSDを備えた専用のCoreOS Container Linuxマシンにetcdクラスターを配置しています。性能は本質的にワークロードに依存するため、本番環境へ配置する前にテストしてください。 その他の推奨事項はハードウェア を参照してください。
最も安定した本番環境は、amd64アーキテクチャーのLinuxです。詳細は対応プラットフォーム を参照してください。
クラスターのメンバー数を奇数にするのはなぜですか?
etcdクラスターの状態を更新するには、ノードの過半数、すなわちクォーラムの合意が必要です。メンバー数がnのクラスターでは、クォーラムは(n/2)+1です。奇数台のクラスターにノードを1台追加すると、クォーラムに必要なノード数は必ず増加します。マシンが増えるため改善に見えますが、クォーラムを失わずに許容できる障害ノード数は変わらず、障害が起こりうるノードだけが増えるため、耐障害性は低下します。これ以上の障害を許容できない状態のクラスターで、ノードを削除する前に追加するのは危険です。アドレスの設定ミスなどで新しいノードがクラスターに登録できない場合、クォーラムが恒久的に失われるためです。
クラスターの最大サイズはいくつですか?
理論上、厳密な上限はありません。ただし、etcdクラスターは7ノード以下にすることが望ましいと考えられます。etcdに似ており、Google内で長年広く利用されているGoogle Chubbyロックサービス は、5ノードでの稼働を推奨しています。5メンバーのetcdクラスターは2メンバーの障害に耐えられ、ほとんどの場合これで十分です。クラスターを大きくすると耐障害性は高まりますが、より多くのマシンにデータを複製する必要があるため、書き込み性能が低下します。
障害許容度とは何ですか?
etcdクラスターは、メンバーのクォーラムを確保できる限り稼働します。ネットワーク分断などの一時的な障害でクォーラムが失われた場合は、ネットワークが復旧してクォーラムが回復すると、自動的かつ安全に再開します。Raftがクラスターの整合性を保証します。電源障害に備え、etcdはRaftログをディスクに永続化します。障害発生時点までログを再生し、クラスターへの参加を再開します。恒久的なハードウェア障害の場合は、実行時の再構成 によってノードをクラスターから削除できます。
クラスターのメンバー数は奇数を推奨します。奇数台のクラスターは、偶数台のクラスターより少ないノード数で同じ数の障害に耐えられます。偶数台と奇数台を比較すると、その違いがわかります。
| クラスターサイズ | 過半数 | 許容できる障害数 |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
| 8 | 5 | 3 |
| 9 | 5 | 4 |
メンバーを追加してクラスターサイズを偶数にしても、障害許容度は増えません。同様に、ネットワークが二つに分断された場合、メンバーが奇数なら、処理を継続でき、分断解消時に正しい状態の基準となる過半数の区画が必ず存在します。
etcdはリージョン間やデータセンター間にまたがる配置で動作しますか?
etcdを複数のリージョンに配置すると、メンバーが異なる障害ドメインに属するため、耐障害性が向上します。その代償として、データセンターの境界を越えるコンセンサスリクエストのレイテンシーが高くなります。etcdはコンセンサスにメンバーのクォーラムを必要とし、少なくとも過半数のメンバーがリクエストに応答しなければならないため、データセンター間のレイテンシーの影響が目立ちやすくなります。また、クラスターのデータはすべてのピアに複製する必要があるため、帯域幅のコストもかかります。
レイテンシーが長い環境では、etcdのデフォルト設定だと選出やハートビートのタイムアウトが頻発する可能性があります。高レイテンシー環境でのタイムアウトの調整は、チューニング を参照してください。
運用
etcdクラスターをバックアップするにはどうすればよいですか?
etcdctlには、バックアップを作成するsnapshotコマンドがあります。詳細はバックアップ
を参照してください。
異常なメンバーを削除する前に、新しいメンバーを追加すべきですか?
etcdノードを置き換える場合は、先にメンバーを削除し、その後で代わりのメンバーを追加することが重要です。
etcdは、クォーラムモデルに基づく分散コンセンサスを採用しています。提案をクラスターにコミットするには、過半数にあたる(n/2)+1メンバーの合意が必要です。提案には、キー・バリューの更新とメンバーシップの変更が含まれます。このモデルにより、スプリットブレインによる不整合の可能性を完全に排除します。その反面、クォーラムの恒久的な喪失は致命的です。
これをメンバーシップに当てはめて考えます。3メンバーのクラスターで1メンバーが停止していても、クォーラムは2で、2メンバーが稼働しているため、処理を継続できます。しかし、この3メンバーのクラスターに新しいメンバーを追加すると、4メンバーの過半数には3票が必要となり、クォーラムが3に増えます。クォーラムが増えるため、この追加メンバーによる障害許容度の改善はありません。あと1ノードで障害が起きれば、引き続きクラスターは復旧不能になります。
さらに、新しいメンバーには設定ミスやクラスターへ参加できないリスクがあります。その場合、2メンバーが停止、2メンバーが稼働している一方で、失敗した追加を取り消すメンバーシップ変更には3票が必要となり、クォーラムを回復できません。etcdはデフォルトで、このようにクラスターを停止させるおそれのあるメンバー追加を拒否します。
一方、停止したメンバーを先にクラスターのメンバーシップから削除すれば、メンバー数は2になり、クォーラムは2のままです。その後で新しいメンバーを追加しても、クォーラムは2に保たれます。そのため、新しいノードを起動できなくても、残りの稼働中のメンバーでクォーラムを確保し、その新しいメンバーを削除できます。
etcdがメンバーシップの変更を受け付けないのはなぜですか?
etcdはstrict-reconfig-checkを設定し、クォーラム喪失を招く再構成リクエストを拒否します。クォーラムを放棄するのは、特にクラスターがすでに異常な場合、非常に危険です。クォーラムを失った際、新しいメンバーを追加するためにクォーラムチェックを無効にしたくなるかもしれませんが、クラスター全体の不整合につながる可能性があります。多くのアプリケーションでは問題がさらに悪化し、最も恐ろしい例の1つに「ディスクジオメトリーの破損」があります。
ディスクレイテンシーが急増するとetcdがリーダーを失うのはなぜですか?
これは意図した動作です。ディスクレイテンシーも、リーダーが正常に動作しているかを判断する要素です。etcdクラスターの選出タイムアウトが1秒なのに、リーダーがraftログの更新をディスクへfsyncするのに1分かかるとします。リーダーが選出間隔内にハートビートの送信などのネットワークメッセージ処理を行えていても、遅いディスクを待つため新しい提案をコミットできず、実質的に利用不能です。ディスクレイテンシーによって頻繁にリーダーを失う場合は、ディスク設定やetcdの時間パラメーターのチューニング を試してください。
etcdの警告「request ignored (cluster ID mismatch)」は何を意味しますか?
新しいetcdクラスターは、初期クラスター設定とユーザーが指定した一意のinitial-cluster-token値に基づいて、新しいクラスターIDを生成します。一意のクラスターIDにより、クラスターを破損しかねないクラスター間の干渉を防ぎます。
この警告は通常、古いクラスターを解体した後、ピアアドレスの一部を新しいクラスターで再利用すると発生します。古いクラスターのetcdプロセスがまだ動いていると、新しいクラスターへの接続を試みます。新しいクラスターはクラスターIDの不一致を検出してリクエストを無視し、この警告を出力します。異なるクラスター間でピアアドレスが重複しないようにすると、多くの場合この警告は解消します。
「mvcc: database space exceeded」は何を意味し、どう対処すればよいですか?
etcdの多版同時実行制御
データモデルは、キー空間の正確な履歴を保持します。--auto-compaction-modeと--auto-compaction-retentionの設定などによってこの履歴を定期的にコンパクションしないと、いずれストレージ容量を使い果たします。容量が不足すると、etcdは容量クォータのアラームを発生させ、クラスターへの追加の書き込みを防ぎます。アラームが有効な間、etcdは書き込みリクエストにmvcc: database space exceededエラーを返します。
空き容量不足によるクォータアラームから復旧するには、次の手順を実行します。
- etcdの履歴をコンパクション します。
- すべてのetcdエンドポイントでデフラグメンテーション を行います。
- アラームを解除 します。
etcdの警告「etcdserver/api/v3rpc: transport: http2Server.HandleStreams failed to read frame: read tcp 127.0.0.1:2379->127.0.0.1:43020: read: connection reset by peer」は何を意味しますか?
クライアント側のストリームが途中で閉じられ、サーバーがTCP RSTフラグを受信したときにgRPC側が出す警告です。たとえば、gRPCサーバーがTCPキュー内のすべてのHTTP/2フレームを処理し終える前に、クライアントが接続を閉じた場合に発生します。サーバー側で一部のデータが失われた可能性はありますが、クライアント接続がすでに閉じているなら問題ありません。
これをログに記録するのは、古いバージョンのgRPC
だけです。etcdでは、v3.2.13以降、デフォルトでDEBUGレベルのログに記録
するため、--log-level=debugフラグを有効にした場合にのみ表示されます。
性能
etcdのベンチマークはどのように行えばよいですか?
benchmarkツール を試してください。比較用に、現在のベンチマーク結果 も公開されています。
etcdの警告「apply entries took too long」は何を意味しますか?
etcdメンバーの過半数がリクエストのコミットに合意した後、各etcdサーバーはリクエストをデータストアに適用し、その結果をディスクに永続化します。低速な機械式ディスクや、AmazonのEBS、GoogleのPDなどの仮想化されたネットワークディスクであっても、通常はリクエストの適用に50ミリ秒もかからないはずです。平均適用時間が100ミリ秒を超えると、etcdはエントリーの適用に時間がかかりすぎていると警告します。
この問題は通常、遅いディスクが原因です。etcdと他のアプリケーションの間でディスクの競合が発生しているか、共有仮想ディスクのようにディスク自体が遅すぎる可能性があります。ディスクの遅さが原因でないことを確かめるには、backend_commit_duration_seconds を監視し、十分な速度であることを確認します。p99の所要時間は25ms未満が目安です。ディスクが遅すぎる場合、通常はetcd専用のディスクを割り当てるか、より高速なディスクを使用すると解決します。
次に多い原因は、CPUリソースの不足です。マシンのCPU使用率が高ければ、etcdに十分な計算能力を割り当てられていない可能性があります。etcdを専用マシンに移す、cgroupsによるプロセスのリソース分離を強める、またはetcdサーバープロセスのnice値を変更して優先度を上げることで、通常は解決します。
キー空間全体の取得など、非常に多くのキーにアクセスする高コストなユーザーリクエストも、適用レイテンシーを長くする原因になります。ただし、リクエストあたりのアクセスが数百キー未満であれば、常に良好な性能が得られるはずです。
上記の方法で警告が解消しない場合は、詳細なログ、監視情報、メトリクスと、可能ならワークロード情報を添えてIssueを作成 してください。
etcdの警告「failed to send out heartbeat on time」は何を意味しますか?
etcdは、整合性のあるデータ複製とログの実行のために、リーダーを基盤とするコンセンサスプロトコルを使用します。クラスターメンバーは1つのリーダーを選出し、他のメンバーはすべてフォロワーになります。選出されたリーダーは、リーダーであり続けるために、定期的にフォロワーへハートビートを送信しなければなりません。フォロワーは、選出間隔内にハートビートを受信しなければリーダーに障害が発生したと判断し、選出を開始します。リーダーが稼働しているのに時間どおりにハートビートを送信できない場合、不要な選出が起きており、リソース不足が原因と考えられます。こうした一時的な障害を検出するため、リーダーがハートビート間隔2回分の送信を逃すと、etcdはハートビートを時間どおりに送信できなかったと警告します。
この問題は通常、遅いディスクが原因です。リーダーは、メタデータを付けてハートビートを送信する前に、そのメタデータをディスクに永続化しなければならない場合があります。etcdと他のアプリケーションの間でディスクの競合が発生しているか、共有仮想ディスクのようにディスク自体が遅すぎる可能性があります。ディスクの遅さが原因でないことを確かめるには、wal_fsync_duration_seconds を監視し、十分な速度であることを確認します。p99の所要時間は10ms未満が目安です。ディスクが遅すぎる場合、通常はetcd専用のディスクを割り当てるか、より高速なディスクを使用すると解決します。etcdに十分な速度があるかを判断するには、fio などのベンチマークツールを使用できます。例はこちら を参照してください。
次に多い原因は、CPUリソースの不足です。マシンのCPU使用率が高ければ、etcdに十分な計算能力を割り当てられていない可能性があります。etcdを専用マシンに移す、cgroupsによるプロセスのリソース分離を強める、またはetcdサーバープロセスのnice値を変更して優先度を上げることで、通常は解決します。
遅いネットワークも、この問題の原因になります。etcdマシン間のネットワークメトリクスに長いレイテンシーや高いパケット損失率が見られる場合、etcdに十分なネットワーク容量がない可能性があります。通常はetcdメンバーを混雑の少ないネットワークへ移すと解決します。ただし、クラスターを複数のデータセンターに配置している場合は、メンバー間の長いレイテンシーが想定されます。その場合は、heartbeat-intervalをマシン間の往復時間とおおむね同じにし、election-timeoutを少なくとも5 * heartbeat-intervalに調整してください。詳細はチューニングのドキュメント
を参照してください。
上記の方法で警告が解消しない場合は、詳細なログ、監視情報、メトリクスと、可能ならワークロード情報を添えてIssueを作成 してください。
etcdの警告「snapshotting is taking more than x seconds to finish …」は何を意味しますか?
etcdは、遅れたフォロワーを最新の状態にするため、またバックアップ のために、キー・バリューストア全体のスナップショットを送信します。転送に時間がかかるとMTTRが増加します。クラスターが高スループットでデータを取り込んでいる場合、遅いフォロワーはスナップショットの受信が終わる前に新しいスナップショットを必要とし、ライブロックに陥る可能性があります。スナップショットの性能低下を検出するため、送信に30秒を超え、かつ1Gbps接続で想定される転送時間を超えた場合、etcdは警告します。
7 - ライブラリーとツール
以下に挙げるサードパーティーのライブラリーやツール(https://github.com/etcd-io 以外で公開されているもの)は、etcdチームによるテストや保守の対象外です。利用する前に、それぞれのドキュメントを読み、調査することを推奨します。
ツール
- etcdctl - etcd用コマンドラインクライアント。
- etcd-dump - etcdのダンプとリストアを行うコマンドラインユーティリティー。
- etcd-fs - etcd用のFUSEファイルシステム。
- etcddir - etcdとローカルディレクトリをリアルタイムに同期します。WindowsとLinuxで動作します。
- etcd-browser - AngularJSを使用した、etcd用のWebベースのキー・バリューエディター。
- etcd-lock - etcdを使用したマスター選出と分散読み書きロックの実装。v2に対応します。
- etcd-console - PHPを使用した、etcd用のWebベースのキー・バリューエディター。
- etcd-viewer - Javaで書かれた、etcdキー・バリューストアのエディター兼ビューアー。
- etcdtool - etcdディレクトリのJSON/YAML/TOML形式でのエクスポート、インポート、編集と、JSONスキーマによるディレクトリの検証を行います。
- etcdloadtest - etcdバージョン3.0以降向けのコマンドライン負荷テストクライアント。
- etcd-tui - etcdデータベースを操作するためのモダンなターミナルユーザーインターフェース(TUI)。キーの参照、値の表示、データの絞り込み、etcdクラスターの管理をターミナルから直接行えます。
- etcdfinder - 即時検索を備えた、etcd用の高速でモダンなWeb UI。etcd v2とv3の両方に対応します。
- lucas - Kubernetesのetcd3.0以降のクラスター向けの、Webベースのキー・バリュービューアー。
- etcd-manager - モダンで効率的な、複数のプラットフォームに対応する無料のetcd 3.x GUI兼クライアントツール。Windows、Linux、Macで利用できます。
- etcd-backup-restore - etcdの定期的な増分バックアップとリストアを行うユーティリティー。
- etcd-druid - etcdクラスターのデプロイと導入後の運用を管理するKubernetesオペレーター。
- etcdadm - etcdクラスターを運用するためのコマンドラインツール。
- etcd-defrag - より使いやすく、賢く動作するetcdのデフラグメンテーションツール。
- etcdhelper - etcd用のIntelliJプラットフォームプラグイン。
ライブラリー
以下では、etcdのクライアントライブラリーを言語別に紹介します。
Go
- etcd/client/v3 - 公式に保守されているv3用Goクライアント。
- go-etcd - 非推奨となった公式クライアント。古いetcd(2.0.0未満)では役立つ場合があります。
- encWrapper - etcdクライアントのKeys API/KV向けの暗号化ラッパー。
Java
- coreos/jetcd - v3に対応します。
- justinsb/jetcd
- cdancy/etcd-rest - jcloudsを使用したv2 APIの完全な実装。
- IBM/etcd-java
Scala
- maciej/etcd-client - v2に対応します。Akka HTTPベースの完全非同期クライアント。
- eiipii/etcdhttpclient - v2に対応します。NettyとScala Futuresを基盤とする非同期HTTPクライアント。
- mingchuno/etcd4s - gRPCでv3に対応し、必要に応じてAkka Streamも使用できます。
Perl
- hexfusion/perl-net-etcd - v3 grpcゲートウェイのHTTP APIに対応します。
- robn/p5-etcd - v2に対応します。
Python
- kragniz/python-etcd3 - v3用クライアント。
- jplana/python-etcd - v2に対応します。
- russellhaering/txetcd - Twisted用のPythonライブラリー。
- cholcombe973/autodock - Dockerのデプロイ自動化ツール。
- lisael/aioetcd - (Python 3.4以降)Asyncioコルーチンクライアント。v2に対応します。
- txaio-etcd - Twisted(現時点)とasyncio(将来)向けの、etcd v3専用の非同期クライアントライブラリー。
- dims/etcd3-gateway - HTTP grpcゲートウェイを使用するetcd v3 APIライブラリー。
- aioetcd3 - (Python 3.6以降)asyncio用のetcd v3 API。
- Revolution1/etcd3-py - (python2.7およびpython3.5以降)gRPC-JSON-Gatewayを使用するetcd v3用Pythonクライアント。
Node
- mixer/etcd3 - v3に対応します。
- stianeikeland/node-etcd - v2に対応します(Coffeescriptを使用)。
- lavagetto/nodejs-etcd - v2に対応します。
- deedubs/node-etcd-config - v2に対応します。
Ruby
- iconara/etcd-rb
- jpfuentes2/etcd-ruby
- ranjib/etcd-ruby - v2に対応します。
- davissp14/etcdv3-ruby - v3に対応します。
C
- apache/celix/etcdlib - v2に対応します。
- jdarcy/etcd-api - v2に対応します。
- shafreeck/cetcd - v2に対応します。
C++
- edwardcapriolo/etcdcpp - v2に対応します。
- suryanathan/etcdcpp - v2に対応します(待機機能あり)。
- nokia/etcd-cpp-api - v2に対応します。
- etcd-cpp-apiv3/etcd-cpp-apiv3 - v3に対応します。
Clojure
- aterreno/etcd-clojure
- dwwoelfel/cetcd - v2に対応します。
- rthomas/clj-etcd - v2に対応します。
Erlang
- marshall-lee/etcd.erl - v2に対応します。
- zhongwencool/eetcd - v3以降に対応します(GRPCのみ)。
Elixir
- team-telnyx/etcdex - v3以降に対応します(GRPCのみ)。
.NET
- wangjia184/etcdnet - v2に対応します。
- drusellers/etcetera
- shubhamranjan/dotnet-etcd - v3以降に対応します(GRPCのみ)。
- SimplifyNet/Etcd.Microsoft.Extensions.Configuration
PHP
- linkorb/etcd-php
- activecollab/etcd
- ouqiang/etcd-php - v3 gRPCゲートウェイ用クライアント。
Haskell
R
Nim
Tcl
- efrecon/etcd-tcl - waitを除き、v2に対応します。
Rust
- jimmycuadra/rust-etcd - v2に対応します。
Gradle
- gradle-etcd-rest-plugin - v2に対応します。
Lua
- api7/lua-resty-etcd - v2およびv3(grpcゲートウェイのHTTP API)に対応します。
デプロイツール
Chefとの連携
Chefクックブック
BOSHリリース
etcdを使用しているプロジェクト
- etcd Raftの利用例 - etcdのraftライブラリー実装を使用するプロジェクト。
- Apache APISIX - etcdを設定ストアとして使用するAPIゲートウェイ。
- apache/celix - OSGi仕様をCとC++向けに適応した実装。
- binocarlos/yoda - etcd + ZeroMQ
- blox/blox - AWS ECSを利用したコンテナー管理とオーケストレーションのためのオープンソースプロジェクト群。
- calavera/active-proxy - etcdで設定するHTTPプロキシ。
- chain/chain - 高い拡張性を持つ許可型ブロックチェーンネットワークの運用と接続のために設計されたソフトウェア。
- derekchiang/etcdplus - etcd上に構築された分散同期プリミティブ群。
- go-discover - Goによるサービスディスカバリー。
- gleicon/goreman - etcdに対応した、Go製Foremanクローンのブランチ。
- garethr/hiera-etcd - etcdを使用するPuppet hieraバックエンド。
- mattn/etcd-vim - vim内からキーをSETおよびGETします。
- mattn/etcdenv - etcd連携機能を備えた「env」shebang。
- kelseyhightower/confd - テンプレートとetcdのデータを使用して、ローカルアプリケーションの設定ファイルを管理します。
- configdb - 任意のデータベースバックエンド上にRESTによるリレーショナルな抽象化を提供し、設定やインベントリーの保存を目的とします。
- kubernetes/kubernetes - Googleが発表したコンテナークラスターマネージャー。
- mailgun/vulcand - etcdを設定バックエンドとして使用するHTTPプロキシ。
- duedil-ltd/discodns - etcdを名前とレコードのデータベースとして使用するシンプルなDNSネームサーバー。
- skynetservices/skydns - RFC準拠のDNSサーバー。
- xordataexchange/crypt - GPG暗号化を使用して、etcdに値を安全に保存します。
- spf13/viper - Go用の設定ライブラリー。ENV、pflags、ファイル、etcdから値を読み込み、必要に応じて暗号化できます。
- lytics/metafora - Go用の分散タスクライブラリー。
- ryandoyle/nss-etcd - etcdから名前を解決するためのGNU libc NSSモジュール。
- Gru - Goでオーケストレーションを容易にします。
- Vitess - MySQLの水平スケーリングを実現するデータベースクラスターシステム。
- lclarkmichalek/etcdhcp - 永続化と協調にetcdを使用するDHCPサーバー。
- openstack/networking-vpp - FD.io VPPデータプレーン を制御し、OpenStack クラウドの仮想ネットワークを提供するネットワークドライバー。
- OpenStack - OpenStackのサービスは、基盤サービスとしてetcdに依存できます。
- CoreDNS - プラグインを連結して処理するDNSサーバー。CNCFとKubernetesの一部です。
- Uber M3 - M3:Uberによる、Prometheus向けのオープンソースの大規模メトリクスプラットフォーム。
- Rook - Kubernetes向けのストレージオーケストレーション。
- Patroni - ZooKeeper、etcd、Consulを使用するPostgreSQL高可用性のテンプレート。
- Trillian - データストレージ層から内容を提供するMerkle木の実装で、極めて大きな木にも拡張できます。
- purpleidea/mgmt - 次世代の分散型、イベント駆動型の並列設定管理。
- Portworx/kvdb - Portworxのクラスター設定を保存する内部kvdb。
- Apache Pulsar - クラウド向けに構築された、オープンソースの分散メッセージング・ストリーミングプラットフォーム。
8 - メトリクス
etcdはメトリクスの報告にPrometheus を使用します。メトリクスはリアルタイムの監視やデバッグに利用できます。etcdはメトリクスを永続化しないため、メンバーを再起動するとメトリクスはリセットされます。
利用可能なメトリクスを確認する最も簡単な方法は、メトリクスのエンドポイント/metricsにcURLでアクセスすることです。形式はPrometheusのドキュメント
に記載されています。
Prometheusの入門ドキュメント に従ってPrometheusサーバーを起動し、etcdのメトリクスを収集してください。
メトリクスの命名は、推奨されるPrometheusのベストプラクティス
に従っています。メトリクス名には、名前空間を表すetcdまたはetcd_debuggingプレフィックスと、サブシステムを表すプレフィックス(walやetcdserverなど)が付きます。
etcd名前空間のメトリクス
etcdプレフィックスのメトリクスは、監視とアラートのためのものです。安定した高水準のメトリクスであり、変更がある場合はリリースノートに記載されます。
etcd2に関連するメトリクスは、v2メトリクスガイド に記載されています。
サーバー
これらのメトリクスはetcdサーバーの状態を表します。障害や問題を検出して対処できるよう、本番環境のすべてのetcdクラスターでサーバーメトリクスを注意深く監視することを推奨します。
これらのメトリクスには、すべてetcd_server_プレフィックスが付きます。
| 名前 | 説明 | 型 |
|---|---|---|
| has_leader | リーダーが存在するかどうか。1は存在し、0は存在しないことを示します。 | Gauge |
| leader_changes_seen_total | 観測したリーダー変更の回数。 | Counter |
| proposals_committed_total | コミットされたコンセンサス提案の総数。 | Gauge |
| proposals_applied_total | 適用されたコンセンサス提案の総数。 | Gauge |
| proposals_pending | 現在保留中の提案数。 | Gauge |
| proposals_failed_total | 観測した失敗した提案の総数。 | Counter |
has_leaderは、メンバーにリーダーが存在するかどうかを示します。メンバーにリーダーが存在しない場合、そのメンバーは完全に利用不能です。クラスター内のすべてのメンバーにリーダーが存在しない場合、クラスター全体が完全に利用不能です。
leader_changes_seen_totalは、メンバーが起動してから観測したリーダー変更の回数です。リーダーが頻繁に変わると、etcdの性能に大きく影響します。また、ネットワーク接続の問題やetcdクラスターへの過剰な負荷などによって、リーダーが不安定であることも示します。
proposals_committed_totalは、コミットされたコンセンサス提案の総数を記録します。クラスターが正常なら、このゲージは時間とともに増加するはずです。etcdクラスター内の複数の正常なメンバーで、同じ時点のコミット済み提案の総数が異なる場合があります。これは、起動後にピアから復旧していること、リーダーより遅れていること、または自身がリーダーで最も多くのコミットを保持していることが原因と考えられます。クラスター内のすべてのメンバーでこのメトリクスを監視することが重要です。特定のメンバーとそのリーダーの間に大きな遅れが続く場合、そのメンバーの処理が遅いか、正常ではないことを示します。
proposals_applied_totalは、適用されたコンセンサス提案の総数を記録します。etcdサーバーは、コミットされたすべての提案を非同期に適用します。通常、proposals_committed_totalとproposals_applied_totalの差は小さく、高負荷時でも数千以内に収まるはずです。この差が増え続ける場合は、etcdサーバーが過負荷であることを示します。負荷の高い範囲クエリーや大規模なtxn操作など、処理コストの高いクエリーを適用するときに起こる可能性があります。
proposals_pendingは、コミット待ちのキューに入っている提案数を示します。保留中の提案が増加している場合は、クライアントからの負荷が高いか、メンバーが提案をコミットできていないと考えられます。
proposals_failed_totalは、通常、リーダー選出に伴う一時的な失敗、またはクラスターのクォーラム喪失による長い停止時間という2つの問題に関連します。
ディスク
これらのメトリクスは、ディスク操作の状態を表します。
これらのメトリクスには、すべてetcd_disk_プレフィックスが付きます。
| 名前 | 説明 | 型 |
|---|---|---|
| wal_fsync_duration_seconds | walが呼び出すfsyncのレイテンシー分布。 | Histogram |
| backend_commit_duration_seconds | backendが呼び出すcommitのレイテンシー分布。 | Histogram |
wal_fsyncは、etcdがログエントリーを適用する前にディスクへ永続化するときに呼び出されます。
backend_commitは、etcdが直近の変更の増分スナップショットをディスクにコミットするときに呼び出されます。
ディスク操作のレイテンシー(wal_fsync_duration_secondsまたはbackend_commit_duration_seconds)が高い場合は、多くの場合、ディスクの問題を示しています。リクエストのレイテンシーが高くなったり、クラスターが不安定になったりする可能性があります。
ネットワーク
これらのメトリクスは、ネットワークの状態を表します。
これらのメトリクスには、すべてetcd_network_プレフィックスが付きます。
| 名前 | 説明 | 型 |
|---|---|---|
| peer_sent_bytes_total | IDがToのピアへ送信した総バイト数。 |
Counter(To) |
| peer_received_bytes_total | IDがFromのピアから受信した総バイト数。 |
Counter(From) |
| peer_sent_failures_total | IDがToのピアへの送信失敗の総数。 |
Counter(To) |
| peer_received_failures_total | IDがFromのピアからの受信失敗の総数。 |
Counter(From) |
| peer_round_trip_time_seconds | ピア間の往復時間のヒストグラム。 | Histogram(To) |
| client_grpc_sent_bytes_total | grpcクライアントへ送信した総バイト数。 | Counter |
| client_grpc_received_bytes_total | grpcクライアントから受信した総バイト数。 | Counter |
peer_sent_bytes_totalは、特定のピアへ送信した総バイト数です。通常、リーダーメンバーはレプリケーションデータの送信を担うため、他のメンバーより多くのデータを送信します。
peer_received_bytes_totalは、特定のピアから受信した総バイト数です。通常、フォロワーメンバーはリーダーメンバーからのみデータを受信します。
gRPCリクエスト
これらのメトリクスは、go-grpc-prometheus を通じて公開されます。
etcd_debugging名前空間のメトリクス
etcd_debuggingプレフィックスのメトリクスは、デバッグ用です。実装への依存度が高く、変更されやすいものです。新しいetcdリリースで、予告なく変更または削除される場合があります。一部のメトリクスは、より安定した段階でetcdプレフィックスへ移される場合があります。
スナップショット
| 名前 | 説明 | 型 |
|---|---|---|
| snapshot_save_total_duration_seconds | snapshotが呼び出すsaveの合計レイテンシーの分布。 | Histogram |
スナップショットの所要時間(snapshot_save_total_duration_seconds)が異常に長い場合は、ディスクの問題を示しており、クラスターが不安定になる可能性があります。
Prometheusが提供するメトリクス
Prometheusのクライアントライブラリーは、goおよびprocess名前空間にいくつものメトリクスを提供します。特に注目すべきものをいくつか挙げます。
| 名前 | 説明 | 型 |
|---|---|---|
| process_open_fds | 開いているファイルディスクリプターの数。 | Gauge |
| process_max_fds | 開くことのできるファイルディスクリプターの最大数。 | Gauge |
process_open_fdsやprocess_max_fdsなどのプロセスメトリクスは、現時点ではDarwin(macOS)システムでサポートされていません。
ファイルディスクリプターの使用量(process_open_fds)が多く、プロセスの上限であるprocess_max_fdsに近い場合は、ファイルディスクリプターが枯渇する可能性があります。枯渇すると、新しいWALファイルを作成できないため、etcdがパニックを起こす場合があります。
自動生成されたメトリクス一覧
9 - バグの報告
etcdプロジェクトのいずれかの部分にバグやドキュメントの誤りを見つけた場合は、Issueを作成 してお知らせください。私たちはバグや誤りを真剣に受け止めており、小さすぎて報告する必要のない問題はないと考えています。バグを報告する前に、同じ問題を報告するIssueがすでに存在していないか確認してください。
バグ報告を正確で理解しやすいものにするため、次の点を満たすようにしてください。
-
具体的であること。バージョン、環境、構成など、できるだけ多くの詳細を含めてください。etcdサーバーの実行に関するバグの場合は、etcdのログを添付してください(etcdの構成が記録された起動時のログは特に重要です)。
-
再現可能であること。問題を再現する手順を含めてください。再現が難しい問題もあることは承知していますので、問題につながる可能性のある手順を記載してください。可能であれば、影響を受けたetcdのデータディレクトリとスタックトレースをバグ報告に添付してください。
-
問題が切り分けられていること。できる限り依存関係を最小限にして、バグを切り分け、再現してください。バグ報告に多すぎる依存関係が含まれていると、修正に大幅に時間がかかります。etcdに依存する外部システムのデバッグは対象外ですが、適切な方向性についての助言やetcd自体の使用方法については、喜んで支援します。
-
重複していないこと。既存のバグ報告と重複する報告はしないでください。
-
範囲が限定されていること。1つの報告につきバグは1つとしてください。同じ報告の中で、別のバグについて追記しないでください。
バグを報告する前に、適切なバグ報告の書き方に関するElika Etemadの記事 を読むと役立つかもしれません。
バグの原因を特定するため、追加の情報をお願いする場合があります。重複したバグ報告はクローズします。
よくある質問
スタックトレースの取得方法
etcdのバージョンの確認方法
systemdサービス「etcd2.service」として実行されるetcdの構成とログを取得する方法
アップストリームのsystemdのバグにより、プロセスの終了時にjournaldがログの最後の数行を記録しない場合があります。journalctlでetcdが停止したと表示されるのにfatalまたはpanicメッセージがない場合は、sudo journalctl -f -t etcd2を試して完全なログを取得してください。
10 - チューニング
etcdのデフォルト設定は、平均ネットワークレイテンシーが低いローカルネットワークであれば、通常は問題なく機能します。ただし、複数のデータセンターにまたがる環境やレイテンシーの高いネットワークでetcdを使用する場合は、ハートビート間隔と選出タイムアウトの調整が必要になることがあります。
レイテンシーの原因はネットワークだけではありません。各リクエストとレスポンスは、リーダーとフォロワー双方の遅いディスクの影響を受けることがあります。それぞれのタイムアウトは、リクエストの送信から、相手のマシンから正常なレスポンスが返るまでの合計時間を表します。
時間に関するパラメーター
基盤となる分散コンセンサスプロトコルは、2つの独立した時間パラメーターを使い、ノードの処理が停止したりオフラインになったりした場合にリーダーを引き継げるようにしています。1つ目はハートビート間隔です。リーダーがフォロワーに対して、自身が引き続きリーダーであることを通知する頻度を表します。
ベストプラクティスとして、メンバー間の往復時間に近い値を設定することを推奨します。etcdのデフォルトのハートビート間隔は100msです。
2つ目は選出タイムアウトです。フォロワーノードがハートビートを受信しなくなってから、自らリーダーになろうとするまでの時間を表します。etcdのデフォルトの選出タイムアウトは1000msです。
これらの値の調整にはトレードオフがあります。ハートビート間隔は、メンバー間の平均往復時間(RTT)の最大値に近い値、通常は往復時間の0.5~1.5倍程度を推奨します。ハートビート間隔が短すぎると、etcdは不要なメッセージを送信し、CPUとネットワークリソースの使用量が増えます。一方、ハートビート間隔が長すぎると、選出タイムアウトも長くなります。選出タイムアウトが長いほど、リーダーの障害検出に時間がかかります。往復時間(RTT)を測る最も簡単な方法は、PINGユーティリティー を使用することです。
選出タイムアウトは、ハートビート間隔とメンバー間の平均往復時間に基づいて設定することを推奨します。ネットワークの変動を考慮できるよう、選出タイムアウトは往復時間の少なくとも10倍でなければなりません。たとえば、メンバー間の往復時間が10msの場合は、選出タイムアウトを少なくとも100msにすることを推奨します。
選出タイムアウトの上限は50000ms(50s)で、この値は世界規模に分散したetcdクラスターを配置する場合にのみ使用することを推奨します。米国本土内の妥当な往復時間は130ms、米国と日本の間では350~400ms程度です。ネットワーク性能が不均一な場合や、パケットの遅延・損失が頻繁に発生する場合は、パケットの送信を成功させるために何度か再試行が必要になる可能性があります。そのため、世界規模の往復時間の安全な上限は5sです。選出タイムアウトはブロードキャスト時間より1桁大きくすることを推奨するため、世界規模の分散クラスターで約5sの場合、50秒が妥当な上限になります。
同じクラスター内のすべてのメンバーで、ハートビート間隔と選出タイムアウトを同じ値にすることを推奨します。etcdメンバーごとに異なる値を設定すると、クラスターの安定性を損なう可能性があります。
デフォルト値はコマンドラインで上書きできます。
値はミリ秒単位で指定します。
スナップショット
etcdはキーに対するすべての変更をログファイルに追記します。このログは増え続け、キーに加えられたあらゆる変更の完全な一連の履歴となります。利用が少ないクラスターでは完全な履歴を保持しても問題ありませんが、頻繁に利用されるクラスターでは大きなログを抱えることになります。
ログが巨大になるのを避けるため、etcdは定期的にスナップショットを作成します。システムの現在の状態を保存し、古いログを削除することで、ログのコンパクションを行えます。
スナップショットの調整
Raftスナップショットは、設定された数のエントリーが適用された後に作成します。etcd 3.7ではV2バックエンドを使用しません。デフォルトでは、10,000回の変更ごとに作成します。etcdのメモリー使用量とディスク使用量が多すぎる場合は、コマンドラインで次のように設定し、スナップショットのしきい値を下げてみてください。
ディスク
etcdクラスターは、ディスクのレイテンシーに非常に敏感です。etcdは提案をログに永続化しなければならないため、他のプロセスによるディスク操作がfsyncのレイテンシーを長くする場合があります。その結果、etcdがハートビートを逃し、リクエストのタイムアウトや一時的なリーダー喪失につながることがあります。etcdサーバーのディスク優先度を高くすると、こうしたプロセスと共存して安定稼働できる場合があります。
Linuxでは、ioniceでetcdのディスク優先度を設定できます。
ネットワーク
etcdのリーダーが大量のクライアントリクエストを同時に処理している場合、ネットワークの輻輳により、フォロワーピアのリクエスト処理が遅れる可能性があります。この場合、フォロワーノードに送信バッファーのエラーメッセージが表示されます。
クライアントのトラフィックよりもetcdのピア間トラフィックを優先することで、これらのエラーが解消する場合があります。Linuxでは、トラフィック制御の仕組みを使ってピア間トラフィックを優先できます。
tcの設定を解除するには、次のコマンドを実行します。
CPU
etcdはレイテンシーに非常に敏感なため、LinuxシステムではCPUガバナーをperformanceまたはconservativeモードに設定することで、さらに性能を最適化できます。
Linuxでは、次のようにCPUガバナーをperformanceモードに設定できます。
11 - 内部実装
11.1 - ディスカバリーサービスのプロトコル
ディスカバリーサービスのプロトコルは、共有のディスカバリートークンとエンドポイントリストを使用して、クラスターのブートストラップ時に新しいetcdメンバーが他のすべてのメンバーを検出できるようにします。
ディスカバリーサービスのプロトコルは、クラスターのブートストラップ時にのみ使用します。実行時の再構成やクラスターの監視には使用できません。
このプロトコルでは、新しいディスカバリートークンを使って一意のetcdクラスターをブートストラップします。1つのディスカバリートークンが表せるetcdクラスターは1つだけであることに注意してください。そのトークンを使ったディスカバリープロトコルが開始されたら、途中で失敗した場合でも、別のetcdクラスターのブートストラップに再利用してはなりません。
以降では、自前で運用するディスカバリークラスターに対応した例を使い、検出処理を順に説明します。
このドキュメントはv3ディスカバリーのみを対象とします。v2ディスカバリー の詳細は、以前のドキュメントを参照してください。
プロトコルの流れ
ディスカバリープロトコルは、内部のetcdクラスターを使って新しいクラスターのブートストラップを調整する仕組みです。まず、新しいメンバーすべてがディスカバリーサービスとやり取りし、想定するメンバーリストを生成します。次に、新しい各メンバーはこのリストを使ってサーバーをブートストラップします。これは-initial-clusterフラグと同じ役割を果たします。
以下の手順例では、理解しやすいようにetcdctlコマンドで各ステップを示します。http://example.com:2379でディスカバリーサービス用のetcdクラスターが稼働しているものとします。
etcdのディスカバリープロトコルでは、慣例としてキープレフィックス/_etcd/registryを使用します。
新しいディスカバリートークンの作成
新しいクラスターを識別する一意のトークンを生成します。以降の手順では、ディスカバリー用のキー空間で一意のプレフィックスとして使用します。uuidgenを使うと簡単に生成できます。
想定するクラスターサイズの指定
ディスカバリートークンには、想定するクラスターサイズを必ず指定する必要があります。ディスカバリーサービスはこのサイズを使い、初期クラスターを構成するすべてのメンバーが見つかったかどうかを判断します。
通常のクラスターサイズは3、5、7です。詳細は最適なクラスターサイズ を参照してください。
etcdプロセスの起動
--discovery-tokenフラグにディスカバリートークン${UUID}を設定し、--discovery-endpointsフラグにディスカバリーサービスを支えるetcdクラスターのエンドポイントを設定します。これにより、v3ディスカバリーを使ってetcdクラスターをブートストラップできます。
--discovery-tokenと--discovery-endpointsフラグを指定すると、各etcdプロセスは内部で以下の手順を実行します。
ディスカバリーサービスでクライアント証明書認証を有効にしている場合は、次のフラグを設定します。使い方は、etcdctlでetcdクラスターと通信する場合とまったく同じです。
ディスカバリーサービスでロールベースの認証を有効にしている場合は、次のフラグを設定します。使い方は、etcdctlでetcdクラスターと通信する場合とまったく同じです。
時間やタイムアウトのデフォルト値も、次のフラグで変更できます。使い方は、etcdctlでetcdクラスターと通信する場合とまったく同じです。
自身の登録
各etcdプロセスはまず、指定した新しいクラスターに自分自身をメンバーとして登録します。これは、レジストリーの完全なキーパス内に、メンバーIDをキーとして作成することで行います。
状態の確認
想定するクラスターサイズと登録状況を確認し、次の操作を決定します。
登録済みのメンバーがまだ足りない場合は、他のメンバーが現れるまで待機します。
登録済みメンバー数が想定サイズNを超えている場合は、最初に登録したN個のメンバーをクラスターのメンバーリストとします。自身がこのリストに含まれていれば、検出手順は成功し、メンバーリストを通じてすべてのピアを取得します。含まれていなければ、クラスターが満員であるため、検出手順は失敗して終了します。
メンバーは自身を登録する前にクラスターの状態を確認することもできます。そのため、クラスターが満員の場合はすぐに失敗できます。
全メンバーの待機
待機処理では、すべてのメンバーが見つかるまでキープレフィックス/_etcd/registry/${UUID}/membersを監視し続けます。
11.2 - ログの規約
etcdはzap ライブラリーを使用し、アプリケーションの出力をレベル別に分類してログに記録します。ログメッセージのレベルは、次の規約に従って決まります。
-
DebugLevelのログは通常、大量に出力されるため、本番環境では一般に無効にします。
- 例:
- リモートピアへの通常のメッセージの送信
- ディスクへのログエントリーの書き込み
- 例:
-
InfoLevelは、デフォルトのログ優先度です。
- 例:
- 起動時の構成
- スナップショット作成の開始
- クラスターへの新しいノードの追加
- 認証サブシステムへの新しいユーザーの追加
- 例:
-
WarnLevelのログはInfoより重要ですが、人が個別に確認する必要はありません。
- 例:
- リモートピアへのRaftメッセージの送信失敗
- 設定された選出タイムアウト内でのハートビートメッセージの受信失敗
- 例:
-
ErrorLevelのログは優先度が高いログです。アプリケーションが正常に動作している場合、エラーレベルのログは出力されないはずです。
- 例:
- WAL用のディスク領域の割り当て失敗
- 例:
-
PanicLevelはメッセージをログに記録した後、パニックを発生させます。
- 例:
- Raftメッセージのエンコード失敗
- 例:
-
FatalLevelはメッセージをログに記録した後、os.Exit(1)を呼び出します。
- 例:
- Raftスナップショットの保存失敗
- 例:
11.3 - Goモジュール
etcdプロジェクトはバージョン3.5以降、単一のリポジトリ に置かれた複数のGoモジュール で構成されています。
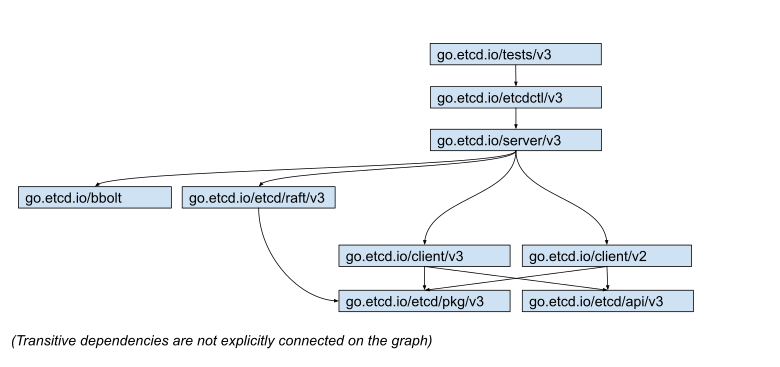
次のモジュールがあります。
-
go.etcd.io/etcd/api/v3 - etcdクライアントとサーバー間の通信プロトコルを定義する API定義(protoやprotoから生成されたライブラリーなど)を含みます。
-
go.etcd.io/etcd/pkg/v3 - etcdで使用する、etcd固有ではないユーティリティーパッケージ群です。 将来独立したリポジトリに移せる可能性のあるパッケージだけをここに置きます。 多くの依存関係を持つコードの追加は避けてください。 それらは自動的にクライアントライブラリーの依存関係にもなり、 軽量に保つという方針に反するためです。
-
go.etcd.io/etcd/client/v3 - ネットワーク(grpc)経由でetcdに接続するクライアントライブラリーです。 etcdの新規利用すべてに推奨します。
-
go.etcd.io/etcd/client/v2 - HTTPプロトコル経由でetcdに接続する旧クライアントライブラリーです。 非推奨です。新規利用ではすべて/v3ライブラリーへの依存を推奨します。
-
go.etcd.io/etcd/raft/v3 - 分散コンセンサスプロトコルの実装です。 etcd固有のコードを含めないようにしてください。
-
go.etcd.io/etcd/server/v3 - etcdの実装です。 このパッケージのコードはetcdの内部実装であり、外部プロジェクトからの利用は推奨しません。 パッケージ構成やAPIは同じマイナーバージョン内でも変更される場合があります。
-
go.etcd.io/etcd/etcdctl/v3 - etcdへのアクセスと管理を行うコマンドラインツールです。
-
go.etcd.io/etcd/tests/v3 - etcdのすべての結合テストを含むモジュールです。 注意:単体テスト(高速でモジュール間の依存関係を必要としないもの)はすべて、 テスト対象のコードと同じモジュールに置くことを推奨します。
-
go.etcd.io/bbolt - 永続的なB木の実装です。 独立したリポジトリ https://github.com/etcd-io/bbolt に置かれています。
運用
-
etcdのすべてのモジュールは、同じバージョンでリリースすることを推奨します。たとえば、
go.etcd.io/etcd/client/v3@v3.5.10はgo.etcd.io/etcd/api/v3@v3.5.10に依存しなければなりません。バージョンを一貫して更新するには、次のコマンドを使用できます。
-
リリースするモジュールは https://golang.org/ref/mod#vcs-version の規則に従ってタグ付けすることを推奨します。 つまり、モジュールごとに固有のタグを付けます。 タグ付けには次のコマンドを使用できます。
-
etcdのすべてのモジュールは、共通の依存先に対して同じバージョンに依存することを推奨します。 次のコマンドで確認できます。
-
go.modファイルには未使用の依存関係を含めてはならず、
go mod tidyの形式に従わなければなりません。 次のコマンドで確認します。 -
全ファイルの自動整形など、すべてのモジュールに対する操作を行うには、 次のスクリプトを使用または拡張してください。
今後の方向性
長期的な目標として、etcdのモジュール構成を次のモデルに近づけたいと考えています。
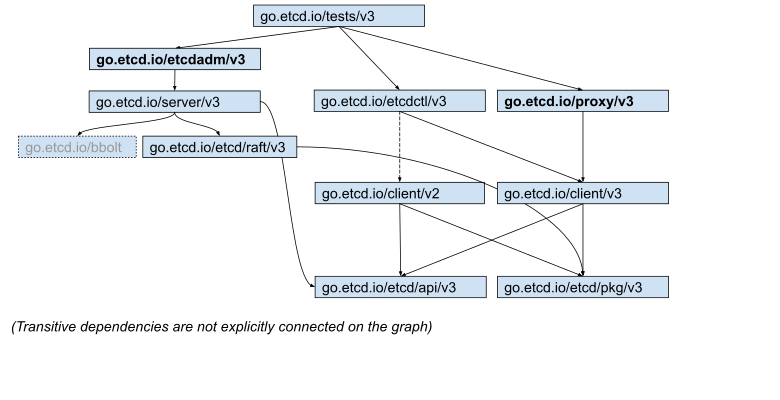
このモデルは次を前提とします。
- etcdmigrate/etcdadmをetcdctlバイナリーから分離します。 これにより、etcdctlはネットワーククライアントAPIを扱う コマンドラインのラッパーとして明確に位置付けられ、 etcdmigrate/etcdadmはetcdのストレージファイルに対する 直接的な物理操作を担うようになります。
- etcd-proxyを./etcdバイナリーから分離します。実験的なコードが多く、 追加のリスクと依存関係を伴うためです。
- v2プロトコルのサポートを非推奨にします。
12 - 学習
12.1 - データモデル
etcdは、更新頻度の低いデータを確実に保存し、信頼できる監視クエリーを提供するように設計されています。etcdはキー・バリューペアの過去のバージョンを公開し、低コストのスナップショットと過去のイベントの監視(「タイムトラベルクエリー」)を実現します。永続的な多版型同時実行制御のデータモデルは、このような用途に適しています。
etcdは、多版型の永続的な キー・バリューストアにデータを保存します。永続的なキー・バリューストアは、値が新しいデータで置き換えられても、キー・バリューペアの以前のバージョンを保持します。このキー・バリューストアは実質的に不変です。操作は既存の構造をその場で更新せず、更新を反映した新しい構造を常に生成します。変更後も、キーの過去のすべてのバージョンにアクセスし、監視できます。データストアが時間とともに無制限に増大し、古いバージョンを保持し続けるのを防ぐため、ストアをコンパクションして、更新によって古くなったデータの最も古いバージョンを取り除くことができます。
論理的な構造
ストアの論理的な構造は、平坦なバイナリーキー空間です。キー空間には、バイト列のキーを辞書順に並べたインデックスがあるため、範囲クエリーを低コストで実行できます。
キー空間は複数のリビジョンを保持します。ストアを作成した時点のリビジョンは1です。アトミックな変更操作(たとえば、トランザクション操作には複数の操作が含まれることがあります)のたびに、キー空間に新しいリビジョンが作成されます。過去のリビジョンが保持するすべてのデータは変更されません。キーの古いバージョンには、過去のリビジョンを通じて引き続きアクセスできます。同様に、リビジョンにもインデックスが付けられるため、ウォッチャーでリビジョンの範囲を効率的に扱えます。領域を節約するためにストアをコンパクションすると、コンパクションリビジョンより前のリビジョンが削除されます。リビジョンは、クラスターの存続期間を通じて単調に増加します。
キーの作成から削除までを1つの世代とします。各キーは1つ以上の世代を持つことがあります。キーを作成すると、そのキーのバージョンが増加します。現在のリビジョンにキーが存在しなければ、1から始まります。キーを削除すると、そのキーのトゥームストーンが生成され、バージョンが0にリセットされて現在の世代が終了します。キーを変更するたびにバージョンが増加するため、バージョンはキーの世代内で単調に増加します。コンパクションを行うと、そのリビジョンより前に終了したすべての世代が削除されます。また、コンパクションリビジョンより前に設定された値は、最新のものを除いて削除されます。
物理的な構造
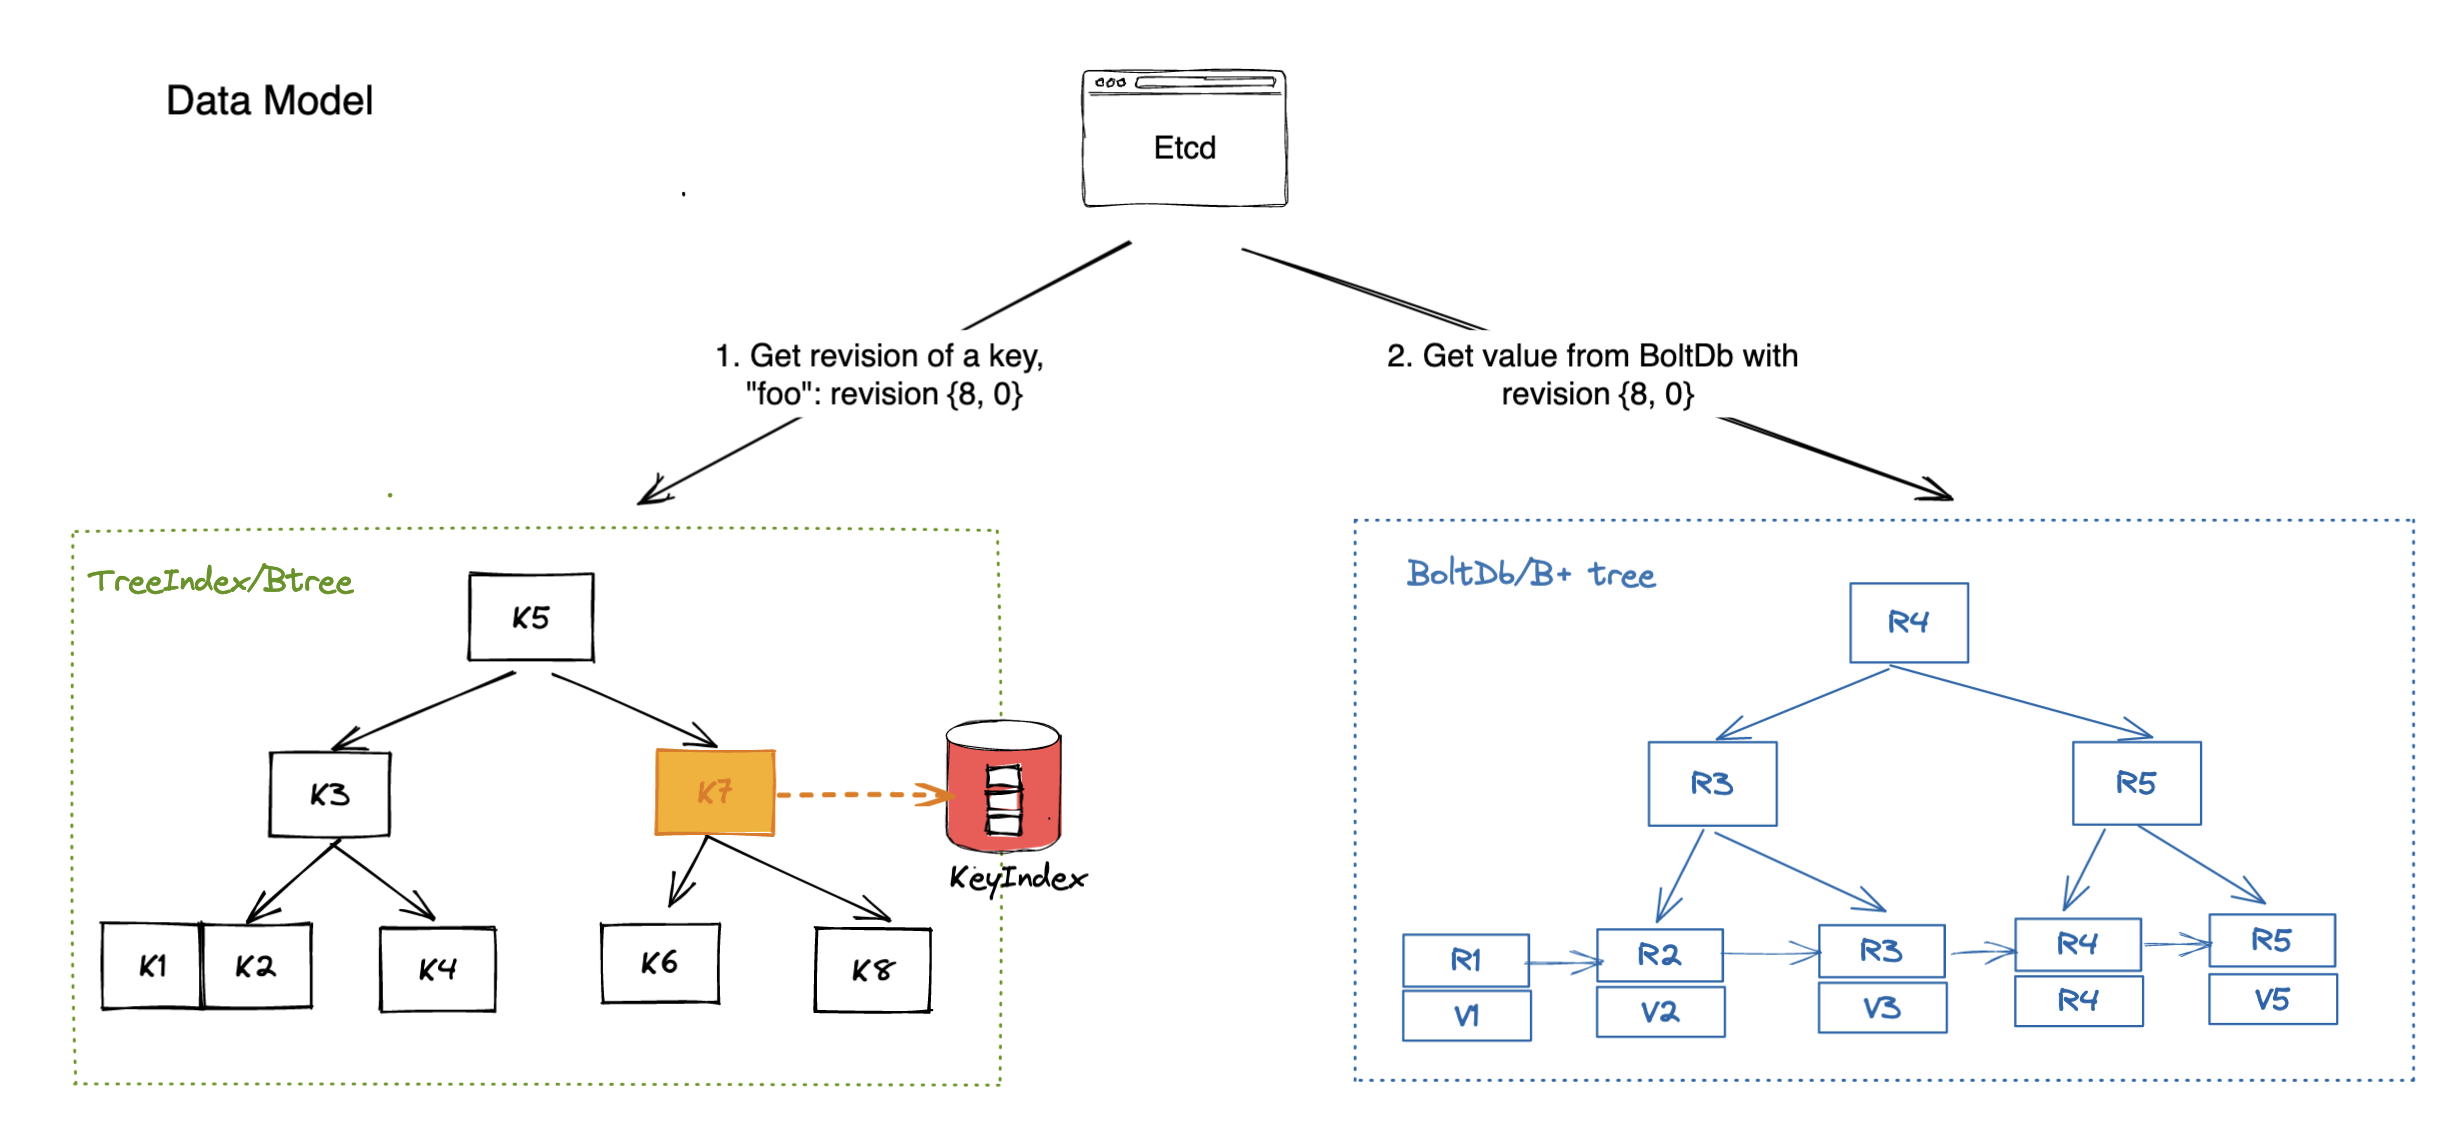
etcdは、永続的なb+tree にキー・バリューペアとして物理データを保存します。効率のため、ストアの状態の各リビジョンは、直前のリビジョンとの差分だけを保持します。1つのリビジョンが、ツリー内の複数のキーに対応することもあります。
キー・バリューペアのキーは、3つの要素からなるタプル(major, sub, type)です。majorは、そのキーを保持するストアのリビジョンです。subは、同じリビジョン内のキーを区別します。typeは、特殊な値に使う省略可能な接尾辞です(値がトゥームストーンを含む場合のtなど)。キー・バリューペアの値は、直前のリビジョンからの変更、つまり1つの差分を保持します。b+treeは、キーのバイト列の辞書順で並びます。リビジョン間の差分に対する範囲検索は高速で、あるリビジョンから別のリビジョンまでの変更をすばやく見つけられます。コンパクションは、古くなったキー・バリューペアを削除します。
etcdは、キーに対する範囲クエリーを高速化するため、メモリー内に補助的なbtree インデックスも保持します。btreeインデックスのキーは、ユーザーに公開されるストアのキーです。値は、永続的なb+tree内の変更へのポインターです。コンパクションは、無効になったポインターを削除します。
全体として、etcdはbtreeからリビジョン情報を取得し、そのリビジョンをキーにしてb+treeから値を取得します(下図)。
12.2 - etcdクライアントの設計
etcdクライアントの設計
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
はじめに
etcdサーバーの堅牢性は、長年にわたる障害注入テストで実証されています。複雑なアプリケーションロジックの大半は、etcdサーバーとそのデータストアがすでに処理しています。たとえば、クラスターのメンバーシップはクライアントから透過的に扱われ、Raftレイヤーが提案をリーダーに転送します。サーバーの構成要素が正しく動作していても、クライアントと組み合わせたときに、障害下での正しさと高可用性を保証するには、別の複雑なプロトコル群が必要です。理想的には、etcdサーバーが多数の物理マシンを1つの論理クラスターとして提供し、クライアントがレプリカ間の自動フェイルオーバーを実装します。このドキュメントでは、クライアントのアーキテクチャに関する判断と実装の詳細を説明します。
用語集
clientv3:etcd v3 API用の、etcd公式Goクライアントです。
clientv3-grpc1.0:grpc-go v1.0.x
を使う公式クライアント実装で、etcd v3.1の最新版で使用されています。
clientv3-grpc1.7:grpc-go v1.7.x
を使う公式クライアント実装で、etcd v3.2とv3.3の最新版で使用されています。
clientv3-grpc1.23:grpc-go v1.23.x
を使う公式クライアント実装で、etcd v3.4の最新版で使用されています。
バランサー:再試行とフェイルオーバーの仕組みを実装する、etcdクライアントのロードバランサーです。etcdクライアントには、複数のエンドポイント間で負荷を自動的に分散することが求められます。
エンドポイント:クライアントが接続できるetcdサーバーのエンドポイントの一覧です。通常、etcdクラスターの3個または5個のクライアントURLです。
固定エンドポイント:複数のエンドポイントが設定されている場合、v3.3以下のクライアントバランサーは、etcdクラスターへの接続総数を抑えるため、1つのエンドポイントだけを選んでTCP接続を確立します。v3.4では、バランサーがリクエストごとに固定エンドポイントをラウンドロビンで選び、負荷をより均等に分散します。
クライアント接続:gRPC Dialによってetcdサーバーとの間に確立されたTCP接続です。
サブ接続:gRPCのSubConnインターフェースです。各サブ接続は、アドレスのリストを持ちます。バランサーは、解決したアドレスのリストからSubConnを作成します。gRPCのClientConnは、複数のSubConnに対応できます。たとえば、example.comが解決された10.10.10.1と10.10.10.2は、2つのサブ接続になります。etcd v3.4のバランサーは内部リゾルバーを使い、エンドポイントごとに1つのサブ接続を確立します。
一時的な切断:gRPCサーバーが、code Unavailable
のステータスエラーを返すことです。
クライアントの要件
正しさ。サーバーの障害によってリクエストが失敗することはあります。しかし、グローバルな順序の性質、破損データを書き込まないこと、変更操作を多くても1回だけ実行する意味論、監視がイベントの一部だけを観測しないことなど、一貫性の保証に違反することはありません。
活性。サーバーは故障したり、一時的に切断されたりすることがあります。どちらの場合も、クライアントは処理を進められるべきです。そうするよう設定されていない限り、オフラインのサーバーの復帰を待ってデッドロックすべきではありません 。理想的には、クライアントがHTTP/2のpingで利用不能なサーバーを検出し、明確なエラーメッセージを伴って他のノードにフェイルオーバーします。
効率性。クライアントは、最小限のリソースで効率的に動作するべきです。エンドポイントの切り替え後は、それまでのTCP接続を正常に閉じる べきです。フェイルオーバー機構は、障害ノードに対して無駄な再試行を繰り返さず、次に接続するレプリカを的確に予測するべきです。
移植性。公式クライアントは明確に文書化され、その実装を他の言語バインディングにも適用できることが求められます。言語バインディング間で、エラー処理は一貫しているべきです。etcdはgRPCを全面的に採用しているため、その実装もgRPCの長期的な設計目標に沿うべきです。たとえば、差し替え可能な再試行ポリシーは、gRPCの再試行 と互換性を持つべきです。クライアントのバージョン間のアップグレードは、動作を中断させないものであるべきです。
クライアントの概要
etcdクライアントは、次の構成要素を実装しています。
- etcdクラスターへのgRPC接続を確立するバランサー
- etcdサーバーへRPCを送信するAPIクライアント
- 失敗したリクエストを再試行するか、エンドポイントを切り替えるかを決めるエラーハンドラー
初期接続の確立方法(TLSの設定など)、Protocol Buffersメッセージをエンコードしてサーバーに送信する方法、ストリーミングRPCの処理方法などは、言語によって異なる場合があります。ただし、etcdサーバーが返すエラーは同じです。エラー処理と再試行ポリシーも同じであるべきです。
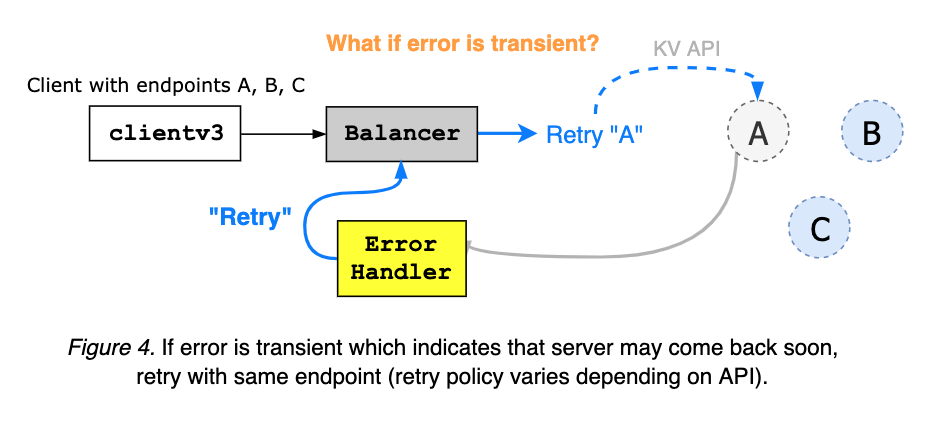
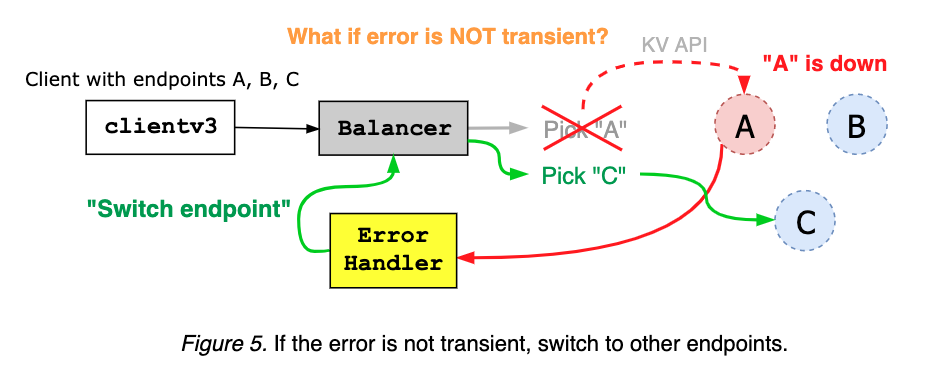
たとえば、etcdサーバーが"rpc error: code = Unavailable desc = etcdserver: request timed out"を返す場合、これは再試行が想定される一時的なエラーです。一方、rpc error: code = InvalidArgument desc = etcdserver: key is not providedは、リクエストが無効であり、再試行するべきでないことを意味します。Goクライアントはgoogle.golang.org/grpc/status.FromError、Javaクライアントはio.grpc.Status.fromThrowableでエラーを解析できます。
clientv3-grpc1.0:バランサーの概要
clientv3-grpc1.0は、複数のetcdエンドポイントが設定されると、複数のTCP接続を維持します。その中から1つのアドレスを選び、クライアントのすべてのリクエストの送信に使用します。固定したアドレスは、クライアントオブジェクトが閉じられるまで維持します(図1)。エラーを受け取ると、クライアントはランダムに別のアドレスを選んで再試行します。
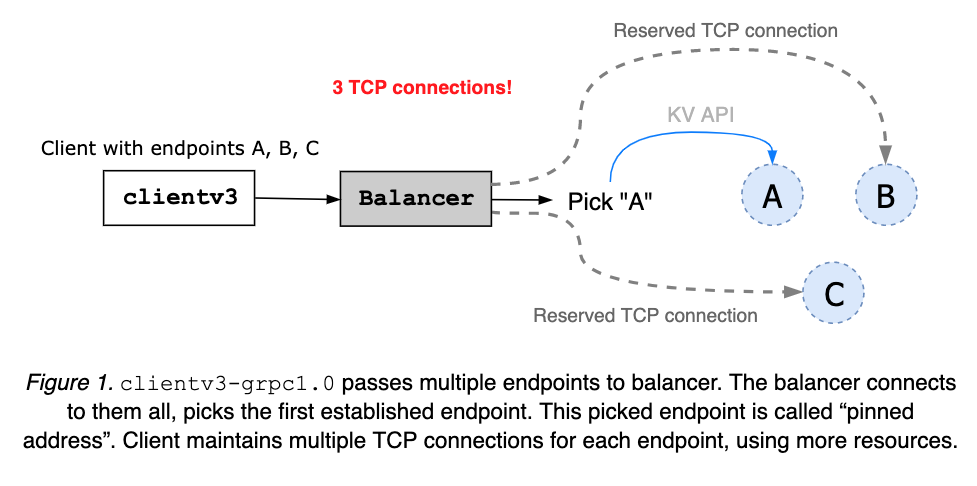
clientv3-grpc1.0:バランサーの制限
clientv3-grpc1.0は複数のTCP接続を開くため、バランサーのフェイルオーバーを高速化できる可能性がありますが、より多くのリソースが必要です。バランサーは、ノードの健全性やクラスターのメンバーシップを把握していません。そのため、障害が起きたノードや、ネットワーク分断されたノードに接続したまま動けなくなることがあります。
clientv3-grpc1.7:バランサーの概要
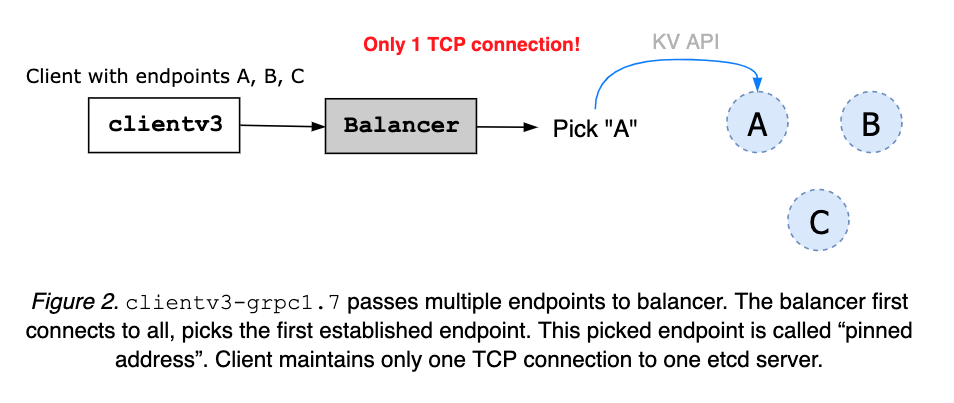
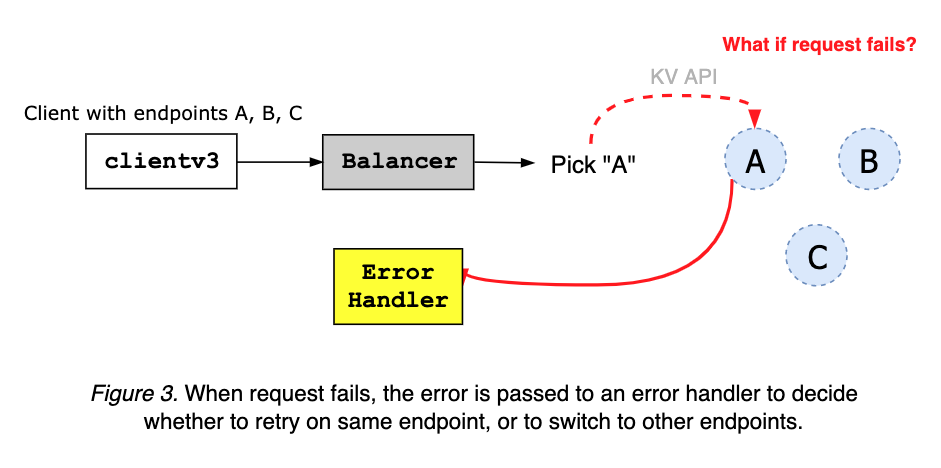
clientv3-grpc1.7は、選択したetcdサーバーへのTCP接続を1つだけ維持します。複数のクラスターエンドポイントが指定されると、クライアントはまずすべてへの接続を試みます。1つの接続が確立すると、バランサーはそのアドレスを固定し、他の接続を閉じます(図2)。固定したアドレスは、クライアントオブジェクトが閉じられるまで維持します。サーバーまたはクライアント側のネットワーク障害によるエラーは、クライアントのエラーハンドラーに渡されます(図3)。
クライアントのエラーハンドラーはgRPCサーバーからエラーを受け取り、エラーコードとメッセージに基づいて、同じエンドポイントで再試行するか、別のアドレスに切り替えるかを決めます(図4と図5)。
WatchやKeepAliveなどのストリーミングRPCは、タイムアウトを設定せずに要求されることがよくあります。その代わりに、クライアントはHTTP/2のpingを定期的に送信して、固定エンドポイントの状態を確認できます。サーバーがpingに応答しなければ、バランサーは他のエンドポイントに切り替えます(図6)。
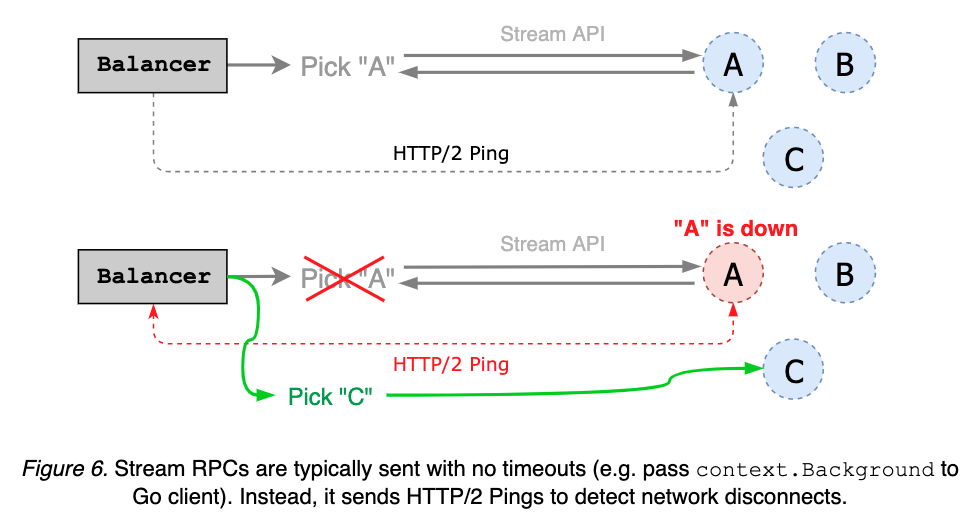
clientv3-grpc1.7:バランサーの制限
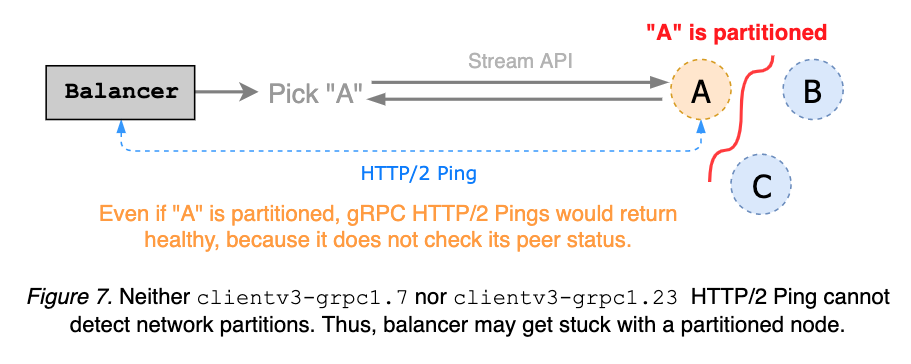
clientv3-grpc1.7のバランサーは、HTTP/2のキープアライブを送信し、ストリーミングリクエストの切断を検出します。これはgRPCサーバーへの単純なping機構であり、クラスターのメンバーシップを考慮しないため、ネットワーク分断を検出できません。分断されたgRPCサーバーもクライアントのpingに応答できるため、バランサーがそのノードに接続したまま動けなくなることがあります。理想的には、キープアライブのpingが分断を検出し、リクエストのタイムアウト前にエンドポイントの切り替えを引き起こすべきです(etcd#8673
と図7を参照)。
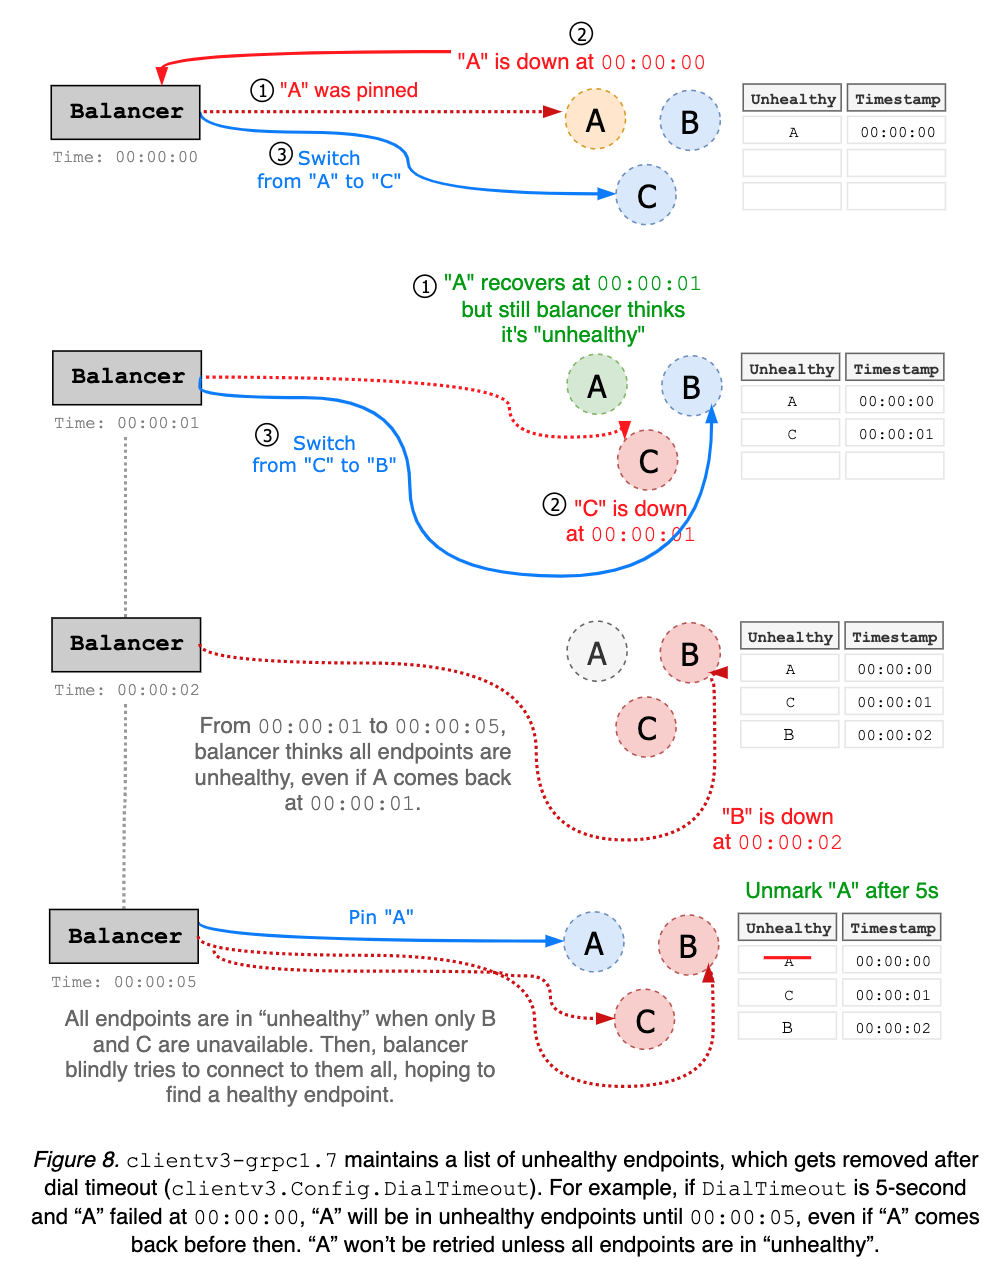
clientv3-grpc1.7のバランサーは、健全でないエンドポイントの一覧を維持します。切断されたアドレスはこの一覧に追加され、待機時間が過ぎるまで利用不能と見なされます。待機時間は接続タイムアウトと同じ値に固定され、デフォルトは5秒です。バランサーは、エンドポイントが健全でないと誤判定することがあります。たとえば、エンドポイントAが除外リストに入った直後に復帰しても、その後5秒間は使用できません(図8)。
clientv3-grpc1.0にも、上記と同じ問題がありました。
アップストリームのgRPC Goは、すでに新しいバランサーインターフェースに移行していました。たとえば、clientv3-grpc1.7の内部のバランサー実装は、新しいgRPCバランサーを使用しながら、古いバランサーの動作との整合性を保とうとしています。互換性はおおむね維持されていましたが、etcdクライアントは微妙な互換性破壊の影響を受けていました
。また、gRPCのメンテナーは、古いバランサーインターフェースに依存しない
ことを推奨しています。一般に、アップストリームからより良いサポートを受けるには、最新のgRPCリリースに追従するのが最善です。再試行ポリシーなどの新機能も、gRPC 1.7ブランチにはバックポートされない可能性があります。そのため、etcdサーバーとクライアントの両方を、最新のgRPCバージョンに移行する必要があります。
clientv3-grpc1.23:バランサーの概要
clientv3-grpc1.7は古いgRPCインターフェースと密結合しており、gRPC依存関係をアップグレードするたびにクライアントの動作が壊れていました。開発とデバッグの作業の大半が、その動作の変化への対処に費やされました。その結果、サーバーの接続性に関する誤った前提を抱えた、過度に複雑な実装になりました。
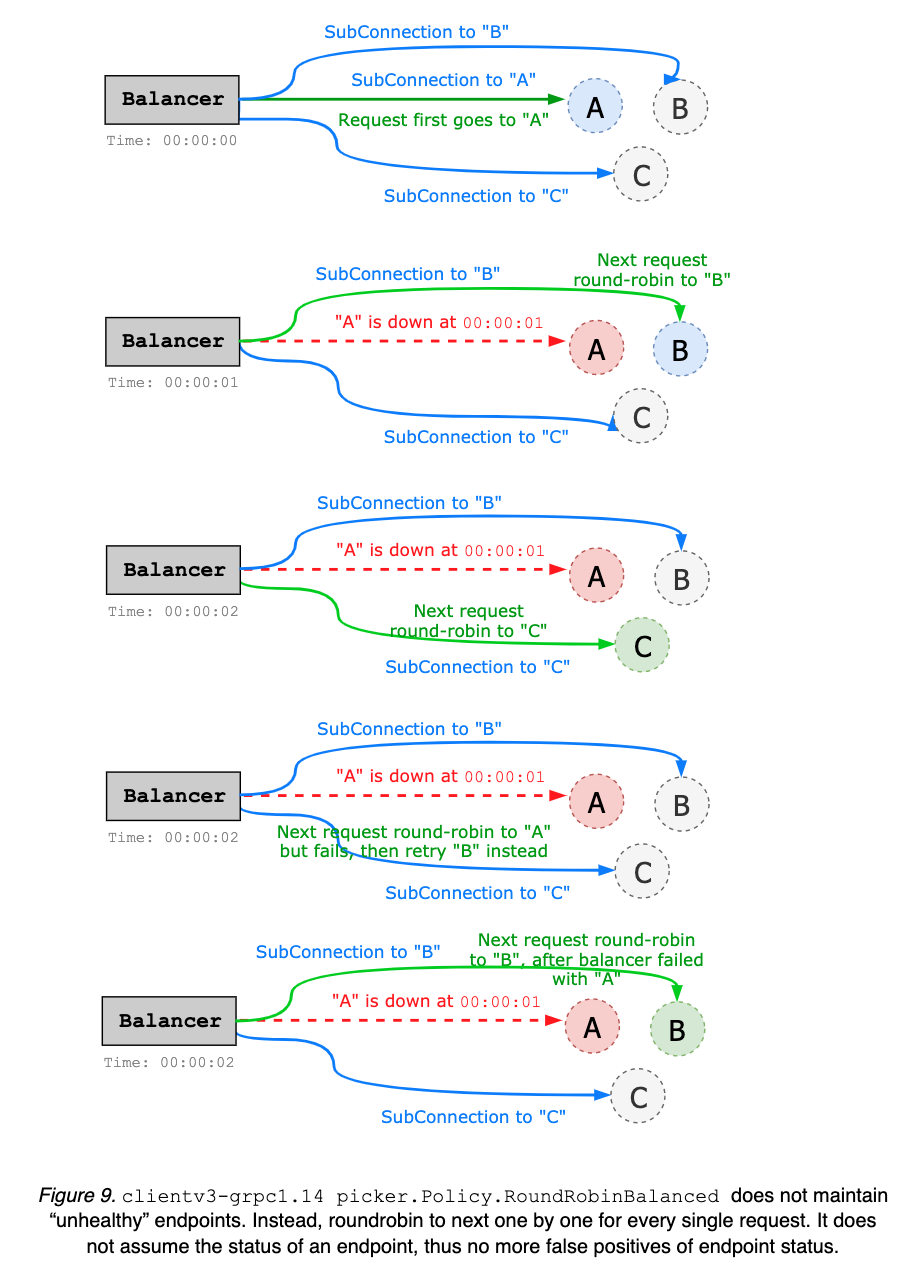
clientv3-grpc1.23の主な目的は、バランサーのフェイルオーバーロジックを単純化することです。古くなる可能性のある、健全でないエンドポイントの一覧を維持するのではなく、現在のエンドポイントから切断されるたびに、次のエンドポイントへ単純にラウンドロビンで移ります。エンドポイントの状態を仮定しないため、複雑な状態追跡は不要です(図8と上記を参照)。すべての後方互換性を維持し、内部だけを変更しているため、clientv3-grpc1.23へのアップグレードに問題はないはずです。
内部的には、複数のエンドポイントが指定されると、clientv3-grpc1.23はエンドポイントごとに1つ、複数のサブ接続を作成します。一方、clientv3-grpc1.7は固定エンドポイントへの接続を1つだけ作成します(図9)。たとえば、5ノードのクラスターでは、clientv3-grpc1.23のバランサーは5つのTCP接続を必要とし、clientv3-grpc1.7は1つだけを必要とします。TCP接続のプールを保持することで、clientv3-grpc1.23はより多くのリソースを使用する可能性がありますが、フェイルオーバー性能に優れた、より柔軟なロードバランサーを提供します。デフォルトの負荷分散ポリシーはラウンドロビンですが、他の方式(power of two、リーダーの選択など)にも容易に拡張できます。clientv3-grpc1.23は、gRPCのリゾルバーグループを使用し、バランサーの選択ポリシーを実装することで、複雑な負荷分散処理をアップストリームのgRPCに委ねます。一方、clientv3-grpc1.7は、各gRPC接続とバランサーのフェイルオーバーを独自に処理するため、実装が複雑になります。clientv3-grpc1.23は、gRPC内部のエラーを自動処理し、バックオフなどの高度な再試行ポリシーも可能にする、gRPCのインターセプターチェーンで再試行を実装しています。clientv3-grpc1.7は、再試行のためにgRPCエラーを独自に解釈します。
clientv3-grpc1.23:バランサーの制限
各エンドポイントの状態をキャッシュすれば、改善できる余地があります。たとえば、バランサーがあらかじめ各サーバーにpingを送り、健全な接続先候補の一覧を維持して、ラウンドロビン時にその情報を使用できます。また、切断時に健全なエンドポイントを優先することもできます。ただし、バランサーの実装が複雑になる可能性があるため、後のバージョンで対応できます。
クライアント側のキープアライブのpingは、依然としてネットワーク分断を考慮していません。ストリーミングリクエストは、分断されたノードで進行できなくなることがあります。クラスターのメンバーシップを把握するには、高度なヘルスチェックサービスを実装する必要があります(詳細はetcd#8673 を参照)。
現在、再試行ロジックはインターセプターとして独自に処理しています。gRPC公式の再試行 を使えば、単純化できる可能性があります。
12.3 - etcdの学習者メンバーの設計
etcdの学習者メンバー
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
背景
メンバーシップの再構成は、運用上の最も大きな課題の1つでした。よくある課題を確認します。
1. 新しいクラスターメンバーがリーダーに過負荷をかける
新たに参加したetcdメンバーはデータを持たない状態から開始するため、リーダーのログに追いつくまで、リーダーに多くの更新を要求します。これによってリーダーのネットワークが過負荷になりやすくなり、フォロワーへのハートビートが滞ったり失われたりします。その場合、フォロワーの選挙タイムアウトが発生し、新しいリーダー選挙が始まる可能性があります。つまり、新しいメンバーを加えたクラスターでは、リーダー選挙が起きやすくなります。リーダー選挙と、その後の新しいメンバーへの更新の伝播は、どちらもクラスターを一時的に利用不能にする原因になりやすい処理です(図1)。
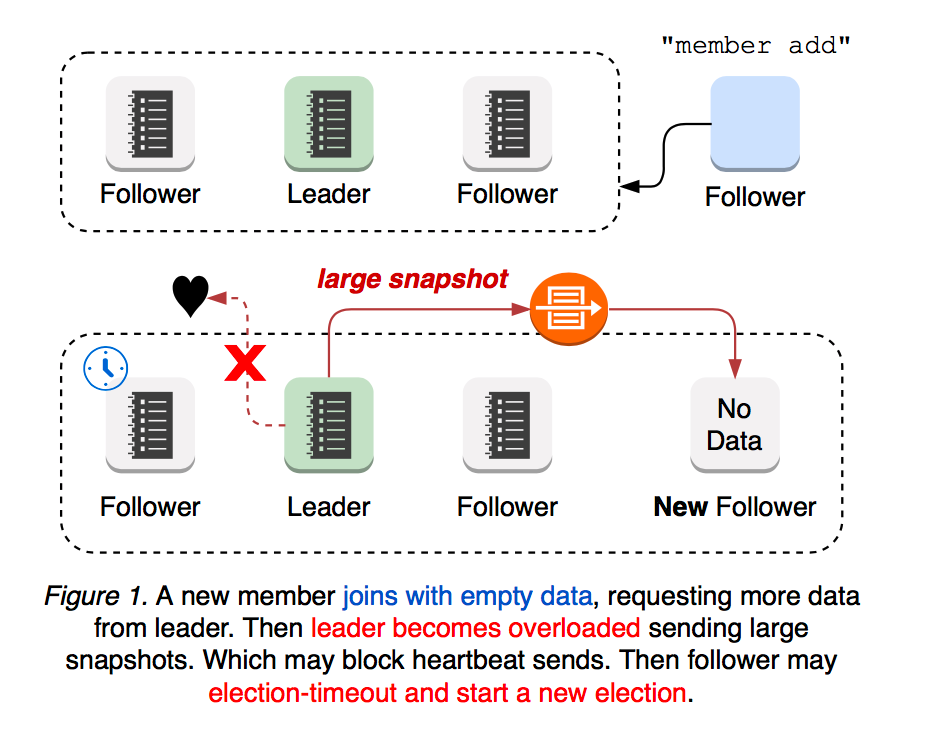
2. ネットワーク分断の各状況
ネットワーク分断が起きるとどうなるでしょうか。リーダーが属する側の状況によって異なります。リーダー側が稼働中のクォーラムを維持していれば、クラスターは動作し続けます(図2)。
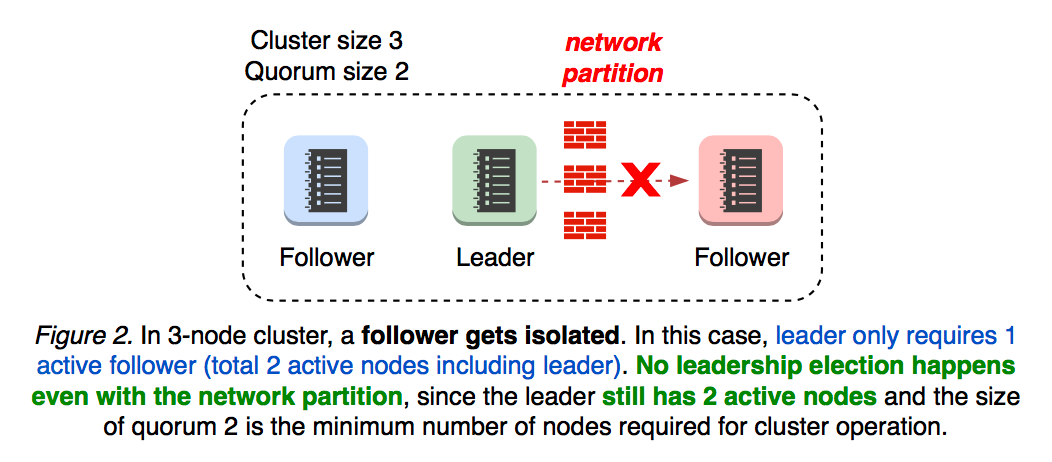
2.1 リーダーの孤立
リーダーがクラスターの他のメンバーから孤立すると、どうなるでしょうか。リーダーは各フォロワーの進捗を監視しています。クォーラムとの接続を失うとフォロワーに戻るため、クラスターの可用性に影響します(図3)。
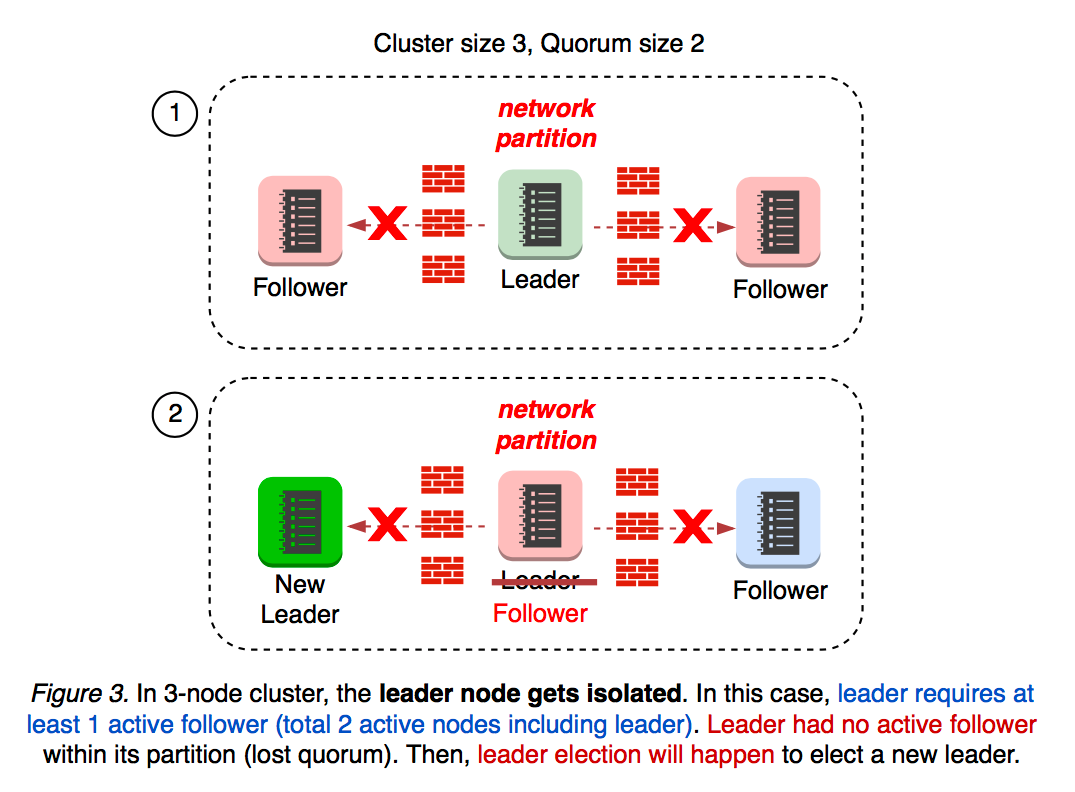
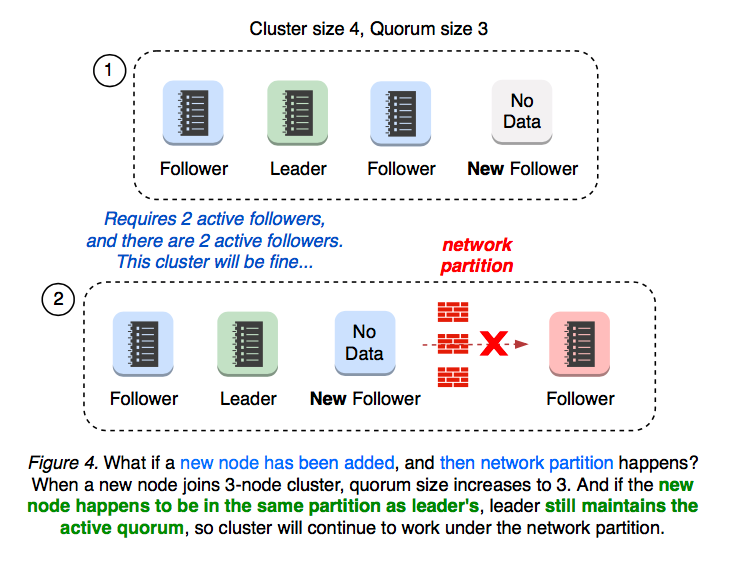
3ノードのクラスターに新しいノードを追加すると、クラスターサイズは4、クォーラムのサイズは3になります。新しいノードが参加した後にネットワーク分断が起きた場合はどうでしょうか。分断後に、新しいメンバーがどちら側に位置するかによって異なります。
2.2 クラスターの3+1への分断
新しいノードがリーダーと同じ側にあれば、リーダーは稼働中の3ノードのクォーラムを維持します。リーダー選挙は発生せず、クラスターの可用性にも影響しません(図4)。
2.3 クラスターの2+2への分断
クラスターが2ノードずつに分断されると、どちら側も3ノードのクォーラムを維持できません。この場合、リーダー選挙が発生します(図5)。
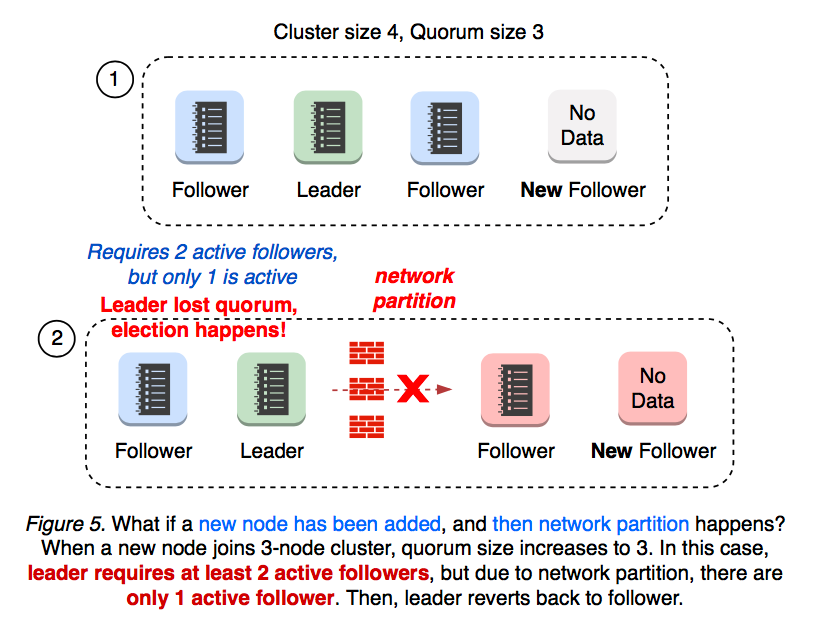
2.4 クォーラムの喪失
先にネットワーク分断が起き、その後で新しいメンバーを追加するとどうなるでしょうか。分断された3ノードのクラスターでは、すでに1つのフォロワーが切断されています。新しいメンバーを追加すると、クォーラムは2から3に変わります。クラスターの4ノード中、稼働しているのは2ノードだけになるため、クォーラムを失い、新しいリーダー選挙が始まります(図6)。
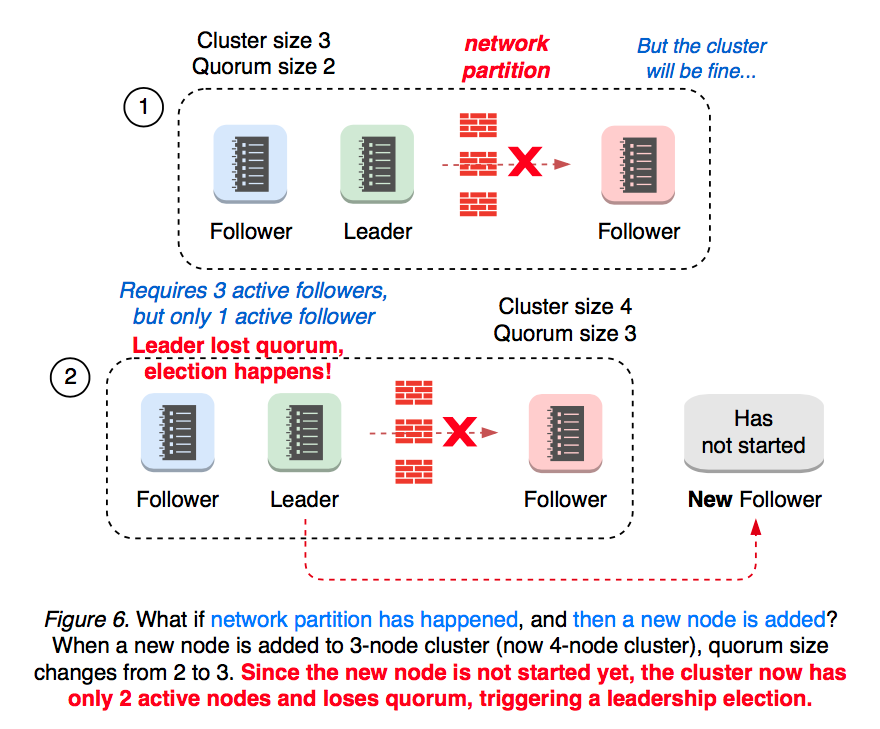
メンバーの追加はクォーラムのサイズを変える可能性があるため、健全でないノードを置き換えるときは、常に先に“member remove”を行うことを推奨します。
1ノードのクラスターに新しいメンバーを追加すると、クォーラムのサイズは2に変わります。それまでのリーダーが、稼働中のクォーラムがないことを認識すると、直ちにリーダー選挙が始まります。これは、“member add”が2段階の処理だからです。ユーザーはまず“member add”コマンドを適用し、その後で新しいノードのプロセスを起動する必要があります(図7)。
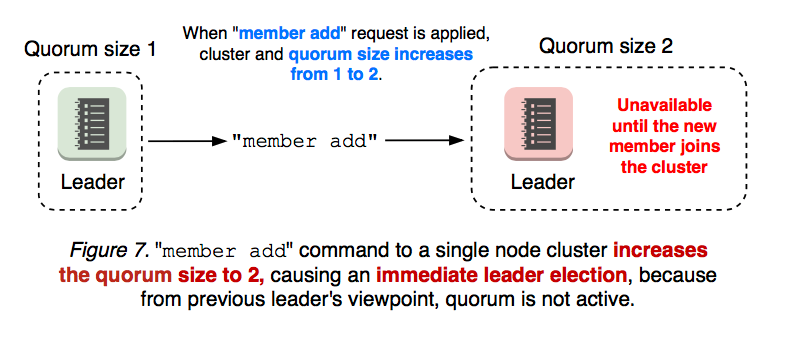
3. クラスターの設定ミス
さらに悪いのは、追加したメンバーの設定が誤っている場合です。メンバーシップの再構成は、“etcdctl member add”と、指定したピアURLでetcdサーバープロセスを起動する、2段階の処理です。つまり、URLの値が無効であっても、“member add”コマンドはURLにかかわらず適用されます。最初の段階で無効なURLを適用すると、次の段階で新しいetcdを起動することすらできません。いったんクラスターがクォーラムを失うと、メンバーシップの変更を元に戻す方法はありません(図8)。
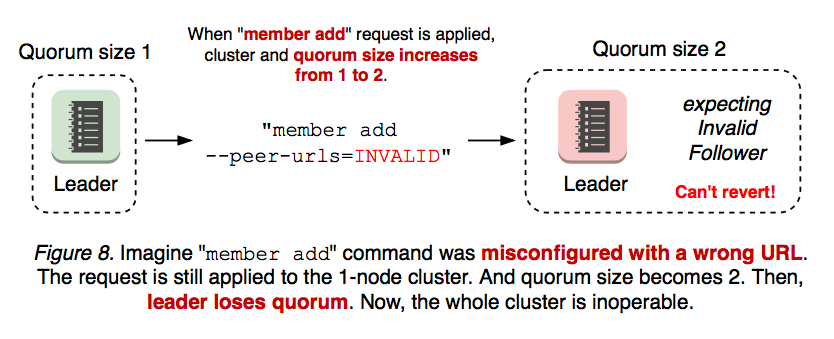
複数ノードのクラスターでも同じです。たとえば、2つのメンバーが停止(1つは故障、もう1つは設定ミス)し、2つが稼働していても、クラスターのメンバーシップを変更するには少なくとも3票が必要です(図9)。
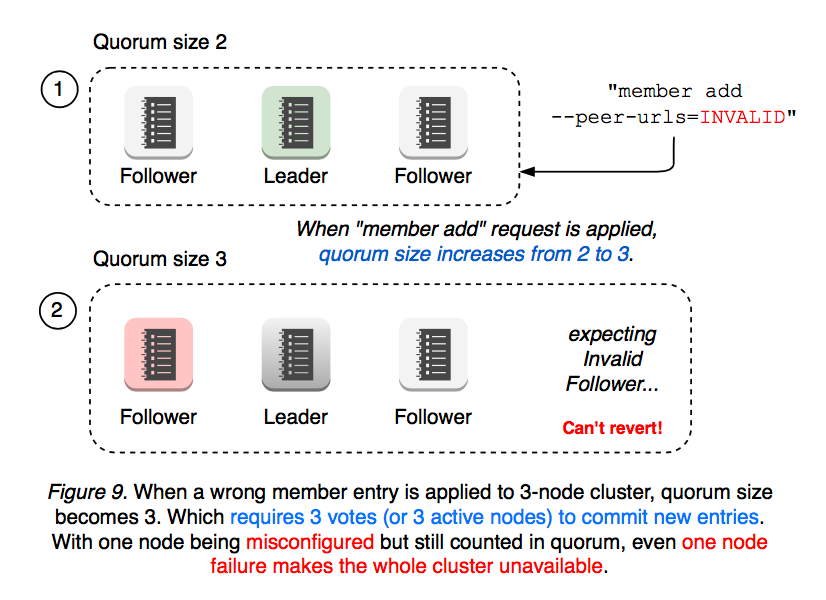
このように、単純な設定ミスでクラスター全体が動作不能になることがあります。その場合、運用担当者はetcd --force-new-clusterフラグを使って、手動でクラスターを再作成する必要があります。etcdはKubernetesに不可欠なサービスになっているため、ごく短い停止でもユーザーに大きな影響を与える可能性があります。etcdでこうした操作を簡単にするために、何を改善できるでしょうか。特に、リーダー選挙はクラスターの可用性にとって極めて重要です。クォーラムのサイズを変えずに、メンバーシップの再構成の影響を小さくできるでしょうか。新しいノードが追いつくまで、リーダーへの更新要求を最小限にして待機できるでしょうか。メンバーシップの設定ミスを常に元に戻せるようにし、より安全に扱えるでしょうか。誤ったmember addコマンドでクラスターが停止することがあってはいけません。新しいメンバーを追加するとき、ユーザーがネットワーク構成を気にする必要はあるでしょうか。ノードの配置や発生中のネットワーク分断にかかわらず、member add APIを動作させられるでしょうか。
Raftの学習者メンバー
前のセクションで挙げた可用性の問題を軽減するため、Raft §4.2.1 では、新しいノード状態“Learner”を導入しています。このノードは、リーダーのログに追いつくまで、投票権のないメンバーとしてクラスターに参加します。
v3.4の機能
新しい学習者ノードを追加するための運用作業は、できるだけ少なくするべきです。member add --learnerコマンドで新しい学習者メンバーを追加します。学習者メンバーは投票権を持たずにクラスターに参加しますが、リーダーからすべてのデータを受信します(図10)。
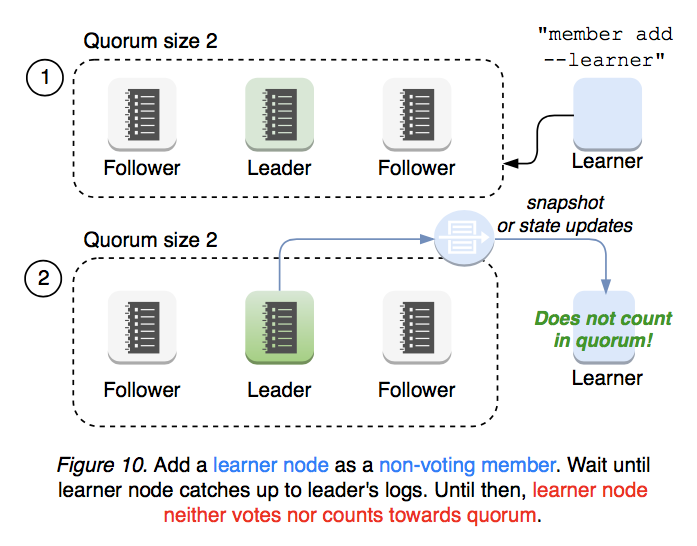
学習者メンバーがリーダーの進捗に追いつくと、member promote APIで投票メンバーに昇格できます。昇格後は、クォーラムの構成員として数えられます(図11)。
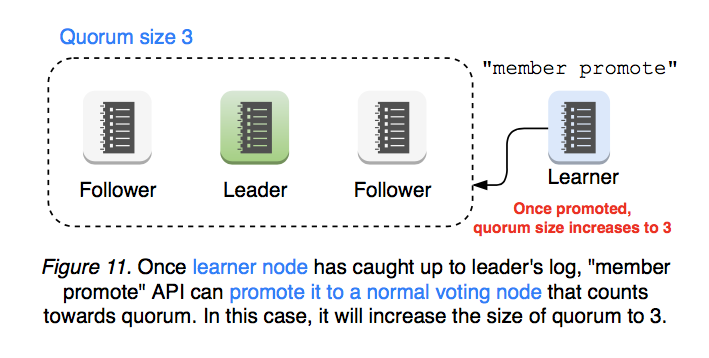
etcdサーバーは、操作の安全性を確保するため、昇格リクエストを検証します。学習者メンバーを投票メンバーに昇格できるのは、そのログがリーダーのログに追いついた後だけです(図12)。
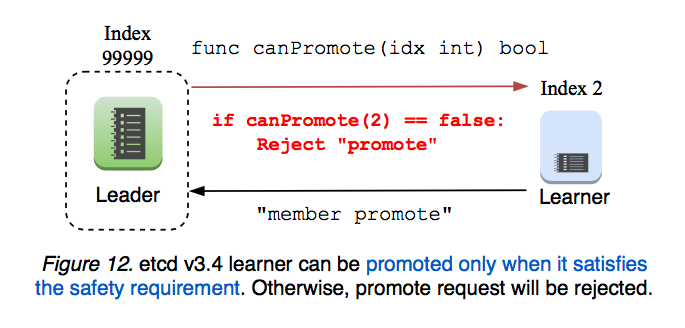
学習者メンバーは、昇格するまで待機ノードとしてのみ機能します。学習者メンバーにリーダーシップを移譲することはできません。学習者メンバーはクライアントの読み書きを拒否します。そのため、クライアントのバランサーはリクエストを学習者メンバーに送らないようにするべきです。これは、学習者メンバーがリーダーにRead Indexリクエストを発行する必要がないことを意味します。この制限によって、v3.4リリースでの初期実装を単純化しています(図13)。
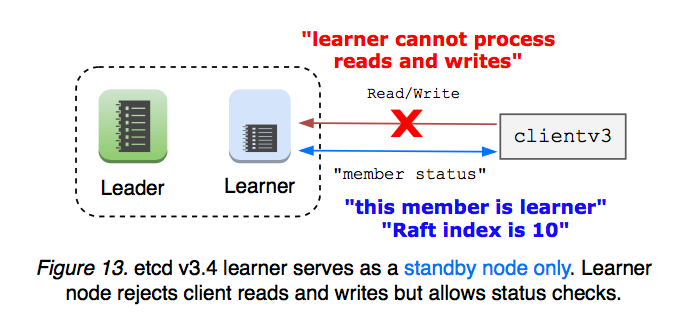
また、etcdはクラスターが持てる学習者メンバーの総数を制限し、ログの複製でリーダーが過負荷になるのを防ぎます。学習者メンバーが自ら昇格することはありません。etcdは学習者メンバーの状態情報と安全性チェックを提供しますが、昇格するかどうかの最終判断は、クラスターの運用担当者が行わなければなりません。
今後のリリースに向けた機能案
新規メンバーの初期状態を学習者に統一し、デフォルトにする:学習者メンバーはクォーラムのサイズを変えないため、新規メンバーのデフォルト状態を学習者にすれば、メンバーシップの再構成の安全性が大幅に向上します。設定ミスがあっても、クォーラムを失わずに常に元に戻せます。
投票メンバーへの昇格を完全に自動化する:学習者メンバーがリーダーのログに追いついたら、クラスターが自動的に昇格させられます。ユーザーが一定のしきい値を定義し、その要件が満たされると、学習者メンバーが自ら投票メンバーに昇格します。ユーザーから見れば、“member add”コマンドは今と同じように動作しつつ、学習者メンバーの機能によって安全性が高まります。
学習者を待機用のフェイルオーバーノードにする:学習者メンバーは待機ノードとして参加し、クラスターの可用性が損なわれると自動的に昇格します。
学習者を読み取り専用にする:学習者メンバーは、昇格しない読み取り専用ノードとしても機能できます。弱い一貫性のモードでは、リーダーからデータを受信するだけで、書き込みを処理しません。コンセンサスの負担なしにローカルで読み取りを処理すると、リーダーの負荷を大幅に減らせますが、古いデータを返す可能性があります。強い一貫性のモードでは、最新のデータを返すためにリーダーへread indexを要求しますが、書き込みは引き続き拒否します。
学習者メンバーとMirror Makerの比較
etcdは、watch APIを使ってキーの作成と更新を別のクラスターに継続的に中継する“mirror maker”を実装しています。ミラーリングは、初期同期が完了すれば、通常は遅延の増加が小さい仕組みです。学習者メンバーとミラーリングは、どちらも既存のデータを読み取り専用で複製するために使える点で共通しています。ただし、ミラーリングは線形化可能性を保証しません。ネットワーク切断中に以前のキー・バリューが破棄されていることがあるため、クライアントは監視レスポンスを検証して正しい順序を確認する必要があります。したがって、ミラーには順序の保証がありません。一貫性と引き換えに最小の遅延が必要な場合(データセンター間など)にはミラーを使用します。すべての履歴データとその順序を維持するには、学習者メンバーを使用します。
付録:v3.4の学習者メンバーの実装
“MemberAdd” APIに“Learner”ノードの種類を公開する。
etcdクライアントは、“MemberAdd” APIに学習者ノード用のフラグを追加します。etcdサーバーのハンドラーは、pb.ConfChangeAddLearnerNode型のメンバーシップ変更エントリーを適用します。コマンドの適用後、サーバーはetcd --initial-cluster-state=existingフラグを指定してクラスターに参加します。この学習者ノードは、投票も、クォーラムの構成員として数えられることもありません。
学習者メンバーはまだ遅れている可能性があり、クォーラムにも数えられないため、etcdサーバーは学習者メンバーにリーダーシップを移譲してはいけません。学習者メンバーが多いほどリーダーが伝播するデータが増えるため、etcdサーバーはクラスターが持てる学習者メンバーを1つに制限します。クライアントは学習者ノードと通信できますが、学習者メンバーは直列化可能読み取りとメンバー状態API以外のすべてのリクエストを拒否します。これは初期実装を単純にするためです。将来的には、クラスターのデータを継続的にミラーリングする読み取り専用サーバーとして、学習者メンバーを拡張できます。クライアントのバランサーは、学習者ノードのエンドポイントを除外する補助関数を提供しなければなりません。そうしなければ、学習者メンバーへ送ったリクエストが失敗する可能性があります。クライアントのメンバー同期の呼び出しは、学習者というノードの種類を考慮するべきです。クライアントのエンドポイント更新の呼び出しも同様です。
MemberListとMemberStatusのレスポンスは、どのノードが学習者かを示すべきです。
“MemberPromote” APIを追加する。
Raft内部では、学習者ノードに対する2回目のMemberAdd呼び出しが、そのノードを投票メンバーに昇格させます。リーダーは、各フォロワーと学習者メンバーの進捗を保持します。学習者メンバーがスナップショットメッセージの処理を完了していなければ、昇格リクエストを拒否します。昇格リクエストを受け付けるのは、学習者ノードが健全であり、リーダーと同期済み、または差分がしきい値以内の場合に限ります。たとえば、学習者メンバーに複製するエントリー数がスナップショット件数の1/10未満なら、昇格後にリーダーが学習者メンバーへスナップショットを送る必要が生じる可能性は低くなります。これらのロジックはすべてetcdserverパッケージに固定されており、設定で変更することはできません。
参考資料
- 元のGitHub Issue:etcd#9161
- ユースケース:etcd#3715
- ユースケース:etcd#8888
- ユースケース:etcd#10114
12.4 - etcd v3の認証設計
v2の認証システムを再利用しない理由
v3プロトコルは、v2のようなRESTfulインターフェースではなく、gRPCを通信に使用します。この新しいプロトコルによって、v2の設計を見直し、改善する機会が得られました。たとえば、v3の認証は接続単位で行い、v2の低速なリクエスト単位の認証から改善されています。また、次のセクションで説明するとおり、v2の認証の意味論は、一貫性を考えるうえで実際には扱いにくい面があります。v3には、v2の認証システムの欠点を解消する、明確に定義された認証機構の説明と実装があります。
機能要件
- リクエスト単位ではなく、接続単位の認証
- gRPC APIに、ユーザーIDとパスワードによる認証を実装する
- 認証ポリシーの変更後は、認証を更新しなければならない
- v2と同じように、シンプルで使いやすい機能を提供する
- v3は、v2のディレクトリ構造とは異なり、平坦なキー空間を提供する。権限チェックは、区間との照合で行う
- v2の認証より強い一貫性保証を持つ
必要な主な変更
- クライアントは、認証付きのリクエストを送信する前に、認証だけに使用する専用の接続を作成しなければならない
- Raftコマンド(
etcdserverpb.InternalRaftRequest)に、権限情報(ユーザーIDと認可時のリビジョン)を追加する - 各リクエストの権限チェックを、APIレイヤーではなく、状態機械のレイヤーで行う
権限メタデータの一貫性
認証のメタデータも、etcdに保存する他のデータと同様に、etcdのRaftプロトコルが制御するストレージに保存し、管理する必要があります。これは、etcdクラスター全体の可用性と一貫性を損なわないために必要です。メタデータ(権限情報など)の読み書きに、クォーラムを超える、すべてのノードの合意が必要なら、単一ノードの障害でクラスター全体が停止する可能性があります。すべてのノードの同時の合意を要求すると、利用可能なクォーラムが存在していても、メンバーのいずれかが停止していれば、通常の読み書きリクエストのチェックを完了できません。この全会一致方式は、結果的にクラスターの可用性を低下させます。一貫した順序付けから合意が得られるため、Raftのクォーラムに基づくコンセンサスで十分です。
etcd v2プロトコルの認証機構には、扱いの難しい点があります。メタデータの一貫性は上記のように動作するべきですが、実際はそうなっていません。各権限チェックは、クライアントリクエストを受信したetcdメンバーが、フォロワーであっても処理します(server/etcdserver/api/v2http/client.go)。そのため、古いメタデータに基づいてチェックする可能性があります。
メタデータが古いままになるということは、運用担当者がetcdctlを実行しても、認証構成がすぐには反映されないことを意味します。したがって、古いメタデータがいつまで有効なのかを知る方法がありません。通常、構成変更はコマンドの実行直後に反映されます。しかし、高負荷の状況などでは不整合な状態が長引き、ユーザーや開発者にとって直感に反する状況が生じることがあります。そのため、このような回避策 が必要になります。
権限の不整合は線形化されたリクエストにとって安全でない
認証状態の不整合が最も深刻になるのは、書き込み時です。運用担当者があるユーザーの書き込みを無効にしても、書き込みがキー・バリューストアに対してだけ順序付けられ、認証システムに対しては順序付けられていなければ、書き込みが成功する可能性があります。認証ストアとキー・バリューストアの両方に対する順序付けがなければ、古い権限を利用した攻撃を受けるおそれがあります。
したがって、etcdの状態機械に権限チェックのロジックを追加するべきです。各状態機械は、適用段階で自身の権限情報に基づいてリクエストをチェックするべきです。そのため、認証情報は古くなっていてはいけません。
設計と実装
認証
まず、クライアントはユーザーIDとパスワードを認証するためだけのgRPC接続を作成しなければなりません。etcdサーバーは、認証レスポンスを返します。成功時には認証トークン、失敗時にはエラーを返します。クライアントはAPIリクエストを行うとき、この認証トークンを使ってetcdに認証情報を提示できます。
認証トークンの要求に使ったクライアント接続は、通常、破棄します。その接続には新しいトークンの認証情報を設定できないためです。gRPCには、接続の作成(grpc.Dial()の呼び出し)後にRPCごとの認証情報を追加する方法がありません。したがって、接続を通じて取得したトークンを、その接続に割り当てることはできません。トークンを使用するには、新しい接続が必要です。
Authenticate() RPCの実装に関する注意事項
Authenticate() RPCは、指定されたユーザー名とパスワードに基づいて認証トークンを生成します。etcdは、Goのbcryptパッケージを使って、設定されたパスワードを保存し、入力されたパスワードを検証します。bcryptのパスワード検証は設計上、計算コストが高く、一般的なx64サーバーで約100msかかります。そのため、この検証を状態機械の適用段階で行うと、etcdクラスター全体で1秒当たり約10件のAuthenticate()リクエストしか処理できず、性能上の問題になります。
性能を確保するため、v3の認証機構はetcdのAPIレイヤーでパスワードを検証し、Raftの外部で並列化できるようにしています。ただし、これにより、検査時点と使用時点の差(TOCTOU)による権限上の問題が生じる可能性があります。
- クライアントAが
Authenticate()リクエストを送信する - APIレイヤーが
Authenticate()のパスワード検証部分を処理する - 別のクライアントBが
ChangePassword()リクエストを送信し、サーバーがそれを完了する - 状態機械のレイヤーが、Aの
Authenticate()のリビジョン番号取得部分を処理する - サーバーがAに成功を返す
- Aは、古いパスワードで認証された状態になる
この状況を避けるため、APIレイヤーは認証ストアのリビジョン番号に基づくバージョン番号の検証を行います。パスワードの検証時に、APIレイヤーは認証ストアのリビジョン番号を保存します。パスワードの検証に成功した後、保存したリビジョン番号を最新のリビジョン番号と比較します。番号が異なれば、別の処理が認証メタデータを更新したことになるため、検証をやり直します。この仕組みにより、古いパスワードに基づく認証の成功を防げます。
APIレイヤーでのトークンの解決
Authenticate()で認証した後、クライアントは認証を使用しない場合と同様にgRPC接続を作成できます。既存の初期化処理に加え、新しく作成した接続にトークンを関連付ける必要があります。このための機能を、grpc.WithPerRPCCredentials()が提供します。
クライアントからの各認証付きリクエストにはトークンが含まれます。サーバー側では、grpc.metadata.FromIncomingContext()でトークンを取得できます。サーバーは、誰がリクエストを発行し、そのユーザーがいつ認可されたかを取得できます。この情報はAPIレイヤーによって、Raftログエントリー(etcdserverpb.InternalRaftRequest)のヘッダー(etcdserverpb.RequestHeader.Usernameとetcdserverpb.RequestHeader.AuthRevision)に設定されます。
状態機械での権限チェック
etcdserverpb.RequestHeader内の認証情報は、状態機械の適用段階でチェックされます。この段階では、認証ストアの最新リビジョンに基づいて、要求されたキーに対する権限がユーザーに付与されているかを確認します。
2種類のトークン:simpleとJWT
トークンには、simpleとJWTの2種類があります。simpleトークンは、本番での使用を想定していません。暗号署名がなく、サーバーがトークンとユーザーの対応関係を状態として追跡する必要があるため、開発時のテスト用です。本番環境では、暗号署名と検証を行うJWTトークンの使用を推奨します。実装上、JWTはステートレスです。トークン自体にユーザー名やリビジョンなどのメタデータを含められるため、サーバーはトークンとメタデータの対応関係を記憶する必要がありません。
simpleトークンには、既知の問題#18437 があります。etcdサーバー内ではトークンをAPIレイヤーで解決し、simpleトークンは状態を保持します。この処理は線形化可能なチェックで保護されていないため、etcdメンバーが前の認証リクエストを処理し終える前に、次のリクエストを受信することがあります。その場合、メンバーはクライアントに"invalid auth token"エラーを返す可能性があります。この問題は、ネットワーク状態が良いノードでは通常まれですが、大きな遅延があると発生することがあります。回避策として、アプリケーション側にこのエラーを処理する再試行の仕組みを実装できます。
JWTトークンの直接設定
標準のAuthenticate() RPCの流れに加え、etcdはクライアントにJWTトークンを直接設定する方法をサポートしています。これにより、生成、検証、ローテーションを含むJWTトークンのライフサイクル全体を、アプリケーションがetcdの外部で管理できます。
用途と処理の流れ
この方法は、次の場合に役立ちます。
- etcdとは別のトークン管理システムが、JWTトークンの生成とライフサイクルを管理する
- アプリケーションが、外部の仕組み(環境変数や構成サービスなど)を通じて署名済みのJWTトークンを受け取る
- トークンのライフサイクルを、etcdによる自動生成ではなく、クライアントアプリケーションだけで管理する必要がある
一般的な流れは、次のとおりです。
- etcdとは別の外部の発行元が、ユーザー名とその他のクレームを含む、署名付きのJWTトークンを生成する
- アプリケーションが署名済みトークンを受け取り、etcdクライアントに設定する
- クライアントが、
Authenticate()を呼び出さずに、リクエストにJWTトークンを直接付けて送信する - etcdサーバーが、設定された公開鍵でトークンの署名を検証し、トークン内のユーザー名に基づいてアクセスを許可する
- トークンの有効期限が切れる前に、アプリケーションが外部の発行元から新しいトークンを取得する
- アプリケーションが、更新されたトークンを使って新しいクライアントを作成する(トークンの更新にはクライアントの再作成が必要)
標準の認証との違い
標準のAuthenticate()の流れでは、次のように動作します。
- クライアントが、ユーザー名とパスワードを指定して
Authenticate()を呼び出す - etcdがトークンを生成して返す
- クライアントが、後続のリクエストにこのトークンを自動的に使用する
- トークンの更新には、再度
Authenticate()を呼び出す必要がある
JWTトークンを直接設定する場合は、次のように動作します。
- 署名済みのJWTトークンを使ってクライアントを初期化する
- クライアントは
Authenticate()を呼び出さない - すべてのリクエストで、そのトークンを直接使用する
- 有効期限前の新しいトークンの取得と、クライアントのライフサイクル管理は、クライアントアプリケーションが担う
有効なトークンがない場合のAuthStatus
JWTトークンを自ら管理するアプリケーションをサポートするため、AuthStatus RPCは、認証が有効かどうかの確認と、現在のauthRevisionの取得ができるように設計されています。これは、トークンの有効期限が切れ、外部のトークンプロバイダーから新しい有効なトークンを取得するために最新のリビジョンが必要となるリカバリー時に重要です。
この機能がなければ、トークンの有効期限切れによって現在のauthRevisionを取得できず、新しいトークンを生成できないデッドロックに陥る可能性があります。
KVSモデルとファイルシステムモデルの違いに関する注意事項
etcd v3はKVSであり、ファイルシステムではありません。そのため、正確なキー名、または["start key", "end key")のようなキー範囲の形式で、ユーザーに権限を付与できます。これは、存在しないキーに対しても権限を付与できることを意味します。意図しない権限の付与に注意してください。ファイルシステムに似たシステム(ChubbyやZooKeeperなど)では、inodeのようなデータ構造に権限情報を含められます。そのため、スティッキービットの場合を除き、存在しないキーに権限を付与することはできません。
etcd v3のモデルでは、ファイルシステムに似たシステムとは異なり、メタデータの複数回の検索が必要です。最悪の場合の検索コストは、ユーザーに権限が付与されたキーと区間の総数になります。v3の平坦なキー空間は、各inodeが権限メタデータを含むUnixのファイルシステムモデルとはまったく異なるため、このコストは避けられません。実際には、メタデータはキャッシュの効果が得られるほど小さいため、深刻な問題にはなりません。
12.5 - etcd API
このドキュメントでは、etcd v3 APIの中心となる設計の概要を説明します。 etcd v3.5で非推奨となったetcd v2 APIとは異なることに注意してください。 すべてを網羅するものではなく、使用頻度の低いAPI呼び出しに話を広げずに、etcdを理解するために必要な基本的な考え方に焦点を当てます。 etcdのすべてのAPIは、etcdサーバーが処理するリモートプロシージャコール(RPC)を分類したgRPCサービス で定義されています。 etcdのすべてのRPCの完全な一覧は、gRPC API一覧 にMarkdown形式で記載されています。
gRPCサービス
etcdサーバーに送信するすべてのAPIリクエストは、gRPCのリモートプロシージャコールです。etcdのRPCは、機能に基づいてサービスに分類されます。
etcdのキー空間を扱う主要なサービスは、次のとおりです。
- KV - キー・バリューペアを作成、更新、取得、削除します。
- Watch - キーの変更を監視します。
- Lease - クライアントのキープアライブメッセージを処理するプリミティブを提供します。
クラスター自体を管理するサービスは、次のとおりです。
- Auth - ユーザーを認証するための、ロールに基づく認証機構です。
- Cluster - メンバーシップ情報と構成機能を提供します。
- Maintenance - リカバリー用スナップショットの作成、ストアのデフラグメンテーション、メンバーごとの状態情報の取得を行います。
リクエストとレスポンス
etcdのすべてのRPCは同じ形式に従います。各RPCは、NameRequestを引数に取り、NameResponseをレスポンスとして返す関数Nameを持ちます。たとえば、Range RPCの定義は次のとおりです。
レスポンスヘッダー
etcd APIのすべてのレスポンスには、そのレスポンスに関するクラスターのメタデータを含むヘッダーが付属します。
- Cluster_ID - レスポンスを生成したクラスターのIDです。
- Member_ID - レスポンスを生成したメンバーのIDです。
- Revision - レスポンス生成時のキー・バリューストアのリビジョンです。
- Raft_Term - レスポンス生成時のメンバーのRaftの任期です。
アプリケーションは、Cluster_IDまたはMember_IDフィールドを読み取り、意図したクラスター(メンバー)と通信していることを確認できます。
Revisionフィールドから、キー・バリューストアの最新のリビジョンを取得できます。これは、過去のリビジョンを指定してtime travel queryを実行し、リクエスト時点での最新のリビジョンを知りたい場合に特に役立ちます。
Raft_Termを使うと、クラスターが新しいリーダー選挙を完了したことを検出できます。
Key-Value API
Key-Value APIは、etcd内に保存されたキー・バリューペアを操作します。通常、etcdに対するリクエストの大半はキー・バリューのリクエストです。
システムのプリミティブ
キー・バリューペア
キー・バリューペアは、キー・バリューAPIで操作できる最小単位です。各キー・バリューペアは、protobuf形式 で定義された複数のフィールドを持ちます。
- Key - バイト列で表したキーです。空のキーは許可されません。
- Value - バイト列で表した値です。
- Version - キーのバージョンです。削除するとバージョンはゼロにリセットされ、キーを変更するたびにバージョンが増加します。
- Create_Revision - キーが最後に作成されたリビジョンです。
- Mod_Revision - キーが最後に変更されたリビジョンです。
- Lease - キーに関連付けられたリースのIDです。leaseが0の場合、キーにリースは関連付けられていません。
etcdは、キーと値に加え、キーのメッセージの一部としてリビジョンのメタデータも付与します。このリビジョン情報は、作成時刻と変更時刻によってキーに順序を付け、分散同期のための並行処理制御に役立ちます。etcdクライアントの分散共有ロック は、作成リビジョンを使ってロックの所有権を待ちます。同様に、変更リビジョンは、ソフトウェアトランザクショナルメモリー の読み取り集合の競合の検出や、リーダー選挙 の更新の待機に使用します。
リビジョン
etcdは、キー空間が変更されるたびに増加する、クラスター全体の64ビットカウンターであるストアリビジョンを保持します。リビジョンはグローバルな論理時計として機能し、ストアへのすべての更新を順序付けます。新しいリビジョンが表す変更は差分です。リビジョンに関連付けられるデータは、ストアを変更したデータです。内部的には、新しいリビジョンとは、増加したリビジョンをキーとして、バックエンドのB+treeに変更を書き込むことを意味します。
etcdの多版型同時実行制御 バックエンドを考えると、リビジョンの有用性がさらに分かります。MVCCモデルでは、過去のキーのリビジョンを保持するため、キー・バリューストアを過去のリビジョンの状態で参照できます。クラスター管理者は、この履歴の保持ポリシーを設定して、ストレージを細かく管理できます。通常、etcdはタイマーによってキーの古いリビジョンを破棄します。一般的なetcdクラスターは、更新によって古くなったキーのデータを数時間保持します。これにより、一時的なネットワーク障害だけでなく、クライアントの長時間の切断にも確実に対処できます。ウォッチャーは、最後に観測した過去のリビジョンから再開するだけです。同様に、特定の時点のストアを読み取るには、読み取りリクエストにリビジョンを指定すると、そのリビジョンがコミットされた時点のキー空間の状態からキーを返せます。
キー範囲
etcdのデータモデルは、平坦なバイナリーキー空間上のすべてのキーにインデックスを付けます。これは、キーをディレクトリにまとめる階層構造を使う他のキー・バリューストアとは異なります。キーはディレクトリ単位ではなく、キーの区間[a, b)で列挙します。
etcdでは、この区間を「範囲」と呼ぶことがよくあります。範囲に対する操作は、ディレクトリに対する操作より表現力があります。階層型ストアと同様に、[a, a+1)による単一キーの検索(例:[‘a’, ‘a\x00’)は’a’を検索)や、ディレクトリの深さに従ってキーをエンコードすることによるディレクトリ検索をサポートします。さらに、区間では接頭辞も表せます。たとえば、区間['a', 'b')は、文字列’a’を接頭辞に持つすべてのキーを検索します。
慣例として、リクエストの範囲はkeyとrange_endフィールドで表します。keyフィールドは範囲の最初のキーで、空にしないでください。range_endは、範囲の最後のキーの次のキーです。range_endが指定されていないか空の場合、範囲にはkey引数だけが含まれます。range_endがkeyに1を加えたもの(例:“aa”+1 == “ab”、“a\xff”+1 == “b”)の場合、その範囲はkeyを接頭辞に持つすべてのキーを表します。keyとrange_endの両方が’\0’の場合、その範囲はすべてのキーを表します。range_endが’\0’の場合、その範囲はkey引数以上のすべてのキーを表します。
Range
RangeRequestを受け取るRange API呼び出しで、キー・バリューストアからキーを取得します。
- Key, Range_End - 取得するキー範囲です。
- Limit - リクエストで返すキーの最大数です。limitを0に設定すると、上限なしとして扱います。
- Revision - 範囲の取得に使用するキー・バリューストアの時点です。revisionがゼロ以下の場合、最新のキー・バリューストアを対象とします。リビジョンがすでにコンパクションされている場合、レスポンスとしてErrCompactedを返します。
- Sort_Order - ソートするリクエストの順序です。
- Sort_Target - ソート対象のキー・バリューのフィールドです。
- Serializable - 範囲リクエストで、メンバーローカルの直列化可能読み取りを使用するように設定します。Rangeはデフォルトで線形化可能であり、クラスターの現在のコンセンサスを反映します。性能と可用性を高めるため、直列化可能な範囲リクエストは、古いデータを読み取る可能性と引き換えに、クラスター内の他のノードとのコンセンサスを必要とせず、ローカルに処理されます。
- Keys_Only - 値を返さず、キーだけを返します。
- Count_Only - 範囲内のキーの数だけを返します。
- Min_Mod_Revision - キーの変更リビジョンの下限です。それより小さい変更リビジョンを除外します。
- Max_Mod_Revision - キーの変更リビジョンの上限です。それより大きい変更リビジョンを除外します。
- Min_Create_Revision - キーの作成リビジョンの下限です。それより小さい作成リビジョンを除外します。
- Max_Create_Revision - キーの作成リビジョンの上限です。それより大きい作成リビジョンを除外します。
クライアントは、Range呼び出しからRangeResponseメッセージを受信します。
- Kvs - 範囲リクエストに一致するキー・バリューペアの一覧です。
Count_Onlyを設定すると、Kvsは空になります。 - More -
limitが設定されている場合、要求した範囲内に返すべきキーがまだあるかどうかを示します。 - Count - 範囲リクエストを満たすキーの総数です。
キー範囲が大きく、レスポンス全体をバッファーに保持したくない場合は、RangeStream を参照してください。
RangeStream
RangeStreamはRangeと同じ結果セットを返しますが、サーバーがレスポンスを一連のチャンクに分割し、クライアントへストリーミングします。これにより、サーバーとクライアントのどちらも、大きな範囲全体をメモリーに保持する必要がなくなります。RangeStreamは、Rangeと同じRangeRequestを受け付けます。
クライアントは、RangeStream呼び出しからRangeStreamResponseメッセージのストリームを受信します。
各チャンクのフィールドは、次のように設定されます。
- Kvs - 各チャンクは、結果の重複しない一部分を保持します。すべてのチャンクの
kvsを到着順に連結すると、1回のRange呼び出しと同じキー集合が得られます。 - Header, More, Count - ストリームがエラーなく完了した場合に限り、最後のチャンクにだけ設定されます。それより前のチャンクでは、これらのフィールドはゼロ値のままです。各チャンクの
range_responseにproto.Mergeを適用すると、Rangeが返すものと同等のRangeResponseが得られます。
ストリームがエラーで終了した場合、有効なheader、more、countを持つチャンクはありません。
ストリーム内のすべてのチャンクは、同じリビジョンを対象に処理されます。リクエストにRevisionが設定されていない場合、サーバーはストリームの開始時に最新のコミット済みリビジョンを取得し、残りのストリームでも同じリビジョンを使います。
RangeStreamは、独自のソート順序やリビジョンフィルター(min_mod_revision、max_mod_revision、min_create_revision、max_create_revision)をサポートしません。どちらかを使用したリクエストは、Unimplementedを返します。etcdのgRPCプロキシもRangeStreamをサポートしません。
RangeStreamを処理する一般的な方法は、次の2つです。
- 各チャンクを個別に処理する。 結果全体を集める前に、キーが届くたびにデコードして処理したい、高い性能が求められる場面に適しています。クライアントはチャンクを順に読み、各チャンクの
kvsを処理します。ストリームが正常に終了した後、最後のチャンクからheader、more、countを読み取ります。 - 単一のレスポンスにまとめる。 単項の
Rangeと同等の結果が必要な場合に適しています。クライアントは、各チャンクのrange_responseを、たとえばproto.Mergeで1つのRangeResponseにマージします。マージ後の結果には、すべてのkvsと、最後のチャンクのheader、more、countが含まれます。Goクライアントは、この処理を補助するclientv3.GetStreamToGetResponseを提供します。
Put
PutRequestを受け取るPut呼び出しで、キー・バリューストアにキーを保存します。
- Key - キー・バリューストアに格納するキーの名前です。
- Value - キー・バリューストア内のキーに関連付ける、バイト列の値です。
- Lease - キー・バリューストア内のキーに関連付けるリースIDです。leaseが0の場合、リースがないことを示します。
- Prev_Kv - 設定されている場合、この
Putリクエストによる更新前のキー・バリューペアのデータを返します。 - Ignore_Value - 設定されている場合、現在の値を変更せずにキーを更新します。キーが存在しない場合はエラーを返します。
- Ignore_Lease - 設定されている場合、現在のリースを変更せずにキーを更新します。キーが存在しない場合はエラーを返します。
クライアントは、Put呼び出しからPutResponseメッセージを受信します。
- Prev_Kv -
PutRequestでPrev_Kvを設定していた場合、Putによって上書きされたキー・バリューペアです。
範囲の削除
DeleteRangeRequestを受け取るDeleteRange呼び出しで、キーの範囲を削除します。
- Key, Range_End - 削除するキー範囲です。
- Prev_Kv - 設定されている場合、削除したキー・バリューペアの内容を返します。
クライアントは、DeleteRange呼び出しからDeleteRangeResponseメッセージを受信します。
- Deleted - 削除したキーの数です。
- Prev_Kv -
DeleteRange操作で削除したすべてのキー・バリューペアの一覧です。
トランザクション
トランザクションは、キー・バリューストア上のアトミックなIf/Then/Else構造です。リクエストをアトミックなブロック(then/else)にまとめ、キー・バリューストアの内容に基づいて実行条件(if)を設定するプリミティブを提供します。トランザクションは、意図しない並行更新からキーを保護すること、比較交換操作を構築すること、より高度な並行処理制御を開発することに使用できます。
トランザクションは、1つのリクエスト内で複数のリクエストをアトミックに処理できます。キー・バリューストアの変更では、そのトランザクションによってストアのリビジョンが増加するのは1回だけで、生成されるすべてのイベントが同じリビジョンを持つことを意味します。ただし、1つのトランザクション内で同じキーを複数回変更することは禁止されています。
すべてのトランザクションには、If文のように、複数の比較の論理積による実行条件があります。各比較は、ストア内の1つのキーを検査します。値の有無、指定した値との比較、キーのリビジョンやバージョンを確認できます。異なる2つの比較は、同じキーにも異なるキーにも適用できます。すべての比較はアトミックに適用されます。すべてがtrueの場合、トランザクションは成功とされ、etcdはthen / successリクエストブロックを適用します。それ以外は失敗とされ、else / failureリクエストブロックを適用します。
各比較は、Compareメッセージとしてエンコードされます。
- Result - 論理比較演算の種類です(等しい、より小さい、など)。
- Target - 比較するキー・バリューのフィールドです。キーのバージョン、作成リビジョン、変更リビジョン、値のいずれかです。
- Key - 比較対象のキーです。
- Target_Union - 比較のためにユーザーが指定するデータです。
比較ブロックを処理した後、トランザクションはリクエストのブロックを適用します。ブロックは、RequestOpメッセージのリストです。
- Request_Range -
RangeRequestです。 - Request_Put -
PutRequestです。キーは一意でなければなりません。他のPutsやDeletesとキーが重複してはいけません。 - Request_Delete_Range -
DeleteRangeRequestです。PutsやDeletesのリクエストとキーが重複してはいけません。
以上をまとめ、TxnRequestを受け取るTxn API呼び出しでトランザクションを発行します。
- Compare - トランザクションの実行条件となる、条件の論理積を表す述語のリストです。
- Success - すべての比較の評価結果がtrueの場合に処理するリクエストのリストです。
- Failure - いずれかの比較の評価結果がfalseの場合に処理するリクエストのリストです。
クライアントは、Txn呼び出しからTxnResponseメッセージを受信します。
- Succeeded -
Compareの評価結果がtrueかfalseかを示します。 - Responses - succeededがtrueの場合は
Successブロック、falseの場合はFailureを適用した結果に対応するレスポンスのリストです。
Responsesリストは、適用したRequestOpリストの結果に対応し、各レスポンスはResponseOpとしてエンコードされます。
内部の各レスポンスに含まれるResponseHeaderは、どのような用途でも解釈しないでください。
最新のリビジョンを取得する必要がある場合、クライアントは常にTxnResponseの最上位のResponseHeaderを確認してください。
Watch API
Watch APIは、キーの変更を非同期に監視する、イベントに基づくインターフェースを提供します。etcdの監視は、現在または過去の指定したリビジョンから継続的に監視してキーの変更を待ち、キーの更新をクライアントへストリーミングします。
イベント
すべてのキーの各変更は、Eventメッセージで表されます。Eventメッセージは、更新データと更新の種類を提供します。
- Type - イベントの種類です。PUTは、キーに新しいデータが保存されたことを示します。DELETEは、キーが削除されたことを示します。
- KV - イベントに関連付けられたKeyValueです。PUTイベントは現在のkvペアを含みます。kv.Version=1のPUTイベントは、キーが作成されたことを示します。DELETEイベントは、変更リビジョンが削除時のリビジョンに設定された、削除済みのキーを含みます。
- Prev_KV - イベント直前のリビジョンにおける、そのキーのキー・バリューペアです。帯域幅を節約するため、監視で明示的に有効にした場合にだけ設定されます。
監視ストリーム
監視は長時間継続するリクエストであり、gRPCストリームでイベントデータをストリーミングします。監視ストリームは双方向です。クライアントはストリームに書き込んで監視を設定し、ストリームから読み取って監視イベントを受信します。イベントに監視ごとの識別子を付けることで、1つの監視ストリームに多数の異なる監視を多重化できます。この多重化によって、中核のetcdクラスターのメモリー使用量と接続の負担を減らせます。
監視イベントに関する保証については、etcd APIの保証 を参照してください。
クライアントは、Watchが返したストリームでWatchCreateRequestを送信して、監視を作成します。
- Key, Range_End - 監視するキー範囲です。
- Start_Revision - 監視を開始するリビジョン(そのリビジョンを含む)で、省略可能です。指定しない場合、監視作成レスポンスのヘッダーにあるリビジョンの次からイベントをストリーミングします。最後のコンパクションリビジョンから、利用可能なイベント履歴全体を監視できます。
- Progress_Notify - 設定されている場合、最近のイベントがなければ、監視はイベントを含まないWatchResponseを定期的に受信します。これは、切断されたウォッチャーを、最近の既知のリビジョンから復旧したい場合に役立ちます。通知の送信頻度は、etcdサーバーが現在の負荷に基づいて決定します。
- Filters - サーバー側で除外するイベントの種類のリストです。
- Prev_Kv - 設定されている場合、監視はイベント発生前のキー・バリューデータを受信します。上書きされたデータの確認に役立ちます。
クライアントは、WatchCreateRequestへの応答として、または既存の監視で新しいイベントが発生した場合に、WatchResponseを受信します。
- Watch_ID - レスポンスに対応する監視のIDです。
- Created - 監視作成リクエストへのレスポンスである場合にtrueに設定されます。クライアントはIDを保存し、そのストリームで監視イベントを受信するようにしてください。作成したウォッチャーへ送信されるすべてのイベントは、同じwatch_idを持ちます。
- Canceled - 監視キャンセルリクエストへのレスポンスである場合にtrueに設定されます。キャンセルされたウォッチャーには、それ以降のイベントは送信されません。
- Compact_Revision - ウォッチャーがコンパクション済みリビジョンで監視しようとすると、etcdで利用可能な最小の過去のリビジョンに設定されます。これは、コンパクション済みリビジョンでウォッチャーを作成した場合や、ウォッチャーがキー・バリューストアの進行に追いつけない場合に発生します。ウォッチャーはキャンセルされます。同じstart_revisionで新しい監視を作成しても失敗します。
- Events - 指定した監視IDに対応する、新しいイベントを順に並べたリストです。
クライアントが監視イベントの受信を停止するには、WatchCancelRequestを発行します。
- Watch_ID - これ以上イベントを送信しないようキャンセルする監視のIDです。
Lease API
リースは、クライアントの生存を検出する仕組みです。クラスターは、生存時間付きのリースを付与します。指定したTTL期間内にetcdクラスターがkeepAliveを受信しなければ、リースは期限切れになります。
リースとキー・バリューストアを結び付けるため、各キーには最大1つのリースを関連付けられます。リースが期限切れになるか取り消されると、そのリースに関連付けられたすべてのキーが削除されます。期限切れになった各キーは、イベント履歴に削除イベントを生成します。
リースの取得
LeaseGrantRequestを受け取るLeaseGrant API呼び出しで、リースを取得します。
- TTL - 秒単位の希望する生存時間です。
- ID - リースに要求するIDです。IDを0に設定すると、etcdがIDを選択します。
クライアントは、LeaseGrant呼び出しからLeaseGrantResponseを受信します。
- ID - 付与されたリースのIDです。
- TTL - サーバーが選択した、秒単位のリースの生存時間です。
- ID - 取り消すリースのIDです。リースを取り消すと、関連付けられたすべてのキーが削除されます。
キープアライブ
リースは、LeaseKeepAlive API呼び出しで作成した双方向ストリームで更新します。クライアントがリースを更新するときは、ストリームでLeaseKeepAliveRequestを送信します。
- ID - 維持するリースのIDです。
キープアライブストリームは、LeaseKeepAliveResponseで応答します。
- ID - 新しいTTLで更新されたリースです。
- TTL - リースに残された、秒単位の新しい生存時間です。
12.6 - etcdの永続ストレージファイル
このドキュメントでは、etcdの永続ストレージの形式、つまり命名、内容、開発者が内容を調べるためのツールを説明します。今後、ストレージモデルの変更に合わせて内容を拡充することを想定しています。etcd開発者のデータリカバリーに役立つことを目的としています。
前提知識
次の記事は、このドキュメントを読むための背景知識として役立ちます。
- etcdのデータモデルの概要
- Raftの概要 (特に「5.3 ログの複製」のセクション)。
概要
長期間保持されるファイル
| ファイル名 | 主な用途 |
|---|---|
./member/snap/db |
bboltのb+treeです。適用済みのすべてのデータ、メンバーシップの認可情報、メタデータを保存します。最後に適用したWALログのインデックス("consistent_index")を把握しています。 |
./member/snap/0000000000000002-0000000000049425.snap ./member/snap/0000000000000002-0000000000061ace.snap |
定期的に作成する旧v2ストアのスナップショットで、次を含みます。
etcd v3以降、その内容は/snap/dbファイルの内容と重複しています。 |
/member/snap/000000000007a178.snap.db |
レプリカが大きく遅れた場合に、etcdリーダーからダウンロードする完全なbboltスナップショットです。 内容の種類は、 このファイルは、次の2つの場合に使用します。
このファイルは、リカバリーが完了しても削除されません(全内容が./member/snap/dbファイルに反映されます)。定期的(30s)にファイルを削除します。
ここでも、直近の |
./member/wal/000000000000000f-00000000000b38c7.wal ./member/wal/000000000000000e-00000000000a7fe3.wal ./member/wal/000000000000000d-000000000009c70c.wal |
Raftの先行書き込みログで、Raftが受け付けた最近のトランザクション、定期的なスナップショット、CRCレコードを含みます。 直近の スナップショットの作成頻度が低すぎると、 |
./member/wal/0.tmp (or .../1.tmp) |
次の先行書き込みログファイルのために事前に割り当てる領域です。 WALログの容量不足により、アラームを発報することもできずにRaftが停止するのを防ぎます。 |
一時ファイル
etcdの内部処理中には、短時間だけ存在する次のようなファイルが見られることがあります。
| ファイル | 主な用途 |
|---|---|
./member/snap/0000000000000002-000000000007a178.snap.broken |
スナップショットファイルを読み込めない場合、ファイル名を‘broken’に変更します。
最新のファイルの読み込みは、etcdの起動時に試みます。 または、etcdctlのbackup/migrateコマンド実行時にも行います。 |
./member/snap/tmp071677638 (random suffix) |
リーダーのmsgSnapリクエスト、つまり指定したスナップショットからストレージをリカバリーする要求に応じて、レプリカ上に作成する一時的なbboltファイルです。
内容の取得が正常に完了すると、ファイルをリネームし、 etcd/issues/12837を参照してください。etcd 3.5で修正されています。 |
/member/snap/db.tmp.071677638 (random suffix) |
デフラグメンテーション処理中に、バックエンドの内容(/member/snap/db)のコピーを保持する一時ファイルです。処理が正常に完了すると、/member/snap/dbにリネームし、元のバックエンドを置き換えます。 etcdサーバーの起動時に、これらのファイルを削除します。 |
bbolt b+tree: member/snap/db
このファイルは、Raftログの特定の時点まで適用された、etcdの主要な内容を保持します(consistent_index を参照)。
物理的な構成
bboltストレージは、物理的にはb+tree
として構成されます。b-treeの物理ページをその場で変更することはありません1。代わりに、空きページ一覧から回収した新しいページへ内容をコピーし、古いページにアクセスする可能性のある未終了のトランザクションがなくなった時点で、そのページを空きページ一覧に追加します。この処理により、未終了のROトランザクションは、一貫した過去のストレージ状態を参照できます。RWトランザクションは排他的であり、他のすべてのRWトランザクションをブロックします。
大きな値は、複数の連続したページに保存します。ページの回収処理と、異なる大きさの連続したページ領域を割り当てる必要性が組み合わさり、bboltストレージの断片化が進むことがあります。
bboltファイルが自動で縮小することはありません。デフラグメンテーション時にだけ、末尾に一定の空きページ領域を確保した、サイズを切り詰めた新しいファイルに書き換えられます。
論理的な構成
bboltストレージはバケットに分かれています。各バケットには、キー(byte[]->value byte[]のペア)を辞書順に保存します。以下は、etcd(バージョン3.5時点)で使用するバケットとキーの一覧です。
| バケット | キー | 値の例 | 説明 |
|---|---|---|---|
| alarm | rpcpb.Alarm:
{MemberID, Alarm: NONE|NOSPACE|CORRUPT}
|
nil |
いずれかのメンバーで問題が検出されたことを示します。 |
| auth | "authRevision" | ""(空)またはBigEndian.PutUint64 |
RolesまたはUsersを変更すると、トランザクションのコミット時にこのフィールドが増加します。 この値は、認可処理中の楽観的ロックにだけ使用します。 |
| authRoles | 文字列の[roleName] | authpb.Roleをマーシャリングした値 |
|
| authUsers | 文字列の[userName] | authpb.Userをマーシャリングした値 |
|
| cluster | "clusterVersion" | "3.5.0"(文字列) |
コンセンサスで合意した共通ストレージバージョンのマイナーバージョンです。 |
| "downgrade" | JSON: {
"target-version": "3.4.0"
"enabled": true/false
}
|
直近の v3.5以降 |
|
| key |
[revisionId]をbytesToRev{main,sub}でエンコードしたものです。 キー・バリューの削除は、末尾に't'を付けてマーシャリングします(「トゥームストーン」として)。 |
mvccpb.KeyValueをマーシャリングしたproto(key, create_rev, mod_rev, version, value, lease id) |
|
| lease | leasepb.Leaseをマーシャリングしたproto(ID, TTL, RemainingTTL) |
注意:LeaseCheckpointが延長するのはRemainingTTLだけです。TTLは元のGrantの値です。 注意2:TTLは、未定義の「現在」からの秒数として永続化します。クラッシュを繰り返すサーバーは、リースを解放しません!!! |
|
| members | [memberId]を16進数の文字列にしたもの:"8e9e05c52164694d" |
JSON文字列にシリアライズしたMember構造体:
{
  "id":10276657743932975437,
  "peerURLs":[
  "http://localhost:2380"],
  "name":"default",
  "clientURLs": ["http://localhost:2379"]
}
|
合意済みのクラスターのメンバーシップ情報です。 |
| members_removed | [memberId]を16進数の文字列にしたもの:"8e9e05c52164694d" |
[]byte("removed") |
削除されたすべてのメンバーのIDです。削除済みのメンバーが、同じIDで再び追加されないことを確認するために使います。 このフィールドは現在(3.4)、V2ストアから読み取り、V3からは読み取りません。https://github.com/etcd-io/etcd/pull/12820を参照してください。 |
| meta | "consistent_index" | uint64のバイト列(BigEndian) | bolt DBストレージに最後に適用したWALエントリーのオフセットを表します。 |
| "scheduledCompactRev" | bytesToRev{main,sub}でエンコードした値(16バイト) | コンパクションリクエストの後にクラッシュした場合に、コンパクションを再初期化するために使います。 | |
| "finishedCompactRev" | bytesToRev{main,sub}でエンコードした値(16バイト) | ストアで直近にコンパクションが正常に完了したリビジョン(https://github.com/etcd-io/etcd/blob/ae7862e8bc8007eb396099db4e0e04ac026c8df5/server/mvcc/kvstore_compaction.go#L54) | |
| "confState" | etcd 3.5以降 | ||
| "term" | etcd 3.5以降 | ||
| "storage-version" |
ツール
bbolt
bboltには、ファイルの内容を調べるためのコマンドラインツールがあります。
使用例:
指定したbboltファイルのすべてのバケットを列挙する
特定のキー・バリューペアを読み取る
etcd-dump-db
etcd-dump-dbは、etcd v3のバックエンド(bbolt)の内容を列挙するために使用できます。
その他の例は、https://github.com/etcd-io/etcd/tree/master/tools/etcd-dump-db を参照してください。
WAL:先行書き込みログ
先行書き込みログは、提案を保存するためのRaftの永続ストレージです。リーダーはまず自分のログに提案を保存し、その後、Raftプロトコルでフォロワーに並行して複製します。各フォロワーは、リーダーに複製の完了を応答する前に、自身のWALに提案を永続化します。
etcdで使用するWALログは、標準的なRaftモデルと次の2点で異なります。
- インデックス付きのエントリーだけでなく、Raftの軽量なスナップショットとhard-stateも永続化します。そのため、WALログだけで、そのメンバーのRaft状態全体をリカバリーできます。
- 追記専用です。エントリーをその場で上書きせず、ファイルに後から追記した同じインデックスのエントリーが、以前のエントリーを置き換えます。
ファイル名
WALログファイルは、次のパターンで命名します。
例:./member/wal/0000000000000010-00000000000bf1e6.wal
つまり、ファイル名には次の情報が16進数で含まれます。
- WALログファイルの連番
- ファイル内の最初のエントリーまたはスナップショットのインデックス 特に、最初のファイル“0000000000000000-0000000000000000.wal”には、index=0の初期スナップショットレコードが含まれます。
物理的な内容
WALログファイルは、一連の「フレーム 」を含みます。各フレームには、次のものが含まれます。
- マーシャリングしたwalpb.Record (3)の長さを格納する、LittleEndian 2でエンコードしたuint64。
- パディング:フレーム全体のサイズを整列(mod 8)させるための、必要な数の0バイト。
- マーシャリングしたwalpb.Record
のデータ:
- type - 下記のdataフィールドの解釈を決める、intでエンコードされた列挙値。
- data - typeによって異なり、通常はマーシャリングしたproto。
- crc - WALログの作成以降、このレプリカ上のすべてのログレコードの“data”フィールドを連結したもの(typeは含まない)のCRC-32チェックサム。CRCは、Raftでコミットされなかったものも含め、すべてのレコードを対象とすることに注意してください。
現在のファイルが64*10^6バイトを超えると、ファイルを「分割」し、新しいファイルを開始します。
論理的な内容
先行書き込みログファイルは、論理的には次を含みます。
Raftpb.Entry:Raftリーダーが複製した最近の提案です。一部は「コミット済み」と見なされ、残りは論理的に上書きされる可能性があります。Raftpb.HardState(term,commit,vote):「コミット済み」、つまり過半数のサーバーに複製されたログエントリーのインデックスに関する、定期的で非常に頻繁な情報です。このエントリーは、変更・上書きされないことが保証され、バックエンド(v2、v3)に適用できます。また、選挙に関する変更があったかを示す“term”と、現在の任期でこのレプリカが投票したメンバーを表すvoteも含みます。walpb.Snapshot(term, index):Raft状態の定期的なスナップショットです。DBの内容は含まず、スナップショットのログインデックスとRaftの任期だけを保持します。- V2ストアの内容は、別の*.storeファイルに保存します。
- V3ストアの内容はbboltファイルに保持し、エントリーが適用されると、その内容が暗黙のスナップショットになります。
- crc32チェックサムレコード(各ファイルの先頭)。ファイルの残りの部分のCRC検査を再開するために使用します。
etcdserverpb.Metadata(node_id, cluster_id)- ログが表すクラスターとレプリカを識別します。
各WALログファイルは、次の順序で構成されます。
-
CRC-32フレーム。それ以前のすべてのファイルからの累積crcで、最初のファイルでは0です。
-
Metadataフレーム(クラスターとレプリカのID)
-
最初のWALファイルの場合だけ:
- 空のSnapshotフレーム(Index:0, Term: 0)。 すべてのエントリーに「先行する」スナップショットがある、という不変条件を維持するためのフレームです。
最初以外のWALファイル(2番目以降)の場合:
- HardStateフレーム。
-
entry、hard-state、snapshotレコードの混在
WALログは、同じインデックスのエントリーを複数含むことがあります。これは、Raftの論文 の図7で説明される状況で発生します。etcdのWALログは追記専用なので、同じインデックスの新しいエントリーを追記することで、以前のエントリーを上書きします。
特に、WALの読み取り時には、古いエントリーを新しいエントリーで上書きする処理 が行われます。そのため、entry.index <= HardState.commitを満たすエントリーの最後のバージョンだけが確定済みと見なせます。index > HardState.commitのエントリーは変更される可能性があります。
WALログの“term”は、単調であることが想定されています。
WALログのインデックスには、次の性質が想定されています。
- いずれかのスナップショットから始まる。
- 同じ‘term’に属する間は、そのスナップショット以降、順に増加する。
- 任期が変わるとインデックスが減少することもあるが、新しい値は、最新のHardState.commitより大きい。
- index >= HardState.commitを満たす任意のインデックスで新しいスナップショットが作られることがあり、そこからインデックスの新しい列が始まる。
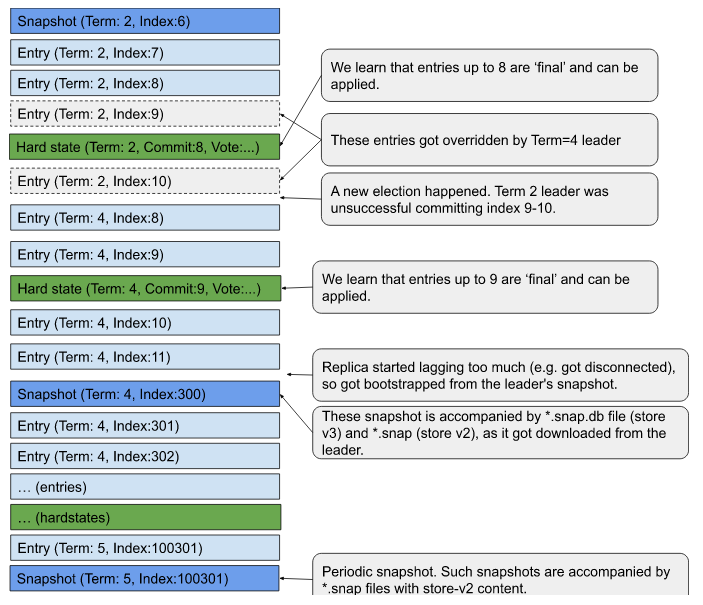
ツール
etcd-dump-logs
etcdのWALログは、etcd-dump-logs ツールで読み取れます。
次の点に注意してください。
- このツールが表示するのはEntriesだけです。WALログファイル内のすべてのレコード(Snapshots、HardStates)を表示するわけではありません。
- エントリーの「上書き」は自動的に適用されます。同じインデックスの新しいエントリーで上書きされた場合、このツールは最後の値だけを表示します。
- このツールは、ログ末尾の未コミットのエントリーも表示します。HardState.commitIndexの情報は表示しないため、エントリーが確定済みかどうかは分かりません。
ストアV2のスナップショット:member/snap/{term}-{index}.snap
ファイル名
member/snap/{term}-{index}.snap
ファイル名はここ
で、("%016x-%016x.snap") の形式で生成されます。16進数でエンコードした次の2つの要素を使います。
- term -> スナップショット出力時のRaftの任期(選挙間の期間)
- index -> スナップショット出力時に最後に適用した提案のインデックス
作成
*.snapファイルは、Snapshotter.SaveSnap メソッドによって作成されます。
このファイルの作成には、次の2つの契機があります。
- およそ–snapshot-count=(v3.7.0のデフォルトは10,000)件の提案を適用するたびに、新しいファイルを作成します。提案をバッチで受け取り、バッチの最後でのみスナップショットの作成を検討し、最終的な作成処理も非同期でスケジュールするため、件数は概数です。 –snapshot-countというフラグ名は、かなり誤解を招きやすいものです。制御するのは、最後のスナップショットのインデックスと、最後に適用した提案のインデックスとの差 だからです。
- Raftがレプリカに、スナップショットからのリストアを要求した場合です。レプリカはネットワークでスナップショット(msgSnapメッセージ)を受信すると、WALログにも軽量なチェックポイントとして記録します。これにより、WALログの末尾には、常に有効なスナップショットがあり、その後にエントリーが続くことが保証されます。これによって、WALログに連続性の欠落が生じるのを防ぎます。
現在、このファイルはWALログのSnapshotエントリーと、おおむね31-1で対応しています。v2ストアの廃止に伴い、ファイルの書き込みは完全に停止される見込みです(3.5.xでは任意、3.6.xでは必須)。
内容
ファイルは、マーシャリングしたsnapdb.snapshot proto
(uint32 crc, bytes data)を含みます。
その’data’フィールドには、Raftpb.Snapshot が格納されます。
(bytes data, SnapshotMetadata{index, term, conf } metadata),
最後に、入れ子になったdataには、JSONにシリアライズしたv2ストアの内容 が格納されます。
具体的には、次の内容を含みます。
- Term
- Index
- メンバーシップのデータ:
/0/members/8e9e05c52164694d/attributes -> {"name":"default","clientURLs":["http://localhost:2379"]}/0/members/8e9e05c52164694d/RaftAttributes -> "{"peerURLs":["http://localhost:2380"]}"
- ストレージのバージョン:/0/version-> 3.5.0
ツール
protoc
etcdのルートディレクトリで次のコマンドを実行すると、ファイルの内容を確認できます。
同様に、‘data’フィールドを取り出し、Raftpb.Snapshot としてデコードできます。
etcd 3.4の*.snapファイルにある、JSONにシリアライズしたv2ストアの内容の例
変更
このセクションは、etcdのバージョン間で導入されたファイル形式の変更を記載するために設けています。
12.7 - etcd APIの保証
etcdは、一貫性と耐久性を備えたキー・バリューストアです。 キー・バリューストアはgRPCサービス を通じて公開されます。 etcdは、分散システムで最も強い一貫性と耐久性の保証を提供します。 この仕様では、etcd APIが提供する保証を列挙します。
対象のAPI
KV APIは、キー・バリューストアの直接の読み取りと操作を提供します。 Watch APIは、キー・バリューストアの変更の購読を提供します。 Lease APIは、キーへの生存時間の割り当てを提供します。
KV APIとWatch APIのどちらでも、キーの最新バージョンだけでなく、 コンパクション操作によって制限される連続した履歴の範囲内で、 過去のバージョンにもアクセスできます。
KV APIの呼び出しは直ちに反映されますが、Watch APIの応答には上限のない遅延が生じます。 正常に動作するetcdクラスターでは、イベント発生から10ms程度の遅延で監視イベントが届くことを期待できます。 ただし、遅延に上限はなく、健全でないクラスターではイベントが届かないこともあります。
KV API
etcdは、すべてのKV API呼び出しに対し、耐久性と厳密な直列化可能性を保証します。 これは、分散トランザクションデータベースシステムにおける最も強い分離保証です。
耐久性
完了した操作にはすべて耐久性があります。アクセス可能なデータも、すべて永続化済みのデータです。 読み取りが、まだ永続化されていないデータを返すことはありません。
厳密な直列化可能性
KVサービスの操作はアトミックであり、操作の実時間の順序と整合する全順序で実行されます。 この全順序はリビジョン によって表されます。 詳細は厳密な直列化可能性 を参照してください。
入れ子のTXNを含まないトランザクションでは、操作の実行順序は 操作リストの順序と一致することが保証されるため、トランザクション内の GETレスポンスは安定しています。 入れ子のTXNを含むトランザクションでは、実行順序は規定されていません。
厳密な直列化可能性は、より理解しやすい、次の弱い保証も満たします。
原子性
すべてのAPIリクエストはアトミックです。操作は全体が完了するか、まったく実行されないかのいずれかです。 監視リクエストでは、1つの操作が生成するすべてのイベントが1つの監視レスポンスに含まれます。 監視が、単一の操作のイベントの一部だけを観測することはありません。
線形化可能性
クライアントの観点では、線形化可能性は動作を考えやすくする有用な性質を提供します。
元の論文
から、明快な説明を引用します。
線形化可能性は、並行するプロセスが適用する各操作が、 その呼び出しから応答までの間のある時点で、 瞬時に有効になるかのように見せます。
たとえば、クライアントが時点1(t1)で書き込みを完了したとします。 t2(t2 > t1)で読み取りを発行したクライアントは、少なくとも t1で完了した書き込みと同じか、それより新しい値を受け取るはずです。ただし、 読み取りが実際に完了するのはt3になる場合があります。線形化可能性は、 読み取りの開始時点t2から完了時点t3までの間のある時点で最新だった値を 返すことを保証します。読み取りの開始前に完了した書き込みはすべて反映されます。 t2とt3の間に発生した並行する書き込みは、反映される場合も、されない場合もあります。 返却値が、読み取りの完了時点で最新の値である必要はありません。
etcdは、その他のすべての操作について、デフォルトで線形化可能性を保証します。
ただし、線形化されたリクエストはRaftコンセンサス処理を経由する必要があるため、
線形化可能性にはコストが伴います。読み取りリクエストのレイテンシーを下げ、
スループットを高めるために、クライアントはリクエストの一貫性モードを
serializableに設定できます。このモードでは、クォーラムに対して古いデータに
アクセスする可能性がありますが、線形化されたアクセスがその都度のコンセンサスに
依存することによる性能上の負担をなくせます。
Watch API
監視は、イベントについて次のことを保証します。
- 順序性:イベントはリビジョン順に並びます。 すでに送信されたイベントより時間的に前のイベントが、後から監視に現れることはありません。 入れ子のTXNを含まないトランザクションでは、生成されるイベントの順序は 操作リストの順序と一致することが保証されます。 入れ子のTXNを含むトランザクションでは、生成されるイベントの順序は 規定されていません。
- 一意性:同じイベントが監視に2回現れることはありません。
- 信頼性:利用可能な履歴の範囲内で、イベント列の一部が欠落することはありません。 イベントが時間順にa < b < cと並んでいる場合、 監視がイベントaとcを受信したなら、bが利用可能な履歴の範囲内にある限り、 bも受信することが保証されます。
- 原子性:イベントのリストは、完全なリビジョンを含むことが保証されます。 同じリビジョンで行われた複数のキーの更新が、複数のイベントリストに 分割されることはありません。
- 再開可能性:切断前に監視イベントで最後に受信したリビジョンが履歴の範囲内にある限り、 そのリビジョンの次から新しい監視を開始することで、 切断された監視を再開できます。
- ブックマーク可能性:進捗通知イベントは、あるリビジョンまでのすべてのイベントが すでに配信済みであることを保証します。
etcdは、監視操作の線形化可能性を保証しません。他の操作との正しい順序を確保するため、 ユーザーは監視イベントのリビジョンを確認する必要があります。
Lease API
etcdはリースの仕組み を提供します。リースの主な用途は、 分散ロックなどの分散協調の仕組みを実装することです。 リース自体の仕組みは単純です。grant APIで作成し、put APIでキーに関連付け、 revoke APIで取り消すことができ、実時間の生存時間(TTL)が過ぎると期限切れになります。 ただし、正しい分散協調の仕組みを実装するには、 APIとその使用上の重要な性質 を理解しておく必要があります。
etcd固有の定義
操作の完了
etcdの操作は、コンセンサスを通じてコミットされ、etcdのストレージエンジンによって
「実行」、つまり永続的に保存された時点で完了と見なされます。
クライアントはetcdサーバーからレスポンスを受信することで、操作の完了を認識します。
タイムアウトした場合や、クライアントとetcdメンバーの間でネットワークが途絶した場合、
クライアントには操作の状態を判断できないことがあります。また、etcdはリーダー選挙が
発生すると操作を中止する場合があります。このとき、クライアントの未完了のリクエストに対して、
etcdはabortレスポンスを送信しません。
リビジョン
キー・バリューストアを変更するetcdの操作には、増加するリビジョンが1つ割り当てられます。 トランザクション操作はキー・バリューストアを複数回変更することがありますが、 割り当てられるリビジョンは1つだけです。操作によって変更されたキー・バリューペアの リビジョン属性は、その操作のリビジョンと同じ値を持ちます。 リビジョンは、キー・バリューストアの論理時計として使用できます。 リビジョンが大きいキー・バリューペアは、リビジョンが小さいキー・バリューペアより後に 変更されています。同じリビジョンを持つ2つのキー・バリューペアは、 1つの操作によって「同時に」変更されています。
12.8 - etcdと他のキー・バリューストアの比較
「etcd」という名前は、Unixの「/etc」フォルダーと、distributed systems(分散システム)の頭文字「d」に由来します。「/etc」フォルダーは単一システムの構成データを保存する場所ですが、etcdは大規模な分散システムの構成情報を保存します。つまり、分散した(distributed)「/etc」が「etcd」です。
etcdは、大規模な分散システムの汎用的な基盤として設計されています。対象となるのは、スプリットブレインでの動作を決して許容せず、そのためには可用性を犠牲にすることもいとわないシステムです。etcdは、一貫性と耐障害性を保ってメタデータを保存します。etcdクラスターは、最高水準の安定性、信頼性、拡張性、性能を備えたキー・バリューストレージの提供を目指しています。
分散システムは、構成管理、サービス検出、分散処理の調整のために、一貫性のあるキー・バリューストアとしてetcdを使用します。多くの組織 が、コンテナースケジューラー、サービス検出サービス、分散データストレージなどの本番システムをetcdで実装しています。etcdを使う代表的な分散処理のパターンには、リーダー選出 、分散ロック 、マシンの生存監視があります。
ユースケース
- Container Linux by CoreOS:Container Linux 上のアプリケーションでは、Linuxカーネルが無停止で自動更新されます。Container Linuxは、更新の調整にlocksmith を使用します。Locksmithはetcd上に分散セマフォを実装し、どの時点でも再起動するのがクラスターの一部だけになるようにします。
- Kubernetes は、サービス検出とクラスター管理のために構成データをetcdに保存します。etcdの一貫性は、サービスを正しくスケジュールし、動作させるために不可欠です。Kubernetes APIサーバーは、クラスターの状態をetcdに永続化します。また、etcdのwatch APIでクラスターを監視し、重要な構成変更を展開します。
比較表
etcdが適しているように見えても、他の技術的な判断と同じく、慎重に検討してください。このドキュメントはetcdチームが執筆しています。技術と機能を公平に比較することが理想ですが、著者の専門知識や考え方は当然etcd寄りです。その点を踏まえて利用してください。
以下の表は、etcdと主な代替製品の違いを一目で確認するための早見表です。各列の補足や詳細は、表の後のセクションで説明します。
| etcd | ZooKeeper | Consul | NewSQL (Cloud Spanner, CockroachDB, TiDB) | |
|---|---|---|---|---|
| 並行処理のプリミティブ | GoのLock RPC 、Election RPC 、コマンドラインのロック 、コマンドラインの選挙 、レシピ | Javaの外部ライブラリーcuratorのレシピ | 組み込みのロックAPI | 存在してもまれ |
| 線形化可能読み取り | 対応 | 非対応 | 対応 | 製品による |
| 多版型同時実行制御 | 対応 | 非対応 | 非対応 | 製品による |
| トランザクション | フィールド比較、読み取り、書き込み | バージョン検査、書き込み | フィールド比較、ロック、読み取り、書き込み | SQL形式 |
| 変更通知 | 過去と現在のキー区間 | 現在のキーとディレクトリ | 現在のキーと接頭辞 | トリガー(一部) |
| ユーザー権限 | ロールベース | ACL | ACL | 製品による(テーブル単位のGRANT 、データベース単位のロール ) |
| HTTP/JSON API | 対応 | 非対応 | 対応 | まれ |
| メンバーシップの再構成 | 対応 | >3.5.0 | 対応 | 対応 |
| 信頼性を保てるデータベースの最大サイズ | 数GB | 数百MB(場合によっては数GB) | 数百MB | TB以上 |
| 読み取りを線形化する最小レイテンシー | ネットワークRTT | 読み取りの線形化なし | RTT + fsync | クロックバリア(原子時計、NTP) |
ZooKeeper
ZooKeeperは、分散システムの調整とメタデータの保存という、etcdと同じ問題を解決します。ただし、etcdはZooKeeperの設計と実装に関する開発・運用経験を、後発として生かせます。ZooKeeperから得られた教訓はetcdの設計に確実に反映され、Kubernetesのような大規模システムのサポートに役立っています。etcdがZooKeeperに対して改善した点には、次のものがあります。
- クラスターのメンバーシップの動的な再構成
- 高負荷下での安定した読み書き
- 多版型同時実行制御のデータモデル
- 通知せずにイベントを取りこぼすことのない、信頼できるキーの監視
- 接続とセッションを切り離すリースのプリミティブ
- 安全な分散共有ロックのAPI
さらに、etcdは多くの言語とフレームワークを標準でサポートしています。ZooKeeperは独自のJute RPCプロトコルを使用し、サポートする言語バインディング
が制限されます。一方、etcdのクライアントプロトコルは、Go、C++、Javaなどの言語バインディングを持つ、広く使われているRPCフレームワークgRPC
に基づいています。また、gRPCはHTTP上のJSONにシリアライズできるため、curlのような汎用コマンドラインツールでも通信できます。多様な選択肢から選べるため、単一の固定された技術群でetcdの周辺を固めるのではなく、それぞれの環境に合ったツールを使ってetcd上にシステムを構築できます。
機能、サポート、安定性を考えると、一貫性のあるキー・バリューストアとしてZooKeeperを採用する予定の新しいアプリケーションは、代わりにetcdを選ぶのがよいでしょう。
Consul
Consulは、サービス検出を一通り提供するフレームワークです。ヘルスチェック、障害検出、DNSサービスを内蔵しています。また、RESTfulなHTTP APIを持つキー・バリューストアも公開しています。Consul 1.0の時点では 、キー・バリュー操作におけるストレージシステムの拡張性は、etcdやZooKeeperなどに及びません。数百万のキーを必要とするシステムでは、大きなレイテンシーやメモリーへの負荷に悩まされます。キー・バリューAPIには、特に、複数バージョンのキー、条件付きトランザクション、信頼できるストリーミング監視が欠けています。
etcdとConsulは、異なる問題を解決します。分散した一貫性のあるキー・バリューストアが必要なら、Consulよりetcdが適しています。クラスターのサービス検出を一通り揃えたい場合、etcdの機能だけでは足りません。Kubernetes、Consul、SmartStackを選んでください。
NewSQL (Cloud Spanner, CockroachDB, TiDB)
etcdとNewSQLデータベース(Cockroach 、TiDB 、Google Spanner など)は、いずれも高可用性と強いデータ一貫性の保証を提供します。ただし、システム設計の前提が大きく異なるため、クライアントAPIと性能の特性も大きく異なります。
NewSQLデータベースは、データセンターをまたいで水平に拡張することを目的としています。通常、データを、離れた場所にあることもある複数の一貫性を持つ複製グループ(シャード)に分割し、TB以上の規模のデータセットを保存します。このような拡張方式は、クロックを待つことによる長いレイテンシーがあり、更新の依存関係グラフがおおむね局所的であることを想定するため、分散協調にはあまり適しません。データはテーブルに整理され、etcdより豊かな意味論を持つSQL形式のクエリー機能を備えますが、その分、クエリーの処理、計画、最適化は複雑になります。
メタデータの保存や分散アプリケーションの調整には、etcdを選んでください。数GBを超えるデータを保存する場合や、完全なSQLクエリーが必要な場合は、NewSQLデータベースを選んでください。
メタデータにetcdを使う
etcdは、単一の一貫性を持つ複製グループ内ですべてのデータを複製します。一貫した順序を保ちながら数GBまでのデータを保存するには、これが最も効率的な方式です。クラスターの状態の各変更には、単調増加するカウンターから、etcdでリビジョンと呼ぶ、グローバルに一意のIDが割り当てられます。これによって変更の順序を判断できます。1つの変更が複数のキーを変えることもあります。複製グループが1つだけなので、変更リクエストはコミットのためにRaftプロトコルを経由するだけで済みます。コンセンサスの対象を1つの複製グループに限定することで、etcdは単純なプロトコルで分散した一貫性を実現しながら、低レイテンシーと高スループットを達成します。
etcdの複製方式は、データのシャーディングがないため、水平には拡張できません。対して、NewSQLデータベースは通常、複数の一貫性を持つ複製グループにデータを分割し、TB以上の規模のデータセットを保存します。ただし、各変更にグローバルに一意で増加するIDを割り当てるには、各リクエストが複製グループ間の追加の調整プロトコルを経由する必要があります。この追加の調整段階では、グローバルIDで競合が起こり、順序を付けるリクエストが再試行を迫られる可能性があります。その結果、方式は複雑になり、厳密な順序付けでは、通常etcdより性能が低下します。
プロセスの調整など、主にメタデータやその順序を扱うアプリケーションにはetcdを選んでください。複数のデータセンターにまたがる大きなデータストアが必要で、強いグローバルな順序の性質にあまり依存しない場合は、NewSQLデータベースを選んでください。
分散協調にetcdを使う
etcdは、イベントの監視、リース、選挙、分散共有ロックなどの分散協調のプリミティブを標準で提供します。ただし、分散共有ロックには分かりにくい性質があるため、使用時には注意が必要です。詳細は後述します。これらのプリミティブは、etcd開発者が保守し、サポートしています。このようなプリミティブを外部ライブラリーに任せるのは、分散ソフトウェアの基盤を開発する責任を放棄し、実質的にシステムを未完成のままにすることです。NewSQLデータベースは通常、こうした分散協調のプリミティブを第三者が作成することを想定しています。同様に、ZooKeeperにも、協調処理のレシピを集めた独立した別のライブラリー があることはよく知られています。組み込みのロックAPIを提供するConsulでさえ、「確実な方法ではない 」と断っています。
理論上は、強い一貫性を持つ任意のストレージシステムの上に、これらのプリミティブを構築できます。しかし、アルゴリズムには微妙な点が多く、一見動いているロックアルゴリズムが、要求の一斉集中やタイミングのずれによって突然破綻することも珍しくありません。さらに、トランザクショナルメモリーなど、etcdがサポートする他のプリミティブは、etcdのMVCCデータモデルに依存しています。単に強い一貫性があるだけでは不十分です。
分散協調にetcdを選ぶことは、運用上の悩みを防ぎ、開発の労力を減らすことにつながります。
ロックとリースの使用上の注意
etcdは、リースの仕組み とそのetcdでの実装 に基づくロックAPI を提供します。リースの基本的な考え方は、サーバーが要求元のクライアントに、リースと呼ぶトークンを付与するというものです。サーバーは付与時にTTLをリースに関連付けます。TTLを超える時間の経過を検出すると、サーバーはリースを取り消します。クライアントは、取り消されていないリースを保持している間、そのリースに関連付けられたリソースへのアクセス権を所有していると主張できます。etcdの場合、そのリソースはetcdのキー空間内のキーです。etcdは、この方式でロックAPIを提供します。ただし、ロックAPIだけを相互排他の仕組みとして使うことはできません。ロックという名前は、歴史的な理由 によるものです。一方、以下で説明するように、ロックAPIは相互排他を最適化する仕組みとして使用できます。
リースの仕組みで最も重要なのは、TTLが物理的な時間間隔として定義されることです。サーバーもクライアントも、自身の時計で時間の経過を測ります。そのため、サーバーはリースを取り消しているのに、クライアントはまだ所有していると主張する状況が起こり得ます。
では、リースの仕組みは、ロックの相互排他をどのように保証するのでしょうか。実際には、リース自体は相互排他を保証しません。リースを所有していても、その所有者がリソースのロックを保持しているとは保証できません。
etcd自身のキーへの相互アクセスをetcdのロックで制御する場合、相互排他はバージョン番号の検証によって実装されます。これは、Consulなどの他のシステムでcompare and swapと呼ばれることもあります。PutやTxnなどのetcdのRPCでは、操作に必要なリビジョン番号やリースIDの条件を指定できます。条件が満たされなければ、操作は失敗することがあります。この仕組みによって、etcdはクライアントに分散ロックを提供します。つまり、クライアントは自身のリクエストがetcdクラスターで正常に完了したとき、キーのロックを取得していることを認識します。
分散ロックに関する文献にも、同様の設計が記載されています。
- Chubbyの論文 では、sequencerという概念が導入されています。ここでは、sequencerはetcdのリビジョン番号とリースIDの組み合わせにほぼ相当すると解釈しています。
- 分散ロックの実装方法 では、Martin Kleppmannがfencing tokenという考え方を紹介しています。著者らは、etcdではリビジョン番号がfencing tokenに相当すると解釈しています。
- 分散システムにおける同期時計の実用的な使用法 には、Thorがバージョン番号の検証とリースに基づく分散ロック機構を実装しているという説明があります。
etcdや他のシステムは、バージョン番号の検証で相互排他を実現するのに、なぜリースを提供するのでしょうか。リースは、中止されるリクエストの数を減らすための最適化機構を提供するからです。
etcdのキーは、リースとバージョン番号の検証によって効率的にロックできます。ただし、etcdと関係のないリソースを保護するには、そのリソース側にも、etcdのキーのようなバージョン番号の検証と、レプリカ間の一貫性の仕組みが必要です。etcdのロック機能だけでは、外部リソースを保護できません。
12.9 - 用語集
このドキュメントでは、etcdのドキュメント、コマンドライン、ソースコードで使う各種用語を定義します。
アラーム
クラスターの信頼性を維持するために運用担当者の介入が必要になると、etcdサーバーはアラームを発報します。
認証
認証は、etcdリソースに対するユーザーのアクセス権限を管理します。
クライアント
クライアントはetcdクラスターに接続し、キー・バリューペアの取得、データの書き込み、更新の監視などのサービスリクエストを発行します。
クラスター
クラスターは複数のメンバーで構成されます。
各メンバーのノードは、Raftコンセンサスプロトコルに従ってログを複製します。クラスターはメンバーから提案を受け取り、コミットしてローカルストアに適用します。
コンパクション
コンパクションは、指定したリビジョンより前のetcdのイベント履歴と、更新によって古くなったキーをすべて破棄します。etcdのバックエンドデータベースのストレージ領域を回収するために使用します。
選挙
etcdクラスターは、Raftコンセンサスプロトコルの一環として、メンバー間でリーダーを選出する選挙を行います。
エンドポイント
etcdのサービスまたはリソースを指すURLです。
キー
ユーザーが定義した値をetcdに保存し、取得するための、ユーザー定義の識別子です。
キー範囲
単一のキー、a <= x < bを満たすすべてのxからなる辞書順の区間、または指定したキーより大きいすべてのキーを含む集合です。
キー空間
etcdクラスター内のすべてのキーの集合です。
リース
更新可能な短期の契約です。有効期限が切れると、関連付けられたキーが削除されます。
メンバー
etcdクラスターのサービス提供に参加する論理的なetcdサーバーです。
変更リビジョン
指定したキーに対する最後の書き込みを含む最初のリビジョンです。
ピア
ピアは、同じクラスターに属する別のメンバーです。
提案
提案は、Raftプロトコルを経由する必要があるリクエスト(書き込みリクエストや構成変更リクエストなど)です。
クォーラム
クラスターの状態を変更するためのコンセンサスに必要な、稼働中のメンバー数です。etcdでは、クォーラムに達するためにメンバーの過半数が必要です。
リビジョン
1から始まり、キー空間が変更されるたびに増加する、クラスター全体の64ビットカウンターです。
ロール
キー範囲の集合に対する権限の単位です。アクセス制御のために、ユーザーの集合に付与できます。
スナップショット
ある時点のetcdクラスターの状態を保存したバックアップです。
ストア
クラスターのキー空間を支える物理ストレージです。
任期
任期は、Raftアルゴリズムの各リーダー選挙に関連付けられた、単調増加する整数です。 1つの任期で選出されるリーダーは1つだけで、リーダーが変わると任期が増加します。
トランザクション
アトミックに実行される操作の集合です。トランザクション内で変更されたすべてのキーは、同じ変更リビジョンを持ちます。
キーのバージョン
キーの作成以降に行われた書き込みの回数で、1から始まります。存在しないキーや削除されたキーのバージョンは0です。
ウォッチャー
クライアントはウォッチャーを開き、指定したキー範囲の更新を監視します。
13 - 開発者ガイド
13.1 - 検出サービスのプロトコル
このページでは、etcd 3.7で削除された旧v2ディスカバリープロトコルを説明しています。新しいv3.7環境のデプロイには、v3ディスカバリープロトコル を使用してください。
検出サービスのプロトコルは、共有の検出URLを使い、クラスターの初期構築時に新しいetcdメンバーが他のすべてのメンバーを検出するためのものです。
検出サービスのプロトコルは、クラスターの初期構築時にのみ使用します。実行時の再構成やクラスターの監視には使用できません。
このプロトコルは、新しい検出トークンを使って、一意のetcdクラスターを1つ初期構築します。1つの検出トークンが表せるetcdクラスターは1つだけです。そのトークンで検出プロトコルを開始した後は、途中で失敗した場合でも、別のetcdクラスターの初期構築に再利用してはいけません。
以降では、自前でホストする検出クラスターの例を使って、検出の流れを説明します。公開検出サービスのdiscovery.etcd.ioも同じ仕組みで動作しますが、複雑なURLを隠し、UUIDを自動生成し、過剰なリクエストをある程度防ぐための層が追加されています。公開検出サービスも、内部ではこのドキュメントで説明するようにetcdクラスターをデータストアとして使用しています。
プロトコルの処理の流れ
検出プロトコルは、内部のetcdクラスターを使って、新しいクラスターの初期構築を調整します。まず、すべての新しいメンバーが検出サービスとやり取りして、予定されたメンバーの一覧を作成します。次に、各新規メンバーはこの一覧を使ってサーバーを初期構築します。これは-initial-clusterフラグと同じ役割を果たします。
以下の処理例では、理解しやすいように、プロトコルの各手順をcurl形式で示します。
慣例として、etcdの検出プロトコルはキーの接頭辞_etcd/registryを使用します。http://example.comで検出サービス用のetcdクラスターをホストしている場合、検出キー空間の完全なURLはhttp://example.com/v2/keys/_etcd/registryです。この例では、これをURLの接頭辞として使用します。
新しい検出トークンの作成
新しいクラスターを識別する一意のトークンを生成します。以降の手順では、検出キー空間内の一意の接頭辞として使用します。uuidgenを使うと簡単に生成できます。
予定するクラスターサイズの指定
検出トークンには、予定するクラスターサイズを指定する必要があります。検出サービスはこのサイズを使い、クラスターを初期構成するすべてのメンバーが見つかったかどうかを判断します。
クラスターサイズは通常、3、5、7のいずれかです。詳細は最適なクラスターサイズ を参照してください。
etcdプロセスの起動
検出URLを-discoveryフラグに指定して、etcdプロセスを起動します。-discoveryフラグが指定された各etcdプロセスは、内部で以下の手順を実行します。
自身の登録
etcdプロセスは最初に、検出URLに自身をメンバーとして登録します。検出URL内にメンバーIDをキーとして作成することで登録します。
状態の確認
検出URLから予定されたクラスターサイズと登録状態を確認し、次の動作を決めます。
登録済みのメンバーがまだ足りなければ、残りのメンバーが現れるのを待ちます。
登録済みのメンバー数が予定サイズNを超える場合、最初に登録されたN個のメンバーを、そのクラスターのメンバー一覧として扱います。自分自身が一覧に含まれていれば検出は成功し、その一覧からすべてのピアを取得します。一覧に含まれていなければ、クラスターが満員であるというエラーで検出処理を終了します。
etcdの実装では、自身を登録する前にメンバーがクラスターの状態を確認することもあります。そのため、クラスターがすでに満員の場合、速やかに失敗できます。
すべてのメンバーを待機
待機処理の詳細は、etcd APIドキュメント を参照してください。
すべてのメンバーが見つかるまで待機を続けます。
公開検出サービス
CoreOS Inc.は、https://discovery.etcd.io/ で公開検出サービスをホストしています。このサービスは、使いやすさのためにいくつかの便利な機能を提供します。
キーの接頭辞の隠蔽
公開検出サービスは、https://discovery.etcd.io/${UUID}を、背後のetcdクラスターの/v2/keys/_etcd/registryにあるキーへリダイレクトします。登録キーの接頭辞を隠すことで、短く読みやすい検出URLを提供します。
新しいトークンの取得
サービス内の生成処理は、新しい検出トークンの作成 から予定するクラスターサイズの指定 までの手順に従います。
検出状態の確認
UUIDの値を要求することで、登録済みのマシンを含む、その検出トークンの状態を確認できます。
オープンソースリポジトリ
リポジトリは https://github.com/coreos/discovery.etcd.io にあります。独自の検出サービスを構築するために使用できます。
13.2 - ローカルクラスターの構築
テストや開発用にデプロイする場合、最も手早く簡単なのはローカルクラスターの構成です。本番環境へのデプロイについては、クラスター構成 のセクションを参照してください。
ローカルの単独クラスター
クラスターの起動
etcdを単独クラスターとしてデプロイするには、次を実行します。
現在の作業ディレクトリにetcdバイナリーがない場合、$GOPATH/bin/etcdまたは/usr/local/bin/etcdにある可能性があります。その場所に合わせてコマンドを実行してください。
起動したetcdメンバーは、localhost:2379でクライアントリクエストを待ち受けます。
クラスターの操作
etcdctlで実行中のクラスターを操作します。
-
例としてキー・バリューペアをクラスターに保存します。
OKと表示されれば、キー・バリューペアの保存は成功です。
-
fooの値を取得します。barが返れば、etcdクラスターとのやり取りは正常に動作しています。
ローカルの複数メンバークラスター
クラスターの起動
etcdのGitリポジトリのルートには、ローカルで複数メンバーのクラスターを簡単に構成するためのProcfileがあります。複数メンバーのクラスターを起動するには、etcdのソースツリーのルートに移動して、次の操作を行います。
-
Procfileに基づくアプリケーションを制御するため、
goremanをインストールします。 -
etcdに付属するProcfileを使い、
goremanでクラスターを起動します。メンバーが起動し、それぞれ
localhost:2379、localhost:22379、localhost:32379でクライアントリクエストを待ち受けます。
クラスターの操作
etcdctlで実行中のクラスターを操作します。
-
メンバーの一覧を表示します。
etcdメンバーの一覧が次のように表示されます。
-
例としてキー・バリューペアをクラスターに保存します。
OKと表示されれば、キー・バリューペアの保存は成功です。
耐障害性のテスト
etcdの耐障害性を試すため、メンバーを停止してからキーを取得します。
-
停止するメンバーのプロセス名を確認します。
Procfileには、複数メンバーのクラスターのプロパティが記載されています。ここでは、プロセス名がetcd2のメンバーを例にします。 -
メンバーを停止します。
-
キーを保存します。
-
前の手順で保存したキーを取得します。
-
停止したメンバーからキーを取得します。
このコマンドでは、接続失敗によるエラーが表示されるはずです。
-
停止したメンバーを再起動します。
-
再起動したメンバーからキーを取得します。
メンバーを再起動すると接続が再確立され、
etcdctlでキーを正常に取得できるようになります。etcdの操作について詳しくは、etcdの操作 のセクションを参照してください。
13.3 - etcdの操作
ユーザーは主に、キーの値を書き込んだり取得したりしてetcdを操作します。このセクションでは、etcdサーバーを操作するコマンドラインツールetcdctlを使う方法を説明します。ここで説明する概念は、gRPC APIやクライアントライブラリーのAPIにも当てはまるはずです。
etcdctl v3.7はv3 APIを使用します。v2 APIとETCDCTL_APIによるバージョン選択は削除されています。
以下の例には過去のコマンド出力が含まれるため、表示されるバージョン番号はインストールしたものと異なる場合があります。以前のetcdリリースではv2とv3のキーを別々のストアで保持していました。v3.7へアップグレードする前に、既存のv2データを移行してください。
バージョンの確認
etcdctlのバージョンとサーバーAPIのバージョンを確認すると、etcdの各種操作に適したコマンドを見つけるのに役立ちます。
バージョンを確認するコマンドは、次のとおりです。
キーへの書き込み
アプリケーションはキーに書き込むことで、etcdクラスターにキーを保存します。保存された各キーは、一貫性と信頼性を確保するため、Raftプロトコルによってetcdクラスターのすべてのメンバーに複製されます。
キーfooの値をbarに設定するコマンドは、次のとおりです。
リースを関連付けると、キーを指定した時間だけ有効にすることもできます。
キーfoo1の値を10sの間bar1に設定するコマンドは、次のとおりです。
上のコマンドのリースID1234abcdは、10sのリースを作成したときに返されるIDです。このIDをキーに関連付けます。
キーの読み取り
アプリケーションは、etcdクラスターからキーの値を読み取れます。クエリーは、単一のキーまたはキーの範囲を読み取ることができます。
etcdクラスターに、次のキーが保存されているとします。
キーfooの値を読み取るコマンドは、次のとおりです。
キーfooの値を16進数形式で読み取るコマンドは、次のとおりです。
キーfooの値だけを読み取るコマンドは、次のとおりです。
fooからfoo3までの範囲のキーを取得するコマンドは、次のとおりです。
範囲はfoo3を含まない半開区間[foo, foo3)なので、foo3は除外されます。
fooを接頭辞に持つすべてのキーを取得するコマンドは、次のとおりです。
fooを接頭辞に持つすべてのキーを対象とし、結果を2件までに制限するコマンドは、次のとおりです。
RangeStream
RPCを使って、fooを接頭辞に持つすべてのキーを取得するコマンドは、次のとおりです。結果は単項のRangeと同じです。
--streamは、--order、--sort-by、リビジョンフィルターをサポートしません。
キーの過去のバージョンの読み取り
アプリケーションは、更新によって古くなったキーのバージョンを読み取りたい場合があります。たとえば、キーの以前のバージョンにアクセスして、古い構成に戻したい場合です。また、キーの履歴にアクセスすることで、複数のリクエストを通じて複数のキーを一貫した状態で読み取りたい場合もあります。 etcdクラスターのキー・バリューストアを変更するたびに、クラスター全体のリビジョンが増加するため、古いetcdリビジョンを指定すれば、過去のキーを読み取れます。
etcdクラスターに、次のキーがすでに存在するとします。
キーの過去のバージョンにアクセスする例は、次のとおりです。
指定したキーのバイト値以上のキーの読み取り
アプリケーションは、指定したキーのバイト値以上のキーを読み取りたい場合があります。
etcdクラスターに、次のキーがすでに存在するとします。
キーbのバイト値以上のキーを読み取るコマンドは、次のとおりです。
キーの削除
アプリケーションは、etcdクラスターから単一のキーまたはキーの範囲を削除できます。
etcdクラスターに、次のキーがすでに存在するとします。
キーfooを削除するコマンドは、次のとおりです。
fooからfoo9までの範囲のキーを削除するコマンドは、次のとおりです。
キーzooを削除し、削除したキー・バリューペアを返すコマンドは、次のとおりです。
zooを接頭辞に持つキーを削除するコマンドは、次のとおりです。
キーbのバイト値以上のキーを削除するコマンドは、次のとおりです。
キーの変更の監視
アプリケーションは、単一のキーまたはキーの範囲を監視して、更新を検知できます。
キーfooを監視するコマンドは、次のとおりです。
キーfooを16進数形式で監視するコマンドは、次のとおりです。
fooからfoo9までの範囲のキーを監視するコマンドは、次のとおりです。
fooを接頭辞に持つキーを監視するコマンドは、次のとおりです。
複数のキーfooとzooを監視するコマンドは、次のとおりです。
キーの過去の変更の監視
アプリケーションは、etcd内のキーの過去の変更を監視したい場合があります。たとえば、あるキーのすべての変更を受け取りたい場合、etcdへの接続を維持していればwatchで十分です。しかし、アプリケーションやetcdに障害が起きると、その間に変更が発生しても、アプリケーションは更新をリアルタイムで受信できません。更新の配信を保証するには、アプリケーションがキーの過去の変更を監視できる必要があります。そのためには、キーの過去のバージョンを読み取るときと同様に、監視に過去のリビジョンを指定します。
次の一連の操作を終えたとします。
過去の変更を監視する例は、次のとおりです。
過去の最後の変更からだけ監視する例は、次のとおりです。
監視の進捗
アプリケーションは、監視ストリームがどの程度最新の状態に追いついているかを判断するために、監視の進捗を確認したい場合があります。たとえば、監視でキャッシュを更新する場合、クォーラム読み取りで得たリビジョンと比べてキャッシュが古いかどうかを把握すると役立ちます。
対話型の監視セッションで"progress"コマンドを使用すると、進捗リクエストを発行し、監視ストリームで進捗通知を送るようetcdサーバーに要求できます。
進捗通知レスポンスのリビジョン番号は、監視ストリームが接続しているローカルのetcdサーバーノードのリビジョンです。このノードがネットワーク分断によってクォーラムから外れている場合、進捗通知のリビジョンは、分断されていないetcdサーバーノードへのクォーラム読み取りで返されるリビジョンより小さいことがあります。
コンパクション済みリビジョン
すでに説明したとおり、etcdはリビジョンを保持し、アプリケーションがキーの過去のバージョンを読み取れるようにします。ただし、履歴が無制限に蓄積するのを防ぐには、過去のリビジョンのコンパクションが重要です。コンパクション後、etcdは過去のリビジョンを削除し、今後の使用のためにリソースを解放します。コンパクションしたリビジョンより前の、更新によって古くなったデータはすべて利用できなくなります。
リビジョンをコンパクションするコマンドは、次のとおりです。
etcdサーバーの現在のリビジョンは、任意のキー(存在するキーでも、存在しないキーでも)に対してgetコマンドを実行し、json形式で取得できます。以下は、etcdサーバーに存在しないmykeyの例です。
リースの付与
アプリケーションは、etcdクラスターからキー用のリースを取得できます。キーをリースに関連付けると、その有効期間はリースの有効期間に結び付けられます。リースの有効期間は生存時間(TTL)によって決まります。各リースには、アプリケーションが付与時に指定する最小TTLがあります。実際のTTLは最小TTL以上で、etcdクラスターが選択します。リースのTTLが経過すると、リースは期限切れになり、関連付けられたすべてのキーが削除されます。
リースを付与するコマンドは、次のとおりです。
リースの取り消し
アプリケーションは、リースIDを指定してリースを取り消します。リースを取り消すと、関連付けられたすべてのキーが削除されます。
次の一連の操作を終えたとします。
このリースを取り消すコマンドは、次のとおりです。
リースの維持
アプリケーションは、TTLを更新することでリースの期限切れを防ぎ、維持できます。
次の一連の操作を終えたとします。
このリースを維持するコマンドは、次のとおりです。
リース情報の取得
アプリケーションは、リースを更新するため、またはリースがまだ存在するか、期限切れになったかを確認するために、リース情報を取得したい場合があります。また、特定のリースに関連付けられているキーを確認したい場合もあります。
次の一連の操作を終えたとします。
リース情報を取得するコマンドは、次のとおりです。
リースに関連付けられたキーとともにリース情報を取得するコマンドは、次のとおりです。
13.4 - gRPCゲートウェイを使う理由
etcd v3は、メッセージングプロトコルにgRPC を使用します。etcdプロジェクトは、gRPCでetcdクラスターと通信するための、gRPCベースのGoクライアント とコマンドラインユーティリティーetcdctl を提供しています。gRPCをサポートしない言語向けには、JSONのgRPCゲートウェイ を提供しています。このゲートウェイはRESTfulなプロキシとして動作し、HTTP/JSONリクエストをgRPCメッセージに変換します。
gRPCゲートウェイの使用
ゲートウェイは、etcdのProtocol Buffers
メッセージ定義のJSONマッピング
を受け付けます。keyとvalueフィールドはバイト配列として定義されているため、JSONではbase64でエンコードする必要があります。以下の例ではcurlを使いますが、どのHTTP/JSONクライアントでも同様に動作するはずです。
注意事項
gRPCゲートウェイのエンドポイントは、etcd v3.3以降で変更されています。
- etcd v3.2以前は、
[CLIENT-URL]/v3alpha/*だけを使用します。 - etcd v3.3は、
[CLIENT-URL]/v3alpha/*を維持しつつ、[CLIENT-URL]/v3beta/*を使用します。 - etcd v3.4は、
[CLIENT-URL]/v3beta/*を維持しつつ、[CLIENT-URL]/v3/*を使用します。[CLIENT-URL]/v3alpha/*は非推奨です。
- etcd v3.5以降は、
[CLIENT-URL]/v3/*だけを使用します。[CLIENT-URL]/v3beta/*は非推奨です。
gRPC-gatewayは、TLSのCommon Nameを使った認証をサポートしていません。
キーの書き込みと取得
/v3/kv/rangeと/v3/kv/putサービスで、キーを読み書きします。
キーの監視
/v3/watchサービスで、キーを監視します。
トランザクション
/v3/kv/txnで、トランザクションを発行します。
認証
/v3/authサービスで、認証を設定します。
/v3/auth/authenticateでetcdの認証を行い、認証トークンを取得します。
認証情報を使ってキーを取得するには、Authorizationヘッダーに認証トークンを設定します。
エラーレスポンス
gRPCゲートウェイは、gRPCのステータスをHTTPステータスコードとJSONのエラー本文に変換します。
etcd v3.6以降は、grpc-gateway v2へのアップグレードによってエラー処理が変わりました
(v2移行ガイドのエラー処理に関する注意事項
を参照)。
現在のゲートウェイの動作は、GoogleのAPIエラーモデル
で説明されている
google.rpc.Status(code、message、details)に沿っています。
以前のgrpc-gatewayにはトップレベルのerrorフィールドも含まれていましたが、
etcd v3.6以降では、このフィールドはサポートされていません。
クライアントは、HTTPステータスコードを成功・失敗の主な判断材料として扱ってください。
リクエストが失敗した場合は、messageフィールドをエラー情報の主な情報源とし、
追加の詳細情報から、さらに詳しい状況を読み取ることを推奨します。
Swagger
生成されたSwagger API定義は、rpc.swagger.json にあります。
13.5 - gRPCの名前解決と検出
etcdは、etcdからエンドポイントを取得してgRPCサービスを検出する代替の名前システムを、gRPCリゾルバーで提供します。その仕組みは、サービス名を接頭辞に持つキーの更新の監視に基づいています。
この機能は、grpc-goでまだ実験的なgoogle.golang.org/grpc/resolver パッケージに依存しているため、実験的機能です。
go-grpcでetcdの検出機能を使う
etcdクライアントは、etcdをバックエンドとしてgRPCエンドポイントを解決するgRPCリゾルバーを提供します。リゾルバーはetcdクライアントで初期化します。
サービスエンドポイントの管理
etcdリゾルバーは、解決対象に"/“を付けた接頭辞(例:“foo/bar/my-service/")の下にあるすべてのキーのうち、
JSONでエンコードされた値(従来はgo-grpcのnaming.Update)を持つものを、サービスエンドポイントの候補として扱います。
新しいキーを作成するとエンドポイントがサービスに追加され、キーを削除するとサービスから削除されます。
エンドポイントの追加
etcdctlで新しいエンドポイントをサービスに追加できます。
etcdクライアントのendpoints.Managerメソッドでも、Addrに対応するキーを使って新しいエンドポイントを登録できます。
複数のエンドポイントを持つサービスへの接続時にラウンドロビン負荷分散を有効にするには、grpc内蔵の ラウンドロビンロードバランサーを使用するように接続を設定します。
エンドポイントの削除
etcdctlでホストをサービスから削除できます。
etcdクライアントのendpoints.Managerメソッドでも、エンドポイントを削除できます。
リース付きのエンドポイント登録
リース付きでエンドポイントを登録すると、ホストがキープアライブのハートビートを維持できなくなった場合(マシンの故障など)に、そのホストがサービスから確実に削除されます。
Goでは、次のように記述します。
エンドポイントのアトミックな更新
1つのトランザクションで複数のエンドポイントを変更するには、endpoints.Managerを直接使用できます。
13.6 - Goアプリケーションへのetcdの組み込み
embedを使用して、アプリケーション内でetcdサーバーを実行するetcdのGoパッケージembedを使用すると、etcdサーバーをアプリケーションに直接、簡単に組み込めます。
詳細はembedパッケージのドキュメント を参照してください。
13.7 - システムの制限
リクエストサイズの上限
etcdは、メタデータで一般的な小さなキー・バリューペアを処理するように設計されています。大きなリクエストも処理できますが、他のリクエストのレイテンシーが増加する可能性があります。デフォルトでは、各リクエストの最大サイズは1.5 MiBです。この上限は、etcdサーバーの--max-request-bytesフラグで設定できます。
ストレージサイズの上限
ストレージサイズのデフォルトの上限は2 GiBで、--quota-backend-bytesフラグで設定できます。通常の環境で推奨される最大サイズは8 GiBです。設定値がこのサイズを超えると、etcdは起動時に警告を出します。
13.8 - etcdの機能
このドキュメントでは、etcdの機能と、それに関連する非推奨化の手続きを理解できるよう、機能の概要を説明します。etcdで機能を開発する方法については、開発ガイドライン を参照してください。
etcdの機能には、「実験的」「安定」「安全でない」の3つの段階があります。etcd --helpを実行すると、機能の一覧を確認できます。
実験的
早期にフィードバックを得るため、新機能は通常、実験的機能として追加されます。実験的機能はフラグ名で識別でき、その名前には--experimentalという接頭辞が付くはずです。実験的機能を使うときは、次の点を考慮してください。
- ユーザーによるテストが不足しているため、バグが残っている可能性があります。有効にしても、期待どおりに動作しない場合があります。
- デフォルトでは無効です。
- 予告なく、いつでもサポートが打ち切られる可能性があります。
- 安定した機能に昇格しない限り、機能の非推奨化 ポリシーに従わず、次のマイナーリリースまたはメジャーリリースで削除されることがあります。
- プロジェクトチームは、実験的機能に関する問題の報告を歓迎します。ただし、安定した機能の問題より優先順位が低くなる場合があります。
- 実験的機能が安定した段階に昇格すると、その機能フラグは非推奨になります 。できるだけ早く、安定した機能のフラグに切り替えてください。
安定
etcdの機能で最も一般的な段階です。安定した機能には、次の特徴があります。
- サポート対象のetcdリリースの一部としてサポートされます。
- デフォルトで有効になっている場合があります。
- サポートを終了する際は、機能の非推奨化 ポリシーに従う必要があります。
安全でない
安全でない機能は少数で、etcdの使用法ドキュメントのUnsafe feature:セクションに記載されています。デフォルトでは無効です。ドキュメントに従い、慎重に使用してください。安全でない機能は、機能の非推奨化ポリシーに従わず、次のマイナーリリースまたはメジャーリリースで削除されることがあります。
機能の非推奨化
実験的
実験的機能は、安定した段階に昇格すると非推奨になります。
- 実験的機能のドキュメントには、関連する安定した機能のフラグを使うよう推奨する非推奨メッセージが表示されます。例:
DEPRECATED. Use <feature-name> instead. - 非推奨になった機能は、次のリリースで削除されます。
安定
プロジェクトの発展に伴い、安定した機能を非推奨にして削除する必要が生じることがあります。その場合は、次のように対応します。
- 非推奨化を予定しているリリースの前に、機能のドキュメントに警告メッセージを表示します。例:
To be deprecated in <release>.。To be deprecatedとされた機能を置き換える新機能がすでに計画されている場合は、その旨もドキュメントに記載します。例:Use <feature-name> instead.。 - 予定されたリリースで機能を非推奨にします。この時点で、機能のドキュメントには、関連する安定した機能を使うよう推奨する非推奨メッセージが表示されます。例:
DEPRECATED. Use <feature-name> instead. - 非推奨になった機能は、次のリリースで削除されます。
13.9 - APIリファレンス
このAPIリファレンスは、各見出しに記載した.protoファイルから自動生成されています。
サービス Auth (api/etcdserverpb/rpc.proto)
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| AuthEnable | AuthEnableRequest | AuthEnableResponse | AuthEnableは認証を有効にします。 |
| AuthDisable | AuthDisableRequest | AuthDisableResponse | AuthDisableは認証を無効にします。 |
| AuthStatus | AuthStatusRequest | AuthStatusResponse | AuthStatusは認証の状態を表示します。 |
| Authenticate | AuthenticateRequest | AuthenticateResponse | Authenticateは認証リクエストを処理します。 |
| UserAdd | AuthUserAddRequest | AuthUserAddResponse | UserAddは新しいユーザーを追加します。ユーザー名は空にできません。 |
| UserGet | AuthUserGetRequest | AuthUserGetResponse | UserGetはユーザーの詳細情報を取得します。 |
| UserList | AuthUserListRequest | AuthUserListResponse | UserListはすべてのユーザーの一覧を取得します。 |
| UserDelete | AuthUserDeleteRequest | AuthUserDeleteResponse | UserDeleteは指定したユーザーを削除します。 |
| UserChangePassword | AuthUserChangePasswordRequest | AuthUserChangePasswordResponse | UserChangePasswordは指定したユーザーのパスワードを変更します。 |
| UserGrantRole | AuthUserGrantRoleRequest | AuthUserGrantRoleResponse | UserGrantRoleは指定したユーザーにロールを付与します。 |
| UserRevokeRole | AuthUserRevokeRoleRequest | AuthUserRevokeRoleResponse | UserRevokeRoleは指定したユーザーからロールを取り消します。 |
| RoleAdd | AuthRoleAddRequest | AuthRoleAddResponse | RoleAddは新しいロールを追加します。ロール名は空にできません。 |
| RoleGet | AuthRoleGetRequest | AuthRoleGetResponse | RoleGetはロールの詳細情報を取得します。 |
| RoleList | AuthRoleListRequest | AuthRoleListResponse | RoleListはすべてのロールの一覧を取得します。 |
| RoleDelete | AuthRoleDeleteRequest | AuthRoleDeleteResponse | RoleDeleteは指定したロールを削除します。 |
| RoleGrantPermission | AuthRoleGrantPermissionRequest | AuthRoleGrantPermissionResponse | RoleGrantPermissionは、指定したキーまたは範囲に対する権限を、指定したロールに付与します。 |
| RoleRevokePermission | AuthRoleRevokePermissionRequest | AuthRoleRevokePermissionResponse | RoleRevokePermissionは、指定したロールからキーまたは範囲に対する権限を取り消します。 |
サービス Cluster (api/etcdserverpb/rpc.proto)
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| MemberAdd | MemberAddRequest | MemberAddResponse | MemberAddはクラスターにメンバーを追加します。 |
| MemberRemove | MemberRemoveRequest | MemberRemoveResponse | MemberRemoveはクラスターから既存のメンバーを削除します。 |
| MemberUpdate | MemberUpdateRequest | MemberUpdateResponse | MemberUpdateはメンバーの構成を更新します。 |
| MemberList | MemberListRequest | MemberListResponse | MemberListはクラスター内のすべてのメンバーを一覧表示します。 |
| MemberPromote | MemberPromoteRequest | MemberPromoteResponse | MemberPromoteは、Raftの学習者メンバー(投票権なし)を、Raftの投票メンバーに昇格させます。 |
サービス KV (api/etcdserverpb/rpc.proto)
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| Range | RangeRequest | RangeResponse | Rangeはキー・バリューストアから範囲内のキーを取得します。 |
| Put | PutRequest | PutResponse | Putは指定したキーをキー・バリューストアに格納します。putリクエストはキー・バリューストアのリビジョンを増加させ、イベント履歴に1つのイベントを生成します。 |
| DeleteRange | DeleteRangeRequest | DeleteRangeResponse | DeleteRangeはキー・バリューストアから指定した範囲を削除します。deleteリクエストはキー・バリューストアのリビジョンを増加させ、削除したキーごとにイベント履歴に削除イベントを生成します。 |
| Txn | TxnRequest | TxnResponse | Txnは1つのトランザクション内で複数のリクエストを処理します。txnリクエストはキー・バリューストアのリビジョンを増加させ、完了したリクエストごとに、同じリビジョンを持つイベントを生成します。1つのtxn内で同じキーを複数回変更することはできません。 |
| Compact | CompactionRequest | CompactionResponse | Compactは、etcdキー・バリューストアのイベント履歴をコンパクションします。キー・バリューストアは定期的にコンパクションすることを推奨します。そうしないと、イベント履歴は無制限に増え続けます。 |
サービス Lease (api/etcdserverpb/rpc.proto)
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| LeaseGrant | LeaseGrantRequest | LeaseGrantResponse | LeaseGrantは、指定した生存時間内にサーバーがkeepAliveを受信しないと期限切れになるリースを作成します。リースが期限切れになると、それに関連付けられたすべてのキーも期限切れになり、削除されます。期限切れになった各キーは、イベント履歴に削除イベントを生成します。 |
| LeaseRevoke | LeaseRevokeRequest | LeaseRevokeResponse | LeaseRevokeはリースを取り消します。リースに関連付けられたすべてのキーは期限切れになり、削除されます。 |
| LeaseKeepAlive | LeaseKeepAliveRequest | LeaseKeepAliveResponse | LeaseKeepAliveは、クライアントからサーバーへキープアライブリクエストをストリーミングし、サーバーからクライアントへキープアライブレスポンスをストリーミングすることで、リースを維持します。 |
| LeaseTimeToLive | LeaseTimeToLiveRequest | LeaseTimeToLiveResponse | LeaseTimeToLiveはリース情報を取得します。 |
| LeaseLeases | LeaseLeasesRequest | LeaseLeasesResponse | LeaseLeasesは既存のすべてのリースを一覧表示します。 |
サービス Maintenance (api/etcdserverpb/rpc.proto)
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| Alarm | AlarmRequest | AlarmResponse | Alarmは、クラスターの健全性に関するアラームの有効化、解除、照会を行います。 |
| Status | StatusRequest | StatusResponse | Statusはメンバーの状態を取得します。 |
| Defragment | DefragmentRequest | DefragmentResponse | Defragmentは、メンバーのバックエンドデータベースをデフラグメンテーションして、ストレージ領域を回収します。 |
| Hash | HashRequest | HashResponse | Hashは、ストレージ内のkey、lease、その他のバケットを含む、バックエンドのキー空間全体のハッシュを計算します。これはテスト専用です!Hash操作はMVCCロックを保持しないため、トランザクションが進行している本番環境では、この操作に依存しないでください。“key"バケットの整合性チェックには、代わりに"HashKV” APIを使用してください。 |
| HashKV | HashKVRequest | HashKVResponse | HashKVは、指定したリビジョンまでのすべてのMVCCキーのハッシュを計算します。バックエンドストレージの"key"バケットだけを走査します。 |
| Snapshot | SnapshotRequest | SnapshotResponse | Snapshotは、バックエンド全体のスナップショットを、メンバーからクライアントへストリームで送信します。 |
| MoveLeader | MoveLeaderRequest | MoveLeaderResponse | MoveLeaderは、現在のリーダーノードに対し、移譲先へリーダーシップを移すよう要求します。 |
| Downgrade | DowngradeRequest | DowngradeResponse | Downgradeは、クラスターのバージョンのダウングレードの要求、実行可能性の検証、またはダウングレードの取り消しを行います。etcd 3.5以降でサポートされています。 |
サービス Watch (api/etcdserverpb/rpc.proto)
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| Watch | WatchRequest | WatchResponse | Watchは、現在または過去に発生したイベントを監視します。入力と出力はどちらもストリームです。入力ストリームはウォッチャーの作成とキャンセルに使用し、出力ストリームはイベントを送信します。1つのwatch RPCで複数のキー範囲を監視し、複数の監視のイベントを同時にストリーミングできます。最後のコンパクションリビジョン以降のイベント履歴全体を監視できます。 |
メッセージ AlarmMember (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| memberID | memberIDは、発報されたアラームに関連付けられたメンバーのIDです。 | uint64 |
| alarm | alarmは、発報されたアラームの種類です。 | AlarmType |
メッセージ AlarmRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | actionは、発行するアラームリクエストの種類です。アクションには、アラーム状態のGET、アラームのACTIVATE、発報済みアラームのDEACTIVATEがあります。 | AlarmAction |
| memberID | memberIDは、アラームに関連付けられたメンバーのIDです。memberIDが0の場合、アラームリクエストはすべてのメンバーを対象とします。 | uint64 |
| alarm | alarmは、このリクエストで対象とするアラームの種類です。 | AlarmType |
メッセージ AlarmResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| alarms | alarmsは、アラームリクエストに関連付けられたアラームの一覧です。 | (slice of) AlarmMember |
メッセージ AuthDisableRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ AuthDisableResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthEnableRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ AuthEnableResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthRoleAddRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | nameは、認証システムに追加するロールの名前です。 | string |
メッセージ AuthRoleAddResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthRoleDeleteRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
メッセージ AuthRoleDeleteResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthRoleGetRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string |
メッセージ AuthRoleGetResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| header | ResponseHeader | |
| perm | (slice of) authpb.Permission |
メッセージ AuthRoleGrantPermissionRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | nameは、権限を付与するロールの名前です。 | string |
| perm | permは、ロールに付与する権限です。 | authpb.Permission |
メッセージ AuthRoleGrantPermissionResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthRoleListRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ AuthRoleListResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (slice of) string |
メッセージ AuthRoleRevokePermissionRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| role | string | |
| key | bytes | |
| range_end | bytes |
メッセージ AuthRoleRevokePermissionResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthStatusRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ AuthStatusResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| enabled | bool | |
| authRevision | authRevisionは、認証ストアの現在のリビジョンです。 | uint64 |
メッセージ AuthUserAddRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string | |
| options | authpb.UserAddOptions | |
| hashedPassword | string |
メッセージ AuthUserAddResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthUserChangePasswordRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | nameは、パスワードを変更するユーザーの名前です。 | string |
| password | passwordは、ユーザーの新しいパスワードです。このフィールドはAPIレイヤーで削除されることに注意してください。 | string |
| hashedPassword | hashedPasswordは、ユーザーの新しいパスワードのハッシュ値です。このフィールドはAPIレイヤーで初期化されることに注意してください。 | string |
メッセージ AuthUserChangePasswordResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthUserDeleteRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | nameは、削除するユーザーの名前です。 | string |
メッセージ AuthUserDeleteResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthUserGetRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string |
メッセージ AuthUserGetResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| roles | (slice of) string |
メッセージ AuthUserGrantRoleRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| user | userは、指定したロールを付与するユーザーの名前です。 | string |
| role | roleは、ユーザーに付与するロールの名前です。 | string |
メッセージ AuthUserGrantRoleResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthUserListRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ AuthUserListResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| users | (slice of) string |
メッセージ AuthUserRevokeRoleRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| role | string |
メッセージ AuthUserRevokeRoleResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ AuthenticateRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| name | string | |
| password | string |
メッセージ AuthenticateResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| token | tokenは、後続のRPCで使用できる認可済みトークンです。 | string |
メッセージ CompactionRequest (api/etcdserverpb/rpc.proto)
CompactionRequestは、指定したリビジョンまでのキー・バリューストアをコンパクションします。コンパクションリビジョンより小さいリビジョンを持つ、更新によって古くなったキーはすべて削除されます。
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | revisionは、コンパクション操作の対象となるキー・バリューストアのリビジョンです。 | int64 |
| physical | physicalを設定すると、RPCはコンパクションがローカルデータベースに物理的に適用され、対象のエントリーがバックエンドデータベースから完全に削除されるまで待機します。 | bool |
メッセージ CompactionResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ Compare (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| result | resultは、この比較で使用する論理比較演算です。 | CompareResult |
| target | targetは、比較のために調べるキー・バリューのフィールドです。 | CompareTarget |
| key | keyは、比較操作の対象となるキーです。 | bytes |
| target_union | oneof | |
| version | versionは、指定したキーのバージョンです。 | int64 |
| create_revision | create_revisionは、指定したキーの作成リビジョンです。 | int64 |
| mod_revision | mod_revisionは、指定したキーの最終変更リビジョンです。 | int64 |
| value | valueは、指定したキーの値をバイト列で表したものです。 | bytes |
| lease | leaseは、指定したキーのリースIDです。 | int64 |
| range_end | range_endは、指定したtargetを範囲[key, range_end)内のすべてのキーと比較します。キー範囲の詳細はRangeRequestを参照してください。 | bytes |
メッセージ DefragmentRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ DefragmentResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ DeleteRangeRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | keyは、範囲内で削除する最初のキーです。 | bytes |
| range_end | range_endは、範囲[key, range_end)内で削除する最後のキーの次のキーです。range_endが指定されていない場合、範囲にはkey引数だけが含まれます。range_endが指定したキーに1を加えた値の場合、範囲にはそのキーを接頭辞に持つすべてのキーが含まれます。range_endが’\0’の場合、範囲にはkey引数以上のすべてのキーが含まれます。 | bytes |
| prev_kv | prev_kvが設定されている場合、etcdは削除前のキー・バリューペアを取得します。削除前のキー・バリューペアはdeleteレスポンスで返されます。 | bool |
メッセージ DeleteRangeResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| deleted | deletedは、範囲削除リクエストによって削除されたキーの数です。 | int64 |
| prev_kvs | リクエストにprev_kvが設定されている場合、削除前のキー・バリューペアが返されます。 | (slice of) mvccpb.KeyValue |
メッセージ DowngradeInfo (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| enabled | enabledは、クラスターのダウングレードが有効になっているかどうかを示します。 | bool |
| targetVersion | targetVersionは、ダウングレード先のバージョンです。 | string |
メッセージ DowngradeRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| action | actionは、発行するダウングレードリクエストの種類です。アクションには、対象バージョンのVALIDATE、クラスターバージョンのDOWNGRADE、現在のダウングレードジョブのCANCELがあります。 | DowngradeAction |
| version | versionは、ダウングレード先のバージョンです。 | string |
メッセージ DowngradeResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | versionは、クラスターの現在のバージョンです。 | string |
メッセージ DowngradeVersionTestRequest (api/etcdserverpb/rpc.proto)
DowngradeVersionTestRequestは、テスト専用です。このリクエストのversionは、WALレコードのバージョンとして読み取られます。ダウングレード先のバージョンがこのバージョンより小さい場合、オンラインのダウングレードやオフラインの移行は安全ではないため、許可すべきではありません。
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ver | string |
メッセージ HashKVRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| revision | revisionは、ハッシュ操作の対象となるキー・バリューストアのリビジョンです。 | int64 |
メッセージ HashKVResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hashは、応答するメンバーのMVCCキーから、指定したリビジョンまでを対象として計算したハッシュ値です。 | uint32 |
| compact_revision | compact_revisionは、ハッシュ計算の開始時点でコンパクションされていたキー・バリューストアのリビジョンです。 | int64 |
| hash_revision | hash_revisionは、ハッシュ計算の対象とする上限のリビジョンです。 | int64 |
メッセージ HashRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ HashResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| hash | hashは、応答するメンバーのKVバックエンドから計算したハッシュ値です。 | uint32 |
メッセージ LeaseCheckpoint (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、チェックポイントを作成するリースのIDです。 | int64 |
| remaining_TTL | Remaining_TTLは、リースの有効期限までの残り時間です。 | int64 |
メッセージ LeaseCheckpointRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| checkpoints | (slice of) LeaseCheckpoint |
メッセージ LeaseCheckpointResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ LeaseGrantRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| TTL | TTLは、秒単位の希望する生存時間です。期限切れのリースでは-1が返されます。 | int64 |
| ID | IDは、リースに要求するIDです。IDが0の場合、リースの貸し手がIDを選択します。 | int64 |
メッセージ LeaseGrantResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | IDは、付与されたリースのIDです。 | int64 |
| TTL | TTLは、サーバーが選択した、秒単位のリースの生存時間です。 | int64 |
| error | string |
メッセージ LeaseKeepAliveRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、維持するリースのIDです。 | int64 |
メッセージ LeaseKeepAliveResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | IDは、キープアライブリクエストのリースIDです。 | int64 |
| TTL | TTLは、リースの新しい生存時間です。 | int64 |
メッセージ LeaseLeasesRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ LeaseLeasesResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| leases | (slice of) LeaseStatus |
メッセージ LeaseRevokeRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、取り消すリースのIDです。そのIDが取り消されると、関連付けられたすべてのキーが削除されます。 | int64 |
メッセージ LeaseRevokeResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ LeaseStatus (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | int64 |
メッセージ LeaseTimeToLiveRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、そのリースのIDです。 | int64 |
| keys | keysをtrueにすると、このリースに関連付けられたすべてのキーを照会します。 | bool |
メッセージ LeaseTimeToLiveResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| ID | IDは、キープアライブリクエストのリースIDです。 | int64 |
| TTL | TTLは、秒単位のリースの残りTTLです。リースはTTL+1秒未満で期限切れになります。 | int64 |
| grantedTTL | GrantedTTLは、リースの作成時または更新時に最初に付与された、秒単位の時間です。 | int64 |
| keys | Keysは、このリースに関連付けられたキーの一覧です。 | (slice of) bytes |
メッセージ Member (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、このメンバーのメンバーIDです。 | uint64 |
| name | nameは、人が読めるメンバー名です。メンバーが起動していない場合、名前は空文字列になります。 | string |
| peerURLs | peerURLsは、クラスターとの通信用にメンバーが公開するURLの一覧です。 | (slice of) string |
| clientURLs | clientURLsは、クライアントとの通信用にメンバーが公開するURLの一覧です。メンバーが起動していない場合、clientURLsは空になります。 | (slice of) string |
| isLearner | isLearnerは、そのメンバーがRaftの学習者メンバーかどうかを示します。 | bool |
メッセージ MemberAddRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| peerURLs | peerURLsは、追加するメンバーがクラスターとの通信に使用するURLの一覧です。 | (slice of) string |
| isLearner | isLearnerは、追加するメンバーがRaftの学習者メンバーかどうかを示します。 | bool |
メッセージ MemberAddResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| member | memberは、追加したメンバーの情報です。 | Member |
| members | membersは、新しいメンバーを追加した後の、すべてのメンバーの一覧です。 | (slice of) Member |
メッセージ MemberListRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| linearizable | bool |
メッセージ MemberListResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | membersは、クラスターに関連付けられたすべてのメンバーの一覧です。 | (slice of) Member |
メッセージ MemberPromoteRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、昇格させるメンバーのメンバーIDです。 | uint64 |
メッセージ MemberPromoteResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | membersは、メンバーを昇格させた後の、すべてのメンバーの一覧です。 | (slice of) Member |
メッセージ MemberRemoveRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、削除するメンバーのメンバーIDです。 | uint64 |
メッセージ MemberRemoveResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | membersは、メンバーを削除した後の、すべてのメンバーの一覧です。 | (slice of) Member |
メッセージ MemberUpdateRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| ID | IDは、更新するメンバーのメンバーIDです。 | uint64 |
| peerURLs | peerURLsは、メンバーがクラスターとの通信に使用する、新しいURLの一覧です。 | (slice of) string |
メッセージ MemberUpdateResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| members | membersは、メンバーを更新した後の、すべてのメンバーの一覧です。 | (slice of) Member |
メッセージ MoveLeaderRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| targetID | targetIDは、新しいリーダーのノードIDです。 | uint64 |
メッセージ MoveLeaderResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader |
メッセージ PutRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | keyは、キー・バリューストアに格納するキーをバイト列で表したものです。 | bytes |
| value | valueは、キー・バリューストア内のキーに関連付ける値をバイト列で表したものです。 | bytes |
| lease | leaseは、キー・バリューストア内のキーに関連付けるリースIDです。leaseが0の場合、リースがないことを示します。 | int64 |
| prev_kv | prev_kvが設定されている場合、etcdは変更前のキー・バリューペアを取得します。変更前のキー・バリューペアはputレスポンスで返されます。 | bool |
| ignore_value | ignore_valueが設定されている場合、etcdは現在の値を使ってキーを更新します。キーが存在しない場合はエラーを返します。 | bool |
| ignore_lease | ignore_leaseが設定されている場合、etcdは現在のリースを使ってキーを更新します。キーが存在しない場合はエラーを返します。 | bool |
メッセージ PutResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| prev_kv | リクエストにprev_kvが設定されている場合、変更前のキー・バリューペアが返されます。 | mvccpb.KeyValue |
メッセージ RangeRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | keyは、範囲の最初のキーです。range_endが指定されていない場合、リクエストはkeyだけを検索します。 | bytes |
| range_end | range_endは、要求した範囲[key, range_end)の上限です。range_endが’\0’の場合、範囲にはkey以上(>=)のすべてのキーが含まれます。range_endがkeyに1を加えたもの(例:“aa”+1 == “ab”、“a\xff”+1 == “b”)の場合、範囲リクエストはkeyを接頭辞に持つすべてのキーを取得します。keyとrange_endの両方が’\0’の場合、範囲リクエストはすべてのキーを返します。 | bytes |
| limit | limitは、リクエストで返すキーの数の上限です。limitが0の場合、上限なしとして扱います。 | int64 |
| revision | revisionは、範囲の取得に使用するキー・バリューストアの時点です。revisionが0以下の場合、最新のキー・バリューストアを対象とします。そのリビジョンがすでにコンパクションされている場合、レスポンスとしてErrCompactedを返します。 | int64 |
| sort_order | sort_orderは、ソートして返す結果の順序です。 | SortOrder |
| sort_target | sort_targetは、ソートに使用するキー・バリューのフィールドです。 | SortTarget |
| serializable | serializableは、範囲リクエストでメンバーローカルの直列化可能読み取りを使用するよう設定します。範囲リクエストはデフォルトで線形化可能です。線形化可能なリクエストは、直列化可能なリクエストよりレイテンシーが高く、スループットが低くなりますが、クラスターの現在のコンセンサスを反映します。性能を高めるため、直列化可能な範囲リクエストは、古いデータを読み取る可能性と引き換えに、クラスター内の他のノードとのコンセンサスを必要とせず、ローカルに処理されます。 | bool |
| keys_only | keys_onlyが設定されている場合、値は返さず、キーだけを返します。 | bool |
| count_only | count_onlyが設定されている場合、範囲内のキーの数だけを返します。 | bool |
| min_mod_revision | min_mod_revisionは、返すキーの変更リビジョンの下限です。変更リビジョンがこれより小さいキーはすべて除外されます。 | int64 |
| max_mod_revision | max_mod_revisionは、返すキーの変更リビジョンの上限です。変更リビジョンがこれより大きいキーはすべて除外されます。 | int64 |
| min_create_revision | min_create_revisionは、返すキーの作成リビジョンの下限です。作成リビジョンがこれより小さいキーはすべて除外されます。 | int64 |
| max_create_revision | max_create_revisionは、返すキーの作成リビジョンの上限です。作成リビジョンがこれより大きいキーはすべて除外されます。 | int64 |
メッセージ RangeResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| kvs | kvsは、範囲リクエストに一致するキー・バリューペアの一覧です。件数を要求した場合、kvsは空になります。 | (slice of) mvccpb.KeyValue |
| more | moreは、要求した範囲内に、返すべきキーがまだあるかどうかを示します。 | bool |
| count | countは、要求された場合に、範囲内の実際のキー数に設定されます。Kvsとは異なり、上限やフィルター(Min/Max、Create/Modify、Revisionsなど)の影響を受けず、指定した範囲内の総数を反映します。 | int64 |
メッセージ RequestOp (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request | requestは、トランザクションが受け付けるリクエスト型の共用体です。 | oneof |
| request_range | RangeRequest | |
| request_put | PutRequest | |
| request_delete_range | DeleteRangeRequest | |
| request_txn | TxnRequest |
メッセージ ResponseHeader (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| cluster_id | cluster_idは、レスポンスを送信したクラスターのIDです。 | uint64 |
| member_id | member_idは、レスポンスを送信したメンバーのIDです。 | uint64 |
| revision | revisionは、リクエストが適用された時点のキー・バリューストアのリビジョンです。キー・バリューストアを操作しない呼び出しでは設定されません(したがって0です)。監視の進捗レスポンスでは、header.revisionが進捗を示します。このストリームで今後受信するすべてのイベントは、header.revisionより大きいリビジョン番号を持つことが保証されます。 | int64 |
| raft_term | raft_termは、リクエストが適用された時点のRaftの任期です。 | uint64 |
メッセージ ResponseOp (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| response | responseは、トランザクションが返すレスポンス型の共用体です。 | oneof |
| response_range | RangeResponse | |
| response_put | PutResponse | |
| response_delete_range | DeleteRangeResponse | |
| response_txn | TxnResponse |
メッセージ SnapshotRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ SnapshotResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | headerは、キー・バリューストアの現在の情報を保持します。スナップショットストリームの最初のheaderは、スナップショットの時点を示します。 | ResponseHeader |
| remaining_bytes | remaining_bytesは、このメッセージの後に送信するblobのバイト数です。 | uint64 |
| blob | blobは、スナップショットストリームの次のスナップショットチャンクを保持します。 | bytes |
| version | スナップショットに記録されたストレージスキーマのバージョンです。メンバーのローカルバックエンドから取得され、バイナリーのバージョンとは異なる場合があります。スナップショットのリストア時に対応している必要があるetcdのストレージバージョンを示します。 | string |
メッセージ StatusRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ StatusResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| version | versionは、応答するetcdメンバーのバイナリーのバージョンです。ストレージスキーマのバージョンは、storageVersionで別に報告されます。 | string |
| dbSize | dbSizeは、応答するメンバーのバックエンドデータベースに物理的に割り当てられた領域のサイズ(バイト単位)です。 | int64 |
| leader | leaderは、応答するメンバーが現在のリーダーと認識しているメンバーのIDです。 | uint64 |
| raftIndex | raftIndexは、応答するメンバーの現在のRaftコミット済みインデックスです。 | uint64 |
| raftTerm | raftTermは、応答するメンバーの現在のRaftの任期です。 | uint64 |
| raftAppliedIndex | raftAppliedIndexは、応答するメンバーの現在のRaft適用済みインデックスです。 | uint64 |
| errors | errorsは、アラームや健全性に関する情報と状態を保持します。 | (slice of) string |
| dbSizeInUse | dbSizeInUseは、応答するメンバーのバックエンドデータベースで論理的に使用されている領域のサイズ(バイト単位)です。 | int64 |
| isLearner | isLearnerは、そのメンバーがRaftの学習者メンバーかどうかを示します。 | bool |
| storageVersion | storageVersionは、dbファイルのバージョンです。目標のクラスターバージョンに対して、更新が遅れる場合があります。 | string |
| dbSizeQuota | dbSizeQuotaは、設定されたetcdのストレージクォータ(バイト単位)です(–quota-backend-bytesフラグでetcdインスタンスに渡した値)。 | int64 |
| downgradeInfo | downgradeInfoは、ダウングレード処理が存在するかどうかを示します。 | DowngradeInfo |
メッセージ TxnRequest (api/etcdserverpb/rpc.proto)
Googleのpaxosdb論文より:この実装の中心となるのは、MultiOpと呼ぶ強力なプリミティブです。反復処理を除くすべてのデータベース操作は、MultiOpを1回呼び出すことで実装されています。MultiOpはアトミックに適用され、3つの要素で構成されます。1. guardと呼ぶテストのリスト。guard内の各テストは、データベース内の1つのエントリーを検査します。値の有無を確認したり、指定した値と比較したりできます。guard内の異なる2つのテストは、データベース内の同じエントリーにも、異なるエントリーにも適用できます。guard内のすべてのテストが適用され、MultiOpはその結果を返します。すべてのテストがtrueの場合、MultiOpはt op(下記の項目2)を実行し、それ以外の場合はf op(下記の項目3)を実行します。2. t opと呼ぶデータベース操作のリスト。リスト内の各操作は、挿入、削除、検索のいずれかで、データベースの1つのエントリーに適用されます。リスト内の異なる2つの操作は、データベース内の同じエントリーにも、異なるエントリーにも適用できます。これらの操作は、guardの評価結果がtrueの場合に実行されます。3. f opと呼ぶデータベース操作のリスト。t opと同様ですが、guardの評価結果がfalseの場合に実行されます。
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| compare | compareは、条件の論理積を表す述語のリストです。比較が成功するとsuccessのリクエストを順番に処理し、レスポンスにはそれぞれの応答が同じ順序で含まれます。比較が失敗するとfailureのリクエストを順番に処理し、レスポンスにはそれぞれの応答が同じ順序で含まれます。 | (slice of) Compare |
| success | successは、compareの評価結果がtrueの場合に適用するリクエストのリストです。 | (slice of) RequestOp |
| failure | failureは、compareの評価結果がfalseの場合に適用するリクエストのリストです。 | (slice of) RequestOp |
メッセージ TxnResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| succeeded | succeededは、compareの評価結果がtrueの場合にtrueに、それ以外の場合にfalseに設定されます。 | bool |
| responses | responsesは、succeededがtrueの場合にはsuccessを、falseの場合にはfailureを適用した結果に対応するレスポンスのリストです。 | (slice of) ResponseOp |
メッセージ WatchCancelRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| watch_id | watch_idは、これ以上イベントを送信しないようキャンセルするウォッチャーのIDです。 | int64 |
メッセージ WatchCreateRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| key | keyは、監視対象として登録するキーです。 | bytes |
| range_end | range_endは、監視する範囲[key, range_end)の終端です。range_endが指定されていない場合、key引数だけを監視します。range_endが’\0’の場合、key引数以上のすべてのキーを監視します。range_endが指定したキーに1を加えた値の場合、そのキーを接頭辞に持つすべてのキーを監視します。 | bytes |
| start_revision | start_revisionは、監視を開始するリビジョン(そのリビジョンを含む)で、省略可能です。start_revisionを指定しない場合は「現在」から開始します。 | int64 |
| progress_notify | progress_notifyを設定すると、最近のイベントがない場合に、etcdサーバーが新しいウォッチャーへイベントを含まないWatchResponseを定期的に送信します。これは、クライアントが切断されたウォッチャーを、最近の既知のリビジョンから復旧したい場合に役立ちます。etcdサーバーは、現在の負荷に基づいて通知の送信頻度を決めることがあります。 | bool |
| filters | filtersは、ウォッチャーに送り返す前にサーバー側でイベントをフィルタリングします。 | (slice of) FilterType |
| prev_kv | prev_kvが設定されている場合、作成したウォッチャーはイベント発生前のKVを取得します。以前のKVがすでにコンパクションされている場合、何も返されません。 | bool |
| watch_id | watch_idが指定され、0でない場合、そのIDがこのウォッチャーに割り当てられます。etcdでのウォッチャー作成は同期操作ではないため、これを使うことで、同じストリーム上に複数のウォッチャーを作成する際に正しい順序を保てます。ストリーム上ですでに使用中のIDを持つウォッチャーを作成すると、エラーが返されます。 | int64 |
| fragment | fragmentは、大きなリビジョンを複数の監視レスポンスに分割できるようにします。 | bool |
メッセージ WatchProgressRequest (api/etcdserverpb/rpc.proto)
監視ストリームの進捗状態を、監視レスポンスストリームでできるだけ早く送信するよう要求します。
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option |
メッセージ WatchRequest (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| request_union | request_unionは、新しいウォッチャーを作成するか、既存のウォッチャーをキャンセルするためのリクエストです。 | oneof |
| create_request | WatchCreateRequest | |
| cancel_request | WatchCancelRequest | |
| progress_request | WatchProgressRequest |
メッセージ WatchResponse (api/etcdserverpb/rpc.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| (versionpb.etcd_version_msg) | option | |
| header | ResponseHeader | |
| watch_id | watch_idは、レスポンスに対応するウォッチャーのIDです。 | int64 |
| created | createdは、監視作成リクエストへのレスポンスである場合にtrueに設定されます。クライアントはwatch_idを記録し、作成したウォッチャーのイベントを同じストリームから受信するようにしてください。作成したウォッチャーに送信されるすべてのイベントには、同じwatch_idが付与されます。 | bool |
| canceled | canceledは、監視キャンセルリクエストへのレスポンスである場合、またはstart_revisionがすでにコンパクションされている場合にtrueに設定されます。キャンセルされたウォッチャーには、それ以降のイベントは送信されません。 | bool |
| compact_revision | compact_revisionは、ウォッチャーがコンパクション済みのインデックスで監視しようとした場合に、最小のインデックスに設定されます。これは、コンパクション済みのリビジョンでウォッチャーを作成した場合、またはウォッチャーがキー・バリューストアの進行に追いつけない場合に発生します。クライアントはそのウォッチャーをキャンセル済みとして扱い、同じstart_revisionでウォッチャーを作り直さないようにしてください。 | int64 |
| cancel_reason | cancel_reasonは、ウォッチャーをキャンセルする理由を示します。 | string |
| fragment | fragmentは、大きな監視レスポンスが複数のレスポンスに分割された場合にtrueです。 | bool |
| events | (slice of) mvccpb.Event |
メッセージ Event (api/mvccpb/kv.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| type | typeはイベントの種類です。typeがPUTの場合、キーに新しいデータが保存されたことを示します。typeがDELETEの場合、キーが削除されたことを示します。 | EventType |
| kv | kvは、イベントのKeyValueを保持します。PUTイベントは現在のkvペアを含みます。kv.Version=1のPUTイベントは、キーが作成されたことを示します。DELETE/EXPIREイベントは、変更リビジョンが削除時のリビジョンに設定された、削除済みのキーを含みます。 | KeyValue |
| prev_kv | prev_kvは、イベント発生前のキー・バリューペアを保持します。 | KeyValue |
メッセージ KeyValue (api/mvccpb/kv.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| key | keyは、バイト列で表したキーです。空のキーは許可されません。 | bytes |
| create_revision | create_revisionは、このキーが最後に作成されたリビジョンです。 | int64 |
| mod_revision | mod_revisionは、このキーが最後に変更されたリビジョンです。 | int64 |
| version | versionは、キーのバージョンです。削除するとバージョンは0にリセットされ、キーを変更するたびにバージョンが増加します。 | int64 |
| value | valueは、キーが保持する値をバイト列で表したものです。 | bytes |
| lease | leaseは、キーに関連付けられたリースのIDです。関連付けられたリースが期限切れになると、キーは削除されます。leaseが0の場合、キーにリースは関連付けられていません。 | int64 |
メッセージ Lease (server/lease/leasepb/lease.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| ID | int64 | |
| TTL | int64 | |
| RemainingTTL | int64 |
メッセージ LeaseInternalRequest (server/lease/leasepb/lease.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| LeaseTimeToLiveRequest | etcdserverpb.LeaseTimeToLiveRequest |
メッセージ LeaseInternalResponse (server/lease/leasepb/lease.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| LeaseTimeToLiveResponse | etcdserverpb.LeaseTimeToLiveResponse |
メッセージ Permission (api/authpb/auth.proto)
Permissionは、単一のエンティティーです。
| フィールド | 説明 | 型 |
|---|---|---|
| permType | Type | |
| key | bytes | |
| range_end | bytes |
メッセージ Role (api/authpb/auth.proto)
Roleは、authRolesバケット内の単一のエントリーです。
| フィールド | 説明 | 型 |
|---|---|---|
| name | bytes | |
| keyPermission | (slice of) Permission |
メッセージ User (api/authpb/auth.proto)
Userは、authUsersバケット内の単一のエントリーです。
| フィールド | 説明 | 型 |
|---|---|---|
| name | bytes | |
| password | bytes | |
| roles | (slice of) string | |
| options | UserAddOptions |
メッセージ UserAddOptions (api/authpb/auth.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| no_password | bool |
13.10 - APIリファレンス:並行処理
このAPIリファレンスは、各見出しに記載した.protoファイルから自動生成されています。
サービス Lock (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
ロックサービスは、クライアント側のロック機能をgRPCインターフェースとして公開します。
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| Lock | LockRequest | LockResponse | Lockは、指定した名前付きロックの分散共有ロックを取得します。成功すると、呼び出し元がロックを保持している間だけ存在する、一意のキーを返します。このキーをトランザクションと組み合わせることで、ロックの所有権を保持している間だけetcdの更新が行われることを安全に保証できます。ロックは、そのキーに対してUnlockを呼び出すか、所有者に関連付けられたリースが期限切れになるまで保持されます。 |
| Unlock | UnlockRequest | UnlockResponse | Unlockは、Lockが返したキーを受け取り、ロックの保持を解除します。すると、ロックを待っている次のLock呼び出し元が起こされ、ロックの所有権が与えられます。 |
メッセージ LockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| name | nameは、取得する分散共有ロックの識別子です。 | bytes |
| lease | leaseは、ロックの所有権に関連付けるリースのIDです。ロックを保持しているリースが期限切れになるか取り消されると、ロックは自動的に解放されます。同じリースによるLockの呼び出しは、1回の取得として扱います。同じリースで2回ロックしても、何も行いません。 | int64 |
メッセージ LockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| key | keyは、Lockの呼び出し元がロックを所有している間、etcd上に存在するキーです。このキーは変更しないでください。変更すると、ロックの動作が未定義になる可能性があります。 | bytes |
メッセージ UnlockRequest (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| key | keyは、Lockによって付与されたロック所有権のキーです。 | bytes |
メッセージ UnlockResponse (server/etcdserver/api/v3lock/v3lockpb/v3lock.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
サービス Election (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
選挙サービスは、クライアント側の選挙機能をgRPCインターフェースとして公開します。
| メソッド | リクエスト型 | レスポンス型 | 説明 |
|---|---|---|---|
| Campaign | CampaignRequest | CampaignResponse | Campaignは、選挙でリーダーシップを取得するまで待機し、成功するとリーダーシップを表すLeaderKeyを返します。LeaderKeyは、その選挙で新しい値を発行すること、リーダーシップの保持を条件にトランザクションでAPIリクエストを保護すること、および選挙から辞任することに使用できます。 |
| Proclaim | ProclaimRequest | ProclaimResponse | Proclaimは、リーダーが公開している値を新しい値で更新します。 |
| Leader | LeaderRequest | LeaderResponse | Leaderは、現在の選挙の宣言があれば、それを返します。 |
| Observe | LeaderRequest | LeaderResponse | Observeは、選挙で選出されたリーダーによる宣言を、発行された順にストリーミングします。 |
| Resign | ResignRequest | ResignResponse | Resignは、他の立候補者がその選挙のリーダーシップを取得できるよう、リーダーシップを解放します。 |
メッセージ CampaignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| name | nameは、立候補する選挙の識別子です。 | bytes |
| lease | leaseは、その選挙のリーダーシップに関連付けられたリースのIDです。リーダーを辞任する前にリースが期限切れになるか取り消されると、次の立候補者がいる場合は、その立候補者にリーダーシップが移ります。 | int64 |
| value | valueは、立候補者が選挙に勝ったときに設定する、最初の宣言値です。 | bytes |
メッセージ CampaignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| leader | leaderは、その選挙のリーダーシップを保持するために使用するリソースを表します。 | LeaderKey |
メッセージ LeaderKey (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| name | nameは、リーダーシップキーに対応する選挙の識別子です。 | bytes |
| key | keyは、その選挙の所有権を表す不透明なキーです。キーを削除すると、リーダーシップは失われます。 | bytes |
| rev | revは、キーの作成リビジョンです。トランザクション中にキーの作成リビジョンがrevと一致するかを調べることで、選挙の所有権を検証できます。 | int64 |
| lease | leaseは、その選挙のリーダーのリースIDです。 | int64 |
メッセージ LeaderRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| name | nameは、リーダーシップ情報を取得する選挙の識別子です。 | bytes |
メッセージ LeaderResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader | |
| kv | kvは、リーダーの最新の更新を表すキー・バリューペアです。 | mvccpb.KeyValue |
メッセージ ProclaimRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| leader | leaderは、その選挙で保持しているリーダーシップです。 | LeaderKey |
| value | valueは、リーダーの現在の値を上書きするための更新値です。 | bytes |
メッセージ ProclaimResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
メッセージ ResignRequest (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| leader | leaderは、辞任によって手放すリーダーシップです。 | LeaderKey |
メッセージ ResignResponse (server/etcdserver/api/v3election/v3electionpb/v3election.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| header | etcdserverpb.ResponseHeader |
メッセージ Event (api/mvccpb/kv.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| type | typeはイベントの種類です。typeがPUTの場合、キーに新しいデータが保存されたことを示します。typeがDELETEの場合、キーが削除されたことを示します。 | EventType |
| kv | kvは、イベントのKeyValueを保持します。PUTイベントは現在のkvペアを含みます。kv.Version=1のPUTイベントは、キーが作成されたことを示します。DELETE/EXPIREイベントは、変更リビジョンが削除時のリビジョンに設定された、削除済みのキーを含みます。 | KeyValue |
| prev_kv | prev_kvは、イベント発生前のキー・バリューペアを保持します。 | KeyValue |
メッセージ KeyValue (api/mvccpb/kv.proto)
| フィールド | 説明 | 型 |
|---|---|---|
| key | keyは、バイト列で表したキーです。空のキーは許可されません。 | bytes |
| create_revision | create_revisionは、このキーが最後に作成されたリビジョンです。 | int64 |
| mod_revision | mod_revisionは、このキーが最後に変更されたリビジョンです。 | int64 |
| version | versionは、キーのバージョンです。削除するとバージョンは0にリセットされ、キーを変更するたびにバージョンが増加します。 | int64 |
| value | valueは、キーが保持する値をバイト列で表したものです。 | bytes |
| lease | leaseは、キーに関連付けられたリースのIDです。関連付けられたリースが期限切れになると、キーは削除されます。leaseが0の場合、キーにリースは関連付けられていません。 | int64 |
14 - 運用ガイド
14.1 - 認証ガイド
14.1.1 - 認証
認証に使用するauth、user、role:
注意:
これは、認証に関する情報を追加して更新する必要がある未完成のページです。上記のテキストはコード例にすぎません。
14.1.2 - ロールベースのアクセス制御
概要
認証はetcd 2.1で追加されました。etcd v3 APIでは、新しいデータモデルに合わせて、認証機能のAPIとユーザーインターフェースを少し変更しています。このガイドは、etcd v3で基本的な認証とロールベースのアクセス制御を設定するためのものです。
特別なユーザーとロール
特別なユーザーrootと、特別なロールrootが1つずつあります。
ユーザーroot
etcdへの完全なアクセス権を持つrootユーザーは、認証を有効にする前に作成しなければなりません。rootユーザーは、ロールや通常のユーザーを管理するためのものです。rootユーザーにはrootロールが必要で、etcd内のあらゆるものを変更できます。
ロールroot
rootロールは、rootユーザーに限らず、任意のユーザーに付与できます。rootロールを持つユーザーには、全体への読み書きのアクセス権と、クラスターの認証設定を更新する権限があります。また、rootロールは、メンバー構成の変更、ストアのデフラグメンテーション、スナップショットの取得など、クラスターの一般的な保守権限も与えます。
ユーザーの操作
etcdctlのuserサブコマンドは、ユーザーアカウントに関するすべての操作を扱います。
次のコマンドでユーザーを一覧表示できます。
ユーザーは、次のように簡単に作成できます。
新しいユーザーを作成すると、新しいパスワードの入力を求められます。--interactive=falseオプションを指定すると、標準入力からパスワードを渡せます。--new-user-passwordを使ってパスワードを指定することもできます。
次のように、パスワードで認証できないユーザーを作成することもできます。
このようなユーザーは、TLSのCommon Nameによる認証 だけを使用できます。
etcdは、--user username:による空のパスワードでの認証に対応していません。たとえば、etcdctl user add anonymous:''のように空のパスワードで作成したユーザーは、ユーザー名とパスワードを使うリクエストでは認証できません。etcdctl --user anonymous: get fooなどのリクエストは、user name is emptyで失敗します。
次のコマンドで、ユーザーにロールを付与したり、取り消したりできます。
ユーザーの設定は、次のコマンドで確認できます。
ユーザーのパスワードは、次のコマンドで変更できます。
パスワードの変更時にも、新しいパスワードの入力を求められます。--interactive=falseオプションを指定すると、標準入力からパスワードを渡せます。
次のコマンドでアカウントを削除します。
ロールの操作
etcdctlのroleサブコマンドは、個々のユーザーに付与する各ロールのアクセス制御に関するすべての操作を扱います。
次のコマンドでロールを一覧表示します。
次のコマンドで新しいロールを作成します。
ロールにパスワードはありません。新しいアクセス権の集合を定義するだけです。
ロールには、単一のキーまたはキーの範囲へのアクセス権を付与します。
範囲は区間[start-key, end-key)として指定できます。start-keyは、アルファベットの辞書順でend-keyより小さくすることを推奨します。
次の例のように、読み取り、書き込み、または両方のアクセス権を付与できます。
付与されている権限は、いつでもロールを参照して確認できます。
権限の取り消しも同様に行います。
ロール全体の削除も同様です。
認証の有効化
認証を有効にする最小限の手順は次のとおりです。管理者は、認証を有効にする前でも後でも、都合に合わせてユーザーとロールを設定できます。
rootユーザーを作成しておきます。
認証を有効にします。
これで、etcdは認証が有効な状態で動作します。何らかの理由で無効にする場合は、逆の操作となる次のコマンドを使用します。
認証による保護範囲
etcdctl auth enableで認証を有効にすると、V3 gRPC APIの操作(get、put、delete、watchなど)が保護されます。
HTTPエンドポイント/metricsと/healthは別のハンドラーで動作し、V3 RBAC認証では保護されません。この設計により、キー・バリューデータを保護しつつ、PrometheusやロードバランサーはgRPC認証なしでメトリクスを収集できます。
これらの可観測性エンドポイントを保護するには、次の方法があります。
--cert-file、--key-file、--client-cert-authでmTLSを有効にする- または、
--listen-metrics-urlsでメトリクスをプライベートなインターフェースにバインドする - または、ネットワークポリシーやファイアウォールルールでアクセスを制限する
etcdctlでの認証
etcdctlは、curlと似た認証用フラグをサポートします。
パスワードは、プロンプトから入力できます。
コマンドラインフラグ--passwordで指定することもできます。
それ以外は、すべてのetcdctlコマンドの使い方は変わりません。ユーザーとロールは引き続き作成、変更できますが、rootロールを持つユーザーによる認証が必要です。
TLSのCommon Nameの利用
v3.2以降、etcdサーバーを--client-cert-auth=trueオプションで起動すると、クライアントのTLS証明書のCommon Name(CN)フィールドをetcdユーザーとして使用します。この場合、Common Nameがユーザーを認証するため、クライアントにパスワードは不要です。ただし、1. --client-cert-auth=trueを指定してクライアントがCNを提供し、かつ2. クライアントがユーザー名とパスワードも提供する場合は、ユーザー名とパスワードによる認証が優先されます。この機能はgRPC-proxyとgRPC-gatewayでは使えません。gRPC-proxyはクライアントからのTLSを終端するため、すべてのクライアントでプロキシーの証明書を共有するからです。gRPC-gatewayも、HTTPリクエストをgRPCリクエストに変換するために内部でTLS接続を使うので、同じ制限があります。このため、クライアントは自身のCNをサーバーに正しく提供できません。指定された証明書に空でないCNがあると、gRPC-proxyはエラーで停止します。gRPC-proxyが返すエラーは、クライアントの証明書のCNが空でないことを示します。
パスワード強度に関する注意
etcdctlとetcd APIは、ユーザーの作成時やパスワードの更新時に、特定のパスワード長を強制しません。こうした要件を適用する責任は管理者にあります。パスワード強度に伴うセキュリティーリスクを避けるには、TLSのCommon Nameによる認証
と、--no-passwordオプションで作成したユーザーを利用できます。
14.2 - 設定オプション
etcdは、次の方法で設定できます。
- コマンドラインフラグ
- 環境変数:各フラグには、同じ名前を大文字のスネークケース
に変換し、
ETCD_を付けた環境変数が対応します。たとえば、--some-flagはETCD_SOME_FLAGになります。 - 設定ファイル
注意:設定方法を組み合わせた場合は、次の規則が適用されます。
- コマンドラインフラグは環境変数より優先されます。
- 設定ファイルを指定すると、すべてのコマンドラインフラグと環境変数は無視されます。
コマンドラインフラグ
以下では、フラグを--flag-name DEFAULT_VALUEの形式で示します。
この取り込み済みリファレンスには、移行の背景として一部の旧v2オプションを残しています。etcd 3.7では、--enable-v2とv2プロキシーモードは利用できません。非推奨の--v2-deprecationフラグはユーザーの指定を無視し、デフォルト値を強制します。旧オプションを使う前に、インストールしたバージョンのetcd --helpを確認してください。
開発による変更が続いているため、以下のフラグ一覧は最新でない場合があります。利用可能な最新のフラグは、etcd --helpを実行するか、etcdのヘルプ
を参照してください。
注記:v3.7で新規追加、更新、非推奨となったフラグの詳細は、CHANGELOG-3.7.md を参照してください。
メンバー
クラスタリング
セキュリティー
認証
プロファイリングと監視
ログ
注記:v3.7では、複数の--experimental-*フラグが安定版に昇格、または改名されています。
非推奨のフラグは、以下に記載する対応する安定版のフラグに必ず置き換えてください。
分散トレーシング
v2プロキシー
v2プロキシーはv3.7より前に削除されました。以下のフラグは、過去の移行の参考資料としてのみ残しており、etcd v3.7サーバーに指定してはいけません。
機能
フィーチャーゲート
安全性を保証しない機能
警告:安全性を保証しない機能を使用すると、コンセンサスプロトコルの保証が損なわれる可能性があります。
設定ファイル
etcdの設定ファイルは、コマンドラインフラグ名をキー、そのフラグの値を値とするYAMLマップです。
このファイルを使うには、--config-fileフラグまたはETCD_CONFIG_FILE環境変数の値としてファイルパスを指定します。
例は、etcd.conf.ymlのサンプル を参照してください。
--grpc-keepalive-min-time、--grpc-keepalive-interval、
--grpc-keepalive-timeout、--backend-batch-interval、--corrupt-check-time、
--compact-hash-check-time、--compaction-sleep-interval、
--watch-progress-notify-interval、--warning-apply-duration、
--warning-unary-request-duration、--downgrade-check-timeなどの期間フィールドは、
コマンドラインフラグでは人が読みやすい文字列(10m、5sなど)を受け付けますが、
設定ファイルではナノ秒を表す整数値しか受け付けません。これは、
time.Durationが単なる整数としてアンマーシャルされる、Go標準ライブラリの既知の制限
です。
たとえば、設定ファイルで監視の進捗通知間隔を10分にするには、次のようにします。
14.3 - 通信のセキュリティーモデル
etcdは、クライアントとサーバーの通信、およびピア間(サーバー間/クラスター内)の通信の両方で、自動TLSとクライアント証明書による認証に対応しています。etcdは、データベースを使い始める際の負担を減らすため、RBACによる認証 も通信層の認証機能も、デフォルトでは有効にしません。また、このデフォルトは2013年のプロジェクト発足以来のもので、変更すると互換性を損ないます。セキュリティー機能を有効にしていないetcdクラスターは、あらゆるクライアントにデータを公開してしまう可能性があります。
まず、CA証明書と、1メンバー用の署名済み鍵ペアを用意します。クラスターのメンバーごとに新しい鍵ペアを作成し、署名することを推奨します。
cfssl ツールを使うと、証明書を簡単に生成できます。このツールを使った例をこちら に示しています。また、自己署名鍵ペアの生成ガイド も参照できます。
開発による変更が続いているため、以下のフラグ一覧は最新でない場合があります。利用可能な最新のフラグは、etcd --helpを実行するか、etcdのヘルプ
を参照してください。
基本設定
etcdには、コマンドラインフラグまたは環境変数で指定できる、証明書関連の設定オプションがいくつかあります。
クライアントとサーバーの通信:
--cert-file=<path>:etcdへのSSL/TLS接続に使う証明書。このオプションを設定すると、advertise-client-urlsでHTTPSスキームを使えます。
--key-file=<path>:証明書の鍵。暗号化されていてはなりません。
--client-cert-auth:指定すると、etcdはすべての受信HTTPSリクエストについて、信頼するCAが署名したクライアント証明書を確認します。有効なクライアント証明書を提示しないリクエストは失敗します。認証
が有効な場合、証明書はCommon Nameフィールドに指定されたユーザー名の認証情報を提供します。
--trusted-ca-file=<path>:信頼する認証局。
--auto-tls:クライアントとのTLS接続に、自動生成した自己署名証明書を使用します。
ピア間(サーバー間/クラスター内)の通信:
ピア用のオプションは、クライアントとサーバーの通信のオプションと同様に機能します。
--peer-cert-file=<path>:ピア間のSSL/TLS接続に使う証明書。ピアアドレスでのリッスンと、ほかのピアへのリクエスト送信の両方で使用します。
--peer-key-file=<path>:証明書の鍵。暗号化されていてはなりません。
--peer-client-cert-auth:指定すると、etcdはクラスターから受信するすべてのピアリクエストについて、指定のCAが署名した有効なクライアント証明書を確認します。
--peer-trusted-ca-file=<path>:信頼する認証局。
--peer-auto-tls:ピア間のTLS接続に、自動生成した自己署名証明書を使用します。
クライアントとサーバーの通信、またはピア間の通信に証明書を指定した場合、鍵も設定しなければなりません。これらの設定オプションはすべて、ETCD_TRUSTED_CA_FILE、ETCD_PEER_TRUSTED_CA_FILEなどの環境変数でも指定できます。
共通オプション:
--cipher-suites:サーバーとクライアント、およびピア間でサポートするTLS暗号スイートのカンマ区切りの一覧(空の場合はGoが自動設定します)。
--tls-min-version=<version>:etcdがサポートするTLSの最小バージョンを設定します。
--tls-max-version=<version>:etcdがサポートするTLSの最大バージョンを設定します。未設定の場合、Goがサポートする最大バージョンを使用します。
TLS証明書のkeyUsageとextendedKeyUsage
etcdの通信を保護するX.509証明書を生成するときは、その役割に応じた適切なkeyUsageとextendedKeyUsageフィールドを含めることを推奨します。etcdは証明書の検証にGoのcrypto/tlsとcrypto/x509ライブラリを使用し、これらのライブラリがTLSハンドシェイク中に用途を検証します。
次の表に、一般的な証明書の役割に対する推奨用途を示します。
| 証明書の役割 | keyUsage | extendedKeyUsage |
|---|---|---|
| サーバー(クライアントとサーバーの通信) | digitalSignature, keyEncipherment | serverAuth |
| クライアント | digitalSignature, keyEncipherment | clientAuth |
| ピア(サーバー間の通信) | digitalSignature, keyEncipherment | serverAuth, clientAuth |
注意事項:
--peer-client-cert-authが有効な場合、ピア証明書はetcdメンバー間の相互TLSに使うため、serverAuthとclientAuthの両方が必要です。--client-cert-authで使うクライアント証明書には、clientAuthを含めることを推奨します。
例1:HTTPSによるクライアントとサーバー間の通信の保護
CA証明書(ca.crt)と署名済み鍵ペア(server.crt、server.key)を用意します。
単純なHTTPSによる通信の保護を提供するよう、etcdを順に設定します。
これで正常に起動するはずです。HTTPSでetcdにアクセスして設定をテストできます。
このコマンドで、ハンドシェイクの成功を確認できるはずです。独自の認証局による自己署名証明書を使用するため、--cacertオプションでCAをcurlに渡さなければなりません。CA証明書をシステムの信頼済み証明書ディレクトリ(通常は/etc/pki/tls/certsまたは/etc/ssl/certs)に追加する方法もあります。
OSX 10.9以降のユーザー:OSX 10.9以降のcurl 7.30.0は、コマンドラインから渡された証明書を認識しません。
代わりに、ダミーのca.crtをキーチェーンに直接インポートするか、curlに-kフラグを付けてエラーを無視してください。
-kなしでテストするには、open ./tests/fixtures/ca/ca.crtを実行し、表示される指示に従います。
テスト後は、この証明書を削除してください。
回避策があれば、お知らせください。
例2:HTTPSクライアント証明書によるクライアントとサーバー間の認証
ここまでは、etcdクライアントがサーバーの身元を検証し、通信を保護できるようにしました。クライアント証明書を使って、etcdへの不正アクセスを防ぐこともできます。
クライアントはサーバーに証明書を提示し、サーバーはそれが指定されたCAによる署名かどうかを確認して、リクエストを処理するか判断します。
最初の例のファイルに加えて、同じ認証局が署名したクライアント用鍵ペア(client.crt、client.key)が必要です。
このサーバーに対し、先ほどと同じリクエストを試します。
サーバーはリクエストを拒否するはずです。
成功させるには、CAが署名したクライアント証明書をサーバーに提示する必要があります。
出力には、次の内容が含まれるはずです。
サーバーからのレスポンスも含まれます。
弱いTLS暗号スイート を拒否するには、暗号スイートを指定します。
無効な暗号スイートを含むClient Helloを送ると、TLSハンドシェイクは失敗します。
例:
この場合、クライアントのリクエストは、サーバーに指定された暗号スイートのいずれかを指定しなければなりません。
例3:クラスター内の通信の保護とクライアント証明書
etcdは、ピア間通信、つまりクラスター内のetcdメンバー間の通信にも、上記と同じモデルをサポートします。
ca.crtと、このCAが署名した各メンバーの鍵ペア(member1.crtとmember1.key、member2.crtとmember2.key)を持つ2つのメンバーがあるとします。次のようにetcdを起動します。
etcdメンバーはクラスターを構成し、クラスター内のメンバー間通信はすべて暗号化され、クライアント証明書で認証されます。etcdの出力には、接続先のアドレスがHTTPSを使用していることが示されます。
例4:自動生成した自己署名証明書による通信の保護
ClientAutoTLSとPeerAutoTLSを指定すると、etcdが自動生成するクライアント証明書とピア証明書の有効期間は1年だけです。–self-signed-cert-validityフラグで、証明書の有効期間を年単位で設定できます。
通信の暗号化は必要でも認証は不要な場合、etcdは自動生成した自己署名証明書でメッセージを暗号化できます。etcdの外で証明書や鍵を管理する必要がないため、配置が簡単になります。
--auto-tlsと--peer-auto-tlsフラグで、クライアント接続とピア接続に自己署名証明書を使うよう設定します。
自己署名証明書は身元を認証しないため、curlはエラーを返します。
証明書チェーンの検証を無効にするには、-kフラグを付けてcurlを実行します。
DNS SRVに関する注意
v3.1.0以降(v3.2.9を除く)、SRVディスカバリーによるブートストラップは、--discovery-srvフラグのルートドメイン名でServerNameを認証します。証明書のSubject Alternative Name(SAN)フィールドに一致するルートドメイン名を要求することで、証明書を使う中間者攻撃を防ぎます。たとえば、etcd --discovery-srv=etcd.localでは、提供された証明書のSubject Alternative Name(SAN)フィールドにルートドメインetcd.localが含まれる場合にのみ、ピアやクライアントを認証します。
etcdプロキシーに関する注意
このセクションでは、削除済みの旧v2プロキシーを説明します。etcd 3.7では、v3 gRPCプロキシー を使用してください。
etcdプロキシーは、クライアントとの接続が保護されている場合、そのTLSを終端します。etcdメンバーとの通信には、--peer-key-fileと--peer-cert-fileで指定したプロキシー自身の鍵と証明書を使います。
プロキシーは、各メンバーの--advertise-client-urlsと--advertise-peer-urlsの両方を使って通信します。クライアントリクエストはメンバーの通知するクライアントURLに転送し、初期クラスター構成はメンバーの通知するピアURLを通じて同期します。
etcdメンバーでクライアント認証が有効な場合、管理者は、プロキシーの--peer-cert-fileで指定したピア証明書がその認証に有効であることを確認しなければなりません。ピア認証も有効な場合は、プロキシーのピア証明書がピア認証にも有効でなければなりません。
TLS認証に関する注意
v3.2.0 以降、クライアント接続ごとにTLS証明書を再読み込みします 。etcdサーバーを停止せずに期限切れ証明書を交換する際に便利で、古い証明書を新しいものに上書きするだけで対応できます。接続ごとの証明書の更新に大きなオーバーヘッドは生じないはずですが、将来はキャッシュ層で改善することもできます。テスト例はこちら を参照してください。
v3.2.0
以降、サーバーはIPのSANが正しくないピア証明書を拒否します
。たとえば、ピア証明書のSubject Alternative Name(SAN)フィールドにIPアドレスがある場合、リモートIPアドレスがそのいずれかと一致するときだけ認証します。これは、許可されていないエンドポイントがクラスターに参加することを防ぐためです。たとえば、ピアBのCSR(cfsslを使用)が次のとおりだとします。
一方、ピアBの実際のIPアドレスは10.138.0.27ではなく10.138.0.2です。Bがクラスターに参加しようとすると、ピアAはx509: certificate is valid for 10.138.0.27, not 10.138.0.2エラーで拒否します。BのリモートIPアドレスがSubject Alternative Name(SAN)フィールドのアドレスと一致しないためです。
v3.2.0
以降、サーバーはSANの検証時にTLSのDNSNamesを名前解決します
。たとえば、ピア証明書のSubject Alternative Name(SAN)フィールドにDNS名だけがあり、IPアドレスがない場合、そのDNS名を正引き(dig b.com)したIPがリモートIPアドレスに一致するときだけ、サーバーはピアを認証します。たとえば、ピアBのCSR(cfsslを使用)が次のとおりだとします。
ピアBのリモートIPアドレスは10.138.0.2です。Bがクラスターに参加しようとすると、ピアAは接続してきたホストb.comを名前解決し、IPアドレスの一覧を取得します(dig b.comなど)。一覧にIPアドレス10.138.0.2がなければ、tls: 10.138.0.2 does not match any of DNSNames ["b.com"]エラーでBを拒否します。
v3.2.2
以降、IPが一致すれば、サーバーはDNSエントリーを確認せずに接続を受け入れます
。たとえば、ピア証明書のSubject Alternative Name(SAN)フィールドにIPアドレスとDNS名があり、リモートIPアドレスがそのいずれかに一致する場合、サーバーはDNS名を追加で確認せずに接続を受け入れます。たとえば、ピアBのCSR(cfsslを使用)が次のとおりだとします。
ピアBのリモートIPアドレスは10.138.0.2で、invalid.domainは無効なホストです。Bがクラスターに参加しようとすると、Subject Alternative Name(SAN)フィールドに一致する有効なIPアドレスがあるため、ピアAはBの認証に成功します。詳しくは、issue#8206
を参照してください。
v3.2.5
以降、サーバーはワイルドカードDNSのSANの逆引きに対応します
。たとえば、ピア証明書のSubject Alternative Name(SAN)フィールドにDNS名だけがあり、IPアドレスがない場合、サーバーはまずリモートIPアドレスを逆引きし、そのアドレスに対応する名前の一覧を取得します(nslookup IPADDRなど)。その名前のいずれかがピア証明書のDNS名と完全一致またはワイルドカード一致すれば、接続を受け入れます。一致しなければ、ピア証明書の各DNSエントリーを正引きし(エントリーが*.example.default.svcならexample.default.svcを検索)、名前解決したアドレスがピアのリモートIPアドレスと一致するときだけ受け入れます。たとえば、ピアBのCSR(cfsslを使用)が次のとおりだとします。
ピアBのリモートIPアドレスは10.138.0.2です。Bがクラスターに参加しようとすると、ピアAはIPアドレス10.138.0.2を逆引きしてホスト名の一覧を取得し、Bの証明書のSubject Alternative Name(SAN)フィールドのDNS名と、完全一致またはワイルドカード一致するかを確認します。逆引きでも正引きでも一致しなければ、"tls: "10.138.0.2" does not match any of DNSNames ["*.example.default.svc","*.example.default.svc.cluster.local"]というエラーを返します。詳しくは、issue#8268
を参照してください。
v3.3.0
では、etcd --peer-cert-allowed-cn
フラグを追加し、ピア間接続のCN(Common Name)による認証
に対応しました。KubernetesのTLSブートストラップでは、etcdメンバーやほかのシステムコンポーネント(APIサーバー、kubeletなど)用に証明書を動的に生成します。コンポーネントごとに別のCAを管理するとetcdクラスターへのアクセスを厳しく制御できますが、多くの場合手間がかかります。–peer-cert-allowed-cnを指定すると、CAを共有していても、Common Nameが一致するノードだけが参加できます。照合は、証明書のCommon Name(CN)フィールドとの完全な文字列比較で、ワイルドカードや前方一致には対応しません。–peer-cert-allowed-hostnameや–client-cert-allowed-hostnameによるホスト名のフィルタリングは、Goのx509.Certificate.VerifyHostname()を使い、完全なホスト名とワイルドカード(*.example.comなど)の両方に対応します。たとえば、3ノードクラスターの各メンバーを、次のCSR(cfsslを使用)で設定します。
--peer-cert-allowed-cn etcd.localを指定すると、Common Nameが一致するピアだけを認証します。CSRのCNや--peer-cert-allowed-cnが異なるノードは拒否します。
各プロセスを次のように起動します。
v3.2.19
とv3.3.4
では、証明書のSANフィールドにIPアドレスだけがあり、ドメイン名がない場合
のTLS再読み込みを修正しています。たとえば、あるメンバーを次のCSR(cfsslを使用)で設定します。
Goでは、サーバーの(*tls.Config).Certificatesフィールドが空の場合、またはクライアントからの有効なSNIで(*tls.ClientHelloInfo).ServerNameが空でない場合に限り、TLS再読み込みのために(*tls.Config).GetCertificateを呼び出します。以前のetcdは、最初のクライアントTLSハンドシェイク時に常に(*tls.Config).Certificatesを設定し、空でない状態にしていました。そのため、TLS検証に合格し、(*tls.Config).GetCertificateによるTLSファイルの再読み込みを発生させるには、クライアントが一致するSNIを必ず送ることを想定していました。
しかし、SANフィールドにドメイン名がなくIPアドレスしかない証明書
では、ServerNameが空の*tls.ClientHelloInfoでリクエストするため、最初のTLSハンドシェイクで再読み込みが発生しませんでした。これは、期限切れ証明書をオンラインで置き換える際に問題となります。
現在は、最初のTLSクライアントハンドシェイク時に(*tls.Config).Certificatesを空で作成し、まず(*tls.Config).GetCertificateを呼び出します。その後、新しいTLS接続ごとに残りの証明書を設定するため、クライアントのSNIが空の場合(証明書がIPだけを含む場合など)でも動作します。
ホスト許可リストに関する注意
etcd --host-whitelistフラグは、HTTPクライアントリクエストで許可するホスト名を指定します。クライアントオリジンポリシーは、保護されていないetcdサーバーへの「DNSリバインディング」
攻撃を防ぎます。任意のWebサイトが、許可されたDNS名を作成し、そのDNSを"localhost"(または任意のアドレス)に向けるだけで、"localhost"でリッスンするetcdサーバーのすべてのHTTPエンドポイントにアクセスできてしまい、DNSリバインディング攻撃に対して脆弱になるためです。詳しくは、CVE-2018-5702
を参照してください。
クライアントオリジンポリシーは、次のように機能します。
- HTTPSによる保護されたクライアント接続の場合、すべてのホスト名を許可します。
- 保護されていないクライアント接続で、
"HostWhitelist"が空でない場合、Hostフィールドが許可リストにあるHTTPリクエストだけを許可します。
制御を厳格にするため、認証が有効かどうかにかかわらず、クライアントオリジンポリシーを適用します。
デフォルトでは、etcd --host-whitelistとembed.Config.HostWhitelistは*に設定され、すべてのホスト名を許可します。許可リストが空の場合も、すべてのホスト名を許可します。ホスト名を指定する場合、ループバックアドレスは自動追加されません。ループバックインターフェースを許可するには、許可リストに手動で追加してください("localhost"、"127.0.0.1"など)。
よくある質問
TLSクライアント認証でSSLv3 alert handshake failureが発生する場合
golangのcrypto/tlsパッケージは、証明書の公開鍵を使う前に鍵の用途を確認します。
証明書の公開鍵をクライアント認証に使うには、証明書の公開鍵を作成する際に、Extended Key UsageへclientAuthを追加する必要があります。
手順は次のとおりです。
openssl.cnfに、次のセクションを追加します。
証明書を作成するときは、-extensionsフラグで必ず参照してください。
ピア証明書認証で"certificate is valid for 127.0.0.1, not $MY_IP"が返る場合
メンバーのパブリックIPアドレスをSubject Nameに指定して、証明書に署名してください。たとえば、etcd-caツールにはnew-certコマンドの--ip=オプションがあります。
証明書はSubject NameにメンバーのFQDNを指定して署名し、Subject Alternative Names(略してIP SAN)でIPアドレスを追加する必要があります。etcd-caツールにはnew-certコマンドの--domain=オプションがあり、opensslでも同じこと
ができます。
etcdはディスク上のデータを暗号化するか
いいえ。etcdは、ディスクに保存するキー・バリューデータを暗号化しません。etcdに保存するデータを暗号化する必要がある場合は、次の方法があります。
- クライアントアプリケーションでデータを暗号化、復号する
- dm-crypt など、基盤となるストレージシステムの保存データ暗号化機能を使う
“directory X exist without recommended permission -rwx——“という警告ログが出る場合
etcdは特定のディレクトリを新規作成するとき、権限のないアクセスをできる限り防ぐため、ファイルの権限を700に設定します。ただし、ユーザーがすでに独自の設定でディレクトリを作成している場合、etcdは既存のディレクトリを使用し、権限が700と異なれば警告メッセージを記録します。
14.4 - クラスター構成ガイド
概要
etcdクラスターを静的に起動するには、各メンバーがクラスター内のほかのメンバーを把握している必要があります。ただし、メンバーのIPアドレスを事前に把握できない場合もあります。その場合は、ディスカバリーサービスを利用してクラスターをブートストラップできます。
etcdクラスターの起動後、メンバーの追加や削除は実行時再構成 で行います。その設計をより深く理解するには、実行時構成の設計ドキュメント を参照することを推奨します。
このガイドでは、etcdクラスターをブートストラップする次の方法を説明します。
いずれの方法でも、次の3台のマシンでetcdクラスターを作成します。
| 名前 | アドレス | ホスト名 |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
静的構成
起動前にクラスターメンバー、そのアドレス、クラスターサイズがわかっているため、initial-clusterフラグを設定してオフラインでブートストラップを構成できます。各マシンに、次の環境変数またはコマンドラインを指定します。
initial-clusterに指定するURLは、通知するピアURLです。各ノードのinitial-advertise-peer-urlsの値と一致させることを推奨します。
テストのために同じ設定で複数のクラスターを起動する場合や、単一のクラスターを作成、破棄する場合は、各クラスターに一意のinitial-cluster-tokenを指定することを強く推奨します。これにより、ほかの設定が完全に同じでも、etcdは各クラスターに一意のクラスターIDとメンバーIDを生成できます。クラスター間の相互作用を防ぎ、それによる破損からetcdを保護できます。
etcdは、クライアントのトラフィックを受け付けるため、listen-client-urls
でリッスンします。etcdメンバーは、advertise-client-urls
に指定されたURLを、ほかのメンバー、プロキシー、クライアントに通知します。対象のクライアントからadvertise-client-urlsに到達できることを確認してください。リモートクライアントからetcdにアクセスする必要があるのに、advertise-client-urlsをlocalhostに設定したり、デフォルトのままにしたりするのは、よくある誤りです。
各マシンで、次のフラグを指定してetcdを起動します。
--initial-clusterで始まるコマンドラインパラメーターは、etcdの2回目以降の実行では無視されます。初回のブートストラップ後は、環境変数やコマンドラインフラグを削除してかまいません。後から構成を変更する場合(メンバーの追加や削除など)は、実行時構成
ガイドを参照してください。
TLS
etcdは、TLSプロトコルによる暗号化通信に対応します。TLSチャネルは、ピア間のクラスター内部通信とクライアントのトラフィックの両方を暗号化できます。このセクションでは、ピアとクライアントにTLSを使うクラスターの設定例を示します。etcdのTLS対応の詳細は、セキュリティーガイド を参照してください。
自己署名証明書
自己署名証明書を使うクラスターは、通信を暗号化するとともに接続を認証します。そのようなクラスターを起動するには、各メンバーが、共通のクラスターCA証明書(ca.crt)で署名された一意の鍵ペア(member.crt、member.key)を持ち、ピア接続とクライアント接続の両方に使用することを推奨します。証明書は、etcdのTLS設定例
に従って生成できます。
各マシンで、次のフラグを指定してetcdを起動します。
証明書の自動生成
暗号化通信が必要でも接続の認証は不要な場合、etcdに鍵を自動生成させることができます。初期化時に、各メンバーは通知するIPアドレスとホスト名に基づいて、自身の鍵を作成します。
各マシンで、次のフラグを指定してetcdを起動します。
エラーの例
次の例では、新しいホストをノード一覧に含めていません。新しいクラスターの場合は、初期クラスターメンバーの一覧に、このノードを追加しなければなりません。
この例では、ノードinfra0を、クラスター一覧のアドレス(10.0.1.10:2380)と異なるアドレス(127.0.0.1:2380)に割り当てようとしています。このノードが複数のアドレスでリッスンする場合は、すべてのアドレスを"initial-cluster"設定に反映しなければなりません。
異なる設定引数で構成されたピアがこのクラスターに参加しようとすると、etcdはクラスターIDの不一致を報告して終了します。
ディスカバリー
クラスターピアのIPアドレスを事前に把握できない場合があります。クラウドプロバイダーの利用時や、ネットワークがDHCPを使う場合にはよくあります。その場合は、静的構成を指定する代わりに、既存のetcdクラスターを使って新しいクラスターをブートストラップします。この処理を「ディスカバリー」と呼びます。
ディスカバリーには、次の2つの方法を使用できます。
- etcdディスカバリーサービス
- DNS SRVレコード
etcdディスカバリー
このセクションのディスカバリーサービスの例は、etcd 3.7で削除された旧v2プロトコルを説明しています。新しいv3.7クラスターには、v3ディスカバリー 、またはこのガイドの静的構成やDNS SRVによるブートストラップ方法を使用してください。
ディスカバリーサービスプロトコルの設計をより深く理解するには、そのドキュメント を参照することを推奨します。
ディスカバリーURLの有効期間
ディスカバリーURLは、etcdクラスターを一意に識別します。既存のURLを再利用せず、各etcdインスタンスで新しいURLを共有して、新しいクラスターをブートストラップします。
また、ディスカバリーURLはクラスターの初回ブートストラップにのみ使用することを推奨します。稼働開始後にメンバー構成を変更するには、実行時再構成 ガイドを参照してください。
独自のetcdディスカバリーサービス
ディスカバリーでは、既存のクラスターを使って新しいクラスターをブートストラップします。非公開のetcdクラスターを使う場合は、次のようにURLを作成します。
このURLにsizeキーを設定することで、想定するクラスターサイズが3のディスカバリーURLを作成します。
この場合に使用するURLはhttps://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83で、etcdメンバーは起動時にhttps://myetcd.local/v2/keys/discovery/6c007a14875d53d9bf0ef5a6fc0257c817f0fb83ディレクトリで登録を行います。
各メンバーのnameフラグには、異なる名前を指定しなければなりません。Hostnameやmachine-idが適しています。同じ名前を指定すると、重複によってディスカバリーが失敗します。
各メンバーで、対応するフラグを指定してetcdを起動します。
各メンバーは独自のetcdディスカバリーサービスに登録し、すべてのマシンの登録が完了するとクラスターを開始します。
公開etcdディスカバリーサービス
利用できる既存のクラスターがなければ、discovery.etcd.ioの公開ディスカバリーサービスを使います。“new"エンドポイントで専用のディスカバリーURLを作成するには、次のコマンドを使用します。
これにより、初期サイズが3メンバーのクラスターを作成します。サイズを指定しない場合は、デフォルトの3を使用します。
各メンバーのnameフラグには、異なる名前を指定しなければなりません。同じ名前を指定すると、重複によってディスカバリーが失敗します。Hostnameやmachine-idが適しています。
各メンバーで、対応するフラグを指定してetcdを起動します。
各メンバーはディスカバリーサービスに登録し、すべてのメンバーの登録が完了するとクラスターを開始します。
環境変数ETCD_DISCOVERY_PROXYを使うと、etcdはHTTPプロキシーを経由してディスカバリーサービスに接続します。
エラーと警告の例
ディスカバリーサーバーのエラー
警告
これは、このマシンではディスカバリーURLを無視するという、無害な警告です。
DNSディスカバリー
DNSのSRVレコード
をディスカバリーに使用できます。
--discovery-srvフラグで、ディスカバリー用SRVレコードを検索するDNSドメイン名を設定できます。
--discovery-srv example.comを指定すると、次の順にDNS SRVレコードを検索します。
- _etcd-server-ssl._tcp.example.com
- _etcd-server._tcp.example.com
_etcd-server-ssl._tcp.example.comが見つかると、etcdはTLSでのブートストラップを試みます。
クライアントがetcdクラスターを発見できるよう、次のDNS SRVレコードをこの順に検索します。
- _etcd-client._tcp.example.com
- _etcd-client-ssl._tcp.example.com
_etcd-client-ssl._tcp.example.comが見つかると、クライアントはSSL/TLSでetcdクラスターとの通信を試みます。
etcdでTLSを使う場合、SSL証明書のDNS SANにホスト名とともにディスカバリーSRVレコード(example.comなど)を含めなければなりません。含めないと、次のようなログメッセージを出力してクラスター構成に失敗します。
etcdで独自の認証局を使わずにTLSを使う場合、ディスカバリードメイン(example.comなど)はSRVレコードのドメイン(infra1.example.comなど)と一致しなければなりません。これは、別のドメインを指す偽のSRVレコードを使う攻撃を軽減するためです。そのドメインは、PKI上は有効な証明書を持っていても、未知の第三者に管理されている可能性があります。
-discovery-srv-nameフラグを使うと、ディスカバリーで問い合わせるSRV名に接尾辞を追加できます。
同じドメイン内の複数のetcdクラスターを区別するために使います。
たとえば、discovery-srv=example.comと-discovery-srv-name=fooを設定すると、次のDNS SRVクエリーを実行します。
- _etcd-server-ssl-foo._tcp.example.com
- _etcd-server-foo._tcp.example.com
DNS SRVレコードの作成
DNSを使ったetcdクラスターのブートストラップ
etcdのクラスターメンバーは、ドメイン名またはIPアドレスを通知できます。ブートストラップ処理はDNS Aレコードを解決します。
3.2以降、--listen-peer-urlsと--listen-client-urlsは、ネットワークインターフェースのバインドにドメイン名を指定すると拒否します(3.1では警告を出力します)。
--initial-advertise-peer-urlsの名前解決後のアドレスは、SRVターゲットを名前解決したアドレスのいずれかと一致しなければなりません。etcdメンバーは、このアドレスを読み取り、SRVレコードが定義するクラスターに属するかどうかを判断します。
ドメイン名の代わりにIPアドレスを使って、クラスターをブートストラップすることもできます。
v3.1.0以降(v3.2.9を除く)、etcd --discovery-srv=example.comをTLSとともに設定すると、サーバーは、提供された証明書のSubject Alternative Name(SAN)フィールドにルートドメインexample.comが含まれる場合にのみ、ピアやクライアントを認証します。DNS SRVに関する注意
を参照してください。
ゲートウェイ
etcdゲートウェイは、ネットワークデータをetcdクラスターに転送する単純なTCPプロキシーです。詳しくはゲートウェイガイド を参照してください。
プロキシー
以前のetcdリリースでは、--proxyによるv2専用のプロキシーモード
をサポートしていました。このモードは削除され、etcd 3.7では利用できません。v3 APIにはgRPCプロキシー
を使用してください。
過去のv2プロキシーのデプロイについては、etcd 2.3リリースのクラスター構成ドキュメント を参照してください。
14.5 - Kubernetes StatefulSetとしてのetcdクラスターの実行
以下では、Kubernetes StatefulSetで静的ブートストラップ手順 を実行する方法を示します。
マニフェストの例
このマニフェストには、Kubernetesに静的なetcdクラスターを配置するためのServiceとStatefulSetが含まれます。
マニフェストの内容をetcd.yamlというファイルにコピーすると、次のコマンドでクラスターに適用できます。
適用後、Podの準備が整うまで待ちます。
この例のコンテナにはetcdctlが含まれており、Pod内で直接呼び出せます。
自己署名証明書を使って配置するには、## TLSで始まるコメント内の設定見出しを参照し、コメントを外せる値を確認してください。cert-managerで証明書を生成する追加の手順は、後のセクションに記載しています。
証明書の生成
このセクションでは、Helm でcert-manager というOperatorをインストールします。
クラスターにcert-managerをインストールすると、クラスター内で自己署名証明書を生成できます。生成した証明書はSecretオブジェクトに格納され、コンテナ内にファイルとして配置できます。
cert-managerをインストールするhelmコマンドは次のとおりです。
自己署名証明書を生成するClusterIssuerの設定例です。
このマニフェストは、ClusterIssuerの"selfsigned"を参照して、クライアント証明書とサーバー証明書のCertificateオブジェクトを作成します。dnsNamesには、cert-managerが作成する証明書に対して有効なホスト名をすべて列挙することを推奨します。
14.6 - コンテナ内でのetcdクラスターの実行
このガイドでは、静的ブートストラップ手順 を使ってDockerでetcdを実行する方法を説明します。
Docker
Dockerホストの外部のクライアントにetcd APIを公開するには、コンテナのホストIPアドレスを使用します。IPアドレスの取得方法については、docker inspect
を参照してください。または、docker runコマンドに--net=hostフラグを指定し、コンテナを独立したネットワークスタックに配置しない方法もあります。
単一ノードのetcdの実行
etcdを構成する際は、ホストのIPアドレスを使用します。
etcdデータを保存するDockerボリュームを構成します。
etcdの最新バージョン(執筆時点ではv3.7.2)を実行します。
クラスターメンバーを一覧表示します。
3ノードのetcdクラスターの実行
APIバージョン3を使ってetcdctlを実行するには、次のようにします。
ベアメタル
ベアメタル上に3ノードのetcdクラスターを構築するには、baremetalリポジトリ の例が参考になります。
証明書ボリュームのマウント
etcdのリリースコンテナには、デフォルトのルート証明書が含まれていません。ルート認証局によって信頼された証明書でHTTPSを使う場合(ディスカバリーなど)は、etcdコンテナに証明書ディレクトリをマウントしてください。
以下のrktコマンドは過去の使用例です。このv2ディスカバリー設定はetcd 3.7では使用できません。現在の環境にデプロイする場合は、上の静的ブートストラップの例を参照してください。
以下のDockerの例は上で設定したNODE1を使い、静的ブートストラップによる証明書ボリュームのマウントを示します。
14.7 - 障害の種類
大規模なマシン環境では、障害は珍しくありません。ハードウェアやソフトウェアの不具合によって、マシンに障害が発生します。停電やネットワークの問題では、複数のマシンに同時に障害が発生します。異なる種類の障害が同時に起きることもあるため、起こり得る障害をすべて列挙することはほぼ不可能です。
このセクションでは障害を分類し、etcdがそれらに耐えるためにどのように設計されているかを説明します。ほとんどのユーザーは、個々の障害をいずれかの種類に当てはめられます。まれな障害やリカバリー不能な障害 に備え、etcdクラスターを必ずバックアップ してください。
少数のフォロワーの障害
フォロワーに障害が発生しても、障害が発生したメンバーがクラスター全体の半数未満で、リーダーが引き続き利用可能であれば、etcdクラスターは大きな支障なくリクエストを受け付け、処理を継続できます。たとえば、5メンバーのetcdクラスターでは、2つのフォロワーの障害はクラスターの動作に影響しません。ただし、クライアントは障害が発生したメンバーとの接続を失います。読み取りリクエストについては、クライアントライブラリがほかのメンバーに自動的に再接続し、ユーザーがこの中断を意識せずに済むようにすることを推奨します。運用担当者は、再接続によってほかのメンバーのシステム負荷が増加することを見込んでおく必要があります。
リーダーの障害
リーダーに障害が発生すると、etcdクラスターは新しいリーダーを自動的に選出します。障害直後に選出されるわけではありません。障害検出がタイムアウトに基づくため、新しいリーダーの選出には選挙タイムアウトとほぼ同じ時間がかかります。
リーダー選出中、クラスターは書き込みを処理できません。選出中に送られた書き込みリクエストは、新しいリーダーが選出されるまで処理キューで待機します。
古いリーダーに送信済みでも、まだコミットされていない書き込みは失われる可能性があります。新しいリーダーは、以前のリーダーの未コミットエントリーをすべて書き換えることができます。ユーザーから見ると、新しいリーダーの選出後に一部の書き込みリクエストがタイムアウトすることがあります。ただし、コミット済みの書き込みが失われることはありません。
新しいリーダーは、すべてのリースのタイムアウトを自動的に延長します。この仕組みにより、古いリーダーが付与したリースでも、付与されたTTLより前に期限切れになることを防ぎます。
過半数の障害
クラスターの過半数のメンバーに障害が発生すると、etcdクラスターは機能しなくなり、それ以上の書き込みを受け付けられません。
etcdクラスターが過半数の障害からリカバリーできるのは、過半数のメンバーが利用可能になってからです。過半数のメンバーがオンラインに戻れない場合、運用担当者は災害復旧 を開始してクラスターをリカバリーしなければなりません。
過半数のメンバーが稼働すると、etcdクラスターは新しいリーダーを自動的に選出し、正常な状態に戻ります。新しいリーダーは、すべてのリースのタイムアウトを自動的に延長します。この仕組みにより、サーバーが利用できないことによるリースの期限切れを防ぎます。
ネットワーク分断
ネットワーク分断は、少数のフォロワーの障害やリーダーの障害に似ています。分断によってetcdクラスターは、過半数のメンバーを持つ側と少数のメンバーを持つ側の2つに分かれます。過半数側は利用可能なクラスターとなり、少数側は利用できなくなります。etcdでは、メンバーの追加と削除を明示的に行い、その都度、現在の過半数のメンバーが変更を承認するため、「スプリットブレイン」は発生しません。
リーダーが過半数側にいる場合、過半数側から見ると少数のフォロワーの障害に相当します。リーダーが少数側にいる場合は、リーダーの障害に相当します。少数側のリーダーは退任し、過半数側が新しいリーダーを選出します。
ネットワーク分断が解消すると、少数側は過半数側のリーダーを自動的に認識し、自身の状態をリカバリーします。
ブートストラップ中の障害
クラスターのブートストラップは、必要なすべてのメンバーが正常に起動した場合にのみ成功します。ブートストラップ中に何らかの障害が発生した場合は、すべてのメンバーのデータディレクトリを削除し、新しいcluster-tokenまたは新しいディスカバリートークンでクラスターを再度ブートストラップしてください。
もちろん、稼働中のクラスターと同様に、ブートストラップに失敗したクラスターをリカバリーすることも可能です。ただし、リカバリーするデータがないため、そのクラスターをリカバリーするより、新しいクラスターをブートストラップするほうが、ほぼ常に時間もリソースも少なくて済みます。
14.8 - 災害復旧
etcdは、マシンの障害に耐えるよう設計されています。etcdクラスターは一時的な障害(マシンの再起動など)から自動的にリカバリーし、Nメンバーのクラスターでは最大*(N-1)/2の恒久的な障害に耐えます。ハードウェアの故障やディスク破損などでメンバーが恒久的に停止すると、そのメンバーはクラスターにアクセスできなくなります。クラスターが(N-1)/2*を超えるメンバーを恒久的に失うと、重大な障害となり、クォーラムを回復不能な形で失います。クォーラムを失うと、クラスターはコンセンサスに達することができず、更新を受け付け続けられません。
重大な障害からリカバリーするため、etcd v3はv3のキーデータを失わずにクラスターを再作成するスナップショットとリストア機能を提供します。v2のキーをリカバリーするには、v2管理ガイド を参照してください。
キー空間のスナップショット作成
クラスターのリカバリーには、まずetcdメンバーのキー空間のスナップショットが必要です。稼働中のメンバーからetcdctl snapshot saveコマンドで取得する方法と、etcdのデータディレクトリからmember/snap/dbファイルをコピーする方法があります。たとえば次のコマンドは、$ENDPOINTが提供するキー空間のスナップショットをsnapshot.dbファイルに保存します。
member/snap/dbファイルからスナップショットを取得すると、wal(先行書き込みログ)フォルダーには含まれていても、まだ書き込まれていないデータが失われる場合がある点に注意してください。
スナップショットの状態
スナップショットに含まれるリビジョンとハッシュを確認するには、etcdutl snapshot statusコマンドを使用できます。
クラスターのリストア
リビジョンの差
クラスターをリストアすると、既存のクライアントにはリビジョンが数百、数千も前に戻ったように見えることがあります。スナップショットには取得時点までのデータ履歴しか含まれず、現在の状態はそれより先に進んでいる可能性があるためです。
これは、etcdを使ってKubernetesを実行している場合に特に問題になります。コントローラーやOperatorは、ローカルキャッシュとして機能し、監視で更新通知を受けるinformersを使用することがあります。古いリビジョンにリストアすると、キャッシュが正しく更新されず、コントローラーが予測不能で不整合な動作をする可能性があります。
監視APIの利用者がいることがわかっている場合、etcdデータをローカルにキャッシュしている場合、またはKubernetesを使用している場合は、スナップショットからのリストアに、後述の「リビジョンの引き上げ」を使うことを強く推奨します。
スナップショットからのリストア
クラスターのリストアに必要なのは、1つのスナップショット「db」ファイルだけです。etcdutl snapshot restoreによるリストアは、新しいetcdデータディレクトリを作成します。すべてのメンバーで同じスナップショットを使ってリストアすることを推奨します。リストア時には、スナップショットの一部のメタデータ(具体的にはメンバーIDとクラスターID)を上書きし、メンバーは以前の識別情報を失います。この上書きによって、新しいメンバーが既存のクラスターに誤って参加することを防ぎます。したがって、スナップショットからクラスターを起動するには、新しい論理クラスターとしてリストアしなければなりません。
単純なリストアは次のように実行できます。
整合性チェック
リストア時には、任意でスナップショットの整合性を検証できます。etcdctl snapshot saveで取得したスナップショットには整合性ハッシュが含まれ、etcdutl snapshot restoreが検証します。データディレクトリからコピーしたスナップショットには整合性ハッシュがないため、リストアには--skip-hash-checkが必要です。
リビジョンを引き上げてリストア
リストア後にリビジョンが減少しないよう、--bump-revisionオプションを指定できます。このオプションは64ビット整数を受け取り、スナップショットの現在のリビジョンに加える数を表します。etcdへの書き込みごとにリビジョンは1増えるため、毎秒の書き込みが1500未満であれば、1'000'000'000引き上げることで1週間前のスナップショットにも対応できます。
Kubernetesコントローラーを使う場合は、--mark-compactedで引き上げ分も含めたすべてのリビジョンをコンパクション済みとしてマークすることも重要です。これにより、すべての監視を終了させ、スナップショット取得後に生じたリビジョンについてのリクエストにetcdが応答しないようにして、informerのキャッシュを事実上無効化します。
呼び出し全体の例は次のとおりです。
メンバー構成を更新してリストア
etcdクラスターのメンバー情報はetcd自身に保存され、Raftコンセンサスアルゴリズムで管理されます。クォーラムを完全に失った場合、たとえばまったく新しいメンバー群を使うなど、新しいクラスターをどこでどのように構成するかを見直すこともできます。
スナップショットからリストアするときは、次のように新しいメンバー構成をデータストアに直接指定できます。
これにより、新しく構成したクラスターは、指定されたトークンでリストアしたほかのメンバーだけに接続し、まだ稼働していて接続を試みる可能性がある古いメンバーには接続しません。
別の方法として、etcdの起動時に--force-new-clusterを指定し、既存のアプリケーションデータを保持したままメンバー構成を上書きできます。ただし、以前のクラスターのほかのメンバーがまだ稼働しているとパニックになるため、この方法は強く非推奨です。スナップショットを必ず定期的に保存してください。
一連の操作例
稼働中のクラスターから、次のようにスナップショットを取得します。
前の例に続いて、次のコマンドで3メンバーのクラスター用の新しいetcdデータディレクトリ(m1.etcd、m2.etcd、m3.etcd)を作成します。
次に、新しいデータディレクトリを指定してetcdを起動します。
これで、リストアしたetcdクラスターが利用可能になり、スナップショットのキー空間を提供しているはずです。
etcd v3.6以降、スナップショットの取得にはetcdctlだけを使用でき、スナップショットからのリストアにはetcdutlを使用します。--data-dirを指定しない場合、--data-dirのデフォルト値は<name>.etcdです(<name>は--nameの値)。たとえば、--data-dirを指定せず、メンバー名がm1、m2、m3であれば、--data-dirのディレクトリはm1.etcd、m2.etcd、m3.etcdになります。
14.9 - etcdゲートウェイ
etcdゲートウェイとは
etcdゲートウェイは、ネットワークデータをetcdクラスターに転送する単純なTCPプロキシーです。状態を持たず、透過的に動作し、クライアントのリクエストを検査したりクラスターのレスポンスに介入したりしません。TLS接続の終端、クライアントに代わるTLSハンドシェイク、接続が保護されているかの検証も行いません。
ゲートウェイは複数のetcdサーバーのエンドポイントに対応し、単純なラウンドロビン方式で動作します。利用可能なエンドポイントだけに転送し、クライアントが障害を意識せずに済むようにします。将来は、重み付きラウンドロビンなど、ほかの再試行方針に対応する可能性もあります。
etcdゲートウェイを使う場面
etcdにアクセスするすべてのアプリケーションは、まずetcdクラスターのクライアントエンドポイントのアドレスを把握しなければなりません。同じサーバー上の複数のアプリケーションが同じetcdクラスターにアクセスする場合も、それぞれがクラスターの通知するクライアントエンドポイントを知る必要があります。再構成によってetcdクラスターのエンドポイントが変わると、すべてのアプリケーションでエンドポイント一覧の更新が必要になる可能性があります。この広範囲の再構成は手間がかかり、誤りも生じやすい操作です。
etcdゲートウェイは、安定したローカルエンドポイントとして機能することで、この問題を解決します。典型的な構成では、各マシンでローカルアドレスをリッスンするゲートウェイを動かし、etcdを使う各アプリケーションはローカルのゲートウェイに接続します。その結果、個々のアプリケーションを更新せず、ゲートウェイのエンドポイントを更新するだけで済みます。
つまり、同じetcdクラスターにアクセスする複数のアプリケーションを実行する各マシンでetcdゲートウェイを動かすことで、クラスターのエンドポイント変更を自動的に反映できます。
etcdゲートウェイが適さない場面
- 性能の改善
ゲートウェイは、etcdクラスターの性能改善を目的として設計されていません。キャッシュ、監視の集約、バッチ処理は提供しません。etcdチームは、クラスターのスケーラビリティーを向上させるためのキャッシュプロキシーを開発しています。
- クラスター管理システム上での実行
Kubernetesのような高度なクラスター管理システムは、サービスディスカバリーを標準で提供します。アプリケーションは、システムが管理するDNS名や仮想IPアドレスでetcdクラスターにアクセスできます。たとえば、kube-proxyはetcdゲートウェイに相当します。
etcdゲートウェイの起動
次の静的エンドポイントを持つetcdクラスターを考えます。
| 名前 | アドレス | ホスト名 | ポート |
|---|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com | 2379 |
| infra1 | 10.0.1.11 | infra1.example.com | 2379 |
| infra2 | 10.0.1.12 | infra2.example.com | 2379 |
次のコマンドで、これらの静的エンドポイントを使用するetcdゲートウェイを起動します。
DNSでサービスディスカバリーを行う場合は、次のDNS SRVエントリーを考えます。
次のコマンドで、DNS SRVエントリーからエンドポイントを取得するetcdゲートウェイを起動します。
設定フラグ
etcdクラスター
–endpoints
- クライアント接続の転送先となるetcdサーバーを、カンマ区切りで指定します。
- デフォルト:
127.0.0.1:2379 - ポートを含めなければなりません。
- 無効な例:
https://127.0.0.1:2379(ゲートウェイはTLSを終端しません)。ゲートウェイはHTTPスキームの検証やリクエストの検査を行わず、指定されたエンドポイントにリクエストを転送するだけである点に注意してください。
–discovery-srv
- SRVレコードを通じてクラスターのエンドポイントをブートストラップするためのDNSドメイン。
- デフォルト:(未設定)
ネットワーク
–listen-addr
- クライアントのリクエストを受け付けるためにバインドするインターフェースとポート。
- デフォルト:
127.0.0.1:23790
–retry-delay
- 障害が発生したエンドポイントへの再接続を試みるまでの待機時間。
- デフォルト:1m0s
- 無効な例:“123”(時間の単位を含む形式が必要)
セキュリティー
–insecure-discovery
- 安全でない、または中間者攻撃を受けるおそれのあるSRVレコードを受け入れます。
- デフォルト:
false
–trusted-ca-file
- SRVディスカバリーが返すエンドポイントを検証するための、etcdクラスターのクライアントTLS CAファイルのパス。このファイルは発見したエンドポイントの認証にのみ使い、データ転送用の接続を作成するためには使わない点に注意してください。ゲートウェイはTLS接続を終端せず、クライアントに代わってTLS接続を作成することもありません。
- デフォルト:(未設定)
14.10 - gRPCプロキシー
gRPCプロキシーは、gRPC層(L7)で動作するステートレスなetcdリバースプロキシーです。中核となるetcdクラスターの処理負荷を減らすために設計されています。水平スケーラビリティーのために、監視APIとリースAPIのリクエストを集約します。また、過剰なリクエストを送るクライアントからクラスターを守るため、キー範囲のリクエストをキャッシュします。
gRPCプロキシーは、複数のetcdサーバーのエンドポイントに対応します。起動時に使用するエンドポイントをランダムに1つ選び、その障害を検出するまで、すべてのリクエストをそのエンドポイントで処理します。障害を検出すると、ほかに利用可能なエンドポイントがあれば切り替え、クライアントが障害を意識せずに済むようにします。将来は、重み付きラウンドロビンなど、ほかの再試行方針に対応する可能性もあります。
スケーラブルな監視API
gRPCプロキシーは、同じキーや範囲を監視する複数のクライアントウォッチャー(c-watchers)を、etcdサーバーに接続する1つのウォッチャー(s-watcher)に集約します。プロキシーは、s-watcherからのすべてのイベントをc-watchersに配信します。
N個のクライアントが同じキーを監視するとき、1つのgRPCプロキシーでetcdサーバーの監視負荷をNから1に減らせます。複数のgRPCプロキシーを配置すれば、サーバーの負荷をさらに分散できます。
次の例では、3つのクライアントがキーAを監視します。gRPCプロキシーは3つのウォッチャーを集約し、etcdサーバーに接続する1つのウォッチャーを作成します。
制限事項
複数のクライアントウォッチャーを効率よく1つに集約するため、gRPCプロキシーは可能であれば、新しいc-watchersを既存のs-watcherにまとめます。この集約先のs-watcherは、ネットワークの遅延やバッファー内の未配信イベントによって、etcdサーバーと同期していないことがあります。監視するリビジョンを指定しない場合、gRPCプロキシーはc-watcherがストアの最新リビジョンから監視を開始することを保証しません。たとえば、リビジョン1000のetcdサーバーをクライアントが監視すると、リビジョン1000から始まります。一方、gRPCプロキシーを介して監視すると、リビジョン990から始まる場合があります。
取り消しにも同様の制限があります。ウォッチャーを取り消したとき、etcdサーバーのリビジョンが取り消しレスポンスのリビジョンより大きい場合があります。
この2つの制限は、ほとんどの用途では問題にならないはずです。将来は、より正確なリビジョンのレスポンスを得るため、ウォッチャーにgRPCプロキシーを迂回させる追加オプションが用意される可能性があります。
スケーラブルなリースAPI
リースを維持するには、クライアントはetcdサーバーへのgRPCストリームを少なくとも1つ確立し、定期的にハートビートを送信しなければなりません。多くのクライアントにまたがって大量のリース操作が行われる場合、これらのストリームがCPUの過剰な使用につながることがあります。中核クラスターのストリーム総数を減らすため、プロキシーはリースストリームの集約に対応しています。
N個のクライアントがリースを更新するとき、1つのgRPCプロキシーでetcdサーバーのストリーム負荷をNから1に減らせます。gRPCプロキシーを追加し、複数のプロキシーにストリームをさらに分散することもできます。
次の例では、3つのクライアントが独立した3つのリース(L1、L2、L3)を更新します。gRPCプロキシーは、3つのクライアント側リースストリーム(c-streams)を、etcdサーバーに接続する1つのリース維持ストリーム(s-stream)に集約します。プロキシーは、クライアント側のリースハートビートをc-streamsからs-streamに転送し、対応するc-streamsにレスポンスを返します。
過剰なリクエストを送るクライアントからの保護
gRPCプロキシーは、一貫性の要件に違反しない場合に、リクエストのレスポンスをキャッシュします。これにより、高速なforループでリクエストを繰り返すクライアントからetcdサーバーを保護できます。
etcd gRPCプロキシーの起動
次の静的エンドポイントを持つetcdクラスターを考えます。
| 名前 | アドレス | ホスト名 |
|---|---|---|
| infra0 | 10.0.1.10 | infra0.example.com |
| infra1 | 10.0.1.11 | infra1.example.com |
| infra2 | 10.0.1.12 | infra2.example.com |
次のコマンドで、これらの静的エンドポイントを使用するetcd gRPCプロキシーを起動します。
etcd gRPCプロキシーは起動し、ポート2379でリッスンします。クライアントのリクエストは、上記の3つのエンドポイントのいずれかに転送されます。
プロキシーを通じてリクエストを送信します。
クライアントエンドポイントの同期と名前解決
プロキシーは、ユーザー定義のエンドポイントに書き込むことで、自身のエンドポイントをディスカバリー用に登録できます。これには2つの目的があります。1つは、クライアントがプロキシーのエンドポイント群と自身のエンドポイントを同期し、高可用性を得ることです。もう1つは、etcdのgRPC名前解決 にエンドポイントを提供することです。
ユーザー定義の接頭辞を指定して、プロキシーを登録します。
メンバー一覧を要求すると、プロキシーは自身のすべてのメンバーを返します。
これにより、クライアントはSyncを通じてプロキシーのエンドポイントを自動検出できます。
一方、リゾルバーの接頭辞を指定せずにプロキシーを構成すると、
grpc-proxyのメンバー一覧APIは、自身のadvertise-client-urlを返します。
名前空間
アプリケーションがキー空間全体を完全に制御できることを想定していても、etcdクラスターはほかのアプリケーションと共有している場合があります。すべてのアプリケーションが互いに干渉せずに動作できるよう、プロキシーはキー空間を分割し、各クライアントからはキー空間全体にアクセスできるように見せられます。--namespaceフラグを指定すると、プロキシーに入るすべてのクライアントリクエストのキーに、ユーザー定義の接頭辞を付けます。etcdクラスターへのアクセスはその接頭辞の配下に限定し、プロキシーが返すレスポンスからは接頭辞を取り除きます。クライアントには、接頭辞が存在しないように見えます。
プロキシーに名前空間を設定するには、--namespaceを指定して起動します。
以後、プロキシーへのアクセスには、etcdクラスター上で透過的に接頭辞が付きます。
TLSの終端
gRPCプロキシーで暗号化されていないローカルエンドポイントを提供し、保護されたetcdクラスターからのTLSを終端します。
試すには、まずクライアント接続にHTTPSを使う単一メンバーのetcdクラスターを起動します。
クライアントポートがHTTPSを提供していることを確認します。
次に、クライアント証明書を使ってetcdエンドポイントhttps://localhost:2379に接続し、localhost:12379でgRPCプロキシーを起動します。
最後に、HTTPでプロキシーにキーを書き込み、TLSの終端をテストします。
メトリクスと健全性
gRPCプロキシーは、--endpointsで指定したetcdメンバーの/healthとPrometheusの/metricsエンドポイントを公開します。--metrics-addrフラグで追加のURLを定義し、/metricsと/healthの両方に応答させることもできます。
既知の問題
プロキシーのメインインターフェースは、HTTP2とHTTP/1.1の両方を提供します。上記の例のようにTLSを設定したプロキシーのリッスンインターフェースにcURLなどのクライアントでアクセスする場合、/metricsや/healthを取得するには、リクエストでプロトコルをHTTP/1.1に明示的に設定する必要があります。--metrics-addrフラグによる追加インターフェースには、この要件はありません。
14.11 - ハードウェアの推奨事項
開発やテストでは、etcdは通常、限られたリソースでも問題なく動作します。ノートPCや安価なクラウドマシンでetcdを使って開発することも一般的です。ただし、etcdクラスターを本番運用する場合は、適切に管理するうえでハードウェアの指針が役立ちます。ここでの提案は厳格な規則ではなく、堅牢な本番環境を構築する出発点です。どの環境でも、本番運用前に想定ワークロードを再現してテストすることを推奨します。
CPU
大きなCPU処理能力を必要とするetcd環境は多くありません。一般的なクラスターは、2〜4コアあれば円滑に動作します。 数千のクライアントや毎秒数万のリクエストを処理する高負荷のetcd環境では、etcdがメモリからリクエストを処理できるため、CPUがボトルネックになりがちです。このような高負荷環境では、通常8〜16個の専用コアが必要です。
メモリ
etcdのメモリ使用量は比較的小さいものの、性能を発揮するには十分なメモリが必要です。etcdサーバーはキー・バリューデータを積極的にキャッシュし、残りのメモリの大半をウォッチャーの追跡に使います。通常は8GBで十分です。数千のウォッチャーと数百万のキーがある高負荷環境では、状況に応じて16GB〜64GBのメモリを割り当ててください。
ディスク
高速なディスクは、etcd環境の性能と安定性を左右する最も重要な要素です。
低速なディスクはetcdのリクエストのレイテンシーを増加させ、クラスターの安定性を損なう可能性があります。etcdのコンセンサスプロトコルはメタデータをログに永続化することに依存するため、過半数のクラスターメンバーがすべてのリクエストをディスクに書き込まなければなりません。さらにetcdは、このログを切り詰められるよう、自身の状態をディスクに増分でチェックポイント保存します。これらの書き込みに時間がかかりすぎると、ハートビートがタイムアウトして選挙が発生し、クラスターの安定性が損なわれることがあります。ディスクがetcdに十分な速度かどうかは、通常fio などのベンチマークツールで確認できます。例はこちら を参照してください。
etcdはディスクの書き込みレイテンシーの影響を非常に強く受けます。通常、逐次50 IOPS(たとえば7200 RPMのディスク)が必要です。高負荷のクラスターには、逐次500 IOPS(たとえば一般的なローカルSSDや高性能な仮想ブロックデバイス)を推奨します。多くのクラウドプロバイダーは逐次IOPSではなく並行IOPSを公表しており、公表値が逐次IOPSの10倍になる場合がある点に注意してください。実際の逐次IOPSを測定するには、diskbench やfio などのディスクベンチマークツールを推奨します。
etcdに必要なディスク帯域幅はそれほど大きくありませんが、帯域幅が大きいほど、障害が発生したメンバーがクラスターに追いつく際のリカバリー時間を短縮できます。通常、10MB/sあれば100MBのデータを15秒以内にリカバリーできます。大規模なクラスターでは、1GBのデータを15秒以内にリカバリーするため、100MB/s以上を推奨します。
可能であれば、etcdのストレージにはSSDを使用してください。SSDは通常、回転式ディスクより書き込みレイテンシーが低く、その変動も小さいため、etcdの安定性と信頼性が向上します。回転式ディスクを使う場合は、できる限り高速なもの(15,000 RPM)を選んでください。回転式ディスクでもSSDでも、RAID 0はディスク速度を上げる有効な方法です。クラスターメンバーが3つ以上ある場合、etcdの整合性を保ったレプリケーションで高可用性を実現できるため、ミラーリングやパリティーを使うRAIDは不要です。
ネットワーク
複数のメンバーを持つetcd環境では、高速で信頼性の高いネットワークが役立ちます。etcdは一貫性と分断耐性を両立させるため、分断を伴う障害が起こる信頼性の低いネットワークでは、可用性が低下します。レイテンシーが低ければ、etcdメンバー間で素早く通信できます。帯域幅が大きければ、障害が発生したメンバーのリカバリー時間を短縮できます。一般的なetcd環境には1GbEで十分です。大規模なetcdクラスターでは、10GbEネットワークで平均リカバリー時間を短縮できます。
レイテンシーの増加を避け、分断の可能性を減らすため、可能であればetcdメンバーを1つのデータセンター内に配置してください。別のデータセンターに障害ドメインを置く必要がある場合は、既存のデータセンターに近い場所を選んでください。複数のデータセンターにまたがる配置については、チューニング のドキュメントも参照してください。
ハードウェア構成例
以下に、AWSとGCE環境でのハードウェア構成例を示します。繰り返しになりますが、運用担当者は本番運用前に、想定ワークロードを再現してetcd環境をテストすることを推奨します。
これらの構成は、マシンをetcd専用に使うことを前提としています。同じマシンでほかのアプリケーションを動かすと、リソース競合が発生し、クラスターが不安定になる可能性があります。
小規模クラスター
小規模クラスターは、クライアント数100未満、毎秒のリクエスト数200未満で、保存するデータは100MB以下です。
アプリケーションのワークロード例:50ノードのKubernetesクラスター
| プロバイダー | タイプ | vCPUs | メモリ(GB) | 最大並行IOPS | ディスク帯域幅(MB/s) |
|---|---|---|---|---|---|
| AWS | m4.large | 2 | 8 | 3600 | 56.25 |
| GCE | n1-standard-2 + 50GB PD SSD | 2 | 7.5 | 1500 | 25 |
中規模クラスター
中規模クラスターは、クライアント数500未満、毎秒のリクエスト数1,000未満で、保存するデータは500MB以下です。
アプリケーションのワークロード例:250ノードのKubernetesクラスター
| プロバイダー | タイプ | vCPUs | メモリ(GB) | 最大並行IOPS | ディスク帯域幅(MB/s) |
|---|---|---|---|---|---|
| AWS | m4.xlarge | 4 | 16 | 6000 | 93.75 |
| GCE | n1-standard-4 + 150GB PD SSD | 4 | 15 | 4500 | 75 |
大規模クラスター
大規模クラスターは、クライアント数1,500未満、毎秒のリクエスト数10,000未満で、保存するデータは1GB以下です。
アプリケーションのワークロード例:1,000ノードのKubernetesクラスター
| プロバイダー | タイプ | vCPUs | メモリ(GB) | 最大並行IOPS | ディスク帯域幅(MB/s) |
|---|---|---|---|---|---|
| AWS | m4.2xlarge | 8 | 32 | 8000 | 125 |
| GCE | n1-standard-8 + 250GB PD SSD | 8 | 30 | 7500 | 125 |
特大規模クラスター
特大規模クラスターは、クライアント数が1,500を超え、毎秒のリクエスト数が10,000を超え、1GBを超えるデータを保存します。
アプリケーションのワークロード例:3,000ノードのKubernetesクラスター
| プロバイダー | タイプ | vCPUs | メモリ(GB) | 最大並行IOPS | ディスク帯域幅(MB/s) |
|---|---|---|---|---|---|
| AWS | m4.4xlarge | 16 | 64 | 16,000 | 250 |
| GCE | n1-standard-16 + 500GB PD SSD | 16 | 60 | 15,000 | 250 |
14.12 - 保守
概要
etcdクラスターの信頼性を維持するには、定期的な保守が必要です。etcdを使うアプリケーションの要件にもよりますが、通常は保守を自動化でき、停止や大幅な性能低下なしに実施できます。
etcdの保守はすべて、キー空間が消費するストレージリソースを管理するためのものです。キー空間のサイズを十分に管理できない場合に備え、ストレージ容量のクォータが設けられています。etcdメンバーの空き容量が少なくなると、クォータによってクラスター全体にアラームが発報され、システムは操作が制限された保守モードに移行します。キー空間への書き込み領域が不足しないよう、キー空間の履歴をコンパクションしなければなりません。ストレージ領域そのものは、etcdメンバーのデフラグメンテーションで回収できます。また、メンバーの状態のスナップショットを定期的にバックアップしておくと、操作ミスによる意図しない論理的なデータ損失や破損からリカバリーできます。
Raftログの保持
etcd --snapshot-countは、コンパクション前にメモリに保持する、適用済みRaftエントリーの数を設定します。--snapshot-countに達すると、サーバーはまずスナップショットのデータをディスクに永続化し、その後で古いエントリーを切り詰めます。遅いフォロワーがコンパクション済みのインデックスより前のログを要求すると、リーダーはスナップショットを送信し、フォロワーの状態を上書きさせます。
--snapshot-countを大きくすると、スナップショットまでに多くのRaftエントリーをメモリに保持するため、メモリ使用量の増大が繰り返し発生します
。リーダーが最新のRaftエントリーを長く保持する分、遅いフォロワーはリーダーのスナップショット作成前に追いつく時間を長く取れます。--snapshot-countは、メモリ使用量の増加と遅いフォロワーの可用性向上とのトレードオフです。
v3.2では、--snapshot-countのデフォルト値が10,000から100,000に変更されました
。v3.7.0のデフォルト値は10,000です。
性能面では、--snapshot-countを100,000より大きくすると、書き込みスループットに影響する可能性があります。メモリ上のオブジェクトが増えると、Go GCのマーク段階であるruntime.scanobject
が遅くなることがあり、メモリの回収頻度が下がると割り当ても遅くなります。性能はワークロードとシステム環境によって異なりますが、一般にコンパクションが頻繁すぎるとクラスターの可用性と書き込みスループットに影響します。頻度が低すぎても、Goのガベージコレクターに過大な負荷をかけるため有害です。詳しい調査結果は、etcdとRaftの性能特性の理解
を参照してください。
履歴のコンパクション:v3 APIキー・バリューデータベース
etcdはキー空間の履歴を正確に保持するため、性能低下や最終的なストレージ容量の枯渇を防ぐには、履歴を定期的にコンパクションすることを推奨します。キー空間の履歴をコンパクションすると、指定したリビジョンより前に置き換えられたキーの情報をすべて破棄します。これらのキーが使っていた領域は、キー空間への追加書き込みに利用できるようになります。
キー空間は、etcdの時間範囲に基づく履歴保持ポリシーで自動的にコンパクションすることも、etcdctlで手動実行することもできます。etcdctlでは処理を細かく制御できます。一方、自動コンパクションは、一定期間のキー履歴だけを必要とするアプリケーションに適しています。
etcdctlから開始するコンパクションは、次のように行います。
コンパクション対象のリビジョンより前のリビジョンにはアクセスできなくなります。
自動コンパクション
--auto-compaction-modeと--auto-compaction-retentionオプションで、キー空間を自動的にコンパクションするようetcdを設定できます。モードはperiodic(デフォルト)とrevisionの2種類です。
定期コンパクション
定期コンパクションでは、時間に基づく範囲のキー空間履歴を保持します。
保持値は、履歴をどれだけ残すかを指定します。レコードは、作成からおよそその期間が経過するまでコンパクションされません。そのため、遅いウォッチャーでも保持期間内であれば追いつくことができます。
保持期間が1時間より長い場合、etcdは保持期間全体の履歴を維持しながら、1時間ごとにコンパクションします。保持期間が1時間以下の場合は、その保持期間と同じ間隔でコンパクションします。
たとえば--auto-compaction-retention=10hでは、etcdは最初のコンパクションまで10時間待機し、その後は1時間ごとにコンパクションします。
推奨値は用途によって異なります。
- 同じキーを頻繁に更新する場合:
1hや30mなどの短い期間 - 更新が少ない場合:
24h、48h、72hなどの長い期間 - 汎用的なデフォルト:
10h
リビジョンによるコンパクション
リビジョンによるコンパクションでは、固定数のリビジョンを保持します。
etcdは5分ごとに確認し、"latest revision" - 1000のリビジョンを対象にコンパクションします。たとえば最新リビジョンが30000の場合、リビジョン29000を対象にコンパクションします。
デフラグメンテーション
キー空間をコンパクションした後、バックエンドデータベースに内部断片化が生じる場合があります。内部断片化した領域はバックエンドが自由に再利用できますが、ストレージ容量を消費し続けます。古いリビジョンのコンパクションは、バックエンドデータベースに隙間を残すことでetcdの内部断片化を引き起こします。この断片化した領域はetcdには利用できても、ホストのファイルシステムには利用できません。つまり、アプリケーションのデータを削除しても、ディスク領域は回収されません。
デフラグメンテーションは、このストレージ領域をファイルシステムに返します。クラスター全体でレイテンシーが急増するのを避けられるよう、メンバー単位で実行します。
etcdメンバーをデフラグメンテーションするには、etcdctl defragコマンドを使用します。
稼働中のメンバーに対するデフラグメンテーションは、状態の再構築中、システムのデータ読み書きをブロックする点に注意してください。
デフラグメンテーションのリクエストは、クラスター内で複製されません。リクエストはローカルノードだけに適用されます。--endpointsフラグにすべてのメンバーを指定するか、--clusterフラグでクラスターメンバーをすべて自動検出してください。
デフォルトのエンドポイントが属するクラスター内のすべてのエンドポイントに対して、デフラグメンテーションを実行します。
etcdが停止している間にデータディレクトリを直接デフラグメンテーションするには、次のコマンドを使用します。
容量クォータ
etcdの容量クォータは、クラスターの信頼性のある動作を確保します。クォータがなければ、etcdのキー空間が大きくなりすぎて性能が低下したり、ストレージ容量が尽きてクラスターが予測不能な動作をしたりする可能性があります。いずれかのメンバーでキー空間のバックエンドデータベースが容量クォータを超えると、etcdはクラスター全体にアラームを発報し、キーの読み取りと削除だけを受け付ける保守モードに移行します。キー空間に十分な空きを確保し、バックエンドデータベースをデフラグメンテーションし、容量クォータのアラームを解除して初めて、クラスターは通常の動作に戻れます。
etcdはデフォルトで、ほとんどのアプリケーションに適した控えめな容量クォータを設定します。コマンドラインで、バイト単位の値を設定することもできます。
次のループで容量クォータに達する状態を作れます。
キー空間の余分なデータを削除し、バックエンドデータベースをデフラグメンテーションすると、クラスターの使用量をクォータの範囲内に戻せます。
メトリクスetcd_mvcc_db_total_size_in_use_in_bytesは、履歴コンパクション後の実際のデータベース使用量を表します。一方、etcd_debugging_mvcc_db_total_size_in_bytesは、デフラグメンテーションを待つ空き領域を含むデータベースのサイズを表します。後者が増えるのは前者が後者に近づいたときだけです。つまり、両方がクォータに近い場合、容量クォータに達するのを防ぐため、履歴のコンパクションが必要です。
v3.4以降、etcd_debugging_mvcc_db_total_size_in_bytesはetcd_mvcc_db_total_size_in_bytesに改名されています。
Put/Txn/LeaseGrantリクエストでErrGRPCNoSpaceエラーが返っても、バックエンドでは書き込みが成功している場合があります。etcdはAPI層と内部のApply層で容量クォータをチェックしますが、Apply層はNOSPACEアラームを発報するだけで、トランザクションの進行をブロックしないためです。
スナップショットのバックアップ
etcdクラスターのスナップショットを定期的に作成すると、キー空間の永続的なバックアップになります。メンバーのバックエンドデータベースのスナップショットを定期的に取得することで、etcdクラスターを正常であると確認できた時点にリカバリーできます。
スナップショットはetcdctlで取得します。
14.13 - etcdの監視
各etcdサーバーは、クライアントポートのHTTPエンドポイントを通じて、ローカルの監視情報を提供します。監視データは、システムの健全性確認とクラスターのデバッグの両方に役立ちます。
デバッグエンドポイント
--log-level=debugを設定すると、etcdサーバーはクライアントポートの/debugパスでデバッグ情報を公開します。性能が低下し、ログ出力が多くなるため、--log-level=debugの設定には注意してください。
/debug/pprofは、Goランタイムの標準的なプロファイリング用エンドポイントです。CPU、ヒープ、ミューテックス、goroutineの使用状況を調査できます。たとえば次のgo tool pprofは、etcdが時間を費やしている関数の上位10件を取得します。
/debug/requestsエンドポイントでは、WebブラウザーでgRPCトレースと性能統計を確認できます。次は、キーabcに対するRangeリクエストの例です。
メトリクスエンドポイント
各etcdサーバーは、クライアントポートの/metricsパスでメトリクスを公開します。必要に応じて、--listen-metrics-urlsで指定した場所にも公開します。
メトリクスはcurlで取得できます。
ヘルスチェック
v3.3.0以降、--listen-metrics-urlsで指定した場所は、/metricsに加えて/healthエンドポイントにも応答します。これは、標準のエンドポイントに相互(クライアント)TLS認証を設定していても、ロードバランサーや監視サービスがヘルスチェックにアクセスする必要がある場合に役立ちます。
v3.4以降、/livezと/readyzの2つのエンドポイントが追加されています。
/livezは、プロセスが生存しているか、再起動が必要かを示します。/readyzは、プロセスがトラフィックを処理できる状態かを示します。
エンドポイントの設計の詳細は、KEP に記載されています。
各エンドポイントには複数の個別のヘルスチェックが含まれます。verboseパラメーターを使うと、チェックの詳細と状態を出力できます。例:
次のようなレスポンスが返ります。
HTTP APIでは、特定のチェックを除外することもできます。例:
Prometheus
etcdのメトリクスを取り込んで記録する最も簡単な方法は、Prometheus の監視サービスを実行することです。
まず、Prometheusをインストールします。
Prometheusのスクレイパーの対象に、etcdクラスターのエンドポイントを設定します。
Prometheusのハンドラーを設定します。
これで、Prometheusは10秒ごとにetcdのメトリクスを収集します。
アラート
etcd v3クラスター向けに、Prometheusのデフォルトアラート が用意されています。
用途に応じてjobラベルの調整が必要になる場合があります。これらのルールは単一のクラスターに適用するよう作られているため、クラスター固有のラベルを選ぶことを推奨します。
Grafana
Grafana にはPrometheus対応が組み込まれているため、Prometheusデータソースを追加するだけで使えます。
次に、デフォルトのetcdダッシュボードテンプレート
をインポートし、カスタマイズします。たとえば、Prometheusデータソース名がmy-etcdであれば、JSONのdatasourceフィールドの値もmy-etcdにする必要があります。
ダッシュボードの例:
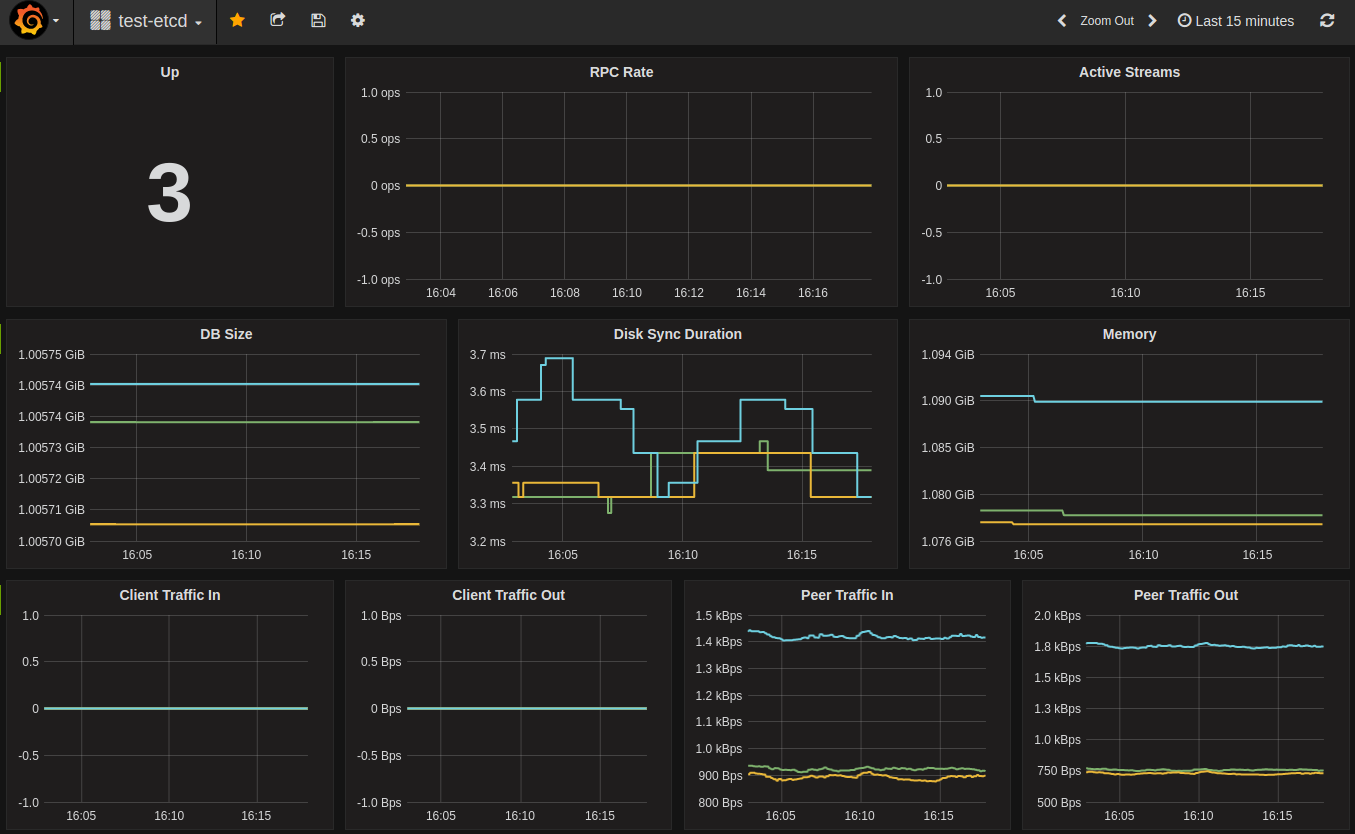
分散トレーシング
etcdはv3.5で、OpenTelemetry を使った分散トレーシングに対応しました。
etcd 3.7では、以下のトレーシング用フラグから以前のexperimental接頭辞を除いたものを使用してください。
分散トレーシングを有効にするには、etcdサーバーに--enable-distributed-tracing=trueを指定します。また、--distributed-tracing-sampling-rate=<number>フラグで、100万スパンあたりに収集するサンプル数を指定します。デフォルトのサンプリングレートは0です。
分散トレーシングを構成するには、次の任意のフラグを指定してetcdサーバーを起動します。
-
--distributed-tracing-address- (任意)- “localhost:4317” - トレースコレクターのアドレス。 -
--distributed-tracing-service-name- (任意)- “etcd” - 分散トレーシングのサービス名。すべてのetcdインスタンスで同じにしなければなりません。 -
--distributed-tracing-instance-id- (任意)- インスタンスID。任意ですが、設定を強く推奨します。etcdインスタンスごとに一意でなければなりません。
分散トレーシングを有効にする前に、OpenTelemetryのエンドポイントを用意してください。アドレスがデフォルトと異なる場合は、--distributed-tracing-addressフラグで上書きします。OpenTelemetryにはさまざまな実行方法があるため、詳しくはコレクターのドキュメント
を参照してください。
ほかの可観測性シグナルと同様に、リソースのオーバーヘッドがあります。初期の測定では、CPUのオーバーヘッドは2%〜4%になる可能性があります。
14.14 - 性能
性能を理解する
etcdは、高い性能を安定して持続的に提供します。性能を決める要素は、レイテンシーとスループットの2つです。レイテンシーは操作の完了にかかる時間で、スループットは一定期間内に完了する操作の総数です。etcdがクライアントのリクエストを並行して受け付ける場合、通常は全体のスループットが増えるにつれて平均レイテンシーも増加します。Google Compute Engine(GCE)の標準的なn-4や同等のAWSマシンタイプといった一般的なクラウド環境では、3メンバーのetcdクラスターは軽い負荷で1ミリ秒未満にリクエストを完了し、高負荷では毎秒30,000を超えるリクエストを完了できます。
etcdは、Raftコンセンサスアルゴリズムを使ってメンバー間でリクエストを複製し、合意に達します。コンセンサスの性能、特にコミットのレイテンシーは、ネットワークIOとディスクIOのレイテンシーという2つの物理的制約を受けます。etcdリクエストの完了に必要な最短時間は、メンバー間のネットワーク往復時間(RTT)と、fdatasyncがデータを永続ストレージにコミットする時間の合計です。データセンター内のRTTでも数百マイクロ秒かかる場合があります。米国内の一般的なRTTは約50msで、大陸間では400msほどかかる場合もあります。回転式ディスクの一般的なfdatasyncレイテンシーは約10msです。SSDでは、通常1ms未満です。etcdはスループットを向上させるため、複数のリクエストをまとめてRaftに渡します。このバッチ処理方針により、高負荷でも高いスループットを実現できます。
etcd全体の性能には、ほかのサブシステムも影響します。シリアライズされた各リクエストは、boltdbを基盤とするetcdのMVCCストレージエンジンを通る必要があり、通常は数十マイクロ秒かかります。etcdは、最近適用したリクエストの増分スナップショットを定期的に作成し、以前のディスク上のスナップショットにマージします。この処理によって、レイテンシーが急増する場合があります。SSDでは通常問題になりませんが、HDDでは観測されるレイテンシーが2倍になることがあります。同様に、実行中のコンパクションもetcdの性能に影響します。ただし、通常のリクエストとリソースを奪い合わないようコンパクションを分散して実行するため、その影響は多くの場合わずかです。RPCシステムのgRPCは、明確に定義された拡張可能なAPIをetcdに提供しますが、特にローカル読み取りでは追加のレイテンシーも生じます。
ベンチマーク
etcdに付属するbenchmark CLIツールで、etcdの性能を測定できます。
基準となる性能値を示すため、次のハードウェア構成の3メンバーのetcdクラスターを考えます。
- Google Cloud Compute Engine
- 8 vCPUs + 16GBメモリ + 50GB SSDのマシン3台
- 16 vCPUs + 30GBメモリ + 50GB SSDのマシン1台(クライアント)
- Ubuntu 17.04
- etcd 3.2.0、go 1.8.3
この構成でのetcdの書き込み性能は、およそ次のとおりです。
| キー数 | キーサイズ(バイト) | 値サイズ(バイト) | 接続数 | クライアント数 | 対象etcdサーバー | 平均書き込みQPS | リクエストあたりの平均レイテンシー | サーバーの平均RSS |
|---|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | リーダーのみ | 583 | 1.6ms | 48 MB |
| 100,000 | 8 | 256 | 100 | 1000 | リーダーのみ | 44,341 | 22ms | 124MB |
| 100,000 | 8 | 256 | 100 | 1000 | 全メンバー | 50,104 | 20ms | 126MB |
コマンド例は次のとおりです。
線形化可能読み取りリクエストは、最新のデータを取得するため、クラスターメンバーのクォーラムを通じてコンセンサスを得ます。直列化可能読み取りリクエストは、クォーラムではなく任意の単一etcdメンバーが処理するため、線形化可能読み取りより低コストですが、古いデータを返す可能性があります。etcdの読み取り性能は次のとおりです。
| リクエスト数 | キーサイズ(バイト) | 値サイズ(バイト) | 接続数 | クライアント数 | 一貫性 | 平均読み取りQPS | リクエストあたりの平均レイテンシー |
|---|---|---|---|---|---|---|---|
| 10,000 | 8 | 256 | 1 | 1 | 線形化可能 | 1,353 | 0.7ms |
| 10,000 | 8 | 256 | 1 | 1 | 直列化可能 | 2,909 | 0.3ms |
| 100,000 | 8 | 256 | 100 | 1000 | 線形化可能 | 141,578 | 5.5ms |
| 100,000 | 8 | 256 | 100 | 1000 | 直列化可能 | 185,758 | 2.2ms |
コマンド例は次のとおりです。
新しい環境に初めてetcdクラスターを構築する際は、十分な性能が得られることを確認するため、ベンチマークテストの実行を推奨します。クラスターのレイテンシーとスループットは、環境のわずかな違いにも影響されることがあります。
14.15 - 実行時再構成の設計
実行時再構成は、分散システム、とりわけetcdのようにコンセンサスに基づくシステムで、実装が最も難しく、誤りが生じやすい機能の1つです。
ここでは、etcdの実行時再構成コマンドの設計と、これらの問題への取り組みを説明します。
2段階の構成変更でクラスターの安全性を確保
etcdでは、安全性のため、すべての実行時再構成を2段階 で行う必要があります。たとえばメンバーを追加する場合は、まず新しい構成をクラスターに通知し、その後に新しいメンバーを起動します。
第1段階 - 新しい構成をクラスターに通知
etcdクラスターにメンバーを追加するには、APIを呼び出して、新しいメンバーの追加をクラスターに要求します。既存のクラスターに新しいメンバーを追加する方法はこれだけです。構成変更にクラスターが合意すると、API呼び出しが戻ります。
第2段階 - 新しいメンバーを起動
新しいetcdメンバーを既存のクラスターに参加させるには、正しいinitial-clusterを指定し、initial-cluster-stateをexistingに設定します。メンバーは起動時にまず既存のクラスターに接続し、現在のクラスター構成がinitial-clusterに指定された期待する構成と一致することを確認します。新しいメンバーが正常に起動すれば、クラスターは期待する構成に到達しています。
処理を明確な2段階に分けることで、ユーザーはクラスターメンバーの変更を明示的に行う必要があります。これにより、実際には柔軟性が増し、動作も把握しやすくなります。たとえば、etcdクラスターの既存メンバーと同じIDを持つ新しいメンバーを追加しようとすると、第1段階ですぐに失敗し、稼働中のクラスターには影響しません。誤って新しいメンバーを追加することも、同様の仕組みで防ぎます。クラスターが構成変更を受け入れる前に新しいetcdメンバーが参加しようとしても、クラスターは受け入れません。
クラスターメンバーの変更に明示的な手順がなければ、etcdでは意図しないメンバー変更が起こり得ます。たとえばsystemdなどのinitシステムの管理下でetcdを実行している場合、メンバーシップAPIで削除されたetcdが再起動し、起動時にクラスターへの再参加を試みます。障害時にetcdを再起動するようsystemdを設定していると、APIでメンバーを削除するたびにこのサイクルが繰り返され、意図しない動作になります。
実行時再構成は頻繁には行わない操作を想定しています。構成の安全性を確保し、明示的な管理の下でクラスターを常に円滑に稼働させるため、ユーザーが主導する明示的な操作としました。
クォーラムを恒久的に失った場合は新しいクラスターが必要
クラスターが過半数のメンバーを恒久的に失った場合、以前の状態をリカバリーするには、古いデータディレクトリから新しいクラスターを起動する必要があります。
障害が発生したメンバーを既存のクラスターから強制的に削除してリカバリーすることは、技術的には可能です。ただし、この方法は通常のコンセンサスによるコミット段階を迂回してしまい安全でないため、サポートしないことにしました。削除するメンバーが実際には停止していない場合や、同じクラスターの異なるメンバーを通じて強制削除した場合、同じclusterIDを持つクラスターの状態が分岐してしまいます。これは非常に危険で、後から原因を調査して修復することも困難です。
正しく配置されていれば、過半数を恒久的に失う可能性は非常に低くなります。それでも、特別な配慮が必要なほど重大な問題です。etcdを本番運用する前に、災害復旧のドキュメント を読み、過半数の恒久的な喪失に備えることを強く推奨します。
実行時再構成に公開ディスカバリーサービスを使わない
公開ディスカバリーサービスは、クラスターのブートストラップにのみ使用することを推奨します。既存のクラスターにメンバーを参加させるには、実行時再構成APIを使用してください。
ディスカバリーサービスは、すべてのメンバーのIPアドレスが事前にわからないクラウド環境で、etcdクラスターをブートストラップするために設計されています。クラスターのブートストラップが完了すると、すべてのメンバーのIPアドレスがわかるため、技術的にはディスカバリーサービスは不要になるはずです。
公開ディスカバリーサービスにはすべてのクラスター構成情報があるため、実行時再構成にも使うと便利に思えます。しかし、公開ディスカバリーサービスに依存すると、次の問題が生じます。
-
ブートストラップ時だけでなく、クラスターのライフサイクル全体に外部依存が生まれます。クラスターと公開ディスカバリーサービスの間でネットワークの問題が発生すると、クラスターも影響を受けます。
-
公開ディスカバリーサービスは、ライフサイクル全体を通じてクラスターの正しい実行時構成を反映しなければなりません。不正な操作を防ぐセキュリティーの仕組みが必要で、その実現は困難です。
-
公開ディスカバリーサービスは、数万のクラスター構成を保持する必要があります。私たちの公開ディスカバリーサービスのバックエンドは、その負荷に対応できる状態ではありません。
実行時再構成に対応するディスカバリーサービスが必要な場合は、専用の非公開サービスを構築するのが最適です。
14.16 - 実行時再構成
etcdは段階的な実行時再構成をサポートしており、稼働中にクラスターのメンバー構成を更新できます。
再構成リクエストを処理できるのは、クラスターメンバーの過半数が稼働している場合だけです。本番環境では、クラスターを常に2を超えるメンバーで構成することを強く推奨します。2メンバーのクラスターからメンバーを削除するのは安全ではありません。2メンバーのクラスターの過半数も2だからです。削除処理中に障害が発生すると、クラスターが処理を継続できなくなり、過半数の障害から再起動 する必要が生じる可能性があります。
実行時再構成の設計について理解を深めるには、実行時再構成の設計ドキュメント を参照してください。
再構成の用途
このセクションでは、クラスターを再構成する主な理由を説明します。多くの場合、後述のクラスター再構成の操作 で説明するメンバーの追加と削除を組み合わせるだけで対応できます。
複数マシンの入れ替えやアップグレード
計画保守(ハードウェアのアップグレード、ネットワーク停止など)で複数のクラスターメンバーを移動する必要がある場合は、1つずつ変更することを推奨します。
リーダーの削除は安全ですが、選挙中に短い停止時間が発生します。クラスターが50MBを超えるv2データを保持している場合は、メンバーのデータディレクトリの移行 を推奨します。
クラスターサイズの変更
クラスターサイズを大きくすると、耐障害性 と読み取り性能を向上できます。クライアントは任意のメンバーから読み取れるため、メンバーを増やすと、直列化可能読み取りの全体的なスループットが向上します。
クラスターサイズを小さくすると、耐障害性が低下する一方で、書き込み性能を向上できます。クラスターへの書き込みは、過半数のメンバーに複製されてからコミット済みと見なされます。クラスターサイズが小さくなると、過半数に必要な数が減るため、各書き込みをより早くコミットできます。
障害が発生したマシンの置き換え
ハードウェアの故障、データディレクトリの破損、その他の致命的な問題でマシンが停止した場合は、できるだけ早い置き換えを推奨します。障害が発生していても削除されていないマシンはクォーラムに悪影響を与え、追加の障害への耐性を低下させます。
マシンを置き換えるには、クラスターからのメンバー削除 の手順に従い、その後で代わりとなる新しいメンバーを追加 します。クラスターが50MBを超えるデータを保持しており、障害が発生したメンバーのデータディレクトリにまだアクセスできる場合は、そのデータディレクトリの移行 を推奨します。
過半数の障害からクラスターを再起動
クラスターの過半数を失った場合や、すべてのノードのIPアドレスが変わった場合は、安全なリカバリーのために手動操作が必要です。基本的な手順は、古いデータから新しいクラスターを作成 し、単一メンバーを強制的にリーダーとして動作させ、最後に実行時構成でそのクラスターに新しいメンバーを1つずつ追加 することです。
少数の障害からクラスターをリカバリー
特定のメンバーを失った場合は、障害が発生したマシンの置き換えと同じです。手順は障害が発生したマシンの置き換え に記載しています。
クラスター再構成の操作
上記の用途を踏まえて、それぞれの操作を説明します。
変更を行う前に、etcdメンバーの単純過半数(クォーラム)が利用可能でなければなりません。これは、etcdへのあらゆる書き込みに必要な条件と基本的に同じです。
クラスターへの変更は、すべて順番に行わなければなりません。
- 単一メンバーのpeerURLsを更新するには、更新操作を実行する
- 正常な単一メンバーを置き換えるには、古いメンバーを削除してから新しいメンバーを追加する
- メンバーを3から5に増やすには、追加操作を2回実行する
- メンバーを5から3に減らすには、削除操作を2回実行する
これらの例ではすべて、etcdに付属するコマンドラインツールetcdctlを使用します。etcdctlを使わずにメンバー構成を変更するには、v3 gRPCメンバーAPI
を使用してください。
メンバーの更新
通知するクライアントURLの更新
メンバーが通知するクライアントURLを更新するには、クライアントURLのフラグ(--advertise-client-urls)または環境変数(ETCD_ADVERTISE_CLIENT_URLS)を変更して、そのメンバーを再起動するだけです。再起動したメンバーは、更新後のURLを自動的に公開します。クライアントURLの更新を誤っても、etcdクラスターの健全性には影響しません。
通知するピアURLの更新
メンバーが通知するピアURLを更新するには、まずmemberコマンドで明示的に更新し、その後でメンバーを再起動します。ピアURLの更新はクラスター全体の構成を変え、健全性に影響する可能性があるため、この追加操作が必要です。
通知するピアURLを更新するには、まず対象メンバーのIDを確認します。etcdctlで全メンバーを一覧表示するには、次のようにします。
この例では、メンバーID a8266ecf031671f3をupdateし、そのpeerURLsをhttp://10.0.1.10:2380に変更します。
メンバーの削除
削除するメンバーIDがa8266ecf031671f3であるとします。removeコマンドで削除します。
対象メンバーはこの時点で自身を停止し、削除されたことをログに出力します。
リーダーの削除は安全ですが、新しいリーダーの選出中はクラスターが動作しません。この時間は、通常、選挙タイムアウトと投票処理の時間の合計です。
新しいメンバーの追加
メンバーの追加は、2段階で行います。
- v3 gRPCメンバーAPI
または
etcdctl member addコマンドで、新しいメンバーをクラスターに追加します。 - 更新後のメンバー一覧(既存メンバーと新しいメンバー)を含む新しいクラスター構成で、新しいメンバーを起動します。
etcdctlでは、メンバーの名前
と通知するピアURL
を指定して、クラスターに新しいメンバーを追加します。
etcdctlは新しいメンバーをクラスターに通知し、正常に起動するために必要な環境変数を出力しました。続いて、新しいメンバーに対応するフラグで新しいetcdプロセスを起動します。
新しいメンバーはクラスターの一員として稼働し、直ちにほかのメンバーへの追従を開始します。
複数のメンバーを追加する場合は、1つずつ構成し、正しく起動することを確認してから次を追加するのがベストプラクティスです。1ノードのクラスターに新しいメンバーを追加すると、コンセンサスに必要な過半数が2メンバーになるため、新しいメンバーが起動するまでクラスターは処理を進められません。この動作は、etcdctl member addが新しいメンバーをクラスターに通知してから、新しいメンバーが既存メンバーへの接続を確立するまでの間だけ発生します。
新しいメンバーを学習者メンバーとして追加
v3.4以降、etcdは新しいメンバーを学習者メンバー、つまり投票しないメンバーとして追加できます。 その背景と設計は、設計ドキュメント を参照してください。 追加処理の安全性を高め、追加時のクラスター停止時間を減らすため、新しいメンバーは追従が完了するまで学習者メンバーとして追加することを推奨します。手順は次の3段階です。
-
gRPCメンバーAPI または
etcdctl member add --learnerコマンドで、新しいメンバーを学習者メンバーとして追加します。 -
更新後のメンバー一覧(既存メンバーと新しいメンバー)を含む新しいクラスター構成で、新しいメンバーを起動します。 この手順は前述とまったく同じです。
-
gRPCメンバーAPI または
etcdctl member promoteコマンドで、新しく追加した学習者メンバーを投票メンバーに昇格させます。 etcdサーバーは、操作の安全性を確保するため、昇格リクエストを検証します。 学習者メンバーは、そのRaftログがリーダーに追いついてからでなければ、投票メンバーに昇格できません。 リーダーのRaftログに追いついていない場合、昇格リクエストは失敗します(詳しくはメンバー昇格時のエラー を参照)。 この場合は、待ってから再試行することを推奨します。
v3.4では、etcdサーバーはクラスター内の学習者メンバー数を1つに制限します。主な目的は、リーダーから学習者メンバーへのデータ配信による、リーダーの追加負荷を抑えることです。
etcdctl member addに--learnerフラグを指定し、新しいメンバーを学習者メンバーとしてクラスターに追加します。
新しく追加した学習者メンバーのetcdプロセスを起動した後、etcdctl member promoteで投票メンバーに昇格させます。
メンバー追加時のエラー
次の例では、新しいホストがノード一覧に含まれていません。新しいクラスターの場合は、初期クラスターメンバーの一覧にこのノードを追加しなければなりません。
この失敗例では、登録したピアアドレス(10.0.1.13:2380)とは異なるアドレス(10.0.1.14:2380)でメンバーを起動しています。
削除済みメンバーのデータディレクトリを使ってetcdを起動すると、クラスター内の稼働中メンバーに接続した時点で、etcdは自動的に終了します。
学習者メンバー追加時のエラー
すでに学習者メンバーが1つあるクラスターには、学習者メンバーを追加できません(v3.4)。
学習者メンバー昇格時のエラー
学習者メンバーを投票メンバーに昇格できるのは、リーダーと同期している場合だけです。
学習者メンバーでないメンバーの昇格は失敗します。
クラスターに存在しないメンバーの昇格は失敗します。
厳格な再構成チェックモード(-strict-reconfig-check)
前述のとおり、新しいメンバーを追加するときは、1つずつ構成し、正しく起動することを確認してから次を追加するのがベストプラクティスです。新しいメンバーの設定が正しくないと(ピアURLの誤りなど)、クラスターがクォーラムを失う可能性があるため、この段階的な方法は非常に重要です。ほかの既存メンバーから新しいメンバーに到達できなくても、新しいメンバーはクォーラムの計算に含まれるため、クォーラムを失うことになります。接続の問題や運用上の問題でも、クォーラムを失う可能性があります。
この問題を防ぐため、etcdは-strict-reconfig-checkオプションを提供します。このオプションを指定すると、再構成後のクラスターのクォーラムに必要な数より起動済みメンバーが少なくなる再構成リクエストを、etcdは拒否します。
このオプションは、デフォルトで有効です。
14.17 - サポート対象プラットフォーム
サポート階層
etcdはさまざまなプラットフォームで動作しますが、保証の内容はプラットフォームのサポート階層によって異なります。
- 階層1:etcdメンテナー が完全にサポートします。機能テストと堅牢性テストを含むすべてのテストに合格することを保証します。
- 階層2:統合テストとエンドツーエンドテストへの合格を保証しますが、機能テストや堅牢性テストに合格するとは限りません。
- 階層3:ビルドできることを保証します。簡単なテストしか行っていない、またはテストしていない可能性があるため、不安定なものとして扱うことを推奨します。
現在のサポート状況
次の表は、現在サポートされているプラットフォームと、それぞれのetcdサポート階層を示します。
| アーキテクチャー | オペレーティングシステム | サポート階層 | メンテナー |
|---|---|---|---|
| AMD64 | Linux | 1 | etcdメンテナー |
| ARM64 | Linux | 1 | etcdメンテナー |
| AMD64 | Darwin | 3 | |
| ARM64 | Darwin | 3 | |
| AMD64 | Windows | 3 | |
| ppc64le | Linux | 3 | |
| s390x | Linux | 3 |
表にないプラットフォームはサポート対象外です。
新しいプラットフォームのサポート
新しいプラットフォームの「公式」メンテナーとしてetcdに貢献する場合、プラットフォームのサポートを継続して担うとともに、サポート階層に応じて次の要件を満たすetcdの継続的インテグレーション(CI)を構築しなければなりません。
| etcdの継続的インテグレーション | 階層1 | 階層2 | 階層3 |
|---|---|---|---|
| ビルドの成功 | ✓ | ✓ | ✓ |
| 単体テストの合格 | ✓ | ✓ | |
| 統合テストとエンドツーエンドテストの合格 | ✓ | ✓ | |
| 堅牢性テストの合格 | ✓ |
ARM64向けの階層2のCIを構築した例は、etcd PR #12928 を参照してください。
サポート対象外のプラットフォーム
サポート対象外のプラットフォームでetcdサーバーを誤って実行することを防ぐため、環境変数ETCD_UNSUPPORTED_ARCHに対象アーキテクチャーが設定されていない限り、etcdは警告メッセージを表示して直ちに終了します。
32ビットシステム etcdには、Goランタイムのバグによる32ビットシステムでの既知の問題があります。 詳しくは、Goのissue #599 とatomicパッケージのバグに関する注記 を参照してください。
14.18 - バージョン管理
このドキュメントでは、etcdプロジェクトでサポートされるバージョンについて説明します。
サービスのバージョン管理とサポート対象バージョン
etcdのバージョンは、セマンティックバージョニング の用語に従い、x.y.zと表記します。xはメジャーバージョン、yはマイナーバージョン、zはパッチバージョンです。新しいマイナーバージョンでは、APIに機能が追加される場合があります。
etcdプロジェクトでは、現行バージョンとその前のリリースのリリースブランチを保守します。たとえば、v3.5が現行バージョンの場合、v3.4もサポートされます。v3.6がリリースされると、v3.4のサポートは終了します。
セキュリティー修正を含む適用可能な修正は、重大度と実現可能性に応じて、これら2つのリリースブランチにバックポートされる場合があります。必要に応じて、これらのブランチからパッチリリースを作成します。
この判断は、プロジェクトのメンテナー が行います。
稼働中のetcdクラスターのバージョンは、etcdctlで確認できます。
APIのバージョン管理
v3 APIのレスポンスは、3.0.0リリース以降は変更されない想定ですが、新機能は今後も追加されます。
14.19 - データ破損
etcdには、メンバー間で状態が分岐することを防ぐため、データ破損の自動検出機能が組み込まれています。
etcd 3.7では、以下のフィーチャーゲートと時間間隔フラグを使用してください。以前の実験的なデータ破損チェック用フラグは削除されています。設定オプション を参照してください。
データ破損検出の有効化
データ破損は、次の方法で検出できます。
- 初期チェック。
--feature-gates=InitialCorruptCheck=trueフラグで有効にします。 - 次の定期チェック。
- コンパクション済みリビジョンのハッシュ。
--feature-gates=CompactHashCheck=trueフラグで有効にします。 - 最新リビジョンのハッシュ。
--corrupt-check-timeフラグで有効にします。
- コンパクション済みリビジョンのハッシュ。
初期チェックは、etcdメンバーのブートストラップ中に実行します。 メンバーは自身の永続状態をほかのメンバーと比較し、不一致があれば終了します。
両方の定期チェックは、稼働中のクラスターでリーダーが実行します。 リーダーは自身の永続状態をほかのメンバーと比較し、不一致があればCORRUPT ALARMを発報します。 両チェックの目的は同じですが、性能と検出までの時間のバランスを取るため、両方を有効にする価値があります。
- コンパクション済みリビジョンのハッシュチェック - 定期的なコンパクションが必要です。性能への負荷はごく小さく、遅いフォロワーにも対応します。
- 最新リビジョンのハッシュチェック - 性能への負荷が高く、遅いフォロワーや頻繁なコンパクションには対応しません。
コンパクション済みリビジョンのハッシュチェック
--feature-gates=CompactHashCheck=trueフラグで有効にすると、1分ごとにチェックを実行します。
間隔は--compact-hash-check-timeフラグで調整できます。形式は1mが毎分、1hが毎時です。
このチェックはコンパクション処理を拡張し、クラスターメンバー間で比較できるチェックサムも計算します。
データベースの追加スキャンを行わないため負荷は非常に小さいものの、クラスターで定期的にコンパクションを行う必要があります。
最新リビジョンのハッシュチェック
--corrupt-check-timeフラグで有効にします。実行間隔の指定が必要で、形式は1mが毎分、1hが毎時です。
性能への負荷が高いため、数時間の間隔を推奨します。
チェックでは、指定リビジョンのetcdの全内容をスキャンしてチェックサムを計算する必要があります。
破損したメンバーのリストア
破損したメンバーをリストアする方法は3つあります。
- メンバーの永続状態を消去する
- メンバーを置き換える
- クラスター全体をリストアする
破損したメンバーをリストアした後、CORRUPT ALARMを解除できます。
メンバーの永続状態の消去
次の手順でメンバーの状態を消去できます。
- etcdインスタンスを停止します。
- etcdのデータディレクトリをバックアップします。
- etcdのデータディレクトリから
snapサブディレクトリを移動します。 --initial-cluster-state=existingを指定し、--initial-clusterにクラスターメンバーを列挙してetcdを起動します。
etcdメンバーは、リーダーから最新のスナップショットをダウンロードするはずです。
メンバーの置き換え
次の手順でメンバーを置き換えられます。
- etcdインスタンスを停止します。
- etcdのデータディレクトリをバックアップします。
- データディレクトリを削除します。
etcdctl member removeを実行し、クラスターからメンバーを削除します。etcdctl member addを実行し、メンバーを再度追加します。--initial-cluster-state=existingを指定し、--initial-clusterにクラスターメンバーを列挙してetcdを起動します。
クラスター全体のリストア
現在のリーダーからスナップショットを保存し、すべてのメンバーにリストアすることで、クラスターをリストアできます。
リーダーに対してetcdctl snapshot saveを実行し、クラスターのリストア手順
に従ってください。
15 - ベンチマーク
ベンチマーク
etcdのベンチマークは定期的に公開され、以下の各リリースについて追跡されます。
メモリー使用量のベンチマーク
さまざまなシナリオで想定されるメモリー使用量を記録します。
15.1 - ストレージのメモリー使用量ベンチマーク
etcdのストレージでは、2つの構成要素が物理メモリーを消費します。etcdプロセスは、キーの検索を高速化するためにインメモリーインデックスを割り当てます。また、オペレーティングシステムが管理するプロセスのページキャッシュには、最近ディスクから読み込んだデータが保存され、すばやく再利用できます。
インメモリーインデックスは、ディスク上のデータ(値)へのポインターとともに、すべてのキーをB木 のデータ構造で保持します。B木の各キーには、値の異なるバージョンを指す複数のポインターが含まれる場合があります。そのため、インメモリーインデックスの理論上のメモリー消費量は、次の式で近似できます。
N * (c1 + avg_key_size) + N * (avg_versions_of_key) * (c2 + size_of_pointer)
ここで、c1はキーのメタデータのオーバーヘッド、c2はバージョンのメタデータのオーバーヘッドです。
次の図は、インメモリーインデックスのB木の詳細な構造を示します。
ページキャッシュのメモリー はオペレーティングシステムが管理するため、このドキュメントでは詳しく扱いません。
テスト環境
etcdのバージョン
GCEのn1-standard-2マシンタイプ
- メモリー:7.5 GB
- CPU:2基
インメモリーインデックスのメモリー使用量
このテストでは、インメモリーインデックスのメモリー使用量のみを測定します。目的は、前述のc1とc2を求め、ストレージのメモリー消費量の厳密な限界を把握することです。
Goのruntime.ReadMemStatsを使い、インデックス作成前後の総割り当てバイト数の差から、メモリー消費量を算出します。インメモリーインデックス自体の使用量を完全に反映するわけではありませんが、おおよその消費傾向を把握できます。
| N | バージョン数 | キーサイズ | メモリー使用量 |
|---|---|---|---|
| 100K | 1 | 64bytes | 22MB |
| 100K | 5 | 64bytes | 39MB |
| 1M | 1 | 64bytes | 218MB |
| 1M | 5 | 64bytes | 432MB |
| 100K | 1 | 256bytes | 41MB |
| 100K | 5 | 256bytes | 65MB |
| 1M | 1 | 256bytes | 409MB |
| 1M | 5 | 256bytes | 506MB |
結果から、c1=120bytes、c2=30bytesと計算できます。式の未知数はこの2つだけなので、c1とc2の算出には2組のデータだけが必要です。c1=120bytesとc2=30bytesは、計算した4組のc1とc2の平均値です。小さなキー・バリューペアに対しては、キーのメタデータのオーバーヘッドは依然として無視できない大きさ(50%)です。しかし、少なくとも1000%のオーバーヘッドがあった旧ストアからは大幅に改善しています。
全体のメモリー使用量
全体のメモリー使用量は、ストレージを含めたetcdのRSS消費量を測定したものです。値はディスクに保存し、頻繁に使う値だけをOSのページキャッシュで管理するメモリーに保持するため、値のサイズがetcd全体のメモリー使用量に与える影響はごく小さいはずです。
| N | バージョン数 | キーサイズ | 値のサイズ | メモリー使用量 |
|---|---|---|---|---|
| 100K | 1 | 64bytes | 256bytes | 40MB |
| 100K | 5 | 64bytes | 256bytes | 89MB |
| 1M | 1 | 64bytes | 256bytes | 470MB |
| 1M | 5 | 64bytes | 256bytes | 880MB |
| 100K | 1 | 64bytes | 1KB | 102MB |
| 100K | 5 | 64bytes | 1KB | 164MB |
| 1M | 1 | 64bytes | 1KB | 587MB |
| 1M | 5 | 64bytes | 1KB | 836MB |
結果から、値のサイズはメモリー消費量に大きな影響を与えないことがわかります。OSのページキャッシュに保持されるデータが増えるため、わずかな増加は見られます。
15.2 - 監視のメモリー使用量ベンチマーク
監視機能は活発に開発されているため、開発が進むにつれてメモリー使用量が変わる可能性があります。ただし、以下の数値を大幅に超えて増えることは想定していません。
etcdの主な目標の1つは、非常に多くのウォッチャーが膨大な数の監視を行えるようにすることです。etcdは、O(10k)のクライアント、O(100K)の監視ストリーム(クライアントあたりO(10)ストリーム)、合計O(10M)の監視(ストリームあたりO(100)の監視)への対応を目指しています。個々の監視が消費するメモリーは、etcd全体の使用量の中で最も大きな割合を占めるため、現在および今後の最適化の重点となっています。
etcdの監視では、関連する3つの構成要素、すなわち各grpc.Conn、各監視ストリーム、各監視インスタンスが物理メモリーを消費します。grpc.Connは実際のTCP接続とその他のgRPC接続状態を保持します。各grpc.ConnはO(10kb)のメモリーを消費し、複数の監視ストリームが接続されることがあります。
各監視ストリームは独立したHTTP2接続で、さらにO(10kb)のメモリーを消費します。 複数の監視で1つの監視ストリームを共有できます。
監視インスタンスは、キー・バリューストアの変更を追跡する実際の構造体です。各監視のメモリー消費量はO(1kb)未満に収まるはずです。
監視の理論上のメモリー消費量は、次の式で近似できます。
memory = c1 * number_of_conn + c2 * avg_number_of_stream_per_conn + c3 * avg_number_of_watch_stream
テスト環境
etcdのバージョン
GCEのn1-standard-2マシンタイプ
- メモリー:7.5 GB
- CPU:2基
全体のメモリー使用量
全体のメモリー使用量は、クライアントのウォッチャーを接続したetcdが消費するRSS を測定したものです。結果には最大10%程度のばらつきがありますが、おおよそのメモリー使用量と割り当ての傾向を把握するという目的には意味があります。
ベンチマーク結果から、おおよそc1 = 17kb、c2 = 18kb、c3 = 350bytesと計算できます。つまり、クライアント接続を1つ追加すると17kb、ストリームを1つ追加すると18kbのメモリーを消費しますが、監視を1つ追加したときの消費量はわずか350bytesです。通常、1台のetcdサーバーで、数GBのメモリーを使って数百万の監視を維持できます。
| クライアント数 | クライアントあたりのストリーム数 | ストリームあたりの監視数 | 監視の総数 | メモリー使用量 |
|---|---|---|---|---|
| 1k | 1 | 1 | 1k | 50MB |
| 2k | 1 | 1 | 2k | 90MB |
| 5k | 1 | 1 | 5k | 200MB |
| 1k | 10 | 1 | 10k | 217MB |
| 2k | 10 | 1 | 20k | 417MB |
| 5k | 10 | 1 | 50k | 980MB |
| 1k | 50 | 1 | 50k | 1001MB |
| 2k | 50 | 1 | 100k | 1960MB |
| 5k | 50 | 1 | 250k | 4700MB |
| 1k | 50 | 10 | 500k | 1171MB |
| 2k | 50 | 10 | 1M | 2371MB |
| 5k | 50 | 10 | 2.5M | 5710MB |
| 1k | 50 | 100 | 5M | 2380MB |
| 2k | 50 | 100 | 10M | 4672MB |
| 5k | 50 | 100 | 25M | OOM |
15.3 - etcd v3のベンチマーク
物理マシン
GCE n1-highcpu-2マシンタイプ
- /var/lib/etcdにマウントした専用ローカルSSD × 1
- OS用の専用低速ディスク × 1
- メモリー1.8 GB
- CPU × 2
- etcdバージョン2.2.0
etcdクラスター
v3デモモードで稼働するetcdメンバー1つ
テスト
etcd v3ベンチマークツール を使用します。
性能
単一キーの読み取り
| キーサイズ(バイト) | クライアント数 | 読み取りQPS | 90パーセンタイルのレイテンシー(ms) |
|---|---|---|---|
| 256 | 1 | 2716 | 0.4 |
| 256 | 64 | 16623 | 6.1 |
| 256 | 256 | 16622 | 21.7 |
空のサーバーハンドラーを使用した場合と、ほぼ同じ性能です。
書き込み後の単一キーの読み取り
| キーサイズ(バイト) | クライアント数 | 読み取りQPS | 90パーセンタイルのレイテンシー(ms) |
|---|---|---|---|
| 256 | 1 | 2269 | 0.5 |
| 256 | 64 | 13582 | 8.6 |
| 256 | 256 | 13262 | 47.5 |
空のサーバーハンドラーを使用した場合、1回のputによって性能は変わりません。したがって、性能低下の原因はストレージパッケージにあると考えられます。
15.4 - etcd v2.2.0-rc-memoryのベンチマーク
物理マシン
GCE n1-standard-2マシンタイプ
- /var/lib/etcdにマウントした専用ローカルSSD × 1
- OS用の専用低速ディスク × 1
- メモリー7.5 GB
- CPU × 2
etcd
テスト
各メンバーが2コアを使用する3メンバーのetcdクラスターを起動します。
キー名の長さは常に64バイトとします。これは、キーの平均的なバイト長として妥当な長さです。
最大メモリー使用量
- フォロワーの1つが停止し、リーダーがスナップショットを送信し続けると、etcdのメモリー使用量が最大になる場合があります。
max RSSは、3回の実行で記録された最大メモリー使用量です。
| 値のバイト数 | キー数 | データサイズ(MB) | 最大RSS(MB) | リーダーの最大RSSとデータサイズの比率 |
|---|---|---|---|---|
| 128 | 50000 | 6 | 433 | 72x |
| 128 | 100000 | 12 | 659 | 54x |
| 128 | 200000 | 24 | 1466 | 61x |
| 1024 | 50000 | 48 | 1253 | 26x |
| 1024 | 100000 | 96 | 2344 | 24x |
| 1024 | 200000 | 192 | 4361 | 22x |
データサイズのしきい値
- etcdのデータサイズがしきい値に達すると、リーダー選出が起こりやすくなり、提案の一部が破棄される場合があります。
- ほとんどの場合、しきい値に達していなければetcdクラスターは問題なく動作するはずです。リソース不足によって正常に動作しない場合は、データサイズを減らしてください。
| 値のバイト数 | キー数の上限 | 推奨データサイズしきい値(MB) | 使用RSS(MB) |
|---|---|---|---|
| 128 | 400K | 48 | 2400 |
| 1024 | 300K | 292 | 6500 |
15.5 - etcd v2.2.0-rcのベンチマーク
物理マシン
GCEのn1-highcpu-2マシンタイプ
- /var/lib/etcdにマウントした専用ローカルSSD:1台
- OS用の専用低速ディスク:1台
- メモリー:1.8 GB
- CPU:2基
etcdクラスター
etcd 2.2.0-rcメンバー3つを、それぞれ別のマシンで実行します。
バージョンの詳細:
比較の基準となる性能を測るため、alpha段階のetcd 2.1.0メンバー3つでもクラスターを構成します。etcdのコミットはc7146bd5 で、etcd 2.1のベンチマーク で使用したものと同じです。
テスト
別のマシンを起動し、hey HTTPベンチマークツール を使って各etcdメンバーにリクエストを送信します。詳しい手順はベンチマーク開発ガイド を参照してください。
性能
単一キーの読み取り
| キーサイズ(バイト) | クライアント数 | 対象のetcdサーバー | 読み取りQPS | 90パーセンタイルレイテンシー(ms) |
|---|---|---|---|---|
| 64 | 1 | リーダーのみ | 2804 (-5%) | 0.4 (+0%) |
| 64 | 64 | リーダーのみ | 17816 (+0%) | 5.7 (-6%) |
| 64 | 256 | リーダーのみ | 18667 (-6%) | 20.4 (+2%) |
| 256 | 1 | リーダーのみ | 2181 (-15%) | 0.5 (+25%) |
| 256 | 64 | リーダーのみ | 17435 (-7%) | 6.0 (+9%) |
| 256 | 256 | リーダーのみ | 18180 (-8%) | 21.3 (+3%) |
| 64 | 64 | 全サーバー | 46965 (-4%) | 2.1 (+0%) |
| 64 | 256 | 全サーバー | 55286 (-6%) | 7.4 (+6%) |
| 256 | 64 | 全サーバー | 46603 (-6%) | 2.1 (+5%) |
| 256 | 256 | 全サーバー | 55291 (-6%) | 7.3 (+4%) |
単一キーの書き込み
| キーサイズ(バイト) | クライアント数 | 対象のetcdサーバー | 書き込みQPS | 90パーセンタイルレイテンシー(ms) |
|---|---|---|---|---|
| 64 | 1 | リーダーのみ | 76 (+22%) | 19.4 (-15%) |
| 64 | 64 | リーダーのみ | 2461 (+45%) | 31.8 (-32%) |
| 64 | 256 | リーダーのみ | 4275 (+1%) | 69.6 (-10%) |
| 256 | 1 | リーダーのみ | 64 (+20%) | 16.7 (-30%) |
| 256 | 64 | リーダーのみ | 2385 (+30%) | 31.5 (-19%) |
| 256 | 256 | リーダーのみ | 4353 (-3%) | 74.0 (+9%) |
| 64 | 64 | 全サーバー | 2005 (+81%) | 49.8 (-55%) |
| 64 | 256 | 全サーバー | 4868 (+35%) | 81.5 (-40%) |
| 256 | 64 | 全サーバー | 1925 (+72%) | 47.7 (-59%) |
| 256 | 256 | 全サーバー | 4975 (+36%) | 70.3 (-36%) |
性能変化の説明
-
ほとんどのシナリオで、読み取りQPSが5~8%低下しています。これは、etcdがストア操作ごとにストアのメトリクスを記録するためです。メトリクスは監視やデバッグに重要なため、この低下は許容できると考えています。
-
リーダーに対する書き込みQPSが20~30%増加しています。raftのメインループとエントリー適用ループを分離し、互いの処理をブロックしないようにしたためです。
-
全サーバーに対する書き込みQPSが30~80%増加しています。フォロワーが最新のコミットインデックスをより早く受信し、提案をより速くコミットできるようになったためです。
15.6 - etcd v2.2.0のベンチマーク
物理マシン
GCEのn1-highcpu-2マシンタイプ
- etcdのデータディレクトリとしてマウントした専用ローカルSSD:1台
- OS用の専用低速ディスク:1台
- メモリー:1.8 GB
- CPU:2基
etcdクラスター
etcd 2.2.0メンバー3つを、それぞれ別のマシンで実行します。
バージョンの詳細:
テスト
etcdクラスターの外部に別のマシンを起動し、接続再利用のパッチを適用したhey HTTPベンチマークツール
を実行して、各etcdクラスターメンバーにリクエストを送信します。パッチと測定手順の再現方法は、ベンチマークの手順
を参照してください。
性能は100回のベンチマーク結果から算出します。
性能
単一キーの読み取り性能
| キーサイズ(バイト) | クライアント数 | 対象のetcdサーバー | 平均読み取りQPS | 読み取りQPSの標準偏差 | 90パーセンタイルレイテンシーの平均(ms) | レイテンシーの標準偏差 |
|---|---|---|---|---|---|---|
| 64 | 1 | リーダーのみ | 2303 | 200 | 0.49 | 0.06 |
| 64 | 64 | リーダーのみ | 15048 | 685 | 7.60 | 0.46 |
| 64 | 256 | リーダーのみ | 14508 | 434 | 29.76 | 1.05 |
| 256 | 1 | リーダーのみ | 2162 | 214 | 0.52 | 0.06 |
| 256 | 64 | リーダーのみ | 14789 | 792 | 7.69 | 0.48 |
| 256 | 256 | リーダーのみ | 14424 | 512 | 29.92 | 1.42 |
| 64 | 64 | 全サーバー | 45752 | 2048 | 2.47 | 0.14 |
| 64 | 256 | 全サーバー | 46592 | 1273 | 10.14 | 0.59 |
| 256 | 64 | 全サーバー | 45332 | 1847 | 2.48 | 0.12 |
| 256 | 256 | 全サーバー | 46485 | 1340 | 10.18 | 0.74 |
単一キーの書き込み性能
| キーサイズ(バイト) | クライアント数 | 対象のetcdサーバー | 平均書き込みQPS | 書き込みQPSの標準偏差 | 90パーセンタイルレイテンシーの平均(ms) | レイテンシーの標準偏差 |
|---|---|---|---|---|---|---|
| 64 | 1 | リーダーのみ | 55 | 4 | 24.51 | 13.26 |
| 64 | 64 | リーダーのみ | 2139 | 125 | 35.23 | 3.40 |
| 64 | 256 | リーダーのみ | 4581 | 581 | 70.53 | 10.22 |
| 256 | 1 | リーダーのみ | 56 | 4 | 22.37 | 4.33 |
| 256 | 64 | リーダーのみ | 2052 | 151 | 36.83 | 4.20 |
| 256 | 256 | リーダーのみ | 4442 | 560 | 71.59 | 10.03 |
| 64 | 64 | 全サーバー | 1625 | 85 | 58.51 | 5.14 |
| 64 | 256 | 全サーバー | 4461 | 298 | 89.47 | 36.48 |
| 256 | 64 | 全サーバー | 1599 | 94 | 60.11 | 6.43 |
| 256 | 256 | 全サーバー | 4315 | 193 | 88.98 | 7.01 |
性能の変化
-
etcdがAPI呼び出しごとにメトリクスを記録するようになったため、ほとんどのシナリオで読み取りQPSがわずかに低下しているようです。得られる監視・デバッグ情報の広がりを考慮し、この小さな性能への影響は妥当なものと判断しました。
-
クラスターのリーダーに対する書き込みQPSは、わずかに増加しているようです。これは、etcdのraft処理でメインループとエントリー適用ループを分離し、両者の間で発生していたいくつかのブロックを解消したためです。
-
全メンバーに対する書き込みQPSは、大幅に増加しているようです。フォロワーが最新のコミットインデックスをより早く受信し、提案をより速くコミットできるようになったためです。
15.7 - etcd v2.1.0のベンチマーク
物理マシン
GCEのn1-highcpu-2マシンタイプ
- /var/lib/etcdにマウントした専用ローカルSSD:1台
- OS用の専用低速ディスク:1台
- メモリー:1.8 GB
- CPU:2基
- etcdバージョン:2.1.0 alpha
etcdクラスター
etcdメンバー3つを、それぞれ別のマシンで実行します。
テスト
別のマシンを起動し、hey HTTPベンチマークツール を使って各etcdメンバーにリクエストを送信します。詳しい手順はベンチマーク開発ガイド を参照してください。
性能
単一キーの読み取り
| キーサイズ(バイト) | クライアント数 | 対象のetcdサーバー | 読み取りQPS | 90パーセンタイルレイテンシー(ms) |
|---|---|---|---|---|
| 64 | 1 | リーダーのみ | 1534 | 0.7 |
| 64 | 64 | リーダーのみ | 10125 | 9.1 |
| 64 | 256 | リーダーのみ | 13892 | 27.1 |
| 256 | 1 | リーダーのみ | 1530 | 0.8 |
| 256 | 64 | リーダーのみ | 10106 | 10.1 |
| 256 | 256 | リーダーのみ | 14667 | 27.0 |
| 64 | 64 | 全サーバー | 24200 | 3.9 |
| 64 | 256 | 全サーバー | 33300 | 11.8 |
| 256 | 64 | 全サーバー | 24800 | 3.9 |
| 256 | 256 | 全サーバー | 33000 | 11.5 |
単一キーの書き込み
| キーサイズ(バイト) | クライアント数 | 対象のetcdサーバー | 書き込みQPS | 90パーセンタイルレイテンシー(ms) |
|---|---|---|---|---|
| 64 | 1 | リーダーのみ | 60 | 21.4 |
| 64 | 64 | リーダーのみ | 1742 | 46.8 |
| 64 | 256 | リーダーのみ | 3982 | 90.5 |
| 256 | 1 | リーダーのみ | 58 | 20.3 |
| 256 | 64 | リーダーのみ | 1770 | 47.8 |
| 256 | 256 | リーダーのみ | 4157 | 105.3 |
| 64 | 64 | 全サーバー | 1028 | 123.4 |
| 64 | 256 | 全サーバー | 3260 | 123.8 |
| 256 | 64 | 全サーバー | 1033 | 121.5 |
| 256 | 256 | 全サーバー | 3061 | 119.3 |
16 - アップグレード
16.1 - etcdクラスターとアプリケーションのアップグレード
このセクションには、etcdクラスターとアプリケーションのアップグレードに関するドキュメントをまとめています。
アップグレード方針
アップグレードを始める前に、etcdでサポートされるアップグレードは次の2つの場合だけであることに注意してください。
- パッチアップグレード: 同じマイナーバージョン内でのパッチリリース間のアップグレードです(例:3.7.0 - 3.7.1)。
- マイナーアップグレード: マイナーバージョンを1つずつ上げるアップグレードです(例:3.6 - 3.7)。マイナーバージョンを飛ばすアップグレードはサポートされず、失敗する可能性が高くなります。次のマイナーバージョンにアップグレードする前に、最新のパッチバージョンに更新してください。
etcd v3.xクラスターのアップグレード
- etcdを3.0から3.1にアップグレード
- etcdを3.1から3.2にアップグレード
- etcdを3.2から3.3にアップグレード
- etcdを3.3から3.4にアップグレード
- etcdを3.4から3.5にアップグレード
- etcdを3.5から3.6にアップグレード
- etcdを3.6から3.7にアップグレード
etcd v2.3からのアップグレード
16.2 - etcdをv3.6からv3.7にアップグレード
通常、etcd v3.6からv3.7へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v3.6のプロセスを1つずつ停止し、etcd v3.7のプロセスに置き換えます。
- すべてのプロセスがv3.7で稼働すると、クラスターでv3.7の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
3.6の更新
3.7にアップグレードする前に、すべての3.6メンバーが3.6.11以降に更新されていることを確認してください。それより前の3.6パッチリリースは、3.7へのローリングアップグレードと互換性がない可能性があります。
V2ストア
v3.7ではv2ストアが完全に削除されました。v2 HTTP API(--enable-v2)、v2-on-v3エミュレーション(--experimental-enable-v2v3)、v2ディスカバリーサービス、client/v2パッケージ、v2スナップショットファイルの読み込みは、すべて削除されています。CHANGELOG-3.7
にある互換性を損なう変更の参照先を確認してください。
3.6クラスターからアップグレードする場合、これらのフラグはすでに存在せず、作業は不要です。カスタムv2データがある古いリリースから移行する場合は、アップグレード前にv2移行ガイド に従ってください。
Goのリファクタリング
v3.7には大規模な内部リファクタリングが含まれています。通常のアップグレードには影響しませんが、独自の連携機能をアップグレードする際には把握しておくと役立ちます。
gogo/protobufから標準のgoogle.golang.org/protobufへの移行(#14533 で追跡)。- 非推奨の
go-grpc-middlewarev1のログおよびタグライブラリから、v2インターセプターへの移行(#20420 )。 - OpenTelemetryのgRPCインターセプターを
otelgrpcv0.61.0に更新し、非推奨のUnaryServerInterceptorとStreamServerInterceptorをNewServerHandlerに置き換えました(#20017 )。
etcdをライブラリとして組み込んでいる場合、clientv3 APIを使用してビルドしている場合、または内部パッケージに依存している場合は、アップグレード前にCHANGELOG
を確認してください。
削除されたフラグ
v3.7では、非推奨の--experimental-*フラグがすべて削除されました(#19959
)。v3.6では、それぞれ同名の非実験的フラグ、または--feature-gatesのエントリーに置き換えられています。これらのフラグがまだ設定されている場合は、v3.7へのローリングアップグレードを行う前に、v3.6の対応する設定に置き換えてください。そうしないと、v3.7のプロセスは起動に失敗します。
削除された各フラグと、対応する非実験的フラグまたは--feature-gatesのエントリーとの対応関係は、v3.5からv3.6へのアップグレードガイド
を参照してください。
追加されたフラグ
ありません。
デフォルト値が変更されたフラグ
ありません。
サーバーアップグレードのチェックリスト
アップグレードの要件
既存のetcd環境をv3.7にアップグレードするには、稼働中のクラスターがv3.6.11以降でなければなりません。それより古いマイナーバージョンを使用している場合は、先にv3.6にアップグレード してください。etcdでサポートされるのは、マイナーバージョンを1つずつ上げるアップグレードだけです。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、スナップショットバックアップをダウンロード してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにロールバック できます。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョンv3.7にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
ロールバック
etcdクラスターをアップグレードする前に、クラスターのスナップショットバックアップを作成してダウンロード してください。このスナップショットを使えば、必要に応じてクラスターをアップグレード前の状態にリストアできます。アップグレード中に問題が発生した場合は、まず根本原因を特定して解決することをお勧めします。少なくとも1つのメンバーがv3.6のままで、クラスターのバージョンがまだ混在している場合は、バイナリまたはイメージを以前のv3.6のものに置き換えるか、スナップショットを使用してクラスターを直接リストアできます。この混在状態ではクラスターはv3.6クラスターとして動作し続けるため、正式なダウングレード手順を踏まずにロールバックできます。
ただし、すべてのメンバーをv3.7にアップグレードすると、クラスターのアップグレードは完了したと見なされ、バイナリによるロールバックはできなくなります。その場合、アップグレードに問題があったときのリカバリー方法は、アップグレード前に取得したスナップショットからリストアするか、公式のダウングレードガイド に従うかのいずれかに限られます。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.6 etcdクラスターをアップグレードする方法を説明します。以下の出力は、1台のホスト上で3つのループバックポートを使用し、etcd v3.6.12とetcd v3.7.0-rc.0を実際に稼働させたときのものです。
手順1:アップグレード要件の確認
クラスターは正常で、v3.6.11以降で稼働していますか。
手順2:リーダーからスナップショットバックアップをダウンロード
問題が発生した場合にダウングレードできるよう、スナップショットバックアップをダウンロード してください。
etcdのリーダーには最新のアプリケーションデータがあることが保証されているため、リーダーからスナップショットを取得します。
手順3:既存のetcdサーバーを1つ停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。リーダーは終了前にリーダーシップを移譲します。
手順4:同じ設定でetcdサーバーを再起動
同じ設定で、新しいetcdバイナリを使用してetcdサーバーを再起動します。
新しいv3.7のetcdは、自身の情報をクラスターに公開します。この時点では、クラスターは引き続き全メンバーに共通する最も低いバージョンであるv3.6のプロトコルで動作します。
{"level":"info","ts":"2026-06-02T07:01:58.920780+0300","caller":"membership/cluster.go:296","msg":"set cluster version from store","cluster-version":"3.6"}
{"level":"info","ts":"2026-06-02T07:01:58.979186+0300","caller":"etcdserver/server.go:1828","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","cluster-id":"7dee9ba76d59ed53","publish-timeout":"7s"}
新しいv3.7のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、未アップグレードのメンバーとアップグレード済みのメンバーに、バージョンの混在状態に関するメッセージが記録されます。これは想定された動作で、すべてのetcdクラスターメンバーをv3.7にアップグレードすると表示されなくなります。
手順5:残りのメンバーで手順3と手順4を繰り返す
すべてのメンバーのアップグレードが完了すると、クラスターはv3.7へのアップグレードが成功したことを報告します。
{"level":"info","ts":"2026-06-02T07:02:36.054783+0300","caller":"etcdserver/server.go:2311","msg":"updating cluster version using v3 API","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059345+0300","caller":"membership/cluster.go:593","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.6","to":"3.7"}
{"level":"info","ts":"2026-06-02T07:02:36.059409+0300","caller":"etcdserver/server.go:2326","msg":"cluster version is updated","cluster-version":"3.7"}
16.3 - etcdをv3.5からv3.6にアップグレード
通常、etcd v3.5からv3.6へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v3.5のプロセスを1つずつ停止し、etcd v3.6のプロセスに置き換えます。
- すべてのプロセスがv3.6で稼働すると、クラスターでv3.6の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
3.5の更新
3.6にアップグレードする前に、すべての3.5メンバーが3.5.32以降に更新されている
ことを確認してください。パッチリリース3.5.24から3.5.26では、アップグレードを妨げる可能性のある問題がいくつか修正されています。3.5.32
では--v2-deprecation=write-only-skip-checkが追加され、etcdutl check v2storeが拡張されてv2スナップショットに加えてWALレコードも検査するようになりました。
V2ストア
--enable-v2フラグを設定していない、またはfalseに設定している場合、追加の作業は不要です。
--enable-v2を設定している場合は、etcdutl check v2storeコマンドを実行し、v2storeにメンバー構成以外の(カスタム)データが含まれていないか確認してください。カスタムデータがなければ、このフラグを安全に削除できます。含まれている場合は、v2移行ガイド
で詳細を確認してください。
追加されたフラグ
削除されたフラグ
非推奨になったフラグ
etcd --experimental-bootstrap-defrag-threshold-megabytesフラグは非推奨になりました。
etcd --experimental-compaction-batch-limitフラグは非推奨になりました。
etcd --experimental-compact-hash-check-timeフラグは非推奨になりました。
etcd --experimental-compaction-sleep-intervalフラグは非推奨になりました。
etcd --experimental-corrupt-check-timeフラグは非推奨になりました。
etcd --experimental-enable-distributed-tracingフラグは非推奨になりました。
etcd --experimental-distributed-tracing-addressフラグは非推奨になりました。
etcd --experimental-distributed-tracing-instance-idフラグは非推奨になりました。
etcd --experimental-distributed-tracing-sampling-rateフラグは非推奨になりました。
etcd --experimental-distributed-tracing-service-nameフラグは非推奨になりました。
etcd --experimental-downgrade-check-timeフラグは非推奨になりました。
etcd --experimental-max-learnersフラグは非推奨になりました。
etcd --experimental-memory-mlockフラグは非推奨になりました。
etcd --experimental-peer-skip-client-san-verificationフラグは非推奨になりました。
etcd --experimental-snapshot-catchup-entriesフラグは非推奨になりました。
etcd --experimental-warning-apply-durationフラグは非推奨になりました。
etcd --experimental-warning-unary-request-durationフラグは非推奨になりました。
etcd --experimental-watch-progress-notify-intervalフラグは非推奨になりました。
v3.5の実験的フラグからフィーチャーゲートへの移行
etcd --experimental-compact-hash-check-enabled=trueに対応するフィーチャーゲート
etcd --experimental-initial-corrupt-check=trueに対応するフィーチャーゲート
etcd --experimental-enable-lease-checkpoint=trueに対応するフィーチャーゲート
etcd --experimental-enable-lease-checkpoint-persist=trueに対応するフィーチャーゲート
etcd --experimental-stop-grpc-service-on-defrag=trueに対応するフィーチャーゲート
etcd --experimental-txn-mode-write-with-shared-buffer=falseに対応するフィーチャーゲート
デフォルト値が変更されたフラグ
以前のデフォルトフラグetcd --snapshot-count=100000
以前のデフォルトフラグetcd --v2-deprecation='not-yet'
以前のデフォルトフラグetcd --discovery-fallback='proxy'
Prometheusメトリクスの違い
サーバーアップグレードのチェックリスト
アップグレードの要件
既存のetcd環境をv3.6にアップグレードするには、稼働中のクラスターがv3.5以降でなければなりません。v3.5より前の場合は、v3.6にアップグレードする前にv3.5にアップグレード してください。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、スナップショットバックアップをダウンロード
してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにロールバック
できます。snapshotコマンドでバックアップされるのはv3データのみであることに注意してください。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョンv3.6にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
ロールバック
etcdクラスターをアップグレードする前に、クラスターのスナップショットバックアップを作成してダウンロード してください。このスナップショットを使えば、必要に応じてクラスターをアップグレード前の状態にリストアできます。アップグレード中に問題が発生した場合は、まず根本原因を特定して解決することをお勧めします。少なくとも1つのメンバーがv3.5のままで、クラスターのバージョンがまだ混在している場合は、バイナリまたはイメージを以前のv3.5のものに置き換えるか、スナップショットを使用してクラスターを直接リストアできます。この混在状態ではクラスターはv3.5クラスターとして動作し続けるため、正式なダウングレード手順を踏まずにロールバックできます。
ただし、すべてのメンバーをv3.6にアップグレードすると、クラスターのアップグレードは完了したと見なされ、バイナリを置き換えるだけでは正しくロールバックできません。リカバリーするには、アップグレード前に取得したスナップショットからリストアするか、公式のダウングレードガイドに従って元のバージョンに戻し、一貫性を確保してデータ破損を防ぐ方法があります。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.5 etcdクラスターをアップグレードする方法を説明します。
手順1:アップグレード要件の確認
クラスターは正常で、v3.5.xで稼働していますか。
手順2:リーダーからスナップショットバックアップをダウンロード
問題が発生した場合にダウングレードできるよう、スナップショットバックアップをダウンロード してください。
etcdのリーダーには最新のアプリケーションデータがあることが保証されているため、リーダーからスナップショットを取得します。
手順3:既存のetcdサーバーを1つ停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
手順4:同じ設定でetcdサーバーを再起動
同じ設定で、新しいetcdバイナリを使用してetcdサーバーを再起動します。
新しいv3.6のetcdは、自身の情報をクラスターに公開します。この時点では、クラスターは引き続き全メンバーに共通する最も低いバージョンであるv3.5のプロトコルで動作します。
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.889+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"bf9071f4639c75cc","from":"3.0","to":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.828+0530","caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
{"level":"info","ts":"2025-03-01T04:40:36.894+0530","caller":"etcdserver/server.go:1686","msg":"published local member to cluster through raft","local-member-id":"bf9071f4639c75cc","local-member-attributes":"{Name:node1 ClientURLs:[http://127.0.0.1:2379]}","cluster-id":"59a05384c9b79ee","publish-timeout":"7s"}
新しいv3.6のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、未アップグレードのメンバーに次のような警告が記録されます。
これは想定された動作で、すべてのetcdクラスターメンバーをv3.6にアップグレードすると表示されなくなります。
手順5:残りのメンバーで手順3と手順4を繰り返す
すべてのメンバーのアップグレードが完了すると、クラスターはv3.6へのアップグレードが成功したことを報告します。
メンバー1:
{"level":"info","ts":"2025-03-01T04:58:32.375+0530","caller":"etcdserver/server.go:2149","msg":"updating cluster version using v3 API","from":"3.5","to":"3.6"}{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"etcdserver/server.go:2164","msg":"cluster version is updated","cluster-version":"3.6"}
メンバー2:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"91bc3c398fb3c146","from":"3.5","to":"3.6"}
メンバー3:
{"level":"info","ts":"2025-03-01T04:58:32.377+0530","caller":"membership/cluster.go:539","msg":"updated cluster version","cluster-id":"59a05384c9b79ee","local-member-id":"fd422379fda50e48","from":"3.5","to":"3.6"}
16.4 - etcdを3.4から3.5にアップグレード
通常、etcd 3.4から3.5へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v3.4のプロセスを1つずつ停止し、etcd v3.5のプロセスに置き換えます。
- すべてのプロセスがv3.5で稼働すると、クラスターでv3.5の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
v3データのないv2から移行する
場合、v3のETCD_DATA_DIR/member/snap/dbファイルがない状態で既存のスナップショットからリストアすると、etcdサーバーv3.2+でパニックが発生します。これは、以前のv3データがないままサーバーをv2から移行した場合に起こります。この動作は、v3データの意図しない消失(たとえばdbファイルが移動された場合)を防ぐ役割も果たします。etcdでは、v3への移行後はv3データが存在する場合にのみ、さらに移行を進められます。v3.0サーバーにv3データが存在するまでは、それより新しいv3バージョンにアップグレードしないでください。
クラスターで認証を有効にしている場合、3.5では認証に関するWALエントリーの形式が変更される ため、3.4以前のバージョンからのローリングアップグレードはサポートされません。
3.5の主な互換性を損なう変更は次のとおりです。
Prometheusメトリクスetcd_debugging_mvcc_db_total_size_in_bytesの非推奨化
v3.5では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_db_total_size_in_bytesをetcd_mvcc_db_total_size_in_bytesに昇格させました。また、v3.5ではetcd_debugging_mvcc_db_total_size_in_bytesが完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_put_totalの非推奨化
v3.5では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_put_totalをetcd_mvcc_put_totalに昇格させました。また、v3.5ではetcd_debugging_mvcc_put_totalが完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_delete_totalの非推奨化
v3.5では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_delete_totalをetcd_mvcc_delete_totalに昇格させました。また、v3.5ではetcd_debugging_mvcc_delete_totalが完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_txn_totalの非推奨化
v3.5では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_txn_totalをetcd_mvcc_txn_totalに昇格させました。また、v3.5ではetcd_debugging_mvcc_txn_totalが完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_range_totalの非推奨化
v3.5では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_range_totalをetcd_mvcc_range_totalに昇格させました。また、v3.5ではetcd_debugging_mvcc_range_totalが完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
etcd --logger capnslogの非推奨化
v3.5では、複数のログ出力と構造化ログをサポートするため、--logger=zapがデフォルトです。
v3.5ではetcd --logger=capnslogが非推奨となり、--logger=zapがデフォルトになりました。
v3.4では、構造化ログと複数のログ出力に対応するため、etcd --logger=zapのサポートを追加しています。主な狙いは、障害が発生してからサーバーログを調べるのではなく、etcdの監視を自動化することです。今後の開発ではetcdのログ出力をできるだけ少なくし、メトリクスとアラートでetcdを監視しやすくします。etcd --logger=capnslogはv3.5で非推奨になります。
etcd --log-outputの非推奨化
v3.4では、複数のログ出力をサポートするため、etcd --log-outputを--log-outputsに改名しました
。
v3.5ではetcd --log-outputが非推奨になりました。
etcd --debugフラグの非推奨化(現在は--log-level=debug)
etcd --debugフラグは非推奨になりました。
etcd --log-package-levelsの非推奨化
capnslog用のetcd --log-package-levelsフラグは非推奨になりました。
現在は、**etcd --logger=zap**がデフォルトです。
[CLIENT-URL]/config/local/logの非推奨化
v3.5では、/config/local/logエンドポイントとetcd --log-package-levelsフラグが非推奨になります。
gRPCゲートウェイのHTTPエンドポイントの変更(/v3betaを非推奨化)
変更前
変更後
/v3betaは3.5リリースで削除されました。
サーバーアップグレードのチェックリスト
アップグレードの要件
既存のetcd環境を3.5にアップグレードするには、稼働中のクラスターが3.4以降でなければなりません。3.4より前の場合は、3.5にアップグレードする前に3.4にアップグレード してください。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、スナップショットバックアップをダウンロード
してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにダウングレード
できます。snapshotコマンドでバックアップされるのはv3データのみであることに注意してください。v2データについては、v2データストアのバックアップ
を参照してください。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョン3.5にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
制限事項
注:クラスターにv3データしかなく、v2データがない場合、この制限は適用されません。
クラスターが50MBを超えるv2データセットを提供している場合、新しくアップグレードした各メンバーが既存のクラスターに追いつくまでに最大2分かかることがあります。直近のスナップショットのサイズを調べて、データの総量を見積もってください。つまり、各メンバーのアップグレードの間に2分待つのが最も安全です。
データの総量が100MB以上とさらに大きい場合、この1回限りの処理にはより長い時間がかかることがあります。この規模の非常に大きなetcdクラスターを管理している場合は、アップグレード前にetcdチーム までお気軽にお問い合わせください。手順についてアドバイスします。
ダウングレード
すべてのメンバーをv3.5にアップグレードすると、クラスターもv3.5にアップグレードされ、この完了状態からのダウングレードはできません。ただし、1つでもv3.4のメンバーが残っていれば、クラスターとその動作は「v3.4」のままであり、この混在状態からすべてのメンバーでv3.4のetcdバイナリを使用する状態に戻せます。
アップグレード完了後でもクラスターをダウングレードできるように、スナップショットバックアップをダウンロード してください。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.4 etcdクラスターをアップグレードする方法を説明します。
手順1:アップグレード要件の確認
クラスターは正常で、v3.4.xで稼働していますか。
手順2:リーダーからスナップショットバックアップをダウンロード
問題が発生した場合にダウングレードできるよう、スナップショットバックアップをダウンロード してください。
etcdのリーダーには最新のアプリケーションデータがあることが保証されているため、リーダーからスナップショットを取得します。
手順3:既存のetcdサーバーを1つ停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
手順4:同じ設定でetcdサーバーを再起動
同じ設定で、新しいetcdバイナリを使用してetcdサーバーを再起動します。
新しいv3.5のetcdは、自身の情報をクラスターに公開します。この時点では、クラスターは引き続き全メンバーに共通する最も低いバージョンであるv3.4のプロトコルで動作します。
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.4"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
新しいv3.5のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、未アップグレードのメンバーに次のような警告が記録されます。
これは想定された動作で、すべてのetcdクラスターメンバーをv3.5にアップグレードすると表示されなくなります。
手順5:残りのメンバーで手順3と手順4を繰り返す
すべてのメンバーのアップグレードが完了すると、クラスターは3.5へのアップグレードが成功したことを報告します。
メンバー1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.5"}
メンバー2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
メンバー3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.4","from":"3.5"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.5"}
16.5 - etcdを3.3から3.4にアップグレード
通常、etcd 3.3から3.4へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v3.3のプロセスを1つずつ停止し、etcd v3.4のプロセスに置き換えます。
- すべてのプロセスがv3.4で稼働すると、クラスターでv3.4の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
v3データのないv2から移行する
場合、v3のETCD_DATA_DIR/member/snap/dbファイルがない状態で既存のスナップショットからリストアすると、etcdサーバーv3.2+でパニックが発生します。これは、以前のv3データがないままサーバーをv2から移行した場合に起こります。この動作は、v3データの意図しない消失(たとえばdbファイルが移動された場合)を防ぐ役割も果たします。etcdでは、v3への移行後はv3データが存在する場合にのみ、さらに移行を進められます。v3.0サーバーにv3データが存在するまでは、それより新しいv3バージョンにアップグレードしないでください。
3.4の主な互換性を損なう変更は次のとおりです。
ETCDCTL_API=3 etcdctlをデフォルトに変更
ETCDCTL_API=3がデフォルトになりました。
etcd --enable-v2=falseをデフォルトに変更
etcd --enable-v2=false
がデフォルトになりました。
つまり、etcd --enable-v2=trueを指定しない限り、etcd v3.4サーバーはv2 APIリクエストを処理しません。
v2 APIを使用していた場合は、v3.4で必ずv2 APIを有効にしてください。
その他のHTTP APIは引き続き動作します(例:[CLIENT-URL]/metrics、[CLIENT-URL]/health、v3 gRPCゲートウェイ)。
etcd --ca-fileおよびetcd --peer-ca-fileフラグの非推奨化
--ca-fileおよび--peer-ca-fileフラグは非推奨です。これらはv2.1から非推奨となっています。
このパラメーターを設定すると、--client-cert-authの値にかかわらず、クライアント証明書認証も自動的に有効になることに注意してください。
grpc.ErrClientConnClosingエラーの非推奨化
grpc.ErrClientConnClosingはgRPC >= 1.10で非推奨になりました
。
クライアントの接続にgrpc.WithBlockが必要
新しいクライアントバランサー
は、非同期リゾルバーを使用してgRPCの接続関数にエンドポイントを渡します。そのため、v3.4クライアントでは、基盤となる接続の確立を待つために、接続オプションgrpc.WithBlockが必要です。
Prometheusメトリクスetcd_debugging_mvcc_db_total_size_in_bytesの非推奨化
v3.4では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_db_total_size_in_bytesをetcd_mvcc_db_total_size_in_bytesに昇格させています。
後方互換性のため、v3.4ではetcd_debugging_mvcc_db_total_size_in_bytesも引き続き提供されます。v3.5で完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_put_totalの非推奨化
v3.4では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_put_totalをetcd_mvcc_put_totalに昇格させています。
後方互換性のため、v3.4ではetcd_debugging_mvcc_put_totalも引き続き提供されます。v3.5で完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_delete_totalの非推奨化
v3.4では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_delete_totalをetcd_mvcc_delete_totalに昇格させています。
後方互換性のため、v3.4ではetcd_debugging_mvcc_delete_totalも引き続き提供されます。v3.5で完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_txn_totalの非推奨化
v3.4では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_txn_totalをetcd_mvcc_txn_totalに昇格させています。
後方互換性のため、v3.4ではetcd_debugging_mvcc_txn_totalも引き続き提供されます。v3.5で完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
Prometheusメトリクスetcd_debugging_mvcc_range_totalの非推奨化
v3.4では、etcdストレージの監視を促すため、Prometheusメトリクスetcd_debugging_mvcc_range_totalをetcd_mvcc_range_totalに昇格させています。
後方互換性のため、v3.4ではetcd_debugging_mvcc_range_totalも引き続き提供されます。v3.5で完全に非推奨になります。
etcd_debugging_*名前空間のメトリクスは、実験的機能と位置付けられていることに注意してください。監視ガイドの改善に伴い、さらに多くのメトリクスを昇格させる可能性があります。
etcd --log-outputフラグの非推奨化(現在は--log-outputs)
複数のログ出力をサポートするため、etcd --log-outputを--log-outputsに改名しました
。etcd --logger=capnslogは複数のログ出力をサポートしません。
etcd --log-outputはv3.5で非推奨になります。etcd --logger=capnslogはv3.5で非推奨になります。
v3.4では、構造化ログと複数のログ出力に対応するため、etcd --logger=zap --log-outputs=stderrのサポートを追加しています。主な狙いは、障害が発生してからサーバーログを調べるのではなく、etcdの監視を自動化することです。今後の開発ではetcdのログ出力をできるだけ少なくし、メトリクスとアラートでetcdを監視しやすくします。etcd --logger=capnslogはv3.5で非推奨になります。
etcd --config-fileのlog-outputsフィールドの型を[]stringに変更
log-outputs(以前のフィールド名はlog-output)が複数のライターを受け付けるようになったため、etcdの設定YAMLファイルのlog-outputsフィールドは、次のように[]string型に変更しなければなりません。
embed.Config.LogOutputをembed.Config.LogOutputsに改名
複数のログ出力をサポートするため、**embed.Config.LogOutputをembed.Config.LogOutputs**に改名しました
。また、複数のログ出力をサポートするため、embed.Config.LogOutputの型をstringから[]stringに変更しました
。
v3.5でcapnslogを非推奨化
v3.5では、capnslog用のetcd --log-package-levelsフラグが非推奨になります。etcd --logger=zap --log-outputs=stderrがデフォルトになります。v3.5では、[CLIENT-URL]/config/local/logエンドポイントが非推奨になります。
etcd --debugフラグの非推奨化(現在は--log-level=debug)
v3.4では、etcd --debug
フラグが非推奨になります。代わりにetcd --log-level=debugフラグを使用してください。
pkg/transport.TLSInfo.CAFileフィールドの非推奨化
pkg/transport.TLSInfo.CAFileフィールドは非推奨になりました。
embed.Config.SnapCountをembed.Config.SnapshotCountに変更
フラグ名etcd --snapshot-countと一貫性を持たせるため、embed.Config.SnapCountフィールドはembed.Config.SnapshotCountに改名されました。
etcdserver.ServerConfig.SnapCountをetcdserver.ServerConfig.SnapshotCountに変更
フラグ名etcd --snapshot-countと一貫性を持たせるため、etcdserver.ServerConfig.SnapCountフィールドはetcdserver.ServerConfig.SnapshotCountに改名されました。
walパッケージの関数シグネチャの変更
構造化ロガーをサポートするため、walの関数シグネチャを変更しました。
pkg/adtパッケージのIntervalTree型の変更
pkg/adt.IntervalTreeはinterfaceとして定義されるようになりました。
embed.Config.SetupLoggingの非推奨化
誤ったログ設定を防ぐため、embed.Config.SetupLoggingは削除され、ログ設定は自動的に行われるようになりました。
gRPCゲートウェイのHTTPエンドポイントの変更(/v3betaを/v3に置き換え)
変更前
変更後
/v3betaエンドポイントへのリクエストは/v3にリダイレクトされ、/v3betaは3.5リリースで削除されます。
コンテナーイメージタグの非推奨化
latestおよびマイナーバージョンのイメージタグは非推奨になりました。
サーバーアップグレードのチェックリスト
アップグレードの要件
既存のetcd環境を3.4にアップグレードするには、稼働中のクラスターが3.3以降でなければなりません。3.3より前の場合は、3.4にアップグレードする前に3.3にアップグレード してください。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、スナップショットバックアップをダウンロード
してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにダウングレード
できます。snapshotコマンドでバックアップされるのはv3データのみであることに注意してください。v2データについては、v2データストアのバックアップ
を参照してください。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョン3.4にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
制限事項
注:クラスターにv3データしかなく、v2データがない場合、この制限は適用されません。
クラスターが50MBを超えるv2データセットを提供している場合、新しくアップグレードした各メンバーが既存のクラスターに追いつくまでに最大2分かかることがあります。直近のスナップショットのサイズを調べて、データの総量を見積もってください。つまり、各メンバーのアップグレードの間に2分待つのが最も安全です。
データの総量が100MB以上とさらに大きい場合、この1回限りの処理にはより長い時間がかかることがあります。この規模の非常に大きなetcdクラスターを管理している場合は、アップグレード前にetcdチーム までお気軽にお問い合わせください。手順についてアドバイスします。
ダウングレード
すべてのメンバーをv3.4にアップグレードすると、クラスターもv3.4にアップグレードされ、この完了状態からのダウングレードはできません。ただし、1つでもv3.3のメンバーが残っていれば、クラスターとその動作は「v3.3」のままであり、この混在状態からすべてのメンバーでv3.3のetcdバイナリを使用する状態に戻せます。
アップグレード完了後でもクラスターをダウングレードできるように、スナップショットバックアップをダウンロード してください。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.3 etcdクラスターをアップグレードする方法を説明します。
手順1:アップグレード要件の確認
クラスターは正常で、v3.3.xで稼働していますか。
手順2:リーダーからスナップショットバックアップをダウンロード
問題が発生した場合にダウングレードできるよう、スナップショットバックアップをダウンロード してください。
etcdのリーダーには最新のアプリケーションデータがあることが保証されているため、リーダーからスナップショットを取得します。
手順3:既存のetcdサーバーを1つ停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
手順4:同じ設定でetcdサーバーを再起動
同じ設定で、新しいetcdバイナリを使用してetcdサーバーを再起動します。
新しいv3.4のetcdは、自身の情報をクラスターに公開します。この時点では、クラスターは引き続き全メンバーに共通する最も低いバージョンであるv3.3のプロトコルで動作します。
{"level":"info","ts":1526586617.1647713,"caller":"membership/cluster.go:485","msg":"set initial cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1648536,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.0"}
{"level":"info","ts":1526586617.1649303,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"7339c4e5e833c029","from":"3.0","from":"3.3"}
{"level":"info","ts":1526586617.1649797,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.3"}
{"level":"info","ts":1526586617.2107732,"caller":"etcdserver/server.go:1770","msg":"published local member to cluster through raft","local-member-id":"7339c4e5e833c029","local-member-attributes":"{Name:s1 ClientURLs:[http://localhost:2379]}","request-path":"/0/members/7339c4e5e833c029/attributes","cluster-id":"7dee9ba76d59ed53","publish-timeout":7}
新しいv3.4のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、未アップグレードのメンバーに次のような警告が記録されます。
これは想定された動作で、すべてのetcdクラスターメンバーをv3.4にアップグレードすると表示されなくなります。
手順5:残りのメンバーで手順3と手順4を繰り返す
すべてのメンバーのアップグレードが完了すると、クラスターは3.4へのアップグレードが成功したことを報告します。
メンバー1:
{"level":"info","ts":1526586949.0920913,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}{"level":"info","ts":1526586949.0921566,"caller":"etcdserver/server.go:2272","msg":"cluster version is updated","cluster-version":"3.4"}
メンバー2:
{"level":"info","ts":1526586949.092117,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"729934363faa4a24","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0923078,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
メンバー3:
{"level":"info","ts":1526586949.0921423,"caller":"membership/cluster.go:473","msg":"updated cluster version","cluster-id":"7dee9ba76d59ed53","local-member-id":"b548c2511513015","from":"3.3","from":"3.4"}{"level":"info","ts":1526586949.0922918,"caller":"api/capability.go:76","msg":"enabled capabilities for version","cluster-version":"3.4"}
16.6 - etcdを3.2から3.3にアップグレード
通常、etcd 3.2から3.3へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v3.2のプロセスを1つずつ停止し、etcd v3.3のプロセスに置き換えます。
- すべてのプロセスがv3.3で稼働すると、クラスターでv3.3の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
v3データのないv2から移行する
場合、v3のETCD_DATA_DIR/member/snap/dbファイルがない状態で既存のスナップショットからリストアすると、etcdサーバーv3.2+でパニックが発生します。これは、以前のv3データがないままサーバーをv2から移行した場合に起こります。この動作は、v3データの意図しない消失(たとえばdbファイルが移動された場合)を防ぐ役割も果たします。etcdでは、v3への移行後はv3データが存在する場合にのみ、さらに移行を進められます。v3.0サーバーにv3データが存在するまでは、それより新しいv3バージョンにアップグレードしないでください。
3.3の主な互換性を損なう変更は次のとおりです。
etcd --auto-compaction-retentionフラグの値の型をstringに変更
--auto-compaction-retentionフラグを変更して文字列値を受け付ける
ようにし、より細かい粒度
で指定できるようにしました。--auto-compaction-retentionが文字列値を受け付けるようになったため、etcdの設定YAMLファイルのauto-compaction-retentionフィールドをstring型に変更しなければなりません。以前は--config-file etcd.config.yamlにauto-compaction-retention: 24フィールドを指定できましたが、今後はauto-compaction-retention: "24"またはauto-compaction-retention: "24h"にする必要があります。--auto-compaction-mode periodic --auto-compaction-retention "24h"と設定する場合、--auto-compaction-retentionフラグの期間の値は、Goのtime.ParseDuration
関数で有効な値でなければなりません。
*etcdserver.ServerConfigをetcdserver.ServerConfigに変更
etcdserver.EtcdServerのメンバーフィールドの型は、*etcdserver.ServerConfigからetcdserver.ServerConfigに変更されました。また、etcdserver.NewServerは*etcdserver.ServerConfigではなくetcdserver.ServerConfigを受け取るようになりました。
変更前と変更後(例:k8s.io/kubernetes/test/e2e_node/services/etcd.go )
embed.Config.LogOutputフィールドの追加
v3.4では、このフィールドが[]string型のembed.Config.LogOutputsに変更されたことに注意してください。詳細はv3.4アップグレードガイド
を参照してください。
embed.ConfigにLogOutputフィールドが追加されました。
以前は、gRPCサーバーの警告はetcdserverに記録されていました。
v3.3以降、gRPCサーバーのログはデフォルトで無効です。
v3.4では、embed.Config.SetupLoggingメソッドが非推奨になったことに注意してください。詳細はv3.4アップグレードガイド
を参照してください。
gRPCサーバーのログを有効にするには、embed.Config.Debugフィールドをtrueに設定します。
/healthエンドポイントのレスポンスの変更
以前は、[endpoint]:[client-port]/healthが手動でマーシャリングしたJSON値を返していました。3.3ではetcdhttp.Health
構造体を定義するようになりました。
v3.3.0-rc.0、v3.3.0-rc.1、v3.3.0-rc.2では、etcdhttp.Healthの"health"と"errors"フィールドがboolean型であったことに注意してください。後方互換性のため、"health"フィールドをstring型に戻し、"errors"フィールドを削除しました。追加の正常性情報は、別のAPIで提供される予定です。
gRPCゲートウェイのHTTPエンドポイントの変更(/v3alphaを/v3betaに置き換え)
変更前
変更後
/v3alphaエンドポイントへのリクエストは/v3betaにリダイレクトされ、/v3alphaは3.4リリースで削除されます。
リクエストの最大サイズ制限の変更
3.3では、サーバー側とクライアント側の両方でリクエストサイズ制限をカスタマイズできるようになりました。以前のバージョン(v3.2.10、v3.2.11)では、クライアントのレスポンスサイズはわずか4 MiBに制限されていました。
サーバー側のリクエスト制限は、--max-request-bytesフラグで設定できます。
または、embed.Config.MaxRequestBytesフィールドで設定します。
指定しない場合、サーバー側の制限のデフォルトは1.5 MiBです。
クライアント側のリクエスト制限は、サーバー側の制限に基づいて設定しなければなりません。
指定しない場合、クライアント側の送信制限のデフォルトは2 MiB(1.5 MiB + gRPCのオーバーヘッド分のバイト数)、受信制限のデフォルトはmath.MaxInt32です。詳細はclientv3 godoc
を参照してください。
低水準gRPCクライアントラッパーの関数シグネチャの変更
3.3では、clientv3のgRPCクライアントラッパーの関数シグネチャが変更されています。この変更は、メッセージサイズ制限を指定するカスタムgrpc.CallOption
をサポートするために必要でした。
変更前と変更後
clientv3のSnapshot APIのエラー型の変更
以前は、clientv3のSnapshot APIが低水準の[grpc/*status.statusError]型のエラーを返していました。v3.3では、他のAPIとの一貫性を保つため、これらのエラーを対応する公開エラー型に変換します。
変更前
変更後
etcdctl lease timetoliveコマンドの出力の変更
以前は、有効期限切れのリースに対してlease timetolive LEASE_IDコマンドを実行すると、残り秒数として-1sが表示されていました。3.3では、より明確なメッセージを出力します。
変更前
変更後
golang.org/x/net/contextのインポートの変更
clientv3ではgolang.org/x/net/contextが非推奨となりました。プロジェクトが他のコード(etcdが生成したprotocol bufferコードなど)にgolang.org/x/net/contextを取り込み、github.com/coreos/etcd/clientv3をインポートしている場合、コンパイルにはGo 1.9+が必要です。
変更前
変更後
gRPC依存関係の変更
3.3では、grpc/grpc-go
のv1.7.5が必要になりました。
grpclog.Loggerの非推奨化
grpclog.Loggerは非推奨となり、代わりにgrpclog.LoggerV2
を使用します。clientv3.Loggerはgrpclog.LoggerV2になりました。
変更前
変更後
grpc.ErrClientConnTimeoutの非推奨化
以前は、クライアントの接続タイムアウト時にgrpc.ErrClientConnTimeoutエラーが返されていました。3.3では代わりにcontext.DeadlineExceededを返します(#8504
を参照)。
変更前
変更後
公式コンテナーレジストリの変更
etcdは、主なコンテナーレジストリとしてgcr.io/etcd-development/etcd
を、補助のレジストリとしてquay.io/coreos/etcd
を使用するようになりました。
変更前
変更後
>= v3.3.14へのアップグレード
v3.3.14 では、クライアントバランサーの実装の差異を最小限に抑えるため、3.4の一部の機能を取り込む必要がありました。このリリースでは、「最初のetcd-serverが利用できないとkube-apiserver 1.13.xが動作しない」(kubernetes#72102) を修正しています。
grpc.ErrClientConnClosingはgRPC >= 1.10で非推奨になりました
。
新しいクライアントバランサー
は、非同期リゾルバーを使用してgRPCの接続関数にエンドポイントを渡します。そのため、v3.3.14
以降では、基盤となる接続の確立を待つために、接続オプションgrpc.WithBlockが必要です。
変更の全一覧は、CHANGELOG を参照してください。
サーバーアップグレードのチェックリスト
アップグレードの要件
既存のetcd環境を3.3にアップグレードするには、稼働中のクラスターが3.2以降でなければなりません。3.2より前の場合は、3.3にアップグレードする前に3.2にアップグレード してください。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、etcdのデータをバックアップ
してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにダウングレード
できます。snapshotコマンドでバックアップされるのはv3データのみであることに注意してください。v2データについては、v2データストアのバックアップ
を参照してください。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョン3.3にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
制限事項
注:クラスターにv3データしかなく、v2データがない場合、この制限は適用されません。
クラスターが50MBを超えるv2データセットを提供している場合、新しくアップグレードした各メンバーが既存のクラスターに追いつくまでに最大2分かかることがあります。直近のスナップショットのサイズを調べて、データの総量を見積もってください。つまり、各メンバーのアップグレードの間に2分待つのが最も安全です。
データの総量が100MB以上とさらに大きい場合、この1回限りの処理にはより長い時間がかかることがあります。この規模の非常に大きなetcdクラスターを管理している場合は、アップグレード前にetcdチーム までお気軽にお問い合わせください。手順についてアドバイスします。
ダウングレード
すべてのメンバーをv3.3にアップグレードすると、クラスターもv3.3にアップグレードされ、この完了状態からのダウングレードはできません。ただし、1つでもv3.2のメンバーが残っていれば、クラスターとその動作は「v3.2」のままであり、この混在状態からすべてのメンバーでv3.2のetcdバイナリを使用する状態に戻せます。
アップグレード完了後でもクラスターをダウングレードできるように、すべてのetcdメンバーのデータディレクトリをバックアップ してください。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.2 etcdクラスターをアップグレードする方法を説明します。
1. アップグレード要件の確認
クラスターは正常で、v3.2.xで稼働していますか。
2. 既存のetcdプロセスの停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
問題が発生した場合にダウングレードできるよう、この時点でetcdのデータをバックアップ することをお勧めします。
3. etcd v3.3バイナリへの置き換えと新しいetcdプロセスの起動
新しいv3.3のetcdは、自身の情報をクラスターに公開します。
新しいv3.3のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、アップグレード済みのメンバーに次のような警告が記録されます。これは想定された動作で、すべてのetcdクラスターメンバーをv3.3にアップグレードすると表示されなくなります。
4. 残りのすべてのメンバーで手順2から手順3を繰り返す
5. 完了
すべてのメンバーのアップグレードが完了すると、クラスターは3.3へのアップグレードが成功したことを報告します。
16.7 - etcdを3.1から3.2にアップグレード
通常、etcd 3.1から3.2へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v3.1のプロセスを1つずつ停止し、etcd v3.2のプロセスに置き換えます。
- すべてのプロセスがv3.2で稼働すると、クラスターでv3.2の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
v3データのないv2から移行する
場合、v3のETCD_DATA_DIR/member/snap/dbファイルがない状態で既存のスナップショットからリストアすると、etcdサーバーv3.2+でパニックが発生します。これは、以前のv3データがないままサーバーをv2から移行した場合に起こります。この動作は、v3データの意図しない消失(たとえばdbファイルが移動された場合)を防ぐ役割も果たします。etcdでは、v3への移行後はv3データが存在する場合にのみ、さらに移行を進められます。v3.0サーバーにv3データが存在するまでは、それより新しいv3バージョンにアップグレードしないでください。
3.2の主な互換性を損なう変更は次のとおりです。
snapshot-countのデフォルト値の変更
--snapshot-countを大きくすると、スナップショットを作成するまでより多くのRaftエントリーをメモリーに保持するため、メモリー使用量が繰り返し増大
します。リーダーが最新のRaftエントリーをより長く保持するので、遅いフォロワーはリーダーのスナップショット作成前に追いつくための時間を多く確保できます。--snapshot-countは、メモリー使用量の増加と遅いフォロワーの可用性向上とのトレードオフです。
v3.2以降、--snapshot-countのデフォルト値は10,000から100,000に変更されました
。
gRPC依存関係の変更(>=3.2.10)
3.2.10以降では、grpc/grpc-go
のv1.7.5が必要になりました(<=3.2.9ではv1.2.1が必要です)。
grpclog.Loggerの非推奨化
grpclog.Loggerは非推奨となり、代わりにgrpclog.LoggerV2
を使用します。clientv3.Loggerはgrpclog.LoggerV2になりました。
変更前
変更後
grpc.ErrClientConnTimeoutの非推奨化
以前は、クライアントの接続タイムアウト時にgrpc.ErrClientConnTimeoutエラーが返されていました。3.2では代わりにcontext.DeadlineExceededを返します(#8504
を参照)。
変更前
変更後
リクエストの最大サイズ制限の変更(>=3.2.10)
3.2.10と3.2.11では、サーバー側のリクエストサイズ制限をカスタマイズできます。>=3.2.12では、サーバー側とクライアント側の両方でリクエストサイズ制限をカスタマイズできます。以前のバージョン(v3.2.10、v3.2.11)では、クライアントのレスポンスサイズはわずか4 MiBに制限されていました。
サーバー側のリクエスト制限は、--max-request-bytesフラグで設定できます。
または、embed.Config.MaxRequestBytesフィールドで設定します。
指定しない場合、サーバー側の制限のデフォルトは1.5 MiBです。
クライアント側のリクエスト制限は、サーバー側の制限に基づいて設定しなければなりません。
指定しない場合、クライアント側の送信制限のデフォルトは2 MiB(1.5 MiB + gRPCのオーバーヘッド分のバイト数)、受信制限のデフォルトはmath.MaxInt32です。詳細はclientv3 godoc
を参照してください。
低水準gRPCクライアントラッパーの変更
3.2.12以降では、clientv3のgRPCクライアントラッパーの関数シグネチャが変更されています。この変更は、メッセージサイズ制限を指定するカスタムgrpc.CallOption
をサポートするために必要でした。
変更前と変更後
clientv3.Lease.TimeToLive APIの変更
以前は、clientv3.Lease.TimeToLive APIに存在しないリースIDを指定すると、lease.ErrLeaseNotFoundが返されていました。3.2では代わりにレスポンスでTTL=-1を返し、エラーは返しません(#7305
を参照)。
変更前
変更後
clientv3.NewFromConfigFileをclientv3.yaml.NewConfigに移動
clientv3.NewFromConfigFileはyaml.NewConfigに移動しました。
変更前
変更後
--listen-peer-urlsと--listen-client-urlsの変更
ドメイン名はネットワークインターフェースのバインド先として無効であるため、3.2では--listen-peer-urlsと--listen-client-urlsのドメイン名を拒否するようになりました(3.1では警告の表示のみでした)。これらのURLがscheme://IP:portの正しい形式であることを確認してください。
背景については、issue #6336 を参照してください。
サーバーアップグレードのチェックリスト
アップグレードの要件
既存のetcd環境を3.2にアップグレードするには、稼働中のクラスターが3.1以降でなければなりません。3.1より前の場合は、3.2にアップグレードする前に3.1にアップグレード してください。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、etcdのデータをバックアップ
してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにダウングレード
できます。snapshotコマンドでバックアップされるのはv3データのみであることに注意してください。v2データについては、v2データストアのバックアップ
を参照してください。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョン3.2にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
制限事項
注:クラスターにv3データしかなく、v2データがない場合、この制限は適用されません。
クラスターが50MBを超えるv2データセットを提供している場合、新しくアップグレードした各メンバーが既存のクラスターに追いつくまでに最大2分かかることがあります。直近のスナップショットのサイズを調べて、データの総量を見積もってください。つまり、各メンバーのアップグレードの間に2分待つのが最も安全です。
データの総量が100MB以上とさらに大きい場合、この1回限りの処理にはより長い時間がかかることがあります。この規模の非常に大きなetcdクラスターを管理している場合は、アップグレード前にetcdチーム までお気軽にお問い合わせください。手順についてアドバイスします。
ダウングレード
すべてのメンバーをv3.2にアップグレードすると、クラスターもv3.2にアップグレードされ、この完了状態からのダウングレードはできません。ただし、1つでもv3.1のメンバーが残っていれば、クラスターとその動作は「v3.1」のままであり、この混在状態からすべてのメンバーでv3.1のetcdバイナリを使用する状態に戻せます。
アップグレード完了後でもクラスターをダウングレードできるように、すべてのetcdメンバーのデータディレクトリをバックアップ してください。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.1 etcdクラスターをアップグレードする方法を説明します。
1. アップグレード要件の確認
クラスターは正常で、v3.1.xで稼働していますか。
2. 既存のetcdプロセスの停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
問題が発生した場合にダウングレードできるよう、この時点でetcdのデータをバックアップ することをお勧めします。
3. etcd v3.2バイナリへの置き換えと新しいetcdプロセスの起動
新しいv3.2のetcdは、自身の情報をクラスターに公開します。
新しいv3.2のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、アップグレード済みのメンバーに次のような警告が記録されます。これは想定された動作で、すべてのetcdクラスターメンバーをv3.2にアップグレードすると表示されなくなります。
4. 残りのすべてのメンバーで手順2から手順3を繰り返す
5. 完了
すべてのメンバーのアップグレードが完了すると、クラスターは3.2へのアップグレードが成功したことを報告します。
16.8 - etcdを3.0から3.1にアップグレード
通常、etcd 3.0から3.1へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v3.0のプロセスを1つずつ停止し、etcd v3.1のプロセスに置き換えます。
- すべてのプロセスがv3.1で稼働すると、クラスターでv3.1の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
v3データのないv2から移行する
場合、v3のETCD_DATA_DIR/member/snap/dbファイルがない状態で既存のスナップショットからリストアすると、etcdサーバーv3.2+でパニックが発生します。これは、以前のv3データがないままサーバーをv2から移行した場合に起こります。この動作は、v3データの意図しない消失(たとえばdbファイルが移動された場合)を防ぐ役割も果たします。etcdでは、v3への移行後はv3データが存在する場合にのみ、さらに移行を進められます。v3.0サーバーにv3データが存在するまでは、それより新しいv3バージョンにアップグレードしないでください。
監視
v3.0.xの次のメトリクスは非推奨となり、go-grpc-prometheus に置き換えられました。
etcd_grpc_requests_totaletcd_grpc_requests_failed_totaletcd_grpc_active_streamsetcd_grpc_unary_requests_duration_seconds
アップグレードの要件
既存のetcd環境を3.1にアップグレードするには、稼働中のクラスターが3.0以降でなければなりません。3.0より前の場合は、3.1にアップグレードする前に3.0にアップグレード してください。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、etcdのデータをバックアップ
してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにダウングレード
できます。snapshotコマンドでバックアップされるのはv3データのみであることに注意してください。v2データについては、v2データストアのバックアップ
を参照してください。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョン3.1にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
制限事項
注:クラスターにv3データしかなく、v2データがない場合、この制限は適用されません。
クラスターが50MBを超えるv2データセットを提供している場合、新しくアップグレードした各メンバーが既存のクラスターに追いつくまでに最大2分かかることがあります。直近のスナップショットのサイズを調べて、データの総量を見積もってください。つまり、各メンバーのアップグレードの間に2分待つのが最も安全です。
データの総量が100MB以上とさらに大きい場合、この1回限りの処理にはより長い時間がかかることがあります。この規模の非常に大きなetcdクラスターを管理している場合は、アップグレード前にetcdチーム までお気軽にお問い合わせください。手順についてアドバイスします。
ダウングレード
すべてのメンバーをv3.1にアップグレードすると、クラスターもv3.1にアップグレードされ、この完了状態からのダウングレードはできません。ただし、1つでもv3.0のメンバーが残っていれば、クラスターとその動作は「v3.0」のままであり、この混在状態からすべてのメンバーでv3.0のetcdバイナリを使用する状態に戻せます。
アップグレード完了後でもクラスターをダウングレードできるように、すべてのetcdメンバーのデータディレクトリをバックアップ してください。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.0 etcdクラスターをアップグレードする方法を説明します。
1. アップグレード要件の確認
クラスターは正常で、v3.0.xで稼働していますか。
2. 既存のetcdプロセスの停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
問題が発生した場合にダウングレードできるよう、この時点でetcdのデータをバックアップ することをお勧めします。
3. etcd v3.1バイナリへの置き換えと新しいetcdプロセスの起動
新しいv3.1のetcdは、自身の情報をクラスターに公開します。
新しいv3.1のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、アップグレード済みのメンバーに次のような警告が記録されます。これは想定された動作で、すべてのetcdクラスターメンバーをv3.1にアップグレードすると表示されなくなります。
4. 残りのすべてのメンバーで手順2から手順3を繰り返す
5. 完了
すべてのメンバーのアップグレードが完了すると、クラスターは3.1へのアップグレードが成功したことを報告します。
16.9 - etcdを2.3から3.0にアップグレード
通常、etcd 2.3から3.0へのアップグレードは、停止時間なしのローリングアップグレードで実行できます。
- etcd v2.3のプロセスを1つずつ停止し、etcd v3.0のプロセスに置き換えます。
- すべてのプロセスがv3.0で稼働すると、クラスターでv3.0の新機能を利用できます。
アップグレードを開始する 前に、このガイドの残りを読んで準備してください。
アップグレードのチェックリスト
v3データのないv2から移行する
場合、v3のETCD_DATA_DIR/member/snap/dbファイルがない状態で既存のスナップショットからリストアすると、etcdサーバーv3.2+でパニックが発生します。これは、以前のv3データがないままサーバーをv2から移行した場合に起こります。この動作は、v3データの意図しない消失(たとえばdbファイルが移動された場合)を防ぐ役割も果たします。etcdでは、v3への移行後はv3データが存在する場合にのみ、さらに移行を進められます。v3.0サーバーにv3データが存在するまでは、それより新しいv3バージョンにアップグレードしないでください。
アップグレードの要件
既存のetcd環境を3.0にアップグレードするには、稼働中のクラスターが2.3以降でなければなりません。2.3より前の場合は、3.0にアップグレードする前に2.3 にアップグレードしてください。
また、ローリングアップグレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl cluster-healthコマンドでクラスターの正常性を確認してください。
準備
etcdをアップグレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、etcdのデータディレクトリをバックアップ してください。アップグレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにダウングレード できます。
バージョンの混在
アップグレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。すべてのメンバーがバージョン3.0にアップグレードされて初めて、クラスターのアップグレードが完了したと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
制限事項
データの総量が50MBを超える場合、新しくアップグレードしたメンバーが既存のクラスターに追いつくまでに最大2分かかることがあります。直近のスナップショットのサイズを調べて、データの総量を見積もってください。つまり、各メンバーのアップグレードの間に2分待つのが最も安全です。
データの総量が100MB以上とさらに大きい場合、この1回限りの処理にはより長い時間がかかることがあります。この規模の非常に大きなetcdクラスターを管理している場合は、アップグレード前にetcdチーム までお気軽にお問い合わせください。手順についてアドバイスします。
ダウングレード
すべてのメンバーをv3.0にアップグレードすると、クラスターもv3.0にアップグレードされ、この完了状態からのダウングレードはできません。ただし、1つでもv2.3のメンバーが残っていれば、クラスターとその動作は「v2.3」のままであり、この混在状態からすべてのメンバーでv2.3のetcdバイナリを使用する状態に戻せます。
アップグレード完了後でもクラスターをダウングレードできるように、すべてのetcdメンバーのデータディレクトリをバックアップ してください。
アップグレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv2.3 etcdクラスターをアップグレードする手順を詳しく説明します。
1. アップグレード要件の確認
クラスターは正常で、v.2.3.xで稼働していますか。
2. 既存のetcdプロセスの停止
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
問題が発生した場合にダウングレードできるよう、この時点でetcdのデータディレクトリをバックアップ することをお勧めします。
3. etcd v3.0バイナリへの置き換えと新しいetcdプロセスの起動
新しいv3.0のetcdは、自身の情報をクラスターに公開します。
新しいv3.0のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
クラスター全体のアップグレードが完了するまでは、アップグレード済みのメンバーに次のような警告が記録されます。これは想定された動作で、すべてのetcdクラスターメンバーをv3.0にアップグレードすると表示されなくなります。
4. 残りのすべてのメンバーで手順2から手順3を繰り返す
5. 完了
すべてのメンバーのアップグレードが完了すると、クラスターは3.0へのアップグレードが成功したことを報告します。
その他の考慮事項
- etcdctlの環境変数が更新されています。
ETCDCTL_API=2 etcdctl cluster-healthは正常に動作するのに、ETCDCTL_API=3 etcdctl endpoints healthがError: grpc: timed out when dialingを返す場合は、必ず新しい変数名 を使用してください。
既知の問題
- etcd < v3.1は、Go > v1.7でビルドすると正常に動作しません。詳細はIssue 6951 を参照してください。
- etcdサーバーのログに
transport: http2Client.notifyError got notified that the client transport was broken unexpected EOF.などのエラーが表示される場合は、ビルド済みのリリース、または(etcd v3.1+ & go v1.7+)もしくは(etcd <v3.1 & go v1.6.x)でビルドしたetcdを使用していることを確認してください。 - アップグレード中にv2.3クラスターへv3ノードを追加することはサポートされておらず、パニックを引き起こす可能性があります。詳細はIssue 7249 を参照してください。etcdメンバーのバージョン混在が許可されるのは、v3への移行中のみです。メンバー構成を変更する前に、アップグレードを完了してください。
17 - ダウングレード
17.1 - etcdクラスターとアプリケーションのダウングレード
このセクションには、etcdクラスターとアプリケーションのダウングレードに関するドキュメントをまとめています。
etcd v3.xクラスターのダウングレード
17.2 - etcdをv3.7からv3.6にダウングレード
通常、etcd v3.7からv3.6へのダウングレードは、停止時間なしのローリングダウングレードで実行できます。
- etcd v3.7のプロセスを1つずつ停止し、etcd v3.6のプロセスに置き換えます。
- ダウングレードを有効にすると、クラスターでv3.7の新機能を利用できなくなります。
ダウングレードを開始する 前に、このガイドの残りを読んで準備してください。
ダウングレードのチェックリスト
v3.7とv3.6の主な違いは次のとおりです。
フラグの違い
v3.7では新しいフラグが追加されていないため、v3.6プロセスはv3.7の設定に含まれるすべてのフラグを受け付けます。ダウングレード時に設定を変更する必要はありません。
この差分は、バージョンv3.7.0-rc.0とv3.6.13に基づいています。実際の差分は使用するパッチバージョンによって異なるため、先にdiff <(etcd-3.7/bin/etcd -h | grep \\-\\-) <(etcd-3.6/bin/etcd -h | grep \\-\\-)で確認してください。
v3.7で削除された非推奨の--experimental-*フラグはv3.6にはまだ存在しますが、ダウングレード後に再追加しないでください。両バージョンで動作する、対応する非実験的フラグまたは--feature-gatesのエントリーを使用してください。
Prometheusメトリクスの違い
サーバーダウングレードのチェックリスト
ダウングレードの要件
ローリングダウングレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをダウングレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、スナップショットバックアップをダウンロード してください。ダウングレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにロールバック できます。
作業を始める前に、etcd v3.6の最新リリースをダウンロードしてください。
バージョンの混在
ダウングレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。etcdctl downgrade enable 3.6でダウングレードを有効にすると、クラスターはダウングレードされたと見なされます。内部では、クラスター全体のバージョンがダウングレード先のバージョンに設定され、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
ロールバック
etcdクラスターをダウングレードする前に、クラスターのスナップショットバックアップを作成してダウンロード してください。このスナップショットを使えば、必要に応じてクラスターをダウングレード前の状態にリストアできます。ダウングレード中に問題が発生した場合は、まず根本原因を特定して解決することをお勧めします。
etcdctl downgrade enableを実行してダウングレードが開始され、少なくとも1つのメンバーがv3.7のままでクラスターのバージョンがまだ混在している場合は、etcdctl downgrade cancelを実行し、ダウングレード済みのすべてのメンバーを元のv3.7バイナリで再起動することで、進行中のダウングレードを取り消せます。
すべてのメンバーをv3.6にダウングレードすると、クラスターのダウングレードは完了したと見なされます。ダウングレードが完全に完了した後に元のバージョンに戻したい場合は、一貫性を確保しデータ破損を防ぐため、公式のアップグレードガイド に従うことをお勧めします。
ダウングレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.7 etcdクラスターをダウングレードする方法を説明します。以下の出力は、直前にv3.6.13からアップグレードしたクラスターで、1台のホスト上の3つのループバックポートを使用し、etcd v3.7.0-rc.0とetcd v3.6.13を実際に稼働させたときのものです。
手順1:ダウングレード要件の確認
クラスターは正常で、v3.7.xで稼働していますか。
手順2:リーダーからスナップショットバックアップをダウンロード
問題が発生した場合にダウングレードをロールバックできるよう、スナップショットバックアップをダウンロード してください。
手順3:ダウングレード先バージョンの検証
ダウングレードを有効にする前に、ダウングレード先のバージョンを検証します。
- サポートされるのは、マイナーバージョンを1つずつ下げるダウングレードだけです。たとえば、v3.7からv3.5へのダウングレードは許可されません。
- 検証が成功するまでは、次の手順に進まないでください。
手順4:ダウングレードを有効化
ダウングレードを有効にすると、クラスターはダウングレード先のバージョンであるv3.6のプロトコルで動作し始めます。また、etcdはスキーマをダウングレード先のバージョンに自動的に移行します。この処理は通常、非常に短時間で完了します。次の手順に進む前に、エンドポイントのステータスを確認し、すべてのサーバーのストレージバージョンがv3.6に移行済みであることを確認してください。
ダウングレードを有効にすると、すべてのサーバーがまだv3.7バイナリで稼働していても、etcdctl downgrade cancelでダウングレードを取り消さない限り、クラスターはv3.6のプロトコルで動作し続けます。
手順5:既存のetcdサーバーを1つ停止
サーバーを停止する前に、そのサーバーがリーダーかどうかを確認します。リーダーは最後にダウングレードすることをお勧めします。停止するサーバーがリーダーの場合、停止前にmove-leaderで別のサーバーへ移譲すると、停止時間の一部を回避できます。
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
手順6:同じ設定でetcdサーバーを再起動
同じ設定で、v3.6のetcdバイナリを使用してetcdサーバーを再起動します。
v3.6のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
v3.5とは異なり、v3.6のステータスエンドポイントはダウングレード情報を報告するため、ダウングレード済みのメンバーは、ダウングレードが完了するまでDOWNGRADE ENABLEDをtrueとして表示し、ストレージバージョンも表示し続けます。
手順7:残りのメンバーで手順5と手順6を繰り返す
すべてのメンバーのダウングレードが終わると、ダウングレードは自動的に完了し、DOWNGRADE ENABLEDはfalseに戻ります。クラスターの正常性とステータスを確認し、すべてのメンバーのマイナーバージョンとストレージバージョンがv3.6であることを確認します。
リーダーのログには、次のようなメッセージが表示されるはずです。
17.3 - etcdをv3.6からv3.5にダウングレード
通常、etcd v3.6からv3.5へのダウングレードは、停止時間なしのローリングダウングレードで実行できます。
- etcd v3.6のプロセスを1つずつ停止し、etcd v3.5のプロセスに置き換えます。
- ダウングレードを有効にすると、クラスターでv3.6の新機能を利用できなくなります。
ダウングレードを開始する 前に、このガイドの残りを読んで準備してください。
ダウングレードのチェックリスト
v3.6からv3.5への移行に伴う主な互換性を損なう変更は次のとおりです。
フラグの違い
v3.6の設定で次のフラグを使用している場合は、v3.5にダウングレードするときに必ず削除、改名、またはデフォルト値の変更を行ってください。
この差分は、バージョンv3.6.0とv.3.5.18に基づいています。実際の差分は使用するパッチバージョンによって異なるため、先にdiff <(etcd-3.6/bin/etcd -h | grep \\-\\-) <(etcd-3.5/bin/etcd -h | grep \\-\\-)で確認してください。
Prometheusメトリクスの違い
サーバーダウングレードのチェックリスト
ダウングレードの要件
ローリングダウングレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
準備
etcdをダウングレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、スナップショットバックアップをダウンロード してください。ダウングレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにロールバック できます。
作業を始める前に、etcd v3.5の最新リリースをダウンロードしてください。
バージョンの混在
ダウングレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。etcdctl downgrade enable 3.5でダウングレードを有効にすると、クラスターはダウングレードされたと見なされます。内部では、クラスター全体のバージョンがダウングレード先のバージョンに設定され、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
ロールバック
etcdクラスターをダウングレードする前に、クラスターのスナップショットバックアップを作成してダウンロード してください。このスナップショットを使えば、必要に応じてクラスターをダウングレード前の状態にリストアできます。ダウングレード中に問題が発生した場合は、まず根本原因を特定して解決することをお勧めします。
etcdctl downgrade enableを実行してダウングレードが開始され、少なくとも1つのメンバーがv3.6のままでクラスターのバージョンがまだ混在している場合は、etcdctl downgrade cancelを実行し、ダウングレード済みのすべてのメンバーを元のv3.6バイナリで再起動することで、進行中のダウングレードを取り消せます。
すべてのメンバーをv3.5にダウングレードすると、クラスターのダウングレードは完了したと見なされます。ダウングレードが完全に完了した後に元のバージョンに戻したい場合は、一貫性を確保しデータ破損を防ぐため、公式のアップグレードガイド に従うことをお勧めします。
ダウングレード手順
この例では、ローカルマシンで稼働する3メンバー構成のv3.6 etcdクラスターをダウングレードする方法を説明します。
手順1:ダウングレード要件の確認
クラスターは正常で、v3.6.xで稼働していますか。
手順2:リーダーからスナップショットバックアップをダウンロード
問題が発生した場合にダウングレードをロールバックできるよう、スナップショットバックアップをダウンロード してください。
手順3:ダウングレード先バージョンの検証
ダウングレードを有効にする前に、ダウングレード先のバージョンを検証します。
- サポートされるのは、マイナーバージョンを1つずつ下げるダウングレードだけです。たとえば、v3.6からv3.4へのダウングレードは許可されません。
- 検証が成功するまでは、次の手順に進まないでください。
手順4:ダウングレードを有効化
ダウングレードを有効にすると、クラスターはダウングレード先のバージョンであるv3.5のプロトコルで動作し始めます。また、etcdはスキーマをダウングレード先のバージョンに自動的に移行します。この処理は通常、非常に短時間で完了します。次の手順に進む前に、エンドポイントのステータスを確認し、すべてのサーバーのストレージバージョンがv3.5に移行済みであることを確認してください。
ダウングレードを有効にすると、すべてのサーバーがまだv3.6バイナリで稼働していても、etcdctl downgrade cancelでダウングレードを取り消さない限り、クラスターはv3.5のプロトコルで動作し続けます。
手順5:既存のetcdサーバーを1つ停止
サーバーを停止する前に、そのサーバーがリーダーかどうかを確認します。リーダーは最後にダウングレードすることをお勧めします。
停止するサーバーがリーダーの場合、停止前にmove-leaderで別のサーバーへ移譲すると、停止時間の一部を回避できます。
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
手順6:同じ設定でetcdサーバーを再起動(v3.5で削除または置換されるフラグを除く)
同じ設定で、新しいetcdバイナリを使用してetcdサーバーを再起動します。
新しいv3.5のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
v3.5のステータスエンドポイントにはダウングレード情報が実装されていないため、v3.5サーバーのDOWNGRADE ENABLEDはfalseと表示されますが、この時点でもクラスターのダウングレードは有効です。
手順7:残りのメンバーで手順5と手順6を繰り返す
すべてのメンバーのダウングレードが完了したら、クラスターの正常性とステータスを確認し、すべてのメンバーのマイナーバージョンがv3.5で、ストレージバージョンが空であることを確認します。
リーダーのログには、次のようなメッセージが表示されるはずです。
17.4 - etcdを3.5から3.4にダウングレード
通常、etcd 3.5から3.4へのダウングレードは、停止時間なしのローリングダウングレードで実行できます。
- etcd 3.5のプロセスを1つずつ停止し、etcd 3.4のプロセスに置き換えます。
- 3.4のプロセスを1つでも起動すると、クラスターで3.5の新機能を利用できなくなります。
ダウングレードを開始する 前に、このガイドの残りを読んで準備してください。
ダウングレードのチェックリスト
クラスターで認証を有効にしている場合、3.5では認証に関するWALエントリーの形式が変更される ため、3.5からのローリングダウングレードはサポートされません。認証の手順 に従い、先に認証を無効にしてすべてのユーザーを削除できます。
3.5から3.4への移行に伴う主な互換性を損なう変更は次のとおりです。
フラグの違い
3.5の設定で次のフラグを使用している場合は、3.4にダウングレードするときに必ず削除、改名、またはデフォルト値の変更を行ってください。
この差分は、バージョン3.5.14とv.3.4.33に基づいています。実際の差分は使用するパッチバージョンによって異なるため、先にdiff <(etcd-3.5/bin/etcd -h | grep \\-\\-) <(etcd-3.4/bin/etcd -h | grep \\-\\-)で確認してください。
etcd --logger zap
3.4のデフォルトは--logger=capnslog、3.5のデフォルトは--logger=zapです。
zapを引き続き使用するには、明示的に指定する必要があります。
Prometheusメトリクスの違い
サーバーダウングレードのチェックリスト
ダウングレードの要件
ローリングダウングレードを円滑に進めるには、稼働中のクラスターが正常でなければなりません。作業を進める前に、etcdctl endpoint healthコマンドでクラスターの正常性を確認してください。
ダウングレード先の3.4バージョンは、>= 3.4.32でなければなりません。
準備
etcdをダウングレードする際は、必ず本番環境に適用する前に、etcdに依存するサービスをステージング環境でテストしてください。
作業を始める前に、スナップショットバックアップをダウンロード
してください。ダウングレードで問題が発生した場合は、このバックアップを使用して元のetcdバージョンにロールバック
できます。snapshotコマンドでバックアップされるのはv3データのみであることに注意してください。v2データについては、v2データストアのバックアップ
を参照してください。
作業を始める前にetcd 3.4の最新リリースをダウンロードし、バージョンが>= 3.4.32であることを確認してください。
バージョンの混在
ダウングレード中のetcdクラスターでは、異なるバージョンのetcdメンバーの混在がサポートされ、全メンバーに共通する最も低いバージョンのプロトコルで動作します。メンバーが1つでもバージョン3.4にダウングレードされると、クラスターはダウングレードされたと見なされます。内部では、etcdメンバーが相互にネゴシエーションを行ってクラスター全体のバージョンを決定し、そのバージョンによって報告されるバージョンとサポートされる機能が決まります。
制限事項
注:クラスターにv3データしかなく、v2データがない場合、この制限は適用されません。
クラスターが50MBを超えるv2データセットを提供している場合、新しくダウングレードした各メンバーが既存のクラスターに追いつくまでに最大2分かかることがあります。直近のスナップショットのサイズを調べて、データの総量を見積もってください。つまり、各メンバーのダウングレードの間に2分待つのが最も安全です。
データの総量が100MB以上とさらに大きい場合、この1回限りの処理にはより長い時間がかかることがあります。この規模の非常に大きなetcdクラスターを管理している場合は、ダウングレード前にetcdチーム までお気軽にお問い合わせください。手順についてアドバイスします。
ロールバック
メンバーが1つでも3.4にダウングレードされると、クラスターのバージョンは3.4に下がり、動作は「3.4」と互換になります。ロールバックするには、etcdを3.4から3.5にアップグレード の手順に従う必要があります。
クラスターのダウングレードが完全に完了した後でも、そのダウングレードをロールバックできるように、スナップショットバックアップをダウンロード してください。
ダウングレード手順
この例では、ローカルマシンで稼働する3メンバー構成の3.5 etcdクラスターをダウングレードする方法を説明します。
手順1:ダウングレード要件の確認
クラスターは正常で、3.5.xで稼働していますか。
手順2:リーダーからスナップショットバックアップをダウンロード
問題が発生した場合にダウングレードをロールバックできるよう、スナップショットバックアップをダウンロード してください。
手順3:既存のetcdサーバーを1つ停止
サーバーを停止する前に、そのサーバーがリーダーかどうかを確認します。
停止するサーバーがリーダーの場合、停止前にmove-leaderで別のサーバーへ移譲すると、停止時間の一部を回避できます。
各etcdプロセスを停止すると、他のクラスターメンバーに想定どおりのエラーが記録されます。クラスターメンバーへの接続が(一時的に)切断されたためであり、正常な動作です。
手順4:同じ設定に--next-cluster-version-compatibleを追加してetcdサーバーを再起動
同じ設定で、新しいetcdバイナリと--next-cluster-version-compatibleを使用してetcdサーバーを再起動します。
新しい3.4のetcdは、自身の情報をクラスターに公開します。この時点で、クラスターは全メンバーに共通する最も低いバージョンである3.4のプロトコルで動作し始めます。
新しい3.4のetcdバイナリで、各メンバー、続いてクラスター全体が正常になることを確認してください。
未ダウングレードのメンバーには、次のような情報が記録されます。
手順5:残りのメンバーで手順3と手順4を繰り返す
すべてのメンバーのダウングレードが完了したら、クラスターの正常性とバージョンを確認します。
18 - トリアージ
18.1 - Issueのトリアージガイドライン
目的
Issueの管理を迅速に行います。
etcdのIssueは https://github.com/etcd-io/etcd/issues
に一覧があり、
ラベルで分類されています。たとえば、バグと判断されたIssueには、
最終的にarea/bug ラベルが付けられます。新しいIssueには当初ラベルがありませんが、
通常はetcdのメンテナーや活発に活動する貢献者が調査結果に基づいて追加します。
ラベルの詳細な一覧は https://github.com/kubernetes/kubernetes/labels
を参照してください。
便利なIssue検索へのリンクをいくつか挙げます。
対象範囲
このガイドラインは、etcdに新たに報告されたIssueをトリアージするための基本文書です。IssueやPRの管理への協力は誰でも歓迎しますが、ここで説明する作業と責任は、etcdのメンテナーや活発に活動する貢献者を想定しています。
Issueがバグかどうかの確認
報告された問題が実際にバグかどうかを確認します。バグでない場合は調査結果をコメントし、軽微なIssueならクローズします。軽微でない場合は、報告者からの返答を待ち、異議がないかを確認します。報告者が30日以内に返答しなければ、Issueをクローズします。問題を再現できない場合や追加情報が必要な場合は、報告者に向けてコメントを残します。
動きのないIssue
報告者からの情報が不足しているIssueは、60日以内に情報が提供されなければクローズすることを推奨します。
重複するIssue
Issueが重複している場合は、その旨と元のIssueへの参照をコメントし、クローズします。
etcdに属さないIssue
etcdが使用している他のプロジェクトの問題が報告されることがあります。たとえば、grpcやgolangの問題です。このような場合は、適切なプロジェクトでIssueを作成するよう報告者に依頼することを推奨します。メンテナーと報告者が追跡のために残す必要があると考える場合を除き、Issueをクローズします。
重要なラベルの確認
Issueに該当領域のラベルが付き、適切な担当者が割り当てられ、マイルストーンが決まっていることを確認します。必要なラベルが欠けていれば追加します。権限不足でラベルを付けられない場合や適切なラベルを判断できない場合は、無理に対応する必要はありません。必要に応じてメンテナーに連絡してください。
必要に応じた担当者への確認
開発者が担当しているIssueで30日経ってもPRが作成されていない場合は、担当者に連絡し、PRの作成、または必要に応じて担当を外れることを依頼します。
18.2 - PRの管理
目的
PRの管理を迅速にすること。
etcdのPRは https://github.com/etcd-io/etcd/pulls
に一覧表示されています。
PRにはさまざまなラベル、マイルストーン、レビュアーなどを設定できます。ラベルの詳細な一覧は、次のページを参照してください。
https://github.com/kubernetes/kubernetes/labels
便利なPR検索の例を以下に示します。
対象範囲
このガイドラインは、etcdでPRを管理する際の基本となるドキュメントです。PRの管理への協力はどなたでも歓迎しますが、このドキュメントで扱う作業と責任は、etcdのメンテナーと積極的に活動するコントリビューターを想定しています。
動きのないPRへの対応
レビューコメントに15日間対応がない場合は、PRの作成者に確認を促してください。PRの作成者から90日間返信がない場合は、可能であれば新しいコミットでPRを更新してください。それができなければ、動きのないPRは180日後にクローズするべきです。
必要に応じてレビュアーに確認を促す
レビュアーは適時に応答していますが、全員が忙しいことを考慮し、レビューを依頼してすぐに応答がなくても、しばらく待ってください。10日間応答がなければ、PRへのコメントの追加、メールの送信、Slackでのメッセージ送信によって連絡して構いません。
重要なラベルが付いていることを確認する
PRに適切なレビュアーが追加されていることを確認してください。また、マイルストーンが指定されていることも確認してください。これらの項目やその他の重要なラベルが不足していれば追加してください。適切なラベルを判断できない場合は、必要に応じてメンテナーに対応を依頼するコメントを残してください。