etcdの学習者メンバーの設計
etcdの学習者メンバー
Gyuho Lee (github.com/gyuho, Amazon Web Services, Inc.), Joe Betz (github.com/jpbetz, Google Inc.)
背景
メンバーシップの再構成は、運用上の最も大きな課題の1つでした。よくある課題を確認します。
1. 新しいクラスターメンバーがリーダーに過負荷をかける
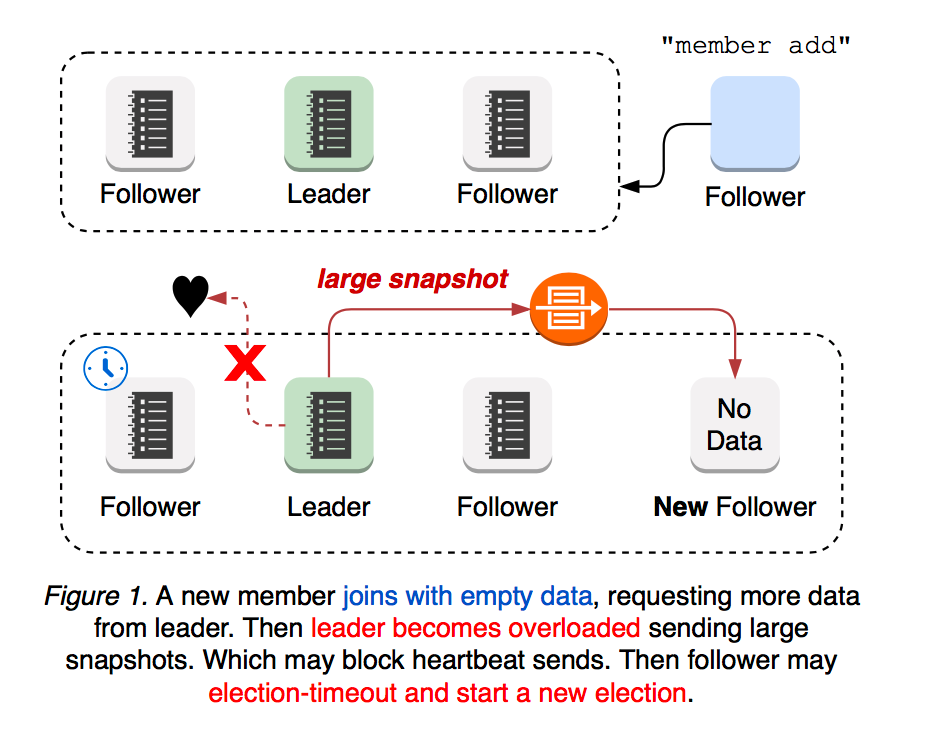
新たに参加したetcdメンバーはデータを持たない状態から開始するため、リーダーのログに追いつくまで、リーダーに多くの更新を要求します。これによってリーダーのネットワークが過負荷になりやすくなり、フォロワーへのハートビートが滞ったり失われたりします。その場合、フォロワーの選挙タイムアウトが発生し、新しいリーダー選挙が始まる可能性があります。つまり、新しいメンバーを加えたクラスターでは、リーダー選挙が起きやすくなります。リーダー選挙と、その後の新しいメンバーへの更新の伝播は、どちらもクラスターを一時的に利用不能にする原因になりやすい処理です(図1)。
2. ネットワーク分断の各状況
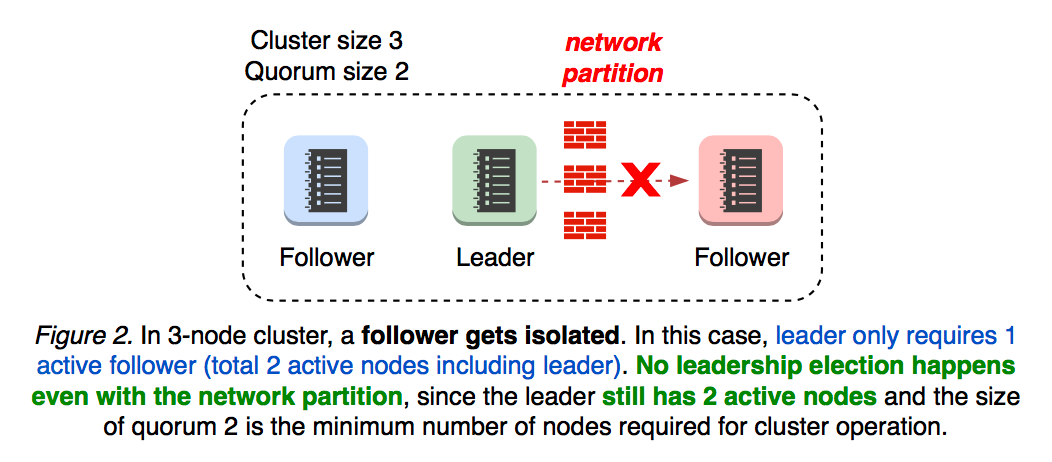
ネットワーク分断が起きるとどうなるでしょうか。リーダーが属する側の状況によって異なります。リーダー側が稼働中のクォーラムを維持していれば、クラスターは動作し続けます(図2)。
2.1 リーダーの孤立
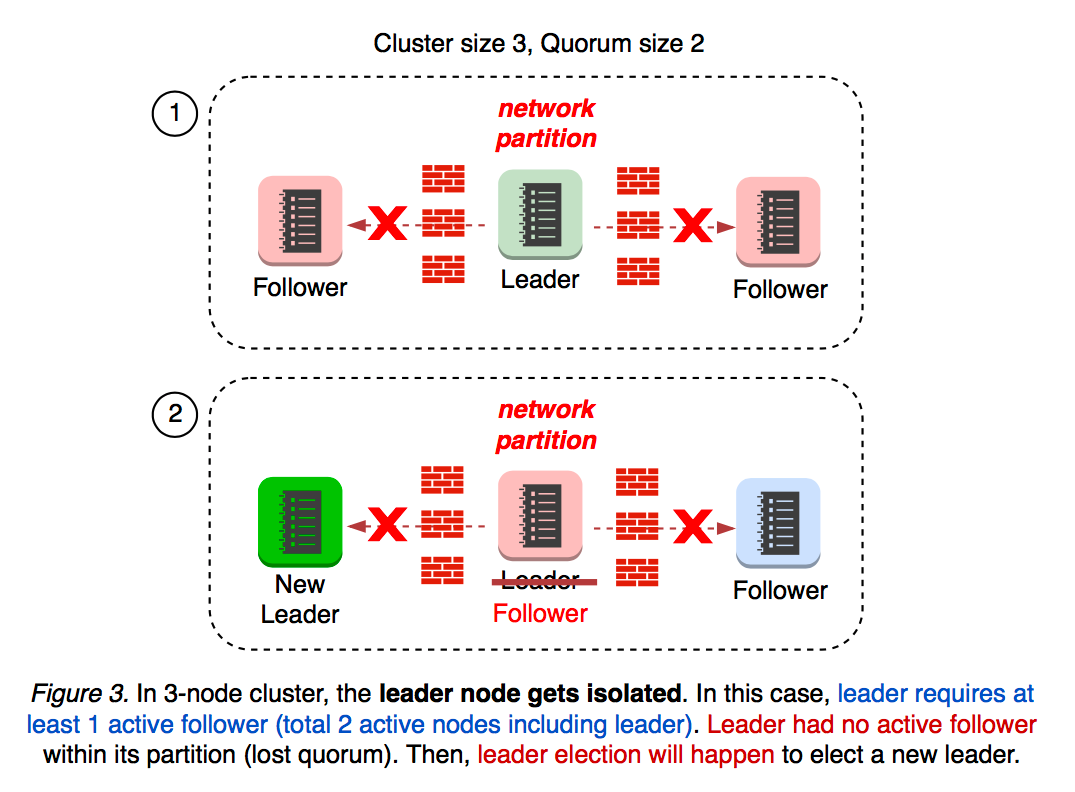
リーダーがクラスターの他のメンバーから孤立すると、どうなるでしょうか。リーダーは各フォロワーの進捗を監視しています。クォーラムとの接続を失うとフォロワーに戻るため、クラスターの可用性に影響します(図3)。
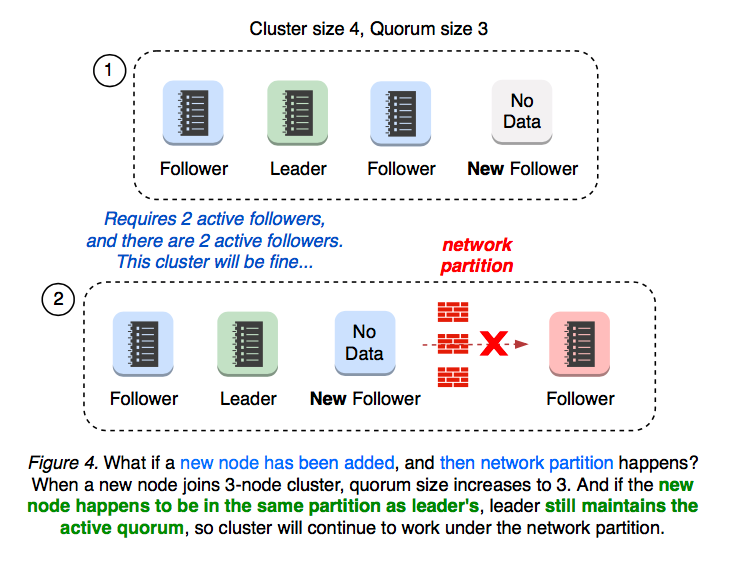
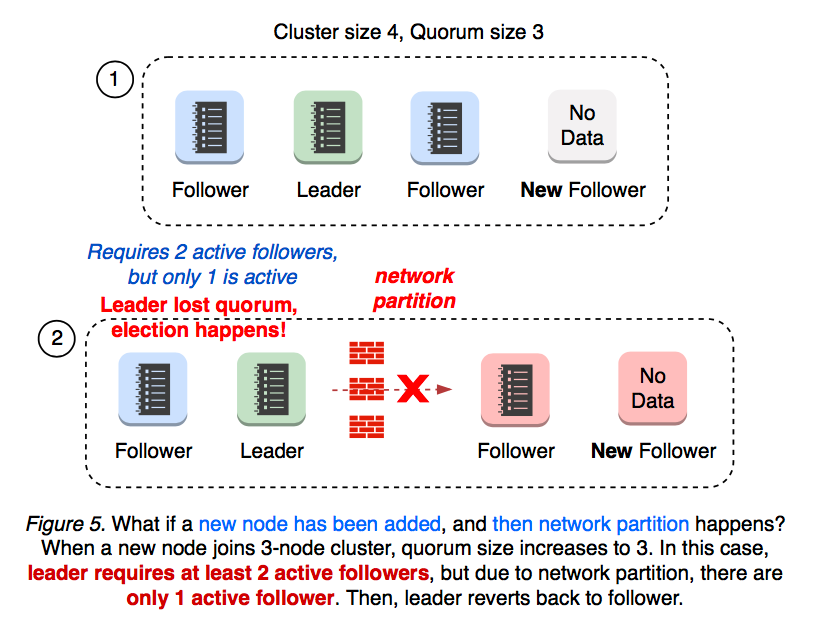
3ノードのクラスターに新しいノードを追加すると、クラスターサイズは4、クォーラムのサイズは3になります。新しいノードが参加した後にネットワーク分断が起きた場合はどうでしょうか。分断後に、新しいメンバーがどちら側に位置するかによって異なります。
2.2 クラスターの3+1への分断
新しいノードがリーダーと同じ側にあれば、リーダーは稼働中の3ノードのクォーラムを維持します。リーダー選挙は発生せず、クラスターの可用性にも影響しません(図4)。
2.3 クラスターの2+2への分断
クラスターが2ノードずつに分断されると、どちら側も3ノードのクォーラムを維持できません。この場合、リーダー選挙が発生します(図5)。
2.4 クォーラムの喪失
先にネットワーク分断が起き、その後で新しいメンバーを追加するとどうなるでしょうか。分断された3ノードのクラスターでは、すでに1つのフォロワーが切断されています。新しいメンバーを追加すると、クォーラムは2から3に変わります。クラスターの4ノード中、稼働しているのは2ノードだけになるため、クォーラムを失い、新しいリーダー選挙が始まります(図6)。
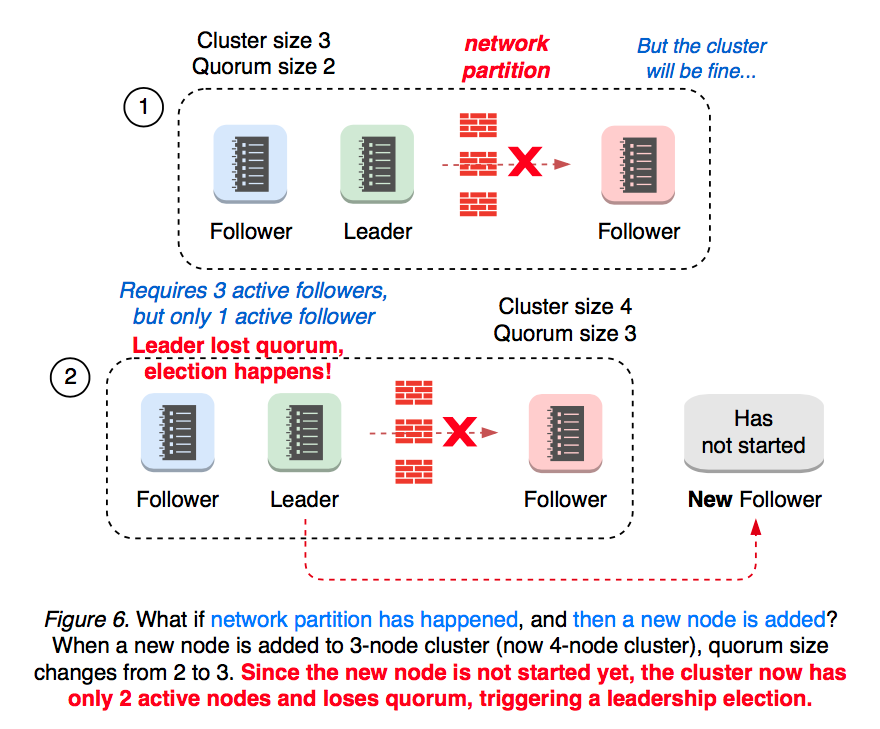
メンバーの追加はクォーラムのサイズを変える可能性があるため、健全でないノードを置き換えるときは、常に先に“member remove”を行うことを推奨します。
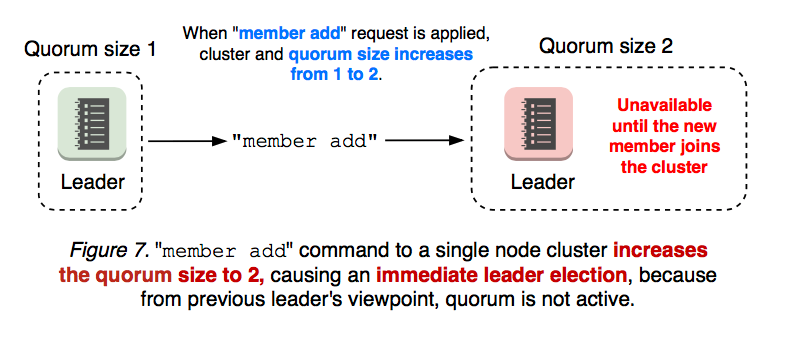
1ノードのクラスターに新しいメンバーを追加すると、クォーラムのサイズは2に変わります。それまでのリーダーが、稼働中のクォーラムがないことを認識すると、直ちにリーダー選挙が始まります。これは、“member add”が2段階の処理だからです。ユーザーはまず“member add”コマンドを適用し、その後で新しいノードのプロセスを起動する必要があります(図7)。
3. クラスターの設定ミス
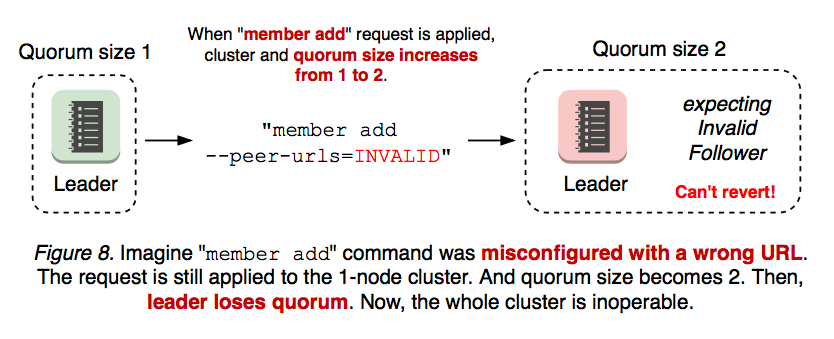
さらに悪いのは、追加したメンバーの設定が誤っている場合です。メンバーシップの再構成は、“etcdctl member add”と、指定したピアURLでetcdサーバープロセスを起動する、2段階の処理です。つまり、URLの値が無効であっても、“member add”コマンドはURLにかかわらず適用されます。最初の段階で無効なURLを適用すると、次の段階で新しいetcdを起動することすらできません。いったんクラスターがクォーラムを失うと、メンバーシップの変更を元に戻す方法はありません(図8)。
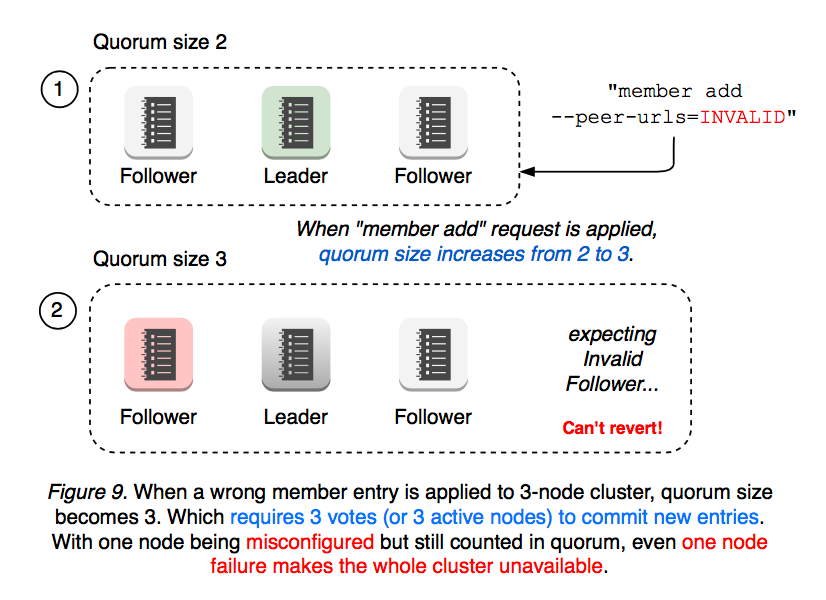
複数ノードのクラスターでも同じです。たとえば、2つのメンバーが停止(1つは故障、もう1つは設定ミス)し、2つが稼働していても、クラスターのメンバーシップを変更するには少なくとも3票が必要です(図9)。
このように、単純な設定ミスでクラスター全体が動作不能になることがあります。その場合、運用担当者はetcd --force-new-clusterフラグを使って、手動でクラスターを再作成する必要があります。etcdはKubernetesに不可欠なサービスになっているため、ごく短い停止でもユーザーに大きな影響を与える可能性があります。etcdでこうした操作を簡単にするために、何を改善できるでしょうか。特に、リーダー選挙はクラスターの可用性にとって極めて重要です。クォーラムのサイズを変えずに、メンバーシップの再構成の影響を小さくできるでしょうか。新しいノードが追いつくまで、リーダーへの更新要求を最小限にして待機できるでしょうか。メンバーシップの設定ミスを常に元に戻せるようにし、より安全に扱えるでしょうか。誤ったmember addコマンドでクラスターが停止することがあってはいけません。新しいメンバーを追加するとき、ユーザーがネットワーク構成を気にする必要はあるでしょうか。ノードの配置や発生中のネットワーク分断にかかわらず、member add APIを動作させられるでしょうか。
Raftの学習者メンバー
前のセクションで挙げた可用性の問題を軽減するため、Raft §4.2.1 では、新しいノード状態“Learner”を導入しています。このノードは、リーダーのログに追いつくまで、投票権のないメンバーとしてクラスターに参加します。
v3.4の機能
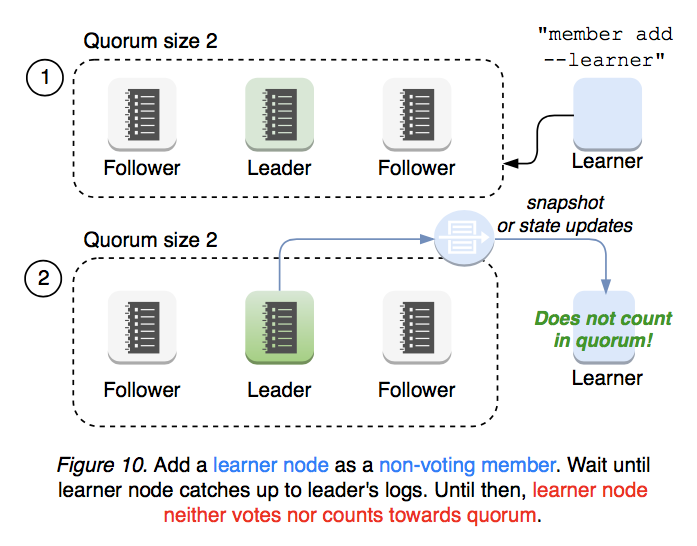
新しい学習者ノードを追加するための運用作業は、できるだけ少なくするべきです。member add --learnerコマンドで新しい学習者メンバーを追加します。学習者メンバーは投票権を持たずにクラスターに参加しますが、リーダーからすべてのデータを受信します(図10)。
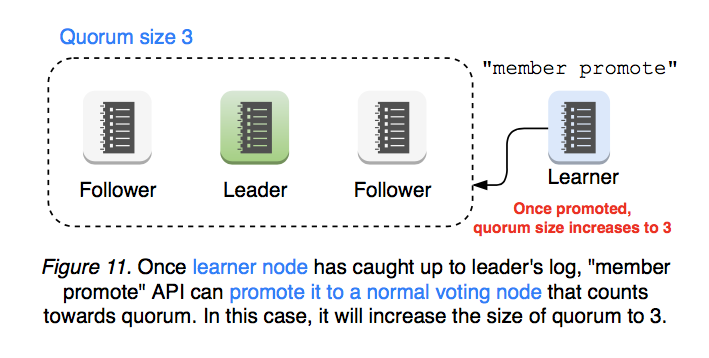
学習者メンバーがリーダーの進捗に追いつくと、member promote APIで投票メンバーに昇格できます。昇格後は、クォーラムの構成員として数えられます(図11)。
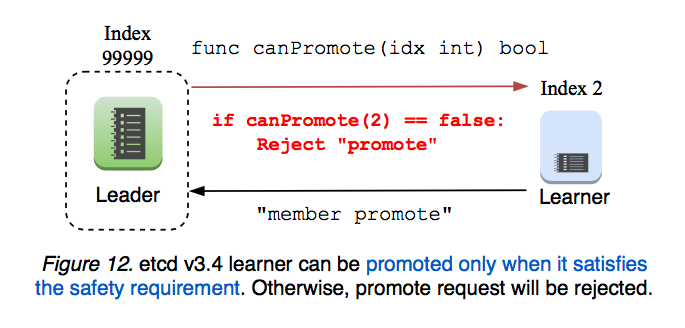
etcdサーバーは、操作の安全性を確保するため、昇格リクエストを検証します。学習者メンバーを投票メンバーに昇格できるのは、そのログがリーダーのログに追いついた後だけです(図12)。
学習者メンバーは、昇格するまで待機ノードとしてのみ機能します。学習者メンバーにリーダーシップを移譲することはできません。学習者メンバーはクライアントの読み書きを拒否します。そのため、クライアントのバランサーはリクエストを学習者メンバーに送らないようにするべきです。これは、学習者メンバーがリーダーにRead Indexリクエストを発行する必要がないことを意味します。この制限によって、v3.4リリースでの初期実装を単純化しています(図13)。
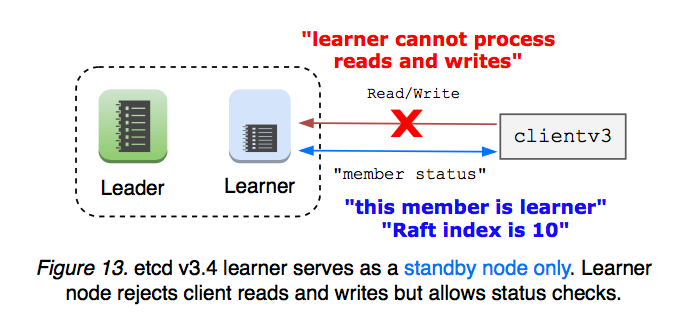
また、etcdはクラスターが持てる学習者メンバーの総数を制限し、ログの複製でリーダーが過負荷になるのを防ぎます。学習者メンバーが自ら昇格することはありません。etcdは学習者メンバーの状態情報と安全性チェックを提供しますが、昇格するかどうかの最終判断は、クラスターの運用担当者が行わなければなりません。
今後のリリースに向けた機能案
新規メンバーの初期状態を学習者に統一し、デフォルトにする:学習者メンバーはクォーラムのサイズを変えないため、新規メンバーのデフォルト状態を学習者にすれば、メンバーシップの再構成の安全性が大幅に向上します。設定ミスがあっても、クォーラムを失わずに常に元に戻せます。
投票メンバーへの昇格を完全に自動化する:学習者メンバーがリーダーのログに追いついたら、クラスターが自動的に昇格させられます。ユーザーが一定のしきい値を定義し、その要件が満たされると、学習者メンバーが自ら投票メンバーに昇格します。ユーザーから見れば、“member add”コマンドは今と同じように動作しつつ、学習者メンバーの機能によって安全性が高まります。
学習者を待機用のフェイルオーバーノードにする:学習者メンバーは待機ノードとして参加し、クラスターの可用性が損なわれると自動的に昇格します。
学習者を読み取り専用にする:学習者メンバーは、昇格しない読み取り専用ノードとしても機能できます。弱い一貫性のモードでは、リーダーからデータを受信するだけで、書き込みを処理しません。コンセンサスの負担なしにローカルで読み取りを処理すると、リーダーの負荷を大幅に減らせますが、古いデータを返す可能性があります。強い一貫性のモードでは、最新のデータを返すためにリーダーへread indexを要求しますが、書き込みは引き続き拒否します。
学習者メンバーとMirror Makerの比較
etcdは、watch APIを使ってキーの作成と更新を別のクラスターに継続的に中継する“mirror maker”を実装しています。ミラーリングは、初期同期が完了すれば、通常は遅延の増加が小さい仕組みです。学習者メンバーとミラーリングは、どちらも既存のデータを読み取り専用で複製するために使える点で共通しています。ただし、ミラーリングは線形化可能性を保証しません。ネットワーク切断中に以前のキー・バリューが破棄されていることがあるため、クライアントは監視レスポンスを検証して正しい順序を確認する必要があります。したがって、ミラーには順序の保証がありません。一貫性と引き換えに最小の遅延が必要な場合(データセンター間など)にはミラーを使用します。すべての履歴データとその順序を維持するには、学習者メンバーを使用します。
付録:v3.4の学習者メンバーの実装
“MemberAdd” APIに“Learner”ノードの種類を公開する。
etcdクライアントは、“MemberAdd” APIに学習者ノード用のフラグを追加します。etcdサーバーのハンドラーは、pb.ConfChangeAddLearnerNode型のメンバーシップ変更エントリーを適用します。コマンドの適用後、サーバーはetcd --initial-cluster-state=existingフラグを指定してクラスターに参加します。この学習者ノードは、投票も、クォーラムの構成員として数えられることもありません。
学習者メンバーはまだ遅れている可能性があり、クォーラムにも数えられないため、etcdサーバーは学習者メンバーにリーダーシップを移譲してはいけません。学習者メンバーが多いほどリーダーが伝播するデータが増えるため、etcdサーバーはクラスターが持てる学習者メンバーを1つに制限します。クライアントは学習者ノードと通信できますが、学習者メンバーは直列化可能読み取りとメンバー状態API以外のすべてのリクエストを拒否します。これは初期実装を単純にするためです。将来的には、クラスターのデータを継続的にミラーリングする読み取り専用サーバーとして、学習者メンバーを拡張できます。クライアントのバランサーは、学習者ノードのエンドポイントを除外する補助関数を提供しなければなりません。そうしなければ、学習者メンバーへ送ったリクエストが失敗する可能性があります。クライアントのメンバー同期の呼び出しは、学習者というノードの種類を考慮するべきです。クライアントのエンドポイント更新の呼び出しも同様です。
MemberListとMemberStatusのレスポンスは、どのノードが学習者かを示すべきです。
“MemberPromote” APIを追加する。
Raft内部では、学習者ノードに対する2回目のMemberAdd呼び出しが、そのノードを投票メンバーに昇格させます。リーダーは、各フォロワーと学習者メンバーの進捗を保持します。学習者メンバーがスナップショットメッセージの処理を完了していなければ、昇格リクエストを拒否します。昇格リクエストを受け付けるのは、学習者ノードが健全であり、リーダーと同期済み、または差分がしきい値以内の場合に限ります。たとえば、学習者メンバーに複製するエントリー数がスナップショット件数の1/10未満なら、昇格後にリーダーが学習者メンバーへスナップショットを送る必要が生じる可能性は低くなります。これらのロジックはすべてetcdserverパッケージに固定されており、設定で変更することはできません。
参考資料
- 元のGitHub Issue:etcd#9161
- ユースケース:etcd#3715
- ユースケース:etcd#8888
- ユースケース:etcd#10114